


世界模型从零讲起(十五):世界模型的预算地图——用算力换数据、用想象换执行的总账
承接前十四篇:散落的账,最后要合成一张表
这个系列已经写了十四条路线:重建式(VAE 潜空间、几何场、占用栅格)、Dreamer 的 RSSM 想象训练、JEPA 的表征预测、Sora/GAIA/Cosmos/Genie 这一支视频生成式世界模型、把动作变成输出的 WAM、评测栈、部署工程、MuZero/TD-MPC2 的潜空间规划、推理系统的 token/KV 账、机器人本体的能耗底线、Dyna 谱系与复合误差、槽位分解、以及分层的时间抽象。每篇都单独算过一笔账——这篇的 KV 缓存多大,那篇的去噪要几步,另一篇的 rollout 能走多远。
但把所有单独算过的账叠在一起,读者面对 2026 年层出不穷的新工作,仍然缺一个骨架回答四个问题:
- 为什么同样叫「世界模型」,有人用千兆 token 的视频去压模型,有人只用几十小时真机数据就够?
- 一个世界模型到底贵在「参数」上、贵在「想象」上、还是贵在「规划」上?
- 论文里说「想象中训练,比真实交互省几个数量级」,这个「省略」是从哪里抠出来的,代价又是什么?
- 当机器人本体算力只有 T4 级别时,该砍掉这四项里的哪个?
本文给出一张预算地图(budget map):世界模型是一笔由四类成本构成的投资——先验数据、参数规模、想象步数、规划算力——它们各自和「需要多少真实环境交互」之间存在可交换的关系。把所有技术路线上的选择,都翻译成「我把成本放在哪一格、从哪一格取回」。
先说清楚这篇文章的定位:它不是某一篇论文的拆解,而是一个组织框架。框架里每个数字都能引回前面已经讲过的具体论文;如果某个环节在前十四篇已经展开,这里只引用,不重讲。
第一张表:世界模型是一笔怎样的交易
世界模型真正想优化的量
把「智能体」写成一个有预算的决策者。设它在真实环境中能执行的交互步数为 ,每步的代价是 (遥操作人工、硬件磨损、安全风险都在里面)。在模型内部的想象步数为 ,每步代价是 (一次前向/几步去噪/一次 rollout 展开)。
总成本写成:
其中 是训练与部署世界模型本身的成本(参数加载、显存占用、蒸馏/量化等一次性开销)。决策者要的是一个目标政策收益 (任务成功率、达到某个目标的步数等),在 足够小的前提下让 最大化。
这个写法把四个常见争论一次性统一了:
- 「世界模型值不值得做」等价于问 是否显著小于原本需要的 ;
- 「视频生成 vs 潜空间」等价于问哪种做法让 最小、每个想象步携带的信息量最大;
- 「要不要在线规划」等价于问:多花在 上,会不会让 进一步下降。
真实世界为什么贵得离谱
真实交互的单价不是常数。以单臂机械臂为例:一套成熟的遥操作数据采集平台,每小时能记录的有效成功轨迹往往是几分钟到十几分钟量级,其余时间是失败、复位、重摆场景与安全停顿。如果每天采 8 小时,一个月也就得到几百到上千条合格轨迹。这还只是数据成本,不含硬件折旧和人力。
更关键的是,真实交互的收益是有上限的:每多采一小时数据,边际收益递减非常快,因为真实分布里本来就没有那么多信息——你会反复看到相似场景。这一点在 Dyna 谱系里被反复讨论过:模型的真正价值在于用同样的数据点出更多的「如果」,而不是再多采一个小时。这就是复合误差那篇文章((十一):Dyna 谱系、PILCO 与复合误差)的起点。
一句话记住这个交易:世界模型不是「更便宜的仿真器」,它是一个把真实步数和想象步数互相兑换的汇率机制。汇率好,模型划算;汇率差,模型就成了纯开销。
第二张表:四项成本与四个杠杆
把前面那笔总账按成本归类,得到四类成本与四项可调节的杠杆。下表的「典型量级」都来自本站前面拆过的工作,作为对照锚点。
| 成本类 | 由什么决定 | 典型量级(对照锚点) | 对应的杠杆 | 把杠杆拧大,省下什么 |
|---|---|---|---|---|
| 先验数据 | 预训练视频/操作数据量 | Sora 级:数百万小时视频;Cosmos 级:从 2000 万小时视频集合中切出约 1 亿段 2–60 秒的视频片段 | 换更强的视觉/物理先验,让下游想象的失真更小 | 减少微调所需的真机数据(跨具身迁移) |
| 参数规模 | 模型宽度/深度、token 长度 | 视频生成骨干常在数十亿参数;潜空间规划模型可压到千万级(TD-MPC2 多任务世界模型从 1M 到 317M 参数) | 决定 的基准单价 | 参数小则单步便宜,可承载更多想象步 |
| 想象步数 | 一次 rollout 的展开长度、去噪步数 | 去噪 10–100 步;rollout 视界 5–50 步 | 决定一次决策要展开多少次模型 | 想象少但偏,还是想象多但贵——与复合误差直接相关 |
| 规划算力 | 候选动作数 × rollout 长度(CEM/MPPI)或树搜索节点数 | CEM 常见 100–1000 个候选;MuZero 搜索节点视预算而定 | 决定搜索广度/深度 | 用搜索代替策略,用算力买成功率 |
这张表解释了系列里很多看起来互相矛盾的选择:
- 视频生成式世界模型把「先验数据 + 参数规模」拉满,换取 里蕴含的高信息量——每一帧携带的物理细节更多,所以想象步数可以少一些。
- Dreamer 系列把「参数规模」压到最小(RSSM 主干通常远小于视频生成骨干),再把「想象步数」开到几十到上百,用想象训练把策略直接喂到收敛。这是第二篇的账:每步想象便宜,所以可以想象很多步。
- MuZero/TD-MPC2 把「规划算力」做大,用树搜索或短视野打靶替代长想象。这是第八篇的账:搜索能替代一部分策略学习,但搜索的代价是 乘以候选数。
为什么是「换」而不是「加」
四项杠杆听起来像四个独立旋钮,但预算地图的关键假设是:它们之间存在近似守恒的交换关系。
设目标是对某个分布下的任务,达到成功率 。经验上满足:
其中 是预训练数据与先验的「有效信息量」(注意是有效信息,不是原始字节), 是模型规模带来的拟合能力, 是规划/搜索投入的有效长度。这个式子不是严格定理,而是一个记账启发式:它表达的事实是——给定同样的成功率,数据强、模型强,可以少搜索;搜索强,可以少数据。
系列里三篇评测与部署文章其实都在给这个式子里的某些项提供经验校准:
把四条路线放进同一张预算地图
不同世界模型路线,本质上是把这四项杠杆放在不同的优先级上。
四条路线的分岔,从数据进来之后的第一步就开始了:要不要先把这个「世界」压成一组 token。视频生成式世界模型在这一步就把预算押满——用视频来训练,再把视频压成时空 token,后续所有想象都在 token 序列上进行。
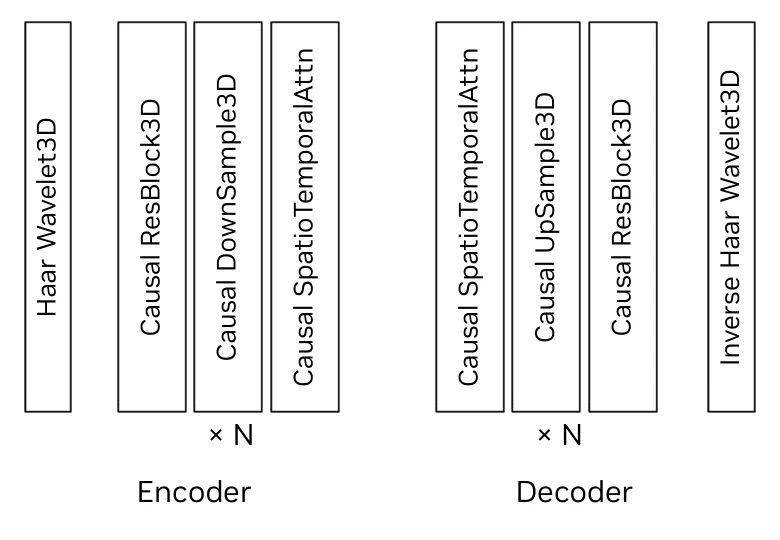
图源:Cosmos(NVIDIA,arXiv:2501.03575)图 3(b)。这一层压缩器把连续的视频帧换成离散/连续 token,并显式保证「第 帧的输出只依赖前 帧」这种时间因果性,才能让后续的自回归或扩散生成在流式场景里成立。在预算地图里,这一层决定了两件事:每一想象步要处理多少 token(乘进 ),以及 token 里保留了多少物理信息(乘进 的有效信息量)。压缩得越狠,单步越便宜但物理细节越少;压缩得越松,单步越贵但长视界推演更可信——这正是四条路线各自不同坐标的根源。
- 重建式(Dreamer/几何/占用/Slot):先验数据便宜(可以只用机器人自己的数据或少量真实图像),参数规模小,单步想象非常便宜,因此可以把想象步数开得很大。代价是 的上限被表示能力限制:潜空间再便宜,如果它没有把关键物理量放进去,想象出来的轨迹是错的。这就是第十三篇槽位分解、第十二篇几何表示的动因——它们都是在往潜空间里回填信息,目的是提高 的有效信息量,而不是靠更大的模型硬拟合。
- 视频生成式(Sora/GAIA/Cosmos/Genie):先验数据极贵,参数规模极大, 高(每一帧都要扩散/流匹配多步),但每一想象步携带的物理信息最多,而且天然覆盖跨具身场景。它把成本几乎全部押在「先验数据 + 参数规模」上,希望凭更少的真机数据换来更强的泛化——第四篇的「生成不等于理解」一节讨论的正是这个押注的风险。
- 联合嵌入(JEPA):参数规模中等,先验可以来自视频(V-JEPA 2),但 落在表征预测上而不是像素生成,单步非常便宜,因此想象可以走得更长,也更容易被部署到机器人本体——这与第十篇的能耗下限讨论接上。
- WAM:参数规模巨大(联合生成动作与帧,公开实现常见 2B–14B 量级),但通过「快动作慢世界」把想象步数的乘法摊到多个动作 chunk 上,从而让 摊销下来——这是第五篇里推理账的要点。
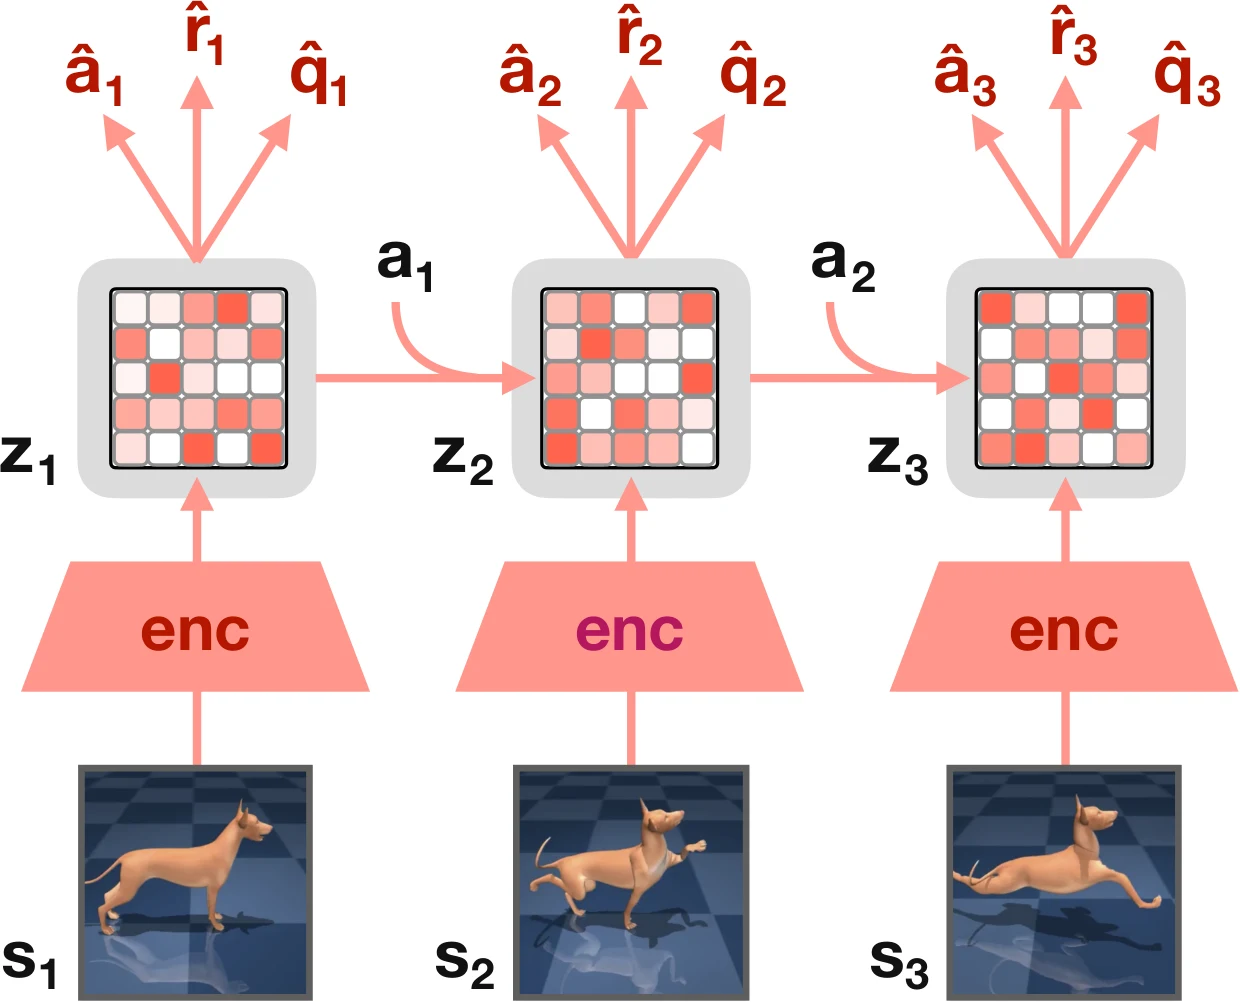
上图是 TD-MPC2 的结构(图源:TD-MPC2 论文 arXiv:2310.16828 图 3):观测 先被编码成归一化的潜表示 ,潜动力学网络负责在 上向前推演,奖励与终止预测给出每一步的代价,最后由基于采样的规划器在这个潜空间里挑出动作序列。这张图把预算地图里「参数规模」和「规划算力」两格画在了同一张纸上——编码器和动力学网络决定单步想象的单价,而规划器里的候选采样次数决定了 和闭环延迟之间要怎么取舍。
这四条路线不是「谁替代谁」,而是在同一张地图上的不同坐标。理解了坐标,就理解了为什么 2026 年出现了大量「混合」工作:它们往往在拿一条路线的强项去补另一条路线的短板。
想象步数与复合误差的兑换率
预算地图里最关键的一个汇率是「想象步数 vs 误差」。这篇的核心论点之一是:想象不是免费的,也不是越多越好。
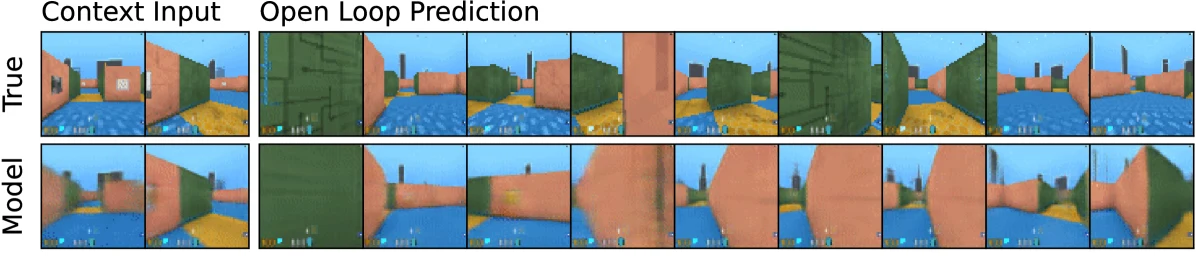
下图是 DreamerV3 做多步视频预测的一个实例(图源:DreamerV3 论文 arXiv:2301.04104 图 4)。给定 5 帧上下文和完整动作序列,模型要自己向前预测 45 帧 DMLab 迷宫画面与四足机器人画面,中间不给任何真实帧。这正是「长视界想象」这个杠杆被开到最大时的样子——每多推一步,误差就在先前预测的基础上再叠一层。
第十一篇推导过复合误差:若单步预测误差为 ,经过 步展开后的误差近似:
其中 是动力学放大率(当系统在真实环境里本身就是不稳定的时候, 可以大于 0,即使模型完美,误差也会随视界增长)。这个式子直接改写预算地图里的汇率:
- 短视界 + 多候选 + 频繁重规划: 小, 可控,但每执行一个动作要重新搜索一次, 乘以候选数。MuZero/TD-MPC2 走这条路。
- 长视界 + 少重规划: 大, 指数放大,但对简单稳定环境有效。早期 Dyna 和部分 Dreamer 想象训练走这条。
- 理想解是「多视界调度」:远处用粗粒度、近处用精细。这一半交给了第十四篇的分层时间抽象,另一半交给了第九篇的流式生成/缓存思想——把长视界切成可缓存的小块,让远处想象不必每一帧都重新展开。
这解释了一个工程直觉:长程规划很少靠「一口气展开到底」,而靠「分层 + 局部 + 缓存」三件事叠加。在预算地图里,这三件事本质都是为了让乘在 上的 尽可能小。
数据量的边际收益:先验什么时候停止起作用
预训练数据越多越好——这在视频生成世界模型里成立,但有一个前提:下游任务与预训练分布有重叠。
第四篇与第五篇都讨论过跨具身问题:一个在互联网视频上训练出来的世界模型,其「物理先验」来自人类视角的相机运动和物体交互,这与机器人第一人称视角、机械臂末端执行器、力反馈之间存在系统性差距。这个差距不会因为再增加十倍视频而消失,因为它的信息根本没有被录进视频里。
把它写进预算地图的式子:
其中 衡量预训练分布与部署分布的交集程度。也就是说,「更多数据」是沿着 的方向放大,而 本身是被数据模态决定的,不是被数据数量决定的。
这推导出 2026 年世界模型工程的一条重要分工:
- 如果部署环境与视频先验高度重叠(如室内操作、常见家庭场景),继续加视频数据有明确回报;
- 如果部署环境与先验有系统性差距(如工厂夹具、特殊材质、闭环控制的高精度力反馈),正确做法是把算力投向「在小规模真机数据上做微调/蒸馏」,而不是再多买几百万小时视频。
这直接对应了第一篇的「训练目标:从重建到变分下界」与第三篇的 V-JEPA 2 三阶段训练节里「动作条件微调」的设计:先验不换,但条件变了。
「模型只在训练分布附近才可信」,并不是一句经验口吻的提醒,而是可以被量化的。下图来自 MBPO(Model-Based Policy Optimization,Janner 等,NeurIPS 2019)对模型泛化性的测量。
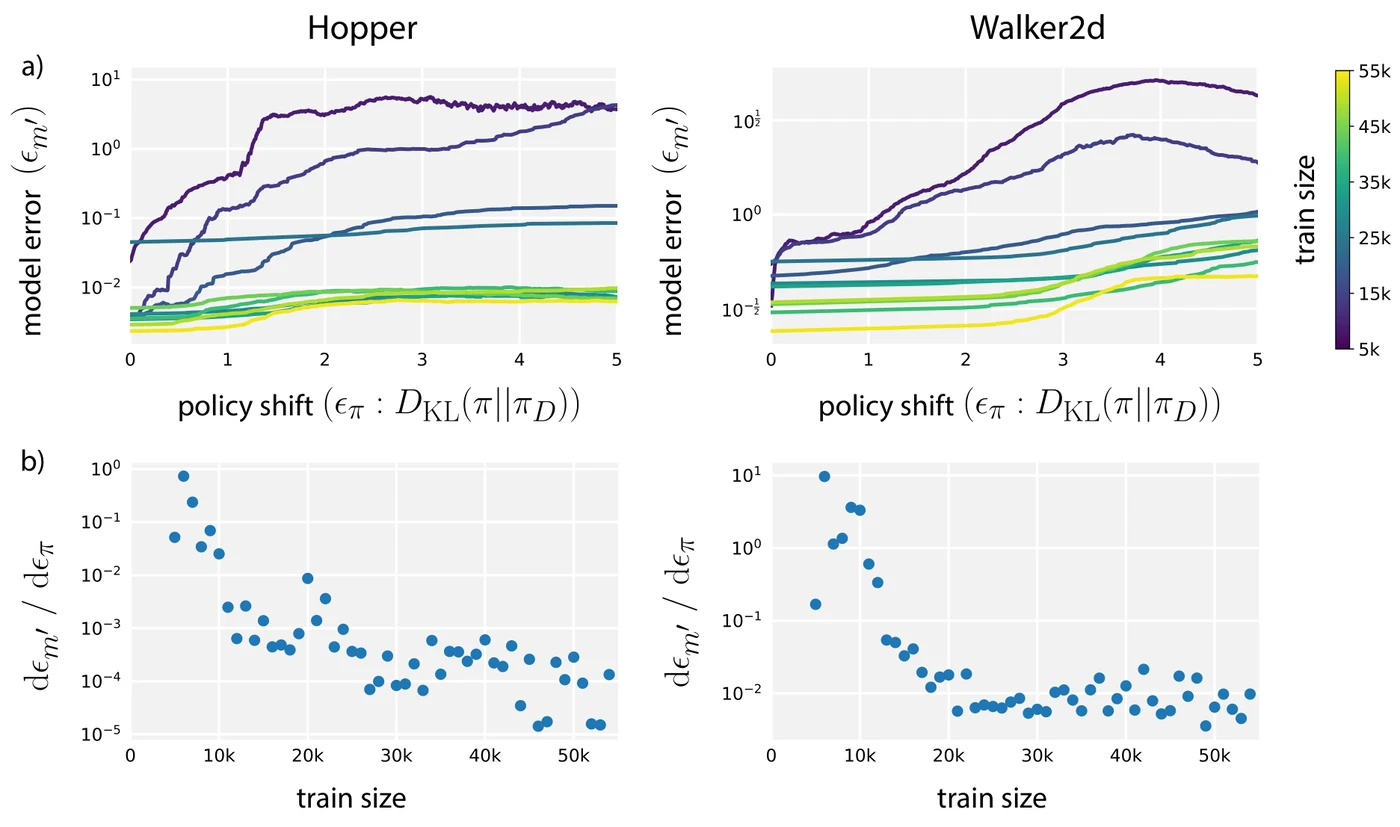
图源:MBPO 论文 arXiv:1906.08253 图 1。上排把模型放在由某个固定策略 产生的数据上训练,再到与它有不同 KL 距离 的策略上评估:横轴是策略偏移程度,纵轴是模型误差(以真实为基准)。误差随偏移单调上升,这是复合误差之外另一条误差来源——模型失配。下排把横轴换成训练集大小:同样偏移程度下数据越多曲线越低,但曲线形状不变。这两个趋势说明,加数据只能让整个误差面整体下沉,改变不了「越偏离训练分布越不可信」的结构。这与预算地图里的 是同一件事的两种表述:覆盖决定形状,数量决定高度。
这条测量也解释了 MBPO 为什么要用「短 rollout、多分支」而不是长 rollout:既然模型越远离训练分布越不可信,那么与其把一条 rollout 展开得很长、让策略跑到未知区域,不如把同样的算力拆成许多条从训练分布附近出发的短分支。分支 rollout 的设计在第十一篇的「MBPO:用分支 rollout 把复合误差关进笼子」一节展开过。
把预算调度写成代码
既然在线可调的只有想象步数与规划算力两格,一个世界模型执行器在每个决策点上要做的,其实就是按本决策剩余的延迟预算,在「想多远」和「搜多宽」之间分配。下面是一段伪代码,用来说明这个调度环路的结构——它不依赖任何具体框架,只保留与预算地图对应的字段。
# 输入:当前观测 obs,目标 goal,本决策的剩余时间预算 budget_ms# 状态:世界模型 f(潜空间或像素空间)、规划器 planner、执行缓冲 exec_buf
def decide(obs, goal, budget_ms): t0 = now() s = world.encode(obs) # 一次编码,结果可跨步复用 plan = None
# 第 1 层:短视界 + 宽搜索,优先满足实时性 plan = planner.search( f, s, goal, horizon=H_short, # 例如 5 步 candidates=E_wide, # 例如 512 条 rounds=1)
# 第 2 层:若仍有剩余预算,加深视界而不是加宽候选 # 复合误差随 H 指数增长,因此每加深一步都要重新校验可信度 while remaining(t0, budget_ms) > next_step_cost(H_long): deeper = planner.refine(plan, horizon=+1, candidates=E_narrow) if uncertainty(f, deeper) > TAU: # 进入不可信区域就停 break plan = deeper
exec_buf.enqueue(plan.action_chunk) # 只执行第一个动作块 return now() - t0 # 实测决策耗时,写进下一轮预算估计这段代码里有三个与预算地图直接对应的设计点。
其一,先短后长、先宽后窄:第 1 层用短视界换低延迟,第 2 层用剩余预算加深视界而不是继续加宽候选。理由是复合误差随 指数增长(见前文),加深一步的风险远大于加宽一条候选,因此值得在加宽之后才加深,并且要用不确定性检查随时刹车。
其二,不确定性阈值 是对复合误差的在线刹车:一旦 refine 出的轨迹进入了模型不可信的潜区域(集成方差或表征距离超阈值),就立即停止加深。这就是第十一篇里 MBPO 与 PILCO 用不确定性限制 rollout 长度的思路在系统中的对应物——不是在训练时固定一个 ,而是在推理时动态决定 。
其三,最后只执行第一个动作块:无论想了多少步,闭环只消费最近的一段动作 chunk,剩下的计划在下一轮决策时被丢弃或作为热启动。这是 MPC 式重规划的落脚点,也是第七篇「异步执行」一节强调的「执行器连续消费,推理与执行并行」的结构。
一个可算的例子:四项成本摊到具体数字
假设有一个 7 自由度桌面机械臂,任务是把三种物体放到指定槽位。下面是一张简化的「预算分配表」,用来演示如何在四个杠杆之间做选择。数字都是示例,但数量级取自前面各篇讨论的典型设置。
场景 A:只有 200 条真机轨迹
| 选择 | 预训练 | 参数 | 想象 | 规划 | 估计结果 |
|---|---|---|---|---|---|
| 无世界模型,行为克隆 | 0 | 100M | 0 | 0 | 成功率低,任务稍有变化就失败 |
| Dreamer + RSSM | 本任务数据自监督 | 千万级以下 | 每条想象轨迹 15–50 步,批量并行 | 无 | 成功率高但训练/想象时间长 |
| Cosmos/视频先验 + 微调 | 大量视频先验 | 十亿级 | 每步 10–20 步去噪 | 无 | 跨具身初始成功率高,但真机微调仍必要 |
| V-JEPA 2 + CEM | 视频表征先验 | 编码器约 10 亿参数(ViT-g) | 表征预测每步很便宜 | 每个决策采样一批候选 × 数个 CEM 迭代 | 在线规划强,闭环延迟成为新约束 |
这张表最想说明的是:200 条轨迹不是「买大模型」能完全弥补的。在四条技术选择里,真正把「200 条」推到高成功率的,是让这些数据以最有效的方式产生「如果」——这正是想象与规划承担的角色。视频先验帮的是初始成功率和样本效率,不是替代真机。
场景 B:每天只有 1 小时可用真机,且必须实时响应 10 Hz
这时 的约束变成硬约束:10 Hz 意味着每次决策 100 ms 闭环预算(第七篇的延迟预算)。在这个预算下:
- 扩散世界模型的一次去噪即使 10 步、单步 20 ms,也会烧掉 200 ms,直接超预算 → 要么蒸到 1–3 步,要么把规划搬到「云端做长视界 + 本体做短执行」的两段式;
- 潜空间规划器可以每秒上千次前向,但搜索候选数要给闭环留余量;
- 最现实的组合往往是分层:本体上跑一个便宜的动作 chunk 策略(百毫秒级),云端/基站每隔几秒刷新一次长视界规划,二者通过动作分块衔接。这就是第十四篇的两个时钟。
四个杠杆的「可调度性」各不相同
把上面的例子抽象出来,四项杠杆在工程上的调节难度是完全不同的:
- 先验数据不是在线变量。一旦模型训好,想改变先验只能重新预训练或做微调,代价是「周」到「月」级别。它决定「起点」,不参与每次决策。
- 参数规模是一次性变量。它决定模型能不能装到本体上、显存够不够,影响每次决策的基线单价 ,但不随任务变。
- 想象步数是每次决策可调的。多走几步想象、少走几步想象,在推理时可以按预算动态裁剪——这是第九篇「少步生成与蒸馏」和「调度」讨论的核心。
- 规划算力也是每次决策可调的。候选数、树搜索深度、CEM 迭代次数,全都可以在运行时按可用算力决定——这是第八篇「推理账本」的落脚点。
因此,真正的在线预算调度只发生在第 3 和第 4 项上。前两项是设计时的决策。工程上常见的误区是把「在线调控」当成可以改模型结构——实际上运行时能动的只有想象和规划。
为什么 2026 年的「混合」正在成为主路
预算地图给出一个观察:2024–2025 年世界模型的各种路线主要沿着四条射线方向各自走到底;而 2026 年的工作大量在射线之间横跳,把一条路线的强项接到另一条路线的短板上。
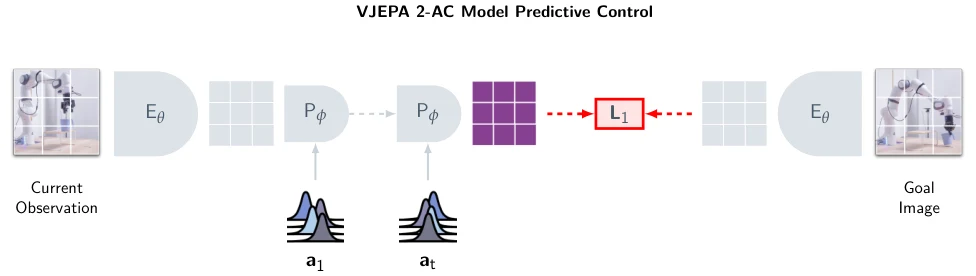
上图是「视频先验 + 潜空间规划」这一组合在 2026 年的代表形态(V-JEPA 2,Meta,arXiv:2506.09985 图 7):规划器不生成像素,只在表征空间里最小化「想象 步后的表征」与目标表征的距离,动作用交叉熵方法(CEM)优化。这正是把先验数据这一格押得很重、又用表征空间把 压低的典型。
典型的四个组合:
- 视频先验 + 潜空间规划:用视频模型做预训练提供 ,但规划发生在压缩表征上, 大幅下降。V-JEPA 2 的「表征先验 + 规划模块」就是这种组合的代表:编码器在两千多万段视频上学表征,规划时却完全不生成像素,只在表征空间里对动作做 CEM。
- 联合生成 + 分层执行:WAM 负责生成粗粒度、动作与帧联合的世界片段;分层模型把长视界的搜索/想象切到「意图」层,本体上只执行短 chunk。把 和 这两项同时压。
- 几何/物体中心表示 + 表征预测:用几何或槽位把 里的 撑大,再在表征空间上做预测,把 压到最低。
- 多模型并行 + 门控路由:部署一组小模型分担不同任务,由门控在线选择——这与第九篇「批处理与调度」一节讨论的世界模型服务特例是同一个方向。
混合路线的共同点是把成本从贵的格子挪到便宜、可动态调度的格子里:先验数据贵但一次性;参数贵但可裁;想象和规划便宜且可以实时调整。
本体侧:预算地图碰到硬上限之后
第十篇从信息论与 CMOS 能耗下界给出的结论是:机器人本体上的规划有一条单线程计算链的上限,并行空间很小;在 T4 级别功耗预算内,能做到的世界模型推理吞吐有限。
把那个上限放回预算地图里,它施加的是对 的一个地板:
这条不等式意味着:本体上可用的想象步数上限,几乎完全由每一步承载多少比特决定,而不是由模型有多大决定。它也是为什么几何/占用/槽位这类「低维、结构化」表示在边缘场景反而有优势——不是它们更准,而是它们能在同样的能量下跑更多步。
因此,「分放到云端 vs 留在本体」不是架构偏好,而是预算地图在两个物理区域上的不同汇率:
- 本体侧:低参数、低比特/步、多步想象;
- 云端/基站:高参数、高比特/步、长视界规划 + 重规划。
两层之间用动作分块、用轻量状态同步衔接——这是第七篇「异步执行 + 状态缓存」两节的技术落点。
把想象单位成本拆开:一次想象到底花在哪
预算地图里被引用最多的符号是 ,但它在不同路线里的物理含义差别极大。把它拆成两项,就能看清每条路线到底在省什么。
一次想象步的时间,在 GPU 上近似由两个下界中的较大者决定:
其中 是参与这一步前向的有效参数数(MoE 架构下只算被激活的专家), 是这一步要处理的 token 数, 是实际可达的浮点吞吐, 是这一步必须从显存读入的字节数(权重 + KV 缓存 + 激活), 是显存带宽。第一项是算力下界,第二项是访存下界——这正是第九篇把推理成本拆成「算、读、等」三层时用的框架。
拿一个具体配置算一遍:一个 10 亿参数的视频世界模型骨干,每步处理 8192 个 token,那么在 A100 级别 300 TFLOPS 的有效吞吐下,第一项约为
而第二项在最坏情况下(每一步都要重读全部权重)是 量级,所以这一步是compute-bound。这解释了为什么视频生成世界模型通常不靠「多批并发」压成本——它的瓶颈在算力,串行去噪的每一步都吃满 SM。
同一个模型如果换成自回归生成、上下文扩展到 10 万 token,第二项里的 KV 缓存读取就变成主导:以 32 层、8 个 KV 头、头维 128、fp16 计,每 token 的 KV 是 ,10 万 token 就是约 12.8 GB,每生成一个 token 都要全量读一遍。这时它变成 memory-bound,优化手段也从「多算」转向「少读」——分页、量化、稀疏注意力,全部作用在第二项上。
这个拆分直接对应预算地图上的四格:
- 参数规模作用于第一项(分子里的 );
- 想象步数是在 前面乘一个整数,无论瓶颈在算还是在读,步数都是最直接的乘数;
- 规划算力是 再乘一个候选数 (CEM 每一轮要评估 条序列);
- 而先验数据不进 ,它进的是 与误差项。
所以「世界模型贵」这句话必须被追问一句:贵在多算、贵在多读、贵在多想,还是贵在多搜。四者的优化手段完全不同,混为一谈就会选错技术路线。
什么时候不该上世界模型
预算地图还有一个反向用途:判断某个场景根本不需要世界模型。把前面那笔总账移项,世界模型划算的条件是
左侧是因为有了模型而省下来的真实交互成本,右侧是模型本身的训练/部署开销加想象开销。这个不等式有两个容易被忽略的含义。
第一, 越低,世界模型越不划算。如果目标环境已经有高保真物理仿真器(刚体动力学、流体、电路仿真),那么「真实交互」的单价本来就极低,此时再训一个神经网络世界模型,相当于用一个更贵、更不准的模型去替代一个已经便宜且准确的模型。正确做法是直接用仿真器,把世界模型留给「仿真器建不准」的部分——接触摩擦、柔性物体、真实相机的成像噪声。这是几何式世界模型(第十二篇)与物理仿真器分工的边界。
第二, 是一次性成本,只有在足够多的任务上摊销才划算。一个预训练世界模型如果只服务一个任务、几十条轨迹,那么它的摊销额会远大于直接用行为克隆。跨任务、跨具身复用(第五篇的跨具身迁移)之所以重要,不是因为它更「通用」,而是因为它是把 摊薄到多个任务上的唯一手段。
这两条合起来给出一条实用的判断顺序:先问有没有便宜且准确的仿真器;再问任务数量够不够摊销模型成本;最后才问想象步数与规划算力该怎么配。多数失败的「上世界模型」项目,是在第一步就该停下的地方继续往下走了。
该怎么用这张地图读新论文
给读者一个可操作的四步问题清单:拿到一篇新的世界模型工作,先不急着看结果表格,按下面四步把它钉到预算地图上。
- 它把成本押在哪一格? 先看预训练数据规模与模型规模——这是押在「先验 + 参数」。再看 rollout 长度和规划开销——这是押在「想象 + 规划」。四个格子的权重一看训练预算和推理延迟预算就清楚。
- 它用什么替什么? 如果它用搜索替策略学习,就去找它的搜索预算与闭环延迟;如果它用想象替在线交互,就去找它宣称的样本效率提升是在什么基线之上比较的;如果它用视频先验替真机数据,就去找跨具身评估。
- 它的误差在哪里放大? 对任何依赖长视界想象的路线,先问复合误差被怎么处理——用的是短视界重规划、分层、不确定性刹车、还是 rollout 分支(MBPO 的做法),这直接决定它在真实系统里能否稳定。
- 它的在线可调度性有多强? 有没有给出「想象步数/规划深度可以在运行时按预算剪裁」的能力。如果一篇工作把「预算可调」写成了核心贡献,它往往就是在预算地图上做了在线维度的工作,而不是一次性设计维度。
这套清单能帮读者分辨:一项工作是在发明一个新的杠杆(少见,一般是新的表示或训练目标),还是在同一张地图上换一个位置(常见)。绝大多数「2026 年新世界模型」属于后者。
与系列前文的接口
这张预算地图不是凭空长出来的,它承接了前十四篇的关键结论:
- 形式化与三条路线(第一篇)给出 的语义;
- Dreamer(第二篇)给出「想象步数」这一格最经典的用法;
- JEPA(第三篇)给出「 压到表征级」这条优化;
- 视频生成(第四篇)给出「先验 + 参数量」这一格的极端形态;
- WAM(第五篇)给出「联合生成把乘法摊薄」这一技巧;
- 评测(第六篇)给出 的输出定义;
- 部署(第七篇)给出闭环里 的现实约束;
- 规划(第八篇)给出「规划算力」这一格的完整成本拆解;
- 推理系统(第九篇)给出 的三层构成与优化空间;
- 边缘硬件(第十篇)给出 的物理地板;
- Dyna/PILCO(第十一篇)给出复合误差这一「汇率」的推导;
- 几何(第十二篇)、槽位(第十三篇)、分层(第十四篇)三条路线,给出往潜空间回填信息、把长视界切短的具体手段。
如果说前面十四篇是分门别类地拆解了十四个房间,这篇就是把整栋房子拍成一张平面图:哪个房间最贵、哪个房间决定走向、哪些房间的门开向哪里。
小结
世界模型是一笔交易:用它自身的成本,换掉一部分真实交互的成本。这笔交易的账目可以被拆成四类成本——先验数据、参数规模、想象步数、规划算力——以及它们与真实环境交互之间的可交换关系。
理解这张地图的意义在于:对任何一篇世界模型工作,读者不再被「世界模型」这个词本身困住,而能准确地判断:
- 它把成本押在哪一格,用哪一格替哪一格;
- 它对复合误差有没有真实处理,用的是短视界、分层、不确定性还是分支;
- 它在线可调的部分是哪一项(通常是想象与规划),一次性设计的部分是哪一项(通常是先验与模型规模);
- 它适合放在本体上还是云端/基站,以及为什么。
前面十四篇和这篇合起来,构成一个从概念到机制、到账本、到预算地图的完整框架。下一阶段的世界模型工作仍会在这张地图上继续移动——新的表示会试图把 的有效信息量撑大,新的系统设计会试图把在线可调度的那两格再压一压。地图本身不会因为具体论文变化而失效,这正是它值得单独作为一篇的价值。
参考资料
- World Models(Ha & Schmidhuber,NeurIPS 2018,arXiv:1803.10122)
- Mastering Atari with Discrete World Models(DreamerV2,arXiv:2010.02193)
- Mastering Diverse Domains through World Models(DreamerV3,arXiv:2301.04104)
- V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning(arXiv:2506.09985)
- DreamZero: World Action Models are Zero-shot Policies
- Cosmos World Foundation Model Platform for Physical AI(arXiv:2501.03575)
- DreamerV3 项目主页(世界模型与想象训练的官方说明)
- When to Trust Your Model: Model-Based Policy Optimization(MBPO,NeurIPS 2019,arXiv:1906.08253)
- TD-MPC2: Scalable, Robust World Models for Continuous Control(arXiv:2310.16828)
- Model-based Reinforcement Learning: A Survey(Dyna、PILCO 与 MBPO 谱系,arXiv:2006.16712)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



