


世界模型从零讲起(五):WAM——动作不再是输入,而是和世界一起被生成
承接前四篇:预测的世界,谁来输出动作
系列的前四篇把「世界模型」一点点建了起来。第一篇给出了形式化定义:世界模型从观测推断状态,再预测状态如何随动作变化,按建模空间分成重建、生成、联合嵌入三条路线。第二篇跟着 Dreamer 走进了 RSSM 的潜空间,第三篇换成 JEPA,把预测搬到表征空间里,第四篇又回到像素,讲清了 Sora、GAIA、Cosmos 与 Genie 这类视频生成式世界模型的架构与成本。
这四篇有一个共同的前提:动作是输入。无论是 Dreamer 的隐空间动力学 ,还是 V-JEPA 2-AC 的动作条件预测,模型回答的都是「如果我这样做,世界会变成什么样」。要真正驱动一个机器人,还得在测试时外挂一个东西——逆动力学模型(从想要的结果反推动作),或者 MPPI、MPC、CEM 这类在动作空间里做搜索的规划器。测试时的搜索开销,一直是这条路线绕不开的一笔账。
WAM(World Action Model,世界动作模型)把方向反过来:动作和未来画面同为输出。模型不被告诉动作,而是自己「想象」未来的画面以及执行这个画面所需的一串动作。本文是系列第五篇,主题就是这一个转折:它到底改变了什么、具体怎么实现、以及它对推理系统意味着什么。
站内的 动作条件世界模型完全拆解已经用 DreamZero 这一个模型把 WAM 的总览、架构与实时性展开讲了一遍。上一篇的标题与系列路线图把第五篇留给了「可交互世界模型与 WAM」,而 DreamZero 那篇拆解的只是这一路线的单个代表。本文在它的基础上,把 2026 年下半年这一波工作整体串起来,回答三个更难的问题:联合生成的动作为什么精度不够,后来的工作怎么补救?世界模型的每一小步都要全量去噪,成本怎么摊薄?哪些帧值得想象、哪些不值得,这个决策能不能学出来? 这三条线索正好对应 WAM 在 2026 年年底的三条改进主线。
WAM 的准确定义:与 ACWM、VLA、LAM 划清界线
先把几个容易混的概念放在一张表里,后面所有讨论都以此为基准。
设 为时刻 的观测(通常是一帧或多路相机图像), 为动作, 为语言指令, 为预测视野。四类模型的区别在于「输入是什么、输出是什么」。
| 模型类别 | 形式化 | 动作的角色 | 推理时是否需要搜索 |
|---|---|---|---|
| VLA(如 、RT-2) | 纯输出,不预测世界 | 否 | |
| ACWM(动作条件世界模型) | 输入条件 | 是(MPC/MPPI 或逆动力学) | |
| WAM(世界动作模型) | 联合同为输出 | 否(规划编译进生成) | |
| LAM(潜动作模型) | 先学离散潜动作 ,再映射到 | 借助离散码间接输出 | 否 |
这张表要读出三层含义。
第一层,WAM 与 VLA 的差别在「有没有世界」。 VLA 直接从观测到动作,学的是「这种场景下常见的动作是什么」。它在语义泛化上很强——换一批没见过的物体、没见过的指令,依然能理解;但在物理运动上很脆弱——新环境里没见过的一种抓取姿态,它就是做不出来。WAM 多了一条约束:动作必须能解释它同时预测出来的未来画面。模型为了把画面预测对,必须内化「杯子怎么翻、布料怎么折、流体怎么流」这些规律,而这些规律同时是动作生成的最好监督。这是「为什么联合预测能把语义泛化变成物理泛化」的根本逻辑。
第二层,WAM 与 ACWM 的差别在「测试时要不要搜索」。 ACWM 有一个好处:它可以被任意外挂的规划器使用,MPPI 采样几百条动作轨迹、每条都用世界模型推演一遍打分,选出最好的那条执行。这个流程理论上能收敛到很好的解,代价是每个控制周期要做几百次前向。WAM 把这件事「编译」进了一次生成:动作本身就是生成结果之一,不需要在动作空间里找。WA-JEPA(2026-11-14)把这层意思说得最直白:代表性规划方法依赖候选动作搜索,需要对每条动作序列反复评估,在线计算成本很高;它要做的就是让预测出来的未来直接参与动作生成,而不经过搜索。后文会看它具体怎么做。
第三层,WAM 与 LAM 的差别在「要不要预测像素」。 LAM 用 VQ-VAE 的思路从相邻两帧之间学出离散潜动作(LAPA,2024-10),好处是只要有视频就能训,不需要动作标签;坏处是潜动作的语义由视频重建决定,往往会聚成「视觉外观相近」而不是「底层动作相近」的簇——两只手在做类似的事情但画面不同,学出来的潜动作就对不齐。SALA(2026-11-12)正是为了解决这个问题,借语言描述给人类视频与机器人视频之间建立语义对应。WAM 则会显式预测未来,代价大,但对物理规律的约束更强。
理解了这条谱系,就能看清 WAM 的核心矛盾:它用一个很贵的生成过程换来了一个很自由的泛化能力,所以工程上的每一分改进都围绕着「把这个生成过程变便宜,同时不丢掉它的物理约束」。
联合生成为什么学得动:一个概率论层面的解释
在讨论具体的工程补救之前,先说清楚联合预测这件事在统计上为什么有用。这部分不是论文里的现成推导,而是把几篇工作的动机放回同一个框架里看。
设数据集里的一对为 ,它们背后有一组潜在的物理状态 。VLA 学的条件分布是 ,WAM 学的是联合分布 ,其中 是未来的观测。按贝叶斯公式:
VLA 直接用参数 拟合左边,WAM 用参数 拟合右边的两个因子。二者在训练集上都能拟合得很好,但泛化行为不同。
VLA 的失败模式是「分布偏移下的动作退化」。 当 落在训练分布外——新环境、新光照、新物体摆放—— 没有数据支撑,就只能退回训练集里相似情景的「平均动作」。这种平均动作常常是「看起来对但物理上错」的:往杯子的大致位置伸手,但抓的不是杯柄。
WAM 的失败模式则多了一层修正机会。 联合预测让动作和画面互为约束——如果模型生成了一条「抓杯柄」的动作,它同时会生成一张「手碰到杯柄」的未来画面。如果这张画面与真实世界的物理规律不符(比如杯子穿过了手指),损失函数会同时惩罚动作和画面。这意味着动作的错误率不是只由动作分布决定,而是由「动作 × 画面」的联合一致性决定。更准确地说,WAM 学到的 对 的条件化,让动作可以从多个「可能的未来」里采样,而 VLA 的 是被训练数据里每个观测的平均动作锚定的。
DreamZero(2026-02)用一个更工程化的表述讲了同一件事:WAM 从异构机器人数据里学到多样化的技能,不依赖于重复示范。VLA 的泛化依赖于「把每种情况都示范一遍」,这是数据层面的代价;WAM 的泛化依赖于「学会一种世界如何变化」,这是模型层面的收益。联合预测的核心收益就是这两件事之间的置换。
不过,这个置换不是免费的。联合分布的拟合比单边条件分布难得多: 的维度是双边之和,而大模型对「未来画面的每一个像素」非常敏感,容易把大部分容量花在静态背景上。这是后文 ResWAM、DiffWAM 要解决的具体问题——不是概念层面的「联合预测不够好」,而是工程层面的「联合预测到底把容量花到了哪」。
架构的基本骨架:DiT 主干与 MoT 专家结构
在拆 2026 年的改进工作之前,先给一个基本骨架,因为几乎所有 WAM 都在这个骨架附近做局部改动。DreamZero 论文的总览把「联合预测 → 物理先验 → 四项能力」这条因果链画得很直白:从多样而非重复的数据中学习、开放世界泛化、只用视频数据做跨具身学习、少量数据适配新机器人。这四项能力在传统 VLA 框架下彼此矛盾,在 WAM 框架下却是同一件事的四个侧面。但那是一张能力图,不是结构图,要看清 WAM 的工程实现,还得把内部部件拆开。
按 2026 年下半年多篇论文的实际实现(ResWAM、DiffWAM、LaST0.5、MetaWAM 等),WAM 的内部结构大体可归结为以下四层:
- 视觉 tokenizer:把每一帧视频压进潜空间。NVIDIA Cosmos 用一个 tokenizer 把视频压成时空潜变量;部分 WAM 用 DINOv3 这类冻结的视觉编码器,不重建像素只抽取特征。
- 主干(backbone):一个基于 DiT 结构的 Transformer 或 MoT(Mixture-of-Transformers,混合 Transformer 专家)结构,把视频潜变量和动作 token 联合处理。视频部分走扩散或流匹配,动作部分常常也走流匹配,两路共享主干的一部分参数。
- 两个或更多解码头:视频头把潜变量解码成像素,动作头把潜变量解码成动作块(action chunk,通常 到 步)。
- 条件通路:语言指令、机器人状态(本体感知)、有时还有任务进度值,通过拼接或交叉注意力的方式进入主干。
ResWAM 的参数划分是理解这个骨架的一个具体样本:它总共 2.3B 参数,其中 0.5B 是一个双分支 DiT——一个动作分支、一个残差分支,通过条件流匹配联合训练。视频主干是冻结的 DINOv3。这种「冻大主干、只在特征空间做联合学习」的变体是最近的一大趋势,后文会详细讲。
动作 token 的设计值得多讲一句,因为它决定了「世界」和「动作」在主干里如何相遇。常见做法是把每一步的动作看作一个 token:, 通常是 7 到 10(末端的 6 维位姿增量加 1 维夹爪开合)。这个 token 先经过线性投影投影到主干维度,再和一个时空位置编码相加,插入到视频 token 序列的末尾。生成时,视频 token 与动作 token 在同一轮去噪里被一起预测。另一种做法是 MoT:视频专家和动作专家是两套独立的 Transformer 参数,它们只在特定层通过交叉注意力交换信息。LaST0.5 就采用了 MoT 结构,并且在视频专家与动作专家之间插入了一个「交互专家」,专门表示机器人-物体局部的交互表征。
两种做法在效率上的区别不小。共享主干(一个 Transformer)更简单,但视频 token 数量很大(一帧 720p 的潜变量就有数万 token),动作 token 只有几十个,这种比例下动作 token 的表征很容易被淹没。MoT 让动作专家在小得多的独立 Transformer 里运行,视频专家只在少量层上向它提供条件信息,这一设计天然地让动作分支的推理更轻快——这是很多实时 WAM 能跑到 7Hz 以上的关键。
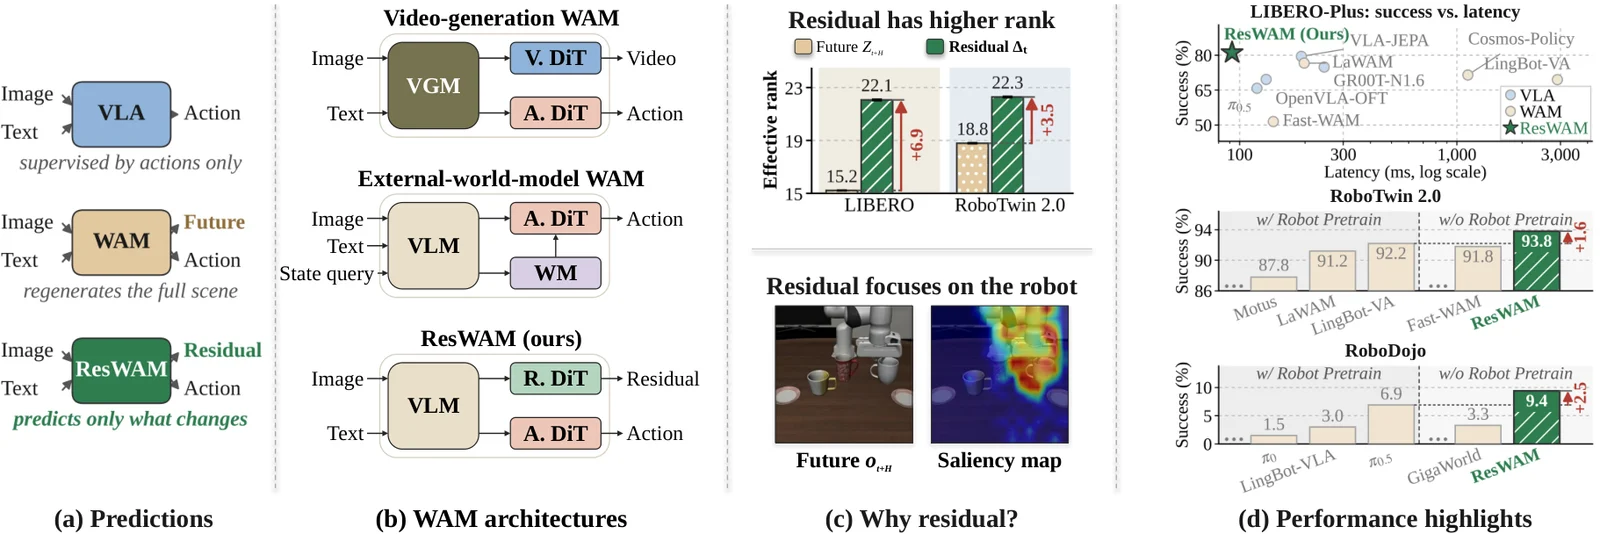
ResWAM 论文 Figure 1 把 2026 年常见的四类架构并排画了出来。第 (b) 栏从上到下依次是:直接用视频生成做策略的 WAM;外挂一个独立世界模型的 WAM;只由动作监督、不预测未来的 VLA;以及 ResWAM 自己的「动作监督 + 残差预测」结构。第 (a) 栏对比了「重建完整未来」与「只预测变化」两种监督目标下的预测画面,第 (c) 栏把残差的关注区域画在机器人臂与被操作物体上,第 (d) 栏是成功率与延迟的散点。这张图值得先记住,因为后文的三条改进线,本质上都是在第 (b) 栏这几种架构之间做取舍。
从「联合生成」到「联合有用」:2026 年的三条改进线
2026 年下半年 WAM 相关论文密集出现,粗略分类,基本都落在三条改进线上。下面三节各自深入。
线一:动作精度——联合生成的动作为什么不够准,以及怎么补救
联合生成的第一波问题出现在精度上。 的双边结构带来三个具体的精度问题。
问题一:动作块存在「自回归漂移」。 WorldVLA(2025-06)最早观察到了这个现象:当模型按自回归的方式逐步生成动作序列时,前面的动作若有偏差,误差会传播到后面,导致性能下降。它给出的方案是注意力掩码——在生成当前动作时,选择性地屏蔽之前动作的注意力,从而让每个动作只依赖观测而不是依赖前序动作。这个修改听起来很小,但它反映了 WAM 里一个基本的设计张力:动作序列在训练时是「一条连贯的轨迹」,在推理时却是「每步独立从观测出发」的重规划。用训练时的连贯性去推理时做重规划,误差必然被放大。
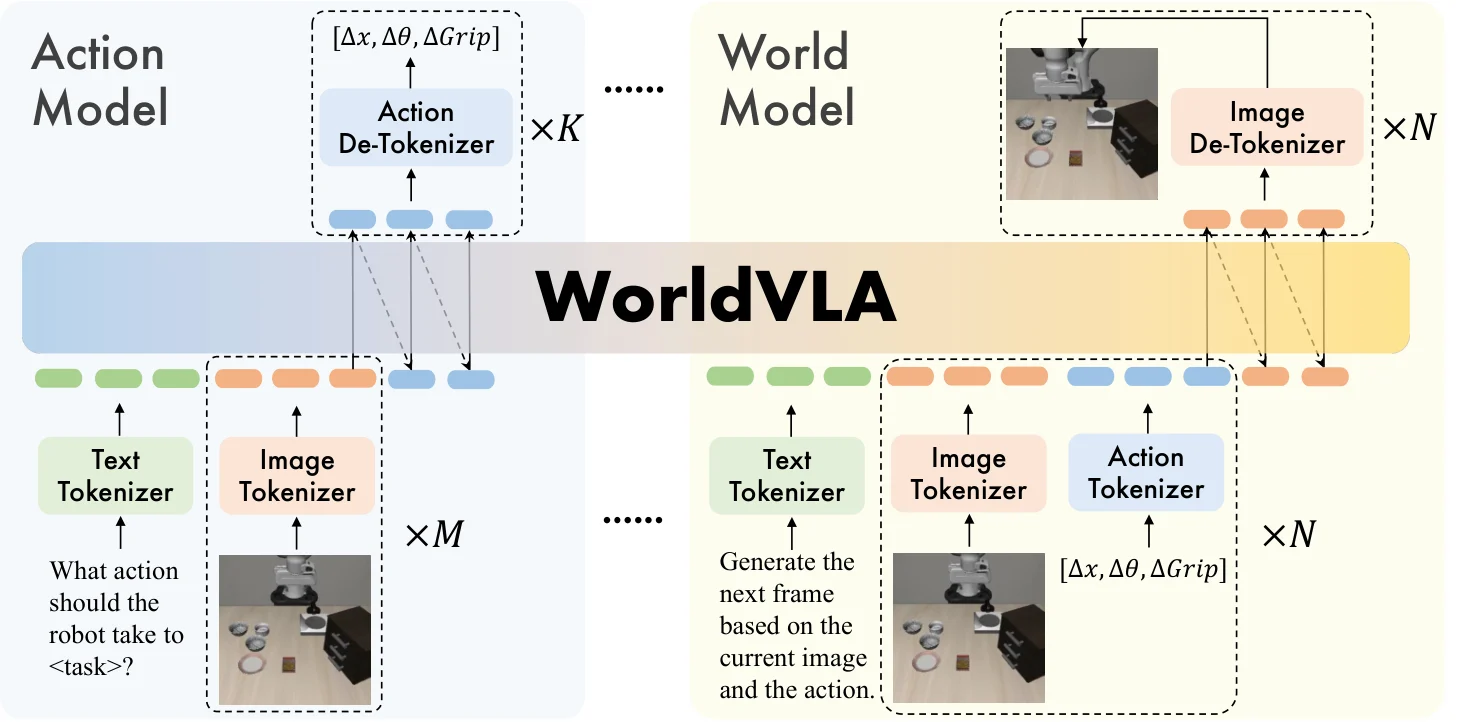
WorldVLA 论文的架构图把「动作模型」与「世界模型」画进了同一个自回归框架:图像 tokenizer 把当前帧离散成图像 token,动作 tokenizer 把动作切成离散动作 token,文本、图像、动作三类 token 拼成一条序列交给同一个主干;序列中的图像 token 由图像 de-tokenizer 解码成下一帧预测,动作 token 由动作 de-tokenizer 解码成下一步动作。图中右侧的分工写得很清楚:世界模型回答「给定当前图像和动作,下一帧应该是什么样」,动作模型回答「给定当前图像和任务,机器人应该执行什么动作」。两者共用一套主干和 tokenizer,这是 2025 年「统一 token 序列」路线最直接的形态,也解释了为什么它的误差会在动作序列内部传播。
问题二:动作生成对未来预测不够敏感。 ThinkWAM(2026-11-16)提出了一种两趟式的补救。它先让策略给出一个完整的动作块(提案),然后用这次提案去修正多个时间视野的未来潜变量,修正后的潜变量再注入同一个动作头的第二趟,生成最终可执行的动作块。这形成了一个「提议—重省—修正」的循环,所有预测都在潜空间里做。这个设计的动机很明确:如果未来预测不以动作块为条件,它就无法反映这个动作块会让视觉表征发生什么变化,也就无法用来修正动作。把条件化关系反过来,预测就从「旁观者」变成了「审阅者」。
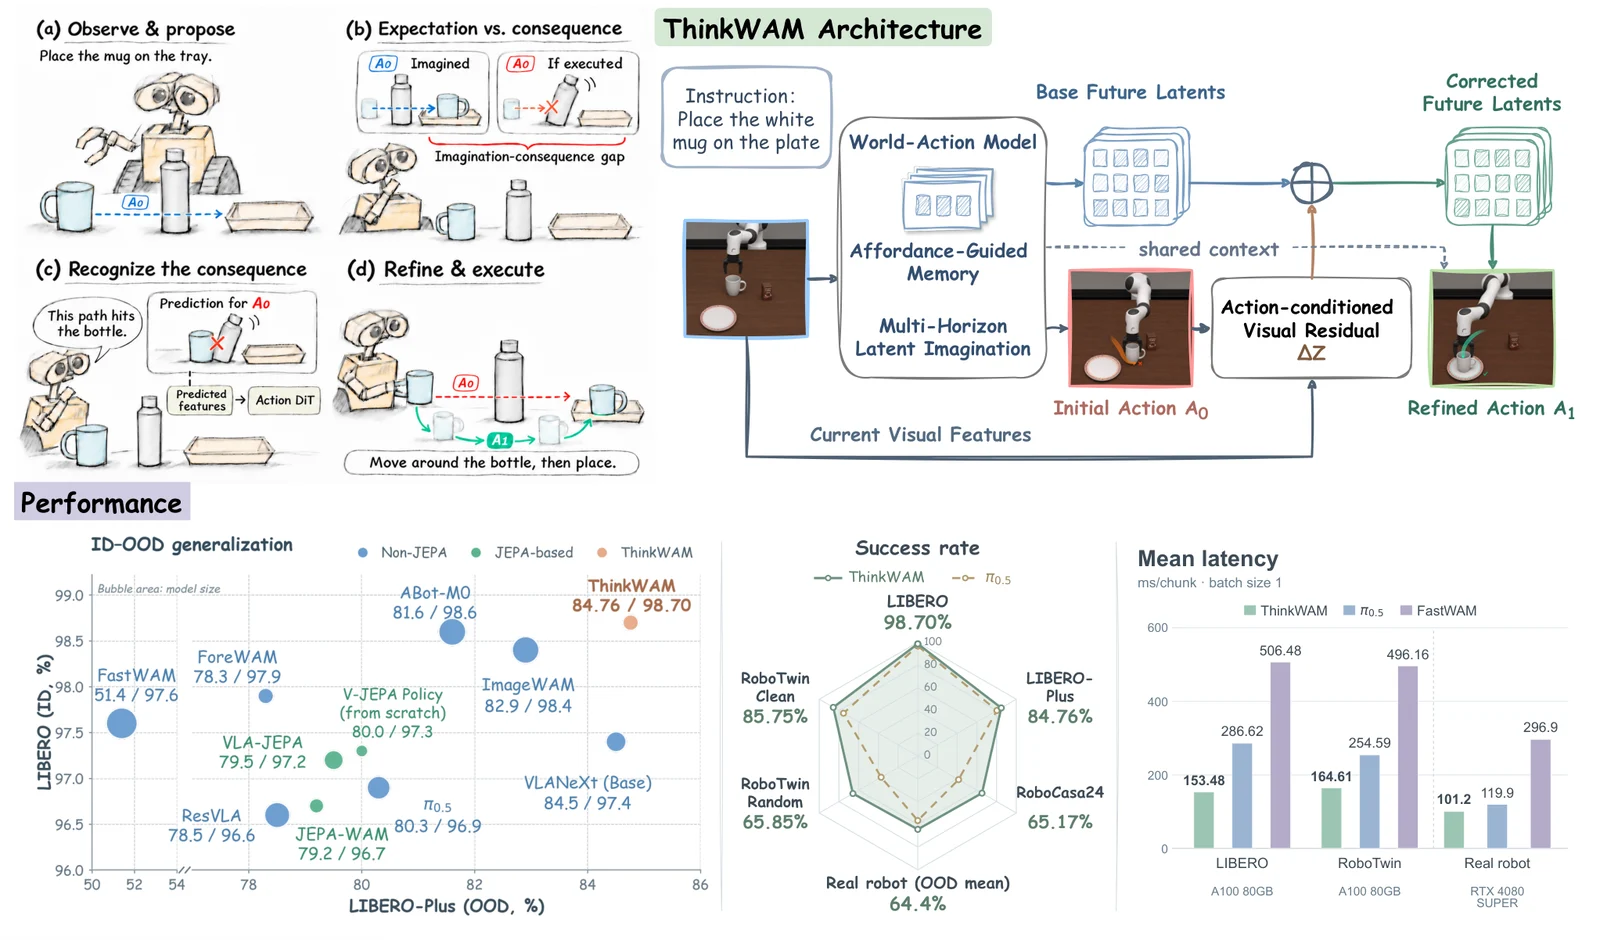
ThinkWAM 论文 Figure 1 把这个「两趟式」流程拆成四步画了出来:(a) 观察并提出初始动作块;(b) 对比「想象出来的未来」与「如果执行这条动作真正导致的未来」,两者之间存在一个「想象-后果差距」;(c) 借助可供性(affordance)引导的记忆识别这个差距意味着什么;(d) 用多时间视野的视觉残差修正动作,执行精炼后的块。右下角的性能部分用气泡大小表示模型规模、横轴是 LIBERO-Plus 上的分布外成功率、气泡位置越高延迟越低,它想说明的正是本文要讨论的核心矛盾:修正动作能换来更好的成功率,但它需要第二趟推理,延迟会涨。论文报告的两趟推理平均每个动作块 101.2 到 164.6 毫秒,正是在这个权衡上给出的具体位置。
问题三:未来画面的监督被背景吞掉。 这是 ResWAM(2026-11-14)与 DiffWAM(2026-11-15)共同针对的问题。一个动作块内,画面变化通常很小,静态背景占了绝大部分。如果直接监督完整的未来观测,损失函数会被「复制背景」这个平凡解主导,而不是去学「机器人和物体如何移动」。ResWAM 的解法是把监督目标换成「当前帧到未来帧的特征残差」——只监督变化,不监督完整未来,并且在冻结的 DINOv3 特征空间里做。DiffWAM 的解法是把「连续视觉差异」定义成相邻观测的潜表征的差,并用一个 MoE 结构里的 Diff 专家专门预测它,同时用单向注意力掩码让 Diff 专家、World 专家、Action 专家只以当前帧为条件、彼此之间不交换注意力——这样推理时把 Diff 专家和 World 专家整个去掉,不增加任何推理开销。
把这三条问题放在一起,能看出 2026 年 WAM 的第一个思路转向:从「大而全地生成未来」转向「只生成对动作有用的那部分未来」。这一点在下面「线三」里会被推到极致。
线二:推理成本——慢世界、快动作,以及更少步数
WAM 的推理成本结构可以用一张「每步成本 × 重规划频率」的二维表来描述。一个行动块的推理包含三部分:视觉编码(把当前帧压进潜空间)、世界去噪(视频潜变量的 次去噪,通常 在 4 到 10)、动作生成(动作潜变量的 次去噪,通常 可以远小于 )。每做一次重规划,这三部分都要跑一遍。部署时的吞吐量等于「1 / 一次重规划的耗时」,乘上并行批次。
这就引出一个核心问题:世界分支的那 次去噪,多少次是必要的? 2026 年的工作在这个方向上分成了两条:
第一条:让动作分支完全绕开世界分支。 UVA(Unified Video Action model,2025-02)是这条线的早期代表。它学一个联合的视频-动作潜表征,但把解码解耦成两个轻量扩散头:视频头、动作头。推理时可以只跑动作头,完全跳过视频生成。它还用掩码训练让同一个模型具备多种能力:已知观测与动作、要求预测未来观测时,它就是前向动力学模型 ;已知两帧观测、要求推断中间动作时,它就是逆动力学模型 ;两者都不遮就是完整策略。论文还对掩码比例做了消融:在「应用无关」的设置里,视频生成与前向动力学在 25% 掩码比例下最好,而策略与逆动力学在 50% 时最好。这种「联合训练、解耦推理」的范式几乎被所有后来的工作继承。
第二条:保留世界分支但不追求完整。 DreamZero(2026-02)的系统优化是这条线里最早跑通的:通过模型与系统层面的一系列优化,一个 14B 参数的自回归视频扩散模型被压到了 7Hz 的实时闭环控制。它并没有把视频分支整个砍掉,而是从三个层次同时压成本。系统层把「推理完成机器人才动」改成异步闭环——执行器连续消费最近一个动作块,推理与执行并行,约束变成「推理必须赶在当前块过期前完成」;同一层还用 CFG 并行把条件与无条件的两次前向拆到两张卡上,并用速度场方向一致性做 DiT 步间缓存,把有效去噪步数从 16 降到 4。模型层则改了训练目标:DreamZero-Flash 把视频与动作的噪声时间步解耦,让视频偏置到高噪声端、动作保持均匀采样,迫使模型学会「视觉上下文还有噪声时也能给出干净动作」,从而允许动作只走一步去噪。三层叠加把单个动作块的生成从约 5.7 秒压到约 150 毫秒。这条线的完整拆解见 动作条件世界模型完全拆解,这里只记住它的结构含义:保留世界分支时,省成本的抓手是「异步 + 步数 + 训练目标」,而不是简单地少算几层。
2026 年 11 月出现了一条更尖锐的意见:与其做缓存复用,不如直接减少步数。 《Cache or Denoise Less? Residual Reuse in a Flow-Matching World Action Model》(2026-11-15)在 Fast-WAM 这个 6B 参数的 WAM 上做了系统对比:
- 在 LIBERO-Goal 上,两步不做任何缓存的推理,成功率与非劣于十步(在 500 个初始状态上,差距在两个百分点以内,针对一个 checkpoint 和噪声种子)。
- 在 PyTorch 默认编译模式下,两次重规划调用在 RTX A6000 上的耗时从 202 ms 降到 92 ms。
- 跨周期缓存(如 Cache)复用前一次重规划的计算,在这种前提下几乎不留改善空间——一个保留两步新鲜步的缓存,不可能比直接跑两步更快,因为每次调用仍然要编码图像、跑视频专家、算这两步。
- 缓存还脆弱:损失跟缓存步覆盖的 flow 路径比例相关。在 Fast-WAM 当前的时间偏移下,Cache 的八个缓存步覆盖了 80% 的路径(而非 44%),对应策略成功率从 95% 跌到 63%;每次调用重采样噪声,会让覆盖 60% 以上路径的缓存再跌 14 到 40 个百分点。
这篇文章的价值不在于它的具体数字,而在于它的方法论:在引入复杂的缓存之前,先确认简单基线(少步数)已经做到了哪里。 它给出的结论是「先做少步数基线,并且在部署所用的采样器与噪声设置下测试复用」。
Elastic-WAM(2026-11-10)则从另一个角度切入:自适应地分配「精炼预算」。它的观察是,不同任务、不同状态下所需的精炼深度不同,而未来画面里不同区域与动作生成的相关性也不同。它学一个「统一时空精炼需求场」:每个时间步、每个空间位置有一个需求强度,需求强的步子走得更远、需求弱的步子早停。这个场用共享的时间基和空间幅度来参数化,分三阶段用动作锚定的监督来训练。推理时,这个场引导稀疏地循环精炼,既提升成功率又降低开销。
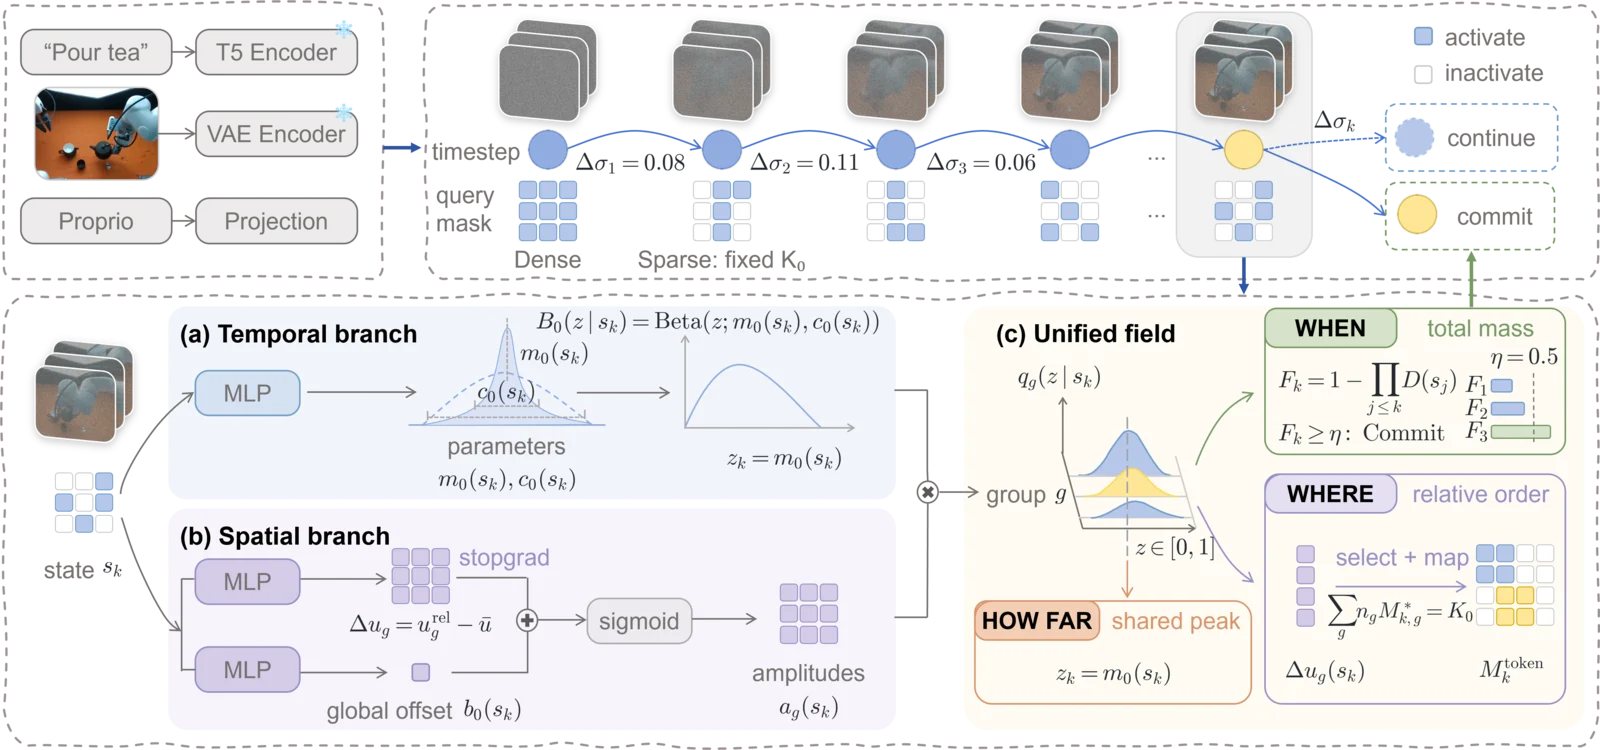
Elastic-WAM 论文的方法图把这个「需求场」拆成三个正交的问题:(a) 时间分支回答「WHEN」——用一个 Beta 分布形式的停止概率,决定这一轮要不要继续精炼;(b) 空间分支回答「WHERE」与「HOW FAR」——给未来画面里每个区域算一个幅度,决定哪些区域需要刷新、每个去噪步推进多远;(c) 把两者合并成一个统一的场,用共享的时间基与空间幅度参数化。图中 Dense 与 Sparse 两条路径的对比是关键:固定预算的精炼(Dense)在每一处都花同样的步数,而需求场驱动的精炼(Sparse)只在需要的地方多花步数。这使得它的推理开销与「画面确实需要被想清楚多少」直接挂钩,而不是一个固定的去噪步数常量。
线三:选择性想象——何时值得想,何时不必想
第三条线把「只生成对动作有用的部分」推到了决策层面:这次的未来到底值不值得想象?
直觉上,如果当前观测已经清晰支持一个稳定的动作,那就不必花时间去生成未来画面;反之,如果当前观测里「语言提到的物体」和「视觉里的物体」绑不上(被挡住、识别错了、或者换了个同名的),那么未来预测就能提供额外的信息。Bind-WAM(2026-11-11)把这个直觉形式化成了一个信号:绑定不确定性(binding uncertainty),即语言指令中的对象与观测中的对象之间关联的稳定程度。
它的实现比较巧。先用一个离线标注流程,基于完整示范和动作上下文,识别任务相关物体并检测三类失败:引用不匹配(指令指的物体在画面里没有对应)、不可见(物体被遮挡)、身份漂移(同名物体被错误关联)。这些伪标签训练一个轻量路由器,输入是当前观测与语言指令,输出绑定不确定性。推理时,共享的 WAM 策略根据这个不确定性和它在相邻重规划之间的变化,决定这一次是否触发联合未来-动作生成。绑定不确定性在这里的角色是一个「成本-收益的阀门」。
Elastic-WAM 与 Bind-WAM 合起来构成一种「按需想象」的结构:前者决定「想多深」,后者决定「要不要想」。这种结构比单纯的架构改进更像一个系统层面的调度问题,与推理系统的思路如出一辙——在 KV 缓存淘汰、投机解码的验证预算这类问题上,业界早就在做同一类决策。
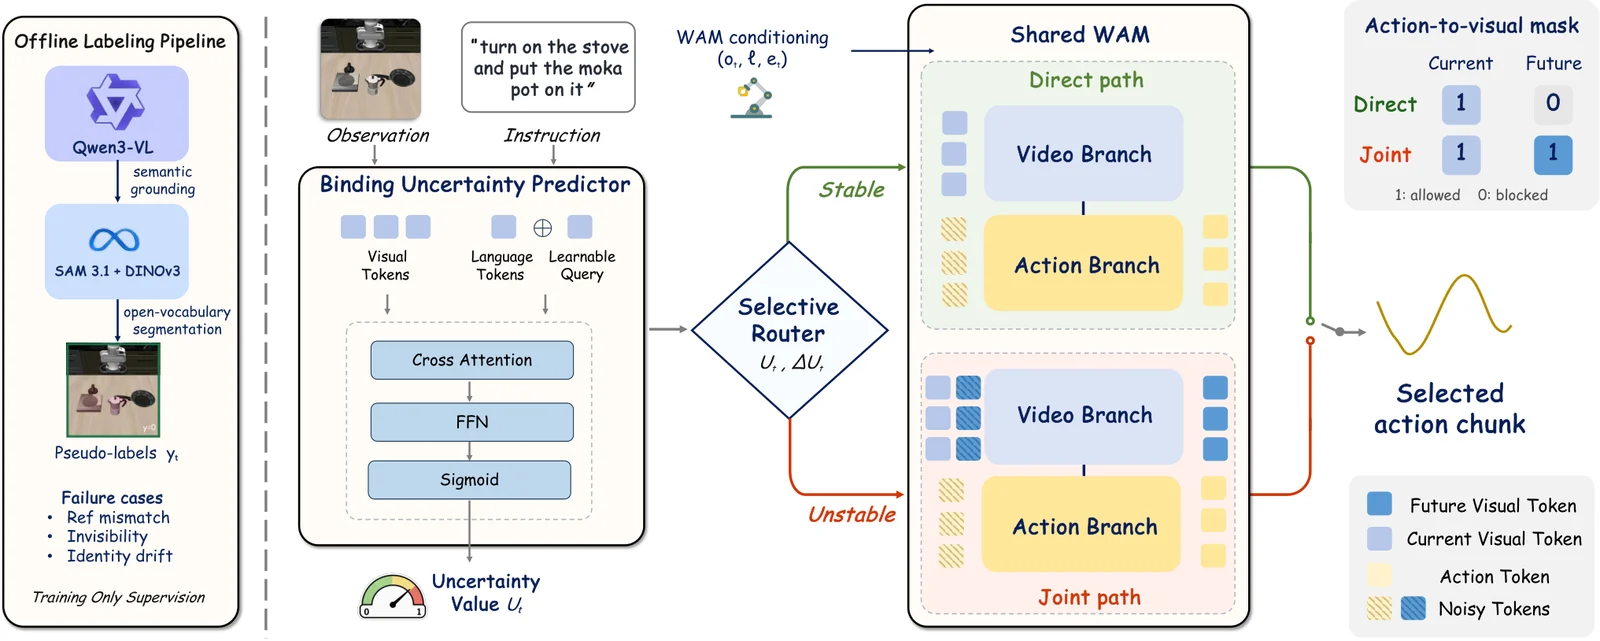
Bind-WAM 论文的方法图把「路由器」放在整张图的中间,这是理解它的关键。左侧是离线标注管线:用 SAM 3.1 + DINOv3 做开放词汇分割,把指令中的对象与画面中的区域绑定起来,再用完整示范的动作上下文标出三类失败——引用不匹配(Ref mismatch)、不可见(Invisibility)、身份漂移(Identity drift),产出伪标签。中间是绑定不确定性预测器:从当前观测、指令与伪标签里学出「这次绑定有多不稳」,再经一个路由器输出「允许(1)」或「阻断(0)」的双值决策。右侧是共享的 WAM:视频分支与动作分支都在,但只有当路由器放行时才走「联合路径」(同时生成未来视觉 token 与动作 token);被阻断时走「直通路径」,只用当前视觉 token 生成动作块,跳过未来想象。这一「同模型、双路径」的结构是它节省计算的核心——它不需要一个专门的「轻 WAM」模型,而是在同一个模型里按需选择更贵的那条路。
跨具身:从「每个机器人一套数据」到「视频就是轨迹」
WAM 在数据经济学上的意义,比它在模型架构上的意义更深远。这一节单独讲。
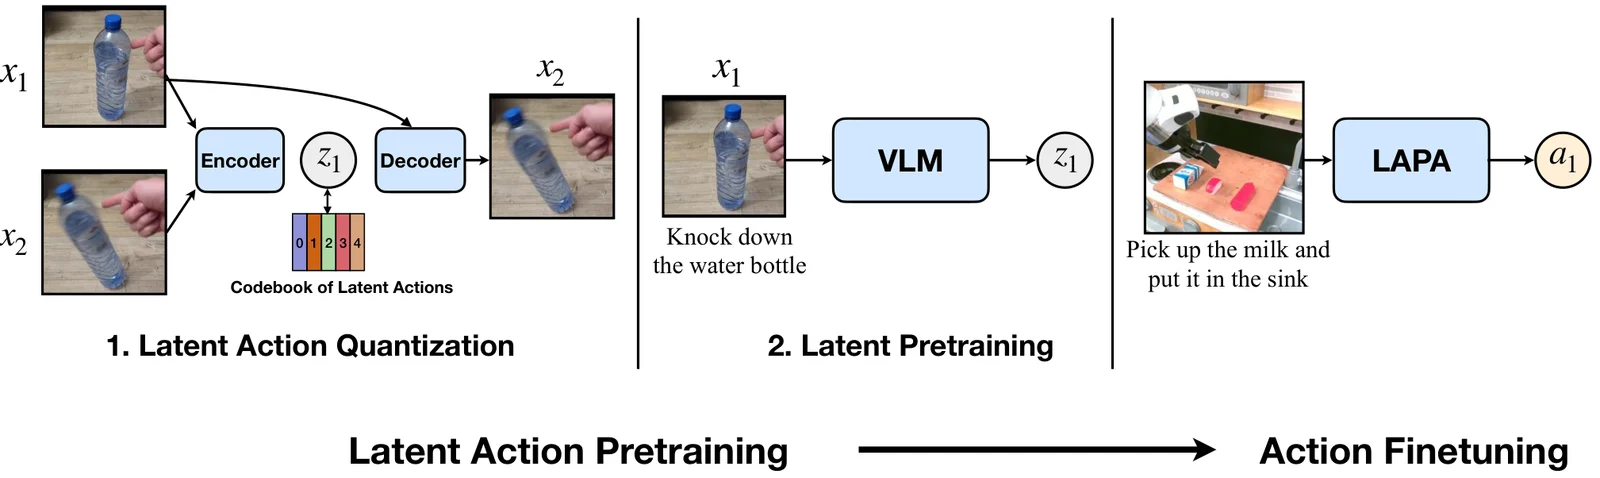
先看这条路线最早的形态。LAPA(Latent Action Pretraining from Videos,2024-10)的流程图把三步画得很清楚:第一步在相邻两帧之间学一个 VQ 码本,把「从这一帧到那一帧发生了什么」量化成离散的潜动作 ;第二步用这个潜动作作为监督,在互联网视频上预训练一个 VLA——输入是观测与任务描述,输出是潜动作,此时完全不需要真实的机器人动作标签;第三步只需要少量机器人操作数据,把潜动作映射到真实动作。LAPA 的贡献是把「无动作视频」从「无法使用」变成了「可以用于预训练」。这条思路也正好暴露了 WAM 与 LAM 的分工:LAM 靠离散码本把动作空间「贴」在世界变化之上,码本的大小与语义决定了它的天花板,这也是 SALA 后来要借语言描述来校准这个码本的原因。
传统 VLA 的预训练要求「观测-动作」配对,意味着每种机器人、每种遥操作装置都需要单独采集一对一的示范数据。这是线性增长:N 种机器人需要 N 倍的数据采集成本。WAM 把视频当作「任意人类或机器人执行有用行为的轨迹」来表示世界如何变化,动作只是这条轨迹上的一个标签;只要模型学会了「世界怎么变」,它就可以把这种变化迁移到一个新的具身上——用少量数据把「变化」映射为对应的动作。
DreamZero 报告了两类跨具身迁移:用其他机器人或人类的无动作示范视频,只给 10 到 20 分钟数据,就能让新任务性能相对提升 42% 以上;给 30 分钟的「玩耍数据」,能让模型适配一个新的具身形态,同时保留零样本泛化。这两个数字属于同一条趋势的两端:数据成本从「线性增长」变成了「对数增长」——先预训练世界变化,再用少量数据把世界变化翻译为该具身的具体动作。
MetaWAM(2026-11-10)从另一个角度处理同一件事,但落点更具体:低维的机器人信号(本体感知、动作、价值)如何进入预训练视频扩散模型的潜空间。 这是一个非常工程化的问题。已有的做法是「为每个信号分配一个潜帧」或「额外挂编码解码器」——前者浪费了大量 token,后者引入了额外的模块与训练参数。MetaWAM 把这件事重新定义成一个分布对齐问题:机器人信号被注入的方式,能否匹配预训练视频扩散模型在去噪时的先验分布?
它的诊断手段很有意思:用一个冻结的 VDM 去噪器对注入信号后的潜帧做「相对重建误差」测量。误差小,说明去噪器「觉得」这个潜帧本来就是它见过的样子;误差大,说明信号偏离了先验。诊断的结论是:常规的空间编码方式离先验很远,而频域打包得到的潜变量,去噪器修正得少得多。于是它把所有机器人信号折进一个「元帧」(meta-frame):每个信号被分配到不重叠的频域通道带,再通过逆离散余弦变换提升到空间潜表示。一组固定频带布局加上槽位感知路由,让同一个元帧同时支持策略、世界模型、价值预测。
这一设计的收益是可量化的:在 RoboCasa 上成功率 68.9%,每个信号的帧塌缩成了一个,推理延迟降低 39%;三个真实世界的 Franka 任务上成功率 85.0%。数据上看,这是「接口」层面的一个小改动,但它揭示了一个 WAM 工程的关键现实:在大模型预训练的视频分布里,「什么格式的信号能被去噪器不费劲地接受」是一个比「模型架构」更贴近工程的问题。 后续任何 WAM 的跨具身迁移,都要先回答这个接口问题。
推理账本:WAM 到底在什么样的预算里运行
这一节从概念回到数字。WAM 的推理预算不是「越快越好」,而是「在满足闭环频率的前提下,尽可能多地做想象」。把不同工作的推理数字并排来看,能把这笔账算清楚。下表只列出各论文在自身实验条件下报告的片段,不做跨论文的横向比较。
| 工作 | 时间 | 控制频率或延迟 | 说明 |
|---|---|---|---|
| DreamZero | 2026-02 | 7 Hz | 14B 参数的自回归视频扩散,实时闭环 |
| ResWAM | 2026-11-14 | 92.7 ms | 2.3B 参数,真实机器人三条任务 |
| ThinkWAM | 2026-11-16 | 101.2 到 164.6 ms(每动作块,两趟推理) | Galaxea A1Z / LIBERO / RoboTwin |
| MetaWAM | 2026-11-10 | 39% 延迟下降(相对每信号一帧的基线) | RoboCasa |
| BEHAVIOR 挑战方案 | 2026-11-10 | 每端口平均超过 2 FPS | 100 个并发的评估端口 |
把这些数字放在一起看,WAM 部署的预算问题就很清楚了。人类遥操作机器人时的典型控制频率在 10 到 30 Hz 之间,抓取时常常更低。7 Hz 意味着一个动作块的执行时长约为 143 毫秒——这个频率下动作会略显「顿」,但对抓取、开门、搬箱子这类慢动作仍然可用。ResWAM 的 92.7 毫秒约合 10.8 Hz,已经进入了「体感流畅」的区间。而 2.3B 对 14B 的参数差距,是后者能达到这个延迟的前提之一。
但延迟只是表面。真正决定吞吐量的是并发规模。BEHAVIOR 挑战的方案是一个很好的样本:它在有限硬件上撑住了 100 个并发评估端口,每端口平均超过 2 FPS。注意这个数字只比 7Hz 低了一截,但并发量多了一两个数量级。在真实的部署里,「一个机器人一个 WAM 实例」是奢侈的;「一个服务给多个机器人提供策略」才是常态。这也是 PhysisServe 那篇物理 AI 推理系统拆解要解决的问题——把世界模型的服务化,从「每台机器一套」推到「一个服务池」。它那篇里提到的虚拟 rank 调度与 Stage-wise 流水线,本质上就是 WAM 服务化要面对的两个问题:多路请求的合并,以及流水线阶段划分。
推理账本的第一个结论是:WAM 的成本结构决定了它天然属于「服务化」形态。单个机器人的 WAM 生成能力有限,真正有意义的规模化是「一个推理池供给大量具身」——这与大语言模型的推理服务化是同一个逻辑,只是「token」变成了「动作块 + 未来帧」。
推理账本的第二个结论是:动作块时长是一个杠杆。设一次重规划的耗时为 ,动作块覆盖 个控制步,控制周期为 。闭环可行的条件是:
其中 是执行与通信的抖动余量。这个不等式给出了两个可调杠杆:增大 (同一动作重复利用更久,减少重规划次数)或者增大 (降低控制频率)。二者都会增加「动作块执行期间世界已经变化」的概率,从而降低成功率。Elastic-WAM 用的就是「在 不变的前提下,把一部分控制步改成「快速动作 + 轻量未来去噪」」这条折中路径。
从联合 WAM 到轨迹优化:一个训练-推理不对称的巧思
WATO(Joint World Action Models through Differentiable Trajectory Optimization,2026-11-13)是 2026 年最值得单独讲的思路之一,因为它在方法论上给出了一个「反直觉」的解法。
问题的起点并不复杂:联合 WAM 生成的动作与未来状态轨迹,是模仿学习学出来的,也就是「模仿演示里怎么做」。但模仿出来的轨迹不保证是「任务有效」的或者「动力学一致」的。WATO 的方案是把生成的轨迹当作一个带动力学约束的轨迹优化问题的参考,优化出一个满足任务约束的轨迹,然后通过这个优化后的轨迹把任务损失反向传播到生成器,训练生成器直接产出「任务感知、动力学一致」的轨迹。
这里的关键设计是「两阶段不对称」:轨迹优化只在训练时做,部署时完全不做。部署时,WATO 只是直接生成候选轨迹,再用世界模型给它们打分排序。这样,测试时不做迭代优化,却把「优化」的好处通过训练传给了生成器。
数字上,WATO 在七个视觉控制环境上把平均成功率从模仿学习版联合 WAM 的 79.9% 提升到 91.7%;与 CEM 相比,部署时平均快 11.5 倍,用的世界模型评估次数少 600.5 倍。
这个方法值得借鉴的根本原因在于它对推理侧的理解:WAM 把搜索「编译」进了生成,但如果这个编译不完美,可以再在训练时用一次更高质量的搜索把梯度补回去,而不必在推理时把搜索代价重新拿出来。 这是「编译-运行」这一对概念在 WAM 上的清晰体现——训练阶段的昂贵计算变成了推理阶段的免费能力。
WA-JEPA(2026-11-14)则是从「训练时不做搜索,推理时也不做搜索」这条路上走的。它的结构是一个「提议-预测-反馈-修正」的循环:先给动作提案,预测在这个提案下的未来场景与本体状态,再用两条反馈路径修正提案——一条基于「预测场景的潜表征与任务目标的差」(GDRF,目标差残差反馈),一条保留预测出来的细粒度场景表征用于后续修正(FSCF,未来场景上下文反馈)。这是从离线示范里联合学出来的,所以修正本身也不需要额外训练。这类「在潜空间里做一次快速重省」的模式,与 ThinkWAM 的两趟推理是同一种结构的不同实现:先快速给一个答案,再用预测的未来评估并修正它。
WAM 在物理、评测与训练数据上的边界
WAM 的能力有明确边界,不把它写清楚,容易高估。
第一,物理正确性不等于视觉逼真。 联合预测的监督信号是画面变化,而画面变化是物理规律的结果,不是物理规律的约束。与第四篇讨论过的视频生成式世界模型的结论一致:WAM 并不会显式惩罚动量不守恒、碰撞穿透、物体不可见这类物理违规,除非训练数据里存在足够多的对应失败与修正样本。ResWAM 用残差监督把重点放在「机器人臂与操作物体」上,恰恰是为了避开背景干扰,但这也并不意味着它学到了背景里所有的物理约束。
第二,跨具身的迁移依赖「相似的视觉变化」。 一只人类手和一只两指夹爪抓同一个杯子,视觉变化显然不同。DreamZero 报告的 42% 相对提升是在「视频示范与本具身足够相似」的前提下测得的。人类手部的视频和机械臂视频之间的迁移,需要中间层——一种从「变化」到「动作」的映射关系。SALA 用语言描述给人类视频与机器人视频建立语义对应,正是对这种映射缺失的补救。
第三,评测工具还不成熟。 ReactBench-AD(2026-11-15)提出了一个值得重视的问题:自动驾驶的 VLA 和 WAM 在面对即将到来的危险时,反应是否正确?这个问题很难用常规的成功率指标回答——因为「反应正确」的场景在训练数据里都是稀少样本,大多数评测集根本不包含。WAM 的评测需要「反事实」能力的测试:向模型呈现一个现实里很少出现的场景(前方突然出现行人、路面塌陷),看生成出来的动作和未来是否一致。
第四,训练数据的质量在 2026 年被重新重视。 SWAM(2026-11-09)汇集了约 47,000 小时的数据(通用视频、第一视角视频、UMI 示范、机器人示范),系统对比了三种监督组合:语言-视频监督、语言-视频-动作监督、二者联合。它发现一个关键事实:语言-视频对齐在视频预训练里是既得的,但引入动作学习会损害这种对齐;在固定训练预算下,混合第一视角视频和 UMI 示范能提升控制泛化。这个发现说明,WAM 的「训练配方」不是简单的「更多数据、更大模型」,而是「监督组合的平衡」——语言-视频对齐,是靠「无动作视频」撑住的;动作学习则要靠「有动作示范」加固。
这也回到本文的一个母题:WAM 的价值在于「用一次前向回答『接下来该做什么』」,但它「怎么做对」的约束,来自它训练数据里「世界如何变化」的分布。数据分布决定它能对什么样的物理规律有把握。这一点,与第四篇里对视频生成式世界模型的结论是一致的。
小结
WAM 这条路线可以用一句话概括:把动作从输入变成输出,以换取向生成过程「编译」规划的能力。 这个交换带来了三个层面的变化:
- 数据经济:视频成为一等公民的监督信号,跨具身迁移从「线性数据成本」变成「对数数据成本」,DreamZero 用 10 到 20 分钟视频实现 42% 以上的相对提升。
- 推理系统:WAM 的成本结构是「动作块 + 未来帧」的联合生成,单机器人闭环有严格的延迟约束,规模化必然走向服务化——与 LLM 推理服务化同构。
- 精度与想象:联合生成带来的动作精度问题,由 WorldVLA 的注意力掩码、ThinkWAM 的两趟推理、ResWAM 与 DiffWAM 的残差监督分别处理;成本则由 UVA、DreamZero、Elastic-WAM、Bind-WAM 沿着「少步数、按需想象」这条主线一并削减。
2026 年下半年这一波工作还揭示了一个方法论层面的转向:把 WAM 当作一个调度问题而不是一个模型问题。Bind-WAM 的「何时想象」、Elastic-WAM 的「想多深」、WATO 的「训练时搜、推理时不搜」、Cache or Denoise Less 的「先砍步数」——这些都不是在架构上做大的改动,而是在「算力应该花在哪里」上做取舍。这正是「世界模型」走向「世界模型系统」的必经之路。
系列前四篇和这一篇合起来,覆盖了世界模型从形式化、潜空间、表征空间、像素空间到世界动作模型的完整谱系。下一篇回到第四篇结尾预告的评测主题:物理一致性、反事实响应与长程记忆各自应该怎么测,为什么现有的大多数视频榜单测不出「世界模型」,以及一个可用的世界模型评测栈应该由哪几层组成。这些问题的答案,也是判断 WAM 究竟能走多远的前提。
参考资料
- World Action Models are Zero-shot Policies(DreamZero,NVIDIA,arXiv:2602.15922,2026-02)
- WorldVLA: Towards Autoregressive Action World Model(arXiv:2506.21539,2025-06)
- Unified Video Action Model(UVA,arXiv:2503.00200,2025-02)
- Latent Action Pretraining from Videos(LAPA,arXiv:2410.11758,2024-10)
- V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning(Meta FAIR,arXiv:2506.09985,2025-06)
- SWAM: Scaling World Action Models with Cross-Modal Alignment(arXiv:2611.12870,2026-11-09)
- LaST0.5: A Generalist World Action Model with Interaction-Centric Latent Reasoning(arXiv:2611.14048,2026-11-10)
- Elastic-WAM: Adaptive Spatiotemporal Imagination for Efficient Robot Control(arXiv:2611.14257,2026-11-10)
- From Video Frames to Robot Meta-Frames: A Unified Latent Interface for World Action Models(MetaWAM,arXiv:2611.14365,2026-11-10)
- WAM is capable in BEHAVIOR-1K: the 2nd-place solution to the 2026 BEHAVIOR Challenge(arXiv:2611.13818,2026-11-10)
- Bind-WAM: Binding-Uncertainty-Guided Selective Future Imagination in World Action Models(arXiv:2611.15368,2026-11-11)
- SALA: Semantically Aligned Latent Actions Enable Dual-Axis Scaling of Embodied Foundation Models(arXiv:2611.17110,2026-11-12)
- Joint World Action Models through Differentiable Trajectory Optimization(WATO,arXiv:2611.17626,2026-11-13)
- WA-JEPA: Goal-Aware Predictive Feedback Action Refinement for a World-Action Model(arXiv:2611.19183,2026-11-14)
- ResWAM: Learning What Changes, Not What Stays, for World-Action Models(arXiv:2611.19559,2026-11-14)
- Difference World Action Model(DiffWAM,arXiv:2611.19904,2026-11-15)
- Cache or Denoise Less? Residual Reuse in a Flow-Matching World Action Model(arXiv:2611.19709,2026-11-15)
- ThinkWAM: Rethinking Latent Futures for Action Refinement(arXiv:2611.21258,2026-11-16)
- ReactBench-AD: Do Driving VLAs and World-Action Models React to Imminent Hazards in Their Path?(arXiv:2611.20011,2026-11-15)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



