


世界模型从零讲起(一):一个模型如何学会「想象」世界
从一次失败的抓取说起
在展开定义之前,先看一个具体的场景。一台机械臂要把桌上的杯子抓起来放进托盘。它没有见过这个杯子——杯壁是磨砂的,直径比训练数据里的马克杯小一圈,桌上还有一处反光。摄像头拍到的是二维像素,机械臂要知道的是六维位姿与夹爪开合宽度。第一次尝试,它夹空了;第二次,夹爪碰到杯壁把杯子推倒;第三次才成功。
人类做这件事时几乎不消耗样本。人看一眼就知道「杯子是圆柱体、杯口朝上、夹爪从侧上方合拢能夹住」,甚至能事先想象出「如果我从这个角度下去,手指会碰到手柄,杯子会晃」——这种在心里预演后果的能力,就是本文要讲的世界模型:一个在内部表征空间里模拟环境如何随动作演化的模型。
这句话里有两个关键词。第一个是「内部表征」:世界模型不必生成逼真的像素,它只需要在自己的表征空间里把「接下来会发生什么」算出来。第二个是「随动作演化」:如果模型只是预测视频的下一帧,而不管智能体做什么,那它是一个视频预测器,而不是一个可用于决策的世界模型。行动者需要的是反事实推演——「如果我往左推,杯子会倒;如果我往上提,杯子会留在桌上」。世界模型的价值,正在于它允许智能体在真正动手之前,把若干种可能的动作在「想象」里各走一遍。
这篇文章是整个系列的第一篇,只做一件事:把世界模型这个概念从零拆开。它解决什么问题、形式定义长什么样、有哪几条技术路线、每条路线的训练目标和推理成本如何、以及怎么判断一个世界模型好不好。后续篇目会分别深入 Dreamer 系列、JEPA 系列、视频生成式世界模型与动作条件世界模型。本文不假设读者读过任何一篇世界模型论文,但要求读者了解 Transformer 和扩散模型的基本概念;不熟悉的读者可以先看站内的 扩散模型从零讲起(一)。
智能体为什么需要一个「想象」出来的世界
无模型方法的样本代价
强化学习里最直接的思路是 model-free:把策略 或价值函数 直接拟合到与环境交互得到的数据上。这条路线在 Atari、Dota、围棋上取得了成功,但它对样本的需求与任务的复杂度成正比。一个机械臂抓取任务,如果每次都靠真实试错,一次失败可能意味着摔坏物体、撞坏设备,或者至少几十秒的复位时间;而在自动驾驶、手术机器人这类场景里,「试错」本身就不被允许。
更根本的问题是数据覆盖。策略只在它访问过的状态附近有可靠的估计,一旦进入训练分布之外的区域——比如把一个没见过的物体放到机械臂面前——价值函数的输出就没有意义。增加覆盖只能靠更多交互,而真实世界的交互是昂贵且长尾的。
世界模型给出的替代方案是:让智能体在一个学到的模型里试错。真实交互一次,可以在模型里 rollout 上千次;危险动作先在模型里撞墙,再决定是否在现实里执行。这就是 model-based reinforcement learning(基于模型的强化学习)的核心动机。它把「与环境交互」的成本,部分转移成了「训练一个足够准的模型」的成本和「在模型里推演」的计算成本。
三种典型用法
世界模型在系统里有三种常见用法,三者的要求并不相同。
第一种是规划。给定当前观测,用模型向前推演若干候选动作序列的后果,再用一个价值或目标函数给每条想象轨迹打分,选最好的一条执行,执行一步后再重新规划。这就是 model predictive control(MPC)的思路,只不过动力学模型从解析方程换成了神经网络。这类用法要求模型对动作敏感、对短期后果预测准确;对长期一致性反而要求较低,因为每次只执行第一步。
第二种是在想象中训练策略。Dreamer 系列是代表:策略和价值函数完全在潜空间里、用模型生成的想象轨迹来训练,不与真实环境交互。这类用法要求模型的想象分布不能偏离真实分布太远,否则策略会在「模型里的世界」中学到在真实世界里无效的行为。这是 model-based RL 里著名的分布漂移问题。
第三种是作为仿真器或评估器。生成式世界模型可以直接充当可交互的虚拟环境:给一张图或一段提示,模型生成一个可以持续交互的场景,人或策略在里面行动、观察后果。它也可以作为策略评估的沙盒——在部署前,把一个候选策略放进世界模型里跑一遍,看它会不会撞车、会不会把杯子打翻。这类用法对视觉保真度和长程稳定性要求最高,对动作的物理精度要求反而可以放松。
三种用法对应三类模型设计,后面会看到,它们的训练目标、表征空间和推理成本差别很大。
形式化:世界模型到底在建模什么
环境、观测与动作
把智能体与环境的交互写成标准的 POMDP(partially observable Markov decision process):环境有一个真实状态 ,智能体只能看到观测 ,执行动作 ,环境按转移分布 演化,并给出奖励 。智能体的目标是最大化累积奖励。
POMDP 的「部分可观测」不是技术细节,而是世界模型设计的起点。真实状态可能是杯子在三维空间中的精确位置、摩擦系数、光照;观测只是摄像头拍到的一张图或一段视频。世界模型要做的,是从观测历史中推断出一个足够好的状态估计,再预测这个估计如何随动作变化。
三个模块的分解
Ha 与 Schmidhuber 在 2018 年的 World Models 一文给出了一个至今仍在用的分解:世界模型由三部分组成。
- 视觉编码器(V):把高维观测压成低维潜变量,。
- 动力学模型(M):在潜空间里预测下一步,。
- 控制器(C):根据当前潜状态选择动作,。
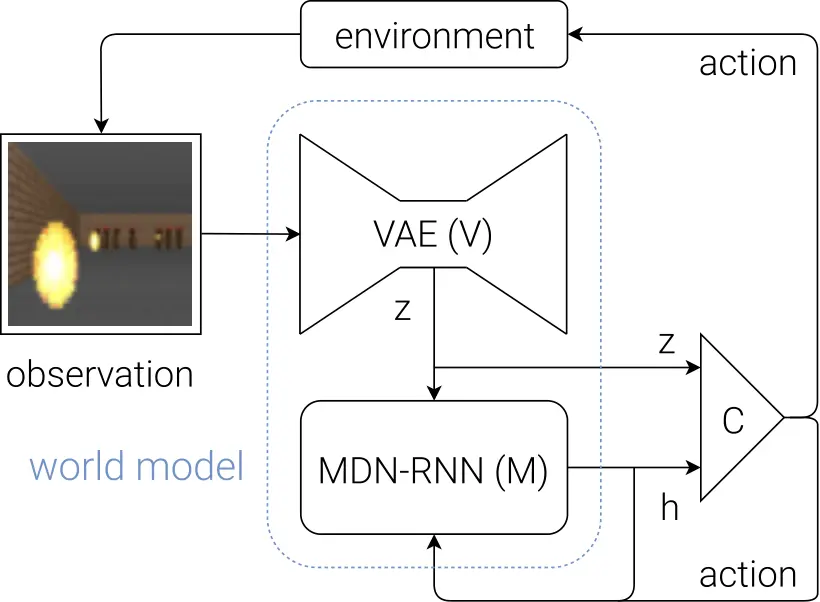
图中从左到右标出了这条闭环:观测送入 VAE 编码器 ,压成潜变量 ;MDN-RNN 动力学模型 接收 与控制器给出的动作 ,预测下一步潜变量的分布;控制器 再根据潜状态选动作。三个模块可以分开训练——VAE 只在观测上做重建,动力学模型在带随机策略动作的序列上学习预测,控制器则用 CMA-ES 这类无梯度方法在潜空间里单独优化。图源:Ha & Schmidhuber,World Models(arXiv:1803.10122)图 1。
这个分解的关键在于:动力学模型不接触像素,它在潜空间里做预测。这带来两个直接好处。第一,计算量小:一张 的图片有 12288 个维度,压缩到 32 维后在潜空间里做一步预测,成本可以忽略。第二,模型被迫学习「什么信息对未来有用」——编码器的信息瓶颈会自动丢弃纹理噪声、保留位置、速度这类与动力学相关的量。
但这个分解也埋下了一个隐患:如果编码器丢掉的信息恰好是预测未来所需的,动力学模型再怎么准也没用。比如杯子被遮挡时,编码器可能完全丢掉杯子的位置,动力学模型就无法预测遮挡解除后杯子在哪。这是所有潜空间世界模型的共同难题,也是 JEPA 路线与重建式路线分歧的根源之一。后面会专门讨论。
两种建模空间:观测空间与潜空间
按预测对象划分,世界模型可以分成两类。
观测空间世界模型直接建模 ,也就是预测下一帧像素或下一段视频。视频生成模型天然属于这一类。它的优点是表征通用、可以继承互联网视频的先验;缺点是计算成本高、而且模型可能把容量花在与决策无关的视觉细节上——把每一片树叶都画对,对抓取决策毫无帮助。
潜空间世界模型建模的是分解后的潜变量动力学:
其中 是编码器(后验), 是潜空间动力学(先验), 是解码器。这个积分在实现中永远无法精确计算,实际做法是用采样的单点近似,或者干脆只优化它的变分下界(ELBO)。
潜空间模型的优点是计算便宜、把容量集中在决策相关因素上;缺点是编码器压缩时可能丢失信息,而且解码器质量直接影响「想象」的可用性。Dreamer 系列选择了这条路,并在潜空间里同时训练策略和价值函数——整个学习过程不生成像素。
一个必须回答的问题:动作怎么进入模型
对决策有用的世界模型,必须让动作真正影响预测。这一点听起来显然,但实现上有三种不同的做法,对应三种不同的模型形态。
其一是动作作为输入:。动作是条件,模型预测「给定这个动作,世界会怎样」。经典世界模型和 Dreamer 都属于这一类。
其二是动作作为输出:模型同时生成未来观测和未来动作,。这就是 World Action Model(WAM)的形态,NVIDIA 在 DreamZero 一文里系统化了这个概念。它把规划「编译」进生成过程,推理时不需要再外挂搜索器。站内的 动作条件世界模型完全拆解 对这一路线有完整分析,本文只交代它在谱系中的位置。
其三是动作作为结果:模型只预测观测,动作由逆动力学模型从「观测差」反推,。JEPA 系列在规划时常用这种形态:先用世界模型预测目标状态,再用逆动力学或优化器找能到达该状态的动作。它的好处是模型可以完全在无动作标签的视频上训练,坏处是逆动力学的多解问题——同一个观测变化可能对应多个动作。
这三种形态没有优劣之分,它们的区别在于「动作标签是否可得」和「推理时是否允许搜索」。真实的系统往往混用:预训练阶段用无动作视频学观测动力学,后训练阶段加动作条件,推理时再用 MPC 微调。
三条技术路线:重建、生成、联合嵌入
重建式潜空间世界模型
这条路线以 World Models、Dreamer 系列为代表。训练目标通常是「重建」:编码器把观测压成潜变量,解码器把潜变量还原成观测,动力学模型在潜空间里预测下一步,三者联合优化。损失函数由重建项和 KL 正则项组成,形式上是变分自编码器(VAE)的序列版本。
Dreamer 系列的 RSSM(recurrent state space model)是这条路线最成熟的实现。它把潜状态拆成两部分:确定性的循环状态 和随机性的潜状态 (DreamerV2 起 改为离散类别变量,V1 中是连续高斯)。 由 GRU 从 、、 更新而来,负责记忆; 从 和当前观测推断而来,负责表示不确定性。动力学模型学的是先验 ,编码器学的是后验 ,训练时用 KL 散度把两者拉近——这样在推理时没有观测,先验也能独立采样。
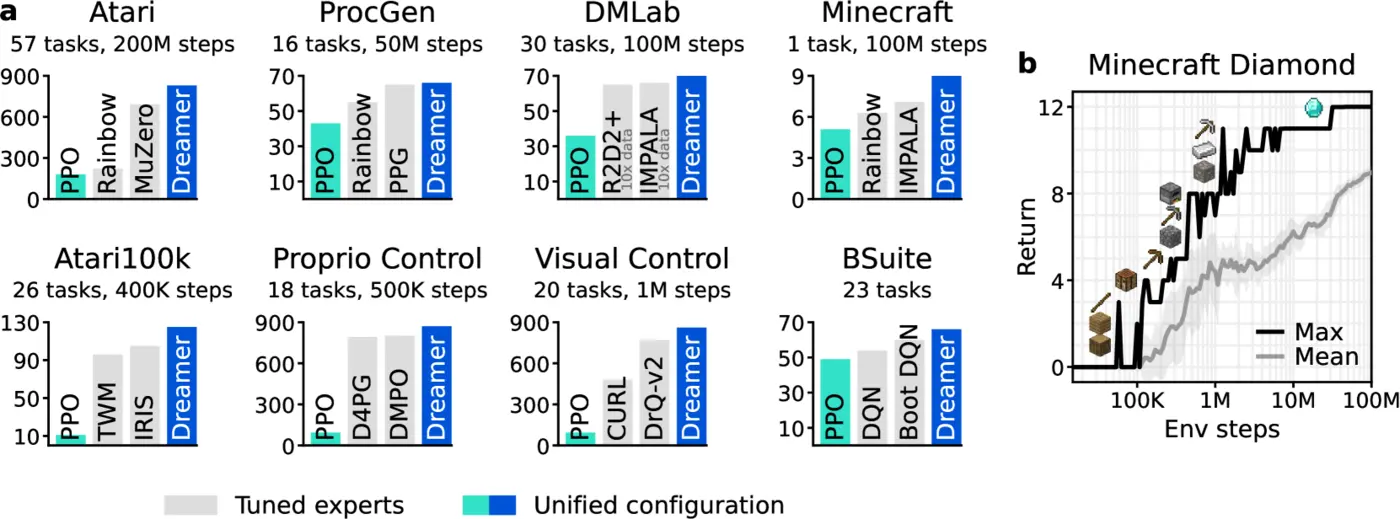
图中上方是任务族与规模:Atari 57 个任务、ProcGen 16 个、DMLab 30 个、Minecraft 1 个;下方按 BSuite、控制、Atari100k 等分组给出归一化分数。每根柱子的左半是统一配置下的 DreamerV3,右半是每个任务单独调参的专家。统一配置在绝大多数任务上没有明显落后,这正是后文「一套超参数跨领域」说法的来源。图源:Hafner 等,Mastering Diverse Domains through World Models(arXiv:2301.04104)图 1。
这条路线在样本效率上非常强。DreamerV3 用同一套超参数在 150 多个不同领域(Atari、DMControl、Minecraft 等)上超过了专门调参的基线;Dreamer 4 进一步把世界模型扩展到从视频中学习、并在想象中训练出能在 Minecraft 里挖钻石的智能体。但它的预测是「短视」的:模型擅长预测几步内的后果,长程 rollout 会逐渐漂移;而且重建目标迫使模型把容量花在像素细节上,这也是 Dreamer 4 转向更大规模视频预训练的原因。
视频生成式世界模型
这条路线以 Sora、Genie、GAIA-1、Cosmos 为代表。模型直接在像素/潜空间视频上训练,目标函数是扩散或流匹配,规模通常在十亿参数以上。它们继承了互联网视频中的物理先验:物体怎么下落、布料怎么褶皱、光影怎么变化,这些规律不需要从零学习。
视频生成式世界模型的优势是泛化与保真度,代价是推理成本。生成一秒钟 720p 视频,需要几十步去噪、每步一次数十亿参数的前向;如果要求实时交互,还要在 24fps 的节奏里完成同样的计算。Genie 3 能做到 720p、24fps 的实时交互,背后是大量系统层面的优化,而不只是模型变小。这一点会在系列的工程篇展开。
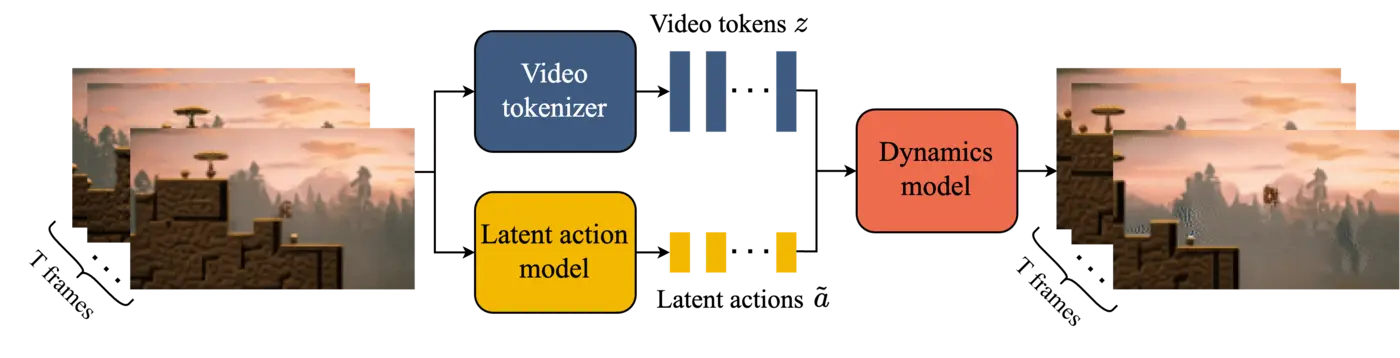
图源:Bruce 等,Genie: Generative Interactive Environments(arXiv:2402.15391)图 2。左侧的视频 tokenizer 把每帧压成离散 token;中间的潜动作模型从相邻帧的 token 差里推断一个离散潜动作——这就是「无动作标签视频也能学可控动力学」的关键;右侧的动力学模型自回归预测下一帧的 token,条件是历史帧与潜动作。视频 tokenizer 用重建损失训练,潜动作模型与动力学模型用交叉熵训练,整个过程完全不需要人工动作标注。
这条路线与重建式路线的根本区别在于目标函数。重建式路线优化的是「还原观测」,视频生成式路线优化的是「生成符合数据分布的观测」。前者关心的是信息保真,后者关心的是分布匹配。这导致两者对不确定性的处理不同:重建式模型倾向于预测一个模糊的平均未来,生成式模型可以采样出多个合理的未来。对规划来说,后者更有用——真实世界的未来本来就是多峰的。
联合嵌入预测:JEPA
第三条路线是 LeCun 在 2022 年立场论文 A Path Towards Autonomous Machine Intelligence 中提出的 JEPA(Joint Embedding Predictive Architecture)。它的核心主张是:不要预测像素,预测表征。
JEPA 的结构是:编码器把观测映射到表征空间,预测器根据当前表征和动作预测未来表征,训练目标是让预测表征与未来观测的编码表征接近。这里没有解码器,也没有重建损失。损失函数直接定义在表征空间:
其中 , 是预测器。看似简单,但它有一个致命的退化解:如果编码器把所有输入都映射成同一个常数向量,损失就是零。JEPA 系列为此设计了多种防坍缩机制——停止梯度、EMA 目标编码器、方差-协方差正则。V-JEPA 2 用 100 万小时视频训练,在机器人规划任务上展示了零样本能力;LeJEPA 则从理论上分析了为什么某些正则项能保证表征不坍缩。
JEPA 的优点是表征高效、不浪费容量在像素细节上;缺点是训练不稳定、而且「预测表征」不等于「预测可执行的未来」——如果表征丢掉了动作相关的细节,规划就会失效。
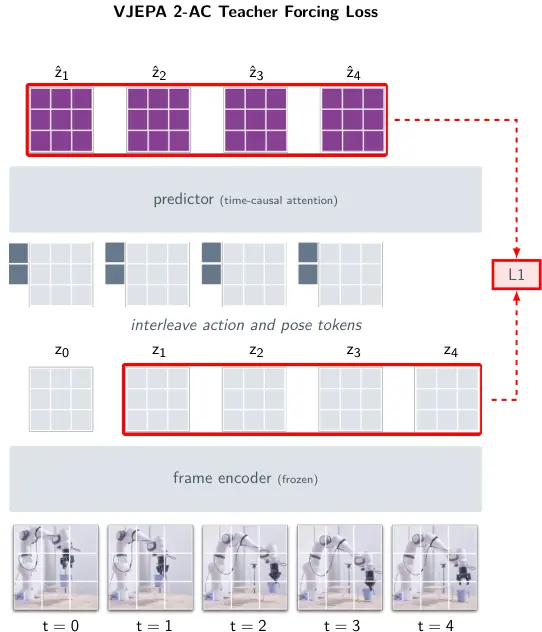
图源:Assran 等,V-JEPA 2(arXiv:2506.09985)图 2。左侧编码器只处理观测,右侧预测器把「当前表征 + 一段动作」映射到未来表征,损失直接定义在两个表征之间,全程没有解码器。注意图中动作是以「块」为单位输入的,而不是单步——这是为了让预测器学到动作的时序效果,而不是记住某一步的瞬时变化。推理时,这个预测器可以接在 MPC 里给候选动作序列打分。
这条路线目前仍在快速演化,系列的 JEPA 篇会详细拆解。
一张对照表
| 路线 | 代表工作 | 预测对象 | 训练目标 | 动作如何进入 | 主要优势 | 主要代价 |
|---|---|---|---|---|---|---|
| 重建式潜空间 | World Models、DreamerV3/4 | 潜变量 + 重建观测 | 重建 + KL | 作为输入 | 样本效率高、可闭环训练策略 | 长程漂移、容量花在像素 |
| 视频生成式 | Sora、Genie、GAIA-1、Cosmos | 视频像素/潜空间 | 扩散 / 流匹配 | 作为条件或联合生成 | 保真度高、物理先验强 | 推理成本高、实时性难 |
| 联合嵌入 | I-JEPA、V-JEPA 2、LeJEPA | 表征 | 表征空间 MSE + 防坍缩 | 作为条件或逆动力学 | 表征高效、无需解码 | 训练不稳、可能丢动作细节 |
| 世界动作模型 | DreamZero | 视频 + 动作 | 联合去噪 | 作为输出 | 规划编译进生成、跨具身 | 数据要求高、系统复杂 |
这张表会在后续各篇中被反复引用。需要强调的是,三条路线不是互斥的:Dreamer 4 用视频预训练初始化潜空间模型,Genie 用视频生成模型做可交互环境,V-JEPA 2 用联合嵌入表征驱动 MPC——真实的系统经常跨路线组合。
训练目标:从重建到变分下界
重建式模型的目标函数
以 VAE 式世界模型为例。给定观测序列,编码器输出后验 ,解码器输出 ,动力学先验是 。训练目标是最大化观测的对数似然,实际优化其变分下界:
第一项是重建似然,鼓励潜变量保留足够信息还原观测;第二项是 KL 正则,鼓励后验靠近先验,使得推理时没有观测也能从先验采样。两项之间存在张力:重建项希望潜变量携带更多信息,KL 项希望它更靠近先验、更「可预测」。这个张力是世界模型设计的核心权衡。
实际训练中,KL 项往往会被加权或截断。DreamerV3 用了两个技巧:KL balancing,把 KL 拆成「先验向后验靠」和「后验向先验靠」两部分,给前者更大的权重,防止先验被后验拖着走;free bits,对每个潜变量维度设置一个 KL 下限,低于下限的部分不计入损失,防止模型过早把某些维度坍缩掉。这些技巧看起来琐碎,但它们决定了模型能否在长序列上保持稳定的动力学。
生成式模型的目标函数
视频生成式世界模型通常用扩散或流匹配。以流匹配为例,模型学习一个速度场 ,把噪声 沿直线路径输运到数据 :
如果模型要以动作为条件,就把动作序列作为额外输入拼进条件通路:。训练数据需要「视频 + 动作」配对,这比纯视频昂贵得多。这也是为什么 WAM 路线强调「用无动作视频预训练、再用少量配对数据后训练」——它试图把视频先验和动作标签的成本解耦。
生成式目标的优点是它建模的是完整分布而非条件均值,能够采样出多种合理的未来;缺点是训练和推理都更贵,而且采样质量依赖步数。站内的 扩散模型从零讲起(六) 讲了采样器如何影响步数与质量,这里的结论可以直接迁移。
表征空间的目标函数
JEPA 的损失前面已经给出。它的关键设计不在损失形式,而在如何防止坍缩。常见做法有三种:停止梯度(只让预测器一侧回传,编码器一侧不回传)、EMA 目标编码器(目标表征由当前编码器的指数滑动平均产生,避免两侧同时塌陷)、以及方差正则(强制表征在每个维度上有足够方差)。V-JEPA 2 用的是前两种的组合;LeJEPA 则用各向同性高斯正则从理论上保证表征不退化。
这三种目标函数对应三种不同的归纳偏置:重建式假设「有用的信息能被还原」,生成式假设「有用的信息能匹配数据分布」,联合嵌入假设「有用的信息在表征空间中可预测」。没有一种假设在所有任务上都成立,选择哪一种取决于任务对保真度、成本和泛化的要求。
不确定性:世界模型的第二种输出
前文的损失函数都在优化「预测得准」,但世界模型真正有用的是另一个量:预测的置信度。当智能体在模型里规划时,它需要知道哪些想象轨迹是可信的、哪些是模型在瞎编。一个在训练分布内很准、在分布外却输出同样「自信」的模型,会把规划器引向最坏的方向。
均值预测掩盖了多峰分布
先看问题。设真实动力学在某个状态下有两个可能的下一步:门可能开也可能关。若用均方误差训练一个确定性的预测器,最优解是预测两扇门各「半开」——这个状态在真实世界里根本不存在。规划器如果按这个均值推演,就会做出对着半开的门撞上去的决策。
重建式模型用 VAE 式的随机潜变量缓解这个问题:潜在变量采样可以产生多个未来。但这只是把多峰性塞进了潜分布,如果 KL 正则太强,潜变量会退化成和输入无关的噪声,采样出来的未来与当前观测脱节;如果 KL 太弱,模型又会退化成逐样本记忆,泛化变差。这就是前文提到的后验-先验张力在不确定性上的体现。
生成式模型天生适合多峰分布:扩散采样一次,就得到一个完整的未来样本。但代价是每个样本都要跑一遍去噪,蒙特卡洛估计不确定性需要采样多次,推理成本成倍增加。WAM 与视频生成式世界模型因此常把「未来多样性」当作一个独立的采样维度,而不是靠单次前向的方差来体现。
集成与不确定性惩罚
工程上最直接的缓解办法是训练多个模型、用它们的分歧当作不确定性。具体做法是训练 个(常见 )初始化不同、数据顺序不同但结构相同的动力学模型,推理时同时 rollout,计算预测的均值与方差:
规划或策略优化时不要直接用最高奖励,而是用保守估计:奖励减去一个与 成正比的惩罚项。这样,模型「不确定」的动作不会被选;即便被选,后续的 TD 更新也会被折扣掉。这个思路在 MOPO、MOReL 这类离线 model-based RL 工作里被系统化,核心结论是:不确定性惩罚的惩罚系数要与模型在数据分布上的平均误差相匹配——太小的惩罚挡不住模型利用,太大的惩罚会让策略退化成只在训练数据里复述。
集成的代价是推理成本乘以 ,这对需要实时交互的世界模型不可接受。于是实践中常见两种折中:其一,只在训练阶段用集成,部署时用单一模型加上一个不确定性头;其二,用 dropout、权重扰动或模型最后一层的小扰动来近似集成,把 次前向压缩成一次带噪声的前向。
让模型知道自己不知道
更彻底的做法是把不确定性显式建模进潜状态。Dreamer 的 RSSM 里随机状态 本身就承担了这部分角色:先验 表示「在没看到当前观测前,我认为状态可能是这些」;后验 表示「看到观测后,我认为是这样」。两者之间的 KL 越大,说明观测带来的信息越多——模型对当前状态越不确定,这一项的数值就越大。
这个量可以直接作为「想象可靠性」的信号:在 rollout 中逐步累加 KL,当它超过阈值时,就认为后续想象已经不可信、值得更保守地使用。DreamerV3 的 symlog 变换和 robust normalization 本质上是在让这个信号在不同量纲的领域里保持可比,否则 Atari 的奖励尺度会和运动控制的奖励尺度差几个数量级,KL 阈值无法通用。
对视频生成式世界模型,这个思路对应「生成质量随 rollout 步数衰减」的问题。可以训练一个轻量的奖励或质量预测器,对每一帧打分,低于阈值就触发重新采样或重置条件。这类做法目前多在工程系统里实现,而不是论文里。
数据从哪来:世界模型的燃料
世界模型的上限基本由训练数据决定,而数据来源决定了它是否携带动作标签、是否覆盖长尾、是否在时间上连续。三条技术路线的数据策略差别很大。
带动作的交互数据
重建式世界模型与 Dreamer 用的是智能体自己生成的交互轨迹: 三元组。优点是完全对齐、动作标签准确;缺点是覆盖有限——智能体只在它探索过的状态附近有数据,而探索本身受策略影响,容易形成自我强化的覆盖偏差。DreamerV3 用统一配置跨领域,很大程度上是在减少「为每个领域重新设计探索策略」的成本,而不是解决了数据覆盖问题。
无动作的视频
视频生成式世界模型与 JEPA 主要用互联网视频。这类数据量大、覆盖长尾场景,但绝大多数没有动作标签,且时间跨度短、镜头切换频繁。用它们预训练,模型学到的是「世界怎么变」,而不是「动作怎么改变世界」。要让模型对动作敏感,必须有带动作的数据做后训练,或者用潜动作模型从视频里反推动作——Genie 的潜动作模型就是这条路线的代表,它把动作变成离散的潜变量,损失仍然是视频预测的交叉熵。
LeJEPA 一文从理论角度分析了这个问题:在表征空间中做预测时,若目标是各向同性高斯分布,模型的预测损失可以直接用表征与高斯之间的差距来度量,而不需要重建像素。这把「从视频中学到什么」的问题,转化成了「学到的表征流形是否足够结构化」,数据规模越大,流形越接近理论假设。这条路线目前仍是理论驱动的,工程上的数据配方在持续摸索。
仿真与合成数据
第三条来源是物理引擎仿真:Isaac Sim、MuJoCo、Habitat 等可以生成带精确动作标签、带分割和深度通道的数据。仿真的优点是标签齐全、可任意扩增长尾;缺点是 sim-to-real 差异——渲染的光照、材质、摩擦系数与真实世界有系统偏差。世界模型在这里有两种角色:一是直接用仿真数据预训练,再在少量真实数据上微调;二是用真实数据训练一个「修正模型」,把仿真的观测映射到真实分布。
三类数据在实践中往往混用:仿真做冷启动,真实交互做对齐,互联网视频做泛化。数据配比是世界模型工程里最难调的超参数之一,它决定了模型在「像真实世界」与「像训练轨迹」之间怎么取舍。
推理成本:世界模型贵在哪里
世界模型与普通监督模型的一个本质区别是:它在推理时要做多次前向。规划时要 rollout 步、每步多个候选;想象训练时要在潜空间里展开上百步;交互式生成时要维持实时帧率。这决定了它的成本结构与视频生成、大语言模型都不完全相同。
自回归 rollout 的误差累积
重建式模型的 rollout 是逐帧递推:,然后把 作为下一步的输入。误差会沿步数指数累积——这是自回归生成的通病,在语言模型里表现为重复或跑题,在世界模型里表现为物理失真与画面崩溃。误差累积的速率取决于转移核的 Lipschitz 常数:如果模型在状态空间的每一步都把微小输入误差放大,rollout 几十步后就会完全脱离真实轨迹。
缓解办法有三种常见的。第一种是缩短规划视野 ,用短程 rollout 加频繁重规划,把误差交给现实观测重置;第二种是在 rollout 中周期性地接收真实观测做校正(teacher forcing 式更新),代价是让规划不再完全在想象中进行;第三种是训练时直接优化长程一致性,比如对 rollout 的第 步也施加监督,而不只监督单步转移。Dreamer 4 的规模化训练在视频上做的就是这个方向。
视频生成的去噪预算
视频生成式世界模型的成本主要落在去噪步数上。若模型用流匹配、采样步数为 ,每帧生成就是 次完整前向;为维持 24fps、720p 的交互,要么把 压到个位数(少步蒸馏,可参考站内的 扩散模型从零讲起(七)),要么用特征缓存把相邻帧的计算复用起来(可参考 扩散模型从零讲起(八))。Genie 3 这类系统能在实时帧率下运行,背后是少步采样、缓存与并行推理的组合,而不是单靠模型变小。
这条成本曲线与 LLM 推理完全不同:LLM 的瓶颈通常在 KV 缓存的内存带宽和解码时的逐 token 串行链,视频生成的瓶颈在每帧的空间注意力与去噪步数。两者需要的系统优化方向也不同,系列的工程篇会专门对比。
潜空间 vs 观测空间的成本差
用潜空间替换像素可以显著降低成本。假设编码器把 的观测压到 512 维,动力学模型就是一个小型 GRU 或 Transformer,在 512 维上做转移;而生成式模型在 的潜空间 patch 上做注意力,patch 数是 ,序列长度与图像分辨率成正比。在同样分辨率下,潜空间动力学的计算量可以低一到两个数量级。
但这个优势是有条件的:它要求编码器一次性完成,且编码结果可以复用。在交互式场景里,每一帧都要重新编码新观测,编码器本身的开销不能忽略;而当模型需要高保真的视觉输出(比如生成式世界模型),解码或去噪的成本又回来了。这就是为什么重建式模型在控制任务上便宜、在视觉交互任务上并不便宜。
规划时的搜索成本
MPC 的成本是候选数与 rollout 步数的乘积乘以单步前向成本。CEM 迭代 轮、每轮 个候选、每个候选 步,总前向次数就是 。若 、、,一次规划就是两万次单步前向——这在一个控制周期(例如 10ms)内必须完成,对模型的单步延迟提出了很高要求。
这解释了为什么世界模型的推理优化往往不在「单次前向多快」,而在「批量 rollout 如何高效并行」与「能否复用前几步的预测」。前者可以靠把候选放在 batch 维度同时计算;后者可以靠缓存早期步的动力学状态。这些优化属于系统层,与模型结构正交,系列的工程篇会逐项展开。
怎么用:规划、想象训练与策略评估
在想象中规划
给定当前观测 和世界模型,规划的做法是:采样若干候选动作序列 ,用模型 rollout 出对应的未来,用价值函数或任务目标打分,选最优序列的第一个动作执行。这就是 MPC。
具体算法常用 CEM(cross-entropy method)或 MPPI(model predictive path integral)。CEM 维护一个动作分布,每轮采样一批轨迹、保留得分最高的 elite 集、用 elite 更新分布,迭代若干轮后取均值。MPPI 则用指数加权的轨迹平均,权重由轨迹代价决定。两者的共同点是都需要模型支持批量 rollout——这是世界模型推理系统要优化的关键路径。
规划对世界模型的要求是短期准确、对动作敏感。因为每次只执行一步,长程误差会被重新规划吸收;但如果模型对动作不敏感(比如把「左推」和「右推」预测成同一个未来),规划就退化成随机搜索。
在想象中训练策略
Dreamer 的做法不同:它不在推理时规划,而是在训练时把策略和价值函数放进潜空间里学。具体来说,用模型 rollout 出潜空间轨迹,用价值函数给每个潜状态打分,用策略梯度更新 actor,用 TD 学习更新 critic。整个过程中不生成像素,也不与真实环境交互。
这条路线对世界模型的要求是分布一致。如果模型在训练分布内很准、在分布外胡编,策略会利用模型的错误——找到那些「模型认为能拿高奖励、真实世界却不行」的动作。这是 model-based RL 的对抗性失效模式,学术上叫 model exploitation。缓解办法包括:集成多个模型取保守估计、对模型预测加不确定性惩罚、限制策略偏离行为策略的程度。DreamerV3 用 symlog 变换和 robust normalization 提升跨领域稳定性,本质上也是在减少模型误差对策略的放大。
作为仿真器与评估器
生成式世界模型可以当作可交互环境。Genie 3 给一段文本提示,就能生成一个可以持续探索的场景,用户或智能体在里面行动,模型实时生成下一帧。这类系统的价值在于长尾场景的生成:真实世界难以收集的罕见情况(暴雨中的路口、从未见过的房间布局),可以用生成模型合成出来,用于训练或评估。
但作为评估器有一个前提:生成的世界必须与真实世界在决策相关的维度上一致。视觉上逼真但物理上错误的仿真器会给出误导性的评估结论。这也是为什么世界模型的评估不能只看 FVD 这类视觉指标,还要看物理一致性、动作可控性和长程稳定性。
评估:什么样的世界模型算「好」
世界模型的评估比普通生成模型复杂,因为它服务的是决策,而不是视觉质量。常用的指标可以分成四层。
第一层是预测质量。 对视频生成模型,常用 FVD(Fréchet Video Distance)衡量生成分布与真实分布的距离,用 PSNR/SSIM 衡量单帧重建质量。这些指标继承自视频生成领域,能反映保真度,但不能反映物理正确性。
第二层是物理一致性。 物体是否遵守重力、碰撞、守恒;遮挡解除后物体是否还在原位;布料、流体的运动是否符合直觉。这类评估目前主要靠人工或视觉语言模型打分,缺乏统一基准。PhysBench、WorldModelBench 这类工作试图把它标准化,但覆盖面和客观性仍在完善中。
第三层是动作可控性。 给定不同的动作输入,模型是否产生可区分、方向正确的未来。评估方法是构造动作对(左推/右推、加速/减速),看预测差异是否与动作差异一致。这一层对规划最关键,却最容易被忽视。
第四层是长程稳定性。 rollout 几百步后,场景是否崩溃、物体是否漂移、画面是否退化。自回归生成模型普遍存在误差累积,长程稳定性是工程落地的主要障碍。评估方法是固定初始条件、逐步 rollout、测量误差随步数的增长曲线。
这四层指标对应不同的使用场景:规划看第二、三层,想象训练看第一、二层,仿真器看全部四层。一个世界模型在 FVD 上领先,不代表它能用来做决策——这是读世界模型论文时最需要警惕的一点。
一个最小世界模型的代码骨架
把上面的概念落到代码,一个最小可用的世界模型可以写成三个模块。下面用 PyTorch 写一个简化版:VAE 编码观测、GRU 预测潜状态、线性层解码观测。它不是 SOTA,但足以说明数据流和损失结构。
import torchimport torch.nn as nnimport torch.nn.functional as F
class Encoder(nn.Module): def __init__(self, obs_dim=64 * 64 * 3, latent_dim=32): super().__init__() self.net = nn.Sequential( nn.Linear(obs_dim, 256), nn.ReLU(), nn.Linear(256, 128), nn.ReLU(), ) self.mu = nn.Linear(128, latent_dim) self.logvar = nn.Linear(128, latent_dim)
def forward(self, obs): h = self.net(obs) return self.mu(h), self.logvar(h)
class Dynamics(nn.Module): def __init__(self, latent_dim=32, action_dim=4, hidden_dim=128): super().__init__() self.gru = nn.GRUCell(latent_dim + action_dim, hidden_dim) self.prior_mu = nn.Linear(hidden_dim, latent_dim) self.prior_logvar = nn.Linear(hidden_dim, latent_dim)
def forward(self, z_prev, a_prev, h_prev): h = self.gru(torch.cat([z_prev, a_prev], dim=-1), h_prev) return self.prior_mu(h), self.prior_logvar(h), h
class Decoder(nn.Module): def __init__(self, latent_dim=32, obs_dim=64 * 64 * 3): super().__init__() self.net = nn.Sequential( nn.Linear(latent_dim, 128), nn.ReLU(), nn.Linear(128, 256), nn.ReLU(), nn.Linear(256, obs_dim), nn.Sigmoid(), )
def forward(self, z): return self.net(z)
def reparameterize(mu, logvar): std = torch.exp(0.5 * logvar) return mu + std * torch.randn_like(std)
def world_model_loss(encoder, dynamics, decoder, obs_seq, act_seq): # obs_seq: [B, T, obs_dim], act_seq: [B, T, action_dim] B, T, _ = obs_seq.shape h = torch.zeros(B, 128, device=obs_seq.device) z = torch.zeros(B, 32, device=obs_seq.device) recon_loss, kl_loss = 0.0, 0.0 for t in range(T): post_mu, post_logvar = encoder(obs_seq[:, t]) z_post = reparameterize(post_mu, post_logvar) prior_mu, prior_logvar, h = dynamics(z, act_seq[:, t], h) recon_loss = recon_loss + F.mse_loss(decoder(z_post), obs_seq[:, t]) kl_loss = kl_loss + kl_div(post_mu, post_logvar, prior_mu, prior_logvar) z = z_post return recon_loss / T + 0.1 * kl_loss / Tkl_div 是标准的高斯 KL:
训练时观测和动作成对送入,编码器看当前观测得到后验,动力学用「上一步的潜状态 + 上一步的动作」得到先验,损失同时约束重建和 KL。推理时没有观测,只跑动力学先验:
@torch.no_grad()def imagine(dynamics, decoder, z0, action_seq): h = torch.zeros(z0.size(0), 128) z = z0 frames = [] for a in action_seq: prior_mu, _, h = dynamics(z, a, h) z = prior_mu # 推理时用先验均值,不再采样后验 frames.append(decoder(z)) return torch.stack(frames, dim=1)这段代码有一个值得注意的选择:推理时用先验均值而不是采样。采样能产生多样的未来,但会让 rollout 的方差变大;规划时通常需要稳定的预测,所以用均值;如果要评估「多种可能的未来」,则保留采样。这个选择在真实系统里会根据用途切换。
代码骨架省略了很多工程细节:离散潜变量、KL balancing、free bits、观测预处理、动作归一化。这些细节在 Dreamer 的实现里都有,系列的 Dreamer 篇会逐项拆解。
系列路线图
这篇文章建立了概念框架,后续篇目按技术路线展开:
- 第二篇:Dreamer 系列——RSSM 的确定性/随机状态分解、KL balancing、想象训练,以及 DreamerV3 如何用一套超参数跨 150 多个领域。
- 第三篇:JEPA 系列——I-JEPA、V-JEPA/V-JEPA 2、LeJEPA 的表征预测与防坍缩机制,以及它为什么适合做规划的表征底座。
- 第四篇:视频生成式世界模型——Sora、GAIA-1、Cosmos、Genie 的架构与训练数据,以及「视频模型是不是世界模型」的争论。
- 第五篇:可交互世界模型与 WAM——Genie 3 的实时交互、DreamZero 的联合去噪与跨具身迁移,以及动作条件模型如何改变机器人数据经济学。
- 第六篇:世界模型的推理系统——实时生成的系统瓶颈、KV 缓存随帧数增长的问题、高频控制信号的调度,结合 PhysisServe 这类系统的设计。
每篇独立成文,但概念框架沿用本文的定义与分类。读者如果只关心某条路线,可以直接跳到对应篇目;如果要建立完整图景,建议按顺序读。
小结
世界模型是一个在内部表征空间里模拟环境随动作演化的模型。它的价值不在于生成逼真的画面,而在于让智能体在动手之前预演后果——规划、想象训练、仿真评估,三种用法对模型的要求各不相同。
形式化上,它建立在 POMDP 之上,核心是「从观测推断状态、再预测状态如何随动作变化」。按建模空间划分,有观测空间与潜空间两条路;按技术路线划分,有重建式、视频生成式、联合嵌入三条主线,WAM 则是把动作从输入变成输出的一个变体。训练目标从重建加 KL,到扩散/流匹配,再到表征空间 MSE,对应三种不同的归纳偏置。评估不能只看视觉指标,还要看物理一致性、动作可控性与长程稳定性。
理解了这些,再看具体论文时就不会被「世界模型」这个词的模糊性困住:先问它预测什么、动作怎么进入、训练目标是什么、推理成本落在哪里。这四个问题,基本能定位任何一篇世界模型工作。
参考资料
- World Models(Ha & Schmidhuber,NeurIPS 2018,arXiv:1803.10122)
- Dream to Control: Learning Behaviors by Latent Imagination(DreamerV1,ICLR 2020,arXiv:1912.01603)
- Mastering Atari with Discrete World Models(DreamerV2,ICLR 2021,arXiv:2010.02193)
- Mastering diverse control tasks through world models(DreamerV3,Nature 2025,arXiv:2301.04104)
- Training Agents Inside of Scalable World Models(Dreamer 4,arXiv:2509.24527)
- Genie: Generative Interactive Environments(DeepMind,ICML 2024,arXiv:2402.15391)
- Genie 3: A new frontier for world models(Google DeepMind,2025)
- GAIA-1: A Generative World Model for Autonomous Driving(Wayve,arXiv:2309.17080)
- Cosmos World Foundation Model Platform for Physical AI(NVIDIA,arXiv:2501.03575)
- A Path Towards Autonomous Machine Intelligence(LeCun,2022)
- Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture(I-JEPA,CVPR 2023,arXiv:2301.08243)
- V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning(Meta,arXiv:2506.09985)
- LeJEPA: Provable and Scalable Self-Supervised Learning Without the Heuristics(arXiv:2511.08544)
- Video generation models as world simulators(OpenAI Sora 技术报告,2024)
- World Action Models are Zero-shot Policies(DreamZero,NVIDIA,arXiv:2602.15922)
- PhysBench: Benchmarking and Enhancing Vision-Language Models for Physical World Understanding(arXiv:2501.16411)
- WorldModelBench: Judging Video Generation Models As World Models(arXiv:2502.20694)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



