


世界模型从零讲起(十三):把世界拆成物体——Slot Attention 与物体中心的动力学
承接前十二篇:一个被三条路线共同跳过的维度
前十二篇按「预测发生在哪里」把世界模型分成了几条路线:Dreamer 系列在紧凑的潜向量里预测,JEPA 在语义表征里预测,视频生成式模型在 token 上预测,几何式模型则把世界重建成一个显式场景。四条路线有一个共同的默认做法:对整个场景用一个整体表示。RSSM 的状态由两部分拼成,一部分是确定性的循环隐藏向量,一部分是随机潜变量;JEPA 的编码器输出是一张 patch 特征图;视频生成器预测的是整帧像素;NeRF 类方法建的是整个空间的辐射场。
这个默认做法在大多数视频预测任务上没什么问题:一整帧画面本来就是作为一个整体被生成或比较的。但一旦世界模型要服务于机器人动作,整体表示就会暴露三个结构性弱点:
- 无法定点施加干预。 你想让模型回答「如果我把杯子往左推 5 厘米会发生什么」,整体潜向量只会给出「下一帧的画面大约长这样」。它不知道杯子是哪一部分,自然也就无法只改动与杯子相关的状态。
- 无法表达物体数量的组合性。 场景里从 2 个物体变成 5 个物体,整体潜向量的维度不变,变化必须被「挤」进同样的维度里。网络能学会,但没有结构上的保证。
- 无法表达物体恒存。 一个被遮挡的物体,其像素在画面里消失了,整体表示会直接丢掉它;但对规划来说,「杯子还在桌子后面」这个信息恰恰是决定下一步该往哪伸手的关键。
物体中心(object-centric)这条路线就是对这个默认做法的直接反驳:不把世界压缩成一个整体向量,而是把它表示成一袋槽位(slots),每个槽位绑定到一个物体。 它来自视觉里的无监督目标发现(unsupervised object discovery)传统,2019 到 2020 年间在几个独立团队的工作里成形,此后逐步与视频预测、强化学习和机器人规划结合,成为世界模型设计空间里一条独立的分支。这一篇只讲这条线的机制本身:槽位是什么、Slot Attention 怎么把像素分给物体、动力学模型如何在槽位之间预测、以及这条路线在 2026 年扩展到了什么程度。
先给出一个定位。物体中心路线在「重建 / 生成 / 联合嵌入」那套三分法之外,切的是另一个维度:表示的因子化程度。Dreamer 与 JEPA 都可以选择因子化或者不因子化;视频生成与几何重建也可以是物体级的(object-centric NeRF、物体级高斯)。所以这篇不是「第五种路线」,而是一个可以叠加在几乎所有路线上的结构约束。理解这一点,后面讲它的代价时才不会误以为它在和别的路线抢位置。
一个具体反例:整体潜向量在哪里失效
为了讲清楚「为什么要拆」,先给一个最小、可复现的场景。
设想一台桌面机械臂,面前有一个方块、一个圆柱和一个托盘。任务是「把方块放进托盘」。用 Dreamer 式的整体潜向量训练一个世界模型,它可以相当准确地预测「机械臂在动的时候画面怎么变化」。但规划器要在这个模型里搜索动作时,会遇到一个尴尬的事实:模型对「方块」和「托盘」这两个概念没有任何独立的接口。
具体来说,如果你把机械臂的末端状态强行改掉、让模型预测「方块被拿起后画面怎么变化」,整体潜向量无法区分「是方块变了」还是「是机械臂变了」。它能做的是:给定完整的当前画面和动作序列,输出下一个完整画面的潜表示。这种模型只有一个输入口和一个输出口,中间没有任何可被单独读写的部位。
槽位表示把这条路打开:状态被写成 个槽位 ,每个槽位有一个语义明确的角色(方块、圆柱、托盘、机械臂……由模型自己从数据里学出来,而不是人工标注)。于是「把方块向左移」可以写成「只修改绑在方块上的那个槽位」,动力学可以写成「每个槽位的下一步主要由与它有交互关系的那些槽位决定」。反事实查询不再是「整段重新生成」,而是「改一个槽、推一步」。
代价也很清楚:把像素拆成物体这件事本身非常难,而且一旦分解错了,后面所有东西都建立在错误的分组上。这条路线几乎全部的技术难点都集中在「如何可靠地把像素分给物体」以及「如何让分出来的分组在时序上保持稳定」这两个问题上。
形式化:把状态写成一袋槽位
把物体中心世界模型写成概率模型,结构会变得非常清楚。设观察为图像或视频帧 ,槽位集合为 。整套模型被拆成三块,每一块都有明确的职责:
第一块是分解器:把当前帧的像素特征映射成 个槽位。第二块是动力学:给定当前槽位和动作,预测下一组槽位。第三块是解码器:由槽位重建像素。三者可以分别训练,也可以联合训练,这是物体中心世界模型最常见的组织方式。
这里有几个符号值得逐一说清楚:
- 是槽位数,是一个超参数,通常远大于场景里常见的物体数( 到 是常见取值)。多出来的槽位会被训练成「空槽」,负责解释背景或什么都没有。
- 每个 是一个稠密向量( 常在 到 之间),它在语义上不是一个「特征」而是一个「实体状态」。它通常同时携带位置、外观、形状等信息,但模型并不保证把这些信息分开——这是后面「绑定问题」的根源。
- 槽位集合 是无序的:第 3 个槽位并不永远对应某一个物体。这种交换性(permutation invariance)是设计上的要求,它让模型不依赖物体的固定顺序,但也让动力学的学习麻烦了很多。
把这三块与前面几篇对照一下,就能看出物体中心路线的独特性。RSSM 的世界模型是 这一类耦合写法,状态本身就带时间结构;槽位模型则把「把像素解释成什么」与「状态怎么演化」完全分开,感知部分可以是无监督、无动作标签的,动力学部分才需要动作标签。这个分离的意义在于:互联网上多得多的无动作视频可以用来训练分解器,而有动作标签的机器人数据只需要用来训练动力学。
Slot Attention:用竞争性注意力把像素分给物体
Slot Attention 由 Locatello 等人在 2020 年提出(arXiv:2006.15055,发表于 NeurIPS 2020),是物体中心表示里最有影响力的单个模块。它不是完整的世界模型,而是「分解器」这一块的独立组件;后续几乎所有槽位世界模型都把它当作感知前端。
模块的结构
Slot Attention 的输入是一组特征向量 ,通常来自一个 CNN 对整帧的编码( 是特征图中的位置数,比如 )。输出是 个槽位。它的结构可以概括为一句话:槽位是查询(query),像素特征是键与值(key, value),多个槽位在同一个像素上竞争。
整个过程是迭代的。初始化 个槽位,每个槽位从一个共享的高斯分布采样(所有槽位用同一个均值和方差,这正是交换性的来源)。然后重复 轮(常见 到 ):
- 把槽位线性映射成查询 ,把特征映射成键与值 、。
- 计算注意力对数:。
- 在槽位维度上做 softmax:。分母遍历的是 个槽位,不是 个像素。
- 归一化后再按像素求和:。
- 用 GRU 更新槽位:。更新后的槽位参与下一轮。
把第 3、4、5 步合起来,一轮更新可以写成:
这里 、、, 是三组可学习的线性变换, 是它们共同的输出维度。 是「槽位 认领到的像素特征的平均」,平均而不是求和,是为了让槽位更新对物体大小不敏感;GRU 则负责把这一轮的新证据与槽位已有的历史状态融合,使迭代不会在两步之间来回震荡。
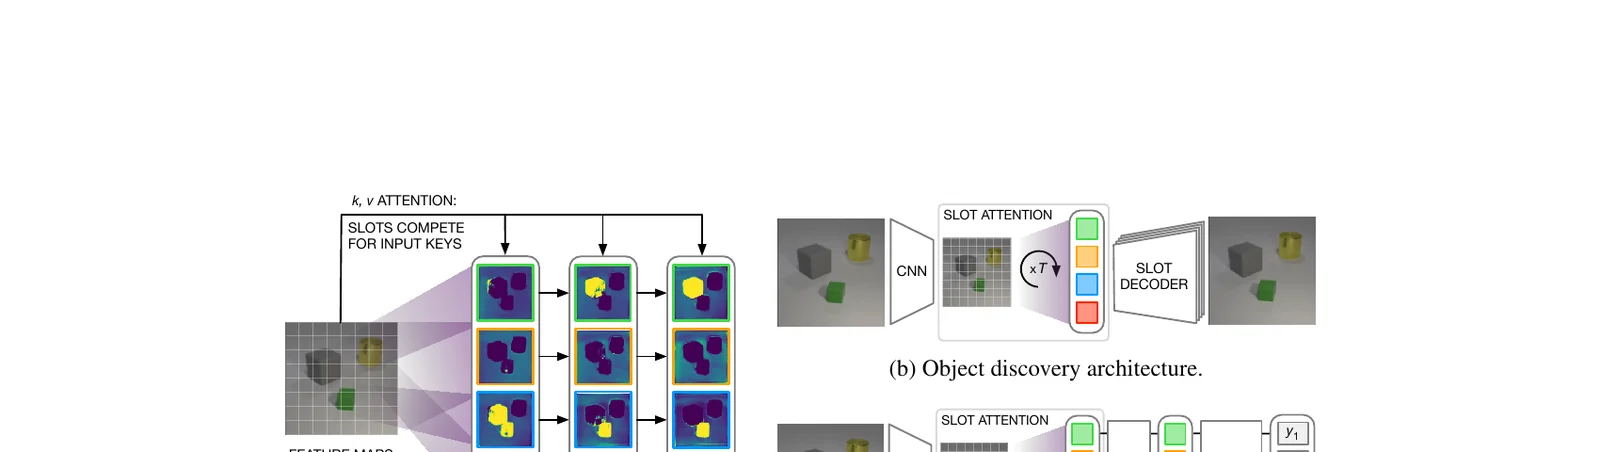
图源:Locatello 等,Object-Centric Learning with Slot Attention(arXiv:2006.15055)图 1。(a) 是模块本身:键与值来自输入特征,查询来自槽位,注意力在槽位维度上归一化,迫使槽位竞争同一批输入;(b) 是把模块接在 CNN 编码器之后、用空间广播解码器重建图像的无监督物体发现架构;(c) 是同一个模块用于集合预测的架构,输出直接与带标签的集合匹配。这张图值得对照后文的公式看:图中标注的「slots compete for input keys」正是前面第 3 步那个方向翻转的直观表述。
第 3 步是整模块最关键的设计,也正是它和标准 Transformer 注意力不同的地方。标准注意力对每个查询在其全部键上归一化:一个 token 的注意力权重之和为 1,不同 token 之间互不影响,谁也不会因为别人多看了某个键而少看。Slot Attention 反过来,对每个键(像素)在其全部查询(槽位)上归一化:一个像素分给所有槽位的权重之和为 1,槽位之间因此必须争夺同一个像素。
这个方向翻转的后果是「竞争」。一个像素的全部注意力质量必须分配给若干个槽位,合起来为 1;如果两个槽位都想「认领」它,它们只能各拿走一部分,而拿得多的一方在下一轮会进一步强化(因为 主要由它占的像素决定),形成正反馈。经过几轮迭代,每个像素会逐渐被某一个槽位垄断。这正是论文所说的「竞争程序」(competitive procedure):槽位通过竞争绑定到物体,而不是通过任何监督信号被告知谁是物体。
第 4 步的归一化还有一个不太显眼但重要的作用。分母 把槽位占据的像素数除掉了,使得一个绑定大物体的槽位和一个绑定小物体的槽位,其更新向量的尺度是相近的。如果不做这一步,大物体对应的槽位会得到范数很大的 ,小物体对应的槽位几乎不动,模型会倾向于只学出「背景槽位 + 几个大块」。
训练:重建损失与空间广播解码器
训练损失用的是重建损失(与 IODINE 相同的重建口径)。但单纯重建会鼓励槽位「平摊」整幅图像的全部信息,而不是各管一块。论文没有额外加对比或多样性项,它依赖的约束来自结构本身:竞争性注意力让每个像素的归属被迫集中,随机初始化的共享分布让槽位之间保持对称,重建的瓶颈则逼迫每个槽位真正携带它所占像素的信息。
解码器是逐槽位的空间广播解码器(spatial broadcast decoder):先把一个槽位向量铺到 的网格上,加上位置编码,再过几层卷积,输出 ——三个 RGB 通道加一个 alpha 掩码。所有槽位共享同一套解码器参数。重组时对 alpha 掩码在槽位维度上做 softmax,再按掩码把各槽位的重建图加权求和,得到最终图像。这个结构有一个直接后果:每个槽位必须独立解释自己那块区域,不能依赖别的槽位「帮它画」。整个重建损失在 的缩放图像上定义;论文明确指出,调好超参数之后,在更高分辨率上评估分割质量可以显著超过表格里报告的数字。
论文在合成数据集上报告了用调整兰德指数(ARI,评估时排除背景标签)衡量的物体发现质量,Slot Attention 在 CLEVR6 上为 ,在 Multi-dSprites 上为 ,在 Tetrominoes 上为 ,与 IODINE、MONet 等当时的分解方法持平或更好,而训练更快、显存更省。但这个成绩的前提是合成场景:背景干净、物体边界清晰、遮挡少。真实照片里的分割边界模糊、遮挡多、物体层次结构复杂,这条路线从第一天起就带着这个鸿沟,2026 年的工作仍然主要在和它打交道。
为什么是注意力,而不是别的方式
物体分解在历史上还有几条其它做法:基于区域的启发式切分(RGB-D 分割、显著性检测)、基于光流把运动一致的区域分组、基于端到端分割头。这些方法的共同问题是都需要某种外部信号——分割模型本身、或连续的、镜头不切换的视频。Slot Attention 的价值在于它把分组变成了一种对整帧的一次性、自监督、无外部模型的操作,并且输出的不是离散的物体 ID 而是可继续微调的连续向量,可以直接接入后续的动力学与规划。
它也带来一个明显的成本:槽位数量固定、且物体数超出 时无法表达。这一点后面「工程细节」一节会展开。
从槽位到动力学:下一步该由谁来预测
分解只解决了「当前帧怎么表示为物体」;世界模型的核心仍然是预测。槽位动力学这条线上有几个代表作,它们各自选择了不同的「谁来预测」这个问题。
SlotFormer:只在槽位上跑一个 Transformer
SlotFormer 由 Wu 等人于 2022 年提出(arXiv:2210.05861,发表于 ICLR 2023),是「槽位 + Transformer」这条主干的代表。它的做法非常直接:先用一个预训练好的视频版槽位编码器(论文用的是 SAVi 类模型)把每一帧编码成 个槽位,然后冻结这个编码器,在其上训练一个自回归 Transformer,输入是最近 帧的槽位(展平成 个 token,每个 token 带时间位置编码与槽位位置编码),预测之后 帧的槽位。
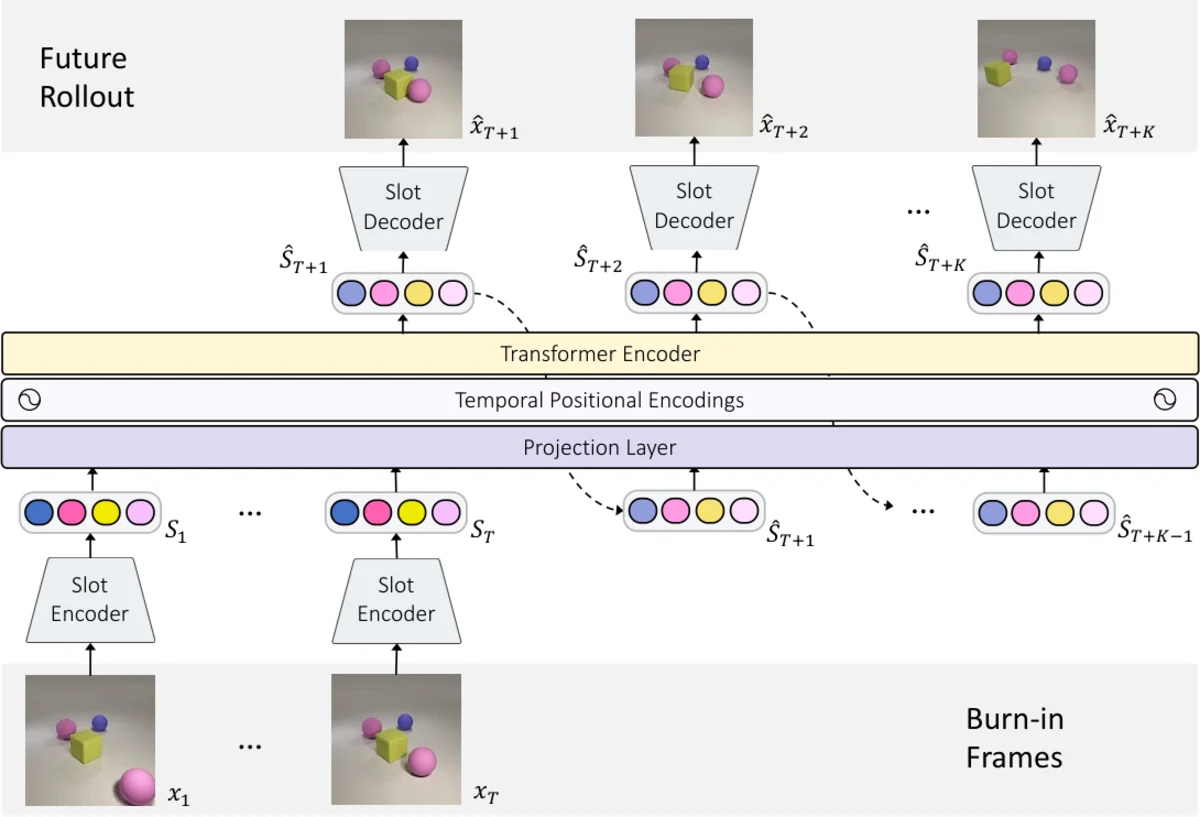
图源:Wu 等,SlotFormer: Unsupervised Visual Dynamics Simulation with Object-Centric Models(arXiv:2210.05861)图 1。左侧是 burn-in 阶段:若干真实帧经冻结的槽位编码器变成 个槽位 token;中间是 Transformer 编码器,时间位置编码标明每个 token 属于哪一帧,槽位位置编码标明它属于哪个槽位;右侧是 rollout:模型输出的未来槽位被送回输入,逐步预测更远的帧,最后由冻结的解码器渲染成图像。整条流水线里只有中间的 Transformer 在动力学数据上训练,两端都是冻结的。
冻结编码器与 V-JEPA 2-AC 的第三阶段在思路上是同构的:大规模数据上训练好的感知不用在少量动力学数据上再调,只训练动力学部分。区别在于,槽位编码器的输出已经是物体级的,所以动力学可以显式地在物体之间选择关注谁。论文在 OBJ3D、CLEVRER 这两个合成数据集上验证了这一点:SlotFormer 能在物体相互碰撞、堆叠之后预测每个物体各自的后续状态,长程 rollout 的视觉质量与槽位精度都优于以往把整体潜表示当作动力学输入的做法。
SlotFormer 的训练细节里有两条值得记住的设计,它们与后续工作的取舍直接相关:
- 训练目标有两项。一项是槽位重建(预测槽位与编码器给出的真实槽位之间的 L2),另一项是图像重建:用冻结的解码器把预测槽位解码成图像,再与真实帧比较。第二项的作用是让槽位保持「外观一致」——如果动力学只优化槽位向量的 L2 距离,预测出的槽位可以在数值上接近却在语义上漂移;解码回图像后,颜色、形状这类属性就不会被随意改动。
- 训练时用模型自己的预测做输入,而不是用真值槽位(teacher forcing)。论文的消融显示,换成 teacher forcing 后 OBJ3D 上的 PSNR 从 掉到 。这与第 3 篇里 V-JEPA 2-AC 的 rollout 损失是同一个道理:训练时要提前暴露在推理时「输入是自己预测出来的」这种分布下,否则长程误差会累积得比预料更快。
槽位动力学并不要求所有物体稠密地互相注意。由于槽位是可寻址的,理论上可以只在「可能发生接触」的槽位对之间做注意力,把一整块 的稠密计算换成稀疏的关系图。SlotFormer 本身用的是稠密注意力池;稀疏化是后续工作展开的方向,下面 World-as-Graph 就是其中一条。
图结构:从「槽位集合」到「槽位之间的关系」
World-as-Graph(arXiv:2609.38927,2026-09)把这一点推得更彻底。它的观察是:槽位模型虽然把场景分解成了物体,但物体之间的关系仍然只是被隐含地编码在槽位向量里。如果一个槽位能表达「一个方块在托盘左边」这类关系,那是训练数据让它恰好如此,而不是结构保证的。
WAG 的做法是把槽位组织成图,并用它给 JEPA 式的表征预测加上关系归纳偏置。它有两个主模块。第一个是关系感知的结构归纳:从物体槽位构造随时间变化的潜图,并设计关系感知的物体掩码策略,让模型在潜空间里学习「物体表征应当由它与邻居的关系定义」;第二个是物体级记忆转移:每个物体维护自己的动态状态,更新时把邻居传来的关系信息与自己的历史记忆结合,从而支持自回归的未来预测。
图结构在本文的语境里有三个设计上的好处:一是关系显式化,规划器可以直接查询「谁在阻挡谁」;二是动态记忆,每个物体可以有自己的历史槽位,图结构让记忆只在有关系的物体间流动;三是当图是稀疏的时候,注意力不必停留在稠密的 两两计算上——但这取决于图有多稀疏、边怎么构造,并不是图结构自动带来的。
粒度的另一种选择:粒子与关键点
槽位不是物体表示的唯一天然单位。DDLP(arXiv:2306.05957,2023-06)把场景表示成一组深潜粒子(deep latent particle),每个粒子带一组可解释的参数,例如位置、尺寸和外观;相比之下槽位是一个稠密向量。论文强调这种表示既紧凑又可解释,并且可以直接对粒子属性做「如果改成这样会怎样」的生成。它的价值在于:粒子的位置是可读写的量,动力学只需预测位置的变化,规划器可以直接对位置做约束;而槽位向量本身是一个黑盒,要让规划器理解「方块在这里」还需要额外的读出层。
这条「显式参数 vs 稠密向量」的取舍与第 12 篇几何式世界模型里的「隐式 vs 显式」是同一个问题,只是出现在物体粒度上。显式表示好规划,但要求更强的先验和更多的监督;稠密表示好训练,但让规划这一端的接口变复杂。
训练目标与监督信号:无标签时如何学会分解
物体中心世界模型最大的卖点是不需要物体级标注,但「不需要标注」并不意味着「不需要监督信号」,而是意味着把监督信号换成了可自监督化的形式。这条线上可用的信号大致有四种,每种都有明确的代价。
重建
最基本的信号来自重建:槽位必须能解码回输入。它同时约束了分解器和解码器,但重建对「槽位到底绑了什么」的约束很弱——你可以让每个槽位都携带整幅图像的一个整体特征,重建依然成功。所以单纯重建容易产出「平均化」的槽位,后续工作往往需要额外的辅助项(对比正则、特征空间重建、掩码监督等)来压住这一点。
运动的平滑性
OPA(Object-centric Prediction without Annotation,arXiv:2105.02799,2021-05)处理的是「视频预测需要稠密分割标注」的问题。它走的是另一条路:不依赖槽位注意力,而是把现成的物体实例分割与光流当作感知先验——分割给出「这一帧里有哪些物体」,光流给出「它们怎么动」,两者合起来就能在没有任何物体标注的视频上构造物体级的自监督信号。感知模型不是冻结的,而是与动力学模型、图像生成模型端到端联合训练,在目标环境上继续微调。论文在堆叠物体下落的视频上验证了这条流水线:给定一帧,模型能预测未来若干帧,物体级的状态预测与像素级生成一起学。
潜动作
当没有动作标签时,物体中心模型可以从相邻帧之间推断潜动作。PlaySlot(arXiv:2502.07600,2025-02)把这条路线与槽位结合:先用槽位分解出物体,再在物体级特征上学习逆动力学(从观察到下一个状态的槽位变化推断潜动作),然后用潜动作驱动前向动力学,得到可控的预测。它的意义在于:这是第 5 篇讲过的 LAPA、Genie 那类潜动作路线与物体中心路线之间的连接点——潜动作在这条路线上天然就是「对某个物体施加的作用」,而不是对整帧施加的全局作用。论文在无标注视频上训练之后,可以把它接进规划,让机器人执行「把某物体推/抓」。
外观与位置的分离
物体恒存问题在 iSEE(arXiv:2610.01201,2026-10)里被直接建模。它的三个组件都针对一件事:槽位在遮挡期间不应该消失。第一个组件把槽位的注意力与它自己的过去作对比,从中检测「物体被挡住」的时刻;第二个组件把每个槽位分成外观流和位置流:外观被冻结用于之后重识别,位置继续演化(模拟「物体还在,只是被挡住了,它在慢慢移动」);第三个组件是一个只从物体重新出现的时刻学习的追踪器,用「重新出现的位姿」作为唯一的训练线索。这是一个很干净的自监督设计:物体恒存不需要被显式标注,只需要「物体回来的时候它还在原来的位置附近」这一条线索。
监督信号的组合方式
实践中,2026 年的多数系统是混合监督的:大规模、无标签视频用于分解器的预训练(重建 + 对比 + 一致性),少量带有动作或位姿的机器人数据用于动力学。物体中心的优势在这一步体现得最明显:由于分解器与动力学是分开训练的,你不需要像端到端方案那样,为了让整条模型有效而要求机器人数据覆盖所有视觉条件。
工程细节:槽位数、坍缩与绑定问题
这部分是这条路线在工程上最容易被低估的一节。下面几个问题在几乎所有槽位实现里都会出现。
槽位数与空槽
必须不小于你希望同时存在的物体数。但 过大会有两个后果:一是多出来的槽位没有被任何像素绑定,它们在动力学里会成为噪声;二是解码器必须学会区分「空槽」与「有内容的槽」,这给重建损失带来了额外的压力。
工程上常见的处理是在重建损失里对空槽加惩罚,或让解码器把空槽解释成背景的一部分。这种做法在合成场景(背景干净)里效果很好,但在真实场景里(背景复杂、材质多样)会让个别槽位被迫承担大量背景像素,从而污染「物体槽位」的语义纯度。这也是后面「表示质量怎么衡量」一节里质量指标会特别区分前景与背景的原因:只测整体重建精度会看不到这类问题。
槽位坍缩
训练早期经常出现的失败模式是槽位坍缩:几个槽位的输出变得几乎相同,每个物体都被「分摊」给多个槽位,而不是被一个槽位独占。它的根源正是竞争机制的另一个面:竞争让强者更强,但如果初始化或学习率让所有槽位的初始归属都太平均,GRU 更新会把它们推向同一个不动点。常见的缓解办法是给槽位间加多样性/对比惩罚,以及在注意力上加入稀疏化(让 更尖锐),迫使像素更快地被单个槽位垄断。也有工作改用在特征空间(而不是像素空间)做重建,避免解码器为了降低像素误差而把槽位推向平均。
绑定问题
绑定问题(binding problem)是这条路线最难缠的底层难点,值得单独说清楚。设想一帧画面里有一个红色方块在左、一个蓝色圆在右。把方块槽位改成「蓝色」,把圆槽位改成「红色」,然后解码,只要每个槽位的外观参数内部还是一致的,解码器仍然输出「蓝色圆在右、红色方块在左」——但两个物体的身份交换了。也就是说,把一个物体的「外观」和「位置」分开表达后,解码器无法保证它们属于同一个物体,除非模型内部还保留某种额外的绑定关系。
这个问题在静态图像上影响不大,因为每个像素的解码都有槽位归属作为桥梁。但在动力学里就非常棘手:如果某个槽位的外观和位置在 时刻属于方块,而到 时刻位置被另一个槽位的更新「抢走」,模型就产生了幽灵交换。前面讲的 iSEE 用「外观流 + 位置流」来显式建模这种分离,正是为了压住这个问题;World-as-Graph 则用图结构把物体身份放进节点身份里。
这些细节有一个共同点:物体中心不是「换个表示然后免费得到结构化能力」,它把结构化的负担从数据侧转移到了表示侧,需要额外的机制去兜底。
表示质量怎么衡量:探测、组合泛化与反事实
「拆得好不好」不是一个能靠肉眼判断的问题。这条路上的质量衡量大体分三类。
分割层面的指标
最直接的是把槽位的归属图当成物体分割,用 FG-ARI、mIoU 这类指标与真值比。它们的优点是标准、可比;缺点也很明显:只在有真值分割的数据集上可用(主要是 CLEVR、Multi-dSprites 这类合成数据),对真实视频几乎没有参考价值。Better Slots, Better Worlds: Representation Quality & Robustness in Object-Centric World Models(arXiv:2608.12078,2026-08)做了一件补充工作:它把无监督的槽位质量指标(FG-ARI、mBO)与下游规划成功率放在一起看,在没有真值分割的离线轨迹上做受控研究,结论是规划成功率与槽位质量正相关,但收益在高质量区间会饱和。这条结论的工程含义是:不必一味追求「完美分割」,超过某个阈值后,对规划帮助有限。
同一篇工作还有两条很实用的发现。第一,槽位绑定得好时,之前那些方法依赖的辅助输入(本体感受 proprioception)与掩码归纳偏置就不再必要——很多人加辅助信息是为了弥补分解不准带来的信息损失,分解准了,这些补丁可以省略。第二,在分布偏移下,槽位绑定良好的物体中心世界模型整体比端到端训练的场景中心模型更稳健,但与基于冻结预训练特征的方案相比仍然有差距——预训练特征本身就是稳健性的主要贡献项。这条结论把物体中心路线与第 3 篇 JEPA 的路线接上了:两者不冲突,槽位分解可以作用在预训练特征之上。
组合泛化
如果槽位真的是物体级的,那么「场景里物体组合换了位置」不应该影响模型对单个物体的理解。这一类测试用训练中没出现过的物体组合来评估,考察的是槽位是否真正承载了可组合的语义。SLATE(arXiv:2110.11405,2021-10)专门针对这一点设计:其解码器在生成时按槽位逐个画,而不是按像素混合,从而可以在测试时自由组合训练中见过的槽位,实现零样本的组合生成。
反事实与规划测试
最贴合世界模型用途的一类衡量是:把模型放进规划环里,看任务成功率。因为物体中心模型的可寻址性,这一类测试可以进一步细化成「只干预某物体后预测是否正确」的定向反事实测试。FORCE(arXiv:2611.00023,2026-10)做的正是把物体分解与反事实编辑连起来。它的结构是:在冻结的自监督特征上用槽位注意力抽出物体,一个关系编码器从一小段观测窗口里为每一对物体推断一个显式的潜关系,一个交互头再把这个潜关系变成力。关键一步是:这个关系潜变量在整个 rollout 期间保持固定,所以一次编辑会持续生效,而不是被模型每帧重新算掉;所有编辑都直接作用在模型自己的量上,不需要映射回模拟器参数。论文在能拿到真值结果的模拟环境里,比较「编辑引发的状态变化」与「模拟器在同样操作下产生的变化」:只用视频信息做编辑时,两者一致度是 到 ;同一套结构改用精确物体位置做训练与评分时,达到 到 。论文据此把差距归因到感知而不是关系动力学——一次反事实编辑能有多准,上限由「能从视频里把物体定位得多准」决定。
这类工作的意义是:它把物体中心从「一个额外的约束」变成了「一个让干预有意义的接口」,并且给出了一个本文反复强调的判断依据——这条路线最终的精度天花板,往往由分解与定位的上游决定。
把槽位接进规划:遮挡、计数与长程推演
物体中心表示在规划里的价值,在遮挡这个场景里体现得最充分。这也是第 12 篇里几何式场景表示与物体中心路线最容易混淆的地方,值得把两者的分工讲清楚。
遮挡下的规划:SCOUT
SCOUT(arXiv:2611.01600,2026-11)解决的问题是:在杂乱的货架或桌面上,前景物体挡住了目标、周围几何和可用的自由空间,只从一个角度看过去的反应式策略会漏掉被藏起来的约束,而穷举搜索又在密集杂乱中算不动。
它的做法分三层。第一层是一个叫 GHOST 的场景表示模块,用物体中心的槽位重建被遮挡的几何:多视角 RGB-D 观测先融合成带不确定性的物体级估计,构成可见槽位;另外维护一组固定容量、初始化为可学习查询的隐藏槽位(每个场景 个),用来表示尚未被观测到、却可能影响规划的对象。两类槽位一起送进一个槽位 Transformer,用自注意力与交叉注意力联合精修,让观测到的物体和潜在假设交换空间上下文;精修后的槽位再经一个基于高斯的模块渲染成占据体。训练时,隐藏槽位会与场景中未被观测到的真值物体做匹配,未被匹配上的隐藏槽位则被监督成「存在概率低」或「零位移」。这正是把本文前面反复说的「物体恒存」落实成数据结构:被挡住的物体不是被丢弃,而是保留在槽位集合里等待规划查询。第二层把槽位转成关系规划状态:谁在挡谁(阻挡层级)、目标是否可见、从货架开口到目标或目标区域的路径是否畅通(可通行走廊)。第三层用一个大语言模型提出结构化的候选动作(对象 + 方向这样的原语),再在学到的动作条件世界模型上做蒙特卡洛树搜索(MCTS),把每个候选动作的后果 rollout 出来打分。
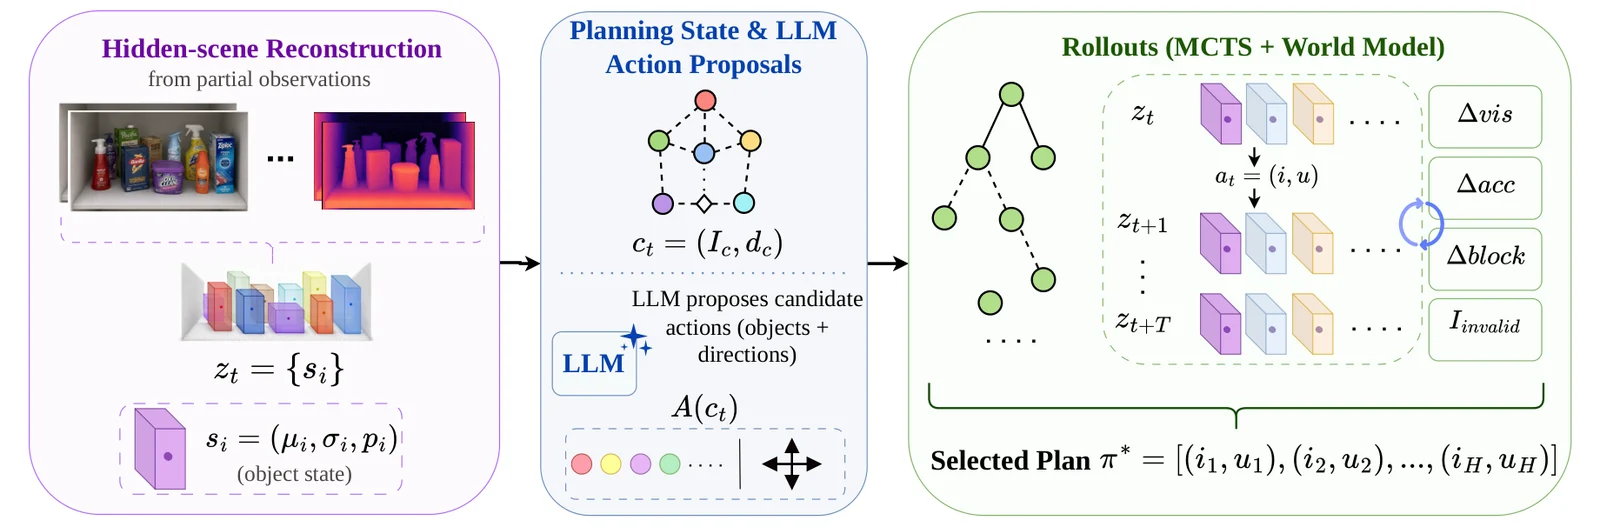
图源:Raj 等,SCOUT: Planning under Occlusion via Object-Centric World Model Rollouts(arXiv:2611.01600)图 1。从左到右依次是:部分观测、GHOST 输出的槽位集合 、由槽位导出的关系规划状态、LLM 给出的结构化动作候选 、以及在世界模型上做 MCTS 展开的 rollout。图中把「感知—关系—搜索」三段画成了一条链,这条链的每一段都由前文某一篇讲过的机制承担,而把它们串起来的正是物体中心那个可寻址的槽位集合。
论文的评测设在密集堆放物体的货架场景,两类任务是 Reveal(先挪开挡路的东西,让目标可见)与 Placement(在杂乱中把物体放到目标区域),每条 episode 最多 个原语动作。在模拟环境里,SCOUT 的分布内平均成功率是 ,最强的基线是 ;多物体场景里对基线的提升最大(Reveal_Multi 与 Place_Multi 各高 个点),单物体任务是 Reveal 的 与 Place 的 ,都比最强基线高 个点。论文还在真实的杂乱货架环境上做了验证。提升集中在多物体场景这一点本身是有信息量的:它说明收益来自「对被遮挡物体及其阻挡关系的推理」,而不是来自一个更强的低层策略。
这个设计是本文几块内容的交汇点:槽位负责把场景拆成可推断的实体,关系层负责把「拆出来的东西之间的关系」变成规划可以直接用的状态,动力学(第 8 篇)负责评估,LLM 负责引导搜索的候选(第 8 篇里提过的「用语言模型缩小动作空间」的改进线)。它的每个组件都由前文某一篇讲过的机制承担,而物体中心表示正是把它们串起来的那一层。
几何重建与物体分解的分工
SCOUT 里「重建被遮挡的几何」需要三维结构,这和几何式世界模型(第 12 篇)讲的是同一件事。两条路线的分工可以这样理解:几何式表示负责「场景在三维空间里的样子」,物体中心表示负责「场景里有哪些独立的东西、它们各自是什么」。前者擅长精细的空间与外观重建,但不天然给出「这是杯子、那是托盘」的对象级语义;后者擅长对象级语义与可组合性,但要重建精确的三维几何往往要借助前者。真实系统里两者经常组合,而不是二选一。
计数与多物体记忆
物体中心表示天然能回答「场景里有几个杯子」这类问题:数一数被有效绑定到杯子的槽位。这个能力在评测里有专门考点:OPIS(arXiv:2609.35052,2026-09)就是为视频世界模型里的多物体记忆设计的一个评估基准,测试的正是这类「模型还能不能记住多个物体各自的状态」。它之所以值得单独做一个基准,是因为这条能力在整体潜向量模型里几乎无法直接测量。
2026 年的进展:数据规模与表示质量两条线
到 2026 年,物体中心世界模型这条线出现了两条明显的扩张方向。这两条线的方向恰好相反:一条往上扩规模,一条往回查质量。
规模:让监督跟得上
ObjectWorld(arXiv:2611.11085,2026-11)把这条线带到数据规模这一层。它提出的中间表示是三维全物体流(3D full-object flow):给物体整个表面(包括被遮挡的部分)上的点分配稠密的三维轨迹。与只跟踪可见表面运动的「可见表面物体流」相比,它的优势是给动力学提供一个完整、可监督的表示,而且对刚体与可变形物体统一适用。为了训练它,论文构建了一个 小时的全物体流数据集(统一到 fps):其中 小时来自物理模拟(聚合了七个机器人操作数据集、约 万条轨迹、 类任务), 小时来自真实视频,靠一套自动化流程标注:先用 Gemini 2.5 Pro 作为视觉语言模型识别目标物体、生成任务描述,并把原始视频切成「一次接触—分离」的原子操作片段;再用 Track4World(以 Depth Anything 3 为骨干)估计相机位姿、把每帧重建到以首帧相机为锚的统一坐标系;目标掩码由 VLM 物体提议加 SeC 传播得到,SAM 3D 据此重建完整物体网格,Any6D 估计初始位姿,FoundationPose 在整段里跟踪位姿;最后在物体规范坐标系里均匀采点,按跟踪到的位姿变换成稠密轨迹。整套流程不需要机器人动作、深度传感器、标定相机或预扫描网格,并配有空间/时间一致性检验与专家复核来剔除低质量标注。
世界模型本身是一个以流匹配式去噪预测流的框架:给定初始 RGB-D 观测和任务描述,Qwen2.5-VL 提取任务条件的视觉语言特征,一个 PointTransformer V3 编码重建出的物体与场景几何,两路特征融合成物体 token 并在自注意力里精修,物体查询再通过交叉注意力读取场景与语言上下文,最后在含噪流与扩散时间步的条件下,由流预测头输出物体完整表面上的稠密三维轨迹。论文在真实机器人上验证了跨新场景、新本体的下游操作能力。
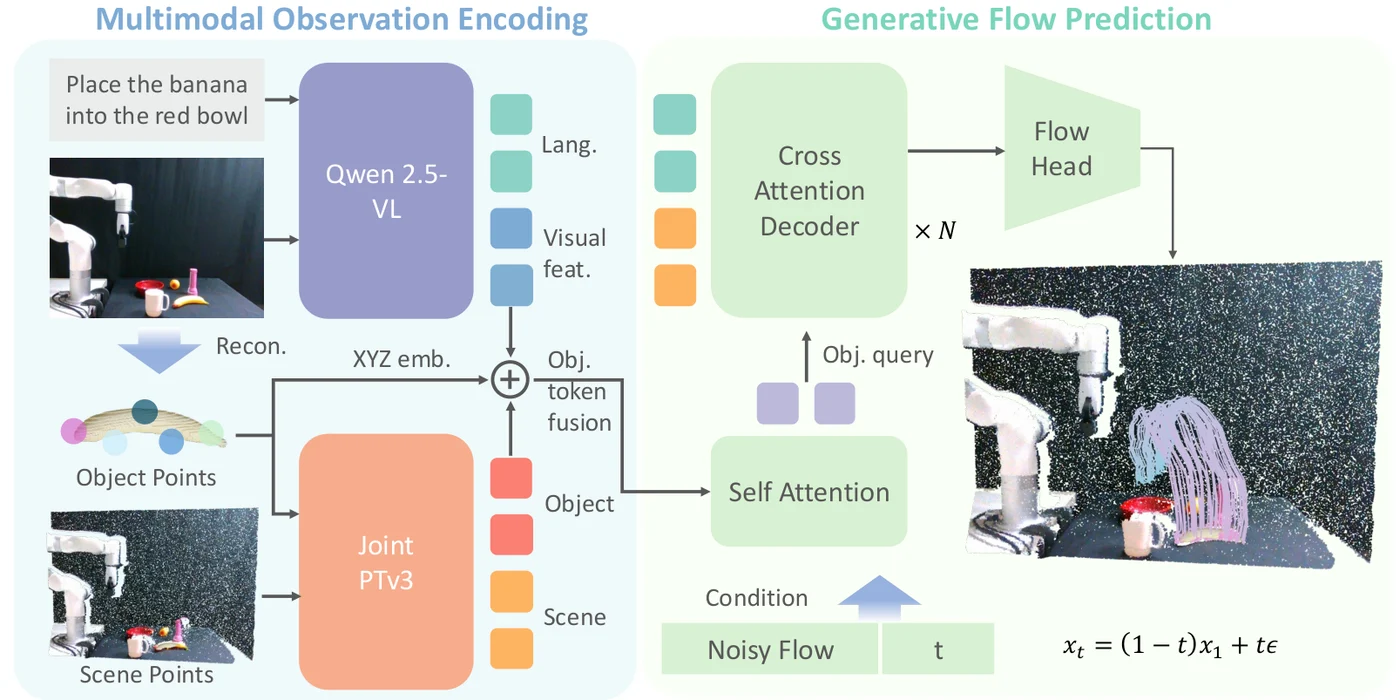
图源:Chen 等,ObjectWorld: Scaling Object-Centric World Models with A Large-Scale 3D Full-Object Flow Dataset(arXiv:2611.11085)图 3。上半部分是观测编码:语言分支走 Qwen2.5-VL,几何分支走 PointTransformer V3,两路融合成物体 token 后做自注意力;下半部分是生成:物体查询通过交叉注意力读取场景与语言上下文,并以含噪流与扩散时间步为条件,由流预测头输出物体完整表面上的三维轨迹。注意它输出的不是「槽位向量」,而是显式的点级运动——这正是它与本文前半部分那套潜空间槽位的根本差别。
这条路线值得注意的地方在它选择了「有监督的中间表示」而不是「无监督的分解」。前面「训练目标」一节说过,物体中心的卖点是不需要标注;ObjectWorld 的取舍是:如果这种表示本身可以在规模上被标注(借助模拟与流水线),那它带来的可监督性和可迁移性可能比「完全无监督分解」更实际。这是这条线从 2020 年到现在最显著的价值取向变化。
语义:从「实例槽位」到「语义槽位」
第二条线要回答的是:槽位只说明「这里有一个东西」,没有说明「这个东西在任务里扮演什么角色」。Beyond Instance Slots: Semantically Rich World Models for Physical Interaction Planning(arXiv:2608.22294,2026-08)提出的 SR-WM 把这个缺口补上:它不再只用实例槽位,而是围绕五个功能角色组织世界模型——夹爪(gripper)、目标(target)、目的地(goal)、关系(relation)和阶段(phase)。视觉实体编码器先从预训练的 patch 特征里提取「软实体假设」(分割掩码只是可选先验,不是必需的输入),一个角色绑定器再把假设映射到任务特定角色上,动作条件的动力学模型预测角色之间的转移,并附带细粒度语义(抓取/接触、谓词成立、关系保持、夹具状态、阶段切换)。这一套角色状态直接支撑下游的多候选动作生成、阶段感知的候选重排序和违规感知的后缀重采样。
这个方向的含义是:对规划而言,「抓玻璃杯」和「抓橡胶球」的差别不只在物体类别,更在它在当前任务里扮演的角色——同一个物体在「递给你」和「放到碗里」两个任务里,规划要看住的属性不同。SR-WM 把这种差别写进了状态结构里,而实例槽位本身没有这个自由度。
稀疏与残差:只预测变化的东西
第三条不太显眼但有实用价值的线是只建模变化。Modeling What Changes: Sparse, Residual World Models for Object-Centric Manipulation(arXiv:2609.02046,2026-09)指出,整体式世界模型每一步都在重算整个状态,把计算量花在「重预测那些本来就没动的静态多数」上,还顺手给它们注入误差。它的替代方案由两个部件组成:一个逐物体的变化门(change gate)判断哪些物体这一步真的会动,一个残差增量头(residual delta head)只对被门标记的物体施加扰动,其余槽位原样透传。
论文在 MuJoCo 桌面推物仿真(物体数从 3 扩到 8)上给出的数据比较具体:在 8 个物体时,稀疏残差模型预测下一状态位姿的精度是稠密 MLP 的 到 倍,参数量只有后者的 到 ;变化检测的 F1 维持在 到 ,而稠密基线已经退化到无法判决;物体数变化时零重训可迁移(F1 保留 ),只用四分之一数据就能达到全量数据约 的精度。自回归 rollout 里它的误差累积远低于稠密模型,基本贴着「完全不动」这条下界走。最有意思的是规划实验:只做预测的模型放进采样式规划器里失败,但稀疏模型在按规划器实际访问的状态做了特征化与训练之后开始能规划(成功率 ),稠密单块模型在所有随机种子上都是零。
这条线对本文的账本讨论有直接意义:它把动力学从「每帧对全部槽位重算一遍」变成「只对少数槽位做增量更新」,和 KV 缓存里「只计算新增 token、复用已有缓存」的思想在结构上是同构的(第 9 篇讨论过世界模型的账本)。
与系列其他路线的接口
把物体中心表示放回整个系列,接口关系可以整理成下面几条:
| 对接路线 | 接口 | 说明 |
|---|---|---|
| Dreamer / RSSM(第二篇) | 槽位可替代 RSSM 的整体状态 | RSSM 的状态被换成 个槽位,动力学从整体转移矩阵变成物体间交互 |
| JEPA(第三篇) | 分解可作用在冻结的预训练特征上 | Better Slots 的结论表明预训练特征本身是稳健性主因;V-JEPA 2-AC 的动作条件预测器也可在槽位特征上训练 |
| 视频生成(第四篇) | 生成按物体逐个进行 | SLATE 风格的「按槽位画」提供了组合生成;与 FORCE 的反事实编辑属于同一动机 |
| 几何式(第十二篇) | 几何重建 + 物体分解互补 | SCOUT 展示了「用物体槽位推断遮挡几何」的用法 |
| 潜动作(第五篇) | 潜动作可以定义在物体级 | PlaySlot 把潜动作作用在物体槽位上而非整帧 |
| 规划(第八篇) | 槽位是可寻址的规划状态 | 对「某个物体」的干预与打分有了确定的落点;MCTS 评估对象可以是物体级的状态转移 |
| 系统账本(第九篇) | 稀疏残差动力学与增量更新 | 与「只对变化部分做计算」的思路同构 |
这张表想说明的是,物体中心在这套系列里不是一个平行的「第十三条路线」,而是一个横切的表示选择。大多数路线都可以选择是否在其上加这一层,而加与不加的取舍,基本都落在本文反复强调的那几条:分解的可靠性、绑定的稳定性、以及它带来的推理与训练成本。
推理账本:槽位注意力的成本结构
物体中心世界模型的推理成本与前面讲的整体模型有显著不同,值得单独算一遍。以「每一帧 个特征位置、 个槽位、 轮迭代、每轮两次线性层」的典型配置为例:
- 分解的成本:每轮计算 的注意力矩阵(约 2000 个元素),在 轮里重复三遍,加起来不到 1 万个乘加。相比一个标准 Transformer 层( 个 token 的稠密自注意力是 万对),槽位注意力反而更便宜,因为注意力方向是「像素 × 槽位」而不是「像素 × 像素」。
- 动力学的成本: 个槽位 token 上的自注意力,即 对,比视频 token 的动力学小得多。这是物体中心在长时空推演上天然占优的地方:状态规模随物体数线性增长,而不是随像素数增长。
- 解码的成本:如果是逐像素解码,成本回到像素规模;如果是「按槽位逐个画」的生成式解码,成本是 次条件生成,按物体数缩放。
这三条算下来,物体中心路线在动力学这一块是明显便宜的,在分解与解码这两块不算便宜。所以它在实际系统中通常被放进「感知——动力学——规划」这条链的一个环节,而不是当作一个完整的端到端生成模型。这和第 7 篇讲部署账本时的结论是一致的:表示选择决定了哪一段成本被搬到哪一段,而部署决策取决于哪一段处在延迟的临界路径上。
从另一个角度看,这种成本结构恰好适配了机器人控制的典型特点:感知可以略慢(相机帧率 10–30 fps),动力学与规划必须在每一帧内的预算里完成多次 rollout。物体中心把昂贵的部分放到感知侧,把便宜的部分放到动力学侧,方向是对的。
局限与已经显露的边界
这条路线的问题也相当具体,不该被「结构化」的美好图景遮住:
- 真实视觉的分解质量不足。 从 2020 年到现在,Slot Attention 类方法在合成场景上的改善不小,在真实、杂乱、多材质、强遮挡的场景里仍然脆弱。ObjectWorld 之所以转向可监督的全物体流表示,正是对这一点的直接回应。
- 物体恒存与遮挡仍是硬骨头。 iSEE 用三个组件专门处理遮挡,说明在无标签的情况下让槽位「不消失」需要结构性设计,而不是靠训练自然得到。
- 绑定问题没有根本解决。 外观与位置的分离在动力学里仍会制造错误的身份交换;目前的方案多是「加约束、加结构」,而不是从根本上保证身份一致性。
- 槽位数是硬约束。 物体数动态变化(物体进出场景、堆叠成新物体)时,固定 的表示要么浪费槽位,要么无法表达;ObjectWorld 的「全物体流」把表示换成了稠密的表面轨迹,某种程度上也是回避了「槽位数」这个结构约束。
- 无监督的「卖点」正在被稀释。 2026 年的几条规模线都在引入更多监督(可标注的中间表示、语义标签),这说明「完全不靠标注就能得到可规划的世界模型」在真实场景里还没有被证明是足够实用的路径。
这些局限不是否定这条路线,而是把它定位清楚:物体中心更像是一种结构性的先验,它在分解可靠、动力学需要结构化、规划需要可寻址这三件事同时重要时最有价值;在只需要高质量视频生成、或者只需要一个大而全的语义表征时,整体表示仍然是更直接的方案。
小结
物体中心世界模型把「世界由物体组成」这个直觉写进了结构里。Slot Attention 用竞争性注意力把像素分给槽位;槽位编码器与动力学分离,使分解可以在无标签视频上预训练,动力学只需要少量带动作的数据;SlotFormer、World-as-Graph 这类工作在槽位集合甚至图结构上做预测;PlaySlot 把潜动作接到物体级,iSEE 用外观/位置双流处理遮挡,SCOUT 把槽位接进遮挡下的 MCTS 规划;ObjectWorld 与 Beyond Instance Slots 分别从数据和语义两侧扩展表示;Better Slots 的受控研究则给出了一条明确的工程结论:绑定质量比单纯的「拆不拆」更重要。
放到整个系列里看,它提醒了一件事:世界模型的设计空间里,表示的结构与预测的载体是两个可以独立选择的维度。前十二篇主要在讲后者,这一篇补上的是前者。
参考资料
- Object-Centric Learning with Slot Attention(Locatello 等,arXiv:2006.15055,2020-06)
- Object-centric Video Prediction without Annotation(OPA,arXiv:2105.02799,2021-05)
- Illiterate DALL-E Learns to Compose(SLATE,arXiv:2110.11405,2021-10)
- SlotFormer: Unsupervised Visual Dynamics Simulation with Object-Centric Models(arXiv:2210.05861,2022-10)
- DDLP: Unsupervised Object-Centric Video Prediction with Deep Dynamic Latent Particles(arXiv:2306.05957,2023-06)
- PlaySlot: Learning Inverse Latent Dynamics for Controllable Object-Centric Video Prediction and Planning(arXiv:2502.07600,2025-02)
- Better Slots, Better Worlds: Representation Quality & Robustness in Object-Centric World Models(arXiv:2608.12078,2026-08)
- Beyond Instance Slots: Semantically Rich World Models for Physical Interaction Planning(arXiv:2608.22294,2026-08)
- Modeling What Changes: Sparse, Residual World Models for Object-Centric Manipulation(arXiv:2609.02046,2026-09)
- World-as-Graph: Relational World Modeling Through Latent Space Graphs(arXiv:2609.38927,2026-09)
- iSEE: Object Permanence Through Self-Supervision(arXiv:2610.01201,2026-10)
- FORCE: Factorized Object Relations for Counterfactual Editing in Video World Models(arXiv:2611.00023,2026-10)
- SCOUT: Planning under Occlusion via Object-Centric World Model Rollouts(arXiv:2611.01600,2026-11)
- ObjectWorld: Scaling Object-Centric World Models with A Large-Scale 3D Full-Object Flow Dataset(arXiv:2611.11085,2026-11)
- OPIS: An Input-Grounded Benchmark for Multi-Object Memory in Video World Models(arXiv:2609.35052,2026-09)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



