


世界模型从零讲起(四):视频生成式世界模型——Sora、GAIA-1、Cosmos 与 Genie,画面预测如何变成可交互的世界
一条分岔路:预测应该发生在哪里
系列的前三篇分别在三个位置建起了「预测」这件事:Dreamer 在 RSSM 的潜状态里预测、JEPA 在冻结编码器的表征空间里预测、而第一篇里列出的第三条路线——视频生成式——则把预测直接放到画面本身。用一个统一的形式化语言说,前两条路线预测的是一个低维状态 ,第三条路线预测的是观测 的每一个像素 token。
这个选择看起来「更原始」,但恰恰是过去两年动作最大的一条线。Sora 在 2024 年 2 月用一句「video generation models as world simulators」把争论推上台面;Wayve 的 GAIA-1 与 GAIA-2 把自驾场景当成生成任务;NVIDIA 的 Cosmos 把世界基础模型做成一套带 tokenizer、预训练模型与后训练流程的平台;Google DeepMind 在 2024 年 2 月的 Genie 和 2025 年 8 月的 Genie 3 则试图让生成出来的画面可以被按键操控、并且实时播放。它们风格差异极大,却共享同一组工程问题:怎么把视频压成能建模的 token、怎么在长度上撑住、怎么以几十毫秒的节拍把画面推给用户。
本文不重复第一篇的定义与路线图,而是沿着「一套视频世界模型从输入到输出要经过哪些部件」的顺序,把这些部件逐个拆开,并在每个部件上回答同一个问题:这个设计对推理成本意味着什么。最后一节会回到那条一直悬而未决的争论——生成逼真的画面,等价于理解世界吗——并给出这条线目前能拿出的证据。
如果你对扩散模型本身还陌生,建议先读站内的 扩散模型从零讲起(一):从 DDPM 的加噪/去噪到 DiT 与 Flow Matching;JEPA 与 Dreamer 两条对照路线分别见 世界模型从零讲起(二) 与 (三)。
为什么视频生成可以冒充世界模型
先把「自监督地拟合 」与「建模状态的转移」之间的关系说清楚,否则后面所有架构讨论都会悬空。
一个视频可以写成帧序列 。任何视频生成模型都在拟合这个序列的联合分布:
其中 是条件——文本提示、第一帧图像、驾驶动作序列都算。只要生成器在给定「过去」之后对「未来」的条件分布足够准确,那么它在给定当前观测 与打算施加的动作 时预测出的下一帧,就等价于一个在像素空间上定义的转移模型 。这正是第一篇里「生成式世界模型」的定义,只不过状态取成了整幅画面。
因此视频世界模型与视频生成模型在数学上没有分界线,分界线在用法上:当条件 里包含动作,而且这个条件能被外部实时修改时,模型就从「一次性出片」变成了「可被驱动的仿真器」。Genie 系列的核心贡献就是把这条从「生成」到「交互」的路走通了——用户每一次按键都改变条件,模型必须在下一次前向里立刻反映出这个改变。
还有一个不显眼的前提值得提前指出:视频世界模型默认观测的维度足以推断状态。真实世界里的状态包括被遮挡物体的位置、其它车辆的速度与意图,而这些都不完全体现在当前一帧像素里。视频生成模型处理这件事的方式是扩展上下文——把历史帧一并作为条件,让模型从轨迹中推断运动。这解释了为什么「上下文长度」在这条路线上是第一等公民,而 Dreamer 只需要一个固定维度的潜状态就够了。
压缩表征:从像素到离散 token 再到潜空间
一段 720p、24 帧每秒、时长一分钟的视频是 个像素值,约 40 亿个分量。直接在这个空间上做 Transformer 的注意力不现实,所以这条线上的每个系统第一步都是同一个动作:学一个视频 tokenizer,把视频压到几百到几万倍的压缩率。
tokenizer 的两条分支
Cosmos 的报告把 tokenizer 分成连续与离散两类,这个分类非常好用,后面提到的所有系统都能落进去。
离散 tokenizer 用一个 VQ-VAE(Vector-Quantized Variational AutoEncoder):编码器输出每个时空小块的特征向量,再在码本中查表,把它替换成码本中最接近的编号。整段视频于是变成一串整数:
其中 是码本第 个向量, 是码本大小。优点是输出是离散整数,可以直接套用语言模型那一整套(交叉熵、top-k 采样、KV 缓存),而且码本很小的时候还可以做并行预测;代价是量化误差,重建细节会有损失。
连续 tokenizer 则把编码器输出直接当作高斯分布的均值与方差,采样得到潜变量 ,与潜空间扩散模型中 VAE 的角色相同。优点是没有离散化误差、重建更真实;代价是下游必须使用扩散或流匹配这类连续生成器,不能直接复用语言模型的采样工具。
空间、时间、时空压缩率
tokenizer 的压缩率通常写成三轴的形式。空间压缩率 决定把 的图切成多少个小块;时间压缩率 决定多少个相邻帧合成一个潜帧。Cosmos 提供了 、 与 等几档:以 为例,每 8 帧压缩成一个潜帧,每帧的空间边长缩小 8 倍;一个 的视频按这个比例,每帧的 token 数是 。
下面是 Cosmos Tokenizer 的整体架构与编码/解码后的数据流:
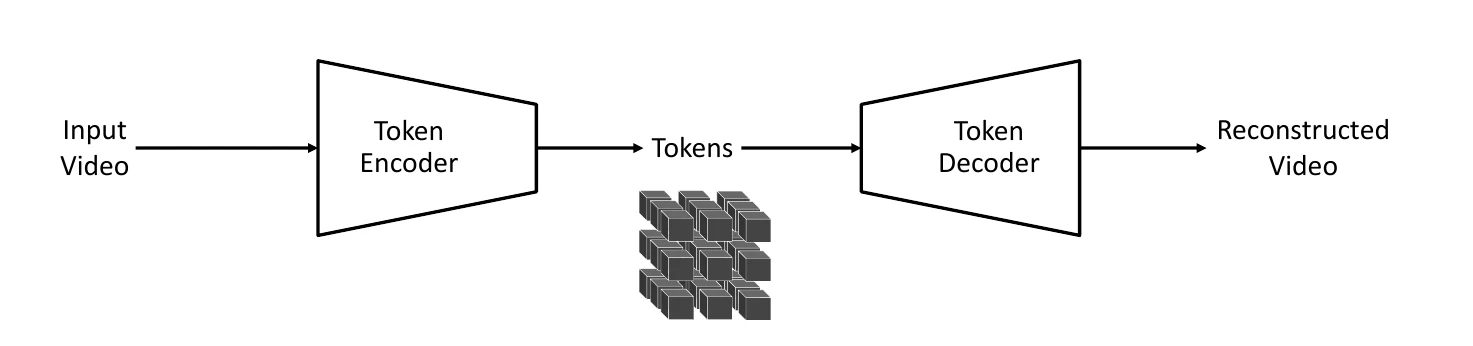
图源:NVIDIA Cosmos World Foundation Model Platform for Physical AI(arXiv:2501.03575)Figure 6。输入视频先被切成固定时长的小段,编码器把它变成连续的潜特征或离散编号,解码器负责把 token 还原成视频;上下两条通路分别对应解码的连续潜变量与量化索引。
压缩率的选择是一个多目标权衡,至少有三条约束同时起作用。
重建质量。压缩得越狠,模型需要「编造」的细节越多,生成画面的保真度越难保证。Cosmos 报告里比较过同一 tokenizer 在不同压缩率下与已有 tokenizer 的差距,给出的结论是:在 的压缩率下它达到了当时最好的重建指标,而即使把它推到 (四倍更大的压缩),图像质量仍常与既有工作在 时相当。这是架构与训练数据共同带来的收益,不是压缩本身不需要代价。
序列长度。压缩率直接决定了 Transformer 要看多少个 token。以 计算,一分钟 24 fps 的视频有 1440 帧、180 个潜帧,每帧 14400 个 token,总计约 259 万个 token。即使模型能线性地处理上下文(每个新 token 的 KV 缓存是常数),光是存 KV 缓存就要按这个量级估算显存——这一点在最后一节会具体算。所以时间压缩率是这条线上最关键的一个旋钮之一。
因果性。视频世界模型要在流式场景里一帧接一帧地预测,tokenizer 本身必须是因果的:第 个潜帧只能看到前 个潜帧。Genie 用的是因果的时空 Transformer(称为 STViViT),Cosmos 的因果 tokenizer 也是出于同一动机——「与物理 AI 系统处理流式数据的方式对齐」。非因果 tokenizer 在做离线视频生成时表现更好,但一旦接入交互闭环,就必须换成因果版本,否则一个「未来」帧会泄漏信息到「过去」。
一个被低估的细节:token 里装了什么
tokenizer 学到的是「重建视频所需要的」特征,而不是「推理世界所需要的」特征。两者经常不一致:重建需要丰富的纹理信息,推理需要的是物体的身份、位置与运动。两个经典做法用来缓解这个错位。第一,像 GAIA-1 那样在 tokenizer 的训练目标里加入感知相似度与语义蒸馏,让码本空间更偏向有语义的结构;第二,像 Cosmos 那样把离散 tokenizer 的码本维度压低(它用的离散 tokenizer 潜维度为 6、连续 tokenizer 为 16),用「瓶颈」迫使每个 token 承载更高层的信息。第二条的本质是把压缩当作一种归纳偏置:瓶颈越小,token 越不可能只是复述像素。
因果化的时序建模:从 UNet 扩散到 Transformer 主干
tokenizer 之后是主干网络,它要回答的问题是:给定前 个潜帧与条件 ,如何采样出第 个潜帧。
GAIA-1:把世界建模写成「下一个 token 预测」
Wayve 的 GAIA-1 于 2023 年 9 月发布,是这条线上最早明确「世界模型 = 自回归 token 预测 + 视频解码」的系统之一。它由三个部件组成:图像 tokenizer、自回归世界模型、视频扩散解码器。
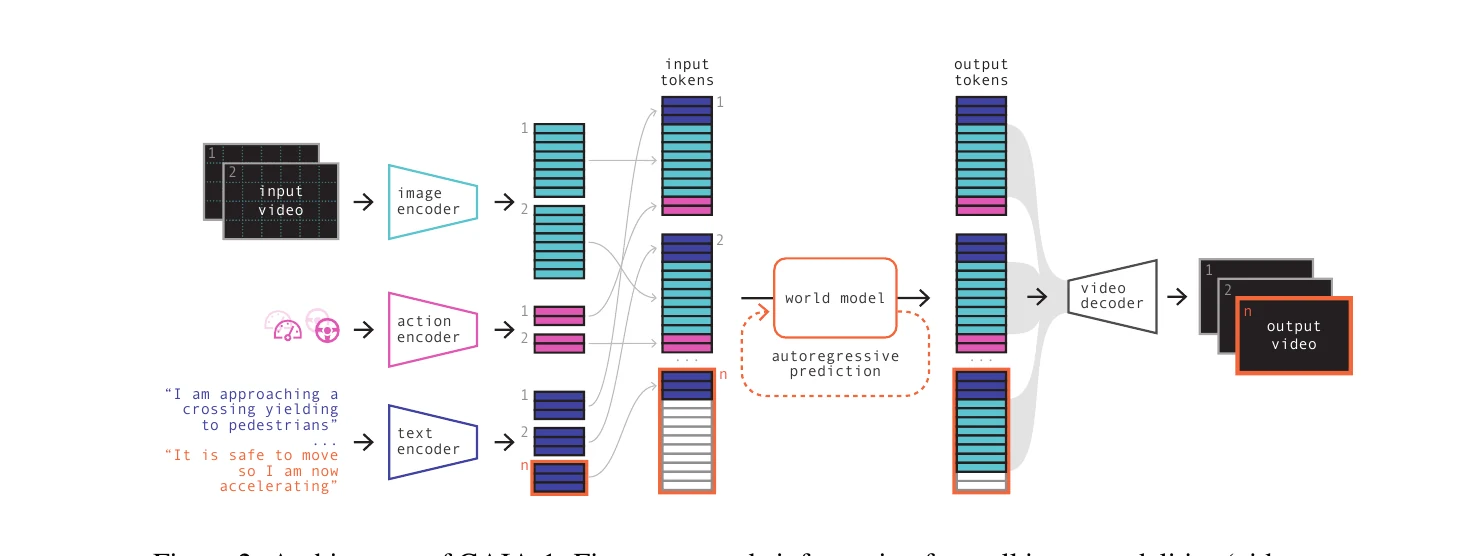
图源:GAIA-1: A Generative World Model for Autonomous Driving(arXiv:2309.17080)Figure 2。左侧三类输入(图像、文本、动作)被编码为统一的 token 序列,中间的自回归 Transformer 逐帧预测下一帧的图像 token,右侧的视频扩散解码器把 token 还原为像素,并做时间上采样。
论文报告的配置让这条流水线的成本结构一目了然:图像 tokenizer 0.3B 参数,把 的图切成 个 token(码本 8192),折合每帧的比特压缩比约 470;世界模型 6.5B 参数,在 6.25 Hz 的 26 帧序列上训练——也就是每 4 秒采样一次状态;每个时间步的文本编码占 32 个 token、动作占 2 个 token,因此序列长度是 。视频解码器 2.6B 参数,负责把粗粒度的 6.25 Hz 序列在时间上上采样到 12.5 Hz。
这个配置里有三个决定值得记住,后续所有系统都在它们的基础上做文章。
图像 tokenizer 是逐帧的,不是时空的。 GAIA-1 把每帧独立切成 576 个 token,时间信息完全交给世界模型去学。这样做的结果是世界模型要自己维护跨帧的运动信息,但 tokenizer 的解码器可以复用图像模型;代价是时间压缩率为 1,序列长度随帧数线性增长。
世界模型工作在低帧率。 在 6.25 Hz 上做自回归预测,意味着模型只需要描述「0.16 秒后的样子」,运动在潜空间里被时间压缩了。低帧率让每帧的预测负担变轻,但帧间的细节变化也要靠扩散解码器补出来。
解码器是独立的、更贵的部件。 世界模型只输出 576 个 token,最后把 token 变回 的清晰画面、并做时间上采样,全部由 2.6B 参数的视频扩散解码器完成。这个拆分让算力的分配非常清晰:世界模型是「推理器」,解码器是「渲染器」,两者的运行频率、并行方式与优化手段完全不同。站内 世界模型从零讲起(一) 里对这套「先潜后渲染」的拆解已有形式化讨论。
GAIA-1 的另一个实验结果对本文后文很重要:它在 0.65M 到 650M 参数的小模型上拟合出与语言模型同形的幂律 ,并用它预测了 6.5B 模型在留出验证集上的交叉熵。这说明「视频 token 的下一 token 预测」与语言建模一样受参数与算力的幂律支配,因此这条路线的可扩展性有一个可以测量的依据,而不只是直观判断。
Sora 之后:时空小块与 Transformer 扩散主干
2024 年 2 月,OpenAI 发布 Sora 时给出的是一个高层技术描述:在可变时长、可变分辨率的视频上训练,把视频视为由时空小块(spacetime latent patches)组成的序列,用一个扩散 Transformer 生成。它没有公开权重、参数量或训练细节,因此本文不引用任何具体数字。但这个描述在社区里被普遍理解为:视频被 tokenizer 压到潜空间之后,每个潜帧被切成固定大小的小块,整段视频变成一条由「帧索引、空间位置」共同定位的 token 序列,主干是 Transformer。
这套表述之所以重要,是因为它把 Diffusion Transformer(DiT)确立为视频生成的主流主干。DiT 在 2022 年末的论文里最早被提出用于图像,用一个 Transformer 替代 UNet 作为扩散的去噪网络,并证明它在更大的算力下表现更好;到了 2024 年,CogVideoX、Wan、HunyuanVideo 等开源模型几乎都采用 DiT 系列主干。站内 扩散模型从零讲起(九):架构演进 对 UNet 到 DiT 的演进有完整拆解。
Transformer 主干带来的最直接影响是:视频生成第一次变成了一个「可以像语言模型一样被优化的 Transformer 推理问题」。KV 缓存、分页显存管理、张量并行、上下文并行——这些在 LLM 推理中已经沉淀下来的技术,可以原样迁移到视频扩散推理上。这也是本文把推理系统视角放进来的原因。
双向与因果:扩散模型的两副面孔
标准 DiT 视频扩散模型有一个与交互式世界模型冲突的特性:双向注意力。训练时,整段去噪序列里的每个 token 都能看到同一时刻所有帧的所有 token,因此每一帧都能利用「未来帧」的信息。这在一次性生成整段视频时是优点——全局一致性好;但在流式交互里是致命的——用户想要的是「下一帧」,而模型要求「整段视频」。
因果化有两条主要做法。
第一条是 扩散强制(Diffusion Forcing):训练时每个帧块(chunk)拥有独立的时间步,模型学会在「过去的块已经干净、未来的块仍然带噪」的条件下预测当前块。这样同一个主干既能做整段并行生成,又能做逐块的流式生成,后者只需要前一块的干净结果作为条件。
第二条是 把双向模型蒸馏成因果模型,MIT 与 Adobe 的 CausVid(2024 年 12 月)是典型代表。它的做法是在双向 DiT 的注意力里换成块级因果掩码——当前块内的 token 互相双向可见,但看不到未来的块:
其中 是 token 索引, 是块大小。训练时沿用扩散强制的逐块独立噪声步,推理时先按因果方式逐步生成潜帧,再把每块的 KV 追加进缓存。
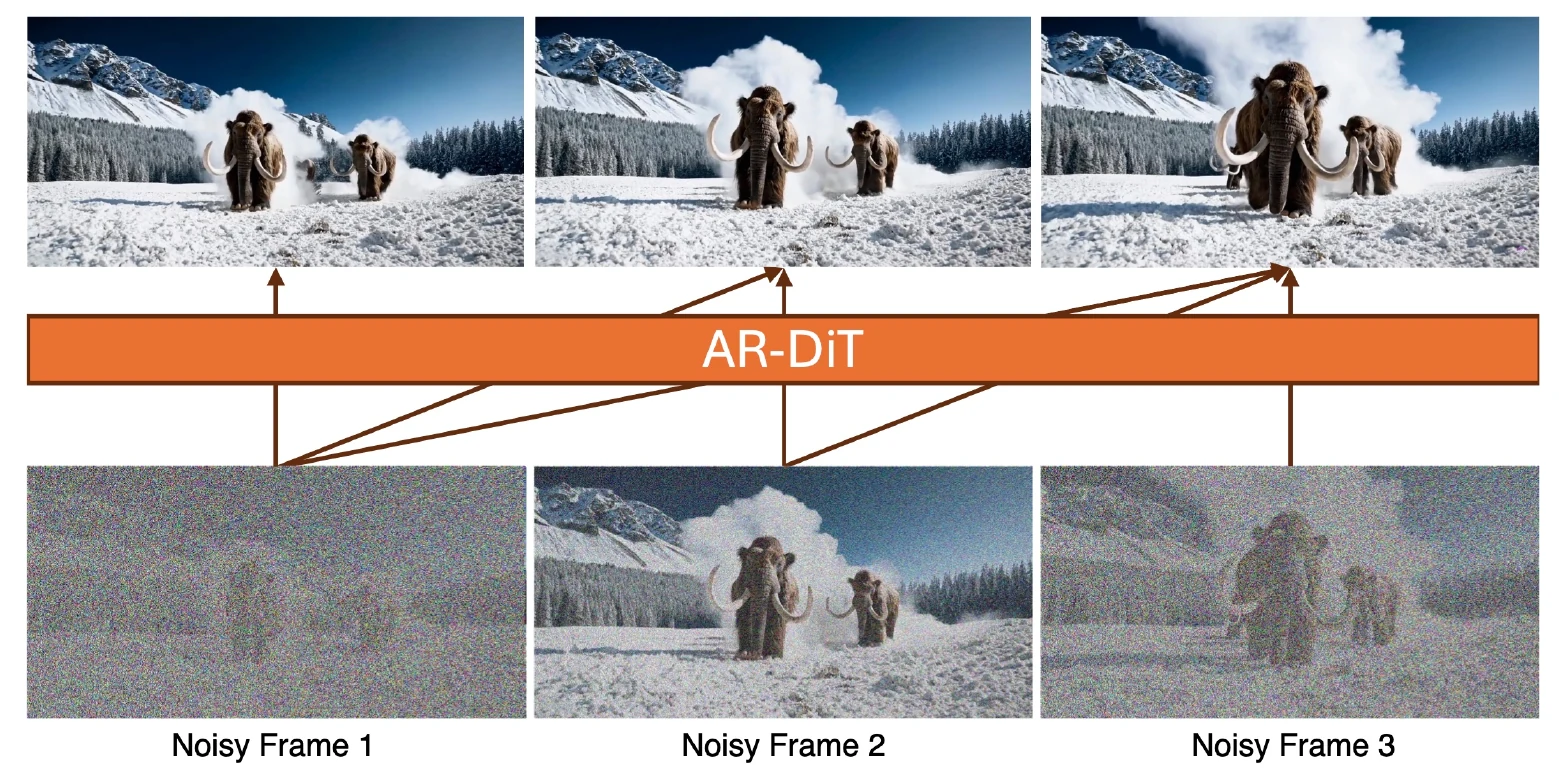
图源:From Slow Bidirectional to Fast Autoregressive Video Diffusion Models(arXiv:2412.07772)Figure 5。结构本身与双向 DiT 相同,只是把注意力掩码换成块级因果:当前块内的 token 双向互看,跨块只允许看过去。
这个设计的工程意义在于它几乎不修改网络结构:权重可以沿用预训练的双向模型,只需要换掩码再微调。作者报告,它的因果学生从双向教师蒸馏后,在一个 GPU 上以约 9.4 FPS 流式生成高分辨率视频,首次延迟约 1.3 秒——而双向教师生成同长度的 128 帧视频需要约 219 秒。这两个数字的对比不是「后者更快」这么简单:双向模型必须等全部帧的去噪都结束后才能出第一帧,因果模型在第一个块完成后就能出图,首帧延迟与总时长解耦了。这是交互式世界模型必须跨过去的一道坎。
顺带一提:用 KV 缓存做逐块生成之后,块级因果掩码在推理时甚至不再必要——因为缓存里只有过去的键值,当前块无论如何都看不到未来。CausVid 也正是利用这一点,在推理时换回了更快的双向注意力实现。这是「训练时需要掩码、推理时掩码被缓存免费实现」的一个干净例子,和语言模型解码时的情形完全同构。
长上下文:几分钟视频是怎么算得动的
交互式世界模型要求的一致性不是「10 秒内」,而是「几分钟内」。Genie 3 的报告给出的数据是:720p、24 帧每秒实时交互、一致性能维持几分钟,视觉记忆可以回溯到约一分钟以前。要理解这个目标意味着什么,先把「上下文长度」换算成序列长度。
序列长度与二次注意力
设潜帧为 帧、每帧 个 token、注意力头维度为 (这里的 指单头维度,模型总隐藏维为 )。完整注意力的计算量约为:
其中因子 4 来自计算 与 各两次乘加。序列长度翻倍,注意力部分翻四倍。用 Cosmos 那组 空间压缩的数字估算: 每帧 14400 个 token;若时间压缩为 8,一分钟 1440 帧得到 180 个潜帧,序列长度约 259 万。按上式粗略估算,注意力部分的 FLOPs 已经到 量级,远超任何单卡一次的合理预算。这就是为什么「几分钟、可交互」在这些系统里必须靠架构层面的稀疏化来解决,而不是靠堆算力。
三层稀疏化
实际系统的做法可以归成三层,Genie、Cosmos、CausVid 以及站内讨论过的 WorldAttention 分别在不同层次上做了工作。
第一层:时间压缩。 把时间压缩率从 8 提到 16 或 32,序列长度线性下降。压缩率越高,tokenizer 需要编造的运动细节越多,重建失真的风险越大,所以这一层的边界由 tokenizer 质量决定。
第二层:时空分解注意力。 Genie 的 ST-transformer 是最直接的实现:每个时空块里,先做空间注意力(在单帧的 个 token 内),再做时间注意力(在同一个空间位置跨 帧)。空间注意力是计算的主项,在块内逐帧并行;时间注意力带因果掩码、跨帧长度只有 。这样就绕开了整段视频的二次代价。
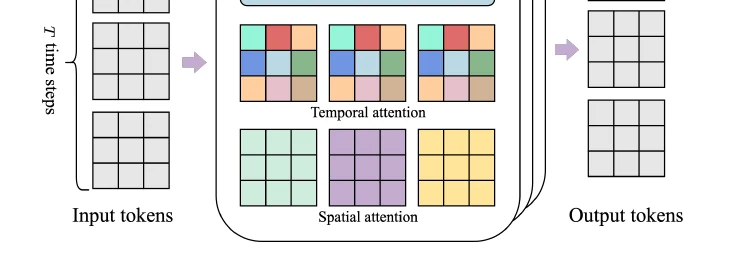
图源:Genie: Generative Interactive Environments(arXiv:2402.15391)Figure 4。每个时空块由空间层、时间层与前馈层组成,图中不同颜色对应不同的注意力图;空间层在 内做注意力,时间层在 上做因果注意力。
论文对这对设计给出了一句很关键的判断:ST-transformer 中计算的主项(空间层)随帧数线性增长,而不是二次增长。但要注意,这个「线性」是对帧数而言;空间注意力本身仍然是单帧 token 数的二次方。对于 720p 这类分辨率,单帧 token 往往就有上万个,空间部分的二次项依然不便宜——这也是为什么后面的系统又引入了局部窗口或全局稀疏通路。
第三层:KV 缓存的分层管理。 第二层解决的是「同一个注意力一次看多少 token」,但因果模型还有一个单独的存储问题:上下文里所有过去的潜帧,其键值都要保留下来供下一帧查询。层数越深、分辨率越高、交互时间越长,这份缓存越不可能整体留在显存里——下一节会给出具体数字。 真正把「几分钟历史」装进 GPU 的,是缓存策略而不是注意力本身。站内 WorldAttention 完全拆解 讨论的就是这条线:完整的 KV 历史留在显存或主机内存里,注意力时按层选择性地读回——全局线性通路负责低频结构,头自适应稀疏通路负责高频细节。它的出发点与 Genie 3 面对的同一个问题一致:用户一分钟之后回到某个位置,模型必须还能查到一分钟之前的画面信息,而这件事每帧都要做几十次。
关于 KV 缓存的显存账,后面会用具体数字单独算一遍。
动作可控性:Genie 式交互世界
Genie 系列真正把视频世界模型和「世界」两个字连起来的地方,是动作。但它面对一个现实难题:互联网视频几乎没有动作标注。Genie 的答案是潜动作模型(Latent Action Model,LAM)。
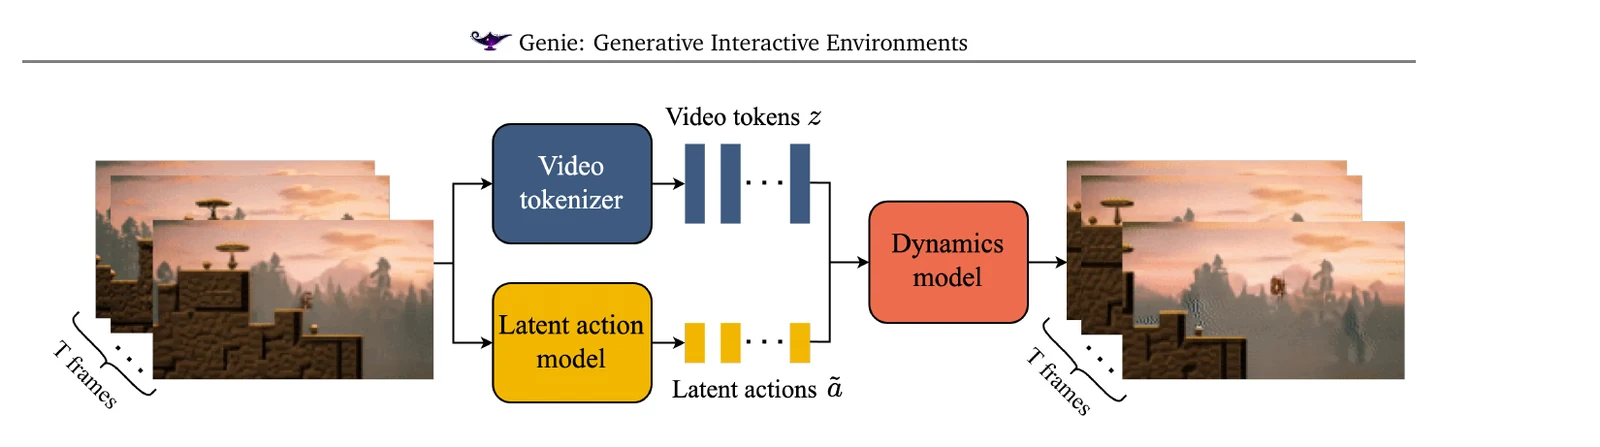
图源:Genie: Generative Interactive Environments(arXiv:2402.15391)Figure 3。视频被 tokenizer 切成离散 token ,潜动作模型从相邻帧之间推断出潜动作 ,两者一起送进动力学模型逐帧生成。
LAM 的结构是一个编码器-解码器对。编码器接收全部历史帧 和下一帧 ,输出一段连续的潜动作序列 ;解码器只接收历史帧和潜动作,被要求重建 。训练目标可以写成:
其中 是解码器, 由编码器 产生。关键在于,解码器看不到下一帧,能用的只有历史与潜动作。所以要让重建成功, 必须恰好编码出「从第 帧演变到第 帧」所需要的那部分变化。这就把动作变成了从像素中反推出来的、不受标注约束的量。
为了让这个潜空间可以被用户操作,Genie 用 VQ 把潜动作限制在一个很小的码本里(论文实验里 ,也就是至多 8 种不同的「动作」)。码本小有两个目的:一是人类可以逐一按键试出来;二是强制每个码值表示一种在重建意义上「有意义的变化」,而不是编码任意细微差别。
推理时,除了码本之外整个 LAM 都被丢弃,用户的按键直接映射为潜动作,与历史 token 一起送进动力学模型。这个替换是 Genie 最漂亮的一步:动作接口不需要在训练时被定义,它从数据自监督地长出来,然后被用户的按键「接管」。
Genie 的动力学模型同样使用离散 token 上的迭代式掩码预测,以 ST-transformer 为骨干:给定历史 token 与潜动作嵌入,预测被掩住的下一帧 token,反复迭代直到整帧补全。整模型共约 11B 参数,其中动力学模型 10.1B,训练用了 256 块 TPUv5、125k 步。训练数据是从 200,000 小时候选视频里筛出的 30,000 小时(6.8M 段)互联网游戏视频——论文报告最终用到的片段规模与候选池相差近一个数量级,这本身就说明了无标注视频里可用部分的稀缺。论文还按 400M 到 2.7B 的规模做过缩放实验,再把规模推到 11B。
Genie 3 则是在这条设计上把交互推到了实时:720p、24 fps、按键后立刻改变画面,视觉记忆延伸约一分钟,并增加了「世界事件」这类由文本触发的、不直接依赖用户动作的动态(例如场景中突然下雨)。官方描述里对技术挑战的表述只有一句话:自回归生成每一帧时,模型必须考虑随时间增长的历史轨迹,并且要在用户输入到达后每秒多次完成这些计算。这句话恰好就是本文下一节要算的账。
Cosmos:把「世界基础模型」做成一套平台
前几节讲的是「一个世界模型」,Cosmos 讲的是「一批世界模型加一整套流水线」。NVIDIA 在 2025 年 1 月发布 Cosmos World Foundation Model Platform,它的贡献不在于某一种新架构,而在于把数据、tokenizer、预训练、后训练串成了一条可复用的生产链。
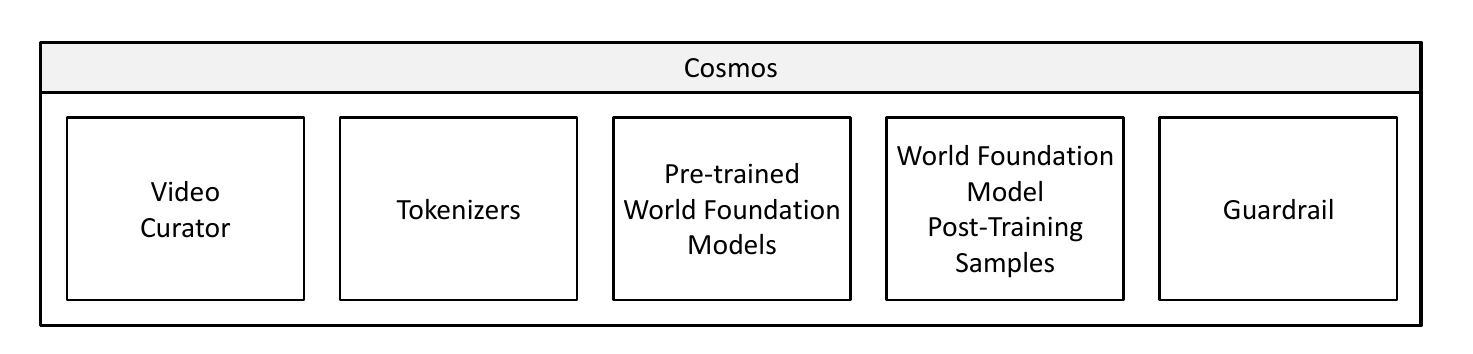
图源:Cosmos World Foundation Model Platform for Physical AI(arXiv:2501.03575)Figure 4。平台由视频策展、视频 tokenizer、预训练世界基础模型、针对具体物理 AI 环境的后训练以及护栏组件构成。
视频策展:把 20M 小时原始视频变成训练数据
Cosmos 的策展管线有五步:切分(按镜头边界把长视频切成段)、过滤、标注、语义去重、按分辨率与比例分片。原始数据约 20M 小时、分辨率从 720p 到 4k,过滤后大量内容因语义冗余或缺少物理信息被剔除,最终用于预训练的片段约 条、用于微调的约 条。
这条管线里的一个推理相关细节很值得注意:切分与编码解码本身的开销并不小,团队把基于 CPU 的软件编码换成 GPU 上的硬件编解码(NVDEC/NVENC),并用 PyNvideoCodec 替换 ffmpeg,报告了约 6.5 倍的吞吐提升。对任何从海量视频中抽取数据的世界模型项目而言,I/O 与转码往往是第一个卡住的环节,而不是模型本身。
模型族:两条主干、两套 tokenizer
Cosmos 的预训练模型按主干分成两族,每族各有一个基座与一个后训练衍生模型:
| 主干 | 基座模型 | 后训练(Video2World) | tokenizer |
|---|---|---|---|
| 扩散(潜扩散 DiT) | Text2World 7B / 14B | 由基座微调,接收观测视频与文本扰动 | 连续 tokenizer,8×8×8 |
| 自回归(下一 token 预测) | 4B / 12B | 由基座微调,接收观测视频 | 离散 tokenizer,8×16×16 |
| 辅助 | — | 扩散族的提示词放大器(12B) | 自回归族的扩散解码器(7B) |
表中数字来自论文的表 10。两个细节能说明设计者的取舍。
第一,扩散族与自回归族使用不同的 tokenizer。扩散族需要连续潜变量以保证重建质量,因此配连续 tokenizer;自回归族要用交叉熵做下一 token 预测,因此配离散 tokenizer,并且用了更高的时间压缩(16 而非 8),把序列压得更短以适配自回归的上下文。同一份数据被两条不同的压缩流水线处理后,分别喂给两类主干。
第二,自回归族配了一个「扩散解码器」,把离散 token(8×16×16 空间)映射到连续 token(8×8×8 空间)。这等于承认离散 token 的重建质量不足以直接出片,需要借助扩散来补细节。这与 GAIA-1 的「世界模型 + 视频扩散解码器」是同一个思路,只是 Cosmos 把它做成了一条可组合的流水线。
Video2World 与后训练
两族模型都分两步预训练:Text2World 先用文本提示生成视频;然后在这个基座上微调,输入从「只有文本」变成「文本 + 当前观测视频」,输出未来的视频。后者才是世界模型形态的模型:
其中 是最近若干帧观测, 是文本扰动(例如「前方出现行人」), 是未来若干帧的预测。后训练则面向具体物理 AI 场景(自动驾驶、机器人操作、传感器仿真),用该场景少量数据把通才模型微调成专才。Cosmos 的另一处推理相关产出是「合成数据」:世界模型可以按需生成带标注的仿真数据,与真实数据一起训练下游策略。这一点与 Dreamer 的想象训练是同一个逻辑,只是想象发生在像素层。
护栏与发布
Cosmos 的论文里,护栏(guardrail)是一个独立的组件,负责检测视频中可能的违规内容。发布形式上,模型以开放的 checkpoint 形式提供,同时附带 tokenizer 与后训练示例——这决定了 Cosmos 的推理成本并不像 Sora 那样无从估算:社区可以在 4B 到 14B 的规模上实测每个时间步的成本,再按需要放大。
推理账本:帧率、延迟、显存与并行
本节把前面的部件换算成系统视角下的四本账。这些账是本文的核心——决定了「一个视频世界模型能不能被实时驱动」。
账一:单帧的生成节拍
一次完整的视频生成由三段时间组成:tokenizer 编码(若有输入观测)、主干去噪、tokenizer 解码。
对扩散主干,生成一个潜帧块需要 步去噪,每步一次完整前向;因果模型的每步还要额外读取历史 KV。所以每帧的有效前向次数是 次(严格地说,K 帧的块共 次前向,单帧摊薄为 )。以 CausVid 为例,它把教师 50 步蒸馏到 4 步、块大小若干帧,于是「生成速度」提高了 12.5 倍。CausVid 报告的首帧延迟 1.3 秒、之后约 9.4 FPS 大致对应这个结构:首帧包含一次块内全部去噪,稳态每帧只摊到一次或几次前向。
对自回归主干,生成一个潜帧需要对该帧的所有 token 做一次完整前向;下一帧的生成只能依赖前面的 KV。所以稳态帧率近似等于:
其中 是主干每秒可以重复前向的最大次数(由算力与每帧前向的 FLOPs 决定)。分母里出现的是帧级串行时间,它的倒数就是帧率上限。这解释了为什么「实时」在这些系统里和「模型多大」直接绑定:24 fps 意味着每帧只有约 41.7 毫秒的预算,其中还包括解码器与传输。
用 GAIA-1 的数据做个粗算,可以说明解码器为什么常常是瓶颈之一。GAIA-1 的世界模型在 6.25 Hz 输出(160 ms 一帧),而视频解码器要把这段粗序列渲染成 12.5 Hz 并做时间上采样。解码器的参数量 2.6B 超过世界模型之外的所有组件,运行频率还高一倍;即使世界模型算得很快,整条流水线的节拍也会被解码器拖住。这是「拆出专门的解码器」之后必然要面对的负载不均衡,后来的系统普遍用蒸馏解码器或直接低分辨率渲染来绕开。
账二:KV 缓存随帧数的增长
这是视频世界模型最容易被低估的一项。
设注意力层数为 、层内 KV 头数为 、头维度为 、每个潜帧的 token 数为 ,以 GPTQ(每元素 2 字节)存储,那么生成 个潜帧后的 KV 缓存大小是:
前面的 2 表示键与值各一份,最后的 2 是 GPTQ 的字节数。注意这个量随 线性增长且没有上限——语言模型还可以在到达上下文上限时回滚窗口,交互式世界模型则恰恰要求跨分钟的记忆不能丢。
代入一组常见量级:、、,每个 token 的 KV 就是 字节,即 128 KiB;若 KV 头数放宽到 16,则是 256 KiB/token。在 360p 分辨率、 空间压缩下,每潜帧有 个 token,单个潜帧的 KV 约占 0.44–0.88 GiB;按时间压缩 8 计算,5 秒视频约 15 个潜帧,就要 6.6–13.2 GiB。换到 720p 的 压缩,每潜帧 14400 个 token,单个潜帧就要 1.76–3.5 GiB,一分钟(180 个潜帧)就是几百 GiB 的量级。这还只是单条序列的长度成本,没有算并行时每张卡各自要存的那一份,也没有算注意力计算本身。
三个工程对策因此自然浮现。第一,降低 :更高的空间压缩率或更小分辨率——这也是为什么实时交互系统往往先在 720p 上跑,而不是直接追求 4K。第二,降低 :使用 GQA 或 MLA 这类压缩 KV 的结构,可以把这个预算砍掉几倍,站内对 MLA 与 KV 缓存的分析见 FlatCake 完全拆解。第三,把历史 KV 分层存放:热的部分留在显存,冷的部分下沉到主机内存或 NVMe,按需读回——这正是 WorldAttention 与 Cosmos 的 KV 管理策略要解决的问题。
Genie 3 的「视觉记忆回溯一分钟」在这些数字下就变得很具体:一分钟的 720p 历史,要么被压缩到更少的潜帧,要么有相当一部分必须放在 GPU 之外。官方没有公布它具体的 KV 放置策略,但问题结构是确定的。
账三:并行
视频生成与语言模型推理的并行形态有明显区别,归纳下来有三类。
序列并行 / 上下文并行沿时间轴切分:不同卡负责不同的帧块,注意力采用环形或分块通信。它特别适合长上下文世界模型,因为 KV 总量太大、单卡放不下,而帧块之间的通信只发生在边界。代价是通信量与块大小成正比,块太窄则通信成为主项。
张量并行沿隐藏维切分,每层都要做全归约通信。它适合把单个巨大的主干(如 Cosmos 的 14B)摊到多卡上,但和序列并行叠加时要小心通信的重叠。
时空并行是针对视频的专用拆法:把不同的空间区域或不同的帧分摊到不同卡,注意力中只交换边界或关键帧。DistriFusion 一类工作用「按步异步」的方式让各卡去噪步错开,代价是每一步的注意力需要跨卡同步——站内 扩散模型从零起(八):推理加速工程 对这类并行采样策略有更细的对照。
实时的关键不在于并行能摊掉多少算力,而在于单帧延迟不能被并行放大太多。24 fps 只有 41.7 ms 的窗口,每多一次跨卡同步就吃掉几毫秒。这与 LLM 推理中「批处理吞吐与单请求延迟的取舍」是同一类问题,只是视频世界模型的解码窗口更窄。
账四:批处理与共享
交互式世界模型有一个特殊约束:每个用户都在驱动它自己的世界。不同的按键序列产生不同的未来,不同用户之间的 KV 完全不同、无法共享前缀。这与 LLM 推理里「同一份权重 + 不同 KV」的结构相似,但多了一层:LLM 服务里可以按请求批处理,同一批内的 token 独立去噪;视频世界模型里每个用户是持续的流,批处理要求把多个用户的帧在时间上对齐——而各用户的帧率与延迟目标不同,强对齐就会牺牲延迟。
PhysisServe 这类系统给出的思路是把「去噪步 × Transformer 层」展开成流水线 stage,让不同的物理 AI 进程分时复用同一份高频算力,同时保持各自的连续输出节奏。站内 PhysisServe 完全拆解 有完整的 system 设计,这里的结论是:视频世界模型的规模化服务更像是「把一张卡的节拍切成若干个时间片」而不是「把一批请求拼成一个大矩阵」。
从生成到评测:怎么判断生成出来的「世界」对不对
画面逼真不代表物理正确。这条线上目前比较有说服力的证据来自专门的物理常识评测。
VideoPhy(2024 年 6 月)用一组材料交互类提示、即固-固、固-液、液-液交互,让模型生成视频后交由人评估「语义是否贴合」与「物理常识是否成立」。VideoPhy-2(2025 年 3 月)把范围扩大到 200 个动作类提示,并且明确把评测拆成三项:语义贴合度、物理常识、物理规则是否被正确体现。它的报告里最值得记住的一句话是:即使在难子集上表现最好的模型,同时满足语义与物理常识的比例也只有 22%,而且模型尤其在质量守恒与动量守恒这类规律上出错。这是一个直接的证据:今天的视频生成模型能画出「像样」的运动,但并不稳定地遵守守恒律。
这一结果对工程的含义是,不能把视频世界模型当作可替代物理引擎的仿真器来用。在需要精确动力学(碰撞、摩擦、刚体约束)的场合,它更适合作为「生成先验」或「数据增广器」——它的长处是开放世界的多样性,而不是数值精度。
对比 JEPA 路线可以看到两种失败模式:V-JEPA 2 在物理规则违背检测基准上表现不佳,但它至少有一个明确的判据(表征残差);视频生成路线则在视觉上有大量「可信的幻觉」,必须靠人评估或专门的评测器(如 VideoPhy-AutoEval)去发现。两条路线各自需要不同的评测栈,不能混用。
生成不等于理解:这条线的证据与边界
回到 Sora 报告里那句被反复引用的话:视频生成模型可以被视为世界模拟器。本文认为这句话应被理解为「有条件的近似」,条件至少有四条。
条件一:状态的可观性。 视频世界模型能从像素推断运动的前提,是相关量的信息出现在像素中。被完全遮挡的物体、其它具身体的意图,从像素里看不到,模型只能用先验去猜。Dreamer 路线把状态显式地写进潜变量,可以携带「看不见但被记住」的量;视频路线只能靠历史画面间接维护。这是两条路线最本质的差别之一。
条件二:交互的一致性。 用户按键必须稳定地映射为同一个动作效果,否则同一个动作在不同场景里表现不同,模型就不是可用的世界。Genie 用极小的潜动作码本换取这种一致性,代价是动作空间被压得很窄——它目前更接近「按几个键就能玩」的程度,距离驱动真实的机器人关节还差很远。
条件三:时间尺度。 Genie 3 自己把边界说得很清楚:几分钟的连续交互,而不是数小时;地理位置的精确一致性不保证;文字只有在输入的世界描述中被提供时才会正确渲染。这三点分别对应上下文长度、空间记忆与符号信息三个方向的局限。
条件四:因果而非相关。 生成逼真的画面,拟合的是像素的统计相关性;物理正确性是其结果,而不是其约束。VideoPhy-2 的失败模式说明,模型可以生成「看起来在下雨」「看起来有风」的画面,但在守恒律这层约束上并不稳定。这是训练目标决定的——交叉熵或扩散损失不会显式惩罚动量不守恒。
不过也不能因此把这条线贬为「只是画面」。它有三个 Dreamer 与 JEPA 不具备的优势:第一,开放世界的视觉多样性,是像素空间独有的;第二,与视频生态天然对齐——一个预训练好的视频基座,可以同时用于生成、编辑、补全与预测;第三,系统侧的成熟度——DiT 主干 + KV 缓存 + 并行推理,几乎复用了整个 LLM 推理栈,这让「把世界模型当服务跑」的工程成本大幅下降。
一个折中的判断是:这条路线当前最可靠的位置,是「生成式数据工厂」与「交互式仿真器」。前者已经在 Cosmos 的合成数据场景里落地;后者取决于能否把一致性、动作空间与时间尺度继续推上一个台阶,而这三件事都需要一套能分别测量它们的评测,这正是下一篇要讨论的问题。
小结
视频生成式世界模型的基本矛盾可以用一句话概括:它想用一次前向描述整个世界,而世界是连续的。 本文沿着部件各算了一遍账:
- tokenizer 决定一帧要多少 token,连续与离散的选择又决定了主干是扩散还是自回归;压缩率与因果性是两个必须先定下来的旋钮。
- 主干从 GAIA-1 的「自回归 token 预测 + 视频解码器」,演进到 Sora 式时空小块 + DiT,再到因果化的块级掩码与蒸馏;每一步都在把「整段生成」往「流式预测」推。
- 长上下文靠时间压缩、时空分解注意力、分层 KV 三类手段叠加;其中 KV 缓存的线性增长是决定「几分钟」能否成立的硬约束。
- 交互靠潜动作模型从无标注视频里自监督地反推动作,再用极小的码本换取一致的操作手感;Genie 3 把节拍压到了 720p / 24 fps。
- 系统这层的账是「首帧延迟与总时长解耦」「KV 线性膨胀」「帧级串行时间」三项,并行策略必须围绕它们选择。
证据上,这条线一方面用 GAIA-1 的幂律拟合说明了可扩展性,另一方面用 VideoPhy-2 的数字(难子集上最好的模型联合通过率也只有 22%)说明了物理正确性还没有解决。它是一条已经在工程上跑通、但在物理与记忆上仍有明确边界的路线。
下一篇转向评测:物理一致性、反事实响应与长程记忆分别应该怎么测,为什么现有的大多数视频榜单测不出「世界模型」,以及一个可用的世界模型评测栈应该由哪几层组成。
参考资料
- GAIA-1: A Generative World Model for Autonomous Driving(Wayve,arXiv:2309.17080,2023-09)
- GAIA-2: A Controllable Multi-View Generative World Model for Autonomous Driving(Wayve,arXiv:2503.20523,2025-03)
- Genie: Generative Interactive Environments(Google DeepMind,arXiv:2402.15391,2024-02)
- Genie 3: A new frontier for world models(Google DeepMind 官方博客,2025-08)
- Cosmos World Foundation Model Platform for Physical AI(NVIDIA,arXiv:2501.03575,2025-01)
- From Slow Bidirectional to Fast Autoregressive Video Diffusion Models(MIT & Adobe,arXiv:2412.07772,2024-12)
- Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion(MIT,NeurIPS 2024,arXiv:2407.01392)
- Scalable Diffusion Models with Transformers(DiT,arXiv:2212.09748)
- VideoPhy: Evaluating Physical Commonsense for Video Generation(arXiv:2406.03520,2024-06)
- VideoPhy-2: A Challenging Action-Centric Physical Commonsense Evaluation in Video Generation(arXiv:2503.06800,2025-03)
- Video generation models as world simulators(OpenAI,2024-02)
- PhysisServe 技术报告(逆矩阵、智源研究院、vLLM、北京大学,2026-10)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



