


世界模型从零讲起(十二):把世界建成一个可以走进去的场景——NeRF、3D Gaussian Splatting 与占用栅格
承接前十一篇:三条路线共同跳过的一维
前十篇把世界模型按「预测什么」拆成了三条路线。(一)给出的分类是:重建式潜空间模型预测潜变量、视频生成式模型预测像素、联合嵌入模型预测表征。三条路线看起来差别很大,但它们有一个共同点——世界被压进一个向量或一串 token 里,没有显式的三维结构。
这在很多任务上不是问题。Atari 的画面只有 210×160,Minecraft 的世界由方块组成,视频预测器只需要让下一帧看起来合理,智能体就能从像素里学到该按哪个键。但换一个场景,这个假设立刻吃紧:一台机器人在厨房里收拾桌子,视频预测器可以生成「手伸向杯子」的逼真画面,却回答不了三个决策必需的问题——杯子在盘子后面被挡住的那一半是什么形状?台面边缘距离手腕还有几厘米?如果我把这摞碗整体向左推十厘米,哪些物体之间会碰撞?
这三个问题的共同点是:它们都不是「下一帧长什么样」,而是「世界在三维里是什么样」。前十一篇讲过的模型,要么把三维结构隐式地压进潜空间(Dreamer 的 ),要么干脆放弃持久结构、每帧重新生成(Sora、Genie、Cosmos 这类视频模型)。它们能通过「看起来对」的测试,却很难支撑需要度量、遮挡与物体恒存性的操作。
(六)在讲评测时已经点出这个问题:物理一致性与反事实响应,本质上要求模型有一个稳定的三维世界作为参照。这一篇补上的就是那一维——几何式世界模型:把场景本身作为状态,用可微渲染或栅格查询作为接口,让「想象」发生在一个可以走进去的三维空间里。
一个具体场景:视频预测器为什么记不住桌子底下
先把问题说得更具体。假设有一台带腕部相机的机械臂,要从桌上拿起一个马克杯。桌上还有一只盘子、一个纸巾盒,马克杯的手柄被盘子挡住了一半。视频世界模型看过大量人类操作视频,能生成相当逼真的「机械臂靠近杯子」画面。但让它规划动作时,会发生几件事。
第一,视角一致性没有保证。模型在训练时见过的是固定几个相机角度;腕部相机移动两厘米,画面里的杯口形状就变了。视频模型可以生成新视角,但它生成的是「看起来像新视角的画面」,而不是「同一个物体从另一个方向看过去应该是什么样」。前者依赖数据分布,后者依赖三维结构。一旦视角离开训练分布,生成结果就可能出现杯子变高、盘子位置漂移这类错误,而规划器无法察觉——它拿到的只是一张图。
第二,没有物体恒存性。视频模型每生成一帧,都要从历史 token 里重新推断世界状态。被盘子挡住的那半个杯子,在画面里根本不存在。模型当然可以在被遮挡区域「生成」一个合理的猜测,但这个猜测不会被保留下来供后续查询:下一帧它又会重新猜一次。几何表示不一样——重建出来的杯子是一个完整的三维对象,遮挡只影响「从当前视角看得到多少」,不影响「物体本身存在什么」。
第三,没有度量。抓取需要知道杯子的直径、手柄的位置、夹爪张开多大、下探多少厘米。视频 token 里没有厘米这个单位。几何表示天然带尺度:一个重建出的场景,点的坐标就是米(或毫米),任意两点之间的距离可以直接算。
第四,不能编辑。规划时经常要问反事实问题:「如果把纸巾盒挪开,杯子还够得着吗?」视频模型只能重新生成一整段视频,而且要保证「只有纸巾盒变了、其他都没变」几乎不可能。几何场景可以只改一个物体的位姿,其余部分原样保留——这是仿真器的基本能力。
这四点合起来,就是几何式世界模型的存在理由:它不追求「生成得像」,它追求「世界是可查询、可编辑、可持续存在的」。
形式化:场景、渲染器与动力学
把几何式世界模型写成一个三元组,会清楚很多。
场景状态 是一个三维对象——它可以是一组高斯、一个体素网格、一个隐式函数,或者一张带语义的占用栅格。渲染器 把场景和相机位姿 映射成一张图:
动力学 描述场景如何随动作变化:
于是一个几何式世界模型要学两件事:从观测里把 恢复出来(重建),以及预测 (动力学)。前者是计算机视觉里的经典问题(SfM、MVS、SLAM、神经渲染),后者才是「世界模型」这个词真正的分量所在。
与第一篇的潜空间形式化对照,差别在于 的可解释性与可查询性:
| 表示 | 状态是什么 | 能否回答「X 点有什么」 | 视角一致性 | 能否局部编辑 | 单次查询成本 |
|---|---|---|---|---|---|
| 潜空间状态(Dreamer) | 向量 | 不能,需解码 | 隐式保证 | 不能 | 一次前向 |
| 视频 token(Sora/Genie) | 帧序列 token | 不能 | 无显式保证 | 不能 | 整段生成 |
| 隐式辐射场(NeRF) | MLP 权重 | 能,沿射线积分 | 强 | 弱 | 每像素多次采样 |
| 显式高斯(3DGS) | 图元集合 | 能,投影后混合 | 强 | 强(改单个高斯) | 每像素一次混合 |
| 占用栅格 | 体素标签 | 能,查表 | 强(离散) | 强 | 一次卷积/注意力 |
这张表里「单次查询成本」一列会在后面展开。现在先记住一个结构性事实:几何表示把成本从「每次生成」挪到了「重建一次 + 每次渲染」。这个不对称性是整条路线的经济学基础。
三种几何表示各有所长,本文按「隐式 → 显式 → 体素」的顺序讲。它们不是互斥的路线,真实系统经常混用:用 NeRF 或 3DGS 重建外观,用占用栅格做规划,用物理引擎或学习模型推动场景演化。
隐式几何:从辐射场到可微渲染
NeRF 的五个输入与两个输出
要把「场景」表示成一个可以查询的东西,最直接的想法是:给空间里任意一点和任意观察方向,回答「从这里看过去,这一点的颜色和遮挡程度是多少」。NeRF(Neural Radiance Fields)在 2020 年由加州大学伯克利分校的 Mildenhall 等人提出,把这个想法写成了一个 MLP:
是三维坐标, 是观察方向(单位球面上的二维方向),输出 是颜色, 是该点的体积密度。整个场景就是这一个函数的定义域——一个连续的三维场,没有网格、没有体素、没有显式表面。
这个表示有几个很讨喜的性质。第一,分辨率是无限可调的:坐标是连续的实数,想在哪儿采样就在哪儿采样,不需要体素化。第二,视角相关的外观被显式建模:颜色同时依赖位置与方向,所以同一个表面从不同角度看会有不同的高光——这正是让渲染结果「像照片」的关键。第三,表达紧凑:一个 8 层、每层 256 宽度的 MLP 大约几十万参数,就能表示一个复杂场景;对比之下,同样保真度的体素网格动辄上 GB。
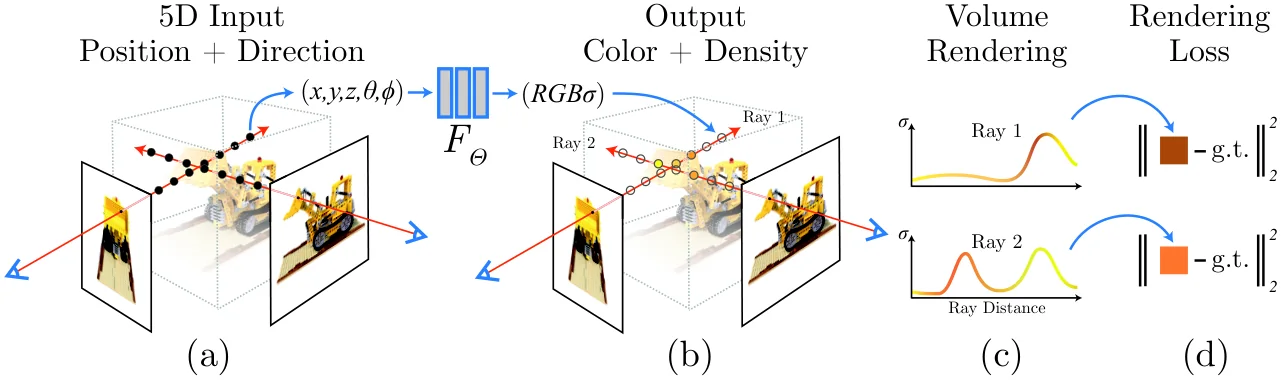
图中从左到右是四个阶段:(a) 输入包含位置与方向两部分;(b) 沿相机射线采样若干点,每点送入同一张 MLP;(c) 用体渲染公式把每个采样点的颜色与密度积成一个像素颜色;(d) 与真实图像算损失、反传优化 MLP。注意 (b) 里多条射线共享同一张 MLP 权重——这是「场景就是函数」的直接体现:任意射线、任意位置,查同一个函数。图源:Mildenhall 等,NeRF(arXiv:2003.08934)图 2。
代价也很明确:MLP 是黑盒,它的定义域里绝大多数体积是空的(空气),但渲染时必须对整个区间采样。这是 NeRF 后续所有加速工作要对付的核心问题,后文会展开。
体渲染:把一条射线上的采样点积成颜色
给定相机光心 和方向 ,一条射线上的点可以写成 。沿这条射线采样 个点 ,每个点查一次 得到 ,然后按体渲染的离散形式累加:
这里 是采样间距, 是射线到达第 个点之前「没被挡住」的概率——即透射率。 是这一段被吸收的概率,乘以颜色就是该段贡献的辐射量。
这个公式每一项都有明确含义,值得逐项读一遍:
- 是光学厚度,密度越大、间距越长,这一段越不透明;
- 是穿透这一段的概率,连乘起来就是 ;
- 最终颜色是「按不透明度加权的颜色平均」,前面的遮挡会压低后面的权重。
它比普通的 alpha 混合多了一个物理约束:透射率是沿整条射线累积的,而不是逐层独立的。这意味着渲染顺序必须从近到远,且每一步都要维护一个前缀和。这也是为什么 NeRF 的渲染是串行的:一个像素的结果依赖它自己的整条射线,不同像素可以并行,但同一像素内的采样点不能。
位置编码:为什么 MLP 学不出高频细节
只用原始坐标喂给 MLP,NeRF 会渲染出非常模糊的结果。原因不是网络容量,而是谱偏差(spectral bias):用坐标直接作输入时,MLP 倾向于先拟合低频函数,高频细节学得极慢。NeRF 的解决办法是在输入之前把每个坐标映射到一组正弦函数上:
位置用 层,方向用 层,这样 3 维坐标变成 60 维输入,2 维方向变成 24 维输入。从「几何式世界模型」的角度看,这一步很关键:空间分辨率不再由网络宽度决定,而是由频率上限 决定。要看清椅子腿上的木纹,就得提高频率上限;频率上限越大,采样间距 也必须越小,否则会混叠——这就把这步和渲染成本直接绑在了一起。
这组编码后来演化成各类可学习的多分辨率表示:Instant NGP 的多分辨率哈希网格把特征存在哈希表里、用插值查,把 MLP 从「负责表示场景」降级为「负责把特征解码成颜色与密度」;Mip-NeRF 系列则把点采样改成区间(锥体)采样,在抗混叠上更严谨。这些改进对推理系统的意义在于:场景表示从「一张 MLP」变成「一张可随机访问的特征表」,查询路径更像查显存而不是算矩阵。
相机从哪来:SfM、SLAM 与已知位姿
NeRF 的训练需要每张图的相机位姿。原始工作用 COLMAP 这类 SfM(Structure from Motion)工具先从多视角图像里恢复相机内外参,再优化辐射场。这一步在几何式世界模型里不可省略,而且经常是整条流水线最脆的一环——纹理少的白墙、重复图案、快速运动,都会让特征匹配失败。
对机器人来说,相机位姿通常由 SLAM 或 VIO 提供,精度足够,但会有累积漂移。于是重建出来的场景会跟着漂:今天建好的桌子,明天在同一坐标上可能已经偏了两厘米。这就要求几何式世界模型在在线更新时有能力把漂移吸收掉,后文讲「位姿已知先验」时会展开。
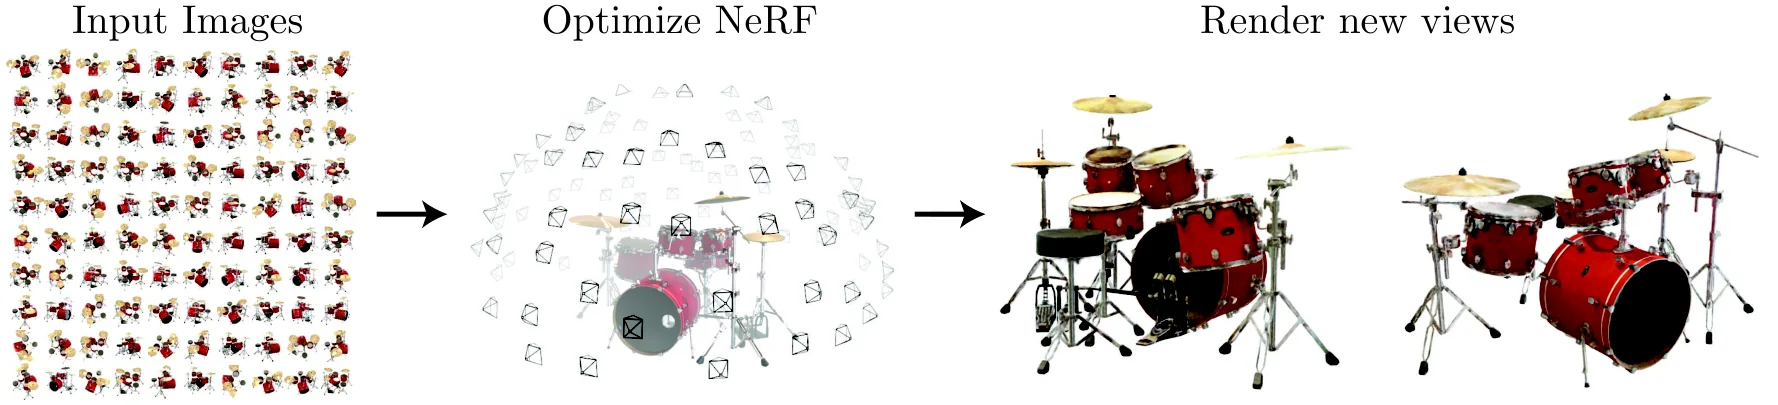
上图是 NeRF 论文的合成数据集示例:左侧是一组输入视角的照片,中间是从这些照片优化出的辐射场,右侧是从训练时没有出现过的新视角渲染出的结果。注意右侧画面里物体的遮挡关系、反射和阴影都是从三维场里重新算出来的,而不是从训练图里检索或拼接。这正是「重建一次、渲染多次」的具体形态:输入图像只用来建场,之后每查询一个视角只需要沿射线积分。图源:Mildenhall 等,NeRF(arXiv:2003.08934)图 1。
推理账本:NeRF 贵在哪里
把 NeRF 的渲染拆成一组可数的操作:
| 量 | 典型值(NeRF 原论文) | 说明 |
|---|---|---|
| 像素数 | 一张渲染图 | |
| 每条射线采样点 | 粗网络 64 + 细网络 128 | 分层采样(hierarchical sampling) |
| 每条射线网络查询 | 256 次 | 粗网络 64 次 + 细网络 64×2 次 |
| 每张图查询总数 | 1.5–2 亿次 | 合成数据 64 万条射线,真实场景 76.2 万条 |
论文给出的实测是:每条射线 256 次网络查询,每张图 1.5 亿到 2 亿次,在单张 NVIDIA V100 上约 30 秒渲染一帧;单个场景优化到收敛需要 100k 到 300k 次迭代,大约一到两天。对离线重建(拍一圈照片、花一两天优化)这没问题;对实时闭环控制完全不行。
更本质的问题是空区域浪费。真实场景里,射线绝大部分长度都在空气里,密度接近零,对最终颜色几乎无贡献,但对每个点仍然要跑一遍 MLP。NeRF 用分层采样部分缓解了这个问题:先用粗网络均匀采样,得到密度分布,再在密度大的区域密集采样细网络。但粗网络本身又要跑一遍全部射线,总调用量并没有下降多少。
把这个问题写成 roofline 的形式会看得更清楚。每个采样点的计算量固定(一次小 MLP),访存主要是网络权重(常驻,可复用)。理论上的算力利用率应该不低,但实际 GPU 利用率很低,原因是:每个像素的射线是独立的串行链,一个线程处理一个像素,线程内要串行地走完 64+128 个点,分支发散严重。这是后来 Instant NGP 用 CUDA 手写 warp 级并行、3DGS 干脆放弃射线积分的原因。
显式几何:把场景拆成一堆可投影的椭圆
NeRF 把场景藏在一个 MLP 里,好看但不透明:想知道「桌子在哪」得自己搜索密度场。3D Gaussian Splatting 的思路反过来——不学一个函数,直接学一组几何图元。
场景就是几百万个高斯
3DGS 于 2023 年由 INRIA、Côte d’Azur 大学与 MPI Informatik 的 Kerbl 等人在 SIGGRAPH 2023 发表,场景被表示成 个三维高斯(论文测试的 在 100 万到 500 万量级),每个高斯 带有五组参数:
- :中心位置,即「这个图元在世界里的哪儿」;
- :协方差,决定这个高斯是球、扁片还是细长条;
- :不透明度;
- :一组球谐系数,描述从不同方向看时这个点的颜色(三阶球谐即 16 个系数 × 3 通道 = 48 维)。
协方差不能自由设置,必须保持半正定且形状可控,所以实际存的是旋转四元数 与三轴尺度 :
这个参数化方式有两层好处。第一,保证 半正定,优化时不会出现退化矩阵。第二, 与 都是低维的(4+3),梯度更稳定——直接优化 6 个协方差独立分量,很容易让高斯退化成一条线甚至一个点。
从「几何式世界模型」的视角看,这个表示和 NeRF 有一个根本性的差别:场景是离散的、可数的、可整体操作的对象。一台机器人可以问「桌面附近有哪些高斯」,可以删除某个物体对应的高斯,也可以把一组高斯整体平移——这些操作在 NeRF 里都做不到,因为场景是一个不可分解的函数。
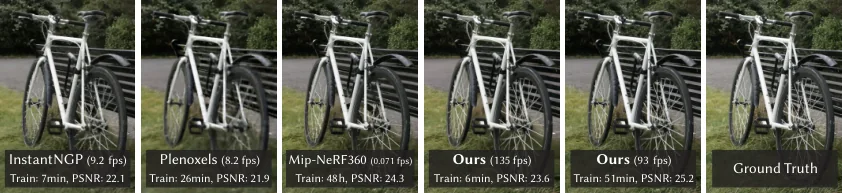
上图是 3DGS 论文的首页图。每一列是同一个场景(如「自行车」)由不同方法渲染的结果,最右一列是真实拍摄的参考。图像下方标注了每种方法的训练时间、PSNR 与渲染帧率:InstantNGP 只有 0.2 fps、Mip-NeRF360 0.071 fps、Plenoxels 82 fps,而 3DGS 的两种配置分别是 135 fps 与 93 fps;训练时间从 5 分钟到 26 分钟不等,PSNR 与参考图接近。图中的碎石、车架线缆、背景树叶都是从一组高斯里混合出来的,不是贴图;相机可以自由绕行,渲染仍然连贯。这是「显式三维表示」相对视频生成模型的核心优势。图源:Kerbl 等,3D Gaussian Splatting(arXiv:2308.04079)图 1。
投影:3D 高斯怎么变成屏幕上的 2D 高斯
给定相机外参 (世界到相机)与投影矩阵,先做仿射变换把世界里的高斯搬到相机空间:
协方差随仿射变换的形式是 ,这是多元高斯线性变换的标准结论,值得单独说明一下——如果随机变量 ,那么 。一个高斯被「压扁、旋转、平移」,结果仍然是高斯,只是均值和协方差变了。这条性质是整条路线成立的前提:只有高斯在投影下还能保持高斯的形状,才能把三维图元投影成屏幕上的二维图元而不丢信息。
投影到图像平面时,透视除法是非线性的,无法直接用 。3DGS 用雅可比矩阵在投影点处做局部线性化,取 为投影函数在 处的雅可比,屏幕空间的协方差为:
再做一次「低通滤波」:为了覆盖一个像素的面积,在二维协方差的对角线上加上常数(典型为 0.3):
这个 0.3 不是随便调的。如果高斯投影后比一个像素还小,渲染时会频繁闪烁、出现锯齿;把最小尺寸抬到一个像素量级,相当于给每个图元加了一层稳定的最小覆盖。代价是远处的细物体会被略微「糊化」,这也是 3DGS 在小尺度物体上不如 NeRF 精细的原因之一。
按深度排序与 alpha 混合
投影完成后,得到一组二维高斯,每个带中心、二维协方差、不透明度与颜色。渲染一个像素 时,需要按从近到远的顺序累加:
是像素中心到高斯中心的二维偏移,指数项是二维高斯在该点的权重。 是「该点的不透明度 × 该点在高斯内的权重」,两个乘起来才是一个高斯对这个像素的贡献。
公式里最关键的是那个 :和 NeRF 的体渲染一样,它是沿深度累积的透射率。这个乘积要求图元按深度排序,否则前面的图元会盖住后面的,或者后面的会把前面的「透出来」。这就是 3DGS 每一帧都要做的一件事。
排序不是一步能省的操作。场景里有几十万到几百万个高斯,每个视角的可见集合是它的一个子集(由视锥裁剪得到);全局排序的开销可以摊销,但视角一变,顺序就变,不能预计算。原始实现里这一点靠 GPU 上的基数排序(radix sort)完成,每帧一次,然后把所有高斯按 16×16 像素的 tile 分桶,每个 tile 内再按深度混合。这一点对机器人尤其重要:相机在动,每帧顺序都在变,排序开销不会因为场景是静态的而降低。
致密化与剪枝:为什么高斯数量会自己长出来
一个关键的设计问题是:初始高斯从哪来、要多少个?3DGS 的答案是——从 SfM 的稀疏点云初始化(每个点一个高斯),然后在优化过程中自适应地增删:
- 每个高斯统计它累积的梯度幅值。梯度大的区域意味着「这里有很多视觉细节没拟合上」,于是对这个高斯做分裂(split)或者克隆(clone);
- 尺度小于阈值的、几乎完全透明的、或者投影后特别大的高斯,会被剪枝(prune);
- 每 100 次迭代左右重置一次统计量,避免早期的大梯度永久影响后续决策。
这条路线的致密化规则从论文那张示意图就能看清楚:
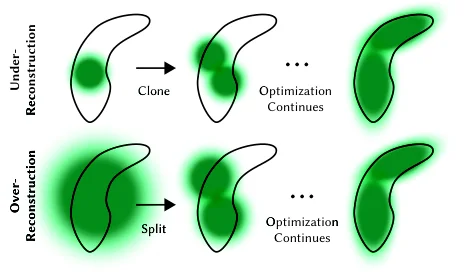
上图是 3DGS 的自适应致密化规则。上排是「重建不足」(under-reconstruction):黑色轮廓是真实几何,现有小高斯覆盖不足,于是把该高斯克隆一份,补到没覆盖的区域。下排是「过度重建」(over-reconstruction):本来该是两块细节的地方被一个大高斯糊住了,于是沿其主方向把它分裂成两个更小的高斯。克隆与分裂的判据是高斯位置上的累积梯度幅值——梯度大说明这里还有没拟合上的细节。图源:Kerbl 等,3D Gaussian Splatting(arXiv:2308.04079)图 4。
但从系统角度看,「自适应」意味着表示大小不可控。同一个场景,用不同的优化步数、不同的初始化,最终高斯数量可以差一个数量级;场景越复杂,数量越大,显存与排序开销同步上涨。这与 NeRF「参数固定」的性质正好相反,对部署方来说是需要额外管理的成本项。
可微渲染:梯度从像素回流到图元参数
渲染公式对每个高斯的参数都是可微的,这让整条路线可以用反向传播训练:给定一组带位姿的输入图,渲染出每个训练视角,与真实图像算 L1 与 D-SSIM 的加权损失,梯度一路回传到 、、、、。
不需要射线采样、不需要体渲染积分、也不需要每个像素做几百次 MLP 调用的另一个好处是训练和渲染的算力形式都对 GPU 友好:高斯可以按 tile 划分、按深度分桶并行,每个像素的累加是一个短序列,可以在共享内存里完成。原始实现在论文测试场景(1 到 500 万个高斯,多数在 1080p 分辨率下)的渲染帧率可达一百帧以上,比 NeRF 的零点几帧每秒快三个数量级以上;代价是每帧一次 GPU 基数排序与 16×16 tile 的重新分桶。
把速度与质量放在同一张表里,会更清楚这笔交换的代价。3DGS 论文在 Mip-NeRF 360 数据集上的平均指标与开销如下(表 1 与图 6 的数字):
| 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | 训练时间 | 渲染帧率 | 显存 |
|---|---|---|---|---|---|---|
| Mip-NeRF 360 | 27.69 | 0.792 | 0.237 | 48 小时 | 0.06 fps | 8.6 MB |
| InstantNGP-Big | 25.59 | 0.699 | 0.331 | 7.5 分钟 | 9.4 fps | 48 MB |
| 3DGS(30K 迭代) | 27.21 | 0.815 | 0.214 | 41.5 分钟 | 134 fps | 734 MB |
读这张表要注意三点。第一,PSNR 不是 3DGS 领先:Mip-NeRF 360 的平均 PSNR 略高(27.69 对 27.21),但 SSIM 与 LPIPS 是 3DGS 更好——说明它的误差更多落在「颜色略有偏差」而不是「结构糊掉」上。第二,速度差距是三个数量级:0.06 fps 对 134 fps,这不是同一类系统。第三,显存代价真实存在:734 MB 对 8.6 MB,前者是显式图元的存储成本,后者是 MLP 权重的成本。这三行数字基本浓缩了整条路线的取舍:用显存换渲染速度,用显式结构换可编辑性,质量上互有胜负。
表示在推理时怎么被查询
前面两个小节讲了两套渲染机制,现在把话题转到推理系统的视角:一个几何场景建好之后,智能体怎么用它?
渲染一次的成本边界
两种表示的每次查询成本可以写成一个简单不等式。设像素数为 ,每像素采样点数 ,每点 MLP 前向成本 ;3DGS 路径设每像素被覆盖的高斯数为 ,每个高斯混合成本 :
是一次几十万乘加的小矩阵链, 是一次二维高斯求值加一次 alpha 混合,二者差一到两个数量级。 是 64+128, 通常只有十几个到几十个(视场内的可见高斯)。这两个数字的乘积差距,就是两种表示在每秒渲染帧数上的差距来源。
更有用的式子是把「分辨率」拉进来。渲染 1080p 的图,;若目标是 30fps,每秒要处理 个像素。如果每个像素的每步运算能压到几十个浮点操作,总运算量大约是 量级——这在现代 GPU 上完全可行。但如果每像素要走 192 次 MLP 前向,总运算量会到 量级,就超出了一个 GPU 的预算。
视角一致性是外推出来的,不是生成出来的
这一点值得单独说明,因为它是几何式世界模型与视频生成式模型最大的定性差异。在 3DGS 里渲染一个从未见过的视角,并不需要模型「想象」这个视角长什么样——它只是把一组三维图元投影到新相机上。视角一致性不需要学习,是表示本身保证的。
这意味着外推能力更强:只要场景重建覆盖了物体的全貌,相机绕到背面也能看到正确的背面;视频模型必须见过或生成过背面视角。代价是几何重建的覆盖必须完整——如果训练时只从正面看过这个物体,3DGS 在背面只会渲染出被拉伸的正面细节。这个问题在所有三维重建方法里都存在,只是程度不同。
对机器人来说,这个性质非常有用:机械臂的腕部相机在整个操作过程中会移动到很多视角,一个在场景里已经建好的物体,可以在任意视角下被查询,而不用视频模型重新生成一遍。
任意视角查询的代价与边界
用渲染做查询,成本随「查询点数」线性增长。规划器如果要评估 100 条候选轨迹,每条轨迹要渲染 10 帧,就是 1000 次渲染。按每秒 100 帧计算,10 秒——对低频规划也许可以接受,对高频控制就不行了。
于是实践中很少整个系统都在渲染上跑。常见做法是分层:
- 渲染层用于感知与回放:离线重建时、评估阶段、可视化阶段;
- 几何层用于规划与碰撞:直接把高斯位置与尺度当作点云/椭球集合,做空间查询;
- 语义层用于物体级推理:把高斯聚类成物体,做对象级的位姿预测。
这三层的成本依次降低,规划路径通常只走几何层与语义层,渲染只用于验证与调试。
离散几何:占用栅格与场景演化
前面两节讲的表示都以「外观」为中心:渲染出来像不像照片,是它们评价优劣的标准。但规划与碰撞检测关心的不是颜色,而是空间里哪里能走、哪里会被挡住。这就引出了第三种几何表示:占用栅格(occupancy grid)。
一个体素回答四个问题
把三维空间切成规则的体素,每个体素用一个标签或多个标签描述:是否被占用、属于什么语义类别、速度是多少。在自动驾驶里常见的形式是每个体素带两类信息——占用概率与语义类别(车、行人、植被、地面),再加上未来若干帧的预测。对机器人来说,每个体素的标签直接对应一个规划约束:占用且属于「可碰撞物」的体素,就是轨迹不能进入的区域。
Occupancy Networks 在 2019 年由 Mescheder 等人提出,用一个隐式函数 表示点 被表面包住的概率。这个形式本身是连续的,但一旦把它离散化到一个 的网格上,它就变成了一个可以查表的张量。这个「可查表」的性质是本文关心的。
离散化的好处很直接:查询成本从「沿射线积分」「投影后混合」变成一次索引。判断一个点是否可通行,只需要算出它在哪个体素里、读一个布尔值。这在规划器里会被调用几万到几百万次(碰撞检测要沿轨迹采样),任何「每次查询都要跑网络」的表示都不可行。
为什么自动驾驶选了占用而不是深度图
在自动驾驶场景里,深度图看起来是更直接的表示——每个像素一个距离值,就能知道障碍物在哪儿。但深度图有三个结构性缺陷:
- 只有可见表面。被前车挡住的路面、对面车道驶来的车的侧面,深度图里都没有数值;
- 没有语义。一张深度图区分不了「路面」(可通行)与「路面上躺着的纸箱」(不可通行);
- 单目歧义。从一张图恢复深度本身就不唯一,误差会直接传导到规划。
占用栅格把这三个问题同时解决:它覆盖整个传感器视锥内的三维空间,被遮挡的部分可以由模型推断补全;每个体素带语义,规划器可以直接按类别设约束;它是多视角或 LiDAR 融合的结果,不是单目反推。这是 2023 年之后自动驾驶世界模型普遍转向「占用 + 语义」的根本原因。
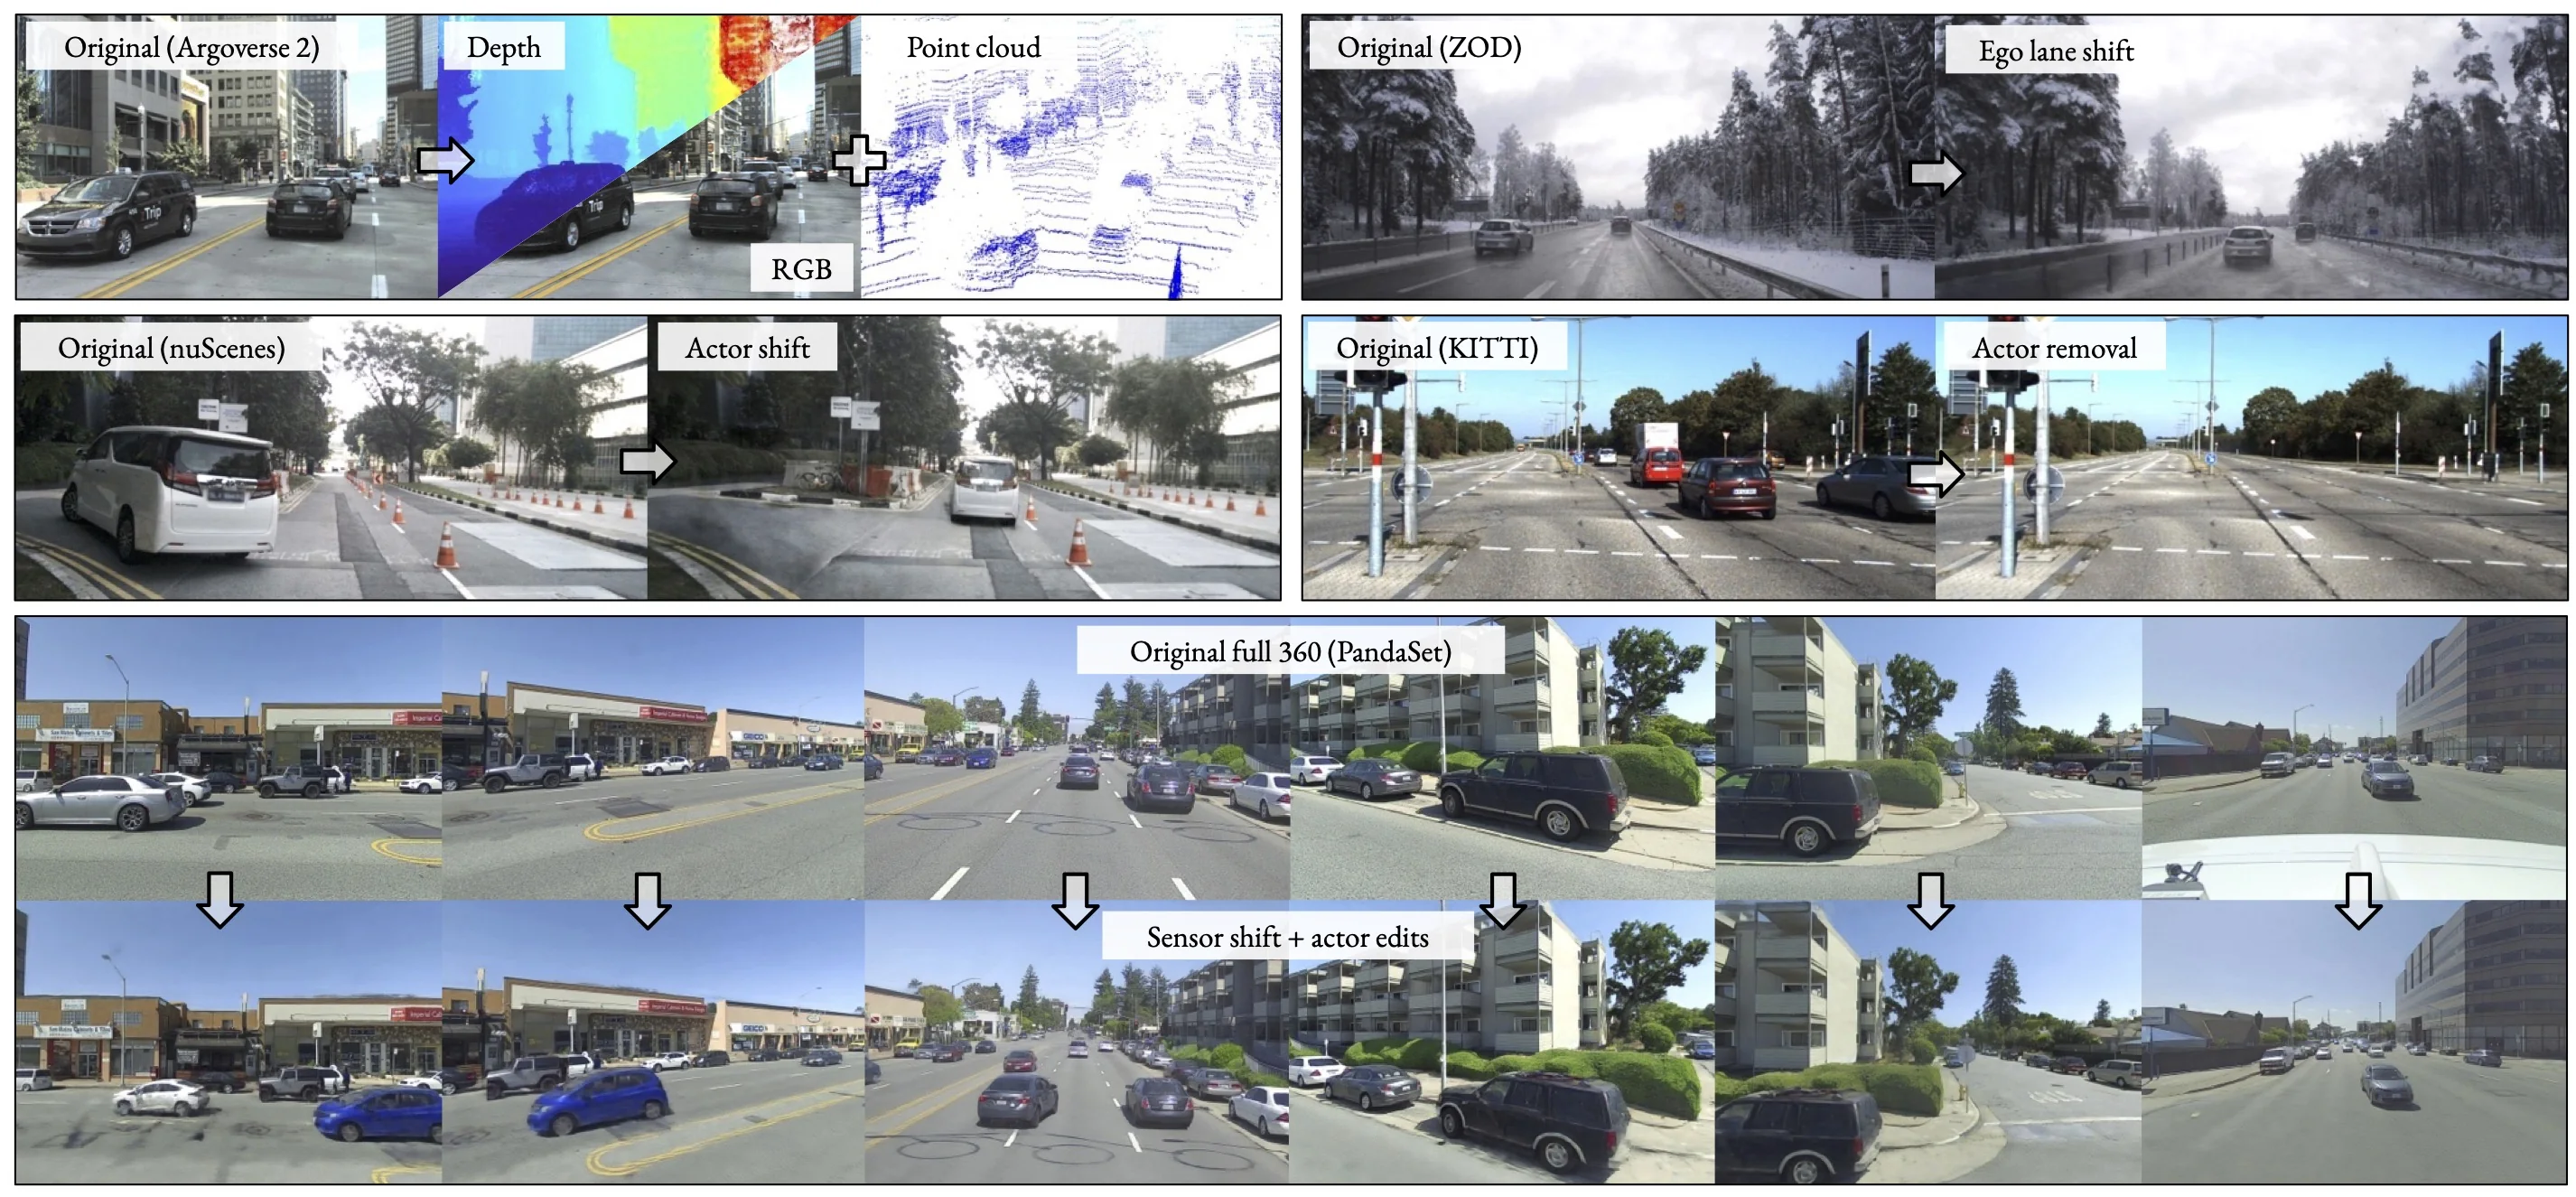
上图来自 NeuRAD(2023)的论文首页图。它展示的是神经场景重建在自动驾驶数据上的作用:场景被重建为一个可渲染的神经场之后,自车位置、其他交通参与者的位姿都可以被改动,车辆可以被删除或新增,然后再渲染出新的传感器数据。这正是「占用栅格」这一层抽象想解决的问题——把「传感器怎么装、时刻怎么采样」与「场景里有什么、在哪儿」分开,让同一套三维表示服务多个车型与多个任务。对占用表示来说,无论传感器是相机拼图还是 LiDAR 点云,最终都落到同一套体素坐标里。图源:Tonderski 等,NeuRAD(arXiv:2311.15260)图 1。
OccWorld:把场景演化写成一个自回归问题
有了当前帧的占用,接下来是最难的一步:预测它怎么变。OccWorld(2023 年,ECCV 2024)的做法是把占用场景先压成离散 token,再用一个自回归 Transformer 预测下一帧的 token——结构上这与语言模型预测下一个词几乎一样。
具体地,OccWorld 先用 VQ-VAE 把每一帧的三维占用压成一组离散的场景 token:为了控制序列长度,它先把 的体素按语义类别嵌入拼到高度维,压成 BEV 形式,再用 2D 卷积编码器和向量量化得到一张低分辨率的 token 图。这张 token 图不是「一个 token 代表一帧」,而是「一个 token 代表一块区域」——比逐体素建模短几个数量级,又保留了空间结构。
序列由两类 token 交替构成:描述周围场景的 scene token 与描述自车状态/运动的 ego token。模型先在每个时间步内做空间混合(把场景 token 聚合成多尺度表示),再沿时间维做注意力,预测下一帧的 scene token 与 ego token;训练目标是让预测的 token 与真实占用/轨迹编码后的 token 一致,推理时把预测出的 token 解码回占用栅格与自车轨迹。规划器如果要评估某条候选轨迹,就把对应的 ego token 序列喂进去,看模型「想象」出的场景是否与这条轨迹自洽。
这个设计有两个值得注意的取舍。第一,压缩必须足够狠。一帧三维场景有几十万到上百万个体素,直接逐体素建模,序列长得根本跑不动。VQ-VAE 把空间压成低分辨率 token 图,本质上是把「高分辨率空间预测」转成了「低分辨率潜空间序列预测」——代价是细节丢失,车辆边界、行人轮廓都变得粗糙。第二,动作以 ego token 的形式进入。规划器如果要评估「往左打方向」与「直行」两种方案,只需换掉 ego token,重新 rollout 一遍。这个接口很像视频世界模型里的条件输入,只是条件作用于 token 而不是像素。
OccWorld 之后这条线迅速分化。2025 年的 SparseWorld 把场景改成一组建模查询(query)而非稠密体素,用稀疏查询表示「场景里有哪些对象」;2026 年的 CascadeOcc 把 VQ 换成级联的多层码本,在粗细两个尺度上分别建模;OccWAM 则进一步把占用预测与自车轨迹联合生成,走向「世界-动作模型」的形式。这些变化的共同方向是:从稠密体素走向对象级、稀疏的表示,因为稠密的体素序列太长,序列建模的算力成本压不下来。
占用预测的推理账本
占用世界模型的成本结构比外观渲染简单得多,但也更「规模化」:
| 环节 | 成本形式 | 说明 |
|---|---|---|
| 感知编码 | 一次图像主干 + 多视角注意力 | 每帧一次,n 个相机 |
| 场景量化 | 一次 VQ 编码 | 把体素降到 token |
| 时间预测 | 自回归 token 生成 | 每预测一步一次解码,类似 LLM |
| 解码回栅格 | 一次 VQ 解码 + 上采样 | 每步一次 |
| 规划查询 | 直接查表 | 每轨迹数百次,几乎免费 |
这张表揭示了占用世界模型和视频世界模型的相似性:预测层同样是一个自回归解码过程。前面第九篇拆过的 KV 缓存、上下文长度、批次调度那套分析,几乎可以原样搬过来。区别只在于「词表」不是自然语言 token,而是场景 token;「序列」不是一句话,而是一段未来场景。
这也解释了为什么 2025 年之后占用世界模型的工程优化大量借用 LLM 推理的技术:稀疏化查询对应稀疏注意力,场景 token 缓存对应 KV 缓存,多步 rollout 对应多 token 投机生成。
动力学:场景怎么从 走到
前面的内容都在解决「 是什么」与「 怎么被看到」,现在回到世界模型最核心的问题: 怎么算。几何场景的动力学有三条实现路径,成本与保真度差别很大。
路径一:物理仿真与刚体动力学
最直接的做法是把重建出的几何交给物理引擎——Isaac Sim、MuJoCo、PyBullet 都可以接收网格或点云,配合质量、摩擦系数、碰撞形状,用刚体动力学积分出下一步。
这条路线的优势是因果可信。碰撞、摩擦、重力、刚体运动,都是被牛顿力学约束的,不会出现「桌子穿过地面」这种错误。对操作任务(抓取、推、堆叠)来说,物理引擎是当前最可靠的动力学来源。
代价有三点。第一,从渲染表示到仿真表示的转换有损:3DGS 是一堆高斯,物理引擎需要的是带碰撞形状的网格;把高斯转成网格、再把网格简化成凸包或胶囊体,每一步都会丢细节,而且转换本身并不总是成功(穿模、非水密网格)。第二,物理参数要猜。同一块布料的摩擦系数、同一个杯子的质量,从视觉上很难准确估计,参数错了,动力学就错了。第三,仿真本身有成本:刚体仿真一次可以很便宜,但如果有几百个物体、细长接触、柔体,仿真步长必须小,成本会上升。在闭环控制里,仿真的时间预算通常只有几毫秒。
路径二:学习出来的动力学
第二条路径是学一个模型。输入当前场景表示,输出下一步场景表示——可以是预测每个高斯的位移与旋转,可以是预测体素标签,也可以是预测场景 token 序列。
在 3DGS 场景上,这对应 4D Gaussian Splatting 这类工作:把一个静态高斯集合扩展成带时间维的高斯,每个高斯有随时间变化的中心与参数,用轨迹或变形场来表达运动。2024 年的 4DGS 用一组时间条件的高斯与变形场建模动态场景,2025 年的 SplatFlux 则把 4D 高斯重建做成从视频潜空间前馈生成——输入一段视频,直接输出可渲染的 4D 场景,不需要逐场景优化。
学习动力学的优势是成本可以做得比仿真低,而且能从数据里学到物理引擎写不出来的东西(布料褶皱、液体、可变形物体)。问题是可靠性:学习模型也会犯「桌子穿过地面」的错误,而且这种错误不会像仿真那样被物理约束拦住。第九篇讲过的复合误差在这里依然成立——多步 rollout 之后,几何场景会逐渐漂移、变形。
路径三:混合——物理引擎做骨架,学习模型做修正
第三条路径是两者混合,这也是目前工业系统最常见的选择:
- 刚体、地面、已知物体用物理引擎处理,因为它们有明确的动力学模型与参数;
- 未知物体、柔体、交互细节用学习模型修正,物理引擎给出的结果再被一个残差网络修正;
- 场景表示用几何表示(高斯或体素),因为它同时兼容渲染与碰撞两种查询。
这套分工可以用一句话概括:学习模型负责「猜会怎样」,仿真负责「确认能不能怎样」。接口的干净程度,决定了整套系统能不能在闭环里跑起来——接口不清楚,每一次物体位姿的转换都要重新标定,误差会在两个子系统之间来回放大。
混合路线的工程接口是一个关键问题:物理引擎在时间步 输出的物体位姿,如何转成高斯或体素?反向的「从观测推断当前场景状态」又怎么对齐到物理引擎里的刚体?一套做得干净的实现通常有一个「场景图」(scene graph)作为中间层,物体是图上的节点,几何表示是节点的属性,物理引擎与学习模型都在这张图上工作。
把两条路放进一张对照表会看得更加清楚。
| 物理引擎 | 学习动力学 | 混合 | |
|---|---|---|---|
| 因果可信度 | 高(受物理约束) | 中(依赖数据) | 高(骨架是仿真) |
| 多步误差 | 低(无学习误差) | 高(复合误差) | 中 |
| 未知物体 | 无法处理 | 可处理 | 可处理 |
| 每步成本 | 毫秒级(物体少) | 一次前向 | 两者相加 |
| 参数从哪来 | 人工设定或估计 | 数据学出来的 | 二者结合 |
| 失败形态 | 穿模、抖动 | 漂移、幻觉 | 接口不一致 |
在场景里查询:规划到底需要什么
到这里,场景、渲染、动力学都讲完了,但还没有回答一个很实际的问题:规划器到底怎么用这个场景?
碰撞检测:一条轨迹要查多少次
设一条候选轨迹有 个路径点,每点用 个包围体近似机器人本体(机械臂用圆柱段、移动底座用矩形),每个包围体要做 次采样检查是否与场景物体相交。总查询次数是 。典型值:,,,即 8000 次查询。如果一帧要评估 1000 条轨迹,就是 次。
这个量级决定了碰撞检测必须能在 GPU 上批量跑、或者在 CPU 上用空间索引(八叉树、哈希网格)跑。任何「每次查询都要一次网络前向」的表示都会被这个量级压垮——这就是为什么几何式世界模型的规划路径总是走进离散表示,而不是走进渲染。
距离场:把「最近障碍物多远」做成一个可查的量
碰撞查询有一个更优雅的替代:符号距离场(signed distance field,SDF)。定义 为点 到最近表面距离,内部为负、外部为正:
有了 SDF,碰撞检测退化成一次查表加一次比较: 就安全, 是机器人的安全半径。更妙的是梯度: 就是远离障碍物的方向,可以直接作为避障梯度用。3DGS 可以从高斯位置与尺度直接得到一个无符号距离场(把每个高斯当作椭球,求点到椭球集合的最小距离),符号可以从重建出的表面法向或自由空间判断出来。这一步转换在实践中很常见:高斯集合 → SDF 体素 → 规划器。
语义与物体图的接入
规划不光要避开障碍,还要知道「这是什么」。把高斯或体素聚类成物体、给每个物体挂语义与位姿、再维护一个物体之间的接触关系,得到的就是一个物体图(object-centric scene graph)。规划器在物体图上操作的成本远低于在原始几何上操作:它只需要问「杯子的位姿、杯子到桌沿的距离、夹爪的预测接触点」。
这一层也是几何式世界模型与语言模型对接的位置:VLM 可以把「厨房台面上有哪些东西」转成物体图上的节点,几何场景负责提供精确位姿与尺寸,两者合起来才是一个「能听的」三维世界。
位姿从哪来:闭环里最容易被低估的一项
前面几节假设相机位姿已知。真实系统里,这个假设经常不成立,而且是整条链上最容易被低估的一项成本。
已知位姿 vs 未知位姿
- 已知位姿:相机装在机械臂上,臂的运动学给出位姿;或者相机固定在场景里,标定好外参。精度高,重建时不需要额外估计,但会有机械误差与标定漂移。
- 未知位姿:手持相机、移动机器人、手机拍摄。位姿要从图像里估计(SfM、SLAM、视觉里程计),误差与耗时都不可忽略。
对几何式世界模型来说,位姿是重建质量的隐形乘数。位姿偏一厘米,同一个表面就会在两张图里被优化成两个「重影」的密度层,渲染出的物体边缘会变糊。这一点在端到端评估里不容易看出来(整体 PSNR 只掉一点),但对需要几何精度的抓取与碰撞检测是致命的。
在线重建:增量更新,避免整场景重算
机器人工作在一个会变化的场景里:桌上的杯子被拿走了、门开了、有人走过。重建不能每次都从头开始,需要增量更新。3DGS 的增量版本(在线 SLAM 式的 3DGS)会做三件事:
- 新增高斯:新观测覆盖的区域,从新视角的点云里初始化新的高斯;
- 删除高斯:移走的物体留下的高斯,通过新观测的「不透明度持续下降」或与当前深度图的矛盾来识别并剪枝;
- 位姿修正:在优化外观的同时微调相机位姿,把累积漂移吸收掉。
这三件事的关键是判断哪些高斯该删。一个高斯在多个视角下都没被看到,可能只是暂时被遮挡,也可能是物体真的走了。判断错了就会出现「鬼影」——物体已经不在了,渲染里还留一个半透明的轮廓。这类问题目前没有通用的解法,常见做法是用「可见视角数」「近几帧的残差」等启发式规则,配合周期性的整体重建。
系统的账本:把几何式世界模型放进闭环
把前面所有内容收拢成一笔账,会看得更清楚它适合放在系统的哪个位置。
存储与带宽
| 表示 | 典型大小 | 更新粒度 | 访问模式 |
|---|---|---|---|
| NeRF(MLP) | 几十 MB 权重 | 整体重训 | 随机读权重 |
| 3DGS(静态场景) | 几百 MB 到数 GB | 单高斯增删 | 随机读图元 |
| 占用栅格(单帧) | 几 MB 到几十 MB | 整帧替换 | 顺序/块读 |
| 场景 token(OccWorld 类) | 几 KB 到几十 KB | 每步一个 token | 序列读 |
注意 3DGS 与占用栅格在大小上的巨大差距:前者是「外观的完整重建」,后者是「规划需要的抽象」。一个场景用 3DGS 表示可能几百 MB,压成占用栅格只有几 MB。这解释了为什么部署在机器人上的系统通常同时维护两套表示:一套完整外观用于感知与可视化,一套抽象几何用于规划。
延迟预算
设控制频率为 (典型 10 Hz 到 100 Hz),一个控制周期的预算为 。几何式世界模型在其中的时间花在:
- :从图像推断当前几何(一次前向或一次在线更新);
- :把新观测合并进场景表示;
- :评估候选轨迹需要的渲染或查询;
- :碰撞与安全约束的验证。
这四项里, 是最容易被低估的——在线重建中的高斯增删需要优化,而不是简单的数组 push; 则取决于规划器怎么用场景,用物体图可以压到微秒级,用完整渲染则到毫秒级甚至更高。
与视频世界模型的分工
把几何式与视频生成式放在一起对比,它们在系统里的位置并不重叠:
| 能力 | 几何式世界模型 | 视频生成式世界模型 |
|---|---|---|
| 回答「某点有什么」 | 直接 | 不能 |
| 回答「下一步画面」 | 需渲染 | 直接 |
| 物理外观(光照、材质) | 依赖重建质量 | 依赖数据先验 |
| 未知场景泛化 | 需重建 | 可直接生成 |
| 每帧成本 | 渲染几十毫秒 | 生成数百毫秒到秒级 |
| 可编辑性 | 强 | 弱 |
实践中两者往往组合使用:几何式模型提供「这里有什么、在哪里」的稳定骨架,视频生成式模型提供「接下来可能发生什么」的先验;几何给视频模型提供相机位姿与深度作为条件,视频模型给几何场景提供未观测区域的「合理猜测」用于补全。
第九篇里拆过世界模型推理系统的那笔账,这一篇补上了其中的几何分支:如果系统里多了一层三维表示,账本里就多出存储、更新、查询三类成本,但也多出了度量、遮挡、编辑三种能力。把这一维补上之后,系列对世界模型基础概念的覆盖就基本成形了:形式化与三条主线、评测与部署、规划与搜索、推理与硬件的账本、误差与动力学前史、几何场景。更细的内容——某篇论文的实现细节、某条路线的最新进展——属于专题深入,而不是入门铺垫。
与系列前文的接口
几何式世界模型不是一个独立的第四路线,它是前十一篇里几条线索的「落地形式」。把接口逐个说清楚,可以让这个系列读起来是一张网而不是列表。
与评测的接口
第六篇的物理一致性评测要求模型能回答「物体穿模了吗」「反事实下该发生什么」。在视频模型上,这两件事都要靠生成结果去观察,误差大且不可控。在几何场景上,它们变成可以直接计算的量:物体是否相交、轨迹是否穿过不可通行区域、把某个物体平移后是否与障碍物重叠。几何表示把一类定性评测转成了定量计算,这是它对评测最大的贡献。
反事实测试也因此更容易做:改一个物体的位姿、重新渲染或重新查询,其他部分完全不变,就能测模型对单个变量变化的响应。这在视频模型上几乎不可能——重新生成整段视频,所有帧都会有细微变化。
与规划、部署的接口
第八篇的潜空间规划(CEM、MPPI、MuZero)全部在一个潜空间里搜索动作。如果把这个潜空间换成一个几何场景,搜索空间就从「抽象向量」变成了「可解释的三维状态」——搜索到的轨迹可以在渲染中被验证、可以在物体图上被标注、可以在仿真里被复现。这在工程上换来的是可调试性:一个在潜空间里看起来最优的轨迹,可能因为碰撞检测发现穿墙而被否决,而否决的理由可以被明确地写出来。
第七篇讲的部署环节(延迟预算、动作分块、异步执行)同样适用。几何模型的每个环节都有自己的延迟,把它们像第七篇那样拆成一个账本,就能找到瓶颈在重建、更新还是查询。
与推理系统、硬件的接口
第九篇拆过视频世界模型的 KV 缓存与调度。几何式世界模型的推理系统没有 KV 缓存,但有自己的「状态管理」问题:高斯集合需要按区域划分(空间哈希、八叉树),渲染时按相机视锥裁剪,更新时按可见性批量处理。这些操作用到的数据结构——空间索引、稀疏张量、拓扑排序——与稀疏注意力里的块稀疏矩阵、与 GPU kernel 里的 tile 划分,在底层是同类的。
第十篇讨论的能耗下界与片上规划加速器,对几何式模型也有意义:碰撞检测是纯算术的、可以做成专用单元;高斯渲染的高度并行性适合固定数据流。不过几何模型的片上化难度更高,因为场景大小不固定、增删过程不规整——这是本文之外、留待硬件篇继续讨论的问题。
局限与已经显露的边界
这一节不是要把前面的内容全都否掉,而是把几何式世界模型在当前阶段最明显的几道坎摆出来。它们决定了这条路能走到哪里。
重建覆盖是硬门槛
所有几何表示都依赖「观测覆盖」。一个物体如果从来没被看到过,几何表示里就没有它;一个表面如果只从一个角度被看到,背面就是猜的。这与视频生成式模型的结构性差异是:后者能「生成」未观测区域,前者只能「优化」已观测区域。对机器人来说,这意味着工作场景必须被有效扫描过,或者系统里必须有主动探索。
动态与可变形物体
刚体好办,布料、液体、软体难办。3DGS 的变形场可以建模一定程度的非刚体运动,但高自由度形变的视觉重建在质量和速度上都还不成熟。物理仿真能处理大部分可变形物体,但反过来要求精确的重建与参数估计。这条边界目前在机器人操作里非常明显——堆叠衣物、倒水、挤牙膏这类任务几乎都还在仿真里跑。
大规模场景的表示大小
一个房间用 3DGS 表示可以做到几百 MB;一个仓库、一条街道会到 GB 级。在这样的规模下,渲染变成了显存带宽问题而不是算力问题:每一帧要把大量高斯参数读进 GPU。空间分块、动态加载、多分辨率 LOD(层次细节)是工程上的必要手段,但它们让「一个场景是单一表示」的简洁性受损——系统必须在场景图层面管理「哪些块是加载的、哪些块是低分辨率的」。
与生成式模型的融合还很不成熟
把几何表示与视频生成结合,是目前最活跃的方向之一,但接口远没有稳定。常见的几种做法——用视频模型补全几何场景的未观测区域、用几何场景给视频模型提供几何约束、用几何渲染作为视频模型的中间表示——都各有明显缺陷,评测标准也不统一。这意味着这条路线在短期内更可能是「几何做骨架、生成做补充」,而不是某一方取代另一方。
小结
这一篇补上了系列里一直空缺的一维:世界模型可以不只是一个向量或一串 token,它可以直接是一个三维场景。
从形式化上看,几何式世界模型是三元组 :状态是几何对象,渲染器把状态映射到图像,动力学把状态映射到下一个状态。与潜空间模型相比,它的优势在于状态是可查询、可度量、可编辑的;它的代价在于必须从观测重建、必须维护表示的一致性、必须为查询与更新支付额外成本。
三种表示各有位置。NeRF 用连续函数表达外观,质量高但渲染慢,空区域浪费严重;3DGS 把场景拆成可投影的高斯,渲染快、可编辑、但表示大小会自适应膨胀,动态场景难处理;占用栅格放弃外观、只要空间占用与语义,查询极快、与规划天然对接,但分辨率受栅格限制、细节靠模型补。真实系统往往三者混用。
动力学有三条路径:物理仿真、学习动力学、两者混合。物理仿真因果可信但需要精确的几何与参数;学习动力学成本低但会累积误差;混合路线在当前工程里最常见,代价是接口复杂。
最后是一笔账:几何式世界模型让系统的成本从「每次生成」变成「重建一次 + 每次渲染 + 每次更新」,并且多出存储、空间索引、状态一致性三类负担。它换来的能力——度量、遮挡、物体恒存、局部编辑——恰恰是操作类任务绕不过去的。理解这笔交换,是判断「什么时候该上几何表示、什么时候用生成式模型就够」的关键。
参考资料
- NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis(Mildenhall 等,ECCV 2020,arXiv:2003.08934)
- 3D Gaussian Splatting for Real-Time Radiance Field Rendering(Kerbl 等,INRIA 等,SIGGRAPH 2023,arXiv:2308.04079)
- 3D Gaussian Splatting 官方项目页(INRIA GraphDeco)
- Occupancy Networks: Learning 3D Reconstruction in Function Space(Mescheder 等,CVPR 2019,arXiv:1812.03828)
- OccWorld: Learning a 3D Occupancy World Model for Autonomous Driving(arXiv:2311.16038,2023-11)
- NeuRAD: Neural Rendering for Autonomous Driving(arXiv:2311.15260,2023-11)
- Instant Neural Graphics Primitives with a Multiresolution Hash Encoding(Müller 等,SIGGRAPH 2022,arXiv:2201.05989)
- Neuralangelo: High-Fidelity Neural Surface Reconstruction(CVPR 2023,arXiv:2306.03092)
- SparseWorld: A Flexible, Adaptive, and Efficient 4D Occupancy World Model Powered by Sparse and Dynamic Queries(arXiv:2510.17482,2025-10)
- CascadeOcc: Rethinking 3D Occupancy World Models with Cascaded VQ Representations(arXiv:2606.27644,2026-06)
- OccWAM: Occupancy World-Action Models with Joint Scene-to-Ego Flow Matching(arXiv:2610.17688,2026-10)
- SplatFlux: Feed-Forward 4D Gaussian Reconstruction and Generation from Video Latents(arXiv:2610.28257,2026-10)
- AEON: Unifying Video and 3D World Models(arXiv:2610.28631,2026-10)
- 4DGS-WAM: Bridging Past and Future with an Object-Centric World Action Model based on 4D Gaussian Splatting(arXiv:2608.25956,2026-08)
- Mip-NeRF 360: Unbounded Anti-Aliased Neural Radiance Fields(CVPR 2022,arXiv:2111.12077)
- DreamerV3: Mastering Diverse Domains through World Models(arXiv:2301.04104,2023-01)
- V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning(Meta FAIR,arXiv:2506.09985,2025-06)
图源说明:NeRF 渲染流程图取自 arXiv:2003.08934 的 Figure 2;3DGS 首页图与致密化过程图取自 arXiv:2308.04079 的 Figure 1 与 Figure 4,新视角合成示意图取自 arXiv:2003.08934 的 Figure 1;场景编辑与传感器布置示意图取自 NeuRAD(arXiv:2311.15260)的 Figure 1。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



