


世界模型从零讲起(十七):记忆不在注意力里——世界模型如何记住走过去的世界
承接前十六篇:记忆被默认放进了注意力里
前面十六篇把世界模型的几个层面拆完了:第一篇给出形式定义——世界模型是在内部表征里模拟「观测随动作如何演化」的模型;第二、三、四篇分别拆了重建式(Dreamer 的 RSSM)、联合嵌入(JEPA 系列)与视频生成式(Sora、GAIA-1、Cosmos、Genie)三条路线;第五篇讲 WAM,把动作从输入变成输出;第六篇讲评测,其中「长程记忆」被列为三层评测中最难量化的那一层;第七、九、十篇讲部署、推理系统与能耗;第八篇讲潜空间规划;第十一至十五篇补了 Dyna 谱系、几何、物体中心、分层与预算地图;第十六篇收在动作接口上。
有一条线索在这些篇目里反复出现,却始终没有被单独拎出来讲。
它出现在第六篇:长程记忆测的不是「画面是否清晰」,而是走了一圈再回来,世界还是不是同一个世界。它也出现在第九篇:交互式世界模型的 KV 缓存必须跨请求存活,因为用户松手再按下,世界不该重置;缓存按「会话」而不是按「请求」管理。它还出现在第七篇:想象出来的世界如何与真实世界对齐,靠的是状态管理与缓存策略。
这些说法都正确,但它们默认了一件事:记忆就是模型注意力里的那一段上下文。于是「让世界模型记住更久」被理解成「把上下文窗口拉长」「把 KV 缓存留住」「把历史帧按指数衰减压缩进去」。这一篇要说明的是,在 2025 到 2026 年的可交互世界模型里,这个默认前提正在被拆开:持久记忆被移出注意力,放进一个外部存储或一块专用参数里——一个记忆库、一张点云、一条位姿索引、一条 GPU/DRAM/NVMe 的分页链,或者一组慢权重。主干仍在做同样的去噪或自回归,变的是它在生成每一帧时去哪里找曾经看见过的东西。
这不是工程细节层面的小改进,而是一次结构性的分工。下面的每一节都会围绕同一个问题展开:当记忆不在注意力里,它到底被放在了哪里,检索又凭什么可靠。
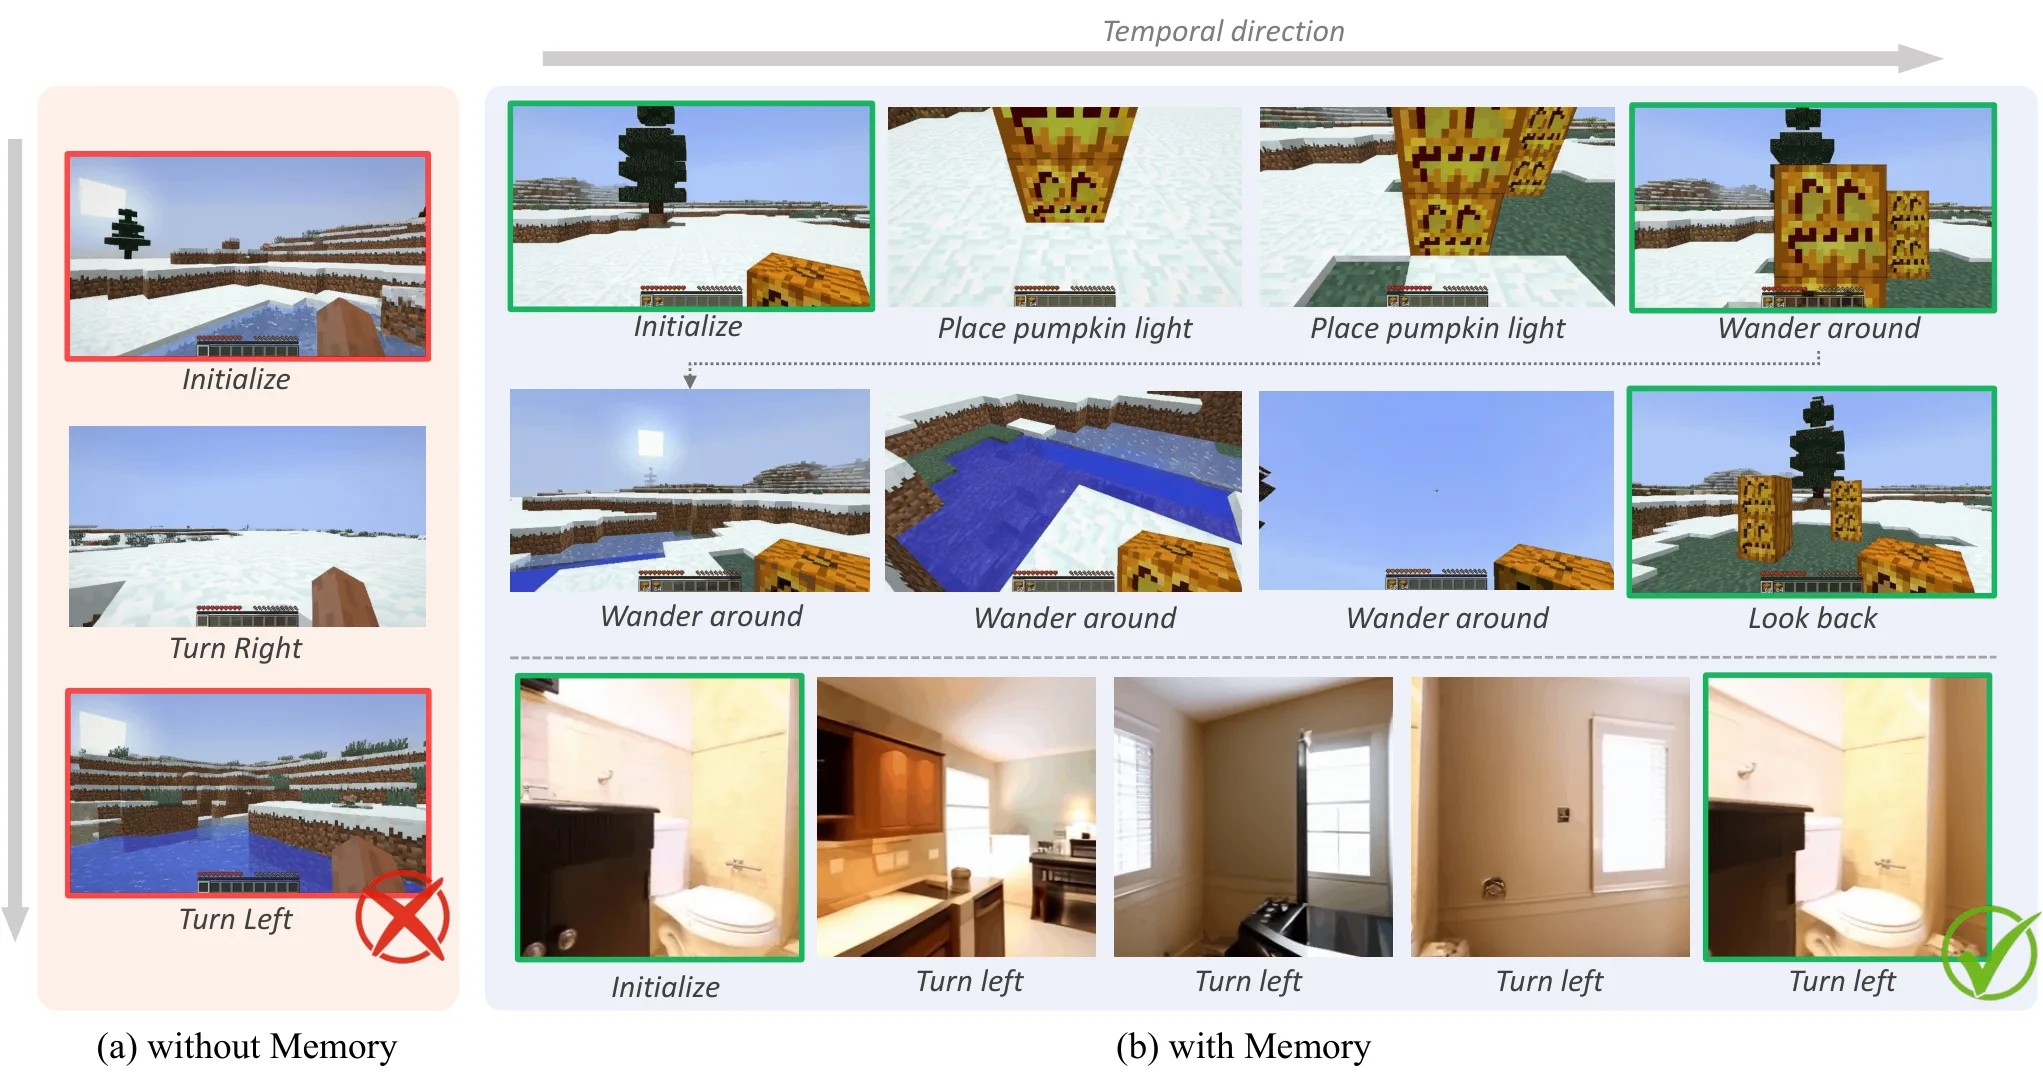
上图来自 WorldMem 论文 Figure 1(arXiv:2504.12369)。两排展示同一条探索轨迹:相机先放置一个南瓜灯,再四处走动,最后回头。上排是没有外部记忆的基线,回访时南瓜灯的位置和周围积雪都变了;下排把历史帧与位姿存进记忆库,回访时不仅找回南瓜灯,连「灯把周围雪融化」这种随时间演化的痕迹也保留了下来。这张图把本文要讨论的问题摆得很清楚:「画得像」与「记得住」是两种能力,后者不能靠把当前窗口画得更好来获得。
记忆到底要存什么:从历史到一个可查询的状态
先把「记忆」这个词收紧。设到第 步为止的交互历史为
其中 是观测(图像、视频帧、点云), 是智能体发出的动作。世界模型要回答的是:给定这段历史和一个未来的动作序列,下一段观测会是什么。写成概率形式:
如果模型能把整个 都作为条件,它就不需要「记忆」这个概念——历史本身就是记忆。问题在于 随交互无限增长,而任何模型的条件计算都有成本上界。于是所有实用系统都在做同一件事:用一个有限大小的 替代 ,
就是记忆机制:它可以是循环网络的一次状态更新,可以是注意力窗口里保留的 KV,也可以是一次带位姿的检索。判断一个记忆机制好不好,本质上是判断 对未来的预测是否够用,也就是条件互信息
是否足够小。这个量没法直接算,但它给出了一个清晰的设计视角:记忆不是「存得越多越好」,而是「存下那些对预测有用、且能在需要时被取出来的部分」。
这也解释了为什么世界模型的记忆比语言模型的上下文更难做。语言模型丢一段旧上下文,最多是忘了说过什么;世界模型丢一段历史,意味着一个物体可能换一个外观、一堵墙可能换一个位置,而模型自己并不知道「这里曾经看过」。前者是信息缺失,后者是空间承诺的违约——它对下游规划与控制的破坏要大得多。
按「存什么」来分,世界模型需要记住的内容至少有三类,它们的存储形态并不相同:
- 静态空间结构:墙、桌子、地形。它不随动作变化,但会随视角变化。最好存成某种三维表示,而不是一堆二维帧。
- 动态实体状态:门是开是关、杯子是满是空、雪有没有融化。它随时间演化,必须带时间戳,否则同一地点在不同时刻的两次观测会被混成一张「平均画面」。
- 情节细节:某个特定物体的纹理、标识、摆放。它不适合压进三维点云(点云太稀疏),更适合保留少量关键帧。
人类记忆的研究常把后两类对应到「工作记忆」「情景记忆」「空间记忆」,2025 年之后的视频世界模型确实借用了这套划分。但借喻只是组织语言,真正的约束来自存储与检索的成本结构。下一节先看最古老、也最容易被默认的一种载体:循环状态。
载体一:循环状态——固定大小的记忆
Dreamer 系列的 RSSM 是这类记忆的代表,第二篇已经拆过它的结构。这里只取与记忆有关的那一半:确定性循环状态 的更新
其中 是上一帧推断出的随机潜变量, 是动作, 通常是一个 GRU。 的维度是固定的,比如 512 或 1024;不论交互进行了 10 步还是 10 万步,它占用的存储都是同一个常数。每步更新只做一次 的矩阵乘,读取的只有上一时刻的状态,不需要回看任何历史帧。
这是所有记忆载体里成本最低的一种。它也是唯一一种不需要检索的载体:记忆就在状态里,前向计算自然带上它。对短视界的控制任务,这已经够用——机器人抓一个杯子只需要知道过去一两秒发生了什么,固定状态的记忆容量足以覆盖。
问题出在「固定大小」这四个字上。循环状态是一个信息瓶颈:所有历史都必须被压进同一个 维向量。压缩必然有损,而有损的方式对后续预测并不友好。用动力系统的语言看, 对 的依赖由雅可比矩阵的乘积决定:
如果这个乘积的谱半径小于 1,早先输入的影响会随 指数衰减。GRU 的门控可以让某些方向保持长期记忆,但那是网络自己学出来的选择,不是外部可控的保证。训练时模型会倾向于记住「对当前预测损失有用」的信息,而「十分钟前路过的那个房间长什么样」对当前帧的预测损失几乎没有贡献——它不会被优先保留。
这就形成了一个结构性错配:循环状态擅长记住「最近发生了什么」,不擅长记住「很久以前看见过什么」。前者是时间连续性问题,后者是空间回访问题。交互式世界模型恰恰以后者为生命线:用户走开、绕一圈、再回来,模型必须认出这是同一个地方。固定大小的状态做不到这一点,不是因为容量不够大,而是因为它没有「按地址取回某段历史」的能力——它只有「当前状态」这一个地址。
把这一点量化会更直观。假设 是 1024 维的 float16,存储是 2 KB。一段 60 秒、20 fps 的交互有 1200 帧;即便每帧只记 1 KB 的视觉特征,原始历史也有 1.2 MB,是循环状态的六百倍。循环状态不是「记得少」,而是「把 1.2 MB 的信息压成了 2 KB」。如果被压掉的恰好是回访时需要的那部分,模型没有任何办法把它找回来。
所以在 2025 年之后的系统里,循环状态很少单独承担长程记忆。它通常作为「短期工作记忆」或「状态汇总器」存在:Dreamer 用它维持想象的连续性,而视频世界模型把它换成注意力,或者干脆把记忆外置。下一节看注意力这条路径。
载体二:上下文窗口——精确,但会到期
Transformer 世界模型的条件是显式的历史 token。设第 层在生成第 帧时读取前 帧的键值:
这里的记忆就是 KV 缓存。它和循环状态相反:存储精确、可寻址、但成本随时长增长。缓存字节数是
其中 是层数, 是每层 K/V 的维度, 是每个元素的字节数,因子 2 对应 K 与 V。 是窗口长度。计算量更麻烦:注意力对窗口是平方的,;这意味着「把窗口翻倍」不是多花一倍显存,而是多花四倍注意力计算。
窗口的边界就是记忆的边界。第 帧之前的内容不只是「权重变小」,而是从条件里彻底消失。模型再生成到那个地点时,没有任何机制提示它「这里曾经有过东西」;它会当作新场景重新画一遍。WorldMem 论文把这种现象称为有限探测视界(limited probing horizon)导致的世界不一致:不是生成质量下降,而是世界承诺断裂。
把上下文本身当记忆:Context-as-Memory
Context-as-Memory(Yu 等,2025 年 6 月,arXiv:2506.03141,TOG)对这个问题给了一个很直接的答案:不要为记忆设计额外的模块,直接把历史帧当作记忆,沿帧维拼到输入里。
它的做法可以拆成两个设计。第一,记忆以帧的形式保存,不做额外后处理——不需要把历史压成 token、不需要训练一个记忆编码器。第二,条件注入靠沿帧维拼接:干净的历史 latent 与带噪的待生成 latent 在 DiT 的注意力里同等参与计算,但输出时只更新 , 保持不变:
这里 是相机位姿。拼接的好处是支持变长上下文——历史有多少帧就拼多少帧,不需要为固定长度设计 Adapter。位置编码也要相应处理:待生成帧沿用预训练时的位置编码,新拼进来的历史帧分配新的位置编码;论文的基座用 RoPE,正好能自然支持变长。
如果只做到这里,它仍然是一个「把所有历史都塞进注意力」的方案,成本不可接受。真正让它可运行的是第二步:记忆检索。论文比较了四种从历史里挑帧的策略:
- 随机选:历史短时可用,历史一长就选不中真正相关的帧。
- 选最近窗口:实现简单,但相邻帧高度冗余,且完全忽略时间上更远、空间上可能重合的旧场景。
- 层次压缩(FramePack 式):按指数衰减给最近帧分配预算,压缩率高但会丢掉久远历史;手动保留关键帧又缺少选择准则。
- 基于相机轨迹的 FOV 检索:用相机位姿判断两帧的视场是否重叠,只取与当前待生成帧「看得见同一片区域」的历史帧。
FOV 重叠的判定被简化成二维射线相交:相机运动限制在 XY 平面,每台相机取左右两条射线,检查四个交点是否落在合理距离内。这个近似会漏掉遮挡等边角情况,但论文的判断是「偶发的漏检或错检不会显著影响整体表现」——因为它只需要把候选集从几百帧降到几十帧,剩下的交给模型自己推理。
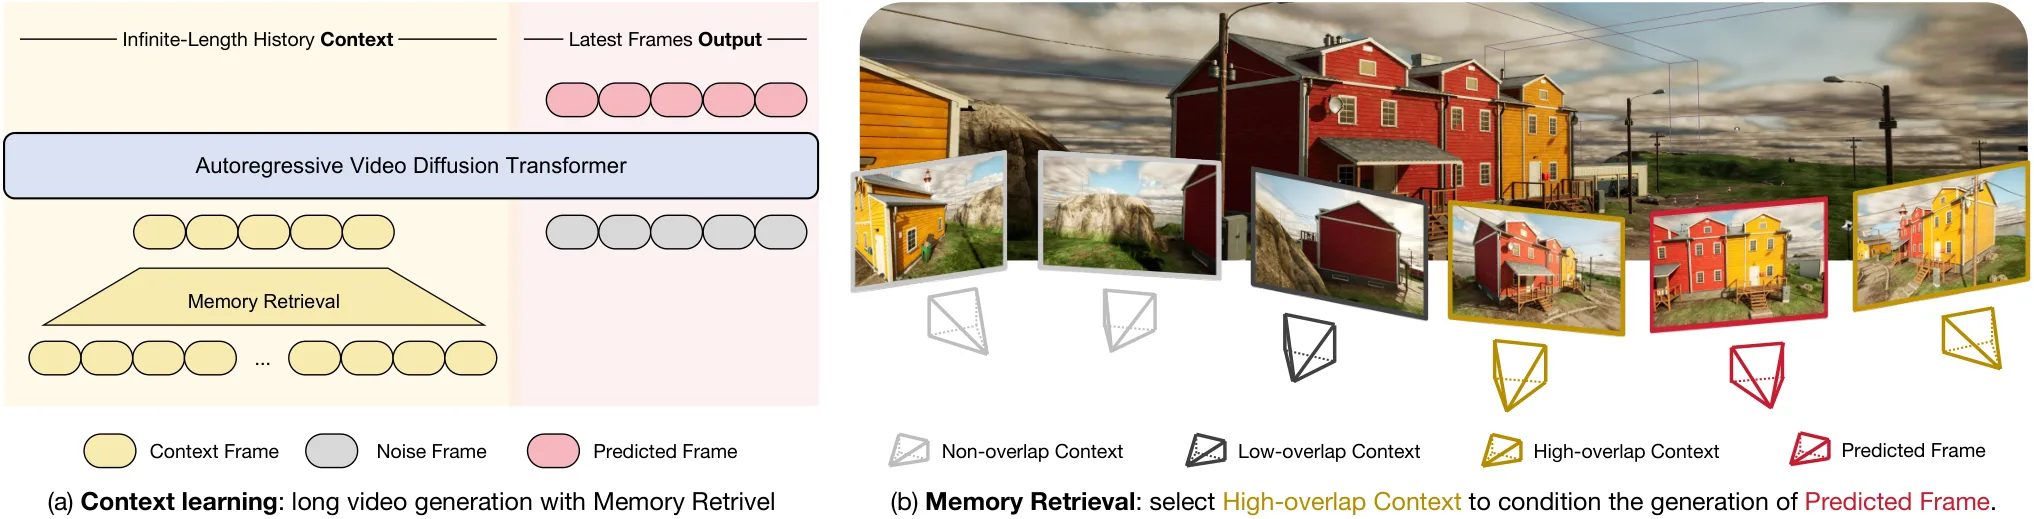
上图来自 Context-as-Memory 论文 Figure 3(arXiv:2506.03141)。左侧是训练与推理共用的条件方式:历史帧作为干净 latent 与待生成 latent 一起进 DiT,只有后者被更新。右侧是检索:给定当前相机位姿,从历史里挑出视场重叠的帧,重叠程度分为高、低、不重叠三档;只有高重叠的帧才真正携带「同一片区域」的信息。
检索之后还有一层去冗余:对连续帧分组,每组只随机保留一帧;如果筛完仍超过上下文上限,再补几帧在空间或时间上最远的,以覆盖长期信息。最终保留的上下文数 是一个显式的预算参数。
论文的消融给出了两个可直接用的数字。上下文长度从 1 增加到 30,记忆能力持续提升,但到 30 时生成速度明显下降;20 是效果与速度的折中点。检索策略上,随机选的 PSNR 是 17.70、LPIPS 是 0.4847;先做 FOV 过滤、再对连续帧去冗余(FOV+Non-adj)之后,PSNR 升到 20.11、LPIPS 降到 0.3075。提升不是来自模型变大,而是来自「把无关帧从条件里拿掉」——无关历史不仅浪费计算,还会作为噪声干扰生成。
这个结果值得停一下。它说明记忆系统的瓶颈往往不在「存不下」,而在「取不准」。同一批历史帧,随机取和按视场取,效果差了一截;而模型本身完全没有变。后面几节的系统,本质上都在用不同的方式回答「怎么取准」。
上下文记忆的三个成本
把上下文当记忆,成本可以分成三笔,它们决定了这条路线能走多远。
第一笔是存储。 KV 缓存随窗口线性增长,且每层都要存。以一个 40 层、每层 K/V 合计 4096 维、窗口 10 万 token 的模型为例,按 层数因子与每元素 2 字节算, 字节约 65 GB——这还没有算视频 token 比文本 token 更密的情况。第九篇算过类似账,结论是自回归世界模型是「decode 密集型」负载,瓶颈在显存读写而不是算力。
第二笔是计算。 注意力的平方项让长窗口变得昂贵。更麻烦的是,视频世界模型的每一步都要对整个窗口做注意力,而 LLM 的 prefill 只做一次、decode 每步只处理一个新 token。同样的窗口长度,视频模型的单位时间成本高得多。
第三笔是「到期」带来的隐性成本。 窗口外的历史不是免费消失的:模型会在回访时重新生成一个不一致的场景,而系统没有任何信号知道「这里本该有记忆」。要发现这种失败,必须专门做回访评测——这正是第六篇那套长程记忆评测存在的原因。
三笔成本合起来,指向同一个结论:上下文窗口适合做短期、精确、高带宽的记忆,不适合做长期、稀疏、按地址访问的记忆。 长期记忆需要另一种结构:把历史搬到注意力之外,按需取回。这就是下一节的记忆库。
载体三:外部记忆库——把「记得」变成「取回」
WorldMem:带位姿与时间戳的记忆单元
WorldMem(Xiao 等,2025 年 4 月,arXiv:2504.12369)把记忆从「上下文」变成了「数据库」。它维护一个记忆库,库里的每一条不是一帧图像,而是一个记忆单元:
其中 是记忆帧,以 token 形式存储——经过视觉编码器压缩,但保留足够重建的细节; 是位姿 ; 是时间戳。位姿与时间戳不是元数据装饰,它们是检索的地址,也是注意力计算的额外条件。
这个设计与 Context-as-Memory 的关键差别在「地址」上。Context-as-Memory 的记忆仍然是帧序列,检索靠位姿算视场重叠;WorldMem 把位姿直接存进每条记忆,于是检索和条件可以共用同一套状态表示。检索阶段,它用一个贪心匹配算法,按帧对相似度挑记忆单元:相似度由 FOV 重叠比例与时间戳差异共同决定,前者保证「看的是同一片区域」,后者避免把不同时刻的同一地点混为一谈。附录给出的耗时是:8 帧记忆、600 个候选时检索约 0.10 秒,1000 个候选约 0.16 秒;单帧生成(20 步去噪)约 0.9 秒。也就是说,检索只占总推理时间的 10% 到 20%,即使候选库有上千条。
检索解决「取哪些」,条件解决「怎么用」。WorldMem 的 state-aware memory attention 是一个跨注意力:查询是当前帧的特征,键值是拼接后的记忆特征。但键和查询都先加上各自的状态嵌入:
其中状态嵌入 由两部分相加:
是 Plücker 嵌入,把 5 维位姿变成逐像素的稠密位置特征 ; 是时间戳的正弦编码;、 是两个 MLP,把两者映射到同一空间。为什么用 Plücker 而不是简单的位姿向量?因为注意力要判断的是「记忆里的哪个像素与当前帧的哪个像素对应」,这需要逐像素的射线几何,而不是一个全局位姿向量。Plücker 坐标恰好用 6 个数描述一条空间直线,适合做这件事。
还有一个容易被忽略的细节:相对状态。记忆帧的位姿不是以世界坐标直接注入,而是相对当前查询帧做归一化——查询帧的位姿重置为单位阵、时间戳归零,记忆帧全部转成相对值。这样模型学到的是「记忆相对于我现在在哪、隔了多久」,而不是绝对的经纬度式坐标。对跨场景泛化来说,这比绝对坐标稳得多。
记忆帧在注意力里的位置也经过设计。它们被拼接在上下文窗口之前,并用一个时间注意力掩码限制影响范围:记忆单元之间不能互相注意,当前帧只能因果地看上下文与记忆。这保证了两件事:记忆不会污染上下文内部的因果结构;记忆之间也不会因为彼此相似而互相强化,形成「回音室」。
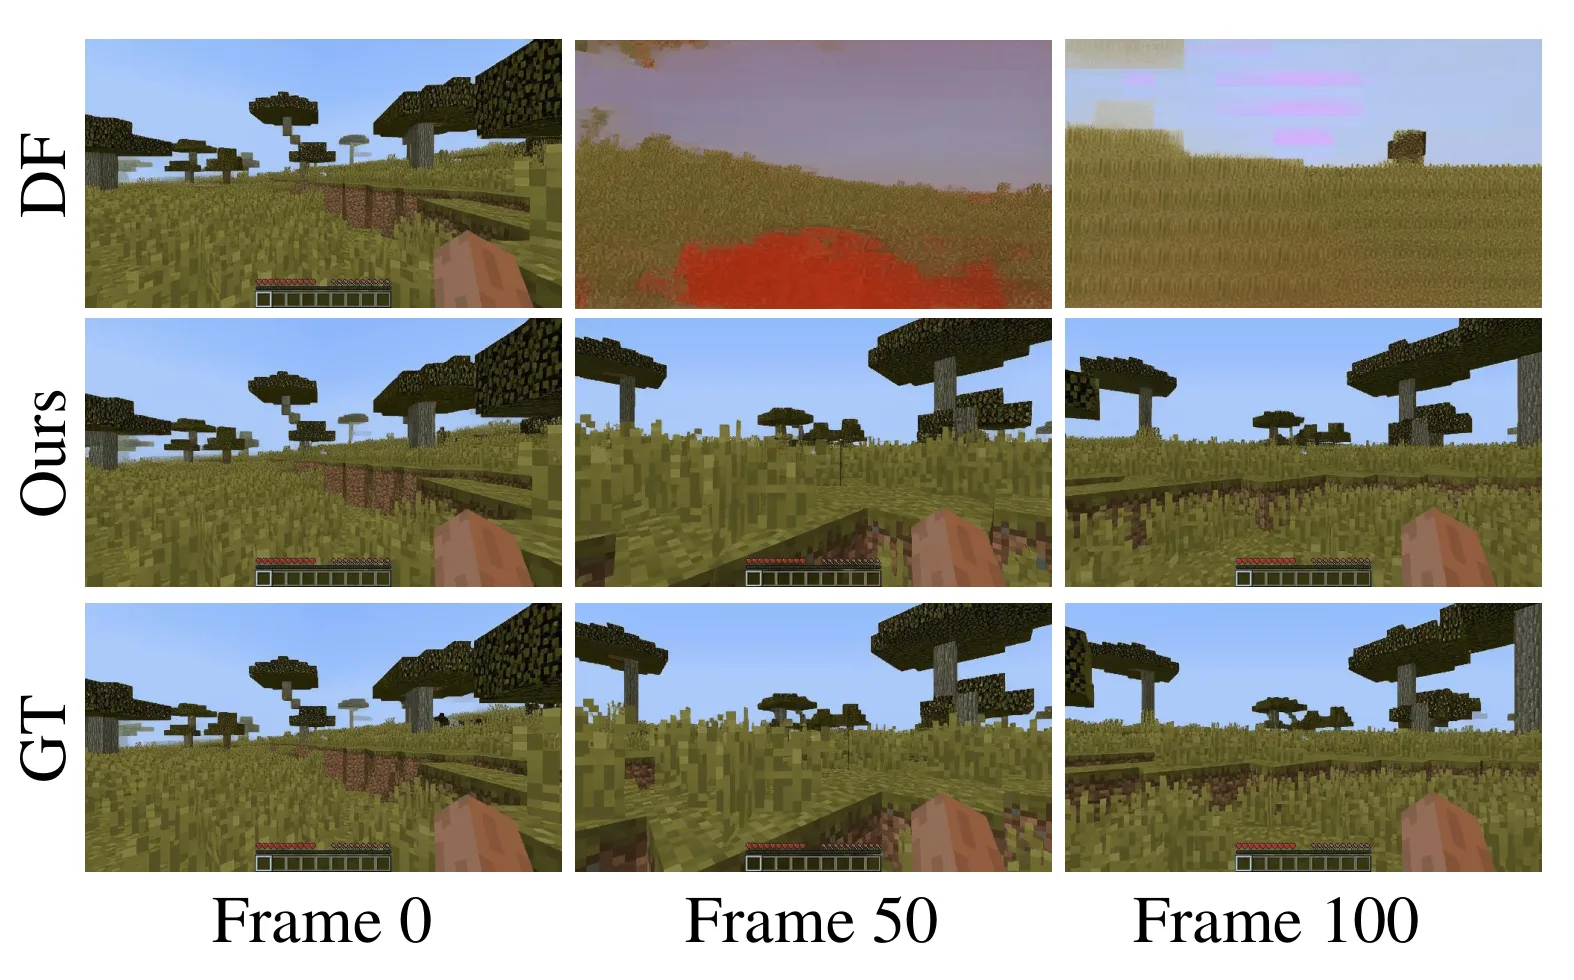
上图来自 WorldMem 论文 Figure 5(arXiv:2504.12369)。三列分别是第 0、50、100 帧。基线在窗口滑过之后逐渐丢掉早先的场景,回到同一地点时画出了不同的内容;WorldMem 通过记忆库把早先帧重新取回,回访时仍能恢复原来的场景。注意这里的关键不是「第 100 帧更清晰」,而是第 100 帧与第 0 帧描述的是同一个地方——这是一致性指标,不是画质指标。
WorldMem 的成本账也值得记录。记忆库并不大:600 条记忆 token、形状 、float32,约 21 MB。推理时带记忆的显存是 11 GB,不带是 9 GB;速度从 1.03 it/s 降到 0.89 it/s(单张 H200,8 帧上下文、8 帧记忆、20 步去噪)。也就是说,长程记忆的代价主要不是存储,而是每帧多出的那次跨注意力。这一点和很多人的直觉相反:大家容易担心「记多了存不下」,实际先撞上的往往是「每帧多算一次」。
几何记忆:把「记住画面」换成「记住场景」
WorldMem 的记忆单元仍然是图像帧。图像帧的问题是:它记录的是「从某个视角看到的画面」,不是「场景本身」。同一个沙发在两个视角下是两张不同的图,模型必须自己学会它们指同一个东西。Video World Models with Long-term Spatial Memory(Wu 等,2025 年 6 月,arXiv:2506.05284)把记忆换成了几何:记住一个持续更新的三维点图,而不是一堆二维帧。
它把记忆分成三条流,对应三种时间尺度:
- 短期工作记忆:最近 帧的 latent,负责运动连续性。这就是上一节的上下文窗口,只不过被明确命名为「工作记忆」。
- 长期空间记忆:一张静态点图,随生成过程增量更新。新观测通过 CUT3R 在线重建出点图,再用 TSDF 融合把动态元素滤掉。
- 情景记忆:一小组稀疏的历史关键帧,负责保留点云装不下的视觉细节与物体身份。
TSDF 融合的更新规则是标准的加权平均:
其中 是体素, 是截断符号距离, 是累积置信权重, 是第 帧观测到的距离, 是该帧的权重。这条式子的妙处在于它对动态物体是自然抑制的:一个人走过房间,不同帧在同一体素上给出的深度互相矛盾,加权平均后得到一个低置信、模糊的值;而静态墙面在所有帧上一致,权重越累越高。于是不需要额外的语义分割,融合过程本身就把动态部分过滤掉了。
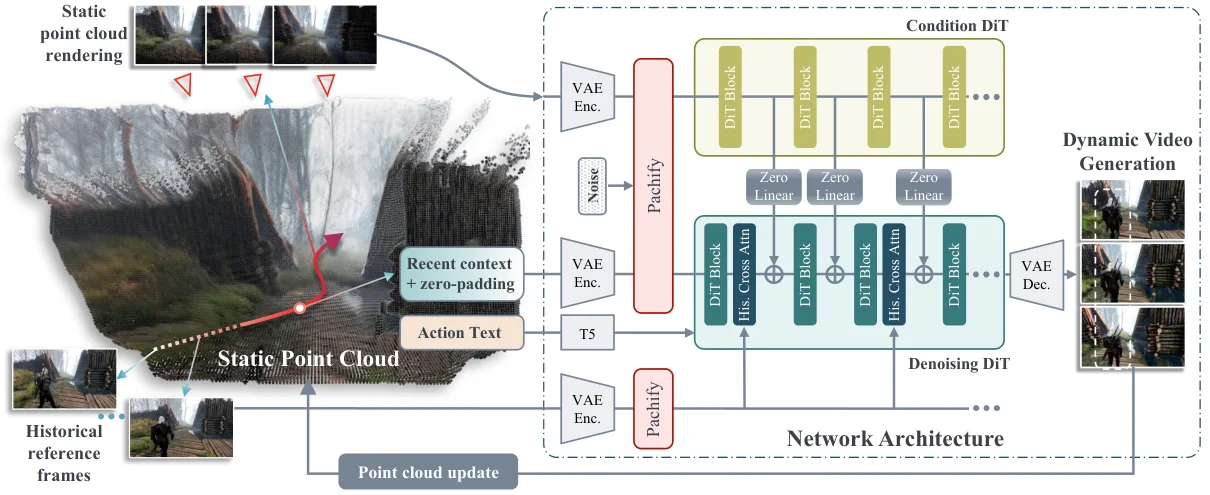
上图来自 Video World Models with Long-term Spatial Memory 论文 Figure 2(arXiv:2506.05284)。左侧是条件通路:静态点云沿目标相机轨迹渲染成视频,缺失区域填黑,经 3DVAE 编码后由一个条件 DiT 处理;右侧是生成主干,同时接收最近帧(短期工作记忆)与稀疏历史帧(情景记忆)。三条记忆流在同一个去噪过程里汇合,分别负责几何、运动与细节。
这套设计把「记忆」从「检索若干帧」推进到「维护一个场景」。它的优势是视角无关:不管从哪个方向回访,点云都能渲染出对应的条件图,不需要刚好存过那个视角的帧。代价是几何重建本身会出错——位姿漂移、遮挡、纹理缺失都会让点云变形,而错误的点云会被当成「世界的样子」反复注入后续生成,误差自我强化。论文的失败案例也集中在这里:相机位姿跳变太大时,4D 重建失败,融合出现重影。
把 WorldMem 与这套几何记忆放在一起看,可以得到一个清晰的取舍:
| 维度 | 帧式记忆(WorldMem / Context-as-Memory) | 几何式记忆(点图 / 3DGS / 占用栅格) |
|---|---|---|
| 存储内容 | 历史帧的 token + 位姿 + 时间 | 场景的静态三维结构 + 少量关键帧 |
| 视角泛化 | 依赖检索到「看过那个角度」的帧 | 任意视角可渲染,不要求存过该视角 |
| 动态处理 | 时间戳区分不同时刻 | TSDF 融合天然抑制动态,但会丢掉动态本身 |
| 主要误差 | 检索错帧、记忆帧外观漂移 | 位姿漂移、重建失败、点云重影 |
| 成本 | 随记忆帧数线性增长 | 随场景体积增长,但可稀疏化 |
第十二篇从「世界表示」的角度拆过 NeRF、3DGS 与占用栅格;这里补的是它们在记忆系统中的角色:几何表示不只是渲染器,它同时是一个可增量更新、可查询的外部记忆。当记忆变成几何,检索问题就变成「给定相机位姿,渲染哪一块」——地址是连续的,不再需要从离散帧里挑。
载体四:慢权重——把记忆写进参数
前面三种载体都把历史存在「数据」里:循环状态存在激活里,上下文存在 KV 缓存里,记忆库存在外部的 token 或点云里。还有一条更激进的路线:把历史直接写进模型权重。
World-T3(2026 年 10 月,arXiv:2610.17434)用的就是这种做法。它在主干上挂一个 test-time training 记忆:每次观测到新的场景内容,就用一条在线更新规则把这些特征「吸收」进一小块专用参数,即所谓的 fast weights。读出时,给定当前相机位姿,直接从 fast-weight 状态里取回对应的场景特征,而不是从帧库里检索。
它的结构可以写成两层:一层固定的投影 ,把位姿键映射到非线性特征
一层可更新的读出矩阵 ,累积时间上的场景表征。键只由相机射线图决定,值来自干净 latent——记忆的读写与扩散噪声解耦,否则同一块场景在不同去噪步上会被写成互相矛盾的值。
写入的时机很关键:不是每帧都写,而是在某个块被上下文窗口驱逐时写。被驱逐的块,其相机射线图 与隐藏状态 被编码成键值对:
如果直接把键值对批量塞进矩阵,会有一个隐蔽的问题:相机平滑移动时,连续驱逐的块位姿几乎共线,朴素写入会反复强化同一方向,冗余观测挤占存储。论文把它写成带权岭回归:
其中 是训练出来的基础读出矩阵, 把在线写入拉回它附近,防止少量观测把记忆冲坏。在线求解用递归最小二乘,同时维护特征相关矩阵的逆:
每写一次,按
更新。这条式子里最有信息量的是 :它是一个白化预条件子。想象位姿键大多集中在某个方向附近,那么 沿这个方向的值很小, 会把「已经记过」的分量压掉,只剩下正交方向上的新内容被写入。这正好解决了上面那个共线问题:重复看到的同一个视角几乎不占存储,只有新视角才真正写入。 读的时候反过来:用目标位姿的键 从 里取回记忆特征 ,再以门控残差注入每个 DiT 块。
存储与每步计算都是常数,与 rollout 长度无关——这正是循环状态曾经承诺、但没能兑现的性质。论文报告的回访 PSNR 从 13.52 dB 提到 18.31 dB,绝对旋转误差从 降到 ;在单张 B200 上 1280×704 分辨率达到 20.6 FPS。
这条路线的方法论意义在于:它把「记忆」从推理时的数据流挪进了参数空间。这么做有三个连带后果:
- 存储不再随历史增长。fast weights 是固定大小的矩阵,存 10 分钟的交互和存 1 小时一样大。对端侧与单卡部署,这是决定性的优势。
- 写入会覆盖。权重空间是共享的,不同地点、不同时间写进同一块参数时,后写的内容会挤占先写的。RLS 的残差式更新缓解了这个问题,但没有根治——当探索范围超出参数容量,记忆仍然会流失。
- 训练与推理的边界模糊。test-time training 本质上是在推理时做梯度式更新,这给系统带来新的工程问题:更新什么时候触发、用什么精度、如何回滚。它不是「推理系统的额外模块」,而是推理系统的一部分。
把四种载体放在一起,可以画出一张「存储量对检索能力」的坐标图。循环状态在左下角:便宜、无需检索、但无法寻址。上下文窗口在中间偏右:精确、可寻址、但成本随长度增长且会到期。记忆库在右上角:可寻址、存储大,但每次生成要付检索与跨注意力的成本。慢权重在另一个方向上:存储极小,靠参数隐式寻址,写入有损。
| 载体 | 存储量随历史 | 能否按地址取回 | 每步额外成本 | 主要失效方式 |
|---|---|---|---|---|
| 循环状态(RSSM) | 常数 | 否 | 一次 GRU 更新 | 长程遗忘、无回访能力 |
| 上下文窗口(KV) | 线性 | 是(按位置) | 随窗口平方增长 | 窗口外到期 |
| 外部记忆库 | 线性(可压缩) | 是(按位姿) | 检索 + 一次跨注意力 | 检索错帧、记忆陈旧 |
| 慢权重(TTT) | 常数 | 隐式(按位姿键) | 一次残差更新 | 写入覆盖、容量饱和 |
这张表没有「最优」一格,每一格都是为某一类负载准备的。实际系统往往是组合:最近几秒用上下文窗口保证平滑,长期地点用记忆库或几何记忆保证回访,而循环状态或慢权重负责跨块的状态传递。下一节看这些组合在系统层面长什么样。
2026 年的三种工程形态:分层、分头、混合状态
WorldPager:把 KV 记忆做成存储层级
WorldPager(2026 年 10 月,arXiv:2610.35529)讨论的是一个很具体的问题:在单张 RTX 4090、32 GiB 主机内存、一块 NVMe 的消费级机器上,交互式世界模型的长会话能撑多久。
它的答案是两个硬墙。第一面是容量墙:以 Matrix-Game 2.0 为例,把历史块 KV 留作检索记忆,bf16 下 45 秒视频就能把 32 GiB 主机内存耗尽;换成 int4,能撑到 2.8 分钟。第二面是位置编码墙:模型自身的位置编码 horizon 是 4.3 分钟,即使存储够,超出这个长度也会失去位置区分能力。
这两个数字可以先做一次交叉验算。32 GiB 在 45 秒内耗尽,平均每秒约 0.71 GiB;int4 撑 168 秒,平均每秒约 0.19 GiB。两者相差约 3.7 倍,与 bf16 到 int4 理论上的 4 倍压缩基本吻合。这说明容量墙不是「某个模块泄漏」,而是每帧 KV 的字节数乘以帧率乘以时长的线性结果。这个线性关系意味着:想把会话从 45 秒拉到 10 分钟,要么压缩 13 倍,要么换存储层级,没有第三条路。
WorldPager 的判断是:这类记忆是容量受限,而不是带宽受限。这个区分很重要。带宽受限的系统优化目标是「少读一点」;容量受限的系统优化目标是「把不常用的搬到更便宜的介质上,需要时再搬回来」。于是它把 int4 KV 放进 GPU 显存 / 主机 DRAM / NVMe 的三级层次,而不是反复重算。
真正让它做到「零停顿」的,是一个世界模型特有的性质:访问集合在计算之前就已知。相机位姿是用户输入,下一块的视野范围可以从位姿外推出来;系统因此可以提前知道「下一块会需要哪段历史 KV」,在它被用到之前从 NVMe 预取到显存。这在 LLM 推理里不成立——文本的下一个 token 要等模型采样出来才知道,检索地址无法提前确定。世界模型的相机位姿把这个「先算后取」的顺序翻了过来,变成「先取后算」。
论文报告的结果是:连续生成 37.5 分钟、零停顿、主机内存恒定,约 9.5 FPS;int4 存储在密封测试集上没有可测的质量损失,长间隔回访时 MUSIQ 约降 1 点。这个降幅给出了一个有用的尺度感:把 KV 从 bf16 压到 int4 的代价,在回访画质上大约是「一分」量级,而不是灾难性的。
从系统设计角度看,WorldPager 把世界模型的记忆问题变成了一个经典的缓存层次问题:谁放在快介质、谁放在慢介质、预取的触发条件是什么、miss 时是等待还是重算。它给出的新答案是「用位姿做预取键」——这正是前面 WorldMem、Context-as-Memory 把位姿存进记忆的同一条思路,只不过在系统层被用来调度 I/O。
ReWorld:把「控制」和「记忆」拆到不同的注意力头
ReWorld(2026 年 8 月,arXiv:2608.23565)从模型结构一侧回答同一个问题。它的出发点是一句很准确的概括:控制想要短视界,记忆想要无界视界,这是一个结构性矛盾。
短视界对控制有利:注意力只看最近几十帧,响应快、延迟低、不会被很久以前的内容干扰。长视界对记忆有利:回访时需要看到很久以前的内容。把两者塞进同一组注意力头,必然有一方妥协。
ReWorld 的做法是按头分工:大多数头使用混合的局部窗口,只关注最近的历史;一小部分「全局头」关注整段历史;再用随机头路由,防止某一种能力固定绑定到某几个头上(否则训练会退化成「全局头只学记忆、局部头只学控制」,失去冗余)。训练时还用随机块丢弃,让「历史是稀疏的」成为分布内的情况,推理时才不会因为检索到的历史不连续而失稳。
推理时,整段历史被压进一个固定预算:一个有界 KV 缓存,外加一个按位姿索引的地标库(landmark bank)。生成当前帧时,按相机位姿从地标库里取最近的地标,作为有界 KV 的补充。论文报告:固定的 12 块缓存,在 64 秒、384 个 latent 的 out-and-back rollout 上仍能重建起始视角;控制误差为 旋转误差,并支持 704×1280 的实时流式生成。
这里的结构思想值得单独拎出来:记忆不是一个模块,而是一种预算分配。 全局头负责「知道大概去过哪」,局部头负责「当前动作要连贯」,地标库负责「想起来那个地方具体长什么样」。三者各有各的容量上限,组合起来覆盖了从秒级到分钟级的记忆尺度。这和上一篇动作接口里「块长受推理延迟与环境变化速度双向约束」是同一类设计:没有一个参数能让所有尺度都最优,只能分层。
HLA-WM:线性注意力的记忆为什么也会丢
第三条路线针对的是循环线性注意力。Softmax 注意力的 KV 随历史线性增长,成本高但记忆精确;Gated DeltaNet(GDN)这类线性注意力把历史压进固定大小的状态,成本低,但 HLA-WM(2026 年 10 月,arXiv:2610.05739)指出了一个严重问题:GDN 存在长程遗忘。远处的、但与当前场景相关的信息,会被之后的状态更新逐步衰减掉。
注意,这不是「容量不够」那么简单。GDN 的状态更新是一个有方向的累积过程,新信息不断写入,旧信息在更新中被稀释。即使状态维度足够大,久远内容也可能因为更新路径太长而变得不可读。这与循环状态的问题同源,只是发生在一个更现代的架构里。
HLA-WM 的解法是「粗检索 + 细状态」的混合:利用 GDN 的仿射结构,缓存每个块的紧凑转移摘要(chunk-wise transition summaries);生成时用相机几何从这些摘要里检索与当前场景相关的历史块,再把它们重组成查询特定的循环状态。整个过程不需要额外训练(training-free)。在 60 秒的 SANA-WM-Bench 上,它把六项回访一致性与相机控制指标全部提升,PSNR 涨 0.74 dB,旋转误差降 28.5%;历史状态内存相对完整 KV 缓存降低 12 倍,推理吞吐最多只降 1.6%。
这条路线与 ReWorld 形成一个有意思的对照:ReWorld 在注意力头层面分预算,HLA-WM 在状态层面做检索。两者都在回答同一个问题——固定大小的记忆状态,怎样在不放弃效率的前提下变得可寻址。 答案都是「不要让状态独自承担全部记忆,给它配一个外部的、按位姿索引的索引层」。
三种形态可以放在一张表里:
| 系统 | 记忆载体 | 关键机制 | 解决的瓶颈 | 代价 |
|---|---|---|---|---|
| WorldPager | int4 KV 的历史块 | GPU/DRAM/NVMe 分层 + 位姿预取 | 单卡容量墙 | 依赖位姿可外推;存储精度损失 |
| ReWorld | 有界 KV + 位姿地标库 | 局部头/全局头分工 + 随机路由 | 控制与记忆的视界冲突 | 结构复杂;地标选择策略需训练 |
| HLA-WM | GDN 状态 + 块级转移摘要 | 几何检索 + 状态重组 | 线性注意力的长程遗忘 | 依赖 GDN 的仿射结构,迁移性受限 |
三者没有互相替代的关系。WorldPager 假设模型已经有检索式记忆,只解决「存不下」;ReWorld 改造模型结构,让记忆能力天生分层;HLA-WM 不改训练,只给现有线性注意力补一个检索层。它们分别对应「系统层」「结构层」「后处理层」三种切入方式,这也是工程上最常见的三条路。
检索的代价:地址、陈旧与错过
把记忆搬出注意力之后,「检索」成了新的核心操作。它看起来只是一个查表动作,但它引入了一整类新的失效模式,而且这些失效模式不会在画质指标上显形。
失效一:地址选错——检索到的帧不属于这里
检索的基础是「相似」。Context-as-Memory 用视场重叠,WorldMem 用 FOV 比例加时间差,几何记忆用位姿键。这些都是几何意义上的相似——两帧从相近的视角看同一片区域。但几何相似不等于内容相关:同一条走廊上的两个门口,位姿可能非常接近,画面却是完全不同的两个房间;反过来,同一面墙从相隔很远的两个位置看,位姿差很大,内容却高度重叠。
几何检索的价值在于把候选集从几百帧缩减到几十帧,而不是直接给出答案。Context-as-Memory 的消融已经显示:只做 FOV 过滤还不够,还要对连续帧去冗余(每组只留一帧),PSNR 才能从 19.17 再提到 20.11。这说明几何检索之后仍然需要一层「去重」,否则同一片区域的十张近似帧会挤占预算,真正有用的旧帧反而进不来。
这类失效的系统后果是「记忆污染」:检索来的帧属于另一个地方,模型却把它当作「这里以前的样子」,于是画出一幅混合了两个场景的画面。在评测上它可能表现为回访 PSNR 下降,也可能表现为画面看起来正常、但物体身份变了——后者只有用语义一致性指标才能抓住。
失效二:记忆陈旧——世界已经变了,记忆没变
WorldMem 把时间戳放进记忆单元,正是因为这一点。同一个地点在不同时刻的状态可能完全不同:雪会融化、灯会熄灭、门会打开。如果只按位姿检索,模型会取回最早的那次观测,把「过去的雪」画进「现在的房间」。
时间戳参与检索(按时间差算置信度)与时间戳参与条件(作为状态嵌入的一部分)是两件事,WorldMem 都做了。前者避免取回过于陈旧、与当前时间点无关的帧;后者让模型知道「这条记忆是多少秒前的」,从而自己决定多大程度上信任它。缺了后者,模型即使拿到了新旧两条记忆,也无法区分它们的时效。
这引出一个更广的问题:动态世界的记忆必须带「时效」这个维度,而大多数三维重建式的几何记忆天然偏向静态——TSDF 融合对动态物体的抑制在防止「幽灵重影」上是对的,但也意味着记忆里根本不存「人在哪」这类动态信息。所以几何记忆系统通常还要配一条短期上下文或情景记忆流,否则动态场景会变得「干净得不真实」。
失效三:错过——有用的历史在库里,但没被取出来
第三种失效最难发现:检索没有出错,只是没选中。被选中的记忆都正确,但它们不足以重建场景,缺的那一块恰好在库里躺着,却因为位姿不匹配、被去冗余规则误删、或预算满了而被跳过。
评测这种失效需要专门的协议。回访一致性检验(去一个地方、绕一圈、回到原位)之所以成为长程记忆的标准测试,就是因为它能同时暴露前两种失效与第三种失效:如果记忆里根本没有那个位置(窗口早已滑过),模型会重新画;如果检索到了错误的帧,画面会混搭;如果检索到了正确的但不够充分的帧,画面会「大体对、细节错」。三种错误在像素级指标上的表现相似,只有把轨迹、检索日志与真值对齐才分得清。
这也是为什么这套系统很难靠「换个更好的指标」解决。真正需要的是一套可观测性:每次生成时记录检索了哪些记忆单元、它们的时间戳与位姿、命中了哪些预算槽位。对世界模型服务来说,这类日志的重要性不亚于每帧延迟——系统一旦出现「回访不一致」,没有它们就只能盲猜。
指标与评测:回访一致性怎么量化,又会被什么骗
第六篇已经把长程记忆拆成了持久性、可回访性、语义一致性三个子问题,这里只补记忆系统特有的评测陷阱。
第一,回访指标需要区分「重建」与「重画」。 回访 PSNR 同时受两件事影响:模型取回了正确的记忆(重建),或者模型恰好依据常识画出了相似的东西(重画)。如果一个房间里只有一张白桌子和白墙,重画也能拿到很高的 PSNR。所以要配一组语义/特征度量:World-T3 同时报告 DINOv2 特征距离(从 0.0800 降到 0.0390 量级)与 PSNR,前者对「是不是同一个内容」更敏感,后者对「像素是否对得上」更敏感。两者一起变好,才能说记忆真的起作用。
第二,回访实验必须控制「绕多远、绕多快」。 相机位姿的跳变幅度直接决定记忆系统是否失效:跳太快,几何重建失败、位姿估计出错;跳太慢,历史帧冗余、检索轻易命中。ReWorld 报告 64 秒、384 latent 的 out-and-back 轨迹,WorldPager 报告 37.5 分钟长会话;这两个数字不能直接比较,因为它们测的不是同一种难度——前者是「回得来找得到」,后者是「一直在跑撑得住」。把两者的数字放在一张表里比高低,是评测里最常见的误读。
第三,记忆容量指标必须说明「存的是什么精度」。 WorldPager 的 int4 与 bf16 差别是 4 倍存储,代价是 1 点 MUSIQ;WorldMem 的 21 MB 是 float32 下 600 条的占用。如果不写精度,这些数字之间没有可比性。对部署规划来说,真正要算的是「每小时会话需要多少字节」,而这个量取决于分辨率、帧率、每帧 token 数与比特宽,任何一项不确定,数字就不可信。
第四,「检索延迟」要与「生成延迟」分开报告。 WorldMem 的检索 0.10 秒对应生成 0.9 秒,占 10%–20%;HLA-WM 的吞吐只降 1.6%。如果只报告端到端帧率,检索的这部分开销会被稀释在整条流水线里,看不出它在长会话中是否会成为瓶颈。分开报告,才能判断「记忆」这一层还能不能再加。
评测之外,还有一层更基本的问题:我们怎么知道这个记忆系统在它没被评测到的地方也是对的? 回访基准都是构造出来的轨迹,而真实使用中的移动路径不可预测。这类系统的鲁棒性通常只能靠大量不同的轨迹做压力测试,而不是靠某一个精心挑选的基准。这也意味着,长程记忆的成熟度判断,很大程度上取决于数据引擎——WorldPager 能外推位姿,是因为位姿是输入;如果换成从像素估计位姿,外推误差会直接变成预取错误。这是它适用边界的一部分。
一笔可算的记忆账:容量、延迟与吞吐
把前面散落的数字收拢成一个可复用的成本模型,是这一篇最有实用价值的部分。世界模型的记忆开销可以拆成三项:存、取、干扰。
第一项:存
设一段会话每秒产生 帧,每帧存 个记忆 token,每个 token 有 维、每维 字节,那么每秒新增的原始记忆字节数是
注意这里没有乘层数:WorldMem 存的是视觉编码器的 token(形状 是按 600 条、每条 个数算的),不是每层 KV。若存的是 KV,则还要乘 (K 与 V、每层一份),量级会大得多——WorldPager 的 45 秒墙算的就是这一种。
给定可用容量 ,记忆能覆盖的时长上界是
这个式子解释了一个常被忽略的事实:长会话的瓶颈通常不是「模型能生成多长」,而是「每秒往记忆里写多少字节」。 要延长 ,只有三条路:降 (降帧率,代价是流畅度)、降 (压缩记忆 token,代价是细节)、降 (量化,代价是精度),或者把 扩大(加内存/加 SSD,代价是成本与带宽)。
把 WorldPager 的数字代进去: GiB, 秒(bf16),得到 GiB/s;换 int4, 降为四分之一, 秒, GiB/s。两者比值 3.7,与量化倍率一致。这个自洽性检查很重要:如果实测比值远离理论倍率,说明瓶颈不在字节数,而在别的地方(例如每帧固定开销、块对齐浪费)。
第二项:取
检索的成本取决于三件事:候选库大小 、每次取回的条数 、以及取回后参与注意力的 token 数。打分阶段通常是对 个候选做一次相似度计算,成本约 ,其中 是打分特征维度;条件阶段是做一次跨注意力,成本约
是当前帧的查询 token 数。它本质上是「多看了 个 token 的注意力」,所以记忆的条件成本可以折算成「上下文窗口加长了多少」。WorldMem 的实测是:8 帧记忆、600 个候选时检索 0.10 秒,1000 个候选 0.16 秒;单帧生成 0.9 秒,检索占 11%–18%。这个比例与「8 帧记忆相对于 8 帧上下文翻了一倍的条件长度」是同一量级。
WorldMem 的吞吐数字也印证了这一点:带记忆 0.89 it/s、不带 1.03 it/s,降幅约 14%。它没有把检索成本藏起来——跨注意力确实多算了。反过来,HLA-WM 用「块级摘要 + 状态重组」,把历史状态内存降了 12 倍,吞吐只降 1.6%:它不是在每次生成时都做一次全量跨注意力,而是把检索结果压回循环状态,让主干的计算量基本不变。「检索后直接拼接」与「检索后重组进状态」是两种成本形态,前者灵活但每帧都付费,后者便宜但需要架构支持(GDN 的仿射结构)。
第三项:干扰
第三项最容易被漏掉:无关记忆不是「零收益」,而是负收益。Context-as-Memory 的随机检索基线 PSNR 只有 17.70,FOV 过滤后升到 20.11;模型没变,变的只是条件里少了无关帧。这说明无关历史会作为噪声进入注意力,稀释真正相关的信号。
干扰成本很难写成公式,但可以用一个实验判据:固定记忆条数 ,把「随机取」与「按位姿取」做对照。如果两者差距很大,说明检索质量是主要矛盾;如果差距很小,说明模型对条件噪声不敏感,可以把预算花在别处。这个对照实验比任何单项指标都更能说明「记忆系统的瓶颈在检索还是在模型」。
三项合起来:一条经验法则
把三项放在一起,可以得到一条粗略的经验法则:记忆的存储成本随时长线性增长,检索成本随每次取回的条数线性增长,而干扰成本随「取回条数中无关条数的比例」增长。 三者中,只有第一项能靠硬件解决;后两项只能靠更好的地址与更好的选择策略。
这也解释了为什么 2026 年的系统普遍把「位姿」放在核心位置:位姿同时是存储的索引、检索的键、预取的触发条件,还是评测时对齐真值的坐标系。一个量同时服务四件事,这在系统设计里是很少见的杠杆。代价是它把系统绑在了「位姿已知」这个前提上——一旦位姿来自估计而非输入,检索、预取、评测三处会同时退化。这是这条技术路线最需要警惕的耦合。
选型:什么场景该用哪种记忆
把前面的分析压缩成一张决策表:
| 场景 | 首选载体 | 理由 | 需要额外注意 |
|---|---|---|---|
| 秒级控制、单房间操作 | 循环状态 + 短上下文 | 成本最低,无需检索 | 不要指望它能回访远处 |
| 分钟级室内探索、频繁回访 | 帧式记忆库 + 位姿检索 | 实现直接,检索可解释 | 去冗余、时间戳、检索日志 |
| 大范围场景、任意视角回访 | 几何记忆(点图/3DGS/占用) | 视角无关,可增量更新 | 位姿漂移与重建失败 |
| 单卡长会话、显存/内存受限 | 分层 KV + 位姿预取 | 把容量墙换成 I/O 调度 | 位置编码 horizon 另有一道墙 |
| 端侧、固定算力预算 | 慢权重 / 线性状态 | 常数存储、常数每步成本 | 写入覆盖与容量饱和 |
| 动态场景(人、天气、可动物体) | 短上下文 + 带时间戳的帧记忆 | 几何记忆会抑制动态 | 不要用纯静态点云做唯一记忆 |
几条可以落地的判断:
第一,先量「回访间隔」再选载体。 如果任务里物体离开视野的时间不超过几秒,上下文窗口就够,不必引入记忆库。如果回访间隔是分钟级,帧式记忆库是性价比最高的起点;如果回访需要任意视角,才值得上几何记忆。不要一上来就做点云——它的失败模式比帧式记忆更难排查。
第二,把「位姿来源」当成一等公民。 位姿是输入还是估计,决定了整套记忆系统的可靠性上限。如果位姿是估计的,就要在检索前做一致性检查(例如回环检测、位姿平滑),否则检索会把错误地址当成真值。WorldPager 的预取能成立,前提是位姿由用户输入且可外推;换成视觉里程计,预取就必须留出更大的容错窗口。
第三,为「记不住」设计降级,而不是假设它不会发生。 所有记忆系统都有容量墙与检索失败。产品上可行的做法是:当检索置信度低时,退回到「重新生成 + 标记不确定」,而不是自信地画一个错误的旧场景。对下游规划来说,一个明确的「这里我没记忆」比一个看起来合理但错误的场景安全得多。这一点与第七篇的安全层是同一个原则:模型必须有办法承认自己不知道。
第四,优先优化「取准」,再优化「存多」。 Context-as-Memory 的消融已经给出证据:同样的上下文预算,换一种检索策略就能带来 2.4 dB 的 PSNR 提升;而把预算从 20 加到 30,收益递减且速度明显下降。多数团队会先加存储,因为加存储看起来更直接;但从数据看,检索策略的边际收益更高。
小结:记忆是一个地址问题
这一篇把世界模型的记忆从「注意力里的一段上下文」拆成了一个独立的系统层。四种载体各有各的地址方式:
- 循环状态没有地址,只有当前状态;它便宜、连续,但无法按地点取回。
- 上下文窗口按位置寻址,精确但会到期,成本随窗口平方增长。
- 外部记忆库按位姿与时间寻址,能跨窗口取回,代价是检索与跨注意力。
- 慢权重把地址隐式写进参数,存储恒定,但写入会互相覆盖。
三种 2026 年的系统展示了这些载体的组合方式:WorldPager 把 KV 记忆做成 GPU/DRAM/NVMe 的分层,用位姿预取做到零停顿;ReWorld 把控制与记忆分到不同的注意力头,用有界缓存加地标库覆盖分钟级回访;HLA-WM 给线性注意力的固定状态补一个几何检索层,在不训练的前提下把长程遗忘压回去。
贯穿这些系统的是一个共同的转向:记忆的关键不再是「存多少」,而是「怎么在正确的时刻取到正确的那一条」。 位姿之所以成为核心,是因为它同时充当索引、检索键、预取触发器和评测坐标系。这也意味着,长程记忆的可靠性最终取决于位姿的质量与检索策略的质量,而不是记忆库的容量。
对世界模型的推理系统来说,这带来一个不同于 LLM 的优化空间。LLM 的下一个 token 未知,检索地址无法提前确定;世界模型的相机位姿是输入,访问集合可以先于计算确定。「先取后算」而不是「先算后取」,让记忆的 I/O 可以被流水线隐藏——这是世界模型服务相对于文本服务的一个结构性优势,也是 WorldPager 能做到零停顿的根本原因。
系列走到这里,世界模型的「表示、路线、规划、评测、部署、推理、硬件、预算、动作、记忆」已经连成一条链。还剩一个没有被单独处理的问题:当多个会话、多个智能体共享同一个世界时,记忆该如何并发、分叉与合并——这是这条路线下一个还没被系统处理的空白,值得单独分析。
参考资料
- WorldMem: Long-term Consistent World Simulation with Memory(Xiao 等,2025-04,arXiv:2504.12369)
- Context as Memory: Scene-Consistent Interactive Long Video Generation with Memory Retrieval(Yu 等,2025-06,arXiv:2506.03141)
- Video World Models with Long-term Spatial Memory(Wu 等,2025-06,arXiv:2506.05284)
- WorldPager: Zero-Stall Tiered Memory for Long-Horizon World Models on a Single Consumer GPU(2026-10,arXiv:2610.35529)
- ReWorld: An Interactive World Model with Long-Horizon Memory(2026-08,arXiv:2608.23565)
- HLA-WM: Hybrid Linear Attention for Long-Horizon Video World Models(2026-10,arXiv:2610.05739)
- World-T3: Test-Time Training as Persistent Memory for Real-Time Video World Models(2026-10,arXiv:2610.17434)
- Mastering Diverse Domains through World Models(DreamerV3,2023-01,arXiv:2301.04104)
- Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM,2023-09,arXiv:2309.06180)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



