


世界模型从零讲起(十):从机房到机器人本体——世界模型推理的能耗下限与片上规划加速器
承接前九篇:账本的另一端
前九篇把世界模型从概念讲到了系统。(二)拆开了 Dreamer 的 RSSM,(三)讲了 JEPA 的表征预测,(五)讲了 WAM 如何把动作变成生成目标,(八)讲了潜空间规划,(九)则把世界模型当成一种推理负载,算清了 KV 缓存、去噪步数与流式调度的系统账。
那些账本都建立在一个隐含前提上:模型跑在机房里的 GPU 上,电和散热是别人的问题。这一篇把这个前提拿掉。机器人要在自己的本体上做规划,电池、散热器和控制周期都是硬约束。于是问题从“怎么把吞吐做高”变成了另一个方向:一次潜空间 rollout 在物理上最少需要多少能量,今天的通用硬件离这个下限有多远,如果差距是十一个数量级,芯片应该长成什么样。
这一篇围绕 2026 年 11 月 6 日提交到 arXiv 的 WMPA 论文展开。作者是 Prerana Ramkumar、Suhas Suresh Bharadwaj 与 Fazal Hameed,论文题为 The World Model Planning Accelerator (WMPA): Hardware-Algorithm Co-Design for Embedded AI in Robotics。它做的事情很少见:先用信息论和布尔电路复杂度给出一条理论下界,再用一块 T4 测出实际差距,接着用三维瞬态热仿真证明这个差距同时也是热问题,最后才给出加速器设计。这条“从下界到瓶颈再到架构”的链条,比单独看一个芯片方案更有价值。
本体上的规划:一条不能并行的计算链
先把被加速的对象写清楚。世界模型在规划中的角色是一个参数化函数:
其中 是潜状态, 是候选动作。MPC 或 MCTS 这类规划器做的是同一件事:从当前潜状态 出发,采样 条动作轨迹,每条向前推演 步,给每个想象出来的未来打分,再选一个动作真正执行。这个过程的计算量是 次状态转移。
以 DreamerV3 的 RSSM 为例,一次转移包含三个子操作:
是确定性的循环状态,通常是一个 GRU 的隐向量; 是随机潜变量,在 DreamerV3 里被表示成 个 categorical 变量,展平后是 1024 维; 是供奖励头、继续头使用的特征。rollout 阶段没有观测,所以 从先验 采样,而不是从后验采样。这一点很关键:先验只依赖 ,所以整条链是自洽的、可以脱离环境向前推。
以论文配置的 RSSM 为例, 维循环状态对应的 GRU 有三组门,每组一个 量级的权重矩阵(输入是上一步确定性状态与 1024 维潜特征的拼接),再加上输出 个 categorical logits 的线性层。这个配置的参数量在几百万量级,权重总量几 MB,全部塞进片上 SRAM 是可能的——这正是 WMPA 敢用近存计算的前提。DreamerV3 原文还报告了从 12M 到 400M 参数的一系列模型规模,权重更大的变体就不是单 tile 的几 MB SRAM 能装下的了。相比之下,一个 7B 参数的 Transformer 权重是 14 GB(FP16),任何片上 SRAM 都装不下,只能分片流式读入。规模差了两个数量级以上,架构必须不同。
从硬件角度看,这条链有三个性质。
第一,步与步之间是严格串行的。第 步需要第 步的 ,第 步又需要第 步的 。这与 Transformer 的 prefill 完全不同:prefill 里所有 token 的矩阵乘可以拼成一个大 GEMM,GPU 的几千个核心都能吃饱;rollout 里每一步都是一个小矩阵乘,后一步必须等前一步算完。宽度换不来深度,这是 Amdahl 定律在时间维度上的体现。
第二, 条轨迹之间可以并行。这是 rollout 里唯一的并行维度。 时,32 条轨迹共享同一个 ,动作序列不同,前几步的中间状态高度相似,越往后分歧越大。后面会看到,这个“前缀共享”的结构正好可以被 copy-on-write 利用。
第三,每个子操作的算术强度都很低。GRU 的权重矩阵只有 量级,状态向量只有 512 维,一次转移的 FLOPs 相对于要读的权重和激活字节数很小。低算术强度意味着瓶颈在访存,不在算力。
把这三个性质放到机器人本体上,约束会更紧。下表不是论文的数据,而是把机器人产品的常见工程边界与数据中心推理并排列出来,用来说明约束的方向和量级:
| 维度 | 数据中心推理 | 机器人本体规划 |
|---|---|---|
| 功耗 | 单卡数百瓦,整机千瓦级 | 整机常见数十瓦到百瓦量级,规划只分到几瓦 |
| 散热 | 风扇或液冷,机房恒温 | 无风扇或小风扇,外壳与结构件兼作散热器 |
| 延迟 | 首 token 几百毫秒可以接受 | 控制周期常见 30–100 Hz,单次规划只有几十毫秒 |
| 批处理 | 多请求批处理摊薄权重读取 | 条轨迹可并行,但 步必须串行 |
| 内存 | HBM 数十 GB,带宽 TB/s 级 | 片上 SRAM 几 MB,片外 DRAM 带宽低一个数量级 |
所以“把数据中心的推理栈裁一裁塞进机器人”这条路走不通。不是模型太大,而是计算的形状不对:它是一条又窄又长的依赖链,正好落在通用 GPU 最不擅长的位置上。
把控制周期折成预算
把上面的约束落到数字上,会得到两个不同的预算,很多讨论把它们混为一谈。
延迟预算决定机器人能不能及时反应。控制频率 30 Hz 意味着每 33.3 ms 要完成一次“感知—规划—决策”的闭环。规划只占其中一部分,假设给它一半,约 16 ms。由于 条轨迹可以并行,关键路径是 步而不是 步; 时每步只有 0.8 ms。这个数字对 GRU 来说不算苛刻,但它不允许任何一步出现排队或换页。
吞吐预算决定芯片要持续做多少功。 次转移要在 16 ms 内算完,平均每次转移 25 μs;如果芯片有 32 条并行 lane,每条 lane 每步有 0.8 ms。这与“单次调用 0.387 J”是同一件事的两种看法:0.387 J 除以 33.3 ms 等于 11.6 W,正好是论文说的 30 Hz 下规划的平均功率。
这里有一个常用的换算值得记住:每焦耳能买多少“想象中的未来”。一次调用产生 个预测潜状态,0.387 J 对应每次转移约 0.6 mJ。如果一个控制周期做一次规划,30 Hz 就是 0.387 J 乘以 30,约 11.6 W;这与上面的算法一致,只是换成了“能量乘频率”的写法。对本体来说,这 12 W 还要和其他执行器、感知、通信竞争同一块电池和同一个外壳的散热面积。
而 68.19 W 是另一种口径:让 GPU 以 176 次/秒的节奏背靠背地连续规划,把板卡压到满负荷。这对应 5.68 ms 一次调用,比 30 Hz 的工作点快约 5.9 倍。论文明确说这是吞吐受限的压力测试,不是 30 Hz 的工作点。做热分析时必须用压力测试,因为瞬时峰值不决定散热,持续功率才决定。
这两个预算也解释了为什么“降功耗”和“降延迟”不能互相替代。降功耗可以靠降频、降精度、关核,但这些手段往往同时抬高延迟;降延迟可以靠加并行度,但并行度受 和片上存储限制,且会增加面积和漏电。真正的设计目标是一条帕累托前沿,而不是单点最优。
信息论给出的最低信息量
要给能耗定下界,先要回答“这一步转移至少传递了多少信息”。论文的出发点是一个标准但容易被忽略的事实:rollout 是开环的。
假设 A1(潜状态马尔可夫性):在固定动作序列下, 是预测 的充分统计量。于是开环 rollout 的联合分布可以写成链式乘积:
假设 A2(随机转移):转移分布方差严格为正、logits 有界,因此对 categorical 潜空间存在一个每步条件熵的下界 :
在 A1 下, 构成马尔可夫链,数据处理不等式给出:
也就是说,随着 rollout 往前走,初始状态 能提供的信息只会减少,不会增加。等价地,给定 后的条件熵单调不减:
这个不等式有两层含义。第一层是悲观的:开环 rollout 越走越不确定,这是世界模型的固有性质,不是实现缺陷。第二层是乐观的:不确定性有天花板,最多就是潜变量字母表能承载的信息量。对 的 categorical 潜变量,每个变量有 32 个取值,总信息量上限是:
论文把这个 160 bit 当作 的上界来评估下界。这一步值得说明:因为能量下界与 成正比,取上界得到的是最宽松、最强的下界。如果真实互信息只有 40 bit,那么实际下界会更低。所以后面算出的十一个数量级差距,是在对硬件最有利的假设下仍然成立的差距。
这里还有一个容易被误读的点。 随 增长,说的是“相对于起点的不确定性”在累积;而 是“每一步新增的不确定性”,它只需要大于 。两者不是一回事。前者决定了规划器要区分多少个未来,后者决定了单步转移至少要携带多少新信息。论文的下界用的是后者与互信息,而不是累积熵。
从比特到焦耳:两级能量下界
有了信息量,接下来要把它换算成硬件代价。论文给了两个层次的下界,一个数门电路,一个数焦耳。
算术复杂度的门数下界
假设 A3(ALU 中的信息流):转移的计算原语是 位操作数的乘累加,每一位从 传到 的信息至少要经过一次门电路求值,不承认“免费布线”。
在这个假设下,实现一次转移所需的门电路求值次数满足:
每个 位操作数最多携带 比特,所以 MAC 操作数的下界是:
对 条轨迹、 步的完整规划调用:
这三个式子想表达的是“信息不能凭空产生,也不能免费搬运”。160 bit 的信息要穿过数据通路,至少要有 160 次门求值;如果每个操作数装 8 bit,那就至少要 20 次 MAC。
必须说明这个论证的边界。它是一个信息流计数,不是电路复杂度理论中严格证明的乘法下界——后者至今仍是开放问题。论文自己也承认这一点,并且只把 位乘法需要 个门这个实现代价用在精度比较上,不把它当作已证明的下界。所以式中的 缩放不能直接读成“精度越低越好”:每次 MAC 的门数按 增长,总门数大致按 变化,低精度确实省,但量化误差可能迫使规划器多走几步,反而把省下的部分吐回去。这是一个典型的“账不能只算一半”。
CMOS 动态能耗下界
第二个层次更物理。Landauer 原理说,任何逻辑不可逆操作,比如擦除一个比特,至少要耗散:
在 K 时约为 J/bit。这是热力学地板,任何真实器件都远高于它。
论文的 Proposition 2 把它套到状态更新上:如果每一步都用 覆盖 ,那么被丢弃的信息是 ,单步至少耗散这么多比特乘以 。这个量对信息保持的更新会趋近于零,对近似可逆的转移也很小,所以论文只把它当作与模型相关的参考尺度,没有代入数值。真正被用来做定量比较的是下一层。
假设 A5(CMOS 开关极限):每个门翻转都要给寄生电容 充放电到电源电压 。于是单步动态能耗下界是门数乘以单门开关能量:
其中 是翻转活动因子。代入 TSMC 12nm FinFET 的参数: V、 fF、,单门开关能量是:
比 Landauer 的 J/bit 高四个数量级以上。所以在今天的工艺下,真正起约束作用的是 CMOS 开关能量,而不是热力学极限。
把 160 bit 代进去:
对 、 的一次规划调用,把 次转移都算作独立:
这个数字小得几乎不真实:6.55 皮焦。它对应的是纯粹的数据通路门电路,在理想假设下、在 12nm 工艺上、按最大互信息计算的下界。任何真实芯片都做不到,因为还要读权重、读激活、搬运数据、维持时钟和供电。
还有一处保守的地方:这个计数把共享前缀的 条轨迹也当成 次独立转移。实际上前缀相同的部分只需要算一次,真正的最小转移数比 640 更少,所以 6.55 pJ 是偏高的下界。即便在这样对硬件有利的口径下,实测仍然高出十一个数量级,这个结论因此更稳。
Roofline:为什么换更快的 GPU 没有用
要定位瓶颈,最合适的工具是 roofline 模型。它用算术强度判断一个负载受算力限制还是受带宽限制:
是峰值算力, 是峰值带宽, 是脊点。当 时,负载落在带宽受限区,加算力不会提高性能;当 时,才落在算力受限区。
论文把 RSSM rollout 的四个核心操作投影到三代 GPU 的 roofline 上:T4、A100、H100。三者的 FP16 稠密脊点分别是 203.5、153.0、295.2 FLOPs/byte。注意 A100 的脊点比 T4 还低——它的算力涨得比带宽快,所以更容易掉进带宽区。这是加速器设计里一个反直觉但重要的事实:算力与带宽不是等比例增长的。
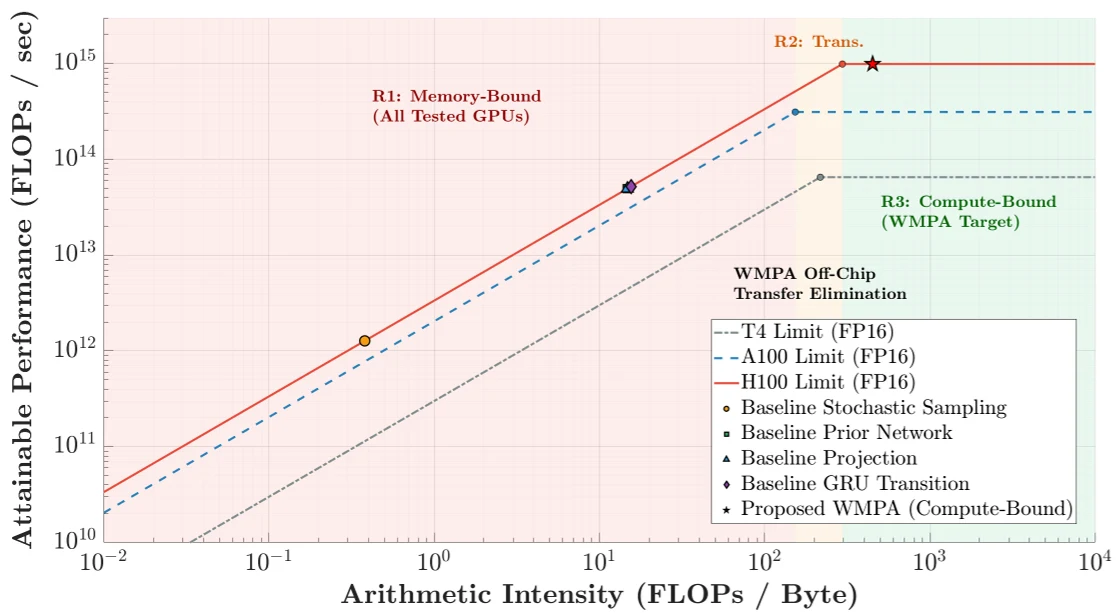
图中横轴是算术强度,纵轴是可达性能,三条斜线分别是 T4、A100、H100 的带宽上限,竖线是各自的脊点。四个基线操作——随机采样、先验网络、投影、GRU 转移——的算术强度落在 0.38 到 15.55 FLOPs/byte 之间,全部位于最左侧的内存受限区 R1。图中还标出了 WMPA 的设计目标:通过消除片外传输把工作点推向右侧。来源:arXiv:2611.10316 图 1。
这张图是整篇论文的转折点。它说明 rollout 的每一个操作,在三代 GPU 上、在所有测试精度下,都没有离开过 R1。既然如此,H100 相对 T4 的算力优势在这里几乎兑现不了。用论文的话说,解决办法不是更多的 FLOP/s,而是提高有效算术强度,把工作点往 R3 推——这正是后面近存计算的来源。
可以用一个更直白的指标看算力浪费的程度。对带宽受限的负载,算力利用率的上界是 。在 T4 上(),随机采样的上界只有 0.19%,GRU 转移也只有 7.6%。也就是说,一块标称 65 TFLOPS 的 GPU,在这个负载上真正有效的算力不到一成,其余时间都在等数据。这解释了为什么下面实测到的板卡功耗几乎顶满 TDP,而计算单元却大量空转。
为什么复用率天然不够
算术强度可以写成“每次访存字节能换来多少次浮点运算”。对一个矩阵乘 ,如果权重 有 个元素、每个占 字节,输入有 行,那么:
分母里权重占一项,激活占两项。 越大,权重那一项被摊得越薄,算术强度越高。这就是数据中心推理喜欢大 batch 的原因:同样读一遍权重,服务 256 个请求而不是 1 个。
rollout 的麻烦在于 被规划预算锁死了。 条轨迹已经不少,但要越过 T4 的脊点 203.5,需要每个权重字节被复用两百多次; 最多只能提供 32 次复用,而且由于 步串行,每一步都要重新读一遍权重,复用率并不会随 累积。把权重常驻在片上可以把“每步重读”变成“只读一次”,但 512 维 GRU 的三组门权重加起来已经有几 MB,SRAM 面积和功耗都要付出代价。
所以 WMPA 的选择不是“把 batch 做大”,而是“把权重搬到计算旁边”。这两个方向在数学上等价于提高分子或降低分母,但在硬件上的代价完全不同:前者受算法约束,后者受面积和工艺约束。
在一块 T4 上量出来的差距
理论下界需要在真实硬件上对一次。论文的实验设置很克制:一个 DreamerV3 风格的 RSSM,512 维 GRU 作为确定性状态, categorical 潜变量展平为 1024 维,再经线性头映射到 512 维特征;放在一张隔离的 Tesla T4 上,,。字节流量由权重和激活尺寸解析计算,能量则通过 pynvml 每 50 ms 读取一次板卡功耗遥测,在连续 3 秒的规划循环里平均,10 次独立试验取均值。
这里没有用“执行时间 × TDP”去估能量。原因很实际:带宽受限的负载,计算核心大量停顿,标称 TDP 与实际耗电的对应关系会失真。板卡功耗遥测测的是真实电流电压乘积,包括 DRAM、供电转换和互连,更接近机器人身上真正要付的电费。论文把 profiling 与 roofline 的代码放在 GitHub 仓库 上,权重结构、字节流量和功率采样都可以按同样口径复现。
测出来的三个事实
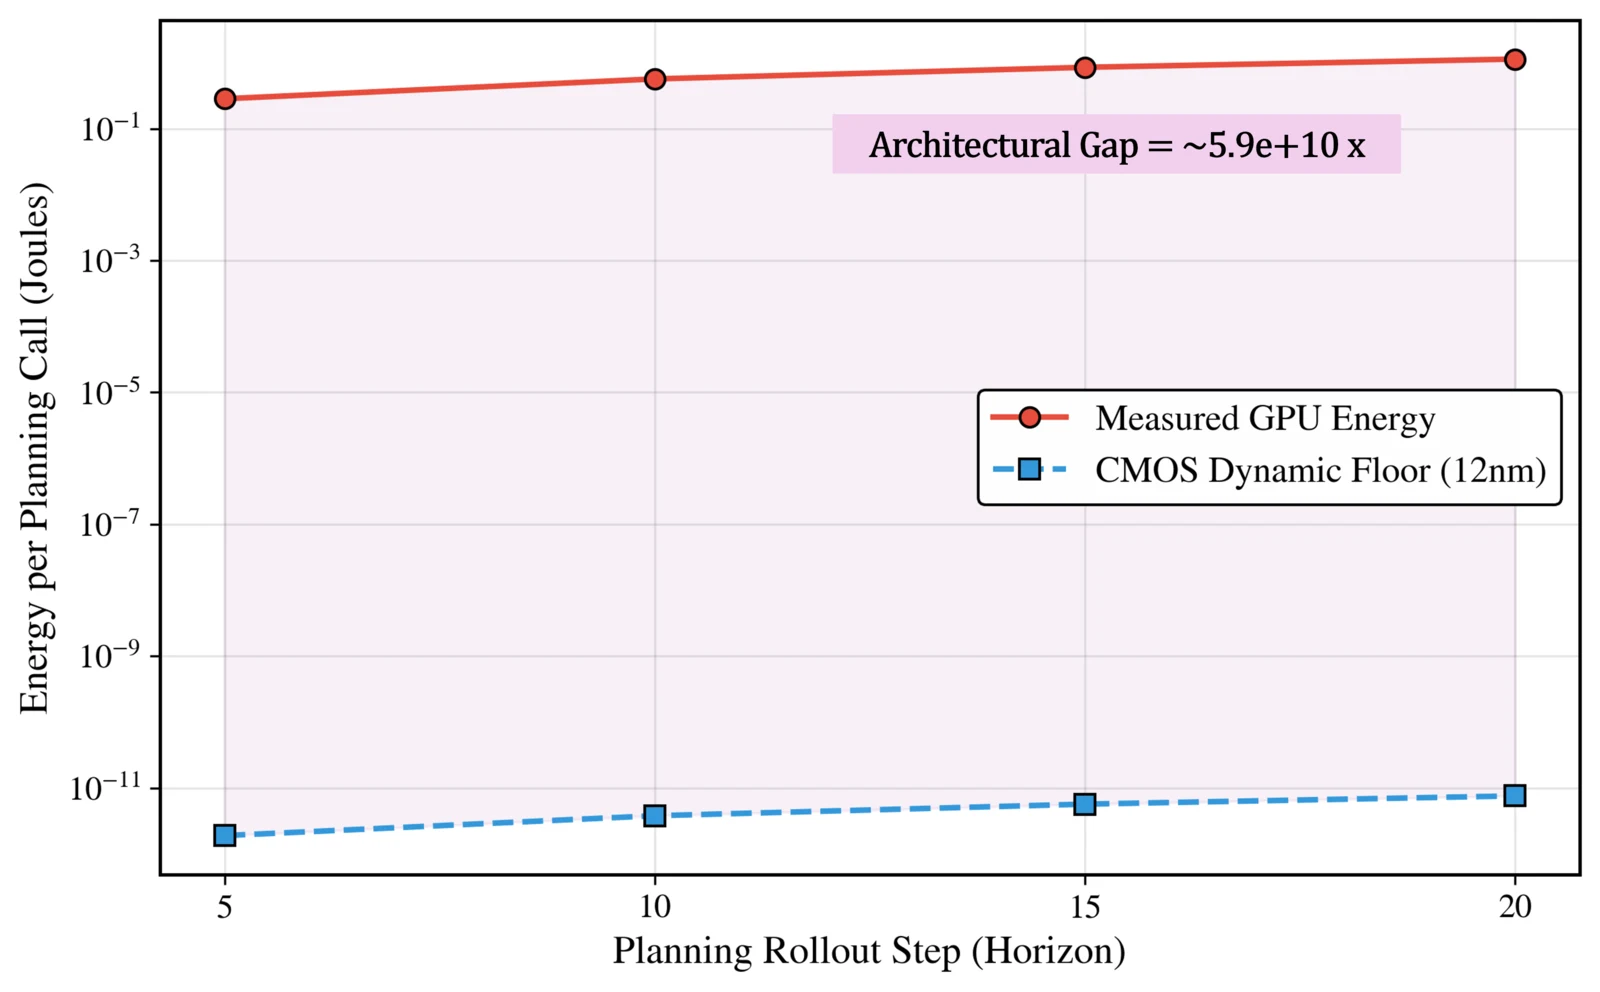
图的纵轴是对数刻度的单次规划调用能量,横轴是 rollout 步数。实线是实测值,随 线性增长;下面那条虚线是 12nm CMOS 下界。两者之间标出的差距在 时是 ,约为十一个数量级。来源:arXiv:2611.10316 图 3。
第一,板卡功耗是 68.19 W,几乎贴着 T4 的 70 W 额定 TDP。而 roofline 分析说计算单元大部分时间在空转。两者并不矛盾:板卡上真正干活的是 DRAM 和供电网络,计算阵列只是在等数据。
第二,能量随 线性增长,与理论下界的缩放规律一致。这说明每次转移的成本确实是一个常数乘子,rollout 没有隐藏的固定开销主导——除了下面会提到的短 horizon 情况。
第三,与 12nm CMOS 下界的差距是 ,在 时;到更短的 horizon 反而略高,达到 ,原因是每次调用有一份固定的启动开销,摊到更少的步数上会被放大。
、 的一次规划调用实测约 0.387 J。按这个数算吞吐,一秒能做 176 次调用。这个数字后面在热分析里会用到。
差距应该怎么读
这个十一个数量级的差距,不能被读成“GPU 比理论下界低效十一个数量级所以很糟糕”。它比较的是两件不对等的东西:下界只覆盖数据通路门电路,而实测覆盖整个板卡子系统——GDDR6 DRAM、电压调节、互连、时钟树。论文自己在正文里明确指出了这一点,并且补充说,由于计算利用率只有个位数,数据搬运是最主要的贡献项。
这个读法反而更有说服力。如果差距主要来自“算”,那么换更先进的工艺、更多算力就能缩小;如果主要来自“搬”,那么工艺微缩帮助有限,因为 DRAM 的带宽和能耗随工艺进步得很慢。近存计算之所以是正确方向,正是因为它的矛头指向后者。
热:被忽略的第三个约束
即便能耗可以接受,毫米级的硅片能不能把热量散掉是另一个问题。机器人的本体上没有风扇,散热器通常兼作结构件,热边界比数据中心严苛得多。
论文的做法是解三维瞬态非线性热传导方程:
其中 是材料密度, 是比热容, 是温度场, 是局部体积热源。
这里有一处让模型更真实但也更麻烦的耦合:硅的热导率随温度下降。论文采用 Glassbrenner 与 Slack 的实测数据做幂律拟合:
其中 ,,在 300–600 K 区间对数-对数回归的 。温度越高,硅越难导热,热点越容易恶化——这是一个正反馈。
边界条件被理想化了:1 mm × 1 mm 的计算 tile,100 μm 厚的硅层,顶面通过等效换热系数 与 300 K 环境换热。这个系数对应 1.5 mm 铜均热片()加上热界面材料的串联热阻,并假设均热片后面的散热器恒在环境温度。这已经是很理想的设置,实际机器人上通常还要更差。
两个场景:
- 场景 A(GPU 级功耗密度):假设板卡功耗的 9% 集中在 1 mm² 的热点上,体积热源为 。
- 场景 B(WMPA 目标):功耗降低 40 倍,热源为 。
在 s 时评估,这个时刻远长于 tile 的热时间常数,数值基本就是稳态值。结果是:场景 A 峰值 556.07 K,比环境高 256 K;场景 B 峰值 306.52 K,只高 6.52 K。
用一维稳态平衡做个交叉验证:
两个场景分别给出 258.7 K 和 6.5 K,与有限元结果相差约 1%。这说明温升主要由散热边界决定, 的退化是次要修正。
556 K 意味着什么?在这个温度下,亚阈值漏电急剧上升,功耗进一步变大;按 Black 的电迁移寿命模型,导线寿命也会大幅缩短。这不是“性能下降”的级别,而是硬件失效风险。一个 mm 级 tile 在理想均热片后面都撑不住 GPU 级功耗密度,这直接排除了“把数据中心 GPU 塞进机器人”的方案。
一维热阻模型:热分析为什么可以用除法估
上面的一维平衡式 值得单独拆开,因为它决定了整个热结论的稳健性。把散热路径看成若干层热阻串联:
对面积为 的 tile,每层材料贡献一份热阻,顶层铜均热片的贡献是 ,热界面材料的贡献是接触热阻 ,再往下散热器被理想化为恒温边界。总换热系数就是总热阻的倒数:
代入论文的参数,1.5 mm 铜、 W/(m·K),加上 0.38 K·cm²/W 的热界面材料,得到 23,850 W/(m²·K)。于是 6.17 MW/m² 的热流产生 258.7 K 温升,而 的体积热源换算成面积热流后只有 0.154 MW/m²,产生 6.5 K。
这个层面热阻模型有两个用途。第一,它解释了为什么温升对功耗几乎严格线性:只要顶层边界不改变, 就是 的常数倍,40 倍功耗降低就是约 40 倍温升降低。第二,它告诉设计者该往哪里用力:如果 能提高一倍,同样的功耗下温升减半;而改进硅内部的热导率只能带来 1% 量级的修正。对机器人本体来说,真正能改的是散热路径——把计算 tile 贴到金属结构件上、用导热垫替代空气层,这些比换工艺更有效。
当然,三维有限元相比一维模型还多了横向扩散和 退化这两项。横向扩散会把热点摊薄, 退化会放大热点,两者部分抵消。仿真结果显示总误差在 1% 量级,说明这个 tile 尺寸下横向扩散确实不可忽略,但也不足以推翻一维判断。如果换成更大的芯片,横向扩散项会变小,一维模型会变得更准确;换成更小的 tile,热点更集中,一维模型会偏乐观。这是使用这类简化模型时必须记住的边界。
还要注意论文对场景 A 的保留:9% 的功耗份额没有 floorplan 级的功率图支撑,是一个量级估计;温升对 线性,所以 556 K 应被读作压力测试而不是实测温度。但它足以说明相对可行性:40 倍功耗下降能把温升压到接近环境,5 倍下降就已经把温升降到约 50 K,热结论并不依赖达到全部目标。
WMPA:按计算的形状长出的芯片
前几节给出五条观察,直接决定了加速器的结构:
- 所有 rollout 操作在三代 GPU 上都落在带宽受限区,所以加算力无意义;
- 在熵坍缩的压力测试中,GRU 状态与特征投影分别出现 14% 与 29% 的接近零激活;
- CMOS 能耗下界与每步互信息成正比,与 、 线性相关;
- 条轨迹共享 、逐步分叉,前缀可以被复用;
- GPU 级功耗密度在本体上无法持续,必须把功耗密度降下来。
对应地,WMPA 由四个部件组成:
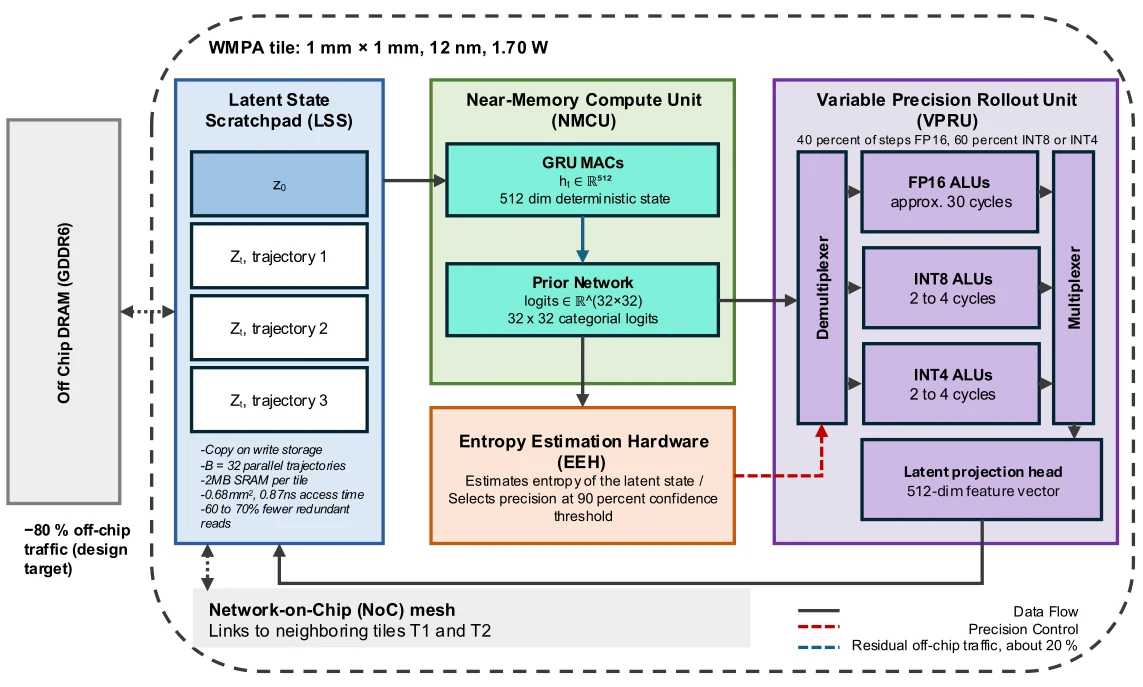
框图展示 1 mm × 1 mm、12 nm 工艺、1.70 W 目标功耗的单个 tile。近存计算单元(NMCU)负责 GRU 状态更新与潜投影;熵估计硬件(EEH)实时估计下一潜状态的预测分布熵并选择精度;变精度 rollout 单元(VPRU)按 EEH 的指示在 FP16、INT8、INT4 之间切换;潜在状态暂存区(LSS)是 2 MB SRAM,以 copy-on-write 保存 条轨迹的状态,并经由 NoC 网格与相邻 tile 互联。来源:arXiv:2611.10316 图 4。
近存计算单元(NMCU)
roofline 分析指向的是片外数据搬运。NMCU 把计算逻辑与 SRAM 放在一起,让 GRU 状态更新和潜投影在存储子系统内部完成,不再走主存总线。论文给的目标是减少 80% 的片外流量——这个数字是设计目标,不是文献数据。
这里有一个必须说清楚的前提:NMCU 能吸收的是哪些操作?GRU 的权重矩阵在每一步都要读一遍,是访存的大头;潜投影的权重同样。对于这种“权重小、每一步都读、激活也小”的负载,把权重放在近存单元旁边确实能省掉绝大部分片外流量。但对于权重很大的视频生成式世界模型,单个 tile 的 SRAM 装不下,需要权重分片和多 tile 协同,这是完全不同的问题——后面会展开。
熵估计硬件(EEH)
EEH 实时估计 的 Shannon 熵:
熵高说明模型对下一刻不确定,此时量化误差容易被放大,用高精度;熵低说明模型赌定了某一条轨迹,细微的数值误差不太会改变结果,可以用低精度。
这个策略的直觉很清晰,但论文诚实地指出了它的边界:这是鲁棒性启发式,不是前面那些下界推出的结论。下界只给出了能耗的最低尺度,并没有规定“熵低就可以降精度”。而且 EEH 在硬件上的实现代价并没有被量化——对 1024 维 categorical 分布做熵估计,本身也要读分布、做对数,这部分开销在设计里如何摊薄,论文没有展开。
变精度 rollout 单元(VPRU)
精度与硬件代价的关系,论文用一张假设的表:
| 精度 | 单次操作周期 | 相对吞吐 | 按 的相对单操作能耗 |
|---|---|---|---|
| FP16 tensor core | 约 30 | 1× | 上限值 |
| INT8 ALU | 2–4 | 约 2× | 约 1/4 |
| INT4 ALU | 2–4 | 约 4× | 约 1/16(上界估计) |
论文的做法是:当模型置信度低于 90% 阈值时走 FP16,高于阈值时走 INT8 或 INT4。在 的熵坍缩压力测试里,置信度在第 7 步与第 8 步之间越过阈值,于是 20 步里有 8 步(40%)走 FP16,12 步(60%)走 INT8/INT4。
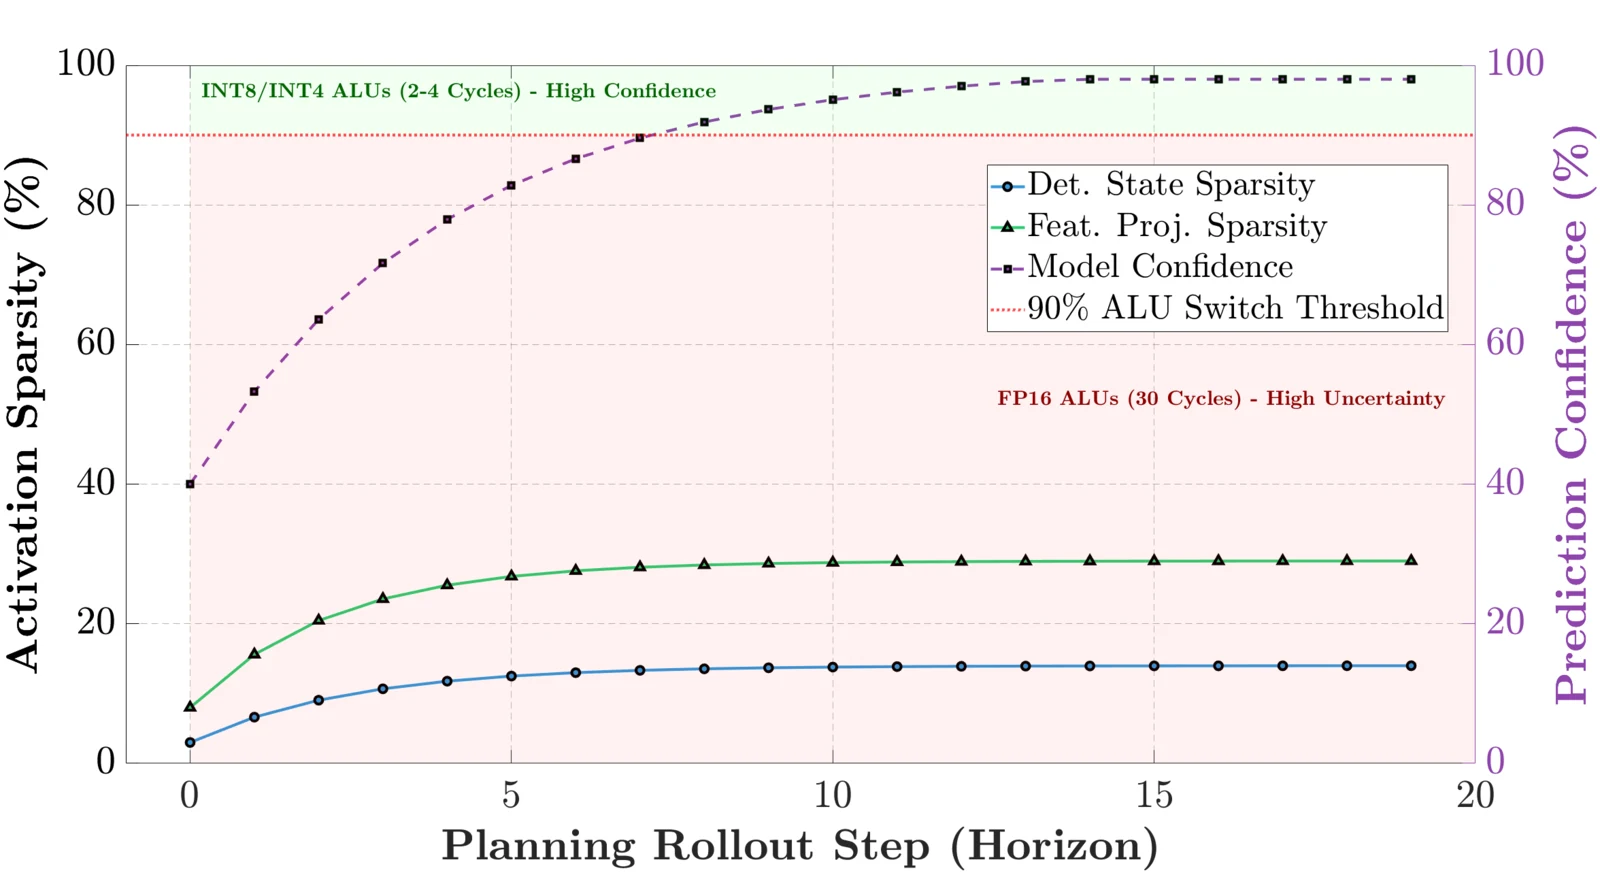
图中两条稀疏度曲线分别是确定性 GRU 状态与特征投影在 rollout 过程中的近零激活占比,随步数上升并在尾部稳定在 14% 与 29%;第三条曲线是模型置信度,跨越 90% 阈值后,VPRU 把剩余步数切到低精度 ALU。来源:arXiv:2611.10316 图 2。
这张图要标注清楚它的口径:它是用逐步衰减 softmax 温度的方法模拟“熵坍缩”得到的解析代理,不是训练好的策略的真实测量。论文在正文里反复强调这一点。代理的作用是提供一个与具体环境无关的压力测试,说明在什么情况下稀疏度和低熵会出现,而不是声称任何真实机器人任务都会这样。
还有一个 GPU 不会利用的事实:近零激活(<0.01)在稠密张量单元上仍然要付完整的访存和 MAC 代价。稀疏度 29% 的投影,在 GPU 上并不比 0% 稀疏的投影快任何东西。VPRU 的价值一半来自降精度,一半来自可以在低熵状态下跳过接近零的分量——但后者需要稀疏代数结构支持,论文没有给出具体的稀疏调度方案。
潜在状态暂存区(LSS)
树形规划里的 条轨迹共享动作前缀,在分叉之前它们的潜状态完全相同。LSS 用 copy-on-write 保存这些状态:共享前缀只存一份,只在分叉点复制。论文估计这能减少 60–70% 的冗余读带宽。
容量设计用 CACTI 7.0 做,在 22 nm 下建模后按 12 nm 缩放。2 MB 的 LSS 在 22 nm 下数据阵列面积 2.297 mm²、访问时间 1.599 ns;按 缩放面积、按 缩放访问时间,得到 0.68 mm² 和 0.87 ns。从 1 MB 增到 2 MB,面积从 0.32 增至 0.68 mm²,访问时间从 0.65 增至 0.87 ns。论文选 2 MB 作为复用率与延迟的平衡点,并把 LSS 分成多个小 SRAM 阵列分布到不同 tile,用 NoC 网格互联以压低延迟。
CACTI 在 22 nm 以下没有经过验证的器件数据,所以这里的 12 nm 数字是一阶近似,不是综合结果。论文自己也这样标注。
功耗与面积目标
单 tile 的面积账:2 MB SRAM 占 1 mm² 的约 68%,留给 NMCU、VPRU、EEH 的逻辑不到三分之一。这个比例决定了整个设计的上限——SRAM 是面积大户,逻辑只能挤在剩下的空间里。
功耗目标是 40 倍下降,从 68.19 W 降到 1.70 W,对应 1 mm² tile 上的 0.154 W(仍按 9% 热点份额折算)。这个 40 倍是设计目标,不是综合或实测结果。论文的论证方式是:NMCU 与 LSS 都作用在同一个数据搬运项上,它们的收益重叠、不能相乘;VPRU 让 40% 的步走 FP16、60% 走低精度,LSS 减少 60–70% 的冗余读,NMCU 把主要操作搬进存储子系统;合起来达到约 80% 的片外流量削减。如果每步能耗随功耗同比下降,WMPA 距离 CMOS 下界约 倍,比 GPU 的 缩小了约两个数量级,但仍然远离理论地板。
这个结果应该怎么评价?它不是一个“接近理论上限”的设计,而是“能否在热约束下持续运行”的可行性设计。从 到 ,数量级没有质变;但 306 K 与 556 K 之间是能不能装进机器人的质变。
四个部件之间怎么配合
四个部件不是四个独立的优化,而是一条流水线上的四个段位,运行时按下面的顺序协作:
- 规划器把 条轨迹的动作前缀送入,LSS 按 copy-on-write 分配共享状态;
- NMCU 在 SRAM 旁执行 GRU 更新,得到 并回写到 LSS;
- EEH 读取先验 logits,估计 ,与阈值比较后输出精度选择信号;
- VPRU 按信号选择 FP16/INT8/INT4 通路,完成潜投影,把 送出给打分头。
整条链每步只走一次,步与步之间串行。这意味着任何一个部件的延迟都会被直接累加到关键路径上,所以四个部件必须被设计成同一拍内完成,而不是做成流水线的不同级。这与 GPU 上常见的“重叠访存与计算”的优化思路相反:GPU 可以靠 warp 级并行把访存隐藏在计算后面,因为有很多独立的 warp 可以调度;单条 rollout 链只有一个 warp 宽度的工作,没有独立指令可以填充延迟。
这也是为什么 LSS 要按 tile 拆分并用 NoC 互联,而不是集中成一个大的共享 buffer:集中式 SRAM 的访问延迟随容量上升,每多 1 MB 就多约 0.2 ns,分摊到 20 步就是 4 ns 的额外关键路径。分布式拆分让每条轨迹访问离自己最近的存储体,把延迟压到最小。
精度调度账:低精度真的省能量吗
EEH 的 90% 阈值听起来像一个粗糙的启发式,但把它代进能耗表会发现它其实有自己的逻辑。
按论文的 模型,INT8 单操作的能耗约为 FP16 的 1/4,INT4 约为 1/16(这是上界估计,论文明确标注了)。如果 60% 的步走 INT4,40% 走 FP16,平均单步能耗的相对值是:
也就是降精度带来约 2.3 倍的单步能耗节省。如果 60% 走 INT8,则是 ,约 1.8 倍。这两个数字都不足以单独撑起 40 倍的整卡目标,真正的大头还是 NMCU 和 LSS 对片外流量的削减。低精度的角色是“在数据已经搬到片上之后,把数据通路本身再缩一缩”,与近存计算是乘性关系而不是替代关系。
这里还藏着一个容易被忽略的陷阱:如果低精度让 rollout 的每一步误差更大,规划器的打分可能变得不可靠,结果是需要更多候选、更长的 horizon 才能选对一个动作。那样的话,“只算单步能耗”就会低估端到端的能量。论文没有做这个闭环实验,因为需要一个训练好的策略和真实任务。这是 WMPA 最需要后续验证的地方,也是所有“近似计算”类硬件共有的风险。
三个数字放在一起看
把论文里最重要的三组数字排在一起:
| 对象 | 一次规划调用的能量 | 1 mm² tile 的持续温升 | 距 CMOS 下界 |
|---|---|---|---|
| 理论下界(数据通路) | 6.55 pJ | 不适用 | 1× |
| T4 实测 | 0.387 J | 约 +256 K(9% 热点份额) | |
| WMPA 目标 | 按 40× 折算约 9.7 mJ(推论) | 约 +6.5 K | 约 |
表中第二行与第三行的能量口径要分开看:T4 的 0.387 J 是板卡遥测,覆盖整块板子;WMPA 的估算只覆盖芯片,而且假设“每步能耗与功耗同比下降”,这是论文的推论而非实测。第三行的温升在同一 9% 热点份额假设下算出,换成不同的封装方式会变化。
这张表说明了 WMPA 的真实定位:它把“能不能持续运行”从否变成是,把“离物理极限有多远”从十一个数量级缩到九个数量级,但没有、也不打算把距离抹平。对嵌入式规划芯片来说,这是一个务实的目标;对研究来说,它留下的空间正是下一代器件和架构要填的。
把单 tile 放进整条栈:WMPA 站在世界模型硬件化的哪一步
WMPA 是一个单 tile、单模型的加速器。它加速的是 DreamerV3 级 RSSM 的 rollout,不是视频生成式世界模型。(九)讲过,视频生成式世界模型的推理账完全不同:主干是 DiT,权重是数十亿参数,KV 缓存随帧数线性增长,单步去噪是全局注意力。把 WMPA 的 1 mm² tile 和 2 MB SRAM 直接拿来跑这种模型,是装不下的。
但 WMPA 的方法论可以迁移。可以把世界模型硬件化的路线分成三档:
| 档位 | 代表模型 | 主干 | 权重/状态规模 | 硬件形态 |
|---|---|---|---|---|
| 本体规划 | DreamerV3 RSSM、小型世界动作模型 | GRU + 小 MLP | 几百万参数,潜状态 KB 级 | 片上近存 tile,WMPA 这一档 |
| 端侧视觉世界模型 | 小型视频预测模型、机器人专用的 WAM | 小型 Transformer/扩散 | 亿级参数 | 手机/机器人 SoC 级 NPU + 大 SRAM |
| 云端世界模拟器 | Cosmos、Genie 3、GAIA-1 | 大 DiT | 数十亿到百亿参数 | 数据中心 GPU 集群 |
WMPA 位于第一档,而且是这一档里最“物理”的研究:它不假设有足够的电,而是从信息和热出发反推芯片。第二、三档的推理系统问题在(九)里已经算过账。真正有意思的是第二档:当端侧 NPU 已经可以跑几亿参数的视觉模型时,能不能把世界模型的前向压进一个几十毫秒的预算,同时又不超过本体的散热能力?这是 WMPA 论文的下一层问题,但它给出的工具——互信息评估每个操作的信息密度、roofline 判断工作点、热仿真判断可行性——可以直接复用。
同一个下界,不同的实现代价
信息论下界有一个很好的性质:它只关心“这一步传了多少信息”,不关心实现是 GRU 还是注意力。所以 160 bit 的上界对任何世界模型都成立。但把 160 bit 兑现成硬件代价的方式,在四条技术路线上完全不同:
| 路线 | 单步主要操作 | 算术强度 | 主要瓶颈 | WMPA 的近存思路是否适用 |
|---|---|---|---|---|
| RSSM/Dreamer | 512 维 GRU + 小投影 | 极低,0.4–16 FLOPs/byte | 片外访存、串行延迟 | 直接适用 |
| JEPA | ViT 编码器 + 小预测器 | 编码器高,预测器低 | 编码器算力、预测器带宽 | 只适用于预测器部分 |
| 视频生成式 | DiT 全序列注意力,多步去噪 | 中高,随分辨率变化 | 算力、显存容量、步数 | 需权重重分片,单 tile 装不下 |
| WAM | 视频主干 + 动作头联合去噪 | 与视频路线相近 | 同上,外加动作精度 | 需与主干协同设计 |
这张表说明 WMPA 的边界:它的四个部件是为“小状态、小权重、强串行”这一种形状设计的。JEPA 的编码器是一次大矩阵乘,算术强度高,GPU 或 systolic array 反而合适;视频生成式的主干权重是数十亿参数,近存单元必须变成多 tile 分片,copy-on-write 的轨迹前缀复用也失去意义,因为瓶颈变成了权重读取而不是状态读取。
把这层区分记住,就不会把 WMPA 误读成“世界模型加速器的通用方案”。它只解决了规划器内部最内层的一段,而这一段恰好是延迟关键路径上最难并行的一段。
与 TPU、近存计算的分工
WMPA 论文的引言把两条前人路线摆在对面:TPU 的 systolic array 和 PIM 的近存计算。
TPU 的核心是把权重读取摊薄到大量乘累加单元上。第一代 TPU 每周期能做 65,536 次 MAC,单个权重的复用次数取决于 batch size:batch 为 256 时,从 DRAM 读入的每个权重可以被 256 个激活复用。这要求 batch 或序列长度足够大,让阵列有足够多的独立工作填充。rollout 的 和 步串行恰好破坏了这个前提:每一步只有 32 条轨迹的并行度,一次转移的矩阵乘尺寸又只有 量级,阵列大部分单元在等下一批数据。论文用 roofline 说明的正是这一点——不是 TPU 不快,而是它的快建立在“有足够大的静态矩阵乘”这个假设上。
PIM 解决的是另一个问题:把计算搬进 DRAM 或 SRAM,省掉片外总线上的数据往返。它能把带宽瓶颈抬高一个数量级,但不改变计算本身的串行结构,也不提供按熵调精度的能力。WMPA 的 NMCU 是近存计算的一种具体形态(计算逻辑贴近 SRAM,而不是真正在存储单元内做模拟计算),它只承担四个部件中的一个角色。
真正的区别在于 WMPA 把“算法结构”写进了架构:熵估计决定精度、轨迹前缀决定 copy-on-write、串行链决定单拍完成。这三件事都不是通用加速器会做的,因为通用加速器面对的是混合负载,不能假设某一个模型族的特定结构。这也是所有领域专用架构的共同赌注:押对了,能效高一个数量级;押错了,只能跑一类模型。
有一类工作已经在这条路上:用世界模型当仿真器做 Sim2Real 迁移。PrimeSim(2026 年 11 月)训练了跨 22 个机器人平台、30110 小时演示数据的动作条件多视角世界模型,用“快视频、慢记忆”的后训练把双向视频生成器转成自回归仿真器。它的部署目标仍然在服务器上,因为要在毫秒级吐出一帧多视角画面,本体的电和热给不了。但它揭示了一个方向:世界模型越靠近本体,对推理系统“每焦耳能产生多少有效预测”的要求就越苛刻。
局限:论文自己列出的三条
第一,精度调度依赖合成代理。EEH 的阈值、40/60 的步数分配,都来自 softmax 温度衰减模拟的熵坍缩,而不是训练好的策略的真实 rollout。真实智能体在真实任务里的置信度曲线可能完全不同,量化误差对规划质量的影响也还没有验证。
第二,40 倍是设计目标。论文没有做 RTL 综合,NMCU 的 80% 片外流量削减、LSS 的 60–70% 冗余读削减也都是估计。真实的综合结果可能在 10–20 倍,那样温升约 15–25 K,仍在可接受范围,但结论的幅度会变。
第三,热模型带了理想化边界。均热片后面的散热器被当作恒温环境,9% 的热点份额是量级假设。真实机器人上的散热路径更长、更复杂,实际温度只会更高。
还有一条论文没有明说但读者应该看到的:WMPA 加速的是 rollout,而 rollout 只是规划的一部分。动作采样、打分、树结构维护、观测编码都还在外面。一块加速器把规划中占比最大的部分加速了几十倍,端到端的规划延迟和能耗仍然取决于这些环节的比例。这提醒我们,硬件加速的收益永远要放回整条流水线里衡量。
读这类论文时怎么分级证据
WMPA 这篇论文的价值和它的风险,都来自它同时做了四种不同性质的工作。把它们混在一起看,要么高估、要么低估。按证据强度排下来是:
| 结论 | 证据类型 | 强度 | 可能需要怎样修正 |
|---|---|---|---|
| 每一步的互信息有上界,开环 rollout 不确定性单调累积 | 信息论不等式,有明确前提 | 强,可直接复用 | 只要求 A1、A2 成立 |
| 门数下界与互信息成正比 | 信息流计数,非严格电路复杂度 | 中等,作为直觉可用 | 严格形式仍是开放问题 |
| CMOS 能耗下界 | 取决于工艺参数取值 | 中等,量级可靠 | 、 随工艺变化 |
| rollout 所有操作落在带宽受限区 | 解析计算的 roofline | 强,独立于具体实现 | 只依赖权重/激活尺寸 |
| 实测能量距离下界约 | 板卡遥测,含全子系统 | 强,但口径不同 | 不宜与纯数据通路下界逐项对比 |
| 持续规划下 tile 会升到 556 K | 三维有限元,边界理想化 | 中等,相对结论可靠 | 绝对温度依赖 9% 份额假设 |
| 熵驱动精度调度有效 | 合成代理,未接训练策略 | 弱,待验证 | 需要真实 agent 的置信度曲线 |
| 40 倍功耗、80% 片外削减 | 设计目标,未综合 | 弱 | 需要 RTL 综合与流片 |
这张表本身就是读论文的方法。最值得信的是“带宽受限”这条:它由权重和激活的尺寸解析算出,与实现细节无关,三代 GPU 结论一致,所以几乎不可能错。最需要在后续工作里补的是最后两条:精度调度和综合结果,它们决定了这套架构是“能用”还是“高效”。中间那几条属于“量级对、细节要小心”的类型:它们足以支撑方向判断,却不足以支撑产品决策。
对关注推理与系统的人来说,这张表还有另一层用处:它示范了怎样把理论下界、微基准测量和热仿真放在同一个论证里。三者各有偏置——理论下界偏乐观、实测偏悲观、仿真偏理想化——但方向不同的误差会互相约束,这比任何一个单独的数字都更可信。这也是(六)讲评测时反复出现的思路:单一指标总是可以被优化到失真,只有交叉验证的栈才站得住。
小结
把这一篇的推导串起来,可以按“前提—结论—代价”三层重述。
前提是三个假设:潜状态满足马尔可夫性,所以开环 rollout 可以链式分解;转移是随机的,所以每步有正的熵增量;信息必须穿过门电路,所以比特要换成焦耳。三个假设都很弱,在 RSSM 上直接成立,在更复杂的潜空间中需要逐条检查。
结论有三条:第一,开环 rollout 的不确定性单调累积但被 封顶, 的 categorical 潜空间封顶 160 bit;第二,这个上界给出 6.55 pJ 的单次规划能量下界,而 T4 实测 0.387 J,差距约十一个数量级,且差距的主因是数据搬运;第三,毫米级 tile 在 GPU 级功耗密度下会升到 556 K,降 40 倍才回到 306 K。
代价也清楚:WMPA 的四个部件让“持续运行”成为可能,但它依赖合成代理的精度调度、未经综合的功耗目标与理想化的热边界,距离理论下界仍有九个数量级。
这一篇把世界模型的账本从机房搬到了机器人本体上,核心是一条从下界到瓶颈再到架构的链条。
在信息侧,开环 rollout 的每一步至少要传递 的信息,对 categorical 潜变量最多 160 bit。在电路侧,这些信息至少要经过同样多的门求值,每一步的 CMOS 动态能耗下界是 ,对 、 的一次规划调用约为 6.55 pJ。在硬件侧,一台 T4 同样配置实测约 0.387 J,差距 ,而差距的来源主要是数据搬运而不是计算。
热是第三个约束。毫米级 tile 在 GPU 级功耗密度下,即使有理想均热片也会升到 556 K;降 40 倍才回到 306 K。WMPA 用近存计算、熵驱动精度、copy-on-write 状态暂存和 NoC 互联的组合去逼近这个目标,而它真正要解决的问题不是“跑得更快”,而是“能不能在不把机器人烤热的条件下持续地想”。
系列到这里基本完成了世界模型从概念到硬件的一条完整链路。如果还要往深处走,剩下的问题在更细的接口:如何让世界模型和规划器之间的数据结构被硬件直接理解,如何把一次 rollout 的中间状态复用给下一次规划,以及当世界模型从 GRU 换成小型 Transformer 时,这套下界推导要怎么改写。
参考资料
- The World Model Planning Accelerator (WMPA): Hardware-Algorithm Co-Design for Embedded AI in Robotics(Ramkumar、Bharadwaj、Hameed,arXiv:2611.10316,2026-11)
- Mastering diverse control tasks through world models(DreamerV3,Hafner 等,Nature 640,2025)
- Temporal Difference Learning for Model Predictive Control(TD-MPC,Hansen、Su、Wang,ICML 2022)
- Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model(MuZero,Schrittwieser 等,Nature 588,2020)
- In-Datacenter Performance Analysis of a Tensor Processing Unit(Jouppi 等,ISCA 2017)
- Processing Data Where It Makes Sense: Enabling In-Memory Computation(Mutlu 等,Microprocessors and Microsystems 67,2019)
- The Architectural Implications of Autonomous Driving: Constraints and Acceleration(Lin 等,ASPLOS 2018)
- Roofline: An Insightful Visual Performance Model for Multicore Architectures(Williams、Waterman、Patterson,CACM 2009)
- Irreversibility and Heat Generation in the Computing Process(Landauer,IBM Journal of Research and Development,1961)
- High-Temperature Thermal Conductivity of Silicon(Glassbrenner、Slack,Physical Review 134,1964)
- CACTI 7: New Tools for Interconnect Exploration in Innovative Off-Chip Memories(Balasubramonian 等,ACM TACO 2017)
- PrimeSim: A Generalist World Model Simulator from Large-Scale Cross-Embodiment Demonstrations(2026-11)
- WMPA roofline 与理论下界复盘代码开源仓库
- Mixed Precision Training(Micikevicius 等,ICLR 2018)
图源说明:图 1(Roofline 投影)、图 2(动态激活稀疏度与置信度阈值)、图 3(实测能量与 CMOS 下界对比)、图 4(WMPA tile 框图)分别取自 arXiv:2611.10316 的 Figure 1、Figure 2、Figure 3 与 Figure 4。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



