


世界模型从零讲起(十一):学过模型之后,为什么还要在它上面再想象一遍——Dyna 谱系、PILCO 与复合误差
承接前十篇:被跳过的一步
前十篇把世界模型按技术路线展开了一遍。(一)给出了「重建、生成、联合嵌入」三条路线的形式化定义,(二)拆了 Dreamer 的 RSSM 与想象训练,(三)讲 JEPA 如何在表征空间里预测,(四)与(五)把话题推到视频生成与动作联合生成,(六)到(十)分别落在评测、部署、规划、推理系统与硬件下界。
这些篇目各自回答了「世界模型长什么样」和「它被放在系统的什么位置」,但有一个更早的问题被跳过了:一个智能体既然已经学会了模型,为什么不直接在真实环境里试,非要在模型里再跑一遍? 这个问题看起来是废话——在模型里跑比在真实世界里试便宜得多。但把具体数字摆出来,答案就不那么显然了:如果模型一步预测只需要几微秒,而真实环境一步要几十毫秒,那么模型里跑一千步的成本只相当于真实世界里跑一步,看起来任何一步都该在模型里跑。可现实里的强化学习系统之所以还要保留大量真实交互,恰恰是因为模型里跑出来的东西会越来越不像真的。
这一篇补的就是这一步。它的两个主角分别站在这条线的起点与第一个成熟拐点上。第一个是 Dyna 架构,Richard Sutton 在 1990 年发表于 Machine Learning 期刊,它第一次把「学到的模型」和「用模型想象出的经验」放进同一个学习循环,并给出了一个到今天仍在被复用的架构图。第二个是 PILCO,Marc Deisenroth 与 Carl Rasmussen 在 2011 年的 ICML 上提出,它第一次把模型的不确定性显式地放进长程规划里,用高斯过程让「模型有多不信自己」变成可以计算、可以求导的量。
两者中间还夹着一条必须单独讲的谱系:World Models、SimPLe、MBPO。这些工作把 Dyna 的想象从表格推进到神经网络与连续控制,同时把这一篇真正的主角推上台面——复合误差。它是所有模型基方法的物理天花板,也是今天的世界模型在做长程 rollout、做规划、做实时控制时绕不开的账。
Dyna:为什么要在模型里再走一遍
一张图看懂 Dyna 的循环
Sutton 在 1990 年的论文 Integrated Architectures for Learning, Planning, and Reacting Based on Approximating Dynamic Programming 里,把当时的强化学习系统分成了两类。一类是纯反应式的:只从真实经验里更新价值函数,学到什么就用什么,没有「规划」这一步。另一类是纯规划式的:先建立一个完整的模型,然后只在模型上反复迭代规划算法,直到收敛,再把结果拿去用。两类系统各有各的毛病。纯反应式系统对每一条真实经验的利用率只有一次,样本效率极低;纯规划式系统必须在模型建好之后才能开始,而且模型一旦建错,规划出来的东西全部作废,没有任何机制去修正。
Dyna 提出的第三个方案是把两者放进同一个循环。真实经验进一帧,就用它更新一次价值函数,再用它更新一次模型;模型一更新,立刻从某个状态出发、用模型展开若干步、把展开出来的虚拟经验拿回去更新价值函数。整个过程没有「先学完模型再规划」的分界,规划和反应交替进行,互相同步。
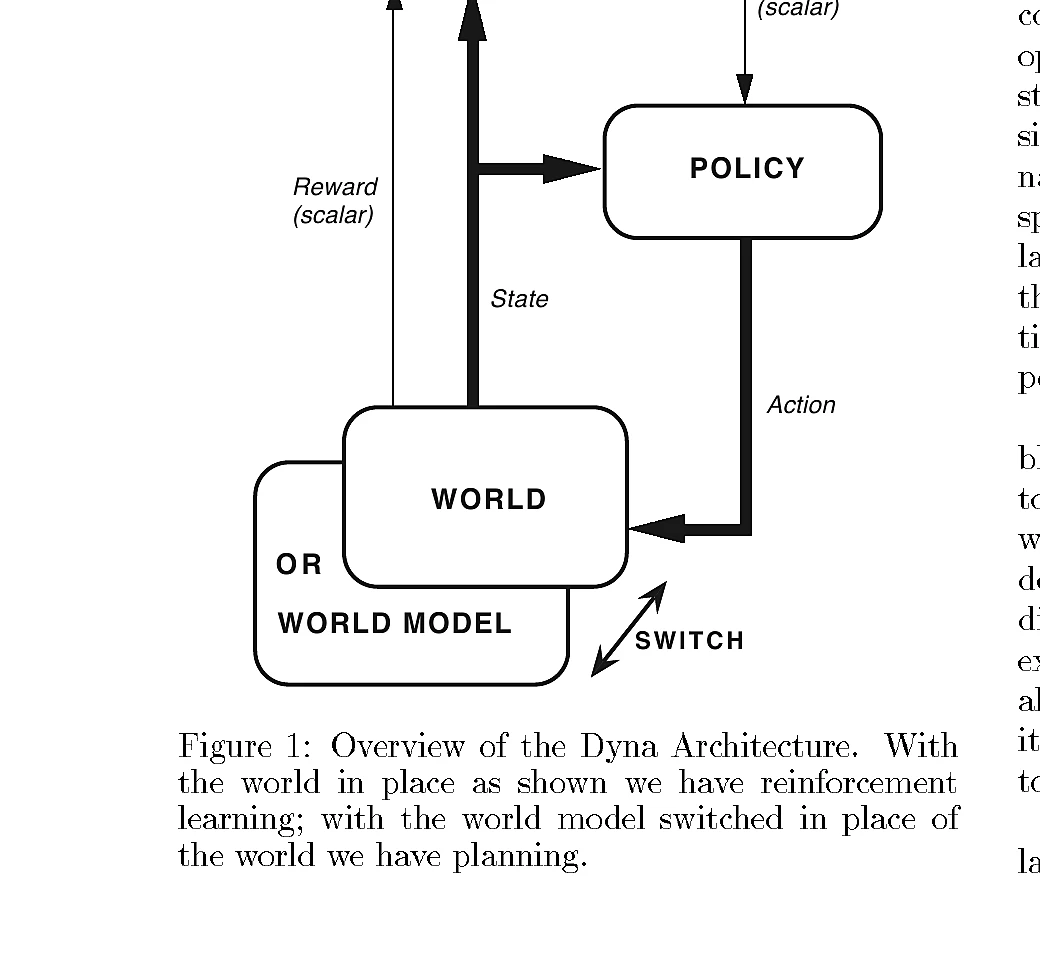
这张图是 Sutton 1990 年论文里的 Figure 1,图中四个部件分别是评估函数(Evaluation Function)、策略(Policy)、外部世界(World)与世界模型(World Model)。图中标出的箭头有三类:状态(State)从世界流向策略与评估函数,奖励(Reward)从世界(或世界模型)流向评估函数,动作(Action)从策略流向世界或世界模型。图注里那句话把整张图说透了:世界里接上真实环境,系统就是强化学习;把真实环境换成世界模型,系统就是规划。区别只在于那一次「拿到下一个状态和奖励」是从真实环境取,还是从模型里取。
阅读这张图时最容易看漏的一点是:模型产生的想象经验更新评估函数与策略之后,并不会反过来更新模型。想象只是被当作额外的样本喂给同一个学习器,它不会改变模型本身。这看起来像是浪费,但恰恰是这个不对称,让 Dyna 在模型出错时仍然能靠真实经验兜底。如果想象经验也拿去训练模型,模型就会在自己的输出上自我强化,误差形成正反馈。这一点在后面讲复合误差时会显得越来越重要。
把 Dyna 写成伪代码
Dyna 本身是一个架构模式,而不是一套固定算法。Sutton 原文在 1990 年的论文里用的是一个叫 Dyna-PI 的具体实例,它用一个共享的「内循环」同时产生真实经验与想象经验,价值函数采用折扣后的 TD 形式:
其中 是状态 的价值估计, 是执行动作后的下一个状态, 是即时奖励, 是折扣率, 是学习率。这个式子的右侧 就是所谓的「一步回报」,它同时也是模型输出的「期望目标」。原文把这个内循环画成 Figure 2,流程是:
1. 决定这次是真实经验还是想象经验2. 选一个状态 x(真实经验用当前状态;想象经验从已遇到过的状态里随机选)3. 用当前策略选动作 a4. 执行 a,从「世界」或「世界模型」得到下一状态 y 和奖励 r5. 若是真实经验,用 (x, a, y, r) 更新世界模型6. 用一步回报 r + γe(y) 更新价值函数 e(x)7. 更新策略,使得在 x 执行 a 的倾向增大或减小,依据 e(x) 与 r + γe(y) 的差8. 回到第 1 步这个内循环最值得注意的是第 2 步和第 5 步的不对称:真实经验时才更新模型,想象经验时不更新模型。想象只用来更新价值函数与策略。这跟许多人对 Dyna 的直觉相反——很多人会以为模型也要从自己的想象里学习。原文明确把想象经验限定为只往价值函数流的样本,原因就是上一节讲的正反馈:模型在自己的输出上训练,会把偏差固化成结构。
用现代写法把它翻译成一个可运行的骨架,就是下面这段:
# Dyna-PI 的现代数值版(表格型)V = defaultdict(float) # 价值函数 e(x)model = {} # 世界模型:model[(x, a)] = (y, r)
def q_update(x, a, y, r): V[x] += alpha * (r + gamma * V[y] - V[x]) # 一步 TD 更新
def dyna(k_plan): x = env.reset() for _ in range(num_trials): a = policy(V, x) # 按策略选动作 y, r = env.step(x, a) # 第 4 步:真实世界 model[(x, a)] = (y, r) # 第 5 步:更新模型 q_update(x, a, y, r) # 第 6 步:直接强化 for _ in range(k_plan): # 第 2 到 6 步:想象 x_p, a_p = random_known_pair(model) # 从已见过的状态里随机选 if (x_p, a_p) not in model: continue y_p, r_p = model[(x_p, a_p)] # 第 4 步:从模型取 q_update(x_p, a_p, y_p, r_p) # 第 6 步:用想象更新 x = y三处动作分别对应前面图里的三条箭头:q_update 直接用真实经验、model[(x, a)] = ... 更新模型、循环里的 q_update 用想象经验。参数 k_plan 控制每次真实交互之后做多少次想象更新。当 k_plan = 0,Dyna-PI 退化成纯反应式的试错学习;当 k_plan 很大,Dyna-PI 的行为接近「每次拿到一条真实经验就把它在记忆里反复咀嚼」。
原文的实验:规划让第四趟就学会
Sutton 用的实验环境是一个 6×9 的网格迷宫,共 54 个格子(状态)。其中一个格子是起点 S,一个格子是目标 G,若干格子是阴影屏障、不可进入,其余格子都可通行。每个格子有四个动作 UP/DOWN/RIGHT/LEFT,如果移动会撞到屏障或走出边界则原地不动。所有转移的奖励都是 0,只有从目标 G 下方那一格执行 UP 时奖励为 +1,并直接回到起点 S 开始下一趟(trial)。每一趟是「从 S 到 G」的一次行程。
原文在一组固定的超参数下只改 (想象次数),分别取 0、10、100,每个设置跑 100 次平均,看每一趟走过的步数怎么下降。参数是 ()或 ( 与 )、、。
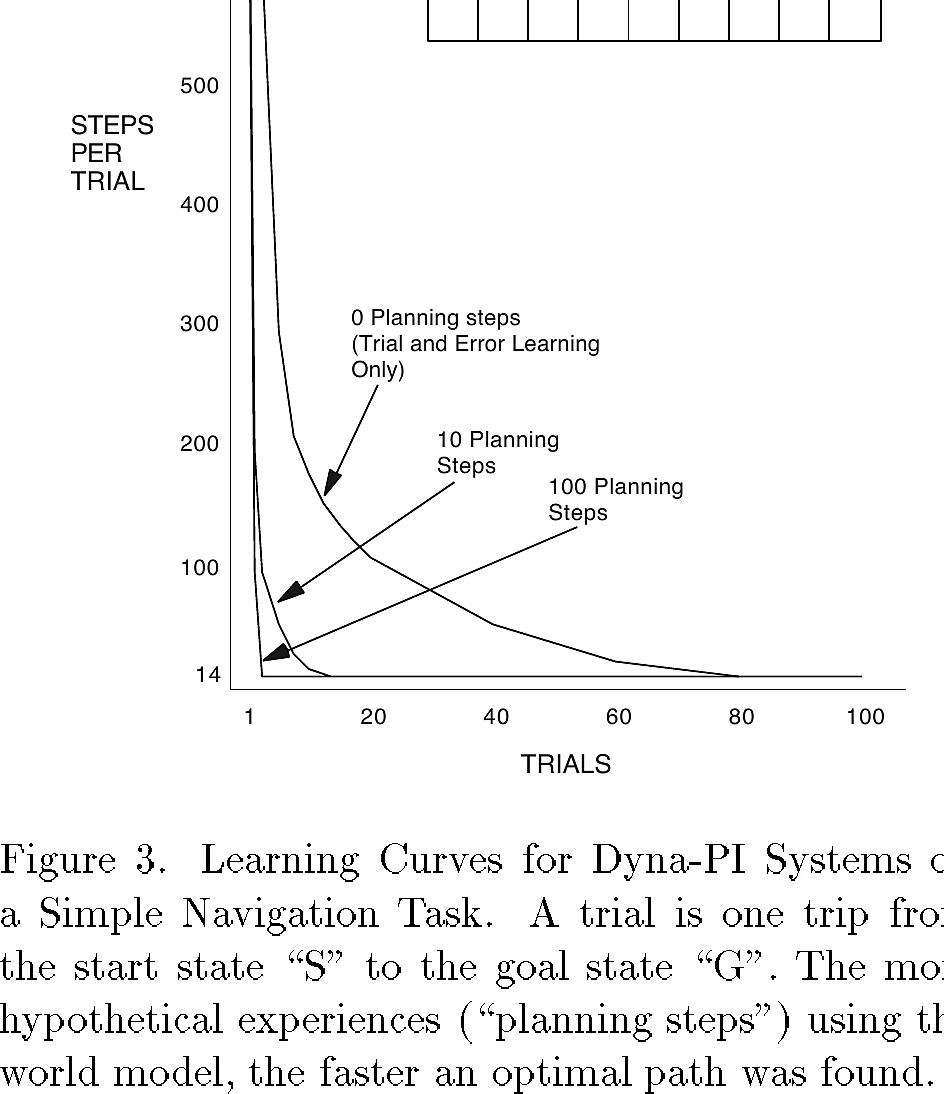
这张图是原文的 Figure 3。横轴是 trial 序号(从 1 到 100),纵轴是每一趟从起点走到目标所用的步数。三条曲线分别对应 (纯试错学习)、 与 。读图时注意三点。第一, 的曲线在最初几十趟里缓慢下降,它每一趟只学到「最后一步」,所以策略是逐格向前推进的。第二, 的曲线下降得明显更快,在十几趟内就接近了较低的步数水平。第三, 的曲线下降最快,通常在第 4 趟就找到最优路径并稳定下来。三条曲线的间距直观地说明了:想象让一次真实更新扩散到了许多状态上。
原文用 Figure 4 进一步画出了第二趟中途两个系统各自的策略: 的系统只学会了「最后一格往哪走」,其他格子的箭头还接近随机; 的系统已经发展出一条从起点几乎能走到目标附近的策略。这个对比解释了为什么 能在第 4 趟学会——它不是靠更多的真实踩点,而是靠模型把已有的价值更新搬运到了尚未走过的格子上。
这一结论在今天仍然是读模型基强化学习论文时最有用的判断标尺:规划的收益上限取决于模型覆盖面的宽度,而不是规划的多少。在这条迷宫里, 从 10 提到 100,收益的边际已经在递减;如果模型覆盖不全(比如有状态从未被真实踩到),再多的想象也只能在已有区域里反复咀嚼。把这一点外推到连续控制的机器人上就是:模型在任何没被数据覆盖的区域内都是空白,而想象偏偏容易跑进这些空白里。
从表格到神经网络:Dyna 的现代形态
1990 年的 Dyna 是纯表格版本的,模型是一张字典,价值函数也是一张表。今天几乎所有「用学到的模型做数据增广」的方法,都沿用这个循环结构,只是把表格换成了神经网络。按时间顺序,这条谱系至少有下面几步:
| 年份 | 工作 | 模型的形式 | 规划或增广的形态 | 与 Dyna 的关系 |
|---|---|---|---|---|
| 1990 | Dyna(Sutton) | 确定性转移表 | 从模型里随机想象一步,更新价值表 | 原型 |
| 2018 | World Models(Ha & Schmidhuber) | VAE + MDN-RNN | 在潜空间里想象完整 rollout,训练控制器 | 把循环搬进潜空间 |
| 2019 | SimPLe | 视频预测模型 | 用模型生成视频帧,在帧上训练 PPO | 视频层级的 Dyna |
| 2019 | PlaNet | RSSM 前身 | 在潜空间里做 CEM 规划 | 用规划取代价值更新 |
| 2020 | DreamerV1 | RSSM | 想象 rollout 训练策略 | 想象训练取代规划 |
| 2020 | MBPO | 集成概率动力学 | 短 rollout 增广真实数据,再交给 SAC | 最清晰的 Dyna 变体 |
这张表里有两个条目值得展开。首先是 World Models:Ha 与 Schmidhuber 在 2018 年把 VAE、MDN-RNN 和 CMA-ES 控制器分开训练,控制器只在 MDN-RNN 的想象里优化,从不直接接触真实环境。这是 Dyna 循环里「规划」那一支被推到极限:真实交互只用于训练模型,策略完全在模型里学。这条路线正是(一)和(二)展开的内容。
其次是 MBPO。Michael Janner 等人在 2019 年公开、2020 年发表于 ICLR 的论文 When to Trust Your Model: Model-Based Policy Optimization 里,把 Dyna 的「想象若干步」显式限制在一个很短的视野里:模型 rollout 的长度通常只有 1 到 5 步,从真实经验过的状态出发,然后把增广出来的数据交给一个离策略算法(SAC)去更新策略。这个短 rollout 看起来是个不起眼的工程选择,其实是这一篇下半个主题——复合误差——的第一个工程答案。
Dyna 的核心洞察:经验是货币
把 Dyna 抽象出来,它其实只说了三件事。第一,经验是强化学习里最稀缺的资源,一条真实的经验应该被用不止一次。第二,模型的作用是凭空造出更多经验,造出来的经验可以拿去同一个学习器里用。第三,模型造出来的经验必须被真实经验兜底,因为模型会错,而错的经验一旦变成学习器唯一的信息来源,学习器就会在错误上自我强化。
这三条听起来平淡,但把第二条推到极致就变成了今天的世界模型:不只是想象一步,而是想象未来几百步,甚至直接在想象里决定动作。这正是(八)里那条从 Dyna 想象到 MuZero 搜索再到 TD-MPC2 轨迹优化的谱系。而把第三条推到极致,就是这一篇的后半段要回答的:想象出来的经验,究竟能信多久。
复合误差:想象为什么不能一直往前跑
一条链上的误差怎么长大
Dyna 的想象是逐层展开的。第一层想象从真实状态 出发;第二层想象的起点,是第一层想象出来的 ;第三层从 出发,依此类推。这里的关键问题是:每一层想象的输入都不是真实的,而是上一层想象的输出。
设真实动力学是 ,学到的模型是 ,每一步的模型误差记为 。假设模型每一步的误差都有界 ,并且模型是 -Lipschitz 的(即对两个不同的起点,输出的差异不超过起点差异的 倍)。那么经过 步想象之后,误差的上界是:
推导很短。第 步的误差可以分为两部分:一部分是第 步模型自身的误差 ;另一部分是第 步模型的输入本身就是错的——输入误差是第 步的误差,经过 -Lipschitz 的模型放大 倍。于是
把递推展开,就得到上面的求和式。这是一个等比数列求和:
由此可以读出两个截然不同的区域。当 (模型是收缩的,误差随传播自动衰减),误差的上界收敛到一个常数 ,想象再长也不会比单步误差大太多——这是 Dyna 原版网格迷宫得以成立的原因,它是确定性转移表,本身是收缩的。当 ,误差的上界随 指数增长, 项主导,想象 步之后的误差是单步误差的 倍量级。一个 的模型,想象 100 步后的误差上界就是单步误差的约 13780 倍; 时是约 8282 万倍。
这张推导给了复合误差(compounding error)一个明确定义:在开环想象里,每一步的模型误差不仅是误差本身,还通过后续 步的放大被反复计入。注意,这个结论与模型在训练集上的精度关系不大——一个在单步上非常精确的模型( 极小),只要它的 Lipschitz 常数大于 1,长程想象依然会爆炸。复合误差的根因不完全是「模型不准」,而是「误差被传播」。
这段推导在物理上有一个直观解释:想象展开的时候,每一步都是在一个「可能已经不在真实世界里的状态」上继续推。真实世界里,动作会改变状态,状态会改变下一步的动力学输入;模型里,输入本身就是模型自己编出来的,一旦编错了一位,后面每一步都会在错误位的基础上重新计算,错误不会被外部纠正。这是开环和闭环的根本区别:真实环境里存在一个环境作为外部反馈,模型想象里没有。
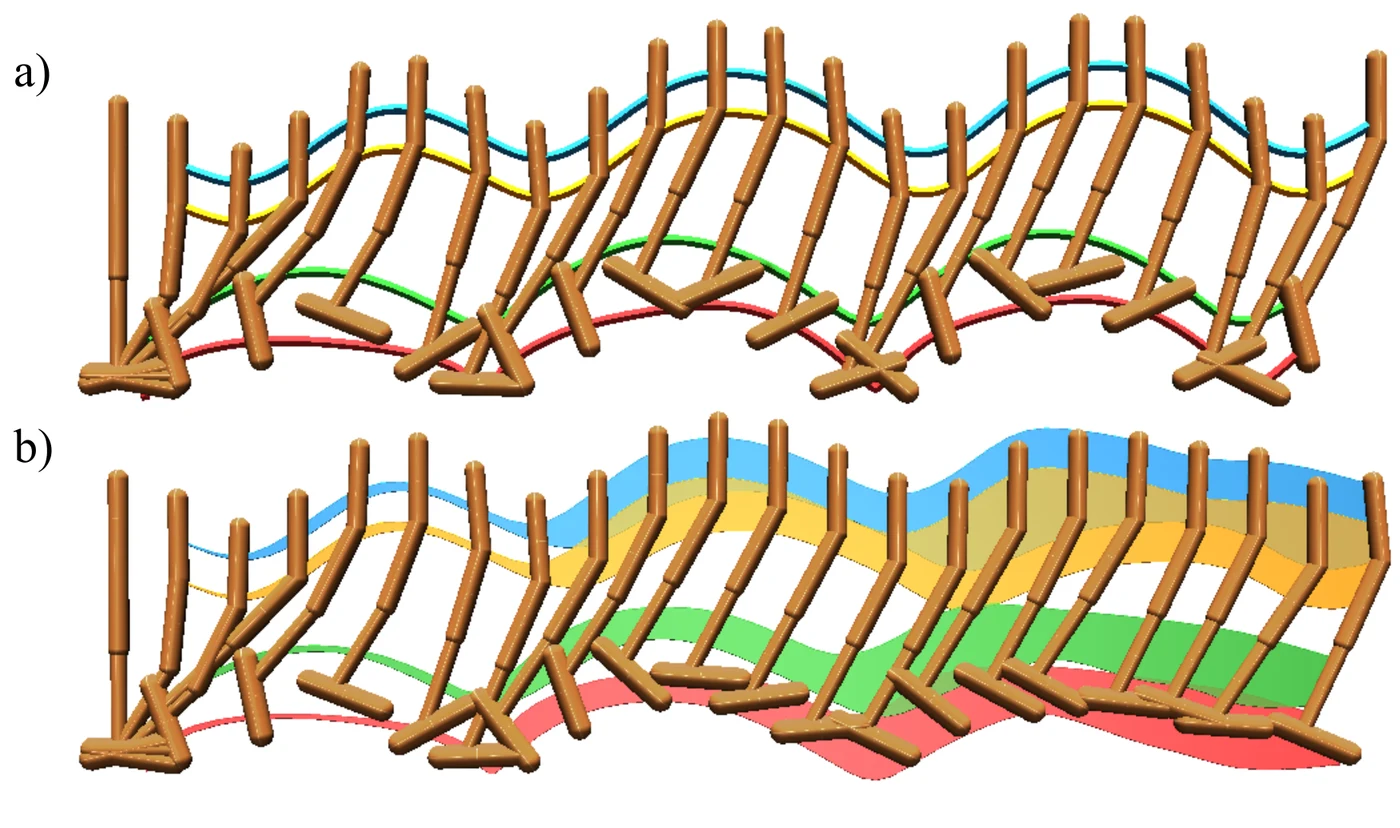
这张图是 MBPO 的 Figure 4,它把上面的推导直接画了出来。左侧是机器人在真实环境里执行一段 450 步的跳跃动作时,关节末端在空间中划出的轨迹;右侧是把同一段动作序列放进学到的模型里展开 1000 次,画出的轨迹分布。右图中阴影的宽度是预测的一个标准差,可以看到它随步数增加而持续变宽,原本清晰的周期性跳动逐渐退化成模糊的一团。这就是复合误差在连续控制里的形状:不是模型在第一步就错得很离谱,而是误差沿着想象的链条越滚越大。
同一张图还有一个常被忽略的细节:右图里 1000 条 rollout 的均值轨迹在相当长的范围内仍然跟左图相似,但方差在增长。这意味着单看均值会低估问题——一条「平均看起来还行」的想象轨迹,其可信区间可能已经把物理上不可能的状态包含进来了。对下游的策略优化来说,真正被拿去训练的恰恰是这些分布里的样本,而不是均值。
模型利用:误差不只是误差
复合误差说的是「想象出来的状态会越来越不对」,但世界模型不只需要预测状态,还被用来评估动作的价值。这就引出了比复合误差更麻烦的第二个问题:模型利用(model exploitation)。
设模型的预测误差在状态空间里不是均匀的。模型在训练数据覆盖的区域里误差很小,在未覆盖的区域里误差可能很大。策略优化要的是奖励最大化,它看到的是模型给出的奖励。如果一个动作把状态推进了未覆盖区域,模型在那个区域里的奖励预测可能是随机的、往往偏高(因为训练数据里高奖励的转移才是策略关注的重点,模型没有见过「在那个区域里动作失败」的样本),策略就会专门选择这些动作,以在模型里骗取高奖励。
形式上,策略优化的目标是
其中 是学到的模型。这个优化问题与真实的目标
之间的差距不是简单的「模型误差」——它是期望里的分布差。当 与 在两个分布下差异显著,两个最优策略可能完全不同:模型里的最优策略,可能是真实世界里的灾难策略。
Dyna 原文的网格迷宫恰好是模型利用最难发生的情形:确定性转移、有限状态、所有状态都会被真实踩到。一旦把环境换成连续控制(机械臂、四足、无人机),模型就再也覆盖不了整个状态空间,模型利用几乎立刻发生。PILCO 正是针对这一困境设计的。
PILCO:把概率写进模型
想法的起点:我不需要「最好的模型」
PILCO 的全名是 PILCO: A Model-Based and Data-Efficient Approach to Policy Search,由 Marc Deisenroth 与 Carl Rasmussen 在 2011 年提出。当年的问题背景很具体:很多真实系统(尤其是机器人)的数据极其昂贵,一条真实经验要花几分钟甚至几个小时,而传统无模型强化学习动辄需要几十万帧。PILCO 的定位就是用最少的数据学到一条策略,它的目标不是「最好的模型」,而是「足够让策略学对的模型」。
这个差别在方法设计上非常关键。普通模型基方法追求的是模型单步误差最小,PILCO 追求的是策略评估所依赖的那部分模型误差可控。这两件事在数学上不是一回事。例如:模型在训练数据附近单步误差很小,但在远处误差巨大;如果策略只在这条精度带里走,模型就够用,单步误差的大小本身并不起作用。
PILCO 的做法是:既然策略只关心在它走过的轨迹上的预测精度,那就让模型输出概率分布而不是点预测,然后在策略评估里把分布传播到轨迹末尾,用传播后的不确定性来判断这次策略更新是不是可信。
高斯过程:从点预测到分布
PILCO 的动力学模型是一个高斯过程(Gaussian Process, GP)。对每个状态维度,假设从 到下一状态 的映射服从一个 GP 先验:
其中 是核函数,PILCO 用的是平方指数(squared exponential)核,形式为
其中 是状态与动作的拼接, 是信号方差, 是各输入维度的长度尺度矩阵(对角阵,每个维度一个长度尺度)。在给定 个观测点 之后,GP 对任意新输入 给出的后验是正态分布:
其中
是 与所有训练点的核向量, 是训练点两两之间的核矩阵, 是观测噪声方差, 是训练目标。 是 GP 给出的点预测, 是 GP 给出的不确定性。
GP 在这里扮演的角色和神经网络完全不同。对于神经网络,模型的不确定性要么没有,要么要靠集成、dropout 这些附加手段估计;对于 GP,不确定性是模型定义的一部分。在训练点附近, 很小(模型见过);在远离训练点的地方,GP 的先验是零均值, 接近 (模型没见过)。这就是 PILCO 用来判断「想象现在还能不能信」的自然信号。
读到这里要停下来想一想 GP 为什么能做到这一步:GP 的后验方差只取决于输入点的位置和核函数,与训练目标的数值无关。换句话说,它是结构先验产生的不确定性,而不是从数据里估出来的不确定性。这也意味着它对数据分布外区域的判断只依赖核的假设——如果环境在训练点附近的真实结构比平滑核所假设的更复杂,GP 在「以为见过」的区域也可能不准。这一点是 PILCO 在长视野下的主要局限之一。
概率传播:把 GP 塞进多步轨迹
只有单步的概率分布还不够,PILCO 真正要的东西是整条轨迹末端状态的概率分布。给定当前状态分布 ,策略 输出一个确定性的动作,动力学是 GP,那么第一步之后的分布是
这个积分对非线性动力学没有解析解。PILCO 的处理是两步近似。第一步,把策略表示成带 RBF 特征的线性模型:
其中 是基函数个数, 和 是固定基的中心与宽度, 是要学的权重。这个形式的关键性质是:当输入 服从高斯分布时, 的期望和协方差都有解析解(这是高斯与 RBF 的乘积积分表带来的)。第二步,在这个性质下,对动力学模型做一阶矩匹配(moment matching),近似地得到 ,然后再把 作为下一次传播的输入,一路往前推。
这里的近似误差有两个来源。其一,策略被限制成 RBF 线性形式,这可能比神经网络的表达能力弱,但 PILCO 选这个形式是有意为之的:只有在这种形式下,传播才有可计算的解析式,而且可微,可以求关于 的梯度。其二,一阶矩匹配只保留了均值和方差,忽略了高次矩,这在分布非高斯的区域会引入偏差。PILCO 的整套设计都在「可解析传播」这一约束下做取舍,这是它能在 2011 年的计算条件下处理上百步视野的原因。
策略优化:在长程代价上做解析梯度
PILCO 要优化的不是奖励,而是代价:每次策略更新之后,智能体被初始状态约束在目标点附近,要评估的是走完整条轨迹的总代价。代价函数定义为
其中 是目标状态, 是宽度矩阵,决定「离目标多近才接近零代价」。这个形式的代价在 时趋于 0,在远处趋于 1,是一个饱和的指数形式,好处是在分布尾部梯度不会爆炸。
PILCO 的总目标函数是
其中 是想象视野长度, 是折扣因子。 关于策略参数 的梯度可以沿着整个传播链做解析求导,这就是 PILCO 的策略搜索:不是采样策略的梯度,而是对已知分布下的期望代价求梯度。这也是它样本效率高的根源——一个梯度更新用到的信息不是一条采样轨迹,而是整条长程传播的解析近似。
原文的实验与它真正证明的东西
PILCO 原文围绕三个系统展开:一个真实的 cart-pole 摆起加平衡任务、一个仿真的 cart-double-pendulum 摆起任务,以及一个 5 自由度的独轮车平衡任务。论文报告的核心数字很具体:在真实 cart-pole 上完成摆起加平衡,PILCO 只用了 17.5 秒的物理交互;仿真的双摆任务用了约 20 到 30 个 trial,对应 60 到 90 秒的交互时间;独轮车任务同样在仿真里从零学起。这些数字的意义不在于「快了多少倍」的排名,而在于它第一次在真实系统上证明了——不需要海量数据,也可以让一个概率模型支撑一条长程策略。
这套方法把「模型不确定性」从附属指标变成了规划的主变量。代价函数在远处趋于饱和,不确定性在传播中变大,两者结合的效果是:策略会主动避开那些模型方差大的区域。这与 Dyna 只做「加样本」的思路有本质差别——Dyna 不区分哪条想象更可信,PILCO 给每条想象打了一个可信度标签。
PILCO 留下的两个问题
PILCO 的方法很优雅,但它留下的两个问题,恰好是后面十年的主线。
第一个问题是可扩展性。GP 的后验计算需要求 矩阵的逆,训练点一多,计算量按三次方增长;PILCO 原文的实验中,训练点数是几十到几百的量级,所以还能承受。一旦把输入换成图像或高维状态,GP 就撑不住了。后来的深度模型基方法(包括 Dreamer 系列)改用神经网络,但神经网络没有自带方差,必须另找一种估计不确定性的方式——这就是集成(ensemble)和潜空间分歧(latent disagreement)登场的原因。
第二个问题是长视野下的解析传播误差。一阶矩匹配把分布压缩成高斯,只能保留均值与方差;当视野拉长、分布变得多峰时,这个近似会失效。PILCO 通过限制视野长度和代价函数的饱和形式缓解了这个问题,但没有从根本上解决。这两个问题在 2019 年的 MBPO 里被换了一个角度处理:不再试图把不确定性传播得又准又长,而是反过来把想象的长度缩短,让复合误差没有机会长大。
MBPO:用分支 rollout 把复合误差关进笼子
从整条轨迹到短分支
MBPO 的出发点是对 Dyna 的一次结构性修改。Dyna 的想象是从当前真实状态出发、连续向前展开 步;MBPO 的想象是从回放缓冲区里随机抽一个真实状态,只展开 步,然后把这 步的转移全部写进模型数据集。这个做法叫分支 rollout(branched rollout)。它有两个直接后果。
第一,想象不再局限于当前策略正在访问的状态,而是覆盖了历史上所有真实访问过的状态。这对模型的训练分布更友好,因为模型本来就是在这些状态上学出来的。第二,每次想象的长度很短,通常只有 1 到 5 步,个别任务在训练后期放宽到 15 到 25 步。这就把复合误差的指数项压到了一个很小的范围里。
算法本身只有几行,原文的 Algorithm 2 可以概括成:
每个 epoch: 1. 用真实数据集训练模型(最大似然) 2. 与环境交互 E 步,把真实转移写入数据集 3. 做 M 次模型 rollout: 从真实数据集里均匀抽一个状态 s_t 用当前策略在模型里展开 k 步,把转移写入模型数据集 4. 做 G 次梯度更新:在模型数据集上更新策略(SAC)关键在于第 3 步的「从真实数据集里抽一个状态」。如果没有这一条,想象就会从当前策略所在的少数状态出发,越走越偏;有了这一条,每一次想象都锚定在真实数据上,模型只需要负责接下来这几步的局部准确性。MBPO 原文的集成规模是 7 个概率网络,每个环境步生成 400 条模型 rollout。
三个定理:把「能信多久」写成公式
MBPO 的理论部分把「模型能信多久」写成了可以比较的不等式,这是它比大多数工程论文更有价值的地方。下面三个定理分别对应三种 rollout 方式,读的时候重点看误差项随 的变化。
第一个定理针对不分叉的模型 rollout(也就是 Dyna 式的连续想象)。设模型与真实转移分布之间的 TV 距离在每一步都有界 ,当前策略与行为策略之间的散度有界 ,奖励上界为 ,折扣因子为 。那么真实回报与模型回报之间满足
方括号里的项记为 ,可以把它读成「模型回报的可信折扣」。它说的是:只要模型回报比旧策略高出超过 ,真实回报才一定也提高。注意这个界里没有显式的 ,因为它是按无限视野推的——误差通过 进入,而 本身是单步的 TV 距离,长程的累积已经藏在 这个分母里了。
第二个定理针对分支 rollout,误差项的形状变了。设 是模型展开的步数, 是分支 rollout 估出的回报,则
这里最关键的是最后一项 :误差随 线性增长,而不是指数增长。前两项则随 指数衰减( 与 ),它们代表的是「短 rollout 少了未来信息」的代价。两项一增一减,就给出了一个有限的、可优化的 。
第三个定理把 换成「当前策略分布下的模型误差」,因为实际训练时模型误差是在新策略访问的状态上测量的。在这个版本里,最优的 rollout 长度是
这个式子把工程直觉写成了数学:模型越准( 越小), 越大;策略越偏离数据分布( 越大),前两项的衰减越慢, 也会被推大。反过来,如果模型在分布外误差很大, 就会被压到很小。MBPO 的实验设置正是这条式子的工程化:多数任务从 开始,随着训练推进线性放宽到 15 或 25。
定理怎么读:为什么分支把指数换成了线性
把定理 4.2 与第一节的 Lipschitz 推导放在一起看,会发现它们说的是同一件事的两种语言。Lipschitz 版本给出 ,指数增长来自「误差作为下一步的输入」;MBPO 的分支版本给出 ,线性增长来自「每多走一步,就多引入一份单步误差,但误差不再作为下一步的输入被反复放大」。
为什么分支能做到这一点?因为分支 rollout 的起点是真实的,而且长度很短。在 步之内,模型仍然在自己的输出上继续推,所以复合误差并没有消失;但 被限制住了,指数项 只在一个很小的 上求值,量级可控。换句话说,MBPO 不是消灭了复合误差,而是把它关进了一个足够短的笼子里。
这也解释了为什么 MBPO 的实践结论是「单步 rollout 出乎意料地强」: 时,想象只走一步,误差就是单步误差本身;而它仍然能把真实数据的价值更新扩散到缓冲区里的所有状态。代价是想象里没有多步信息,策略学不到长程因果;收益是几乎不会碰到复合误差。原文的消融实验显示,固定 就能保留大部分收益,而 200 步的 rollout 已经明显变差,500 步则完全不可用。
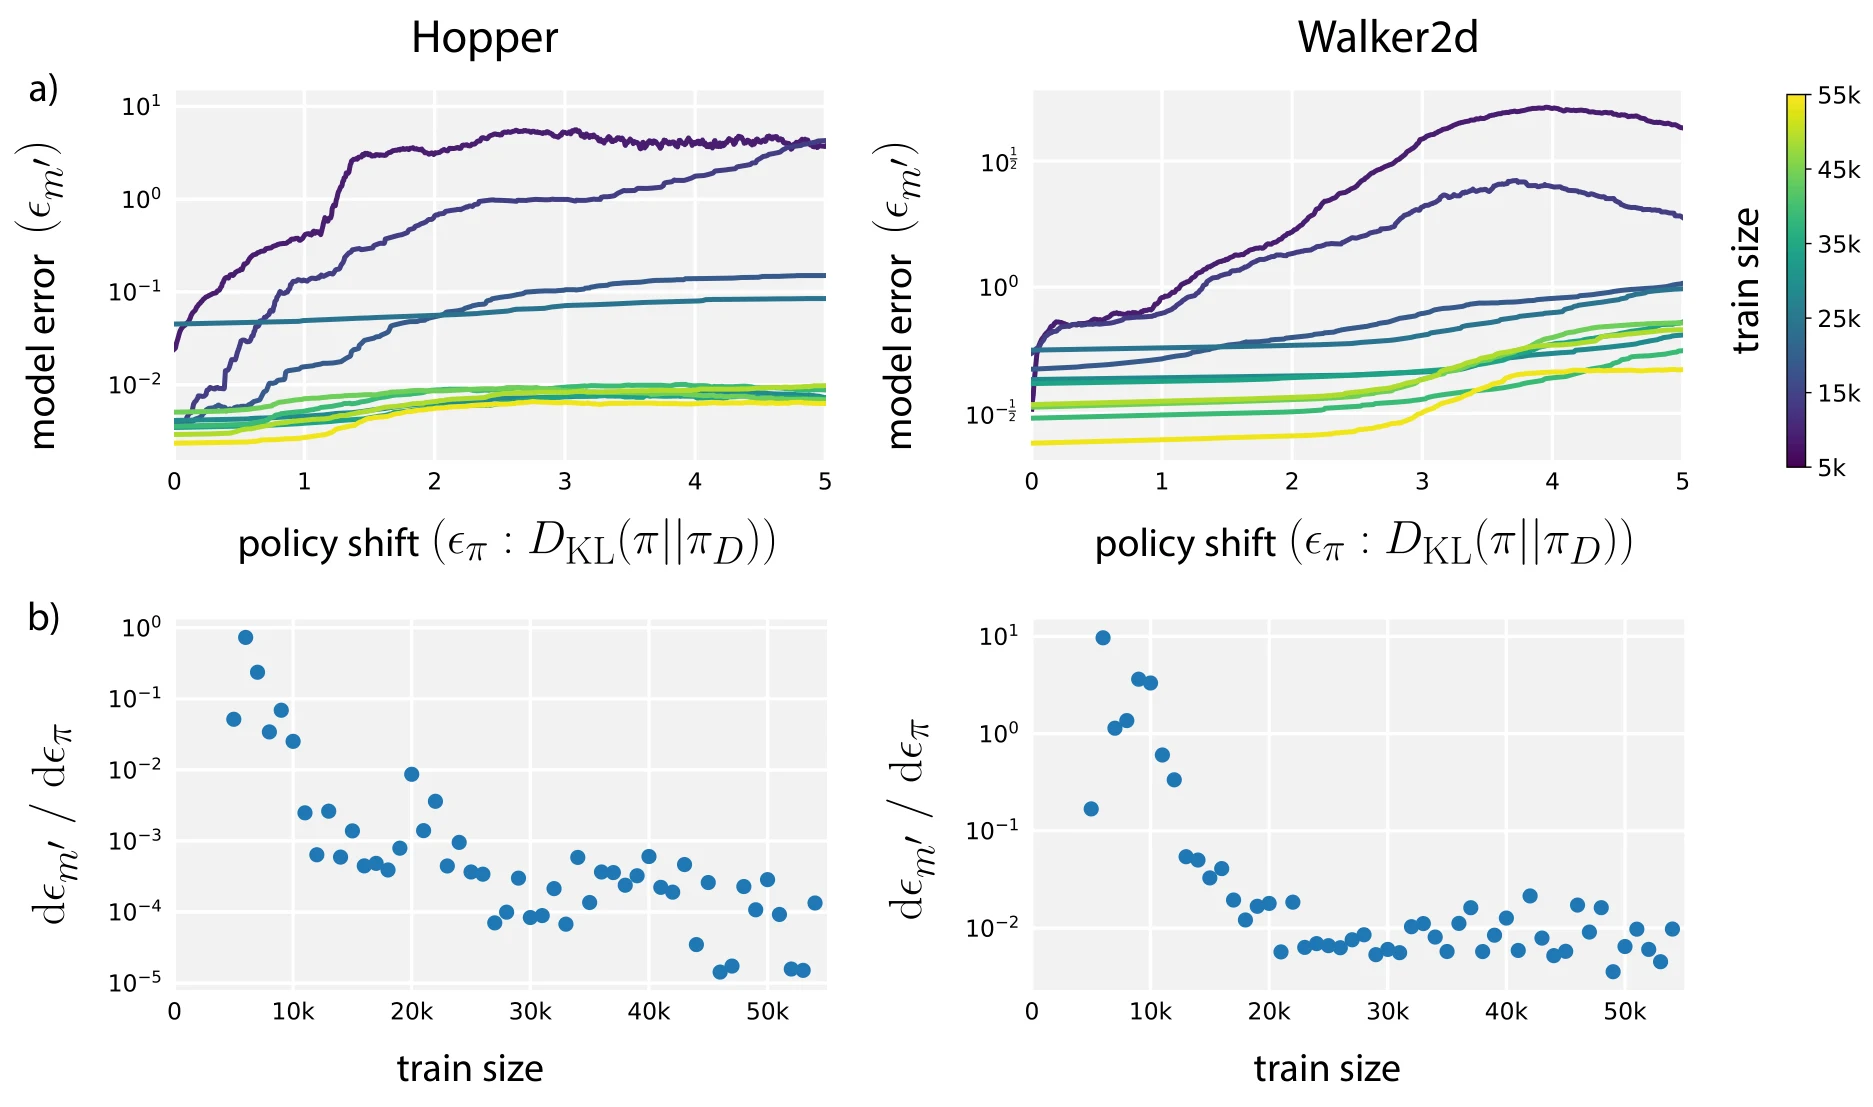
这张图是 MBPO 的 Figure 1,它解释了上面定理里 的来源。左侧两个子图分别是 Hopper 与 Walker2d 环境,横轴是当前策略与行为策略之间的散度(policy shift),纵轴是模型预测误差;不同颜色的曲线对应不同规模的训练数据(5k 到 55k 转移)。读图时注意三件事。第一,随着策略偏离训练分布,模型误差单调上升,这就是 大于 的直接证据——模型在训练分布上准,不代表在新策略访问的状态上准。第二,训练数据越多,整条曲线越低,说明覆盖面的宽度直接决定了误差的基线。第三,各条曲线的斜率不同:数据少的模型误差上升得更快,这对应着更大的有效 Lipschitz 常数。
右侧两个子图把误差对训练规模画了出来,横轴是训练转移数,纵轴仍是模型误差,可以看到误差随数据量增加而下降,但在几万条之后开始变平。这个饱和形状对工程很重要:它说明靠增加数据来压低模型误差有上限,超过某个规模后,瓶颈从数据量转移到了模型表达能力和分布覆盖上。这也解释了为什么后来的方法不再单纯堆数据,而是转向更好的表征(潜空间模型)和更好的不确定性估计(集成、分歧)。
450 步的实测:误差锥
前面 Figure 4 的右图已经展示了复合误差的形态,这里补充它没有说清的一个细节:那条误差锥的宽度不是线性的。原文的描述是「增长的不确定性与可辨识正弦运动的退化」,也就是说,模型并不是每一步都均匀地丢一点信息,而是在某个转折点之后开始丢掉整个运动模式。对规划来说,这意味着误差的增长有两个阶段:前一段是局部抖动,后一段是结构性失真。前者还能靠集成平均压住,后者不能——因为所有集成成员会在同一个转折点上一起偏离。
这也给了「不确定性惩罚」一个物理依据:惩罚不应该只与方差成正比,还应该与「预测是否仍然保持了系统的结构」相关。PILCO 用 GP 方差隐式地表达了这件事,MBPO 用集成方差近似地表达了这件事,而今天的世界模型评测((六))则把这件事显式化为物理一致性与反事实响应。
不确定性:第二种「刹车」
集成与分歧
神经网络没有 GP 那样的解析方差,工程上最常用的替代是集成:训练 个模型(不同初始化或不同数据子集),用它们预测的离散程度作为不确定性。对状态预测,第 个模型给出 ,集成方差可以写成
这个量在训练分布内很小,在分布外会变大。它的计算成本是 倍的前向,但可以并行,所以实际延迟通常远小于 倍。MBPO 用 7 个模型,DreamerV3 之后的很多实现用 5 到 8 个,都是这个折中。
集成方差有一个 GP 方差没有的好处:它不依赖核函数的平滑假设,能捕捉到数据驱动的不确定性。它也有一个 GP 方差没有的坏处:它只测量「模型成员之间是否一致」,如果所有成员以同样的方式外推错了,方差会很小,系统会误以为那里可信。这就是所谓的「集成共识错误」,在分布外区域非常常见。
Plan2Explore:把分歧变成探索奖励
2020 年的 Plan2Explore(Ramanan Sekar 等人,ICML 2020,arXiv:2005.05960)把集成分歧从「刹车」变成了「油门」。它的做法是:在潜空间动力学模型的集成上,计算不同成员对下一潜状态的预测分歧,把这个分歧当作内在奖励,让智能体主动去访问模型最不确定的区域。
形式上,内在奖励定义为
其中 是第 个集成成员预测的下一潜状态, 是它们的均值。智能体在没有任何外部奖励的任务上先用这个内在奖励预训练,然后在测试时零样本迁移到下游任务。Plan2Explore 的意义不在于它拿了多少分,而在于它把「不确定性」从被动的防御指标变成了主动的信息获取目标。这与 PILCO 的思路一脉相承:不确定性不是噪声,而是「哪里还有信息」的地图。
对世界模型来说,这条线后来演化成了两个方向。一个是探索:在数据稀缺的区域主动采样,把模型覆盖补全;另一个是保守:在不确定性高的区域不要相信模型,把策略限制在可信区域内。前者是 Plan2Explore,后者是 MOReL 与 MOPO。
离线场景:MOReL 与 MOPO 的保守化
离线强化学习把「模型利用」推到了极端:没有在线交互可以纠错,模型一旦在分布外高估,策略就会沿着错误一路走到底。2020 年的两项工作给出了两种保守化方案。
MOReL(Rahul Kidambi 等人,NeurIPS 2020,arXiv:2002.04580)的思路是构造一个悲观 MDP:当模型对某个状态的不确定性超过阈值时,直接把这个状态视为吸收态,后续回报记为一个固定的低值。这样策略就不会被诱导进入模型不确定的区域。它的关键参数是阈值,阈值太松挡不住模型利用,太紧会把可用的状态也封掉。
MOPO(Tianhe Yu 等人,NeurIPS 2020,arXiv:2005.13239)的思路是给奖励加惩罚:用集成分歧估计不确定性 ,把奖励改成 ,其中 是惩罚系数。这等价于在乐观的模型奖励上做一次保守修正。原文的分析指出, 需要与模型误差的量级匹配,否则要么保守不足、要么过度保守。
这两项工作与这一篇的主题关系很直接:它们都是复合误差的工程对策,只是作用点不同。MBPO 从「缩短想象长度」下手,MOReL 从「截断不可信状态」下手,MOPO 从「惩罚不可信动作」下手,PILCO 从「把不确定性传播进代价」下手。四种方法,同一个目标:让策略优化只发生在模型还能信的区域内。
这条前史如何塑造今天的世界模型
Dreamer 的想象时域就是 k
Dreamer 系列的想象训练,本质上是一个 很大的分支 rollout:从真实经验的后验状态出发,在潜空间里展开 15 到 50 步,用想象出来的奖励和继续信号训练策略与价值。它之所以能承受这么长的 ,是因为 RSSM 把预测搬到了低维潜空间,模型的 Lipschitz 常数和单步误差都比像素级模型小得多;同时 KL balancing 与离散潜变量让模型在长程上更稳定。但即便这样,Dreamer 的想象时域仍然是一个需要调的超参数,而不是越长越好——(二)里提到的「想象太久会漂移」就是这个原因。
WAM 与视频世界模型的复合误差
把预测搬到视频 token 上之后,复合误差的问题被放大了。一个视频世界模型每生成一帧,都要以之前生成的帧为条件;帧与帧之间的误差会通过注意力机制传播,而且传播的不只是状态,还有纹理、光照、物体身份这些高维属性。这就是为什么(四)里长上下文的成本那么高:为了压住漂移,模型必须不断回看更早的帧,而回看的代价是序列长度与 KV 缓存。
(五)讲的 WAM 则换了一个角度:它不追求长程开环生成,而是把动作和未来几帧一起生成,用动作作为条件来锚定物理。这相当于把复合误差的链条截短,让每一段生成都有一个新的条件输入。这个设计与 MBPO 的短分支在精神上是一致的:不是让模型一次想很远,而是让它反复从可信的锚点重新出发。
评测里的反事实测试从哪来
(六)讲的评测栈里,反事实响应测试要求模型对「换一个动作会发生什么」给出正确的差异。这个测试的设计动机,正是这一篇讲的模型利用:如果一个模型只在训练分布内准确,它对反事实动作的预测就会退化成「平均值」或「训练集里最相似的样本」,从而无法支撑规划。把反事实响应单独拿出来测,就是在测模型有没有在分布外保持因果结构,而不是只记住相关性。
一条边界:模型基 RL 不等于世界模型
这一篇讲的方法都属于模型基强化学习,但并不是所有模型基 RL 的模型都配叫世界模型。区别在于模型被要求预测什么。Dyna 的表格模型只预测「下一状态与奖励」,它不需要理解世界,只需要记住转移;PILCO 的 GP 预测连续状态,它的不确定性是结构性的;Dreamer 的 RSSM 预测潜状态、奖励与继续信号,它要求模型对未来的可用性负责;而今天的视频世界模型要求模型生成可观看、物理一致的未来帧,这个要求高得多。
这个区分对读论文很有用:看到「world model」这个词时,先问它预测的是什么、被用来做什么、误差如何传播。如果它只被用来做一步预测或价值估计,那它更接近 Dyna 的表格模型;如果它被用来做长程想象、规划或生成,那复合误差就是它的核心约束。
推理账本:想象的成本
每次决策的模型调用次数
把这一篇的方法放到推理系统里,第一笔账是「一次决策要调用多少次模型」。Dyna 的每次真实交互之后做 次想象,但这 次是在训练时发生的,推理时只做一次策略前向。PILCO 的推理更轻:策略是一个 RBF 线性模型,一次前向就出动作,代价函数与 GP 只在训练时用。MBPO 的推理同样轻:策略是 SAC 的网络,模型只在训练时生成数据。
真正把模型调用搬到推理时的是规划类方法:MPC、CEM、MPPI、MCTS。它们每次决策都要在模型里展开 条轨迹、每条 步,模型调用次数是 。这就是(八)里的搜索账本,也是(九)里把世界模型当作推理负载时的主要成本项。
一次规划的成本模型
把一次规划的算力写成式子,可以看清瓶颈在哪里。设模型单次前向的浮点运算量为 ,单次前向要读取的权重与激活为 字节,硬件的算力为 (FLOP/s),带宽为 (B/s),那么一次前向的时间下界是
一次决策的总时间约为 加上规划器的打分与选择开销。这个式子里有两个乘数: 和 。 由动作空间的维度决定, 由复合误差决定—— 越长,单步误差越大,规划出来的轨迹越不可信。所以复合误差不仅是一个统计问题,它直接给 设了上限,从而给推理延迟设了下限。
这也解释了为什么端侧世界模型必须走「短视野 + 高频重规划」的路线:与其一次想 100 步,不如每 10 步重新规划一次,用新的真实观测把误差清零。代价是控制频率要足够高,收益是每次规划只需要很短的 。这条路线在(七)的部署账本里被展开过,在(十)的能耗下界里也能看到同一个结构:能量下界与信息量成正比,而信息量随 增长。
为什么这条账本在 2026 年变得重要
1990 年的 Dyna 不需要考虑推理成本,因为表格查一次是常数时间。2011 年的 PILCO 也不需要,因为 GP 的推理成本虽高,但调用次数很少。今天不一样:世界模型被放进实时控制回路,每次决策的预算被压到毫秒级,而模型本身可能是几十亿参数的 Transformer。复合误差决定了「能想多远」,推理成本决定了「能想多快」,两者共同决定了「能想多少次」。这三个量构成了今天世界模型系统的实际边界。
小结
把这一篇的线索收拢,可以按「架构、误差、对策」三层重述。
架构层是 Dyna。它把真实经验、模型学习、想象更新放进同一个循环,并留下一条不对称规则:想象可以更新价值,但不能更新模型。这条规则的本质是防止模型在自己的输出上自我强化。Dyna 的实验说明,规划的价值来自把一次真实更新扩散到许多状态,而扩散的上限由模型的覆盖面决定。
误差层是复合误差。开环想象里,每一步的误差都会作为下一步的输入被放大,在 -Lipschitz 假设下上界是 。 时误差收敛, 时指数爆炸。这个结论与模型在训练集上的精度无关,只与误差是否被传播有关。模型利用是它的孪生问题:策略会主动寻找模型误差最大的区域,把错误当成奖励。
对策层有四条路。PILCO 把不确定性写进模型与代价,让规划主动避开不可信区域;MBPO 把想象长度截短并从真实状态分支,把指数增长换成线性增长;Plan2Explore 把不确定性变成探索奖励,主动补全模型的覆盖面;MOReL 与 MOPO 在离线场景里用吸收态或奖励惩罚做保守化。四条路的共同点是:不与复合误差正面抗争,而是承认它、度量它、把策略限制在它还能信的范围内。
对今天的世界模型来说,这三层仍然成立。Dreamer 的想象时域、视频世界模型的长上下文、WAM 的短段生成、评测里的反事实测试、部署里的高频重规划,都可以在这三层里找到位置。世界模型的能力上限由表征与数据决定,但它的可用性上限,往往由复合误差决定。
参考资料
- Integrated Architectures for Learning, Planning, and Reacting Based on Approximating Dynamic Programming(Sutton,Machine Learning 5,1990)
- PILCO: A Model-Based and Data-Efficient Approach to Policy Search(Deisenroth & Rasmussen,ICML 2011)
- World Models(Ha & Schmidhuber,NeurIPS 2018,arXiv:1803.10122)
- Model-Based Reinforcement Learning for Atari(SimPLe,Kaiser 等,arXiv:1903.00374)
- Learning Latent Dynamics for Planning from Pixels(PlaNet,Hafner 等,ICML 2019,arXiv:1811.04551)
- Dream to Control: Learning Behaviors by Latent Imagination(DreamerV1,ICLR 2020,arXiv:1912.01603)
- When to Trust Your Model: Model-Based Policy Optimization(MBPO,Janner 等,ICLR 2020,arXiv:1906.08253)
- Planning to Explore via Self-Supervised World Models(Plan2Explore,Sekar 等,ICML 2020,arXiv:2005.05960)
- MOReL: Model-Based Offline Reinforcement Learning(Kidambi 等,NeurIPS 2020,arXiv:2002.04580)
- MOPO: Model-based Offline Policy Optimization(Yu 等,NeurIPS 2020,arXiv:2005.13239)
- Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model(MuZero,Schrittwieser 等,Nature 588,2020,arXiv:1911.08265)
- TD-MPC2: Scalable, Robust World Models for Continuous Control(Hansen 等,ICLR 2024,arXiv:2310.16828)
图源说明:图 1(Dyna 架构)与图 3(Dyna-PI 学习曲线)分别取自 Sutton 1990 年论文的 Figure 1 与 Figure 3;图 2(模型误差随策略偏移与数据量变化)与图 4(450 步 rollout 的误差锥)分别取自 MBPO 论文的 Figure 1 与 Figure 4。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



