


世界模型从零讲起(八):潜空间规划——MuZero、TD-MPC2 与搜索如何把预测变成动作
前七篇把世界模型从头到尾走了一遍:它预测什么、怎么训练、Dreamer 如何在潜空间里想象、JEPA 如何只预测表征、视频生成模型如何把画面变成可交互的世界、WAM 如何把动作和世界一起生成、怎么评测、怎么上线。这条链路里始终悬着一个问题没有正面回答:模型预测得再准,动作到底是怎么从预测里选出来的?
Dreamer 的答案是「不选」——它把策略训练进网络,推理时一次前向直接输出动作。WAM 的答案也是「生成」——动作和未来帧一起被去噪出来。这两条路线都绕开了显式的搜索。但在另一条谱系里,世界模型的存在意义恰恰是在决策时刻被反复调用:同一个模型向前展开几十条可能的轨迹,比较它们的结果,再决定下一步做什么。这条谱系从 Dyna 的想象 rollout,到 MuZero 的蒙特卡洛树搜索,再到 TD-MPC2 的潜空间轨迹优化,构成模型基规划(model-based planning)的完整技术栈。
这一篇就讲这条谱系。重点不是强化学习怎么训练,而是推理时那笔搜索账:搜多少、搜多深、在什么空间里搜、每一步要花多少前向、什么时候搜索比直接生成更划算。
三种「用模型」的方式:为什么还需要规划
要理解规划为什么值得付出额外的计算,先把「世界模型在推理时被怎么用」分成三类。
第一类是当训练场用。 Dreamer 属于这一类:世界模型只在训练阶段被大量调用,用来在潜空间里做想象 rollout,训练出一个策略网络;部署时只跑策略网络,世界模型根本不在推理路径里。这一类的推理成本是「策略网络的一次前向」,世界模型的成本被摊进了训练。这部分在世界模型从零讲起(二)里已经拆过。
第二类是把策略训练成世界模型的一部分。 WAM 属于这一类:动作和未来表征在同一个生成过程里被联合去噪出来,推理时跑的是生成器本身,动作是生成的副产物。这一类的推理成本是「生成器的 N 次去噪前向」,搜索不存在,但生成过程本身可能就要几十步。这部分在(五)里拆过。
第三类是在决策时刻直接搜索。 同一个世界模型被反复调用:给定当前状态,向前展开一组候选动作序列,用世界模型预测每条序列未来几步的状态与回报,再挑最好的一条执行第一步。这一类没有独立的策略网络,也没有预训练好的动作生成器,动作来自「展开—打分—选择」的循环。
第三类为什么还有存在的必要?有两个理由,一个是原理上的,一个是工程上的。
原理上的理由是:规划对模型的准确度要求,和策略对网络的泛化能力要求,是两种不同的东西。 一个策略网络要学会的是「任意状态下该做什么」,这是一个定义在整个状态空间上的映射,需要覆盖足够多的状态才能泛化。而规划只需要模型在当前这一条轨迹附近足够准。世界模型可以在远离训练分布的地方错得离谱,但只要它沿着即将执行的那条轨迹预测可靠,规划就能工作。MuZero 能在围棋上超越人类,靠的不是一个记住了所有局面的价值网络,而是一个能在搜索树里被反复调用的模型。
工程上的理由是:规划的计算量是可调的,而且是逐请求可调的。 策略网络的推理成本是固定的(一次前向),而搜索可以按需要搜 16 次、64 次、800 次。简单决策少搜,关键决策多搜;服务器空闲时多搜,负载高时少搜。这种「思考时间可伸缩」的性质,在推理系统里等价于一个可以按负载调节的计算预算——这和 LLM 推理里用测试时计算换质量是同一种逻辑。
代价也很明确:搜索把一次前向变成成百上千次前向。 MuZero 做一局围棋,搜索树的每次扩展都要调用一次预测网络;TD-MPC2 每个控制步要把 512 条候选序列各展开 3 步,一轮规划就是 1500 多次隐空间推演。后面所有关于「推理账本」的讨论,本质上都是在算这笔额外开销划不划算。
世界状态的三种形态:规划在什么空间里展开
在展开任何一种搜索之前,必须先回答:搜索的节点是什么? 这个问题在不同技术里的答案差别很大,而它直接决定了单次前向的成本和搜索的粒度。三种主流形态:
显式状态:表格、连续向量与物理仿真
最古老的形态是显式状态。Dyna 架构(Sutton,1990)里,世界模型就是一张记录「状态—动作—下一状态—奖励」的转移表;现代版本里可能是已知的刚体物理仿真器(模型预测控制里的 MPC),也可能是学习到的连续状态转移函数 。规划直接在状态本身的空间里进行,每个节点是一个完整的、物理意义明确的状态。
这种形态的好处是预测的结果可以直接解释,约束也能直接施加(关节限位、碰撞检测都可以在状态空间里检查)。坏处是维度:如果一个状态是一帧图像或者一个高维传感器读数,在原始空间里展开轨迹几乎不可行;而如果是学习得到的转移函数,长程复合误差会在多次展开后迅速累积。
隐式潜状态:一个向量包住所有需要的东西
为了解决显式状态的高维问题,第二条路线把状态压缩成一个低维隐向量 。世界模型变成两部分:编码器把观测压成 ,动力学模型 在隐空间里推演,而规划完全在 空间里做。
这就是 MuZero 和 TD-MPC2 的路线。MuZero 的表示函数 把一段观测序列映射成根节点的隐状态,动力学函数 把隐状态和动作映射成下一隐状态,预测函数 从隐状态读出策略先验和值。TD-MPC2 的编码器把观测映射成隐状态,隐空间动力学在同一个向量上推演,同时有一个奖励头和一个值头。
隐式潜状态的代价是可解释性和约束能力的丧失。规划跑完以后,你拿到的是「这条隐轨迹的值最高」,但这条隐轨迹对应什么物理状态,模型并没有承诺告诉你。TD-MPC2 的卖点之一恰恰是它是无解码器的(decoder-free):它不重建观测,只预测奖励和值。对连续控制任务来说这是取舍——省掉了重建的算力,但也就没有了一条从隐空间回到物理空间的、可以检查的通道。
表征空间:JEPA 式的嵌入
第三条路线在(三)里已经拆过。JEPA 不在像素上预测,也不强行压成很小的隐向量,而是预测一个编码器输出的目标表征。它和隐式潜状态的区别在于:隐向量的维度往往很小、是为了动力学建模专门学的;JEPA 的表征维度更大、是为了「可预测」而不是「可控制」学的。把它当规划空间用,就出现了 V-JEPA 2 那种在表征空间里用能量最小化加交叉熵方法做规划的设计。
三种形态并不是互斥的。同一个系统可以既有隐式潜状态(用于快速推演),又有从隐状态到观测的解码器(用于可视化或安全检查)——DINO-WM 这类模型就是先用冻结的 DINOv3 编码出视觉 token,再在 token 空间里学动力学,规划完还能把轨迹映射回图像看一眼;而 TD-MPC2 明确选择了不提供这条通道。
局部轨迹优化:CEM 与 MPPI
最轻量、也是用得最广的规划方式是局部轨迹优化(local trajectory optimization),或者叫打靶法(shooting)。它的思路极其直接:
- 采样一组候选动作序列,每个序列覆盖未来 步;
- 用世界模型把每个序列展开成未来 步的隐状态和奖励;
- 给每个序列算一个总回报(或总代价);
- 根据回报重新分布采样,向好的方向靠近;
- 重复数轮,输出最优序列的前若干步并执行。
形式化
记当前状态为 ,动作序列为 。在隐空间里展开:
一条候选序列的回报是折扣后的奖励之和:
规划的目标是
注意这里没有任何策略网络参与,唯一的模型是 和 。展开一条 步的序列需要 次动力学调用, 条候选就要 次。这就是搜索账的分子。
交叉熵方法(CEM)
对动作序列通常不可导(或者可导但梯度不靠谱,因为世界模型本身可能很尖锐)。所以用无梯度的优化:交叉熵方法(Cross-Entropy Method, CEM)把候选序列的参数化成高斯分布
每一轮采样 条候选,按 排序,取前 条最优(elite),用它们的位置和方差重新估计 和 :
前几轮方差要留足以保持探索,后面逐步收缩。整个过程不需要任何梯度,只需要在世界模型上做前向。
MPPI:权重形式的重采样
CEM 用「取前 K 名的经验分布」更新,而 MPPI(Model Predictive Path Integral,Williams 等,2017)用的是指数加权的软更新。每条候选序列的权重是
其中 控制权重分布的尖度: 越小,越接近「只保留最优」, 越大越接近平均。新的均值对每条候选序列做加权平均:
MPPI 的好处是所有候选都参与了更新,不只看前 条,权重是连续的,采样稳定性更好,也不需要挑 elite 的数量。代价是多一个超参 。
为什么每轮都要动方差
从直觉上看,CEM/MPPI 的收敛速度取决于两件事:方差收缩的速度(太快就早收敛到局部,太慢就浪费轮数)和候选数量(样本量越大,最优估计越可靠)。这是典型的采样效率问题:每一轮的计算开销是 次模型前向,轮数是 ,所以一次规划的前向总数是
这个数在 TD-MPC2 里有明确答案。论文的 Table 8 给出了一套跨全部 104 个任务不变的计划超参:规划视野 ,迭代次数 6(动作维度不小于 20 时再加 2),每轮候选 512 条,其中 64 条精英、24 条来自策略先验,温度 0.5,隐状态维度 512。按这套配置,单个控制步的隐空间展开次数是
也就是一次控制决策要做九千多次「512 维向量上的小 MLP 前向」。单看数字很吓人,但这些前向全部是批处理的:一次矩阵乘就把 512 条候选 × 3 步的状态一起算完,GPU 上是一个很小的 kernel。加上论文的 warm-start 技巧——把上一控制步求出的均值、方差平移一步作为本步的初始分布——实际迭代次数往往可以少一些。
这里有一个容易被忽略的细节:TD-MPC2 的「512 条候选」里只有 24 条来自策略先验 ,其余从高斯分布采样。先验样本的作用不是直接选动作,而是给 MPPI 的加权平均提供一个靠近好解的锚点,加快收敛。这个设计和后面 MuZero 用 做 PUCT 的先验项是同一个思想:搜索不是从零开始,而是从模型已经学到的「哪里可能有解」开始。
展开误差为什么会复合
打靶法的精度上限是世界模型在视野 上的复合精度,不是单步精度。假设单步动力学有确定性误差 ,即 (误差不随状态消失,也不被吸收),那么展开 步后的状态误差最坏是 ,最好情况是零(误差恰好相互抵消)。如果误差是乘性的,即每步之后状态被放大 倍并叠加一个误差,那么误差按几何级数增长,量级是 。这解释了为什么隐空间动力学要尽量学得平滑:平滑的动力学至少让误差不放大,而尖锐的、对输入极敏感的动力学会让误差在几步内就发散。
对规划来说,这带来一个直接的判据:视野 不能超过模型的误差发散点。 如果模型的预测在第 步之后变得不可信,那打靶的视野就应该设在 以内,剩下的部分交给值函数估计。这是 TD-MPC 用短视野的第二个理由(第一个理由是无解码器的成本)。
一个工程事实:无解码器是 MPPI 能跑在实时里的前提
TD-MPC(Hansen 等,2022)和 TD-MPC2(Hansen 等,2024)都坚持隐空间动力学不解码观测。这不是为了省事,而是因为解码器会把每一次展开的前向成本放大一个数量级:如果每次展开都要重建一张图像,那 次重建在控制回路里根本跑不动。无解码器的隐空间推演让每次前向只是几层带残差的小 MLP,这才是局部轨迹优化能在真实控制回路里跑起来的前提。
MuZero:在搜索树里学一个规划用的模型
局部轨迹优化只搜索一个时间跨度很短的候选集。如果问题是围棋、棋类或者需要长程因果的决策,就必须在更大、更深的搜索空间里展开——这正是蒙特卡洛树搜索(MCTS)擅长的事。问题在于:传统 MCTS 要求一个完美的仿真器,AlphaZero 用真实的棋类规则做仿真;而 MuZero 要在没有仿真器、只能学习模型的条件下做同样的事。
三个函数
MuZero(Schrittwieser 等,2019)用一个学习到的模型(learned model)驱动 MCTS。模型由三部分组成:
- 表示函数 :把一段观测变成隐状态;
- 动力学函数 :给定隐状态和动作,预测奖励和下一隐状态;
- 预测函数 :从隐状态读出动作先验概率 和值 。
注意这三个函数的输出都是和规划直接相关的量:奖励、策略、值。没有任何一步重建观测。这是 MuZero 最核心的设计决定,也是它区别于「先学一个重建世界的模型,再在上面规划」的关键。
搜索树的一个节点
MCTS 树里的每个节点对应一个隐状态 ,携带:
- 先验概率 (由 给出);
- 访问次数 ;
- 累计值 (子树里的值估计);
- 从父节点到达该节点的奖励 。
从根节点出发,每一步选择动作的依据是 PUCT(Predictor + UCT)分数:
这里 是从这个节点出发、按当前搜索统计估计出来的动作值, 是该动作被选中的次数, 是父节点所有动作的访问总数, 是预测函数给出的先验概率。三项的分工是: 负责利用已搜到的信息, 负责把先验知识带进搜索, 与 的比值负责探索。没访问过的动作因为 小、分母接近 1、分子带着父节点访问量的平方根,所以分数会被抬高;访问多了以后分子分母抵消,分数回落到 本身。系数 控制先验与探索的权重,规模越大,搜索越依赖模型给出的先验而不是实际展开的结果。
在 MuZero 的实现里, 不是简单的均值。一次模拟回传时,沿途每一步的奖励被累加,末端的值作为剩余回报,整条路径的估计值是
其中 是本次模拟从该节点到叶子的步数, 是叶子节点由预测函数读出的值。这个 随后按访问计数增量平均,更新到路径上每个节点的 。奖励的折扣 在棋类里通常取 1(因为回合制、没有时间折扣的必要),在 Atari 里取常见的 0.99 量级。
AlphaZero 与 MuZero 的分界
理解 MuZero 的最好参照是 AlphaZero。AlphaZero 的搜索树节点是真实棋盘局面,展开靠棋类规则,终局靠规则判定胜负;它的网络只提供先验和值,搜索本身不需要「模型」。MuZero 把节点换成隐状态,展开靠 ,值靠 ,真实规则完全不在回路里。
这个替换带来两个连锁反应。第一,搜索的正确性从「由规则保证」变成「由模型保证」:AlphaZero 的叶子值只可能因为网络估计不准而错,MuZero 的叶子值还可能因为模型推演本身偏了而错。第二,模型可以跨域复用:同一套 结构可以用在围棋、国际象棋、将棋和 57 个 Atari 游戏上,因为模型学的不是某个游戏的规则,而是「在这个游戏里,什么量对规划有用」。MuZero 论文的标题里强调「without any knowledge of their underlying dynamics」,指的就是这一点。
一次模拟(simulation)
一次 MCTS 模拟分四个阶段:
- 选择(select):从根节点沿 PUCT 分数一路下降到「还没展开」的节点或其子节点,沿途记录路径;
- 扩展(expand):用动力学函数 得到奖励和新的隐状态,用预测函数 得到新节点的先验和值;
- 回传(backup):沿路径把新节点的值、和沿途累积的奖励,按 计数平均回传到每个父节点;
- 重复:再来一次模拟,直到访问预算用完。
展开一次要调用一次 和一次 (根节点上的 和 只需要一次),所以搜索成本 ≈ 模拟次数 两次网络前向。MuZero 论文在围棋、国际象棋与将棋上每步跑 800 次模拟(论文报告这等价于约 0.1 秒一次搜索),而 Atari 因为动作空间小得多,每步 50 次模拟就够用。按每步 800 次模拟算,就是每步约 1600 次「动力学 + 预测」的小网络前向。
训练目标:为什么是奖励、策略、值
MuZero 的模型不是通过重建观测学出来的,而是通过一个「展开 K 步后的预测要对」的目标学出来的。对当前状态展开 K 步,每一步都有:
- 与真实环境的即时奖励对齐的 目标;
- 与真实环境的策略搜到的最佳动作对齐的 目标;
- 与真实环境执行后 n 步的回报对齐的 目标。
这一点的意义在于:模型的每一个输出都是规划会用到的量,没有一个是规划用不到的。 反过来说,如果模型重建图像、重建像素,那重建的算力只服务于一个人眼观看的目的,对搜索毫无用处。MuZero 用这个取舍把模型压缩到刚好够规划用。
更精确地说,训练时的目标是沿展开轨迹用 n 步之后的真实回报来定义值的:
其中 是模型在路径上预测的奖励(或环境的真实奖励,取决于展开段落在真实环境里还是在模型里), 是环境的真实值目标, 是论文选择的未来步数。策略目标使用搜索得到的根部访问分布,奖励目标使用真实环境的即时奖励。三个目标分别在展开的 K 步上都有监督,所以模型的误差在训练时就被拉到了「K 步之后也对」的尺度上,而不是「一步之内对」。
EfficientZero 与后续
MuZero 的原始版本样本效率很低,因为每次决策都要与真实环境交互,而学习的模型又不够精确。EfficientZero(Ye 等,2021)在同样架构上加了几处针对「有限数据」的改造:自监督的一致性损失(把隐状态和未来时刻的隐状态之间的预测误差作为额外监督)、价值前缀损失(用多个时间尺度的回报做监督)、以及用树模型做目标搜索(把 MCTS 的搜索结果作为策略目标)。它的结果是在 Atari 100k 这个「只用 10 万步交互」的基准上达到超人水平(论文报告均值 194.3% 人类表现,中位数 109.0%)。
后续的 Sampled MuZero、MuZero Unplugged(离线数据)、Gumbel MuZero(用 Gumbel 噪声做更小的搜索)、以及 Dreamer 4 在 Minecraft 上做的树搜索,都是「搜索 + 学习模型」这条线上的分支。
TD-MPC2:把 MCTS 换成短视野的潜空间打靶
MuZero 的问题是在隐空间里做 MCTS 仍然很贵,尤其是动作空间是连续时的(PUCT 分数需要对连续动作先做离散化,或者采样一组候选动作)。TD-MPC2 的答案是:换成 CEM/MPPI 式的打靶,但把值函数加进来,弥补短视野的短板。
两个关键设计
TD-MPC(Hansen 等,2022)的核心思想可以用一句话概括:在世界模型上做短视野的局部规划,用学到的终端值函数估计长程回报。展开的只有 步(TD-MPC2 的默认值是 3),回报是
第一项是展开视野里的即时奖励之和,第二项是到达 之后的价值估计乘以折扣。第二个项就是整个方法的灵魂:短视野规划不用担心「看不到后面」,因为价值头替你看了后面。价值头本身就是用 TD 学习(通过 Bellman 备份)在很长的时间尺度上训练出来的。
这带来一个有趣的对称性:规划和学习是在同一个方向上分工的。 规划负责局部的、精确的、只看眼前 步的部分;学习负责长程的、粗糙的、只看最终回报的部分。如果只用规划(没有值函数),短视野会被「看不到后面」困住;如果只用学习(没有规划),策略网络很难在关键决策点上做精确的局部调整。TD-MPC 把两者拼在一起,并用同一个隐空间动力学把它们的误差对齐。
TD-MPC2(Hansen 等,2024)是这个思路的规模化:104 个在线 RL 任务、4 个不同领域、一套超参;以及一个 317M 参数的智能体在多个领域、多种具身、多种动作空间上同时学会 80 个任务。
隐空间里的每一步
TD-MPC2 在控制回路中的每一步:
- 编码:把当前观测编码成 ;
- 采样:从对角高斯分布里采 512 条动作序列;其中 24 条的起点来自学习到的策略先验 ,其余从高斯采样;
- 展开:用隐空间动力学把每条序列推演 步,每步在终点读出值 + 奖励,用值头给 估剩余回报;
- 更新:MPPI 式加权平均更新均值与方差(精英 64 条,温度 0.5);
- 迭代:重复 6 轮(动作维度不小于 20 时为 8 轮),每轮都从上一轮的结果 warm-start;
- 执行:从最终分布里采样一个动作,执行第一步。
整个一步的计算量是约 9 千次隐状态展开,但合并成批以后只有约 6 次「512×3 步」的批量推演,每次推演是几层 512 维 MLP——这是它能跑在控制频率里的原因。warm-start 是另一个关键工程技巧:上一控制步的 、 平移一步作为本步的初始分布,让本步的迭代从「已经很接近的解」开始,而不是从零开始。
为什么值函数能让短视野成立
在 CEM/MPPI 里加值函数,本质上是把「打靶目标」从原始的累计奖励换成「累计奖励 + 剩余价值」。如果把 推到足够长,第二项趋近于零,打靶就退化为原始的 CEM;如果 很短,第二项就承担了大部分估计。TD-MPC 的贡献就是把「用值函数补短视野」做成了一个可以在隐空间里闭环学习的结构。
一个直接的推论:值函数越准, 可以越短,搜索成本越低。 这也是为什么 TD-MPC2 强调「用同一套隐空间同时学动力学、奖励和值」——三者共享一个表示,才能保证「动力学展开的终点 」和「值头读值的起点」在同一个坐标系里。
Dreamer 为什么不搜:想象训练的闭环
把搜索放在这三条路线的对照里看,会浮现一个反直觉的事实:Dreamer 的训练本身就是「展开」,但它的推理不搜索。 它的想象 rollout 本质上就是一遍又一遍地在潜空间里「展开 步、读奖励、算回报」,只不过展开的目的是更新策略和值,而不是在决策时刻选动作。
这个结构可以理解成一个把搜索摊销进训练的极端:如果策略网络在训练中已经对「在各种想象出来的未来中该做什么」形成了条件反射,推理时就不必重复搜索。Dreamer 的推理成本因此几乎为零(一次前向),代价是策略网络的容量必须足够大、训练数据必须足够多,因为它要内化的正是「展开 + 打分」的全部信息。
从这个角度看,Dreamer、TD-MPC2 和 MuZero 其实在同一个天平的两端之间滑动:搜索的越少,网络需要学的就越多;网络学的越多,每次决策需要的搜索就越少。 TD-MPC2 在中间:它没有学一个纯策略,而是学了「值 + 短视野动力学」,搜索一个很短的展开;MuZero 更偏向搜索一侧,模型只学规划必须的少量量;Dreamer 最偏向学习一侧,网络承担了全部决策。
这条天平的解释力也延伸到 2026 年:ResWAM 把搜索里「世界会怎么变」的知识内化进生成器,本质上是在往「网络多学一点」的方向移动;LG-DKGP 在搜索侧加先验,本质上是在往「搜索少搜一点无用候选」的方向移动。两个方向的目标相同:缩短推理时真正需要展开的步数。
推理账本:搜索的成本从哪里来,用在哪里
把以上几种方式放在一起,可以做一个统一的成本分解。一次规划的推理成本可以写成三个因子的乘积:
三个因子在不同方法里的取值差别极大:
- MuZero: 是模拟次数(数百到数千), 是树深(由搜索自然决定,但每次模拟要走的深度与树深相关), 是「动力学 + 预测」两个小网络的前向;
- TD-MPC2: 是候选数 × 迭代轮数, 是短视野(个位数), 是「一个小 MLP 的前向 × 每步」;
- CEM 打靶: 是候选 × 轮数, 是中长视野, 同 TD-MPC2;
- Dreamer:(无搜索),, 是策略网络前向——也就是搜索成本为零。
这个分解解释了一个现象:为什么越靠「搜索」的方法,越倾向于在隐空间里做、越倾向于用小模型。 因为 和 的乘积在搜索里是几百到几千,任何 的放大都会被这个乘积成倍放大。MuZero 宁可让模型只预测奖励/策略/值,也不重建观测;TD-MPC2 宁可放弃解码器,也坚持隐空间动力学——本质上都是为了把 压到最小。
什么时候搜索划算,什么时候不划算
搜索的收益不是无条件的。粗略地看,搜索值得做需要满足两个条件:
一是模型对当前决策点的局部精度足够高。 搜索对模型误差非常敏感,因为误差会在展开中被复合:每一步的预测误差 会以某种方式叠加到后续状态上。如果模型的步骤误差是 、视野是 ,粗估的累计误差大致在 的量级(具体取决于误差是系统性还是随机性)。这就是为什么搜索方法几乎都在隐空间里使用「短视野 + 值函数补长程」的结构。
二是决策点的重要性足够高。 如果每个决策点的动作都对最终结果影响很小,那么把计算花在搜索上不如把计算花在更多决策点上。棋类是最典型的反例:每一步都可能决定整个局面的走向,所以每步 800 次模拟是值得的。而在连续控制里,TD-MPC2 把搜索压到短视野、小候选,恰恰说明大多数控制步不需要深搜索。
与 LLM 推理的类比
这笔搜索账在数值上和 LLM 推理的「测试时计算」高度同构。一个 LLM 在生成每个 token 时都要做一次前向,推理系统通过批处理、KV 缓存、投机解码等手段压前向成本;而在「思考模型」里,一个 token 可以被展开成几百上千个推理 token,本质上是在更长的序列上增加前向次数来换质量。
世界模型规划里的「搜索」是同一件事换了一个坐标系:把前向次数从「一个 token 一次」变成了「一个决策点 次」,并且用一组小模型(隐空间动力学)替代一个大模型。两者共享同一个经济学结论:在推理系统里,最重要的优化永远是降低每次前向的成本,以及在可能的时候把前向次数从关键路径上挪走。
另一个对应的类比是调度:MuZero 的模拟次数、TD-MPC2 的候选数、CEM 的迭代轮数,都是可以在推理时按条件调节的参数。这和 LLM 推理里投机解码的草稿长度、批处理大小的动态选择是同一种工程自由度——搜索预算是一个可以在线调节的旋钮,而不是一个写死的常数。
规划与生成的合流:2026 年的三条改进线
上面对比的两种结构——「训练时就把搜索摊销掉」和「推理时真的展开」——在 2026 年的新工作里不是二选一,而是彼此穿插。三条有代表性的工作分别从监督目标、潜动作的语义、搜索先验三个方向,回答了同一个问题:怎么让模型以更便宜的方式内化「未来会怎么变」,从而缩短推理时真正需要展开的步数。
三条线之前先补一个背景:WAM(world-action model)把动作与未来表征放在同一个生成过程里,是「第二类用模型方式」的代表;而它最常被批评的是辅助监督太贵,且学到的未来表征未必和动作有关。下面的工作都在修这两点。
在 ResWAM(2026-11)里,作者换了一个角度来解决「世界模型的辅助监督对决策无用」的问题。他们指出:在 LIBERO 上,当前帧和未来帧的视觉特征平均余弦相似度是 0.96,这意味着监督「预测整个未来帧特征」在很大程度上是在复制静态背景,而不是在学习动作如何改变物体。他们的做法是把监督目标从未来帧的全部特征改成「未来帧特征减当前帧特征」的残差:
每个 patch 只预测它自己会变多少。他们的分析表明:这个残差的有效秩比未来帧的特征更高(它包含了更多样的变化方向),并且从空间上看,残差的范数集中在机械臂和被操作物体上,而不是静态背景上。
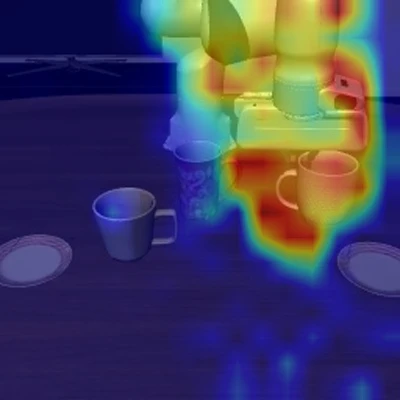
上图来自 ResWAM 论文 Figure 3 区域(LIBERO 场景),右侧是残差范数在空间上的分布:热区集中在机械臂和它正在接触的物体附近,静态背景几乎为零。这正是「只学什么变了、不学什么没变」这句话在像素上的可视化。
在架构上,ResWAM 用一个 2B 的 VLM 主干编码当前观测和语言指令,冻结的 DINOv3 提供当前视觉 token,一个 0.5B 的双分支 DiT 同时去噪动作 chunk 和视觉残差。两个分支共享注意力,所以残差分支学到的「世界怎么变」可以直接影响动作分支的表示。
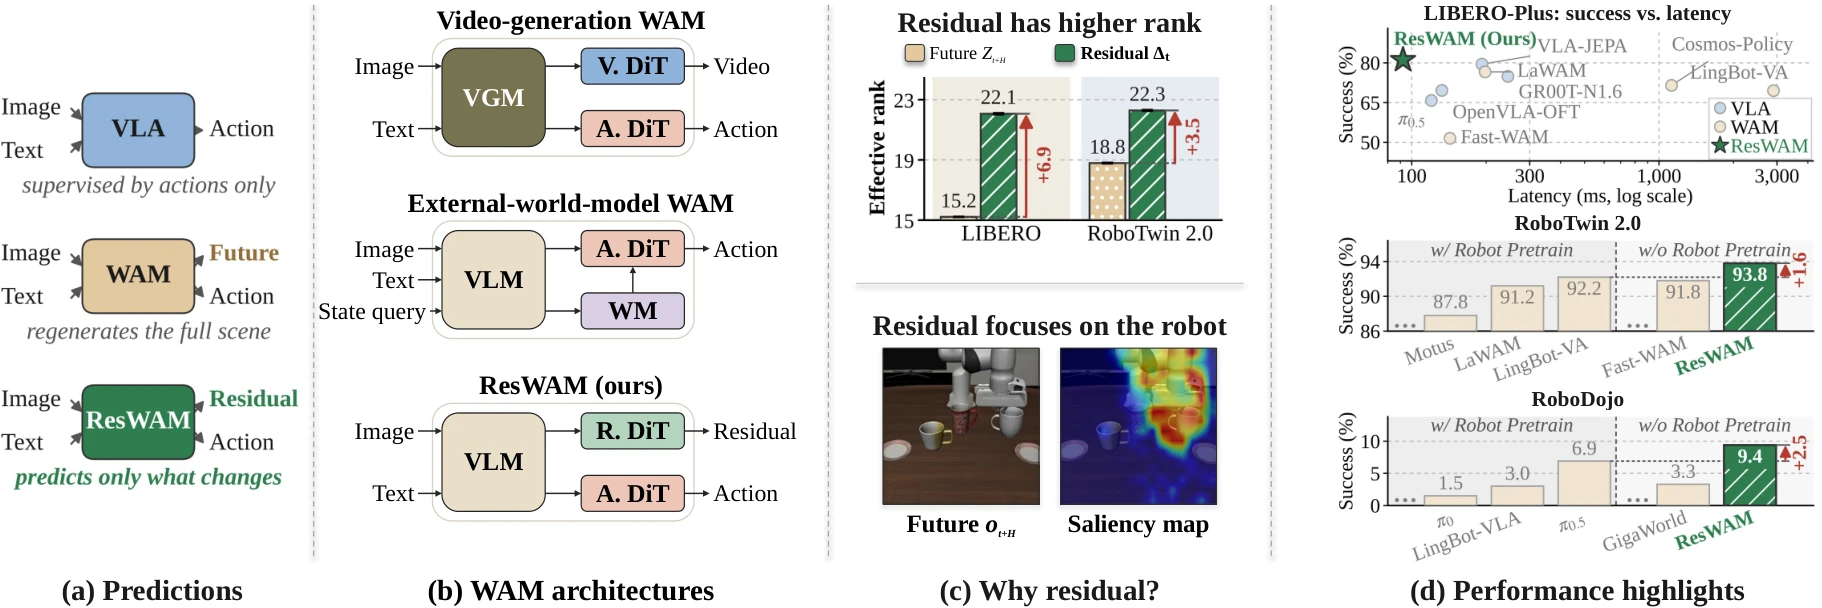
上图来自 ResWAM 论文 Figure 1。左侧对比了四种范式:VLA(只有动作监督)、视频生成式 WAM(用视频扩散重建完整未来)、外部世界模型 WAM(在动作生成前查询一个独立世界模型)、残差式 WAM(只预测残差,与动作一起去噪)。右下角的散点图把不同方法的成功率与每 chunk 推理延迟放在同一张图上对比:残差方式的点在低延迟区间内占了更高的成功率。
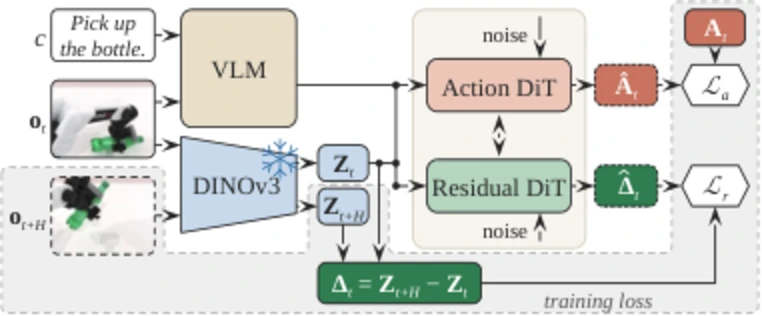
上图来自 ResWAM 论文 Figure 4。VLM 主干编码当前图像与指令;动作分支与残差分支各自从噪声开始,通过联合注意力交换信息,并分别 cross-attend 到 VLM 输出和冻结 DINOv3 的当前 token。残差分支的监督目标是 与 两帧 DINOv3 token 的差。推理时两条分支共享 10 次 Euler 积分步,不做像素空间解码。
论文报告的结果里,最值得看的是成本口径:ResWAM 的总参数量约 2.3B(VLM 2B + 双分支 0.5B),每个 chunk 的推理计算在 1.0–1.4 TFLOPs 量级,在单张 RTX A6000 上的每 chunk 延迟在 92–100 ms 量级;在真实机器人三个任务上平均成功率 80.0%,比 高 10 个百分点。这些数字来自论文的表格与附录(效率口径见其附录 D),我引用它们是为了说明「代价结构」而不是为了做性能排榜:一个不用视频生成器、不跑独立世界模型、不做像素解码的 WAM,可以在保持动作生成质量的同时把成本压到推理实时区间。
ResWAM 回答的是第二类用模型方式里的一个问题:当世界模型的辅助监督不再重建整个未来,而是只监督「变化」时,动作生成可以更轻。它和「搜索」的关系在于:它没有搜索,动作是生成的,但它的残差监督是为了让生成出来的动作更接近搜索会选出来的动作——把「世界怎么变」的信息以更便宜的方式喂回了生成器。这是 2026 年世界模型生态里一个很典型的走向:搜索和生成不是对立的,生成器越能内化关于未来变化的知识,需要显式搜索的场景就越少。
潜动作与「动作是否真的被编码」
LASR(2026-11)提出了一个尖锐的问题:在无动作标注的视频上学出来的潜动作(latent action),如果它只是让未来预测变准了,它可能编码的是「当前状态」「episode 进度」或者「任务身份」,而不是动作本身。现有的评估(重建损失、rollout 保真度、动作恢复、下游表现)都无法把「动作信息」单独隔离出来。作者提出 LASR 作为一个专门衡量「潜动作是否真正以动作接地」的指标。
这对规划路线的意义是直接的:规划假设隐状态里编码了「执行这个动作会发生什么」,这是一个比「预测得准」更强的假设。 一个重建得很准的模型,可能完全没有编码「如果我推这个箱子会怎样」。这也是为什么 MuZero 只学奖励/策略/值——它不试图让模型看起来对,只要求它在规划需要的量上对。
评测的新问题
FlipTest(2026-11)用一组「视觉最小对」来测视频世界模型:两张几乎一样的初始帧,真实未来却完全不同(比如箱子在桌沿前几毫米还是后几毫米)。如果模型真的跟踪了世界状态,它的预测也应该翻转。他们构建了一个三层严格度的测试集,覆盖 10 个仿真任务和 15 个真实任务。结论是当前的视频世界模型大多在基础层就失败。
这件事在(六)里已经有系统的讨论,这里提它的目的是把评测和规划连起来:规划的价值完全建立在「展开的结果可信」之上。 一个预测画面很美、但箱子的状态翻转时预测不跟着翻转的模型,在规划里会选错动作。反过来,一个不重建画面、只在少数规划相关的量上准确的模型(MuZero 那种),反而可能被规划用得更可靠。
LG-DKGP(2026-11)从另一个角度补搜索效率:专家演示里的动作有很强的时间连续性,而在世界模型规划里,候选动作序列往往被当成独立样本采样。作者设计了一个局部门控的深度核高斯过程先验,利用最近执行动作的历史来预测后续动作的合理延续,并用一个训练得到的探索尺度初始化搜索。本质上,这是把「人类动作的连续性」先验注入到 CEM 式搜索里,以减少无效候选。
把三个因子放进真实系统的放置问题
如果搜索方法的推理成本能写成 ,那么「在哪个设备上做搜索」就变成一个很自然的工程问题。这里有一个可能被忽视的维度:在具身场景里,动力学模型和值模型不一定住在同一个地方。这在(七)里关于算力放置的讨论里已经出现过,把它和规划成本结合起来看:
- 如果模型很小(TD-MPC2 的隐空间动力学是几层 MLP),搜索可以放在边缘设备上,每次前向是微秒级的;
- 如果模型是视频生成器或大 VLM(像 ResWAM 的 2B 主干),搜索会变得很贵,这时候要么把搜索压短(少候选、短视野),要么改成「大模型出先验、小模型做搜索」两层结构;
- 如果模型在云端而控制回路在本地,那么每一次展开的往返网络开销都会乘以 ,网络延迟会直接吃掉搜索的全部预算。
这和 PhysisServe 那类服务系统里「把重计算放进流水线、把轻计算放在控制回路」的设计是同一个逻辑,只是在规划这件事上,被拆分的不再是「prefill 和 decode」而是「展开和打分」。
小结
把这一篇的内容收束成几句话:
- 世界模型在推理时有三种用法:训练场(Dreamer)、内化进生成器(WAM)、决策时搜索(MuZero / TD-MPC)。三者不是替代关系,而是对「模型用在关键路径上的哪个位置」的三种不同答案。
- 规划的空间有三种形态:显式状态(可解释但高维)、隐式潜状态(高效但不可解释)、表征空间(JEPA)。三种形态决定了单次前向的成本和搜索的粒度。
- 局部轨迹优化(CEM / MPPI)是最轻量的搜索:采样、展开、按回报重采样,只需世界模型的前向,不需要梯度。
- MuZero 把搜索搬到 MCTS 里,并只让模型预测规划需要的量(奖励、策略、值)。这是「模型为规划而建」的极端例证。
- TD-MPC2 把长视野拆成「短视野展开 + 价值头补长程」,用同一个隐空间把规划和学习的误差对齐。
- 所有搜索的成本都能写成 。越靠搜索的方法越倾向于在隐空间里用小模型,是这三种因子共同作用的必然结果。
- 2026 年的新工作里,ResWAM 的残差监督、LASR 的动作接地、LG-DKGP 的动作连续性先验,都在回答同一个问题:如何让模型以更便宜的方式内化「未来会怎么变」,从而减少需要在推理时真正展开的步数。
这个系列写到第八篇,世界模型的「定义—构建—使用—评测—部署」链路已经合上,但规划这一环也暴露出这条路线最根本的成本结构:世界模型的价值不在于它预测得多像,而在于它在决策点上给出的那几次前向是否可信、是否划算。 一个模型只要能在被搜索调用的那几十次前向里保持可靠,就足以支撑一个智能体的决策;一个模型即使能生成以假乱真的几分钟视频,如果它在反事实点上不翻转,就撑不住一次搜索。
这也是后续更深入工作的入口:模型压缩、搜索加速、以及如何把搜索预算变成推理系统里一个可以调度的资源。这些属于推理系统的问题,和 LLM 推理里的调度、批处理、缓存问题在一个层面上。
参考资料
- Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model(MuZero,arXiv:1911.08265,2019-11)
- Mastering Atari Games with Limited Data(EfficientZero,arXiv:2111.00210,2021-10)
- Temporal Difference Learning for Model Predictive Control(TD-MPC,arXiv:2203.04955,2022-03)
- TD-MPC2: Scalable, Robust World Models for Continuous Control(arXiv:2310.16828,2023-10)
- Training Agents Inside of Scalable World Models(Dreamer 4,arXiv:2509.24527,2025-09)
- ResWAM: Learning What Changes, Not What Stays, for World-Action Models(arXiv:2611.19559,2026-11)
- The Flip Test: Video World Models Fail to Learn the World State(arXiv:2611.19822,2026-11)
- Beyond Prediction Gain: LASR as a Metric for Action-Grounded Latents in World Models(arXiv:2611.17775,2026-11)
- Rethinking Actions: Continuity-Aware Priors for World-Model Planning(LG-DKGP,arXiv:2611.16645,2026-11)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



