


世界模型从零讲起(二):Dreamer 系列——在潜空间里想象,如何让一个智能体学会行为
承接上一篇:世界模型有了,策略怎么学
上一篇把世界模型拆成了「编码—动力学—控制器」三块,并指出它在系统里有三种用法:规划、在想象中训练策略、充当可交互仿真器。那篇文章只在概念层面讨论了这三种用法,没有回答一个工程问题——拿到一个学好的世界模型之后,策略究竟怎么在里面学?
这看起来是件小事:把策略放进想象出来的轨迹里跑,用强化学习的目标函数更新它就行了。实际上这条路线在 2018 年之前并不成立,卡在三个具体的地方。
第一是模型状态必须是马尔可夫的。如果动力学模型只是「预测下一帧像素」,那么策略要决策时,需要的上下文是过去很多帧;想象一条 15 步的轨迹,就得把 15 帧高清图像全部生成出来,成本高到无法并行。第二是梯度必须能从奖励一路回传到动作。策略网络的参数只通过动作影响未来;如果状态预测是像素级的,梯度要先穿过一次图像生成,链路既长又噪声极大;如果动作是采样出来的离散量,梯度在采样处还会断掉,需要专门的估计器把它接回去。第三是想象出来的状态分布必须与真实数据重合。世界模型有误差,策略会主动去找模型误差最大的区域并利用它,这就是 model-based RL 里著名的模型利用(model exploitation)问题。
Dreamer 系列(Hafner 等人,从 2019 年的 ICLR 2020 论文到 2025 年发表于 Nature 的 DreamerV3,再到 2025 年 9 月的 Dreamer 4)逐一解决了这三件事,并且把方法演进成了一套相当通用的配方。这一篇按代际拆开,重点不在「它拿了多少分」,而在于每一处设计决策回应了哪个具体问题。
RSSM:把状态拆成「记住的」与「猜出来的」
为什么需要两路状态
一个只靠 RNN 隐状态 的动力学模型,把「世界现在是什么样」和「过去发生了什么」全部挤在同一组向量里。这带来两个麻烦:隐状态必须精确编码长期历史,否则几步之后就忘了关键信息;而隐状态又要作为预测的起点,任何一点噪声都会沿 rollout 放大。
RSSM(recurrent state space model,递归状态空间模型)的做法是把状态拆成两部分:
- 确定性的递归状态 :由 GRU 维护,看的是历史,。它负责记住「多久、在什么地方、什么动作之后」这类长期上下文,本身不引入随机性。
- 随机状态 :表示「在这一时刻世界里有哪些不确定的东西」,比如物体速度、遮挡物的位置。它从分布里采样,可以由观测推断(后验),也可以由动力学预测(先验)。
两者拼起来构成模型状态 。这个分解直接借鉴了卡尔曼滤波:滤波器的协方差描述「不确定的是什么」,状态估计描述「已知的是什么」。区别在于 Kalman 滤波器在高斯假设与线性动力学下做解析推断,而 RSSM 用神经网络做非线性版本。还有一层区别更关键:网络可以学习多峰分布。同一个观测下,「门是开着的」与「门被风吹开又关上」两种解释的下一步预测完全不同,高斯滤波器只能给出一个均值,RSSM 的随机状态则可以是多峰的。这也是 V2 之后把随机状态换成离散码本的一个理由——类别分布天然可以拟合多峰。
这样做的好处是:确定性部分把长期信息以低噪声的方式扛住,随机部分只负责承载局部不确定性,并且允许先验与后验分开——想象时只用先验(不看观测),学习时用后验(看着观测)。
四个网络与两组分布
DreamerV1 给出的分解(原始 RSSM 出自 2018 年的 PlaNet 工作)是:
这里 与 的记号在论文中有意区分: 是能在真实数据上采样的分布(后验,看到观测), 是近似分布(先验,看不到观测)。之所以用两个记号,是因为世界模型的训练目标天然有两个方向——后验要能解释观测,先验要能预测后验。这两条约束写成 KL 散度就是一个项,具体怎么配平是后面 KL balancing 要解决的问题。
观测模型只作为训练信号存在。它把 解码回图像,逼使随机状态保留足够的信息;但推理与想象时完全不需要它。这是整个方法能并行的关键:一条想象轨迹只有几百维的向量在动,没有一张图像被生成。
从 V1 的连续隐变量到 V2 的离散码本
DreamerV1 的随机状态是 30 维对角高斯,用重参数化技巧采样。DreamerV2 做了一个在外人看来很奇怪的改动:把随机状态换成 32 个独立的类别变量,每个 32 类。
理由有三层。其一,连续高斯与策略梯度的配合很别扭:重参数化让采样可微,但采样出的向量噪声在长 rollout 里被逐步放大,策略容易学到对噪声敏感的行为。离散变量的 straight-through 估计器则给出一个偏置更小、方差更小的梯度。其二,32 个类别变量展开后共有 种组合,容量远大于 30 维高斯,却可以强制稀疏——采样出的码本组合天然是「少数几个类别的 hot」,这相当于给随机状态施加了稀疏先验,迫使模型只在必要时激活变量。其三,论文在 55 个 Atari 游戏上做了对照:离散潜变量在 42 个游戏上优于高斯(容差 5% 以内算平局,8 个更差、5 个持平)。论文自己也坦承不知道确切原因,给出的几个假设都与前面的分析一致——类别先验能精确拟合多峰的聚合后验,压平后的 1024 维二值向量平均只有 32 个激活位,天然稀疏。
直通梯度(straight-through estimator)的实现非常粗暴,DreamerV2 论文里给出了等价于自动微分可以写出来的形式:
# 前向:用硬采样的 one-hot;反向:用 softmax 概率的梯度sample = one_hot(draw(logits)) # 采样结果没有梯度probs = softmax(logits)sample = sample + probs - stop_grad(probs) # 梯度走 probs 那一项这一行代码值得停下来想:前向传播时 sample 是纯 one-hot,后向时梯度来自 probs。也就是说,前向与反向经由的函数并不相同,这是用少量偏置换取可导性的典型取舍。离散采样不可导,直通估计器用「近似导数为恒等映射」的方式绕过去,是离散潜变量方法普遍的做法,也是 VQ-VAE 一类模型的核心技巧。
一次世界模型训练前向的完整顺序
把上面这些组件串起来,训练时一个长度为 的序列是这样走的:
- 从回放缓冲区取出 条长度为 的片段 。动作与观测成对,是因为转移模型要知道「上一个动作是什么」。
- 用 CNN 把每一帧 编码成嵌入 ;对向量观测则先做 symlog 再送入 MLP。
- 沿时间递推:,其中 用后验采样得到,而不是先验。训练时必须让后验看着当前帧,否则 就失去了对历史的校正。
- 由 与 算后验 ,由 算先验 ;采样 后同时送进解码器、奖励头、折扣头。
- 所有时间步的负对数似然与 KL 取平均后反向传播。
第 3 步的「递推用后验」是一个容易忽视但关键的选择。推理时智能体只有先验,训练时却把后验采到的 喂回 GRU——这相当于教师强制:训练阶段每一步都告诉模型「上一时刻的真实隐状态是这个」,让它集中精力学「下一步怎么预测」。如果训练时也用先验采样,误差会在序列里线性累积,梯度噪声大到难以收敛。代价是训练与推理之间存在轻微的不一致,这正是序列 VAE 里 teacher forcing 的老问题,Dreamer 用 KL 把先验与后验拉近,本质上是在缩小这个不一致。
目标函数:重建、KL 与想象出来的奖励
世界模型的损失
把上面四个网络合起来,世界模型的最小化目标(以 DreamerV2 的写法为准)是序列上各步的负对数似然加上一个 KL 正则:
逐项读:
- 三项负对数似然分别对应图像重建、奖励预测、折扣因子预测。图像项的形状决定了随机状态必须保留哪些信息——它相当于一个信息瓶颈:能重建出图像的信息被保留,重建不了的信息被 KL 赶出去。
- 缩放 KL。Atari 上取 ,连续控制上取 。为什么差别这么大?Atari 的画面中大量背景像素与决策无关,强制潜变量预测这些像素只会造成浪费,弱 KL 让编码器可以多保留一些信息;连续控制任务的画面简单,需要更紧的瓶颈来让先验更容易预测。
这个目标本质上是一个条件变分自编码器(conditional VAE)在时间维上的展开,每一步的后验看到当前观测,先验只看到历史与动作。
KL balancing:让先验先学会,别被后验拖着走
KL 项 同时干了两件事:把先验往「真实后验的平均值」拉,把后验往先验那一边推。训练早期先验基本是瞎猜的,如果两边用同样的学习率,后验会被一个错误先验反复拖拽,导致后验退化成「只保留极少信息」的平庸解,而先验也因此学不到东西。
KL balancing 的做法是把 KL 拆成两项、各自乘不同的权重、并且用 stop-gradient 切断一侧:
表示停止梯度。第一项只训练先验(把它往真实后验的平均分布拉),第二项只训练后验(让它靠近先验,但此时先验不会因为这项而改变)。V3 把两侧的权重分别记为 与 ;V2 则用一个系数 分配:先验一侧乘 、后验一侧乘 ,并取 ——先验的 KL 以 0.8 的幅度更新,后验以 0.2 的幅度更新,所以先验学得更快。
DreamerV2 的实验把 KL balancing 单独拿出来和标准 KL 对比,在 44 个任务上 KL balancing 更好,而且先验预测后验的 KL 更低。论文给出的解释是:标准 KL 倾向于通过提高后验熵来降低 KL,也就是让后验变得更不确定;而 KL balancing 倾向于让先验变得更准。这个区别在长 rollout 里非常重要——想象走的是先验,先验不准就会离真实分布越来越远。
free bits:给 KL 设一个地板
KL 项本身还有一个细节:完全不加下限时,训练后期会出现「先验与后验相差极小」的状态,KL 项对总损失的贡献趋近于零,先验约束逐渐失效。V2 的改动记录里明确写着,它用 KL balancing 取代了 V1 使用的 free nats 截断;到了 V3,做法变成两者并用——KL balancing 负责分配两侧的更新速度,free bits 负责给 KL 设一个地板,动态损失与表示损失都被截在 1 nat(约 1.44 bit)之上:
它的含义是:当某一步的 KL 已经小于 1 nat 时,这一项的梯度为零,模型可以把容量让给预测损失。如果没有这个地板,训练后期大量轨迹的 KL 很小,KL 项对总损失的贡献几乎为零,模型会逐渐放弃对先验的约束,导致「先验与后验之间只差一点点」这种看似漂亮实则信息很少的状态。free bits 用一个简单的地板保护了先验的约束。
想象训练:策略只在潜空间里长大
想象 MDP 的构造
世界模型一旦训练好,参数就冻结,接下来在它上面定义一个「想象出来的 MDP」:
- 初始状态 取自回放缓冲区里真实数据的后验。初始状态取自后验,而不是「随机初始化一个潜向量」或「用先验从零推演」。原因是想象要与真实数据分布对齐:策略在想象里学到的行为,最终要迁移回真实环境;如果起点就是一个模型自己幻想出来的状态,这条轨迹可能根本不对应任何真实观测,策略学到的动作就没有意义。用真实片段的后验作为起点,等于把「想象」锚在「真实发生过的事情」上,再让模型向前外推几步。外推的长度就是想象水平线 ,它决定了想象能偏离数据多远。
- 从 出发,动作 由策略网络给出,状态按先验 推进,奖励由奖励模型预测 。
- 折扣因子同样由模型预测。真实环境会终止的回合,如果模型不预测终止,想象的轨迹就会把不存在的奖励也算进去,所以 V1 之后折扣因子预测成为一个独立的小头。
这个 MDP 是完全可观测的,因为 满足马尔可夫性。这正是 RSSM 用处:智能体在想象里只看到几百维的向量,看不到图像,于是可以在一张 GPU 上同时想象上千条轨迹——DreamerV2 论文给出的数字是单卡并行 2500 条。
截断与 λ 回报
想象轨迹有固定长度 (V1 中连续控制 ,离散控制 )。问题是,截断处没算到的奖励怎么办?如果直接对 步内的奖励求和,策略会变得短视。Dreamer 用价值网络 来估计截断之后的回报,并把不同截断步长 的多步回报加权平均:
是「走 步然后用价值网络估计剩余」的回报, 把它们指数加权平均。 时只剩最长的 ,方差大; 时只剩 的一步回报,偏置大。V1 取 、。
论文里有一个对照:不用价值网络(只对 步奖励求和)的版本在长视野任务上表现明显更差,而且对 的不同取值很敏感;加了价值网络后,水平线从 5 到 45 都能稳定。这说明价值网络在想象训练里不是装饰,而是让短想象为长任务服务的必要接口。
梯度怎么穿过动力学
策略的更新目标可以写成:
价值估计依赖奖励预测,奖励预测依赖想象出的状态,状态依赖动作,动作依赖策略参数。每一步都是神经网络,所以整个链路可以自动微分——这就是 Dreamer 与 PPO/A3C 这类「用价值当基线、用策略梯度」方法的本质区别:Dreamer 不需要对数概率梯度,它直接对动作做解析梯度。
这也解释了为什么动作参数化有讲究。连续动作用 tanh 变换的高斯,均值与标准差由网络输出,然后重参数化:
均值被乘以 5 再经过 tanh,是为了让策略能饱和到动作边界,否则网络只能逼近 ±1 附近,无法输出「满舵」。离散动作则用 straight-through,V1 的实验显示动作噪声用 -greedy 从 0.4 线性衰减到 0.1——想象训练本身不保证探索,探索仍然要靠加噪。
价值网络为什么是回归而不是分类
价值网络最小化:
目标值 是从想象轨迹上算出来的,梯度在目标值处截断(否则价值网络会推动想象轨迹朝自己走去,这不是想要的)。V2 在这一基础上加了一个目标网络:Critic 的目标值由每 100 次梯度更新同步一次的旧副本计算。V3 没有沿用硬同步,而是把目标网络的思路改成EMA 正则:主 Critic 照常学习,同时加一项损失,要求它对采样状态的输出贴近自身参数的指数滑动平均副本;回报计算则直接用主 Critic。这保留了「用平滑目标稳住回归」的作用,又避免旧副本滞后带来的偏置。V3 还把 Critic 损失同时施加在想象轨迹(权重 1)与回放缓冲区中的真实轨迹(权重 0.3)上,在奖励难以预测的环境里提供额外的监督信号;并且把奖励头与 Critic 最后一层的权重初始化为零,避免训练初期预测出巨大的奖励拖慢学习。V3 在此基础上把 Critic 换成了对 symexp 分箱上的分类损失,原因在于回归平方损失对大目标值很敏感,而不同领域的回报量级相差几个数量级。
与在线规划的分界:为什么 Dreamer 不再需要搜索
上一篇介绍过 PlaNet 式的在线规划:每一步用模型展开若干候选动作序列,用奖励与价值打分,选最好的执行,下一步再重新规划。PlaNet 与 Dreamer 用的是同一个 RSSM,差别只在策略怎么来。
在线规划的问题是搜索成本随动作空间与候选数线性增长,而且每个真实决策步都要重新跑一遍。Dreamer 的做法是把「搜索」从推理时搬到训练时:策略网络在想象里被反复优化,学到一个从状态直接映射到动作的函数;部署时只需要一次前向,不需要展开与评分。这相当于用一次性的训练成本换掉了长期的推理成本。
代价是策略网络只能表示它学到的那一类映射。如果任务需要精确的多步推理(例如「先绕到背面、再推、再抓」这种必须规划路径的连贯动作),纯策略网络可能不如带搜索的规划器。V1 的实验给出了一个直接对照:在同一 RSSM 上,5×10^6 环境步时 Dreamer 的 20 任务平均回报是 823,在线规划的 PlaNet 是 332,而最强的 model-free 基线 D4PG 要到 10^8 步才达到 786。也就是说,学会一个策略不仅比每步搜索便宜,在相同数据预算下还更准——因为策略把「如何在模型里搜索」这件事压缩进了参数,而在线规划每次都要从零开始。不过在需要精确多步推演、且模型足够可信的任务上,基于规划的方法仍然有位置。这个权衡在后续的系统里演化成混合方案:策略给出候选、规划器在潜空间里做局部修正——但在 Dreamer 的主线里,策略始终是主角。
Dreamer 的三代跃迁
V1 → V2:Atari 上的离散化
V2 的结构与 V1 几乎一样(RSSM + 想象训练),改动集中在潜变量表示与 KL 正则上。论文给出的结果是:在 55 个 Atari 游戏上,首个达到人类水平的 model-based agent,200M 环境步、单张 V100 训练不到 10 天;按论文给出的口径,这 200M 步真实交互期间,策略是在模型下想象中的 468B 个潜状态上学会的。可见一旦想象足够便宜,「用模型替代交互」的收益可以被放到两三个数量级。
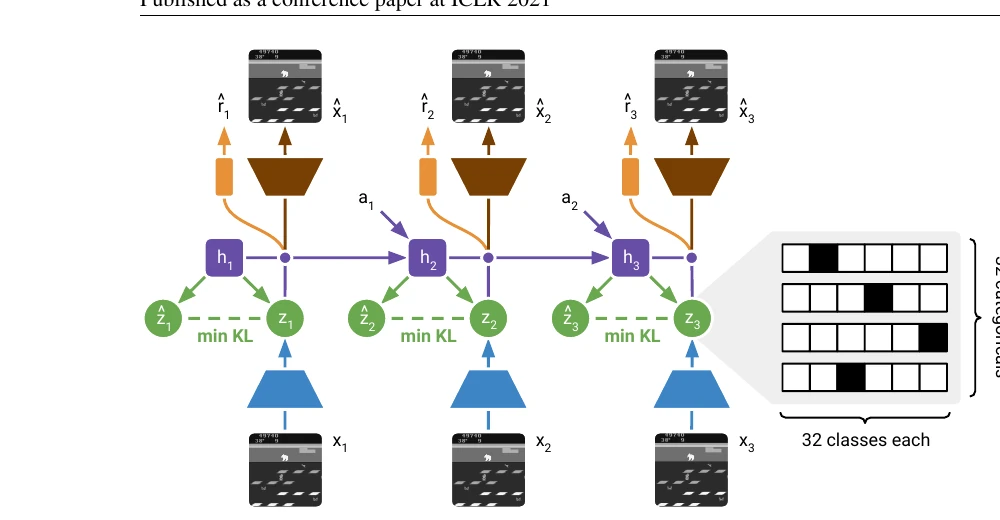
图中横向是时间轴,每一步同时出现两个随机状态:后验 由 CNN 编码的 与 共同推断,先验 只由 推出。虚线箭头对应 KL 项,它连接先验与后验。想象训练沿虚线向右走——只用先验,不经过编码器与 CNN。右下角写着「32 categoricals × 32 classes each」,这正是 V2 对随机状态做的离散化:32 个独立的 32 类类别变量。图源:DreamerV2 论文(arXiv:2010.02193)图 2。
这张图值得对照上一篇里的「重建式潜空间世界模型」:上一篇强调重建式模型要经过解码器,这一篇要强调解码器只出现在训练侧。想象训练里那条先验路径完全绕开了图像,这就是「在潜空间里学行为」的字面含义。
V2 → V3:一套超参数跨域
V3 的目标不再是某个基准的最高分,而是用同一套超参数在 150 多个任务上稳健地学。这项工作的难点是不同领域的信号尺度差异极大:Minecraft 的稀疏奖励、Atari 的密集小奖励与连续控制套件的连续回报,量级相差好几个数量级。平方损失在这些尺度混在一起时会失衡——大回报任务的梯度会淹没小回报任务。
V3 用了五个小工具消除这种不平衡:
- symlog / symexp 变换。,。它在原点附近近似恒等,在大值上压缩对数尺度,并且对称处理负数。用变换后的目标做平方损失,等价于「大值误差被压缩,小值不受影响」。这与用对数直接变换不同:对数无法处理负目标。
- symexp twohot 损失。对奖励与 Critic 这类随机目标,网络输出在分箱位置 上的 softmax,训练目标是 twohot 编码:把连续值 投到相邻两个箱,权重线性插值。读出时是 。这样做的好处是梯度大小与目标量级解耦 —— 目标是 1000 还是 1,分类损失都在同一个量级。
- 百分位回报归一化。,用 5% 到 95% 分位差而不是最大最小值,对离群回合稳健,然后再平滑。
- free bits(上一节讲过)与 KL balancing,两者合起来让表示正则化在不同视觉复杂度下都可用。
- 1% unimix:编码器、动力学预测器与 Actor 输出的分布都取「99% 网络输出 + 1% 均匀分布」的混合,保证任何类别的概率都不会精确为零、对数概率不会发散,先验与后验也不会收缩成确定性分布。V3 的随机状态由一组类别码本组成、码本个数随模型维度变化,所以这里的关键不在具体维度,而在「永远不会变成精确的 one-hot」这一性质。深 VAE 训练里常见的 KL 尖峰,正是分布塌缩到确定性时梯度数值爆炸引发的,掺入 1% 噪声从源头消除了这种可能。
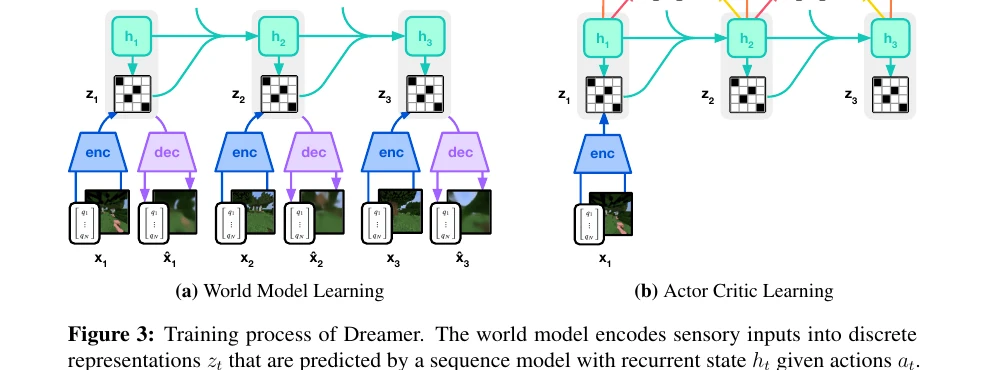
左侧子图 (a) 就是 RSSM 的完整形态,只不过随机状态换成了来自类别码本。右侧子图 (b) 是想象训练的抽象:Actor 与 Critic 不再接触图像,只在 与 的管道里互训。对比 V2 那张图的右下角,离散化保持不变;改动最集中的地方在损失函数一侧,这也是 V3 的论文主要在讲的东西。图源:DreamerV3 论文(arXiv:2301.04104)图 3。
有一点值得特别说明:V3 没有使用世界模型的注意力结构、也没有扩大潜变量,它的容量控制很朴素——从 12M 到 400M 参数,维度 取 256 到 1536 之间的 1.5 倍序列,递归单元宽度固定为 ,每步随机状态的码本数固定为 。默认使用 200M,作者指出在两个控制套件上 12M 即可达到同样的表现。这种「缩放法则」体现了一个判断:世界模型的推理时容量不需要像 LLM 那么夸张,因为决策任务的状态复杂度远低于自然语言。
V3 的消融:哪几个部件真的重要
V3 在 14 个跨越视觉与向量输入的多样化任务上逐个关掉鲁棒性部件,论文给出的结论可以概括为三点。其一,世界模型的 KL 目标是贡献最大的单项,关掉它之后性能下降最普遍;其二,回报归一化与 symexp twohot 的奖励/价值预测次之;其三,每个部件都只是「在子集任务上关键」,没有任何一个部件在所有任务上都不重要,也没有一个部件在所有任务上都是唯一关键。
这个结果比「某个技巧带来了 X% 的提升」更有信息量:它说明 Dreamer 的通用性不是靠某一个万能招数,而是一组各自覆盖不同失效模式的补丁。symlog 处理量级,twohot 处理随机目标,百分位归一化处理离群回合,free bits 与 KL balancing 处理先验学习,unimix 处理数值尖峰。少一块,就会有一类任务退化。
V3 → Dreamer 4:从潜向量世界到视频世界
Dreamer 4(2025 年 9 月,arXiv:2509.24527)是一次更大跨度的改动。前代都在「小潜向量 + MLP/CNN」的世界里,Dreamer 4 把世界模型换成了一个自回归视频扩散模型,策略仍然在其中做想象训练,但预测的对象是视频 token 表示。
四个关键技术直接决定了它可行:
- shortcut forcing。流匹配的采样步数越多越准,代价是每帧要有几十次前向。shortcut 模型把「步长」也作为条件输入,训练时用自蒸馏(较小的两步目标)教会网络在大步长下一步到位。推理时只用 4 步去噪即可生成一帧,每步都是确定性的迭代。
- diffusion forcing。序列上每一帧有独立的噪声水平,训练时任意帧可以是干净的也可以是加噪的,这让「已知过去若干帧、生成下一帧」与「已知部分帧、生成未来若干帧」成为同一个任务的两个特例。想象时把上下文帧设为轻度噪声(Dreamer 4 用 )就能容忍自己生成出来的不完美历史。
- efficient transformer。因果时间 + 全空间注意力的 2D 结构,把注意力拆成空间层与时间层,只在每 4 层放一层时间注意力,并对所有注意力用 GQA 压缩 KV。
- 长序列训练与长度泛化。视频模型的上下文越长,生成的时间一致性越好,但短序列训练更省算力。Dreamer 4 的做法是交替使用大量短批次与少量长批次,最后再只用长批次微调。论文特别强调批次长度要长于模型实际需要的上下文:否则 Transformer 会记住「上下文开头永远是一张起始帧」这种伪规律,生成到训练长度边界就崩。这一点对任何做自回归视频生成的系统都成立,和 LLM 的长度外推问题是同一类。
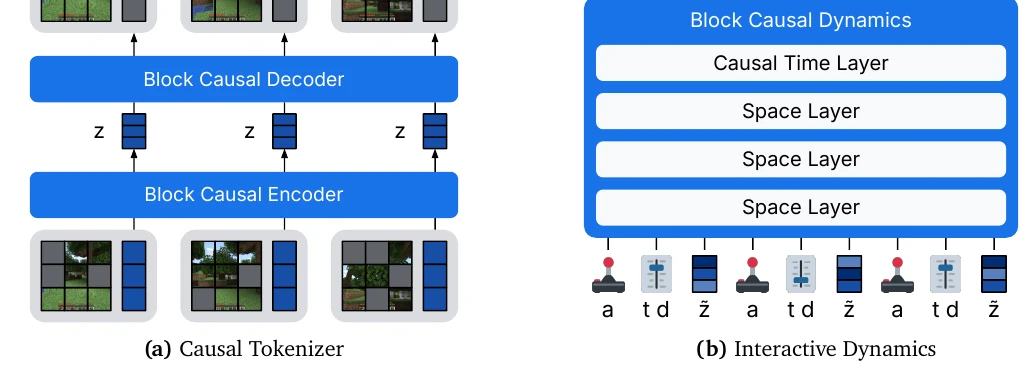
图中左侧 (a) 是 tokenizer,右侧 (b) 是动力学模型。两者都使用「空间层 / 时间层」交替的块因果结构:每个时间步内的所有空间 token 可以互相注意,而跨时间只能看到过去。可以看到动作 、噪声水平与步长都作为条件输入进动力学模型——这正是 shortcut forcing 与 diffusion forcing 在序列结构上的体现。图源:Dreamer 4 论文(arXiv:2509.24527)图 2。
shortcut forcing 带来的成本变化值得算一笔账。常规视频扩散生成一帧要 64 步甚至更多去噪,每步都是一次完整前向;Dreamer 4 把步长作为条件,训练时就让网络学会「一步跨 的间隔」,推理时用 步。四步不是拍脑袋选的:步长必须能被模型在训练分布里见过(步长按 2 的幂采样,),而 4 步对应的 是质量与成本的经验平衡点;再少就会出现明显的画质退化。
更关键的是,去噪步数只是单帧成本的一部分。做交互式想象时,每生成一帧都要把此前的帧放进上下文,注意力成本随历史长度增长。Dreamer 4 的三条工程措施——空间/时间分离注意力、每 4 层才有一层时间注意力、GQA——本质上都是在压这个随帧数增长的 KV 开销。这与 LLM 长上下文推理里「稀疏化 + 分组共享 KV」的思路同源,区别在于这里的「token」是视频块,且每个新帧都要重新走一遍去噪迭代。
策略这一侧也换了做法。Dreamer 4 在预训练的动力学模型里插入一组「agent token」,它们可以看所有模态,但其他模态不能回看它们,避免当前任务信息污染未来预测。这一约束在想象训练时依旧生效,所以即便经过强化学习阶段,世界模型的视觉预测路径也没有被策略梯度改动——这与前代「世界模型冻结、只对策略反向传播」的思路在 Transformer 主干上保持一致。策略与奖励用 MTP 的方式同时预测接下来 8 个 token 对应的动作与奖励:
这一步可以理解为在视频模型内部挂载了一个行为策略头,它不需要额外的 Transformer,而是复用同一个主干。随后用想象 rollout 做强化学习,策略损失换成了 PMPO(preference optimization as probabilistic inference)的变体:
其中 ,优势为正的状态归一化后放「增大概率」一侧,为负的放「减小概率」一侧, 让两边权重相同,最后一项 KL 把策略约束在行为先验附近()。PMPO 的关键性质是只用优势的符号、不用大小:这样跨任务不需要回报归一化,量级不同的回报自动被统一。这一点与 V3 的百分位归一化解决的是同一个问题,但方式更彻底。
为什么 Dreamer 的推理成本很低
Dreamer 系列能被长期使用的一个现实原因:它在推理时基本不烧算力。
用 Dreamer 时的推理有两种。第一种是决策推理:每一步把观测编码成 、跑一遍 MLP 策略输出动作,成本与模型规模线性,与上下文长度无关——这和 Transformer 的 KV Cache 增长完全不同。第二种是想象规划:如果要在线规划,需要在潜空间里展开若干条轨迹,每步只有一次先验前向与一次奖励预测,同样没有图像生成。
这解释了 Dreamer 为何能在单张 GPU 上与真实环境同步运行:Atari 用 200M 规模、Minecraft 用 64 个环境实例、单张 A100 训练。相比之下,用视频生成模型做世界模型时,规划一步的成本等于生成一帧,跨进交互式控制的门槛很高——这是 Dreamer 4 必须引入 shortcut forcing 的原因,也是上一篇中提到的「视频式世界模型推理成本落在哪」的延续。
从系统视角来看,Dreamer 的推理路径可以整理成一张清晰的表:
| 阶段 | 需要世界模型的哪部分 | 是否接触图像 | 典型成本 |
|---|---|---|---|
| 编码观测 | 编码器 + GRU + 后验 | 是 | 每步一次 CNN |
| 想象决策 | 先验 + 策略 MLP | 否 | 每步几次小型前向 |
| 在线规划 | 先验 + 奖励头 + 价值头 | 否 | 每候选动作若干次前向 |
| 世界模型训练 | 全部组件 + 解码器 | 是 | 序列长度 × 全部网络 |
真正贵的只有「世界模型训练」这一行。一旦训好,策略与规划的推理成本相对固定——这也意味着用 Dreamer 的工程重点往往会落在数据采集与回放缓冲区,而不是推理服务本身。
工程细节与常见坑
回放缓冲区里存什么。 世界模型的训练需要 序列,但每步的后验 算过一遍之后可以存起来,供策略训练初始化想象轨迹使用。DreamerV3 的补充材料提到维护一个存「轨迹起始状态」的在线队列,以及容量更大的主缓冲区,这样想象训练不必重复编码历史。这个优化在不改变算法的情况下,把训练吞吐提升明显——因为编码图像是整条链路中最贵的一步。
动作重复与想象水平线。 在 Atari 上,动作重复(action repeat)决定了「一个策略决策对应多少帧」。V3 在 Atari 与 DMLab 用 4,在连续控制套件用 2;V1 则统一固定为 2。重复越大,想象水平线覆盖的真实时间越长,但每一步的信息也越少。论文把动作重复当作数据效率与计算预算之间的显式旋钮。
策略梯度与直通梯度要混用。 V2 的消融显示,仅用直通梯度做策略优化的版本在 Atari 上表现明显不如 REINFORCE,在少数游戏(如 Seaquest)上更快,组合两者效果最稳。直通梯度穿过离散采样带来偏置(前向与反向的函数不同),策略优化对偏置很敏感。Dreamer 4 干脆用 PMPO 绕开这个问题:动作取自行为克隆头在想象轨迹上的采样,策略损失只依赖对数概率与优势符号,不再需要任何穿过动力学的直通梯度。
KL 尖峰。 Dreamer 3 的作者指出,在早期实验中类别潜变量偶尔会出现 KL 的尖峰,原因是先验或后验的分布变为几乎确定性的,此时 KL 的梯度数值变得非常大。V3 加 1% unimix 就是为了从源头消除这个可能。类似问题在扩散模型的采样器里也出现过,处理思路相同:在分布里掺一点噪声,保证它不会塌缩到一点。
世界模型与策略的训练比例。 世界模型太弱,想象轨迹会迅速偏离真实分布;策略更新太激进,想象出的状态又会跑到训练数据没覆盖过的地方,两者的误差会互相放大。V1 的做法是交替进行:数据集中先放入 5 个随机策略的 episode 作为种子,之后每次用 100 次梯度更新训练 World Model、价值与动作模型,再用当前策略采集 1 个 episode。V3 引入了回放比例(replay ratio)这个显式旋钮——每采一个环境步,平均做多少次梯度更新。回放比例越大,每个真实样本被榨出的价值越多,但梯度更新与数据采集的分布差距也越大;论文按各基准的环境步预算分别设定该比例,这也是它能在固定超参数下覆盖不同数据预算的原因之一。
symlog 用在哪几层。 V3 对向量观测在编码前、解码后都做 symlog 变换,奖励预测与 Critic 则直接用 symexp twohot 分类头;图像这一类有界输入不走 symlog,而是保留普通 MSE,因为像素范围已经被压缩在本就有界的区间里,再做对数变换只会引入额外的非线性。
从 Dreamer 到 WAM:预测奖励,还是预测动作
Dreamer 的输出是一个策略 与一个价值 。世界模型本身输出的是「状态与奖励」,动作由策略在想象里选择。这条链路隐含一个前提:奖励是可学习的。在游戏里奖励由环境给出,在真实机器人任务里,奖励往往需要人工设计,或者用偏好模型学出来,这本身就是一层误差来源。
世界动作模型(world action model,WAM)把输出侧调了个方向:模型不再预测奖励,而是直接输出动作块,同时预测这些动作会造成什么观测。代表工作是 DreamZero(NVIDIA,2026),它在视频扩散主干上联合去噪「未来视频」与「动作序列」,用真值动作回灌 KV 缓存来保持上下文一致。这样做的动机是:互联网上有海量「视频 + 动作」数据(人类操作视频、机器人遥操作数据),可以先把「看到什么就该怎么动」学成一个生成先验,再把奖励或价值当作下游的小头接上去;而在 Dreamer 里,视频只是世界模型的一部分,策略头从随机初始化开始,需要靠想象 rollout 才能学会动作。
两者并不是替代关系,而是把「模型该学什么」的边界画在了不同位置。Dreamer 把动作留给策略,世界模型专注动力学与奖励,好处是 RL 目标清晰、想象训练可以严格地做策略改进;WAM 把动作纳入生成目标,好处是能直接吃行为数据、零样本迁移到新任务,代价是训练目标里混入了动作似然,动力学与策略的耦合更难分离。本站的 动作条件世界模型完全拆解 详细拆过 DreamZero 的联合去噪与跨具身迁移,这里只把它与 Dreamer 的分界点讲清楚。
四代放在一起看
把四代的核心差异压缩成一张表,能更清楚地看到每一代在改什么:
| DreamerV1 | DreamerV2 | DreamerV3 | Dreamer 4 | |
|---|---|---|---|---|
| 世界模型主干 | CNN + RSSM,30 维高斯 | CNN + RSSM,32×32 类别 | 同左,加鲁棒损失 | 因果 tokenizer + 块因果 Transformer |
| 预测空间 | 图像重建的潜向量 | 同左 | 同左 | 视频 token 表示 |
| 随机状态 | 对角高斯 | 离散码本 | 离散码本 | 扩散去噪的连续表示 |
| 策略学习 | 想象 actor-critic | 加 straight-through 与 REINFORCE | 同左,加鲁棒价值 | agent token + 行为克隆 + 想象 RL |
| 数据来源 | 在线交互 | 在线交互 | 在线交互 | 离线视频 + 少量任务数据 |
| 关键新部件 | λ 回报、折扣预测 | 离散潜变量、KL balancing | symlog、twohot、free bits、unimix | shortcut forcing、diffusion forcing、GQA |
| 代表结果 | 20 任务平均回报 823 | 55 个 Atari 达人类水平 | 150+ 任务一套超参数 | 仅用离线数据(无环境交互)拿到 Minecraft 钻石 |
这张表容易被读成「一代比一代强」。实际上四代的目标并不相同:V3 的重点不是刷新单一基准的分数,而是用同一套超参数覆盖更多领域;V4 的强项是从离线视频学习,而不是在在线交互场景里追求更高回报。每一代解决的是不同约束下的问题:V2 解决离散动作与长序列,V3 解决跨域超参数,V4 解决从视频先验到行为。选型时应按「数据是否可在线采集、动作是否离散、是否需要视觉保真度」来判断,而不是按代际编号。
如果要在自己的任务上用 Dreamer,有三条实践上的判断。其一,状态维度不需要大:V3 在连续控制上 12M 参数即可达到 200M 的表现,先从小模型跑通再扩。其二,先把世界模型的重建质量与先验 rollout 的稳定性调好,再动策略——想象训练对世界模型的误差极其敏感,很多「策略不收敛」最后都归因于先验几步之后就飘了。其三,动作重复与想象水平线要一起调:动作重复小、水平线短,策略会更短视;动作重复大、水平线长,模型误差会吃掉收益。这两者的乘积大致对应「想象覆盖的真实时间」,是比单个参数更有意义的量。
局限与边界
第一个边界是一个没有完全解决的假设:世界模型学到的动力学对策略的行为是「足够准确」的。当策略开始做训练数据里没有的动作时,先验会被推到未见过的地方,误差放大。KL 正则让先验更容易预测后验,从而延缓漂移,但这本质上是用「让策略不太偏离数据」换来的稳定,代价是探索的广度受限。
第二个边界是观测必须能压缩成小潜变量。Atari、连续控制和 Minecraft 这类图像的状态复杂度有限,潜向量可以覆盖;但真实机器人场景里有大量三维细节、遮挡与光照,潜空间可能撑不住,策略也就看不到需要的细节。这是视频式世界模型(V-JEPA、视频扩散、Dreamer 4)出现的动因之一。
还有一个常被忽视的边界是评估口径。Dreamer 的论文大多在仿真环境里报告回报或成功率,而真实机器人上的失败模式往往不是「回报低」,而是「偶发的危险动作」「长时间静止」「对光照与摩擦变化不鲁棒」。想象训练优化的是模型内部的期望回报,它不会主动惩罚这些在模型里看不到的失效。把 Dreamer 部署到真实系统时,通常要在奖励里显式加入安全项、在动作上加低层限幅,并保留一个人工接管通道——这些都不在算法本身里。
第三个限制是动作预测的因果归属在复杂任务上可能很脆弱。Dreamer 4 插入 agent token 并禁止其他模态回看它们,本质上是在架构层面强行切断「任务信息泄漏进预测」的通路。一旦这个切断在训练中不严格,模型会学到「预测动作取决于任务」之类的捷径,世界模型的预测就不可靠了。
下一篇系列文章会转向 JEPA:同样的「在表征空间里预测」,但去掉重建、改用在嵌入空间上的自监督目标。I-JEPA、V-JEPA 2 的防坍缩机制与 Dreamer 的 KL 正则在思想上有很多呼应,但约束方式完全不同,对比着看会更清楚为什么 LeCun 认为重建是「浪费容量」。
小结
Dreamer 系列的骨架可以一行说清:用 RSSM 把状态拆成确定性历史与随机局部,用条件 VAE 式的重建 + KL 训练世界模型,用先验在潜空间里展开想象轨迹,用价值网络把短想象接到长任务上,用解析梯度穿过整条链路更新策略。
三代演进各有重心:V1 把「在潜空间里做 actor-critic」做成可训练的系统;V2 用离散潜变量与 KL balancing 让模型在 Atari 规模上稳;V3 用 symlog、twohot、百分位归一化与 free bits 把一套超参数推向 150 多个领域;Dreamer 4 把世界模型换成 shortcut 条件化的自回归视频扩散,并把策略挂载到同一主干里做想象训练。
这条线的价值不仅在于几个基准的分数,而在于把「世界模型如何被消费」设计成了一组接口:先验负责想象,后验负责学习,价值网络负责延伸,KL 负责约束。理解了这组接口,再去看任意一个 model-based agent 系统——包括后面的 JEPA、视频世界模型、以及更接近部署的推理系统——都能很快定位它把哪条接口换掉了。
参考资料
- Dream to Control: Learning Behaviors by Latent Imagination(DreamerV1,ICLR 2020,arXiv:1912.01603)
- Mastering Atari with Discrete World Models(DreamerV2,ICLR 2021,arXiv:2010.02193)
- Mastering diverse control tasks through world models(DreamerV3,Nature 2025,arXiv:2301.04104)
- Training Agents Inside of Scalable World Models(Dreamer 4,arXiv:2509.24527)
- Learning Latent Dynamics for Planning from Pixels(PlaNet,ICML 2019,arXiv:1811.04551)
- World Models(Ha & Schmidhuber,NeurIPS 2018,arXiv:1803.10122)
- One Step Diffusion via Shortcut Models(Frans et al.,ICLR 2025,arXiv:2410.12557)
- Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion(NeurIPS 2024,arXiv:2407.01392)
- Better & Faster Large Language Models via Multi-token Prediction(DeepSeek 等,arXiv:2404.19737,Dreamer 4 的策略头使用其多 token 预测形式)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



