


TensorRT-LLM 源码完全拆解(三十三):一条请求的准入与激活——Request 如何变成 LlmRequest,又怎样在某个迭代正式登台
在一个推理服务里,用户看到的是「发出去一个 chat 请求,几百毫秒后开始吐字」。而在框架内部,这条请求要先换三次身份:HTTP 体变成一份 Python 的 GenerationRequest 对象,跨进程传到引擎后被展开成一堆字段,再由调度器包成 C++ 的 LlmRequest,最后被某个迭代的 ScheduledRequests 收进门。每一次换身份,都有一组准入判断在决定它「能不能进」「进到哪一步」「先等等还是直接拒绝」。
这篇沿着 TensorRT-LLM 当前的源码把这条链路完整走一遍。前面几篇分别拆过 PyExecutor 的装配线、调度器的容量算术和序列槽位的分配,本篇补齐中间那段常被跳过的部分:请求对象的形态转换与准入判断。读完之后应当能回答四个问题:一个请求为什么会在 C++ 层再被校验一次、为什么 REQUEST_TYPE_CONTEXT_ONLY 这种类型能存在、「等待队列」为什么不是一个简单的 FIFO,以及已经被准入的请求为什么还可能被调度器「退回」到队列里。本篇是第一篇把「准入」这一层单独拎出来讲的,和前面讲 PyExecutor 单步循环、调度器容量算术的两篇前后呼应,读完这一篇再回去看那两篇,很多看起来奇怪的判断都会变得顺理成章。
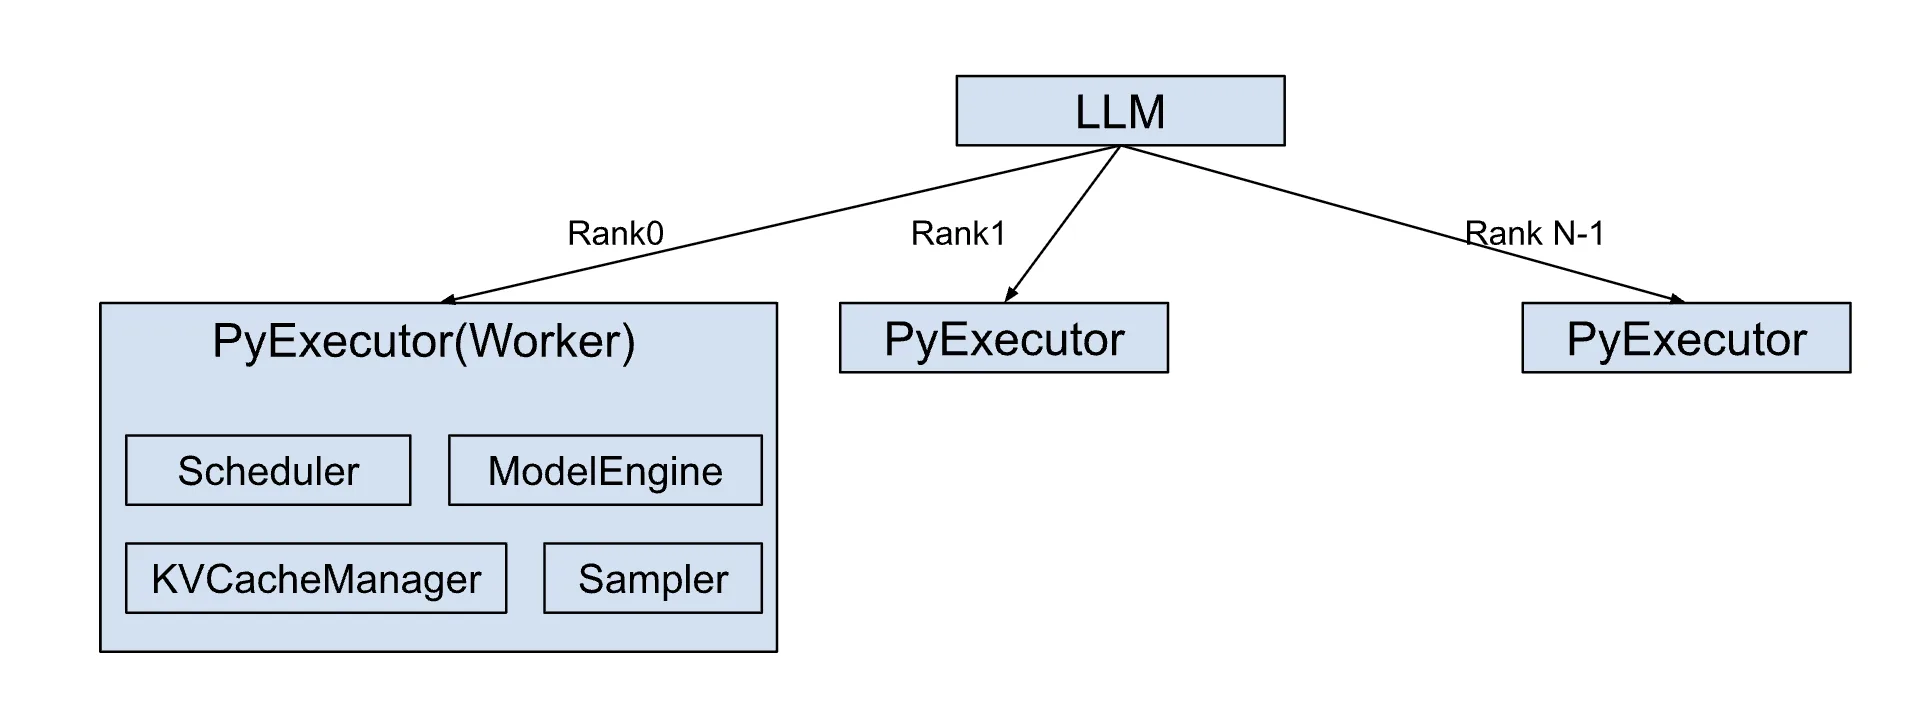
上图是官方文档里的架构总览。可以把它当作本篇的地图:左边是用户请求进入的 Executor 前端层,中间是负责排队、分配 KV 与调度的 Batch Manager 层,右边是真正执行算子的运行时层。准入判断几乎全部发生在左侧到中间的这条缝里——请求还没轮到 GPU 的时候,它的命运已经在这里被决定了。下面按「身份转换 → 各层准入 → 登台」的顺序展开。
三段身份:Request、ExecutorRequest、LlmRequest
同一个用户请求,在 TensorRT-LLM 里有三种不同的表示形式,每一段各有分工。理解这三段身份的分工,是理解后面所有准入逻辑的前提。
第一段:Python GenerationRequest(前端侧)
前端层构造的是 tensorrt_llm/executor/request.py 里的 GenerationRequest。它有大量可选字段:sampling_params、lora_request、streaming、kv_cache_retention_config、disaggregated_params、multimodal_params、scheduling_params、cache_salt、arrival_time、encoder_input_token_ids、priority……
这个类的构造函数里有一段值得注意的代码:
if isinstance(prompt_token_ids, list): self.prompt_token_ids = prompt_token_idselif isinstance(prompt_token_ids, (torch.Tensor, np.ndarray)): if prompt_token_ids.ndim == 1: # A flat array goes straight into the int32 wire buffer that # __setstate__ also produces ... if isinstance(prompt_token_ids, torch.Tensor): prompt_token_ids = prompt_token_ids.cpu().numpy() self._prompt_token_ids = None self._prompt_token_ids_i32 = np.array(prompt_token_ids, dtype=np.int32, order="C") else: self.prompt_token_ids = prompt_token_ids.tolist()如果调用者传入的是一个一维 Tensor 或 ndarray,GenerationRequest 不会把它转成 Python 整数列表,而是直接拷贝成一块 C 序的 int32 ndarray。注释写得很直白:这样在 pickle 跨进程传递时不必「为每个 token 构造一个 PyLong,再在 C++ 侧一个一个转回来」。Python 列表则只有在真正被访问时才惰性物化。
这是准入链路上的第一个「隐形门槛」:输入的物理形态决定了它的搬运成本。一个 32K token 的 prompt,如果以 list[int] 的形式跨进程,那就是 32K 个 Python 对象;以 int32 ndarray 的形式,就是一条 128KB 的连续缓冲区。后者在 MPI 广播、pickle 和共享内存拷贝里都便宜得多。
构造函数里还有两个前置校验:
if cache_salt is not None: if not isinstance(cache_salt, str): raise TypeError(...) # The C++ side validates against UTF-8 byte length, so do the same here cache_salt_byte_len = len(cache_salt.encode("utf-8")) if cache_salt_byte_len > self.MAX_CACHE_SALT_LEN: raise ValueError(...)cache_salt 是前缀缓存的一个「盐值」,用来隔离不同租户的 KV 复用。Python 侧按 UTF-8 字节长度检查,而不是像朴素写法那样用 len() 数码点——因为 C++ 侧比对的就是 std::string 的字节长度,非 ASCII 的盐如果按码点检查会「这边通过、那边失败」,报错位置离根因很远,排查费劲。这体现了一条贯穿整条栈的工程惯例:凡是会跨越语言边界的字段,校验必须与目标语言的度量口径一致。
priority 也被限制在 [0.0, 1.0]:
if not (0.0 <= priority <= 1.0): raise ValueError(f"priority must be a float in [0.0, 1.0], got {priority}")这里用的是一个小巧的写法:not (0.0 <= priority <= 1.0) 对 NaN 也成立,因为与 NaN 的任何比较都为假,链式比较结果就是假,取反为真。所以 NaN 会在前端就被拒绝,而不是一路闯到等待队列的堆里。
第二段:C++ executor::Request(跨层传输)
Python 对象被 pickle 后送进引擎,在 C++ 侧对应的是 tensorrt_llm/executor/request.cpp 和 requestImpl.h 里的 Request。它是一个 pimpl 包装,Impl 的构造函数把几十个字段一次性收下:
Impl(VecTokens inputTokenIds, SizeType32 maxNewTokens, bool streaming, SamplingConfig const& samplingConfig, OutputConfig outputConfig, std::optional<TokenIdType> const& endId, ..., PriorityType priority, RequestType type, std::optional<ContextPhaseParams> contextPhaseParams, ..., std::optional<IdType> disaggRequestId, std::optional<std::string> cacheSalt = std::nullopt) : ... , mPriority(priority), mType(type), ... , mCacheSalt(validateCacheSalt(std::move(cacheSalt))), ...{ validate();}注意两个细节。第一,cacheSalt 的校验在成员初始化列表里就完成了,validateCacheSalt 抛异常时对象还没构造完。这样做的好处是:任何访问 Impl 的代码都不用担心看到一个超长盐。第二,validate() 只做两条最基本的检查:
void validate(){ TLLM_CHECK(!mInputTokenIds.empty()); TLLM_CHECK(mMaxNewTokens > 0);
if (mGuidedDecodingParams.has_value() && mSamplingConfig.getBeamWidth() > 1) { TLLM_THROW("Guided decoding does not support with beam search."); }}也就是说,C++ 的 Request 故意只做「不依赖模型和引擎配置」的校验。它不知道模型词表有多大,不知道 max_beam_width 配的是多少,不知道 KV 池的容量——这些信息全在引擎侧。于是很多看上去「应该在这里检查」的错误,被留到了后面更了解上下文的层。
第三段:LlmRequest(排队与执行侧)
第三段是 tensorrt_llm/_torch/pyexecutor/llm_request.py 里的 LlmRequest,它是 tensorrt_llm.bindings.internal.batch_manager.LlmRequest 的 Python 子类。这一段不再只是数据的容器,它还带上了状态:
class LlmRequest(tensorrt_llm.bindings.internal.batch_manager.LlmRequest): ...C++ 的 GenericLlmRequest 里维护 mLlmRequestType 与 mState。类型只有三种:
enum LlmRequestType{ LLMREQUEST_TYPE_CONTEXT_AND_GENERATION = 0, LLMREQUEST_TYPE_CONTEXT_ONLY = 1, LLMREQUEST_TYPE_GENERATION_ONLY = 2};状态机则更细,仅「可调度」的那一段就包括:
kCONTEXT_INIT = 10,kDISAGG_CONTEXT_INIT_AND_TRANS = 11,kDISAGG_GENERATION_TRANS_COMPLETE = 12,kGENERATION_IN_PROGRESS = 13,kGENERATION_TO_COMPLETE = 14, // schedulable states endskGENERATION_COMPLETE = 20,kDISAGG_CONTEXT_TRANS_IN_PROGRESS = 21,kDISAGG_CONTEXT_COMPLETE = 22,kDISAGG_GENERATION_WAIT_TOKENS = 23,而 isContextFinished() 的实现值得单独看:
[[nodiscard]] bool isContextFinished() const noexcept{ return isGenerationInProgressState() || mState == LlmRequestState::kDISAGG_CONTEXT_INIT_AND_TRANS;}在普通的聚合服务里,一条请求的 prefill 结束、进入 generation,就是 kGENERATION_IN_PROGRESS;而在 P/D 分离里,上下文 worker 跑完 prefill 之后处于 kDISAGG_CONTEXT_INIT_AND_TRANS——KV 还在往解码端传——从它的视角看,上下文阶段也已经结束,尽管此时还没有任何后续状态迁移到 generation。这就是状态机要为分离式服务单独留出两个分支的原因:「上下文跑完了」和「这台机器上开始解码了」是两件不同的事。
三段身份的分工可以总结成一张对照表:
| 阶段 | 载体 | 负责哪些校验 | 为什么在这一层 |
|---|---|---|---|
| 请求构造 | Python GenerationRequest | 类型、cache_salt 字节长度、priority 范围 | 面向调用者,报错最直接 |
| 跨层序列化 | C++ executor::Request | 输入非空、maxNewTokens > 0、guided decoding 与 beam search 互斥 | 不依赖模型配置,可以先拦住明显错误 |
| 排队执行 | LlmRequest | 词表范围、beam width、KV 块预算、模型钩子 | 这些判断需要模型、采样器、调度器与 KV 管理器 |
一个常见困惑是「为什么同一个请求在 Python 里通过了,到 C++ 又报错」。理由在表里:每一层能看到的上下文不同,而框架选择把校验尽量下沉到信息最全的层,同时在最上层做最基本的免费检查。
请求类型:一条请求为什么可以只做一半
三段身份里最容易被忽略的字段是 RequestType。cpp/include/tensorrt_llm/executor/types.h 里只有三个取值:
enum class RequestType{ REQUEST_TYPE_CONTEXT_AND_GENERATION = 0, REQUEST_TYPE_CONTEXT_ONLY = 1, REQUEST_TYPE_GENERATION_ONLY = 2};在聚合服务里,几乎所有请求都是第一个值:同一台机器先 prefill 再 decode。那另外两个值为什么必须存在?答案在 P/D 分离的部署形态里:上下文端只跑请求的前一半,解码端只跑后一半。上下文端的请求被标记为 REQUEST_TYPE_CONTEXT_ONLY,它的职责是算完 prefill、把 KV 交出去,然后就结束;解码端的请求被标记为 REQUEST_TYPE_GENERATION_ONLY,它不重新读 prompt 做 prefill,而是等待(或已经收到)KV,从第一个生成步开始解码。
这个类型不是「优化选项」,而是请求身份的一部分。它决定了三件事:
- KV 管理器的记账方式不同。上下文端只需要为 prefill 分配临时块,并在传输完成后释放;解码端需要按生成过程的增长持续分配。同一个
LlmRequest类在两个角色下的生命周期完全不同。 - 采样与输出语义不同。上下文端通常不产生用户可见的 token(或者只产生首 token),解码端负责从第一个 token 开始流式返回。
_handle_first_token_response这类函数就是专门为「上下文端提前交首 token」的场景存在的。 - 校验规则不同。前文
_validate_request里那条「pipelined transfer 只对LLMREQUEST_TYPE_CONTEXT_ONLY生效」的限制就是明证:边算边传是上下文端才有的行为,拿解码端请求去套这套规则没有意义。
executor_request_to_llm_request 里的映射是一张显式的表:
REQUEST_TYPE_MAPPING = { tllm_executor.RequestType.REQUEST_TYPE_CONTEXT_AND_GENERATION: LlmRequestType.LLMREQUEST_TYPE_CONTEXT_AND_GENERATION, tllm_executor.RequestType.REQUEST_TYPE_CONTEXT_ONLY: LlmRequestType.LLMREQUEST_TYPE_CONTEXT_ONLY, tllm_executor.RequestType.REQUEST_TYPE_GENERATION_ONLY: LlmRequestType.LLMREQUEST_TYPE_GENERATION_ONLY,}而 LlmRequest 上的 isContextOnlyRequest() / isGenerationOnlyRequest() 则是这条身份在后续代码里的「快速判据」:
[[nodiscard]] bool isContextOnlyRequest() const noexcept{ return mLlmRequestType == LlmRequestType::LLMREQUEST_TYPE_CONTEXT_ONLY;}
[[nodiscard]] bool isGenerationOnlyRequest() const noexcept{ return mLlmRequestType == LlmRequestType::LLMREQUEST_TYPE_GENERATION_ONLY;}调度器、KV 管理器和 batch 组装都会用这两个判据走不同的分支。这样设计的好处是:同一个 LlmRequest 类型可以同时承载三种生命周期,而无需为「上下文请求」「解码请求」各写一套对象模型。代价是代码里到处都有 isContextOnlyRequest() 的判断,读源码时必须随时意识到「当前这条请求可能只活一半」。
对 P/D 分离的服务来说,这个类型还有一种「配对」作用。ExecutorRequestQueue._get_request_id 会在请求带有 disagg_request_id 时复用它,使上下文端与解码端的请求共享一个逻辑 ID;而 ContextPhaseParams 则携带传输状态、对端地址、以及「从哪一层开始传」等信息。类型 + 共享 ID + 传输参数,三者合起来才构成一次完整的跨端交接。缺了类型,解码端就不知道进来的请求要不要重做 prefill;缺了共享 ID,日志和 KV 传输就对不上;缺了 ContextPhaseParams,解码端就只能等一个「不知道什么时候会来」的 KV。
第一道门:请求队列的收编
ExecutorRequestQueue 不只是一个 queue.Queue
引擎侧的接收口是 tensorrt_llm/_torch/pyexecutor/executor_request_queue.py 中的 ExecutorRequestQueue。它看起来很简单——内部就是一个 queue.Queue[RequestQueueItem]——但它承担了三件普通队列不做的事:编号、子请求、准入状态。
def _get_request_id(self, request: Optional[ExecutorRequest] = None): # if request has a disagg_request_id, use it as request id so that # corresponding context and generation requests have the same request id if request and request.disagg_request_id and isinstance( request.disagg_request_id, int): return request.disagg_request_id
current_id = self.next_request_id self.next_request_id = get_local_request_id(current_id) return current_id在 P/D 分离里,上下文端和解码端看到的是同一个逻辑请求的两种角色。如果两边的请求 ID 由各自的计数器独立生成,那么在追踪日志、指标统计和 KV 传输配对时就得额外维护一张映射表。所以上游如果给了 disagg_request_id,排队时就把它当作正式 ID 使用,一句话消除跨端对齐问题。这是那种看着不起眼、但省掉大量下游代码的设计。
编号本身的生成也有讲究:self.next_request_id = get_local_request_id(current_id)——从 max_batch_size 起步,并且使用一个专门的「本地 ID」函数,而非简单的 +1。代码注释解释了这一点:在分离式服务里,全局请求 ID 使用一个独立的高位区间,本地 ID 与它必须不重叠,否则两边的请求在合并视图里会撞号。
子请求:一次提交,多个座位
_enqueue_impl 里还有一个容易忽略的动作:
req_id = self._get_request_id(request)if self.enable_iter_perf_stats: self.start_times[req_id] = start_timechild_req_ids = self._generate_child_request_ids(request)
item = RequestQueueItem(req_id, request, child_req_ids=child_req_ids)_generate_child_request_ids 会为每个父请求生成若干子 ID。子请求数量来自 request_utils.py 的 get_num_child_requests:
def get_num_child_requests(request: ExecutorRequest) -> int: sampling_config = request.sampling_config return 0 if sampling_config.beam_width > 1 else (sampling_config.num_return_sequences or 1) - 1逻辑很清晰:beam search 不需要子请求(beam 在 LlmRequest 内部按 beam width 维护),而 num_return_sequences > 1 的采样需要额外 k-1 个「兄弟」请求,它们和父请求共享 prompt,只是在采样阶段各自抽签。为什么要把这些兄弟提前编号?因为座位是在准入阶段按请求数算的:如果等到采样阶段才「分裂」,前面基于 max_num_active_requests 的容量判断就少算了,会在一批请求都快结束的时候突然爆出更多活跃请求。
这也是后面 get_from_waiting_queue 里那个看起来奇怪的条件:
num_children = len(req_item.child_req_ids) if req_item.child_req_ids else 0if (req_count + 1 + num_children) > max_req_count: break——一个父请求加上它的全部子请求,要么一起进,要么一起等。不能把父请求放进去而把兄弟挤在门外,否则采样结果的数量就不对了。
start_times 则给统计留了后路:父请求和每个子请求入队时都记一个时间戳,后面 calculate_queue_latency 会逐个出队计算排队延迟,统计的是每个请求各自的等待时长,而不是父请求的。
睡眠与唤醒:队列级别的准入开关
ExecutorRequestQueue 最容易被忽视的部分是 RequestAdmissionState:
class RequestAdmissionState(enum.Enum): RUNNING = "running" PARKING = "parking" PARKED = "parked" WAKING = "waking" FAILED = "failed"引擎进入睡眠(把权重腾出显存以给其他进程让路)时,前端不能继续把请求往里塞。于是队列自己维护一个状态机:
def _enqueue_impl(self, requests: Iterable[ExecutorRequest]) -> List[int]: req_ids = [] with self.enqueue_lock: assert self.active, "PyExecutor has already been shutdown." if self.admission_state is not RequestAdmissionState.RUNNING: raise RuntimeError( "Cannot enqueue requests while executor admission is " f"{self.admission_state.value}")_transition_admission_state 还要求「目标状态必须从预期状态出发」,做的是严格的 CAS 风格转换:
def _transition_admission_state(self, expected, target) -> None: if self.admission_state is not expected: raise RuntimeError("Invalid executor admission transition: ...") self.admission_state = target为什么要在队列上做状态机,而不是让外层「先检查一下再入队」?因为 begin_sleep_transition 与入队可能在两个线程上并发。两段式检查必然存在一个窗口:检查时是 RUNNING,入队时已经变成了 PARKING。把状态判断和入队放进同一把 enqueue_lock,才能把「拒绝」和「接受」做成原子操作。
第二道门:从队列到等待队列——广播、分拣与限流
_fetch_and_enqueue_requests:一次迭代的搬运
PyExecutor._fetch_and_enqueue_requests 负责在每一步把 ExecutorRequestQueue 中的条目搬到等待队列。它做五件事,顺序本身就有含义:
def _fetch_and_enqueue_requests(self, waiting_queue, total_num_live_requests): connector = self.kv_connector_manager control_pending = len(self.control_requests) != 0 if control_pending and (...): return
idle = (total_num_live_requests == 0 and len(waiting_queue) == 0 and not self.is_shutdown and not self._has_pending_connector_transfers()) if idle: timeout = datetime.timedelta(seconds=1200) if self._disable_mpi else None else: timeout = datetime.timedelta(0)
new_requests = [] if self.dist.rank == 0 and not control_pending: if len(self.request_accumulated) != 0: new_requests.extend(self.request_accumulated) self.request_accumulated.clear() timeout = datetime.timedelta(0) with self.hang_detector.pause(): new_requests.extend(self.executor_request_queue.get_from_request_queue(timeout))
new_requests, py_request_objects = self.request_broadcaster.broadcast( new_requests, prefer_cpu=idle) new_requests = self._handle_special_queue_items(new_requests) ... waiting_queue.add_requests(new_requests)阻塞与否,取决于空不空。这是最值得展开的一处。当有活跃请求或等待队列非空时,timeout=0,即非阻塞——每轮迭代都取一下,有多少拿多少。反之,如果整个引擎都闲下来了,rank 0 会阻塞在 queue.get() 上,直到有新请求。阻塞意味着在这段时间里它不进主循环,也就不会空转。
可一旦进入阻塞,就引出一个陷阱:如果收到的是关闭哨兵,后面就再没有条目来唤醒它,阻塞的 get() 会让主循环永远到不了 should_stop_processing 检查,shutdown() 也就卡在 shutdown_event 上。源码注释把这层因果关系交代得很清楚,代码里 not self.is_shutdown 这个条件是它的直接体现。一个「空闲就阻塞」的优化,必须同时写好「退出路径如何被唤醒」,否则只会让问题在压测结束时才会暴露。
为什么只有 rank 0 去拉队列?请求在 rank 0 上序列化后由 RequestBroadcaster 广播给所有 TP/PP/CP rank。这样只需要一份 Python 对象解析、一份 pickle 反序列化,其余 rank 拿到的是同一条字节流。广播在空闲时传 prefer_cpu=idle,因为空闲时 rank 0 可能阻塞长达 20 分钟,其他 rank 也要跟着等在这个探针上——此时不能占用一个自旋的 NCCL kernel,否则会触发 600 秒的 watchdog。
还有一个与 P/D 分离相关的细节:
if connector is not None and not self.enable_attention_dp and self.dist.rank == 0: completed = connector.take_finished_prefix_loads() if completed: new_requests.insert(0, RequestQueueItem(PREFIX_LOAD_COMPLETION_REQUEST_ID, finished_prefix_load_ids=completed))KV Connector 从远端预加载完成的前缀块,会被打包成一个占位的队列条目插到最前面。这个条目的「请求 ID」是 PREFIX_LOAD_COMPLETION_REQUEST_ID 常量,is_normal_request 属性会返回 False。于是用户请求与 KV 预加载完成通知走的是同一个通道,在同一个迭代里被处理——不需要一个单独的「完成队列」加上额外的同步点。
get_from_request_queue:凑批的等待窗口
取出条目之后,还有一个「攒批」的环节:
if self.batch_wait_timeout_ms == 0: return itemsif len(items) >= self.max_batch_size: return itemsdeadline = time.monotonic() + self.batch_wait_timeout_ms / 1000.0while len(items) < self.max_batch_size: remaining_timeout = deadline - time.monotonic() if remaining_timeout <= 0: break try: item = self.request_queue.get(timeout=remaining_timeout) items.append(item) except queue.Empty: breakbatch_wait_timeout_ms 是一个显式的「凑批窗口」:已经拿到一部分请求,不妨再等几十毫秒,看看能不能凑满 max_batch_size。这是吞吐与延迟的老交易——等待换更大的 batch,更大的 batch 换更高的 GPU 利用率。默认为 0 时完全不等待,符合「在线服务优先响应」的默认取向。
_handle_special_queue_items:分拣哨兵
广播过来的条目到达后,会被 _handle_special_queue_items 过一遍,把取消哨兵、控制请求、profile 起停、前缀加载完成、关闭哨兵等从普通请求里摘出来。RequestQueueItem 用一个统一的 ID 空间来表示这些「非请求」:
@propertydef is_normal_request(self): return not (self.is_shutdown_request or self.is_canceled_request or self.is_control_request or self.is_profile_start_request or self.is_profile_stop_request or self.is_prefix_load_completion_request)为什么要混用一个队列?因为它们都需要与用户请求保持相同的顺序。取消请求的语义是「取消我发过的那个请求」,如果取消哨兵走另一条通道,它可能抢在请求之前到达,结果就是「取消了一个还不存在的 ID」,然后请求照常执行。同队列同序保证了「先入队后取消」的时序。
第三道门:等待队列
两种策略,一个接口
进入等待队列的请求,会排在 WaitingQueue 的某个实现里。create_waiting_queue 根据配置选择实现:
def create_waiting_queue(policy=WaitingQueuePolicy.FCFS, gen_admission=None): if gen_admission is not None and gen_admission.enabled: ... return GenAdmissionWaitingQueue(gen_admission) if policy == WaitingQueuePolicy.FCFS: return FCFSWaitingQueue() elif policy == WaitingQueuePolicy.PRIORITY: return PriorityWaitingQueue() else: raise ValueError(f"Unsupported waiting queue policy: {policy}")FCFSWaitingQueue 直接继承 deque,一切按到达顺序;admission_groups 返回全 0,意思是「没有分组的区分」。PriorityWaitingQueue 则用最小堆:
def _push(self, item: RequestQueueItem) -> None: entry = (-self._get_priority(item), next(self._counter), item) heapq.heappush(self._heap, entry)
def _push_front(self, item: RequestQueueItem) -> None: entry = (-self._get_priority(item), next(self._prepend_counter), item) heapq.heappush(self._heap, entry)堆元素的构造有一个非常务实的细节。元组的第一个分量取 -priority,因为 heapq 是最小堆,取负号后最大的优先级排在最前。第二个分量是严格递增的计数器——它的作用是让任意两个元素的前两个分量都不同,从而保证堆比较在第二个分量处就被判定完毕,RequestQueueItem 本身永远不需要实现 __lt__。如果直接放 (priority, item),Python 在比较相同优先级时就会去比较两个 RequestQueueItem 对象,立刻抛 TypeError。
而 _prepend_counter 从 -1 开始每次减一,专门给 prepend_request 用。这让「被调度器退回」的请求能排在同优先级的正常入队请求之前——它本来就比它们更早到达,被打回后排到队尾会制造不必要的乱序。prepend_requests 还会把传入序列反转后再逐个插入,从而让第一个元素排在最前,调用方不需要自己倒序。(见(三)里 get_from_waiting_queue 的 waiting_queue.prepend_requests(pending_requests)。)
PriorityWaitingQueue 的 admission_groups 按优先级断点分组:
def admission_groups(self, requests): """One group per priority.""" groups = [] group = 0 for i, request in enumerate(requests): if i and self._get_priority(request) != self._get_priority(requests[i - 1]): group += 1 groups.append(group) return groups这个分组信息会被后面的「准入分组」逻辑使用——不同优先级组之间的请求不允许互相穿插,否则低优先级的请求可能在同一个批次里被高优先级请求「包夹」,采样顺序与优先级排序不一致。
第三种策略:DISAGG 的 TTFT 感知准入
GenAdmissionWaitingQueue 是 P/D 分离专用的,代码位于 scheduler/gen_admission_queue.py。它在策略上最激进,值得花一段展开,因为它是「等待队列不是 FIFO」这一判断最有力的证据。
它的输入是一个环境变量 TLLM_GEN_ADMISSION_TTFT_PERCENTILE,取值语义直接写在模块 docstring 里:
Orders the GEN waiting queue by the original arrival at the disagg orchestrator. P: 0 is FCFS, P ≥ 99 is oldest original arrival first, and 0 < P < 99 is slack admission with a target X and a guard G estimated online.
即:按哪个百分位的 TTFT 来排序。P=0 退化为 FCFS;P≥99 变成「最早到达者优先」;中间值则进入一种叫 slack admission 的模式。配置结构本身说明这套策略围绕几个量展开:
@dataclass(frozen=True)class AdaptiveSlackConfig: q: float = 0.85 # quantile of the per-request work (TTFT - GEN wait) n: int = 2000 # rolling window and warm-up length (admissions) upd_s: float = 10.0 # X update period alpha: float = 0.02 # step toward the target per update cap_up: float = 1.0 # max X increase per update cap_dn: float = 0.2 # max X decrease per update freeze: float = 0.5 # hold X if < this share of the window's admissions queued queued_s: float = 0.1 # GEN wait above which an admission counts as queued margin: float = 0.5 x_lo: float = 4.0 x_hi: float = 60.0 guard_k: float = 1.5 # G = X + guard_k * mean GEN wait百分位如何换算成「取哪个分位的工作量」也写在代码里:
def work_quantile_for_ttft_percentile(percentile: float) -> float: """q = p - 5 * (1 - p)^2 with p = P / 100, clipped to [0.5, 0.99].""" q = (100.0 * percentile - 5.0 * (100.0 - percentile) ** 2) / 10000.0 return min(0.99, max(0.5, q))以 P=90 代入,q = 0.85。这个非线性映射的意思是:想优化 P90 的 TTFT,用不着取该分位的工作量,取 85 分位就够了;优化 P50 时取 50 分位,而 P99 附近会被压到 0.99,趋近「按最差情况排队」。它把「哪个尾延迟更值得关心」这件产品级的东西,变成了一个调度算法参数。
运行时量 X 与 G 的更新逻辑更值得看:
def _target(self, work, gw): return _quantile(work, self.cfg.q) + _mean(gw) + self.cfg.margin
def on_clock(self, now): ... tgt = self._target(self.obs_work, self.obs_gw) if self.X is None: k = max(1, int(c.n * c.warm_frac)) self.X = self._target(list(self.obs_work)[-k:], list(self.obs_gw)[-k:]) kind = "warm_start" elif upd_n > 0 and upd_q / upd_n >= c.freeze: self.X += max(-c.cap_dn, min(c.cap_up, c.alpha * (tgt - self.X))) kind = "update" else: kind = "hold" self.X = max(c.x_lo, min(c.x_hi, self.X)) self.G = self.X + c.guard_k * _mean(self.obs_gw)工作量的定义在 on_admit 里:
def on_admit(self, now, orig_arrival, gen_arrival): gw = now - gen_arrival self.obs_work.append(now - orig_arrival + self.s2f_s - gw) ...也就是「从原请求到达编排器到解码端准入」的时长减去「只在解码端等待」的时长,再加上准入到首 token 的 s2f 估计。本质上,这是一个请求在「它自己的那段时间轴」上占据的时长,扣掉它在本题队列里排队的时间。X 是它的目标分位值加上一个余量,G 是「允许一个人在最前面走的那段路加上一定比例的排队等待」——它近似于「一个请求从准入到首 token 的最晚可接受时间」。如果一个新的准入会让最前面那个请求的 G 被撑破,那么它就要等;否则越过更早到达的请求先走。
更新被三项约束住:alpha 决定每 10 秒调整多少;cap_up/cap_dn 不对称,涨得慢、降得快(1.0 对 0.2)——这反映了「宁可谨慎放得松,出问题立刻收紧」的工程直觉;freeze 则在窗口里排队比例低于 50% 时保持不动——没有排队的信号时,调整 X 就是在给噪声做响应。
源码注释里还特别强调:
Driven only by rank-consistent inputs, so the state is identical on every rank.
以及模块 docstring:
Every rank must pop the same requests, so all inputs are rank 0’s: the arrival stamps ride in the broadcast queue items, and its clock and
s2f(admission -> first token time) ride with the request-count broadcast.
这一点非常关键:等待队列的准入决策必须在所有 rank 上一致,否则不同 rank 会「排出不同的请求」,然后在下一轮集合通信里对不上号。_fetch_and_enqueue_requests 里那句 waiting_queue.set_now(self.request_broadcaster.rank0_now, self.request_broadcaster.rank0_aux) 就是在把 rank 0 的时钟与 s2f 塞进每个 rank 的队列,让它们在相同的输入上算出相同的顺序。
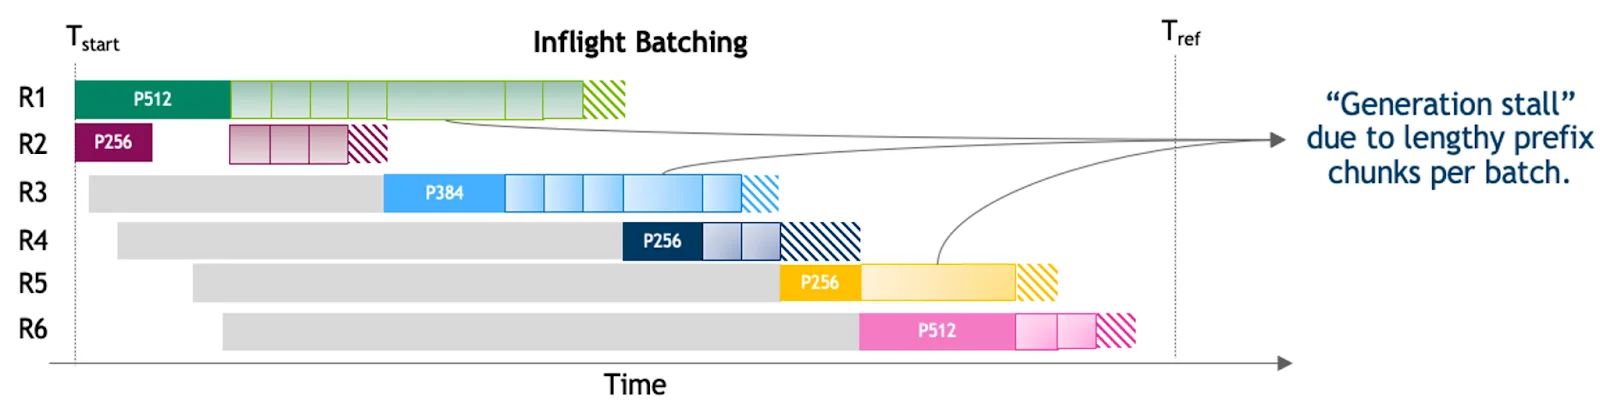
上图(来自官方 P/D 分离服务文档)展示了分离式部署下请求在上下文端与解码端之间的流转。可以看到解码端的「请求准入」并不是简单接续上下文端:请求在编排器处的原始到达时间会一路带到解码端,这正是 admit_arrival / admit_orig_arrival 字段存在的原因,也是上面那套 TTFT 感知排序的输入来源。在聚合服务里这两端是同一条请求的同一段生命周期;在分离式服务里,它们变成了一次跨节点的交接,排队策略也就必须重新设计。
_pop_from_waiting_queue:座位账本
从等待队列里能取出多少请求,由 _pop_from_waiting_queue 决定:
admission_capacity = self._get_request_admission_capacity()max_new_requests = admission_capacity - total_num_active_requests
# Benchmark disagg fill-phase admission throttle (slow-start ramp).if self.is_benchmark_disagg and self._benchmark_fill_phase_active and not self.is_warmup: if self._fill_admit_cap == 0: self._fill_admit_cap = self.dist.tp_size else: self._fill_admit_cap = min(self._fill_admit_cap * 2, admission_capacity) max_new_requests = min(max_new_requests, self._fill_admit_cap)_get_request_admission_capacity 的定义是:
if self.enable_attention_dp: return self.dist.tp_size * self.max_num_active_requestsreturn self.max_num_active_requests注意力 DP 下容量按 tp_size 倍算,因为每个注意力 DP rank 都各自持有 max_num_active_requests 个座位(后面由 ADP 路由再把请求分给具体 rank)。这种记账方式意味着:容量的单位是「座位」,不是「请求」——子请求、dummy 请求都会被计入。
而 _fill_admit_cap 的倍增逻辑是压测场景下的慢启动:一开始只放 tp_size 个请求,每个填批周期翻倍,直到满容量。为什么压测要这么做?因为压测常常要求「所有请求同时在途」;如果一次性放满,前置阶段的 GPU 会在还没有任何解码工作的时候就先被填满,紧接着大量请求同时结束,吞吐曲线完全失真。慢启动压的是时序,不是容量。注释里也提到了另一种极端:如果某个 rank 的调度器连一个请求都放不下,_sync_gen_only_benchmark_has_insufficient_kv 会判定为 KV 不足并让所有请求失败——这是为了避免永远空等。
用一组具体数字把座位账算清楚。假设 TP=8、max_num_active_requests=256、max_num_tokens=8192、投机解码的 max_total_draft_tokens=3,且启用了注意力 DP。先算每 rank 的容量上限:
总准入容量是:
如果此刻各 rank 的活跃请求总数是 1900,那么本步最多还能准入 148 条。注意这个数字和 KV 池容量是两本账:座位够不代表 KV 够,KV 是否够由调度器的容量算术与 _validate_request_budget 决定。反过来,KV 够也不代表座位够——max_num_active_requests 是请求槽位的上限,超过它就没有序列槽位可用。两条约束同时满足,请求才能真正被调度。
再看 max_num_tokens 的约束为什么要除以 1 + D。每个生成请求在一步里至少要占 1 个 token 槽,开了投机解码则要占 1 + D 个(草稿 token 也要进模型验证)。如果每 rank 有 256 个请求、每个请求 4 个 token 槽,一步就是 1024 个 token,只是 8192 的八分之一,还不是问题;真正的问题是某些配置下 max_batch_size 远大于 max_num_tokens // 4,例如 max_num_tokens=1024、max_batch_size=512 时,每步的 token 上限根本装不下全部请求。derive_attention_dp_per_rank_request_cap 给出的就是这条「容量不能超过一步工作量」的硬约束:
源码在缩小时会打印一条 warning,并明确告诉用户「把 max_num_tokens 提到 N 才能跑满声明的 max_batch_size」。这类 warning 的价值在于:配置之间的冲突不会以「性能低于预期」的形式出现,而是以一条可操作的提示出现。
get_from_waiting_queue:为什么弹出还要退回
request_utils.py 中的 get_from_waiting_queue 是「等待队列到本批」的最后一道过滤:
while req_count < max_req_count and waiting_queue: req_item = waiting_queue.peek_request() num_children = len(req_item.child_req_ids) if req_item.child_req_ids else 0 if (req_count + 1 + num_children) > max_req_count: break req_item = waiting_queue.pop_request()
can_process = ( can_process_attention_dp_request(req_item, scheduling_all_ranks_num_active_requests, max_num_active_requests) if enable_attention_dp else True )
if can_process: items.append(req_item) req_count += 1 + num_children else: pending_requests.append(req_item)
waiting_queue.prepend_requests(pending_requests)waiting_queue.mark_admitted(items)最反直觉的是先 pop 再 prepend 回去。这段代码之所以必要,是因为在注意力 DP 下,请求有可能被指定送给某个 DP rank(scheduling_params.attention_dp_rank),而那个 rank 的座位已经满了:
def can_process_attention_dp_request(req_item, all_ranks_num_active_requests, max_num_active_requests): scheduling_params = getattr(req_item.request, "py_scheduling_params", None) if scheduling_params is None: return True target_dp_rank = scheduling_params.attention_dp_rank if target_dp_rank is None or scheduling_params.attention_dp_relax: return True if all_ranks_num_active_requests[target_dp_rank] < max_num_active_requests: all_ranks_num_active_requests[target_dp_rank] += 1 return True return False「被路由到某 rank」的承诺,在取出时必须立刻兑现或推迟,不能悄悄改道。get_from_waiting_queue 的做法是:能兑现就兑现、并把目标 rank 的活跃计数加一;不能兑现就放回队首,让排后的请求有机会被拿到(因为排后的可能不属于同一个 rank)。若不这样做,头部那条固执地要某个满 rank 的请求,就会把整批等待队列都堵死。prepend_requests 的「插回队首」也因此不只是为了保序——它是保证「不会因为一个暂时无法满足的约束而饿死整个队列」的手段。
从(三)的角度看,这正是「等待队列不只是 FIFO」的具体体现:它有 peek/pop/prepend 三个基本操作,就是为了支持「试探—退回」这个模式。只看实现,会以为 prepend 是为了某些边界情况;从准入视角看,它是整个策略的核心原语。
mark_admitted 则在 GenAdmissionWaitingQueue 里被重写,用来把「刚才准入」的时刻报给 AdaptiveSlack.on_admit,驱动 X/G 的在线估计。
第四道门:激活时的二次校验
_fetch_and_activate_new_requests
从等待队列拿出来的请求,并不会立刻进入 active_requests。_fetch_and_activate_new_requests 会做三件事:
def _fetch_and_activate_new_requests(self) -> List[LlmRequest]: def _respond_if_invalid(request: LlmRequest) -> bool: try: self._validate_request(request) if self._mm_encoder_item_scheduling_enabled: initialize_multimodal_encoder_request(request, ...) return False except Exception as e: self._handle_errors(str(e), requests=[request], charge_budget=False) return True
new_requests_cur_rank = self._fetch_new_requests(self.waiting_queue, self.active_requests) validated_requests = [request for request in new_requests_cur_rank if not _respond_if_invalid(request)] self.active_requests.extend(validated_requests) return validated_requests注意 _respond_if_invalid 的行为:校验失败时,它不会抛出去中断整个批次,而是把这一个请求标记为错误并返回响应,其余请求照常继续。charge_budget=False 意味着这条失败的请求不占用迭代统计里的预算。这是服务系统的通行做法的具体化:一个坏请求不应该连累同批的好请求。
值得注意的是,校验发生在 _fetch_new_requests 之后、扩展 active_requests 之前。也就是说,请求在 merge_requests 里已经变成了 LlmRequest 对象——它在等待队列里还只是一个 RequestQueueItem,到了这一步才「有状态、能查模型」。
_validate_request:四组检查
_validate_request 不短,但可以清楚分成四组。
第一组:P/D 分离与 KV 保留配置的兼容性。
retention = request.kv_cache_retention_configif self._is_kv_manager_v2 and retention is not None: if retention.transfer_mode != KvCacheTransferMode.DRAM: raise ValueError("KVCacheManagerV2 does not support per-request GDS/POSIX transfer_mode ...") if not 0 <= retention.decode_retention_priority <= 100: raise ValueError("Decode retention priority must be between 0 and 100") if (self._kv_connector_moves_kv and self.kv_cache_manager.num_pools > 1): raise ValueError("Per-request KV cache retention is not supported with a KV cache connector and multiple layer groups: ...")这段检查的三条,恰好分别对应三类「两个特性组合之后产生的新约束」。保留模式是 GDS/POSIX(从磁盘直接读)与 V2 管理器不兼容,因为它接管了页的物理位置;解码保留优先级必须落在 [0, 100],超出了评分逻辑就会失效;最后一个更微妙——KV Cache Connector 的优先级元数据只支持一个组,而多层的混合 KV 会拆出多个池,于是「按请求保留」这种精细语义无法转义到连接器上,只能拒绝。
再看「pipelined transfer」那一组:
if (self.kv_cache_transceiver is not None and self.kv_cache_transceiver.pipeline_transfer_enabled and disagg_params is not None and request.llm_request_type == LlmRequestType.LLMREQUEST_TYPE_CONTEXT_ONLY): if not self.model_engine.attn_runtime_features.chunked_prefill: raise ValueError("enable_chunked_prefill is required when enable_pipelined_transfer is set.") if request.py_beam_width != 1: raise ValueError("enable_pipelined_transfer requires beam_width == 1 ...") if disagg_params.schedule_style != DisaggScheduleStyle.GENERATION_FIRST: raise ValueError("enable_pipelined_transfer requires schedule_style='generation_first' on the request.") if self.dist.pp_size != 1: raise ValueError("enable_pipelined_transfer is not supported with pipeline_parallel_size=...")流水线式传输 = KV 边算边传。这就意味着必须在每个 chunk 结束时能交出稳定的一份 KV,因此它要求分块预填充;多 beam 会让 KV 的布局和交接口径都不同;调度风格必须是「generation first」(否则解码端还没准备好接收,上下文端就传了);多层流水会让 KV 的分层写入与时序错位。四条限制不是拍脑袋,而是流水线式传输的每个前提条件被逐一写成了断言。这类校验最值得在写自己的服务框架时借鉴:不是「某个配置不推荐」,而是「这个配置破坏了该特性的前提」。
第二组:beam width 与长度惩罚。
if sampling_config.beam_width != self.max_beam_width: raise ValueError(f"Request beam width {sampling_config.beam_width} is not equal to max_beam_width {self.max_beam_width}. ...")代码里给的注释解释了为什么不能支持「更窄的 beam」:
TorchSampler can sample a narrower request … but the layers around it are not ready: the attention metadata is stamped with max_beam_width while the generation rows are laid out at the per-request width, and the scheduler is not beam-width aware, so a narrower request can be batched with a wider one and fail at forward time.
也就是说,采样器能算,但其余组件不行。这种「局部可行、整体不可行」的差别,只能用逐请求校验守住。同理,beam_width_array 不允许递减:
The documented semantics only cover widening, ending at the full width … a narrowing array leaves the trailing rows holding ancestry from an earlier, wider step.
以及 length_penalty 不允许为负:
A negative exponent inverts that: dividing by
length ** negativemultiplies instead, so longer beams score higher and the beam order is reversed.
这几条都是同一类问题:参数的「看起来更一般化的取值」会破坏实现所依赖的假设。在引擎侧把它们断言掉,比让它们在 forward 里产生错乱的 beam 好得多。
第三组:词表与预算。
self._validate_token_id_range(request)...self._validate_request_budget(request)_validate_token_id_range 会检查 end_id 是否在 [-1, num_embeddings) 内,并调用 request.check_token_id_range(num_embeddings) 检查每个 token ID。这里还包含一个多模态特例:Llama4 的多模态请求会跳过该检查(其图像 token 可能不在 lm_head 的词表范围内)。
_validate_request_budget 的检查更「重」:
for resource_type, required_blocks, primary_capacity in ( self.resource_manager.get_request_kv_block_budgets(request)): if required_blocks > primary_capacity: raise ValueError( f"{resource_type.value} requires {required_blocks} KV cache blocks to complete the request, " f"which exceeds its GPU-primary capacity of {primary_capacity} blocks " f"(prompt_len={request.orig_prompt_len}, max_new_tokens={request.max_new_tokens}, " f"beam_width={request.py_beam_width}).")这条检查的意义在于把「一定会卡死」变成「立即报错」:一个需要多于整个 KV 池的请求,如果放进去,之后在 GUARANTEED_NO_EVICT 下它会永远等待「永远不会出现的容量」,而不是失败。_warn_if_kv_block_budget_unchecked 里把这种情形讲得很清楚:
Such a request is admitted and then cannot complete: under GUARANTEED_NO_EVICT it waits for capacity that will never exist rather than failing.
而与之对应的警告也说明了一个现实的局限:稀疏/压缩 KV、可变滑窗、线性注意力、Mamba 混合模型这些管理器自己维护成本模型,会选择退出 get_request_kv_block_budget,于是这条检查对其不生效。这时引擎只剩一次警告:
A request needing more blocks than a pool holds waits unscheduled instead of failing; lower max_beam_width or max_seq_len if generation makes no progress.
这是一个很好的「做对了一半」的例子:对稠密注意力模型,准入预算检查彻底到位;对异构 KV 模型,只留下一条诊断日志。写文章时如果只说前者,那就掩盖了工程的真实分层。
第四组:采样器与模型钩子。
self.sampler.validate_request(request)
model = getattr(getattr(self, "model_engine", None), "model", None)validate = getattr(model, "validate_request", None)if validate is not None: validate(request)
mm_data = getattr(request, 'py_multimodal_data', None)if mm_data: validate_mm = getattr(self.model_engine.model, "validate_multimodal_request_data", None) if validate_mm is not None: validate_mm(mm_data)这里用的是鸭子类型钩子:模型类如果定义了 validate_request / validate_multimodal_request_data,就被调用;没有定义就跳过。之所以用 getattr(..., None) 而不是强制实现,是因为模型动物园里有大量实现,不可能要求每个模型都实现这两个钩子。这一层是「模型自己的额外约束」的出口——例如某些模型对图像尺寸上限有要求,某些对特定推理后端有要求。
第五道门:调度器为什么「退回」已准入的请求
到这里,请求已经在 active_requests 里了。但它在一次 _schedule 之后,并不一定会真的被排上表:
scheduled_context_requests = scheduler_output.context_requests...should_check_waiting = (not self.is_encoder_decoder and not self.enable_attention_dp and self.enable_batch_waiting and len(scheduler_output.context_requests) > 0 and len(scheduler_output.generation_requests) > 0)if should_check_waiting: scheduled_context_requests = self._waiting_requests( scheduler_output.context_requests, scheduler_output.generation_requests)_waiting_requests 的定义:
def _waiting_requests(self, context_requests, generation_requests): """Return an empty list if scheduled requests fulfill the waiting conditions, otherwise return the original context requests. Waiting conditions: - The number of scheduled tokens ... is smaller than `self.batch_wait_max_tokens_ratio * self.max_num_tokens` - The number of waiting iterations is smaller than `self.batch_wait_timeout_iters`.""" num_scheduled_tokens = self._compute_scheduled_tokens(context_requests, generation_requests) should_waiting = (self.batch_wait_iters_count < self.batch_wait_timeout_iters and num_scheduled_tokens < self.batch_wait_max_tokens_ratio * self.max_num_tokens) if should_waiting: self.batch_wait_iters_count += 1 return [] self.batch_wait_iters_count = 0 return context_requests这就是「batch waiting」:当一批里同时有上下文与生成请求、而本步排出的 token 总量偏少时,上下文请求先不跑,空出这一步,让并存的解码请求继续推进,同时给等待队列一点时间聚拢更多请求。它的直观解释是延迟—吞吐:一个 token 数量很少的 prefill 如果跑进本步,本步的 GPU 利用率就会很低;不如等几步,把一个大的 prefill 与一大堆 decode 打包。batch_wait_max_tokens_ratio 控制「多低才算低」,batch_wait_timeout_iters 防死等。
这个「回退」与前面等待队列的「prepend」其实是同一个思想的两次出现:同一个请求可以在一个生命周期里被回退多次,每次都被放回队首,保持它在同优先级中的先后。准入不是一道闸门,而是一条回环。
更彻底的是抢占:已经调度并开始执行的请求,也可能被打回等待队列:
if self._is_kv_manager_v2: self._terminate_recompute_paused_requests(scheduled_batch) self._pause_recompute_paused_requests(scheduled_batch)else: self._pause_requests(scheduled_batch.paused_requests)paused_requests 是调度器输出的一部分,表示「为了腾出 KV 容量而被挤下去的请求」。在 V2 里,它们走的是「paused → 重算」的路径;在 V1 里则是重算 / 重放语义。不论哪条路径,请求都会重新出现在 active 集合里,并在下一轮调度中重新参与竞争。(三)对「抢占」有更细的拆解,本篇只需要强调这一点:被抢占并不等于回到进程外,它仍是引擎内部的一种「重新排队」。
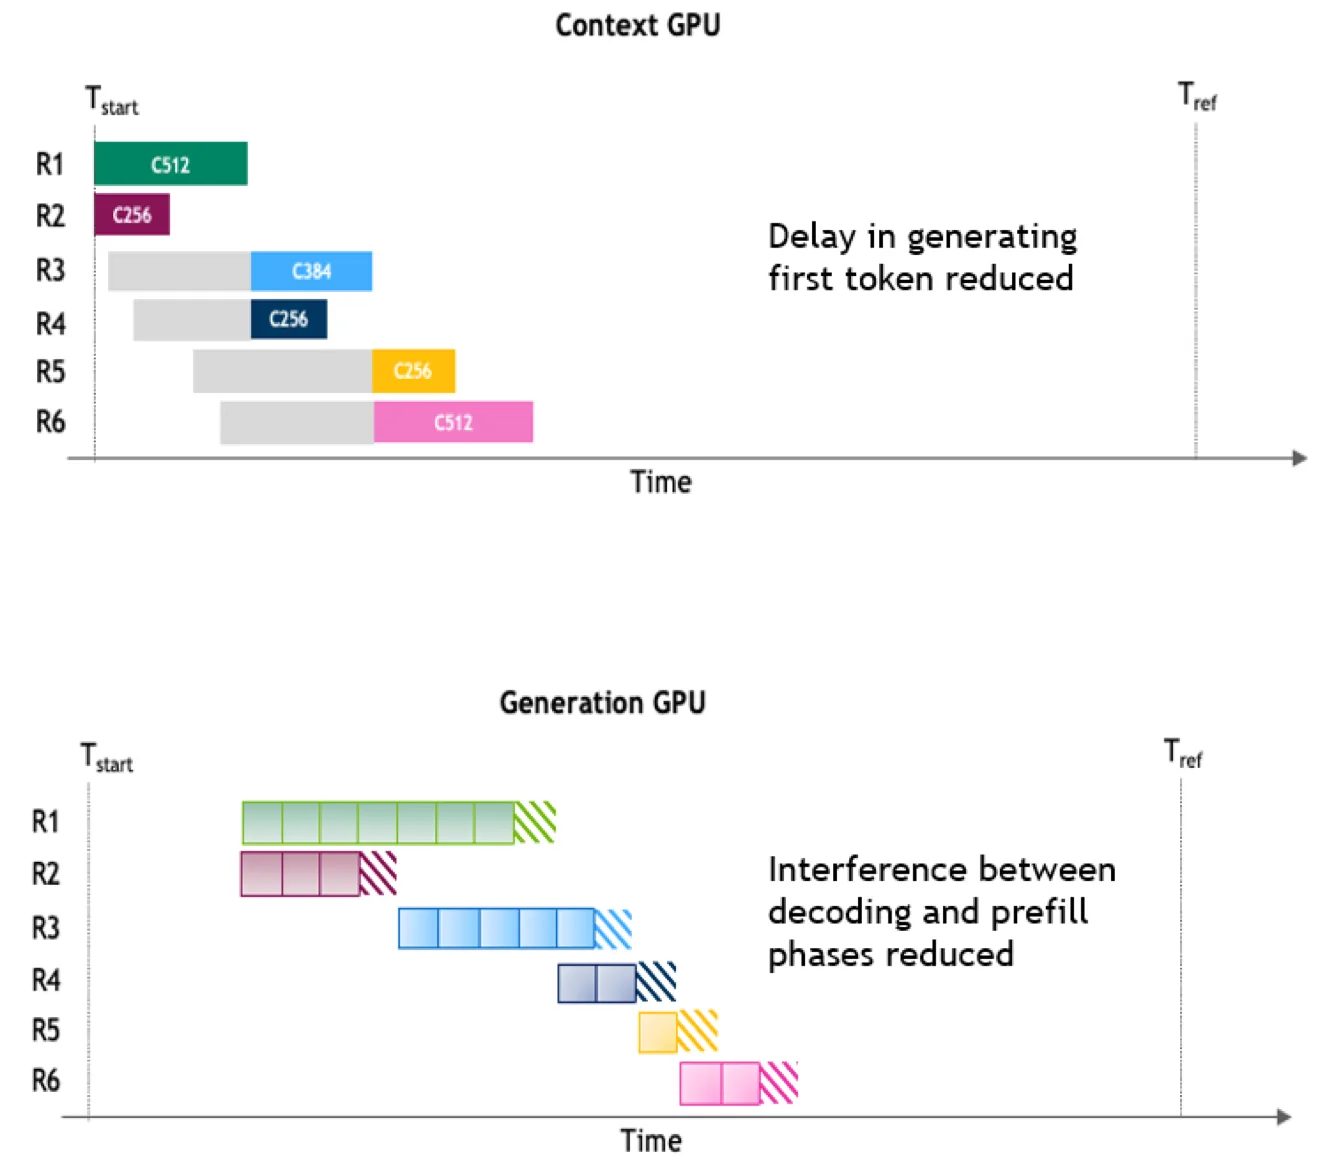
上图(同样来自官方文档)把上下文阶段与生成阶段放在一条时间线里。准入的几道门本质上是在回答一个问题:这条请求现在应该被摆在哪个阶段、哪一批、哪个 rank 上。一个请求在 kCONTEXT_INIT 与 kGENERATION_IN_PROGRESS 之间的迁移,不只是状态机里的一次赋值,还要经过等待队列、调度器、抢占流程与资源管理器的多次协商。
一次请求的准入全链路:从 HTTP 到第一个 token
把上面所有关卡串成一条时间线,可以写成下面这张表(以聚合服务为例):
| 步骤 | 代码位置 | 决策点 | 失败时的表现 |
|---|---|---|---|
1. 前端构造 GenerationRequest | executor/request.py | 类型、cache_salt 字节长度、priority 范围 | 构造时抛异常,前端返回 400 |
| 2. 序列化与传输 | proxy.py / ipc | 是否使用 int32 ndarray | 与准入无关,只影响成本 |
3. C++ Request 构造 | executor/request.cpp | 输入非空、maxNewTokens > 0、guided decoding 与 beam 互斥 | C++ 抛异常,前端返回 400 |
| 4. 入队与编号 | ExecutorRequestQueue._enqueue_impl | 是否 RUNNING、disagg_request_id 复用、子请求分配 | 状态不对则拒绝入队 |
| 5. 拉取与广播 | _fetch_and_enqueue_requests | idle 与否、rank 0 单点拉取、广播到各 rank | 关停哨兵、控制请求分拣 |
| 6. 分拣哨兵 | _handle_special_queue_items | 取消/控制/前缀加载完成 | 分拣后进入对应处理 |
| 7. 等待队列排队 | WaitingQueue.add_requests | FCFS / 优先级堆 / TTFT 感知 | 决定后续出队顺序 |
| 8. 出队与位置分配 | get_from_waiting_queue | 子请求是否够座位、ADP 目标 rank 是否满 | 退回队首 |
9. 合并为 LlmRequest | merge_requests | CP 配置、last generation logits 取舍 | 形成真正的 LlmRequest |
| 10. 激活时二次校验 | _validate_request | 词表、beam width、KV 预算、模型钩子 | 该请求单条失败,其余继续 |
| 11. 调度器排表 | _schedule | chunked context 预算、batch waiting | 上下文请求被回退 |
| 12. 抢占 | paused_requests | KV 容量不足 | 已调度请求被打回 |
| 13. 真正执行 | _forward_step | — | 进入第一次 prefill |
一条请求能否在毫秒级进入 GPU,取决于 1~10 这十道门里每一道都在「它的生命周期里只有一次机会」的前提下给出正确的判断。反过来看,任何一道门如果做得太宽或太严,都会在其它层「看不出原因」的地方体现:太宽,请求会永远卡在调度器里;太严,服务端会莫名拒绝本来合法的请求。
「准入」和「调度」的分工常被混淆:准入回答的是「这条请求能不能存在」,调度回答的是「这条请求现在排第几」。前者由请求的属性与引擎的配置决定,后者由当前批的状态与队列策略决定。把它们分开,才能保证同一个请求在重试、抢占、回退的时候仍然有稳定的身份,而排队顺序可以随策略自由变化。
局限和工程取舍
把这条链路看全了,也能看出这套设计里的若干取舍。
校验分散在四层(前端 Python、跨层 C++、激活期引擎、模型钩子)。好处是每一层只做它上下文足够的检查,报错定位清晰;代价是同一个请求的错误可能在不同的层被发现,用户看到的错误码与文案需要额外的映射表(前端 400 / 队列拒绝 / 单请求失败)才能统一。如果要在更少的层做更全的校验,就必须让前端直接加载模型配置——这会把前端跟某一版本的模型绑定,反而降低了部署的灵活性。
TTFT 感知准入需要所有 rank 一致的输入。这迫使该策略只能使用 rank 0 的观测(时钟、s2f),并且完全不含「本 rank 当前负载」这类在其它 rank 看不到的信息。好处是正确性容易被验证;代价是它对「rank 之间负载差异很大」的情形不够敏感。AdaptiveSlack 里 freeze 阈值的意义也正是这一点:在没有排队的信号时不做调整,避免用非 rank 一致的信息「算出差异」。
预算检查对异构 KV 模型不完整。get_request_kv_block_budget 是「支持的池」上的能力,稀疏/压缩/线性注意力/Mamba 混合这些池选择退出,于是对它们只剩下一条诊断日志。这不是 bug,是接口边界的现实:异构池的「每请求最坏需求」没有统一的闭式表达。如果做一个泛化的准入预算,就得让每个管理器都提供自己的成本上界——这本身是一个不小的工程量。
子请求与座位的耦合限制了策略的自由。「父 + 子」必须整组准入,使得等待队列无法做「只放一部分」的动作;对于只想尽快拿到第一条样本的请求,这种「全有全无」其实偏保守。但一旦允许部分准入,num_return_sequences 的语义就很难定义——样本数不完整等于「这次调用的返回值与承诺不一致」。这又是一个「可解释性优于调度灵活性」的取舍。
等待窗口与批等待都基于「时间」而不是「量」。batch_wait_timeout_ms 与 batch_wait_timeout_iters 都是显式的上限,属于「用时间兜底」的工程做法。它在稳态下工作良好,但在负载突升时会成为延迟的来源:一旦队列里恰好只有一份小批,所有请求都要等这个窗口关。如果要做得更聪明,就需要在准入阶段引入「预测下一步会涌进来多少请求」的信息——这正是 GenAdmissionWaitingQueue 里 AdaptiveSlack 尝试的方向,但它的应用范围目前仍局限于分离式解码。
小结
TensorRT-LLM 的请求准入不是一个函数,而是一串分布在 Python 前端、C++ 传输对象、引擎激活路径和调度器里的决策点。它们各自解决一个「只有在自己这一层才看得清」的问题:
- 前端检查类型、
cache_salt的字节长度和priority范围,负责把明显不合法的请求挡在进程之外; - C++
Request只检查与模型无关的基本约束,保证跨层对象本身是自洽的; ExecutorRequestQueue负责编号、子请求、状态与「空闲才阻塞」的取件策略;WaitingQueue用 FCFS、优先级堆或 TTFT 感知的 slack admission 决定顺序,并支持「退回队首」;- 激活时的
_validate_request把词表、beam width、KV 预算与模型特有约束一次性校验,失败只影响单条请求; - 调度器的 batch waiting 与抢占则说明:准入不是一次性闸门,已准入的请求仍可能被退回、被暂停、再重新竞争。
如果只看单点实现,很容易把 prepend_requests 当成边界处理,把 charge_budget=False 当成一个参数,把 batch_wait_timeout_iters 当成一个无关紧要的循环计数。把它们放进「请求的一生」里,才会看到这三个细节其实共享同一个前提:请求的身份必须稳定,而它的位置可以反复变化。这也是后续阅读调度器、KV 管理器和 P/D 分离代码时最有用的一个视角。
下一篇
本篇把请求从 HTTP 到第一个 token 的准入链条完整打通了。下一步更自然的方向是把「请求被准入之后,调度器如何把一批请求排进一次前向」展开——也就是(三)里容量算术与批次构造的细节,本篇已经把入口留在了 _schedule 与 batch_waiting 处。此外,还可以专门拆开「抢占与回退」:V2 KV 管理器下的 recompute-pause 与 V1 的重算语义究竟差在哪里,以及为什么两者在处理同一类请求时对 paused_requests 的消费方式完全不同。
参考资料
- TensorRT-LLM 官方文档:架构总览
- TensorRT-LLM 官方文档:Disaggregated Serving
- TensorRT-LLM 源码:
tensorrt_llm/executor/request.py - TensorRT-LLM 源码:
tensorrt_llm/executor/requestImpl.h - TensorRT-LLM 源码:
tensorrt_llm/executor/request.cpp - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/executor_request_queue.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/request_utils.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/scheduler/waiting_queue.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/scheduler/gen_admission_queue.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/llm_request.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/py_executor.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/scheduler/scheduler.py - TensorRT-LLM 源码:
cpp/include/tensorrt_llm/batch_manager/llmRequest.h - TensorRT-LLM 源码:
cpp/include/tensorrt_llm/executor/types.h
文中代码片段均摘自 NVIDIA TensorRT-LLM GitHub 仓库的
main分支,图一来自官方文档的架构总览页,图二、图三来自官方 P/D 分离服务文档。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



