


vLLM 源码完全拆解(三十三):算子抽象层与平台分派——一次 RMSNorm 调用如何落到 CUDA、ROCm、TPU 与 Ascend
在一个 671B 参数的 MoE 模型里,每一层至少要做两次 RMSNorm、一次 RoPE、一次 SwiGLU,再加上几十个专家的分组 GEMM 和一次分页注意力的 KV 读写。按 61 层、每层 4 到 6 个算子估算,一个 token 走完一次前向,要发起数百次算子调用;在 decode 阶段,这些调用每个只处理一两行 token,单次耗时常常只有几微秒,调度开销和访存效率同样重要。
这些调用的名字看起来很普通:模型代码里写的是 RMSNorm(x)、SiluAndMul(x)、FusedMoE(...)。但同一个 RMSNorm.forward,在 H100 上会走进手写的 CUDA 内核,在 MI300 上会走 HIP 编译的同一份源码或 AITER 提供的融合实现,在 TPU 上可能退回到 XLA 能编译的 PyTorch 原生表达式,在昇腾 NPU 上则由 out-of-tree 插件提供 CANN 算子,在纯 CPU 环境下会走 PyTorch 的 eager 实现。推理框架必须在一套模型代码、多个硬件后端之间建立稳定的分派机制,否则每接一块新卡就要改一遍模型层。
这篇沿着 vLLM 当前的 platforms/、model_executor/custom_op.py、vllm/ir/、model_executor/layers/ 与 csrc/ 五条源码线,把一次 RMSNorm 调用从模型层一路追到 GPU 内核的发射参数。重点回答四个问题:平台单例是怎么确定的;CustomOp 如何在构造期就把 forward 方法固定下来;新引入的 vLLM IR 为什么要在语义之外再维护一组 provider 实现;以及当 Python 层被 torch.compile 接管时,这套分派还剩多少。
为什么推理框架要自建算子层
PyTorch 已经提供了 torch.nn.functional.layer_norm、torch.nn.functional.silu、torch.bmm 这些算子,从语义上说,vLLM 完全可以拿它们拼出一个正确的模型。问题在于推理场景对每个算子的要求与训练框架不同:形状是动态的(batch 内序列长度从 1 到几万不等)、数据类型经常是 FP8 或 4-bit packed、访存模式围绕分页 KV 展开、单次调用可能只有一个 token。通用算子为了覆盖所有形状和 dtype,往往带多层分发和边界检查,在 decode 这种小算子里,框架开销会超过计算本身。
因此推理框架会为高频路径准备专用内核:RMSNorm 有按 token 一行的向量化实现,SwiGLU 把 gate、up、激活和乘法融成一个 kernel,MoE 有按专家分组的 GEMM,注意力有分页 KV 的专用内核。每多一种硬件,就要多一套内核;每多一种量化格式,就要多一组参数布局。如果模型层直接 import 某个 CUDA 扩展,代码立刻失去可移植性。
vLLM 的解法不是把硬件判断散落在模型代码里,而是抽出两层抽象:一层负责“同一个语义在不同平台上的 Python 方法选择”,另一层负责“同一个算子的语义与多个内核实现之间的选择”。前者是 CustomOp,后者是 vLLM IR。两者最终都把调用落到 torch.ops 上,由 PyTorch 的 dispatcher 把 C++ 函数送进对应的 CUDA、HIP 或 CPU 实现。
全景:从模型层到 torch.ops._C
先看一张自上而下的地图。下表是一次 RMSNorm 调用会经过的层次,以及每层负责做的决策。
| 层次 | 代表模块 | 职责 |
|---|---|---|
| 模型层 | model_executor/layers/layernorm.py | 声明 RMSNorm(nn.Module),在 forward 里调用 ir.ops.rms_norm |
| 平台层 | platforms/__init__.py、platforms/interface.py | 进程启动时确定 current_platform,提供 dispatch key、内核导入与注意力后端选择 |
| 算子对象层 | model_executor/custom_op.py | 按平台选择 forward_cuda、forward_hip、forward_oot,支持 out-of-tree 类替换 |
| 语义与实现层 | vllm/ir/op.py、vllm/ir/ops/、vllm/kernels/ | 定义 native 语义,注册多个 provider 实现,按优先级和参数支持情况分派 |
| 扩展层 | csrc/torch_bindings.cpp、csrc/layernorm_kernels.cu | 用 STABLE_TORCH_LIBRARY 注册 torch.ops._C.rms_norm,在 CUDA dispatch key 下绑定 C++ 启动函数 |
这张表里有两个容易混淆的点,值得先说明。
第一,CustomOp 与 vLLM IR 不是替代关系,而是叠加关系。RMSNorm 本身仍然是 CustomOp 的子类,平台相关的 Python 分支仍然由 CustomOp.dispatch_forward 决定;但在 CUDA 分支内部,forward_native 调用的不是 torch.nn.functional,而是 ir.ops.rms_norm。IR 层再根据优先级挑选 vllm_c、native、oink、aiter 等实现。也就是说,一个算子可能先经过平台方法选择,再经过内核实现选择。
第二,最终的 torch.ops._C.rms_norm 是 C++ 扩展,不是一个 Python 函数。PyTorch 的 dispatcher 会根据张量所在的设备选择 dispatch key,vLLM 在注册时把 CUDA 实现挂在 CUDA key 上,把纯形状检查类函数挂在 CompositeExplicitAutograd 上。这个细节决定了 ROCm 为什么能复用同一份绑定代码。
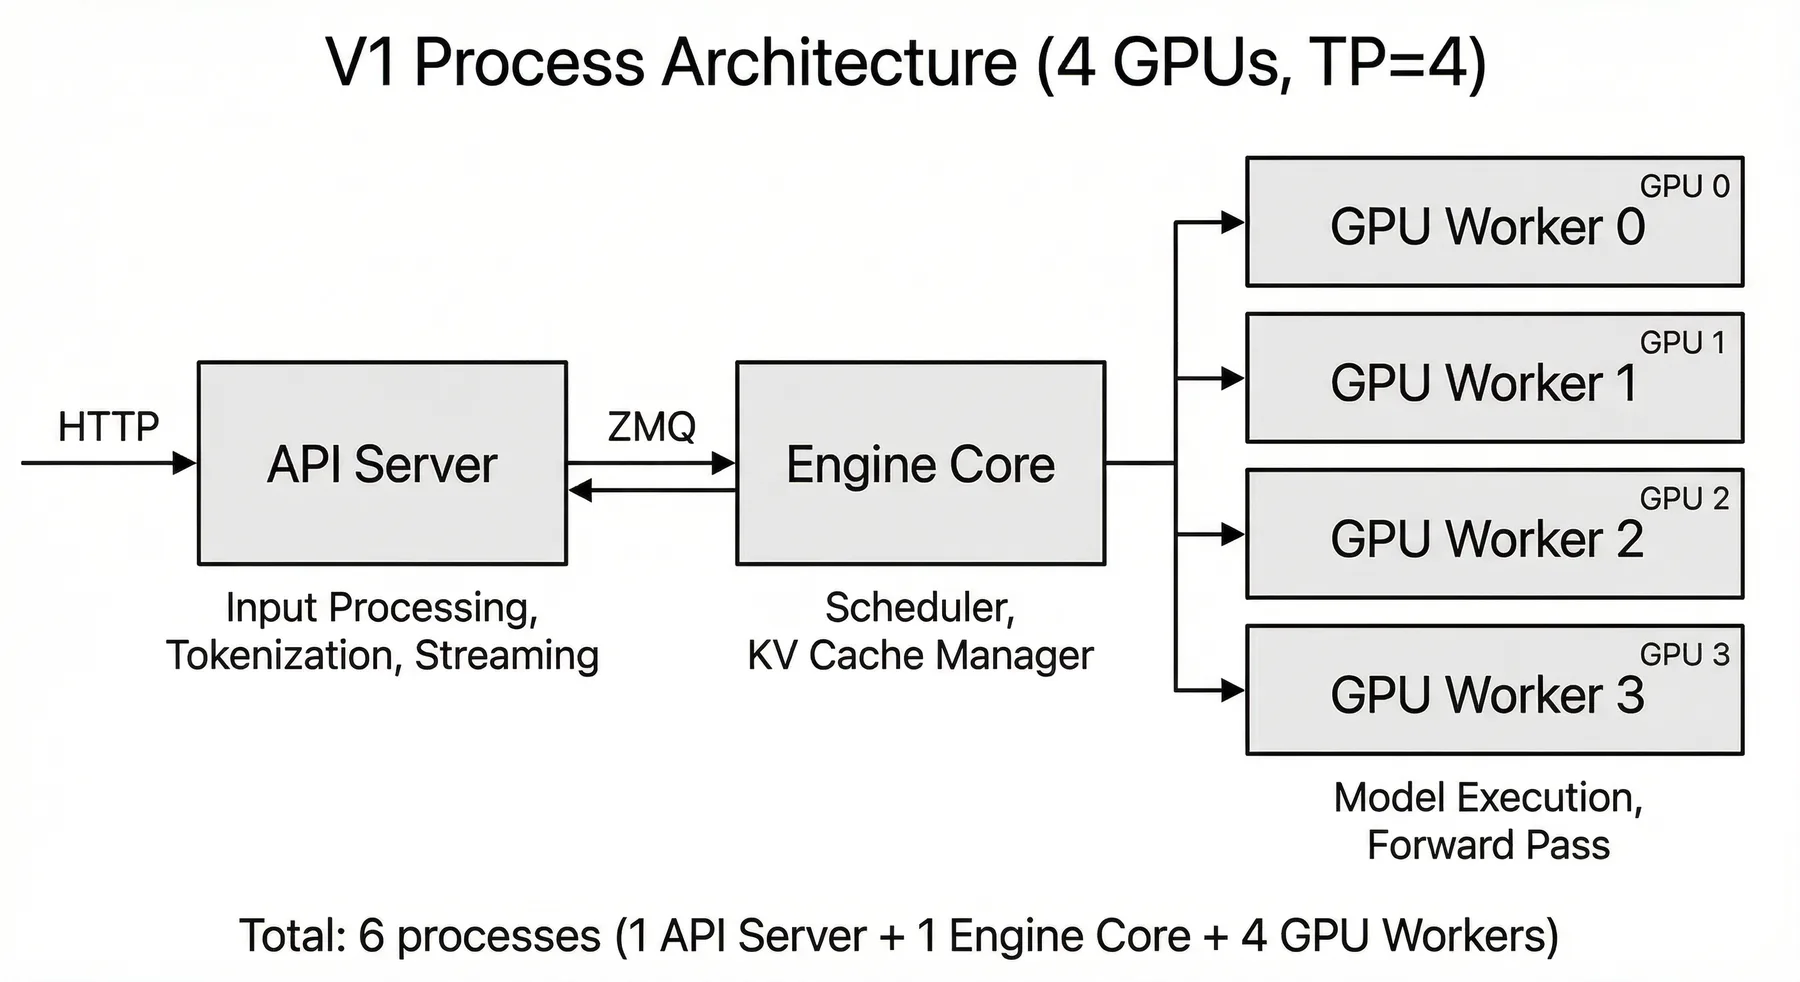
图源:vLLM 官方文档 Architecture Overview,V1 Process Architecture(TP=4)。
从进程视角看,这张图解释了为什么平台分派必须是进程级的:EngineCore 进程负责调度,Worker 进程负责模型执行,每个 Worker 只看到自己那块设备。current_platform 在每个进程里独立初始化,out-of-tree 插件也必须在每个进程里被加载,否则就会出现调度进程认为自己在 CUDA 上、Worker 进程却在另一套后端上的错位。
平台单例:current_platform 是怎么选出来的
vllm.platforms.current_platform 是一个延迟初始化的单例。延迟的原因写在 platforms/__init__.py 的注释里:out-of-tree 平台插件需要 from vllm.platforms import Platform 来继承基类,如果模块导入时就把单例解析出来,插件还没有注册,解析必然失败;另外,vLLM 内部有些模块在 import 阶段就会访问 current_platform,必须保证插件已经加载完。
单例的实现依赖模块级的 __getattr__:
_current_platform = None
def __getattr__(name: str): if name == "current_platform": global _current_platform if _current_platform is None: platform_cls_qualname = resolve_current_platform_cls_qualname() _current_platform = resolve_obj_by_qualname(platform_cls_qualname)() global _init_trace _init_trace = "".join(traceback.format_stack()) return _current_platform elif name in globals(): return globals()[name] else: raise AttributeError(f"No attribute named '{name}' exists in {__name__}.")_init_trace 记录了第一次访问时的调用栈,用来排查“平台为什么被提前初始化”这类问题。这类细节在接入新硬件时很实用:如果插件里的某个 import 触发了 current_platform,栈里会直接显示出来。
真正的选择逻辑在 resolve_current_platform_cls_qualname。它先处理一个特例:VLLM_TARGET_DEVICE=cpu 时直接返回 CPU 平台,不再探测其他插件。注释解释得很清楚:CPU-only 的 CI 任务可能跑在带加速卡的机器上,复用加速卡 wheel,如果继续探测,就会同时激活 CPU 和主机加速卡两个插件。
之后,它把内置探测函数与通过 entry point 注册的 out-of-tree 插件放在同一条链上依次调用:
platform_plugins = load_plugins_by_group(PLATFORM_PLUGINS_GROUP)
for name, func in chain(builtin_platform_plugins.items(), platform_plugins.items()): platform_cls_qualname = func() if platform_cls_qualname is not None: activated_plugins.append(name)内置插件有五个:tpu、cuda、rocm、xpu、cpu。它们的探测方式各不相同,但都遵循同一个约定:能识别出对应硬件就返回平台类的全限定名,否则返回 None。
cuda_platform_plugin通过 NVML 查询设备数量,同时检查 vLLM 是否是用 CPU 版本编译的。后者是为了避免“在 GPU 机器上装了 CPU 版 vLLM”时误判。NVML 不可用时还会检查 Jetson 的/etc/nv_tegra_release。rocm_platform_plugin通过amdsmi查询处理器句柄。WSL 环境下如果amdsmi不可用,会退回到 PyTorch 的torch.version.hip与torch.accelerator.is_available()。xpu_platform_plugin检查torch.xpu.is_available(),并顺便设置分布式后端为xccl。tpu_platform_plugin检查 Pathways 代理或libtpu是否可导入。cpu_platform_plugin检查构建标签、VLLM_TARGET_DEVICE与 macOS;在 AMD Zen 且安装了zentorch时返回ZenCpuPlatform。
选择规则写得很严格:out-of-tree 插件优先。只要激活了一个 OOT 插件,就用它;激活两个 OOT 插件直接抛 RuntimeError,因为一个进程只能有一套硬件语义。没有 OOT 插件时,内置插件也必须恰好激活一个,多了同样报错;一个都没有时落到 UnspecifiedPlatform,后续大部分算子会走 native 路径。
这条规则带来一个实际后果:在昇腾机器上同时装了 CUDA 版 vLLM 和 vllm-ascend 插件时,OOT 插件会赢,即便 NVML 也报告了 GPU。对多硬件共存的开发机,这避免了“插件装了但没生效”的困惑。
Platform 基类定义了一组供上层查询的属性和钩子。最常用的几个是:
dispatch_key:默认"CPU",CudaPlatform覆写为"CUDA"。这个字符串会直接传给torch.library.Library.impl,决定自定义算子注册到哪个 dispatch key。device_type与device_name:用于创建张量、选择设备。supported_dtypes:不同计算能力支持的 dtype 列表,CUDA 平台会按has_device_capability(80)返回 BF16/FP16/FP32,老卡则去掉 BF16。import_kernels():默认实现导入vllm._C,CUDA 平台覆写为导入vllm._C_stable_libtorch、_moe_C_stable_libtorch,并可选导入_qutlass_C。import_ir_kernels():默认导入vllm.kernels,把内置 IR 实现注册进 op registry;OOT 平台应覆写它来注册自己的内核模块。get_attn_backend_cls(...):按选中的注意力后端枚举返回后端类路径,这是注意力层真正的平台分派入口。get_default_ir_op_priority(vllm_config):返回该平台的 IR 优先级默认值。apply_config_platform_defaults(vllm_config)与check_and_update_config(vllm_config):在配置初始化阶段修改默认值或做兼容性检查。
dispatch_key 这个属性值得多说一句。它的默认值是 "CPU",注释写得很明确:对于没有在 PyTorch 里注册 dispatch key 的平台,用 CPU 作为兜底。这个值会被 direct_register_custom_op 使用——当调用方没有显式指定 dispatch key 时,它取 current_platform.dispatch_key,把 Python 函数注册到该 key 上。如果一块新硬件在 PyTorch 里对应 PrivateUse1,但平台类没有覆写 dispatch_key,那么通过 torch.library 注册的算子会被挂到 CPU 上,设备张量调用时可能根本命中不了预期实现。相反,torch.ops._C.rms_norm 这类 C++ 扩展是在编译期按 CUDA key 注册的,不受这个属性影响,两者不要混为一谈。
get_default_ir_op_priority 在基类里返回 ["native"],CudaPlatform 覆写为:使用 inductor 编译时返回 ["native"],eager 或只做 Dynamo trace 时返回 ["vllm_c", "native"]。这条规则的动因会在后面讲编译边界时展开。
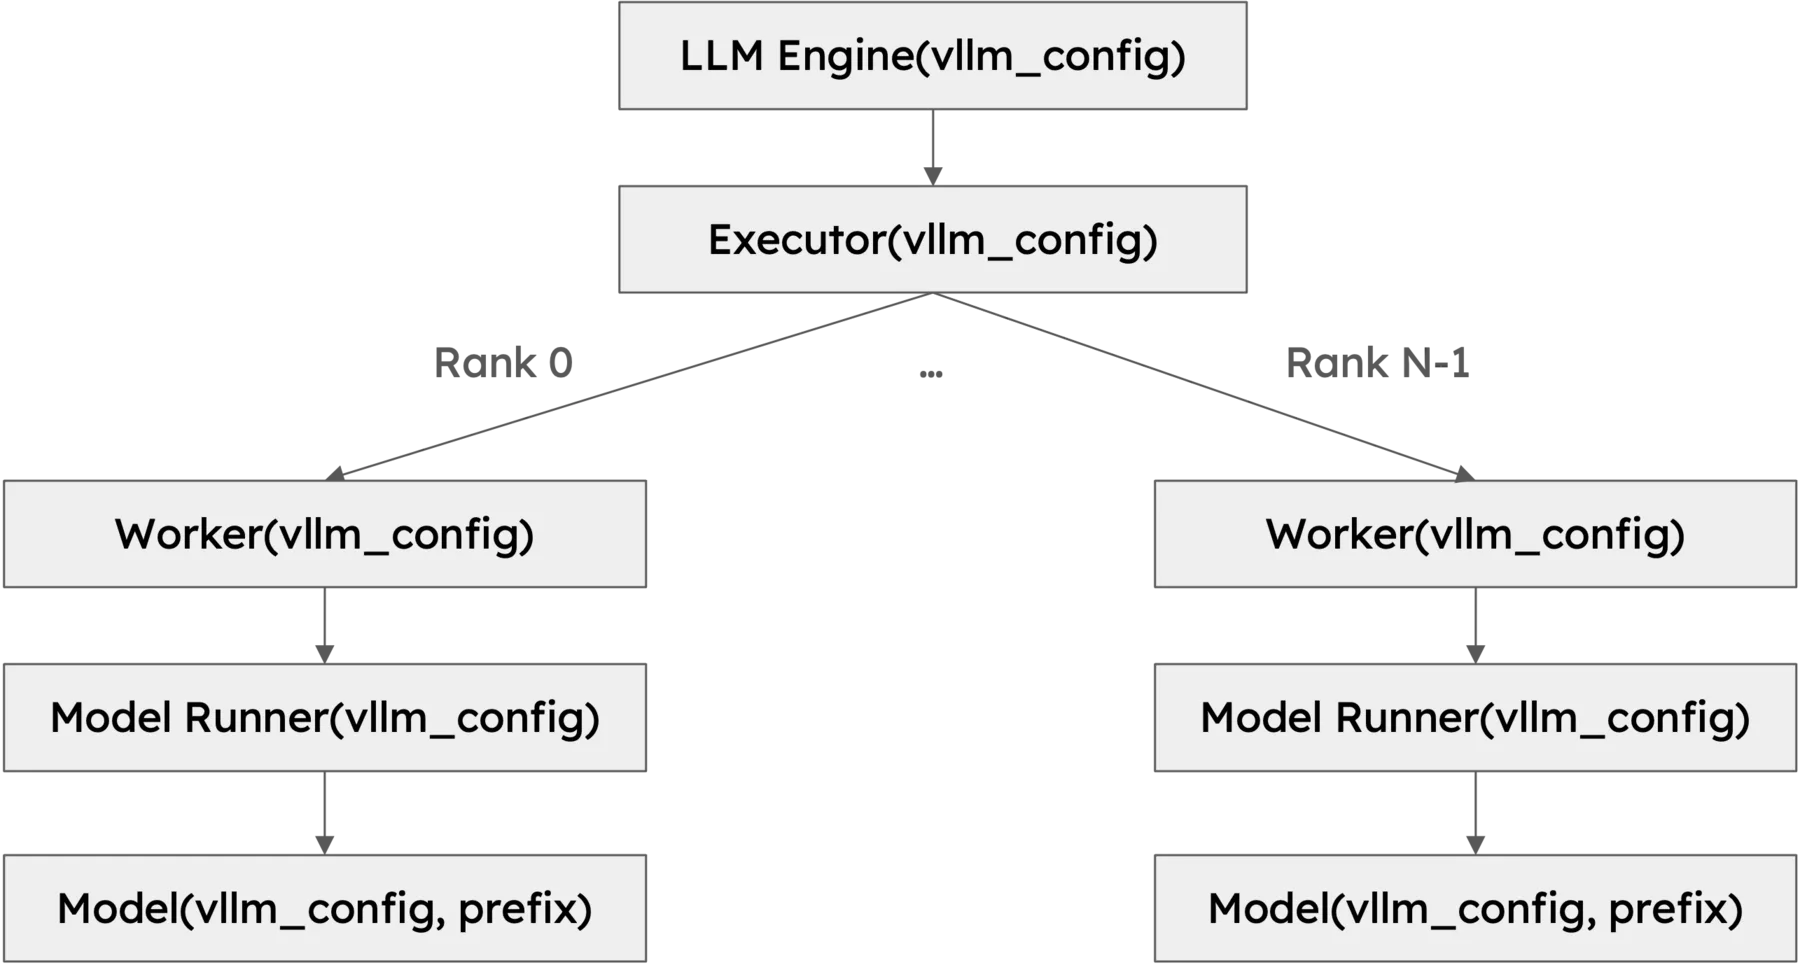
图源:vLLM 官方文档 Architecture Overview,Class Hierarchy。
类层次图里可以看到 Platform 位于最上层,向下依次影响 Executor、Worker 与 ModelRunner。算子层的分派不是孤立的一行 if,而是这条层次结构把“当前设备是什么”一路传到了每一次内核选择。
CustomOp:按平台挑 forward,按编译开关挑实现
CustomOp 是 vLLM 最早的算子抽象,解决的问题很直接:一个 nn.Module 在不同平台上要有不同的 forward 实现,但模型层不应该出现平台判断。
先看它的注册表:
op_registry: dict[str, type["CustomOp"] | type["PluggableLayer"]] = {}op_registry_oot: dict[str, type["CustomOp"] | type["PluggableLayer"]] = {}op_registry 里是 vLLM 自带的算子类,op_registry_oot 里是 out-of-tree 平台注册的替换类,两者都按注册名索引。注册靠装饰器:
@classmethoddef register(cls, name: str, dynamic_arg_dims=None): def decorator(op_cls): assert name not in op_registry, f"Duplicate op name: {name}" op_cls.name = name op_cls._dynamic_arg_dims = dynamic_arg_dims op_registry[name] = op_cls return op_cls return decoratorOOT 替换则用 register_oot,注册名默认取被装饰类的类名:
@classmethoddef register_oot(cls, _decorated_op_cls=None, name: str | None = None): def decorator(op_cls): reg_name = name if name is not None else cls.__name__ assert reg_name not in op_registry_oot op_cls.name = reg_name op_registry_oot[reg_name] = op_cls return op_cls关键的替换发生在 __new__,而不是 forward 里:
def __new__(cls, *args, **kwargs): op_name = cls.__name__ if op_name not in op_registry_oot: op_cls_to_instantiate = cls else: op_cls_to_instantiate = op_registry_oot[op_name] return super().__new__(op_cls_to_instantiate)这意味着模型代码写 RMSNorm(hidden_size) 时,拿到的可能已经是 OOT 平台提供的子类实例。构造完成后,__init__ 再把 forward 绑定到一个具体方法:
def __init__(self, *, enforce_enable=False, compile_native=False): super().__init__() self._enforce_enable = enforce_enable self._forward_method = self.dispatch_forward(compile_native=compile_native)
def forward(self, *args, **kwargs): return self._forward_method(*args, **kwargs)dispatch_forward 做两件事:先决定这个算子是否启用,再按平台选方法。
enabled = self._enforce_enable or self.enabled()if enabled: compilation_config.enabled_custom_ops.update([self.__class__.name])else: compilation_config.disabled_custom_ops.update([self.__class__.name])
if not enabled: return self.maybe_compile(self.forward_native, enable=compile_native)
if current_platform.is_rocm(): return self.forward_hipelif current_platform.is_cpu(): return self.forward_cpuelif current_platform.is_tpu(): return self.forward_tpuelif current_platform.is_xpu(): return self.forward_xpuelif current_platform.is_out_of_tree(): return self.forward_ootelse: return self.forward_cuda几个默认回退值得记住:
forward_hip默认调用forward_cuda,因为 HIP 算子通常与 CUDA 兼容;forward_xpu、forward_cpu、forward_tpu、forward_oot默认调用forward_native;- 最后落到
forward_cuda,所以未识别的平台也会先尝试 CUDA 实现,基类的forward_cuda会抛NotImplementedError,迫使算子作者至少实现一个平台方法。
enabled() 的语义与 CompilationConfig.custom_ops 绑定。这个配置支持 all、none 两种基础模式,以及 +op、-op 形式的逐个开关:
enabled = f"+{cls.name}" in custom_opsdisabled = f"-{cls.name}" in custom_opsif enabled and disabled: raise ValueError("custom_ops cannot both enable and disable ...")return (CustomOp.default_on() or enabled) and not disableddefault_on() 要求列表中恰好有一个基础模式:包含 none 则默认关闭,包含 all 则默认开启。vLLM 在配置初始化时按编译后端补齐这个基础模式:使用 inductor 且编译模式不是 NONE 时默认追加 none,否则追加 all。这条规则非常关键,它解释了为什么同一个模型在 eager 模式下走厂商内核、在 torch.compile 模式下却走 PyTorch 原生算子:inductor 需要看见算子内部的计算,才能做融合;一个不透明的自定义算子会切断融合。
maybe_compile 是为另一种情况准备的:一个 CustomOp 被包在更大的不透明自定义算子内部(例如 fused_moe、unified_attention),模型级编译看不到它内部。此时如果该算子处于“关闭自定义实现”的状态,forward_native 仍然需要被编译,才能避免 eager 下逐个小算子发射。它根据 _dynamic_arg_dims 对指定维度调用 torch._dynamo.mark_dynamic,再以 dynamic=True 编译,减少重编译。代码注释也提醒了边界:这种编译不跨算子融合,因此能用普通算子表达的地方仍应尽量展开。
一个更具体的例子是 SiluAndMul:
@CustomOp.register("silu_and_mul")class SiluAndMul(CustomOp): def __init__(self, *, compile_native: bool = True): super().__init__(compile_native=compile_native) if (current_platform.is_cuda_alike() or current_platform.is_xpu() or (current_platform.is_cpu() and current_platform.get_cpu_architecture() == CpuArchEnum.POWERPC)): self.op = torch.ops._C.silu_and_mul
@staticmethod def forward_native(x): d = x.shape[-1] // 2 return F.silu(x[..., :d]) * x[..., d:]
def forward_cuda(self, x): d = x.shape[-1] // 2 out = torch.empty(x.shape[:-1] + (d,), dtype=x.dtype, device=x.device) self.op(out, x) return out它的内核句柄在构造期就选好了,而不是每次 forward 再判断平台。这是 CustomOp 的典型用法:把平台判断移到初始化阶段,让热路径只剩下一次函数调用。
vLLM 里的层大致有三种形态,选择哪一种取决于需要替换的范围。
- 普通
nn.Module:没有平台差异,或者平台差异已经在内部通过别的机制处理,例如只做张量拼接、形状变换的工具层。 CustomOp:单个算子的 forward 在不同平台上有不同实现,或者需要在编译模式下退回 native。典型例子是RMSNorm、SiluAndMul、RotaryEmbedding。PluggableLayer:整个模块的结构都可能被替换,包括子模块的组合方式、参数初始化、forward 的组织。典型例子是注意力层、MoE 层这类需要厂商重写内部结构的模块。
PluggableLayer 不提供 forward_* 方法分派,它的替换发生在 __new__:只要 OOT 表里有同名类,实例化的就是 OOT 类。这个设计把“换实现”从方法级提升到类级,代价是 OOT 类必须自己保证与基类的接口兼容。对于要改注意力层内部子模块结构的平台,这比在 forward_cuda 里塞一堆条件判断更清晰。
两种替换机制的选择可以归纳成一张对照:
| 需要改变的内容 | 选择 | 代价 |
|---|---|---|
| 单个计算的实现,输入输出语义不变 | IR provider 或 forward_oot | 小,只替换内核 |
| 单个层的 forward 需要不同参数处理或 dtype 推导 | CustomOp.register_oot | 中,OOT 类要跟上基类签名变化 |
| 层内部子模块组合、参数初始化方式要变 | PluggableLayer.register_oot | 大,OOT 类要维护自己的完整实现 |
实际工程里最常见的组合是:核心计算算子用 IR provider,少数语义差异大的算子用 register_oot,注意力和 MoE 用 PluggableLayer。这样既能复用 vLLM 的大部分模型代码,又能让厂商专注于真正不同的部分。
一次 RMSNorm 的完整链路
把上面的抽象串起来,最直观的方式是完整走一遍 RMSNorm。vLLM 当前的 layernorm.py 里,这个类同时用了 CustomOp 和 vLLM IR 两套机制,正好能展示叠加关系。
第一层:CustomOp 注册与方法选择
@CustomOp.register("rms_norm")class RMSNorm(CustomOp): def __init__(self, hidden_size, eps=1e-6, var_hidden_size=None, has_weight=True, dtype=None): super().__init__() self.hidden_size = hidden_size self.variance_epsilon = eps self.variance_size_override = ( None if var_hidden_size == hidden_size else var_hidden_size ) self.pass_weight = has_weight self.pass_weight_add = has_weight ...构造期会注册参数、决定 variance_size_override,并由 CustomOp.__init__ 调 dispatch_forward 绑定平台方法。在 CUDA 上,绑定的是 forward_cuda:
def forward_cuda(self, x, residual=None): if envs.VLLM_BATCH_INVARIANT: ... return rms_norm_batch_invariant( x, self.weight.data if pass_weight else None, self.variance_epsilon, residual=residual, ) return self.forward_native(x, residual)默认路径回到 forward_native,而它已经不再直接写 PyTorch 表达式:
def forward_native(self, x, residual=None): if residual is None: return ir.ops.rms_norm( x, self.weight.data if self.pass_weight else None, self.variance_epsilon, self.variance_size_override, ) return ir.ops.fused_add_rms_norm.maybe_inplace( x, residual, self.weight.data if self.pass_weight_add else None, self.variance_epsilon, self.variance_size_override, )maybe_inplace 是一个值得注意的重载。普通调用保证输入不被修改;maybe_inplace 表示调用者不再使用激活输入,允许实现原地复用输入内存。fused_add_rms_norm 的 C++ 内核正是原地写回 x 与 residual 的。对于 decode 阶段每层都要做一次 residual 加与归一化的模型,这个选择省掉的是整层激活的分配与拷贝。
第二层:vLLM IR 的语义与实现
ir.ops.rms_norm 在 vllm/ir/ops/layernorm.py 里用 @register_op 声明,函数体是一段普通 PyTorch:
@register_opdef rms_norm(x, weight, epsilon, variance_size=None): orig_dtype = x.dtype x = x.to(torch.float32) x_var = x if variance_size is None else x[..., :variance_size] variance = x_var.pow(2).mean(dim=-1, keepdim=True) x = x * torch.rsqrt(variance + epsilon) if weight is not None: x = x.to(weight.dtype) * weight return x.to(orig_dtype)这段代码有三个身份:它是语义定义,规定了形状、dtype 和数值行为;它是默认实现,在所有专用 provider 不可用时兜底;它还是测试基准,其他实现必须与它对齐。
专用实现注册在 vllm/kernels/vllm_c.py:
rms_no_var_size = lambda x, weight, epsilon, variance_size=None: ( variance_size is None and (weight is None or weight.dtype == x.dtype))
@ir.ops.rms_norm.register_impl( "vllm_c", supports_args=rms_no_var_size, supported=GPGPU_DEVICE)def rms_norm(x, weight, epsilon, variance_size=None): assert variance_size is None if IS_ROCM and (x.dim() > 2 or not x.is_contiguous()): original_shape = x.shape x = x.reshape(-1, original_shape[-1]) output = torch.empty(x.shape, device=x.device, dtype=x.dtype) torch.ops._C.rms_norm(output, x, weight, epsilon) return output.reshape(original_shape)
output = torch.empty(x.shape, device=x.device, dtype=x.dtype) torch.ops._C.rms_norm(output, x, weight, epsilon) return output这里的 supported 与 supports_args 是两个不同层次的判断。supported 是静态的平台判断,GPGPU_DEVICE 在 CUDA 类、XPU 上为真;supports_args 是动态的参数判断,vLLM 的 C 内核不支持 variance_size 覆盖,也要求输入与权重的 dtype 一致,不满足时会跳到下一个 provider。ROCm 分支则补上了内核只接受连续二维张量这一限制:高维或非连续的输入先展平,算完再恢复形状。
第三层:C++ 扩展与 CUDA 内核
torch.ops._C.rms_norm 的 schema 定义在 csrc/torch_bindings.cpp:
STABLE_TORCH_LIBRARY_FRAGMENT(_C, ops) { ops.def( "rms_norm(Tensor! result, Tensor input, Tensor? weight, float epsilon) " "-> ()"); ops.def( "fused_add_rms_norm(Tensor! input, Tensor! residual, Tensor? weight, " "float epsilon) -> ()");}Tensor! 表示这个参数会被原地修改。CUDA 实现挂在 CUDA dispatch key 上:
STABLE_TORCH_LIBRARY_IMPL(_C, CUDA, ops) { ops.impl("rms_norm", TORCH_BOX(&rms_norm)); ops.impl("fused_add_rms_norm", TORCH_BOX(&fused_add_rms_norm));}csrc/layernorm_kernels.cu 里的 C++ 启动函数负责把张量形状翻译成网格与线程块:
void rms_norm(torch::stable::Tensor& out, torch::stable::Tensor& input, std::optional<torch::stable::Tensor> weight, double epsilon) { STD_TORCH_CHECK(out.is_contiguous()); if (input.stride(-1) != 1) { input = torch::stable::contiguous(input); }
int hidden_size = input.size(-1); int num_tokens = input.numel() / hidden_size; ... const bool batch_invariant_launch = vllm::vllm_is_batch_invariant(); const int max_block_size = batch_invariant_launch ? 1024 : ((num_tokens < 256) ? 1024 : 256); dim3 grid(num_tokens); ... const int calculated_vec_size = std::gcd(16 / sizeof(scalar_t), hidden_size); const int block_size = std::min(hidden_size / calculated_vec_size, max_block_size); ... vllm::rms_norm_kernel<scalar_t, vec_size, tensor_rank, true> <<<grid, block, 0, stream>>>(out..., input..., strides..., weight_ptr, weight_stride, epsilon, num_tokens, hidden_size);}几个参数的含义值得解释:
grid = num_tokens:一个 block 处理一行,RMSNorm 的归约只在 hidden 维内进行,行与行之间没有依赖;vec_size = gcd(16 / sizeof(scalar_t), hidden_size):尽量凑出 16 字节的向量化访存,同时保证能整除 hidden_size,避免尾部处理;block_size = min(hidden_size / vec_size, max_block_size):每个线程处理一个向量块;token 数很多时把 block 压到 256,以提高 SM 并发;token 数少于 256 且非 batch-invariant 时允许 1024,减少 block 内空转;batch_invariant_launch固定用 1024:batch-invariant 模式要求同一行在 batch 大小变化时得到逐位一致的结果,归约顺序不能随 block 大小变化,所以发射参数被锁死。
内核模板还按 tensor_rank 分成 2、3、4 维三个版本,并传入 stride(-2)、stride(-3)、stride(-4)。这不是为了支持任意形状,而是为了接住 QKV 投影切出来的非连续视图:Q、K、V 常常是同一个大张量的切片,最后一维连续、行间步长不为 hidden_size。把步长传进内核,比在 Python 层做一次 contiguous() 拷贝便宜得多。
同一链路的其他终点
这条链路在不同平台上会换掉最后一段:
- ROCm 复用同一份
layernorm_kernels.cu源码编译出 HIP 内核,IS_ROCM分支在 provider 层把高维、非连续输入规范化;如果 AITER 可用,IR 优先级可以把aiter排在vllm_c前面,直接走 AITER 的融合实现。 - XPU 平台在 eager 或只做 Dynamo trace 时按官方设计文档的默认优先级使用
xpu_kernels,在 inductor 编译下与 CUDA 一样退回native,把表达式交给编译器。 - TPU 平台沿用基类默认的
native,让 XLA 去编译这段由pow、mean、rsqrt组成的表达式。XLA 对这类逐元素加归约的模式很擅长,手写内核未必更快。 - CPU 平台默认同样走
native;POWERPC 等有专用向量指令的平台可以在forward_cpu里选择_C实现。 - 昇腾等 OOT 平台通过
import_ir_kernels注册自己的 provider,或者用register_oot替换整个RMSNorm类,把调用接到 CANN 算子。
同一条 RMSNorm 语义,最后落到五种以上不同的执行路径,但模型层只写了一次 ir.ops.rms_norm。这就是算子抽象层的价值。
vLLM IR:语义与实现分离的第二代设计
CustomOp 的分派粒度是“平台上的 Python 方法”。它解决了一个算子要在 CUDA 与 CPU 上有不同写法的问题,但没有解决另一个问题:CUDA 上也可能有多个内核实现,谁快用谁;同一个平台的不同编译模式下,最优实现也可能不同;out-of-tree 厂商想给现有算子加一个新实现,不应该被迫替换整个类。
vLLM IR 就是为这组需求设计的。它把算子拆成“一个语义定义”和“多个具名实现”,并在调用时按优先级挑选。
声明:语义只写一次
@register_op(allow_inplace=True)def fused_add_rms_norm(x, x_residual, weight, epsilon, variance_size=None): orig_dtype = x.dtype x = x.to(torch.float32) x = x + x_residual.to(torch.float32) x_residual = x.to(orig_dtype)
x_var = x if variance_size is None else x[..., :variance_size] variance = x_var.pow(2).mean(dim=-1, keepdim=True) x = x * torch.rsqrt(variance + epsilon) if weight is not None: x = x.to(weight.dtype) * weight return x.to(orig_dtype), x_residualregister_op 的签名里有两个参数控制后续行为。activations 默认取所有以 x 开头的参数名,用来标记“哪些输入可能在原地实现中被复用”;allow_inplace=True 会额外生成一个 maybe_inplace 重载,允许实现原地写回这些激活。
IrOp.__init__ 做了几件容易被忽略但很重要的事:
- 禁止 keyword-only 参数,因为 lowering 阶段需要按位置参数重放实现;
- 用
infer_schema从原生函数推导 torch op schema; - 把 native 实现注册为
impls["native"],并把 fake 实现默认指向 native; - 把 op 注册进
torch.library.Library("vllm", "FRAGMENT"),dispatch key 用CompositeExplicitAutograd,同时注册_register_fake。
CompositeExplicitAutograd 的选择有明确理由:它不会被 ATen IR 的规范化过程自动分解,因此在 AOTAutograd 之前仍以高层算子出现在图里,vLLM 的自定义融合 pass 才能按一个简单模式匹配整个 rms_norm,而不是去匹配 pow、mean、rsqrt 这一串底层算子。
实现:provider、支持判断与优先级
注册实现时,每个 provider 必须提供与 native 完全一致的签名,IrOpImpl.__init__ 会用 infer_schema 重新推导并逐字比较:
schema = infer_schema(impl_fn, mutates_args=[])if schema != op._schema_str: raise ValueError( f"Implementation for provider {provider} has schema '{schema}' " f"which does not match native schema '{op._schema_str}' ..." )这条校验避免了“实现函数多一个默认参数、少一个默认值”导致的静默错配。supports_args 也被要求参数名、默认值与 native 一一对应,这样 dispatch 热路径可以直接按位置传参,不需要再做名字解析。
一个实现是否会被选中,要过两道门:
supported:静态判断,通常在注册时求值,例如current_platform.is_cuda_alike()或某个第三方库是否可导入;supports_args:动态判断,每次调用时根据实际参数决定,例如 dtype 是否匹配、是否使用了variance_size覆盖、张量是否连续。
优先级是一个字符串列表:
@ir.ops.rms_norm.register_impl( "vllm_c", supports_args=rms_no_var_size, supported=GPGPU_DEVICE)它的顺序由 KernelConfig.ir_op_priority 决定。平台在配置初始化阶段提供默认值,CudaPlatform 的默认值又依赖编译模式:eager 时 ["vllm_c", "native"],inductor 编译时 ["native"]。用户可以在命令行用 --ir-op-priority.rms_norm=vllm_c 覆盖,用户列表会排在平台默认值前面。
配置初始化完成后,IrOpPriorityConfig.set_default() 会把每个字段安装到对应的 IrOp 上:
def set_default(self) -> None: """Permanently set the IR op priority for all op members.""" for ir_op, op_priority in self._iter_op_priorities(): ir_op.set_default(op_priority)_iter_op_priorities 先调用 current_platform.import_ir_kernels() 确保 provider 已注册,再按字段名到 IrOp.registry 里找到对应的算子对象。字段名与算子名一一对应,这是这套配置能自动生效的前提。
安装动作发生在 Worker 初始化阶段,而不是每次 forward。set_default 内部会调用 _filter_priority_impls,把静态不支持与永远轮不到的 provider 提前剔除,所以热路径上的 dispatch 只需要顺序检查 supports_args。这也意味着优先级是进程级的全局状态,同一个进程里不同模型不能使用不同的优先级列表;需要并存的场景必须拆进程。
_filter_priority_impls 会在安装优先级时先筛一遍:跳过 supported=False 的实现;遇到 supports_all_args=True 的实现就停止,因为后面的实现再也不可能被选中;如果所有实现都不保证支持全部参数,会在末尾补上 native 并打一条警告。这样 dispatch 在热路径上只需要顺序检查 supports_args,不必担心没有兜底。
原地实现与函数式语义
推理内核经常原地写回,但编译器和框架期望算子满足函数式语义。IR 用两层机制调和这个矛盾。
第一层是调用端的 maybe_inplace 重载。它告诉框架“这些激活可以被捐赠”。调用者如果还需要原值,必须自己 clone。
第二层是 func_impl_fn。当实现声明 inplace=True 时,它在调用前克隆激活参数:
def func_impl_fn(self, *args, **kwargs): if not self.inplace: return self.impl_fn(*args, **kwargs)
new_args = list(args) for i in self.op.activation_indices: new_args[i] = args[i].clone() return self.impl_fn(*new_args, **kwargs)于是同一个 vllm_c 的 fused_add_rms_norm 既可以被原地调用以省内存,也可以在必须保留输入时自动退化为“克隆再原地”。编译路径下,lowering pass 会做同样的事,并在后续的 clone 清理 pass 中,根据“输入是否由图中创建且不再使用”以及“是否是标记为捐赠的图参数”把多余克隆删掉。
IrOpImpl.uuid() 还承担了缓存失效的职责:它哈希实现函数所在的源文件。内核实现改动后,编译缓存键随之变化,不会错误复用旧图。
为什么它被标记为弃用
需要如实说明:截至当前 main 分支,vLLM IR 已经被标记为弃用。KernelConfig.ir_op_priority 的注释写明它会在 v0.34.0 移除,官方设计文档也写明“不要再把新算子移植到 vLLM IR”,--ir-op-priority 仍然可用但会打印警告。方向是让内核继续由平台来选择,回到与其他 custom op 一致的机制。
这并不妨碍读它。它把“语义与实现分离”的设计空间展示得很完整:多个 provider、静态与动态支持判断、优先级、原地与函数式语义的调和、编译缓存哈希。这些正是任何推理框架在做算子层时都会遇到的问题。理解了这套设计,再回头看 CustomOp 的类替换与平台方法分派,就能判断哪些能力是长期需要的,哪些只是过渡形态。
第三个维度:量化格式如何进入分派
平台与编译模式并不是内核选择的全部。同一个 CUDA 平台上,一个 Linear 可能走 BF16 的 cuBLAS、FP8 的 CUTLASS scaled GEMM、INT4 的 Marlin、AWQ 的 dequant 内核,或者某套 Triton 实现。决定这件事的是权重格式,而权重格式来自 checkpoint。
这条链路从 LinearBase.__init__ 开始:
if quant_config is None: self.quant_method = UnquantizedLinearMethod()elif quant_method := resolve_quant_method(quant_config, self, prefix=prefix): self.quant_method = quant_methodresolve_quant_method 先按模块前缀向 QuantizationConfig 询问“这一层用什么方法”,再叠加在线量化配置。方法一旦确定,后面三件事都交给它:
create_weights(...):声明这一层有哪些参数。BF16 层只有weight;FP8 层多出 per-tensor 或 block 的weight_scale_inv;GPTQ/AWQ 还有qzeros、scales。参数对象上带着各自的weight_loader,决定按 TP rank 切哪一段。process_weights_after_loading(...):把 checkpoint 布局整理成内核布局。FP8 需要转置成列主序、合并融合层的多个 scale;4-bit 权重需要按 Marlin 的 tile 重排。apply(...):真正的前向分派,按格式与运行时形状选择cutlass_scaled_mm、marlin_gemm、awq_gemm、per_token_group_quant等内核。
这条轴与 IR 的优先级轴很像,但粒度不同。IR 是按“算子”维护一个全局优先级列表;量化是按“层”在构造期绑定一个方法对象,方法内部再根据格式、dtype、group size 与平台支持列表选内核。平台在这里的作用是给出 supported_quantization 列表,提前拒绝不支持的格式;真正的内核选择仍然发生在量化方法内部。
因此读 vLLM 的算子分派时,至少要区分三种选择:平台方法选择(CustomOp)、算子实现选择(IR 或量化方法内部)、编译路径选择(custom_ops 开关)。三者可以同时生效,例如一个 FP8 的 RMSNorm 在 CUDA 上可以先经过 forward_cuda,再走 vllm_c provider,最后因为启用了 inductor 而被替换成可融合的原生表达式。
初始化顺序:算子为什么必须在建壳前注册
算子的注册与绑定发生在多个 import 阶段,顺序错了会出现“类存在但内核没有”“平台是 CUDA 但 _C 没导入”这类问题。把关键节点按时间排开,会更容易排查。
| 阶段 | 发生的事 | 如果顺序错了 |
|---|---|---|
| 进程启动 | vllm 包导入,vllm.platforms 尚未解析单例 | 过早访问 current_platform 会让 OOT 插件来不及注册 |
| 首次访问平台 | 加载 vllm.platform_plugins,探测内置插件,实例化 Platform | 插件未加载时落到内置平台或 Unspecified |
| 导入算子模块 | layernorm.py 顶部 import vllm.kernels,触发 IR provider 注册 | 没有 provider 时 IR 只能退回 native |
| 导入平台内核 | vllm/kernels/vllm_c.py 顶部调用 current_platform.import_kernels() | torch.ops._C 不存在,第一次调用即报错 |
| 构建模型壳 | 每层 CustomOp.__init__ 读取 CompilationConfig 并绑定 forward | 配置未初始化时无法判断 custom op 开关 |
| 装载权重 | 量化方法按 create_weights 声明的参数清单填充张量 | 参数清单与 checkpoint 对不上,装载报缺参 |
| 装载后处理 | process_weights_after_loading 重排布局、合并 scale | 内核读到错误布局,结果不对或直接崩 |
| 首次前向 | IR 按优先级 dispatch,_C 执行内核 | 优先级未安装时退回 native,性能异常 |
有两个细节值得单独说。
layernorm.py 顶部那行 import vllm.kernels # noqa: F401 看起来像无用导入,实际上是注册副作用:导入 vllm.kernels 会依次导入 vllm_c、aiter_ops、oink_ops 与 Triton 相关模块,这些模块在 import 时执行 register_impl。如果没有这行,模型层第一次调用 ir.ops.rms_norm 时,provider 表里可能只有 native。
vllm/kernels/vllm_c.py 顶部的 current_platform.import_kernels() 同理。它确保在注册 vllm_c provider 之前,torch.ops._C.rms_norm 已经存在;否则 provider 虽然注册成功,第一次调用仍会在 torch.ops._C 上失败。把“导入扩展”和“注册 provider”放在同一个模块的导入期,顺序天然正确,也避免了运行时的懒加载分支。
还有一条容易忽视的约束:CustomOp 的 forward 方法在构造期绑定,enabled() 也在构造期求值。模型建好之后再修改 compilation_config.custom_ops,不会改变已经实例化的层。做 A/B 对比时要重新建模型,而不是在同一个进程里改配置再跑第二次。
平台抽象管不到的地方
Platform 是一层粗粒度的门,它回答“这台机器属于哪类硬件”“支持哪些 dtype 与量化格式”“默认注意力后端候选是谁”。它不回答“这一层该用哪个内核”。后者由各自的 selector 决定,平台只提供候选与校验。
注意力层是一个典型例子。Platform.get_attn_backend_cls(selected_backend, attn_selector_config, num_heads) 返回后端类路径,但选择逻辑要考虑用户显式指定的后端、head size、dtype、是否使用 MLA、是否启用分页、KV cache dtype、是否要求确定性。同一个 CUDA 平台上可能同时存在 FlashAttention、FlashInfer、Triton 与 FlexAttention 后端,具体选哪个由 AttentionSelectorConfig 与后端自身的支持矩阵决定。平台做的是“把不可能的后端排除掉”,而不是“替每一层做最终选择”。
MoE 层类似。moe_backend 配置可以在 Triton、CUTLASS、FlashInfer、DeepGEMM 等实现之间切换,平台负责校验该后端在当前设备上是否可用,层内部再按专家数、top-k、dtype、EP 规模与 token 分布选择分组 GEMM 或 fused kernel。
量化层也一样:平台给出 supported_quantization,量化方法内部再按 group size、是否有 zero point、是否需要 act quant 选择具体 kernel。
理解这个分工,能避免一个常见误解:以为把平台插件接好、supported_quantization 列表填对,所有算子就会自动用上厂商最优内核。实际上每个子系统都有自己的选择器,平台只是第一道闸门。vLLM IR 的优先级列表是试图把这类选择统一起来的一种尝试,但它只覆盖了 rms_norm、fused_add_rms_norm、gelu_and_mul_sparse 等少数算子,注意力和 MoE 仍然沿用各自的机制。
编译边界:custom op、Triton 与 inductor
推理框架的算子分派与 torch.compile 之间存在直接冲突。自定义算子是图上的一个黑盒,inductor 看不到内部,就无法把 RMSNorm 与后面的量化、把 SiLU 与后面的乘法融合成一个 Triton kernel。vLLM 的取舍写在 CompilationConfig.custom_ops 的默认值里:使用 inductor 时默认关闭 CustomOp,让 forward_native 里的 PyTorch 表达式暴露给编译器;eager 时默认开启,走厂商内核。
vLLM IR 试图把这件事做得更细。官方设计文档描述的流水线是:
模型前向 → Dynamo 追踪:vllm_ir.* 作为不透明 custom op 进入 FX 图 → pre-grad:把 maybe_inplace 改写成 default,记录被捐赠的输入 → AOTAutograd:函数化 → post-grad:高层 IR 融合 pass(如 allreduce + rms_norm) → post-grad:IR lowering,把每个 IR op 换成选中的实现 → clone 清理:根据捐赠信息删掉多余克隆 → inductor:常规的模式匹配、融合、内存规划与代码生成这条流水线的关键在于 lowering 发生的时机。Dynamo 阶段保留高层语义,融合 pass 可以按一个 rms_norm 节点做匹配;到了 lowering 阶段,再用 fake tensor 作为参数代入选中的实现,通过 make_fx 把实现函数展开成一组底层算子。展开后插入的克隆,会在 clone 清理阶段被删掉。
编译路径下 supports_args 的判断依据是 fake tensor,而不是真实张量。这意味着支持判断只能依赖形状、dtype、stride 这类元数据,不能依赖张量的实际数值。写 provider 的 supports_args 时需要遵守这个约束,否则 eager 与编译两条路径会给出不同的选择。
图源:vLLM 官方博客 vLLM V1: A Major Upgrade to vLLM’s Core Architecture。
另外两个细节也影响分派行为。
CustomOp.maybe_compile 只编译被包在不透明算子内部的原生实现。它不能跨算子融合,所以注释明确说“能用普通算子表达的地方应尽量展开”。如果一个融合算子内部又塞了十几个小算子,编译只能减少每个小算子的发射开销,拿不到跨算子融合的收益。
IrOp.uuid 与 KernelConfig.ir_op_priority.compute_hash 一起参与编译缓存键。优先级列表变了、某个 provider 的实现源码变了,缓存都会失效。这条机制保证了“换了内核实现但复用了旧编译产物”这类难以排查的问题不会发生。
out-of-tree 平台如何接管
vLLM 的硬件插件机制在 2025 年 5 月由社区与昇腾团队推动成型。它的目标是把 Executor、Worker、ModelRunner、Attention Backend 与 Communicator 的实现从主仓库里解耦出去,让新硬件以独立 Python 包的形式接入。
接入点是一个标准 Python entry point,组名固定为 vllm.platform_plugins:
setup( name="vllm_ascend", entry_points={ "vllm.platform_plugins": [ "ascend = vllm_ascend:register", ], },)register 函数返回平台类的全限定名。vLLM 启动时,load_plugins_by_group 用 importlib.metadata.entry_points 枚举该组下的所有插件,逐个调用注册函数;随后 resolve_current_platform_cls_qualname 按前面说的规则选中唯一的 OOT 平台。
插件会被加载到 vLLM 创建的每个进程里,包括 EngineCore 与各个 Worker。这一点很关键:调度进程要用平台信息决定块大小、注意力后端与可用 dtype,Worker 进程要用平台信息导入内核。VLLM_PLUGINS 环境变量可以按名字过滤插件,便于在同一台机器上切换后端。
一个 OOT 平台通常要覆写这些钩子:
import_kernels():导入厂商编译的 C/C++ 扩展,让torch.ops下出现对应算子;import_ir_kernels():导入注册了 IR provider 的模块,或直接调用ir.ops.<name>.register_impl;get_attn_backend_cls(...):返回厂商的注意力后端类路径;get_default_ir_op_priority(...):给出厂商内核与 native 的优先级顺序;apply_config_platform_defaults(...)与check_and_update_config(...):改写默认配置、校验不兼容项;pre_register_and_update(parser):在配置初始化之前注册 out-of-tree 量化方法或修改命令行参数;register_oot装饰器:替换单个CustomOp或PluggableLayer类。
PluggableLayer 是 CustomOp 的模块级对应物。它不提供 forward_* 的平台分派,而是在实例化时替换整个层类,适用于需要自定义子模块组合与初始化的场景,例如更换注意力层的内部结构、替换 MoE 层的专家组织方式。CustomOp.__new__ 与 PluggableLayer.__new__ 都查同一张 op_registry_oot 表,但键分别是算子名与层类名。
一个最小骨架大致是这样。它不依赖 vLLM 主仓库的任何私有接口,只用到前面读过的基类钩子:
from vllm.platforms import Platform, PlatformEnum
class MyPlatform(Platform): _enum = PlatformEnum.OOT device_name = "myaccel" device_type = "myaccel" dispatch_key = "PrivateUse1" # PyTorch 已注册该后端时才这样写 supported_quantization = ["fp8", "compressed-tensors"]
@classmethod def import_kernels(cls): import myaccel_vllm._C # 注册 torch.ops.myaccel_C
@classmethod def import_ir_kernels(cls): from . import kernels # 模块内调用 register_impl return kernels
def register(): return "my_platform:MyPlatform"对应的 entry point 写 my_platform = my_platform:register 即可。register 返回的是平台类路径,不是类对象,这样 vLLM 可以在确定插件唯一性之后再导入它,避免两个插件在导入期互相干扰。
如果厂商只提供了少量算子,也可以不写完整的 Platform 子类,而是在现有算子上注册 OOT 实现。例如用 @CustomOp.register_oot(name="RMSNorm") 替换整类,或调用 ir.ops.rms_norm.register_impl("myaccel", supported=True) 增加一个 provider。前一种方式适合算子语义本身不同、需要额外参数或子模块的场景;后一种方式适合语义一致、只是内核不同的场景。选择哪一种,取决于厂商实现是否需要改变层的构造行为。
需要提醒的是基类默认值:forward_oot 默认调用 forward_native。这意味着 OOT 平台如果只是注册了插件、没有覆写具体算子,运行时会静默落到 PyTorch 原生实现,性能可能远低于预期,但结果仍然正确。排查性能问题时,先确认厂商扩展是否真的被 import_kernels() 导入、对应算子是否真的注册了 forward_oot 或 IR provider,比盯着调度器更有效。
一条 decode 路径上的账:分派结果为什么会差出几毫秒
前面的机制听起来只是“选哪个函数”,落到 decode 阶段会变成实实在在的时间。举一个只做数量级估算的例子,假设模型 61 层、hidden size 7168、decode batch 为 32、每层做两次 RMSNorm,且不使用 torch.compile。
forward_native 的表达式会被 eager 模式拆成一组 ATen 算子:转 FP32、平方、按行求均值、加 epsilon、开方取倒数、乘回、按权重缩放、转回原 dtype。即使编译器能消掉一部分,实际执行的 kernel 数量仍在 6 到 8 个之间。vllm_c 的实现是单个内核,一次发射完成全部计算。
按每层节省 6 次发射、61 层、两次 RMSNorm 计算,一个 decode step 少掉的 kernel 发射约为:
单次小内核的端到端间隔按 1.5 到 4 微秒估算,对应的墙钟差异在 1.1 到 2.9 毫秒之间。这个数字对 decode 来说并不小:一个 32 并发、每步输出一个 token 的服务,如果单步总耗时是 20 毫秒,2 毫秒就是 10% 的吞吐差异。
但这笔账有两个前提。第一,发射开销能否被隐藏。GPU 队列很深时,CPU 端的发射可以与上一批计算重叠;当 CPU 成为瓶颈,节省的发射次数直接转化为吞吐。第二,batch 很小时计算量极小:32 行、7168 列的 RMSNorm 单程约 458KB 的 BF16 数据,读加写接近 0.9MB,在 3TB/s 带宽下只要约 0.3 微秒,内核时间几乎全被固定开销占据。反过来,prefill 阶段一个 batch 处理上万 token,计算与访存占主导,少几次发射的收益就被摊薄。
这也解释了编译路径的取舍。torch.compile 打开后,forward_native 里的那串算子会被 inductor 融合成一到两个 Triton kernel,发射次数与 vllm_c 相当,还能和相邻的量化、残差加法继续融合。此时继续启用 CustomOp 反而会切断融合,所以 vLLM 默认在 inductor 模式下关闭它。
验证方法比估算更可靠:用 torch.profiler 抓一个 decode step,按 kernel 名统计发射次数与 GPU 时间;或者在 nsys 里看每层之间的空隙。如果空隙主要来自 aten:: 系列小算子,说明当前走的是 native 路径;如果每层只有一个 rms_norm_kernel,说明厂商内核生效;如果看到大量 triton_ 前缀的融合内核,说明编译路径接管了这段计算。
调试与验证
算子分派出问题时,现象往往很分散:模型能跑但慢、某种 dtype 下结果不对、某个平台启动即报 AttributeError。下面几条路径可以快速定位。
先确认平台:
python -c "from vllm.platforms import current_platform as p; print(p, p.device_type, p.dispatch_key)"如果要看平台是在哪里被初始化的,可以读取 vllm.platforms._init_trace,它保存了第一次访问时的调用栈。插件没有生效时,这个栈通常能指出是哪个模块提前触发了初始化。
再确认算子注册:
python - <<'PY'from vllm.model_executor.custom_op import op_registry, op_registry_ootprint(sorted(op_registry)[:10])print(sorted(op_registry_oot))PYop_registry_oot 为空,说明 OOT 类替换没有发生;op_registry 里没有目标算子,说明对应模块没有被导入,常见于只导入了模型壳、没有触发 layers/__init__ 的场景。
然后确认编译开关。想在 eager 下强制使用厂商内核,可以把 custom_ops 设成只启用目标算子:
vllm serve <model> --compilation-config '{"custom_ops": ["none", "+rms_norm"]}'反过来,怀疑某个内核有问题时,可以禁用单个算子,让它退回 native:
vllm serve <model> --compilation-config '{"custom_ops": ["all", "-rms_norm"]}'注意 all 与 none 只能出现一个,同时出现 +op 与 -op 会直接报错。
常见的报错与含义:
Failed to import from vllm._C_stable_libtorch:扩展没有编译、ABI 与当前 PyTorch 不匹配,或动态库依赖缺失。CUDA 平台导入的是 stable ABI 版本,ROCm 构建会走另一条源码编译路径。module 'torch.ops' has no attribute '_C':扩展没有被提前导入。Platform.import_kernels()的职责就是在模型构建前完成这件事;自定义启动脚本如果绕过了 vLLM 的初始化流程,容易出现这个问题。Duplicate op name或Duplicate layer name:同一个注册名被注册两次,常见于插件被重复加载,或两个 OOT 包注册了同名类。does not match native schema:IR 实现签名与语义定义不一致,多一个参数、少一个默认值都会触发。Priority set incorrectly: the last implementation must support all args:优先级列表里最后一个实现也不能保证支持当前参数,且没有 native 兜底。修复方式是把支持面最广的实现放到末尾,或显式加入native。Implementation ... not supported:优先级列表里包含了一个静态supported=False的实现。_filter_priority_impls通常会在安装时过滤掉它,但手工set_priority或平台默认值写错时仍可能遇到。
IR 还提供了一个对内核开发很有用的测试设施:register_input_generator 与 override_tolerance。每个 IR op 可以注册一个按 num_tokens、hidden_size、dtype 生成随机输入的生成器,并覆盖特定 dtype 的容差。rms_norm 就把 FP16 的容差放宽到 atol=1e-2, rtol=2e-3,因为大形状下的归约会累积舍入误差,默认容差会让几百万个元素里的少数几个误报。这套设施让“新 provider 是否与 native 语义一致”可以自动化验证,而不必靠人眼比对。
除了这些运行时手段,还有几条编码层面的检查值得在接入新算子时固化下来。
第一,provider 的 supports_args 必须能在 fake tensor 上求值。它经常会被写成 x.dtype == torch.float8_e4m3fn and x.is_contiguous() 这类判断,这没有问题;但如果写成读取张量元素、调用 .item()、依赖设备实际可用的动态查询,eager 和编译两条路径就会给出不同的结论,甚至在 lowering 阶段直接失败。
第二,supported 只能在注册时求值一次,不要在里面放随请求变化的判断。平台是否支持、第三方库是否可导入,属于静态信息,适合放在 supported;dtype、形状、是否使用 variance_size 覆盖,属于动态信息,适合放在 supports_args。两者混用会让优先级列表的过滤结果与实际分派不一致。
第三,注册 provider 的模块必须保证在模型构造之前被导入。如果厂商把 provider 放在一个懒加载模块里,import_ir_kernels 的覆写实现必须显式导入它。否则会出现“代码写了、单独测试能过、服务启动后永远走 native”的情况,而且日志里通常没有提示,因为 native 永远是兜底。
第四,OOT 类替换与 IR provider 不要同时用于同一个算子。两种机制都能改变执行路径,叠加使用会让排查变难:op_registry_oot 决定用哪个类,IR 优先级决定类内部走哪个 kernel,两层都要配置正确才能得到预期效果。厂商通常选择其中一种作为主路径,另一种只用于灰度对照。
第五,数值对账要覆盖所有可能被选中的 provider。不同实现的归约顺序、累加精度与向量化宽度不同,override_tolerance 必须按 provider 与 dtype 分别设置。它经常会被写成 x.dtype == torch.float8_e4m3fn and x.is_contiguous() 这类判断,这没有问题;但如果写成读取张量元素、调用 .item()、依赖全局 CUDA 状态的逻辑,eager 和编译两条路径就会给出不同的结果,甚至在 lowering 阶段直接失败。
第二,supported 只能在注册时求值一次,不要在里面放随请求变化的判断。平台是否支持、第三方库是否可导入,属于静态信息,适合放在 supported;dtype、形状、是否使用 variance_size 覆盖,属于动态信息,适合放在 supports_args。两者混用会让优先级列表的过滤结果与实际分派不一致。
第三,注册 provider 的模块必须保证在模型构造之前被导入。如果厂商把 provider 放在一个懒加载模块里,import_ir_kernels 的覆写实现必须显式导入它。否则会出现“代码写了、测试单独跑能过、服务启动后永远走 native”的情况,而且日志里通常没有任何提示,因为 native 永远是兜底。
第四,OOT 类替换与 IR provider 不要同时用于同一个算子。两种机制都能改变执行路径,叠加使用会让排查变得困难:op_registry_oot 决定用哪个类,IR 优先级决定类内部走哪个 kernel,两层都要配置正确才能得到预期效果。厂商通常选择其中一种作为主路径,另一种只用于灰度对照。
第五,数值对账要覆盖所有会选中的 provider。不同实现的归约顺序、累加精度与向量化宽度不同,override_tolerance 必须按 provider 与 dtype 分别设置。rms_norm 对 FP16 放宽容差就是例子:在大形状下,native 的 mean 归约与 vllm_c 的块内归约会产生不同的舍入累积,默认容差会让少数元素误报。
最后,VLLM_BATCH_INVARIANT 环境变量会改变 forward_cuda 与内核发射参数。开启后,RMSNorm 走 rms_norm_batch_invariant,内核固定 1024 线程块,保证同一行在不同 batch 大小下逐位一致。做数值对账或复现实验时,先确认这个开关的状态,否则会看到“同一个请求、不同 batch、结果最后几位不同”的现象。
小结
把这篇的链路压缩成一句话:模型层只声明语义,平台单例决定这套语义在哪个设备上执行,CustomOp 在构造期选出该平台的 Python 方法,IR 在调用期选出该平台的具体内核,最终由 torch.ops 把调用交给 C++ 扩展或厂商算子库。
这条设计里有三个值得带走的判断。
平台选择必须是进程级、延迟初始化、且 OOT 优先的。推理框架的调度、显存预算、注意力后端、量化支持列表都依赖平台信息,一旦不同进程对平台的判断不一致,问题会以非常隐蔽的方式出现。
算子分派的粒度要与编译策略匹配。CustomOp 的类替换适合“整套实现都不同”的硬件,IR 的 provider 优先级适合“同一平台上多个内核竞争”的场景。两者叠加并不冗余,因为一个解决可移植性,一个解决内核选择。
编译开关是算子层的一部分,而不是外部配置。custom_ops 的 all / none 默认值直接改变了 RMSNorm 走厂商内核还是走可融合的原生表达式。读 vLLM 的性能数据时,先确认编译模式与算子开关,再比较不同内核的差异,否则很容易把“编译路径不同”误判为“内核更快”。
站内延伸阅读可以沿着这条链路继续往下钻:注意力后端的平台选择见 vLLM 源码完全拆解(六):Attention Backend 如何统一 FlashAttention 与 FlashInfer;分页注意力的内核实现见 vLLM 源码完全拆解(七):PagedAttention Kernel 如何遍历分页 KV 并完成稳定 Softmax;量化层如何参与建壳与后处理见 vLLM 源码完全拆解(二十):权重装载——safetensors 分片、TP 切分与量化层的参数清单;编译期融合 pass 如何匹配这些算子见 vLLM 源码完全拆解(三十一):编译期的融合 pass;另一套引擎如何用 Platform 抽象同时支撑 CUDA 与 Ascend,见 DeepInfer 源码拆解(三十三):Platform 抽象与 CUDA/Ascend 双后端。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



