


SGLang 源码完全拆解(七):ForwardBatch、TpModelWorker 与 ModelRunner——调度计划如何变成一次 GPU 前向
前六篇之后,还缺哪一环
到这里,SGLang 源码系列已经走完了半条主干。第一篇画出了进程拓扑与四次对象形态变化的地图:GenerateReqInput 表达外部请求,Req 表达长期调度状态,ScheduleBatch 表达一轮决策,ForwardBatch 表达设备执行契约。第二篇到第六篇依次补齐了入口与出口(Tokenize / Detokenize)、请求状态机、PrefillAdder 的容量预算与分块预填充、KV 内存池与 RadixCache 的所有权闭环,以及 Overlap Scheduler 如何在 CPU 调度与 GPU 执行之间重叠。可参考 SGLang 源码完全拆解(一):整体架构、进程拓扑与请求数据流、SGLang 源码完全拆解(三):Scheduler 请求状态机如何闭环、SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch、SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环 与 SGLang 源码完全拆解(六):Overlap Scheduler 如何重叠 CPU 调度与 GPU 执行。
这些文章都在回答同一个问题的前半段:调度器决定了这一轮要算什么。它们把请求聚成 ScheduleBatch,算好了要写入的 KV slot、要提交的前缀长度、要分几块做 prefill。但 ScheduleBatch 本身不能执行。它是一个装着 Python 对象列表、host 端整数列表和几个 GPU 张量的混合体,里面有 Req、有 SamplingParams、有 stop string、有 SSE 回调,GPU 一个都不认识。
从 ScheduleBatch 到设备上真正跑起来的那一次前向,中间隔着三层:
ForwardBatch——把”这一轮要算什么”翻译成”这一轮要喂给模型什么”,即形状、索引、位置和元数据;TpModelWorker——把一次前向放进部署拓扑里,决定它是单卡前向、张量并行前向,还是流水线并行中间段的转发;ModelRunner——真正持有权重、KV 池、注意力后端和 CUDA Graph,并在这几条执行路径之间做选择。
这一篇就补这三层。目标不是列函数清单,而是回答一件更容易被忽略的事:当调度器交出 ScheduleBatch 之后,还有哪些决定必须在这一层做,为什么不能在别处做。
三次形态变化的完整链条
先把本篇要走的路径画成一张数据流图。左侧是调度器已经算好的东西,右侧是设备执行真正拿到的东西。
Scheduler.schedule() ← 第三、四篇 │ │ 选出 reqs、算出 prefix_lens / extend_lens、 │ 分配 out_cache_loc(KV 写入槽位) ▼ScheduleBatch ← 一轮决策的完整描述 │ reqs: List[Req] Python 对象,带 stop string、sampling params │ input_ids: torch.Tensor 扁平化 token,长度 = 本轮总 token 数 │ seq_lens / out_cache_loc 设备张量 │ extend_lens / prefix_lens host 端整数列表,只有 extend 才有 │ sampling_info 一整批的采样配置(已合并成张量) │ spec_info 投机解码的草稿/验证信息(可能为 None) │ │ TpModelWorker.forward_batch_generation(batch) ▼ForwardBatch ← 设备执行契约 │ forward_mode: ForwardMode EXTEND / DECODE / MIXED / TARGET_VERIFY / ... │ positions 每个 token 的位置 id │ extend_start_loc 每条序列在扁平 token 流中的起点 │ extend_seq_lens 本轮每条序列要算多少 token │ extend_prefix_lens 前面已经算好的 part │ global_num_token_non_padded / num_token_non_padded │ DP/TP padding 之后的真实 token 数 │ kv_loc_plan KV 写入的物理槽位计划 │ capture_hidden_mode 是否需要回传 hidden states,回传哪个token │ │ ModelRunner.forward(fb) ▼ModelRunnerOutput ├─ logits_output 采样器要用的 logits(或 hidden states) └─ can_run_graph 本次是否走了 CUDA Graph 重放理解这条链条的关键在于:每一次形态变化都在丢掉一类信息。ScheduleBatch 里的 Req 携带了完整的应用语义,ForwardBatch 只留下数值字段,到 ModelRunnerOutput 就只剩张量。信息一旦丢掉就不会回来,所以每一层必须在这一刻把需要的东西全部固化下来。
ForwardMode:不是”prefill 和 decode”两种
读 model_executor/forward_batch_info.py 时,第一个会让人意外的定义是 ForwardMode。它不是布尔量,而是一个枚举,当前有八个取值:
class ForwardMode(IntEnum): EXTEND = auto() # 常见的 prefill:一段未算过的 token DECODE = auto() # 每请求追加一个 token MIXED = auto() # 分块预填充时同一批里既有 extend 又有 decode IDLE = auto() # 无序列可算,DP attention 下某些 rank 会空转 TARGET_VERIFY = auto() # 投机解码:目标模型验证草稿 DRAFT_EXTEND_V2 = auto() # 投机解码:草稿模型扩展 PREBUILT = auto() # PD 分离的解码 worker,KV 已就绪 SPLIT_PREFILL = auto() # PD 复用场景的切分 prefill DLLM_EXTEND = auto() # 扩散语言模型的块内去噪为什么要把”prefill”这一个概念拆成 EXTEND、MIXED、SPLIT_PREFILL、DLLM_EXTEND 四种?因为在 kernel 层面它们的形状完全不同。EXTEND 是每条序列一段连续新 token;MIXED 是同一批里两种形状共存,注意力 kernel 要对不同行使用不同的 mask 与不同的 KV 长度;SPLIT_PREFILL 是把一次 prefill 沿层切成几段、只有第一段要构造 ForwardBatch;DLLM_EXTEND 则是在一个固定大小的块内原地重写,位置的构造方式与普通 extend 完全不同。
枚举上挂着一组方法,把”这一次前向具有哪些性质”表达成可复用的谓词:
def is_decode(self): return self == ForwardMode.DECODE
def is_cuda_graph(self): return ( self == ForwardMode.DECODE or self == ForwardMode.TARGET_VERIFY or self == ForwardMode.IDLE or self == ForwardMode.DLLM_EXTEND )
def is_extend_without_speculative(self): return self.is_extend() and not self.is_target_verify()is_cuda_graph() 这一条值得停一下。它规定了哪些前向模式允许走 CUDA Graph 重放:decode、目标验证、idle、dLLM 的块内去噪。四者的共同点是形状在每一轮之间足够稳定,可以用一组固定 batch size 的桶把形状覆盖住。而普通 EXTEND 不在其中,因为它的 token 数随请求长度连续变化,无法预先穷举。这个判断直接决定了后面 _forward_raw 里的分支走向。
is_extend() 的定义同样有意思,它把 TARGET_VERIFY、SPLIT_PREFILL、DLLM_EXTEND 都算作 extend 的一种:
def is_extend(self, include_draft_extend_v2: bool = False): return ( self == ForwardMode.EXTEND or self == ForwardMode.MIXED or (include_draft_extend_v2 and self == ForwardMode.DRAFT_EXTEND_V2) or self == ForwardMode.TARGET_VERIFY or self == ForwardMode.SPLIT_PREFILL or self == ForwardMode.DLLM_EXTEND )含义是:这些模式下每条序列都要处理一段 token,而不是像 decode 那样处理一个 token,因此它们的形状描述需要 extend_seq_lens / extend_prefix_lens / extend_start_loc 这组字段。把 TARGET_VERIFY 归入 extend 是有代价的:投机验证在语义上是”验证 k 个草稿 token”,但形状上它和 prefill 一样是一段多 token 的序列,复用同一套字段比再造一套更省事。代价是 ForwardBatch.init_new 里到处都要写 is_extend_without_speculative() 这样的排除条件,因为投机路径的 req_pool_indices_cpu 等字段的语义与普通 prefill 不同。
ForwardBatch:一份设备执行契约
ForwardBatch 是一个 dataclass(更准确说是 ForwardBatchDeepSeekMHAMixin 的子类),它被显式分成了几组,分组本身就是设计意图的说明:
class ForwardBatch(ForwardBatchDeepSeekMHAMixin): """Store all inputs of a forward pass."""
# === Required core inputs (no default; input_ids / req_pool_indices / seq_lens / out_cache_loc are borrowed from ScheduleBatch) === forward_mode: ForwardMode batch_size: int input_ids: torch.Tensor req_pool_indices: torch.Tensor seq_lens: torch.Tensor out_cache_loc: torch.Tensor seq_lens_sum: int
# === Borrowed from ScheduleBatch: GPU tensors (cross-stream; clone targets for stream isolation) === orig_seq_lens: Optional[torch.Tensor] = None kv_loc_plan: Optional[KVLocPlan] = None kv_loc_cols: Optional[Cols] = None out_cache_loc_virtual: Optional[torch.Tensor] = None
# === Borrowed from ScheduleBatch: config / flags (by-value) === return_logprob: bool = False is_prefill_only: bool = False spec_algorithm: SpeculativeAlgorithm = None
# === Borrowed from ScheduleBatch: host metadata (CPU lists / mirrors) === seq_lens_cpu: Optional[torch.Tensor] = None req_pool_indices_cpu: Optional[torch.Tensor] = None top_logprobs_nums: Optional[List[int]] = None
# === Borrowed from ScheduleBatch: compound (carry their own device tensors) === sampling_info: SamplingBatchInfo = None spec_info: Optional[SpecInput] = None
# === Per-forward overrides passed explicitly to init_new === capture_hidden_mode: CaptureHiddenMode = None
# === Forward-derived (built in init_new on the forward stream; FB-owned) === positions: torch.Tensor = None extend_num_tokens: Optional[int] = None extend_seq_lens: Optional[torch.Tensor] = None extend_prefix_lens: Optional[torch.Tensor] = None extend_start_loc: Optional[torch.Tensor] = None源码里对”借用”这个词写得很直白,甚至留了一条 FIXME:
# FIXME(lsyin): these are currently aliased by reference from ScheduleBatch. Once # they are cloned/relayed into FB-owned copies at the boundary, move them out of # "Borrowed" into a dedicated "Forward-resolved snapshot" group.这条 FIXME 指出了当前实现里一个真实的张力:ForwardBatch 名义上是设备执行契约,但它引用的相当一部分张量仍然是 ScheduleBatch 的别名(aliasing),不是自己拥有的副本。在重叠调度下,调度器会在 GPU 还在读这些张量的同时准备下一轮批次,一旦下一轮复用了同一块缓冲区,就会读到错误的数据。源码里 out_cache_loc_virtual 的注释把这种顾虑写得很清楚:它是”调度器记账用的虚拟槽位副本”,用于 lazy compaction 的在途写入集合、TBO 切分与状态捕获——也就是说,同一份 KV 写入意图被同时表达成三种坐标(物理 id、虚拟 id、NPU 的 per-pool bundle),每一种服务于一个不同的消费者。
这也解释了 init_new 顶部那条看似奇怪的注释:
# init_new must not mutate the input ScheduleBatch; per-forward # overrides go through explicit keyword arguments.契约是单向的:ScheduleBatch → ForwardBatch。允许反向修改会让重叠调度下的状态变得不可推理,所以连 seq_lens_sum 那种”顺便补一下”的写法都被标注为待移除的临时妥协。
init_new:一次前向的所有派生计算
ForwardBatch.init_new 是这一层最长的函数。它做四件事。
第一件是决定 hidden state 的捕获模式。这条逻辑短但很关键:
# capture_hidden_mode=None means no override: capture the server's # configured maximum so lower-mode requests can share one graph. if capture_hidden_mode is None: request_capture_hidden_mode = ( CaptureHiddenMode.NULL if model_runner.is_draft_worker else max( batch.return_hidden_states_mode, get_server_return_hidden_states_mode(), ) ) capture_hidden_mode = get_required_capture_hidden_mode( request_capture_hidden_mode, batch.spec_info, )为什么要取 max 而不是按请求各取所需?因为 CUDA Graph 重放的前提是形状和缓冲区固定。如果一批里有的请求要 full hidden states、有的只要 last、有的什么都不要,那么每批的输出张量形状都会不同,图形就无法复用。于是设计上取一个全局上界(服务端配置的最大模式),让所有请求共用同一个图,代价是低需求请求会多算出一些不会被使用的结果。CaptureHiddenMode 本身是 NULL=0 / LAST=1 / FULL=2 的 IntEnum,还实现了 __lt__ 以便直接比较取大值。
第二件是构造 ForwardBatch 的核心字段,其中绝大多数是直接从 ScheduleBatch 搬过来的引用,个别需要按模式区分:
# extend-mode-only fields are None on decode/idle if batch.forward_mode.is_decode_or_idle(): extend_seq_lens = extend_prefix_lens = extend_logprob_start_lens = None else: extend_seq_lens = batch.extend_lens extend_prefix_lens = batch.prefix_lens extend_logprob_start_lens = batch.extend_logprob_start_lens这一行体现了”同一份结构服务多种模式”的做法:decode 与 idle 没有”每条序列要算多少 token”的概念,于是这三个字段置空,后续所有依赖它们的代码都要先判断模式。
第三件是绑定 KV 写入计划:
translator = model_runner.kv_index_translator if kv_loc_plan is None: kv_loc_plan = translator.own_plan(ret) kv_loc_plan.bind(ret, translator, cols=write_cols)KVLocPlan 是对第五篇 KV 池那套”逻辑槽位 → 物理页”映射的一次批量化表达。注释说明了它的角色:
# This iteration's KV ids, translated once per sub-pool (`KVLocPlan`). # Every forward of the iteration holds the same plan; `out_cache_loc` is # its write window in the full-attention ids this runner's pool indexes, # and a backend that writes another sub-pool asks the plan for its ids # (`KVIndexTranslator.write_ids`).“每个子池翻译一次”这个说法对应的是混合注意力模型的现实:一个模型可能同时有全注意力层、滑窗层、稀疏索引层和 Mamba 状态,它们各自有独立的存储池。调度器只分配了一套全局槽位 id,翻译成各池各自的物理 id 是执行层必须做的事,而且要保证同一轮前向里所有子池看到的是同一个计划,否则跨层引用会错位。
第四件是生成位置信息,这是数值上最不能出错的一段:
# Init position information if ret.forward_mode.is_decode() or ret.forward_mode.is_target_verify(): if ret.positions is None: ret.positions = clamp_position(batch.seq_lens) else: if isinstance(extend_seq_lens, list): # Main path: H2D from host lists; populate *_cpu mirrors. pin_memory = is_pin_memory_available(device) ret.extend_seq_lens = torch.tensor( extend_seq_lens, dtype=torch.int32, pin_memory=pin_memory ).to(device, non_blocking=True) ...
ret.extend_num_tokens = batch.extend_num_tokens if extend_position_info is None: positions, ret.extend_start_loc = compute_position( model_runner.prefill_attention_backend_str, ret.extend_prefix_lens, ret.extend_seq_lens, ret.extend_num_tokens, )decode 的位置直接从 seq_lens 推出来——每条序列当前长度就是下一个 token 的位置。extend 则要复杂得多:compute_position 要按每条序列的前缀长度和本段长度,展开出一串从 prefix_len 到 prefix_len + seq_len - 1 的位置 id,同时算出每条序列在扁平 token 流里的起点 extend_start_loc。注意这里把 prefill_attention_backend_str 传了进去——位置的计算方式依赖注意力后端,因为不同后端对 extend_start_loc 的含义有约定差异(有的要 token 偏移,有的要 KV 偏移)。这是”调度器不应该知道的事”的典型例子:调度器知道每条请求的前缀是多少,但它不该知道 FlashAttention 后端期望 extend_start_loc 怎么编码。
padding 与真实 token 数
ForwardBatch 里有一组字段专门处理 padding:global_num_token_non_padded、global_num_token_non_padded_cpu、num_token_non_padded。源码用一大段注释解释了它们存在的理由:
# Real (non-padding) token count, held at two scopes whose meaning never # changes once set: # GLOBAL — the real-token count across the attn-TP group before sharding. # global_num_token_non_padded GPU int32 scalar. The invariant source # the eager forward and the cuda-graph # registry localize from on each forward / # replay. Present only when # enable_num_token_non_padded(). # LOCAL — this attn-TP rank's owned count after sharding. # num_token_non_padded GPU int32 scalar, derived from # global_num_token_non_padded (see # compute_local_num_token_non_padded). The # MoE topk kernel masks padded rows with # it; replicated forwards keep the full # count. Left None until localized (eager # forward only for reference.为什么需要”真实 token 数”这个量?因为在 MoE 与数据并行注意力下,一次前向的 token 数会被补齐到某个整齐的值,或者被 TP 组切分。补齐出来的那些行是无效输入,它们会参与 MatMul 但结果无意义。问题出在 MoE 的 top-k 路由:如果 padding 行也去参与专家选择,会造成无意义的 all-to-all 通信;更糟的是,非均匀的 padding 会让不同 rank 上的路由结果不一致,破坏集合通信的对称假设。所以要把”真实有多少 token”作为一个标量显式传给 MoE kernel,让它在 topk 阶段把 padding 行掩掉。
注意这里的两个作用域:global 是切分前的全局真实 token 数,num_token_non_padded(local)是本 rank 切分后拥有的数量。二者之间隔着一个 compute_local_num_token_non_padded。这个转换在 _prepare_eager_forward_batch 里被调用:
# Derive the LOCAL num_token_non_padded from the GLOBAL scalar. sharded is # cleared for DSA and MLA prefill CP: those flavors # already feed a zigzag-split rank-local layout whose token count should # not be further divided by attn_tp_size, so they keep the full count. if forward_batch.global_num_token_non_padded is not None: forward_batch.set_local_num_token_non_padded( sharded=( forward_batch.attn_tp_sequence_sharded and not is_dsa_enable_prefill_cp() and not is_mla_cp_enabled() ), )sharded 这个开关是个很好的设计决策样本。它的直觉是:如果 TP 组是按 token 维切分序列的(sequence sharding),那么每个 rank 拿到的真实 token 数应该是全局数除以 attn_tp_size ;但如果采用的是另一种布局——例如稀疏注意力(DSA)或 MLA 的 prefill 上下文并行,token 是按 zigzag 分片分配给各 rank 的——那么每个 rank 的 token 数是经过特殊布局的,不能再被简单整除,否则掩码位置会算错。用一个布尔参数把这两种布局分开,比在每个 kernel 里各判一次要安全得多。
形状的”最后一步调整”
ForwardBatch 还负责把动态批次调整成固定形状,这是 CUDA Graph 能重放的前提。两条路径对应两个函数:prepare_mlp_sync_batch 处理数据并行下 MLP 需要同步的场景,prepare_attn_tp_scatter_input 处理纯 TP+SP 的场景。
def prepare_attn_tp_scatter_input(self, model_runner: ModelRunner): from sglang.srt.layers.layer_boundary import get_attn_tp_context
# Pure TP+SP has no MLP-sync pass, so stamp the decision here. self.attn_tp_sequence_sharded = model_runner.attn_tp_sequence_sharded( self._forward_num_tokens() )
attn_tp_context = get_attn_tp_context() input_scattered = attn_tp_context.use_input_scattered(self) if not input_scattered: return assert self.forward_mode.is_extend() tokens = self.input_ids.shape[0] rank_size = get_parallel().tp_size tokens_padded = (tokens + rank_size - 1) // rank_size * rank_size self._pad_inputs_to_size(model_runner, tokens_padded, self.batch_size)tokens_padded = (tokens + rank_size - 1) // rank_size * rank_size 就是把 token 数向上取整到 tp_size 的倍数。原因是序列并行(SP)把 token 维切成 tp_size 份,每份必须等长,否则 all-gather 之后的张量无法对齐。补齐发生在执行层,而不是调度层,因为”要补到几”取决于部署的 TP 大小与是否启用 SP——调度器不该知道 GPU 拓扑。
与之对称的是前向结束后的裁剪:
# MLP-sync padding appended dummy rows after the real ones; slice the # per-request tensors back so post-forward consumers (seeded sampling, # ngram token-table updates) never see the padding. if self.spec_info is None and self._original_num_tokens is not None: self.positions = self.positions[: self._original_num_tokens] self.seq_lens = self.seq_lens[:bs] self.req_pool_indices = self.req_pool_indices[:bs]补齐进来的 dummy 行必须在采样之前切掉,否则采样器会把 padding 行的 logits 当作真实输出。这段逻辑在投机解码下的分支更细:TARGET_VERIFY 要按 bs * num_tokens_per_req 切,DRAFT_EXTEND_V2 也要按 num_tokens_per_req 乘回去。每个模式的输出 token 数与输入 batch size 的关系都不一样,这就是为什么 post_forward_mlp_sync_batch 会有一个不长但分支密集的实现。
TpModelWorker:把一次前向放进部署拓扑
ForwardBatch 造好之后,调用链进入 managers/tp_worker.py。TpModelWorker 的职责可以用一句话概括:它是”一次前向”与”部署拓扑”之间的适配层。
入口是 forward_batch_generation,先看它如何构造 ForwardBatch:
def forward_batch_generation( self, batch: Optional[ScheduleBatch], forward_batch: Optional[ForwardBatch] = None, pp_proxy_tensors: Optional[PPProxyTensors] = None, is_verify: bool = False, skip_attn_backend_init: Optional[bool] = None, # deprecated *, capture_hidden_mode: Optional[CaptureHiddenMode] = None, return_kv_loc_plan: bool = False, ) -> GenerationBatchResult: # Get forward batch from schedule batch if batch is not None: # update the consumer index of hicache to the running batch self.set_hicache_consumer(batch.hicache_consumer_index)
if get_exec().features.enable_encoder_swa_bounded_replay: from sglang.srt.model_executor.encoder_swa_replay import ( run_encoder_swa_replay, )
# Replay reads restored main/indexer KV before the normal extend. run_encoder_swa_replay(self, batch)
forward_batch = ForwardBatch.init_new( batch, self.model_runner, capture_hidden_mode=capture_hidden_mode, return_hidden_states_before_norm=False, ) else: # FIXME(lsyin): unify the interface of forward_batch assert forward_batch is not None assert capture_hidden_mode is None, ( "capture_hidden_mode override requires a ScheduleBatch input" )两个分支暴露了一个尚未统一的接口:要么给 ScheduleBatch 让它构造 ForwardBatch,要么直接给一个已经造好的 ForwardBatch。后者用于投机解码的验证阶段等”同一次迭代里多次前向”的场景——第一段前向用 ScheduleBatch 构造,后续段复用同一个 ForwardBatch,靠 kv_loc_plan 与 write_cols 参数区分各自写入 KV 的窗口。
然后是流水线并行的分支:
if self.pp_group.is_last_rank: out = self.model_runner.forward( forward_batch, pp_proxy_tensors=pp_proxy_tensors, ) logits_output, can_run_cuda_graph = out.logits_output, out.can_run_graph batch_result = GenerationBatchResult( logits_output=logits_output, can_run_cuda_graph=can_run_cuda_graph, expert_distribution_metrics=out.expert_distribution_metrics, routed_experts_output=out.routed_experts_output, indexer_topk_output=out.indexer_topk_output, kv_loc_plan=forward_batch.kv_loc_plan if return_kv_loc_plan else None, ) else: out = self.model_runner.forward( forward_batch, pp_proxy_tensors=pp_proxy_tensors, ) pp_proxy_tensors, can_run_cuda_graph = out.logits_output, out.can_run_graph return GenerationBatchResult( pp_hidden_states_proxy_tensors=pp_proxy_tensors, can_run_cuda_graph=can_run_cuda_graph, expert_distribution_metrics=out.expert_distribution_metrics, )这是本篇最值得细讲的一处设计。在流水线并行下,模型被按层切成若干段,每段在独立的 GPU 或进程上。只有最后一段持有输出投影与 norm,能产生 logits;中间段算完自己的层之后,要把激活值交给下一段。SGLang 的抽象很取巧:中间段把 hidden states 当作 logits_output 传递,把下一段的输入当作一个 ModelRunnerOutput 返回。所以 out.logits_output 在这一分支里拿到的是”要转给下一步的张量”,而不是真正的 logits。PPProxyTensors 这个类型名表明了它并不保证内容的语义,只保证形状与传递路径。
这个复用带来一个直接后果:采样只在最后一段发生。看接下来的代码:
capture_pre_sample_logits(batch, forward_batch, logits_output)
if is_verify: # Skip sampling; spec_v2 worker fires its own publish post-verify. return batch_result
# Delay sampling only for normal generation requests. # Keep the existing grammar behavior unchanged. if ( self.enable_overlap and not self.enable_spec and ( forward_batch.sampling_info.grammars is not None or ( envs.SGLANG_ENABLE_DELAY_SAMPLE.get() and not forward_batch.is_prefill_only ) ) ):
def sample_batch_func(): batch_result.next_token_ids = self.model_runner.sample( logits_output, forward_batch ) self._maybe_finalize_elastic_cuda_graph_scale() return batch_result
batch_result.delay_sample_func = sample_batch_func return batch_result
if not forward_batch.is_prefill_only: # For normal requests, sample the next token ids. batch_result.next_token_ids = self.model_runner.sample( logits_output, forward_batch ) else: # For prefill-only requests, create dummy token IDs on CPU # The size should match the batch size (number of sequences), not total tokens batch_result.next_token_ids = torch.zeros( len(forward_batch.seq_lens), dtype=torch.long, device=forward_batch.input_ids.device, )这里有三个可以讨论的决策。
第一,delay_sample_func:在重叠调度下,采样被推迟成闭包而不是立即执行。原因在第六篇讲过——重叠调度的核心是把”调度器准备下一轮”与”GPU 执行这一轮”并行起来,如果采样立刻在 Python 里跑,主线程就会被 CPU 侧的 logits 处理阻塞,重叠收益消失。把采样包成闭包交给调度器在下一次迭代的空档执行,是维持重叠的前提。注意它被刻意限制在 enable_overlap and not enable_spec 的组合下:投机解码的采样与验证逻辑耦合太紧,无法安全推迟。
第二,is_verify 直接返回。目标验证阶段不做采样,因为验证的语义是”这批草稿 token 各自被接受多少”,接受长度由 spec_v2 worker 自己发布。这属于第十一篇(SGLang 投机解码)的范畴。
第三,is_prefill_only 时构造假的 token id。这是一个非常典型的”让形状保持一致”的技巧:某些请求只做 prefill 不生成(例如只为计算 KV 或 logprob),但调度器的下游代码假定每个请求都产出一个 token id。于是造一批全零张量,长度取序列数而非 token 数——源码里专门加了一行注释强调这点,因为这是最容易写错的地方:next_token_ids 是 per-request 的,不是 per-token 的。
ModelRunner.forward:三条执行路径的分派
ForwardBatch 与部署拓扑都处理完,就轮到 model_executor/model_runner.py。ModelRunner 持有的资产决定了它必须承担分派责任:模型权重、KV 内存池、注意力后端、CUDA Graph runner、采样器。forward 本身不长,它主要在做观测与簿记,真正的分派在 _forward_raw:
def _forward_raw( self, forward_batch: ForwardBatch, pp_proxy_tensors: Optional[PPProxyTensors], reinit_attn_backend: bool = False, split_forward_count: int = 1, ) -> ModelRunnerOutput: if has_forward_context(): ctx_mgr = contextlib.nullcontext() else: ctx_mgr = forward_context(ForwardContext(attn_backend=self.attn_backend)) with ctx_mgr: mode_check = ( forward_batch.forward_mode.is_cpu_graph if self.device == "cpu" else forward_batch.forward_mode.is_cuda_graph ) can_run_graph = bool( mode_check() and self.decode_cuda_graph_runner and self.decode_cuda_graph_runner.can_run_graph(forward_batch) )
# Replay cuda graph if applicable if can_run_graph: ret = self.decode_cuda_graph_runner.execute( forward_batch, pp_proxy_tensors=pp_proxy_tensors, ) return ModelRunnerOutput(logits_output=ret, can_run_graph=can_run_graph)这是第一条路径:decode 走 CUDA Graph 重放。注意 can_run_graph 的三个合取条件——模式允许(前面 is_cuda_graph() 那组谓词)、runner 存在(可能因为显存不足而没建图)、以及 runner 自己判断这个 batch 的形状能落在某个已捕获的桶里(can_run_graph(forward_batch))。第三个条件是最容易被忽略的:即使图存在,如果这一轮的 batch size 不在捕获集合中,也无法重放。这是为什么 decode 的图要按一组 batch size 桶来捕获。
如果不是重放,就要走补充路径:
# DP / MLP-sync padding + attn-tp normalization. Only the decode # cuda-graph path above pre-pads its static buffers and returns # early; split prefill, the prefill cuda graph, and the eager # forward all run the live batch and need this first — it sets # global_dp_buffer_len / padded token counts that graph eligibility # and the collectives depend on. self._prepare_eager_forward_batch(forward_batch)
# Deferred mamba COW/clear on the forward stream, before the extend # dispatch below reads the pool. self._maybe_execute_deferred_mamba_cow_and_clear(forward_batch)
dwdp_mgr = get_global_dwdp_manager() if dwdp_mgr is not None: dwdp_mgr.prefetch_first_layers()
if forward_batch.forward_mode.is_split_prefill(): # Layer-split mode; stays on ModelRunner, not the eager runner. ret = self.forward_split_prefill( forward_batch, reinit_attn_backend=reinit_attn_backend, forward_count=split_forward_count, )_prepare_eager_forward_batch 的位置也有讲究。注释明确说明:CUDA Graph 路径在上面已经 return 了,它的静态缓冲区在捕获/重放时自己补齐;而 split prefill、prefill CUDA Graph 和 eager 前向三种路径都跑活的批次,必须在这里做补齐与非填充计数归一化。换句话说,padding 的时机取决于执行路径:重放路径用捕获时固定的缓冲区,eager 路径则要现场补齐。把这一步放在分派之后、路径分叉之前,是最不容易出错的位置。
第二条路径是 prefill 的 CUDA Graph:
elif ( forward_batch.forward_mode.is_extend(include_draft_extend_v2=True) and not isinstance(self.prefill_cuda_graph_runner, EagerRunner) and self.prefill_cuda_graph_runner is not None and self.prefill_cuda_graph_runner.can_run_graph(forward_batch) and forward_batch.token_indices_to_pool is None and _prefill_cuda_graph_allows_context_parallel( self.prefill_cuda_graph_runner, forward_batch ) ): # Prefill cuda graph (piecewise). kwargs = self._extend_forward_kwargs(forward_batch, pp_proxy_tensors) category = ( "target_verify" if forward_batch.forward_mode.is_target_verify() else "extend" ) with device_timer_ctx(self.device_timer, category): ret = self.prefill_cuda_graph_runner.execute( forward_batch, **kwargs ) can_run_graph = Trueprefill 也能走图,但走的是分段(piecewise)形式而非整图,因为 prefill 的形状维度太多、无法全图覆盖。这里的注释写着 “Prefill cuda graph (piecewise)“,对应的正是后面要展开的 Breakable CUDA Graph 机制。注意 token_indices_to_pool is None 这个额外条件:有些特性(例如 setwise pooling 的读出位置)要求不捕图,这个前置判断把它们排除在外。
第三条路径是 eager:
else: # Eager: decode / extend / idle dispatched inside the runner. ret = self.eager_runner.execute( forward_batch, pp_proxy_tensors=pp_proxy_tensors )
if ( forward_batch.global_num_tokens_cpu is not None and self.pp_group.is_last_rank ): forward_batch.post_forward_mlp_sync_batch(ret)
return ModelRunnerOutput(logits_output=ret, can_run_graph=can_run_graph)eager_runner 是一个执行器对象而不是”直接调用 model”,这一点和第六篇的 EagerRunner 命名一致:它把 eager 前向也包装成一个可与 CUDA Graph runner 互换的对象,使 can_run_graph / execute 成为统一接口。这就是为什么上面第三条分支里 not isinstance(self.prefill_cuda_graph_runner, EagerRunner) 是一个有意义的判断——当 prefill 图被配置为禁用时,这个字段本身就退化成 EagerRunner,此时它已经在 can_run_graph 里返回了 False,但显式排除能让意图更清楚。
最后那三行只在 MLP-sync 场景下生效:is_last_rank 这个条件再次出现,因为在流水线并行下只有最后一段拿到真实 logits,中间段的”logits”是待传递的激活值,不能做后处理。
ModelRunner 的构造顺序:为什么这三步不能换
ModelRunner 的 forward 之所以能同时维持整图重放、分段图与 eager 三条路径,是因为它在构造阶段就把三者的公共资源准备好了。构造过程中有三项初始化,它们的先后顺序是有硬约束的。
第一项是内存池:
def alloc_memory_pool(self, memory_pool_config: Optional[MemoryPoolConfig] = None): """Allocate KV cache memory pools only (no backends or cuda graphs).""" if memory_pool_config is not None: self.memory_pool_config = memory_pool_config
self.init_kv_cache_configurator() result = self.kv_cache_configurator.configure( pre_model_load_memory=self.pre_model_load_memory ) self.max_total_num_tokens = result.max_total_num_tokens self.max_running_requests = result.max_running_requests self.req_to_token_pool = result.req_to_token_pool self.token_to_kv_pool = result.token_to_kv_pool self.token_to_kv_pool_allocator = result.token_to_kv_pool_allocator self.memory_pool_config = result.memory_pool_config if self.is_hybrid_swa: self.full_max_total_num_tokens = result.full_max_total_num_tokens self.swa_max_total_num_tokens = result.swa_max_total_num_tokens第五篇讲的 KV 池就是在这里被造出来的。注意 configure 的输入是 pre_model_load_memory——权重加载之后剩下的显存才决定池能多大,所以这一步必须发生在权重加载之后、任何会占用显存的事情之前。返回的五个量里有两个是容量规划的产物:max_total_num_tokens 决定 KV 池按多少个 token 槽位分配,max_running_requests 决定 req_to_token_pool 的行数上限——后者就是调度器能同时容纳的请求数上限。is_hybrid_swa 分支说明混合滑窗模型会拿到主池与滑窗池两套容量,这是第四篇容量预算里”分池记账”的执行层对应物。
紧跟着被初始化的是索引翻译器:
def _init_post_memory_pool_components(self): """Post-pool component wiring, split out of alloc_memory_pool so forks that build bespoke memory pools can reuse it after allocating them.""" self.init_kv_index_translator()
# Must be called AFTER init_memory_pool so the pool object exists for # canary to monkey-patch, and BEFORE init_decode_cuda_graph so warmup # forwards captured into the graph see the patched pool methods. self.canary_manager = install_canary(注释把顺序约束写成了两句话:池必须先存在(否则没有对象可供检查工具挂钩),图必须在它之后(否则捕图时的 warmup 前向看不到被挂钩后的池方法)。这也解释了为什么 init_new 里那句 translator = model_runner.kv_index_translator 能直接拿到翻译器——它的生命周期与池绑定在一起。
第二项是注意力后端:
def init_attention_backends(self): """Initialize attention backends only (no cuda graph capture).""" # Must be called BEFORE init_decode_cuda_graph() so CUDA graph capture # runs with aux hidden state capture enabled. configure_aux_hidden_state_capture(...) # Resolve before building: backends read the pair off the runner while # they construct (the FlashInfer KV-access check). resolved = resolve_attention_backend_strs(model_runner=self) self.prefill_attention_backend_str = resolved.prefill self.decode_attention_backend_str = resolved.decode backends = build_attention_backends(model_runner=self) self.attn_backend = backends.attn_backend self.decode_attn_backend = backends.decode_attn_backend self.decode_attn_backend_group = backends.decode_attn_backend_group self.kv_index_translator.bind_and_verify_backends( [self.attn_backend, self.decode_attn_backend] )这段代码解释了本篇前面两个伏笔。其一,prefill_attention_backend_str 会被 init_new 里的 compute_position 读取,所以后端必须在任何一次 init_new 之前就位。其二,也是更关键的一点:prefill 与 decode 可以选不同的后端——resolved.prefill 与 resolved.decode 是两个独立的字符串。为什么允许分开?因为两个阶段的瓶颈不同:decode 是内存带宽受限、每请求一个 token、重视 KV 分页访问效率;prefill 是计算受限、多 token 一段、重视大块矩阵乘。为两个阶段各选一个最合适的 kernel 家族,是推理引擎里代价很低的一步优化。
bind_and_verify_backends 是一个安全阀。它把注意力后端与 KV 索引翻译器绑定,并验证后端实际索引的池与翻译器输出的槽位一致。这个检查的价值在于:如果后端写的是全注意力层的槽位、而翻译器给的是另一个子池的物理 id,那么在跑起来之前就会失败,而不是在跑出错误结果之后才被发现。混合注意力模型(全注意力 + 滑窗 + 稀疏索引 + Mamba 状态)让”哪一层写哪个池”变成了一个非平凡的问题,这类验证是在这个背景下必然出现的。
第三项是 CUDA Graph:
def init_cuda_graphs(self, capture_decode_cuda_graph: bool = True): ... capture = capture_cuda_graphs( model_runner=self, capture_decode_cuda_graph=( capture_decode_cuda_graph and not defer_decode_capture ), finalize=not defer_decode_capture, defer_distributed_setup=defer_decode_capture, )前面已经展开过它的产物。这里补一点顺序上的约束:注释写明 init_attention_backends 必须在 init_decode_cuda_graph 之前,因为捕图时要用到注意力后端持有的 workspace——FlashInfer 这类后端的 plan/workspace 是按最大形状预分配的,图段里会引用这些缓冲区,如果后端还没建好就捕图,捕获到的地址会在后端重建时失效。于是实际构造顺序是稳定的三步:池 → 后端(含索引翻译器绑定) → 图。任何一步提前都会让后续步骤引用到尚未存在的对象或即将失效的地址。
与 vLLM 的对照,以及四个值得下的断点
本站已经用十六篇拆过 vLLM 的源码,其中 vLLM 源码完全拆解(五):GPUModelRunner 如何把动态请求拼成一次 GPU 前向 讲的正是本篇这一层。把两边的做法放在一起看,能更清楚地看出 SGLang 的设计取舍。
vLLM 用一个 InputBatch 承担”把动态请求拼成一次前向”的职责:它在构建时就铺平 token、位置与 KV 索引,并维护 CPU 侧的镜像张量供采样器与后处理使用。对象更扁平,一次性把执行需要的东西都算齐。
SGLang 则把这件事拆成两个对象:ScheduleBatch 表达调度决策,ForwardBatch 表达一次前向的契约,并且允许从同一个 ScheduleBatch 派生多次前向。这个拆分不是为了对称,而是被投机解码逼出来的——一次投机迭代里,草稿模型前向、目标模型验证前向、以及可能的草稿扩展前向,共享同一批请求与同一套 KV 分配,但形状、模式与位置各不相同。如果只有一个扁平对象,就必须在每次前向之前重新构造它;有两个对象,就可以只构造一次 ForwardBatch 的公共部分,再用 kv_loc_plan 与 write_cols 区分各自写入窗口。
代价就是本篇反复提到的借用与别名:ForwardBatch 引用了 ScheduleBatch 的张量,而 ScheduleBatch 又会在下一轮被复用,于是重叠调度下必须极其小心地界定”哪些引用可以跨迭代存活”。源码里那条 FIXME 正是这个代价的痕迹。
落到实操,读这一层源码时有四个位置值得下断点。
第一个在 init_new 返回之后。此时检查三件事:positions 是否覆盖了正确的连续区间、extend_start_loc 的首元素是否为 0、seq_lens_sum 是否等于所有序列长度之和。这三个量一旦有一个不对劲,后面的 kernel 不会报错,只会算错,排查成本极高。
第二个在 _forward_raw 里 can_run_graph 的赋值处。它由三个条件合取而成,最常见的情况是模式允许、图存在、但形状不在捕获桶里——表现出来就是”明明配了 CUDA Graph,profil 里却全是 kernel 启动开销”。在这一行下断点可以把三个条件分开看。
第三个在 post_forward_mlp_sync_batch 前后。这个函数负责把补齐的 dummy 行切回去,同时恢复被修改过的 forward_mode 与 batch_size。如果这里切错了长度,症状会表现为采样出的 token 数比请求数多、或者 logprob 数组错位。
第四个在采样分支上。delay_sample_func 是否被设置,决定了这次采样是立刻发生还是推迟到下一轮;在开启重叠调度后,看到”logits 算完但 token id 还没出来”是正常现象,不是 bug。
上下文与资源:三个”谁来拥有”的问题
通读这几层代码,会发现有几类资源的所有权被反复调整,它们构成了执行层真正的复杂度来源。
第一,注意力后端的所有权。 _forward_raw 开头用 forward_context(ForwardContext(attn_backend=self.attn_backend)) 把后端放进上下文,而不是作为参数层层传递。原因是注意力层深埋在模型 forward 的每一层里,签名无法接受额外参数;用 context 传递既避免了改签名,也保证了整次前向用的是同一个后端实例。但这也带来一个约束:has_forward_context() 的判断意味着嵌套调用(例如投机解码里草稿模型与目标模型交替前向)不能各自设置后端,否则内层会覆盖外层。
第二,KV 写入的所有权。 KVLocPlan 的出现说明”这一轮写哪些槽位”这件事已经从调度器下移到执行层,但只有一轮。注释里那句”Every forward of the iteration holds the same plan”划出了边界:一次迭代(可能包含多次前向,如投机解码的草稿 + 验证)共享一个计划,靠 write_cols 区分各自窗口。这个边界的选择有其道理——跨迭代共享计划会让调度器无法安全回收槽位。
第三,CUDA Graph 与内存的所有权。 init_cuda_graphs 把 eager runner、prefill runner、decode runner 三者一起构造出来,并记录显存与时间开销:
capture = capture_cuda_graphs( model_runner=self, capture_decode_cuda_graph=( capture_decode_cuda_graph and not defer_decode_capture ), finalize=not defer_decode_capture, defer_distributed_setup=defer_decode_capture, ) self.eager_runner = capture.eager_runner self.prefill_cuda_graph_runner = capture.prefill.runner self.decode_cuda_graph_runner = capture.decode.runner self.graph_memory_usage = capture.memory_usage self.graph_time_usage = capture.time_usage这三个 runner 的顺序也有讲究:注释里写着 init_attention_backends 必须在 init_decode_cuda_graph 之前,因为捕图时要用到注意力后端的 workspace;而 alloc_memory_pool 必须在 init_decode_cuda_graph 之前,因为 warmup 前向会流经 KV 池,池对象必须先存在。
Breakable CUDA Graph:把 eager 断点插进捕获过程
前面提到 prefill 走的 CUDA Graph 是分段形式。这一节把机制讲清楚,因为它解释了为什么执行层要同时维护”整图”和”分段”两种捕获策略。
难点是这样的:CUDA Graph 要求被捕获的区域完全由图兼容的算子组成,但真实前向里总有一些算子做不到。典型例子是 prefill 注意力:某些注意力后端会从运行时元数据里读序列长度并做 host 端准备,这类行为在捕获时无法安全重放。一个不兼容算子就足以让整段前向无法被图覆盖——捕获一旦遇到它就必须整体放弃。
为什么”整体放弃”是常态而不是例外
要理解这个问题的严重性,得先明确 CUDA Graph 的前提条件。捕获阶段记录的是设备端操作的序列,重放时按同样的顺序重新执行。这要求几件事同时成立:算子序列在每次重放时完全一致(没有依赖数据的 host 端分支)、所有输入输出缓冲区地址固定、以及没有任何 host 与 device 之间的同步往返。
推理前向里违背这三条的算子并不少见,而且往往集中在这一层刚刚处理完的那些元数据上。举几个具体的例子。
其一是注意力后端的 plan 阶段。FlashInfer 这类后端在真正计算前要先根据每批的序列长度与分页表构造一个调度计划,这个计划在 host 端计算、然后作为张量送进 device。序列长度是每轮变化的,因此 plan 的内容每轮不同——但只要形状固定,把 plan 张量当作”图的输入”而不是”图内的计算”就能解决,这正是分段捕获的做法:plan 阶段留在 eager 段,注意力计算段捕进图。
其二是集合通信里的运行时协调。MoE 的 all-to-all、TP 的 all-reduce 在某些后端下需要主机参与决定分组或缓冲切换,这类分支无法在捕获时固化。
其三是服务特性带来的动态状态更新。分层缓存要在前向中更新命中计数、确定性推理要对某些中间量做累积、LoRA 要在批次切换时换适配器权重。它们的输入是”这一轮的服务状态”,捕获时无法预知。
把这三类放在一起,结论就很清楚了:在一套真实的服务栈里,完全图兼容的前向是罕见的,部分不兼容才是常态。这决定了捕获策略必须能容忍断点,而不是把”全图捕获”当作唯一目标。
断点的位置由服务逻辑决定,而不是由编译器决定
这是 BCG 与基于编译器的分段方案最本质的区别,也是执行层源码里那条”图边界可以跟着服务逻辑走”的判断依据。
编译器路径的工作方式是反过来的:先把整个前向追踪成一张完整的计算图,再在图里找出可以切分的位置,最后把每块编译并捕获。这个流程有两个内在约束。
第一个约束是可见性。要让 torch.compile 看见自定义 kernel,就得把它们包装成它认识的形式——注册成 torch.library 算子,并附上一个只描述形状与类型的 fake implementation 供追踪使用。SGLang 大量使用自定义 CUDA、Triton 与 JIT 编译 kernel,于是这套”注册 + 写假实现”的脚手架会散布在整个 kernel 栈里。它本身不改变 kernel 行为,但把编译器的存在渗透进了一层本该与编译器无关的代码。
第二个约束更硬:切分点必须落在编译器能表示的接口上。跨过图边界的输入输出必须能被编译器表达。当自然边界涉及专门的运行时状态或特殊返回类型时,就只剩两种选择——换一个不那么自然的切分点,或者把 eager 区域撑大来凑出一个编译器能处理的接口。这两种选择都在把工程结构往编译器方便的方向拽,而不是往服务逻辑方便的方向放。
随着 DP attention、MoE all-to-all 后端、LoRA、PD 分离、分层缓存、确定性推理这些特性快速演化,这个问题会持续放大:每加一个新 kernel 往往意味着一次自定义算子注册与假实现,每加一个新特性都可能逼着挪动图边界。作者在博客里用”做 CUDA Graph 支持越来越像一个 torch.compile 集成项目”来概括这种感受,这个说法很准确地描述了约束的迁移方向。
BCG 把决定权拿回来:断点由开发者用标注显式给出,图系统不需要理解被标注函数怎么实现、也不需要追踪它内部。于是图边界服从的是服务逻辑里哪些部分天然无法捕获,而不是编译器能表示哪些接口。
一个具体的工作量对比
博客给了一组很能说明问题的数字:达到同样的分段执行结构,BCG 的实现是 521 行,而基于 torch.compile 的 piecewise 后端是 1,771 行。大约是四分之一。
行数差在哪?主要差在编译器适配的脚手架:自定义算子注册、fake implementation、切分点的注册与选择逻辑、以及为满足类型要求而做的接口适配。这些代码的存在理由只有一条——让编译器能工作;一旦捕获路径上不再有编译器,它们就整体消失。
与之配套的是启动时间。编译(而不是捕获)才是编译器方案里耗时的大头:占准备 prefill 图时间的 78–86%,且随模型复杂度增长,在 235B MoE 上达到 90 秒,在 GLM-5.2 上达到 158 秒。BCG 把这一阶段整个去掉,一趟捕获就得到分段执行。对开发流程而言还有一个隐性收益:在当时的 CI 配置里编译经常在测试之间重复发生,导致 CUDA Graph 相关测试明显变慢;把编译器从捕获路径上拿掉,也就顺手把这层复杂性从开发循环里移除了。
边界缓冲区的设计细节
回到机制本身。跨断点的数据传递是这套方案里唯一需要真正设计的部分,因为它必须同时满足两个相反的要求:边界地址在捕获与重放之间固定,而 eager 段的输出又必须是新鲜的计算结果。
做法是把这两件事分开:捕获阶段被标注的函数真实执行一次,返回的张量被保留下来作为持久的边界缓冲区,它的设备地址就此固定,后续图段就是针对这个地址捕获的。重放阶段 eager 函数照常执行、返回一个新的张量,BCG 负责把新张量拷贝进那个保留的缓冲区。于是下一段图从它当初捕获时的地址读到的,就是最新一次 eager 计算的结果。
这个设计的精妙之处在于它把”地址稳定”与”数据新鲜”这两个要求拆给了两个不同的机制去满足:地址由保留缓冲区保证,数据由每次重放的拷贝保证。代价是一次额外的设备端拷贝,但因为只发生在边界上、且通常只在少数几个位置,相对于它换来的捕获覆盖面,这个代价是可以接受的。
同时它带来一个重要的性质:BCG 从不检查或追踪 eager 段内部的操作。eager 段只需要能正确执行。这意味着可以在断点里放任何东西——带 host 端同步的 plan 阶段、依赖运行时状态的协调逻辑、甚至临时的调试代码——只要它执行正确,捕获与重放就成立。这条性质是前面所有收益的技术根源。
两种”分段”的等价与不等价
从功能角度看,BCG 与基于编译器的 piecewise 后端产出的是同一类结构:CUDA Graph 段之间夹着 eager 区域。两者在重放语义上等价,差别只在结构是如何被构造出来的——编译器方案先让编译器理解整次前向、再切开;BCG 在捕获进行中直接放置切分点。
这个等价性有一个直接的工程后果:两者可以在同一套 runner/backend 接口下互换。前面提到的重构把”runner 管理执行相关的状态”与”backend 决定如何捕获”分离开,正是因为历史上已经出现了三种捕获方式(整图、BCG、编译器分段),把它们的差异收进 backend 接口、让 runner 对三者一视同仁,才能避免每种执行路径各写一套捕获逻辑。博客里对这次重构的描述是:重构之前 decode、prefill、投机解码各自拥有自己的 CUDA Graph runner,在捕获形状、静态缓冲区、重放与图配置上有大量重叠;runner 只依赖公共 backend 接口之后,每条执行路径可以独立选择捕获策略——prefill 与 decode 各有 runner,投机解码再在此基础上加出 EAGLE 草稿、草稿扩展与冻结 KV 的 MTP 草稿各一个 runner,而目标验证直接复用 decode runner(因为它只是每次请求验证多于一个 token)。
SGLang 的解法是允许在捕获进行到一半时主动中断。SGLang 团队在官方博客 Advanced CUDA Graph Techniques in SGLang 中记录了这套机制的名字与来历:Breakable CUDA Graph(BCG)由 SGLang 团队提出、命名、实现并开源,首次实现见 2026 年 2 月 21 日的 PR #19102,prefill 扩展见 4 月 24 日的 PR #22218,此后成为 prefill 的默认策略。
机制本身不复杂:不兼容的算子用 @eager_on_graph 标注;捕获执行到被标注的函数时,当前图段关闭,函数以 eager 方式跑一次,之后开启新的一段继续捕获。于是整次前向变成”图段 — 断点 — 图段”的序列。
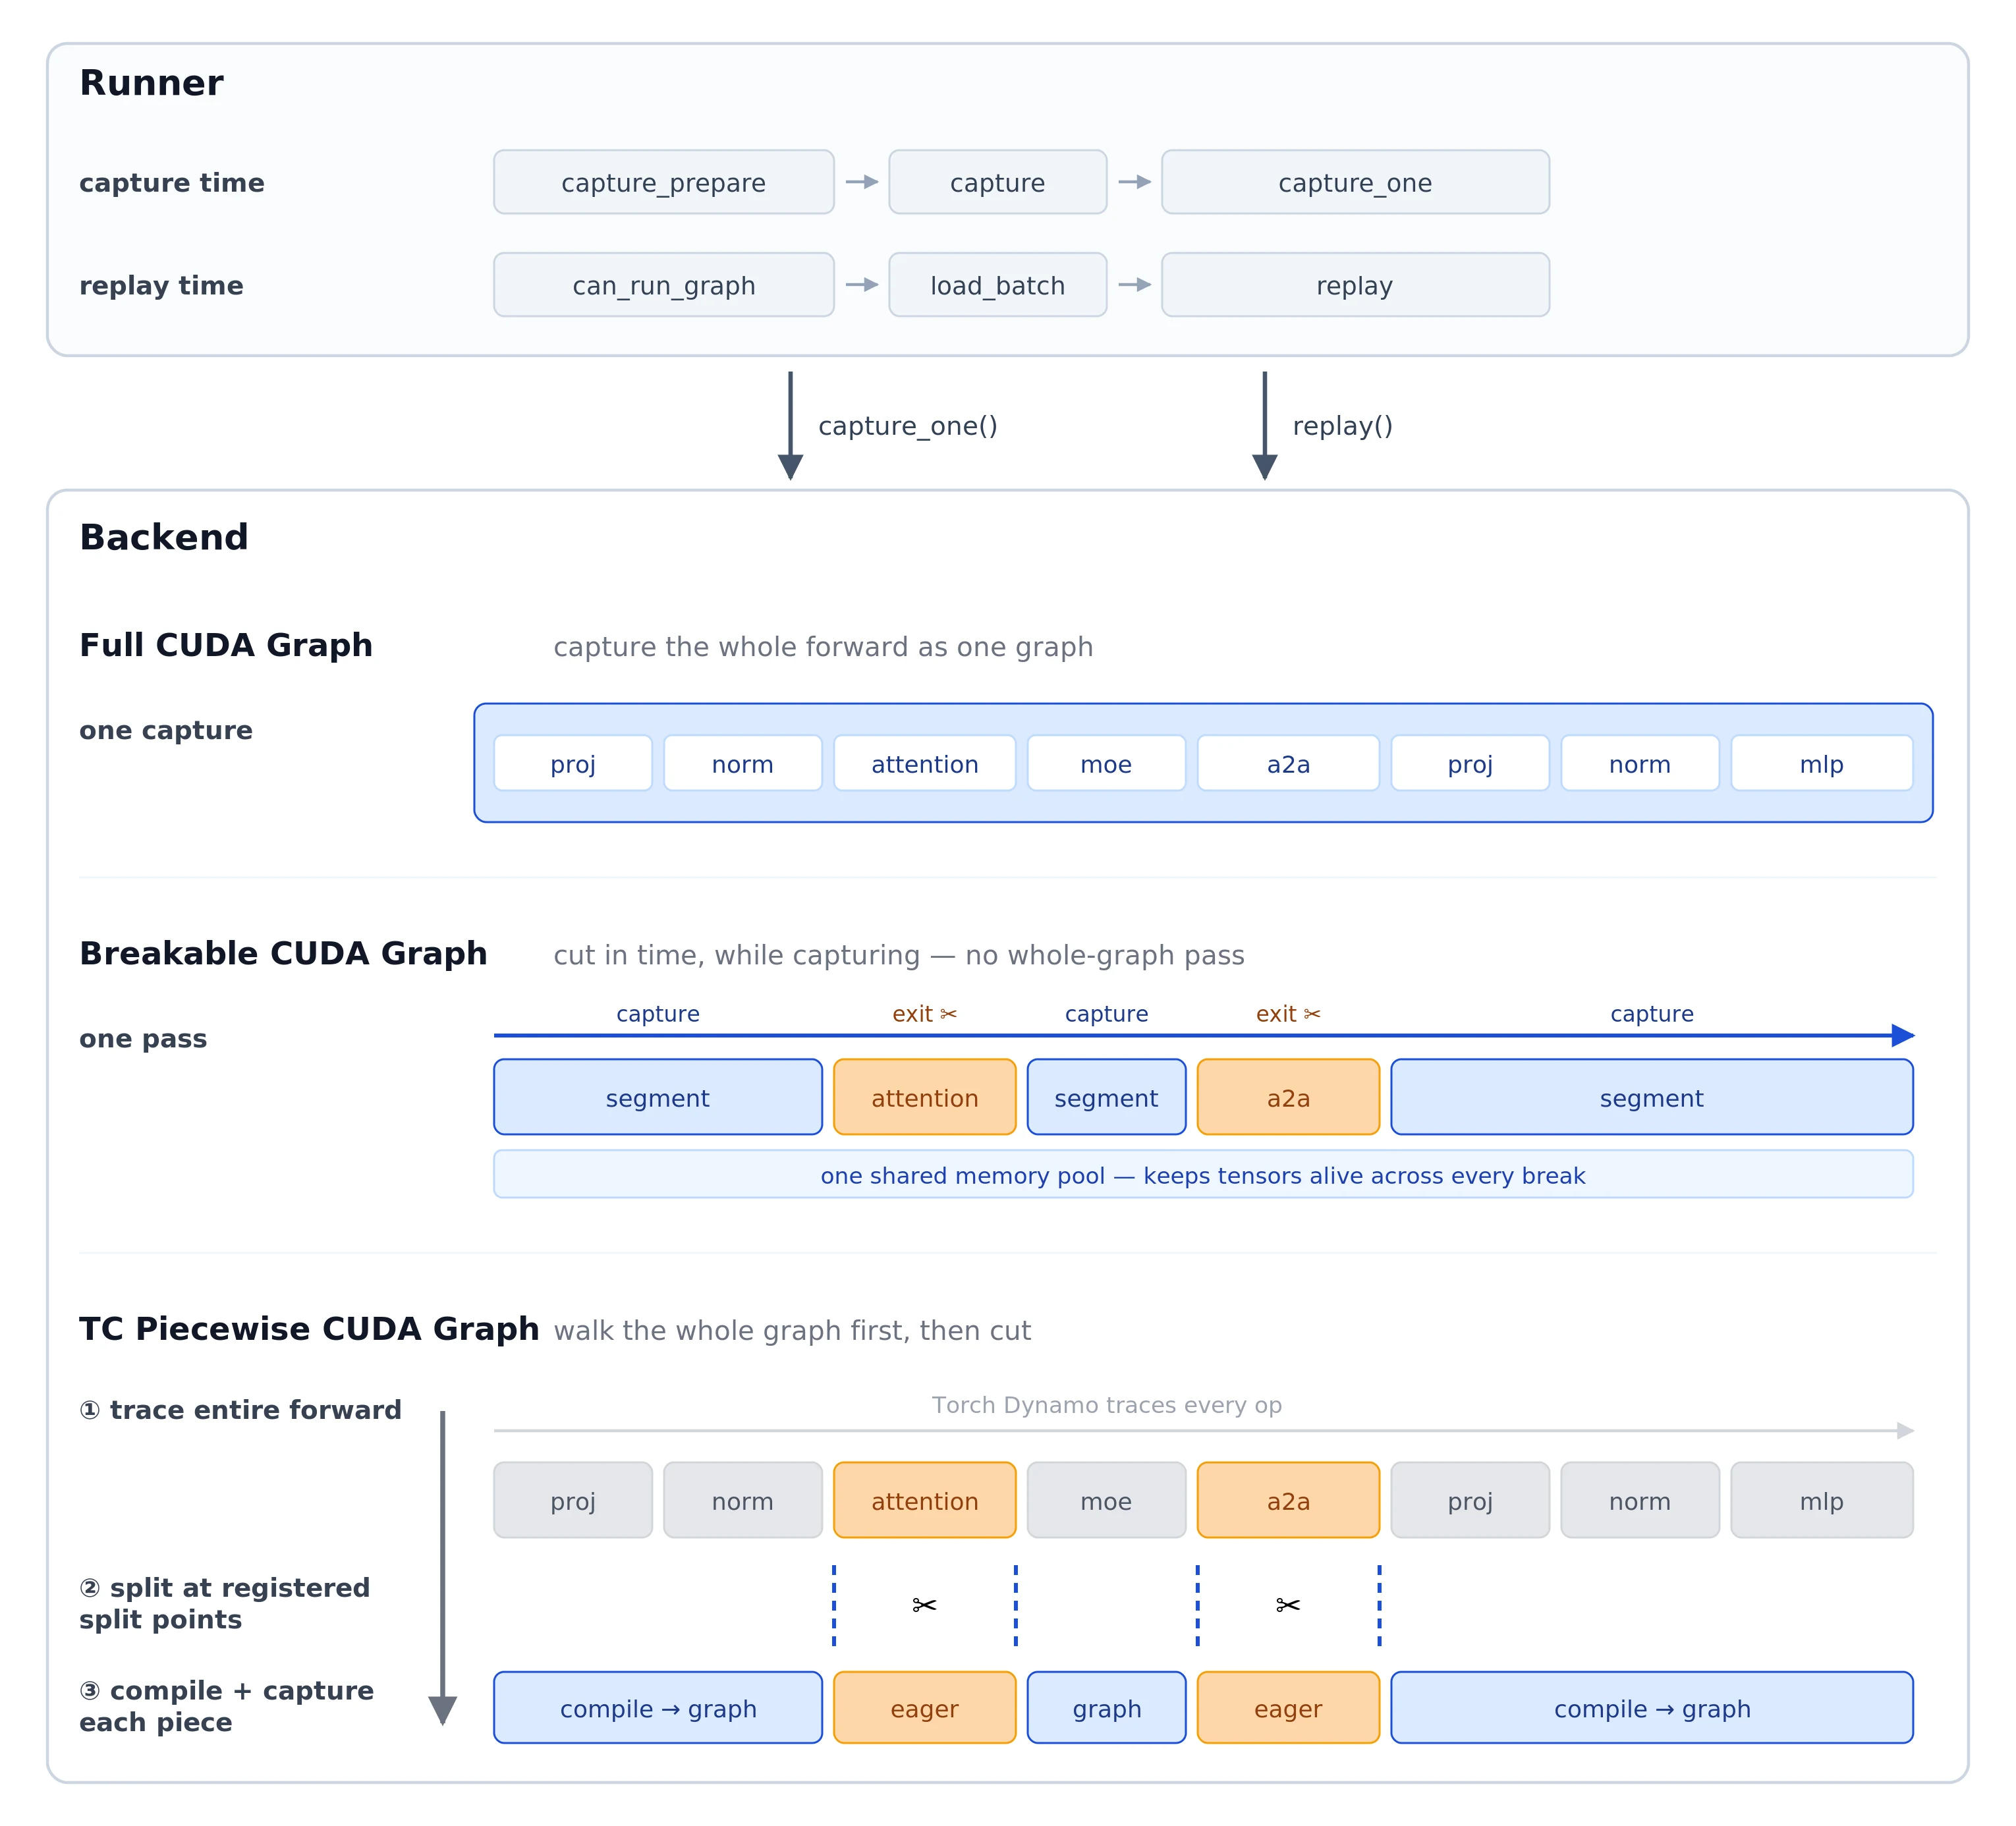
图源:SGLang 官方博客 Advanced CUDA Graph Techniques in SGLang。图中把一次前向拆成若干图段与若干 eager 断点,断点两侧的图段各自独立捕获。
真正需要设计的是跨断点的数据传递。博客里给出了答案:捕获阶段被标注的函数会真实执行一次,它返回的张量被保留为持久的边界缓冲区,设备地址固定;后续图段就是针对这个固定地址捕获的。重放时 eager 函数照常执行并返回一个新的张量,BCG 把它拷贝进那个保留的缓冲区,于是下一段图从它当初捕获时的地址读到最新值。这套做法避免了对 eager 区域的任何追踪:BCG 从不检查 eager 段内部做了什么,只要求它能正确执行。
这个”不追踪”的性质带来了四个工程上的好处,其中两个对本篇的源码阅读最直接。
一是兼容性。SGLang 大量依赖自定义 CUDA、Triton 和 JIT 编译的 kernel,它们不是原生 PyTorch 算子。要让 torch.compile 看见它们,往往得用 torch.library 包一层并写 fake implementation 供追踪使用。更麻烦的是,编译器还限定了图边界能放在哪里:跨算子边界传递的输入输出必须能被编译器表示,当自然边界涉及更专门的运行时状态或返回类型时,就必须换个切分点、或者把 eager 区域撑大来凑出一个编译器能处理的接口。BCG 去掉了这个约束——断点处不需要理解被标注函数的实现,图边界可以跟着服务逻辑走,而不是跟着编译器追踪和类型要求走。
二是启动速度。基于编译器的分段方案中,耗时大头是编译而不是捕获:torch.compile 占准备 prefill 图时间的 78–86%,并且随模型复杂度增长,在 235B MoE 上达到 90 秒,在 GLM-5.2 上达到 158 秒。BCG 取消了这一阶段,一趟捕获就得到分段执行。博客给出的实测是在 4×GB300、TP4、42 个捕获形状下构建 prefill CUDA Graph 的时间对比;BCG 比编译器路径快 3.8–5.2 倍。
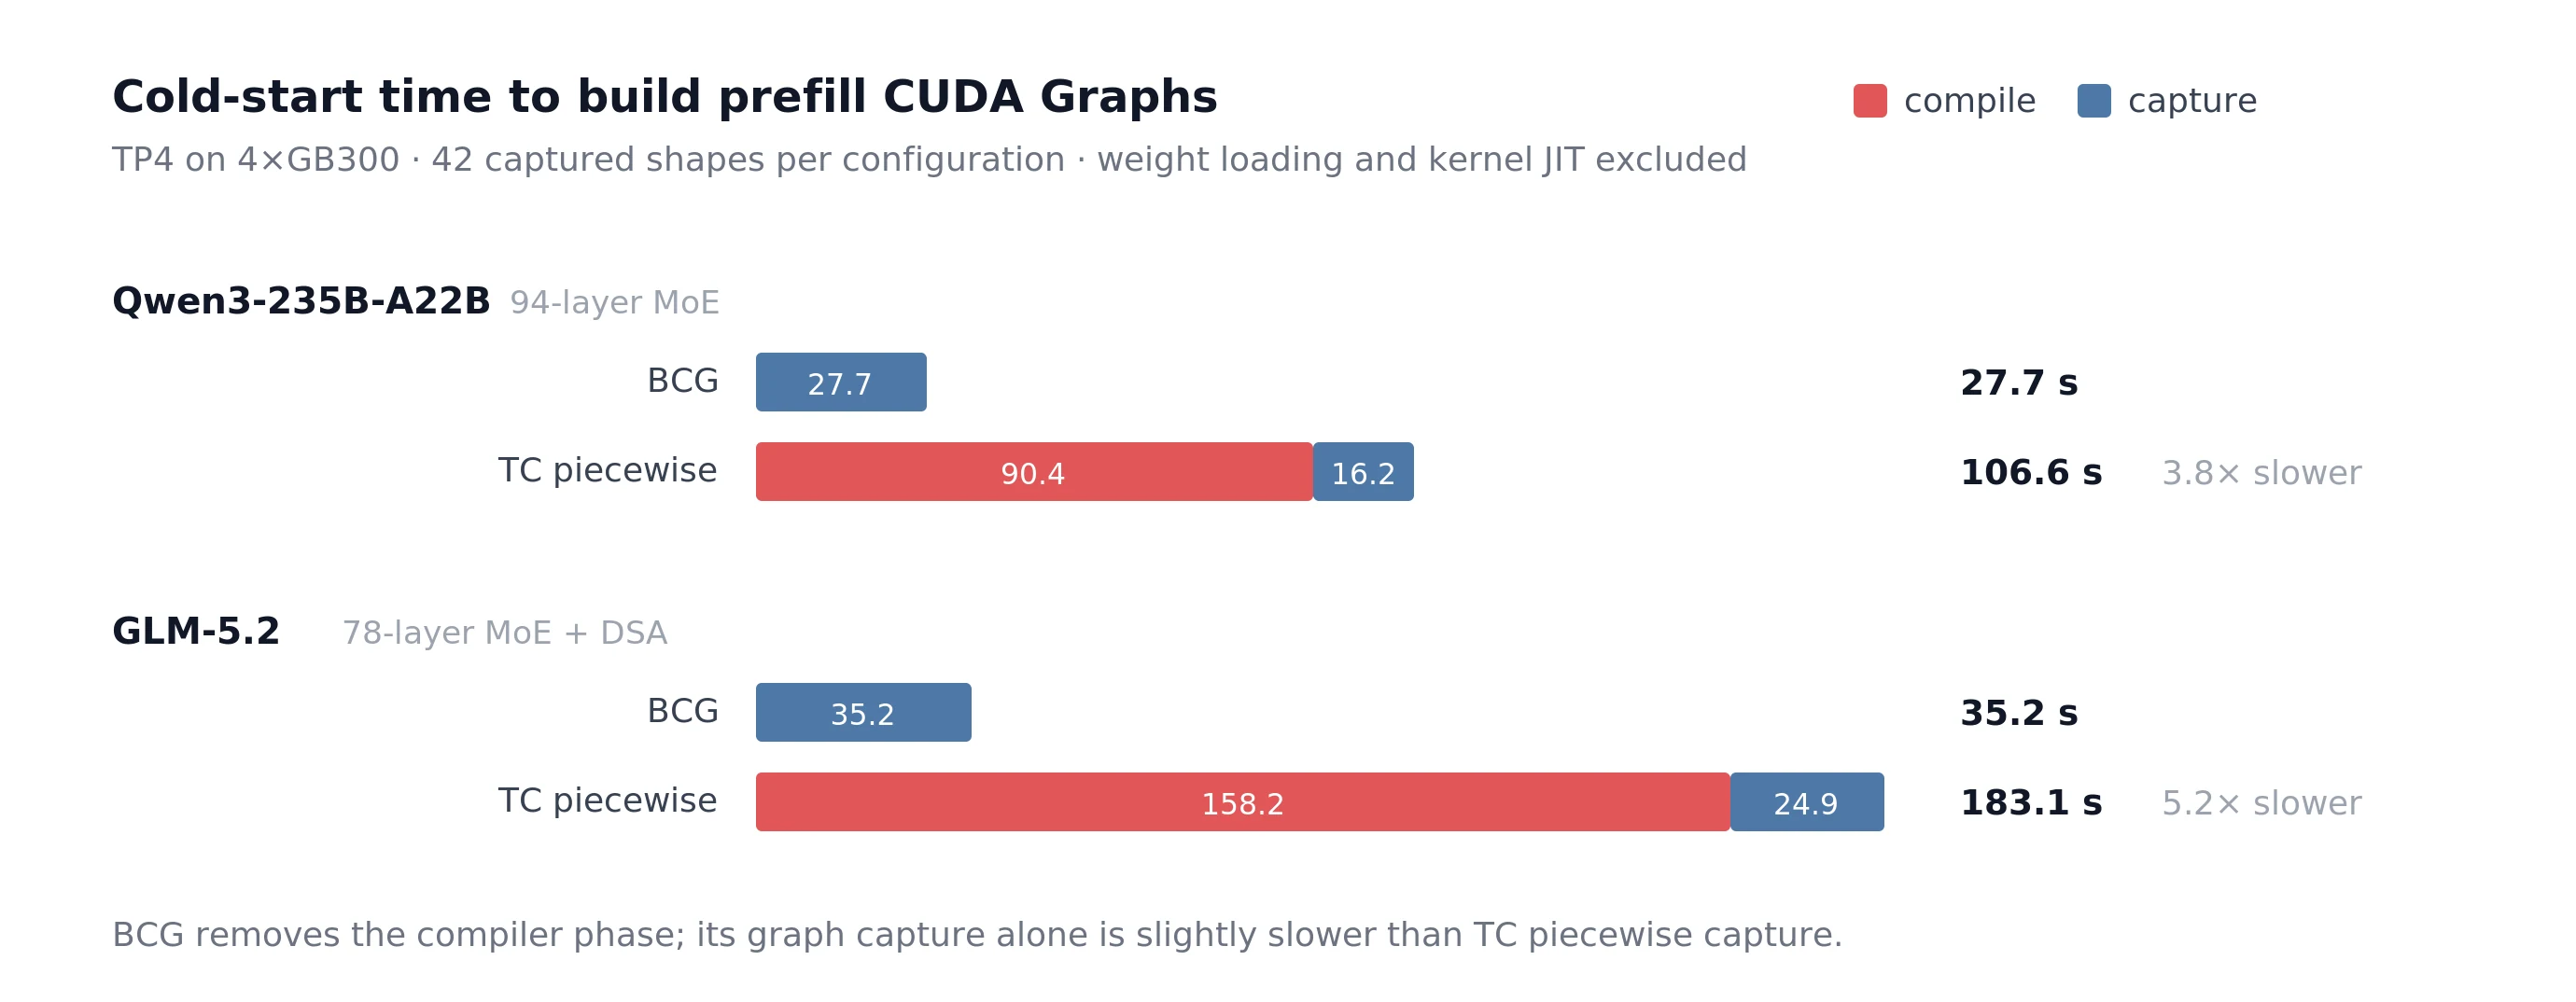
图源:SGLang 官方博客 Advanced CUDA Graph Techniques in SGLang。BCG 去掉了编译阶段,单趟捕获即得分段执行结构。
三是可调试。被捕获的图重放时是一个不透明的整体,普通 Python 不会在里面执行,print、断言和单步检查都很难做。BCG 天然留下了若干 eager 区域,普通 Python 每次重放都会跑。SGLang 进一步提供了 --debug-cuda-graph,它实际上把整次前向包成一个 eager 断点:模型以 eager 方式执行,但仍然走 CUDA Graph runner、静态缓冲区、重放路径和元数据准备。于是得到一个可用的诊断边界——如果问题依旧存在,它多半在模型或 runner 路径里;如果问题消失了,捕获本身就是首要嫌疑。
四是覆盖范围。BCG 无需编译器即可工作,因此在接入 DP attention、MoE all-to-all 后端、LoRA、PD 分离、分层缓存、确定性推理等快速演进的特性时,不需要为了满足编译器而反复挪动图边界或注册自定义算子。
同一个机制也被扩散模型栈采用。扩散去噪过程会反复执行同一个 DiT 前向,而这些前向里有很多小的、受启动开销支配的 kernel,正是 CUDA Graph 最有效的场景。这里的形状维度比文本侧更宽:分辨率、视频帧数、prompt 条件长度、CFG 模式、以及所选 transformer 都会影响捕获签名,因此实现上是”预热真正会被服务的形状,遇到未见过签名就退回 eager”。
prefill 整图捕获:用 padding 换掉形状维度
BCG 把 prefill 的覆盖范围推进了一大步,但它仍然是分段执行。更进一步的做法是把整段 prefill 前向都捕进一张图,SGLang 在这个方向上也做了开创性工作(配合 FA4 与 FlashInfer 注意力后端)。
难点在于形状。decode 之所以能整图捕获,是因为每个请求只贡献一个 token,唯一的形状变量是 batch size,用一组桶就能覆盖。prefill 的 token 数随请求长度连续变化,无法穷举。解法是 padding:把实际批次补到一个固定的最大形状,让每次前向的输入张量形状完全相同。
padding 的代价是显而易见的——多算的 token 白费算力。所以这里有一个明确的权衡:全图捕获相对 eager 在 prefill 上快 1.93 倍,而 BCG 分段方案是 1.70 倍。多出来的收益来自重放时更少的启动次数,代价是补齐浪费。注意这两组数字测的都是 prefill 单独一段。
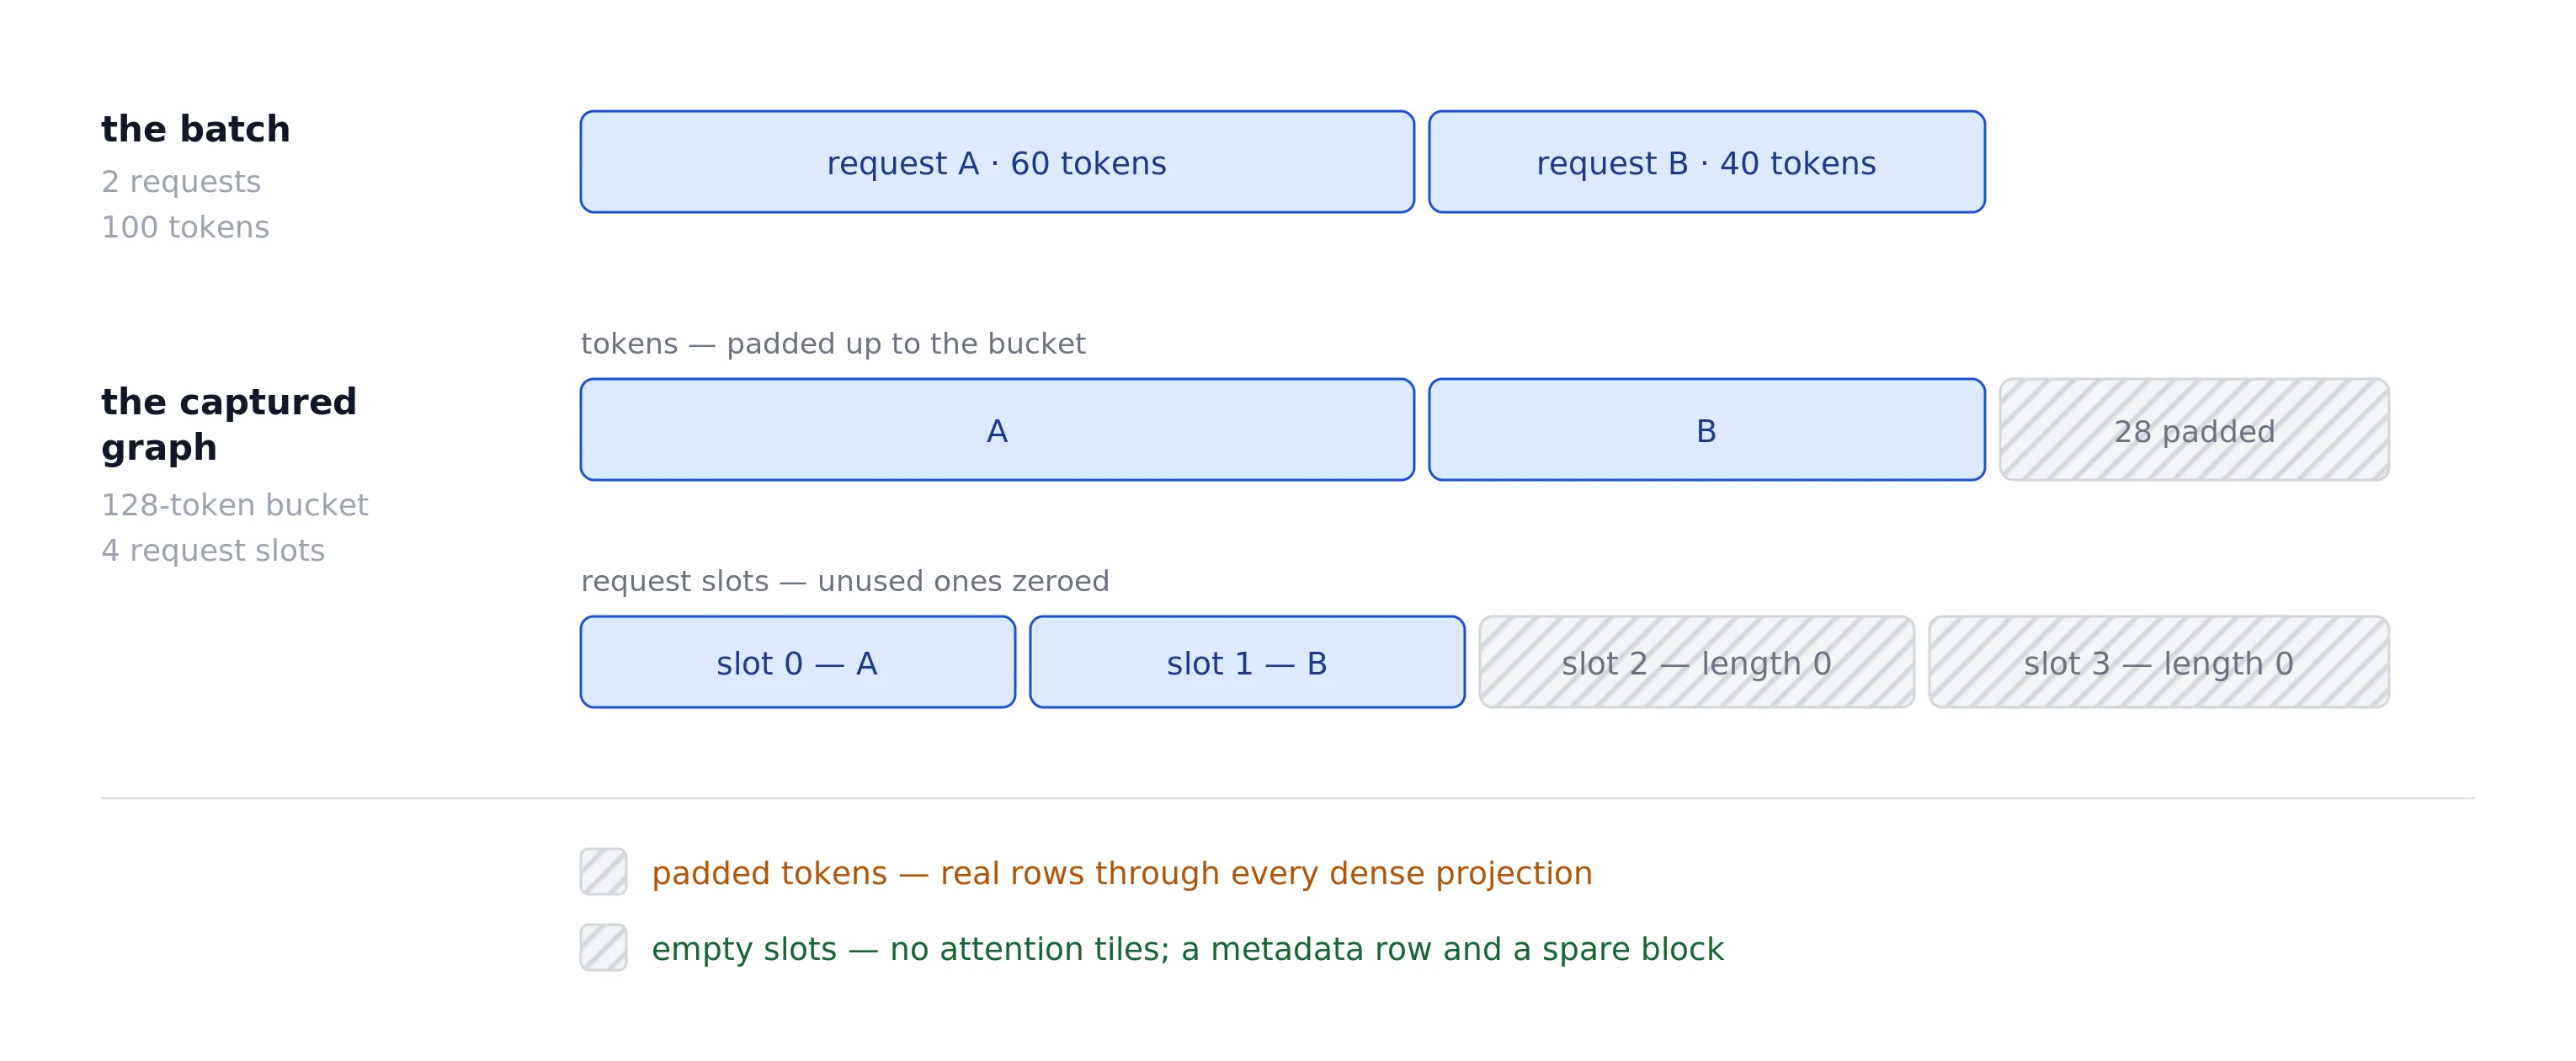
图源:SGLang 官方博客 Advanced CUDA Graph Techniques in SGLang。整图捕获把动态 prefill 批次补齐到固定形状,使整次前向成为一张可重放的图。
这部分与本篇的关系在于:padding 正是前文 num_token_non_padded 那组字段的存在理由。补齐出来的 dummy 行必须被一路标记清楚,让 MoE 的 top-k 掩掉它们、让采样器最终切掉它们。也就是说,整图捕获的收益能否兑现,取决于执行层是否把”真实 token 数”这个标量维护得足够干净。把这两个看似无关的部分连起来,才能看出 ForwardBatch 里为什么会有那么多关于 padding 的字段。
CUDA Graph 的显存账
分段捕获还有一个常被忽略的收益:显存可以跨形状与跨图段复用。博客里把这一点单独作为一节,因为随着图形数量增长,图的显存占用会成为实际的部署约束。
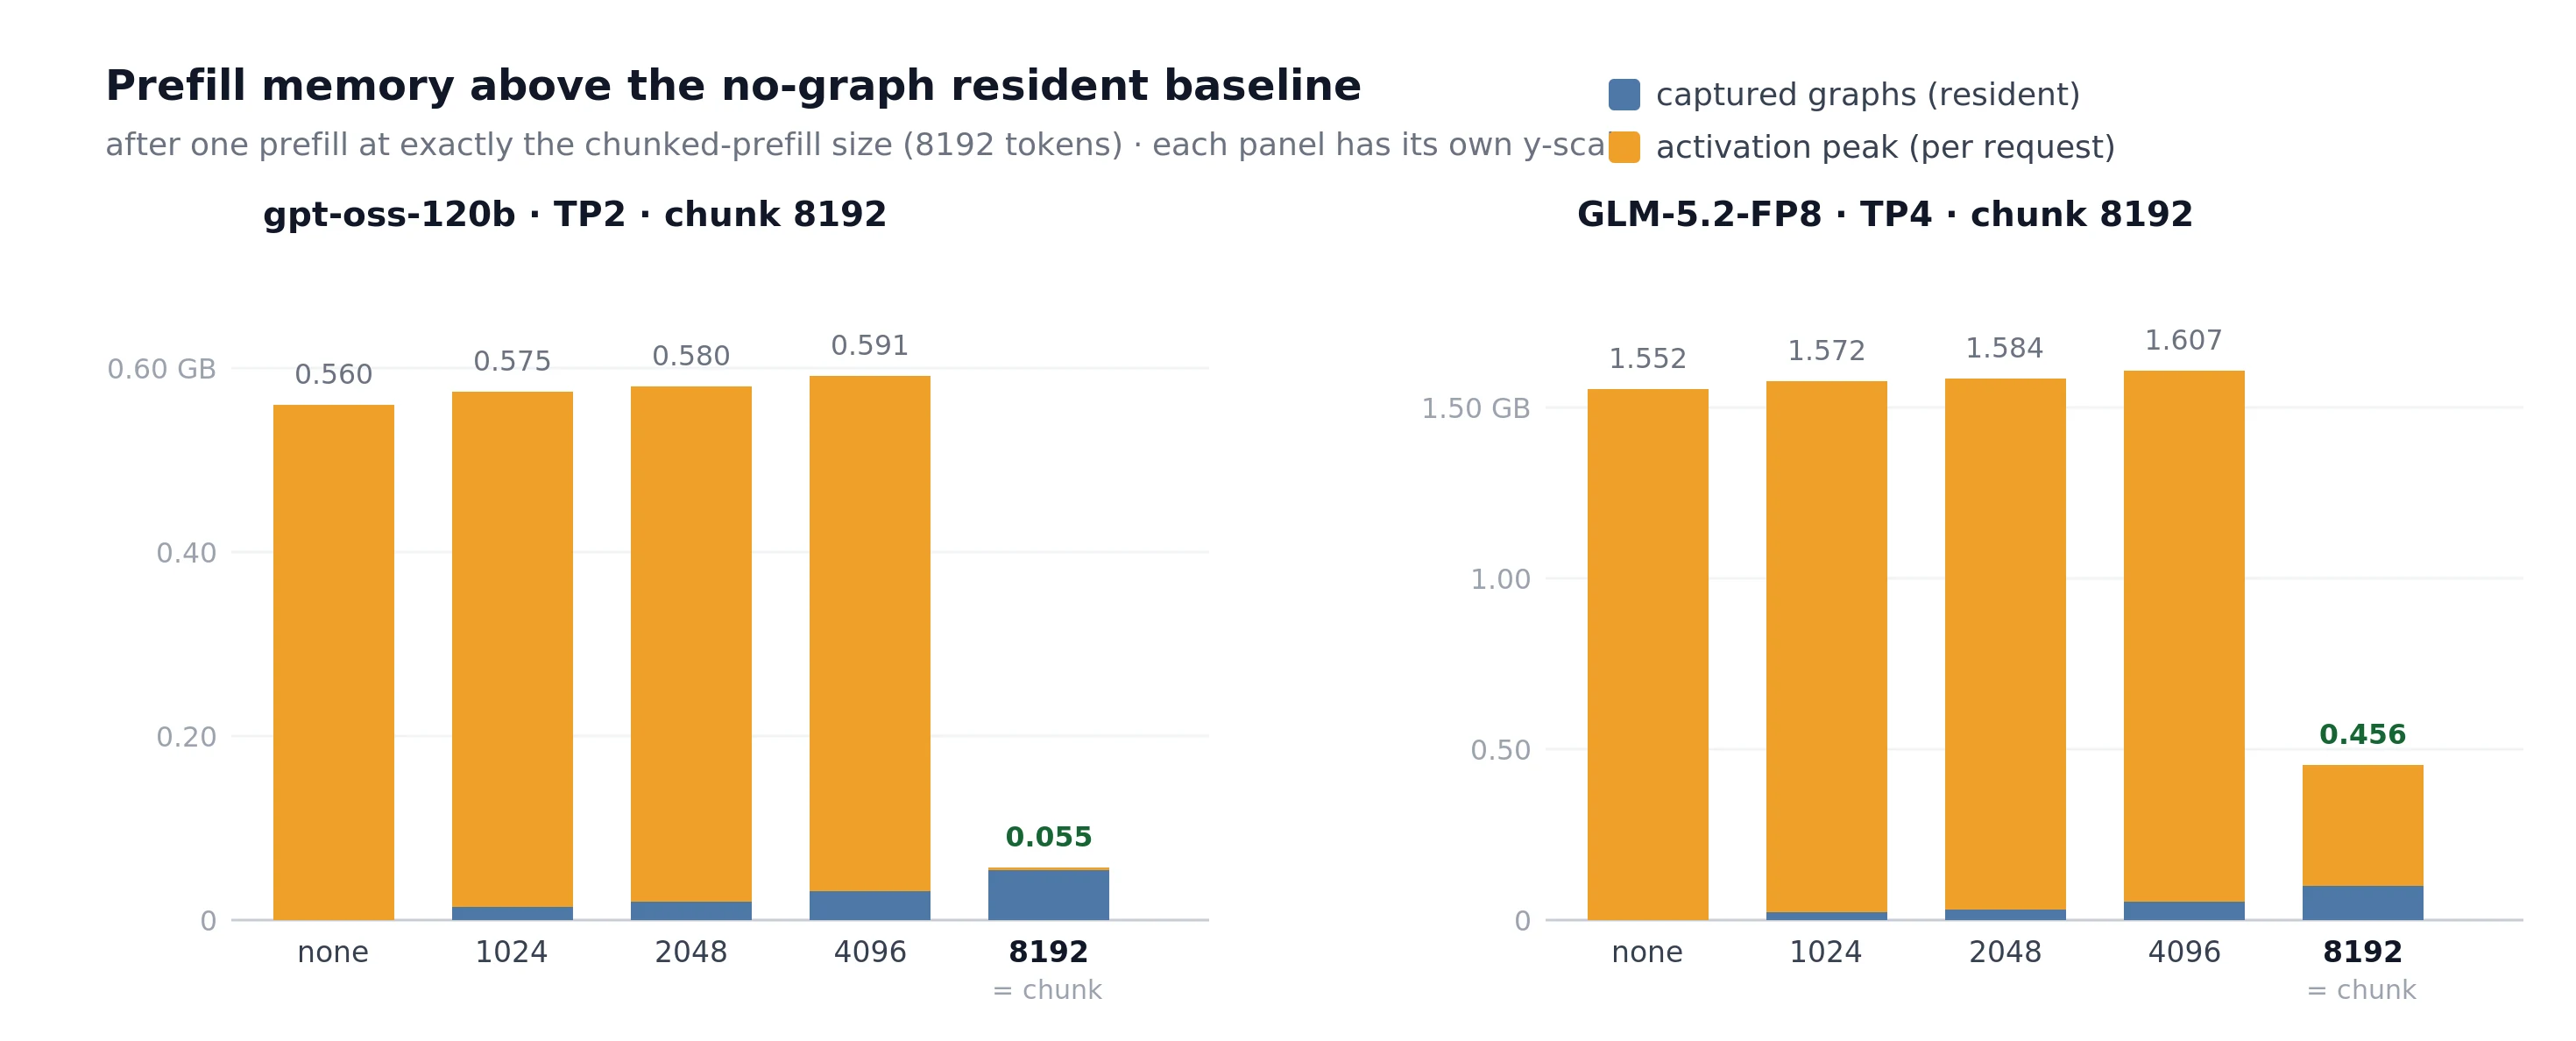
图源:SGLang 官方博客 Advanced CUDA Graph Techniques in SGLang。当一次捕获被切成多个图段时,各段的中间缓冲区生命周期不重叠,因而可以共享同一块显存。
这件事对整体显存管理的影响是渐进的:捕获形状越多,图占的显存越多,留给 KV Cache 的就越少。所以在 init_cuda_graphs 里把 graph_memory_usage 与 graph_time_usage 记录到 ModelRunner 上,不只是为了打日志,它也是容量规划的输入。
为什么这些决定不能放在别处
把本篇的内容收束成一个问题:前面这些逻辑——hidden state 捕获模式、位置生成、padding 到 TP 倍数、非填充计数、KV 计划翻译、执行路径选择、图段与 eager 断点——为什么不能放进调度器或模型定义里?
不能放进调度器,因为它们依赖执行时的物理事实:TP 大小、是否启用序列并行、注意力后端类型、图捕获了哪些 batch size、显存里是否真的建起了 graph runner。调度器的输入是逻辑请求与逻辑 KV 预算,它对 GPU 拓扑应当是无知的——否则同一个调度逻辑无法跨部署复用。
不能放进模型定义,因为它们依赖部署配置而非模型结构:同一个模型定义在不同 TP 大小、不同注意力后端、不同 CUDA Graph 策略下,需要完全不同的形状处理。把 padding 与 shape 归一化写进模型会让模型无法跨部署复用。
所以这一层的位置是被夹出来的:上界是”调度器能知道的逻辑信息”,下界是”kernel 需要的具体形状”。ForwardBatch 就是这两个世界之间的兑换窗口——进来的是一轮决策,出去的是一批形状确定的张量、索引与元数据。理解了这一点,init_new 里那些看似琐碎的字段就会各归其位。
小结
SGLang 的执行层可以用三段职责概括。
ForwardBatch.init_new 把 ScheduleBatch 兑换成设备执行契约:确定 ForwardMode、从 host 端整数列表造出 positions 与 extend_start_loc、按模式决定哪些 extend 字段为空、翻译 KV 写入计划、固化 hidden state 捕获模式、并把”真实 token 数”这个标量维护到 GLOBAL 与 LOCAL 两个作用域。它遵守一条单向契约:不修改输入 ScheduleBatch。
TpModelWorker.forward_batch_generation 把一次前向放进部署拓扑:非最后一段只传递激活值、不采样;最后一段在重叠调度下把采样推迟为闭包,在 prefill-only 请求上造出 per-request 而非 per-token 的假 token id;验证阶段跳过采样交给投机子系统。
ModelRunner._forward_raw 在三条执行路径之间分派:decode 走整图重放、prefill 走分段图(BCG)、其余走 eager;padding 与计数归一化只在非重放路径上做,因为重放路径的形状由捕获时的静态缓冲区决定。init_cuda_graphs 把三种 runner 一起建起来并记录显存与时间开销,供容量规划使用。
下一篇沿 attention backend 继续向下:ForwardBatch 里那些元数据如何被构造成后端能吃的 KV 索引与 mask、build_attention_backends 如何在 prefill 与 decode 上选择不同后端、以及注意力层在整条模型前向里的执行边界在哪里。
参考资料
- SGLang: Efficient Execution of Structured Language Model Programs(arXiv)
- SGLang: Efficient Execution of Structured Language Model Programs(NeurIPS 2024)
- Advanced CUDA Graph Techniques in SGLang(LMSYS 官方博客)
- SGLang v0.4: Zero-Overhead Batch Scheduler 官方发布文章
- SGLang 官方 GitHub 仓库
- ForwardBatch 与 ForwardMode 源码(固定提交)
- TpModelWorker 源码(固定提交)
- ModelRunner 源码(固定提交)
- ScheduleBatch 与 Req 数据结构源码(固定提交)
- Breakable CUDA Graph 初始实现 PR #19102
- BCG 扩展到 prefill 的 PR #22218
- SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
- SGLang 源码完全拆解(六):Overlap Scheduler 如何重叠 CPU 调度与 GPU 执行
- CUDA Graph 完全拆解:从逐次 Kernel Launch 到可重放推理执行图
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



