


SGLang 源码完全拆解(二十四):可观测性——一个请求的每一段时间、每一块 KV 与每一个专家,是怎么被记成指标的
这一篇要回答的问题
前面二十三篇沿着请求路径读完了 SGLang 的调度器、PrefillAdder、RadixCache、HiCache、Overlap Scheduler、DP Attention 与投机解码。那些文章回答的是「它怎么跑」;这一篇换一个方向,回答「它跑得怎么样,怎么从数字里看出来」。
一个推理服务出问题时,工程师面对的是三个彼此独立的问题:
- 一条请求的时间到底花在哪一段?是在排队、在 prefill、在 decode,还是在 tokenizer、在 KV 传输、在 HTTP 回传?
- 吞吐为什么掉下来了?是 KV 池满了、批太小、某个 TP rank 在等别人、前缀缓存没命中,还是投机解码接受率变差?
- 同一个模型、同一份权重,为什么这一小时的 P99 和上一小时不一样?差异来自负载结构、缓存状态,还是某个进程的空转?
日志能回答一部分,但它没有稳定的聚合口径;单次 profiling 能回答一部分,但它无法长期在线;Prometheus 指标能持续聚合,却只给快照,不告诉你一条请求内部发生了什么。SGLang 的可观测性设计,本质上是把这三类信息拼成一套账本:指标负责长期趋势,请求时间戳负责单请求归因,OpenTelemetry span 负责跨进程因果链。
本文沿着当前源码的 python/sglang/srt/observability/ 目录和 python/sglang/srt/managers/scheduler_components/metrics_reporter.py 展开。需要先说明一个源码阅读上的坑:SGLang 在版本演进中把原来的 srt/metrics/collector.py 迁到了 srt/observability/metrics_collector.py,同时把调度器侧「什么时候采样、采样哪些字段」从 scheduler.py 拆进了 SchedulerMetricsReporter。如果你按旧文章里的路径去找,会找不到对应文件。目录名从 metrics 改成 observability,也正好说明了范围:它不只做 Prometheus 指标,还包含 trace、HTTP 中间件、请求阶段时间戳和函数级计时。
这一篇不重复调度算法本身。SGLang 的请求状态机可参考 SGLang 源码完全拆解(三):Scheduler 请求状态机如何闭环,Prefill 预算可参考 SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch,前缀树的所有权可参考 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环。这里只关心:那些模块在什么时刻、把哪个数字、以什么标签写进了哪本账。
采集器体系:谁在哪个进程里记账
SGLang 的一次请求会穿过多个进程:HTTP 入口进程、TokenizerManager、若干 Scheduler(每个 TP rank 一个,DP 时还有多组)、Detokenizer,PD 分离时还多出 prefill 与 decode 两套实例。指标不能只在一个地方记,因为每一段的事实只存在于对应进程里。于是代码把采集器按角色拆开,每个角色只回答自己那一段。
| 采集器 | 所在角色 | 主要回答的问题 |
|---|---|---|
SchedulerMetricsCollector | 每个 Scheduler rank | 队列长度、KV 池占用、吞吐、缓存命中、投机接受率、PD 队列、DP 平衡 |
TokenizerMetricsCollector | TokenizerManager / HTTP 前端 | 请求数、prompt / generation token 数、TTFT、ITL、E2E、TPOT、缓存来源 |
StorageMetricsCollector | HiCache 存储层 | prefetch / backup 的 token、页数、带宽、未完成与丢弃 |
RadixCacheMetricsCollector | 前缀树 / 分层缓存 | 驱逐 token 数、驱逐耗时、load-back、backup、丢弃原因 |
ExpertDispatchCollector | MoE / EPLB | 每层每个 GPU 的物理专家数、专家均衡度 |
EncoderMetricsCollector | 多模态编码器 | 图像缓存、预处理、前向、传输、端到端时延 |
这些类共享一个轻微但重要的设计:_StatLoggerDIMixin 允许外部注入 Counter、Gauge、Histogram 类。默认实现直接用 prometheus_client,但 Ray Serve、嵌入式调用或测试可以换成自己的后端。resolve_collector_class(role, default_cls) 再从 ServerArgs.stat_loggers 里按角色查覆盖类。这样引擎不需要知道指标最终写到哪里,采集器也不需要知道引擎被谁托管。
采集器不是无条件创建的。SchedulerMetricsCollector.init_new() 里先算几个布尔量:
enable_metrics = get_observability().enable_metricsis_stats_logging_rank = ( parallel.attn_tp_rank == 0 and parallel.attn_cp_rank == 0)current_scheduler_metrics_enabled = enable_metrics and ( is_stats_logging_rank or get_observability().enable_metrics_for_all_schedulers)is_stats_logging_rank 只让 attention TP rank 0、CP rank 0 负责打日志和导出「引擎级」指标。原因是 TP 组内每个 rank 看到的是同一批请求、同一套调度决策,只是权重分片不同;如果每个 rank 都导出同一组队列指标,多进程 registry 要么在 mostrecent 模式下让不同 rank 互相覆盖、曲线反复跳动,要么在计数型指标上把各 rank 的值相加,让结果变成 TP 倍。默认只让 rank 0 导出,是为了让「引擎级」序列保持可读。
但「只看 rank 0」会掩盖另一类问题:某个 rank 的 KV 池、专家分布、前缀缓存可能与其他 rank 不同。于是还有 --enable-metrics-for-all-schedulers:打开后,每个 rank 都导出,但必须配合 tp_rank、pp_rank、dp_rank、moe_ep_rank 这些标签一起看,否则多进程汇聚会把不同 rank 的序列混成一条。前缀缓存采集器甚至专门在 radix_cache_metric_labels() 里写死了 rank 标签,并在注释里说明:每个 scheduler rank 管自己那份 KV 分片,没有 rank 标签,多进程 registry 会把 TP 个 rank 的计数加成一个 TP 倍的数字。
指标标签由 init_new() 统一组装:
labels = { "model_name": get_serving().served_model_name, "engine_type": engine_type, "tp_rank": parallel.tp_rank, "pp_rank": parallel.pp_rank, "moe_ep_rank": parallel.moe_ep_rank,}if enable_priority_scheduling: labels["priority"] = ""if parallel.dp_rank is not None: labels["dp_rank"] = parallel.dp_rankif get_observability().extra_metric_labels: labels.update(get_observability().extra_metric_labels)engine_type 不是随便写的字符串,而是由 DisaggregationMode.to_engine_type() 得到的 prefill、decode、unified;如果开了 PD 角色切换,则统一写成 dynamic,避免同一个引擎在角色翻转后变成两条序列。priority 先以空字符串占位,因为 Prometheus 的标签集合必须在第一次创建时就固定;每次报数时再按队列里的实际优先级填值。这一点在后面讲队列指标时会再展开。
所有采集器都把 from prometheus_client import ... 放在 __init__() 内部,而不是模块顶层。这不是风格问题,而是多进程模式的硬约束:prometheus_client 在 import 时读取 PROMETHEUS_MULTIPROC_DIR 并选择对应的 value backend。SGLang 需要在 import 之前调用 set_prometheus_multiproc_dir(),因此只能延迟导入。源码注释里反复出现这句话,说明它曾经是一个真实的坑。
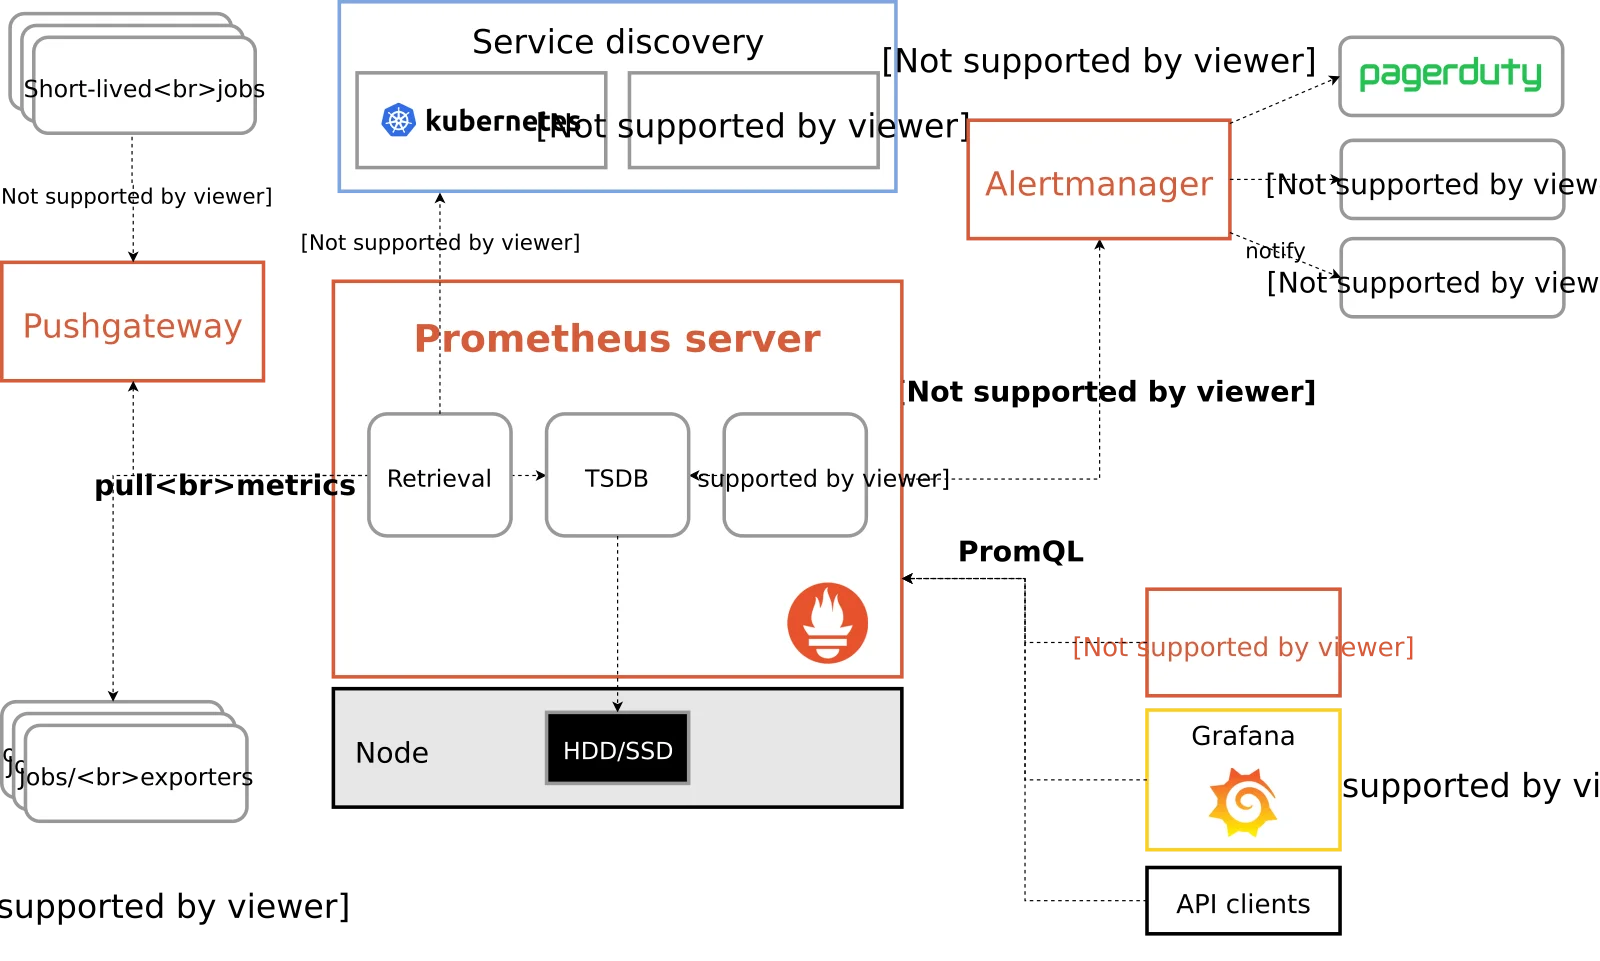
上图是 Prometheus 官方文档里的架构示意。SGLang 的 /metrics 端点扮演左侧的 exporter:Prometheus 每隔一个 scrape interval 来拉一次,把样本写进 TSDB,Grafana 再从查询层读数。理解这张图对读后面的多进程细节很关键:Prometheus 不保存请求对象,它只保存「某个标签组合在某个时刻的数值」。因此代码里每一个「这条请求现在处于什么阶段」都必须先被压成一个可聚合的数字,否则 Prometheus 根本接不住。
请求阶段账本:RequestStage 与 req_time_stats 的时间线
指标回答「整体」,但单请求归因必须落到时间戳上。req_time_stats.py 的核心是一个阶段表和一个按角色拆分的时间戳对象。
RequestStage:阶段名、层级与是否导出指标
@dataclassclass RequestStageConfig: stage_name: str level: int = 0 metrics_is_observed: bool = FalseRequestStage 用这个结构列出全部阶段,大致可分五组:
- 入口与分发:
tokenize、api_server_dispatch、dpc_dispatch(DP Controller 分发) - 统一模式主链路:
request_process、prefill_waiting、prefill_forward、chunked_prefill、decode_forward、decode_loop - PD 分离 prefill 侧:
prefill_prepare、prefill_bootstrap、prefill_transfer_kv_cache - PD 分离 decode 侧:
decode_prepare、decode_bootstrap、decode_waiting、decode_transferred、fake_output、quick_finish - 投机与 CPU:
spec_draft、spec_verify、run_batch_cpu
level 同时服务两个用途。第一是 trace 的层级过滤:trace_level 越大,记录的 span 越多,__check_fast_return() 会用 level > self.trace_level 直接跳过。第二是表示阶段嵌套深度:decode_loop 是 level 3,因为它包住了多个 decode_forward(level 1);chunked_prefill 是 level 3,因为它包住多个 prefill_forward。
metrics_is_observed 则区分两种阶段。prefill_forward、chunked_prefill、PD 的 bootstrap / 传输阶段都会单独观察直方图;而 prefill_waiting 特意标成 False,注释写着“equal to observe_queue_time”——排队时间不通过阶段直方图记录,而是通过 queue_duration_s 单独累加。原因很实际:一条请求可能因为抢占多次重新进入等待队列,阶段直方图如果每次进出都打一个样本,会把一次请求的排队拆成若干小样本,分布形状失真;而 queue_duration_s 会把所有进入等待队列的时间累加成一个总排队时长,更接近用户体感。
时间戳分散在三个角色对象里
同一个请求在不同进程中看到的时间线并不相同,所以 ReqTimeStatsBase 下面有三个子类:
APIServerReqTimeStats : created → tokenize → dispatch → first_token → finishedDPControllerReqTimeStats : created → api dispatch → dpc dispatch(done)SchedulerReqTimeStats : wait_queue → forward → completion(统一模式) bootstrap_queue → wait_queue → forward → transfer_queue(prefill 节点) prealloc_queue → transfer_queue → wait_queue → forward(decode 节点)ReqTimeStatsBase.__getstate__() 把 enable_metrics 强制设为 False,只序列化 disagg_mode 和 trace_ctx 状态。这是因为请求对象会被 pickle 发到下游进程:采集器属于进程,不属于请求。请求跨进程后,新进程会通过 set_metrics_collector() 重新挂上自己的采集器。如果误把带锁的 Prometheus 对象也序列化过去,就会在子进程里拿到一个永远不属于当前 registry 的副本。
时间基准:perf_counter 加周期校准的偏移
细看 APIServerReqTimeStats.set_created_time():
ts = ts or time.perf_counter()self.created_time = ts所有内部时间戳都用 time.perf_counter(),因为它单调、高精度、不受 NTP 拨钟影响。但输出给用户和 trace 的 request_received_ts 必须是真实的墙钟时间,而 time.time() 与 perf_counter() 的差值会因 NTP 周期性变化。文件顶部因此维护一个全局偏移:
global_diff_realtime_monotonic = time.time() - time.perf_counter()
def calibrate_time_diff(): global global_diff_realtime_monotonic global_diff_realtime_monotonic = time.time() - time.perf_counter()ReqTimeStatsBase.new_from_obj() 每次创建新对象时调用一次 calibrate_time_diff();convert_time_to_realtime() 在输出时加上偏移。convert_time_to_realtime_ns() 进一步把结果乘 1e9,作为 OTel span 的起始时间。这里有一个隐含的假设:单条请求的时延尺度(毫秒到秒)远小于 NTP 调整的周期,所以同一请求内用同一个偏移是安全的。如果把两条相隔几分钟的请求的 perf_counter 值混在同一个偏移下比较,就可能出现几毫秒的误差。
为什么 TTFT 有一个「不可观测」的边界
APIServerReqTimeStats 提供的派生量非常直白:
def get_first_token_latency(self): return self.first_token_time - self.created_time
def get_e2e_latency(self): return self.finished_time - self.created_time
def get_decode_latency(self): return self.finished_time - self.first_token_time其中 get_decode_latency() 就是 TTFT 与 E2E 的差。注意 first_token_time 只在 set_first_token_time() 时赋值,而 set_first_token_time() 和 set_last_time() 一样,只被 TokenizerManager 在收到第一个输出 batch 时调用。这意味着:
- 如果请求的输入全是 prompt、输出为 0 token(例如 /v1/embeddings 或中止),
first_token_time保持 0,get_first_token_latency()会得到一个负值。 - TokenizerManager 的
collect_metrics()对 abort 请求专门跳过 TTFT 观察,PD prefill 侧也永远不观察 TTFT(它不会经过 decode),这些分支正是为了防止负值或错误样本进入直方图。
TPOT 的写法更能说明「分母必须排除第一个 token」:
def get_time_per_output_token(self, completion_tokens: int): if self.first_token_time <= 0.0 or completion_tokens <= 1: return None decode_latency = self.get_decode_latency() if decode_latency <= 0.0: return None return decode_latency / (completion_tokens - 1)第一个输出 token 的时刻已经在 TTFT 里,decode 阶段实际产出的是 completion_tokens - 1 个 token,所以分母减一。如果输出只有一个 token,就没有 decode 区间,返回 None 而不是 0,避免把「没有 decode」误记成「decode 极快」。
统一、prefill、decode 三种时间线
SchedulerReqTimeStats.convert_to_duration() 是理解三种拓扑差异最直接的代码。它按 disagg_mode 分支输出不同字段:
- 统一模式:
queue_duration(所有进入等待队列的时间和)与forward_duration(forward_entry_time到completion_time)。 - PD prefill:
bootstrap_duration或bootstrap_queue_duration、queue_duration、forward_duration,外加transfer_speed与transfer_total。 - PD decode:
prealloc_queue_duration(或细分为bootstrap_duration+alloc_wait_duration)、transfer_duration、queue_duration、forward_duration。
以 decode 节点为例,prealloc_duration 是「请求进入预分配队列」到「进入传输队列」之间的时间。这个区间里 decode 节点并没有在算,而是在等 prefill 节点启动 bootstrap 并返回信息;一旦 bootstrap 完成,剩余部分变成 alloc_wait_duration,即等本地 KV 槽位真正分配。代码在开了 SGLANG_TEST_REQUEST_TIME_STATS 时会对每一段做非负断言,这看起来只是调试开关,实际上是工程团队用来验证「时间戳顺序在所有拓扑下都不倒挂」的回归测试。
duration_between() 对任一端点为 0 的情况直接返回 0,而不是返回 end - start。这避免了「某阶段没有发生」被记成一个巨大的负值:在 decode 节点上,decode_prealloc_queue_entry_time 在 PD 模式下一定会被设置,但在统一模式下不会;同一个类要兼容两种模式,就必须把「未发生」和「耗时为 0」区分开,这里的处理方式是统一视为 0。
阶段与 trace 的耦合
每个 set_xxx_time() 除了记录时间戳,还会在 trace_ctx.tracing_enable 为真时直接开 / 关一个 span。例如 set_created_time() 会顺带启动 tokenize span,set_tokenize_finish_time() 关闭它,set_api_server_dispatch_time() 启动 api_server_dispatch span,set_api_server_dispatch_finish_time() 关闭并带 thread_finish_flag=True。这种写法看起来把两件事耦合在一起,但它保证了一个核心性质:指标与 trace 使用的是同一个时间戳,不存在「日志说 TTFT 80ms,trace 说 120ms」的口径分裂。后面讲 trace 时会看到,span 的起止时间正是由这些 perf_counter 值转换成 realtime 纳秒得到的。
调度器的快照:SchedulerStats 与 log_stats
如果只看 sglang:num_running_reqs 这一个名字,很容易以为它是「当前正在跑的请求数」。读源码后发现,它其实是一个快照对象在某个时刻被整个推入 Prometheus 的产物。这个对象叫 SchedulerStats,而把它推出去的函数叫 log_stats()。
SchedulerStats 里按主题分组的字段
SchedulerStats 定义在 metrics_collector.py,字段按注释分成十多个分组:
Basics num_running_reqs, num_queue_reqs, num_grammar_queue_reqs, gen_throughput, cache_hit_rate, decode_sum_seq_lensMemory pools token_usage, full_token_usage, swa_token_usage, mamba_usage, num_used_tokens, kv_available_tokens, kv_evictable_tokens, kv_used_tokens, swa_*, mamba_*Spec decoding spec_accept_length, spec_accept_rate, spec_cap_length, spec_block_accept_length, spec_num_steps, spec_num_draft_tokensRetract num_retracted_reqs, num_paused_reqsPD disagg num_prefill_bootstrap_queue_reqs, ..., kv_transfer_speed_gb_sUtilization utilization, fwd_occupancyScheduler policy new_token_ratioCUDA graph is_cuda_graphLoRA lora_pool_slots_used / total / utilizationHiCache hicache_host_used_tokens, hicache_host_total_tokens, ...Streaming session num_streaming_sessions, streaming_session_held_tokensRouting key num_unique_running_routing_keys, routing_key_running_req_counts为什么把这些字段塞进同一个 dataclass,而不是让采集器在读时直接访问调度器?在 Overlap Scheduler 模式下,调度器线程与转发线程分离,log_stats() 可能在另一个线程里执行;如果它在一个循环里逐个读取调度器字段,就可能在读到 running_batch.reqs 长度之后、读 waiting_queue 长度之前,插进一次调度更新,得到一个不可能同时成立的快照(例如 running + waiting 超过 max_num_seqs)。把所有字段先写进一个局部对象,再由采集器一次性吐出去,至少能在同一个报数节拍内得到一致的时刻点。
队列字段为什么是 QueueCount 而不是 int
一个细节值得单独讲:num_running_reqs 与 num_queue_reqs 的类型是 QueueCount,而不是整数。
@dataclassclass QueueCount: total: int = 0 by_priority: Optional[Dict[int, int]] = None
@classmethod def from_reqs(cls, reqs: List[Req], enable_priority_scheduling: bool = False): by_priority = ( dict(Counter(req.priority for req in reqs)) if enable_priority_scheduling else None ) return cls(total=len(reqs), by_priority=by_priority)from_reqs() 在一次遍历里同时算出总数和按优先级的分布。如果不做这一步,要么遍历两次(在热路径上不可忽略),要么只导出总数、丢失优先级信息。开了优先级调度时,运维需要知道「高优先级的请求是不是被低优先级的请求挤住了」,只有总数无法回答这个问题。
log_stats() 调用 _log_gauge_queue_count() 时遵循一条约定:
priority="" → 总数(默认标签值)priority="<int>" → 该优先级下的数量Grafana 查询总数时必须显式写 priority="",否则会匹配到多条序列。源码注释里明确写了这一点。这里也解释了 init_new() 里为什么要在第一个请求之前就把 priority 标签设置成空串:如果等到第一个有优先级的请求到来时才创建标签,Prometheus 会把同一个 metric name 当成两个不同的 series family,旧序列会变成历史残留。
两个报数节拍:prefill 与 decode 的职责分工
SchedulerMetricsReporter 有两个主要的报数函数:report_prefill_stats() 与 report_decode_stats()。它们的节拍与职责并不对称:
| 字段 | 谁负责写 | 节拍 |
|---|---|---|
num_queue_reqs、num_running_reqs | 两个函数都写 | prefill 每次、decode 每 decode_log_interval 次 |
cache_hit_rate | 仅 prefill | 每次 prefill 报数,以本次 prefill 的有效 token 计算 |
gen_throughput | 仅 decode | 每 decode_log_interval 次,以窗口内生成 token 数除以时间 |
decode_sum_seq_lens | 仅 decode | 每 decode_log_interval 次 |
spec_accept_* | 仅 decode | 每 decode_log_interval 次,窗口内累加 |
new_token_ratio | 仅 prefill | 每次 |
| KV 池字段 | 两个函数都写 | 都通过 pool_stats.update_scheduler_stats() |
这种非对称分工是刻意的。cache_hit_rate 只在 prefill 时有意义——decode 不读前缀;而 gen_throughput 只在 decode 时有意义——prefill 不产生生成 token。如果把两者都写成「每次调度迭代都更新」,那么在纯 prefill 负载下 gen_throughput 会停在最后一次 decode 的值,在纯 decode 负载下 cache_hit_rate 会一直为 0。代码在 report_decode_stats() 里专门加了一条注释:
# cache_hit_rate is prefill-owned (per-report semantics); decode# ticks must not reset it, or the exported gauge reads 0 whenever# a decode report lands between prefill reports.这句话背后的场景很具体:prefill 报数间隔与 decode 报数间隔不一定同步。如果 decode 报数把 cache_hit_rate 覆盖成 0,那么当一个长 decode 周期恰好落在两次 prefill 之间,Grafana 上的命中率曲线就会出现一条向下的脉冲,运维看到会以为缓存失效。保留 prefill 的旧值,至少能保证它是「最近一次 prefill 的命中率」。
gen_throughput 则有另一种失真风险:如果 decode 停下来(比如负载全变成 prefill,或者引擎暂停),last_gen_throughput 会永远停在最后一个非零值。_current_gen_throughput() 用陈旧衰减处理:
if now - self.last_decode_stats_tic > GEN_THROUGHPUT_STALENESS_SECONDS: self.last_gen_throughput = 0.0return self.last_gen_throughput30 秒没有 decode 报数就归零。暂停路径 pause_generation() 里还额外手动把 last_gen_throughput 清零并强制打一次 idle 日志,因为暂停期间调度器事件循环在到达 on_idle 之前就会短路,否则 Gauge 会在整个暂停窗口里保留旧值。
利用率与转发占用
utilization 的定义在 _calculate_utilization() 里:
if self.scheduler.disaggregation_mode == DisaggregationMode.PREFILL: self.stats.utilization = -1else: max_under_slo = getattr(self.scheduler, "max_running_requests_under_SLO", None) if max_under_slo is not None and max_under_slo > 0: self.stats.utilization = max( self.stats.num_running_reqs.total / max_under_slo, self.stats.token_usage / 0.9, )它取「并发请求数 SLO 上限」与「KV 池 90% 水位」两者的较大值。前者表示已经用掉了多少并发预算,后者表示 KV 池离满还有多远。为什么取 max 而不是 min?因为两者代表两种不同的失败路径:并发到达上限意味着新请求无法准入,KV 到达 90% 意味着很快会触发抢占。任何一条路径逼近,都说明利用率在升高。prefill 节点写 -1,是因为它没有稳定的并发上限——prefill 的窗口由 KV 预算与调度策略共同决定,单独定义一个利用率没有意义。
fwd_occupancy 是另一个维度:它衡量 GPU 转发实际执行的墙钟时间占全部墙钟时间的比例,只在开启设备计时器时才有值。二者合在一起能区分「忙但没算满」和「算满了但 GPU 空闲」:如果 utilization 高而 fwd_occupancy 低,说明队列里有请求但 GPU 在等待(CPU 调度慢、通信等待、或者某个 TP rank 拖后腿);如果两者都高,那就是真正接近饱和。
retract 不只是一个次数
num_retracted_reqs 与 num_paused_reqs 每次报数后归零,但它们并不只在抢占时增加。更重要的是,increment_retracted_reqs() 接收三个量:
increment_retracted_reqs( num_retracted_reqs=len(retracted_reqs), num_retracted_input_tokens=sum(len(r.origin_input_ids) for r in retracted_reqs), num_retracted_output_tokens=sum(len(r.output_ids) for r in retracted_reqs),)除了请求数,还记录了被撤回请求的输入 token 总数与已生成输出 token 总数。这对应指标 num_retracted_reqs_total、num_retracted_input_tokens_total、num_retracted_output_tokens_total。为什么输出 token 数要单独记?因为一次抢占的代价不只是「重算 prefill」,还包括「已经生成、但必须丢弃的进度」。一个请求被撤回时已经产出 2000 个 token,和只产出 10 个 token,对用户体感与算力浪费完全不同。仅有 retract 次数无法区分「频繁撤回短请求」和「偶尔撤回长请求」,加入 token 数后才能估算真实损失。
调用点在 batch.retract_decode() 之后,并且只在 enable_metrics 且确实有 retract 时执行。retract_decode() 的返回值里同时包含 reqs_to_abort,但指标只统计 retracted_reqs,不统计被直接 abort 的请求——后者已经结束,不属于「还会重来」的那一类。
KV 的两本池账:available / evictable / used 为什么必须分开
KV Cache 是推理服务里最容易被误读的资源。运维看到 sglang:token_usage 为 0.85,第一反应是「快满了,该扩容」;但源码里 token_usage 并不是「已分配 / 总量」,而是「已锁定 / 总量」。两者差了一个关键量:可以被驱逐、但还留在缓存里的 token。
PoolStats:从池子抽象到报数字段
SchedulerPoolStatsObserver.get_pool_stats() 返回一个 PoolStats,它先把 storage.usage() 按 full、swa、mamba 三个子池拆开,再分别计算:
num_used = full.capacity - (available_size + evictable_size)token_usage = num_used / full.capacity if full.capacity else 0.0这个式子隐含了 KV 池的一个不变量:
available:空闲槽位,任何请求都能立刻分配。evictable:被前缀树持有、但没有任何运行中请求在用的槽位。新请求来时可以驱逐这些前缀来腾空间,代价是后续请求的前缀命中率下降。used:被运行中请求锁定的槽位。这部分不能驱逐,否则请求无法继续 decode。reserved:代码注释里提到的「受保护 / 会话持有的 token」,并未完全暴露到指标里。它解释了为什么kv_available_tokens + kv_evictable_tokens + kv_used_tokens的总和可能略小于max_total_num_tokens。
为什么必须把 evictable 单独拿出来?因为「快满了」和「真的满了」对调度器意味着完全不同的后果。evictable 高说明前缀缓存正在占着大量空间,调度器仍可以继续接受新请求,只是会牺牲前缀命中;used 高说明已经没有驱逐余地,新请求要么排队,要么抢占。只看「可用 token 数」无法区分这两种情况。
混合模型的三池账
当模型同时有 full attention 与 sliding-window attention 层时,_get_swa_token_info() 分别计算两个池并单独导出 swa_* 字段。此时 token_usage 取三者的较大值:
def get_max_pool_usage(self) -> float: usage = self.full_token_usage if self.is_hybrid_swa: usage = max(usage, self.swa_token_usage) if self.is_hybrid_ssm: usage = max(usage, self.mamba_usage) return usage这个 max 的含义是:几个池里哪个先满,整个引擎就先卡住。SWA 层只保留窗口内的 KV,理论上占用远小于 full;但在混合模型里,某个时刻可能被大量长上下文请求同时占满,导致 SWA 池先满。如果只报 full 池的占用,运维完全看不到这个瓶颈。
Mamba 状态池更特殊。_get_mamba_token_info() 里有一段注释值得单独抄下来:
# mamba_usage/mamba_num_used track the ACTIVE bf16 pool occupancy (running requests)# -- this feeds throttle decisions (get_max_pool_usage) which asserts usage >= 0.# With int8 checkpoints the radix-cached states live in a SEPARATE int8 pool,# so they own ZERO active slots: report evictable=0 against the active pool.也就是说,当 Mamba 的 checkpoint 以 int8 形式存放时,radix 缓存的状态在另一个池子里,不在 active 池。此时如果把 evictable 算到 active 池上,mamba_num_used = capacity - (available + evictable) 就可能为负,进而让 get_max_pool_usage() 的断言失败。源码选择把 mamba_evictable_size 强制设为 0 来规避负值,而不是修整公式。这会略微高估 active 占用,但保证了断言与限流决策的稳定性。
同一类问题在 SWA 的「每请求窗口环」上也出现过:
# Per-request SWA ring: released with the req slot, yet cached radix# prefixes still report swa_evictable; counting it drives usage negative.if is_swa_req_ring(self.token_to_kv_pool_allocator): swa_evictable_size = 0这两处处理说明一个共性:指标公式的输入必须是同一本账里的量。一旦 available 来自 allocator、evictable 来自前缀树,而两本账对「谁拥有这块空间」的定义不一致,减法就会算出负数。指标代码里所有的 max(0, ...) 与「强制置零」,都是在承认两本账之间可能存在短暂的相位差。
每个请求自己也算了一遍私有 token
除了池子层面的账,kv_private_tokens() 还算了另一类「私有占用」:
def kv_private_tokens(kv: ReqKvInfo, page_size: int) -> int: return ceil_align(kv.kv_allocated_len, page_size) - kv.cache_protected_len按页对齐后的分配长度,减去已经被前缀树保护(可复用)的部分。对 SWA 还有专门的 kv_private_swa_tokens(),扣除已经被窗口驱逐的行。这些量用于计算「streaming session 占用了多少 KV」,而不是用于总池占用统计——总池占用已经通过 allocator 的 available / evictable 得到。分开算是为了避免重复计数:同一个 token 既被某个 session 持有、又被前缀树缓存,不能算两次。
日志里的 usage 为什么 round 到两位
report_prefill_stats() 拼日志字符串之前会先 round(self.get_max_pool_usage(), 2)。理由很实在:日志每一行都在热路径上,两位小数已经足够判断「是否进入危险水位」;而指标导出的 Gauge 保留完整浮点。两者使用不同精度,是因为用途不同:日志给人快速扫一眼,指标给 Prometheus 做精确历史。
这里有一个与 SGLang 源码完全拆解(十五):内存池与显存管理 直接相关的原则:指标代码不重新定义「谁拥有哪个槽位」,它只是把调度器已有的账本读出来,再按不同视角(池子 / 请求 / session)分别汇总。因此读指标时出现的所有「奇怪」数字,几乎都能追回到那篇里讲的
ReqToTokenPool、KVPool与Allocator在某个具体时刻的状态。
前缀缓存的命中账:RadixCacheMetricsCollector
前缀缓存是 SGLang 最显眼的收益来源,也是指标最容易被「平均值」骗过去的地方。cache_hit_rate 只有一个 Gauge,但它在三个尺度上都被记录了:单次 prefill 的比值、滑动窗口的比值、以及请求级的 cached_tokens_total 计数。三者回答的是不同问题。
命中率为什么必须用滑动窗口
_CacheHitRateWindow 的实现很短,但处理了一个关键问题:
class _CacheHitRateWindow: def __init__(self) -> None: self.samples = deque() self.hit_tokens = 0 self.total_tokens = 0
def add(self, hit_tokens: int, total_tokens: int, now: float) -> float: if total_tokens > 0: self.samples.append((now, hit_tokens, total_tokens)) self.hit_tokens += hit_tokens self.total_tokens += total_tokens
cutoff = now - CACHE_HIT_RATE_WINDOW_SECONDS while self.samples and self.samples[0][0] <= cutoff: _, expired_hit_tokens, expired_total_tokens = self.samples.popleft() self.hit_tokens -= expired_hit_tokens self.total_tokens -= expired_total_tokens
return self.hit_tokens / self.total_tokens if self.total_tokens > 0 else 0.0窗口内的分母是token 数而不是请求数。为什么?因为两条请求的 prompt 长度可能相差两个数量级:一条 10 token 的问候和一条 80000 token 的长文档命中率各自怎么算,对「前缀缓存值不值」这个问题的贡献完全不同。如果按请求数平均,一次小请求未命中就会把一次 8 万 token 的大命中摊薄;按 token 加权,则更接近「缓存真正省下了多少 prefill 计算」。
CACHE_HIT_RATE_WINDOW_SECONDS 来自环境变量 SGLANG_CACHE_HIT_RATE_WINDOW_SECONDS,而不是写死在代码里。这背后是一个工程判断:窗口长度取决于业务负载的周期性。聊天机器人负载的前缀缓存命中在会话开始时低、后续轮次高,窗口太短会一直在跟踪「新一轮会话」;批处理负载的命中率与任务分布周期性相关,窗口太短会把周期性当成噪声。没有一种窗口适合所有负载,所以交给部署方设置。
直接导出的 cache_hit_rate 与窗口值为什么分开
report_prefill_stats() 里写了两份命中率:
cache_hit_rate = ( effective_hit_tokens / total_tokens if total_tokens > 0 else 0.0)self.recent_cache_hit_rate = self.cache_hit_rate_window.add( effective_hit_tokens, total_tokens, now)self.stats.cache_hit_rate = cache_hit_rate 导出的是本次 prefill 的瞬时值;recent_cache_hit_rate 是窗口值,被 SchedulerLoadInquirer 读取,用于估计 waiting queue 的负载和准入决策。两者的消费者不同:
- 瞬时值给 Grafana 画曲线,能看到「刚发生了一次低命中」,便于和其他指标对齐时间。
- 窗口值给调度器做决策,因为它需要稳定估计——用一个瞬时值做准入,会让准入策略随单次 prefill 抖动。
注意 effective_hit_tokens 与 effective_input_tokens 都减去了 reprocessed_* 部分。为什么?因为被抢占后重新 prefill 的请求,其「命中」部分来自它自己上一次计算过的 KV,并不是真正省下的新计算。如果把 reprocessed 算进命中率,命中率就会随着抢占次数上升而虚高,而实际上这部分 token 已经被计算过两次。
请求级的缓存来源:device / host / storage
TokenizerMetricsCollector.observe_one_finished_request() 会把命中 token 按来源拆开:
report_cache_source("device", cached_tokens_details.get("device", 0))report_cache_source("host", cached_tokens_details.get("host", 0))if "storage" in cached_tokens_details: report_cache_source("storage", cached_tokens_details.get("storage", 0))这三类对应三级缓存:
device:直接命中了 GPU 上的 RadixCache。host:命中了 HiCache 的 CPU 内存层,load-back 到 GPU 后才可用。storage:命中了 L3 存储层(例如远端存储或文件系统),先 prefetch 到 host 再 load-back 到 device。
拆开的意义在于,命中率一样是 80%,但「device 80%」与「storage 80%」的代价完全不同:前者几乎没有额外开销,后者需要经过两次拷贝,会增加 TTFT。如果只报总命中率,运维会误以为「缓存高效」;拆开以后,能看出「最近命中率没变,但命中来源从 device 漂到了 storage」——这往往对应一次显存扩容失败或 KV 池被压低。
驱逐与搬运:直方图和计数成对出现
RadixCacheMetricsCollector 的指标成对设计:
| 指标 | 类型 | 作用 |
|---|---|---|
sglang:eviction_duration_seconds | Histogram | 一次设备侧驱逐的总耗时 |
sglang:evicted_tokens_total | Counter | 驱逐释放的 token 槽数 |
sglang:load_back_duration_seconds | Histogram | host → device 的合并拷贝耗时 |
sglang:load_back_tokens_total | Counter | load-back 的 token 数 |
sglang:hicache_backup_duration_seconds | Histogram | device → host 备份耗时 |
sglang:hicache_backup_tokens_total | Counter | 备份 token 数 |
sglang:hicache_backup_bytes_total | Counter | 备份字节数 |
sglang:hicache_dropped_tokens_total | Counter | 因容量不足被丢弃的 token |
“耗时 + 数量”的组合能直接算出速率:evicted_tokens_total / eviction_duration_seconds_sum 就是驱逐吞吐。如果只有耗时,看不出驱逐是不是在做「无用功」(每次只驱逐几个 token 却耗了几毫秒);如果只有数量,看不出驱逐对 decode 的停顿影响。
hicache_dropped_tokens_total 带 reason 与 pool 标签。原因标签的存在,是因为「丢弃」有两种:一种是正常淘汰(容量满、被替换),一种是异常(例如 prefetch 失败、aux buffer 分配失败)。前者是设计内的行为,后者说明系统在紧张。只看总丢弃量,无法区分。
桶的边界为什么写得这么密
eviction_duration_seconds 的默认桶是:
0.001, 0.002, 0.003, 0.004, 0.005, 0.006, 0.007, 0.008, 0.009, 0.01,0.02, 0.03, 0.04, 0.05, 0.1, 0.2, 0.5, 1.01 毫秒到 10 毫秒之间有 10 个边界,这在一般指标设计里显得太密。源码注释解释了原因:在下游的指标网关里,固定的桶模板可能会把不在预设边界上的系列直接丢掉;而 1 到 10 毫秒正好是「驱逐是否打断了一个 decode step」的关键区间——一次 decode step 一般只有十几毫秒,驱逐超过 10 毫秒就会在整个 decode 间隔里留下一个明显空洞。把桶集中在关键区间,是为了让 P99 能精确落到「是否超出一个 decode step」。
backup_duration_seconds 的桶宽得多,从 1 毫秒一直到 60 秒。原因是 write_back 策略下,device → host 备份是阻塞的合并操作,可能持续数秒;用驱逐的桶去量它,几乎全部会落到 +Inf。这里的差异说明:桶的选择必须基于「这个指标的真实量级」,不能简单复用别的指标的桶。
DP 注意力的平衡账:DPBalanceStats
DP Attention 是 SGLang 里横向对比最多的机制之一,可参考 SGLang 源码完全拆解(十七):DP Attention 与专家并行。从可观测性角度看,它引入了一个独特的现象:每个 DP rank 的调度器在每一步都一起进入 MLP 同步,整步的耗时不取决于任何一个 rank 自己的负载,而取决于最忙的那个 rank。这意味着普通的「每 rank 吞吐」指标会显示「某些 rank 慢」,但真正的问题不在那些 rank 上。
DPBalanceStats 的字段与不变式
DPBalanceStats 是一个 msgspec.Struct,只包含一次同步步里的汇总量:
local_tokens 本 rank 在这一步的 token 数max_tokens gather 后最忙 rank 的 token 数sum_tokens 所有 rank 的 token 总数local_attention_pairs 本 rank 的因果 (query, key) 对数max_attention_pairs 最忙 rank 的对数num_ranks DP rank 数sync_wait_seconds 本 rank 这次 all-gather 的墙钟耗时它把「token」与「attention pairs」分开算,这个设计值得展开。token 数量衡量的是 MoE 与投影层的负载:在 MAX_LEN 补齐模式下,每个 rank 都会补齐到 max_tokens 行,所以所有 rank 在 MoE 上付出的计算量是一样的,差别在于「有多少行是 padding」。attention pairs 衡量的是注意力层的负载:注意力只在本地行上执行,每个 rank 真正算的 pair 数是 local_attention_pairs,最忙的 rank 决定所有 rank 在同步点上的等待时间。
用公式表达这个步的「代价」:
其中 是 rank 的 token 数, 是它的因果 pair 数。第一个 max 来自 MAX_LEN 补齐:所有 rank 的 MLP 都按 max_i n_i 行执行;第二个 max 来自同步:最快的 rank 要等到最慢的 attention 完成。这两个 max 的「来源」不同,所以需要两套不同的不平衡量。
imbalance_tokens = max_tokens - local_tokens 表示「本 rank 因补齐而浪费了多少行容量」;imbalance_attention_pairs = max_attention_pairs - local_attention_pairs 表示「本 rank 在等待别人时浪费了多少 pair 容量」。max_over_mean = max_tokens * num_ranks / sum_tokens 是偏斜度:1.0 表示完美均衡,等于 num_ranks 表示只有一个 rank 在干活。
create() 里对 max_tokens == 0 和 max_attention_pairs == 0 都直接抛异常:
if max_tokens == 0: raise ValueError("DP balance stats need a rank with tokens")if max_attention_pairs == 0: # Every row attends at least one key, so this is a gather or # pair-count bug, not a quiet step. raise ValueError("A rank with tokens attends at least one pair")这两条断言把「完全空闲的步」和「统计 bug」区分开:所有 rank 都没有 token,说明调度器进入了真正的空转;如果某个 rank 有 token 但对数是 0,那是 gather 或 pair 计数错了,应该立刻暴露,而不是被记成「均衡度 0」。
导出侧:五种指标而不是一条
observe_dp_balance() 把同一个结构体拆成多个指标:
if stats.local_tokens: self._dp_attention_tokens["scheduled"].inc(stats.local_tokens)if stats.imbalance_tokens: self._dp_attention_tokens["imbalance"].inc(stats.imbalance_tokens)if stats.local_attention_pairs: self._dp_attention_pairs["scheduled"].inc(stats.local_attention_pairs)if stats.imbalance_attention_pairs: self._dp_attention_pairs["imbalance"].inc(stats.imbalance_attention_pairs)rank_state = "idle" if stats.local_tokens == 0 else "active"self._dp_attention_steps[rank_state].inc(1)self._dp_attention_sync_wait_seconds.observe(stats.sync_wait_seconds)dp_attention_tokens_total{kind="scheduled"|"imbalance"}dp_attention_pairs_total{kind="scheduled"|"imbalance"}dp_attention_steps_total{rank_state="active"|"idle"}dp_attention_token_imbalance_ratio(直方图,等于max_over_mean)dp_attention_sync_wait_seconds(直方图)
为什么 imbalance 要作为独立的计数器,而不是用 scheduled - something 推导?因为 imbalance 是「浪费」,它与「实际工作量」不能相减。例如 sum_tokens 是本地量的总和,imbalance 的总和等于 num_ranks * max_tokens - sum_tokens,这个值只有在汇总所有 rank 后才能算出——单个 rank 导出自己的 imbalance,Prometheus 再对所有 rank 求和,正好得到「本引擎在同步步里浪费的 token 总数」。如果只导出 scheduled,就无法区分「工作量本身小」和「工作量被补齐放大」。
rank_state="idle" 尤其重要。DP Attention 在某个 rank 没有 token 时仍然要参与同步(否则 all-gather 会挂住),所以「有一半 rank 在空转」和「全部 rank 都在干活」是两种不同的状态。idle 计数的上升,往往意味着 DP 的请求分配不均匀——这正是 router 侧的负载账本应该修正的地方,可参考 GLM-5.3 推理全链路(六):token 跨卡的那一段 里对 all-to-all 与路由的讨论。
imbalance_ratio 只由一个 rank 导出。SchedulerMetricsReporter.__post_init__() 里:
self.reports_dp_token_imbalance_ratio = ( parallel.attn_dp_rank == 0 and parallel.attn_tp_rank == 0 and parallel.attn_cp_rank == 0)因为这种「整引擎级」的比值在多进程 registry 下会被重复累加:每个 rank 都观察到同一个 max_over_mean,如果都导出到同一个直方图,样本数会被放大 num_ranks 倍。只让 rank 0 导出,保持单份样本。
sync_wait 的桶为什么从 0.1 毫秒开始
0.0001, 0.00025, 0.0005, 0.001, 0.0025, 0.005, 0.01, 0.025,0.05, 0.1, 0.25, 0.5, 1.0注释解释了 gloo 路径与 device-group 路径的区别:在默认的 overlap scheduling 配合 gloo 的情况下,sync_wait_seconds 主要是「等待最慢 rank」;而在 device group 路径上,它还包含 gather 本身的 stream 同步。两种情况下,0.1 毫秒到 1 毫秒之间的分布都最密集,所以桶从 0.1 毫秒开始。如果桶从 1 毫秒开始,绝大多数样本会落到第一个桶,看不出差异。
投机解码、HiCache 与 PD 分离的专项指标
这三块机制的指标都有一个共性:在「接受率」或「命中率」这个百分比背后,至少有三个不同的量需要分开记,否则会得出相反的结论。
投机解码:接受长度、接受率与「上限长度」
report_decode_stats() 在每个 decode 报数窗口结束时计算:
spec_accept_length = self.spec_num_accept_tokens / self.spec_num_forward_ctnum_correct_drafts = self.spec_num_correct_draftsif get_spec().speculative_num_draft_tokens: draft_per_round = get_spec().speculative_num_draft_tokens - 1else: draft_per_round = get_spec().speculative_num_steps or 0total_draft_tokens = self.spec_num_forward_ct * draft_per_roundspec_accept_rate = ( num_correct_drafts / total_draft_tokens if total_draft_tokens > 0 else 0)三个量的含义需要严格区分:
spec_accept_length:每次转发平均产出多少个 token。分子是「被接受的草稿 token 数 + 每个转发的奖励 token」,分母是转发次数。它直接对应「一步算几个」,是用户感受到的速度。spec_accept_rate:被接受的草稿占全部提出草稿的比例。分子只计「草稿被接受」,不含奖励 token;分母是转发次数 × 每轮草稿数。spec_cap_length:在开启 ragged verify 的 CAP_ACCEPT 模式下,每次转发平均接受多少个「块级」token。
为什么不能只报接受率?因为接受率相同,收益可以差很多。假设草稿 4 个,接受率 50%:
- 如果 4 个草稿中有 2 个被接受,那么每次转发产出 3 个 token(2 个 + 1 个奖励),加速比接近 3 倍。
- 如果草稿是递推生成的,前 2 个被接受、后 2 个被拒绝,那么收益也是 3 个;但如果只接受第 1 个,后面全部连锁拒绝,同样是 25% 的接受数,产出只有 2 个。
spec_accept_length 直接反映「平均每步产出」,才是真正的收益量。spec_accept_rate 反映的是「草稿模型的质量」,用来调草稿模型的训练或选择。两个数字一起看,才能区分「是草稿质量差」还是「是验证开销大」。
spec_num_steps 与 spec_num_draft_tokens 则解释「为什么接受率变了」。如果接受率下降,但 spec_num_draft_tokens 同时上升,说明配置被调到了更激进的草稿数量,或者自适应策略(_active_spec_config_snapshot())改了档。把这两个配置量一起导出,是为了让曲线变化能对上配置变化。
源码里还有一个容易忽略的细节:计数器每 decode_log_interval 清一次窗口值,但同时累加 spec_total_num_accept_tokens 与 spec_total_num_forward_ct。这两个「生命周期累计值」是给 SchedulerLoadInquirer 用的:准入和限流需要看到「自启动以来接受率的整体水平」,而不是最近一个窗口的瞬时值。两个版本并存,正好对应「曲线」与「决策」的不同需求。
HiCache:host 池的占用是第三个 Gauge
_log_hicache_stats() 只在开分层缓存时才填字段:
host_total = host_pool.logical_sizeself.stats.hicache_host_used_tokens = host_total - host_pool.available_size()self.stats.hicache_host_total_tokens = host_total配合 prefetched_tokens_total、backuped_tokens_total、storage_prefetch_hit_tokens_total 等计数,构成一个完整的「三级缓存账」:
而 storage_prefetch_unfulfilled_tokens_total 与 storage_prefetch_deferred_tokens_total 是两个「没拿到」的量:前者是 prefetch 请求发出但没能完成的数量,后者是 prefetch 被推迟到后续 step 的数量。分开记,是因为前者意味着「系统没做到」,后者意味着「系统在排队」。如果只看 storage_prefetch_hit_tokens_total,会把「排队完成」和「快速完成」混为一谈。
HiCache 的细节可参考 SGLang 源码完全拆解(十六):HiCache——三级 KV 缓存、分层前缀树与异步搬运;指标里需要关注的是它导出的三个独立数字:host 池占用率、prefetch 完成量、backup 完成量。
PD 分离:五个队列而不是一个
PD 分离引入了多个中间队列。SchedulerStats 里与 PD 相关的字段一共六个:
| 字段 | 含义 |
|---|---|
num_prefill_bootstrap_queue_reqs | prefill 节点上等待 bootstrap 完成的请求 |
num_prefill_inflight_queue_reqs | prefill 节点上已经进入转发、等待 KV 发送完成的请求 |
num_decode_prealloc_queue_reqs | decode 节点上等待预分配 KV 的请求 |
num_decode_transfer_queue_reqs | decode 节点上等待 KV 传输的请求 |
num_decode_host_receive_queue_reqs | decode 节点上等待 host 接收的请求 |
num_decode_deferred_kv_release_reqs | 延迟释放 KV 的请求 |
为什么 decode 侧要分三个队列?因为「请求已经进入 decode 节点」和「请求可以开始 decode」之间隔着两段独立的时间:先要等 prefill 节点完成 bootstrap 并分配远端 buffer,再要等 KV 真正传输进来,最后还要等本地 KV 槽位准备好。三段之间任何一段阻塞,都会让请求停在不同的队列里。如果只报「decode 队列总长度」,运维无法判断瓶颈在 bootstrap、传输还是本地分配。这三个队列的请求数,正好对应 SchedulerReqTimeStats 里 decode 节点的三个阶段时间戳:decode_prealloc_queue_entry_time、decode_transfer_queue_entry_time、wait_queue_entry_time。
kv_transfer_speed_gb_s 与 kv_transfer_latency_ms 只在传输结束的请求上更新,统计最近一次或最近窗口的传输速率。这两个量对应 compute_and_observe_kv_transfer_metrics(),它会用 transfer_total_mb 除以传输时间,得到带宽。为什么带宽要单独报?因为传输延迟会随 KV 大小变化,单看延迟无法判断是「KV 太大」还是「网络太慢」。带宽能直接回答后者。
num_decode_deferred_kv_release_reqs 则记录了「请求已经结束,但 KV 还不能释放」的请求数。这在 prefetch / offload 场景下经常出现:KV 正在被异步拷贝到 host,拷贝完成前不能释放。这个数字上升,意味着「已经完成的请求还在占用 KV 池」,直接影响新请求的准入。
KV 事件的发布
report_prefill_stats() 与 report_decode_stats() 末尾都会调用 KV 事件发布:
self.scheduler.kv_events_publisher.emit_kv_metrics()self.scheduler.kv_events_publisher.publish_kv_events()这套「KV 事件」与 Prometheus 指标是并行的出口:前者给外部 prefix-cache-aware router 或 KV 复用服务用,后者给监控系统用。emit_kv_metrics() 位于 current_scheduler_metrics_enabled 条件块内,只有负责导出的 rank 才执行;publish_kv_events() 放在条件块外,但它仍然在 report_* 的早退之后,只有通过 is_stats_logging_rank(或开启 all-schedulers)的 rank 才会走到。两者共用同一份 SchedulerStats 快照,区别在于一个更新指标、一个向 router 发送 KV 池状态事件。
前端与令牌器:TTFT、ITL 与队列等待
前面三节都在引擎内部。但用户体感的 TTFT 与 ITL,实际上是从「HTTP 到达」走到「decoder 产出」的整段链路。TokenizerMetricsCollector 是唯一能看到整条链路的采集器。
标签集合与指标集合
tokenizer_metric_labels() 只设置两个基础标签,优先级开启时再加一个空占位:
labels = { "model_name": get_serving().served_model_name, "engine_type": DisaggregationMode.to_engine_type(...),}if get_schedule().enable_priority_scheduling: labels["priority"] = ""注意:tokenizer 侧没有 tp_rank / pp_rank / dp_rank 标签。因为 TokenizerManager 是所有 rank 的上游,它只看到一个逻辑引擎。除这两个基础标签外,只有 tokenizer_metrics_allowed_custom_labels 白名单里的自定义标签与 extra_metric_labels 会被追加,避免请求头里的任意字段变成标签。这一点对 Grafana 查询有直接影响:用 tp_rank 过滤 tokenizer 指标会返回空,因为标签根本不存在。
指标集合按用途分四组:
| 组 | 指标 |
|---|---|
| Token 计数 | prompt_tokens_total、generation_tokens_total、cached_tokens_total{cache_source} |
| Token 分布 | prompt_tokens_histogram、uncached_prompt_tokens_histogram、generation_tokens_histogram |
| 延迟 | time_to_first_token_seconds、inter_token_latency_seconds、e2e_request_latency_seconds、request_time_per_output_token_seconds |
| 请求计数 | num_requests_total{is_streaming}、num_so_requests_total、num_aborted_requests_total、spec_verify_calls_total |
is_streaming 标签出现在请求计数、prompt / generation token 计数以及 TTFT / E2E 直方图上;ITL 直方图刻意不带该标签,因为非流式请求根本没有「逐 token 间隔」可测。流式请求的 TTFT 是「首 token 到达客户端」的时间,一次性请求的 TTFT 是「第一个 batch 产出」的时间,后者的 E2E 几乎等于 TTFT 加 decode 时间,而前者的 E2E 还包括网络回传。如果不分标签,两类请求会混在同一个直方图里,P50 变成两类的中位数,既不能代表流式,也不能代表非流式。
prompt_tokens_histogram 的桶跨越了 100 到 1,100,000,一共 35 个边界。之所以从 100 开始,是因为小于 100 的 prompt 在长上下文服务里通常可以忽略;之所以到 110 万,是因为现代模型支持百万级上下文。桶在 10 万以下比较密(每 1000 到 2500 一个),是因为「常规对话」集中在几千到几万;10 万以上开始稀疏,因为大上下文请求的分布通常更宽,精确定位没有意义。uncached_prompt_tokens_histogram 用同样的桶但是减去命中 token,这正是「实际需要计算多少 prefill 工作」的分布,它才是决定 prefill 时间的历史依据。
collect_metrics:一次输出 batch 的时间戳与样本
TokenizerManager 在收到每个输出 batch 时调用 collect_metrics()。核心逻辑是三个状态位:
if not state.ttft_observed: if (finish_type != "abort" and self.disaggregation_mode != DisaggregationMode.PREFILL): state.ttft_observed = True state.last_completion_tokens = completion_tokens self.metrics_collector.observe_time_to_first_token( labels, state.time_stats.get_first_token_latency(), stream=getattr(state.obj, "stream", False), )else: num_new_tokens = completion_tokens - state.last_completion_tokens self.metrics_collector.observe_inter_token_latency( labels, state.time_stats.get_interval(), num_new_tokens, )ttft_observed 只置一次。后面所有的输出 batch 都进入 ITL 分支。这里有一个细节值得注意:num_new_tokens 可能为 0。例如带 stop string 的请求,可能收到一个不含新 token 的 batch,只是确认停止条件;也可能因为投机解码回滚,completion_tokens 没有增加。observe_inter_token_latency() 对 num_new_tokens <= 0 直接返回,避免把「没有新 token 的时间间隔」当成 ITL 样本。
observe_inter_token_latency() 还做了一件性能优化:
adjusted_interval = internval / num_new_tokenshis = self.histogram_inter_token_latency.labels(**labels)...his._sum.inc(internval)for i, bound in enumerate(his._upper_bounds): if adjusted_interval <= bound: his._buckets[i].inc(num_new_tokens) break它直接操作 Prometheus Histogram 的内部字段 _sum 与 _buckets,而不是调用 observe() 循环 num_new_tokens 次。原因很实际:在投机解码开启后,一个输出 batch 可能包含 8 到 16 个 token;如果每个 token 都调用一次 observe(),会引入上百次锁竞争和多进程原子操作,对吞吐有可测量的影响。直接操作内部字段是一次有意的「把监控开销降到可忽略」的工程妥协。这条路径只在默认 Prometheus 后端下可用,如果注入了其他 _stat_logger_di 后端,就回退到公开 API 循环 observe。
TTFT 的分段与 gen_ai 语义约定
APIServerReqTimeStats.convert_to_gen_ai_span_attrs() 把时间线切成几段,并按 OpenTelemetry GenAI 语义约定命名:
gen_ai.latency.time_to_first_token = first_token - createdgen_ai.latency.e2e = finished - createdgen_ai.latency.time_in_model_decode = finished - first_tokengen_ai.latency.time_in_model_inference = finished - api_server_dispatch_finishgen_ai.latency.time_in_model_prefill = first_token - api_server_dispatch_finish第一段 time_in_model_prefill 从「HTTP 分发结束」算起,到「第一个 token」为止。它不是单纯的 prefill 计算时间,还包括排队、tokenizer、调度与 KV 命中判断。真正的 prefill 计算时间只能从 Scheduler 侧的时间戳得到。这就是为什么这套指标需要同时存在 APIServer 与 Scheduler 两侧:前者是用户视角的端到端,后者是引擎视角的内部分段。
time_in_model_inference 是「模型开始处理」到「完成」,中间正好是 prefill 与 decode 两段;它在语义约定里的地位相当于「用户看到模型开始动」与「结束」之间的全部时间。把它分解成 time_in_model_prefill 与 time_in_model_decode 两段,正好对应两个不同的优化方向:前者是排队与首 token,后者是 decode 吞吐。
队列等待:谁在等,等了多久
阶段直方图里唯一与「等待」直接相关的指标是 sglang:queue_time_seconds,由 observe_queue_time() 写入。req_time_stats.observe_per_stage_req_latency() 在 prefill_waiting 阶段不导出,因为排队时间通过 queue_duration_s 一次性累加。这两个口径的差异在于:
- 阶段直方图记录的是「一次进入等待队列的时长」,它会被抢占拆成多个样本。
queue_duration_s记录的是「这条请求总共在等待队列里待了多久」,它对应get_queueing_time()的返回值。
用户体感是后者:一条请求被抢占三次,每次等 5 秒,用户感受到的是 15 秒的额外等待,而不是三个 5 秒的样本。这也是为什么 SchedulerReqTimeStats 里要把 queue_duration_s 当作独立的累计量,而不是从时间戳相减。
追踪:OTel span 如何把一次请求串成一条时间线
指标告诉你「哪一段变慢了」,但不告诉你「这条请求为什么慢」。Trace 补上因果链,代价是它必须跨进程传播,并且在每个进程里维护一套嵌套关系。SGLang 的 trace 实现集中在 observability/trace.py,核心对象是 TraceReqContext。
三层 span:请求、线程、切片
一次请求在 trace 里会形成三层结构:
root span "Req <rid 前 8 位>" 或 "prefill Req ..." / "decode Req ..." └─ thread span "Tokenizer (host:... | pid:...)" └─ slice spans tokenize / api_server_dispatch / request_process / prefill_forward ...root span 在 trace_req_start() 里创建:
root_span = tracer.start_span( name=f"{role} Req {orig_rid[:8]}", start_time=ts, context=external_trace_context, attributes=attrs,)self.root_span = root_spanself.root_span_context = trace.set_span_in_context(root_span)self.thread_context = self.__create_thread_context(ts)orig_rid 是去掉 MultiTokenizer 的 worker_id 前缀后的请求 ID;role 在统一模式下为空,在 PD 模式下是 prefill 或 decode。同一条请求在 PD 两侧会各自产生一个 root span,名字不同、进程不同,但通过 trace id 与外部 header 关联起来。
thread span 的名字带上了 rank 与主机信息:
thread_name = f"{thread_info.thread_label}"if thread_info.tp_rank is not None: thread_name += f" [TP {thread_info.tp_rank}] "if thread_info.pp_rank is not None: thread_name += f" [PP {thread_info.pp_rank}] "if thread_info.dp_rank is not None: thread_name += f" [DP {thread_info.dp_rank}] "thread_name += f"(host:{thread_info.host_id[:8]} | pid:{self.pid})"为什么需要 thread span?因为一个请求会在 Tokenizer、Scheduler、Detokenizer 等多个线程里被处理。如果所有 slice 都直接挂在 root 下,时间线会变成一条没有分支的直线,无法看出「这 300 毫秒到底在哪个进程里」。thread span 把同一进程内的所有 slice 收拢到一个分组下,trace UI 上就能按进程展开。
thread_info 由 trace_set_thread_info() 在每个线程启动时注册。HTTP 入口进程注册 Tokenizer(PD 时加前缀 Prefill / Decode),Scheduler 注册 Scheduler 或 Prefill Scheduler / Decode Scheduler,并带上 tp/dp/pp rank。注册是线程局部状态,不依赖请求对象,因此即使请求还没到,线程也能在后续 span 里带上正确的 rank 标签。
切片嵌套与「上一个 span」
trace_slice_start() 维护一个当前线程的切片栈:
if not self.thread_context.cur_slice_stack: if self.last_span_context: prev_span_context = self.last_span_contextelse: parent_span = self.thread_context.cur_slice_stack[-1].span
parent_span_context = trace.set_span_in_context(parent_span)span = tracer.start_span(name=cur_slice.slice_name, start_time=..., context=parent_span_context)if prev_span_context: span.add_link(prev_span_context)self.thread_context.cur_slice_stack.append(cur_slice)这段代码里有两个细节:
- 如果栈为空,新 slice 的 parent 是 thread span;如果栈非空,parent 是栈顶 slice。这自然表达了
decode_loop→decode_forward的嵌套。 - 如果栈为空且已经有一个
last_span_context,新 slice 会额外add_link到上一个已完成的顶层 slice。因为请求的阶段并不总是严格嵌套:api_server_dispatch_finish_time()会带thread_finish_flag=True结束整个线程上下文,后续的request_process可能是另一个线程里重新开始的顶层 slice。link 而不是 parent,让 trace 图能显示「顺序发生」,又不会错误地表达成「嵌套」。
trace_slice_end() 会检查 slice_name 与 level 是否与栈顶一致,不一致时打印 warning 并弹栈。这类断言在 trace 代码里很常见,因为 span 的开闭是手动配对的;一旦配对错了,整个 trace 的层级就会错位。
自定义 ID 生成器:为什么不能直接用默认的
TraceCustomIdGenerator 的注释写得很清楚:
Why custom IDs are needed: The default IdGenerator may produce duplicate trace IDs across multiple TP scheduler processes.默认的 OpenTelemetry IdGenerator 在多个进程里各自随机生成 trace id。SGLang 在每个 TP rank 上都有一个 Scheduler 进程,如果同一条请求在这些进程里各自生成一个 root span,就会得到多个不同的 trace id,无法在 UI 上聚成一次请求。自定义生成器用 random.Random() 种子化后生成 64 位 trace id / span id,并在跨进程序列化 context 时把 root context 一起带过去,让所有后续 span 共享同一个 trace id。
生成器还支持「预置下一个 span id」:
@classmethoddef preset_next_span_id(cls, span_id: int): cls._preset_local.span_id = span_id这是给异步 exporter 用的。SGLANG_TRACE_ASYNC=1 时,span 的创建被推迟到 exporter 进程,但调用方进程需要提前知道 span id,以便在跨进程 link 时引用。调用方先生成 id,随事件发给 exporter;exporter 在 tracer.start_span() 之前 preset_next_span_id(id),下一次 generate_span_id() 就会消费它。这样既不修改标准 OTel API,又让两个进程对同一个 span 使用同一个 id。
trace level 与模块过滤
TraceReqContext.__init__() 里的:
self.tracing_enable = opentelemetry_initialized and self.trace_level > 0意味着 trace level 为 0 时,整个上下文退化成 TraceNullContext,所有方法都是空操作。这样做是为了让热路径没有 if tracing_enable 的分支成本——TraceNullContext 的 __getattr__ 返回一个可调用对象,调用即返回,不需要检查。
--trace-modules 可以进一步过滤:只有名字在列表里的模块才创建 context,默认空模块名不受过滤。/set_trace_level HTTP 端点允许运行时调整 level,不需要重启。这个设计对生产环境很实用:默认 level 0,出问题时临时调到 2 或 3,观察几条请求的完整 span,再调回 0。代价是 level 越高,span 数量与内存占用越大。
跨进程传播:trace ctx 与请求一起走
ReqTimeStatsBase.__getstate__() 里:
trace_ctx_state = ( self.trace_ctx.__getstate__() if self.trace_ctx.tracing_enable else {"tracing_enable": False})TraceReqContext.__getstate__() 保留 root span context(以 traceparent carrier 形式)、trace id、角色、trace level、模块名与 last span id,但不保留 span 对象与 thread context 本身。反序列化时通过 __setstate__() 重建 TraceReqContext,再调用 rebuild_thread_context() 在当前进程里创建新的 thread span。这样一条请求从 Tokenizer 到 Scheduler 后,Scheduler 里的 span 仍然挂在同一个 trace 下,但 thread span 是本进程新建的。
__getstate__() 还会标记 is_copy。副本的 root span 为 None,只保留 context;它不能结束 root span,否则会在 Scheduler 进程里提前关闭 Tokenizer 创建的 root。trace_req_finish() 里对 self.root_span 为 None 的情况直接返回,正是为此;副本只会在本地进程中新建 thread span,并把它挂在继承来的 root context 下。
extract_trace_headers() 从 HTTP headers 中取出 traceparent / tracestate,传给 init_trace_ctx()。如果上游网关已经开启 trace,SGLang 的 span 会挂到上游 trace 下,而不是新起一条。跨系统排障时,这一条比任何本地指标都重要。
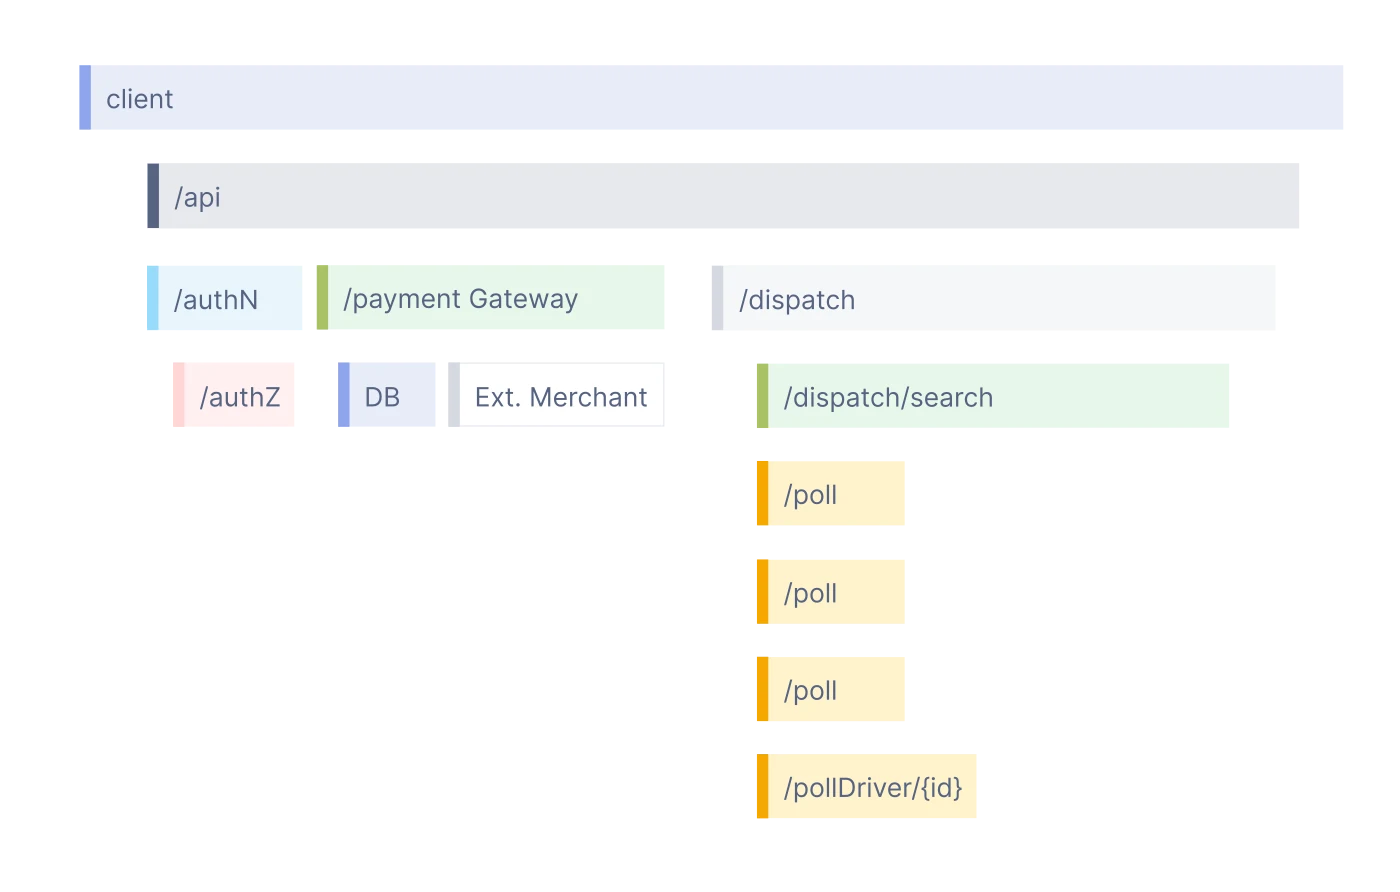
这张图不是 SGLang 自己的 trace,而是 OpenTelemetry 文档里的标准示意。它展示了读 trace 时最重要的两件事:横向看时间重叠,纵向看父子关系。SGLang 的 trace 结构与此一致:root 是请求,thread 是进程,slice 是阶段;一个 decode_loop 下面会挂多个 decode_forward,每个 decode_forward 内部又可能有 spec_draft 与 spec_verify。
时间线视图解决的是另一个问题:不同 span 的先后顺序。在 PD 分离场景里,prefill 侧的 prefill_transfer_kv_cache 与 decode 侧的 decode_transfer_queue 在时间上是重叠的,但它们在两个 trace 里。如果两侧共享同一个 trace id(通过 bootstrap room 与外部 header),时间线视图能把「prefill 还在传,decode 已经在等」显示成重叠区间,而不是两个独立的故事。
根 span 上的 GenAI 语义属性
APIServerReqTimeStats.convert_to_gen_ai_span_attrs() 把时间线派生量写进 root span 的属性:
gen_ai.latency.time_to_first_tokengen_ai.latency.e2egen_ai.latency.time_in_model_decodegen_ai.latency.time_in_model_inferencegen_ai.latency.time_in_model_prefill这些名字来自 OpenTelemetry GenAI semantic conventions。使用标准名字的好处是,任何支持 GenAI 语义的 trace 后端都能直接按这些属性筛选、聚合,不需要为 SGLang 写专用解析器。代价是这些属性只覆盖「请求级」的时间段,更细的 prefill_bootstrap、spec_draft 等仍然只以 span name 存在,需要后端按名字查询。
出口:多进程 Prometheus、标签与直方图分桶
指标与 trace 都产生在进程内部,最终要变成一个 HTTP 端点。SGLang 的 /metrics 与业务端口共用同一个 FastAPI 应用,默认是 30000;--enable-metrics 打开后,启动时还会注册 HTTP 中间件、开启函数计时、初始化 HTTP 请求指标。文档里给出的最直接验证方式就是 curl http://localhost:30000/metrics。
多进程目录:必须在 import 之前设置
common.py 里的 set_prometheus_multiproc_dir() 做了两件事:
if "PROMETHEUS_MULTIPROC_DIR" in os.environ: logger.debug("User set PROMETHEUS_MULTIPROC_DIR detected.") prometheus_multiproc_dir = tempfile.TemporaryDirectory( dir=os.environ["PROMETHEUS_MULTIPROC_DIR"] )else: prometheus_multiproc_dir = tempfile.TemporaryDirectory() os.environ["PROMETHEUS_MULTIPROC_DIR"] = prometheus_multiproc_dir.name如果用户没有设置,就创建一个临时目录并把环境变量指过去;如果用户设置了,就在那个目录下再建一个子目录。为什么是「再建子目录」而不是直接用用户给的目录?因为每个引擎实例需要独立的目录,避免同机多个实例互相污染;TemporaryDirectory 对象被全局持有,进程退出时自动清理。
add_prometheus_middleware() 再把 /metrics 挂到 ASGI 应用:
registry = CollectorRegistry()multiprocess.MultiProcessCollector(registry)metrics_route = Mount("/metrics", make_asgi_app(registry=registry))metrics_route.path_regex = re.compile("^/metrics(?P<path>.*)$")app.routes.append(metrics_route)MultiProcessCollector 会在每次 scrape 时读取目录下所有进程的 .db 文件,按指标类型与标签聚合。这正是 TP / DP 多进程模式下指标能跨进程可见的原因。path_regex 的改写是为了绕过 Starlette Mount 对 /metrics 的 307 重定向——如果没有这行,Prometheus 的默认 scrape 会收到 307,很多版本的 Prometheus 不会自动跟随。
Gauge 的 multiprocess_mode 不是装饰
多进程 registry 对不同类型的指标有不同的聚合规则。Counter 默认求和,Histogram 也是求和;Gauge 必须显式选择模式。SGLang 的调度器 Gauge 几乎全部用 multiprocess_mode="mostrecent":
self.num_running_reqs = Gauge( name="sglang:num_running_reqs", documentation="The number of running requests.", labelnames=labels.keys(), multiprocess_mode="mostrecent",)mostrecent 的含义是取最后一次更新的值,而不是把所有进程的值相加。队列长度必须用 mostrecent,因为每个 Scheduler rank 看到的是同一批请求的调度状态,它们的 num_running_reqs 是同一个逻辑队列的重复观测,相加会得到 TP 倍。用 mostrecent 取最新一次观测,正好得到「当前队列长度」。
但 HTTP 侧的活跃请求数用了另一种模式:
self.requests_active = Gauge( name="sglang:http_requests_active", documentation="Number of currently active HTTP requests", labelnames=["endpoint", "method"], multiprocess_mode="livesum",)livesum 的含义是只累加仍然存活的进程的值。HTTP 请求真正分布在不同 worker 进程上,每个进程的活跃请求是独立的一部分,必须相加;livesum 还能在某个 worker 退出后自动减去它的值,避免僵尸进程把活跃数永久抬高。同一个 registry 里两个 Gauge 用不同模式,正说明「这个指标是逻辑上共享的还是进程私有的」必须先想清楚。
标签基数:从 endpoint 到 routing key
HTTP 中间件的标签是 endpoint 与 method,而不是原始 URL:
path, is_handled_path = _get_fastapi_request_path(request)_get_fastapi_request_path() 遍历 FastAPI 的路由表,用 route.matches(request.scope) 找到匹配的模板路径。这样 /v1/chat/completions 与 /v1/models 是不同的 endpoint,但查询字符串不会多出一条序列。源码注释里也承认「recording all requests 有高基数风险,如果请求路径是任意未处理的路径」;SGLang 引擎通常部署在 router 后面,路径集合有限,所以这个风险可控。
routing_keys_active 则是一个更细的基数来源。它按 x-smg-routing-key header 计数,用 RefCountedGauge 维护每个 key 的引用数:第一个活跃请求让 Gauge 加一,最后一个结束让 Gauge 减一。为什么需要引用计数而不是直接 inc/dec?因为一个 key 可能同时对应多条请求,简单 inc 会在每次请求结束时 dec,但只要还有别的请求,活跃 key 数就不应该减少。RefCountedGauge 用一个 Dict[str, int] 保存每个 key 的引用数,计数归零时才 gauge.dec()。
源码里对路由 key 的统计还有一个性能保护:
if all(r.routing_key is not None for r in batch.reqs): ...只有当 running batch 里所有请求都带 routing key 时才计算路由统计。否则,一个混合 batch 里只要有一条没有 key,统计就没有意义,还会在每次 decode 报数时多做一次遍历。
桶配置:规则、环境变量与稳定性
直方图桶的来源有三类:
- 代码里写死的默认桶(例如
RadixCacheMetricsCollector的驱逐 / load-back / backup 桶)。 server_args里的观测配置(例如bucket_time_to_first_token、bucket_e2e_request_latency、bucket_inter_token_latency),通过generate_buckets()解析。- 环境变量覆盖(例如
SGLANG_BUCKET_EVICTION_DURATION),由get_histogram_conf_from_env()读取。
generate_buckets() 支持三种规则:
default 使用默认桶tse middle base count 双侧指数桶:以 middle 为中心向两侧指数扩展custom v1 v2 ... 自定义边界two_sides_exponential_buckets() 的实现是:从 middle 开始,每次乘 base 向上、减同样距离向下,最后排序去重。它适合「中位数附近需要高分辨率、尾部不需要」的分布。SGLang 的 bucket_time_to_first_token 允许用 tse 规则配置,因为 TTFT 的分布通常是「大多数在几百毫秒,少数在几十秒」,双侧指数桶能在中位数附近给出足够的分辨率,又不会被长尾撑爆。
桶的稳定性是一个容易被忽略的运维约束。源码在 RadixCacheMetricsCollector 里注释:
Keep within a 1.0s ceiling: downstream metrics gateways with a fixed bucket presetsilently drop the series when a boundary falls outside it.这意味着如果随意改桶边界,某些网关会直接丢弃整条序列,而不是报错。生产环境修改桶配置时,必须确认下游网关的预设边界包含新边界;否则指标会「无声消失」。这也是为什么默认桶往往写得保守、边界取常见值。
抓取与面板
examples/monitoring/ 提供了一套最小可用的 Prometheus + Grafana 配置:prometheus.yaml 里 scrape_interval: 5s,target 指向 127.0.0.1:30000;grafana/dashboards/json/sglang-dashboard.json 有 8 个面板,覆盖 E2E 延迟、TTFT、运行请求数、生成吞吐、缓存命中率与队列数。cache_hit_rate 这类 Gauge 在多进程下是 mostrecent,面板上直接读即可;gen_throughput 也是 Gauge,不要用 rate(),因为它已经是「每秒 token」而不是累计计数。
需要区分 Gauge 与 Counter 的查询方式:
Gauge 直接读当前值:sglang:num_running_reqsCounter 用 rate / increase:rate(sglang:generation_tokens_total[1m])Histogram 用 histogram_quantile(0.99, sum by (le) (rate(..._bucket[5m])))SGLang 的 generation_tokens_total 是 Counter,gen_throughput 是 Gauge;两者都叫「吞吐」,但一个是从启动累计的 token 数,一个是最近窗口的瞬时速率。混用会让面板出现「重启后吞吐归零」或「吞吐随运行时间线性增长」的假象。
用指标回答问题:几条从数到结论的路径
前面各节把「数字是怎么产生的」讲清楚了,这一节把视角反过来:从问题出发,沿着数字链推出结论。下面每一条路径都只用到前面已经解释过的指标,不引入新的假设。
路径一:P99 变差,先看排队还是计算
排队延迟可以用一个简化的闭式直觉来理解。假设请求到达率 、每步能处理 条请求、每次处理耗时 ,那么服务能力是「每 秒处理 条」,负载强度 。平均每条请求要等多少步,近似为:
这个式子不是精确的排队论结果,但它抓住了三个依赖关系:批越大,排队越短;单步越贵( 越大),排队越长;负载越接近 1,排队爆炸式增长。这也解释了为什么 num_running_reqs 与 num_queue_reqs 要放在同一个面板上:它们对应 与 两个量。如果 num_running_reqs 已经接近 max_num_seqs,而 num_queue_reqs 仍在上升,瓶颈在并发上限,而不是单步耗时;如果两者都在低位而等待仍然长,问题更可能在准入逻辑或 KV 不足。
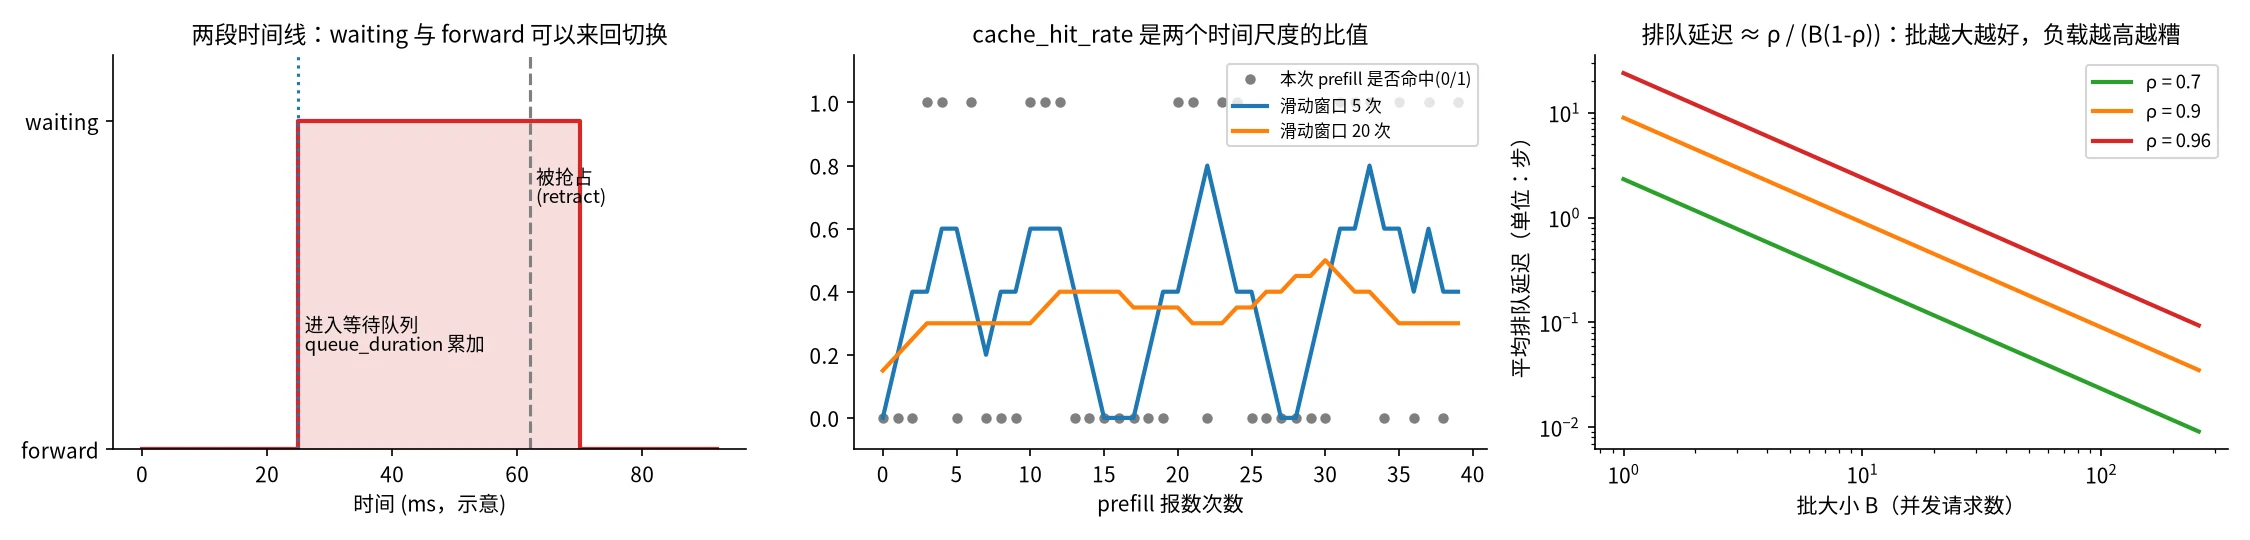
左图模拟了一条请求的时间线:waiting 与 forward 来回交替,每次抢占都会让 queue_duration_s 再累加一段;中图对比「每次 prefill 是否命中」的原始序列与不同窗口长度的滑动平均,说明窗口越短越能跟踪变化、越长越稳定;右图给出 在批大小增加时下降、在负载接近 1 时急剧上升的形状。三张图对应三个不同的推理结论:单请求归因必须累加,命中率需要用窗口,排队延迟同时依赖批大小与负载。
路径二:前缀缓存看起来命中良好,但 TTFT 没降
命中率是一条曲线,TTFT 是另一条,两者可以脱钩。常见原因有三个:
- 命中来源从 device 漂到 storage。看
cached_tokens_total{cache_source="storage"}是否持续上升;如果上升,说明前两级缓存被挤压,命中的代价变高了。 - 命中 token 多,但
uncached_prompt_tokens_histogram的长尾仍然重。说明每次仍有不小的长 prompt 需要完整 prefill,命中率只覆盖了前缀部分。 reprocessed_*占比高。被抢占的请求重新 prefill 时会重算一部分「账面命中」的 token,命中率好看,但实际计算量没降。此时num_retracted_reqs通常同时上升。
路径三:DP 模式下某些 rank 看起来更忙
dp_attention_tokens_total{kind="imbalance"} 汇总的是所有 rank 的浪费量。如果它增长,而各 rank 的 num_queue_reqs 并不均衡,说明路由把请求分歪了;如果各 rank 的队列长度差不多而 imbalance 仍在增长,问题在请求长度分布而不是请求数量:某个 rank 恰好分到了几个长请求,在 prefill 阶段就会出现长尾。
dp_attention_steps_total{rank_state="idle"} 的上升则更直接:idle 步意味着 router 没有把请求分到所有 DP rank。如果 idle 步占比高,优先怀疑路由;如果 idle 步很少而 imbalance 高,优先怀疑长度分布。
路径四:decode 变慢,是算力、调度还是投机
三条线组合起来能区分:
gen_throughput下降而num_running_reqs不变:单步变慢。接着看fwd_occupancy是否下降。fwd_occupancy下降且scheduler_idle_seconds_total上升:调度器空转。再细分scheduler_stage_seconds_total里哪个阶段变长,尤其是recv_requests与process_batch_result。fwd_occupancy不变而spec_accept_length下降:转发时长没变,但每步产出的 token 少了,说明草稿质量或验证行为变了。- 如果同时
eplb_balancedness与dp_attention_sync_wait_seconds恶化,说明专家分布不均与同步等待相互放大,属于 MoE 侧的负载问题。
路径五:同机多实例一起慢
先区分「前端被打爆」和「引擎内部变慢」。sglang:http_requests_active{endpoint, method} 看是否某个 endpoint 的并发异常升高;sglang:routing_keys_active 看是否大量不同的 routing key 同时活跃(通常是上行负载均衡在扩散请求);func_latency_seconds{name} 里 generate_request 的 P99 上升而 scheduler_stage_seconds_total{category="recv_requests"} 不变,说明瓶颈在入口而不是引擎内部。
一张读图顺序
下面的排查顺序不是官方文档给出的,而是从上面的数字链推出来的,可以作为起点:
1. TTFT / E2E 曲线变化 └─ 变化发生在所有请求,还是某一类(is_streaming / model_name / engine_type)2. 排队 vs 计算 ├─ num_queue_reqs 上升 → 看 max_num_seqs、KV 池、retract 计数 └─ num_queue_reqs 平稳 → 看 gen_throughput、fwd_occupancy、spec_accept_length3. 资源 ├─ token_usage 高 → 分解 evictable / available / used └─ cache_hit_rate 高但 TTFT 未降 → 看 cached_tokens_total{cache_source}4. 并行 ├─ DP imbalance 上升 → 看 rank_state=idle 与请求长度分布 └─ sync_wait 上升 → 看 EPLB balancedness 与通信5. 前端 └─ 看 http_requests_total、func_latency_seconds、队列等待观测的边界:开销、基数与一致性
可观测性不是免费的。SGLang 在设计上做了许多取舍,读者如果自己给推理引擎加指标,下面这些边界值得提前考虑。
开销:三条不同频率的路径
- 每次迭代的轻量计数。
increment_realtime_tokens()在每个 decode step 都会调用(prefill 报数时也会按批调用),只是给 Counter 加几个整数;increment_scheduler_iterations()每步加一。这些操作在多进程模式下会写共享内存文件,但仍然远小于一次 attention。 - 每 N 步的重量报数。
report_decode_stats()在forward_ct_decode % decode_log_interval != 0时直接返回,只有每 N 步才计算接受率、拼日志、更新几十个 Gauge。decode_log_interval是一个可调参数,决定了「指标分辨率」与「开销」的折中。 - 每请求的直方图。TTFT / ITL / E2E 每条请求各一次;ITL 的样本数等于输出 token 数除以 batch 内的 token 增量。源码用直接操作
_sum与_buckets的方式,把投机解码下的多次 observe 压成一次。
trace 的开销则取决于 level:level 0 时 context 是空对象,几乎零成本;level 3 以上会为每个阶段创建 span,并且跨进程传播 context。生产环境不应长期开着高 level。
基数:比开销更容易拖垮 Prometheus
一个指标的开销不只在写入端,更在存储端。Prometheus 的每个标签组合都是一条独立的时间序列;如果给每个请求 ID、每个用户 ID 都加标签,序列数会随请求数线性增长,最终把 TSDB 打爆。SGLang 在几个地方明确控制了这一点:
prompt_tokens_histogram只有 model_name / engine_type 等固定标签,没有按请求维度。routing_keys_active按 key 计数,但如果业务侧产生无限多的 key,仍然是基数风险;它只适合 key 集合有限的场景。tokenizer_metrics_allowed_custom_labels是一个白名单:只有明确允许的自定义标签才会进入 tokenizer 指标,防止请求头里的任意字段被复制成标签。- HTTP endpoint 使用模板路径而不是原始 URL,避免路径参数造成基数爆炸。
extra_metric_labels 也是一个需要谨慎使用的入口:它把部署方给的标签加到所有调度器指标上,如果值集合很大(例如按实例 ID 而不是按集群),序列数会乘以实例数。
一致性:指标不是事务
log_stats() 一次性写几十个 Gauge,但 Prometheus 的 scrape 是独立读取的:它可能在两次报数之间拉取,看到的是一组「上一次报数的值」。因此:
num_running_reqs与num_queue_reqs在 scrape 时刻可能来自不同的报数节拍(如果 prefill 与 decode 报数异步),不能严格保证相加等于某个总量。cache_hit_rate是上一次 prefill 的值,而gen_throughput是上一次 decode 的值,它们的时间戳不同。- 多进程 registry 读取
.db文件时,各进程的写入时间也不同,无法得到一个全局一致的「同一瞬间」。
要得到严格一致的状态,只能看 SchedulerStats 的单次快照日志,或者用 trace 把同一条请求的因果链拼起来。指标适合趋势与告警,不适合做「精确对账」。
时钟:跨进程不要比较绝对时间
req_time_stats 用 perf_counter 记录内部时间戳,每个进程的 perf_counter 起点不同;convert_time_to_realtime() 用本进程的偏移转成墙钟,才让跨进程的 trace 时间可比。即便如此,跨主机的绝对时间仍然受 NTP 影响。实践原则是:
- 同一进程内:用
perf_counter差值,最可靠。 - 同一主机跨进程:用转换后的墙钟,误差通常在毫秒级。
- 跨主机:只比较「区间长度」与「相对顺序」,不要拿两个绝对时间戳直接相减来断言因果。
convert_time_to_realtime() 的注释也承认这一点:在单条请求的时延尺度内,假定偏移不变。这正是「跨请求比较时要用转换后的墙钟,而不是原始 perf_counter」的原因。
什么是指标回答不了的
最后列出三类指标无法回答、必须靠 trace 或日志的问题:
- 单条请求的内部因果。指标只能给出「P99 TTFT 上升」,不能告诉你「这条请求在 bootstrap 队列里等了 2 秒」。要看
SchedulerReqTimeStats.convert_to_duration()的日志,或者打开 trace。 - 跨实例的请求链路。PD 分离、router、多级缓存让一条请求跨多个进程甚至多台机器;只有 trace 的 traceparent 传播能把它们串起来。
- 配置与行为的对应。
spec_accept_length下降时,指标不知道是草稿模型变了、配置档位变了,还是输入分布变了;需要看spec_num_steps/spec_num_draft_tokens,再对照部署变更记录。
小结
SGLang 的可观测性实现可以归纳为四条设计原则:
-
按角色拆采集器。Scheduler 看到队列与 KV,Tokenizer 看到端到端延迟,Storage 与 RadixCache 看到搬运,ExpertDispatch 看到专家分布。每个采集器只导出自己那份事实,没有试图拼一个「什么都有」的大指标页。
-
同一份快照,多种视角。
SchedulerStats是一个对象,但log_stats()把它展开成几十条序列;PoolStats是同一本账,但按池子、按请求、按 session 分别汇总。指标不是新的状态,而是已有状态的投影。 -
指标、时间戳、trace 三路并行。Prometheus 负责趋势,阶段时间戳负责单请求归因,OTel span 负责跨进程因果。三者的时间基准一致(
perf_counter加校准偏移),避免了口径分裂。 -
每个「奇怪」的处理都有账本原因。
mostrecent与livesum的区别来自「指标是共享还是私有」;mamba_evictable_size = 0来自两本账的相位差;cache_hit_rate只由 prefill 写、spec_accept_length与spec_accept_rate分工,都来自它们度量的是不同的东西。
对读源码的人来说,这一篇最重要的结论可能是:理解一个指标,先要理解它是谁、在什么时候、从哪本账里读出来的。同一个名字在多进程、多 rank、多拓扑下可能完全不同;如果只看名字去用,几乎一定会得到错误的结论。
下一篇将讨论 SGLang 的请求级 dump 与日志采样:dump_requests 如何把一条请求的输入、输出、时间戳与 meta_info 写成可回放的 JSON,以及它与指标、trace 三者的分工边界。可以把这一篇作为前置:dump 里的每一个时间戳,正是前面 ReqTimeStats 与 OTel span 共用的那一套 perf_counter 账。
参考资料
- SGLang 源码:observability/metrics_collector.py
- SGLang 源码:observability/req_time_stats.py
- SGLang 源码:observability/trace.py
- SGLang 源码:observability/http_request_metrics.py
- SGLang 源码:observability/scheduler_stage_metrics.py
- SGLang 源码:managers/scheduler_components/metrics_reporter.py
- SGLang 源码:managers/scheduler_components/pool_stats_observer.py
- SGLang Documentation:Production Metrics
- SGLang 监控示例:Prometheus 配置与 Grafana Dashboard
- prometheus_client:Multiprocess mode
- Prometheus Documentation:Overview and Architecture
- OpenTelemetry:GenAI semantic conventions
- OpenTelemetry Documentation:Traces
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



