


SGLang 源码完全拆解(十五):内存池与显存管理——ReqToTokenPool、KVPool 与 Allocator 如何记物理账
从「逻辑位置」到「物理槽位」:这一篇要打开的东西
前十四篇里,「KV 槽位」「页分配」「超额分配」「释放」这些词反复出现,但真正的物理账本一直没打开。调度器决定「这一批要跑哪些 token」,RadixCache 决定「哪些前缀能复用」,注意力后端决定「怎么读这些页」——可这些讨论都建立在一个隐含前提上:存在一套可靠的机制,能把逻辑序列位置映射到显存中的具体字节。
这一篇就补这个前提。SGLang 的运行时把这件事拆成四层账本:
| 层 | 类 | 管的是什么 |
|---|---|---|
| 请求槽位层 | ReqToTokenPool / HybridReqToTokenPool | 每个在跑的请求占一行;行里存这个请求「第 i 个 token 的 KV 在哪」 |
| KV 存储层 | KVCache 及其子类(MHATokenToKVPool、MLATokenToKVPool、DSATokenToKVPool…) | 真正申请显存的那块大 buffer,按 token 槽位排布 |
| 页分配层 | TokenToKVPoolAllocator / PagedTokenToKVPoolAllocator | 谁在用哪个页、哪些页空闲;把「要几个新槽位」翻译成「拿哪几页」 |
| 混合架构层 | HybridLinearKVPool、SWATokenToKVPoolAllocator | 全注意力层与线性/滑窗层两套状态如何各自记账、如何共用请求槽位 |
这四层每一层解决的都是「逻辑到物理」的映射问题,但映射的粒度不同:请求槽位层映射的是「请求 → 行号」,页分配层映射的是「逻辑 token 位置 → 物理 token 槽位」,KV 存储层映射的是「物理槽位 → 显存里的字节偏移」。理清这三重映射的边界,后面代码里那些看似绕的约束(为什么 last_loc 要单独传、为什么预填充和解码要用两个不同 kernel、为什么 SWA 要有两张分配表)都会变得自然。
这套「页表 + 物理页池」的组织方式来自 vLLM 的 PagedAttention 论文,SGLang 沿用了同一套思想并在此基础上扩展出多池与混合架构的变体。论文里的系统总览图把「逻辑连续的 KV」与「物理上离散的 KV 页」之间的关系画得很清楚:
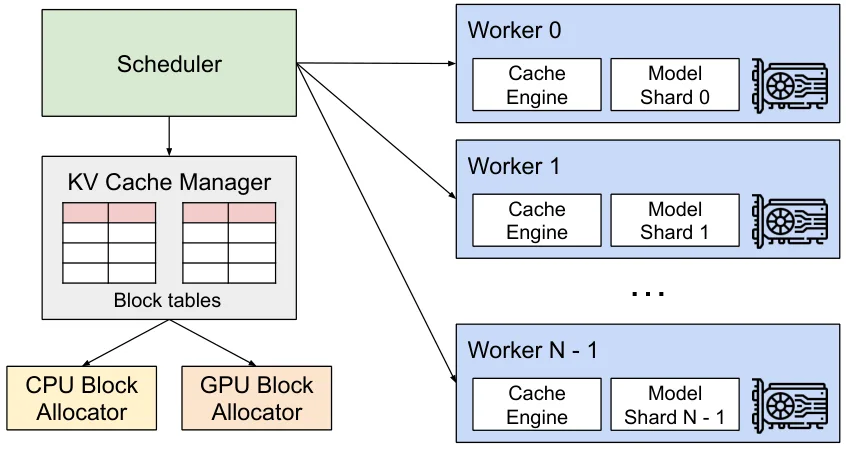
图片来源:Efficient Memory Management for Large Language Model Serving with PagedAttention(SOSP 2023)系统总览图
注意图中每条序列的逻辑块序列是连续的,但映射到的物理块(Physical blocks)散布在块池各处,而块池本身是显存里一整块连续的大 buffer。本篇要拆的就是「块池怎么切、页表怎么填、块怎么回收」这三件事在 SGLang 里的具体实现。
一重映射:请求槽位池——每个请求一行账
ReqToTokenPool 是最靠上、也是最简单的一层。它的全部职责可以用一句话概括:给每个在跑的请求分配一个固定的行号,并在这一行里记录这个请求每一个 token 的 KV 落点。
class ReqToTokenPool: def __init__(self, size, max_context_len, device, enable_memory_saver): self.size = size # +1 padding row at index 0: cuda-graph padded batches default # req_pool_indices to 0, so dummy reads/writes land here harmlessly. self._alloc_size = size + 1 self.req_to_token = torch.zeros( (self._alloc_size, max_context_len), dtype=torch.int32, device=device ) self.free_slots = list(range(1, self._alloc_size)) self.req_generation = torch.zeros(self._alloc_size, dtype=torch.int64)三行代码里有三个设计决策值得展开。
为什么多一行 padding。 数组的第一维是 size + 1 而不是 size,第 0 行永远是空的、永远不会被任何请求占用(free_slots 从 1 开始)。原因是 CUDA Graph:解码阶段要整图捕获,而捕获时批次形状必须固定,padded 的假请求需要一个合法的行号来读写,默认值就是 0。把 0 号行留作「垃圾桶行」,填充出来的假请求读写它不会污染任何真实请求的账本。这是一个典型的「用一格显存换掉一次分支判断」的设计——如果没有这一行,图里每个访问 req_to_token 的 kernel 都得先判断「这个请求是不是 padding 的」。
为什么 free_slots 从尾部弹出。 分配时走的是:
select_index = self.free_slots[-need_size:]del self.free_slots[-need_size:]从尾部切片删除是 ,而从头部弹出是 ,因为列表头部删除要把后面所有元素前移。在请求数上千的服务里,free_slots 可能有几千个元素,每个调度 step 都要分配一次,这个常数不能忽略。注释里明确写了这个取舍——代价是空闲行号的顺序被打乱,但没有人要求 req_pool_idx 连续,所以这个代价为零。
为什么有 req_generation。 这是整个池子里最容易被忽略、但正确性上最关键的一个字段。请求结束后它的行被回收,下次分配可能又落到同一个行号上。如果某个异步组件(比如 HiCache 的写回、或者 overlap 调度里的在途操作)缓存了「(行号, 当时的状态)」,它怎么知道这个行号已经被换过主人了?答案是读 req_generation:行号每次被分配时自增 1,读者把当时看到的代数记下来,下次用「代数是否相等」判断这行还是不是同一个请求。
def alloc_rows(self, need_size: int) -> Optional[List[int]]: """Take need_size rows and bump their generation, with no Req bound to them. alloc() layers Req binding on top; beam member rows have no Req.""" if need_size > len(self.free_slots): return None if need_size == 0: # Handled separately: free_slots[-0:] is the entire list, not []. return [] select_index = self.free_slots[-need_size:] del self.free_slots[-need_size:] self.req_generation[select_index] += 1 if self._on_alloc_rows is not None: self._on_alloc_rows(select_index) return select_index注意 need_size == 0 被单独处理:Python 里 list[-0:] 等于 list[0:],也就是整个列表,不是空列表。如果不特判,一次「需要 0 行」的分配会把整个空闲表返回出去。这类边界在框架代码里出现得非常频繁,读源码时看到莫名其妙的特判,第一反应应该是去想「哪个退化输入会触发它」。
clear() 里还有一条不显眼的注释,值得完整引用:
def clear(self): self.free_slots = list(range(1, self._alloc_size)) # req_generation must stay monotonic: readers detect row reuse by # equality with a generation they stored, so zeroing it here can give a # row's next request the same generation as its previous one.清空池子时 free_slots 重置了,但 req_generation 故意不清零。因为它必须单调递增——如果清零,某行此前的代数恰好是 0(刚初始化后的第一次分配),复用该行的新请求代数也是 0,读者就会把「新请求」误认成「旧请求」。这行的代数一路涨到 int64 溢出要几百年,所以「不清零」是安全的,而「清零」是不安全的。
alloc() 在 alloc_rows 之上薄薄加了一层请求绑定,其中有一个分支专门服务分块预填充:
def alloc(self, reqs: list[Req]) -> Optional[List[int]]: # Indices of reqs that already have a req_pool_idx and will reuse # their existing slot (e.g. chunked prefill continuing across chunks). reusing = [i for i, r in enumerate(reqs) if r.kv.holds_kv] assert all(reqs[i].kv.kv_allocated_len > 0 for i in reusing), ( "a reused row must carry allocated KV" ) select_index = self.alloc_rows(len(reqs) - len(reusing)) ... for r in reqs: if not r.kv.holds_kv: r.kv.req_pool_idx = select_index[offset] offset += 1 return [r.kv.req_pool_idx for r in reqs]一个长 prompt 被切成多个 chunk 分多轮跑,请求对象 Req 在轮次之间一直活着,它已经有行号了,只需要为没有行号的新请求分配。这里的断言很关键:复用的行必须已经持有 KV(kv_allocated_len > 0),否则说明状态机出了错。这个「先算需要几行、再按需绑定」的两段式结构在后面 KV 池的 extend 分配里会以更大的规模重现。
二重映射:KV 存储池——显存里的那块大 buffer 长什么样
请求槽位层只记录「第 i 个 token 的 KV 在哪个物理槽位」,真正申请显存的是 KV 存储层。先看基类 KVCache 里那些被所有子类共享的约定:
class KVCache(abc.ABC): @abc.abstractmethod def __init__(self, size, page_size, dtype, layer_num, device, ...): self.size = size self.page_size = page_size self.dtype = dtype if dtype in (torch.float8_e5m2, torch.float8_e4m3fn, torch.float8_e4m3fnuz): # NOTE: Store as torch.uint8 because Tensor.index_put is not # implemented for torch.float8_e5m2 self.store_dtype = torch.uint8 else: self.store_dtype = dtype self.layer_num = layer_num self.start_layer = start_layer or 0 self.end_layer = end_layer or layer_num - 1这里第一个关键概念是 store_dtype 与 dtype 的分离。FP8 类型(float8_e4m3fn 等)虽然有一等公民的 dtype,但 PyTorch 对它们没有实现 index_put,所以显存里实际用 uint8 存字节,读取时再 view 回 FP8。get_key_buffer 里就能看到这个来回:
def get_key_buffer(self, layer_id: int): if self.store_dtype != self.dtype: return self.kv_buffer[layer_id - self.start_layer].view(self.dtype) return self.kv_buffer[layer_id - self.start_layer]start_layer / end_layer 是流水线并行留下的口子:一个 rank 只持有自己那几层 KV,所有 pool 的 layer 维度都是局部的。这就是为什么后面所有 buffer 访问都要写 layer_id - self.start_layer——layer_id 是全局层号,buffer 数组是局部下标。
看 MHA 的 _create_buffers:
def _create_buffers(self): with self.memory_saver_adapter.region(GPU_MEMORY_TYPE_KV_CACHE): with (torch.cuda.use_mem_pool(self.custom_mem_pool) if self.custom_mem_pool else nullcontext()): # The padded slot 0 is used for writing dummy outputs from padded tokens. self.k_buffer = [torch.zeros((self.size + self.page_size, self.head_num, self.head_dim), dtype=self.store_dtype, ...) for _ in range(self.layer_num)] self.v_buffer = [torch.zeros((self.size + self.page_size, self.head_num, self.v_head_dim), dtype=self.store_dtype, ...) for _ in range(self.layer_num)]三个设计点:
每层一个独立张量,而不是一个大张量切层。 这样每层的地址独立,可以单独挂到 CUDA Graph、单独做 HiCache 的层粒度传输、单独做 layer-wise transfer counter 的等待。代价是 Python 层的 List 结构,以及在自定义内存池下多几次分配调用。
size + page_size 而不是 size。 和 ReqToTokenPool 的 +1 同一个思路,但这里多出的是一整页:paged 布局下最后一页可能只用了几个槽位,而 alloc_decode_kernel 这类 kernel 会按整页读写;留一页余量让「部分页」的读写永远落在合法地址内。MLA 池的注释写得更直白:
# The padded slot 0 is used for writing dummy outputs from padded tokens.内存池与内存节省器。 torch.cuda.use_mem_pool(self.custom_mem_pool) 让 KV 分配走指定的显存池(用于与其它组件共享/隔离),memory_saver_adapter.region(GPU_MEMORY_TYPE_KV_CACHE) 把这块分配登记成「可被 RL 训练等场景临时释放的 KV 区域」。两者都是可选开关,关掉时是 nullcontext(),不影响主路径。
不同注意力架构的池子形状差别很大,这正是「为什么需要多个子类」的原因:
| 池类 | buffer 形状 | 适用 |
|---|---|---|
MHATokenToKVPool | K/V 分开,各 (size+page, head_num, head_dim) | 标准 MHA/GQA,K 与 V 维度可不同 |
MLATokenToKVPool | 单个 kv_buffer,(size+page, 1, kv_lora_rank + qk_rope_head_dim) | MLA:K/V 压成一个低秩 latent |
DSATokenToKVPool | 继承 MLA,另加 indexer 的 K 缓存 | DeepSeek 稀疏注意力:主 KV 之外还要给 indexer 存 key |
HybridLinearKVPool | 组合池:全注意力层走 full_kv_pool,线性层挂 mamba_pool 的循环状态 | 混合模型(部分层全注意力 + 部分层线性注意力) |
MHATokenToKOnlyPool | 只有 K | 某些只缓存 K 的稀疏/共享 V 架构 |
显存占用可以写成两行对比。设层数 、token 数 、每头维度 、头数 、字节宽度 ,标准 MHA 的 KV 池大小是:
其中系数 来自 K 和 V 各存一份, 是每 token 每层的元素个数。MLA 的池大小只有一份 latent:
是 kv_lora_rank(压缩后的 latent 维度), 是 qk_rope_head_dim(必须原样保留的 RoPE 部分)。注意公式里没有 ——所有注意力头共享这一份 latent,这是 MLA 省显存的根本原因; 那一项之所以不能一起压,是因为旋转位置编码作用在各头的 Q/K 上,压掉它会让注意力完全失去位置分辨力。这个取舍在 MLA 完全拆解 里有完整的推导。
MLA 池最值得单独讲,因为它把「KV Cache 为什么能压那么小」直接写在了形状里。标准 MHA 每 token 每层存的是 2 × head_num × head_dim 个数(K 和 V 各一份,每头一份);MLA 存的是 kv_lora_rank + qk_rope_head_dim 个数,且所有头共享这一份。以 DeepSeek-V3 为例,kv_lora_rank = 512、qk_rope_head_dim = 64,每 token 每层 576 个数;而如果按 128 头、head_dim 128 的标准 MHA 存,是 2 × 128 × 128 = 32768 个数。差了两个数量级。
self.kv_cache_dim = ( override_kv_cache_dim if self.dsa_kv_cache_store_fp8 else (kv_lora_rank + qk_rope_head_dim))读 K/V 时从同一个 buffer 的两段里切:
def get_key_buffer(self, layer_id: int): # ...(store_dtype 转换) return self.kv_buffer[layer_id - self.start_layer]
def get_value_buffer(self, layer_id: int): return self.kv_buffer[layer_id - self.start_layer][..., : self.kv_lora_rank]也就是说「K」是整条 576 维(含 RoPE 那 64 维),「V」其实不存在——V 要从 K 的 latent 部分经 kv_b_proj 上投影出来,这一步在注意力 kernel 里完成。这就是为什么 MLA 不需要存 V buffer,也是为什么它能省下一半显存。 这个推导在 MLA 完全拆解 里有完整过程。
三重映射:页分配器——把「要几个槽位」翻译成「拿几页」
现在到了全书最核心的一层。TokenToKVPoolAllocator 和它的分页版本 PagedTokenToKVPoolAllocator 负责回答:「这一批要新增 个 token 的 KV,池子里哪些物理槽位可以用?」
先看不分页的简单版本,它是理解分页版本的基础:
class TokenToKVPoolAllocator(BaseTokenToKVPoolAllocator): def __init__(self, size, dtype, device, kvcache, need_sort): super().__init__(size, 1, dtype, device, kvcache, need_sort) # page_size = 1 self.clear()
def clear(self): # The padded slot 0 is used for writing dummy outputs from padded tokens. self.free_pages = torch.arange(1, self.size + 1, dtype=torch.int64, device=self.device) self.release_pages = torch.empty((0,), dtype=torch.int64, device=self.device)
def alloc(self, need_size: int): if self.need_sort and need_size > len(self.free_pages): self.merge_and_sort_free() if need_size > len(self.free_pages): return None select_index = self.free_pages[:need_size] self.free_pages = self.free_pages[need_size:] return select_indexpage_size = 1 时,每个 token 是一个独立可分配的槽位,free_pages 就是一列空闲槽位号,分配就是从头部切片、释放就是往末尾拼接。注意这里也有「0 号槽位留作 padding 垃圾桶」的约定,arange(1, size+1) 从 1 开始。
need_sort 这个看起来不起眼的布尔量值得解释。它控制释放时是「立刻把释放的槽位拼回 free_pages」还是「先攒在 release_pages 里」。为什么要有这种延迟?因为释放的槽位号是乱序的,如果每次释放都往头部 cat,free_pages 会变成一堆不连续的小段;后续分配从头部切片拿到的槽位号就会很分散,导致:
- KV 写入的地址不连续,写 kernel 的合并访存变差;
- 前缀缓存的块对齐变难,因为连续前缀的 KV 落在物理上不连续的位置。
延迟合并的策略是:释放时先攒起来,等到某次分配发现「空闲不够」时才做一次排序合并(merge_and_sort_free),把碎片整理成大块。这是一个典型的「把 O(n log n) 的整理摊到真正缺页时才做」的摊销设计。
分页版本把这一切从「token 粒度」抬到「页粒度」:
class PagedTokenToKVPoolAllocator(BaseTokenToKVPoolAllocator): def __init__(self, size, page_size, dtype, device, kvcache, need_sort): super().__init__(size, page_size, dtype, device, kvcache, need_sort) self.num_pages = size // page_size self.clear()
def clear(self): # The padded slot 0 is used for writing dummy outputs from padded tokens. self.free_pages = torch.arange(1, self.num_pages + 1, dtype=torch.int64, device=self.device) self.staged_pages: list[torch.Tensor] = [] self.num_staged_pages = 0注意 free_pages 现在装的是页号而不是槽位号,且从 1 开始(0 号页同样是垃圾桶页)。available_size 的换算也体现了这一点:
def available_size(self): return (len(self.free_pages) + self.num_staged_pages) * self.page_size前面反复出现的「页表」(block table)在实际分配中长什么样,vLLM 官方博客的这组动画把「逻辑块 → 物理块」的对应关系表现得很直观。下图是分配过程的一个中间状态:序列的逻辑块依次落到块池里不连续的物理块上,块表逐行记下对应关系:
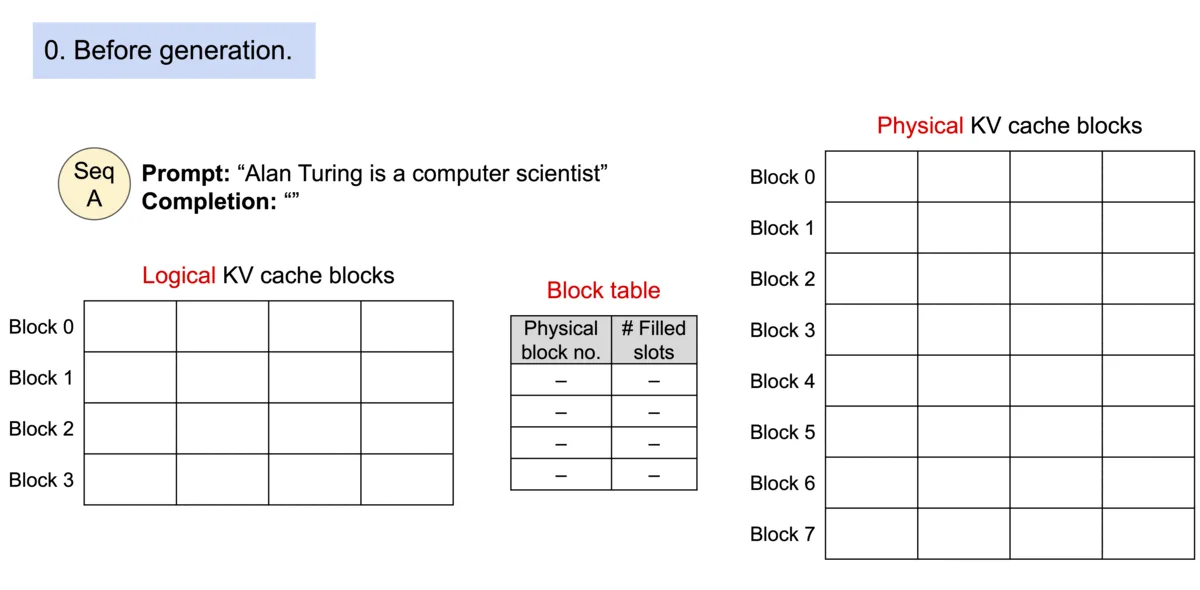
图片来源:vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention 官方博客动画中的一帧
SGLang 的 alloc_extend_kernel 做的事本质相同——把「这个请求的每个逻辑 token」映射到一个物理槽位号——只是它把这个映射在 GPU 上并行地算出来,而且一次处理整批请求,同时还要处理「前缀未页对齐」这种动画里没有表现出的细节。
分配器家族:一套接口,多种策略
allocator 目录下一个文件一种分配策略,全部实现 BaseTokenToKVPoolAllocator 定义的同一组接口(alloc / alloc_extend / alloc_decode / free / free_segment / available_size …)。调度器侧不做任何 allocator 类型分支,它只调接口——这是基类注释里明确写的设计意图:
# -- scheduler-facing capacity hooks -- # The scheduler calls these unconditionally, with no allocator-type branches # on its side; byte-accounted composites override the token-count defaults.这组接口里有一半是「面向调度器的容量问答」,而不是真正的分配动作,它们决定了调度器能接纳多少请求、每请求最多能生成多少 token:
| 方法 | 回答的问题 |
|---|---|
available_size() | 现在还能放下多少个 token 的 KV |
request_slot_reserve() | 除 prefill 外还要为这个请求预留多少槽位(含请求私有工作区) |
max_new_tokens_for_memory() | 在剩余容量下这次生成最多还能出多少 token |
prealloc_fits() / prealloc_ceiling_fits() | 这个规模的需求能不能被满足(且要不要先驱逐) |
evict_to_free_tokens() | 驱逐多少缓存页才能腾出指定数量的 token |
max_new_tokens_for_memory 的实现把页对齐的浪费算得很实在:
def max_new_tokens_for_memory(self, input_tokens, max_new_tokens, *, token_capacity, sliding_window_size, chunk_size): """Clip generation to the empty-pool budget; None means prompt cannot fit.""" paged_input = -(-input_tokens // self.page_size) * self.page_size return max(0, min(max_new_tokens, token_capacity - paged_input - self.page_size - 1))-(-x // p) 是向上取整到页。输入长度先按页向上取整,再加上一整页的余量和 1,从总容量里扣掉——这三项分别对应「输入自身占的页」「输入尾部半满页的浪费」「最后一页可能开新页的余量」。 少了任何一项,都会在边界上多接纳一个请求,然后在运行中撞上分配失败。
家族成员按「池子拓扑」而不是按实现细节分类:
| 分配器 | 对应池子拓扑 |
|---|---|
TokenToKVPoolAllocator | page_size = 1,token 粒度,无页表 |
PagedTokenToKVPoolAllocator | 标准分页,页表 + 页池 |
SWATokenToKVPoolAllocator | 全注意力池 + 滑窗池双表 + 跨池映射 |
UnifiedSWATokenToKVPoolAllocator | FULL/SWA 共享同一 id 空间,两端分配 |
UnifiedMambaSWATokenToKVPoolAllocator | 三池复合:全注意力 + 滑窗 + mamba/conv 状态 |
PageInterleavePoolAllocator | 逻辑页分片(logical-page KV sharding),按类做水位控制 |
HiSparseTokenToKVPoolAllocator / DeepSeekV4HiSparse... | 稀疏/DeepSeek-V4 的分层稀疏 KV 记账 |
最后一条值得单独看一眼,因为它是把「稀疏」写进分配粒度的:
class HiSparseTokenToKVPoolAllocator(BaseTokenToKVPoolAllocator): ... def alloc(self, ...): """Allocate only logical indices without hisparse device indices."""「只分配逻辑索引、不分配设备页」意味着上层可以先记账、后落地——稀疏注意力层不需要为每个 token 都准备物理页,只有被选中的 token 才真正需要设备槽位。这正是 DeepSeek-V4 混合注意力完全拆解 里 CSA/HCA 那套稀疏结构在内存侧的实现。UnifiedSWAAllocatorBase 的类注释也点出了统一池的核心权衡:
class UnifiedSWAAllocatorBase(SWATokenToKVPoolAllocator): """Shared FULL/SWA virtual IDs, allocation lifecycle, and index translation.「共享虚拟 id」是统一池相对双池的本质区别:双池有两套 id 空间,需要一个映射表把它们对上(前面那张 full_to_swa_index_mapping);统一池让两边共用一套虚拟 id,映射就消失了,代价是分配器要同时管两种池的字节预算,复杂度从「表」转到了「分配策略」里。
分配中最难的部分:alloc_extend
分块预填充(extend)阶段要一次给一批请求分配新增 token 的 KV。难点在于:每个请求的前缀长度不同、每个请求新增的 token 数不同,所以每个请求会跨的页边界也不同。 一个请求可能完全没有开新页(只往已有的半满页里续写),也可能开好几个整页再加一个半满页。
如果用最朴素的做法——对每个请求单独算它要几页、从 free_pages 里抠出来——那么分配就是串行的,在批次很大时会成为 CPU 侧的瓶颈。SGLang 的做法是把它写成一个 Triton kernel,一个 program 处理一个请求,所有请求并行:
@triton.jit(do_not_specialize=["free_page_ptr"])def alloc_extend_kernel( pre_lens_ptr, seq_lens_ptr, last_loc_ptr, free_page_ptr, out_indices, bs_upper: tl.constexpr, page_size: tl.constexpr,): pid = tl.program_id(0)
load_offset = tl.arange(0, bs_upper) seq_lens = tl.load(seq_lens_ptr + load_offset, mask=load_offset <= pid) pre_lens = tl.load(pre_lens_ptr + load_offset, mask=load_offset <= pid) extend_lens = seq_lens - pre_lens
seq_len = tl.load(seq_lens_ptr + pid) pre_len = tl.load(pre_lens_ptr + pid) extend_len = seq_len - pre_len
sum_extend_lens = tl.sum(extend_lens) output_start_loc = sum_extend_lens - extend_len第一个关键操作是 prefix sum。tl.load 时用 mask=load_offset <= pid 只加载到当前 program 为止,然后 tl.sum(extend_lens) 求和——这是每个 program 自己算一遍前缀和,得到「我这一份输出应该写到 out_indices 的哪个位置」。O(bs²) 的加载量在 bs 是几十到几百量级时完全可接受,而且避免了跨 program 通信。
先形式化分页映射。设页大小 (page_size),页号 、页内偏移 (),则该槽位的物理编号就是
这就是 kernel 里 page_start * page_size + offset % page_size 那一行的含义,也是「逻辑 token 位置 → 物理槽位」的完整定义。反过来,已知物理槽位 求它属于哪一页,就是整数除法:
释放时 free_index // self.page_size 用的正是这个式子——去重要按页去,而不是按槽位去。
第二个关键操作是算「我开几页、这些页从 free_pages 的第几个开始」:
num_pages_after = (seq_lens + page_size - 1) // page_size num_pages_before = (pre_lens + page_size - 1) // page_size num_new_pages = num_pages_after - num_pages_before
num_page_start_loc_self = (seq_len + page_size - 1) // page_size - (pre_len + page_size - 1) // page_size sum_num_new_pages = tl.sum(num_new_pages) new_page_start_loc = sum_num_new_pages - num_page_start_loc_self把每页 个槽位、分配前后长度记为 与 ,则分配前后的页数分别是
是向上取整:只要前缀长度不是页的整数倍,就已经占着一个「半满页」。 就是这个请求本次要新开的页数——注意它可能是 0(新 token 全落在已有的半满页里)。
这就是 alloc_extend 的核心公式。翻译成人话:
num_pages_before= 这个请求在分配前「理论上占了几页」(按前缀长度算);num_pages_after= 分配后占几页;- 两者之差就是这个请求需要新开几页。
再对 num_new_pages 做一次前缀和,就得到「我这些新页应该从 free_pages 数组的哪个下标开始取」。两个前缀和(一个是 token 的输出位置,一个是页的下标)都靠 tl.sum 在 program 内完成。
接下来是写输出,分成三段,对应一个请求跨越页边界的三种情况:
Part 1:填满当前的半满页。 前缀长度 pre_len 可能不在页边界上,那么新 token 的前几个应该写进这一页剩余的空位:
last_loc = tl.load(last_loc_ptr + pid) num_part1 = min(seq_len, (pre_len + page_size - 1) // page_size * page_size) - pre_len offset_one_page = tl.arange(0, page_size) tl.store( out_indices + output_start_loc + offset_one_page, last_loc + 1 + offset_one_page, mask=offset_one_page < num_part1, ) if pre_len + num_part1 == seq_len: returnlast_loc 是「这个请求上一个 token 的物理槽位号」,它一定是这一页里的某个位置;last_loc + 1 ... last_loc + num_part1 就是这一页剩下的连续槽位。这里必须用 last_loc 而不是从页号重算——因为一个请求的页可能来自任意页,只有 last_loc 记录了它当前在页内的偏移。 这就是 alloc_extend 为什么必须把 last_loc 当参数传进来,也是 ReqToTokenPool 里那行 req_to_token[req, i] 的意义:它记的就是每个请求每个位置的物理槽位,last_loc 就是其中最后一个。
注意提前 return 的 if pre_len + num_part1 == seq_len——如果这个请求的新增 token 刚好把当前页填满就结束了,后面两段都不用写。
Part 2:写整页。 中间那些完整的新页,直接用刚分配的页号换算:
num_part2 = (seq_len // page_size * page_size - (pre_len + page_size - 1) // page_size * page_size) BLOCK_EXTEND: tl.constexpr = 4096 num_blocks = (num_part2 + BLOCK_EXTEND - 1) // BLOCK_EXTEND for block_id in range(num_blocks): offset_in_block = tl.arange(0, BLOCK_EXTEND) offset = block_id * BLOCK_EXTEND + offset_in_block mask = offset < num_part2 page_start = tl.load(free_page_ptr + new_page_start_loc + offset // page_size, mask=mask) tl.store( out_indices + output_start_loc + num_part1 + offset, page_start * page_size + offset % page_size, mask=mask, )page_start * page_size + offset % page_size 就是「第 p 页的第 k 个槽位」的物理编号,这是分页映射的定义式。注释里解释了为什么用 动态上界的 blocked loop 而不是 tl.arange(0, num_part2):
# Part 2: fill the new full pages using a dynamic blocked loop.# The loop bound is derived from num_part2 (runtime value), so Triton# generates a real loop instead of unrolling -- no constexpr dependency# on extend size and only one kernel compilation.如果 extend 长度是 constexpr,Triton 会为每个长度单独编译一份 kernel;用运行期循环上界,则只编译一份。chunked prefill 的 chunk 大小虽然配置固定,但最后一块通常短于 chunk_size,所以 extend 长度是变化的——每次变化都触发一次 JIT 编译要几十到上百毫秒,这在长 prompt 的第一个 chunk 上是能感觉到的延迟。
Part 3:写最后一个半满页。 新增 token 的尾巴落在新开的最后一页里:
num_part3 = seq_len - seq_len // page_size * page_size start_loc = tl.load(free_page_ptr + new_page_start_loc + num_page_start_loc_self - 1) tl.store( out_indices + output_start_loc + num_part1 + num_part2 + offset_one_page, start_loc * page_size + offset_one_page, mask=offset_one_page < num_part3, )注意这里从 free_pages 取的是最后一个新页(下标 - 1),因为这一段只写这一个页且从页首开始。
三段拼起来,一个请求的完整物理槽位序列就构造好了。整个过程没有一次 CPU-GPU 同步:free_pages 在 GPU 上,输出 out_indices 也在 GPU 上,页码的推进(self.free_pages = self.free_pages[num_new_pages:])只是一个视图切片。
alloc_decode:每步只多一个 token
解码阶段每步每个请求只新增一个 token,所以逻辑简单得多,但同样用 kernel 并行:
@triton.jit(do_not_specialize=["free_page_ptr"])def alloc_decode_kernel(seq_lens_ptr, last_loc_ptr, free_page_ptr, out_indices, bs_upper: tl.constexpr, page_size: tl.constexpr): pid = tl.program_id(0) load_offset = tl.arange(0, bs_upper) seq_lens = tl.load(seq_lens_ptr + load_offset, mask=load_offset <= pid) pre_lens = tl.where(load_offset <= pid, seq_lens - 1, seq_lens)
seq_len = tl.load(seq_lens_ptr + pid) pre_len = seq_len - 1
num_pages_after = (seq_lens + page_size - 1) // page_size num_pages_before = (pre_lens + page_size - 1) // page_size num_new_pages = num_pages_after - num_pages_before
num_page_start_loc_self = (seq_len + page_size - 1) // page_size - (pre_len + page_size - 1) // page_size sum_num_new_pages = tl.sum(num_new_pages) new_page_start_loc = sum_num_new_pages - num_page_start_loc_self
if num_page_start_loc_self == 0: last_loc = tl.load(last_loc_ptr + pid) tl.store(out_indices + pid, last_loc + 1) else: page = tl.load(free_page_ptr + new_page_start_loc) tl.store(out_indices + pid, page * page_size)结构与 extend 版一致,只是 pre_len = seq_len - 1 写死。最后那个 if/else 就是「新增一个 token 有没有跨页」:没跨页就 last_loc + 1,跨页就从新页的页首取。整段 kernel 的输出只有 bs 个值,一个请求一个槽位。
alloc_decode 在 host 侧要先把页数算清楚:
num_new_pages = get_num_new_pages(seq_lens=seq_lens_cpu, page_size=self.page_size, decode=True)if num_new_pages > len(self.free_pages): return None注意这里用的是 seq_lens_cpu——主机侧已经有 CPU 上的长度副本,就不去读 GPU 张量。这是为了避免 torch.sum().item() 那样的隐式同步,因为解码阶段的 alloc_decode 跑在 overlap 调度的关键路径上,一次同步就可能吃掉重叠带来的收益。
扩容与不足
如果页不够,alloc_extend / alloc_decode 返回 None,上层调度器据此决定「这一批少放几个请求」或者「驱逐一些缓存页」。这里有一段注释很值得一读:
if max_new_pages > len(self.free_pages): # The bound cannot prove the pool is deep enough, and both kernels # read past free_pages when it is not: the Triton one out of # bounds, the native one clamping to duplicate rows. Pay for the # exact count before launching. if num_new_pages is None: num_new_pages = get_num_new_pages(seq_lens=seq_lens_cpu, page_size=self.page_size, prefix_lens=prefix_lens_cpu) if num_new_pages > len(self.free_pages): return Nonemax_new_pages 是一个上界估计(extend_num_tokens // page_size + bs + 1),它比实际需要多。正常情况下用上界就能证明「够用」(上界都够,实际肯定够),所以走快路径:先启动 kernel,事后再精确算页数并推进 free_pages。但如果上界都不够,就不能赌了——kernel 会越界读 free_pages,Triton 版直接越界,native 版会 clamp 到重复行。这时才花一次 CPU 计算做精确判断。这是「乐观快路径 + 悲观慢路径」的经典写法。
释放、去重与 free_group:为什么不能「谁先释放谁先拿」
释放侧有两个容易踩的坑。
坑一:同一页会被多次释放。 一个请求结束时,req_to_token 行里有这个请求所有 token 的槽位。如果逐个槽位释放,同一页会被释放 page_size 次,页号重复入队,下次分配就会把同一页发给两个请求——两个请求的 KV 互相覆盖,输出全错。
所以 paged 释放的第一件事是去重:
def free(self, free_index: torch.Tensor): if free_index.numel() == 0: return if self.free_group is None: self._release_page_ids(torch.unique(free_index // self.page_size)) else: self.free_group.append(self._copy_for_free_group(free_index))free_index // self.page_size 把槽位号转成页号,torch.unique 去重。但 torch.unique 有代价:它在 GPU 上要做排序,ROCm 上第一次调用还会 JIT 编译 rocPRIM 的 sort/unique kernel,约 200ms。所以 __init__ 里显式做了一次预热:
# Pre-warm the torch.unique used by free(): on ROCm the first call# JIT-compiles rocPRIM sort/unique kernels and costs ~200ms.if _is_hip and torch.cuda.is_available(): try: _warmup = torch.arange(1024, dtype=torch.int64, device=device) _ = torch.unique(_warmup // page_size) torch.cuda.synchronize() except Exception: pass把 200ms 从「第一次真实请求」挪到「初始化」,对在线服务是可感知的差别。
坑二:torch.unique 依然是一次 GPU 排序。 如果释放的 KV 索引是「页对齐的连续段」,就可以不用去重——每个页只取一个代表。这就是 free_segment:
def free_segment(self, free_index: torch.Tensor, *, start_pos: int): """Fixed-shape free(): page-aligned start plus contiguous per-page tokens make ``free_index[::page_size]`` hit each page once; no torch.unique sync.""" if free_index.numel() == 0: return ps = self.page_size assert start_pos % ps == 0, f"segment start {start_pos} is not page-aligned" reps = free_index[::ps] self.free_page_ids(reps // ps)条件很明确:start_pos 页对齐 + 每个页的 token 连续,那么每隔 page_size 取一个就是每页的代表,无需 unique。这是一个「用结构保证代替运行时检查」的例子——调用方(块级驱逐、SWA 的页回收)知道自己的索引有这种结构,就调 free_segment;不知道就调 free,多付一次排序。
free_group:把一批释放攒成一次
在 prefix cache 的树结构里驱逐一批节点时,如果每驱逐一个节点就立刻把它下面的页号 cat 回 free_pages,会触发几十次张量拼接,而每次拼接都要重新分配内存、拷贝。free_group 就是把这批释放攒起来、结束时一次合并:
def free_group_begin(self): super().free_group_begin() self.free_page_ids_group = []
def free_group_end(self): super().free_group_end() if self.free_page_ids_group: self._release_page_ids(torch.cat(self.free_page_ids_group)) self.free_page_ids_group = [] if self.debug_mode: # the no-double-free contract can only break across a group's calls self._debug_check_no_duplicate_pages()注释点出了一个重要事实:在 group 内部,防重复释放的检查是做不了的,因为页还没真正回到 free_pages,查不到。所以契约变成「group 结束后整体不许有重复页」。调试模式下才会在 free_group_end 里做这一次全量检查——这是拿调试期的 O(n) 检查换生产期的正确性保证。
_release_page_ids:排序合并的真正开关
def _release_page_ids(self, *page_ids: torch.Tensor): if self.need_sort: self.staged_pages.extend(page_ids) self.num_staged_pages += sum(ids.numel() for ids in page_ids) else: self.free_pages = torch.cat((*page_ids, self.free_pages))need_sort 为真时,释放的页先摞在 staged_pages 里;等到 available_size 报出的数不够用时(alloc 里那句 if num_pages > len(self.free_pages): self.merge_and_sort_free()),才把 staged 和 free 合起来排一次序:
def merge_and_sort_free(self): if not self.staged_pages: return self.free_pages, _ = torch.sort(self.get_all_free_pages()) self.staged_pages = [] self.num_staged_pages = 0排序之后 free_pages 是升序的,从头部切片拿到的页号就倾向于是连续的大块。这个设计的目标是让「连续的新分配拿到连续的物理页」,从而让 KV 写入和注意力读取的访存更友好。代价是把排序推迟到真正缺页的时刻,那时 CPU/GPU 上要多做一次排序——但缺页本来就是慢路径。
available_size 必须把 staged 也算进去,否则会误判「没有空闲」而在根本不缺页的时候触发无谓的合并:
def available_size(self): return (len(self.free_pages) + self.num_staged_pages) * self.page_size
def get_all_free_pages(self): return torch.cat((self.free_pages, *self.staged_pages))混合架构的双账本:SWA 与线性注意力
真实模型越来越多是混合的:一部分层是全注意力(要 per-token KV),一部分是滑窗注意力 SWA(只需要窗口内 KV),一部分是线性注意力(只需要固定大小的循环状态)。这时一套池子 + 一套分配器就不够了。
双池 + 映射表:SWATokenToKVPoolAllocator
SWA 分配器维护两张分配表:
class SWATokenToKVPoolAllocator(BaseTokenToKVPoolAllocator): def __init__(self, size, size_swa, page_size, dtype, device, kvcache, need_sort, req_to_token_pool=None): assert isinstance(kvcache, BaseSWAKVPool) self._size_full = size self._size_swa = size_swa full_kv_pool = getattr(kvcache, "full_kv_pool", None) swa_kv_pool = getattr(kvcache, "swa_kv_pool", None)
if page_size == 1: self.full_attn_allocator = TokenToKVPoolAllocator(size, dtype, device, full_kv_pool, need_sort) self.swa_attn_allocator = TokenToKVPoolAllocator(size_swa, dtype, device, swa_kv_pool, need_sort) else: ... self.full_attn_allocator = PagedTokenToKVPoolAllocatorClass(size, page_size, dtype, device, full_kv_pool, need_sort) self.swa_attn_allocator = PagedTokenToKVPoolAllocatorClass(size_swa, page_size, dtype, device, swa_kv_pool, need_sort)full_attn_allocator 管全注意力池,swa_attn_allocator 管滑窗池。两者页号空间独立——所以还需要一张跨池映射表,记录「全注意力池的第 p 页,对应滑窗池的哪一页」:
# Trailing -1: a last_loc of -1 (no prefix) indexes it, so alloc_extend and # alloc_decode see -1 on the SWA side as well. self.full_to_swa_index_mapping = torch.cat([ torch.zeros(size + self.page_size, dtype=torch.int64, device=device), torch.tensor([-1], dtype=torch.int64, device=device), ])维度定为 size + page_size + 1 而不是 size,末尾多补一个 -1。原因写在注释里:last_loc 在没有前缀时是 -1,分配逻辑会拿 -1 去查这张表,所以要有一个合法的「查不到」位置返回 -1,让 SWA 侧的分配走「不开新页」的分支。这就是为什么表要长一格——为哨兵值留位。
为什么滑窗可以「按请求」记账
SWA 池最激进的设计是 per-request ring:
# Per-request SWA ring: the paged SWA indices built here are unused and # SWA capacity is bounded by req slots, not tokens. ring_size = kvcache.swa_req_ring_size self._swa_req_ring = ring_size is not None self._req_to_token_pool = req_to_token_pool if self._swa_req_ring: assert req_to_token_pool is not None, ("per-request SWA ring: capacity is counted in req slots") self._swa_ring_cost = ((ring_size + self.page_size - 1) // self.page_size) * self.page_size # Total SWA capacity is every req slot's ring; all slots are free here. self._size_swa = req_to_token_pool.available_size() * self._swa_ring_cost逻辑链条是这样的:滑窗层只需要「最近 个 token」的 KV,所以每个请求需要的滑窗 KV 容量是固定的 ,与它跑多长无关。于是总容量 = 请求槽位数 × 每槽一个 ring 的成本。这带来两个好处:
- 滑窗容量不再是「token 数」的预算,而是「并发请求数」的预算。 长上下文请求不会因为序列变长而挤占 SWA 池,容量可预测。
- ring 的复用天然对齐请求槽位。 请求槽位复用(前面讲的
req_generation)时,ring 也跟着换主人,不需要单独一套生命周期管理。
代价是每个请求槽都必须预留下 ring 的空间,即使这个槽此刻没有跑滑窗层——这是拿「稳态并发下的定容量」换掉「随序列长度波动的动态分配」。注释也直说了 paged SWA indices built here are unused:在 ring 模式下,那套分页索引结构是白建的,只是个占位。
混合架构的第三本账:循环状态池
滑窗层还能靠「每 token 一个 KV 槽位」的思路记账,线性注意力层就不行了——它根本不存在 per-token KV,只有一份固定大小的循环状态(Mamba 的 conv + temporal state、GDN 的各种 state)。这类状态必须按请求槽位而不是按 token 记账,于是 HybridReqToTokenPool 在请求槽位池里再挂一层:
class HybridReqToTokenPool(ReqToTokenPool): """A memory pool that maps a request to its token locations.""" mamba_pool_cls = MambaPool
def __init__(self, *, size, mamba_size, mamba_spec_state_size, max_context_len, device, cache_params, mamba_layer_ids, enable_mamba_extra_buffer, enable_overlap_schedule=True, ...): super().__init__(size=size, max_context_len=max_context_len, device=device, ...)
self.mamba_ping_pong_track_buffer_size = get_mamba_tracking_slots(extra_buffer=True, overlap=enable_overlap_schedule) self.mamba_initial_tracking_slots = get_mamba_tracking_slots( extra_buffer=enable_mamba_extra_buffer, overlap=enable_overlap_schedule, lazy=enable_mamba_extra_buffer_lazy)注意 mamba_size 是一个独立于 size 的槽位数,而不是等于请求数。为什么?因为 tracking slots:
def get_mamba_tracking_slots(*, extra_buffer: bool, overlap: bool, lazy: bool = False) -> int: """Tracking slots allocated initially; lazy mode defers the second slot.""" if not extra_buffer: return 0 if lazy: return 1 return 2 if overlap else 1在 overlap 调度下,CPU 侧在为第 步做调度时,GPU 还在跑第 步。第 步的循环状态还在被读,第 步又要写新的状态——同一个请求需要两份状态空间,形成 ping-pong。 这就是 2 if overlap else 1 的来历:非重叠时一份就够,重叠时要双缓冲。lazy 模式则先只给一份,等真正需要时再补第二份,省掉启动时的显存开销。
MambaPool 里还有一层更细的账:状态不是一块张量,而是「每个 mamba 层若干块张量」:
@dataclass(frozen=True, kw_only=True) class State: conv: List[torch.Tensor] temporal: torch.Tensorconv 是卷积状态(滑窗历史),temporal 是递归状态(SSM 的 )。conv 是 List,因为不同层的卷积核宽度不同,每层一块。register_slot_state 则允许额外状态挂到同一个槽上,保证「槽换主人时,附属状态一起走」:
def register_slot_state(self, state) -> None: """Attach a state that rides along on clear / copy / host round-trip, so a slot never changes owner with a stale sibling row attached.""" self._slot_siblings = [*self._slot_siblings, state]为什么要专门解决这件事? 因为循环状态是「跨请求残留」的:如果槽换主人时旧的 conv/temporal 还挂着,新请求会读到别人的历史,输出完全错误,而且这种错误极难排查(看起来像模型质量问题)。所以正确性做法是把「槽的生命周期」和「所有附属状态的生命周期」绑成一个原子操作。
在 HybridReqToTokenPool 里,所有需要按槽记账的状态都被显式登记:
self.mamba_pool = self.mamba_pool_cls(size=mamba_size, spec_state_size=mamba_spec_state_size, ...) self.mamba_allocator = MambaSlotAllocator(size=mamba_size, device=device) self.mamba_map = {layer_id: i for i, layer_id in enumerate(mamba_layer_ids)}mamba_map 是层号到「第几个 mamba 层」的映射——模型里 mamba 层是稀疏分布的(比如 3-4 层里 1 层),池子里只给这些层开槽,所以需要一个稠密化映射。这和 start_layer 的处理是同一类问题:全局编号与局部存储编号之间的换算。
除 Mamba 外,SGLang 还把两类新状态池挂在这里:
from sglang.srt.mem_cache.ple_state_pool import NGramPool, ShortConvPool self.short_conv_pool = ShortConvPool(...) self.ngram_pool = NGramPool(size=mamba_size, spec_state_size=mamba_spec_state_size, context_len=ngram_context_len, eos_token_id=ngram_eos_token_id, ...)ShortConvPool 管短卷积层(Gemma 系),NGramPool 管 n-gram 草稿池(无草稿模型的投机解码)。两者都是每请求一份固定状态,所以都按 mamba_size 起槽,也都能在 speculative 场景下额外开 spec_state_size 个草稿槽。
这一节的要点是:内存池的分层不是「一层比一层细」,而是「按状态的访问模式分层」。 全注意力 KV 是 per-token、可随机访问,所以用页分配;滑窗 KV 是 per-token 但只需窗口,所以用 per-request ring;线性注意力状态是 per-request、每步全量覆盖,所以用 per-request 槽位;草稿状态是 per-request-speculation,所以独立开池。四类状态四种记账法,硬塞进一套就会出现「某类状态把其它类的容量吃光」的问题。
谁在往页里写:分配结果如何变成一次真正的写入
前三节讲的都是「账怎么记」。但账记下来之后还有一个必须回答的问题:out_cache_loc(分配器返回的物理槽位)是怎么从调度器一路传到注意力层的写入 kernel 的? 这一层是分配结果的实际消费者。
SGLang 用一个值对象把「写入地址」和它的语义标记打包在一起:
class KVWriteLoc: """Write target(s) for ``KVCache.set_kv_buffer``.
All location info lives here (in the attention metadata), NOT in the pool: - ``loc``: the generic per-token write location (``out_cache_loc``). PHYSICAL on every pool: by allocation on non-unified pools, the iteration's plan's write ids on the unified pool (``KVLocPlan.bind``). - ``swa_loc``: the SWA-sub-pool location for hybrid SWA pools (``None`` otherwise): the same plan's write ids in the sliding-window sub-pool. - ``full_loc``: OPTIONAL full-attention-sub-pool location, in the same id space as ``loc``; pools fall back to ``loc`` when it is ``None``. """
loc: torch.Tensor swa_loc: Optional[torch.Tensor] = None full_loc: Optional[torch.Tensor] = None physical: bool = False三个字段对应三种池子的拓扑:
loc:通用的 token 写入位置,所有池子都有。swa_loc:混合 SWA 池的滑窗子池位置。上一节讲过 SWA 分配器维护两张表,swa_loc就是同一批 token 在滑窗池里的那一份地址。full_loc:可选的全注意力子池位置;为None时池子回退到loc。
关键在于注释的那句 “All location info lives here (in the attention metadata), NOT in the pool”:位置信息放在注意力元数据里,而不是池子对象里。这样同一个 set_kv_buffer 调用对任何池子都成立,注意力后端不需要知道自己面对的是哪种池子。
physical 这个布尔量是本篇最能体现分层思想的一处:
@classmethod def for_batch(cls, forward_batch, *, swa_loc=None, full_loc=None) -> KVWriteLoc: """The batch's ``out_cache_loc`` as a write loc, carrying the batch's physical mark. A ``swa_loc`` or ``full_loc`` passed here travels under the same mark, so it must come from the same plan; a loc produced separately states its own mark with ``KVWriteLoc(loc, physical=...).""" return cls(forward_batch.out_cache_loc, swa_loc, full_loc, physical=forward_batch.out_cache_loc_is_physical)池子侧会检查它:
requires_physical_write_loc = False
def _check_physical_write_loc(self, loc_info, where: str) -> None: # A flag read, no device sync: cheap enough to run on every write-door # call. Fused writers that scatter through `get_kv_buffer`, and a # replayed cuda graph, do not pass through here. if self.requires_physical_write_loc and not write_loc_is_physical(loc_info): raise ValueError( f"{where}: write loc is not marked physical. Hand the pool " "KVWriteLoc.for_batch(forward_batch) for a batch bound to a " "plan (KVLocPlan.bind), or KVWriteLoc(loc, physical=True) for " "ids translated separately.")为什么要专门标记「这个 loc 是不是物理地址」? 因为存在两种不同的 loc:一种来自分配器(已经落在物理槽位空间),另一种可能仍是逻辑/虚拟 id,需要池子再做一次映射。统一池(unified pool)在某些路径下会自己做 id 翻译,所以它拒绝收到未经标记的 loc——如果调用方给错了,宁可立刻报错,也不要写出到错误的页。
”# A flag read, no device sync: cheap enough to run on every write-door call” 这句注释也值得留意:这个检查是一次纯主机侧的布尔读,不进 GPU、不同步、开销可忽略,所以可以放在每次写入前做。但融合写入器和 CUDA Graph 重放不经过这个门——前者通过 get_kv_buffer 自己 scatter,后者是把整个图录下来重放。这就是「安全检查的覆盖面」与「性能路径」之间的取舍:门可以留,但它保护不到所有路径,所以正确性最终还要靠分配器和调度器之间的约定。
__post_init__ 里还有一段处理形状对齐的细节:
def __post_init__(self): # swa_loc / full_loc are resolved once at metadata-init from the full # (padded) out_cache_loc; piecewise/DP-padded paths later narrow loc per # layer, so slice these pre-resolved locs to match (same per-token order). if self.swa_loc is not None and self.swa_loc.shape[0] != self.loc.shape[0]: self.swa_loc = self.swa_loc[: self.loc.shape[0]]swa_loc / full_loc 是在元数据初始化时基于带 padding 的 out_cache_loc 一次性解析的;后面的分段编译或 DP padding 路径会把 loc 逐层收窄,于是两个预解析的子池 loc 也要跟着切片。因为三者的 per-token 顺序一致,切片就能对齐——这是「一次解析、多次收窄」的代价:解析得早,就得在收窄时同步调整。
把这一节和上一节连起来看:分配器产出 out_cache_loc(物理槽位序列)→ 元数据里把它连同子池的对应地址打包成 KVWriteLoc → 注意力层用这个 loc 调 set_kv_buffer 写入。分配的正确性只有在写入落地后才真正成立,而 physical 标记就是这条链路上最后一道廉价的一致性检查。
池子之外:宿主机侧还有一层账
设备侧的池子并不是终点。当上下文长到一台机器的显存装不下,或者想跨请求复用更远的 KV 时,SGLang 会把 KV 缓存分层扩展到宿主机内存甚至存储上——这套机制叫 HiCache,本篇不展开其调度细节,但有两点与「池」直接相关,值得先建立位置感。
第一,设备池的形状决定了宿主机池的形状。KVCache.host_pool_decls 的注释把这条契约写得很明白:
def host_pool_decls(self): """Host pools HiCache keeps for the buffers this device pool (and its sub-pools) owns: the KV pool itself, plus dependent pools such as sparse index keys in subclasses. Not a description of the whole model: buffers owned elsewhere (e.g. Mamba state in req_to_token_pool) are declared by their owner or assembled by the existing strategy paths.""" from sglang.srt.mem_cache.pool_host.host_pool_decl import make_kv_pool_decl return (make_kv_pool_decl(self),)也就是说「谁拥有 buffer,谁负责声明它的宿主侧副本」。Mamba 状态住在 req_to_token_pool 里,就由请求槽位池去声明,而不是由 KV 池代劳。这是所有权原则在内存层次上的延伸:跨层搬运的前提是每一层都清楚哪些字节属于自己。
第二,层的维度在宿主侧依然有意义。设备池是「每层一个张量」,宿主侧也保持了层粒度,这样才能做逐层传输与逐层等待;host_capacity_tokens 之类的字段说明宿主池的容量单位同样是 token 数,与设备池用同一套口径,避免两边预算对不上。
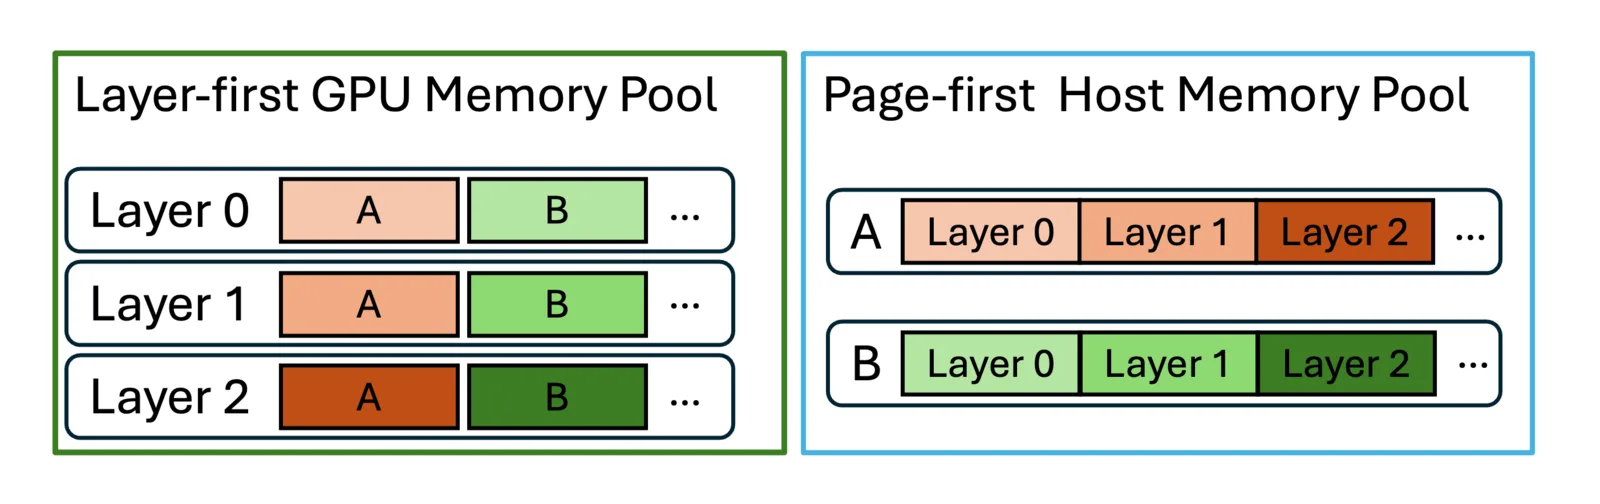
图片来源:SGLang HiCache 设计文档 中的内存层次布局图
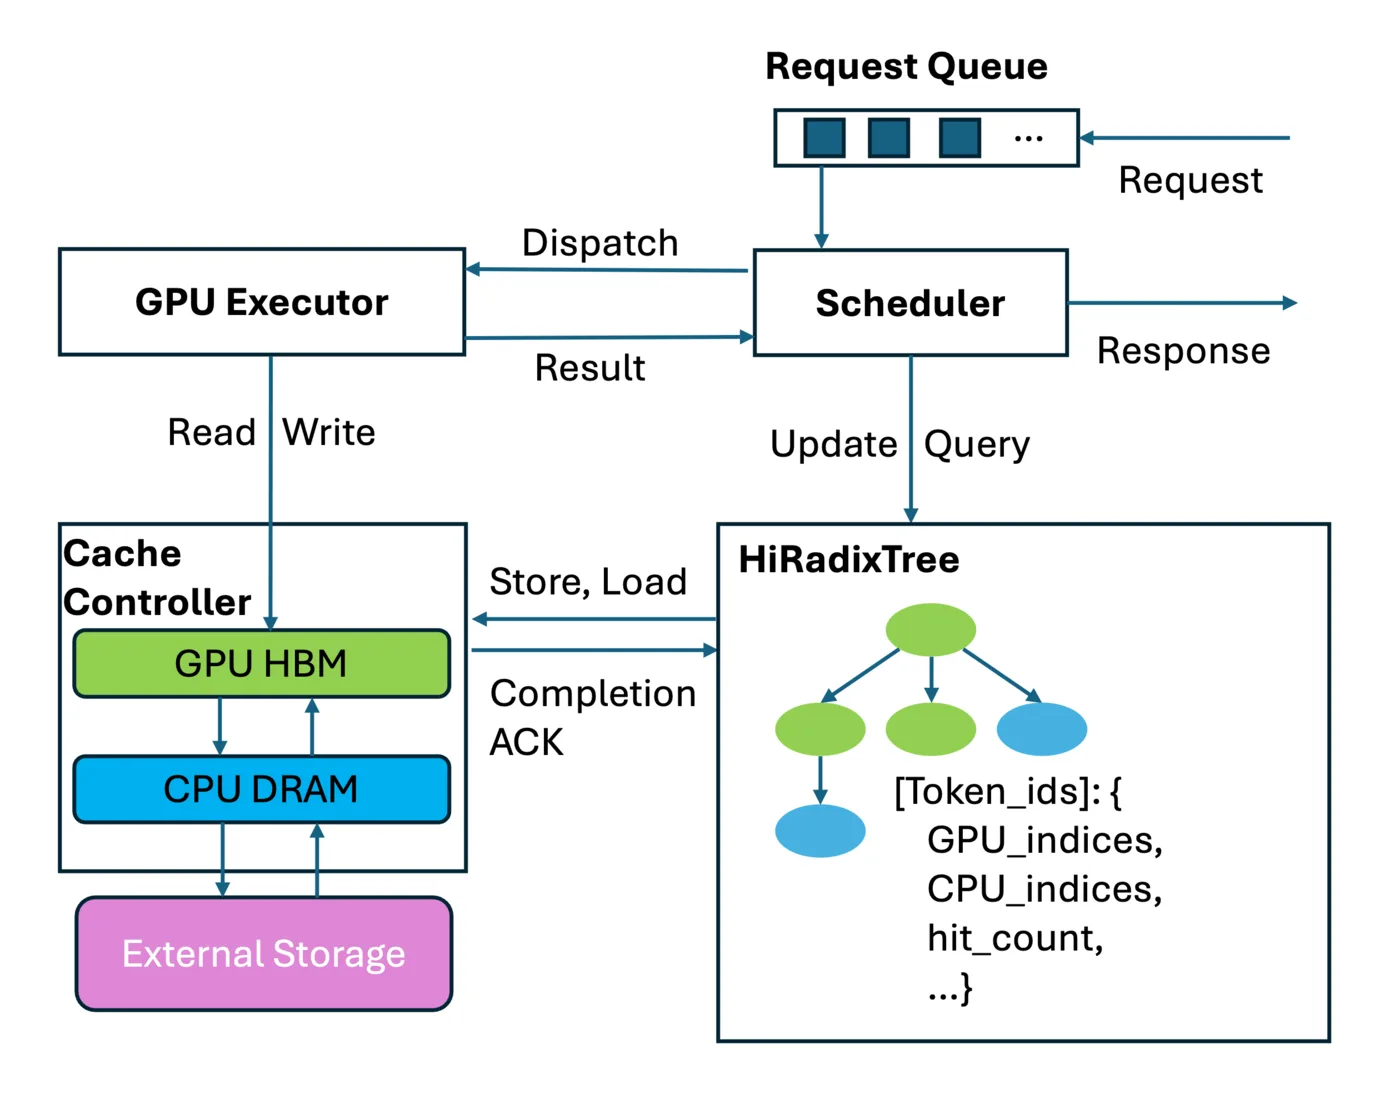
图片来源:SGLang HiCache 设计文档 中的整体架构图
把这两张图和前面的分配器放在一起看会发现:分配器的「空闲页」概念只适用于设备层,而 HiCache 管的是「哪些页在设备层、哪些只在主机层」。 一次前缀命中如果落在主机层,流程是先申请设备页、再从主机侧拷回来——所以分配器的分配动作和 HiCache 的搬运动作必须能对接上,这也是 translate_kv_indices_for_transfer 这类接口存在的意义。
调度器在决定「先跑谁」时,也要把「谁的 KV 更容易命中」算进去。SGLang 官方博客给出的缓存感知调度示意,把「高命中前缀的请求优先放行」这条策略画得很直观:
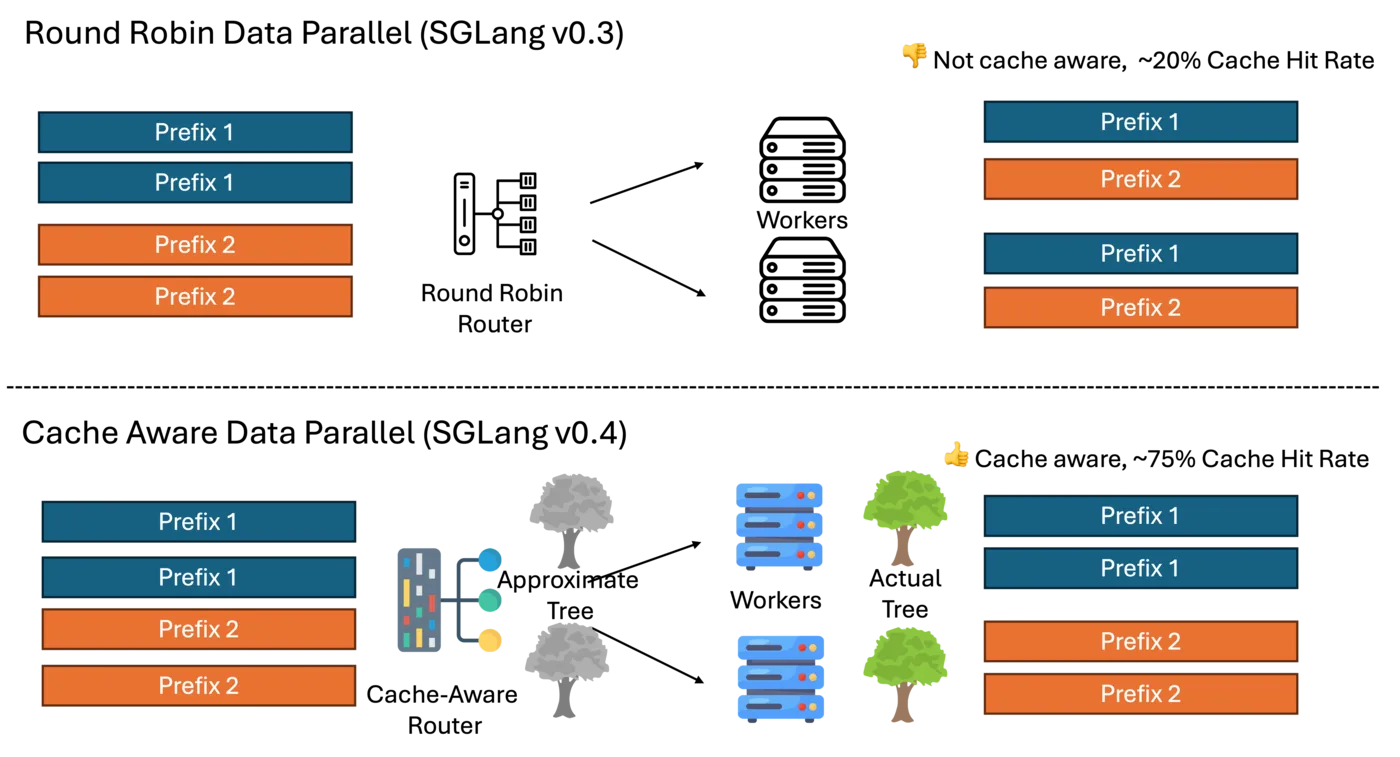
图片来源:SGLang v0.4: Cache-Aware Load Balancing and Faster Structured Output 中的缓存感知调度示意
这三张图放在一起说明了一件事:分配器并不孤立。 它上面接着调度器(谁先跑、跑多少),下面接着 HiCache(页在设备与主机之间怎么搬),它的「空闲页」既是调度器的准入判据,也是 HiCache 搬运的目标位置。理解分配器,也就理解了 SGLang 内存管理的中央枢纽。
规格是怎么定的:从显存预算到池尺寸
前面讲了池子怎么工作,但没回答一个更前置的问题: 是谁定的? 答案在 kv_cache_configurator 和 allocation_sizing 里。
先看最直观的一段——每步允许分配的 KV 长度:
def get_alloc_len_per_decode() -> int: """KV length one request may allocate in a single decode step.""" spec = get_spec() if spec.speculative_algorithm is None: return 1 spec_steps = spec.speculative_num_steps or 1 spec_topk = spec.speculative_eagle_topk or 1 spec_tokens = max_speculative_num_draft_tokens() page_size = get_alloc_page_size()
spec_algo = SpeculativeAlgorithm.from_string(spec.speculative_algorithm) if spec_algo.is_uno(): if spec_tokens is None: raise RuntimeError("UNO requires speculative_num_draft_tokens") # UNO retains an additional clean-root position beside Q/F draft slots. return spec_tokens + 1 if page_size == 1 or spec_topk == 1 or not spec_algo.has_draft_kv(): return max(spec_steps * spec_topk, spec_tokens) else: # spec v2 tree (page>1, topk>1): worst-case page-aligned footprint per # topk branch is ceil((page_size-1 + num_steps) / page) pages, each branch # duplicated -- reserve for all topk branches. num_new_pages_per_topk = ((page_size - 1) + spec_steps + page_size - 1) // page_size return max(num_new_pages_per_topk * page_size * spec_topk, spec_tokens)普通解码每步只多 1 个 token,所以返回 1。但一旦开了投机解码,一步要为整棵草稿树分配 KV——草稿树有 spec_topk 个分支、每个分支 spec_steps 深,还要按页对齐(对齐会额外浪费最多 page_size - 1 个槽位)。所以预留量是 ceil((page_size-1 + num_steps)/page) × page × topk。
这是一个很典型的「分配器的容量预算必须跟着解码策略变」的例子:投机解码不只是多算几个 token,它改变了「一步要多少 KV 页」这个数量级,而所有上游容量计算(可跑步数、可容纳请求数、能否接纳新请求)都建立在这个数上。
再看双缓冲预留:
def get_alloc_reserve_per_decode() -> int: """KV length reserved per request at each decode step. The 2x is a double-buffer that absorbs the kv_committed_len lag in overlap mode; see eagle_utils.eagle_prepare_for_decode.""" return 2 * get_alloc_len_per_decode()2x 的理由和 Mamba 的 2 if overlap else 1 完全同源:overlap 模式下,调度器记的 kv_committed_len 落后于 GPU 实际状态,所以必须按两倍预留,否则会出现「调度器以为还有空间、实际已经踩到边界」的竞态。
请求槽位池的行宽也要跟着改:
def get_req_to_token_extra_context_len() -> int: """req_to_token row headroom beyond the model context length. Sized to hold the decode over-allocation; the spec v2 page>1 topk>1 holey draft footprint can outgrow the default num_draft_tokens headroom.""" # FIXME(lsyin): temporary fix for the context length issue under spec decoding extra = 4 + (max_speculative_num_draft_tokens() or 0) page_size = get_alloc_page_size() spec_algorithm = get_spec().speculative_algorithm if spec_algorithm is not None: from sglang.srt.speculative.spec_info import SpeculativeAlgorithm spec_algo = SpeculativeAlgorithm.from_string(spec_algorithm) if page_size > 1 or spec_algo.is_uno(): # UNO's double-buffer reserve applies at every page size. Larger # pages may additionally round the allocation up by page_size - 1. extra = max(extra, get_alloc_reserve_per_decode() + page_size - 1) return extra回顾一下第一重的 req_to_token 形状 (size + 1, max_context_len):max_context_len 不是模型的最大上下文长度,而是它加上这段 extra headroom。原因就是上面说的——投机解码会在上下文之外留下「洞状的草稿痕迹」(holey draft footprint),普通上下文长度的行宽装不下。注释里的 FIXME 说明这是个临时补丁,但它在告诉我们:行宽、池容量、页数这三处预算必须由同一组配置推导,否则会出现「行宽够但池子不够」或反之的不一致。
get_alloc_page_size 里还有一处分布式细节:
def get_alloc_page_size() -> int: # Mirrors _build_token_to_kv_pool_allocator's DCP branch; the platform # allocators that skip it page smaller, so this is an upper bound for them. return get_schedule().page_size * get_parallel().attn_dcp_sizeattn_dcp_size 是解码上下文并行的切分数——DCP 把上下文切成几段、每段落在不同 rank 上,于是每个 rank 上的页粒度要乘以切分数。分配粒度和并行策略耦合,这是分布式推理里很常见的一类隐式约束。
小结
这一篇把 SGLang 推理运行时的物理账本从最上层走到了最底层,核心是三重映射与「按访问模式分层」这两条线索。
-
三重映射。请求槽位层把请求映射到行号(
ReqToTokenPool,带 padding 行、尾部弹出与单调的req_generation);KV 存储层把物理槽位映射到字节偏移(KVCache子类,store_dtype与dtype分离、start_layer局部化、per-layer 张量);页分配层把逻辑 token 位置映射到物理槽位(PagedTokenToKVPoolAllocator)。alloc_extend_kernel是这套映射最凝练的实现:两个 program 内前缀和求输出位置与页下标,三段式填充处理「半满页 → 整页 → 新半满页」,全程不做 CPU-GPU 同步。 -
分配与释放的对称性。分配走「乐观上界快路径 + 缺页时精确慢路径」,释放走「页号去重 + 延迟排序合并」。
free_segment用「页对齐 + 每页连续」的结构前提换掉一次torch.unique,free_group把一批释放攒成一次拼接,need_sort把排序推迟到真正缺页的时刻——全都在用结构信息换运行期的排序与同步开销。 -
按访问模式分层。全注意力 KV 是 per-token 可随机访问 → 页分配;滑窗 KV 只需窗口 → per-request ring(容量按请求数而非 token 数记账);线性注意力状态是 per-request 每步全量覆盖 → per-request 槽位池;草稿状态 → 独立池。四类状态四本账,混用就会互相挤占容量。
-
预算推导的一致性。、
page_size、req_to_token行宽、每步可分配长度都由同一组配置推导:get_alloc_len_per_decode决定一步要多少 KV、get_alloc_reserve_per_decode给 overlap 场景加一倍双缓冲、get_req_to_token_extra_context_len给行宽加 headroom、get_alloc_page_size把 DCP 切分乘进页粒度。任何一处算错都会表现为「边界附近偶发错误」这类最难排查的问题。
回到开头那句话:调度器、RadixCache、注意力后端之所以能各自独立地讨论「跑哪些 token」「复用哪些前缀」「怎么读页」,正是因为底下有这样一套把逻辑位置翻译成物理字节的账本。把这一层打开之后,前面十四篇里那些被当作黑盒的「KV 槽位」「超额分配」「页」才真正有了落点。
下一篇沿 mem_cache 目录继续,进入 RadixCache 与 HiRadixCache 的对照:前缀树节点如何在「设备页」与「宿主机页」两套账本之间迁移、命中判定如何同时考虑两级、以及驱逐策略在跨层场景下如何重新定义「最近最少使用」。
参考资料
- Efficient Memory Management for Large Language Model Serving with PagedAttention(SOSP 2023,PagedAttention 原始论文)
- SGLang: Efficient Execution of Structured Language Model Programs
- SGLang GitHub 仓库
- SGLang
mem_cache/memory_pool.py - SGLang
mem_cache/allocator/base.py - SGLang
mem_cache/allocator/paged.py - SGLang
mem_cache/allocator/swa.py - SGLang
kernels/ops/memory/allocator.py - SGLang
mem_cache/allocation_sizing.py - SGLang HiCache 设计文档
- vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention
- SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
- SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch
- PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率
- vAttention 完全拆解:用 CUDA 虚拟内存保住连续 KV Cache
- MLA 完全拆解:DeepSeek 低秩 KV 压缩注意力的原理与全部实现细节
- KV Cache Offloading 完全拆解:把显存装不下的历史塞进 CPU、SSD 与远端内存
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



