


SGLang 源码完全拆解(十六):HiCache——三级 KV 缓存、分层前缀树与异步搬运
这一篇要回答的问题
前十五篇里,KV Cache 一直住在一个地方:GPU 显存。调度器算的是显存里的空闲页,RadixCache 管的是显存里的前缀树,分配器发的是显存里的物理槽位。但显存是有限的——一台 8 卡的 H200 服务器,掏出 100 GB 给 KV Cache 已经算慷慨,按 128 KB/token 的口径(70B 级模型、FP16),这只够存八十万 token 左右;换成 MLA 架构的模型能存更多,可依然撑不住「成千上万个会话、每个会话几万 token 前缀」这种实际负载。
现实负载的特点是:前缀的重叠程度极高。系统提示词、少样本示例、代码库上下文、多轮对话的历史——这些东西在每个请求里都重复出现,而一次缓存命中和一次全量重算(prefill)之间的代价差距,在长上下文场景下可以到两个数量级。把这种复用的边界卡在显存容量上,等于把最有价值的那部分缓存扔掉了。
HiCache(Hierarchical Cache)就是 SGLang 对这个问题的回答:把 KV Cache 从「一层」扩成「三层」,让显存只用来装正在被读写的热数据,而把冷下来的历史放到主机内存甚至远端存储上,等需要时再搬回来。它的三个层次分别是:
- L1:设备显存——正在跑的请求的 KV 必须在这里,注意力 kernel 只能读显存;
- L2:主机内存——宿主机 DRAM 里的 KV 副本,容量比显存大一个数量级,通过 PCIe/NVLink 与设备互传;
- L3:存储后端——文件系统、Mooncake、3FS、NIXL、LMCache 等外部 KV 存储,容量不受单机限制,代价是更高的延迟。
这一篇要拆的就是这三层之间谁在何时把哪些页搬到哪里:分层前缀树怎么在设备树之外再长出一棵主机树;命中判定怎么区分「设备命中」与「主机命中」;预取(prefetch)和写回(writeback)两条异步流水线怎么和调度器、分配器对接;以及 L3 的 key 怎么设计才能让不同张量并行度、不同流水线划分的部署共享同一份 KV 字节。
前置的概念在站内已有详细铺垫:KV 分页与块表见 PagedAttention 完全拆解,前缀树的设备侧实现见 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环,页分配器与池尺寸的推导见 SGLang 源码完全拆解(十五):内存池与显存管理;把 KV 卸载到 CPU/SSD/远端的通用机制(不限于 SGLang)见 KV Cache Offloading 完全拆解。
为什么单层显存 KV 缓存不够用
先把「不够用」这件事算成具体的数字,否则后面所有的机制都像在凭空造楼。
一个请求在解码过程中,每一层注意力都要读它自己历史所有 token 的 K 和 V。以 Llama-3-70B 为例:80 层,8 个 KV 头(GQA),头维度 128,FP16。每个 token 每层要存的 KV 字节数是 字节,也就是 4 KB;80 层加起来是 320 KB/token。上下文 32K 时,单个请求就要占约 10 GB——几乎是一整张 A100 的容量。就算把 GQA 头数压到 8、把上下文压到 8K,单个请求也是 2.5 GB 量级。
真实的在线服务里,问题不是「一个长请求装不下」,而是并发的请求数乘以每个请求的上下文长度。一台 8 卡 H200 服务器,扣掉权重、激活、通信 buffer,能留给 KV 的显存可能只有 400 GB 左右。按上面的口径,这只够同时容纳约 1200 个 32K 上下文的请求——如果每个会话平均开 16K 上下文、平均并发 500,看似够;但只要业务是「长文档问答 + 多轮客服 + Agent 长轨迹」,每个会话动辄 64K 以上,容量就立刻见底。更棘手的是负载是长尾的:少数超长会话吃掉大部分显存,剩下的短请求反而被挤到无显存可用,调度器只能拒绝或排队。
显存不够时的第一个思路是「压」——量化 KV、驱逐不重要的 token、压缩层间冗余。站内已经系统讲过这些:KV 量化的 KIVI、KVQuant,驱逐的 H2O、SnapKV,压缩的 MLA、YOCO(见 KIVI 完全拆解、H2O 完全拆解、SnapKV 完全拆解、MLA 完全拆解)。这些方法都在回答「每一份 KV 该占多少字节」。
但还有第二个维度:每一份 KV 该放在哪一级存储上。上下文里的大部分 token 是「冷」的——系统提示词、已读完的文档段落、很久之前的对话轮次,它们在后续解码中很少再被显著关注;真正每步都要读的只有最近的滑窗和少数「重击者」。把冷 KV 留在一台机器最贵、最稀缺的显存里,等于用黄金地段存旧报纸。
这就是分层缓存(Hierarchical Cache,简称 HiCache)的出发点:让 KV Cache 按热度在显存、主机内存、外部存储三层之间流动,而不是全部挤在显存里。 这套思路在 SGLang 里从 2025 年初的 v0.4 开始落地(LMSYS 博客 SGLang v0.4: Cache-Aware Load Balancing and Faster Structured Output 首次公开了 HiCache 的整体设计),随后在 vLLM 的 CPU offload、LMCache 的独立 KV 层、Mooncake 的 KVCache 中心里都能看到同源的形态(LMCache 的系统设计见 LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference)。SGLang 的实现之所以值得逐行读,是因为它把「分层」这件事和已有的前缀树、分页分配器、调度器缝在了一起,而不是外挂一个独立的 KV 存储服务。
三层各自的角色与边界
HiCache 的三层可以用一张图概括。下面这张图来自 LMSYS 的 HiCache 设计文档,画的是三个内存层次之间的布局关系:
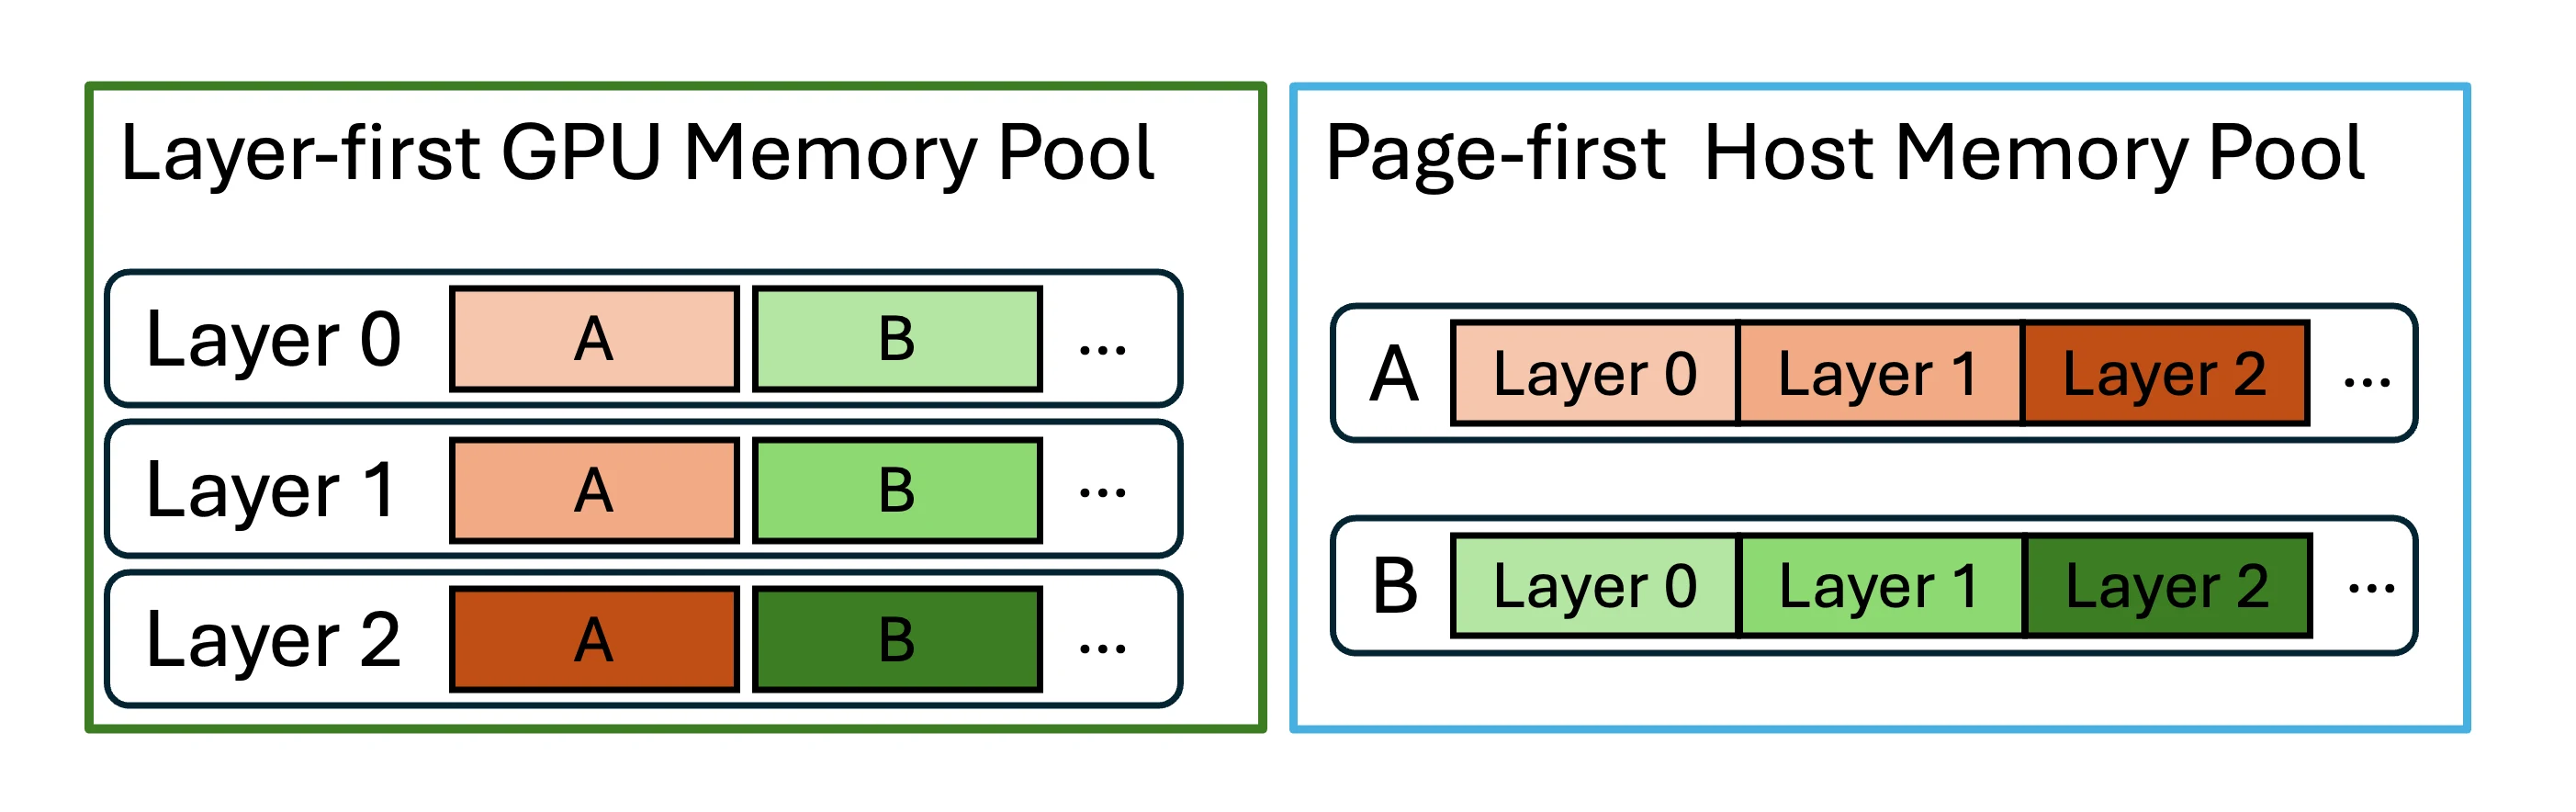
图片来源:SGLang HiCache 设计文档 中的内存层次布局图
而下面这张整体架构图把「谁和谁说话」画得更细——注意图中区分了两条不同的路径:请求在前缀树里被匹配(决定命中多长),以及 KV 字节在两套内存池之间被搬运(决定命中何时能用):
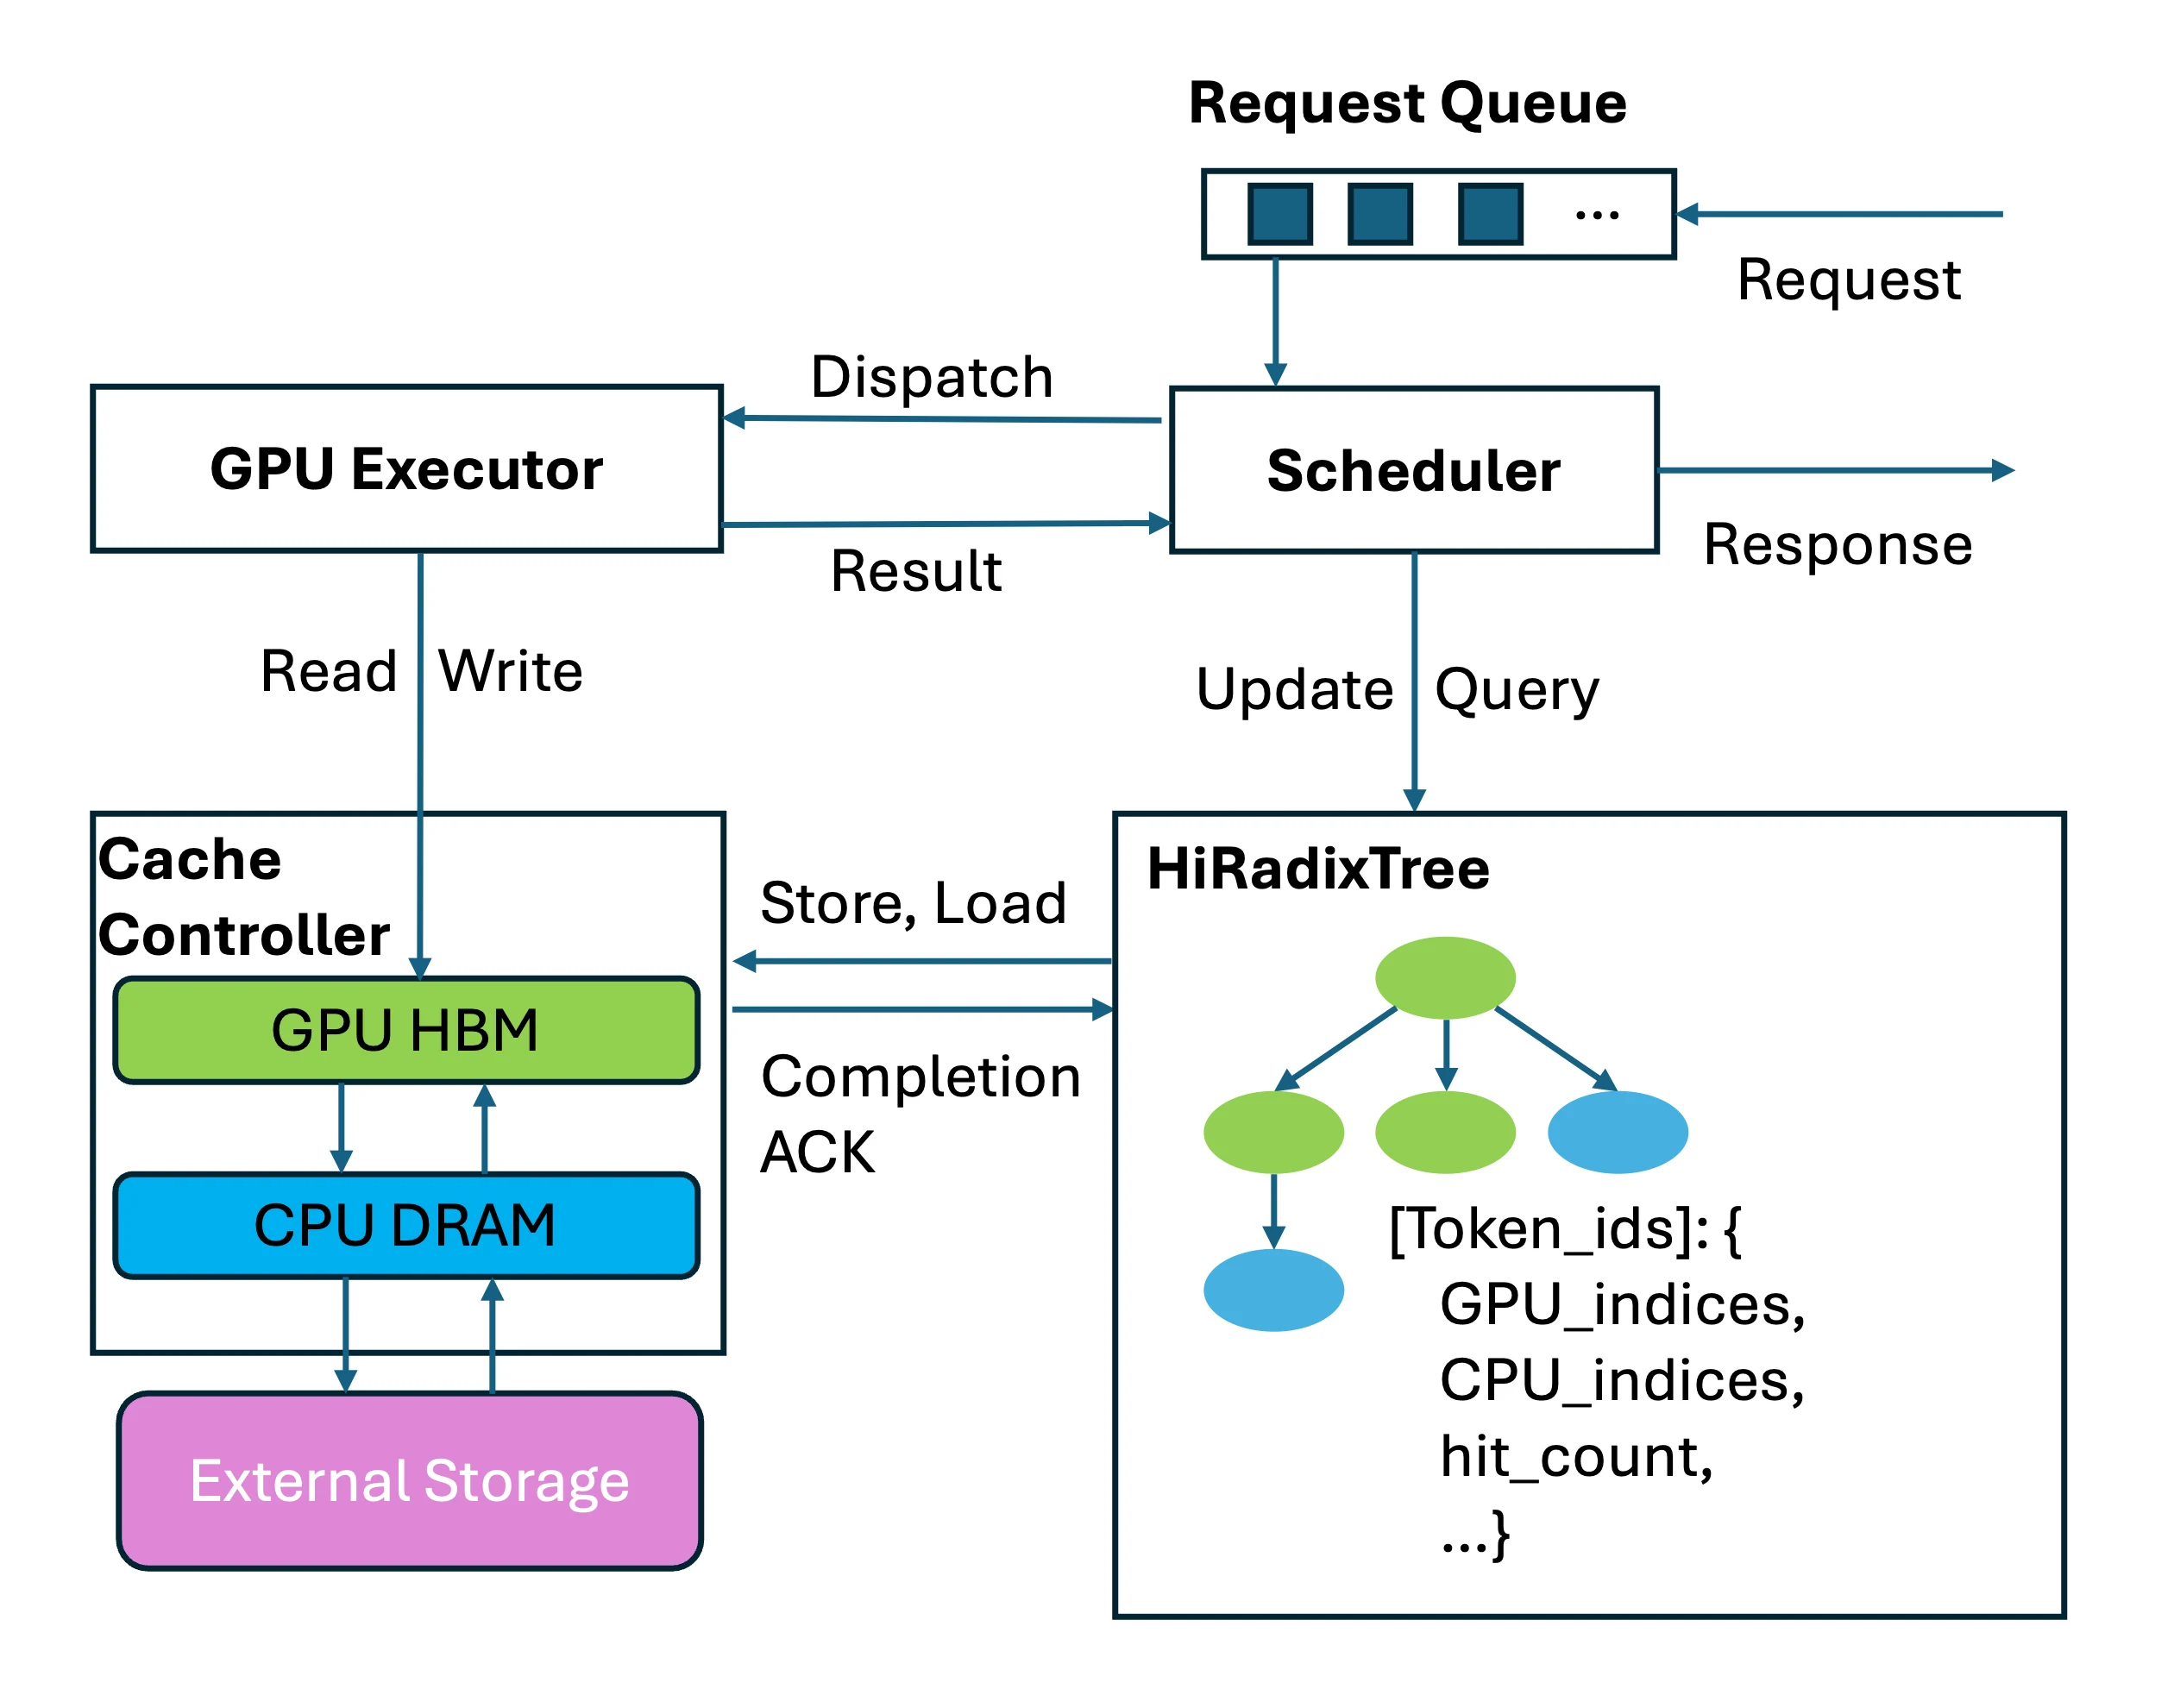
图片来源:SGLang HiCache 设计文档 中的整体架构图
图中每一层解决的是同一件事——「存 KV 字节」——但容量、带宽、延迟、成本四组数字完全不同,理解这张表,就理解了后续所有机制为什么要做成那样:
| 层次 | 介质 | 典型容量 | 读带宽(量级) | 延迟(量级) | 谁来管 |
|---|---|---|---|---|---|
| L1 | GPU 显存(HBM) | 40 - 400 GB | 5 - 8 TB/s | 百纳秒 | 设备 KVPool + 分配器 |
| L2 | 主机 DRAM | 1 - 4 TB | 50 - 500 GB/s(PCIe/NVLink-C2C) | 微秒级 | HostKVCache 主机池 |
| L3 | 存储后端 | 无上限(可扩) | 1 - 50 GB/s | 十微秒到毫秒 | HiCacheStorage 抽象 |
从 L1 到 L2,容量涨了约 10 倍,带宽掉了约 10 - 100 倍;从 L2 到 L3,容量不再受单机限制,但延迟又涨一到两个数量级。这条曲线决定了 HiCache 的核心约束:注意力 kernel 只能读 L1,所以任何一次命中都最终要把 KV 搬回显存;而搬运的成本必须由「省下的 prefill 计算」来偿还。
省下多少?一次 prefill 对长度为 的 prompt,注意力部分的计算量约为 ,而搬运 个 token 的 KV 只是 的纯拷贝。以 32K 的 prompt 为例,重算需要跑满整个前向的矩阵乘,而搬回来只需要拷贝约 10 GB(70B、32K)——在 PCIe 5.0 x16 的约 60 GB/s 下不到 0.2 秒,而重算 32K 的 prefill 在单卡上通常要数秒。当命中长度足够长时,搬运一定比重算便宜,这就是分层缓存能成立的经济学基础。反过来,如果只命中几百个 token,搬运的固定开销(分配页、发起传输、等待完成)可能比重算还慢——这解释了后面会看到的 prefetch_threshold 这类阈值参数为什么存在。
三层之间还有一个容易被忽略的边界:L2 和 L3 的「页」未必是同一套布局。L1 因为要喂给注意力 kernel,页面排布必须服从 kernel 的访存模式(见 SGLang 源码完全拆解(七):Attention Backend);L2 由 SGLang 自己决定布局,可以选择对拷贝更友好的排布;L3 由外部存储后端决定,甚至可能是跨进程、跨节点的共享对象。HiCache 的一大半工程量,就是把「同一次命中」在这三套布局之间翻译来翻译去。
分层前缀树:一次命中如何在三层之间被判定
单层 RadixCache 的前缀匹配是一棵树的深度遍历:从根出发,沿着 token 序列往下走,最长能走到哪就是命中的长度(树的构造与匹配见 SGLang 源码完全拆解(五):RadixCache 的所有权闭环)。分层之后,「命中」这个词变得含糊了:一个节点可能在设备上、可能只在主机上、可能还在存储里,也可能已经被驱逐。所以 HiCache 要做的第一件事,是给树上的每个节点标注它此刻在哪一层,并让匹配过程在这些标注上做出区分。
SGLang 的实现里,树节点(UnifiedTreeNode)在 HiCache 模式下多出两个关键状态位——evicted 与 backuped:
# 匹配遍历中的关键判断(unified_tree_core.py 的 _match_prefix_helper)while key_offset < len(key) and child_key in node.children: child = node.children[child_key]
# HiCache: dead node (evicted + not backuped) — stop traversal if child.evicted and not child.backuped: break这两行的语义值得逐字拆开:
evicted表示这个节点的设备侧 KV 已经不在显存里了(被驱逐或从未落到设备上);backuped表示这个节点的主机侧副本存在(它的 KV 字节已经写进 HostKVCache)。
于是 evicted and not backuped 就是「这棵子树上的 KV 哪里都没有」——它是一截死枝,遍历到此为止。而只要 backuped 为真,即使设备侧没有,遍历也应该继续:因为命中可以落在主机层,后面可以通过一次加载把它变回设备命中。
这里有一个很自然的疑问:如果主机侧命中也要继续往下走,那匹配出来的长度还能直接拿去当「可执行的 prefix_len」吗?答案是不能,这正是分层匹配最容易埋 bug 的地方。站内第十五篇在讲 RadixCache 接口时就点明了这个约定:MatchResult 里保留了 last_device_node、last_host_node、best_match_node 三个字段,普通单层实现里三者恒等,而分层的意义就是让它们不再相等——最长逻辑命中可能在主机,而已经位于 GPU 的命中终点往往更短。调度器绝不能假设三者相等。
SGLang 的 _match_prefix_helper 把这个区分做得很干净:当 enable_hicache 打开时,它同时构造两套校验器——一套 validators(只要节点在任意一层有 KV 就算命中),一套 device_validators(match_device_only=True,只有设备侧有 KV 才算命中),然后分别维护两个最佳匹配:
separate_device_match = self.enable_hicacheif separate_device_match: validators = tuple(comp.create_match_validator() for comp in self.components) device_validators = tuple( comp.create_match_validator(match_device_only=True) for comp in self.components )def _update_best_if_valid(node): nonlocal best_match_node nonlocal best_match_device_value_len, best_match_device_node matched = _all_valid(validators, node) if matched: best_match_node = node # 最长「逻辑」命中,可能停在主机层
if not separate_device_match: ... return if _all_valid(device_validators, node): best_match_device_value_len = len(value) best_match_device_node = node # 最长「设备就绪」命中,可直接给调度器用这段代码回答了一个设计问题:为什么调度器需要两个终点,而不是一个。 调度器此刻真正要交付给这次前向的,是「哪些 token 的 KV 已经在显存里、可以立刻被注意力 kernel 读」——这就是 best_match_device_node 和 best_match_device_value_len。而 best_match_node 表示「逻辑上能复用多少」——它可能更长,但多出来的部分要先从主机或存储搬回来,搬运是异步的、有延迟的、还要占用主机池的空闲页。把这两个数字分开,调度器才能在「立刻开跑」和「等一下换更长前缀」之间做权衡;把两者混成一个数字,就会出现「声称命中 10 万个 token,结果其中 9 万个还在远端存储」的灾难。
树上的三种节点状态
把上面两个状态位组合起来,树上的节点其实只有三种处境,理解这三态就理解了整个分层树:
| 状态 | evicted | backuped | 含义 | 匹配行为 |
|---|---|---|---|---|
| 设备驻留 | 否 | 任意 | KV 在显存,可直接被 kernel 读 | 逻辑命中 + 设备命中 |
| 仅主机备份 | 是 | 是 | 显存里没有,主机有副本 | 逻辑命中,但需加载 |
| 死枝 | 是 | 否 | 哪一层都没有(被驱逐且未备份) | 停止遍历 |
第三态「死枝」是最容易被忽略的:树节点不会因为 KV 被驱逐就被立刻删除,因为它的存在本身还有价值——它标记了一段曾经出现过的 token 序列,将来同样的前缀再来时,至少知道该往哪个方向找。但既然 KV 已经无处可取,遍历就必须停下,否则会得到一个永远无法兑现的命中长度。SGLang 在 insert 路径里对这类情况还有一个专门的分支:写入主机时,如果发现要落盘的位置上面挂着一个「未备份」的节点,说明这段前缀在主机和存储里都不存在,prefetch 的回填就会被丢弃而不是接进树里:
# Drop the refill only under write-through (a non-write-back policy).if node is not self.root_node and not node.backuped and not self.is_write_back: logger.info( "HiCache prefetch dropped %d-token refill under un-backed-up node %d", len(host_value), node.id, ) result.host_insert_dropped = True return result这条分支只在 write_through 策略下生效,原因后面讲写回策略时会解释:write_through 的语义是「设备上有什么,主机上就有什么」,如果一段主机回填挂在没有主机副本的节点下面,就破坏了这条不变量。
写回策略:write_through、write_through_selective 与 write_back
「GPU 上的 KV 什么时候往主机搬」看起来是个工程细节,实际是一个语义选择,它决定了三件事:主机池的容量需求、命中时还要不要重新加载、以及树上 backuped 的含义。SGLang 提供了三个策略(源码里的枚举校验):
if write_policy not in ["write_through", "write_through_selective", "write_back"]: raise ValueError(f"Invalid write policy: {write_policy}")write_through(写穿):每次把 KV 落在设备上时,同步也写一份到主机。它的好处是语义最强——任何被算出来的 KV 都不会丢,主机永远是设备的一个超集。代价是主机容量压力最大(等于设备池的镜像),而且每一次算完都要多发一次 D2H 拷贝。上一节那条「不变量」断言正是 write_through 专属的:
else: assert refilled_host_node is None, ( "write-through host-prefix invariant broken: encountered " f"backed node {node.id} below a refilled host tombstone" ) host_prefix_len += prefix_lenwrite_through_selective(选择性写穿):只把被多次命中的叶子写回主机。「写回」的成本只在那些大概率还会被复用的 KV 上花——一个只被访问过一次、之后再没出现的前缀,不值得占主机页。判断依据就是每个节点的 hit_count:RadixCache 在每次匹配到节点时会 _inc_hit_count(node)(见 SGLang 源码完全拆解(五) 里的计数逻辑)。这是默认策略,也是绝大多数部署该用的策略。
write_back(写回):不主动搬,只在主机池有空闲、或者节点即将被驱逐时才回写。它把主机当成一个「只在必要时才动用」的次级存储,主机容量压力最小,但代价是可能丢缓存——如果一次都没来得及回写就被驱逐,这段前缀就永远消失在两层之间了。源码里这条策略走的是和 write_through 不同的路径:它不是「遇到就在设备上算好、立刻回写」,而是把回写推迟到驱逐时机,插入主机时走的是 result.inserted_host_node 那条分支。
三种策略的取舍可以概括成一张表:
| 策略 | 主机池需求 | 丢缓存风险 | 每次前向的额外 D2H | 适用场景 |
|---|---|---|---|---|
write_through | 最高(镜像设备池) | 无 | 每次都有 | 主机内存充裕、极度在意命中率 |
write_through_selective | 中 | 低频前缀会丢 | 仅热前缀 | 通用默认 |
write_back | 最低 | 高(未及时回写即丢) | 仅驱逐时 | 主机内存紧张 |
主机池必须比设备池大:一个容易被忽略的容量约束
上面三种策略都指向同一个配置陷阱。SGLang 官方文档在「Host Pool Sizing」一节里写得非常直白:
Storage (L3) hits are staged in the host pool before being loaded to the GPU, so the host pool needs free room at the time of the hit. With
write_through, every token cached on the GPU also keeps a host copy. Once the GPU pool is full, at mosthost pool tokens − GPU pool tokensis left for storage hits. If the host pool is not larger than the GPU pool, storage hits are dropped and the prompt is recomputed.
翻译成一句话:在写穿策略下,主机池里必须留出一块「设备池的镜像」之外的空闲,专门用来给 L3 命中的页面做中转(bounce buffer)。 因为 L3 命中不能直接写进显存——它是先读进主机池的一个空闲页,再从主机池拷进显存(后面讲 prefetch 时会更清楚)。如果主机池只是设备池的等大镜像,那么当 GPU 池被占满时,主机池也被镜像占满,L3 命中无处可放,只能整体丢弃并重算 prompt。文档甚至给出了对应的监控指标:sglang:storage_prefetch_unfulfilled_tokens_total{reason="host_capacity"} 就是这个情况在持续增长——看到这个指标涨,说明主机池该扩容了。
这条约束解释了默认配置为什么是 --hicache-ratio 2(主机池按设备池的 2 倍配置):一倍镜像、一倍中转。
宿主池:主机侧的那本账
主机侧的布局与设备侧必须保持一致,这是第十五篇里 host_pool_decls 那条契约说的:谁拥有 buffer,谁负责声明它的宿主副本;设备池是「每层一个张量」,宿主池也保持层粒度,才能做逐层传输与逐层等待。宿主池的核心类 HostKVCache(memory_pool_host.py / pool_host/base.py)和设备池共享同一套记账思路,但在实现上有几处专门为主机侧做的优化。
延迟合并空闲表。 设备池的分配器在每次 free 时直接改写空闲表;主机池不一样——主机侧的释放非常频繁(每写完一批就要把已经搬走的页放回空闲表),如果每次都用 torch.cat 拼接大空闲表,光这一项开销就很可观。SGLang 的做法是把释放先攒着,等到真正需要分配、且当前空闲表不够用时再合并:
def free(self, indices: torch.Tensor) -> int: indices_cpu = indices.cpu() if indices_cpu.numel() == 0: return 0 self.release_slots.append(indices_cpu) self.num_release_slots += len(indices_cpu) return len(indices)def _merge_release_slots(self): if self.num_release_slots == 0: return if len(self.free_slots) == 0 and len(self.release_slots) == 1: self.free_slots = self.release_slots[0] else: self.free_slots = torch.cat([self.free_slots, *self.release_slots]) self.release_slots = [] self.num_release_slots = 0注意 _merge_release_slots 里的那个特判:如果空闲表是空的而待释放列表恰好只有一段,就直接把那一整段拿过来当空闲表,连 cat 都省了——这是最常见的稳态(池子被占满 → 一批写回释放 → 立刻又要分配),一个特判就把最热路径上的拷贝消掉了。
双重释放与重复分配的检测。 主机池的访问来自多个线程(调度器线程决定释放、后台传输线程推进搬运),出错时的症状是「两个请求指向同一块主机页」——这类错误在 KV 里表现为静默的数值污染,比崩溃难查得多。所以宿主池额外维护一个 slot_used 位图,在分配和释放时都做断言:
assert not self.slot_used[select_index].any(), ( f"Double-alloc detected: slots already allocated: " f"{select_index[self.slot_used[select_index]].tolist()}.")self.slot_used[select_index] = Trueassert self.slot_used[indices_cpu].all(), ( f"Double-free detected: slots not currently allocated: " f"{indices_cpu[~self.slot_used[indices_cpu]].tolist()}.")这是典型的「用一次断言换掉一整类难复现的线上事故」——代价是一张与池同长的 bool 张量,对于几十 GB 的主机池,这张位图只有几 MB。
宿主内存预算的分配。 主机内存不是无限的,而且要在一个节点上的多个 rank 之间分。host_memory_budget_bytes 的做法是:先查这台机器当前可用的主机内存,减去一个给操作系统和其他进程留出的固定保留量,再除以本机上的 rank 数:
HICACHE_HOST_MEMORY_RESERVE_BYTES: int = 10 * (1024**3)
def host_memory_budget_bytes(requested_bytes: int = 0, *, auto_size: bool = False) -> int: free = ( available_host_memory_bytes(allow_cgroup_fallback=not auto_size) - HICACHE_HOST_MEMORY_RESERVE_BYTES ) return free // ranks_per_host()ranks_per_host() 是从启动的 world size 除以节点数推算出来的,注释里明确说了不能用集合通信去问——因为每个 rank 可能构造数量不同的宿主池,用一次 all-reduce 会让本可以独立的初始化互相卡住。这是一个很实际的经验:初始化阶段的集合通信是最容易死锁的地方,能不算就不算。 保留 10 GB 也是同一个道理——把主机内存吃干净,连 Python 解释器和日志缓冲都可能触发 OOM。
预算还有一个「快照」机制:host_memory_budget_scope 用 ContextVar 把一次预算快照固定下来,作用域内构建的每个池都从同一个数里扣减,而不是各自重新采样 psutil。否则两个池分别看到「可用 100 GB」会各自申请 80 GB,加起来就超了。
异步搬运:预取与写回的两条流水线
分层缓存真正的工程量在「搬运」上。如果每次命中都同步等待 KV 从主机拷到显存,那调度器就被传输延迟拖住了,整个流水线退化成串行。HiCache 的做法是把 L2↔L1 和 L3↔L2 的搬运拆成独立的后台线程 + 队列 + 完成确认,调度器只负责「发请求」和「读结果」。
控制中枢是 HiCacheController,它启动的线程分别是:负责 L3 预取的 prefetch_thread、负责 L3 预取 IO 的 prefetch_io_aux_thread、负责跨 rank 同步预取结果的 prefetch_sync_thread,以及负责 L2→L3 备份的 backup_thread:
def _start_storage_threads(self): assert self.enable_storage assert not self.storage_stop_event.is_set()
self.prefetch_thread = threading.Thread(target=self.prefetch_thread_func, daemon=True) self.prefetch_io_aux_thread = threading.Thread(target=self.prefetch_io_aux_func, daemon=True) self.prefetch_sync_thread = threading.Thread(target=self.prefetch_sync_thread_func, daemon=True) self.backup_thread = threading.Thread(target=self.backup_thread_func, daemon=True) self.prefetch_queue = Queue() self.backup_queue = Queue()四个线程对应四个方向/阶段,这个拆分本身就是设计:L3 的「存在性查询」和「真实读取」被分成两个阶段,因为前者便宜(只是查 key 是否存在)而后者昂贵(要搬字节),分开才能先知道命中多长、再决定值不值得搬。
预取(prefetch):L3 → L2
预取的完整链路是这样的。调度器发现一个请求的前缀可能命中 L3,就调 prefetch() 把「请求 id + 新输入 token + 上一次的哈希」做成一个 PrefetchOperation 丢进队列:
def prefetch(self, request_id, new_input_tokens, last_hash=None, prefix_keys=None) -> PrefetchOperation: operation = PrefetchOperation(request_id, new_input_tokens, last_hash, prefix_keys) self.prefetch_queue.put(operation) return operation后台线程拿到操作后,先做存在性查询(_storage_hit_query):把 token 序列切成页、算出每页的哈希,然后分批(STORAGE_BATCH_SIZE = 128)向后端问「这些 key 存在吗」,一旦某一批出现不存在,就立刻停下——因为前缀缓存要求连续的命中,后面的页即使存在也用不上:
for start in range(0, len(page_hashes), STORAGE_BATCH_SIZE): batch_hashes = page_hashes[start : start + STORAGE_BATCH_SIZE] hit_page_num = self.storage_backend.batch_exists(batch_hashes, extra_info) hash_value.extend(batch_hashes[:hit_page_num]) storage_query_count += hit_page_num * self.page_size if hit_page_num < len(batch_hashes): break为什么是连续的? 因为命中前缀在树上必须是一段从根出发的路径。如果中间缺一页,后面的页即使字节都在存储里,也无法接成一棵可用的树——KV 的复用前提是「这段前缀的注意力计算全部完成」,缺任何一个 token 的 KV 都会让后续 token 的注意力结果错掉。这也解释了为什么 batch_exists 的约定是「返回从起点开始连续存在的个数」,而不是「存在的总数」。
查询结果要在 TP/PP 各 rank 之间取最小值。这一步很关键:一次前缀命中必须在所有 rank 上同时成立,否则不同 rank 会算出不同长度的前缀,模型前向就会读到不一致的 KV:
def _sync_prefetch_hit_query(self, operation, storage_hit_count: int) -> int: """Rank-reduce a hit query (MIN) so every rank agrees on the usable prefix.""" hit_count = torch.tensor(storage_hit_count, dtype=torch.int) self._all_reduce(hit_count, torch.distributed.ReduceOp.MIN, self.prefetch_hits_sync_groups) return int(hit_count.item())注意注释里那句「Runs for every operation, hit or miss」——即使这次查询是零命中,也必须参与这次 all-reduce。原因是集合通信的对称性:如果某个 rank 因为「自己算出来是 0」就跳过 reduce,其他 rank 就会在这个 reduce 上永久阻塞。这类「短路优化」在集合通信里是经典死锁源,源码里专门用注释标出来,说明踩过。
真实读取阶段(_page_transfer)同样是分批的,且有一个很妙的容错设计:即使中途失败,也要继续把剩下批次的 ack 发出去,让每个 rank 产生的 PrefetchAck 数量一致,因为 prefetch_sync_thread 要在这个队列上做 reduce:
# When an error is occurred, we should keep looping and produce the same number of# PrefetchAck as other ranks do, because prefetch_sync_thread (i.e. consumer of# prefetch_sync_queue) perform reduce on the results. This is so tricky.if all_success and operation.is_terminated(): all_success = Falseif all_success: ... hit_pages = self._page_transfer_kv_batch(...)...ack = PrefetchAck(rid=operation.request_id, completed_tokens=completed_pages * self.page_size, operation=operation)self.prefetch_sync_queue.put(ack)源码注释直接写了「This is so tricky」——这类「为了保证通信对称而把失败路径也走一遍」的写法,在多 rank 系统里几乎是必修课。
预取还需要限流。如果放任预取把存储后端打满,正在跑的解码请求会因为 PCIe/网络被抢占而抖动。prefetch_rate_limited 用一个「已占用预取 token 数」的上限来刹车:
def prefetch_rate_limited(self) -> bool: if self.host_memory_mode == "buffer_only": used = self.mem_pool_host.size - self.mem_pool_host.available_size() if self.host_write_staged_tokens_fn is not None: used -= self.host_write_staged_tokens_fn() return max(0, used) >= self.prefetch_capacity_limit if self.prefetch_tokens_occupied >= self.prefetch_capacity_limit: return True return Falsebuffer_only 模式下的那两行减法值得留意:它把「写回暂存(write staging)占用的部分」从已用量里扣掉。注释解释了原因——写暂存是写预算的使用,如果把它算进读预算,那么每一次 L3 命中都会被排在正在排水的写回之后,命中延迟会被写回拖长。这是一个很细的带宽账本划分:读写各自有预算,不能互相顶账。
写回(writeback):L2 → L3
反方向的搬运是备份。write_storage 把「主机页 + token ids + 哈希」做成 StorageOperation 丢进 backup_queue,由 backup_thread 消费:
def write_storage(self, host_indices, token_ids, hash_value=None, prefix_keys=None) -> int: operation = StorageOperation(host_indices, token_ids, hash_value=hash_value, prefix_keys=prefix_keys) self.backup_queue.put(operation) return operation.id备份同样是分批的(_page_backup),但容错策略与预取相反:预取失败要继续走完流程保对称,备份失败则直接 break——写失败后面的页也不用写了,因为存储里也不允许出现「中间有洞」的前缀:
success = self.page_set_func(batch_hashes, batch_host_indices, extra_info)if not success: logger.warning(f"Write page to storage: {len(batch_hashes)} pages failed.") break这里的 page_set_func 可能是零拷贝版本(_page_set_zero_copy),直接把主机页的内存地址交给后端去读,省掉一次主机侧的翻转拷贝(见下一节)。
分层的 L2 传输:设备←→主机的搬运
L2↔L1 这一级的搬运由 L2TransferEngine 执行,它接受一个 L2Transfer 描述(源池、目标池、主机索引、设备索引),走的是专门的拷贝内核。这里有一个非常实际的工程点:主机索引和设备索引在哪一侧、用什么顺序,取决于 I/O 后端与内存布局的组合,需要在传输前统一整理。move_indices 就是做这件事的:
def move_indices(self, host_indices, device_indices): # move indices to GPU if using kernels, to host if using direct indexing if self.io_backend == "kernel": if not host_indices.is_cuda: host_indices = host_indices.to(self.device, non_blocking=True) return host_indices, device_indices elif self.io_backend == "direct": if self.mem_pool_host.layout == "layer_first": device_indices = device_indices.cpu() host_indices, idx = host_indices.sort() return host_indices, device_indices.index_select(0, idx) elif self.mem_pool_host.layout == "page_first_direct": return host_indices, device_indices.cpu() ...layer_first 分支里的那个 sort + index_select 是布局决定的:在层优先布局下,一次传输要按主机地址顺序访问才能获得好的 PCIe 效率,所以要把索引排序、并让设备索引跟着重排。page_first_direct 则不需要,因为它的布局本身就是为直接 I/O 设计的。布局选择不是审美问题,它决定了传输前要不要多一次排序和重排。
传输完成的事件通知
异步搬运最后要解决的问题是:调度器怎么知道「搬完了」。HiCache 的做法是给每次传输生成一对事件(start/finish),并把 finish 事件注册到设备分配器上,让分配器在决定「这一页能不能被复用」时能查到它的搬运状态:
completion = self.l2_transfer_engine.submit_device_to_host( self._l2_transfers(host_indices, device_indices, pool_transfers))self.mem_pool_device_allocator.set_hicache_transfer_done_event( (id(self), "write"), completion.finish_event)第十五篇讲过分配器里「空闲页不等于可用页」的约束,这条注册就是让那个约束成立的信息来源:一个新的请求拿到一张设备页之前,必须确认这张页上有没有一次尚未完成的搬运在写它。
内存布局:为什么主机池要有三种排布
同一个 KV 页在三层里要经历四次落点:设备 kernel 读它、D2H 拷它、主机池存它、存储后端读它。这四件事对「页内字节怎么排」的偏好并不一致,所以 SGLang 让主机池支持三种布局,并用 --hicache-mem-layout 选择:
| 布局 | 页内组织 | 适配的 I/O 后端 | 主要收益 |
|---|---|---|---|
layer_first | 每层一个张量,页内按 token 连续 | direct(必须) | 逐层搬运天然对齐,逐层等待方便 |
page_first | 一页的所有层拼在一起,页内按层排 | kernel | 一页一次 DMA,零拷贝写回 |
page_first_direct | 页优先 + 为直接 I/O 优化的组织 | direct | 兼容 FA3,兼具零拷贝 |
layer_first 是「结构自然」的排布。 设备池本来就是每层一个张量(第十五篇解释过为什么不把层拼成一个大张量:每层地址独立,便于单独挂 CUDA Graph、单独做层粒度传输与等待)。主机池照抄这个结构,好处是搬运时「第 l 层的设备页 → 第 l 层的主机页」是一次一对一的拷贝,逐层流水线也最直观。
page_first 是「IO 友好」的排布。 当存储后端按「页」为单位读写时(L3 的对象通常就是「一页包含全部层的 KV」),层优先布局会让一次页读写变成多次跨层的分散拷贝;而页优先把「同一页的所有层」放在连续内存里,一次 DMA 就能把整页搬走。这就是文档里说的「Optimized for I/O efficiency with zero-copy」。
page_first_direct 是给直接 I/O 后端准备的页优先变体。 文档明确写了两条兼容性约束,这两条是选型时最容易踩的坑:
page_first:Only compatible withkernelI/O backend, automatically switches tolayer_firstwithdirectbackend.page_first_direct:Specifically designed fordirectI/O backend with optimized memory organization.
也就是说:布局不是独立可选项,它和 I/O 后端是绑定的组合。 选了 page_first 却用 direct 后端,框架会静默降级成 layer_first——你会看到配置里写的是 page_first 但实际跑的不是,这种「配置与实际不一致」在排查性能问题时非常浪费时间。所以文档给出的推荐组合是成对出现的:
--hicache-mem-layout page_first_direct \--hicache-io-backend direct \--hicache-write-policy write_through页优先布局还带来一个额外能力:写回存储时可以做零拷贝。 如果主机页在内存里就是「一页连续」,那么把它写进存储后端时,后端可以直接拿这块内存的地址去发 DMA,不需要先在主机侧做一次翻转拷贝。源码里的体现就是两套写函数并存——_generic_page_set(先 get_data_page 取出数据再交给后端)和 _page_set_zero_copy(直接把主机索引给后端):
def _generic_page_set(self, hash_values, host_indices, extra_info=None) -> bool: data = [ self.storage_host_pool.get_data_page(host_indices[i * self.page_size]) for i in range(len(hash_values)) ] return self.storage_backend.batch_set(hash_values, data)
def _page_set_zero_copy(self, hash_values, host_indices, extra_info=None) -> bool: return all(self.storage_backend.batch_set_v1(hash_values, host_indices, extra_info))后者的 batch_set_v1 只收「key + 主机索引」,字节从哪来由后端自己按索引去主机内存里读——这就是零拷贝的接口形态。注意这里出现了 v1/v2 两代接口,这不是历史包袱而是分层抽象的结果:v1 是「按页」的简单接口,v2 引入了 PoolTransfer 描述(后面讲),能表达「一次传输同时涉及多个池」。
L3:存储后端抽象与 key 设计
后端抽象:三个方法起步
HiCache 对 L3 的抽象是一个很薄的接口。文档把「接一个自定义后端」的门槛写得极低——实现三个方法并注册到 BackendFactory 即可:
get(key):Retrieve value by key;exists(key):Check key existence;set(key, value):Store key-value pair.
薄接口的好处是后端可以非常简单。SGLang 自带的文件后端 HiCacheFile 就是最直接的例子:key 加上后缀就是文件名,set 是写文件、get 是读文件、exists 是查文件。源码里几处细节很能说明「薄接口 + 小心实现」的工程风格:
suffixed = self._get_suffixed_key(key)tensor_path = os.path.join(self.file_path, f"{suffixed}.bin")
# Fast path: same key already on disk. Refresh recency and skip rewrite.if self.exists(key): logger.debug(f"Key {key} already exists. Skipped.") self._evictor.touch(suffixed, tensor_path) return True
tmp_path = os.path.join(self.file_path, f".{uuid.uuid4().hex}.tmp")value.contiguous().view(dtype=torch.uint8).numpy().tofile(tmp_path)os.replace(tmp_path, tensor_path)三个要点:
- 已存在就跳过重写,只刷新 LRU。 同一个前缀被反复写回是常态,直接覆盖会白白消耗存储带宽;
exists走的是元数据缓存(MetadataCache,带 TTL)而不是每次都stat。 - 先写临时文件再
os.replace原子改名。 这保证任何时刻存储里出现的都是完整文件——如果直接写目标路径,进程被杀就会留下半截文件,而它会被下一次exists判定为「存在」,导致读出垃圾字节。原子替换是缓存类存储的硬要求,因为「存在」这个判定必须等价于「内容完整」。 - 失败要回滚预留空间。
set在正式写之前先向 evictorreserve(可能触发磁盘淘汰腾空间),写失败要abort回滚,否则空间账本会漏。
MetadataCache 本身也值得看一眼,它解决的问题是「判断 key 是否存在」在文件后端上需要一次系统调用,而在命中查询阶段(batch_exists_v2 会一次性问几百个 key)这些系统调用会累积成可观的开销:
class MetadataCache: def __init__(self, ttl_seconds: float): self.ttl_seconds = ttl_seconds self.cache: dict[str, float] = {} # key -> monotonic timestamp self.lock = threading.Lock()
def contains(self, key: str) -> bool: with self.lock: if key not in self.cache: return False if self.ttl_seconds == -1.0: return True if time.monotonic() - self.cache[key] > self.ttl_seconds: del self.cache[key] return False return True注意 ttl_seconds == -1.0 的含义是「永不过期」,而默认 TTL 是 5 秒——这个 5 秒是一个非常务实的取值:它假设「同一个 key 的写入/删除在 5 秒内完成传播」,用一个短 TTL 换取「绝大多数查询打在内存里」。缓存元数据的 TTL 本质上是在「少一次系统调用」和「可能读到过期状态」之间做交易。
启动时这个缓存还会主动扫描目录预热(_scan_existing_files_to_metadata_cache),让重启后的第一批查询不至于全部落空。但它只收(endswith)属于本 rank/本模型的文件:
for fn in names: if not fn.endswith(".bin"): continue stem = fn[:-4] # Only files belonging to this rank/model. if stem.endswith((self.config_suffix, self.tp_config_suffix)): self.metadata_cache.add(stem)key 设计:哈希怎么算、为什么 key 里有 rank 后缀
L3 的 key 不是明文 token,而是页哈希:把一页的 token 序列连同它的前缀哈希一起做摘要,得到该页的 key。get_storage_hash_str(tokens_to_fetch, last_hash, page_size=self.page_size) 就是入口,last_hash 参数保证「同一段 token 出现在不同前缀下会得到不同 key」——这是必需的,因为 KV 值依赖于注意力看到的全部历史,而不是当前这一页的 token。
在此基础上,文件后端还给每个 key 加了一个后缀,把 rank 信息编进 key 里:
model_name = "-".join(model_name.split("/")) if model_name else ""enable_pp = pp_size > 1shard_suffix = f"_{pp_size}_{pp_rank}" if enable_pp else ""# Under NSA context parallel each CP rank holds a disjoint slice of every# page, so give each rank its own file key to avoid a cross-rank write race.if attn_cp_size > 1: shard_suffix += f"_cp{attn_cp_rank}_{attn_cp_size}"self.tp_config_suffix = f"_{model_name}_{tp_rank}_{tp_size}{shard_suffix}"self.config_suffix = f"_{model_name}{shard_suffix}" if is_mla_model else self.tp_config_suffix三种情形的处理各不相同,理解它的前提是理解每个 rank 到底持有什么:
- MLA 模型:KV 在 TP rank 之间是复制的(不是切分),所以所有 rank 写的是同一份字节,可以共用一个 key(
config_suffix里不带 tp_rank),并且约定由tp_rank == 0负责创建/淘汰这份共享文件; - 非 MLA(GQA/MHA):KV 按头切分到各 TP rank,每个 rank 持有的是不同的字节,必须以 rank 后缀区分,否则两个 rank 会互相覆盖;
- 注意力上下文并行(CP):每个 CP rank 持有同一页的不相交切片,同样必须各自一份 key——源码注释说得很清楚,这是为了避免跨 rank 写竞争。
跨部署共享:统一 key 方案
上面这套「把 rank 后缀编进 key」的做法有一个明显的代价:key 的身份被部署形态绑死了。 tp=4 和 tp=8 的两套部署,即使共享同一个存储 namespace,它们的 key 也完全不同——因为 rank 编号、切分方式都不一样。这在实践中意味着你无法把一个大 TP 集群算出的 KV 复用给小 TP 集群(或反过来),而这恰恰是「同一个系统提示词被不同规模的实例反复处理」这类负载最想要的能力。
hicache_key_scheme.py 里的统一 key 方案(--hicache-storage-key-scheme unified)就是为解决这个问题提出的:它用「这段对象持有什么」取代「谁写的」来命名。文件开头的注释把这个哲学讲得很完整:
"""Unified L3 key scheme (``--hicache-storage-key-scheme unified``).
Replaces the rank/topology key suffixes (``_{tp_rank}_{tp_size}``,``_{pp_size}_{pp_rank}``, ``_cp{r}_{s}``) with one topology-free coordinate::
{page_hash}_{digest}_L{start}-{end}[_H{head_group}]
The coordinate names what an object HOLDS -- a layer-range x head-rangerectangle of one page, both K and V -- never who wrote it, so any deploymentwhose shard tiles the grid derives the same keys for the same bytes. A TP2rank's objects are exactly the union of two TP4 ranks'; a PP1 rank's are theunion of the stages'."""这段话里有两个信息量极大的句子,值得展开:
「坐标命名的是「这段对象持有什么」——某页在层区间 × 头区间上的一个矩形。」 一个 KV 对象(存储里的一份字节)本质上是模型全局张量网格里的一个矩形块。层这一维被 PP 切,头这一维被 TP 切,token 这一维被页切。只要命名只引用绝对坐标(第几层到第几层、第几个头组),那么无论谁来切、怎么切,落在同一个矩形上的字节都会得到同一个 key。
「TP2 rank 的对象集合恰好等于两个 TP4 rank 的并集。」 这就是「tiling the grid(铺满网格)」的直观含义:TP 大小的变化只是把同一个网格用不同粒度的块去铺。TP2 的每个块,正好是 TP4 的两个块拼起来。
实现上,key 由前缀哈希(digest)+ 层坐标 + 头组组成:
_SCHEMA_VERSION = 1
def namespace_digest(namespace: KVCacheNamespace) -> str: encoded = msgspec.msgpack.encode(namespace) return f"ukv{_SCHEMA_VERSION}-{hashlib.sha256(encoded).hexdigest()[:16]}"
suffixes=[ f"{digest}_{coord}_H{first_head_index + i}" for coord in layer_coords for i in range(groups_per_rank)]KVCacheNamespace 把这些「必须匹配才能共享字节」的事实全部收进一个不可变结构:模型 id、逻辑 dtype、页大小、是否 rank 复制、总 KV 头数、头组大小、层分区粒度、对象字节布局。注释里对其中几个字段的解释很值得一读:
# Logical dtype, not the storage view: fp8 variants all store as uint8# and must not share a keyspace.dtype: str...# Byte order of the stored objects. Layouts serialize a page in different# orders at EQUAL sizes, so omitting this would let two deployments# exchange byte-permuted KV under identical keys.object_layout: strdtype记的是逻辑 dtype 而不是存储视图:fp8_e4m3和fp8_e5m2在存储里都是uint8,如果按存储视图命名,两套不同精度的部署就会共享同一个 keyspace,读到的字节会被按错误的精度解释——结果是数值全错但不会报任何错。object_layout必须进命名空间:不同布局在「相同大小」下会以不同字节序序列化一页,两个部署用相同 key 交换「字节排列不同」的 KV,同样是静默的数值错误。
_validate_grid 这一段则是「宁可拒绝也不降级」的态度:
total_kv_heads = 0 if rank_replicated else local_kv_heads * attn_tp_sizenamespace = derive_namespace(...)_validate_grid(namespace)if namespace.total_kv_heads % namespace.head_group != 0: raise ValueError( f"head_group={namespace.head_group} must divide " f"total_kv_heads={namespace.total_kv_heads}." )而 plan_unified_kv 的注释把「为什么错误要抛异常而不是降级」讲得很清楚:
"""Derive the namespace and this rank's chunk plan from deployment facts.
Raises rather than degrading: a rank whose shard does not tile the declaredgrid would write objects a reader cannot reassemble, and the symptom wouldbe silently wrong KV rather than a miss."""「症状不是未命中,而是静默的错误 KV」——这句是整套 key 设计里最重要的一句判断。存储系统里「命中但内容不对」是比「未命中」严重得多的故障,因为它不触发任何重算逻辑,直接把错误结果送进模型。所以这一层的所有校验都选择硬失败。
同一段里还有一条对当前实现边界的诚实说明:
if attn_cp_size > 1: raise NotImplementedError( "the unified key scheme does not support attention context " "parallelism yet: NSA-CP ranks hold sub-page slices (needs the " "token-granule extension) and replicated-CP needs writer election. " "Use --hicache-storage-key-scheme rank-suffix." )use --hicache-storage-key-scheme rank-suffix 给出了退路——新旧两套方案并存,而不是强行统一,这是渐进式替换的正常形态。
最后看一个很典型的「跨部署共享」配置。文档给出的异构图景是 tp=4 与 tp=8 共享:
# Example: heterogeneous TP = {4, 8}, so lcm = 8--hicache-storage-backend-extra-config '{"tp_lcm_size": 8}'tp_lcm_size 取所有共享部署的 TP 大小的最小公倍数,它的作用是把「头组粒度」定死为一个所有部署都能整除的单位。源码里的警告也说明如果不设它会怎样:
logger.warning( "unified key scheme: --hicache-storage-head-group is unset, so " "this namespace is keyed to this rank's %d of %d kv heads and " "can only share objects with deployments at attn-TP %d. Set it " "to total_kv_heads / lcm of the fleet's attn-TP sizes to share " "across TP sizes; a rank owning several groups simply owns " "several chunks.", local_kv_heads, total_kv_heads, attn_tp_size,)不设的后果是「命中率 0% 而不是报错」——注释里明说了「Nothing else reports this — the symptom is a 0% hit rate against a populated store」。这是分布式缓存里最难受的一类问题:存储是满的、key 也算得出来,就是永远不命中;而根因只是一个「粒度没对齐」。
后端生态与共享范围
SGLang 的 L3 后端不是一个,而是一组:仓库的 mem_cache/storage/ 目录下并列着 file、mooncake_store、hf3fs、nixl、lmcache、aibrix_kvcache、seaweedfs、shm、mmap、eic、flexkv、tensorcast_store、umbp、npu_memcache、simm 等实现——既有本地文件与共享内存,也有面向集群的对象存储与 RDMA 传输库。这种「一个抽象、多个后端」的排布方式是 KV 存储层的常态;下面这张来自 LMCache 论文的架构图展示了这种独立 KV 层的典型形态:
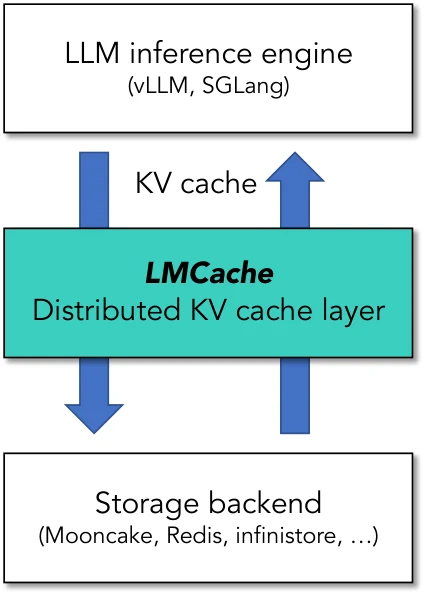
图片来源:LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference 中的架构图
选择后端时最关键的一条区分,是官方文档明确强调的共享范围:
L1 and L2 are private to a single inference instance; only L3 can be shared. Host memory cannot be pooled across instances or across hosts, not even for two instances on the same node. Raising
--hicache-ratioor--hicache-sizeonly enlarges the instance’s own private L2. Cross-instance reuse is the job of L3.
这句话纠正了一个非常常见的误解:以为把主机池调大就能让同机两个实例互相复用 KV。 事实是不能——file 后端默认落在节点本地的 /tmp/hicache,默认也是实例私有的;只有 mooncake、hf3fs、nixl、aibrix 这类集群级后端、并且所有实例共享同一个 namespace 时,L3 才真正达到集群范围。
这个分层的能力边界可以概括为:
| 复用范围 | 需要的层 | 典型配置 |
|---|---|---|
| 同一实例内、同一请求间 | L1 + L2 | --enable-hierarchical-cache + --hicache-ratio 2 |
| 同一实例、跨请求、跨长空闲 | L2 | 同上,主机池足够大 |
| 同机多实例 | L3(集群级后端 + 共享 namespace) | --hicache-storage-backend mooncake 等 |
| 跨机、跨集群、异构 TP | L3 + 统一 key 方案 | 加 --hicache-storage-key-scheme unified + tp_lcm_size |
预取策略与调度器的协同
预取是异步的,但请求迟早要开跑。等到什么时候是一个策略问题,SGLang 把它做成可选项(--hicache-storage-prefetch-policy):
| 策略 | 语义 | 收益 | 代价 |
|---|---|---|---|
best_effort | 需要时随时终止预取 | 不阻塞调度,尾延迟好 | 命中可能提前中断,复用率低 |
wait_complete | 保证预取跑完 | 复用率最高 | 请求可能为等待而排队 |
timeout | 超时则退化为尽力而为 | 两者折中 | 需要一个合适的超时值 |
控制器里对应的是 terminate_prefetch():
def terminate_prefetch(self, operation): """ Request to terminate a prefetch operation.
Must be called in the scheduler thread.
Asynchronous prefetch tasks may be running in background threads. When all prefetch tasks are terminated, a PrefetchAck with completed_req=True will be sent to ack_prefetch_queue. """ operation.mark_terminate() return operation.completed_tokens, operation.hash_value注意 Must be called in the scheduler thread 这条约束:终止请求只能由调度器线程发起——因为终止的判定(「现在要不要为了别的请求牺牲这个预取」)本质上是一个全局调度决策,它需要知道当前队列里还有谁在等。而 terminate_prefetch 返回的是「目前已完成多少」——半途终止的预取,其已完成部分依然可用,这是这套设计的一个实用之处:不是全有或全无,预取到哪里就算到哪里。
预取执行路径里对终止的处理也是「检查点式」的——在每一批 IO 之间看一眼是否已被终止:
if all_success and operation.is_terminated(): all_success = Falseif all_success: ... # 只有未被终止才继续搬这一批配合前面讲的「无论成败都要发 ack 保对称」,一个被终止的预取在集群里会收敛到一个所有 rank 一致认可的前缀长度:
def _reduce_prefetch_ack(self, ack: PrefetchAck): """Synchronize all ranks to agree on a PrefetchAck.""" if ack.completed_tokens is not None: # Determine the minimal successful prefix of tokens. completed_tokens_tensor = torch.tensor(ack.completed_tokens, dtype=torch.int) self._all_reduce(completed_tokens_tensor, torch.distributed.ReduceOp.MIN, self.prefetch_completion_sync_groups) ack.completed_tokens = completed_tokens_tensor.item()「取最小值」在这里出现了第二次(第一次是命中查询)——整个分层缓存的跨 rank 一致性,就是靠这两个 MIN 归约兜住的:命中长度取所有 rank 的最小值、完成长度也取最小值。逻辑很朴素:只要有任何一个 rank 没准备好,所有 rank 就都只认那个较短的前缀。这是分布式推理里唯一安全的做法,因为一次前向必须所有 rank 同步执行。
命中之后:KV 如何真正回到显存
预取把字节搬到主机池,但请求要跑,KV 必须在显存里。这一步由 load() + start_loading() 完成:
def load(self, host_indices, priority=None, node_id=-1) -> Optional[torch.Tensor]: """Load KV caches from host memory to device memory.""" device_indices = self.mem_pool_device_allocator.alloc(len(host_indices)) if device_indices is None: return None self.load_queue.append(CacheOperation(host_indices, device_indices, node_id, priority)) return device_indicesstart_loading() 里有一处对 overlap 调度的适配,注释写得很实在:
if self.load_fence_stream is not None: # in overlap scheduling, reclaimed pages might still be written by the forward thread # therefore a fence is needed for loading thread to prevent memory corruption # todo: it's possible to use a finer-grained fence self.l2_transfer_engine.host_to_device_stream.wait_stream(self.load_fence_stream)在重叠调度下,被回收的页可能还在被前向线程写——因为重叠调度让「调度下一批」和「执行当前批」并行(见 SGLang 源码完全拆解(六):Overlap Scheduler)。于是加载线程必须先在流上加一道栅栏,等前向流推进到某个点再开始拷贝,否则会把「正在被计算覆盖的页」当成「已经回收的空闲页」往里写。源码里那句 todo: it's possible to use a finer-grained fence 也诚实地标出了优化空间:当前是一道粗栅栏(整流的 wait),更细的做法是按页或按层做定向等待。
还有一个工程细节:加载时的 host→device 顺序与 layer-wise transfer counter 有关。加载不是「一把拷完再放行」,而是逐层推进、逐层放行——第 l 层搬完,这一层的注意力就可以先跑,不必等最后一层。LayerLoadingEvent / LayerDoneCounter 就是这套计数器的实现:
class LayerDoneCounter: def __init__(self, num_layers: int): ... def update_producer(self): ... def set_consumer(self, index: int): ... def wait_until(self, threshold: int): ...逐层放行是分层缓存能把延迟藏住的关键。 如果等全部层加载完再开跑,一次 32K 命中的加载要为几十层的数据等待;逐层流水后,第一层的等待时间只占全部加载的几十分之一。
一张完整的时序图:一次长前缀命中发生了什么
把前面所有零件串起来,一次「多轮对话的第二轮」在 HiCache 下的完整路径是:
- 请求到达。请求带着它的 token 序列进入调度器,做前缀匹配。命中可能有三段:GPU 上已有的(设备命中)、主机上有备份的(主机命中)、存储里存在的(L3 潜在命中)。
- L3 存在性查询(如果开了存储后端)。
prefetch_thread分批问后端「这些页在不在」,得到连续命中长度;所有 rank 取 MIN 得到一致的前缀长度;低于prefetch_threshold(默认 256 个 token)就直接放弃——省下一次注定不划算的搬运。这个阈值就是正文开头那道「搬运 vs 重算」经济学在实现里的落点。 - 预取搬运(L3 → L2)。命中页从存储读进主机池的一个空闲页(bounce buffer)。这里需要主机池有空闲——这就是前面那条「主机池必须比设备池大」的约束。
- 加载搬运(L2 → L1)。
load()先问设备分配器要一批设备页;拿到之后发起 H2D 传输;传输按层推进,逐层用LayerDoneCounter放行。 - 同步与开跑。等待完成后,调度器把「已就绪的设备页」交给本次 prefill 的注意力,只有未命中的尾部 token 才真正参与计算。命中的 KV 直接参与注意力,不需要重算。
- 写回(L1 → L2,可选 L2 → L3)。算完的新 KV 按写策略回写主机;若开了存储后端,再由
backup_thread按页备份到 L3。
这条链路里任何一环失败,都不应让请求失败——最差也要退化成「全部重算」。这是分层缓存的一个基本设计原则:缓存是优化,不是依赖。 源码里所有涉及缓存的失败路径(前缀查询异常、页读取失败、备份失败、回填被丢弃)都是记日志 + 继续跑,而不是抛异常。这一点在工程上极其重要:如果缓存故障能让请求失败,那「省时间」的组件就变成了「制造 SLO 事故」的组件。
这种「KV 在多个实例与多个存储层之间流动」的形态,正是当前推理系统演进的一条主线。下面这张来自 LMCache 论文的端到端系统图展示了它在更大范围内的位置——KV 缓存层不只是单机内的三层,它可以横跨多个推理引擎与多个存储系统:
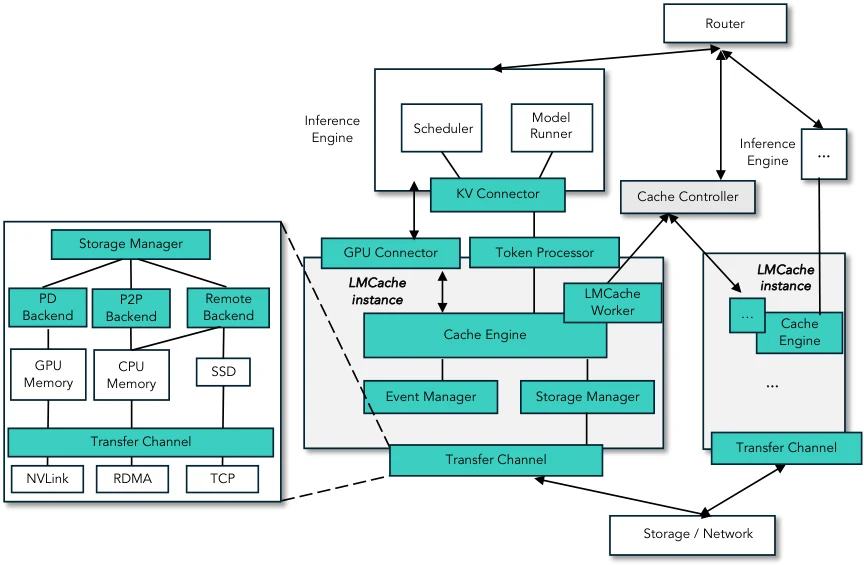
图片来源:LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference 中的端到端系统图
工程配置清单与已知边界
最后把可用开关与边界整理成一份清单,方便对照着读源码。
核心开关(来自官方 HiCache 文档):
--page-size 64 # 缓存管理的页大小--enable-hierarchical-cache # 打开 HiCache--hicache-ratio 2 # 主机池 = 设备池的 2 倍(token 口径)--hicache-size 100 # 直接用 GB 指定主机池,会覆盖 ratio--hicache-io-backend kernel # CPU<->GPU 搬运后端--hicache-write-policy write_through # GPU->CPU 的写策略--hicache-storage-backend # 可选 L3 后端(hf3fs / mooncake 等)三个最容易踩的坑:
- 主机池没留出中转空间。写穿策略下主机池若只等于设备池,L3 命中会整批丢弃,指标
sglang:storage_prefetch_unfulfilled_tokens_total{reason="host_capacity"}会持续增长。 - 布局与 I/O 后端不匹配。
page_first配direct后端会被静默降级为layer_first,配置与实跑不一致。 - 跨 TP 共享没设
tp_lcm_size。症状是「存储是满的但命中率是 0」,不报错。
当前实现的边界(源码中明确标注的):
- 统一 key 方案尚不支持注意力上下文并行(
attn_cp_size > 1会直接NotImplementedError),需要退回rank-suffix方案; - 加载栅栏目前是粗粒度的流级等待(源码
todo标注),更细的按层/按页栅栏是预留的优化方向; - 每个 rank 在 1 KV 头 / 多 TP 的场景下无法自动推断命名空间(可能意味着复制也可能意味着切分),必须显式给出
--hicache-storage-head-group。
从这套实现里能带走的几条通用经验:
- 分层缓存的成败在于「连续性」:前缀命中的判定、预取的分批短路、备份的中断即停,全都在维护「从根出发的一段连续前缀」这个不变量;
- 跨 rank 一致性靠 MIN 归约兜底,而且归约必须对所有 rank 对称执行(哪怕本 rank 结果是 0),否则集合通信死锁;
- 缓存对象的存在判定必须等价于内容完整,所以原子替换(tmp + rename)、元数据 TTL、原子回滚这些「存储基本功」一个都不能省;
- 命名空间里必须写进所有会导致字节不可互换的事实(逻辑 dtype、字节布局、头粒度),漏一个就是静默的数值错误而不是未命中。
小结
HiCache 做的事情可以一句话概括:把 KV Cache 从「一个显存池」扩展成「一个跨三层的缓存体系」,并让前缀树、分配器、调度器都能感知这个体系的边界。
它由这几个机制咬合成整体:
- 分层前缀树用
evicted/backuped两个状态位把节点分成三态,匹配时同时维护「最长逻辑命中」与「最长设备就绪命中」,前者用于规划、后者用于开跑; - 写回策略(写穿 / 选择性写穿 / 写回)决定了主机池需要多大、哪类前缀会被保住,并且引出「主机池必须比设备池大」这条容量硬约束;
- 宿主池在主机侧维持与设备侧同构的层粒度布局,用延迟合并空闲表、双分配/双释放断言、快照式内存预算来保证正确性与效率;
- 异步搬运(预取与写回两条流水线)把 L3↔L2 和 L2↔L1 的拷贝从关键路径上摘下来,用分批、限流、逐层放行和事件通知与调度器对接;
- L3 抽象把存储后端压到
get/exists/set三个方法的薄接口上,同时用页哈希 + 命名空间 + 统一 key 方案解决「谁写的」与「持有什么」之间的身份问题。
理解这套机制之后,再回看那些选项(--hicache-ratio、--hicache-mem-layout、--hicache-write-policy、--hicache-storage-prefetch-policy)就不再是「配置项列表」,而是一条条设计决策的直接投影:每一条都在回答「容量换带宽、延迟换命中、复杂度换复用范围」这三个交易里的某一笔。
下一篇将讨论 SGLang 的专家并行与 EPLB——MoE 模型在一台多卡机器上如何切分专家、如何在解码过程中动态重排专家位置以应对负载倾斜,以及它与 HiCache、P/D 分离这些机制的交叉点。
参考资料
- SGLang HiCache 设计文档
- SGLang HiCache 最佳实践
- SGLang v0.4: Cache-Aware Load Balancing and Faster Structured Output
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference
- SGLang GitHub 仓库(
python/sglang/srt/mem_cache、managers/cache_controller.py) - Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
- Strata: Hierarchical Context Caching for Long Context Language Model Serving
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



