


vLLM 源码完全拆解(三十六):编码器分离(EPD)与 EC Connector——视觉编码如何从生成集群里拆出去,又把嵌入接回来
前三十五篇里,vLLM 的请求路径被拆得很细:从 Renderer 把文本变成 token,到 EngineCore.step 调度,再到 GPUModelRunner 把一批请求拼成一次前向;多模态请求也在第十三篇里走完了「预处理 → 调度器预算 → 编码器执行 → 嵌入回填」这条链路。
那条链路有一个隐含前提:视觉编码器、文本预填充、解码,三者跑在同一组 GPU 上。这个前提在低并发时没有问题,在高并发、多图、图文混合的负载下就开始出问题。这一篇把前提拆掉:vLLM 的编码器分离(Encoder-Prefill-Decode Disaggregation,下称 EPD)把视觉编码器搬到独立实例上,编码器输出通过一个叫 EC Connector 的传输层送到生成实例,再由生成实例像「本地编码器刚跑完」一样把嵌入注入前向。
vLLM 的原生 EPD 支持由 PR #25233 在 2025 年 11 月合入,从 0.11.1 版本开始可用;在它之前,NVIDIA Dynamo 曾以 vLLM 为后端支持过 EPD 形态的分离,但文档与实现都比较有限。本篇讨论的是 vLLM 主干上的原生实现。
本篇沿 V1 源码拆解这条链路:EC 的两个角色(producer / consumer)、调度器如何把「编码请求」与「解码 token」分开记账、跨实例存储里放了什么,以及 worker 端在 execute_model 的哪个位置把嵌入装进来、又在什么时候把本地副本释放掉。前几节先把「为什么要拆」讲清楚,后面几节才进代码。
为什么编码器要搬出去
三种计算挤在一块卡上
一次多模态请求在 GPU 上的工作可以分成三段,三段的计算特征完全不同:
- 视觉编码:一次性、计算密集、并行度高。一张 640×640 的图在 Qwen3-VL 这类模型上约产生 400 个视觉 token,一次 ViT 前向是典型的密集矩阵乘,属于 compute-bound。
- 文本预填充:同样是 compute-bound,但长度可长可短,且与已有 KV 前缀有关。
- 解码:逐 token、访存密集,属于 memory-bound,且每一步都要把 KV Cache 读一遍。
三者共用同一组 GPU 时,GPU 的 SM 与显存带宽要在它们之间轮换。vLLM 官方博客对这件事的总结很直接:编码器的工作无法与其他请求的 prefill/decode 重叠,而且编码器的耗时波动很大(取决于分辨率、图片数量),一旦和纯文本请求混在同一批里,一条多图请求就能把整个 batch 卡住,prefill 与流式解码的延迟随之抖动。反过来,编码器和解码器对并行策略的要求也不同——前者要高并行度的一次性前向,后者要长生命周期的顺序执行;把两者放在同一组卡上,就只能选一套折中策略。
图 1 是 vLLM 官方博客给出的 EPD 工作流。最左侧是代理(proxy),中间是编码实例,右侧是 prefill/decode 实例,底部是存放编码器输出的远端存储。
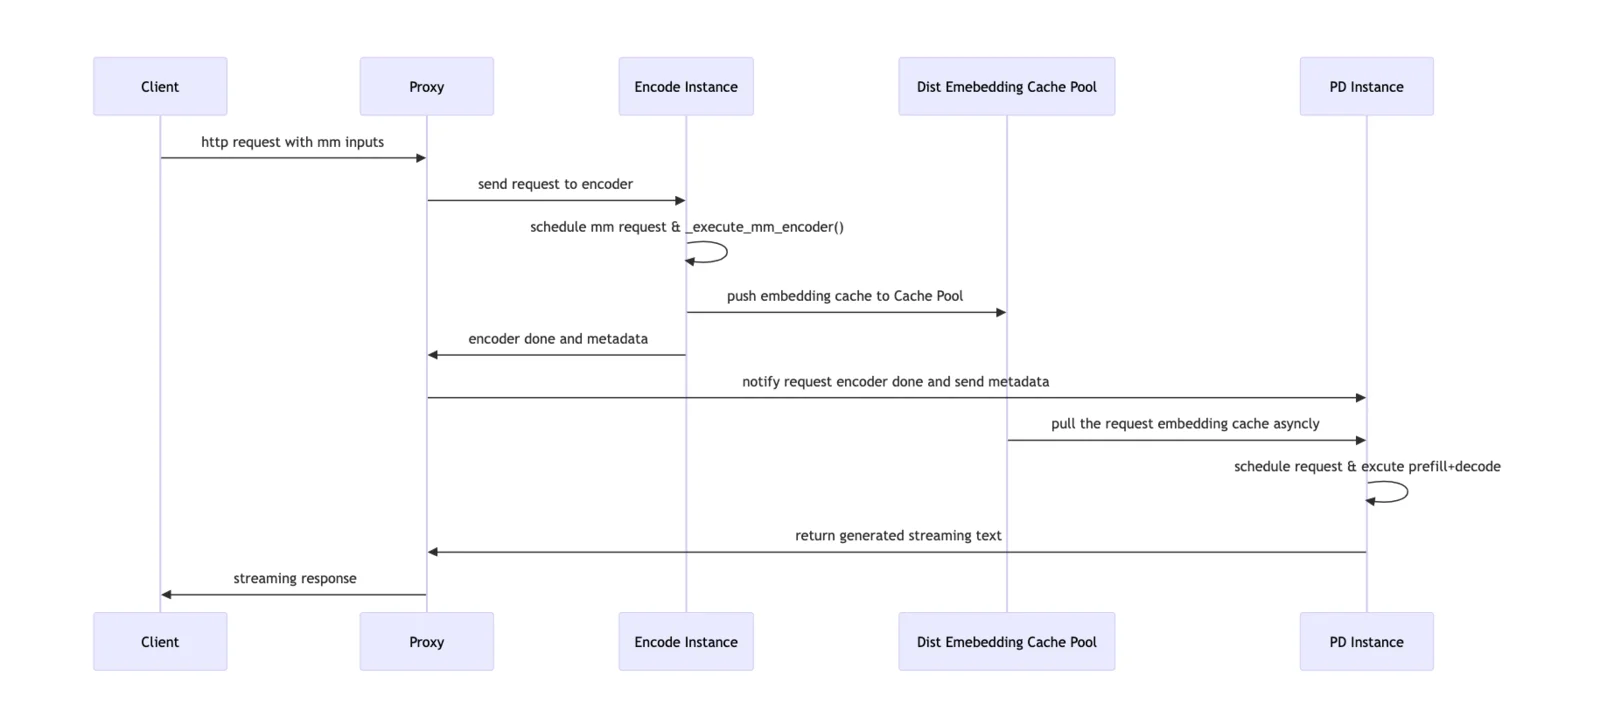
图中可以把链路读成一条流水线:请求 N 的编码器还在跑的时候,请求 N−1 已经进入了 prefill 或 decode;纯文本请求完全不经过编码实例,也不会排在图片任务后面。编码实例的规模由图片数量决定,生成实例的规模由总请求率与输出长度决定,两者各自伸缩,不再互相绑架。
单机上的折中:ViT DP + LM TP
在「完全拆开」之前,vLLM 先做过一个单机内的折中:视觉编码器走数据并行(Data Parallel),语言模型走张量并行(Tensor Parallel)。这组策略让编码器在每张卡上各处理一部分图片,靠 DP 提高吞吐;语言模型仍然按 TP 切开。它显著降低了 TTFT,之后也被 SGLang 等其他框架采纳为多模态模型的默认并行方式。
但这个做法仍然是「同一组卡上的分工」:编码器与解码器共享显存与带宽,资源比例是固定的。EPD 要解决的是这个比例问题——让编码器集群与生成集群可以按各自的负载曲线独立扩容。
一个直接的量化
vLLM 博客给出的评测环境是 4×A100 80G、Qwen3-VL-4B-Instruct,数据集用 vllm bench serve --dataset-name random-mm,文本长度 400/2000 token,每个请求 1–4 张 640×640 图片(每张约 400 个视觉 token),输出 150 token,基准是 1 个编码实例 + 3 个 prefill/decode 实例(记为 1E3PD),对照组是 --data-parallel-size 4 的四实例数据并行部署。goodput 定义为同时满足 P99 TTFT 20 s 与 P99 TPOT 100 ms 的最大可持续请求率。
短文本(约 400 token)场景下,单图请求的 goodput 只是小幅提升(23 → 24 QPS);四图请求的 goodput 翻倍(6 → 12 QPS),P99 TTFT/TPOT 普遍低 20–50%。对照组在没有 EPD 时,多图负载在 12–14 QPS 附近就失稳,P99 TPOT 跳升 30–50% 并越过 SLO。长文本(约 2000 token)场景下,编码开销占总工作量的比例变小,系统进入解码主导区间,对照组单图可持续 8 QPS、3–4 图 4 QPS,EPD 则分别维持 18 / 11 / 9 / 8 QPS,goodput 提升 2–2.5 倍,有效解码吞吐提升 10–30%。
图 2 是短文本场景下 EPD 与数据并行的吞吐-延迟曲线对比。横轴是请求率,纵轴是延迟分位数;曲线走势的差异比具体数字更能说明问题——非 EPD 曲线会在某个点之后陡升,EPD 曲线则更平缓,在同样的请求率下把尾部延迟压在 SLO 以内。这组数字与源码机制的对应关系可以拆成三层:
- 编码器不再与解码器抢 SM。非 EPD 时,一条多图请求的编码前向排进同一个 step,同一批里的纯文本解码请求只能等这步算完;
encoder_compute_budget虽然是全局预算,但预算只约束「本步排多少编码输入」,不改变「编码与解码共享 GPU」这一事实。 - 纯文本请求走快通道。
ensure_cache_available只对有mm_features的请求生效,纯文本请求不会因为其他请求的图片在途而被调度器跳过,也不进入编码实例的队列。 - 资源比例可以独立调。编码实例
get_kv_cache_spec()返回空字典,KV 块数为零,显存全给权重与编码器;生成实例则按num_layers、num_kv_heads、head_dim分配 KV。Qwen3-VL-4B 的语言模型部分是 36 层、8 个 KV 头、每头 128 维、bf16,每个 token 的 KV 约 字节,约 144 KB;编码实例上这 144 KB/token 的预算完全不存在。
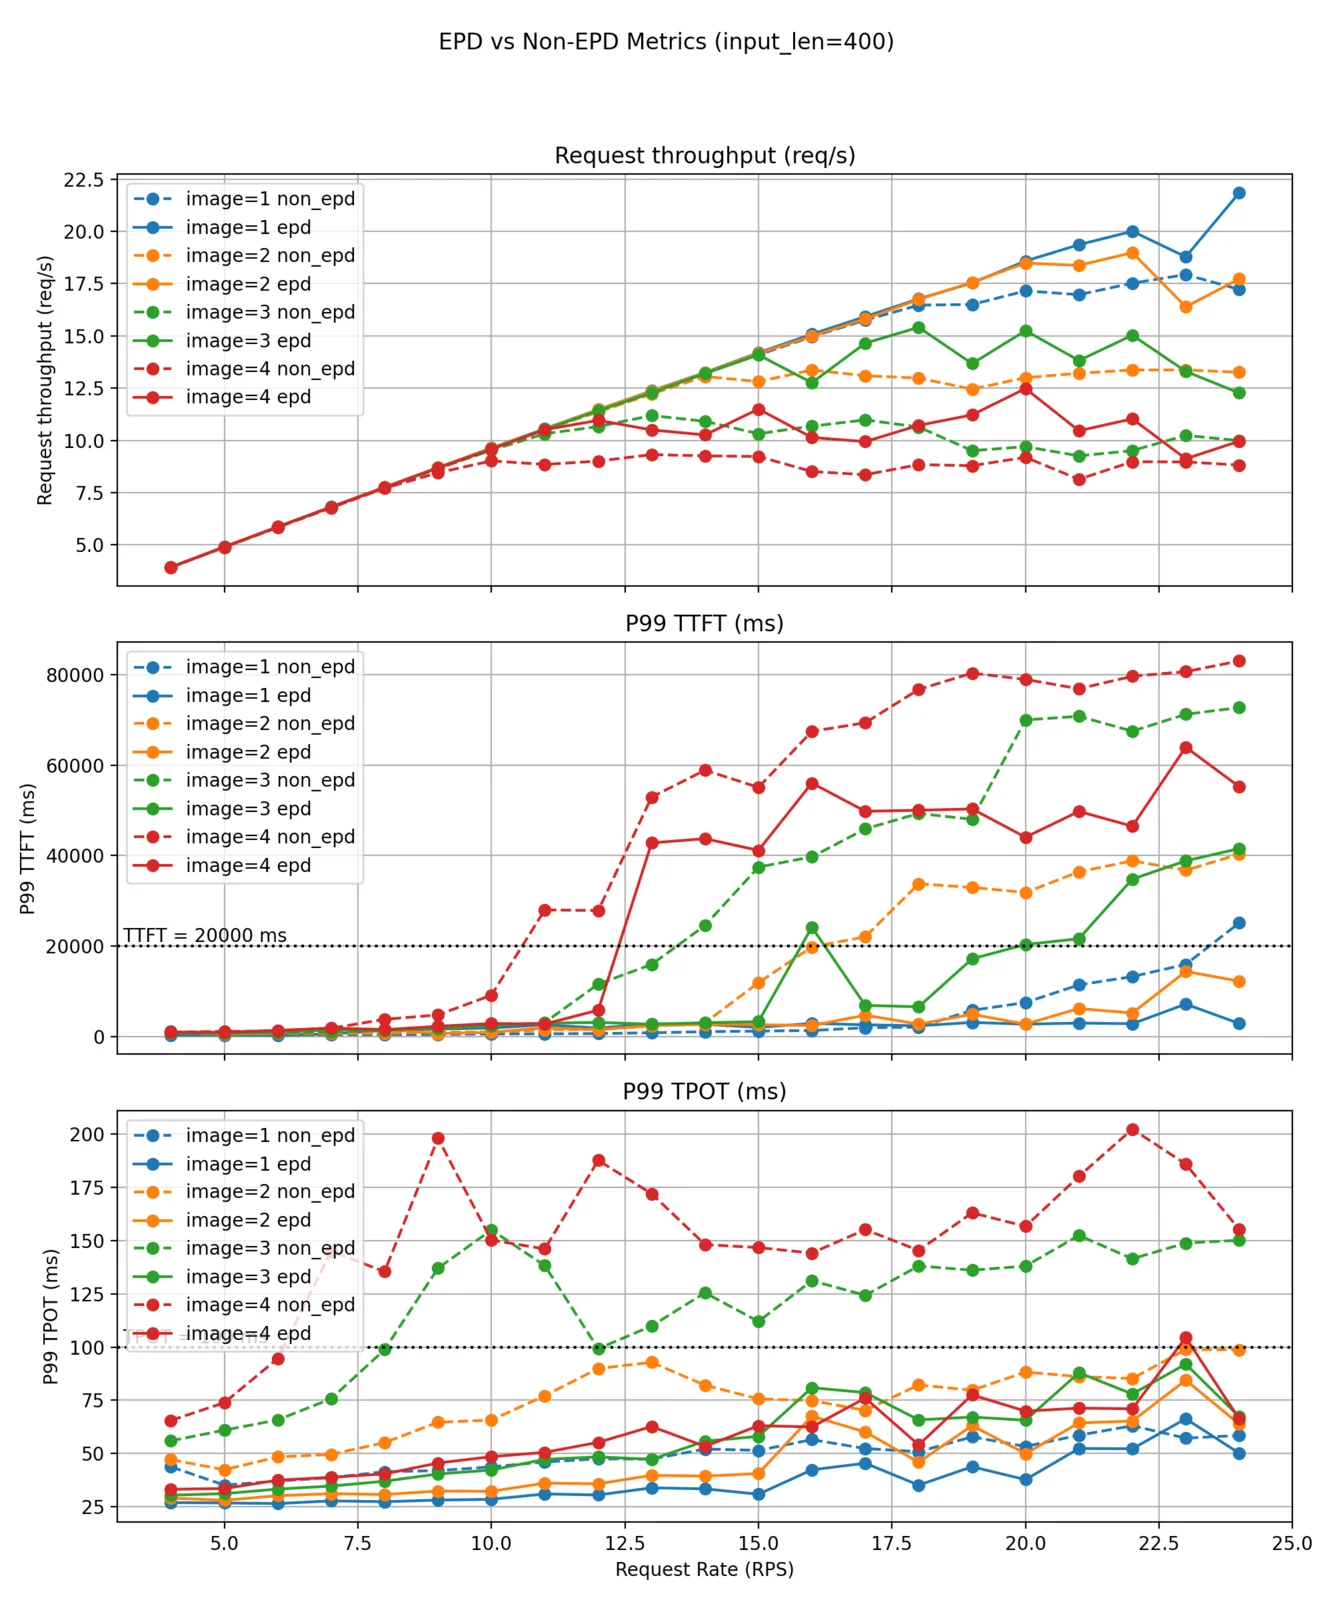
图源:vLLM 官方博客《Encoder Disaggregation for Scalable Multimodal Model Serving》(2025-12-15)。
长文本场景的曲线见图 3。输入约 2000 token 时,编码开销被更长的 prefill 摊薄,EPD 的收益主要来自「纯文本请求不被图片阻塞」与「编码集群独立伸缩」,而不是编码计算本身被消除了多少。
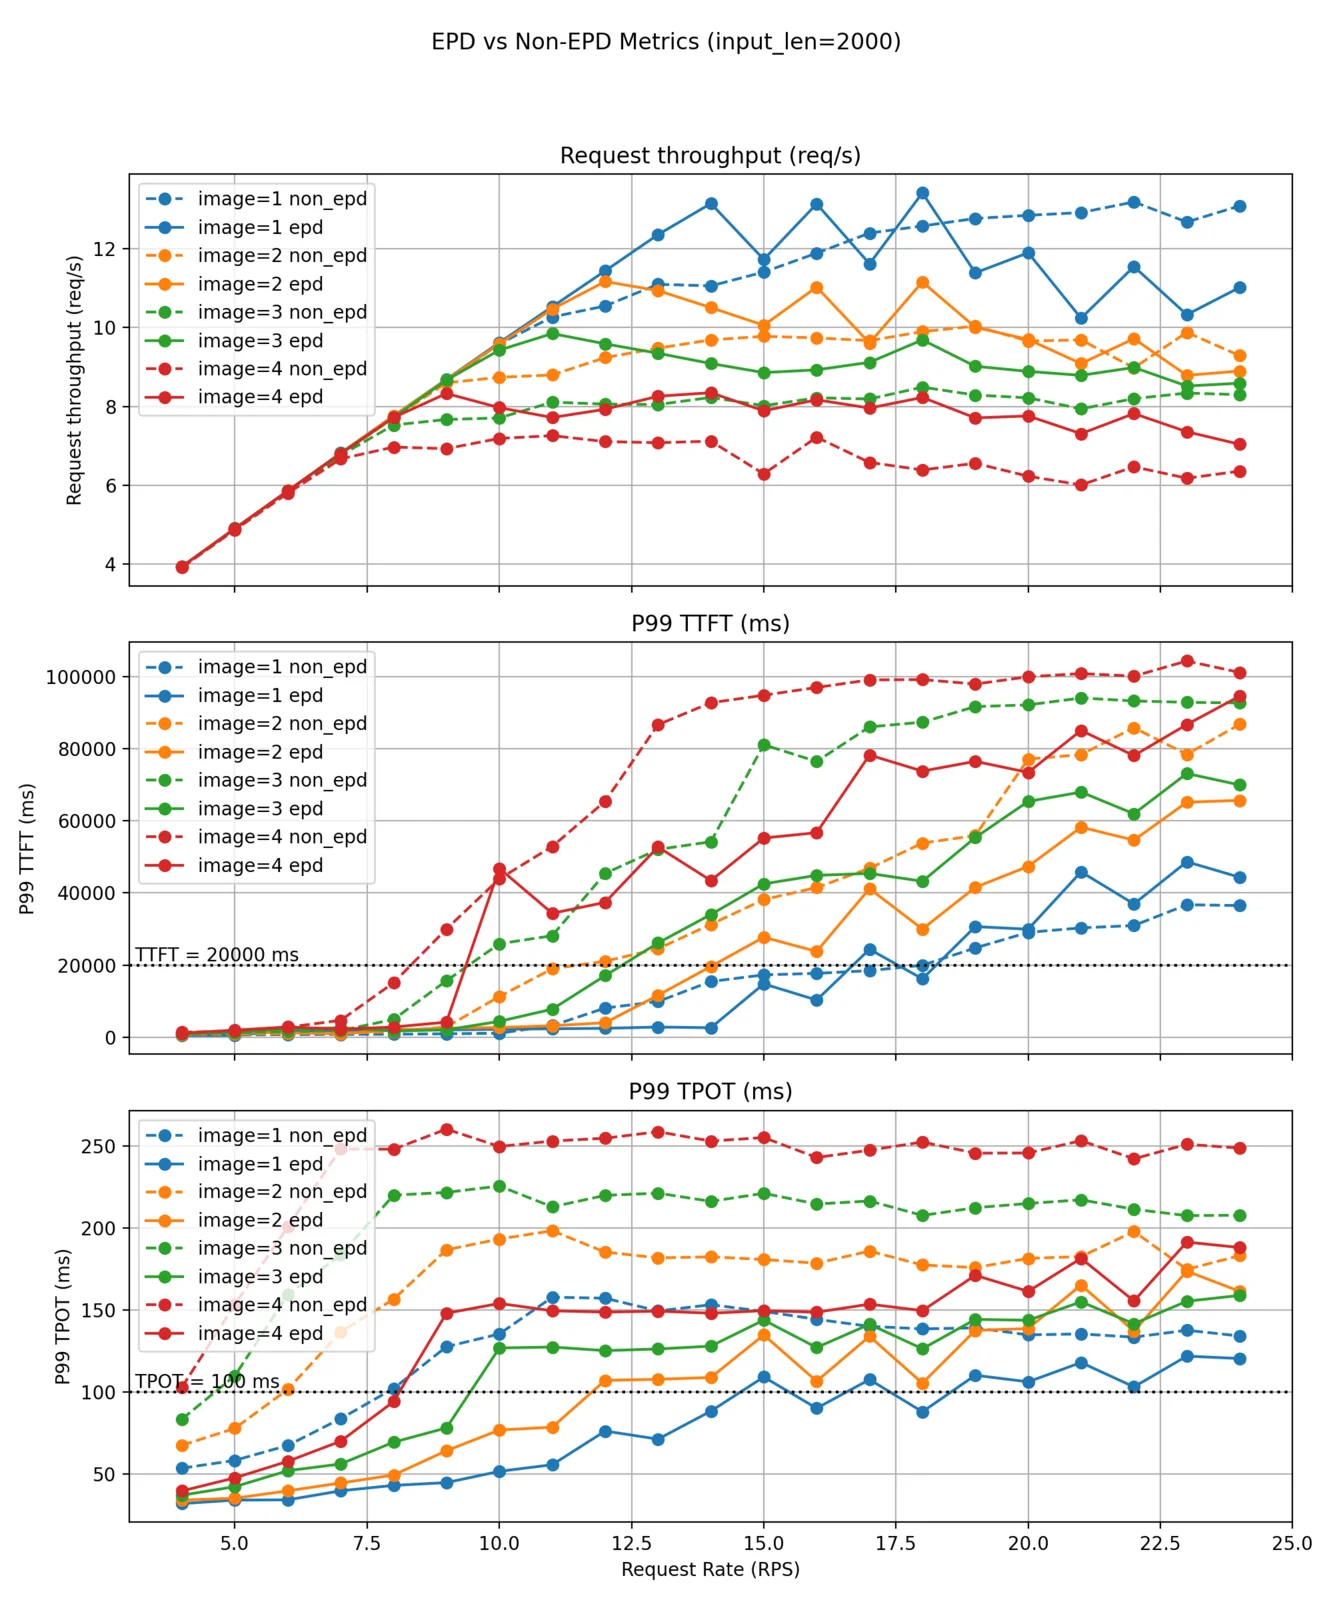
图源:同上,vLLM 官方博客 EPD 评测。
博客还报告了在 4×Ascend 910B 32G、Qwen2.5-VL-7B-Instruct 上的复现实验,结论一致:稳定区间内吞吐提升 5–20%,P99 TTFT/TPOT 显著降低。这条信息的意义在于,EPD 的收益来自架构解耦,而不是英伟达硬件的特异性。
先看清「编码器」到底输出了什么
EPD 之所以能成立,前提是编码器的输出对生成实例来说是一个可以搬运的张量。以 Qwen3-VL 这类模型为例:图片被切成若干 patch,ViT 编码后得到每个图片项的嵌入序列,长度为 feature_size × hidden_size,其中 feature_size 就是该图片的视觉 token 数。生成实例在文本序列里用占位符 token 标出这些位置,前向时把占位符位置的 token embedding 替换成编码器输出。也就是说,跨实例搬运的不是像素,也不是 KV Cache,而是编码器算完的嵌入。
这一步决定了 EC 通道的设计边界:它的数据量是「视觉 token 数 × hidden_size × 元素字节」,与文本 KV 无关;它的生命周期是「从编码完成到该图片的占位区间被 decoder 消费完」;它天然可以按图片内容去重(同一张图在不同请求里哈希相同)。
传输量的算术
把单张图片的编码输出记为 个视觉 token、模型隐藏维为 、元素字节为 ,则一份编码输出的字节数是:
以 Qwen3-VL-4B-Instruct 为例,语言模型隐藏维 ,bf16 下 ;一张 640×640 的图在 spatial_merge_size=2 的 patch 合并后约产生 个视觉 token,于是:
四个这样的图片项,一个请求就要搬约 8 MB 的嵌入。若生成集群稳态处理 12 QPS 的四图请求,仅 EC 读方向就是 ;如果编码实例与生成实例不在同一台机器,这个量级决定了互连的选择:共享文件系统适合调试与低频场景,RDMA 或高速内网才适合生产。
对比一下 KV 的量级:同一模型上,一条 1000 token 的序列,KV Cache 为 。也就是说,一段一千 token 的 KV,比四张图的编码输出大一个数量级。这解释了为什么 EC 通道可以承担「每张图都传一次」,而 KV 通道必须花大力气做 P/D 之间的增量传输、块复用与前缀命中;两者的数据体量与复用模式完全不同。
另一个经常被忽略的差异是去重粒度。KV Cache 的去重靠前缀哈希,粒度是 token block;编码输出的去重靠多模态内容的哈希,粒度是「一张图 / 一段音频 / 一个视频」。同一张商品图出现在一千个请求里,编码实例只算一次、存一份,之后每个请求只付一次读的带宽;前缀缓存则要求请求前缀逐 token 相同。这也是博客里强调「centralized encoder 天然支持 cross-request cache」的原因。
请求里的 mm_features 长什么样
调度器和 worker 之间传递的不是像素,而是一组 MultiModalFeatureSpec。它的字段决定了 EPD 的语义边界(vllm/multimodal/inputs.py):
@dataclassclass MultiModalFeatureSpec: data: MultiModalKwargsItem | None # 像素/音频等原始张量;命中缓存时为 None modality: str # "image" / "audio" / "video" identifier: str # 编码器缓存的键(带 LoRA 前缀) mm_position: PlaceholderRange # 在 prompt 里的占位区间 mm_hash: str | None = None # 处理器输出的哈希(不带 LoRA 前缀)mm_position 是 PlaceholderRange(offset, length, is_embed):offset 是占位符在 prompt 里的起点,length 是占位 token 数,is_embed 是一个可选的布尔掩码,标出这 length 个位置里哪些要真正写入嵌入。get_num_embeds() 返回掩码为真的位置数(没有掩码时等于 length),get_embeds_indices_in_range() 负责把「本步的 token 区间」映射到「编码器输出的切片区间」。第十三篇里 _gather_mm_embeddings 的 start_idx/end_idx 就是靠这两个方法算出来的。
data 字段的类型是 None 这一点值得单独说:命中缓存的项不需要把原始张量从 API 进程传到 EngineCore,源码注释写的是「Can be None if the item is cached, to skip IPC between API server and engine core processes」。在 EPD 里这个优化被放大:生成实例收到的请求本来就只带哈希与占位符,data 为 None 是常态,而不是例外。编码实例则需要 data 来跑 ViT——所以「谁拿到像素、谁只拿哈希」在请求结构层面就已经分开了,不需要额外的协议。
identifier 与 mm_hash 是两个不同的键:前者用于编码器输出缓存(带 LoRA 前缀,因为同一个视觉输入在不同 LoRA 下的嵌入可能不同),后者用于处理器输出缓存(不带 LoRA 前缀)。把两者混用,就会出现后文要讲的「哈希被复用、嵌入数却对不上」的故障。
EC Connector:两个角色、两侧接口
调度侧与 worker 侧
vLLM 把 EC 传输封装在 vllm/distributed/ec_transfer/ec_connector/base.py 的 ECConnectorBase 里。这个类按进程角色分成两半(ECConnectorRole):
SCHEDULER:跑在调度器进程里,负责「这一轮哪些图片需要从远端读、哪些需要写回」的决策,并把结果编成元数据塞进SchedulerOutput。WORKER:跑在每个 worker 进程里,按元数据真正执行读/写。
基类文件头部的注释用一组「原语」概括了两侧职责。注释里的名字是较早的命名(check_caches_exist、start_load_ec、wait_for_save),当前实现对应的方法略有不同:
Scheduler-side: has_cache_item() - 远端是否已有单个编码器缓存项 ensure_cache_available() - 本步需要的项是否已就位;未就位则让路 update_state_after_alloc() - 分配后更新连接器状态,决定加载与否 request_finished() - 请求结束,在释放缓存前完成交接
Worker-side: start_load_caches() - 开始加载(可异步) save_caches() - 把编码结果写回远端 get_finished() - 返回异步收发已完成的请求 build_connector_worker_meta()- 把 worker 侧状态回传调度器这里有一个贯穿全篇的设计原则:调度器不碰张量,worker 不碰调度决策。调度器只跟「哪个图片哈希需要读/写、占多少预算」打交道,所有 GPU 显存里的张量都在 worker 手上。这一点与第十三篇里视觉编码器缓存的分工是一致的——EncoderCacheManager 记账、GPUModelRunner.encoder_cache 存张量——EPD 只是在同一套分工上多加了一个远端。
一个请求在调度器里的「三张账」
对一条多模态请求,调度器同时记三本账:
- 解码 token 账:
request.num_computed_tokens,即 decoder 已经算到第几个位置,KV 块按它分配。 - 编码预算账:每步全局有一个
encoder_compute_budget,以「编码器 token 数」计,决定这一步允许跑多少编码工作。它来自MultiModalBudget的encoder_compute_budget,默认值在SchedulerConfig.__post_init__里设为max_num_batched_tokens。 - 编码器缓存账:
EncoderCacheManager.num_free_slots,以嵌入 token 数计,限制「已编码但尚未被 decoder 消费」的输出总量,默认同为max_num_batched_tokens。
EPD 加入后,第 1 本账属于生成实例,第 2、3 本账在编码实例上是主要开销、在生成实例上则被远端命中大幅压缩。下面按请求的状态机把这三本账串起来。
角色配置:producer、consumer 与 encode-only
ECTransferConfig(vllm/config/ec_transfer.py)定义了实例角色。ec_role 取 ec_producer、ec_consumer 或 ec_both,配合 ec_connector 选择具体连接器实现。两个派生属性决定了很多分支:
@propertydef is_ec_producer(self) -> bool: return self.ec_connector is not None and self.ec_role in get_args(ECProducer)
@propertydef is_ec_consumer(self) -> bool: return self.ec_connector is not None and self.ec_role in get_args(ECConsumer)
@propertydef is_encode_only(self) -> bool: """Whether this instance encodes but does not run the language model.""" return self.is_ec_producer and not self.is_ec_consumeris_encode_only 这个属性是 EPD 资源复用度的关键。它的注释写得很直白:这类实例不分配 KV Cache,因为 GPUModelRunner.get_kv_cache_spec 在「有 EC 传输且本实例不是 consumer」时直接返回 {}:
def get_kv_cache_spec(self) -> dict[str, KVCacheSpec]: ... if has_ec_transfer() and not get_ec_transfer().is_consumer: return {} kv_cache_spec: dict[str, KVCacheSpec] = {} ...返回空字典意味着启动时的显存 profiling 不会为 KV 块留预算——整个显存可以用来装权重和跑编码器。这就是「编码实例可以只买编码所需的硬件」在代码上的落点。
is_encode_only 还牵动了几处配置解析(VllmConfig 里以 _resolve_mm_* 命名的一组方法):
mm_encoder_only被强制打开,编码实例只跑视觉编码器,不跑语言模型;- 多模态预处理(缩放、归一化)默认放到加速器上执行,前提是
--mm-tensor-ipc=torch_shm,因为其他传输方式要把输出拷回主机,反倒不如在 CPU 上做;显式指定--mm-processor-device时以用户为准; - 视频默认用 torchcodec 的 NVDEC 后端在 GPU 上解码,省掉帧数据在 CPU 与 GPU 之间的往返。
这三条优化的共同点是:encode-only 实例的 GPU 是「独占」的,前端预处理和编码器不需要和语言模型抢设备,所以可以放心把原本在 CPU 上做的预处理搬进 GPU。
consumer 一侧则在 _resolve_... 里把 allow_missing_mm_embeddings 打开,并强制 enable_mm_embeds:生成实例收到的是「图片哈希 + 占位符」,像素数据不在请求里,嵌入由 EC 通道补进来。如果这个开关不开,前端会把它当成缺字段的请求直接拒掉。
连接器工厂与内置实现
ECConnectorFactory(vllm/distributed/ec_transfer/ec_connector/factory.py)用「名字 → 模块路径 → 类」的惰性注册表管理连接器,注册方式与 KV Connector 同构。内置选项在 ECTransferConfig.ec_connector 的文档里列了两种:
ECExampleConnector:共享文件系统,用 safetensors 格式存取。它适合功能验证与调试,读写路径简单,没有远端传输的延迟模型。ECMooncakeConnector:基于 Mooncake TransferEngine 的 RDMA 传输,要求安装mooncake-transfer-engine,并要求生产者和消费者两侧的ec_connector_extra_config相互匹配;额外配置里设置cross_encoder_cache后,可以在编码之前先查 Mooncake Store 里是否有共享的编码结果,从而跳过重复编码,同时保留点对点投递。
ECTransferConfig 的若干字段值得在部署时逐项核对:
ec_role:ec_producer、ec_consumer或ec_both。不设ec_role却设了ec_connector会在__post_init__里直接报错;engine_id:不填时自动生成一个 UUID,用于在连接器之间识别引擎身份;ec_buffer_device与ec_buffer_size:前者目前只支持cuda,后者默认约 1 GB,是传输缓冲的大小;ec_ip/ec_port:构建分布式连接用的地址,默认127.0.0.1:14579;mm_encoder_output_widths:一个由生产者在启动期测量、供消费者使用的字段,记录每种模态「每个 token 的编码器输出宽度」。注释里特别指出它可能超过语言模型的嵌入宽度(例如 DeepStack 这类把多层视觉特征拼接送进文本流的模型)。这是 EPD 里一个容易被忽略的约束:consumer 不能假设encoder_output的最后一维等于hidden_size,宽度要以生产者公布值为准。
最后一条也解释了为什么 ec_transfer_config.compute_hash() 返回的是一个空 factors 的哈希——注释写明「this config will not affect the computation graph」。EC 配置只改变数据的来源与传输方式,不改变模型的算子图,所以不参与编译缓存键。
ECMooncakeConnector 本身只是门面:构造函数按角色分别创建 ECMooncakeScheduler(调度侧逻辑)与 ECMooncakeWorker(worker 侧传输),把基类接口逐项委托下去。同一目录下的 metadata.py、scheduler.py、worker.py、transfer.py 等文件分别承载元数据、调度、worker 与传输引擎。这种拆分让连接器实现可以独立演进,而调度器和模型执行器看到的始终是 ECConnectorBase 这一套接口。
本篇的代码拆解以基类的协议为主,具体连接器只在必要处点名:跨实例传输的工程细节(存储介质、RDMA 注册、故障恢复)属于另一条线,先把 vLLM 自身的契约讲清楚。
调度器里的编码账:一次 step 如何处理一张图
编码输入与远端命中
调度器主循环在每一步先处理 running 队列,再处理 waiting 队列。对每条有编码输入的请求,_try_schedule_encoder_inputs(vllm/v1/core/sched/scheduler.py)返回五个值:
(encoder_inputs_to_schedule, # 本步需要在本地跑的编码输入下标 num_new_tokens, # 可能被缩小后的解码 token 数 new_encoder_compute_budget, # 更新后的编码预算 external_load_encoder_input, # 本步需要从远端加载的编码输入下标 duplicate_encoder_inputs) # 同一步里重复出现的输入下标这五元组本身就是一张「本步编码账」:前两个字段决定「要算多少」,后三个决定「哪些要借远端、哪些要跳过」。函数的判断顺序值得逐条读:
- 本步是否覆盖该输入。编码输入在序列里的位置是
[start_pos, start_pos + length),函数用[num_computed_tokens, num_computed_tokens + num_new_tokens)与它求交。没有交集的输入直接跳过——这一步的 decoder 还没走到那张图的位置。 - 禁止分块的模态输入。如果用户设了
disable_chunked_mm_input,而本步只覆盖了图片的一部分,函数会把解码 token 数回滚到该图片起始位置之前(num_new_tokens = max(0, start_pos - num_computed_tokens)),把图片整体推迟到下一步。原因在源码注释里:编码器通常是双向注意力,一张图切碎算出来的嵌入没有意义。 - 同一步重复。同一个哈希在一批里出现多次时,只跑一次编码,其余记为
duplicate。 - 远端命中。这是 EPD 的分支:
if self.ec_connector is not None and self.ec_connector.has_cache_item(item_identifier): mm_hashes_to_schedule[item_identifier] = num_encoder_embeds external_load_encoder_input.append(i) num_embeds_to_schedule += num_encoder_embeds continue命中远端的图片不扣本地编码预算(encoder_compute_budget 不减),只计入缓存账,并进入「外部加载」列表。这意味着生成实例上,远端命中的图片占用的是「加载时间」,而不是「ViT 计算时间」——后者搬到了编码实例。
不过这一段在源码里被 if not self.is_encoder_decoder: 包着:远端缓存检查目前只对「多模态 decoder」模型成立。encoder-decoder 模型(Whisper、BART 一类)不走这条 has_cache_item 分支,它只按本地的编码预算与缓存槽做分配;这与 EncoderDecoderCacheManager 那句「编码缓存暂未被真正使用,只用于调度」的注释互相印证。读这段代码时不要把两类模型的路径混在一起:is_encoder_decoder 的早期分支会把已计算的编码输入直接跳过,远端命中与去重在当前实现里是 decoder-only 模型的特性。
5. 本地缓存账与预算检查。没命中远端、也不在本地缓存里的图片,要做 can_allocate:当前预算够不够、缓存槽够不够。不够时,若本步尚未走到图片位置就打住(回滚到图片之前),若因为前缀缓存已经把 num_computed_tokens 推过了图片起点,则本步一个 token 都不排(num_new_tokens = 0)。
远端在途时的「让路」
命中远端并不等于嵌入已经就位。调度器在处理 running 队列之前,会先问连接器「哪些编码输入还在路上」:
if ( self.ec_connector is not None and request.mm_features and not self.ec_connector.ensure_cache_available( request, request.num_computed_tokens - request.num_output_placeholders )): req_index += 1 continueensure_cache_available 的契约在基类里写得很清楚:如果所有需要的项都已就绪或根本不用传,返回 True;如果有任意一项还在途中,返回 False,这条请求这一步被跳过(不是报错,而是原地等下一拍)。生成实例在做 prefill 时若某张图的嵌入还没到,对应的解码 token 就无法拼进前向,于是调度器选择「先跑别人」。这种让路是 EPD 能在同一条链路上和纯文本请求共存的前提:纯文本请求不碰 EC 通道,不会被在途的图片拖住。
ensure_cache_available 的默认实现直接返回 True,所以这条检查只在实现了远端预取的连接器上生效。
同一套检查在 waiting 队列里也走了一遍,只是封装成了 _ec_transfer_pending,命中时不是「跳过」而是「把这请求挪到队尾」(skip_request):
def _ec_transfer_pending(self, request: Request, num_computed_tokens: int) -> bool: return ( self.ec_connector is not None and bool(request.mm_features) and not self.ec_connector.ensure_cache_available(request, num_computed_tokens) )running 队列的「跳过」与 waiting 队列的「挪队尾」是有意区分开的:前者已经在跑,只是本步凑不齐输入,让它保持原位即可;后者还没上过 GPU,挪到队尾既不丢位置,又让后面的纯文本请求先被调度。这条细节对延迟很关键——如果新到的图文请求卡在队首等远端嵌入,排在它后面的纯文本请求会跟着被堵住。
编码预算的「退还」
预算是全局的,一步之内多个请求共享。源码里有两处「退还」值得注意:
第一处在抢占路径上。running 队列里的请求因显存不足被抢占时,如果它在本次 step 里已经排了编码输入,调度器要把这些输入的嵌入数加回预算:
preempted_encoder_inputs = scheduled_encoder_inputs.pop(request.request_id, None)if preempted_encoder_inputs: encoder_compute_budget += sum( preempted_req.get_num_encoder_embeds(i) for i in preempted_encoder_inputs )如果请求排了 k 个视觉 token 的编码,却因为 KV 不够被踢出 running,那么这 k 个 token 的预算应该让给后面的请求,而不是白白浪费在一条本步不跑的请求上。
第二处在分配失败路径上:kv_cache_manager.allocate_slots 返回 None 时,请求排不进来,编码缓存上刚 touch 的条目也要退掉:
if new_blocks is None: if request.has_encoder_inputs: self.encoder_cache_manager.free(request) break这两处退让说明「编码预算」在源码里是一个先排、再退的乐观账,而不是一次性决算。
编码器缓存的释放时机
update_from_output 之后,调度器检查每个输入的占位区间是否已经被 decoder 消费完,消费完就释放:
elif start_pos + num_tokens <= request.num_computed_tokens - request.num_output_placeholders: self._free_encoder_input(request, input_id)条件里减去 num_output_placeholders 是为了处理异步调度(第二十九篇讲过的占位符机制):调度器可能已经预支了几个位置,但这些位置的实际 token 还未落定,若草稿被拒,num_computed_tokens 会回滚,而编码器的读取范围也可能跟着回退,所以释放要看「已落定」而非「已预支」的位置。
释放同时会通知连接器:
def _free_encoder_input(self, request: Request, input_id: int) -> None: self.encoder_cache_manager.free_encoder_input(request, input_id) if self.ec_connector is not None: self.ec_connector.update_state_after_free(request, input_id)在生成实例上,「释放」只意味着本地 encoder_cache 里的副本和记账槽被回收;在编码实例上,释放信息也要同步到连接器,因为它的缓存账是自己那份。
请求结束时的一笔交接
请求结束时的顺序在 free_request 附近写得比较特别:先调 ec_connector.request_finished(),再释放编码缓存:
ec_delay_free, ec_xfer_params = self.ec_connector.request_finished(request)...self.encoder_cache_manager.free(request)源码注释解释了这次顺序:request_finished 需要在该请求的编码缓存被释放之前触发,连接器才有机会读取自己在 save_caches() 时记下的 mm_hash 列表,并据此产出回传给客户端的 ec_transfer_params(例如告知前端嵌入存放的位置)。返回值 ec_delay_free 被并入 delay_free_blocks:若连接器还在异步发送这块数据,KV 块与编码缓存就要晚一步释放。
对比一下 KV 侧的对应接口,就会发现 EPD 的这块实现是照着 KV Connector 的形状做的——has_pending_push_work() 的文档里甚至直接写了「This mirrors exactly the KV Connector’s has_pending_push_work()」。这种「同构但不共享代码」的做法,让两个连接器可以各自演进,而调度器中的调用点保持对称。
encoder-decoder 支线:编码器输出如何变成 cross-attention 的 KV
对 encoder-decoder 结构(Whisper、BART 一类),EPD 的实现路径与纯 decoder 模型有一处本质差异,值得单独拆。二者的输入侧不同:
- 多模态 decoder(Qwen3-VL 等):视觉编码器的输出被当作「图像 token 的嵌入」,插进文本序列里参与 prefill。编码器输出是一段 token 嵌入。
- encoder-decoder:编码器吃的是整段输入序列,输出的是每个位置的一列隐藏状态,decoder 的 cross-attention 用它们当 key/value。编码器输出是「一整个序列的 KV 来源」。
vllm/model_executor/layers/attention/cross_attention.py 为此单独实现了一个注意力层 CrossAttention。它的 get_kv_cache_spec 返回 CrossAttentionSpec,而 CrossAttentionSpec.max_memory_usage_bytes 的计算方式是从 max_num_encoder_input_tokens 出发的:
def max_memory_usage_bytes(self, vllm_config: VllmConfig) -> int: # For cross-attention, we need to cache encoder states # Get encoder length (e.g., 1500 for Whisper). max_encoder_len = vllm_config.scheduler_config.max_num_encoder_input_tokens return cdiv(max_encoder_len, self.block_size) * self.page_size_bytesWhisper-large-v3 的 max_source_positions 是 1500——也就是 30 秒音频在 16 kHz 下经两段卷积下采样后得到的编码器位置数。因此 cross-attention 的 KV 池按「1500 个编码器 token」预留,而不是按解码长度。这也意味着在 EPD 里,生成实例的显存预算里仍然要为 cross-attention KV 留一块,跨实例搬运的只是编码器输出,不是 cross-attention KV。
cross-attention 的 KV 只写一次
CrossAttention 在构造时用 _get_underlying_attention_backend(attn_type=AttentionType.ENCODER_DECODER) 取得底层后端,再用 create_cross_attention_backend 包一层。被包装的 CrossAttentionBuilder.build() 做了一件纯 decoder 注意力不会做的事:
new_metadata.causal = Falsequery_lens_cpu = (query_start_loc_cpu[1:] - query_start_loc_cpu[:-1])num_computed_tokens_cpu = seq_lens_cpu_upper_bound - query_lens_cpunum_cache_decodes = (num_computed_tokens_cpu > 0).sum().item()if num_cache_decodes > 0: # CrossAttn KV cache has already been populated on first decoder step, # skip slot_mapping calculation for requests that do not need reshape_and_cache. new_metadata.encoder_seq_lens_cpu = np.where( num_tokens > 0, 0, new_metadata.encoder_seq_lens_cpu)new_metadata.seq_lens = common_attn_metadata.encoder_seq_lensnew_metadata.seq_lens_cpu_upper_bound = torch.from_numpy(common_attn_metadata.encoder_seq_lens_cpu)逐句读:
causal = False:cross-attention 的 query 是 decoder 的当前 token,key/value 是整段编码器输出,不存在因果掩码——每个解码位置都能看到全部编码器状态。num_computed_tokens_cpu > 0识别出「这是解码步」。只有第一个解码步需要把编码器状态写进 cross-attention KV;之后的每一步,KV 已经在池子里,编码器输出只剩「读」。- 对已经写过 KV 的请求,把
encoder_seq_lens_cpu置零。置零之后_get_cross_slot_mapping会跳过它,reshape_and_cache不再重写。 seq_lens与seq_lens_cpu_upper_bound被替换成编码器长度——这是注意力内核读取 key/value 长度的来源。
_get_cross_slot_mapping 本身也值得看一眼,它把「第几个编码器 token」映射到「KV 池里的第几个槽」:
active_indices = np.nonzero(encoder_seq_lens)[0]for req_index in active_indices: encoder_seq_len = encoder_seq_lens[req_index].item() num_blocks_needed = cdiv(encoder_seq_len, block_size) needed_block_ids = block_table_tensor[req_index][:num_blocks_needed] i_values = torch.arange(encoder_seq_len, dtype=torch.int64, device=device) block_indices = i_values // block_size block_offsets = i_values % block_size block_numbers = needed_block_ids[block_indices] slot_mapping = block_numbers * block_size + block_offsets这是一段「按请求逐个展开」的循环,不是向量化实现;源码注释给的理据是:并行请求里绝大多数已经在解码,真正需要写 cross-attention KV 的只占少数,active_indices 通常很短,所以循环的代价可以忽略。
调度端的一次性分配
cross-attention 的块分配在调度器里也是「一次性的」。KVCacheCoordinator.get_num_blocks_to_allocate 对 CrossAttentionManager 单独分支:
if isinstance(manager, CrossAttentionManager): # For cross-attention, we issue a single static allocation # of blocks based on the number of encoder input tokens. num_blocks_to_allocate += manager.get_num_blocks_to_allocate( request_id, num_encoder_tokens, [], 0, 0, num_encoder_tokens, apply_admission_cap=apply_admission_cap)注意它传给管理器的第一个 token 数是 num_encoder_tokens 而不是 num_tokens——cross-attention 组的块数只跟编码器长度有关。调度器在 running 队列里只在「本步确实排了编码输入」时才算这个数:
num_encoder_tokens = 0if (self.is_encoder_decoder and request.has_encoder_inputs and encoder_inputs_to_schedule): num_encoder_tokens = sum(request.get_num_encoder_embeds(i) for i in encoder_inputs_to_schedule)也就是说,每个请求的 cross-attention 池在它第一次排编码的那一步一次分配到位,后续解码步不再申请。allocate_slots 的文档字符串里对 num_encoder_tokens 的解释是「The number of encoder tokens to allocate for cross-attention in encoder-decoder models (e.g., Whisper). For decoder-only models, this should be 0.」
CrossAttentionManager 还有几条「故意不做」:add_local_computed_blocks 断言 new_computed_blocks 为空;cache_blocks 直接抛 ValueError("Should not be called as prefix caching is disabled.");find_longest_cache_hit 抛 NotImplementedError。注释里的三条理由很清楚:编码器状态按请求唯一(不同图像/音频)、每个请求只计算一次而非增量计算、不同多模态输入之间不存在可复用前缀。这三条与第十三篇里「没有前缀缓存时编码器输出缓存按请求独立持有」是同一件事的两面。
编码器执行与 encoder_outputs
encoder-decoder 模型的编码器在 _preprocess 里执行,位置放在「决定输入形态」之后:
if is_encoder_decoder and scheduler_output.scheduled_encoder_inputs: # Run the encoder, just like we do with other multimodal inputs. # For an encoder-decoder model, our processing here is a bit # simpler, because the outputs are just passed to the decoder. # We are not doing any prompt replacement. We also will only # ever have a single encoder input. encoder_outputs = self._execute_mm_encoder(scheduler_output) model_kwargs.update({"encoder_outputs": encoder_outputs})这段注释恰好点出了与多模态 decoder 的三处不同:不需要做 prompt 替换(编码器输出不进 token 序列)、只会有一个编码输入(调度器初始化时断言 len(mm_budget.mm_max_toks_per_item) <= 1)、编码器输出直接通过 model_kwargs 传给模型。在 EPD 里,这三条正好对应「consumer 拿到的嵌入来自远端」的简化:生成实例的 encoder_outputs 是远端读回来的,编码器本地不跑。
CUDA Graph 的边界
解码步能不能进全量 CUDA Graph,取决于这一批里有没有编码器输出。_determine_batch_execution_and_padding 里:
has_encoder_output = (self.model_config.is_encoder_decoder and num_encoder_reqs > 0)...cudagraph_mode, batch_descriptor = dispatch_cudagraph( num_tokens, disable_full=has_encoder_output)带着编码器输出的那一步被禁用 FULL 模式,只能走 eager 或 piecewise。这与后面「三个硬约束」里那条「encoder-decoder 模型的 CUDA Graph 只做解码段的全量捕获」是同一机制的两处表述:形状取决于编码器输出的步不能冻成静态图。
encoder_seq_lens 的填充与捕获期
解码步要告诉注意力内核「这一批里每条请求的编码器输出有多长」。_get_encoder_seq_lens 的实现很短,但有两处要点:
self.encoder_seq_lens.np[:num_reqs] = 0for req_id in num_scheduled_tokens: req_index = self.input_batch.req_id_to_index[req_id] req_state = self.requests[req_id] if req_state.mm_features is None: self.encoder_seq_lens.np[req_index] = 0 continue encoder_input_tokens = sum( feature.mm_position.length for feature in req_state.mm_features) self.encoder_seq_lens.np[req_index] = encoder_input_tokensif for_cudagraph_capture: max_encoder_len = getattr(self.model_config.hf_config, "max_source_positions", self.max_encoder_len) self.encoder_seq_lens.np[:num_reqs] = max_encoder_len第一处要点:填充的是 mm_position.length 之和,而不是 get_num_embeds()。对 encoder-decoder 模型,is_embed 一般为空、两者相等;这个选择与「不替换 prompt」是自洽的——decoder 需要的是编码器序列的完整长度。
第二处要点:捕获 CUDA Graph 时,所有请求位置都填 max_source_positions(Whisper 是 1500),而不是真实长度。原因是 max_seqlen_k 是图捕获时固定下来的参数,如果捕获期用真实长度,回放时遇到更长的编码器输出就会越界。用模型允许的最大源长度捕获,等于把「最大可能的 key 长度」写进图里;代价是捕获的那张图对更短的编码器输出并不最优,却保证正确。这也是为什么 encoder-decoder 模型的 CUDA Graph 被限制在 FULL_DECODE_ONLY——capture 时的形状规则性只对解码段成立。
EPD 在这里的落点
把 encoder-decoder 的三段连起来看,EPD 的拆分点很清楚:
CrossAttentionSpec的池按编码器长度预留,块在首次编码的那一步一次分配;- 编码器输出在第一次解码步被写进 cross-attention KV,之后只读;
- CUDA Graph 只覆盖「不带编码器输出」的解码步。
因此「把编码器搬到别的实例」对生成实例来说,改变的只是「编码器输出从哪来」:本地 _execute_mm_encoder 换成了远端加载,model_kwargs["encoder_outputs"] 的提供者变了,其余路径——cross-attention KV 的写入、encoder_seq_lens 的填充、CUDA Graph 的禁用条件——都不变。这种「变换点单一」的设计,是多模态 decoder 与 encoder-decoder 能在同一套 EC 连接器上共用实现的原因。
从像素到嵌入:两侧各自看到了什么
编码侧:请求带着像素来,带着哈希走
编码实例收到的是完整的多模态请求,它做两件事:
- 预处理 + 编码。与第十三篇里的本地编码路径相同:
_execute_mm_encoder按模态分组,调用model.embed_multimodal(**mm_kwargs_batch)得到每个图片项的嵌入序列,然后sanity_check_mm_encoder_outputs校验输出项数。 - 写回远端。对每个
mm_hash调用:
self.encoder_cache[mm_hash] = outputself.maybe_save_ec_to_connector(self.encoder_cache, mm_hash)maybe_save_ec_to_connector 在 EC 传输已初始化时调用连接器的 save_caches(encoder_cache, mm_hash),把这一项的嵌入推送到远端存储。
写入的时机不止「编码刚完成」。V1 新版在 producer 上把 start_save_caches 提到前向之前,并把 encoder_cache 显式传进去,注释里写了一个容易被忽略的情况:某个图片在更早的 step 已经编码并缓存,本步不会重新编码,于是 save_caches 不会为它触发——但 producer 仍需要把这项发布出去。这正是编码实例作为「缓存服务」而非「流水线」时必须补的口子。
生成侧:请求带着哈希来,嵌入由远端补齐
生成实例的请求里没有像素,只有 mm_features(每个项的哈希、位置偏移、长度、嵌入数)与占位符 token。它在前向之前需要嵌入就位,这个动作由三个地方共同完成:
- 调度器:
external_load_encoder_input让连接器知道本步要读哪些项; - 连接器元数据:
build_connector_meta(scheduler_output)把本步读写计划编成ECConnectorMetadata,挂到scheduler_output.ec_connector_metadata上; - worker:在
execute_model的 EC 上下文管理器里,bind_connector_metadata→start_load_caches,把远端嵌入读进encoder_cache,然后_gather_mm_embeddings像本地命中一样取出来。
第 3 步的上下文管理器在 vllm/v1/worker/ec_connector_model_runner_mixin.py:
@contextmanagerdef _get_ec_connector_output(scheduler_output, encoder_cache, **kwargs): output = ECConnectorOutput() ec_connector = get_ec_transfer() ec_connector.bind_connector_metadata(scheduler_output.ec_connector_metadata)
if ec_connector.is_producer: ec_connector.start_save_caches(encoder_cache=encoder_cache, **kwargs)
if ec_connector.is_consumer: ec_connector.start_load_caches(encoder_cache, **kwargs)
try: yield output finally: output.finished_sending, output.finished_recving = ( ec_connector.get_finished(scheduler_output.finished_req_ids) ) output.ec_connector_worker_meta = ec_connector.build_connector_worker_meta() ec_connector.clear_connector_metadata()读这段要抓三个结构点。
第一,producer 与 consumer 的分支同处一个上下文。ec_both 的实例两侧都会走;encode-only 只走 producer 分支;纯生成实例只走 consumer 分支。
第二,加载发生在前向之前,回收发生在之后。finally 块里的 get_finished 返回两个集合——已经完成的发送与接收。这两个集合回传调度器后,调度器才能知道某条请求的「在途」状态发生了变化,从而允许它在下一步被调度。这里的设计与 KV 连接器的「挂起-完成」语义一致,只是对象换成了嵌入。
第三,worker 元数据是有聚合语义的。ECConnectorWorkerMetadata.aggregate 的文档说,一个 step 里每个 worker 都可以输出自己的元数据,这些元数据在回传调度器之前会被逐级聚合。EPD 在多卡(TP/PP)部署时,一次 step 的 EC 状态可能是多个 worker 的并集,因此聚合不是可选项。
嵌入回填:与本地路径复用同一套代码
生成实例拿到远端嵌入后,后续路径与本地编码完全一致。_gather_mm_embeddings 用 req_state.num_computed_tokens 与 num_scheduled_tokens 切出本步需要的那一段,写入 inputs_embeds 的对应位置;is_mm_embed 掩码标出哪些位置来自图像,供 embed_input_ids 混合查表与嵌入。
这种「同一套回填」是有意为之:EPD 在模型层不引入任何新语义,模型本身不知道嵌入来自本地 ViT 还是远端存储。它也让「部分编码、部分命中」的请求变得自然——一个请求里图 A 命中远端、图 B 需要本地编码,两者在 _gather_mm_embeddings 看到的是同一类对象。
不过,_gather_mm_embeddings 里有一处断言值得单独看:
encoder_output = self._get_encoder_output_from_cache(mm_hash)if encoder_output is None: if start_pos >= req_state.num_computed_tokens + num_scheduled_tokens: continue raise RuntimeError(f"Encoder cache miss for {mm_hash}.")前半句是为投机解码(第四十类草稿)的「+1 前瞻」留口子:草稿器可能读到尚未编码的图片前缀位置,这时退回 token embedding,不报错。后半句则是硬约束:既然已经排进了本步,嵌入就必须在。它把「调度器说可以排」和「worker 真的有嵌入」之间的不一致直接暴露成一个错误,而不是静默地用错误数据算下去。
V2 执行器的对应位置
V2 模型执行器把多模态部分收进了 vllm/v1/worker/gpu/mm/:EncoderRunner 承担编码与回填(execute_mm_encoder、gather_mm_embeddings、get_inputs_embeds),EncoderCache 承担按请求的缓存增删。EC 连接器的 mixin 在 V2 上仍然是同一份——这符合 vLLM 近几轮重构的方向:把「是什么」(编码器执行)和「怎么传」(connector)继续拆开,V1 与 V2 共享后者。
跨实例的边界条件
三个硬约束
EPD 不是「随便开开就行」的特性。源码里有三个明确的约束:
- encoder-decoder 模型不做 chunked prefill。
SchedulerConfig.__post_init__在is_encoder_decoder时设置disable_chunked_mm_input = True、enable_chunked_prefill = False,日志里写明 encoder-decoder 模型既不支持分块预填充也不支持前缀缓存。这条约束同时是第十三篇里那条「编码器输出缓存 → decoder KV 缓存」接力机制的原因之一:没有前缀缓存,解码侧的 KV 只能按请求独立持有。 - encoder-decoder 模型的 CUDA Graph 只做解码段的全量捕获。配置解析里若
cudagraph_mode不是NONE也不是FULL_DECODE_ONLY,会被强制改成FULL_DECODE_ONLY。原因是带编码输入的 prefill 步形状不固定,而解码步的形状相对稳定。 - Dual Batch Overlap 与多模态模型互斥。
_get_unsupported_dbo_reasons里把is_multimodal_model与is_encoder_decoder都列为不支持项,注释说明 DBO 只捕获 FULL 图,多模态的输入侧无法放进静态图中。
这三条约束背后是同一种张力:多模态输入让前向的形状与时机变得不规则,而 CUDA Graph、分块预填充、重叠批处理都依赖规则性。EPD 的做法是把不规则的那段(编码)移走,让生成实例的前向回到规则形状——这与上面几篇里「把动态的东西静态化」的主线一致。
远端失败的语义
基类里有一个接口 take_unavailable_requests(),注释很短:「Request IDs whose encoder inputs the connector can no longer obtain. The Scheduler fails these; re-issuing the request re-runs the encode.」
在 V1 新版调度器的错误汇总处:
error_req_ids.update(self.encoder_cache_mismatch_reqs)...if self.ec_connector is not None: error_req_ids.update(self.ec_connector.take_unavailable_requests())if error_req_ids: error_reqs = self.finish_requests(error_req_ids, RequestStatus.FINISHED_ERROR)它把 EC 侧的失败并入与语法编译失败相同的错误通道:请求以 FINISHED_ERROR 结束,客户端重新提交即可重跑编码。这个选择意味着 vLLM 没有在引擎内部实现「缺图自动重编码」——重跑的责任交给了调用方。从工程上看,这比在调度循环里猜「是不是该重新编码」更容易解释,也避免了编码实例与生成实例之间隐藏的重试放大。
另一个相关接口是 update_state_after_free:它在生成实例释放本地副本时通知连接器,让连接器决定远端项的引用计数与淘汰。远端存储的淘汰策略由具体连接器实现(例如 Mooncake 的 cross_encoder_cache 会在编码前查询 Store),vLLM 只规定「什么时候告诉它」——分配后、释放后、请求结束后。
与 KV Connector 的对照
EC Connector 很容易被当成「KV Connector 的另一个实例」,两者确实共享一套接口形状,但拆开看有六处实质差异:
| 维度 | EC Connector | KV Connector |
|---|---|---|
| 传输对象 | 编码器输出的 token 嵌入 | 注意力层的 K/V 块 |
| 缓存键 | 多模态内容哈希(identifier) | 前缀 token 哈希(block hash) |
| 生产时机 | 每张图/音频项编码完成时 | 每个 prefill 块计算完成时 |
| 消费时机 | 生成实例 prefill 之前 | 生成实例 prefill/decode 之前 |
| 共享范围 | 跨请求、跨用户,同一内容一份 | 同前缀的请求之间 |
| 与模型结构的关系 | 编码器可以是独立模型/独立实例 | 必须与目标模型的层结构一致 |
最关键的一行是「缓存键」:EC 的键来自内容,所以一张图算一次可以服务所有请求;KV 的键来自前缀 token,所以只有前缀完全相同的请求才能复用。这也解释了两者的失效方式不同:EC 的失效是「同一标识符被用于不同内容」,KV 的失效是「前缀哈希碰撞或块回收」。前者的防护是 encoder_cache_mismatch 检查,后者的防护是 block hash 与引用计数。
接口形状的相似之处则集中在调度侧:两者都要在 SchedulerOutput 上挂一份元数据(kv_connector_metadata / ec_connector_metadata),都要在 worker 的 execute_model 前后完成 bind/finish,都要通过 request_finished 在释放资源前交接,也都有 has_pending_push_work 让引擎在主循环里多跑几拍等待传输完成。这种对称性不是巧合——它们解决的是同一类问题:把一个跨实例的中间状态,接进一个原本单实例的调度循环。
两种编码器缓存管理器
vllm/v1/core/encoder_cache_manager.py 里有两个类,名字很像,语义却不同:
EncoderCacheManager:面向多模态模型。它按mm_hash去重,同一个图片项被多个请求引用时只占一份槽位;cached记录每个哈希被哪些请求引用,引用集合为空时才进入freeable,分配新条目时优先淘汰这些无引用的旧条目。这是「远端共享缓存」在调度器侧的账本。EncoderDecoderCacheManager:面向 encoder-decoder 模型。它的check_and_update_cache直接返回False,can_allocate只检查预算与剩余槽位,不做跨请求去重;get_freed_mm_hashes用to_free/allocated两个列表轮转,返回的是上一轮分配的哈希。
第二处的轮转是为了配合释放时机。EncoderDecoderCacheManager.get_freed_mm_hashes 的注释写得很清楚:encoder-decoder 的编码缓存「不被使用」,真正释放发生在 runner 里、模型执行之前;因此 to_free 充当一个缓冲,让条目在「产生它的那一步执行完之后」才被删掉,而不是在产生它的同一步就被删。这个时序如果搞反,就会出现「本步刚编码完的嵌入,在本步前向之前被释放」的悬空引用。
源码里还有一条注释值得注意:EncoderDecoderCacheManager 是「临时实现,只把管理器用于调度目的;encoder-decoder 模型最终会用上缓存,届时这个类会并入 EncoderCacheManager」。也就是说,当前 EPD 的跨请求缓存能力主要面向多模态 decoder 模型;encoder-decoder 的远端缓存是「能传、但还不做跨请求去重」的状态。读源码时不要把两者混为一谈。
缓存一致性的一个「坑」:哈希复用
调度器里有一处告警,是 EPD 部署时最容易踩到的:
def _reject_on_encoder_cache_embed_mismatch(self, request, input_id, identifier, cached_num_encoder_embeds, requested_num_encoder_embeds): if cached_num_encoder_embeds == requested_num_encoder_embeds: return False logger.warning( "Encoder cache entry for multimodal identifier %r holds %d embeddings, " "but request %s input %d expects %d. A client-provided multimodal UUID " "may have been reused for different content.", ...) self.encoder_cache_mismatch_reqs.add(request.request_id) return True代码检查的不是内容的哈希,而是嵌入数。若客户端自己传了多模态 UUID 作为 identifier,并且把同一个 UUID 用在了内容不同的两张图上,那么第二次编码得到的嵌入数可能与缓存里那份不一致,调度器随即把该请求判为 encoder_cache_mismatch 并以错误结束。
这条告警折射出 EPD 的一个隐含契约:identifier 必须与内容一一对应。客户端自己指定标识符时,要保证「同内容同标识、不同内容不同标识」,否则编码实例与生成实例之间的缓存就会出现串味。这也是一个跨实例系统比单实例系统更难发现的故障——本地缓存里两个用户之间的小错位,在远端共享存储里会被放大成跨请求污染。
一张图把 EPD 的请求路径串起来
把上面的机制按时间轴排一遍。假设一条请求带两张图,图 A 在远端已有缓存,图 B 需要新编码,1 个编码实例、3 个生成实例:
t0 代理:收到请求,按图切出 N 个编码任务,把像素发到编码实例; 同时把「图片哈希 + 占位符」的原始请求留到编码完成后再转发。
t1 编码实例 - 调度器: 图 B 进入 waiting,_try_schedule_encoder_inputs 计入编码预算; kv_cache_manager.allocate_slots(num_encoder_tokens=len_B) 为 cross-attn 预留块; _allocate_encoder_inputs → ec_connector.update_state_after_alloc。
t2 编码实例 - worker: maybe_get_ec_connector_output 绑定元数据 → start_save_caches; _execute_mm_encoder 编码图 B → encoder_cache[hash_B] = emb_B; save_caches 把 emb_B 写入远端。
t3 生成实例 - 调度器: 请求到来,图 A 命中远端(has_cache_item → external_load_encoder_input); 图 B 的项可能仍在途 → ensure_cache_available 返回 False,本步跳过。
t4 生成实例 - worker(B 到达后): start_load_caches 把 emb_A、emb_B 读进 encoder_cache; _gather_mm_embeddings 按本步范围切片 → 回填 inputs_embeds; prefill → 采样 → 解码。
t5 生成实例 - 调度器: 占位区间被 decoder 消费完 → _free_encoder_input → update_state_after_free; 请求结束 → request_finished 在释放前产出 ec_transfer_params。这张时间轴把本篇几个分散的机制连成了一条线:编码实例负责「算 + 写」,生成实例负责「读 + 用」,调度器负责「记账 + 让路 + 交接」,连接器负责「把记账变成读写」。与 KV 的 P/D 分离放在一起看,两者的结构是同构的:一个拆的是生成阶段(prefill vs decode),一个拆的是输入阶段(encode vs decode),共同点是把不同计算特征的工作放到不同实例上,用远端存储作为交接面。
部署形态与容量算术
三段流水线的稳态
把 EPD 看成一个三阶段流水线:编码(E)、预填充(P)、解码(D)。设请求到达率为 (请求/秒),每个请求平均带 张图,单张图的编码时间为 ,编码实例数为 ;单个生成实例的 prefill 与 decode 服务率分别为 、。忽略网络与排队,系统能长期稳定的条件是每一段的产能都不低于需求:
第一个不等式是 EPD 新增的约束:编码段的产能由「编码实例数 / 单图编码时间」决定,而不是由生成实例的剩余算力决定。没有 EPD 时,编码与 prefill/decode 共用 组卡,第一式变成 一类的混合约束,资源比例被钉死;EPD 之后, 与 可以各自按上式调节。
TTFT 的分解
一条多模态请求的 TTFT 可以写成三段之和:
其中 是编码队列等待, 是 prefill 队列等待, 与 是实际计算时间。EPD 的收益主要落在 与 上:
- 编码实例只跑编码, 不再被解码请求挤占;
- 纯文本请求绕过编码段, 不受图片任务影响;
- 编码与上一请求的解码可以重叠,流水线的稳态吞吐由最慢一段决定,而不是三段之和。
反过来,EPD 也引入了一跳额外的传输:编码输出写入远端、生成实例再读回。这个传输时间不在上面的公式里显式出现,而是被 ensure_cache_available 的「在途让路」吸收进了 ——请求在嵌入到达前不进入 prefill,等待时间体现为 prefill 队列的延迟,而不是一次阻塞式的读取。
为什么基准是 1E3PD
博客的基准配置是 1 个编码实例 + 3 个生成实例,这个比例不是通用规则,而是该实验负载下的一个可行点。按上面的产能式,编码段与生成段的比例大致是:
图片越多、单图编码越慢,编码实例的占比就越高;文本越长、解码越重,生成实例的占比就越高。真正部署时要先测出 、、 与平均图片数 ,再按目标 QPS 反推两侧的实例数,而不是照搬某个固定比例。
缓存命中改变了什么
如果编码实例接入跨请求缓存,设图片内容命中率为 ,则编码段的实际计算需求从 降到 ;但读方向的数据量仍然是 (每个请求仍要取回嵌入),除非生成实例本地也缓存了这份嵌入。所以缓存命中主要省的是编码算力,不是传输带宽。反过来,如果生成实例的 encoder_cache 命中(同一实例短时间内重复收到同一张图),读也可以省掉——_gather_mm_embeddings 直接读本地字典,不经过连接器。这两种命中在容量规划里要分开算。
什么时候该用 EPD
结合机制与官方数据,可以整理出几条判断:
适合的负载:多图请求比例高、图片尺寸与数量差异大、图文混合并发。这类负载下编码开销占比大,且对纯文本请求的干扰最明显。EPD 的首要收益是消除交叉干扰与尾部延迟抖动,其次才是吞吐。
收益递减的情形:长文本、单图、编码开销占比小的解码主导负载。官方数据里长文本场景仍有 2–2.5 倍 goodput,但机制上它主要来自「纯文本不被图片拖住」与「编码实例独立伸缩」,若请求几乎都是短文本长输出,收益主要落在端到端延迟而非吞吐。
部署代价:多了一组编码实例、一套远端存储与 EC 连接器。编码实例不分配 KV,显存可以全给权重与编码器;但远端存储的带宽与容量要按「视觉 token × hidden × 字节」估算,并且要规划缓存淘汰策略。跨实例传输本身增加了一跳延迟,ensure_cache_available 的「在途让路」把这一跳藏进了调度,而不是把它变成阻塞。
与 P/D 分离组合:EC 与 KV 两个连接器在调度器里是相互独立的字段(kv_connector_metadata 与 ec_connector_metadata),KV 消费者可以配合 allow_missing_mm_embeddings 接受「只有嵌入、没有像素」的请求。两者组合后的完整拓扑(编码 → 预填充 → 解码三段分离)在请求形状上是一致的,只是交接物从嵌入换成了 KV。
最后回到本篇最核心的一句话:EPD 把「编码器输出」当作一份可以远程共享的数据,而不是生成实例前向的一部分。正因为它是数据,才能被缓存、被去重、被独立扩容、被跨实例传输;也正因为它是数据,才需要一套与 KV 连接器同构的调度契约来界定「谁在什么时候拥有它」。读懂 EC Connector,本质上是在读 vLLM 如何为一类「不是 KV、却同样跨实例流动」的中间数据设计生命周期。
延伸阅读:
- vLLM 源码完全拆解(十三):多模态输入——从图像预处理到 Placeholder Range 嵌入——本篇的编码器缓存、预算与回填路径在那篇里逐层展开;
- vLLM 源码完全拆解(十七):KV Connector——P/D 分离中 KV 缓存如何跨实例传输与接管调度——EC Connector 在接口形状上与它同构;
- vLLM 源码完全拆解(二十九):异步调度——
num_output_placeholders对编码缓存释放时机的影响在那一篇有完整背景; - SGLang 源码完全拆解(十四):多模态输入——图像如何在文本流里占位、编码与回填——另一套框架在单机内的同类设计。
小结
vLLM 的编码器分离把视觉编码搬到独立实例:编码实例只跑 ViT、不分配 KV,把嵌入写进远端;生成实例收到「图片哈希 + 占位符」,通过 EC Connector 在 execute_model 前把嵌入装进 encoder_cache,再走与本地编码相同的回填路径。调度器用 _try_schedule_encoder_inputs 的五元组把「本地编码、远端加载、重复跳过」分开记账,用 ensure_cache_available 让在途请求原地等一拍,用 request_finished 在释放缓存前完成交接。这套机制与 KV 连接器同构,是 vLLM 把「跨实例中间数据」抽象成统一契约的一次延展。
参考资料
- Encoder Disaggregation for Scalable Multimodal Model Serving(vLLM 官方博客,2025-12-15)(文中图 1、图 2 出处)
- vLLM 源码:
vllm/distributed/ec_transfer/ec_connector/base.py(ECConnectorBase 与两侧原语) - vLLM 源码:
vllm/distributed/ec_transfer/ec_connector/factory.py(连接器注册与创建) - vLLM 源码:
vllm/distributed/ec_transfer/ec_connector/mooncake_ec_connector.py(Mooncake 实现门面) - vLLM 源码:
vllm/distributed/ec_transfer/ec_connector/example_connector.py(共享文件系统实现) - vLLM 源码:
vllm/config/ec_transfer.py(ECTransferConfig 与角色语义) - vLLM 源码:
vllm/v1/core/sched/scheduler.py(_try_schedule_encoder_inputs、ensure_cache_available与释放路径) - vLLM 源码:
vllm/v1/worker/ec_connector_model_runner_mixin.py(worker 侧 EC 上下文) - vLLM 源码:
vllm/v1/worker/gpu_model_runner.py(encoder cache、_gather_mm_embeddings与get_kv_cache_spec) - vLLM 源码:
vllm/v1/core/encoder_cache_manager.py(EncoderCacheManager 与 EncoderDecoderCacheManager) - vLLM PR #25233:encoder disaggregation 的原生实现
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



