


词表维上的并行账:嵌入查表、LM Head 切分与 logits 收集的跨框架拆解
一个 token 的两次跨卡旅行
一次 LLM 推理,从外面看只有两个动作:文本进来,文本出去。但在设备侧,这两端都要经过词表维——一个宽度等于词表大小的维度。
输入端是 token embedding。用户输入被分词成 id 序列,模型用这些 id 去一张 [vocab_size, hidden_size] 的表里取行,得到 [num_tokens, hidden_size] 的隐状态。输出端是 LM head。最后一层的隐状态乘以同一张形状的矩阵(转置),得到 [num_samples, vocab_size] 的 logits,采样器再从这一行几万个分数里挑出一个 token。
两个操作的数学形式非常接近,都是”查表”与”矩阵乘”,但计算特征完全相反:
- Embedding 是稀疏访问。一个 batch 有 个 token,只碰 行权重,其余十几万行一次都不读。它的瓶颈是访存,不是算力。
- LM head 是稠密计算。每一行 hidden state 都要和整个词表矩阵相乘, 次浮点运算,一分不少。
当模型被切到多张卡上时,这两端立刻暴露出同一个问题:词表维该不该切? hidden 维的切法已经有一套成熟答案——每个 rank 算一部分列,算完做一次 all-reduce,大家得到完整的 hidden。词表维不行。token id 是一个整数坐标,它在全局只属于一个 rank;词表的分片意味着”编号 0 到 16159 归 rank 0,16160 到 32319 归 rank 1”,一个 rank 手里只有自己那一段 id 的行。
这就带来三个必须在设计里解决的不变量:
- 所有权不变量:每个 token id 有且只有一个 rank 持有它的 embedding 行。查表时,非所有者必须查到一个零向量,而不是越界或查错行。
- 坐标不变量:lm_head 分片产出的 logits 是”局部列区间”,采样之前必须把它还原成与全局 token id 一一对应的坐标。这一步不是简单拼接,因为 padding 与 LoRA 追加词表会把列顺序打乱。
- 归一化不变量:softmax 的分母是整个词表的指数和。词表被切开后,“每个 rank 各自算 softmax”在数学上是错的,必须先合并分母。
围绕这三条不变量,五个主流框架给出了五种不同的工程答案。它们的差异不在数学,而在并行拓扑把哪一维切开了,以及愿意为一次集合通信付多少钱。
先把账算清楚:129280 × 5120 有多重
后面所有设计取舍都建立在这几个数字上。以 DeepSeek-V4.1-Flash 为例,vocab_size = 129280、hidden_size = 5120、tie_word_embeddings = false,也就是 embedding 和 LM head 是两张独立的矩阵。
单张矩阵的 BF16 体积:
两张合计约 2.47 GiB。这个数字本身不算惊人,但把它放到并行拓扑里,差异就出来了:
| 项目 | 单卡 | TP=8 分片 | 备注 |
|---|---|---|---|
| 词表矩阵(每张) | 1.23 GiB | 157.8 MiB | 分片省下约 1.07 GiB/卡 |
| 每卡两份矩阵合计 | 2.47 GiB | 315.6 MiB | 全复制时 8 卡共多占 8.6 GiB |
| BF16 logits,256 行 | 63.1 MiB | 7.9 MiB | 每卡只算自己那段列 |
| FP32 logits,256 行 | 126.2 MiB | 15.8 MiB | 采样通常升到 FP32 |
| FP32 logits,1024 行 | 504.8 MiB | 63.1 MiB | 投机解码验证行数会翻几倍 |
再看通信。词表分片之后,embedding 查表要把各 rank 的贡献加起来,这一步是 all-reduce。设一步里有 个 token(prefill 时是整段 prompt,decode 时是 batch 大小),每个 token 的隐状态是 个 BF16 元素,则一次 all-reduce 的原始数据量是:
Ring all-reduce 每个 rank 的收发量约为:
代入 、、: MB,每卡约 146.8 MB。按 300 GB/s 的有效互联带宽估算,光这一次 all-reduce 就要接近 0.5 ms。prefill 阶段每层都要做一次,几十层叠加起来是毫秒级的固定开销。
LM head 侧的账更微妙。它不 per-layer,只在最后算一次,但它的计算量随 batch 线性增长:
时约 339 GFLOP; 时约 678 GFLOP。按 600 TFLOPS 的有效吞吐,单是 LM head 就要 0.56 到 1.13 ms。相比之下,一次 decode step 里每层注意力和 MoE 的权重读取才是大头,但 head 这一刀能占到几个百分点,且它是串行链路的最后一环,直接压在 TTFT/TPOT 上,无法被前面的计算掩盖。
最后是 logits 的落地成本。采样器拿到的不是一个抽象分布,而是一块真实显存:
时是 505 MB。在显存紧张的部署里,这块缓冲甚至比一份 KV 池的分片还大。SGLang 的源码里就留了一句很直白的注释:跳过 LM head 就能省掉一次 [batch * num_dp_ranks, vocab] 的 all-gather,而那次 all-gather 在 DP attention 的显存预算下会 OOM。
账算到这里,五种做法的动机已经能猜到大半:vLLM 和 SGLang 选择切词表、再想办法把 logits 收回来;TensorRT-LLM 把”切”与”不切”做成一个开关;llama.cpp 因为根本没有张量并行而不切;DeepInfer 则因为并行拓扑切在别处,索性把整张词表复制到每个 rank。下面逐个看它们的源码。
vLLM:词表分片、掩码查表与 all-reduce
vLLM 是这套做法的”教科书版本”,也是 DeepInfer 那 30 行代码的注释里明确写着的来源(Derived from vLLM)。它的实现分布在 vllm/model_executor/layers/vocab_parallel_embedding.py 与 vllm/model_executor/layers/logits_processor.py 两个文件。
为什么先 pad 再切
词表大小往往不是 TP 度的整数倍。129280 除以 8 恰好整除,但绝大多数模型没这么巧。vLLM 的做法是在构造时把词表补齐到 64 的倍数:
DEFAULT_VOCAB_PADDING_SIZE = 64
def pad_vocab_size(vocab_size: int, pad_to: int = DEFAULT_VOCAB_PADDING_SIZE) -> int: return ((vocab_size + pad_to - 1) // pad_to) * pad_to补到 64 的倍数,再除以 TP 度,就能保证每个 shard 大小一致,GEMM 的 N 维也落在对齐边界上。补出来的那几行权重不参与真实 token,但在数学上必须有值——通常是零——否则采样时要额外做一次越界判断。
更复杂的是 LoRA。vLLM 支持运行时挂载 LoRA adapter,而 LoRA 可以带来额外词表(新增 token)。这些 token 的 embedding 不在基础权重里,加载顺序也不可控。vLLM 因此把词表划分成两段:基础词表与追加词表,两段各自 pad、各自切分,然后在同一个张量里首尾相接。源码里那张 ASCII 示意图讲得很细:
TP2, rank 0:|< --------------------BASE--------------------- >|<-LORA-->|<-LORA PAD->|| 0 | 1 | ... | 497 | 498 | ... | 511 | 1010 | ... | 1025 | -1 | ... |这样做的好处是:无论基础词表怎么 pad,LoRA 新增的 id 永远落在张量末尾,加载器只需要知道两段各自的起止下标,不需要重新排列已有权重。
掩码查表:非所有者的行必须变成零
VocabParallelEmbedding.forward 面对的第一件事,是把全局 id 翻译成”本 rank 的局部 id”,并把不属于本 rank 的 id 屏蔽掉:
org_vocab_mask = (input_ >= org_vocab_start_index) & (input_ < org_vocab_end_index)added_vocab_mask = (input_ >= added_vocab_start_index) & (input_ < added_vocab_end_index)added_offset = added_vocab_start_index - (org_vocab_end_index - org_vocab_start_index) - num_org_vocab_paddingvalid_offset = org_vocab_start_index * org_vocab_mask + added_offset * added_vocab_maskvocab_mask = org_vocab_mask | added_vocab_maskinput_ = vocab_mask * (input_ - valid_offset)return input_, ~vocab_mask这段代码值得逐行拆开。valid_offset 是两段各自的偏移:基础段的 id 减去本段起点,就变成从 0 开始的局部下标;追加段的 id 需要再跨过基础段的长度与 padding。vocab_mask 为真的位置保留,为假的位置直接把 id 置 0——置 0 而不是置 -1,因为后面要做 embedding 查表,负下标会越界。查出来的那一行随后用 masked_fill_ 清零:
output_parallel = self.quant_method.embedding(self, masked_input.long())...output_parallel.masked_fill_(input_mask.unsqueeze(-1), 0)清零之后再 all-reduce,数学上就成立了:每个 id 恰好在一个 rank 上查出非零向量,其余 rank 贡献零向量,求和得到唯一正确的那一行。这就是前面说的所有权不变量的落地方式。
这里还有一个不太起眼但很讲究的优化。当权重是 FP8 时,代码先把输出按 int8 视图做 all-reduce:
if is_fp8(output_dtype): # Each vocab token has one owner, so FP8 bytes can use int8 SUM. output_parallel = output_parallel.view(torch.int8)因为每个 token 只有一个所有者,其余 rank 全是零字节,所以”FP8 求和”与”INT8 求和”在结果上完全等价,而后者不涉及任何浮点运算,NCCL 可以直接按字节做归约。这是一个利用稀疏性把通信变成纯内存操作的小技巧。
用融合 kernel 把掩码、偏移、查表合并
上面那段 Python 掩码逻辑会在每次前向产生好几个逐元素 kernel。vLLM 在支持 CUDA 且权重未量化时,改走一个融合算子:
self.use_fused_embedding = ( self.tp_size > 1 and current_platform.is_cuda() and isinstance(quant_method, UnquantizedEmbeddingMethod))
output_parallel = ops.vocab_parallel_embedding( input_, self.weight, shard_indices.org_vocab_start_index, shard_indices.org_vocab_end_index, shard_indices.num_org_vocab_padding, shard_indices.added_vocab_start_index, shard_indices.added_vocab_end_index,)融合的收益不在算术,而在少了几次全量读写:掩码、偏移、gather 三步对一块 [T, H] 的数据各扫一遍,融合后只扫一遍。注释里还写了它只适用于”plain row-major shard”,量化权重的布局不满足这个前提,因此只能退回通用路径。
LM head 与 logits 收集
vLLM 的 ParallelLMHead 继承自 VocabParallelEmbedding,但它把 forward 直接写成异常:
class ParallelLMHead(VocabParallelEmbedding): def forward(self, input_): del input_ raise RuntimeError("LMHead's weights should be used in the sampler.")这个设计在 DeepInfer 里被原样继承。理由不是”懒”,而是职责边界:head 的权重要被采样器直接拿去做 GEMM,而不是作为一个 nn.Module 参与模型前向的调用栈。模型只负责输出 hidden state,head 与采样在同一个内核管线里完成,CUDA Graph 捕获时也更稳定。
采样前的收集发生在 LogitsProcessor._gather_logits:
def _gather_logits(self, logits): if self.use_all_gather: logits = tensor_model_parallel_all_gather(logits) else: logits = tensor_model_parallel_gather(logits) return logits两条路径的差别在于谁最终持有完整 logits。all_gather 让每个 rank 都拿到整份 [B, V],所有 rank 可以独立、确定地做同样的采样;gather 只把结果收到 rank 0,之后再把采样出的 token 广播出去。vLLM 的注释解释了为什么某些平台必须用 all-gather:XLA 要求严格 SPMD,每个设备都要执行相同的后续操作,不能出现”rank 0 有值、其他 rank 是 None”的分支。
收集之后还有一步容易忽略的裁剪:logits[..., :self.org_vocab_size]。前面补齐的 padding 列在这里被切掉,保证采样看到的列数与 tokenizer 的词表大小一致。
不收集整份 logits 的贪心
如果只是贪心解码,其实没必要把整份 [B, V] 收回来。vLLM 提供了 get_top_tokens:每个 rank 先在本地 shard 上做 argmax,然后只 all-gather 一对 (value, index):
local_max_vals, local_max_indices = logits.max(dim=-1)global_indices = local_max_indices + vocab_startlocal_pair = torch.stack([local_max_vals.float(), global_indices.float()], dim=-1)gathered = tensor_model_parallel_all_gather(local_pair, dim=-1)gathered = gathered.view(hidden_states.shape[0], tp_size, 2)max_rank_idx = gathered[:, :, 0].argmax(dim=-1, keepdim=True)top_tokens = gathered[:, :, 1].gather(dim=-1, index=max_rank_idx)通信量从 降到 。、 时,前者是 66 MB,后者是 16 KB,四个数量级的差距。注释里还特意强调索引用 float32 而不是 bf16:bf16 的尾数只有 7 位,在 12 万这个量级上无法精确表示每一个整数,转换成 bf16 会让相邻 token id 撞在一起。
代价是这条路径只适用于 argmax(以及带一定约束的 top-k),因为 top-p、min-p、典型采样都需要完整的分布做归一化与截断。工程上的取舍很清楚:能只做归约就不要做广播,但前提是采样算法允许。
下面这张图是 vLLM 官方文档里的 TP=4 进程拓扑,可以看到每个 worker 只持有一部分权重,词表矩阵也被切成四份:
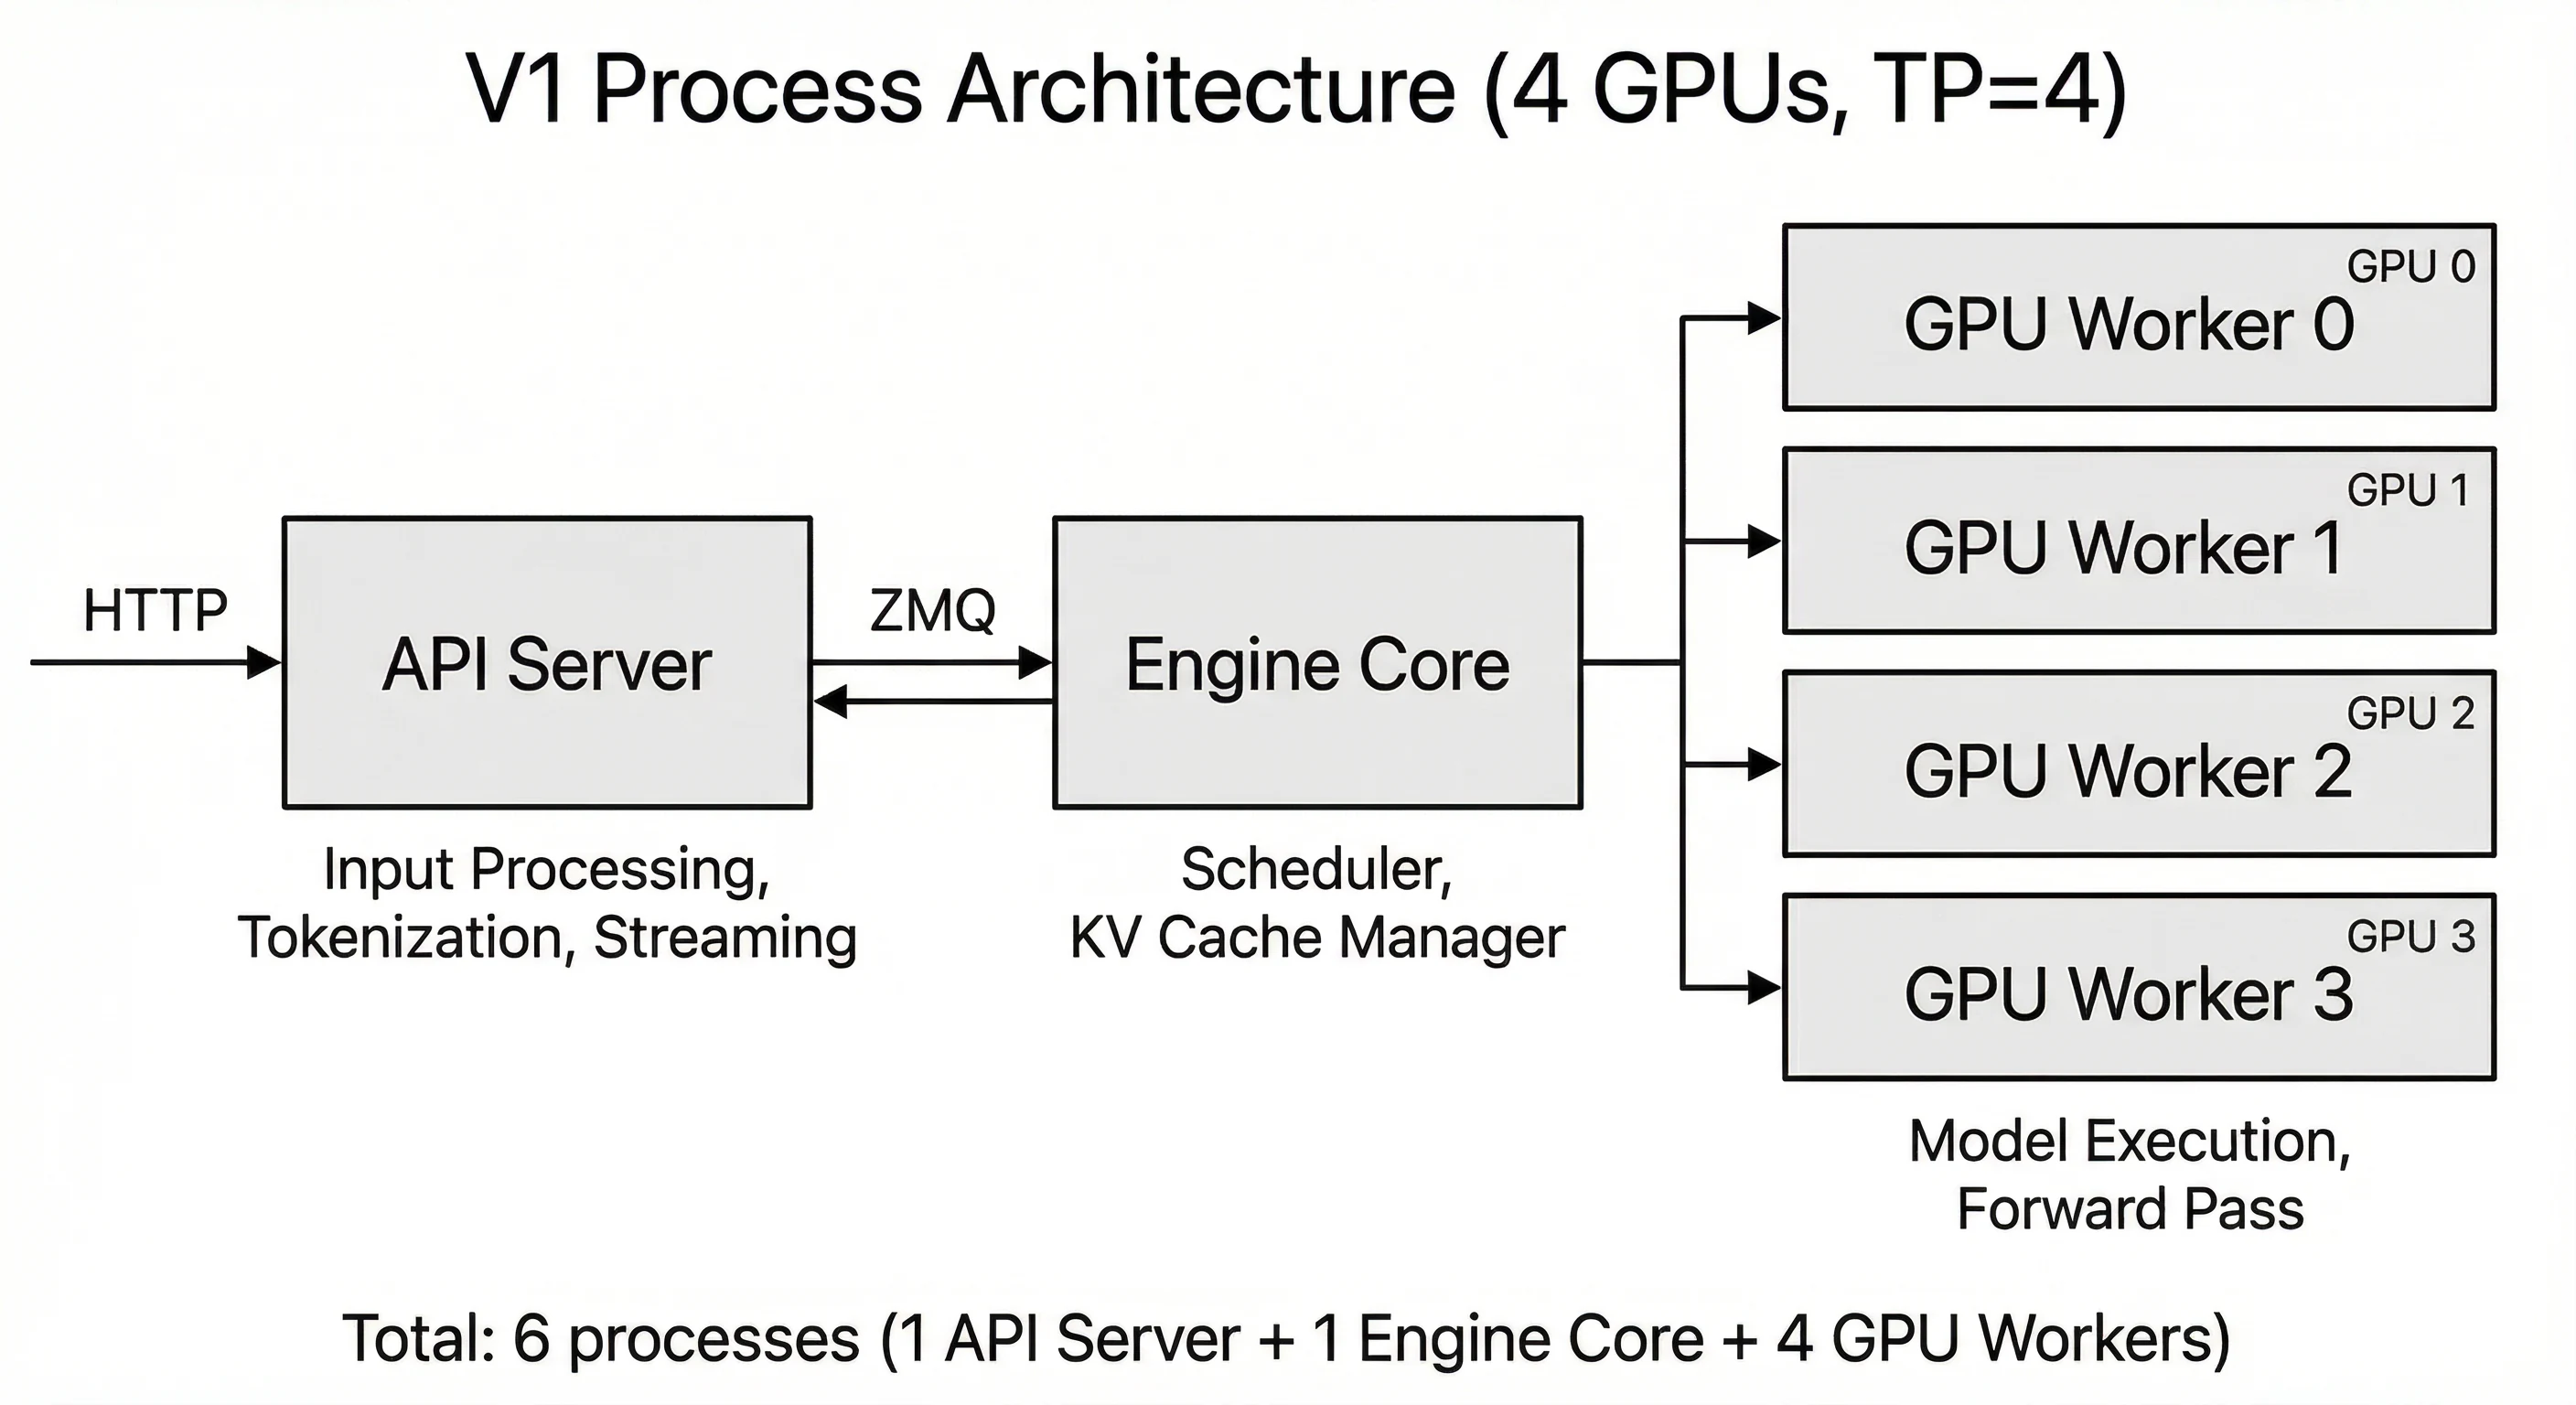
vLLM 的张量并行切分与 worker 组织在模型并行与 Worker 层一篇里已经完整拆过;本文只关心它在词表这一维上多出来的那两段特殊逻辑。
SGLang:三条收集路径与对称内存
SGLang 面对的是同一组不变量,但它的并行拓扑比 vLLM 复杂:除了 TP,还有 DP attention(注意力按数据并行切,MoE 按专家并行切)与 attention TP 的区分。这两种拓扑下”logits 在哪里、要收集到什么范围”完全不同,因此 LogitsProcessor 里出现了三条并行的收集路径。
路径一:DP attention 先收 hidden,再算 head,再散回 logits
DP attention 的核心是:每个 DP rank 只跑自己那一批请求的注意力,但 MoE 层需要全局 token 一起路由。于是 hidden state 的分布是”每 rank 一份本地 batch”,而 LM head 的权重可能是全局共享的。
SGLang 的选择是先把各 DP rank 的 hidden state 收成一份全局张量,算完全局 logits,再把属于各 rank 的行散回去:
hidden_states, local_hidden_states = self._gather_dp_attn_hidden_states( hidden_states, logits_metadata)...logits = self._compute_lm_head(hidden_states, lm_head, embedding_bias, out=logits_buffer)...logits = self._scatter_dp_attn_logits(logits, local_hidden_states, logits_metadata)_scatter_dp_attn_logits 里新建的缓冲形状是 [local_rows, vocab],再用 dp_scatter 把全局 logits 的对应行搬回来。这条路径的账很清楚:多了一次 hidden 的 all-gather(小)和一次 logits 的 scatter(大),但 head 只算一遍,且每个 rank 的采样看到的都是完整词表。
源码里那句注释正是对这笔账的警告:[batch * num_dp_ranks, vocab] 的 all-gather 在显存紧张时会 OOM。这也是为什么 SGLang 在 autotune 的 dummy run 里允许跳过 LM head——只为测注意力 kernel,没必要把几百 MB 的 logits 也搬一遍。
路径二:attention TP 组内 all-gather
当 enable_dp_lm_head 打开时,logits 的收集范围从全局 TP 组缩小到 attention TP 组:
self.use_attn_tp_group = get_parallel().enable_dp_lm_head...if self.use_attn_tp_group: logits = self._gather_attn_tp_logits(logits)这一步的意义是把”必须同步的 rank 数”从 降到 。DP attention 下,不同 DP rank 的 batch 是独立的,没必要为了一个 rank 的采样把其他 rank 的 logits 也拉进来。收集范围越小,单次通信的参与者越少,尾延迟越可控。
路径三:all-to-all 交换行块
第三条路径最有意思。它不收集 logits,而是交换 logits 的行块:
def _tp_lm_head_all_to_all(self, logits): """Exchange only the row block owned by each destination DP rank.""" logits = logits.contiguous() all_to_all_output = torch.empty_like(logits) get_parallel().tp_group.all_to_all_single( all_to_all_output.view(-1), logits.view(-1) ) return _reassemble_tp_lm_head_all_to_all_output(all_to_all_output)前提条件写在 _can_use_tp_lm_head_all_to_all 里:每个 rank 的本地行数必须相同(或者处于 decode CUDA Graph 的等长 padding 布局),且 lm_head.tp_size 与全局 TP 度一致。满足条件时,all-to-all 的通信量与 all-gather 其实是同一个量级——每卡发出 、收回 ——但它换来的是每个 rank 只保留自己那部分行对应的完整列,不需要在本地物化整份 [B, V]。对显存紧张的场景,这是关键差别。
对称内存与 multimem:把 all-gather 做成一次写
当收集不可避免时,SGLang 试图把这次 all-gather 本身做快。triton_symm_mem_ag.py 实现了一个基于对称内存与 multicast 的 all-gather:所有 rank 的缓冲区映射到同一段虚拟地址,发送方用 multimem.st 一次写入,所有 rank 的副本同时更新,不需要 ring 式的逐跳转发。
class MultimemAllGatherer: def __call__(self, x): if (state is not None and x.dtype == torch.bfloat16 and x.dim() == 2 and x.is_contiguous() and 0 < x.shape[0] <= state.max_token_num and x.data_ptr() % 16 == 0 and x.shape[-1] * state.world_size <= state.hidden_dim): return all_gather_inner(state, x, tp_hidden_dim=x.shape[-1] * state.world_size) return tensor_model_parallel_all_gather(x, dim=-1)这段条件判断值得逐条看,因为它暴露了这类”零拷贝集合通信”的全部约束:
x.dtype == torch.bfloat16:kernel 按 128 位打包写,只对 bf16 有实现;x.dim() == 2且连续:kernel 假设输入是行主序的二维块;x.shape[0] <= state.max_token_num:对称内存缓冲在初始化时就按最大 token 数分配,超出只能退回 NCCL;x.data_ptr() % 16 == 0:multimem.st要求 16 字节对齐;x.shape[-1] * world_size <= state.hidden_dim:目标缓冲的维度必须够宽。
任何一条不满足就 fall back 到 NCCL。更细的一条在 _build 里:如果当前正处于 CUDA Graph 捕获中,不能分配对称内存缓冲,于是返回 _UNINIT 等待下一次 eager 调用再建。这说明连”通信原语的初始化”都要服从 CUDA Graph 的约束。
all_gather_inner 内部还有一个按 token 分块的外层循环。注释写得很清楚:一次搬完整个 [B, V] 会超出对称内存缓冲,按 max_tokens 切块可以复用同一段缓冲,代价是多次 kernel 启动。这与 vLLM 的 LogitsGatherer 思路一致——大块通信要分块做,否则显存峰值不可控。
下面这张 SGLang 官方图展示了 DP attention 的结构:注意力在 DP 组内独立,MoE 走全局专家并行,LM head 与 logits 的归属需要在这两种拓扑之间做选择:
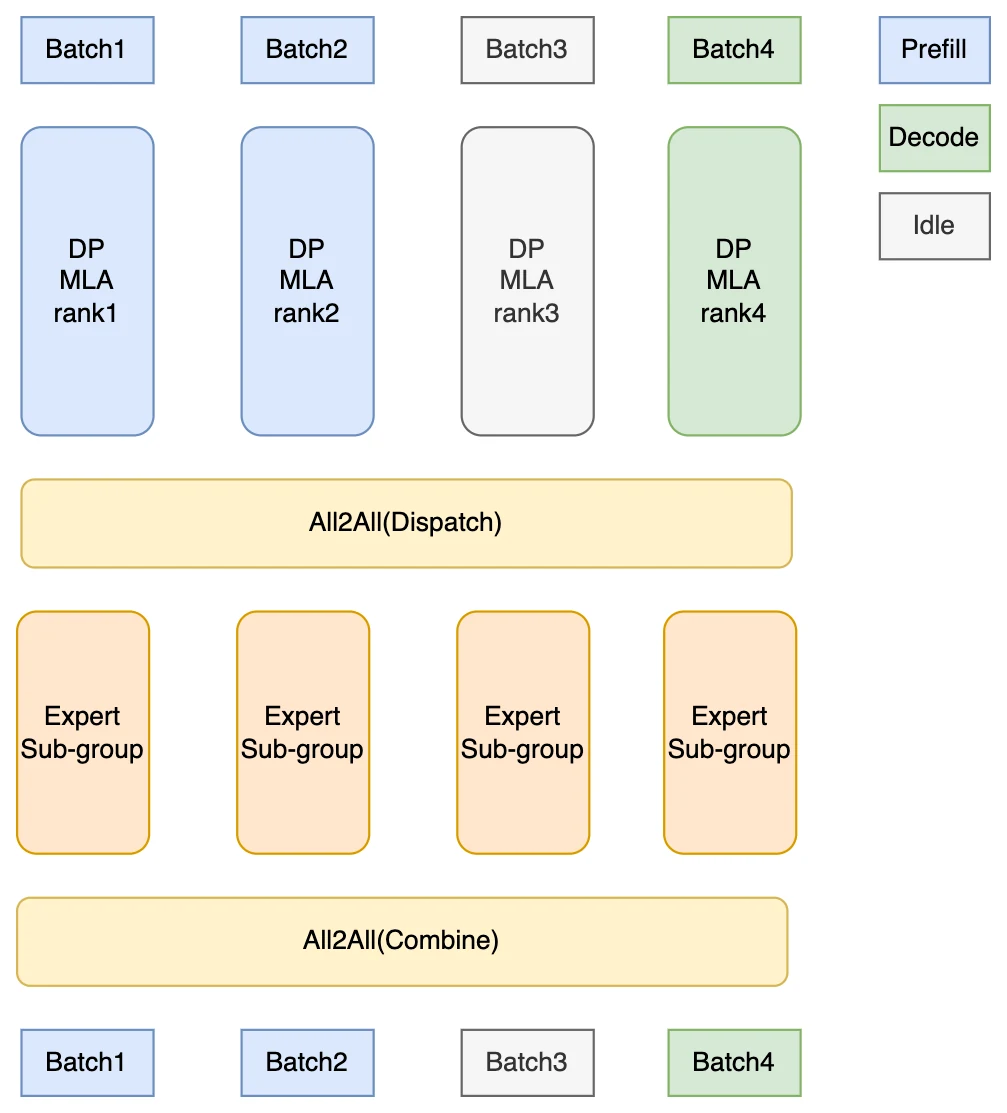
DP attention 的调度与专家并行细节在 SGLang DP Attention 与专家并行 一篇里已经展开;本文只取它对 logits 归属的影响。
TensorRT-LLM:两套 LMHead 与 gather_output
TensorRT-LLM 的 PyTorch 后端把这个问题做成了一个显式的二选一。DecoderModelForCausalLM.__init__ 里:
if config.mapping.enable_attention_dp and not config.mapping.enable_lm_head_tp_in_adp: self.lm_head = LMHead(vocab_size, hidden_size, dtype=..., quant_config=lm_head_quant_config)else: self.lm_head = LMHead( vocab_size, hidden_size, dtype=..., mapping=config.mapping, tensor_parallel_mode=TensorParallelMode.COLUMN, gather_output=config.lm_head_gather_output, reduce_output=False, quant_config=lm_head_quant_config, )两个分支的区别只有一行:有没有 mapping。没有 mapping,LMHead 就是一张完整的、复制的矩阵,每个 rank 各存一份;有 mapping,它按列(词表维)切开,每卡存 行。
gather_output=True 时,Linear 在 forward 末尾做一次 all-gather,把各卡的分片拼回完整 logits:
# allgather with sizes=None requires every rank to hold the same shapeif self.gather_output and self.tp_size > 1 and ...:这也是 TensorRT-LLM 与 vLLM 的一个细微差别:TP 度的切分不是简单均分,而是 _calc_shard 的”不整除时前面的 rank 多拿一行”:
@staticmethoddef _calc_shard(total, tp_size, rank): return (total // tp_size) * rank + min(total % tp_size, rank)这样即使 vocab_size 不能被 TP 度整除,也不需要 padding,代价是各卡的形状略有不同,all-gather 必须传 sizes 而不能用等长版本。对 CUDA Graph 来说这是一个负担——形状不一致意味着每个 rank 的图不一样,捕获与重放都要按各自形状处理。TensorRT-LLM 因此更倾向于要求词表对齐,或者在部署时统一 pad。
gather_output=False 时,logits 留在各卡的分片里,由后续的采样 kernel 直接在全 TP 组上做分布式归约。这与 vLLM 的 get_top_tokens 是同一个思路,只是 TensorRT-LLM 把它下沉到了采样 kernel 内部。
LogitsProcessor 只算需要的行
TensorRT-LLM 的 LogitsProcessor.forward 很短:
if not return_context_logits: last_tokens = torch.cumsum(attn_metadata.seq_lens_cuda, dim=0, dtype=torch.long) - 1 hidden_states = hidden_states[last_tokens]logits = lm_head(hidden_states)logits = logits.float()先用 cumsum(seq_lens) - 1 算出每个请求最后一个 token 在扁平序列里的位置,只把这些行喂给 head。这一步把 从”批内总 token 数”降到”请求数”,在 chunked prefill 场景下可能是几十倍的差距。
.float() 是第二处细节。head 的 GEMM 用 bf16 算,结果立刻升到 FP32 再做 softcap、缩放与采样。理由和 vLLM 里索引必须用 FP32 一样:bf16 只有 7 位尾数,12 万级别的 logits 在累加和比较时精度不够,尤其是 top-p 需要把很多小概率相加。
lm_head 的量化取舍
TensorRT-LLM 对 lm_head 是否量化有一条显式规则:只有当 checkpoint 里真的存了 lm_head.weight_scale 时才量化。注释里给了两个理由:
- 很多 bf16 checkpoint 根本不包含 lm_head 的量化参数,强行量化会引入额外误差;
tie_word_embeddings时 lm_head 与 embedding 共享同一块稠密 bf16 权重,量化会破坏共享关系;- 在 ADP 里做 lm_head TP 时,权重是在 forward 时切片的,也不能预先量化。
这条规则看起来是工程细节,实际上决定了词表矩阵在显存预算里的分量:量化到 FP8 可以把 1.23 GiB 压到 0.62 GiB,量化到 NVFP4 可以压到 0.31 GiB。对一张 80 GB 的卡,这是”能不能多放几层 KV”的差别。TensorRT-LLM 的量化全链路在量化全链路一篇里已经拆过,这里只强调词表矩阵的特殊性:它是少数可以整块复制、也最值得量化的权重。
TensorRT-LLM:两套 LMHead 与 gather_output
llama.cpp:词表根本不切
llama.cpp 没有张量并行,所以词表问题在它这里根本不存在。但它有两个与词表维直接相关的选择,值得拿来和上面三个框架对照:lm_head 放在哪台设备上,以及词表矩阵存成什么精度。
output 层是一块独立的放置单元
权重加载时,llama.cpp 把层编号分成两类:重复层(0 到 n_layer - 1)与输出层(编号 n_layer)。两者走同一个设备分配函数:
// assign the input layer// there is very little benefit to offloading the input layer, so always keep it on the CPUpimpl->dev_input = { cpu_dev, &pimpl->cpu_buft_list };
// assign the repeating layers to the devices according to the splitsfor (int il = 0; il < n_layer_all; ++il) { pimpl->dev_layer[il] = get_layer_buft_list(il);}
// assign the output layerpimpl->dev_output = get_layer_buft_list(n_layer_all);输入层强制放在 CPU,注释写的理由是”offload 输入层几乎没有收益”——embedding 查表只读几十行,把 1.23 GiB 的矩阵搬到显存是一次性成本,而每次前向读的量很小。输出层则跟着 -ngl 的层数走,可以被 offload 到 GPU。
这两条决策对应的是两个完全不同的瓶颈:
- embedding 是随机访问,读放大严重,但总量小;放 CPU 时通过统一内存或 pinned buffer 访问,延迟高但带宽需求低。
- lm_head 是稠密 GEMM,计算量是 ,放 CPU 会直接把 decode 速度打下来;放 GPU 后又要多传一次 hidden state,但 hidden 只有 ,与 logits 的 相比微不足道。
源码的日志也把这件事说得很直白:offloading output layer to GPU 与 offloaded %d/%d layers to GPU。在显存不够的情况下,用户会看到”层被分成两段”——前几层在 GPU、后几层在 CPU,或者反过来只把输出层留在 CPU。
只算需要的行,在图的末端切
一次 prefill 的输入可能有几千个 token,但只有每个序列的最后一个 token 需要 logits。llama.cpp 在图的倒数第二层之后插入一次按行 gather:
if (il == n_layer - 1 && inp_out_ids) { cur = ggml_get_rows(ctx0, cur, inp_out_ids); inpSA = ggml_get_rows(ctx0, inpSA, inp_out_ids);}ggml_get_rows 只挑出需要的行,后面的输出归一化与 lm_head 只处理这几十行。这一步的收益是 倍的节省——prefill 8192 token、batch 32 时,lm_head 的计算量从 8192 行降到 32 行,直接省掉 256 倍。
有意思的是源码里一段被注释掉的优化:
// note: when all tokens are output, we could skip this optimization to spare the ggml_get_rows() calls,// but this would make the graph topology depend on the number of output tokens, which can interfere with// features that require constant topology such as pipeline parallelism如果所有 token 都要输出(比如训练或逐 token 打分),这次 gather 就是多余的。但跳过它会让图的结构依赖输出行数,而流水并行(PP)要求各 rank 在不同 micro-batch 上跑同一个拓扑的图。为了保住拓扑稳定,llama.cpp 选择永远保留这次 gather,牺牲一点点 eager 模式的性能。这和 vLLM 在 CUDA Graph 下要求形状稳定是同一类约束,只是发生在图构建阶段而不是捕获阶段。
量化表与词表
llama.cpp 的 lm_head 与 embedding 都按 GGUF 的块量化存储,常见的是 Q4_K、Q6_K 等 k-quants 格式。块量化把每 32 个或 256 个权重连同缩放因子打包成一个 block,embedding 查表时读的是一整块而不是连续行。这对随机访问更友好——块内连续、缓存命中率高;对 lm_head 的 GEMM 则需要 mmq 内核在计算时边解码边乘。GGUF 的块格式与 mmq 内核在 GGUF 与 k-quants 块格式和 llama.cpp 后端与 Kernel两篇里已经拆过。
llama.cpp 的结论对本文的意义在于:词表切分的必要性来自张量并行,而不是词表本身。当并行拓扑不切 hidden 维时,词表也可以完整保留;此时要优化的是”放哪、算什么精度、只算几行”,而不是”怎么收集 logits”。
DeepInfer:把词表完整复制
DeepInfer 的做法乍看像是”没做优化”,但它是在一个不使用张量并行的拓扑下做出的合理选择。先看代码,再解释为什么这样选。
30 行的 VocabParallelEmbedding
class VocabParallelEmbedding(torch.nn.Module): def __init__(self, num_embeddings: int, embedding_dim: int, weight: torch.nn.Parameter) -> None: super().__init__() assert weight.shape == (num_embeddings, embedding_dim) self.weight = reconstruct_param(weight)
def forward(self, input_: torch.Tensor) -> torch.Tensor: output = gather(self.weight, input_) return output
class ParallelLMHead(VocabParallelEmbedding): def forward(self, input_: torch.Tensor) -> None: del input_ raise RuntimeError("LMHead's weights should be used in the sampler.")和 vLLM 的同名类相比,这里既没有 shard_indices,也没有掩码与 all-reduce:forward 就是一次按行 gather。名字里的 “Parallel” 是历史遗留,实际行为是”全复制 + 本地查表”。这篇源码在开头的版权头里写着 Derived from vLLM; modified by DeepSeek.,改动的核心就是删掉分片逻辑。
reconstruct_param 那一层包装的理由在模型装配与前向主循环一篇里解释过:装配阶段先物化 HF 参数壳再构造运行时模型,重新包一层 Parameter 可以共享 data 但隔离生命周期。
gather 内核:为什么不用 torch 的 index_select
查表走的是 tilelang_ops/gather.py:
def gather(x, index, out=None): """Row gather ``x[index]`` with out-of-range indices zero-filled.""" ... if out is None: out = torch.empty(out_shape, dtype=x.dtype, device=x.device) x = _flat_dense_int8(x) y = _flat_dense_int8(out) kernel = ops.gather_tl(x.shape[1], x.dtype, index.dtype, x.stride(0)) kernel(x, index, y) return out三个细节值得讲。
第一,越界下标零填充。y[i] = x[index[i]] 若 index[i] 不在 [0, n),输出整行为 0。这和 vLLM 的掩码逻辑目的相同,但位置不同:vLLM 是在查表之前把 id 置 0 并记住掩码,查完再清零;DeepInfer 则是让内核在越界时直接写零。之所以需要这个行为,是因为图像占位 token 用的是 vocab_size + offset 的哨兵值——这些 id 在真实词表之外,查 embedding 时必须安全地变成零向量,再由多模态路径回填视觉特征。
第二,按字节视图处理。_flat_dense_int8 把任意 dtype 的张量 view 成 int8,gather 内核只做字节搬运,不关心元素类型。这让同一个内核可以服务 bf16、fp8、fp4 各种权重,只要行是稠密的。对于 FP8 的 embedding,这意味着查表也是零拷贝语义。
第三,strided 输入不复制。注释里说明,非连续但”行内稠密”的张量可以直接用 strided 内核,只有任意内部布局才先 contiguous。参数化测试里专门有 strided_x 这一维,用 randn(n, d+17)[:, :d] 构造行间有间隙的输入,验证内核在 stride 不为 d 时仍然正确。
复制词表的代价与收益
在 DP attention + Wide-EP 的拓扑下,每个 rank 都要独立处理自己的一批请求。如果词表按 TP 切分,每次 embedding 都要一次跨 rank all-reduce——但在 DP 拓扑里没有”TP 组”这个概念,all-reduce 就要退化成 DP 组内的全收集,通信量会随 DP rank 数线性增长。反过来,复制一份词表只需要 1.23 GiB × 2 的显存,对一张 192 GB 的卡来说是 1.3% 左右。
更重要的是采样侧没有集合通信。每个 rank 本地持有完整词表,本地算出完整 logits,本地采样,输出 token 直接从 rank 返回。整个解码关键路径上少了一次 [B, V] 的 all-gather 或 all-to-all。在 EP 规模到几十、上百 rank 的部署里,这次通信的尾延迟比那 2.5 GiB 显存更贵。
源码里唯一的跨 rank 同步出现在 prompt logprobs:只有 CP rank 0 物化结果,因为 prompt logprobs 只用于调试与评测,不需要让每个 rank 都算一遍。
if PG.context_parallel_group().rank() == 0: result = torch.empty((full_batch_size,), dtype=torch.float, device=hidden_states.device)注意注释里那句”每个 CP rank 必须收到相同的 hidden-state 行数,这样 chunk 边界才对齐”——即使只有 rank 0 需要结果,所有 rank 也要按相同分块走完循环,否则跨 rank 的同步会错位。
lm_head 的投影写在哪
GPTHead 里有一个普通的 ReplicatedLinear:
class GPTHead(nn.Module): def __init__(self, cfg, layer_id=None): super().__init__() self.norm = DropoutAddRMSNorm(cfg.hidden_size, eps=cfg.rms_norm_eps, ...) self.head = ReplicatedLinear(cfg.hidden_size, cfg.vocab_size, bias=False, use_fp8_gemm=False)但这个 head 并不在模型前向里被调用。真正算 logits 的是 sampler_utils.get_logits:
def get_logits(hidden_states, embedding, vocab_size): logits = torch.empty(hidden_states.size(0), embedding.size(0), device=hidden_states.device, dtype=torch.float) bf16_gemm_nt(hidden_states, embedding, logits) assert logits.shape[-1] == vocab_size return logitsembedding 就是 VocabParallelEmbedding.weight,也就是那份复制的词表矩阵;bf16_gemm_nt 是”NT 布局”的 GEMM——A 是行主序的 hidden,B 是行主序的权重(即 ),正好对应 。输出缓冲直接分配为 FP32,与 TensorRT-LLM 的 logits.float() 是同样的理由。
ReplicatedLinear 里还有一套输出对齐逻辑:
def _allocate_output(self, shape, dtype, device): outputs_per_alignment = _OUTPUT_ALIGNMENT_BYTES // itemsize physical_output_size = (self.output_size + outputs_per_alignment - 1) // outputs_per_alignment * outputs_per_alignment storage = torch.empty((*shape[:-1], physical_output_size), dtype=dtype, device=device) return storage[..., : self.output_size]按对齐字节数分配物理宽度,再切出逻辑宽度。源码里 _OUTPUT_ALIGNMENT_BYTES = 32,也就是说每一行的物理跨度必须是 32 字节的整数倍。FP32 下是 8 个元素一组,129280 恰好能被 8 整除;换成 BF16 则是 16 个元素一组,同样整除。这样做让下游的 tile kernel 拿到的 stride 始终对齐,避免每次 GEMM 都做一次拷贝。
CUDA Graph 里的约束
全复制还有一个附带好处:在 CUDA Graph 下,词表矩阵是每 rank 一份的静态权重,head 的 GEMM 可以在图里被捕获并重放,没有任何集合通信需要在图外处理。相比 vLLM/SGLang 需要为 all-gather 做显存预算与分块,DeepInfer 的图捕获简单得多。代价是显存,收益是解码路径的确定性——这与 DeepInfer 在异步调度与 ZOS里”把 CPU 后处理移出关键路径”的整体思路是一致的。
下图是 DeepInfer 官方仓库给出的系统架构总览,可以看到它不做 TP、而是把并行度放在 DP Attention 与 Wide-EP 上:
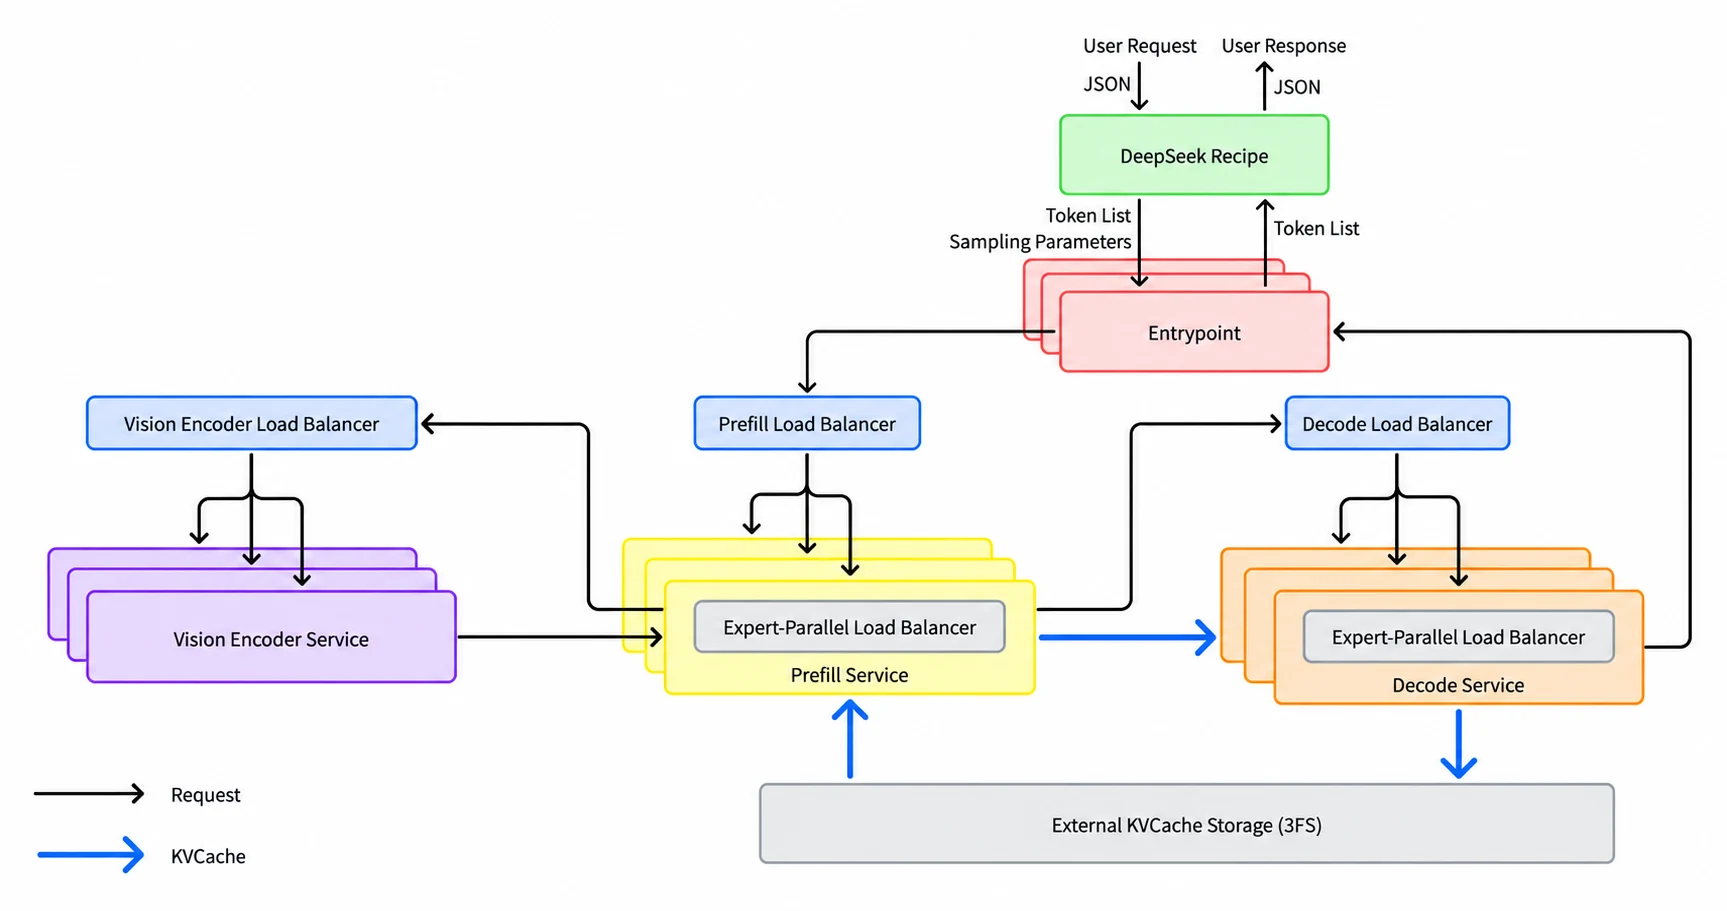
横向对照:五种做法的坐标与账单
把五条路径放在同一张表里,差异就很清楚了。注意”是否切词表”与”是否切 hidden”是两件独立的事:真正决定词表策略的是并行拓扑有没有 TP,以及采样在哪个 rank 上完成。
| 框架 | 词表是否分片 | embedding 同步 | logits 收集方式 | 采样位置 | 主要代价 |
|---|---|---|---|---|---|
| vLLM | 是,pad 到 64 倍数,基础段与 LoRA 段分开切 | 掩码查表 + all-reduce(FP8 用 int8 视图) | all-gather 或 gather 到 rank 0;贪心可用局部 argmax 归约 | 持有完整 logits 的 rank | 每层一次 embedding all-reduce;每步一次 logits 收集 |
| SGLang | 是,且区分 attention TP 与全局 TP | 同 vLLM 语义,收集范围可缩到 attention TP | DP attention 下先收 hidden、散回 logits;另有 all-to-all 行块交换与 multimem all-gather | 本地 DP rank(散回后) | DP 下 [B*dp, V] 的 logits 显存峰值;对称内存初始化受 CUDA Graph 限制 |
| TensorRT-LLM | 开关:attention DP 时不切,否则按列切 | 复制时无同步;切分时同 vLLM | gather_output 控制是否 all-gather;也可留给采样 kernel 做分布式归约 | 取决于 gather_output | 不整除时各卡形状不一,all-gather 需带 sizes |
| llama.cpp | 否(无 TP) | 无 | 无(logits 整块回 host) | host 上的采样器 | head 放 CPU 时 decode 变慢;logits host 缓冲按 n_vocab × n_outputs 分配 |
| DeepInfer | 否(全复制) | 无 | 无 | 每个 DP rank 本地 | 每卡多占约 2.47 GiB 词表权重 |
下图把前面五节拆过的切分方式并排放置。每一行左侧是权重在词表维上被切成的块数,中间是该框架在 embedding 上做的同步,右侧是 logits 的收集方式:
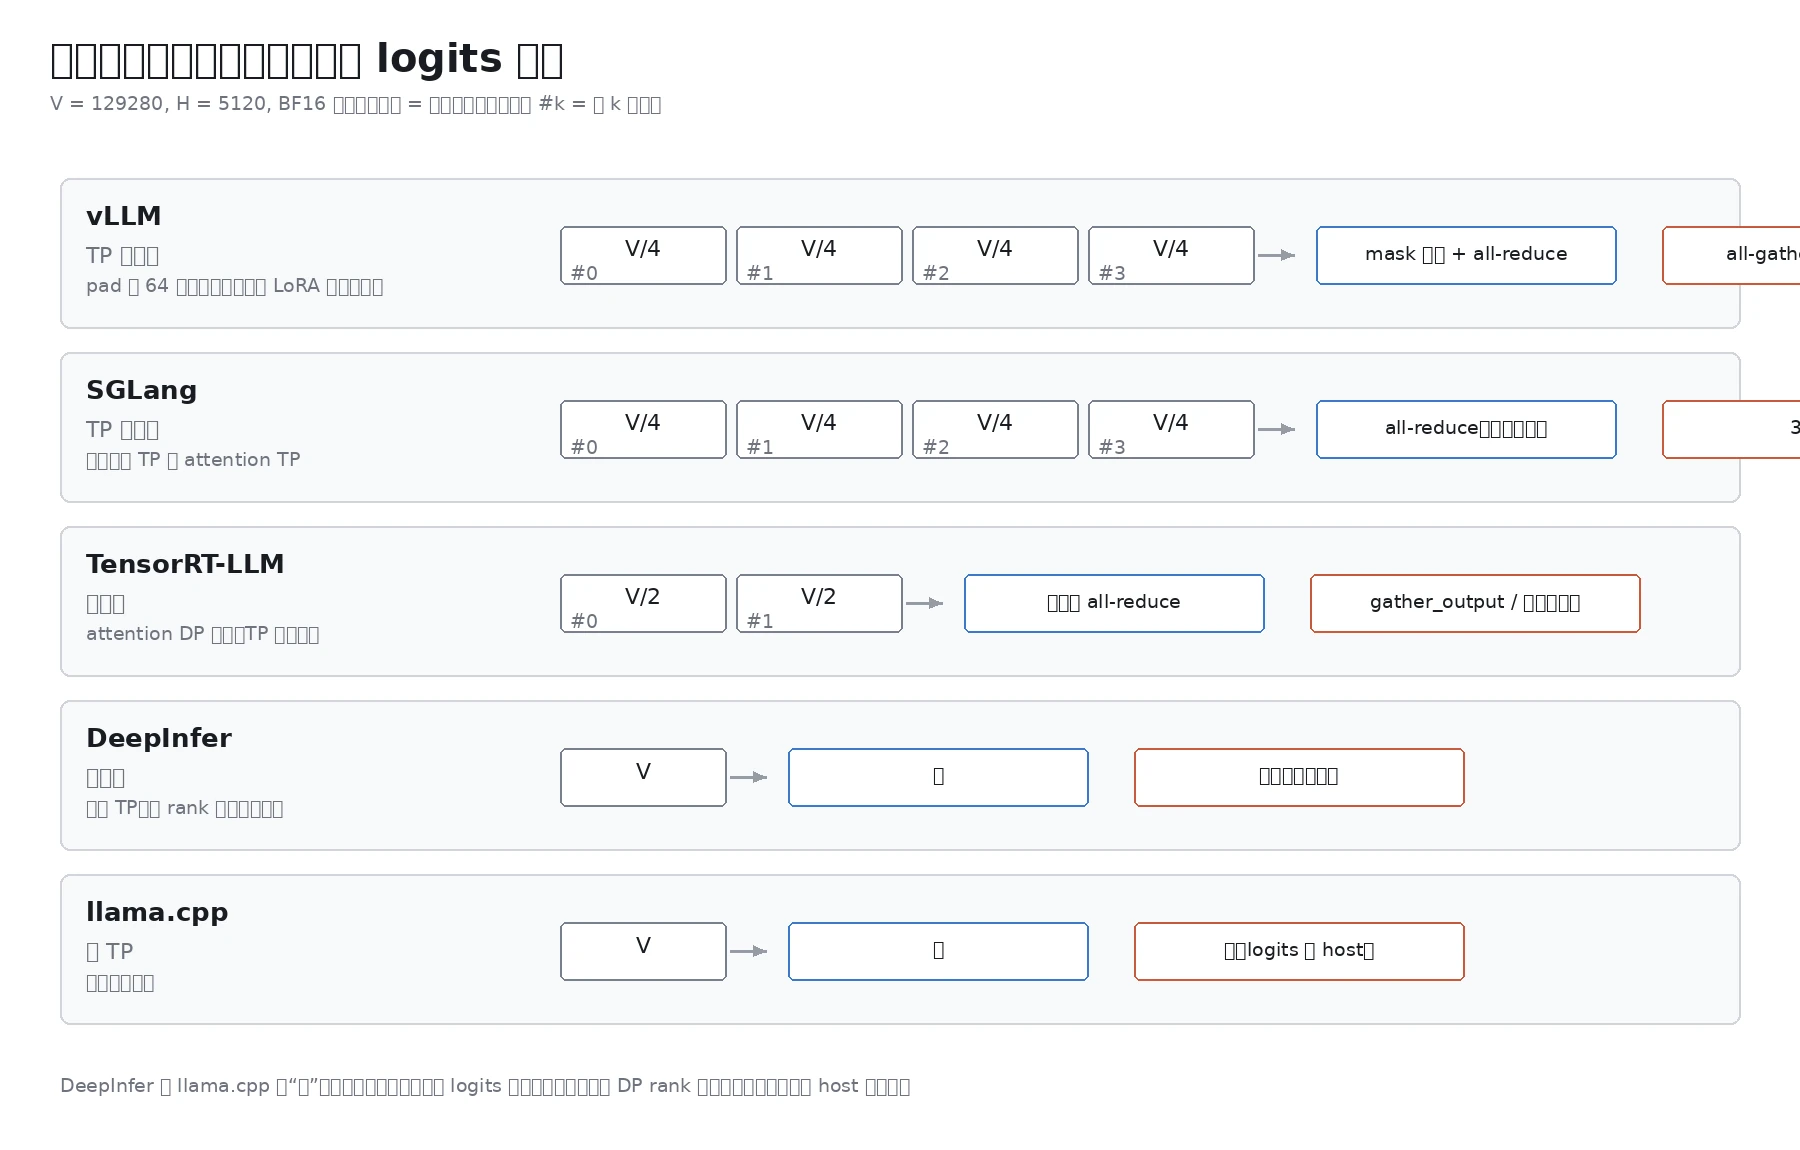
图中两个”无”需要区分含义:DeepInfer 与 llama.cpp 的解码关键路径上都不存在 logits 集合通信,但前者是因为每个 rank 都持有完整词表、可以本地采样,后者是因为根本没有张量并行(多卡时按层切分而非按词表切分)。
三种收集策略的适用边界
all-gather 是最”通用”的做法:所有 rank 最终持有完整 logits,采样逻辑不需要知道并行拓扑,任意采样算法都能跑。代价是显存峰值最高,因为每个 rank 都物化一份 [B, V]。vLLM 在支持 P2P 的 GPU 平台上默认走这条,SGLang 的 multimem 路径则是它的加速版。
gather 到单 rank 把显存压力集中到一个 rank,其他 rank 只保留分片。它适合”采样逻辑复杂、但只需要一份结果”的场景;代价是结果要再广播回所有 rank,且非目标 rank 在这段时间空转。
不收集、只归约 是通信量最小的路径,但只对”逐元素可分解”的采样算法成立。argmax 可以;top-k 可以(局部 top-k 再合并);top-p、min-p 不行,因为阈值依赖整份分布的累积和。
DeepInfer 的”零收集”其实是第四类:不是把归约做得更聪明,而是从拓扑上消除了收集的必要性。这也解释了为什么它的 VocabParallelEmbedding 只有 30 行——当并行度不切词表时,这段逻辑确实不需要存在。
显存与通信的换算
把前面的数字代进来,可以做一个粗略的换算。以 TP=8、、BF16 logits 为例:
- all-gather 的每卡接收量约 MB MB;
- 若有效带宽 300 GB/s,时间约 193 μs;
- 若改用局部 argmax,通信量降到 16 KB,时间可以忽略。
再看显存。全复制词表在 8 卡上多花 GiB 的总显存,但每卡只多 2.16 GiB。对 80 GB 卡来说,这 2.16 GiB 大概相当于 3 到 5 万 token 的 KV 容量(按 V4.1-Flash 的 890 字节/token 估算,约 2.4 万 token)。也就是说,DeepInfer 的选择是用每卡约 2.4 万 token 的 KV 容量,换掉解码路径上的一次 193 μs 通信。在 EP 规模很大、decode 延迟以毫秒计的场景里,这笔交易是划算的;在小规模单机部署里,可能就不划算。
这也是为什么同一个问题在不同框架里有不同答案:答案取决于拓扑,而不是取决于数学。
采样侧:收集之后还要归一化
logits 收齐只是第一步。真正决定”能不能不收集”的,是采样算法需要什么样的统计量。
softmax 的分母是全局量
给定一行 logits ,softmax 是:
分母要对整个词表求和。词表切成 份后,每个 rank 只有 ,它算出的局部和 用的还是局部最大值 。要合并成全局分布,必须做两步:
- 先 all-reduce 出全局最大值 ;
- 每个 rank 用 重新缩放局部和,再 all-reduce 求和。
这是标准的 log-sum-exp 合并,通信量是每行两个标量,很小。但它是两次串行归约,中间还夹着一次全量的 exp 重算。如果每步都要为采样做这两次归约,延迟就会叠加在关键路径上。
vLLM 与 SGLang 选择”先把 logits 收齐,再在一个 rank 上做一次 softmax”,本质上是用带宽换延迟确定性:一次大通信,换掉两次小但串行的归约。DeepInfer 因为本地就有完整词表,两次归约都退化成一次本地扫描。
top-k、top-p、min-p 各自需要什么
| 采样算法 | 需要的全局信息 | 能否只做归约 |
|---|---|---|
| greedy / argmax | 全局最大值及其 id | 能, |
| top-k | 全局前 k 大及其 id | 能,局部 top-k 后合并 |
| top-p(nucleus) | 全局排序后的累积概率 | 不能,需完整分布 |
| min-p | 全局最大概率乘以阈值 | 能,先求全局最大值再过滤 |
| 典型采样 | 全局熵与排序 | 不能,需完整分布 |
| 结构化输出 | 全局词表上的 bitmask | 视实现,通常需按 shard 对齐掩码 |
表里最容易被忽略的是最后一行。结构化输出(JSON Schema、正则约束)在采样前要把不允许的 token 的 logits 置为 。这份 bitmask 是按全局 token id 生成的,长度等于词表大小;词表一旦分片,每个 rank 只能取自己那一段 bitmask:
偏移算错一位,整个约束就会错位到别的 token 上。vLLM 与 TensorRT-LLM 都要求 bitmask 按 TP 度补齐并对齐,原因就在这里。SGLang 的语法编译与掩码路径在 SGLang 采样与语法一篇里拆过,DeepInfer 的对应实现在结构化输出与确定性一篇里。
logprobs 的语义
返回给用户的 logprobs 是 ,同样依赖全局分母。如果只在分片上算,得到的是”局部 softmax”,数值会比真实值大——因为分母少了几万项。这类错误不会让程序崩溃,只会让 API 返回的概率之和不等于 1,很难在测试里发现。
TensorRT-LLM 与 vLLM 都在返回前把 logits 升到 FP32 并做全局归一化;DeepInfer 因为本地有完整词表,process_sampling 可以直接对 [total_q, vocab_size] 的 FP32 张量做 log-softmax。词表是否分片,决定了这一步是本地循环还是跨 rank 归约。
确定性与 batch 不变性
还有一个更隐蔽的维度:同一请求在不同 batch 组成下,logits 的归约顺序会变,浮点结果会有 1-2 ULP 的差异。词表分片把这个问题放大了——all-gather 的拼接顺序、all-reduce 的树形结构,都会随 TP 度与拓扑变化。DeepInfer 的全复制反而让每个 rank 的 head GEMM 完全一致,只有 batch 内行数变化带来的 tile 划分差异。
batch-invariant 的完整讨论在 Batch-invariant 推理一篇里;这里只指出一个结论:词表并行是 batch 不变性的一道额外裂缝,因为它的归约维度不在 hidden 上,而在一个通常没人检查的词表维上。
工程细节与坑
把上面五套代码放在一起看,会反复遇到同一批坑。它们不属于某一家框架,而是词表并行本身的固有难点。
padding 列必须在采样前屏蔽
分片要求词表能被 TP 度整除,于是补零。补出来的列在 lm_head 里也会产生 logits,且值可能不小——因为权重是零,logits 是零,但在 softmax 之后仍有非零概率。若不屏蔽,模型有一定概率采样到一个”不存在的 token id”。
vLLM 的做法是在局部 argmax 前把 padding 列置 :
num_pad = lm_head.shard_indices.num_org_vocab_paddingif num_pad > 0: logits[..., -num_pad:] = -float("inf")然后在收集完成后切掉尾部:logits[..., :self.org_vocab_size]。两步缺一不可——只切不屏蔽,argmax 可能先选中 padding 列;只屏蔽不切,列数与 tokenizer 对不上。
LoRA 追加词表会打乱”下标等于 id”
基础词表与 LoRA 词表分开切分后,物理列的顺序是”基础段所有 rank → 追加段所有 rank”。收集回来的 logits 列序与 token id 不再一一对应。vLLM 为此提供了一个重排映射:
def get_sharded_to_full_mapping(self) -> list[int] | None: """Get a mapping that can be used to reindex the gathered logits for sampling."""它按 rank 顺序枚举基础段、追加段与 padding,生成一个长度等于 num_embeddings_padded 的索引表,采样前用 index_select 把列重排成 id 顺序。这个细节在多 LoRA 服务里尤其重要:不同请求可能挂不同 adapter,词表大小不同,重排映射也要按请求切换。
CUDA Graph 与集合通信的形状
图捕获要求每次重放的 kernel 序列与形状固定。词表相关的三个量都会破坏这一点:
- batch 行数:vLLM 用
logits_indices的 padding 把行数对齐到桶; - logits 宽度:分片宽度固定,但 padding 数随模型变;
- all-gather 的输出缓冲:SGLang 的对称内存缓冲按
max_tokens预分配,捕获期间不能新建。
SGLang 的 _build 里专门判断了 torch.cuda.is_current_stream_capturing(),捕获中返回 _UNINIT,等 eager 调用时再建。TensorRT-LLM 则要求 gather_output 的形状在各 rank 一致,否则 all-gather 不能走等长路径。这些约束在 KV Cache 与注意力上已经被讨论过很多次,在词表上同样成立。
FP8 与 BF16 的精度分工
词表矩阵通常是 BF16,但 embedding 的输出与 logits 的计算可以走 FP8:
- vLLM 的 FP8 embedding 用
int8视图做 all-reduce,因为每个 token 只有一个所有者; - DeepInfer 的 lm_head 显式关闭 FP8(
use_fp8_gemm=False),因为词表矩阵不在prepare_meta_fp8()的量化范围内; - TensorRT-LLM 只在 checkpoint 带 scale 时量化 lm_head。
三种做法的共同点是:词表矩阵是精度最敏感的一块。它参与的是”最后一层到 token”的映射,误差会直接改变采样结果;而中间层的 MoE 权重误差会被后续层平滑掉。这也是为什么量化方案通常把 lm_head 留在 BF16 或 FP8,而不敢轻易上 FP4。
通信与计算的流水
当收集不可避免时,最后的优化手段是把 head 的 GEMM 按列分块,算完一块就发一块,与下一块的 GEMM 重叠。vLLM 的 LogitsGatherer 与 SGLang 的 MultimemAllGatherer 都支持按 token 分块;DeepInfer 则因为没有收集而省掉了这一整层调度。
这类流水的收益取决于 head 的计算时间与通信时间的比例。 很小时,head 的 GEMM 只有几十微秒,通信占主导,流水的收益有限; 很大时,GEMM 变成毫秒级,分块重叠能把通信藏进去大半。
工程细节与坑
小结
词表维在推理系统里像一条被忽略的边界。它不参与 KV Cache 的账,也不在每层注意力里出现,但它同时位于输入端与输出端,两端都必须回答”这个 id 归谁”。
五个框架的答案可以压缩成三句话:
- 切不切,取决于 TP。vLLM、SGLang、TensorRT-LLM 的 TP 路径必须切,因为不切就要每卡存两份 1.23 GiB 矩阵;llama.cpp 与 DeepInfer 不切,因为它们的并行度在别的维度上,复制词表的显存代价比一次跨 rank 通信更便宜。
- 切了就必须同步。embedding 用掩码 + all-reduce 保证每个 token 只有一个所有者;如果采样只需 argmax,就把同步从”搬整份 logits”降到”搬最大值”。这是词表并行里性价比最高的一处优化。
- 采样是正确性的最后一关。softmax 分母、top-p 阈值、结构化 bitmask、logprobs 都需要全局视角;收集的边界在哪,正确性的边界就在哪。
真正值得记住的不是某一段代码,而是那条不变量:token id 在全局唯一,而权重在 rank 间被切分。所有掩码、偏移、重排、收集、归约,都是在弥合这两者之间的缝隙。读懂这条缝隙,再去看任何框架的 vocab 层代码,都会发现它们只是同一套逻辑的不同写法。
参考资料
- vLLM 源码:vocab_parallel_embedding.py
- vLLM 源码:logits_processor.py
- SGLang 源码:logits_processor.py
- SGLang 源码:triton_symm_mem_ag.py
- TensorRT-LLM 源码:modeling_utils.py
- TensorRT-LLM 源码:linear.py
- llama.cpp 源码:llama-model.cpp
- llama.cpp 源码:models/llama.cpp
- DeepInfer 源码:vocab_parallel_embedding.py
- DeepInfer 源码:tilelang_ops/gather.py
- DeepInfer 源码:sampler_utils.py
- Megatron-LM:Efficient Large-Scale Language Model Training on GPU Clusters
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



