


llama.cpp 源码完全拆解(三十一):Qwen3-Next 在 ggml 里怎么落地——混合层排布、delta-net 状态与 GQA 门控
从“又一个 decoder 层”说起
llama.cpp 的图构建代码有一个特点:每个模型架构都会给出一个独立的图构建类或函数,把 HF 权重名字映射到 ggml_tensor,再按层堆叠出计算图。前三十篇里我们已经把这条路的通用件拆得差不多了——llama.cpp 源码完全拆解(六):图构建与注意力 讲过 llama-graph 如何把模型结构翻译成图,llama.cpp 源码完全拆解(二十一):递归状态缓存 讲过 Mamba、RWKV 这类“没有 KV Cache 的层”如何存状态,llama.cpp 源码完全拆解(二十九):Meta device 与张量并行 讲过现代 llama.cpp 如何用虚拟设备组织多卡权重。
Qwen3-Next 恰好把“线性注意力层”和“全注意力层”这两种形态放进了同一个模型。按官方模型卡的描述,它由两层核心注意力组成:
- Gated DeltaNet:线性注意力,每层维护一个固定的、与序列长度无关的递归状态矩阵;
- Gated Attention:带输出门控的 GQA 全注意力,也就是常规 KV Cache 那一条路。
二者按固定节奏交错,官方写法的层排布是 12 × (3 × (Gated DeltaNet → MoE) → 1 × (Gated Attention → MoE)),也就是 48 层里每 4 层有 1 层是全注意力、3 层是线性注意力。在 llama.cpp 里,这套结构由 src/models/qwen3next.cpp 负责:文件主要分三块——load_arch_hparams 读超参并标记哪些层是递归层、load_arch_tensors 把每层需要的权重全部建出来、graph 构造函数逐层拼图。本篇就沿这三块,把 Qwen3-Next 在 ggml 里真正落地的方式讲清楚。
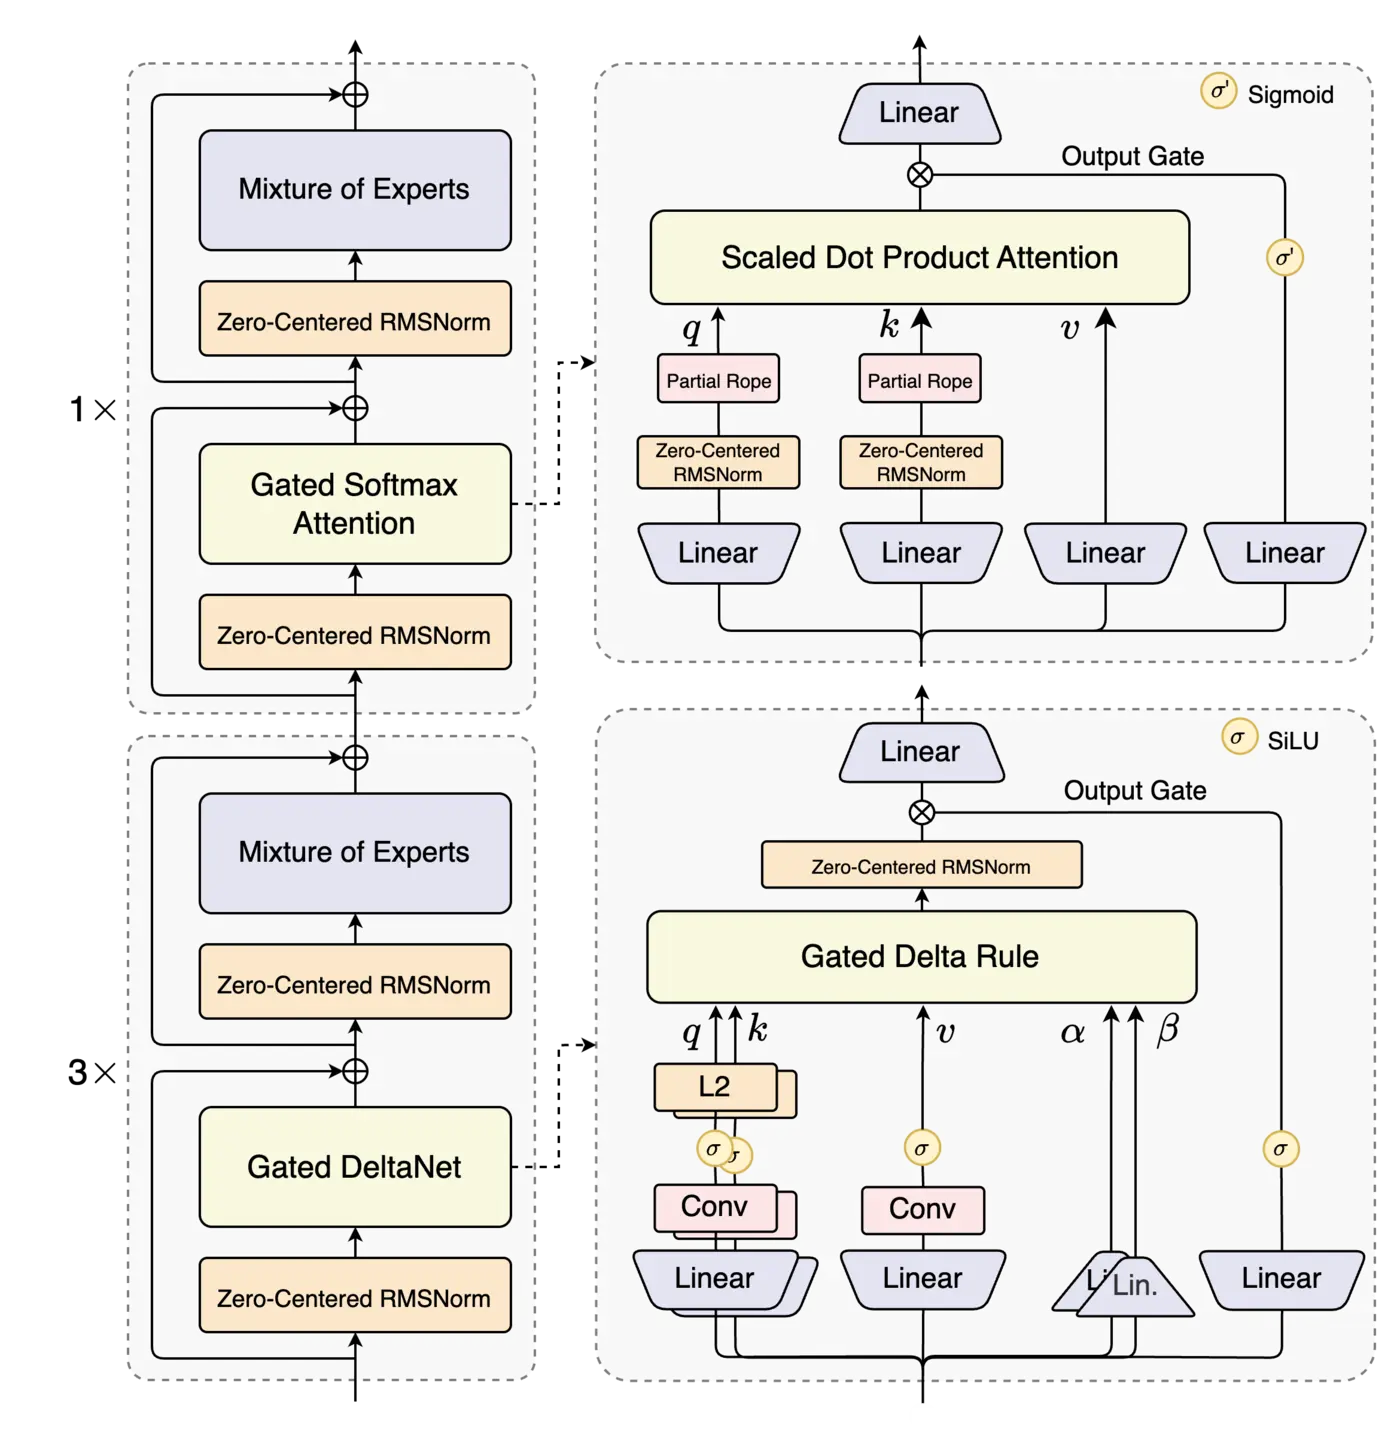
上图是 Qwen3-Next 的官方结构示意:左侧是超长上下文需求下混合注意力的取舍,右侧是 Gated DeltaNet、门控归一化与输出投影的模块划分。先建立这张图,后面每一节讲的张量都能在上面找到位置。本文中的源码均来自 llama.cpp 当前 master 分支的 src/models/qwen3next.cpp 与 src/models/delta-net-base.cpp。
超参:谁在什么时候决定一层是“递归层”
第一块是 load_arch_hparams。它先读 MoE 相关维度(n_ff_exp_arr、n_ff_shexp)和 RMSNorm 的 eps,再读线性注意力那一组 ssm_* 超参:
ml.get_key(LLM_KV_SSM_CONV_KERNEL, hparams.ssm_d_conv);ml.get_key(LLM_KV_SSM_INNER_SIZE, hparams.ssm_d_inner);ml.get_key(LLM_KV_SSM_STATE_SIZE, hparams.ssm_d_state);ml.get_key(LLM_KV_SSM_TIME_STEP_RANK, hparams.ssm_dt_rank);ml.get_key(LLM_KV_SSM_GROUP_COUNT, hparams.ssm_n_group);这些名字看起来像 Mamba 用的,这里却被 Gated DeltaNet 借用了:ssm_d_conv 是短卷积核长度(Qwen3-Next 为 4),ssm_d_state 是每个头 key/value 的维度(128),ssm_n_group 是 key 头数(16),ssm_dt_rank 在这里被当作 value 头数(32)。之所以复用 ssm_* 命名,是因为 llama.cpp 把它们归入同一类“递归状态”超参,后续的 hparams.n_embd_r()、hparams.n_embd_s() 也因此自然可用。
真正决定“哪层是线性注意力”的,是下面这段:
if (!ml.get_key_or_arr(LLM_KV_ATTENTION_RECURRENT_LAYERS, hparams.is_recr_impl, hparams.n_layer_all, false)) { uint32_t full_attn_interval = 4; ml.get_key(LLM_KV_FULL_ATTENTION_INTERVAL, full_attn_interval, false); for (uint32_t i = 0; i < hparams.n_layer_all; ++i) { hparams.is_recr_impl[i] = (i < hparams.n_layer()) && ((i + 1) % full_attn_interval != 0); }}逻辑是:如果 GGUF 里直接给了逐层的布尔数组,就照用;否则用 full_attention_interval(默认 4,正好对应 Qwen3-Next 的 full_attention_interval: 4)生成——第 0、1、2 层是递归层,第 3 层不是;之后周期重复。注意 i < hparams.n_layer() 这个条件:只有“主干层”参与,MTP(NextN)头对应的额外层永远不算递归层,因为它本身就是一个全注意力块。这份 is_recr_impl 数组之后会贯穿整个 graph 构造函数,决定每层走哪条分支。
另外,文件末尾还有一个基于层数判型的小动作:n_layer() == 48 时判为 LLM_TYPE_80B_A3B,对应 80B 总参数、每 token 激活约 3B 的规模。
造张量:同一文件里两条完全不同的权重清单
load_arch_tensors 决定了每层需要哪些权重。它先把线性注意力的维度从超参里算出来:
const int64_t head_k_dim = hparams.ssm_d_state; // 128const int64_t head_v_dim = hparams.ssm_d_state; // 128const int64_t n_k_heads = hparams.ssm_n_group; // 16const int64_t n_v_heads = hparams.ssm_dt_rank; // 32const int64_t key_dim = head_k_dim * n_k_heads; // 2048const int64_t value_dim = head_v_dim * n_v_heads; // 4096const int64_t conv_dim = key_dim * 2 + value_dim; // 8192随后在一个 load_block_trunk lambda 里,根据 hparams.is_recr(il) 走两个分支。非递归层走普通注意力的建法 create_tensor_qkv(...),再额外建一个 wo 输出投影和两个 RMSNorm 权重:
if (!hparams.is_recr(il)) { create_tensor_qkv(layer, il, n_embd, n_embd_head_k * n_head * 2, n_embd_k_gqa, n_embd_v_gqa, flags); layer.wo = create_tensor(tn(LLM_TENSOR_ATTN_OUT, "weight", il), { n_embd_head_k * n_head, n_embd }, flags); layer.attn_q_norm = create_tensor(tn(LLM_TENSOR_ATTN_Q_NORM, "weight", il), { n_embd_head_k }, flags); layer.attn_k_norm = create_tensor(tn(LLM_TENSOR_ATTN_K_NORM, "weight", il), { n_embd_head_k }, flags);}注意 create_tensor_qkv 这里传的是 n_embd_head_k * n_head * 2 而不是 n_embd_head_k * n_head:Qwen3-Next 的全注意力层把 query 和门控拼在同一个投影里,Q 投影的输出宽度翻倍,拆法后面在 build_layer_attn 里会看到。门控 Attention 还额外带了 q_norm 和 k_norm,这是 Qwen3 家族一贯的设置。
递归层则是一整套“线性注意力专用”张量:
layer.ssm_in = create_tensor(tn(LLM_TENSOR_SSM_IN, "weight", il), { n_embd, qkvz_dim }, TENSOR_NOT_REQUIRED | flags);layer.wqkv = create_tensor(tn(LLM_TENSOR_ATTN_QKV, "weight", il), { n_embd, key_dim * 2 + value_dim }, TENSOR_NOT_REQUIRED | flags);layer.wqkv_gate = create_tensor(tn(LLM_TENSOR_ATTN_GATE, "weight", il), { n_embd, value_dim }, TENSOR_NOT_REQUIRED | flags);layer.ssm_conv1d = create_tensor(tn(LLM_TENSOR_SSM_CONV1D, "weight", il), { hparams.ssm_d_conv, conv_dim }, flags);layer.ssm_dt = create_tensor(tn(LLM_TENSOR_SSM_DT, "bias", il), { hparams.ssm_dt_rank }, flags);layer.ssm_a = create_tensor(tn(LLM_TENSOR_SSM_A_NOSCAN, il), { hparams.ssm_dt_rank }, flags);layer.ssm_beta_alpha = create_tensor(tn(LLM_TENSOR_SSM_BETA_ALPHA, "weight", il), { n_embd, ba_dim }, flags);layer.ssm_norm = create_tensor(tn(LLM_TENSOR_SSM_NORM, "weight", il), { head_v_dim }, flags);layer.ssm_out = create_tensor(tn(LLM_TENSOR_SSM_OUT, "weight", il), { value_dim, n_embd }, flags);这里有两个值得注意的细节。其一,ssm_in 和 wqkv / wqkv_gate 被标成 TENSOR_NOT_REQUIRED:这是为兼容旧的 GGUF 转换而留的“legacy 路径”。新格式把 q、k、v、z 拆成两个投影,老格式只有一个捆在一起的 ssm_in(输出 qkvz_dim 宽)。其二,ssm_a 用的是 SSM_A_NOSCAN,说明这里存的不是 Mamba2 那种“扫描时现算”的 A,而是一份已处理过的负 A 数组——后面的 gate 计算会直接拿它乘上 softplus(alpha)。
MoE 部分是所有层共享的:每层都有一个专家门控 ffn_gate_inp({n_embd, n_expert},512 个专家),一个下投影 ffn_down_exps,再配上路由的 gate/up,外加一路共享专家(ffn_gate_inp_shexp 是每 token 一个标量的 sigmoid 门控)。这解释了“每层后面都跟一个 MoE”的层排布——注意力机制换来换去,FFN 部分不变。
最后,load_arch_tensors 还在主干层之后,对 n_layer 到 n_layer_all 的 MTP 层调用 load_block_mtp:先按主干块建,再补上 eh_proj(把 embedding 和隐状态拼起来降维的 {2*n_embd, n_embd} 矩阵)、enorm / hnorm 两个 RMSNorm,以及可选的 embed_tokens 和共享头。这部分是投机解码用的 NextN 头,主前向里不执行,后面 graph 构造函数里会显式裁剪掉。
图构建的主干:一次前向怎么在两类层之间切换
graph 构造函数继承自 llm_build_delta_net_base。这个基类定义在 src/models/delta-net-base.cpp,提供了 build_conv_state、build_recurrent_attn、build_delta_net 三个辅助函数——所有使用 Gated DeltaNet 的模型(Qwen3-Next 只是其中一个)都复用它们。构造函数的前几行是常规准备:
inpL = build_inp_embd(model.tok_embd);auto * inp = build_inp_mem_hybrid();ggml_tensor * inp_pos = build_inp_pos();ggml_tensor * inp_out_ids = build_inp_out_ids();build_inp_mem_hybrid() 是这里的关键:它同时准备两套输入——一套是全注意力层用的 KV cache 输入(get_attn()),一套是递归层用的 ring-state 输入(get_recr())。这和混合 Mamba 模型的做法一致,区别只是 Qwen3-Next 的递归状态比 Mamba 大不少(下面会算)。
逐层循环里,先做 attention 前的 RMSNorm,然后按 is_recr 分流:
if (hparams.is_recr(il)) { cur = build_layer_attn_linear(inp->get_recr(), cur, il);} else { cur = build_layer_attn(inp->get_attn(), cur, inp_pos, il);}之后是 Qwen3-Next 特有的“双残差”结构:attention 输出先加回输入(attn_residual),再经过一个 post-attention RMSNorm(attn_post_norm),送进 FFN/MoE,MoE 输出再加到 post-norm 之前的张量上(ffn_residual):
cur = ggml_add(ctx0, cur, inpSA);ggml_tensor * ffn_residual = cur;ggml_tensor * attn_post_norm = build_norm(cur, model.layers[il].attn_post_norm, nullptr, LLM_NORM_RMS, il);cur = build_layer_ffn(attn_post_norm, il);cur = ggml_add(ctx0, cur, ffn_residual);这和 Qwen3 家族的 x = x + attn(norm(x)); x = x + mlp(post_norm(x)) 写法不同:这里 post-norm 作用在残差和之后、结果再加回去,相当于对残差流做了一次再归一化。对这种“层数多、激活稀疏(每 token 只走 10 个专家)”的架构来说,它能让残差流的尺度更稳定。
循环末尾还有一段和 MTP 头相关的裁剪逻辑:
if (il == n_layer - 1 && crop_before_nextn(inp_out_ids)) { cur = ggml_get_rows(ctx0, cur, inp_out_ids); inpSA = ggml_get_rows(ctx0, inpSA, inp_out_ids);}MTP 头的输入只来自最后一个主干层的部分 token(inp_out_ids 选中的行),而不是全部 token,所以这里要先收敛 batch 维度。主干末尾的 h_nextn 会被存下来,既作为 LM head 的输入,也作为 MTP 头的输入。
递归层的线性注意力:一次前向里五段流水
build_layer_attn_linear 是 Qwen3-Next 最有特点的部分。它把线性注意力拆成五段:输入投影与门控拆包、递推参数计算、短卷积、delta-net 核心、门控归一化与输出投影。
输入投影:两条路径与“z”门控
第一步通过 build_qkvz 得到 qkv_mixed 和 z。新格式下走优化路径:
if (model.layers[il].wqkv) { ggml_tensor * qkv_mixed = build_lora_mm(model.layers[il].wqkv, input, model.layers[il].wqkv_s); qkv_mixed = ggml_reshape_3d(ctx0, qkv_mixed, qkv_mixed->ne[0], n_seq_tokens, n_seqs); ggml_tensor * z = build_lora_mm(model.layers[il].wqkv_gate, input, model.layers[il].wqkv_gate_s); return { qkv_mixed, z };}两个投影分别输出 key_dim*2 + value_dim(q、k、v 拼接,2048+2048+4096=8192 宽)和 value_dim(z,4096 宽)。z 是 Gated DeltaNet 的输出门控,作用类似 Mamba 里的那条 gated norm 支路:它不参与状态更新,只在最后一步对输出做门控。
老格式则用一个 ssm_in 输出 2*head_k + 2*head_v*ratio 每 key 头宽度的张量,再按偏移切出 q、k、v、z,并分别 cont 成扁平形状后拼接。两条路径产出的 qkv_mixed 形状一致,后续代码无需区分。
递推参数:beta 与 alpha
线性注意力的核心递推需要两个 per-head 参数:beta(写入强度)和 alpha(衰减率)。它们由一个共享投影 ssm_beta_alpha 一次算出:
ggml_tensor * mixed_ba = build_lora_mm(model.layers[il].ssm_beta_alpha, cur);int64_t ba_new_dim = 2 * num_v_heads / num_k_heads;ggml_tensor * mixed_ba_reshaped = ggml_reshape_4d(ctx0, mixed_ba, ba_new_dim, num_k_heads, n_seq_tokens, n_seqs);// b -> beta, a -> alphaggml_tensor * beta = ggml_sigmoid(ctx0, b);ggml_tensor * alpha_biased = ggml_add(ctx0, alpha, model.layers[il].ssm_dt);ggml_tensor * alpha_softplus = ggml_softplus(ctx0, alpha_biased);ggml_tensor * gate = ggml_mul(ctx0, alpha_softplus, model.layers[il].ssm_a); // -A_log.exp() * softplusbeta 过 sigmoid 得到 0 到 1 之间的“写入率”;alpha 加偏置后再过 softplus,乘上 ssm_a(本质上是 -exp(A_log)),得到对数域上的衰减。因为每层的 ssm_a 参数直接来自 GGUF,所以衰减完全由权重决定,运行时只需一次逐元素乘——不必像 Mamba2 那样在扫描过程里再算 A。
短卷积:把状态当作环形缓冲
Gated DeltaNet 在 Q/K/V 进入核心递推之前做一次深度可分离的短卷积(kernel=4)。llama.cpp 把它实现为“把 conv 状态拼在输入前面,再调用 ggml_ssm_conv”:
ggml_tensor * conv_states_all = mctx_cur->get_r_l(il);ggml_tensor * ssm_states_all = mctx_cur->get_s_l(il);ggml_tensor * conv_input = build_conv_state(inp, conv_states_all, qkv_mixed, conv_kernel_size, conv_channels, il);ggml_tensor * conv_output_proper = ggml_ssm_conv(ctx0, conv_input, conv_kernel);ggml_tensor * conv_output_silu = ggml_silu(ctx0, conv_output_proper);build_conv_state 做两件事:把该层保存的 conv_kernel_size - 1 个历史 token 的卷积输入拼到当前 chunk 前面,并把拼接后最新的那一段写回 conv 状态槽位。这里有个和 rollback 相关的分支:如果 cparams.n_rs_seq > 0(需要支持回滚),它会把最后 K = n_rs_seq + 1 份滑动窗口写进不同槽位,保证投机解码被拒绝时可以退回任意前缀——这个机制与 llama.cpp 源码完全拆解(九):投机解码 里讲的 KV 裁剪是同一套思路。
卷积核是 {4, conv_channels} 的深度卷积,输出保留全部 token;之后按偏移切开:
int64_t qkv_dim = head_k_dim * num_k_heads * 2 + head_v_dim * num_v_heads;ggml_tensor * q_conv = ggml_view_4d(...); // head_k_dim x num_k_headsggml_tensor * k_conv = ggml_view_4d(...);ggml_tensor * v_conv = ggml_view_4d(...);q_conv = build_gdn_l2_norm(ctx0, q_conv, eps_norm);k_conv = build_gdn_l2_norm(ctx0, k_conv, eps_norm);Q 和 K 过 L2 归一化,这是 delta 规则里“更新方向是单位向量”的前提。随后处理 head 数不匹配的问题——16 个 key 头对 32 个 value 头,需要把 Q、K 按 value 头数重复展开:
if (num_k_heads != num_v_heads) { GGML_ASSERT(num_v_heads % num_k_heads == 0); int64_t repeat_factor = num_v_heads / num_k_heads; // 2 // reshape -> ggml_repeat_4d -> reshape back}代码里留了一句 TODO: avoid repeats for fused GDN, needs broadcast configuration for GDN op [TAG_GGML_GDN_BCAST],说明作者也知道这一步是多余的复制,但为了能复用融合算子先接受这个开销。
delta-net 核心:三条实现路径
真正的状态更新在基类 build_delta_net 里。它根据 token 数和算子能力挑三选一:
if (n_seq_tokens == 1) { if (cparams.fused_gdn_ar) return build_delta_net_fused(...); return build_delta_net_autoregressive(...);}if (cparams.fused_gdn_ch) return build_delta_net_fused(...);return build_delta_net_chunking(...);递归路径(build_delta_net_autoregressive)是最直观的写法,对应 decode 阶段一个 token 一步:
g = ggml_exp(ctx0, g);s = ggml_mul(ctx0, s, g); // s ← s ⊙ exp(g)ggml_tensor * sk = ggml_mul(ctx0, s, k);sk = ggml_sum_rows(ctx0, sk); // sk = kᵀ s,先衰减再读ggml_tensor * d = ggml_sub(ctx0, v, ggml_transpose(ctx0, sk));d = ggml_mul(ctx0, d, b); // d = beta ⊙ (v - kᵀ s)k = ggml_repeat(ctx0, k, s);kd = ggml_mul(ctx0, k, d_t);s = ggml_add(ctx0, s, kd); // s ← s + (beta ⊙ (v - kᵀ s)) kᵀggml_tensor * s_q = ggml_mul(ctx0, s, q);o = ggml_sum_rows(ctx0, s_q); // o = qᵀ s这就是 delta 规则的完整形式:先读取当前状态对 K 的投影,与 V 比较得到残差,按 beta 缩放后用外积写回,最后用 Q 读出。ggml_sum_rows 做的是第一个维度上的求和,而 permute/reshape 让每个头的 128×128 状态被当做一个矩阵处理。
分块路径(build_delta_net_chunking)是 prefill 的主路径。它把 token 按 CS(普通 GDN 为 64)切成块,块间只传状态、块内做并行的三角求解:
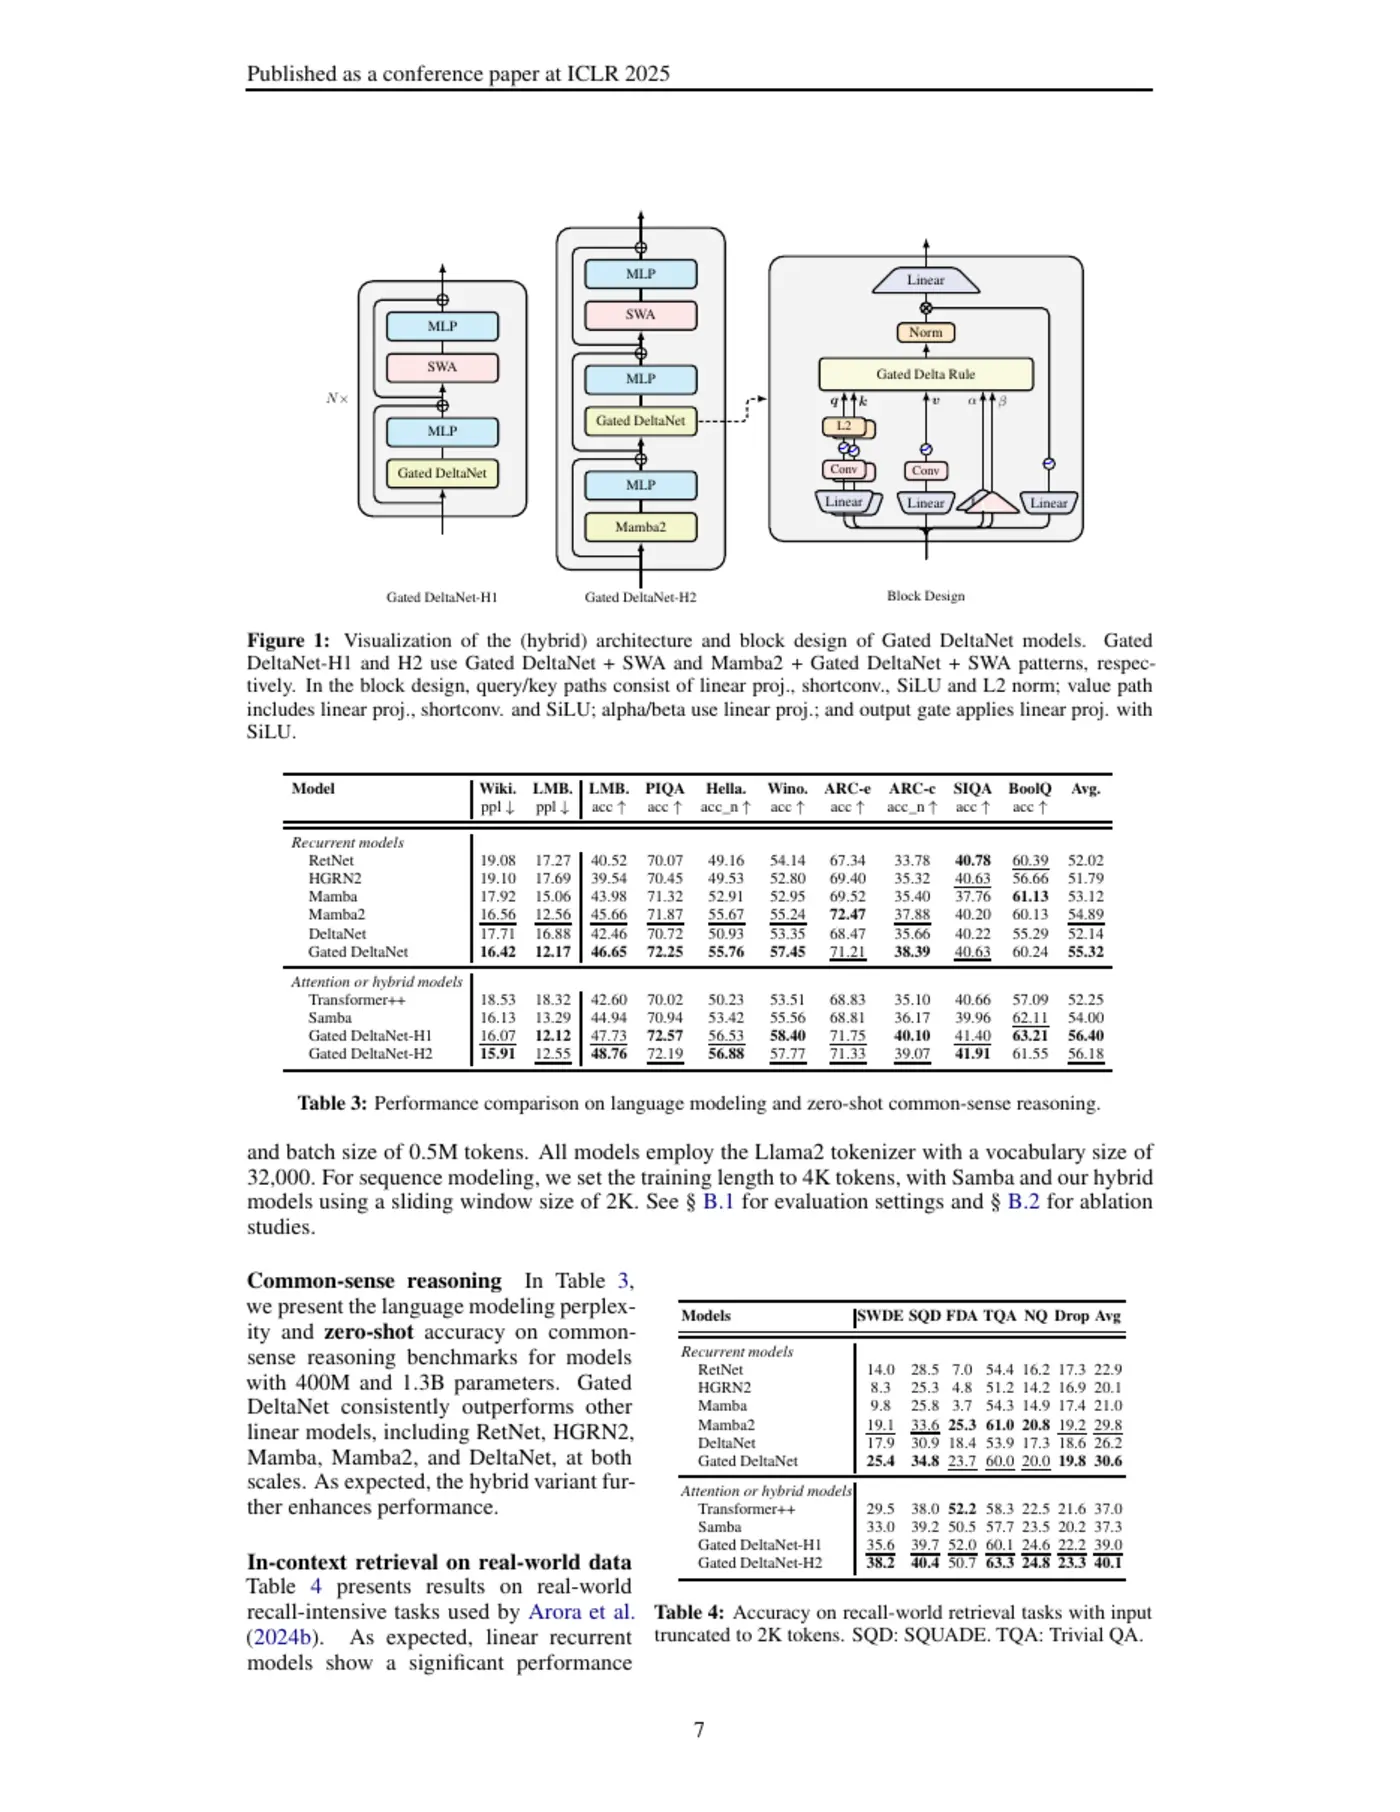
上图为 Gated DeltaNet 原始论文(Yang、Kautz、Hatamizadeh,2024)图 1 的架构页:左侧是线性注意力块与全注意力块交错排布的 hybrid 模型,右侧是单个 Gated DeltaNet 块的内部设计。Qwen3-Next 的层排布正是把这种 hybrid 形态落地成 3:1 的节奏。分块并行算法的具体推导在论文正文,这里只取其结论:块间只串行传递状态矩阵,块内可以完全并行。llama.cpp 的分块实现遵循这个结构,关键片段是:
ggml_tensor * g_cs = ggml_cumsum(ctx0, ggml_cont(ctx0, ggml_transpose(ctx0, g))); // 块内衰减前缀和ggml_tensor * decay_mask = ggml_sub(ctx0, g_cs_j, g_cs_i);decay_mask = ggml_tri(ctx0, decay_mask, GGML_TRI_TYPE_LOWER_DIAG);decay_mask = ggml_exp(ctx0, decay_mask);ggml_tensor * kb = ggml_mul_mat(ctx0, k, k_b);kb = ggml_mul(ctx0, kb, decay_mask);ggml_tensor * attn = ggml_tri(ctx0, kb, GGML_TRI_TYPE_LOWER);identity = ggml_diag(ctx0, identity);ggml_tensor * lhs = ggml_add(ctx0, attn, identity);ggml_tensor * lin_solve = ggml_solve_tri(ctx0, lhs, attn, true, true, false);ggml_tri 按衰减掩码截出下三角,加单位阵后通过 ggml_solve_tri 解一个三角线性系统——这就是“块内求逆”。之后的 k_cd(累计衰减的 K)与每块的状态 s 相乘得到块入口处的投影,再构造 v_t_new = v_t - k_cd·s,和块内的 kq 交互后更新状态:
ggml_tensor * v_t_p = ggml_mul_mat(ctx0, ch_k_cd, s);ggml_tensor * v_t_new = ggml_sub(ctx0, ch_v_t, v_t_p);ggml_tensor * v_attn = ggml_mul_mat(ctx0, v_t_new, ch_kq);s = ggml_mul(ctx0, s, ch_g_last_exp_t);s = ggml_add(ctx0, s, kgv); // 块末状态 = 衰减后的 s + 块内写入这一段还有一个处理 KDA(Kimi Delta Attention)变体的分支:const bool kda = (g->ne[0] == S_k && g->ne[1] == H_k),当衰减门控是按 key 维度逐元素给出时,chunk size 改为 16,并用逐元素衰掩码替代标量门控。llama.cpp 把这个基类做成同时支撑两种 delta 变体。
融合路径在最后:ggml_gated_delta_net(ctx0, q, k, v, g, b, s, K) 是一个后端特化算子,把上面整套递推压进一个 kernel,输出一个 view_4d 里同时包含 [attn_output, new_state]。当 K > 1 时它还在状态区后面追加 K 份快照,供回滚使用(见 build_recurrent_attn 的 keep 分支)。哪条路径生效由 cparams.fused_gdn_ar / fused_gdn_ch 控制,属于推理配置层,不属于模型结构本身。
状态写回与门控归一化
build_recurrent_attn 负责把新状态写回 ring-state 缓存:
ggml_build_forward_expand(gf, ggml_cpy(ctx0, new_state, ggml_view_2d(ctx0, ssm_states_all, hparams.n_embd_s(), n_seqs, ssm_states_all->nb[1], kv_head * hparams.n_embd_s() * ggml_element_size(ssm_states_all))));状态按 kv_head 槽位排布,每层一块大小为 n_embd_s() 的区域。到这里就明白“序列与长度无关”:无论上下文跑多长,每层只保存这一块 128×128×32 的矩阵。
回到 build_layer_attn_linear,核心注意力输出后还要做门控归一化与输出投影:
ggml_tensor * z_2d = ggml_reshape_4d(ctx0, z, head_v_dim, num_v_heads, n_seq_tokens, n_seqs);ggml_tensor * attn_out_norm = build_norm_gated(output, model.layers[il].ssm_norm, z_2d, il);ggml_tensor * final_output = ggml_reshape_2d(ctx0, attn_out_norm, head_v_dim * num_v_heads, n_seq_tokens * n_seqs);cur = build_lora_mm(model.layers[il].ssm_out, final_output);build_norm_gated 就是 RMSNorm(x) ⊙ SiLU(z),和 Qwen3-Next 论文里 Gated DeltaNet 的写法一致。注意这里是带权重的 RMSNorm——ssm_norm 是每头一个 128 维向量。
全注意力层:一个投影里的 Q 与门
非递归层走 build_layer_attn,结构比常规 GQA 多一步“拆 Q”。build_qkv 的查询宽度传的是 n_embd_head * 2:
auto [Qcur_full, Kcur, Vcur] = build_qkv(model.layers[il], cur, n_embd_head * 2, n_head, n_embd_head, n_head_kv, n_embd_head, n_head_kv, il, false);Qcur_full = ggml_reshape_4d(ctx0, Qcur_full, n_embd_head * 2, n_head, n_tokens, 1);即每个头的 Q 投影输出 256×2=512 维:前 256 维是真正的 Q,后 256 维是门控。拆法用 ggml_view_4d 在同一块 4D 张量上取两个视图,偏移分别是 0 和 n_embd_head * element_size:
ggml_tensor * Qcur = ggml_view_4d(ctx0, Qcur_full, n_embd_head, n_head, n_tokens, 1, Qcur_full->nb[1], Qcur_full->nb[2], Qcur_full->nb[3], 0);ggml_tensor * gate = ggml_view_4d(ctx0, Qcur_full, n_embd_head, n_head, n_tokens, 1, Qcur_full->nb[1], Qcur_full->nb[2], Qcur_full->nb[3], n_embd_head * ggml_element_size(Qcur_full));这个“Q 投影多输出一截当门”的做法在 llama.cpp 里不是第一次出现——llama.cpp 源码完全拆解(六):图构建与注意力 里 Qwen3 的 dense 注意力也这么干过。Qwen3-Next 的 Gated Attention 只是把它延续下来,并额外配了 q_norm / k_norm:
Qcur = build_norm(Qcur, model.layers[il].attn_q_norm, nullptr, LLM_NORM_RMS, il);Kcur = build_norm(Kcur, model.layers[il].attn_k_norm, nullptr, LLM_NORM_RMS, il);之后是 RoPE(ggml_rope_ext),注意 n_rot 由 partial_rotary_factor: 0.25 和头维 256 决定,即只旋转前 64 维——这也是 Qwen3-Next 为了超长上下文(rope_theta=1e7)做的设计。
调用 build_attn 时所有 mask、槽位参数都传 nullptr,说明这一层用的是常规 KV cache 输入,由 inp->get_attn() 内部提供的 llm_graph_input_attn_kv 封装。attn 输出后:
gate = ggml_cont_2d(ctx0, gate, n_embd_head * n_head, n_tokens);gate = ggml_sigmoid(ctx0, gate);cur = ggml_mul(ctx0, cur, gate);cur = build_lora_mm(model.layers[il].wo, cur, model.layers[il].wo_s);门控按 sigmoid(q_gate) 施加在注意力输出上,再做输出投影。这是 Qwen3-Next 官方描述里“Gated Attention”的落地:门控由 Q 投影的额外一半头维生成,不需要单独的投影权重,因此层内张量清单里只有 wo 和两个 norm。
FFN:路由专家与带门控的共享专家
build_layer_ffn 处理每层后面的 MoE。除了常规的路由分支(build_moe_ffn,512 选 10),它额外处理了共享专家:
ggml_tensor * shared_gate = build_lora_mm(model.layers[il].ffn_gate_inp_shexp, cur);shared_gate = ggml_sigmoid(ctx0, shared_gate); // 每 token 一个标量ffn_shexp = ggml_mul(ctx0, ffn_shexp, shared_gate);共享专家在 vLLM 源码完全拆解(八):MoE 层的前向执行 里也出现过:路由专家负责 specialize,共享专家负责通用能力,再用一个每 token 的 sigmoid 门控决定“共享部分贡献多少”。Qwen3-Next 的共享专家中间维是 512,和单个路由专家一样大,所以它本质上就是“第 11 个专家、但每个 token 都必走”。
混合层排布带来的推理侧后果
把上面三块拼起来后,能从代码里读出几条和部署直接相关的结论:
- 显存账本分成两套。 48 层里有 36 层是递归层,每层状态
n_embd_s()在 Qwen3-Next 里等于head_k_dim*head_v_dim*num_v_heads = 128*128*32 = 524288个元素(fp16 下约 1 MiB/层/序列);12 层全注意力层按n_embd_k_gqa + n_embd_v_gqa(每层 K、V 各256*2头维 = 512 元素)按 token 增长。上下文极长时,KV cache 的增长由这 12 层主导,这就是混合注意力对显存的意义。关于全注意力这一侧的块池与分组,可参看 vLLM 源码完全拆解(二十三):混合 KV Cache 的组账本。 - 两条 attention 路径计算形态完全不同。 递归层每层固定读 1 MiB 状态、矩阵规模 128×128;全注意力层则随上下文线性增长。调度器看到的是同一个“每 token 一个 forward”,但 batch 内不同上下文长度对两类层的耗时影响差异很大——对长上下文,递归层几乎不变,GQA 层是瓶颈;对短上下文,递归层成为主要开销。这个差异也解释了为什么 llama.cpp 在
delta-net-base.cpp里准备了三条实现:decode 单 token 走递推、批量 prefill 走分块、有融合算子时就交给一次 kernel 调用。 - 投机解码需要状态快照。
build_recurrent_attn里的keep分支和K份状态快照是为投机解码拒绝后的回滚服务的。GQA 层可以靠“裁 KV cache 长度”回滚,递归层则必须保存“每个候选 token 之后的状态”,否则一次被拒绝的投机就得重算整段——这是混合模型上投机解码最关键的一处工程差异。 - MTP 头是独立图。 当
params.gtype == LLM_GRAPH_TYPE_DECODER_MTP时build_arch_graph返回graph_mtp,把主干最后的h_nextn与下一个 token 的 embedding 一起送进额外的 MTP 块。这对应官方模型卡所说的“Multi-Token Prediction 加速推理”,也是 llama.cpp 里投机解码的一种草稿来源。
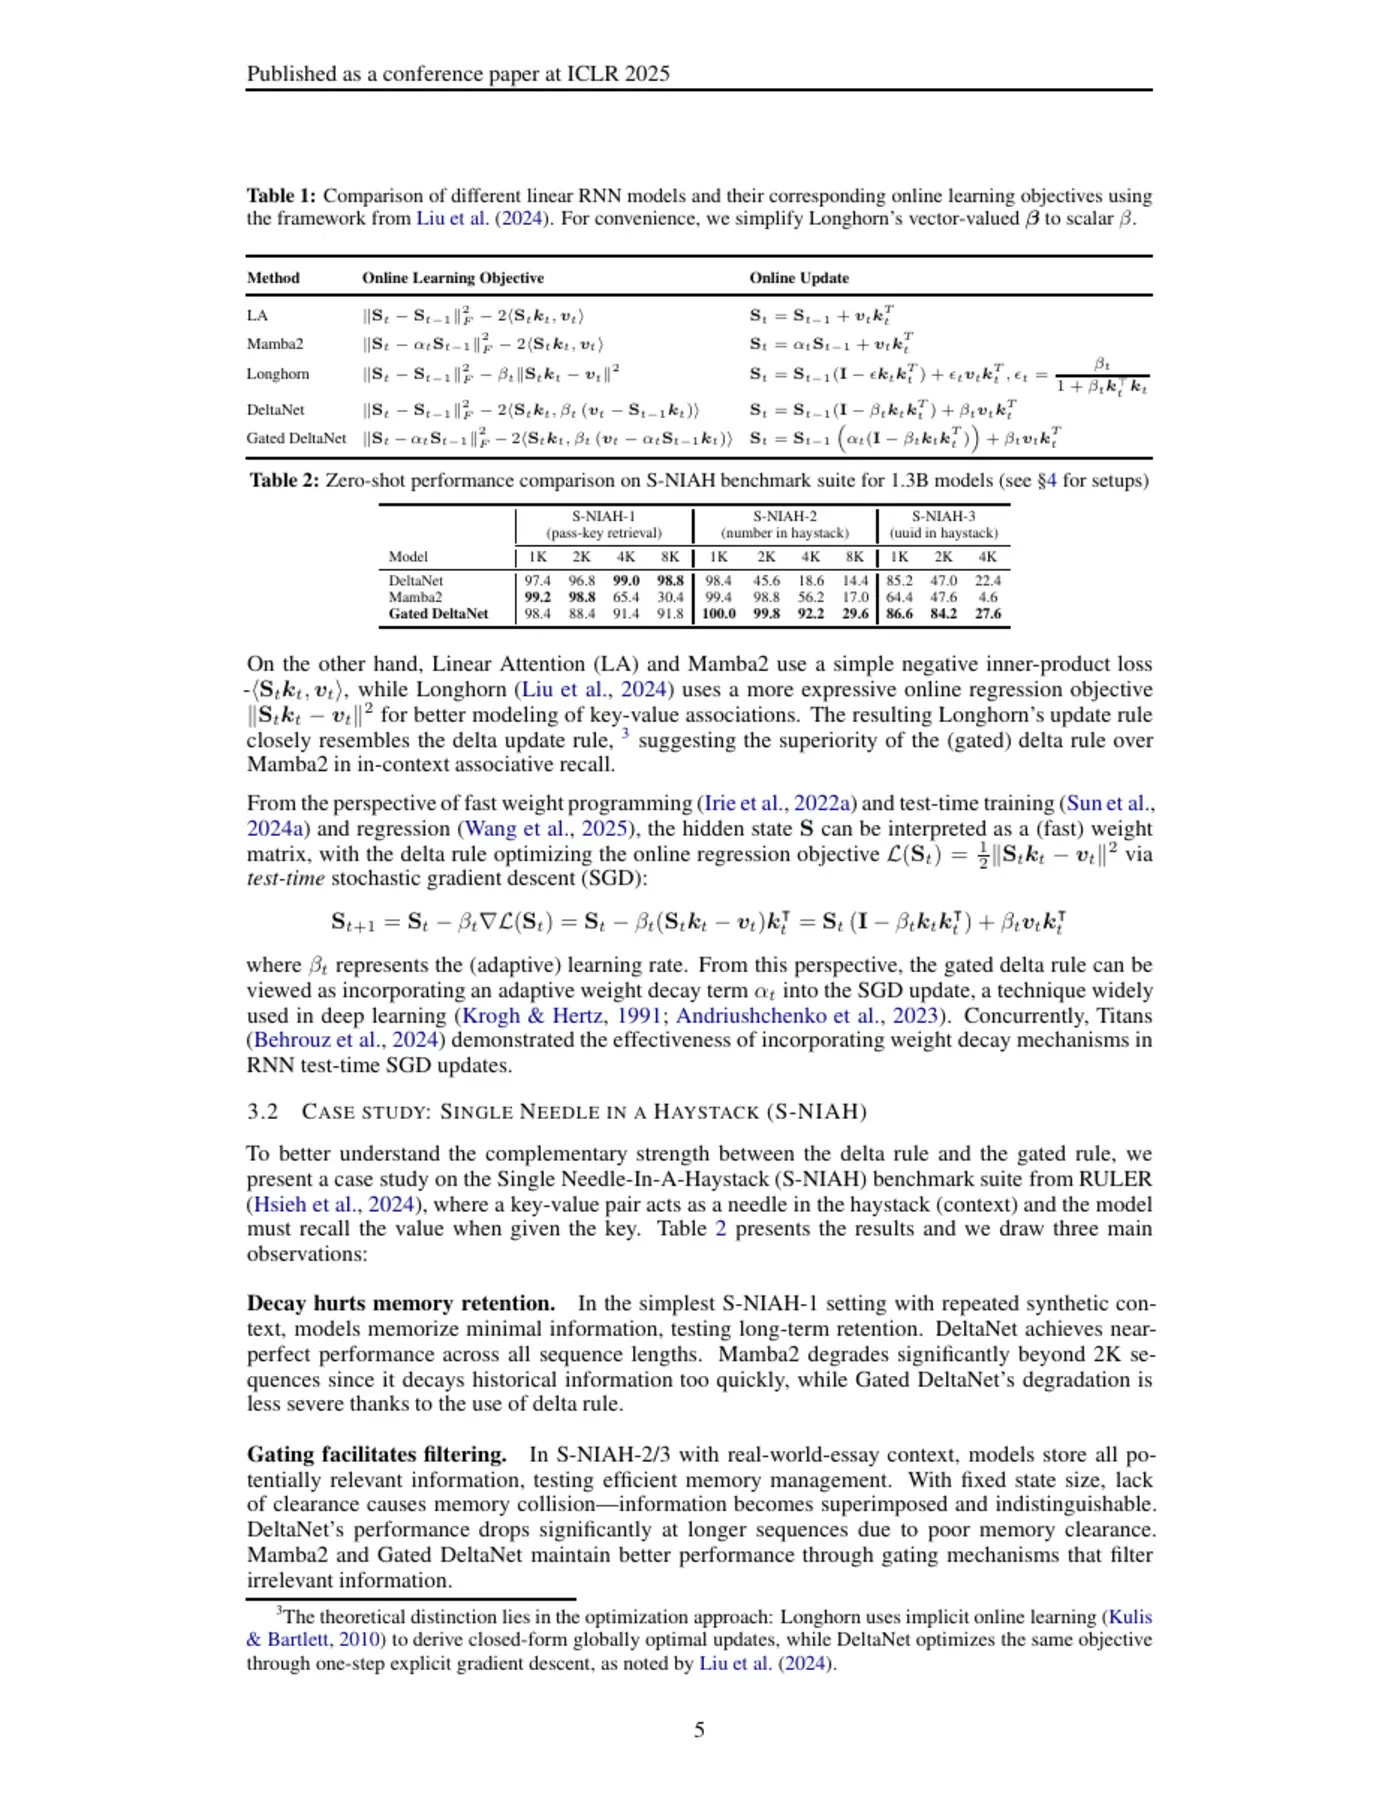
上图同样来自 Gated DeltaNet 原始论文,对比了循环形式(逐 token 递推,对应 build_delta_net_autoregressive)与分块形式(块内并行、块间串行,对应 build_delta_net_chunking)的算子结构。llama.cpp 在 decode 与 prefill 两条路径上的选择,本质上就是在算子层面复现论文里的这两种执行形态。
一个小结与阅读建议
Qwen3-Next 在 llama.cpp 中并不是“新增了一种层”,而是把已有的三套机制组合起来:Gated DeltaNet 复用 ssm_* 超参与 ring-state 缓存,Gated Attention 复用 Qwen3 的“Q+门”投影与 q/k norm,MoE 复用共享专家模式。真正需要理解的地方集中在两处——build_layer_attn_linear 里五段流水如何衔接,以及 delta-net-base.cpp 里三条实现路径的取舍。读源码时建议先用一份小 GGUF 打印出 is_recr_impl 数组和每层张量尺寸,再对着本篇的分支走一遍 graph 构造函数,比直接啃全部代码高效得多。
按本系列的进度,下一篇会继续沿 llama.cpp 的模型目录往下走,选一个与混合注意力或递归状态直接相关的模型(例如使用类似线性注意力层的后续架构),和本篇做横向对照,看同一套 delta-net-base 基类在新模型上是如何被复用或扩展的。
参考资料
- llama.cpp 源码:
src/models/qwen3next.cpp、src/models/delta-net-base.cpp、src/llama-graph.cpp(github.com/ggml-org/llama.cpp) - Qwen3-Next-80B-A3B-Instruct 模型卡:https://huggingface.co/Qwen/Qwen3-Next-80B-A3B-Instruct
- Qwen3-Next 官方配置(
full_attention_interval、linear_*超参):https://huggingface.co/Qwen/Qwen3-Next-80B-A3B-Instruct/blob/main/config.json - Gated Delta Networks: Improving Mamba2 with Delta Rule(Yang, Kautz, Hatamizadeh,2024):https://arxiv.org/abs/2412.06464
- Kimi Linear: An Expressive, Efficient Attention Architecture(KDA):https://arxiv.org/abs/2510.26692
- 站内:llama.cpp 源码完全拆解(六):图构建与注意力、llama.cpp 源码完全拆解(九):投机解码、llama.cpp 源码完全拆解(二十一):递归状态缓存
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



