


llama.cpp 源码完全拆解(十一):嵌入、重排与池化——一个序列的向量如何从计算图里读出来
从「生成」切换到「读取」
大模型推理最常见的输出形态是一个 token 序列:每一步前向只关心最后一个位置的 logits,采样器把它变成词表上的一个整数,然后循环。这个循环天然是串行的,也天然是「一条序列一条账」。但另一类工作负载的输出不是 token,而是一个固定长度的向量:把整段文本压成一行浮点数,供向量检索、聚类、分类、或者给检索结果打分。这时模型不再需要 LM head,采样器也不参与,真正要回答的问题是——一个 batch 里有多条序列,每条序列的向量从哪里读出来,怎么保证读的是对的序列、对的位置。
这个切换看似只是「取 hidden state」这么简单,实际上牵动了推理引擎里几乎每一层:
- 输入侧,token 不再按「一条序列往后追加」组织,而是多条序列并排塞进一个 batch;
- 计算侧,编码器模型需要双向注意力,不能按因果掩码只看前缀;
- 输出侧,需要把「每个 token 一行」的 hidden state 聚合成「每条序列一行」,而且聚合方式随模型而异;
- 服务侧,还要处理归一化、批内多序列、长文档切块、以及与生成请求共存的调度。
llama.cpp 把这些需求收进了一个显式的「嵌入模式」:上下文参数里有 embeddings 开关和 pooling_type,图构建阶段用专门的池化算子把 token 维压成序列维,公开 API 再用 llama_get_embeddings_seq 把每行的指针交出去。这篇文章沿着这条链路走一遍,重点不是列出 API,而是回答三个问题:池化为什么被放进计算图、为什么有些池化类型必须整条序列一次算完、以及服务端如何把几十条序列拼成一次前向还不串味。
先给一个背景坐标。BGE-M3 在 2024 年把 dense、sparse、multi-vector 三种检索表示统一到同一个编码器上(arXiv:2402.03216),它说明「一个编码器、多种读出头」已经是检索模型的常态:
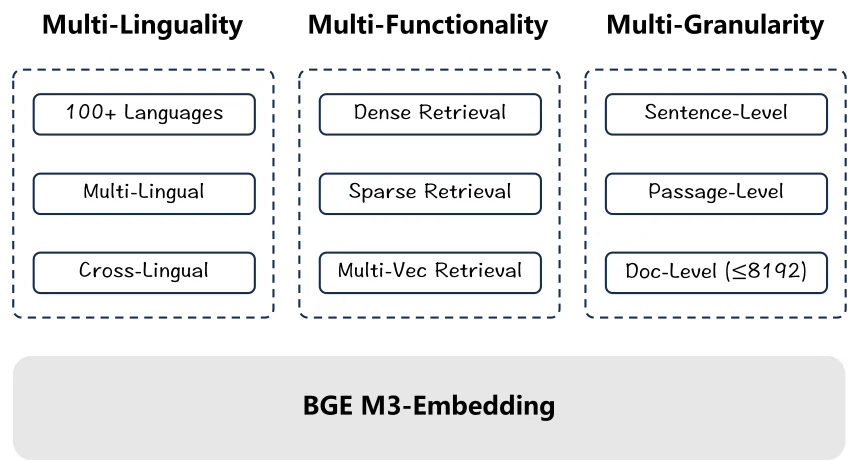
llama.cpp 的池化对应其中最基础的一条:把编码器的最后一层 hidden state 聚合成一条 dense 向量。稀疏权重和多向量表示不在池化算子的覆盖范围内,llama.cpp 也不提供对应的输出头;它只保留「不池化」这一档,让调用方拿到逐 token 的 hidden state 之后自行处理。
两个入口:decode 与 encode
理解 llama.cpp 的嵌入路径,先要分清两个公开入口。
llama_decode 是生成路径,也是大多数嵌入请求实际走的路径:它通过 llama_memory_i 管理 KV 缓存、按 ubatch 切分、逐批执行图。llama_encode 是编码器路径,专为 T5 一类 encoder-decoder 模型的编码阶段准备:它不经过 KV 缓存,强制非因果注意力,并且要求整个输入批次放进一个 ubatch。
嵌入模式并不等于编码器模式。一个 BERT 式编码器模型可以通过 llama_decode 跑(前提是上下文没有 memory,或者模型本身不需要按位置追加缓存),也可以通过 llama_encode 跑;一个 decoder-only 的 embedding 模型(例如 LlamaEmbeddingModel、Qwen3-Embedding)则必须走 llama_decode,因为它需要因果注意力,并且用最后一个 token 的表示作为序列向量。这个区分会在后面的「能不能切块」一节里变成一条硬约束。
决定「这次前向要不要输出向量、按什么方式聚合」的是三个上下文参数:
struct llama_context_params { enum llama_pooling_type pooling_type; // 池化方式 enum llama_attention_type attention_type; // 因果 / 非因果 bool embeddings; // 是否提取 embeddings // ...};pooling_type 的默认值是 LLAMA_POOLING_TYPE_UNSPECIFIED,初始化时按「用户指定 → 模型 GGUF 元数据 → 默认 NONE」的顺序落定:
if (cparams.pooling_type == LLAMA_POOLING_TYPE_UNSPECIFIED) { if (hparams.pooling_type == LLAMA_POOLING_TYPE_UNSPECIFIED) { cparams.pooling_type = LLAMA_POOLING_TYPE_NONE; } else { cparams.pooling_type = hparams.pooling_type; }}这段顺序值得留意:模型文件自己可以声明池化方式。GGUF 元数据里有 {arch}.pooling_type 这一项,转换脚本或模型作者可以写入;没有写入时,这里就落到 NONE。用户指定了但与模型默认不一致时,llama.cpp 只打一条警告,不阻止——这既给了调试空间,也埋下了「池化选错、向量全废」的坑。BGE 与 E5 的默认池化并不相同(前者 CLS、后者 MEAN),换模型时尤其要核对。
attention_type 的落定同理:未指定时跟随模型元数据里的 causal_attn;显式指定 NON_CAUSAL 时,编码器模型会关掉因果掩码。对 BERT 类模型,这个值通常是 false;对 decoder-only 模型是 true。
服务端的按 slot 切换
服务端并不是在启动时把整个上下文永久设成「嵌入模式」。llama-server 的每个 slot 有自己的任务类型,真正下发给 GPU 前会按当前批次的需要切换:
llama_set_embeddings(ctx_tgt, slot_batched->need_embd());llama_set_embeddings 内部有一个容易被忽视的动作:
// a pooled context computes the logits only without embeddings,// so the toggle changes the graph shapeif (cparams.embeddings != value && cparams.pooling_type != LLAMA_POOLING_TYPE_NONE) { sched_need_reserve = true;}原因是池化上下文在 embeddings = true 时会把 LM head 从图里摘掉;一旦开关翻转,图的结构就变了,必须重新做一次调度器预留。也就是说,嵌入请求和生成请求共用同一个上下文时,切换不是免费的,它会触发一次图重建和缓冲区重算。这也是为什么实际部署里通常用 --embedding 把服务限制为纯嵌入用途,而不是让同一实例混跑两类请求。
嵌入模式下 decode 的三个前置条件
无论走 decode 还是 encode,嵌入模式都会改写 batch 的输出语义。在 llama_decode 开头:
// when computing embeddings, all tokens are outputconst bool output_all = cparams.embeddings;// non-causal attention needs the whole sequence in one ubatchconst bool embd_all = output_all || !cparams.causal_attn;output_all 把所有 token 标记为「需要输出」。这带来一个硬性检查:如果池化方式是 NONE,需要逐 token 的向量,那么 n_outputs_all 必须等于 n_tokens_all;否则直接报错。对 pooled 模式,这个检查同样存在,但实际上已经用不到逐 token 的输出缓冲——池化把序列压成了一行。
embd_all 则决定了 ubatch 的切分策略:非因果注意力要求整条序列在同一个 ubatch 内,所以切分不能用「按 token 数均分」的简单策略,而要按序列切。这个约束在编码器模型上会进一步收紧为「整个批次一个 ubatch」,下一节展开。
池化:把 token 维压成序列维
llama.cpp 支持五种池化语义,枚举定义在公开头文件里:
| 枚举 | 语义 | 读取位置 | 典型模型 |
|---|---|---|---|
NONE | 不池化,逐 token 输出 | 每个输出 token | 需要自定义聚合、稀疏/多向量检索 |
MEAN | 序列内 token 向量取平均 | 整条序列 | E5 等 |
CLS | 取第一个位置(CLS token) | 位置最小的 token | BERT 类编码器、BGE |
LAST | 取最后一个位置 | 位置最大的 token | decoder-only embedding 模型 |
RANK | 池化后接分类头,输出分数 | 视模型:CLS 或 LAST | reranker、分类模型 |
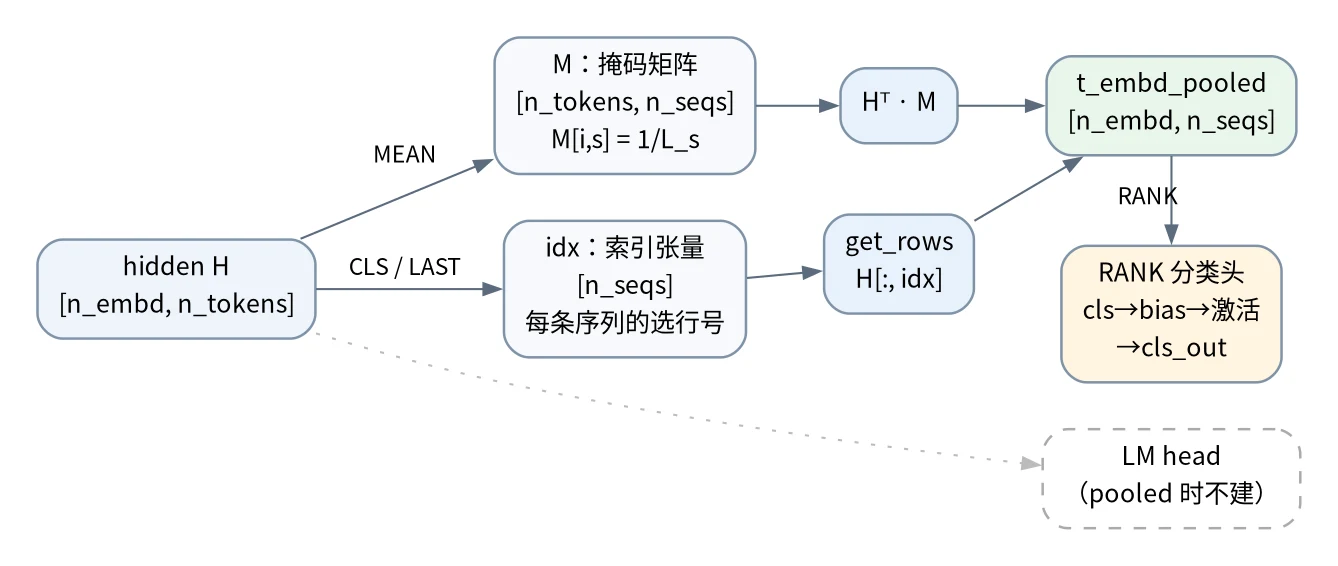
这五种不是「同一件事的五种写法」,它们在计算图里的形态分成两类:MEAN 是矩阵乘,CLS/LAST 是按行取值,RANK 是「先取值或平均,再接一条分类头」。理解这三类形态,才能理解后面的形状约束。
MEAN:一张 0/1 掩码矩阵
最直观的均值池化写法是:对每条序列,把它的 token 向量加起来除以 token 数。放到 GPU 上,逐序列循环会让 kernel 的并行度依赖序列数,也不适合 ggml 的图执行模型。llama.cpp 的做法是把它写成一个矩阵乘法:
设 hidden state 矩阵为
其中每一列是一个 token 的向量。构造一个掩码矩阵
当 token 属于序列 时,,否则为 ; 是该序列在当前 ubatch 里的 token 数。于是
的第 列就是序列 的均值向量。一次矩阵乘同时算出所有序列的池化结果,形状只依赖 n_tokens 和 n_seqs_unq,与序列长度分布无关——这正是 llama.cpp 想要的「形状可预测」。
图里的构造只有一行:
cur = ggml_mul_mat(ctx0, ggml_cont(ctx0, ggml_transpose(ctx0, inp)), inp_mean);inp 是 [n_embd, n_tokens],转置并连续化后变成 [n_tokens, n_embd];inp_mean 是 [n_tokens, n_seqs_unq] 的 F32 输入张量;ggml_mul_mat 得到 [n_embd, n_seqs_unq]。注意转置后的 ggml_cont:ggml 的矩阵乘对内存布局有要求,非连续视图必须先物化,否则 kernel 会按错误的 stride 读数据。
掩码矩阵的内容不是在图里算的,而是在 set_input 阶段由 CPU 填好:
void llm_graph_input_mean::set_input(const llama_ubatch * ubatch) { const int64_t n_tokens = ubatch->n_tokens; const int64_t n_seq_tokens = ubatch->n_seq_tokens; const int64_t n_seqs_unq = ubatch->n_seqs_unq;
float * data = (float *) mean->data; memset(mean->data, 0, n_tokens*n_seqs_unq*ggml_element_size(mean));
std::vector<uint64_t> sums(n_seqs_unq, 0); for (int i = 0; i < n_tokens; i += n_seq_tokens) { for (int s = 0; s < ubatch->n_seq_id[i]; ++s) { const llama_seq_id seq_id = ubatch->seq_id[i][s]; const int32_t seq_idx = ubatch->seq_idx[seq_id]; sums[seq_idx] += ubatch->n_seq_tokens; } }
std::vector<float> div(n_seqs_unq, 0.0f); for (int s = 0; s < n_seqs_unq; ++s) { if (sums[s] > 0) div[s] = 1.0f / float(sums[s]); }
for (int i = 0; i < n_tokens; i += n_seq_tokens) { for (int s = 0; s < ubatch->n_seq_id[i]; ++s) { const llama_seq_id seq_id = ubatch->seq_id[i][s]; const int32_t seq_idx = ubatch->seq_idx[seq_id]; for (int j = 0; j < n_seq_tokens; ++j) { data[seq_idx*n_tokens + i + j] = div[seq_idx]; } } }}这段代码里有三个设计点值得拆开。
第一,n_seq_tokens 是「每序列组的 token 数」,不是「每条序列的长度」。 llama.cpp 的 ubatch 按「序列组」组织,一个组里的 token 在位置上对齐;如果一个 token 同时属于多条序列(共享前缀的父子序列),n_seq_id[i] 会大于 1,同一个位置要往多个掩码列里写系数。所以外层的步长是 i += n_seq_tokens,内层再遍历这个位置的序列集合。
第二,系数是 1 / L_s,而 L_s 用 sums[seq_idx] += n_seq_tokens 累加。 这意味着均值是对「当前 ubatch 内的 token 数」取平均,而不是对「整条序列的总长度」取平均。对单 ubatch 的短序列两者一致;对分块的长序列,如果池化在每块上各算一次,再把块向量平均,结果并不等于整条序列的均值——每块的权重会变成均等,而不是按 token 数加权。这正是 MEAN 池化不能随意分块的原因,后面会看到服务端的切块判断直接把它排除在外。
第三,seq_idx 是「序列 id → 列号」的映射。 ubatch 里的序列 id 是调用方给的任意整数(服务端用 slot id,可能不连续),而掩码矩阵的列必须紧凑。llama_ubatch 预先把 seq_id_unq 和 seq_idx 建好,掩码写入和后面的输出读取都用同一套映射。
CLS 与 LAST:一个索引张量
CLS 和 LAST 只取一个位置,不需要掩码矩阵,只需要每条序列一个行号:
ggml_tensor * inp_cls = build_inp_cls(); // [n_seqs_unq] I32cur = ggml_get_rows(ctx0, inp, inp_cls); // MEAN 分支里由 build_inp_mean() 提供掩码矩阵inp 是 [n_embd, n_tokens],ggml_get_rows 按索引取列,得到 [n_embd, n_seqs_unq]。索引由 set_input 填入,选行逻辑是这段:
const bool last = (cparams.pooling_type == LLAMA_POOLING_TYPE_LAST || (cparams.pooling_type == LLAMA_POOLING_TYPE_RANK && cparams.causal_attn));
for (int i = 0; i < n_tokens; ++i) { const llama_pos pos = ubatch->pos[i]; for (int s = 0; s < ubatch->n_seq_id[i]; ++s) { const llama_seq_id seq_id = ubatch->seq_id[i][s]; const int32_t seq_idx = ubatch->seq_idx[seq_id];
if ((target_pos[seq_idx] == -1) || ( last && pos >= target_pos[seq_idx]) || (!last && pos < target_pos[seq_idx])) { target_pos[seq_idx] = pos; target_row[seq_idx] = i; } }}last 为真时取位置最大的行,为假时取位置最小的行。注意它不是「取数组的第一个/最后一个元素」,而是按位置选行:ubatch 里的 token 顺序未必等于位置顺序(多序列拼接、KV 复用、位置重排都会打乱),用位置比较才是可靠的。
RANK 的 last 条件还有一个后缀:只有因果的 RANK 才取最后一个位置。这对应两类 reranker:
- BERT 式 cross-encoder(非因果):query 和 document 拼成一条序列,取
[CLS]位置的表示接分类头; - decoder-only reranker(因果,例如 Qwen3-Reranker):整条序列的最后一个 token 才能看到全部上下文,取最后一个位置。
如果反过来,在因果模型上取 CLS,位置 0 的 token 只能看到自己,分类头拿到的是一段几乎无信息的表示——这是实践中很容易犯的错,后面「池化选错」一节会再提。
RANK:池化之后的一条分类头
RANK 的图不是「池化完就结束」,而是继续接分类头。核心代码如下:
case LLAMA_POOLING_TYPE_RANK:{ if (hparams.pooling_type_cls == LLAMA_POOLING_TYPE_MEAN) { // modern bert with classifier_pooling = "mean" cur = ggml_mul_mat(ctx0, ggml_cont(ctx0, ggml_transpose(ctx0, inp)), build_inp_mean()); } else { cur = ggml_get_rows(ctx0, inp, build_inp_cls()); }
if (cls) { cur = ggml_mul_mat(ctx0, cls, cur); if (cls_b) cur = ggml_add(ctx0, cur, cls_b); cur = ggml_unary(ctx0, cur, hparams.act_cls); if (cls_norm) cur = build_norm(cur, cls_norm, NULL, LLM_NORM, -1); }
if (cls_out) { cur = ggml_mul_mat(ctx0, cls_out, cur); if (cls_out_b) cur = ggml_add(ctx0, cur, cls_out_b); }
if (arch == LLM_ARCH_QWEN3 || arch == LLM_ARCH_QWEN3VL) { cur = ggml_soft_max(ctx0, cur); }}这条链回答了四个模型差异:
- 池化基座不同:ModernBERT 一类模型的分类头以 mean 池化为输入,其余多数以 CLS 为输入。
hparams.pooling_type_cls就是模型声明的「分类头用哪种池化」。 - 头的层数不同:有的模型只有一层
cls(Linear + bias + 激活),有的还有cls_out(再一层投影到类别数)。Jina reranker 的 tiny 版本就没有cls_out,代码里对两层都做了可空判断。 - 激活不同:
act_cls由模型元数据给出,可能是 GELU、ReLU、tanh 等。 - 归一化位置不同:
cls_norm是分类头内部的 LayerNorm,和输出向量的 L2 归一化不是一回事。
最后一行的 softmax 只对 Qwen3 系模型生效:它的分类头输出两个 logit(yes/no 或相关/不相关),需要 softmax 变成概率。其他 reranker 通常输出单个 logit,由服务端或调用方决定是否过 sigmoid。llama.cpp 不会替所有模型统一做激活,这是使用 rerank 接口时必须核对的模型细节。
池化上下文不建 LM head
还有一个结构性后果:只要池化类型不是 NONE,build_logits 会把 logits 指针置空:
// a pooled embeddings context outputs one vector per sequence,// so its graph skips the LM headif (cparams.embeddings && pooling_type != LLAMA_POOLING_TYPE_NONE) { res->t_logits = nullptr;}词表投影是 decoder 模型里最贵的一层(),把整个 batch 的所有输出行都投影一遍纯属浪费。池化模式直接把它从图里摘掉,这是嵌入模式相对「先当生成模型跑、再自己取 hidden」最直接的速度收益。
反过来,pooling none 时 LM head 仍然会被展开——因为 logits 指针没有被置空,模型建图时仍然会 expand 输出。对只需要逐 token 向量的场景,这是一笔可以避免的开销;实践中应该显式把 embeddings 打开并接受这个代价,或者在上层用 pooling none 时只标记必要的输出行。这个细节在源码注释里没有强调,但值得在读 build_logits 时留意。
形状约束:为什么有些池化只能一次算完
池化被放进计算图之后,它就不再是「取一个 hidden state」这么简单的后处理,而是一个有形状输入、有形状输出的图节点。输入张量的形状是 [n_embd, n_tokens],池化矩阵的形状是 [n_tokens, n_seqs]。前者由当前 ubatch 的 token 总数决定,后者由当前 ubatch 的序列数决定——也就是说,每换一次切分方式,图的形状就变了。
这直接引出了 llama.cpp 嵌入模式里最重要的一条设计约束:不同池化类型对「能否把一条序列拆到多个 ubatch」的容忍度不同。
MEAN 与 CLS:拆开就错
先看 MEAN。前面已经提到,掩码系数是 1 / L_s,而 L_s 是当前 ubatch 内该序列的 token 数。如果一条 2048 token 的文档被切成两个 1024 token 的 ubatch 分别池化,那么:
- 第一个 ubatch 输出的是前 1024 个 token 的均值 ;
- 第二个 ubatch 输出的是后 1024 个 token 的均值 。
无论上层怎么组合这两个向量(直接相加再除以 2,还是别的加权),都很难精确等于整条序列的均值 ——除非上层知道每块的 token 数并相应地加权。而 llama.cpp 的公开 API llama_get_embeddings_seq 只交出一条序列一行向量,并没有「块信息」可言。换句话说,一旦 MEAN 池化跨了 ubatch,语义就丢了。
CLS 更直接:它取的是「位置最小」的 token。如果序列被拆分,那么后面几个 ubatch 里根本不存在位置最小的那个 token,池化矩阵里对应的行号指向的是这一块里的最小位置——结果变成了「每块各自的 CLS」,而不是整条序列的 CLS。
所以对 MEAN 和 CLS,正确的做法是让整条序列落在同一个 ubatch 里。
服务端的切块判断
llama-server 并没有把这条规则写进上下文层,而是写成了一个显式的前置判断:
// if the context does not have a memory module then all embeddings// have to be computed within a single ubatchif (!llama_get_memory(ctx_tgt)) { return false;}// context can be chunked/split if the pooling type is LASTconst auto pooling = llama_pooling_type(ctx_tgt);if (pooling == LLAMA_POOLING_TYPE_LAST) { return true;}// causal rerankers read the last token and have a KV cache, so they// can also be chunked/split.if (pooling == LLAMA_POOLING_TYPE_RANK && llama_get_causal_attn(ctx_tgt)) { return true;}这段代码是「这条任务能否被拆成多个 batch 处理」的判定函数,返回 false 意味着整条 prompt 必须作为一批、一次前向算完。它给出的结论是:
- 没有 KV 缓存(例如纯编码器模型通过
llama_decode跑,上下文里没有 memory)→ 不能拆; - 池化方式是 LAST → 可以拆(位置最大的 token 一定在最后一块里);
- 池化方式是 RANK 且是因果模型 → 可以拆(reranker 读最后位置,和 LAST 同理);
- 其余情况(MEAN、CLS、非因果 RANK)→ 不能拆。
pooling none的逐 token 模式不在这个判定里单独列出,它走的是同一套批次路径,但服务端只用它返回整批 prompt 的逐 token 向量,不存在跨批拼接的问题。
为什么 LAST 可以拆
LAST 取的是位置最大的 token。位置是单调递增的,序列的最后一块 ubatch 必然包含最大的那个位置,因此「最后一块里的最大位置」就是「整条序列的最大位置」——池化矩阵的选行结果与是否拆分无关。
这就解释了一个常见的观察:decoder-only 的 embedding 模型在处理长文档时,比 BERT 式模型更”友好”。GTE-Qwen、E5-Mistral、LlamaEmbeddingModel 这类模型用的是 LAST(或 EOS)池化,只要把文档切块喂进去,池化总能读到最后一块里最后一个 token 的表示;而 BGE(CLS)与 E5(MEAN)这类非因果模型切开就丢语义。这不是实现质量问题,而是池化语义本身的数学性质。
另一条更硬的约束:启动时的参数检查
除了运行期的切块判断,服务端启动时还有一条配置层面的保护。嵌入模式要求一次前向覆盖整批 token;如果 n_batch 大于 n_ubatch,llama_decode 就会把一批拆成多块,池化矩阵的形状也就跟着变。服务端的做法是直接修正参数并给出警告:
// validate batch size for embeddings// embeddings require all tokens to be processed in a single ubatchif (params.embedding && params.n_batch > params.n_ubatch) { SRV_WRN("embeddings enabled with n_batch (%d) > n_ubatch (%d)\n", ...); SRV_WRN("setting n_batch = n_ubatch = %d to avoid assertion failure\n", ...); params.n_batch = params.n_ubatch;}注意这里修正的是 n_batch(一次 llama_decode 最多接收的 token 数),而不是允许 n_batch 大于 n_ubatch。效果是一样的:llama_decode 内部的 ubatch 切分循环就不会把一批拆成多块,从而保证整条 prompt 在同一个 ubatch 内完成。
图复用与形状的联动
还有一个容易被忽视的后果:因为池化矩阵的形状依赖 n_tokens 与 n_seqs,嵌入模式下几乎每个 batch 的形状都不一样,图的复用率天然较低。llm_graph_input_mean::set_input 里用 memset 把整个矩阵清零再填值,而不是「只改变化的行」——对一个只用于嵌入的图,这种朴素写法是够用的:池化矩阵本身很小(n_tokens × n_seqs 的浮点),不值得为它引入更复杂的增量更新逻辑。
对于 pooling none 这种逐 token 输出的模式,情况又不一样:没有池化矩阵,t_embd 就是整块 hidden state,n_outputs 直接等于 n_tokens。此时 ubatch 可以正常切分,但输出缓冲区要能容纳整个批次的所有行——这也解释了前面提到的那个检查:n_outputs_all 必须等于 n_tokens_all。
前向之后:一份 embd_seq 映射
图算完之后,t_embd_pooled 被异步拷贝回主机侧。这里 llama.cpp 做了一个关键的「记账」:按序列 id 而不是按张量行列来保存结果。
// extract sequence embeddingsauto & embd_seq_out = embd_seq;
for (uint32_t s = 0; s < ubatch.n_seqs_unq; ++s) { const llama_seq_id seq_id = ubatch.seq_id_unq[s]; const int32_t seq_idx = ubatch.seq_idx[seq_id];
const uint32_t n_embd_out = hparams.n_embd_out(); embd_seq_out[seq_id].resize(n_embd_out); ggml_backend_tensor_get_async(backend_embd, t_embd, embd_seq_out[seq_id].data(), (n_embd_out*seq_idx)*sizeof(float), n_embd_out*sizeof(float));}embd_seq 是 std::map<llama_seq_id, std::vector<float>>,每个序列 id 对应一条主机侧的缓冲。它让公开 API 的签名变得非常自然:
float * llama_context::get_embeddings_seq(llama_seq_id seq_id) { auto it = embd_seq.find(seq_id); if (it == embd_seq.end()) { return nullptr; } return it->second.data();}调用方只需知道自己的序列 id(也就是服务端分配的 slot id),不需要关心 ubatch 内 token 的排列。这正是服务端能够按 slot 取回各自结果的前提:多条请求可以共用一个批次,读取时却各拿各的。
对 RANK 模式,同一段读取逻辑只是换了元素宽度:
case LLAMA_POOLING_TYPE_RANK:{ auto & embd_seq_out = embd_seq; const uint32_t n_cls_out = hparams.n_cls_out; for (uint32_t s = 0; s < ubatch.n_seqs_unq; ++s) { const llama_seq_id seq_id = ubatch.seq_id_unq[s]; const int32_t seq_idx = ubatch.seq_idx[seq_id];
embd_seq_out[seq_id].resize(n_cls_out); ggml_backend_tensor_get_async(backend_embd, t_embd, embd_seq_out[seq_id].data(), (n_cls_out*seq_idx)*sizeof(float), n_cls_out*sizeof(float)); }}n_cls_out 是分类头的输出维度。对常见的单分数 reranker,它等于 1,embd_seq[seq_id] 里只存一个分数;多分类模型可以大于 1,send_rerank 取 embd[0] 作为第一个类别的分数。
n_embd_out 与 n_embd_inp:别混用
这段代码里还有一条注释值得单独拎出来:
// use n_embd_out (not n_embd_inp) - the pooled embedding has the model's// output dimension, which differs from input dimension for deepstack models (e.g. qwen3vl)在大多数模型里,输入嵌入维度与输出 hidden 维度相同,所以两者可以混用而不会出错。但对 Qwen3-VL 这类「输入投影层」与「主模型 hidden 维度」不一致的模型,池化的结果沿输出维度排布;如果按输入维度去算偏移,相邻两行就会错位。这是一个典型的在工程实践中被踩到过、才补上注释的细节。
embd_seq 在批次间被清空
注意 encode 和 decode 在开始之前都会:
// sync first so any in-flight async copies into embd_seq complete before it is freedif (!embd_seq.empty()) { synchronize();}embd_seq.clear();先同步再清空的理由是:调用 ggml_backend_tensor_get_async 把数据拷进 embd_seq[seq_id] 的缓冲区是异步的;如果紧接着 clear() 让 map 节点析构,异步拷贝可能还在往一块已经释放的内存里写。先 synchronize()、再清空,是这类「异步 IO 指向容器内缓冲」场景通用的正确做法。
llama_encode:编码器专用的另一条路径
前面几节讲的是 llama_decode 里的嵌入。llama.cpp 另有一个 llama_encode 入口,专供 T5 一类 encoder-decoder 模型的编码阶段使用;它同样是「整批一次前向」的语义,只是实现更收紧。它与 decode 有几个关键差异:
// note: during encode, we always output all tokens and skip position// continuity checks (output_all=true)if (!balloc->init(batch_inp, model.vocab, true)) { ... }
// micro-batching is not possible for non-causal encoding,// so we process the batch in a single shotGGML_ASSERT(cparams.n_ubatch >= n_tokens && "encoder requires n_ubatch >= n_tokens");
...
// always use non-causal attention for encoder graphscparams.causal_attn = false;const auto * res = process_ubatch(ubatch, LLM_GRAPH_TYPE_ENCODER, nullptr, status);cparams.causal_attn = causal_attn_org;四个要点:
- 一个 ubatch 跑完整个批次。编码器要求每个 token 能看到同一条序列的所有其他 token;一旦切开,第二个 ubatch 里的 token 就看不到第一个 ubatch 的内容。所以这里不是「按序列切」,而是「全部一起切」——直接断言
n_ubatch >= n_tokens。 - 强制非因果注意力。
cparams.causal_attn临时被置为false,算完再恢复;原因是图上编码器的语义就是双向的,即使模型元数据误标为因果,也不能出错。 - 没有 memory 上下文。
process_ubatch(..., nullptr, ...)传的是空指针,编码器不会读写 KV 缓存。 - 输出全量 token。
balloc->init(..., true)把所有 token 标记为输出,后面按池化类型决定是逐 token 拷到embd还是按序列拷贝到embd_seq。
这四点合起来意味着:编码器路径下,模型必然走「不能拆块」的 MEAN / CLS 分支。对一份很长的文档,如果你想用 BERT 式模型算相似度,要么把它截断到 n_batch 以内,要么使用支持滑动窗口的编码方案(llama.cpp 本身不提供这个能力,需要在应用层拼接多段向量)。这是 BERT 类模型在长文档场景下的固有限制,不是 llama.cpp 独有的。
归一化:在引擎外做的一步
拿到向量之后,下游几乎总要做一件事:L2 归一化。余弦相似度的计算式是
如果两边都先归一化成单位向量,那么余弦相似度就退化成裸点积——这在向量数据库里是一个巨大的性能与数值优势(点积 + 内积索引即可)。
llama.cpp 把这一步放在服务层,而不是上下文层:
// normalize only when there is poolingif (llama_pooling_type(slot.ctx_tgt) != LLAMA_POOLING_TYPE_NONE) { common_embd_normalize(embd, embd_res.data(), n_embd_out, slot.task->params.embd_normalize); res->embedding.push_back(embd_res); break;}归一化函数的默认 embd_norm = 2(欧氏范数),另外支持 -1(不归一化)、0(按 int16 满量程)、1(L1 范数)、>2(p-范数):
switch (embd_norm) { case -1: sum = 1.0; break; case 0: for (...) if (sum < std::abs(inp[i])) sum = std::abs(inp[i]); sum /= 32760.0; // make an int16 range break; case 2: for (...) sum += inp[i] * inp[i]; sum = std::sqrt(sum); break; default: for (...) sum += std::pow(std::abs(inp[i]), embd_norm); sum = std::pow(sum, 1.0 / embd_norm); break;}const float norm = sum > 0.0 ? 1.0 / sum : 0.0f;for (int i = 0; i < n; i++) out[i] = inp[i] * norm;这里有两个需要讲清楚的细节。
第一个:对 pooling none 不归一化。 在逐 token 模式下,服务端返回了「每一个 token 一行」的向量。这些向量本身并不是”一句语义的代表”,归一化对它们没有普遍意义;更糟的是,如果调用方准备自己做别的处理(例如按词重要性加权、或拼接成 ColBERT 式的多向量),预先归一化会让后续的余弦/内积计算被夹带一层隐含的缩放。所以 llama.cpp 选择在这个模式下返回原始隐藏状态,把归一化交给调用方。这与 BGE-M3 设计里 dense、sparse、multi-vector 三种表示共享一个 encoder、各自不同后处理的思路是一致的:同一个编码器,不同的读出方式,后处理放在各自路径上。
第二个:break 的位置。 在 send_embeddings 的循环里,一旦某一行满足 output 且 seq_id == slot.id,就取出池化结果、归一化、写回并 break 出去。这里有两层筛选:
- 先按
seq_id过滤,保证只读本 slot 的序列。一个批次里可能同时有多个 slot 的嵌入请求(甚至还有生成请求),序列 id 各不相同,llama_get_embeddings_seq只认自己的 id,别的序列不会被误读。 - 再按
output过滤:当前 token 是否被标记为需要输出。它决定了在batch.tokens里哪些行会被选中,而不论池化类型——选中之后,pooled 模式用get_embeddings_seq取整条序列那一行,pooling none模式用get_embeddings_ith取该 token 自己那一行。
break 本身没有语义作用(一条序列只有一个池化结果,后面不会再命中),它只是一个早退优化。真正保证结果正确的是那两个过滤条件。
与归一化顺序相关的一个陷阱
从「池化 → 归一化 → 返回」的顺序看,llama.cpp 采用的是「先算均值向量,再单位化」,而不是「先单位化每个 token 的向量,再算平均」。这两种顺序在很多模型上的结果不相等:
- 先均值后归一化:
- 先归一化后均值:(再归一化)
对于 Sentence-Transformers 生态中的很多文本 embedding 模型,论文和训练代码采用的都是前一种,llama.cpp 的实现与之一致。如果哪一步顺序搞反,向量相似度会系统性偏移。这种偏差不会让程序崩溃,只会让召回率悄悄下降,因此在跨实现迁移时值得用少量样本对照一次。
Matryoshka:截断与再归一化
检索系统里还有一类操作叫 Matryoshka Representation Learning:训练时让向量的前缀本身也是一个可用的低维嵌入。因此推理时可以只取前 维,再把 维向量单位化,从而用更小的存储换近似相同的召回。Matryoshka 的思想在 2022 年由 Kusupati 等人提出(arXiv:2205.13147),核心是「嵌套子集都可独立用于检索」:
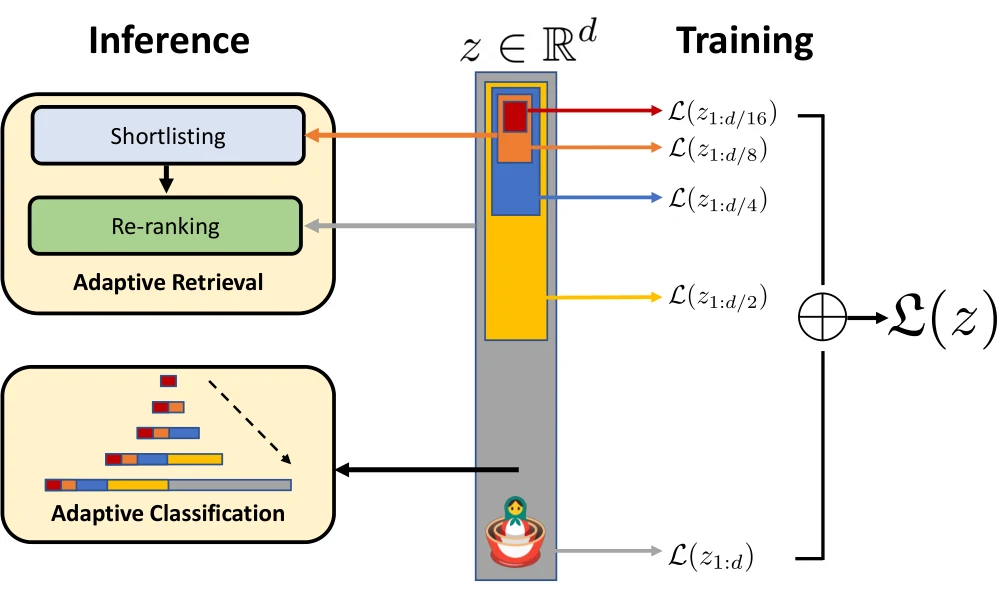
llama.cpp 本身不处理 Matryoshka 截断——服务端返回的是完整维度的归一化向量。如果要在 llama.cpp 上使用 Matryoshka 模型,正确顺序是:拿回完整向量后,先截断到目标维度,再对截断后的向量做一次 L2 归一化。直接截断已归一化的完整向量,得到的是一个非单位向量,会导致内积排序与设计预期不一致。
服务端:把嵌入接进与生成共存的调度
前几节讲的是引擎内部。真实部署中,嵌入请求不是孤立存在的——它们会与生成请求竞争调度器、KV 缓存和 CUDA Graph 资源。llama-server 用 slot 的概念统一这两类任务:每个 slot 持有自己的上下文和任务类型,调度器在批组装时只关心「哪些 slot 能放进同一批」。
一个请求的路径
一条嵌入请求进来,大致经历:
- 路由层:
/v1/embeddings、/embeddings、/embedding、/v1/rerank、/rerank等路由接到同一组处理函数; - 请求解析:提取
input(文本或文本数组)、可选的embd_normalize(非 OAI 接口)、top_n(rerank); - slot 分配:找一个空闲 slot,把任务类型标为 embedding / rerank;
- 批组装:与生成任务一起进入调度器的批;
- 前向:按 slot 是否需要嵌入切换
llama_set_embeddings,然后执行; - 结果回填:从
llama_get_embeddings_seq或_ith读取,并归一化写回响应。
其中第 5 步的 llama_set_embeddings(ctx_tgt, slot_batched->need_embd()) 我们前面讲过:切换开关会触发调度器重新预留,也就是说混跑两类请求会让每一批进入和离开嵌入态时都付出一次图预留的代价。对于以嵌入为主的场景,--embedding 参数会在启动时把服务限定为纯嵌入用途,从而避免这种来回切换。
两个接口的差异
服务端的 /embeddings(非 OAI)与 /v1/embeddings(OAI 兼容)的差异并不是命名包装层面那么简单:
/embeddings支持所有池化方式,包括pooling none,后者返回每个 token 的未归一化向量;/v1/embeddings要求池化方式不为none,并且返回的向量是按欧氏范数归一化的;/embeddings允许在请求级别传embd_normalize覆盖服务端默认值,而 OAI 接口不暴露这个选项。
这意味着:如果你在 llama.cpp 上部署一个 BERT 类 embedding 模型,想给下游返回原始未单位化的向量做其他用途,应当走非 OAI 接口并显式传 embd_normalize: -1;而不是去 OAI 接口再想办法反归一化。后者理论上可以恢复,但浮点精度上会有舍入误差。
rerank 接口的语义
/rerank 系列接口要求模型以 --pooling rank(或 --reranking)启动——也就是上文的 RANK 模式。它返回的是「query 与每篇 document 的相似度分数」,而不是向量本身。对于 BERT 式 cross-encoder,query 与 document 拼接成一条序列后整段穿过模型,从 [CLS] 位置接分类头读分数;对于 decoder-only reranker,序列以最后一个 token 的表示接分类头读分数。两种形态共用同一套池化图,只是 pooling_type_cls 与 causal_attn 的组合不同。
这也意味着 rerank 请求天然是”每条序列一段 prompt”,和 embeddings 请求一样需要按序列组织 batch;并且对 BERT 式 reranker,同样受「不能拆块」的约束——query+document 必须能放进同一个 ubatch。
几个容易踩的坑
前面讲的是机制,最后把工程里最常见的几处偏差集中列一下。它们的共同点是:程序不会报错,向量看起来也正常,但检索质量会悄悄下降。
池化类型与注意力类型必须匹配
CLS 池化取的是位置最小的 token。在因果模型上,位置 0 的 token 只能看到自己——它的 hidden state 里没有任何来自后文的上下文。拿这样一个向量去做句级相似度,效果会明显差于 LAST。
反过来,在非因果模型上用 LAST,最后一个 token 能看到整条序列,本身没有错;但训练时如果模型用的是 CLS 目标(BGE 就是一例),最后一层的表示并没有被训练成”句向量”,效果同样会下降。池化方式不是推理期的自由参数,而是模型训练目标的一部分。
llama.cpp 对这种情况的处理很克制:用户指定的 pooling_type 与模型元数据里的默认值不一致时,只打一条警告,不阻止。这是给调试留空间,但也意味着把 --pooling mean 随手加到 BGE 上不会被拦下来。部署前应该先确认模型卡(model card)里写的 pooling 是什么,再决定是否覆盖。
指令前缀与特殊 token 不会被自动补
E5 一类模型在训练时给 query 和 passage 分别加了 query: / passage: 前缀;BGE 的中文模型也有类似的 instruction 约定。llama.cpp 的分词器只负责把输入文本切成 token,并加上模型配置里的 BOS/EOS,它不知道”这是 query”还是”这是 document”,因此不会替你补领域前缀。
如果直接拿原始文本去请求,得到的向量与训练分布不一致,召回率会下降,而且这种下降很难从单条结果上看出来。正确做法是在调用方拼好前缀:查询侧加 query: ,文档侧加 passage: ,再分别请求。同理,如果模型训练时对输入做了小写化、去重音或截断,调用方也要在请求前完成。
MEAN 会把特殊 token 一起平均
MEAN 的掩码覆盖当前 ubatch 内的所有 token,包括 BOS 与 EOS。很多句向量模型在训练时也是这样处理的,所以这通常没问题;但如果某个模型在训练时显式排除了特殊 token,推理时又把它们算进均值,向量就会有一个小幅但系统性的偏移。
llama.cpp 没有提供”排除特殊 token”的开关——掩码只按序列归属生成,不按 token 类型过滤。遇到这类模型,需要走 pooling none,拿到逐 token 向量后由调用方自行选择参与平均的位置。这也是 pooling none 这一档存在的另一个理由:当引擎的池化语义与模型训练语义不完全一致时,保留一个”不池化”的逃生舱。
长度上限是三个参数的联合约束
一条嵌入请求能有多长,不只取决于 n_ctx:
n_ctx决定位置编码与缓存能覆盖的最大长度;n_batch决定一次llama_decode最多接收多少 token;n_ubatch决定图一次能处理多少 token,而嵌入模式又要求n_batch = n_ubatch。
三者共同把”单条输入的长度上限”压到 min(n_ctx, n_batch)。超过这个上限的输入,服务端要么截断、要么报错,具体行为取决于请求参数与启动配置。部署时应该把 --ctx-size 与 --batch-size / --ubatch-size 按最长文档长度一起调大,而不是只调 --ctx-size;只调后者并不会让一次前向多容纳 token。
不要把生成请求的 /v1/completions 用来取向量
最后一条不算坑,但值得写下来:生成接口返回的是 token 与 logprobs,不返回句向量;/v1/embeddings 才是向量接口。用生成接口的 hidden state 去凑向量,既拿不到正确维度的输出,也绕过了池化与归一化,结果不可复现。两者在 llama.cpp 内部共享前向,但在 API 层是两条明确的路径。
实践:从 API 到向量数据库
把上面这些拼起来,一个最小可用的离线嵌入流程一般是这样:
- 模型转换:用
convert_hf_to_gguf.py转成 GGUF,并确认元数据里的pooling_type、attention_type与模型实际语义一致;不一致时可以在运行时用--pooling/--embedding覆盖,但必须知道自己在改什么; - 启动服务:
llama-server -m model.gguf --embedding --pooling mean --ctx-size N(或--pooling cls/--pooling rank); - 批量请求:调用
/v1/embeddings或/embeddings,注意每条输入的长度不能超过一次 ubatch 的容量; - 归一化与存储:pooled 结果默认已 L2 归一化,可直接入向量索引;
pooling none需自行处理; - 检索:余弦距离等价于点积。
这里最容易被忽略的是第 1 步与第 3 步的组合:pooling 选错类型、或者输入长度超过 unbatch 上限,前者会得到”看起来正常、检索效果很差”的向量,后者会直接请求失败。两者都应该在首次部署时用一小撮样本做对照测试。
横向看一眼:SGLang 把池化放在模型外面
llama.cpp 的选择是「池化进图」。另一条同样合理、甚至更常见的路线,是把池化放在模型 forward 之后,当成普通的张量运算。SGLang 的池化层就是后者,它的实现能让我们更清楚地看到 llama.cpp 那些看起来”绕”的设计到底在换什么。
SGLang 的 Pooler 拿到的 hidden state 是扁平的 [total_tokens, hidden]:一个 prefill 批次里所有请求的 token 首尾相接,请求边界由 ForwardBatch.extend_seq_lens 记录。于是三种池化都能写成一行 cumsum:
if pooling_type == PoolingType.LAST: last_token_indices = torch.cumsum(forward_batch.extend_seq_lens, dim=0) - 1 return hidden_states[last_token_indices]elif pooling_type == PoolingType.CLS: prompt_lens = forward_batch.extend_seq_lens first_token_flat_indices = torch.zeros_like(prompt_lens) first_token_flat_indices[1:] += torch.cumsum(prompt_lens, dim=0)[:-1] return hidden_states[first_token_flat_indices]elif pooling_type == PoolingType.MEAN: prompt_lens = forward_batch.extend_seq_lens end_indices = torch.cumsum(prompt_lens, dim=0) - 1 cumulative_hidden_states = torch.cumsum(hidden_states, dim=0) sums = cumulative_hidden_states[end_indices] preceding_sums = torch.zeros_like(sums) preceding_sums[1:] = cumulative_hidden_states[end_indices[:-1]] return (sums - preceding_sums) / prompt_lens.unsqueeze(-1)对照 llama.cpp 的实现,几个差异非常直观:
| 维度 | llama.cpp | SGLang |
|---|---|---|
| 池化位置 | 构建在 ggml 图里,图直接输出池化结果 | 模型 forward 之后,用 PyTorch 张量运算 |
| 输入布局 | 每个 ubatch 一个 [n_embd, n_tokens] 张量 | 整个 prefill 批次一个扁平 [total_tokens, hidden] |
| MEAN 实现 | 构造 [n_tokens, n_seqs] 掩码矩阵后做矩阵乘 | 对扁平张量做 cumsum,再按请求边界差分 |
| CLS / LAST | 由 seq_idx 选行,图里 get_rows | 由 extend_seq_lens 算扁平下标 |
| 归一化 | 服务层完成,范数可配置 | Pooler 内用 F.normalize(p=2) 完成 |
| Matryoshka 截断 | 不提供,调用方自己截断并再归一化 | 请求里的 dimensions 直接生效 |
MEAN 的 cumsum 写法有一个隐含前提:每个请求的 token 在扁平张量里是连续的一段。prefill 阶段确实如此,因为所有请求的 input_ids 被首尾相接拼成了 extend 序列;但这也意味着它不能像 llama.cpp 那样,在「一条序列被拆成多个 ubatch」的情况下自动按块池化——块与块之间的前缀不连续,cumsum 的差分就断了。SGLang 对这些模型的规避方式写在 EmbeddingModelSpec 里:对 ENCODER_ONLY 一类模型,规格中直接标出 safe_disable_chunked_prefill、safe_disable_kv_cache 与 safe_disable_radix_cache,用「不做分块预填、不申请 KV、不开前缀树」换取池化语义的简单性。这与 llama.cpp 服务端「MEAN/CLS 不可拆块」的判定是同一个约束的两种表达:一个写在调度配置里,一个写在批处理判定里。
另一个差异在请求形态。SGLang 的 TokenizedEmbeddingReqInput 里写着「Dummy sampling params for compatibility」——嵌入请求复用了生成请求的队列、状态机与 Req 对象,采样参数只是占位;调度器用 handle_embedding_request 把它变成一条普通的待调度请求。llama.cpp 走的也是同一条路:嵌入请求进入 slot,和生成请求共享批组装,只是 slot 的 need_embd() 不同。两套系统都没有为嵌入单独造一条调度通路,因为嵌入与生成在”前向”这一步是同构的,差别只在输出侧的读取方式。这也解释了为什么两边的实现都愿意为嵌入增加少量分支,而不是维护第二套引擎。
小结
llama.cpp 的嵌入路径不复杂,但它把几个容易混淆的概念清晰地分开了:
- 池化是图的一部分:MEAN 用矩阵乘
Hᵀ · M(M 是 0/1 掩码),CLS/LAST 用索引张量get_rows,RANK 在后两者之上再接分类头; - 池化上下文不建 LM head:词表投影是最贵的一层,池化模式下从图里摘掉;
- 序列 id 是读取的唯一钥匙:
embd_seq按llama_seq_id保存池化结果,llama_get_embeddings_seq直接返回; - 池化语义决定能否切块:LAST 与因果 RANK 可以在多个 ubatch 之间拆分,MEAN 与 CLS 必须整条序列一次算完;服务端用一个判定函数显式表达这条规则,启动时还会强制
n_batch = n_ubatch; - 归一化在服务层:pooled 结果默认 L2 归一化,
pooling none不归一化;Matryoshka 截断需要调用方自己处理; - 嵌入与生成共用同一套调度:切换
llama_set_embeddings开关会改变图形状并触发重新预留,纯嵌入用途应使用--embedding避免来回切换;SGLang 则把池化放在模型 forward 之后,用扁平布局和 cumsum 完成同一件事,两边的差异恰好落在「图边界画在哪」。
这个系列后续还可以沿着另一条与嵌入相邻的路线继续:LoRA 适配器如何在建图阶段替换权重。llama.cpp 的 LoRA 不是在运行时改指针,而是在 build_lora_mm 里把低秩分支拼进图,这与池化一样属于「图的形状由参数决定」的设计;适配器一换,图和缓冲区都要重新规划。那条路线会把本篇提到的 llm_graph_context、llama_adapter_lora 与服务端的 adapter 槽位串起来,是读 llama.cpp 模型层时绕不开的一块。
参考资料
- llama.cpp 官方仓库:https://github.com/ggml-org/llama.cpp
- llama.cpp 服务端文档(embeddings / rerank 接口):https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md
- Sentence-Transformers 官方文档:https://www.sbert.net
- Chen et al., BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation, arXiv:2402.03216,https://arxiv.org/abs/2402.03216
- Kusupati et al., Matryoshka Representation Learning, arXiv:2205.13147,https://arxiv.org/abs/2205.13147
- 站内延伸阅读:llama.cpp 源码完全拆解(四):llama_context 与记忆系统、llama.cpp 源码完全拆解(五):图构建与注意力、llama.cpp 源码完全拆解(八):服务化与调度、GGUF 完全拆解
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



