


TensorRT-LLM 源码完全拆解(三十二):OpenAI 协议层——一条 chat 请求如何穿过请求模型、模板渲染、工具约束与流式后处理
从第三十一篇接上:引擎内部已经讲完,外面还隔着一层协议
前面三十一篇沿着 TensorRT-LLM 的源码一路向下:调度器、KV 块管理、注意力后端、量化、并行拓扑、投机解码、GenerationExecutor、序列槽位。第三十一篇拆到无模型投机解码的控制面时,视角已经在引擎内部相当深的位置——n-gram 池怎么建、后缀自动机怎么旁路、验收怎么关闸。
但真实用户不会直接调用这些接口。用户发给服务端的是一个 HTTP 请求,请求体是 OpenAI 格式的 JSON:messages 数组、tools 列表、response_format、stream: true。从这个 JSON 到引擎能消费的 SamplingParams 加一段 prompt,中间横着一层经常被当作「胶水」的代码。这一层代码在 tensorrt_llm/serve/openai_server.py 里大约四千行,在 openai_protocol.py 里大约两千六百行,复杂度和调度器不相上下。
这一层值得单独拆,原因是它决定了三件在引擎里看不到的事:
- 请求语义怎么归一。OpenAI 的字段语义和推理引擎的采样语义并不一一对应:
temperature的默认值、logprobs > 1的可用条件、response_format与guided_decoding的关系、stop与stop_token_ids的差别,都要在这一层翻译。 - 提示怎么渲染。
messages只是对话结构,模型要的是一段按模板拼好的文本,中间还有图像、视频、工具声明、思考开关。渲染顺序错了,模型看到的东西就错了,而且不会报错。 - 输出怎么还原。引擎吐的是 token,协议层要把它切成内容、思考、工具调用三段,再按 SSE 的帧格式推给客户端。流式状态下每一步都可能切在半个 UTF-8 字符或半个 JSON 对象上。
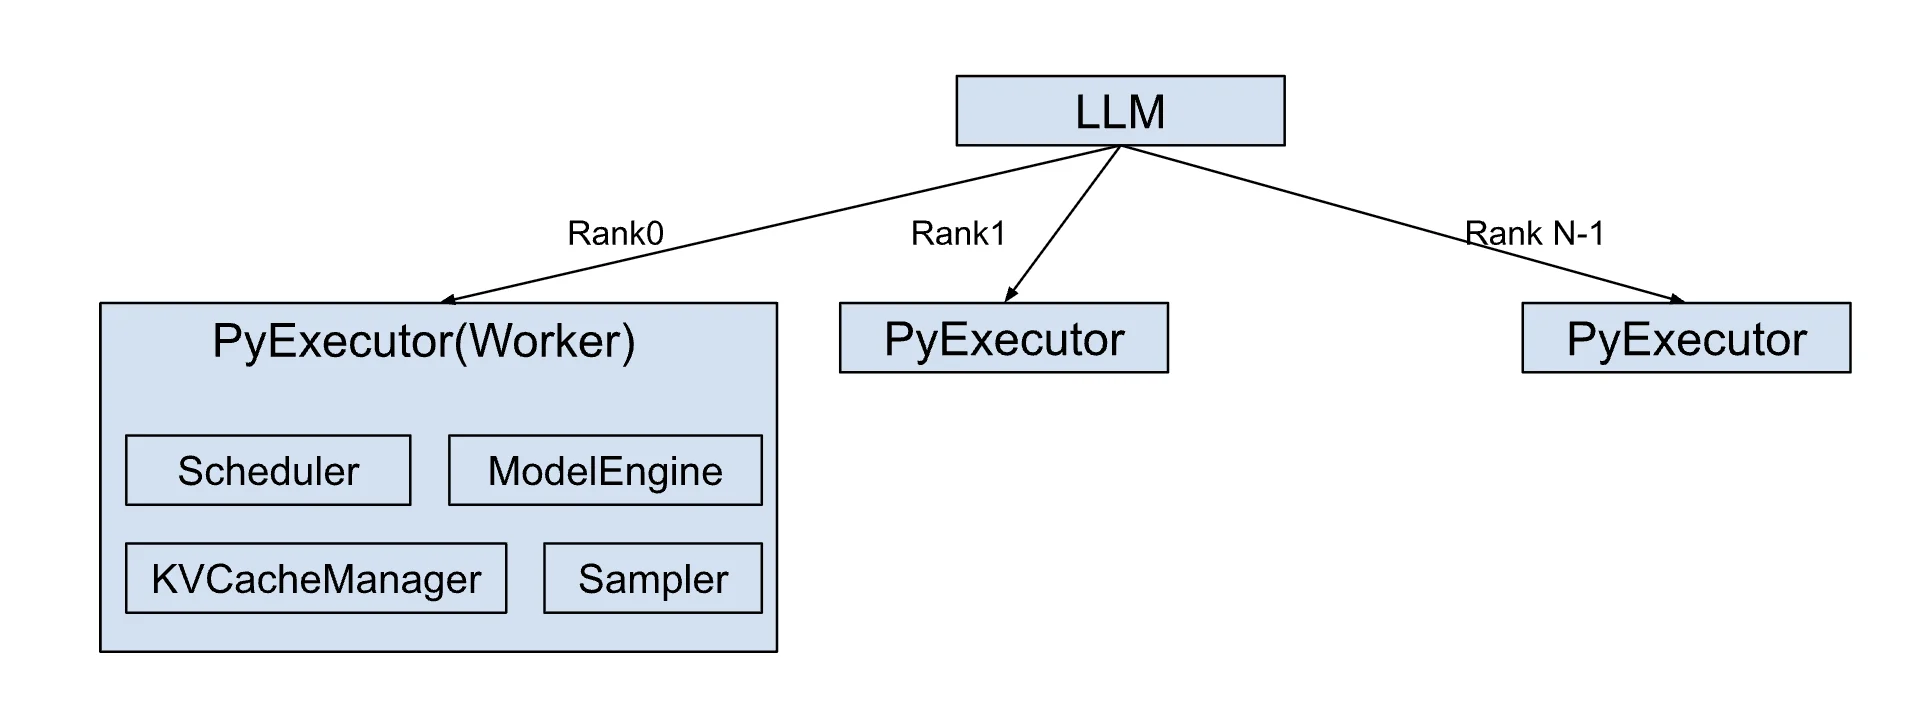
上图是 TensorRT-LLM 的整体分层。协议层位于最外侧,它的下游是 LLM/GenerationExecutor,再往内才是 PyExecutor、调度器与模型引擎。协议层不参与 GPU 前向,但它决定了进入前向的 prompt 长什么样、采样参数取什么值、输出如何被消费,因此它出问题时表现出来的现象往往像「模型质量下降」,而不是某个模块报错。
服务对象是怎么装配起来的
OpenAIServer 的构造函数接收的参数很多,但真正决定协议行为的只有几个:tokenizer、model_config、generator、tool_parser、reasoning_parser、chat_template、use_harmony、guided_decoding_backend、postproc_worker_enabled。
其中 generator 不是构造时就建好的。_init_llm(chat_template) 在稍后阶段才创建执行器,并把模板传进去;这是因为模板渲染依赖 tokenizer 与模型配置,而执行器的创建又需要模板已经确定。use_harmony 是一个分叉点:为真时,服务使用 gpt-oss 的 harmony 通道格式,/v1/chat/completions 路由指向 chat_harmony 而不是 openai_chat,同时 Anthropic 兼容路由不再注册。
postproc_worker_enabled 决定后处理发生在哪里。为真时,后处理器跑在独立进程里,HTTP 侧拿到的 RequestOutput 已经带有 _postprocess_result;为假时,HTTP 侧在每个输出帧上同步调用 post_processor(first_response, args)。这个开关的存在是因为后处理(尤其是工具解析、思考解析、增量 detokenize)是 CPU 密集的,放在 HTTP 事件循环里会拖慢并发。
一条请求的完整时序:先画出来再读代码
在读具体函数之前,先把一条 POST /v1/chat/completions 的处理顺序画成时序,后面的每一节都对应其中一段:
客户端 │ JSON body + stream=true ▼FastAPI 路由(_MsgspecRoute) │ msgspec 解析 body → ChatCompletionRequest ▼openai_chat ├─ prepare_chat_request 工具声明、扩展预处理 ├─ to_sampling_params temperature/top_p/logprobs/logit_bias/response_format ├─ parse_chat_messages_coroutines │ ├─ 纯文本消息 → conversation │ └─ 媒体项 → 异步下载/解码协程 ├─ render_conversation(与媒体协程并发) │ └─ 模板渲染 + 强制工具前缀注入 ├─ prompt_inputs 包装 prompt 结构 ├─ 工具约束装配 required / strict / forced 三选一 ├─ generator.generate_async 提交给执行器 └─ 分流 ├─ stream=true → chat_stream_generator → SSE 帧 → [DONE] └─ stream=false → _create_chat_response → JSON这条时序里有两个「先做判断、后做动作」的点:工具约束必须在 generate_async 之前装好,因为它要写进 SamplingParams;而断开监听必须在 generate_async 之后立刻挂上,否则客户端在首帧到达前断开时,引擎侧的在途请求会一直占着 KV 直到自然结束。
路由表:注册顺序本身是语义的一部分
register_routes() 是一段很长但很直白的代码。把它按功能分组看,得到的是这个服务对外承诺的全部接口:
| 组别 | 路径 | 说明 |
|---|---|---|
| 健康与元信息 | /health、/health_generate、/version、/v1/models、/server_info | 存活探针、版本、模型名 |
| 生成主接口 | /v1/completions、/v1/chat/completions | 文本补全与对话补全 |
| Anthropic 兼容 | /v1/messages、/v1/messages/count_tokens、/v1/messages/batches* | 供 Claude Code 一类客户端使用 |
| Responses API | /v1/responses、/v1/responses/{response_id} | 有状态的响应对象 |
| 观测与调试 | /metrics、/energy_metrics、/start_profile、/stop_profile | 迭代统计、能耗、profiling |
| 分离部署控制 | /kv_cache_events、/steady_clock_offset、/data_transceiver_state | P/D 分离与时钟对齐 |
| 内部接口 | /v1/tokenize、render/generate(环境变量开启) | 渲染与分词拆分 |
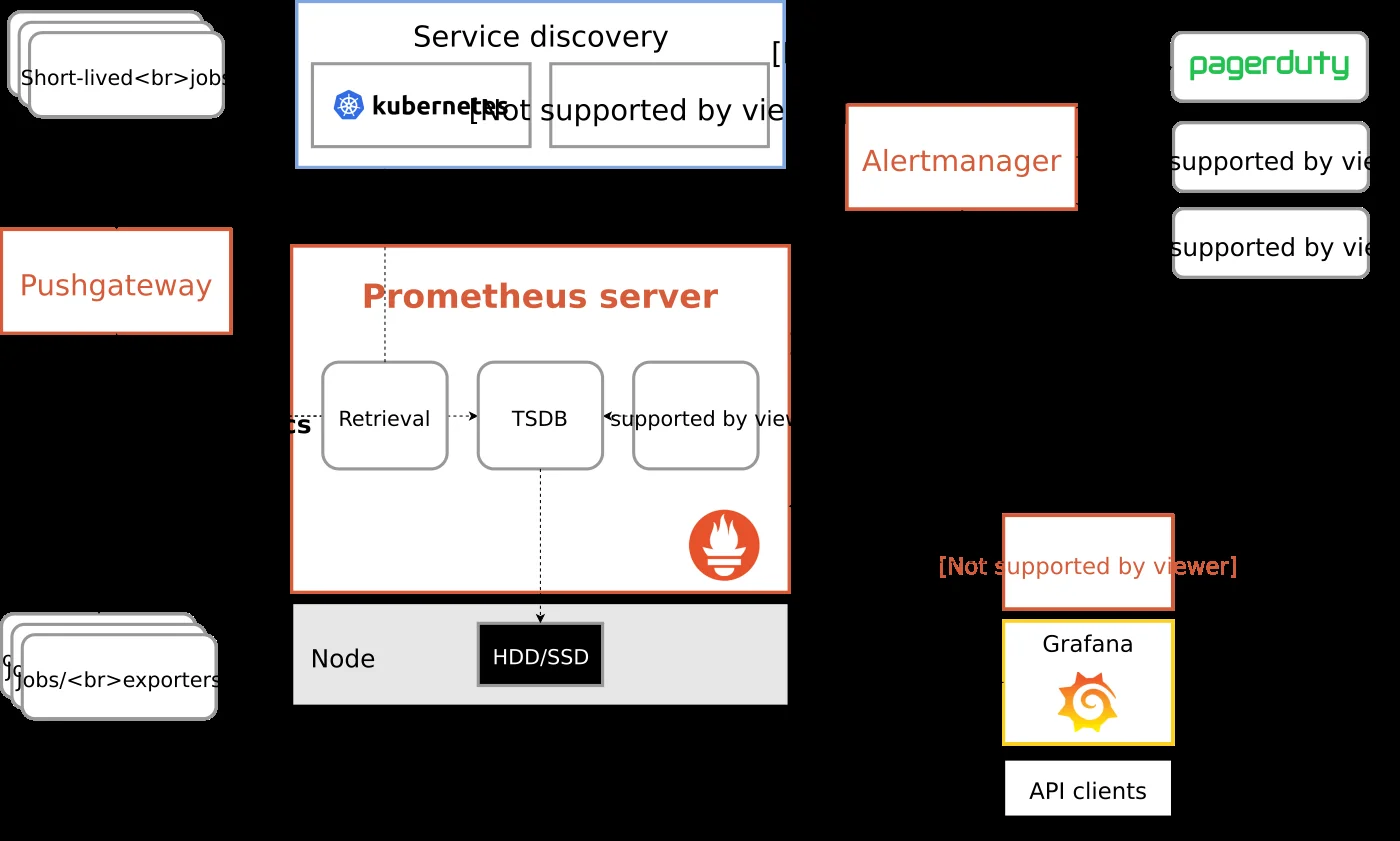
上图是 Prometheus 官方文档给出的组件关系。推理服务的 /metrics 端点在这个图里扮演的是最左侧的 target:Prometheus 按固定间隔抓取,写入时序库,再由告警规则消费。理解这张图有助于解释后面 mount_metrics() 里的多进程细节——抓取端看到的是「一个 target 的一组样本」,而服务端可能是多个进程各自维护计数器,两者之间必须靠共享目录做汇总。
这张表里有两处细节值得单独说。
第一处是注册顺序。 FastAPI 按注册顺序匹配路由。/v1/messages/batches 必须在 /v1/messages/{batch_id} 之前注册,否则字面路径会被参数路径吞掉——batches 会被当成一个 batch id。代码里对此有一条注释,说明这不是随手写的顺序。反过来,/v1/responses/{response_id} 在 /v1/responses 之后注册没有问题,因为路径段数不同,不存在歧义。
第二处是 /metrics 的口径。 代码里明确写着:这个端点目前只报告迭代统计,不报告运行时统计。mount_metrics() 只有在 args.return_perf_metrics 为真时才注册 /prometheus/metrics,而且它需要在 prometheus_client 被导入之前设置 PROMETHEUS_MULTIPROC_DIR,否则多进程模式下计数器会各算各的。这是 Prometheus 多进程模式的一个老问题:子进程各自维护计数器,靠共享目录里的 mmap 文件汇总,目录必须在客户端库导入前就绪。
# 注册顺序决定匹配优先级:字面路径必须排在参数路径之前self.app.add_api_route("/v1/messages/batches", self.anthropic_create_batch, methods=["POST"])self.app.add_api_route("/v1/messages/batches", self.anthropic_list_batches, methods=["GET"])self.app.add_api_route("/v1/messages/batches/{batch_id}", self.anthropic_get_batch, methods=["GET"])self.app.add_api_route("/v1/messages/batches/{batch_id}/cancel", self.anthropic_cancel_batch, methods=["POST"])请求模型:一个类里装了三套字段
ChatCompletionRequest 继承了 OpenAI 的字段集,又往里塞了两类扩展:一类是 TensorRT-LLM 自己的采样参数(top_k、min_p、repetition_penalty、length_penalty、use_beam_search),另一类是服务化扩展(prompt_token_ids、prompt_token_ids_b64、disaggregated_params、cache_salt、conversation_params、thinking_token_budget、lora_request)。
把这些放进同一个类,好处是校验集中、错误信息统一;代价是字段的「来源」不再一目了然。读代码时需要建立一个心理分区:哪些字段是 OpenAI 标准、哪些是社区扩展、哪些只对内部编排器有意义。比如 prompt_token_ids_b64 是给 P/D 分离的编排器用的:上下文 worker 生成 token id 后用 base64 的 int32 缓冲回传,避免在编排器的事件循环里把几万个整数逐个序列化成 JSON。
校验器里能看到几条容易被忽略的约束:
logprobs有上限检查(check_logprobs_limit),并且to_sampling_params会再做一次后端相关判断;stream_options只有在stream为真时才允许出现,否则直接拒绝——这是一个典型的「字段组合语义」校验,OpenAI 的服务端也是这么做的;suffix显式不支持,传了就报错,而不是静默忽略;thinking_token_budget走专门的校验函数,因为它会影响思考段的长度上限。
采样参数映射:默认值是语义问题
to_sampling_params() 是协议层里最重要的一段翻译代码。它把请求字段一个个搬进 SamplingParams,但有几处不是简单搬运:
sampling_params = SamplingParams( best_of=self.best_of, frequency_penalty=self.frequency_penalty, logprobs=sampling_logprobs, max_tokens=self.max_tokens, n=self.n, presence_penalty=self.presence_penalty, seed=self.seed, stop=self.stop, temperature=(self.temperature if self.temperature is not None else 1.0), top_p=(self.top_p if self.top_p is not None else 1.0), ... guided_decoding=_response_format_to_guided_decoding_params(self.response_format), embedding_bias=_logit_bias_to_embedding_bias(self.logit_bias, vocab_size),)第一处是 temperature 与 top_p 的默认值。OpenAI 的请求模型里这两个字段可以缺省,缺省时服务端用 1.0;但很多推理引擎的默认值不是 1.0,如果协议层不显式补齐,请求的语义会随引擎版本漂移。这里显式写 else 1.0,是为了把「协议默认值」钉死在翻译层,而不是依赖下游默认值。
第二处是 logprobs。当 logprobs 大于 1 时,只有 PyTorch 后端或者开启 gather_generation_logits 才支持,否则直接抛错。原因是返回前 k 个候选需要对整个词表做 top-k,而某些后端为了性能只回传采样 token 的 logprob,多要就只能走「收集完整 logits」的路径。这是协议能力与后端能力之间的显式契约:不支持就报错,而不是悄悄降级成 1。
第三处是 logit_bias。OpenAI 的 logit_bias 是一个 token_id → bias 的字典,TensorRT-LLM 把它展开成一个长度等于词表大小的 embedding bias 张量,交给采样器。展开需要词表大小,因此 to_sampling_params 要接收 vocab_size;词表大小取不到时,这个字段就只能被忽略或报错,具体行为取决于调用方的实现。这里体现了一个通用原则:凡是需要模型结构信息才能翻译的字段,翻译函数必须显式接收这份信息,不能靠全局变量。
第四处是 response_format。它被翻译成 GuidedDecodingParams,也就是把「我要 JSON」这种协议层意图变成引擎层的语法约束。翻译发生在采样参数构造时,而不是后处理时——因为约束必须作用在 logits 上,事后校验只能拒绝,不能引导。
还有一处是 early_stopping。OpenAI 的 early_stopping 是三态(布尔或字符串),而引擎侧通常要一个整数枚举;协议层用 _early_stopping_to_int 做映射。三态到枚举的映射看起来琐碎,但它决定了 beam search 在什么条件下提前停,属于「小字段、大行为」。
结构化输出的实际形态:从 schema 到可执行语法
response_format 的三种取值对应三条不同的约束构形路径,协议层把它们的区别压缩成一个 GuidedDecodingParams 对象:
{"type": "text"}:不约束,翻译结果是None;{"type": "json_object"}:只要求输出是任意合法 JSON,生成带json_object参数的约束;{"type": "json_schema", "json_schema": {"schema": ...}}:按给定 schema 约束字段名、类型与嵌套结构。
这里有一个容易被忽视的差异:json_object 模式只保证「语法上是合法 JSON」,它不保证字段满足业务 schema。模型的训练数据里 JSON 形态五花八门,只给语法约束,模型很可能吐出一个合法但字段完全不对的对象。要字段级约束,就必须走 json_schema。这也是很多客户端「明明要了 JSON 却拿到错误字段」的根因——它们在服务端只设了 json_object。
logprobs 与结构化输出也有交互。开启约束后,被语法掩码掉的 token 概率归零,此时返回的 top-k logprobs 只会在「仍可被接受的 token」里挑选。客户端若用 logprobs 做置信度估计,需要注意分母已经变了。
stop 与 stop_token_ids 的区别也落在这一层。stop 是字符串,需要交给 tokenizer 转成 token 序列,再在输出侧做匹配;stop_token_ids 直接是 token 编号,引擎可以早停,省去继续生成与 detokenize 的开销。前者对用户友好、对引擎昂贵,后者对引擎高效但对用户不直观。协议层把两者同时放进 SamplingParams,由引擎决定处理顺序,但要求用户不要同时依赖两者。
模板渲染:把 messages 变成模型看得懂的 prompt
openai_chat 的前半段可以概括成一条流水线:
messages → parse_chat_messages_coroutines(拆出纯文本对话、媒体协程、占位符计数、媒体顺序) → render_conversation(套 chat template,生成文本或 token id) → prompt_inputs(包装成引擎的 prompt 结构) → 挂载 multimodal data / embeddings → generate_async这条流水线里有两个并发点和一个顺序约束。
并发点一:渲染与媒体加载同时进行。 代码先启动 render_task,再用 asyncio.gather(render_task, mm_coroutines) 等两者一起完成。渲染只依赖对话结构与模板,媒体加载要下载、解码、可能还要跑视觉预处理,两者互不依赖。把它们串行执行,首 token 时延会叠加;并发之后,总时延取决于较慢的那一个。这也是为什么 render_conversation 的签名里要传 mm_placeholder_counts——模板需要在正确的位置插入图像占位符,而占位符数量来自解析阶段,不需要等媒体真正加载完。
并发点二(隐含):模板渲染本身可能很慢。 某些模板包含大量条件分支、工具声明展开、文档拼接,纯 Python 实现下可能耗费几十毫秒。代码把「工具约束的语法构建」放进 _input_proc_executor 线程池执行,就是为了不阻塞事件循环。渲染本身在 render_conversation 内部处理,是否也走线程池取决于实现,但设计意图是一致的:HTTP 事件循环只做编排,不做重计算。
顺序约束:强制工具调用的前缀只能加在渲染文本上。 当请求是「必须调用某个具名函数」时,协议层会把工具解析器的 begin 字符串作为前缀注入渲染结果,让模型从工具调用的中间开始生成。但代码同时保留了 rendered.template_text(不含前缀的原始模板输出),原因在注释里写得很清楚:resolve_prefilled_thinking() 要检查模板到底渲染出了什么,前缀不属于模板的一部分。如果把带前缀的文本交给思考状态解析器,解析器会看到一段它不认识的标记。
这引出一个更普遍的问题:同一段渲染结果,在不同消费者眼里是不同的东西。对模型来说,它是完整的 prompt;对思考解析器来说,它只是模板的产物;对 token 计数来说,它可能还要排除某些通道开启符(代码里用 prompt_tokens_excluded_from_usage 处理这种情况,并且只在服务端没有覆盖模板时才生效)。协议层必须保留这些「视图」,而不能只留一个最终字符串。
直通路径:prompt_token_ids 绕开模板
如果请求直接给了 prompt_token_ids(或 base64 版本),协议层会跳过模板渲染,直接把 token id 交给引擎。这条路径存在的原因是多轮场景:客户端已经持有上一轮的 token 序列,重新渲染一遍既浪费又可能因为模板版本变化导致前缀不一致,破坏前缀缓存。
直通路径也带来一组限制。最典型的是「具名工具强制调用」不能与 prompt_token_ids 同时使用:强制路径依赖把 begin 前缀拼到渲染文本上,而把前缀拼到已经分好词的 token 序列上,在不同 tokenizer 上会出现 token 边界问题(特殊 token 与相邻文本合并规则不同)。代码选择显式拒绝,而不是尝试拼接,这是正确的取舍——拼接失败的表现是模型输出不可预测,而不是一个明确的错误。
工具调用:三条约束路径,各有各的前提
TensorRT-LLM 的工具调用处理是协议层里最复杂的部分。它不是一个开关,而是三条并行的路径,选择哪一条取决于请求字段和服务配置。
| 路径 | 触发条件 | 约束手段 | 前提 |
|---|---|---|---|
| required 结构标签 | tool_choice="required" 且扩展声明 required_tool_choice_mode=="grammar" | 工具解析器生成 structural tag,作为 guided_decoding | 必须先解析出思考状态 |
| strict 结构标签 | 至少一个 tool 带 strict=True | triggered_tags 语义的结构标签 | 请求没有自带 guided decoding |
| 具名强制调用 | tool_choice={"type":"function","function":{"name":"X"}} | begin 前缀 + 参数 JSON Schema | 必须配置 guided decoding 后端,且解析器不支持自提取 |
required 路径的难点在思考状态。结构化标签要区分「模型是否处于思考段」,因为思考段里允许自由文本,只有思考结束后的内容才受工具语法约束。思考状态不能只看请求参数——模板可能已经把 <think> 或 </think> 预填进 prompt 了。所以代码先从渲染后的 prompt 里解析出实际状态(resolve_prefilled_thinking),再让工具解析器据此构建标签。P/D 分离时,生成 worker 不渲染模板,就拿上下文 worker 通过 disaggregated_params.resolved_thinking 传过来的状态;如果拿不到,代码只警告一次,而不是反复刷日志。
strict 路径只有在请求没有自带 response_format 时才生效,因为两者都要占用 guided_decoding 槽位,同时生效会产生一个「谁覆盖谁」的隐式规则。协议层的选择是:请求显式设置的约束优先,服务端的 strict 约束只在没有显式约束时补位。
具名强制路径最容易被误解。它的目标是让模型「必须调用函数 X」,实现方式是两段式:先把工具解析器的 begin 串注入 prompt,让模型一开口就已经在工具调用结构里;再用只针对该函数参数的 JSON Schema 约束后续生成。两段缺一不可:
- 只有前缀没有语法约束:模型补完参数、闭合工具调用对象后会继续自由生成,整段尾巴都会被当成
arguments; - 只有语法约束没有前缀:模型可能先输出一段自然语言,再进入工具调用,协议层收到的是一个不符合「强制」语义的结果。
代码对这两种残缺情况都做了显式拒绝:没有配置 guided decoding 后端时直接返回 400,并提示需要 xgrammar 或 llguidance;解析器若能自己从标记里提取强制调用(extracts_forced_tool_calls),则不走语法路径,因为没有语法可建。
还有一条限制是对「具名强制」与 response_format 并存的拒绝。前者约束的是工具调用,后者约束的是助手正文;同时给出时,无论满足哪一个都会违背另一个。静默选择其一的后果是用户的显式指令被忽略,所以协议层选择报错。
一段值得记住的注释
代码里对具名强制路径有一段很长的注释,大意是:这条路是「构造上强制」的,模型无法逃出工具调用;而 triggered_tags 的 strict 路径是「语法上引导」的,模型仍可能在标签之外输出内容。两种「强制」的强度不同,不能混为一谈。这类区分在文档里通常看不到,但对排查「为什么模型没按工具格式输出」非常关键。
思考解析:状态从哪来,为什么两个 key 都要写
推理内容解析器(reasoning parser)的职责是把模型输出拆成「思考」与「正文」。它需要在后处理阶段知道两件事:模型是否被要求思考,以及模板是否已经把思考标记预填进 prompt。
协议层在这里做了三件事:
- 若解析器支持从 prompt 推断(
resolves_thinking_from_prompt),就用rendered_prompt推断; - P/D 分离时,用
disaggregated_params.resolved_thinking兜底; - 把推断结果同时写进
chat_template_kwargs的thinking与enable_thinking两个键。
第三步看起来冗余,注释解释了原因:解析器对这两个键做的是「或」运算,只写一个而另一个残留旧值,旧值会覆盖推断结果。这类「两个同义键、下游做或运算」的设计在兼容多套模板时很常见,代价是上游必须同时维护两者的一致性。
另外,_configure_parser_special_token_decoding 会在有工具或需要解析思考时调整特殊 token 的解码设置。原因很直接:如果特殊 token 在 detokenize 阶段被直接跳过,解析器就看不到 <|tool_call|> 这类边界标记,工具调用永远解析不出来;如果全部保留,正文里又会混入标记。协议层要按「当前启用了哪个解析器、请求里有没有工具」来选一个折中的解码策略。
流式输出:promise、首帧与 SSE 帧
generate_async() 返回的不是一个同步生成器,而是一个可异步迭代的 RequestOutput promise。流式路径的核心是 chat_stream_generator:
first_response = await anext(promise)raw_request.state.server_first_token_time = self._adjusted_steady_clock.now()pp_results = first_response.outputs[0]._postprocess_result \ if self.postproc_worker_enabled else post_processor(first_response, args)for pp_res in pp_results: yield pp_resasync for res in promise: ...yield "data: [DONE]\n\n"await self._extract_metrics(res, raw_request)这段代码有四个值得展开的点。
第一,首帧用 anext 单独取。 这样做是为了在首帧到达时立刻记录首 token 时间。首 token 时延(TTFT)是流式服务最重要的指标之一,但它不能靠「第一个 SSE 帧的时间戳」来算,因为首帧可能包含多个 token 的后处理结果,而且后处理本身有耗时。在拿到引擎的第一个 RequestOutput 时就打点,口径更接近「模型产出第一个 token 的时刻」。
第二,[DONE] 是协议的一部分,不是装饰。 OpenAI 的 SSE 流以 data: [DONE] 结束,客户端据此关闭连接、停止解析。少了这一帧,很多客户端会一直等到超时。协议层在 [DONE] 之后才做指标提取,因为此时生成已经确定结束。
首帧为什么不能直接转发
很多实现会把引擎的第一个 RequestOutput 原样转成第一帧 SSE。TensorRT-LLM 没有这么做,原因在于第一帧的「形状」和后续帧不同:首帧可能同时携带思考开始的标记、正文的第一个字符、以及工具调用状态机的初始状态。如果后处理器逐帧无状态地转换,客户端会收到一个既不是完整 JSON、也不像正常增量块的片段。
正确的做法是把首帧交给后处理器,让它在内部完成「通道判定 + 状态初始化」,再输出若干条已经格式化的 pp_results。这也是为什么 chat_stream_generator 对首帧和后续帧用的是同一套 post_processor 调用,只是首帧额外记录了首 token 时间。后处理器的状态是跨帧累积的,首帧调用时它把内部状态机置到一个确定的位置,后续帧才能顺序推进。
第三,异常语义要分清。 生成器内部的 except Exception 只记录并重新抛出。注释说明:消费者停止读取会以 GeneratorExit 关闭生成器,客户端断开会取消它,这两种都不是「这条流出错」。把它们当错误记录,日志会被正常的断连刷满。真正需要清理的是引擎侧的在途请求,这由 await_disconnected(raw_request, promise) 这个后台任务负责。它的实现很朴素:每秒调用一次 raw_request.is_disconnected(),一旦为真且 promise 尚未完成,就调用 promise.abort()。
这里有两个设计细节值得注意。其一,轮询频率是 1 Hz,而不是更高。断开检测本身有成本,而推理请求的清理延迟容忍度远高于 Web 请求——晚一秒回收 KV 通常不会造成可见影响,但每秒多次 is_disconnected() 会在高并发下产生可观的空转开销。其二,批量请求(Anthropic Messages Batches)没有真实客户端 socket,代码用 raw_request.state.no_client_connection 直接跳过轮询;否则这个协程会以 1 Hz 永远运行,并且持有 Request 与 RequestOutput,每条批量请求泄漏一个任务。这类「合成请求没有连接」的边界,是协议层适配多种入口时最容易漏掉的一处。
第四,后处理的两种执行位置。 后处理 worker 开启时,RequestOutput 已经带有 _postprocess_result,HTTP 侧只做搬运;未开启时,HTTP 侧对每一帧调用 post_processor。前者的好处是把 CPU 密集的解析移出事件循环,坏处是多了一次进程间传输;后者的好处是实现简单,坏处是高并发下事件循环容易被解析拖慢。
增量输出的三个边界
流式后处理要处理三类边界,它们都不是「把字符串切片」能解决的:
- UTF-8 边界:一个汉字可能被切在两个 token 之间,按字节切片会产生非法序列;必须按 tokenizer 的增量解码规则处理,保留「可能还会变」的后缀。
- 结构化片段边界:工具调用的 JSON 参数是逐 token 生成的,中途不是合法 JSON;解析器必须维护状态机,只在状态允许时输出增量。
- 通道边界:思考段与正文段之间的切换标记可能跨帧;切换发生时,同一帧要拆成两个不同
delta字段的输出。
这三类边界的共同点是:流式协议的输出单位不是 token,而是「已经确定不会再变的最小片段」。协议层的后处理器本质上是把 token 流重新切成这种片段。
非流式、usage 与 P/D 回传
非流式路径走 _create_chat_response,它等 promise 结束,把最终输出聚合成一个 ChatCompletionResponse:choices 数组、usage、可选的 prompt_token_ids。与流式相比,它多了一步「聚合」:多个 token 的输出要拼成完整字符串,工具调用要拼成完整对象,usage 要统计 prompt token、completion token 与总量。
有两个细节容易出错。
其一,n 与 best_of 的关系。 请求可以要 n 条候选,同时让引擎生成 best_of 条再选前 n 条。协议层把两者原样传给 SamplingParams,聚合时要按 n 截断,而不是按 best_of 返回。返回多了,客户端会拿到它没要求的候选;返回少了,索引会对不上。
其二,P/D 分离下的 prompt token 回传。 上下文 worker 可以选择把 prompt_token_ids 以 base64 int32 缓冲回传,且编码发生在上下文 worker(1 对 N 中的那一个),不在编排器的事件循环里。这是一个明确的性能决策:几万个整数的 JSON 序列化在编排器上会阻塞所有请求,放到 worker 上则只影响这一条。
还有 cache_salt、conversation_params、scheduling_params、priority 这些字段,它们不影响模型输出,但影响调度与缓存命中。比如 cache_salt 用来给前缀缓存加盐,让不同租户的相同前缀不被复用;priority 直接进入调度器的优先级队列。协议层把它们原样透传,是因为这些语义只有调度器能解释。
媒体解析的一个分支:什么时候「不解析」
多模态请求里,媒体(图像、视频、音频)默认要被下载、解码、预处理。但 P/D 分离的生成 worker 是一个例外:它拿到的是上下文 worker 已经展开好占位符的 prompt_token_ids,KV 也已经通过传输层送过来了,媒体本身对它没有意义。
代码用一个显式的布尔量控制:
resolve_media = not ( disaggregated_params is not None and disaggregated_params.request_type == "generation_only" and (request.prompt_token_ids is not None or request.prompt_token_ids_b64))注释说明了为什么要在「取媒体」之前判断,而不是取完再丢弃:解析会重新下载并解码每一项,遇到只有上下文 worker 能读的引用(节点本地路径、一次性 URL、已过期 URL)还会直接失败。生成 worker 本来不需要这些数据,却因为一次多余的解析而报错,这是分布式部署里很典型的一类故障。
另一个约束是 multi_modal_data 与 multi_modal_embeddings 互斥。前者是原始媒体,后者是已经算好的嵌入;同时传会让引擎不知道该用哪一份,所以协议层直接拒绝。
错误处理:为什么引擎错误要让进程退出
openai_chat 的异常处理分三层:
ValueError→ 返回 400,属于请求本身的问题;CppExecutorError→ 记录堆栈、通知生成器终止、向自己发SIGINT;- 其他异常 → 记录堆栈、返回错误响应。
第二层是这份代码里最不寻常的设计。C++ 执行器抛出的错误通常意味着引擎内部状态已经不可信——KV 块账本错乱、CUDA 上下文损坏、通信器失联。这种情况下继续服务,后续请求会拿到错误结果,甚至把损坏的状态扩散到整个副本。让进程退出,由编排层重启,是更安全的失败方式。代价是这一副本上的在途请求全部失败;收益是不会产生「看起来正常但结果是错的」响应。
这个取舍与前面几篇讨论过的「请求中止」不同:中止是单条请求的生命周期管理,这里处理的是整个执行器的不可恢复故障。两者的边界在于「状态是否还能被信任」。
时延在协议层留下的足迹
协议层不改变 GPU 上的计算量,但它能决定这些计算量以什么节奏到达客户端。DeepInfer 官方仓库给出的两张帕累托图把这件事量化得很清楚:在 4 张 SM100 卡上测预填充、在 64 张卡上测解码,横轴分别是「未命中缓存时的输入吞吐」和「每个用户的输出速度」,曲线上的每个点是一组批大小与服务参数的组合。
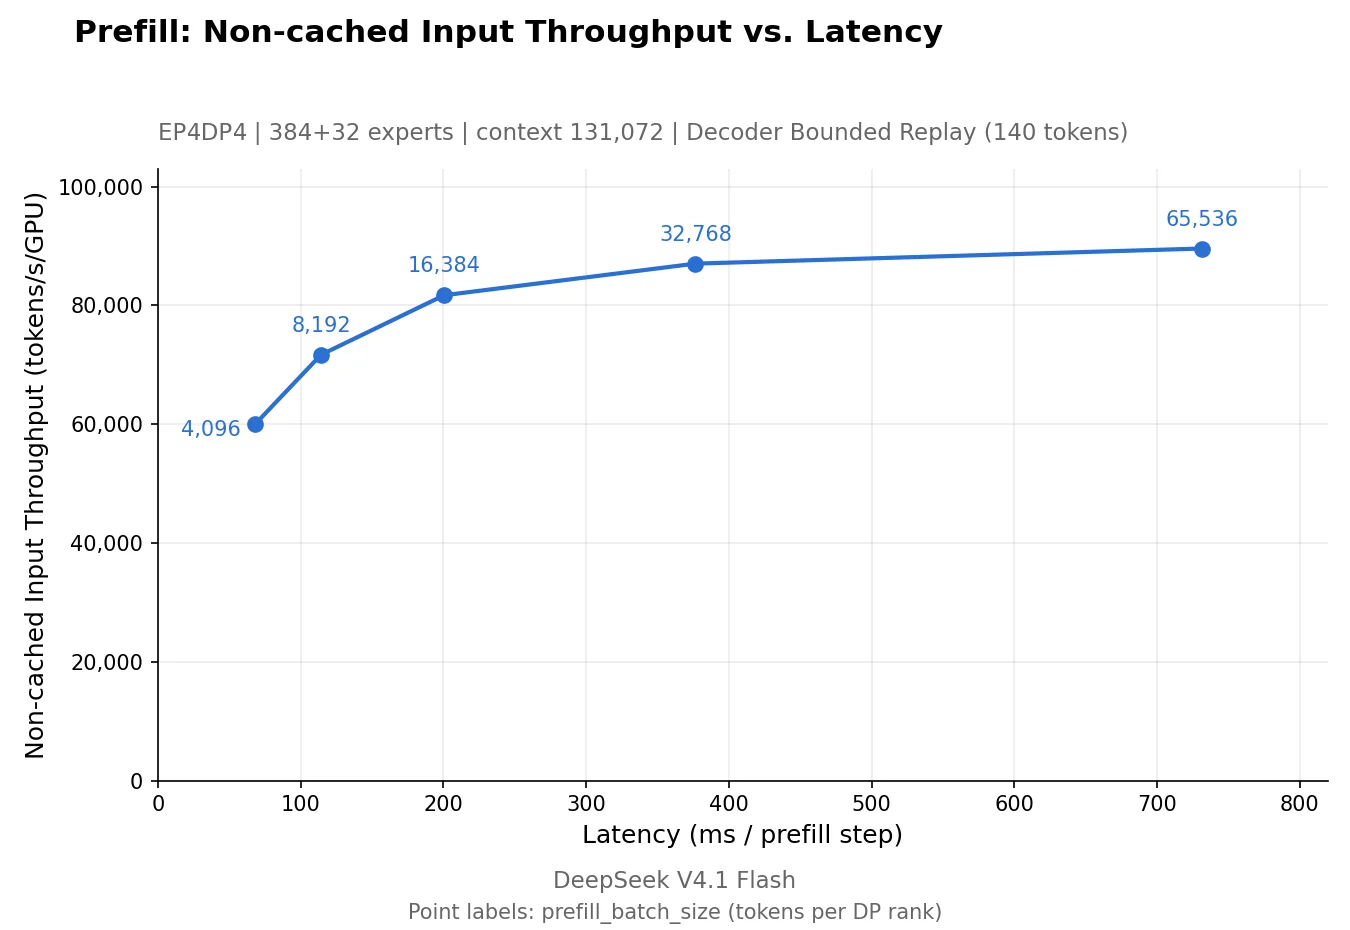
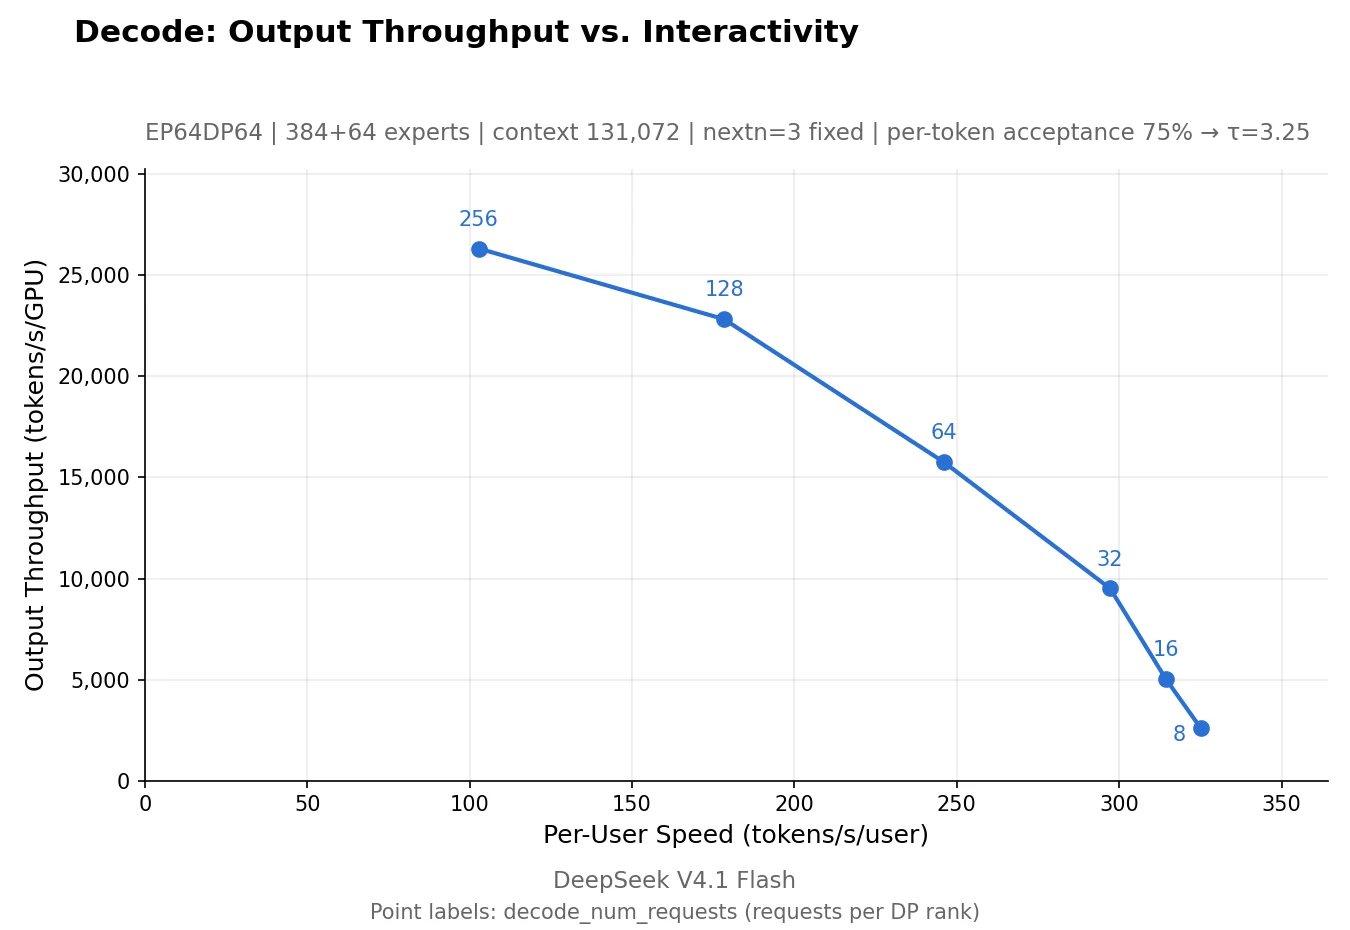
这两张图说明的规律对协议层同样适用。预填充侧关心的是「首 token 时延」:模板渲染、媒体下载、语法编译这些在 generate_async 之前完成的工作,都会直接加在首 token 时延上,在图里表现为整条曲线向右平移。解码侧关心的是「每步开销」:如果后处理在事件循环里同步执行,高并发时每步的 CPU 开销会挤占 GPU 之间的空隙,表现为单用户输出速度下降。换言之,协议层的设计决定了你在帕累托曲线上落在哪个位置,而引擎内部的 kernel 优化决定这条曲线本身的位置。
一个具体的量级参考:模板渲染与语法编译属于「每请求一次」的开销,可以被并发化与线程池吸收;后处理与 detokenize 属于「每帧一次」的开销,会随输出长度线性增长。前者适合在请求入口并发处理,后者适合在 worker 进程里流式处理——这正是 postproc_worker_enabled 与 _input_proc_executor 两个开关分别针对的对象。
与另外两个框架的协议层对照
把 TensorRT-LLM 的协议层和 llama.cpp、vLLM 放在一起看,能看到三种不同的设计重心。
| 维度 | TensorRT-LLM | llama.cpp | vLLM |
|---|---|---|---|
| 模板渲染 | 与媒体加载并发,保留 template_text 供解析 | 服务端一次性渲染,模板由 minja 解释 | 前端渲染,强调 tokenizer 与截断预算 |
| 工具约束 | 三条路径(required、strict、具名强制),显式拒绝冲突组合 | 以 GBNF/工具解析为主,约束在采样侧 | 结构化输出后端统一管理,投机解码整合 |
| 流式后处理 | 可放独立 worker,HTTP 侧只搬运 | 服务端线程内处理 | 前端输出处理器 + 解析器状态机 |
| 错误策略 | 执行器故障直接退出进程 | 单请求错误返回 500 | 引擎错误通过输出处理器传播 |
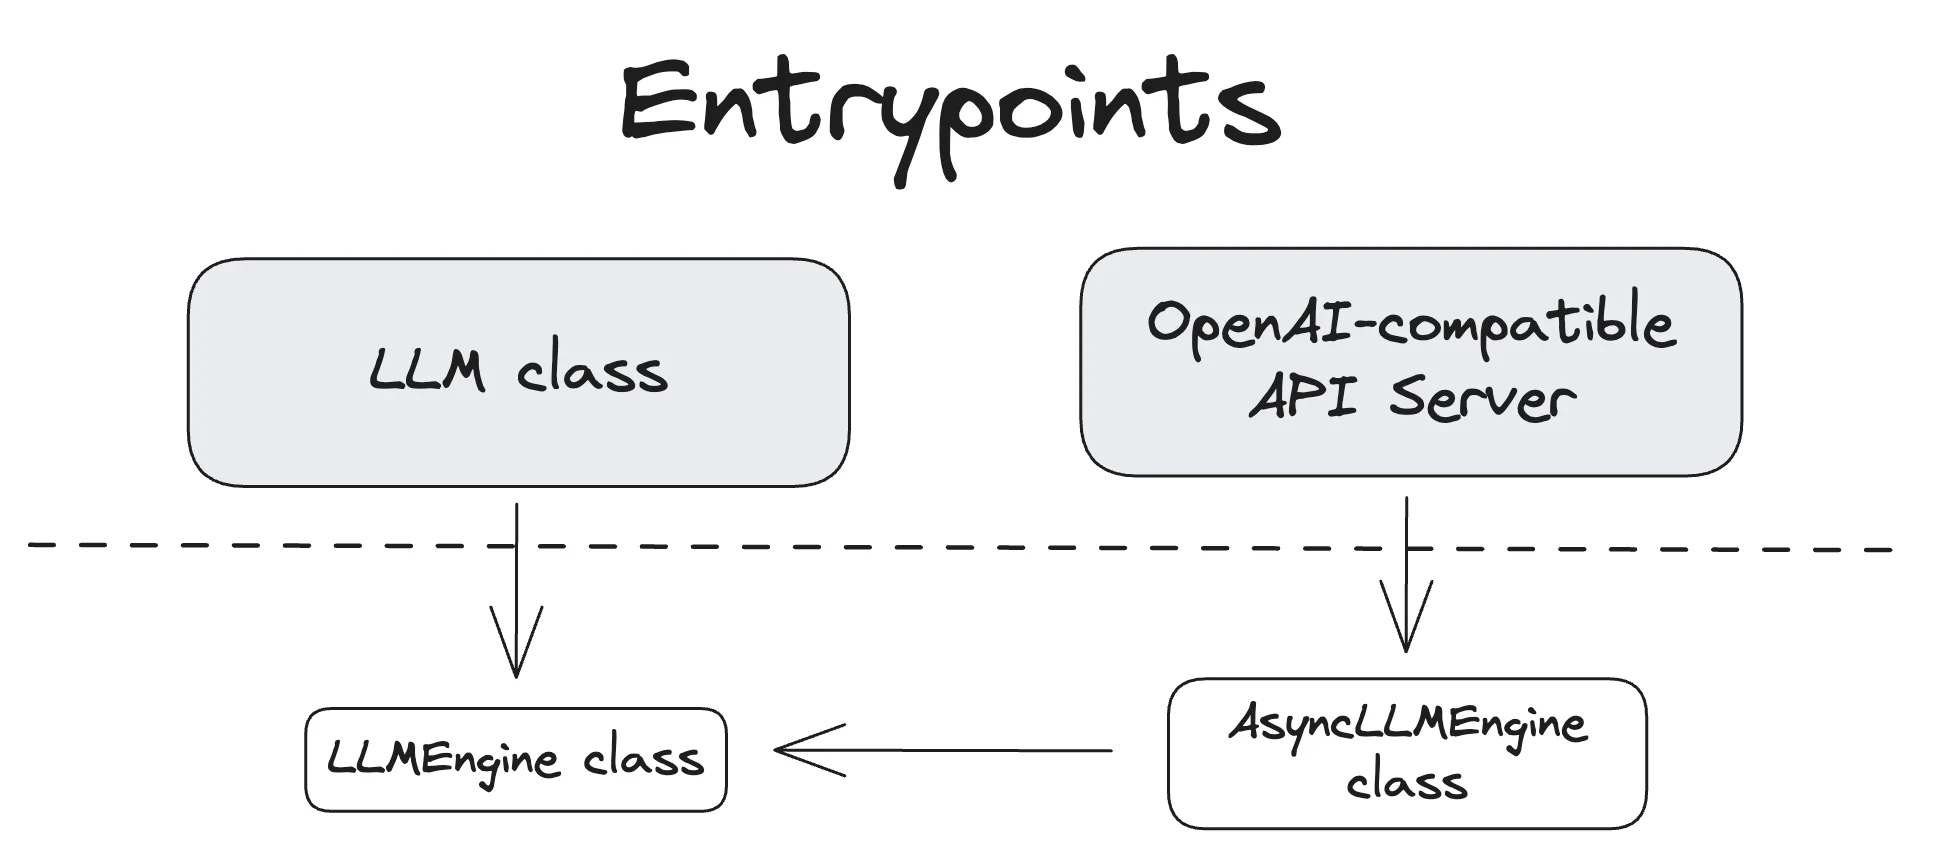
上图是 vLLM 官方文档给出的分层示意,可以直接用来对照 TensorRT-LLM 的协议层位置。vLLM 把「OpenAI API 前端」与 EngineCore 划分为不同进程,前端的输出处理器负责把 EngineCore 产出的 token 切片转成协议帧;TensorRT-LLM 的 OpenAIServer 与 GenerationExecutor 之间是同类划分,只是 TensorRT-LLM 还额外把后处理单独抽出了一个可选 worker 进程。两种划分的选择标准是一样的:凡是每帧都会执行、又只依赖 CPU 的工作,都应该离开引擎进程和 HTTP 事件循环。
差异的根源是部署形态。TensorRT-LLM 面向的是多副本、P/D 分离、编排器调度的生产环境,所以它把「协议层能不能被水平拆开」看得很重:渲染与媒体并发、后处理可外置、prompt token 可由 worker 回传、媒体解析可跳过。llama.cpp 面向单机与边缘,协议层倾向「一次做完、少跨进程」。vLLM 介于两者之间,更强调与引擎调度、投机解码、结构化输出的统一。
展开来说,这三处的差异各有代价:
模板渲染的并发度。 TensorRT-LLM 让渲染与媒体加载并发,前提是渲染结果与媒体数据可以分别挂到同一个 prompt 结构上——这一点依赖 render_conversation 把占位符位置与媒体项顺序分离。llama.cpp 的服务端没有这种分离,它把一次对话渲染成一段文本,媒体以嵌入或 token 的形式预先生成,因此单次渲染必须串行等待全部输入就绪。对于纯文本请求,两者差别很小;对于多图请求,差别接近「最慢一张图的下载时间」。
工具约束的显式性。 TensorRT-LLM 对三种工具约束路径分别做了前提检查,遇到冲突组合直接返回 400。这种「显式拒绝」的风格会把一部分复杂度推给客户端:客户端必须知道自己用哪条路径、需要开哪个后端。llama.cpp 用 GBNF 做通用约束,工具调用更多依赖模板与解析器约定,约束能力更统一但「强制调用某个具名函数」这类需求需要用户自己写语法。vLLM 则把结构化输出做成一个可插拔的后端栈,工具调用与结构化输出共用一套语法后端。
流式后处理的放置。 可外置的后处理适合多副本部署,因为它把 CPU 压力从 HTTP 进程移到独立 worker,扩缩容时 HTTP 进程与后处理 worker 可以按不同比例伸缩。代价是多了一次进程间传输,并且后处理崩溃时的故障域变大。单进程后处理的故障域小,但在高输出速率的请求上容易成为事件循环瓶颈。
可参考 llama.cpp 源码完全拆解(二十四):HTTP 路由与参数解析——一条请求如何穿过路由表、JSON 体与 URL 参数,才变成 server_task 与 vLLM 源码完全拆解(三十四):推理内容解析器——同一个模型输出,为什么要拆成内容、思考与工具调用三段,这两篇分别从路由层与解析器层拆过同类问题。
工程陷阱清单
把这一层读完后,最值得记下来的陷阱有下面这些。它们都不是「代码写错了」,而是「语义在翻译中悄悄变了」。
- 默认值漂移:请求缺省
temperature时,若协议层不补齐 1.0,引擎默认值会接管,同一请求在不同版本上行为不同。 - 注册顺序:字面路径必须早于参数路径注册,否则会被吞掉。
- 模板视图丢失:注入的前缀、预填的思考标记、被排除的 usage token,都要求保留「模板原文」这一视图。
- 强制工具调用的两段性:前缀与语法约束缺一不可,只做一半会产生看似成功、实则越界的结果。
- 思考状态来源:不能只看请求参数,模板可能已经预填;P/D 下要接住上游解析结果。
- 特殊 token 解码策略:全跳过则解析器失明,全保留则正文污染。
- 流式切片的单位:按 token 切会切坏 UTF-8 与 JSON;要按「确定不变的最小片段」切。
[DONE]与断连:缺[DONE]客户端会等到超时;把断连当错误会污染日志。- 媒体解析的跳过条件:生成 worker 不该重新下载媒体,否则一次性 URL 会让请求失败。
- 执行器故障的边界:不可信状态要继续服务还是退出,取决于「错误结果」和「请求失败」哪个代价更高。
logit_bias的词表依赖:映射到 embedding bias 需要词表大小,取不到时行为会随实现漂移;客户端不应假设它总被应用。stream_options与stream的组合:允许stream_options但忽略它是错误做法;正确的处理是拒绝,让客户端及时修正。- 工具约束与
response_format的互斥:两者都占用 guided decoding,同时给出时必须报错,而不是悄悄选其一。 - 模板版本与前缀缓存:直通 token id 绕开模板,能保住前缀缓存;重新渲染则可能因模板版本变化让前缀失配、缓存全失效。
n与best_of的聚合口径:返回条数按n截断,而不是按best_of;后者只是引擎的内部候选数。cache_salt的隔离语义:它改变前缀缓存的键,用于多租户隔离;协议层必须透传,不能在任何一层「优化掉」。
小结
协议层不是胶水代码,它是「用户语义」与「引擎语义」之间的翻译器,而且这份翻译是有损的:OpenAI 的字段无法一一映射到采样器参数,模板渲染会引入模型特定的标记,工具调用在不同模型上有不同的原生格式。TensorRT-LLM 的处理方式是把这些有损点显式化——能翻译的翻译,不能翻译的报错,需要前置状态的先解析状态,需要两段配合的就两段都做。
从工程角度看,这一层最重要的三个设计是:渲染与媒体的并发、后处理的可外置、以及「保留模板原文」这一视图分离。它们分别对应首 token 时延、高并发下的 CPU 开销、以及解析正确性。
下一篇继续留在 tensorrt_llm/serve/render 包:拆渲染上下文本身——模板的加载与缓存、工具声明如何展开成模板变量、文档与多模态占位符的编号协议,以及 render/generate 两条内部路由为什么要拆开暴露。
参考资料
- TensorRT-LLM 官方仓库
- TensorRT-LLM OpenAI 兼容服务文档
- TensorRT-LLM 源码:serve/openai_server.py
- TensorRT-LLM 源码:serve/openai_protocol.py
- TensorRT-LLM 源码:serve/chat_utils.py
- TensorRT-LLM 源码:serve/render 渲染包
- DeepInfer 官方仓库(预填充与解码帕累托基准图来源)
- MDN:使用 Server-Sent Events 实现流式推送
- OpenAI OpenAPI 规范(HTTP 接口字段定义)
- Prometheus 文档:数据抓取与多进程模式
- vLLM 源码完全拆解(三十四):推理内容解析器
- llama.cpp 源码完全拆解(二十四):HTTP 路由与参数解析
- TensorRT-LLM 源码完全拆解(三十一):无模型投机解码的控制面
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



