


vLLM 源码完全拆解(二十三):混合 KV Cache 的组账本——KVCacheCoordinator 如何让全注意力、滑窗与 Mamba 层共用一个块池
一个模型里为什么会长出两种 KV
Gemma 3 的每一层并不都是全注意力。以 27B 版本为例,模型交替堆叠局部注意力层与全局注意力层,局部层只看最近的 1024 个 token,全局层才看整段上下文。Qwen3-Next 把门控 DeltaNet 线性注意力层与全注意力层按固定比例交替排布。Jamba 更激进,直接在 Transformer 层之间插入 Mamba 状态空间层。这类结构通常被概括成「混合注意力」或混合序列模型,一句话带过,但落到推理引擎里就是一堆具体的账。
局部注意力层只需要保留最近 个 token 的 K/V;全局层要保留整段历史;Mamba 层根本不存 K/V,只存固定大小的递归状态和一小段卷积缓存。三类层的缓存形状不同、每块的内存不同、随 token 增长的速度不同,但服务系统必须把它们放进同一块显存、共用同一个空闲块计数器、共用同一套前缀缓存与抢占逻辑。
vLLM 对这件事的回答不是给每类层各写一套独立的内存管理器。它先把层按缓存规格分组,每组建一个负责这类层的管理器,再由一个协调器统一记账;前缀缓存命中时,协调器再把各组独立查出来的命中长度收敛成一个所有组都能接受的边界。这套「分组—协调—对齐」的机制,是理解混合模型在 vLLM 里如何被服务的关键,也解释了为什么带滑窗层的模型前缀命中经常比同规模全注意力模型更短。
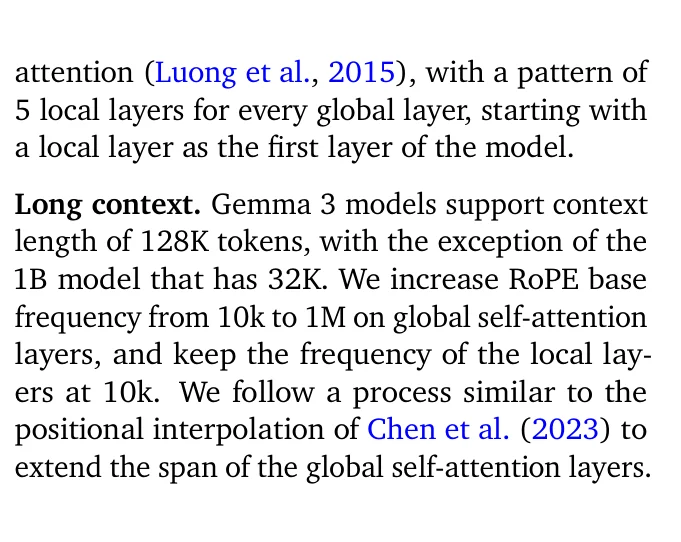
(图源:Gemma 3 技术报告,arXiv:2503.19786)
从 KVCacheSpec 开始:一层缓存的最小描述
vLLM 把「一层需要什么样的 KV 缓存」抽象成 KVCacheSpec(定义在 vllm/v1/kv_cache_interface.py)。它是一个冻结的 dataclass,只描述缓存的物理形状,不描述注意力怎么算。基类里最核心的四个属性决定了它在块池里怎么记账:
| 属性 | 含义 | 用来干什么 |
|---|---|---|
block_size | 一个物理块装多少个 token | 块数计算、块表行数 |
page_size_bytes | 一个物理块占多少字节 | 块池按固定字节切分 |
max_memory_usage_bytes() | 这个请求最坏情况下占多少字节 | 启动时推算整个池能分多少块 |
max_num_blocks_per_req() | 单个请求块表要多少行 | worker 侧块表的行宽 |
此外还有几个在混合场景里才显形的字段:prefix_cacheable 决定这一组能不能参与前缀缓存(环形缓冲这类临时状态返回 False);tokens_per_state 描述一个存储状态覆盖多少 token(普通注意力是 1,Mamba 的块模式则不同);has_layer_views 说明分配器是否为这一组创建逐层视图。
注意力类层:AttentionSpec
AttentionSpec 在基类上补了注意力的形状字段:num_kv_heads、head_size、dtype、head_size_v,以及可选的 num_head_slots(打包布局时每页的逻辑头槽数)。它的页面大小由此算出:
其中 是每页的头槽数(默认为 num_kv_heads), 是一个块里能容纳的存储状态个数, 是 block_size,、 分别是 K 与 V 的头维, 是每个元素字节数。普通情况 ,公式退化为「块大小 × KV 头数 × (K 头维 + V 头维) × 元素字节」。若后端提供了打包布局(page_size_padded、state_content_bytes),则以打包后的字节为准;否则用 unpadded_page_size_bytes。这一步很关键:不同模型、不同 KV 量化方式下,同一个 block_size 算出来的字节数可能差好几倍,块池切分必须以字节为准而不是块数为准。
在 AttentionSpec 之上,vLLM 分出四类具体的注意力规格:
FullAttentionSpec:全注意力。max_memory_usage_bytes为 ,即按最大序列长度全量预留。它额外带一个可选的sliding_window字段,仅用于「关闭混合管理器时,把滑窗层当成全注意力来分配」这条回退路径。SlidingWindowSpec:滑窗注意力。关键在于max_admission_blocks_per_request:
是窗口长度, 是为多模块投机解码额外保留的尾部 token 数, 是「已调度但尚未结算」的 token 上限(max_in_flight_tokens)。末尾 +1 是因为窗口不一定从块边界开始:块大小为 4、需要存 6 个 token 的窗口 [CDEF] 时,会落成 [XXCD][EF] 两块。num_retained_tokens 定义为 ,worker 会把块表里完全低于这个位置的项置空。
ChunkedLocalAttentionSpec:按固定 chunk 做局部注意力的结构(如 LLaMA 4 的本地注意力),准入上限是 。MLAAttentionSpec、SlidingWindowMLASpec等:MLA 压缩缓存及其滑窗变体,unify_kv_cache_spec_page_size对 MLA 有特殊约束(下文会讲原因)。
非注意力类层:MambaSpec
MambaSpec 不继承 AttentionSpec,因为它没有头维:它的页面由若干组 (shape, dtype) 张量拼成,page_size_bytes 就是这些张量字节数之和(或打包后的值)。它的 max_memory_usage_bytes 与 block_size 无关,只与缓存模式和投机块数有关:
def max_memory_usage_bytes(self, vllm_config): if vllm_config.cache_config.mamba_cache_mode == "align": return self.page_size_bytes * ( 2 + self.num_speculative_blocks + self.num_prefill_checkpoint_blocks) else: return self.page_size_bytes * (1 + self.num_speculative_blocks)读法:每个请求常驻「当前状态块 + 上一状态块」两份(align 模式),加上投机解码需要的若干块,以及预填过程中发布的 checkpoint 块。align 模式允许前缀缓存,普通模式不允许——MambaManager 的构造函数里直接断言 mode == "align" or not enable_caching。为什么状态缓存也要预留「上一块」,以及 checkpoint 是怎么发布的,在 DeepInfer 的 KV 内存与 SWA 有界重放 与 Mamba 状态空间模型推理完全拆解 里已有横向展开,这里只关心它对记账的影响:Mamba 组每个请求的块数是常数,前缀命中的粒度可以细于块。
一个容易被忽略的细节:block_table_token_alignment
KVCacheSpec.block_table_token_alignment 默认返回 128,Mamba 与环形缓冲返回 None。这个字段是块表对齐的「token 粒度」提示:注意力层的块表按 token 位置对齐到 128,而 Mamba 的状态块不是位置索引的,所以不需要这种对齐。worker 端在把块号写进块表时,会依据它决定哪些槽位需要填空块。混合模型里两类层被拼进同一个调度单元,这个字段保证了两边的块表在同一个 token 位置上语义一致。
分组:把层切成「同构的管理单元」
有了每层的规格,下一步是把层分组。分组函数在 vllm/v1/core/kv_cache_planning.py:get_kv_cache_groups,它是一个逐级回退的分层判断:
1. --disable-hybrid-kv-cache-manager → unify_hybrid_kv_cache_specs,全部并入一组2. 无缓存的层(纯 encoder 等)→ 空列表3. HiSparse 分组(host 池)→ 专用分组4. 所有层 spec 完全相同 → 一组(绝大多数模型)5. 同类型但 head 维不同 → UniformTypeKVCacheSpecs 合并为一组6. packed 布局(块内并排打包页)→ _get_packed_kv_cache_groups7. 统一页大小 → _get_kv_cache_groups_uniform_page_size(核心路径)8. 统一失败 → 全量分配回退 _try_get_full_allocation_fallback_groups绝大多数混合模型走第 7 条。这条路径做两件事:先统一页大小,再按「重复模式」把同类型层切成层数相同的若干组。
第一步:统一页大小
块池按固定字节切分,一个块号在同一时刻只能属于一组,所以组间页大小的差会直接制造碎片。unify_kv_cache_spec_page_size 把所有层的 page_size_bytes 对齐到最大值:
max_page_size = max(page_sizes)for layer_name, layer_spec in kv_cache_spec.items(): if layer_spec.page_size_bytes == max_page_size: new_kv_cache_spec[layer_name] = layer_spec elif isinstance(layer_spec, MambaSpec): new_kv_cache_spec[layer_name] = replace(layer_spec, page_size_padded=max_page_size) else: layer_page_size = layer_spec.page_size_bytes if max_page_size % layer_page_size == 0: ratio = max_page_size // layer_page_size new_kv_cache_spec[layer_name] = replace(layer_spec, block_size=layer_spec.block_size * ratio) elif isinstance(layer_spec, AttentionSpec) \ and not isinstance(layer_spec, MLAAttentionSpec): new_kv_cache_spec[layer_name] = replace(layer_spec, page_size_padded=max_page_size) else: raise NotImplementedError(...)三条分支对应三种物理现实:
- 整除关系:小页层的块大小乘以比值,例如全局层块大小为 16、局部层为 8,把局部层调到 16 即可完美对齐,零浪费。
- Mamba 层:页大小由状态张量形状决定,与
block_size无关,只能把物理页补齐到最大页大小,多出来的字节在页尾浪费。 - 不整除的非 MLA 注意力层:同样补齐,读取时走带步长的视图(
page_size_padded生效)。
MLA 被单独排除,原因写在代码注释里:稀疏 MLA 以整 token 行索引缓存(flat_kv_row_view),它的块步长只能按自身行对齐的 alignment 补齐,不能任意补到别的页大小,否则整行索引会错位。如果遇到无法统一的组合(例如 MLA 主模型配一个不兼容的滑窗投机草稿),函数抛 NotImplementedError,get_kv_cache_groups 捕获后走全量分配回退:放弃细粒度回收,给每个请求按最大长度预留。这是一个正确性优先的兜底,代价是混合模型省内存的收益消失。
当统一页大小有多个候选取值时,get_uniform_page_size 断言最终所有层的页大小相等;_ensure_min_page_size 还会在 TP 切分后检查公共页是否小于隐藏态层的单 token 成本,必要时抬升公共页,再为隐藏态层重新选一个能整除的块大小,并在日志里报告每块浪费多少字节。
第二步:按重复模式切组
页大小统一后,层还混在一起,需要按注意力类型切开,让每组内部用同一个管理器。_get_kv_cache_groups_uniform_page_size 的文档注释给出的例子最直观:10 个全注意力层 + 20 个滑窗层,可以看作「1 全 + 2 滑」重复 10 次。于是切出 3 组,每组 10 层;每组共享一张块表,块表复制给组内 10 层使用。
具体实现分两手:先按 spec 分桶,能 merge 的再合并(比如窗口大小一致的全注意力层被并到一组);再用组大小把每桶均分。组大小的选择有一个启发式:
min_num_layers = min(len(layers) for layers in layer_buckets)group_size = min_num_layersmax_num_layers = max(len(layers) for layers in layer_buckets)if max_num_layers < min_num_layers * 1.5: group_size = max_num_layers常规的 n:1 模式取「1」那一侧,例如 Gemma 3 的 5:1(5 个滑窗 : 1 个全局),组大小为 1,最终就是「每组 1 层」的细分组。但当两类层数接近时(例如 gpt-oss-20b 配 EAGLE 草稿后 12 滑窗 + 13 全注意力),若仍取 12,全注意力一侧要切成两组,第二组只有 1 层却按 13 层的样子补齐,填充层会白白占 KV;所以取 13 作为组大小,两组各补齐 0 层。1.5 是经验值。
切分时还有一个与流水并行相关的细节:层是按 layers[i::num_groups] 交错分配,而不是按连续区间切。原因是如果按连续区间切,PP 的两个 stage 各自包含 (全, 滑, 滑) 三组,stage 0 的三组里就会有一组是空的,补齐后形成大量空层。交错切保证每个组在两个 stage 上都有非空层。
填充层并不是完全免费的:代码在补齐时打警告,说明最多浪费多少比例的 KV 内存。填充层不参与计算,但块表按组大小统一分配,所以块池里按组计数的部分仍然按补齐后的层数计。
分组结果长什么样
create_kv_cache_group_specs 把每组包装成 KVCacheGroupSpec:
layer_names:组内层的名字;kv_cache_spec:该组的合并规格;is_eagle_group:是否含草稿层,决定是否要剪掉命中的最后一块;host_resident、role:HiSparse 专用的 host 池与角色;enable_kv_transfer:是否属于可跨实例传输的 KV。
最终组结构与块池的关系可以画成这样:
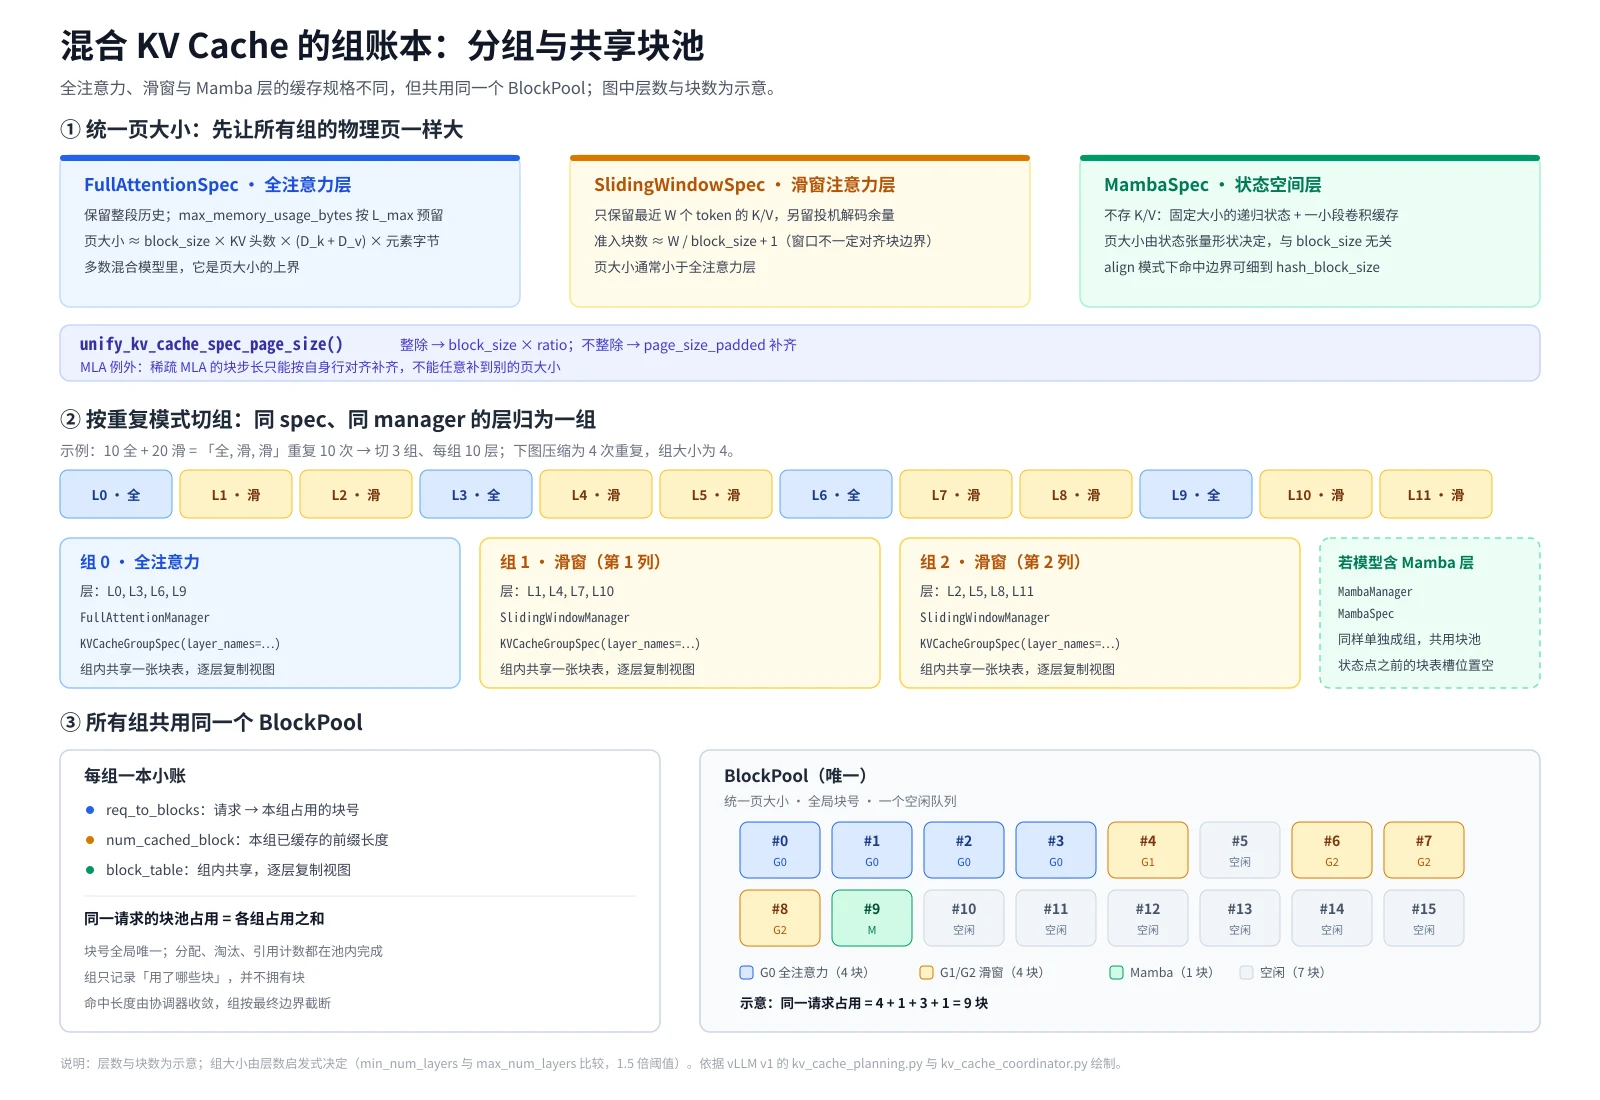
图中的块池是唯一的:所有组从同一个 BlockPool 里取块号,块号对应的物理页大小已统一。每个组持有自己的 req_to_blocks、num_cached_block 与块表视图;同一个请求在块池里的占用是各组占用之和。
值得注意的是组数与「简单混合」的定义:协调器只对「1 个全注意力组 + 另外恰好 1 种类型」的情形做了一次迭代的快速判断(is_simple_hybrid),文档注释也承认 find_longest_cache_hit 的通用实现还没做干净。所以分组数过多虽然能构造出来,但命中查找的效率与正确性需要按模型逐个验证。实际部署中,Gemma 3、Qwen3-Next 这类模型恰好落在「全注意力 + 一种局部结构」的简单混合里。
协调器:三种实现与选择规则
get_kv_cache_coordinator(kv_cache_coordinator.py 末尾)按三个条件选择实现:
| 条件 | 实现 | 说明 |
|---|---|---|
| 前缀缓存关闭 | KVCacheCoordinatorNoPrefixCache | 命中永远为空,支持任意组数乃至 0 组 |
| 只有 1 组 | UnitaryKVCacheCoordinator | 命中直接委托给唯一的 manager |
| 多于 1 组且有缓存 | HybridKVCacheCoordinator | 逐组查找并收敛边界 |
三种实现共享基类里的大部分逻辑,差异只在 find_longest_cache_hit。基类里对其他路径的处理体现了「协调器只记账、不管细节」的分工:
get_num_blocks_to_allocate:逐组调用各 manager 的版本,全部相加。交叉注意力组按 encoder token 数申请,其余组按 token 数申请;prefill_end在非稀疏保留模式下清零。allocate_new_computed_blocks:两阶段分配。先把每个组的本地命中块 touch 一遍,再统一为外部(KV connector)计算出的 token 分配新块。这个顺序是必须的:如果先给第 0 组分配外部块,get_new_blocks可能淘汰掉第 1 组还没被 touch 的命中块,导致第 1 组的命中失效。代码注释把这个问题标为 #33775。free/pop_blocks_for_free/remove_skipped_blocks:逐组遍历,语义由各 manager 决定。pop_blocks_for_free返回的不还池,由调用方按逆序释放,保证尾部块先被淘汰。cache_blocks:先算出重放边界replay_boundaries,再对每一组用组自己的可缓存 token 数缓存;可缓存 token 数默认等于已算 token 数减去多模块投机预留的尾部。
UnitaryKVCacheCoordinator 的约束
单组模型(绝大多数纯全注意力或纯滑窗模型)看似简单,但代码里有三个断言值得记住:
self.block_size = self.single_type_managers[0].block_sizeassert not enable_caching or (hash_block_size == self.block_size)assert len(self.kv_cache_config.kv_cache_groups) == 1即单组时哈希粒度必须等于物理块大小。这解释了为什么「哈希粒度小于块大小」的能力只在混合协调器里出现——单组模型没有跨组对齐问题,没必要引入细粒度哈希。
混合协调器的初始化:先验约束,再切规格组
HybridKVCacheCoordinator.__init__ 是全文最密的一段,它把很多模型层的不变量压进了断言与派生字段。
初始化时校验的不变量
- 块大小整除哈希粒度:所有「可前缀缓存」的组的
block_size必须能被hash_block_size整除。被排除的是prefix_cacheable=False的组(例如 GLM-5.3 索引器尾部的环形缓冲),它们只是 scratch,不参与哈希。 - PCP 只支持全注意力与复制的草稿组。
pcp_world_size > 1时,组的 spec 要么是FullAttentionSpec,要么是带dcp_sharded=False的注意力组(即草稿模型被各 rank 复制)。原因:PCP 要求各 rank 能看到完整的注意力上下文,滑窗与 Mamba 的局部状态无法简单切分。 - DCP 同理:
decode_context_parallel_size > 1时同样只接受全注意力、Mamba 与复制草稿组。 - 多模块 MTP 与滑窗前缀缓存:若某组是 EAGLE 组且
scheduler_block_size < num_prefill_lookahead,直接报错。原因见下文「EAGLE 尾块剪掉」一节。 - Mamba checkpoint 与 EAGLE 的重放边界对齐:如果启用 EAGLE,把所有
MambaManager的drop_eagle_checkpoint_block置真。
这五条的共同点是:它们都不是可选优化,而是「若不满足就会算出错误 KV」的前置条件,所以放在构造期用断言而非运行期处理。
注意力规格组 attention_groups
初始化后半段调用 verify_and_split_kv_cache_groups,把「同 spec、同 manager 类、同块池」的组归并为 SpecGroup。归并的目的是减少命中查找的轮数:如果滑窗层因为切分组而分成两个组,但两组物理规格一致,那么一次查找可以同时处理两组,结果复制。
归并后做两件事:
- 全注意力排在最前。注释写得很直白:全注意力的高效从左到右扫描能给出更紧的初始上界,减少后续组的查找工作。
- 记录
full_attention_group_id。如果模型没有全注意力层(例如全滑窗 + Mamba),该字段为None,后文处理「无稠密参考组」时要特别小心。
细粒度部分命中:enable_partial_hash_hits
partial_hash_hits_enabled 决定命中边界能否细到 hash_block_size,而不是必须对齐到 scheduler_block_size。它需要的前提是:Mamba 处于 align 模式,且每组的管理器都支持细粒度哈希查找;TP 场景还需要哈希粒度细于 Mamba 块;DCP 场景则允许相等,因为 DCP 会放大有效块大小。
self.enable_partial_hash_hits = (allow_partial_hash_hits and partial_hash_hits_enabled(kv_cache_config.kv_cache_groups, hash_block_size, dcp_world_size, [type(m) for m in self.single_type_managers]))
@propertydef _cache_hit_alignment_tokens(self) -> int: return self.hash_block_size if self.enable_partial_hash_hits \ else self.scheduler_block_sizecache_hit_alignment_tokens 会被写回每个 manager。这就是为什么同一次部署里,开关一个 Mamba 缓存模式会改变滑窗层的命中粒度:对齐粒度是协调器统一决定的,管理者只是执行者。
_align_cacheable 与 get_num_cacheable_tokens 使用同一粒度。启用细粒度时不做任何取整,注释解释了原因:即使向下对齐到 hash_block_size,也会把私有化的 Mamba 尾部重新登记为可共享,造成污染。未启用时向下对齐到 scheduler_block_size。
EAGLE 组还有一条额外规则:缓存 token 数可以越过对齐边界多出一块,然后再被剪掉:
if manager.use_eagle and cached_num_computed_tokens > 0: num_finalized = max(0, num_computed_tokens - self.num_reprefillable_tokens) return min(num_finalized, self._align_cacheable(num_finalized) + manager.block_size)这行代码与「命中时多查一块再剪掉」互为镜像:缓存侧多登记一块,是为了让下一轮能命中恰好对得上;命中侧多查一块,是为了证明尾块可复用后再剪掉它。
命中收敛:不动点迭代怎么算
find_longest_cache_hit 的文档注释把它概括为「迭代不动点算法」:每种类型要么接受当前候选长度,要么把它缩短;只要有一类缩短了长度,就从头对全部类型重查。因为长度单调递减且有下界 0,所以必然收敛。
while True: curr_hit_length = hit_length for idx, (spec, group_ids, manager_cls, use_eagle) in enumerate(self.attention_groups): ... if isinstance(spec, FullAttentionSpec) and cached_blocks is not None: curr_hit_length = min(curr_hit_length, hit_length_by_group[first_group_id]) continue drop_eagle_block = use_eagle and idx not in eagle_verified ... hit_blocks, _new_hit_length = manager_cls.find_longest_cache_hit(...) ... curr_hit_length = _new_hit_length if curr_hit_length >= hit_length: break hit_length = curr_hit_length if is_simple_hybrid: break逐条拆开:
- 全注意力只需查一次。全注意力在前缀意义上向下闭合:长度为 的全注意力缓存命中,意味着所有 也必然命中。所以第二次迭代只需把已查到的块截断到新的候选长度,不必再访问块池。这是「全注意力排在第一」的收益所在。
- 滑窗与 Mamba 必须重查。滑窗的命中要求是「窗口范围内连续
need块」,窗口移动后,同一段的命中可能变化;Mamba 的命中是状态点,同样受候选长度影响。所以候选长度一被缩短,这两类必须从新的长度重新查找。 - 简单混合提前退出。只有「全 + 另一类」两组时,第一轮全注意力给出上界,第二轮另一类要么接受要么缩短,第三轮全注意力只需截断,此时条件
curr_hit_length >= hit_length已经满足或提前 break。 - EAGLE 剪块与失效。若某组需要剪掉最后一块(EAGLE),它会在
max_length上多加一个余量再查找,剪完落到候选长度;同一候选长度下每组只剪一次(eagle_verified)。当某组返回的长度被缩短时,之前所有已验证的剪块作废,清空集合重来——因为新的候选长度下,剪块的位置变了。
收敛后还有一步收尾:
for group in self.attention_groups: if not isinstance(group.spec, FullAttentionSpec): continue if manager.retains_longer_hit: continue num_blocks = cdiv(hit_length, group_block_size) for group_id in group.group_ids: del blks[num_blocks:] hit_length_by_group[group_id] = hit_length即所有全注意力组(除 HiSparse 源组这类刻意保留更长命中的组)都被截断到最终长度,避免「某一组命中了更长前缀但最终不能用」导致块表里出现多余的块。
返回值里的第三个值
find_longest_cache_hit 返回三元组:各组命中块、收敛后的命中长度、num_uncached_common_prefix_tokens。第三个值定义为 longest_hit_length - hit_length,即某一组单独命中了更长的前缀,但收敛边界更短。这在带稀疏保留的组里出现:例如滑窗层按稀疏保留策略只缓存了部分尾部,全注意力层缓存了更长,前者还没缓存到公共前缀的某一段。调度器可以利用这个数字知道「再算多少 token,这段公共前缀就能被全部组复用」。这个字段在普通混合模型里为 0。
滑窗管理器如何给出更紧的边界
滑窗组的 find_longest_cache_hit 与全注意力完全不同(single_type_kv_cache_manager.py:SlidingWindowManager):
- 需要的连续块数:
cdiv(window - 1, block_size),EAGLE 时再加 1; - 从右向左扫描,遇到命中就累计连续块数,达到需要的连续块数时把右侧多出来的块裁掉;
computed_blocks初始填满null_block,只在命中位置填真实块;命中前的空位保持空块,块表里就是空的;- 若最终命中的块数不足需要的连续块数,仍按实际命中的块数截断返回;未对齐时再逐块弹出直到对齐。
它还有一个 reachable_block_mask,用于决定稀疏保留下哪些块值得缓存:在段边界上保留最后 need 块、在重放边界与共享前缀交界处保留尾部。这条逻辑在 RadixFlow 的前缀缓存文章 里从「为什么命中跑不进一个 batch」的角度讨论过,本篇只关心它与命中收敛的接口:掩码决定缓存侧登记哪些块,收敛决定使用侧接受多长。
Mamba 管理器如何给出边界
Mamba 组在 align 模式下使用细粒度哈希(supports_fine_grained_hash_lookup = True),命中长度可以是 hash_block_size 的任意倍数,而不是 Mamba 块大小的倍数。查找同样从右向左,找到第一个已缓存状态点就结束,块表中状态点之前的位置补空块。因为状态是「在该位置之前所有 token 的压缩」,状态点之前的块表槽位必须置空,否则注意力内核会去读不存在的 KV。
这就是为什么 Mamba 组的命中常常比滑窗组更细,也为什么开启细粒度部分命中能让滑窗层跟着变细:两组的命中边界必须统一,而 Mamba 能给出更细的边界。
前缀缓存在混合模型里的三个坑
坑一:窗口移动导致块被回收后再命中
滑窗层只保留窗口内的块,窗口之外整块被置空并归还。在持续解码中,序列前部的滑窗块早已不在,但块哈希仍然存在。如果新一轮请求有同样的前缀,滑窗命中的是「窗口内的最后一段」,而不是从位置 0 开始。于是块表里位置 0 到窗口起点之间的槽位是空块,hit_length 也不是「命中块数 × 块大小」意义上的连续长度。
协调器处理这种情况的方式是让滑窗组报告的长度与全注意力组取交集后的最小者,并在最终截断时把全注意力组也截到同一长度。代价是:全注意力部分明明可以复用更长前缀,却因为滑窗部分只有窗口内的命中而被迫放弃。对「长前缀 + 短滑窗」的模型(Gemma 3 就是典型),这意味着每次带公共系统提示词的请求,能复用的全注意力 KV 取决于滑窗层能命中的那一段——而滑窗层的块在前面的解码里可能已经被淘汰。
remove_skipped_blocks 每次调度在 allocate_slots 里、在下一块预填之前调用,正是为了保证「每请求峰值持有的块」不超过准入上限,让启动时的池容量推算成立。SlidingWindowSpec.max_admission_blocks_per_request 的注释说得很清楚:两者一旦漂移,要么重新出现 #39734 的死锁,要么预填中途 OOM。
坑二:EAGLE 尾块必须剪掉
启用 EAGLE 或 MTP 时,预填的最后一次前向会把「下一个预填 token 的隐状态」与草稿输入组合,写进 KV。如果这个 token 恰好在块边界上,最终块里被写入的 KV 就「掺」了一个可能不属于匹配前缀的 token。下次请求若命中这个块,就会读到一个被污染的槽位。
解决办法有两个层面:命中侧,EAGLE 组多查一块再剪掉(eagle_margin),保证不把掺了的块交出去;缓存侧,get_num_cacheable_tokens 在 EAGLE 时允许多登记一块,再被剪掉。对多模块 MTP,问题从「最后一个 token」泛化为「最后 num_speculative_tokens 个」,所以构造期断言 scheduler_block_size >= num_prefill_lookahead:剪掉的尾部必须至少有一个调度块那么大,且与调度边界对齐,否则剪不干净。
Mamba 组的处理略有不同:MambaManager.find_longest_cache_hit 本身从不剪块,所以协调器不会给 Mamba 组加 eagle_margin(代码注释:草稿模型没有 Mamba 层,加余量会让命中超过候选长度)。Mamba 的尾块问题改由预填 checkpoint 的位置处理:get_mamba_prefill_checkpoint_position 在没有 EAGLE 时保留最后 1 个 token 不登记,有 EAGLE 时因尾块已丢,checkpoint 位置向下移一个哈希块。
坑三:简单混合的提前退出只对「全 + 一类」成立
如果模型有三类组(例如全注意力 + 滑窗 + Mamba 的 Jamba 变体),is_simple_hybrid 为假,迭代最多执行到长度不再缩短为止。收敛性有保证,但每轮对全部组重查,开销随组数线性上升。更关键的是正确性:attention_groups 的归并、full_attention_group_id 的选取都假设「至多一个全注意力规格组」,代码里多处注释提到通用实现还没做干净。因此三类结构的模型需要先确认 vLLM 版本是否已支持,或者退回 --disable-hybrid-kv-cache-manager 用统一的页大小去跑。
关闭混合管理器时会发生什么
--disable-hybrid-kv-cache-manager 走 unify_hybrid_kv_cache_specs:把所有层统一成 FullAttentionSpec,滑窗层的 sliding_window 只作为元信息记录在 spec 里。管理层面,滑窗层被当成全注意力分配——每个 token 都有块;计算层面,模型执行器仍然按滑窗计算。也就是说:内存按全注意力付,计算按滑窗省。
这个模式的意义在于兜底与对照:当混合管理器遇到不支持的组合(三类组、MLA 配对问题、layout 无法表达)时,关掉它至少能跑,代价是长上下文下 KV 占用按最大长度计算,滑窗省下的内存全部浪费。所以对 Gemma 3 这类长上下文模型,混合管理器带来的收益主要在内存侧:滑窗层每组只按窗口 + 在飞 token 预留,而不是按最大长度。
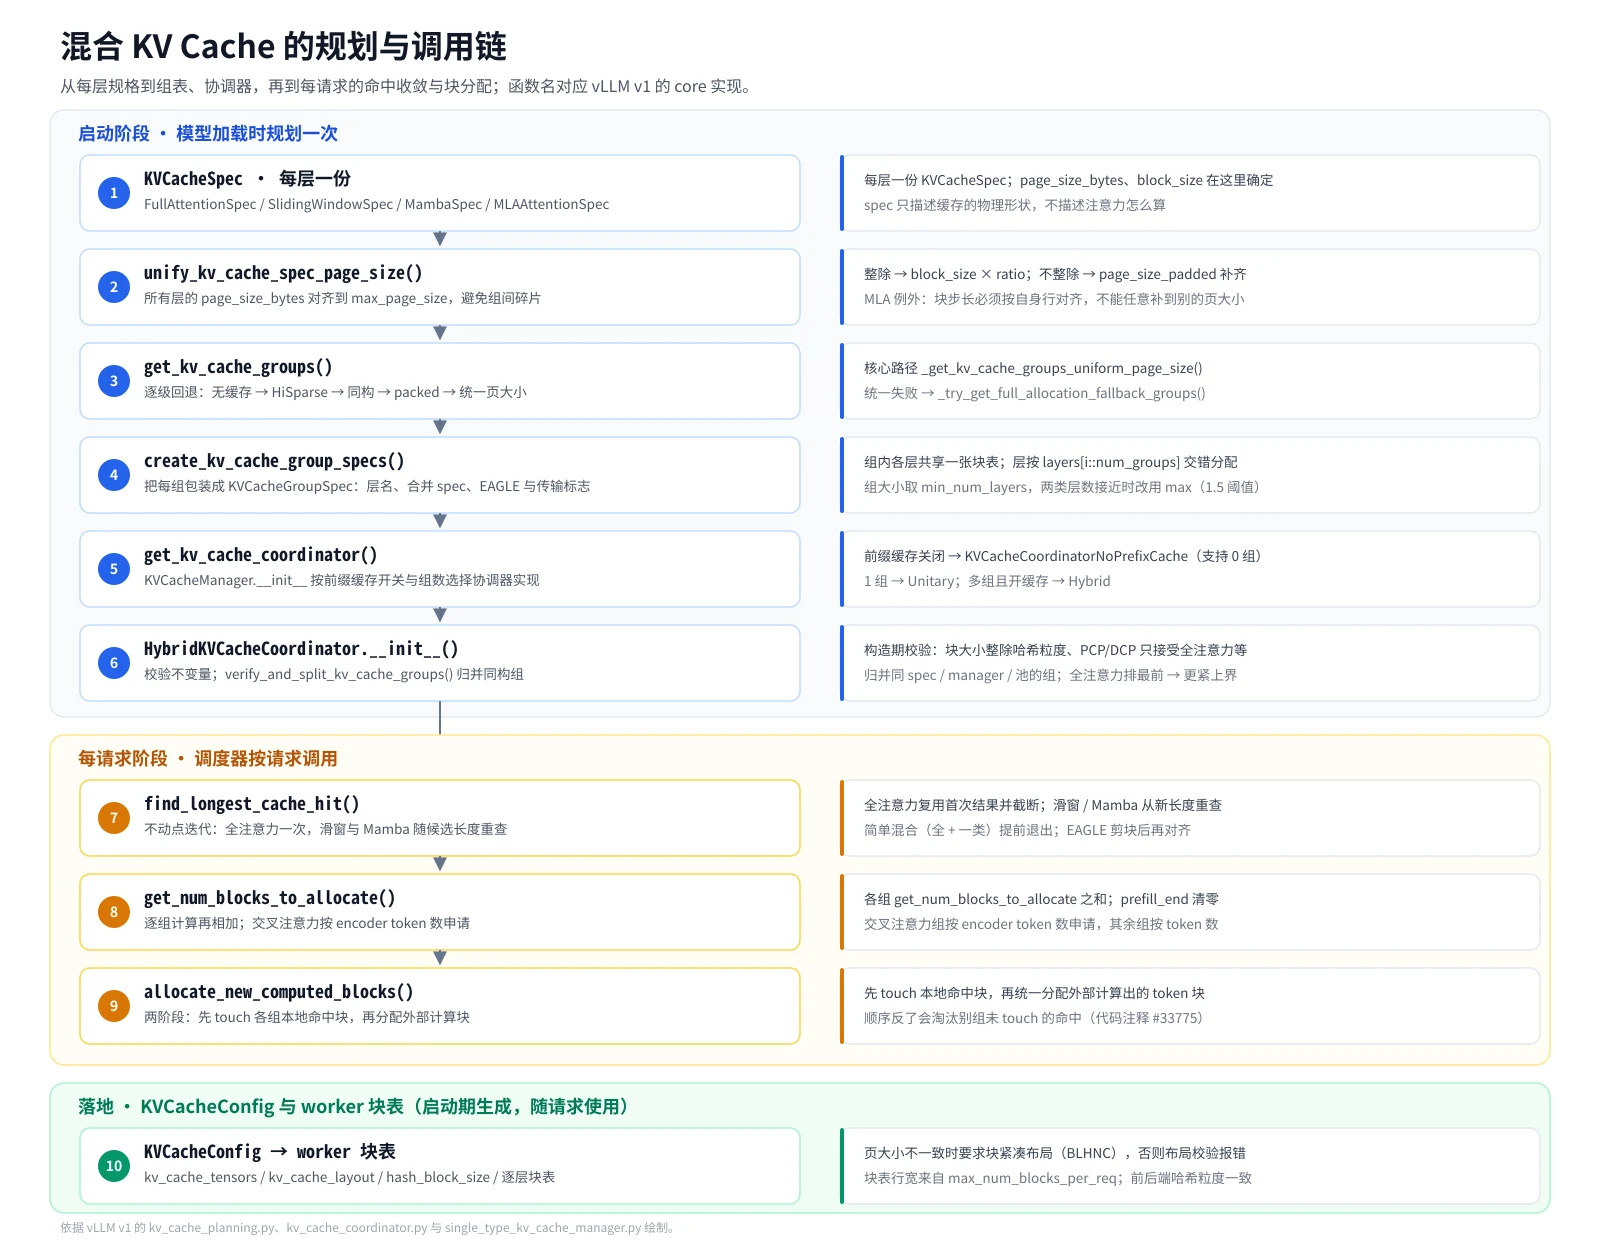
上图把本文涉及的函数按调用先后串起来,便于在源码里对照阅读。
数据结构的落点:从组表到 worker 侧块表
协调器只管调度侧的账,worker 侧的块表由 KVCacheConfig 生成:
kv_cache_tensors:每个张量的字节大小与层列表;kv_cache_layout:块内布局(BLHNC 等),混合页大小时要求块紧凑布局,否则报错提示改用VLLM_KV_CACHE_LAYOUT=BLHNC;hash_block_size与cache_hit_alignment_tokens:由引擎核心解析后下发给所有 worker,保证前后端的哈希粒度一致;prefix_cacheable_group_ids:哪些组参与哈希寻址存储。
_get_kv_cache_bytes_per_block 与 validate_kv_cache_layout 处理布局的可表达性:页大小不一致时,每个页必须是块内一段连续内存,且多组时层维必须在块维内层(BLHNC 风格)。这是「物理块大小统一」假设在代码里的具体体现——它不再只是注释里的假设,而是布局校验的硬约束。
块表本身的行宽来自 max_num_blocks_per_req:全注意力按最大长度;滑窗按准入上限的回退块数;Mamba align 模式按 cdiv(max_len, block_size) + num_speculative_blocks,因为块表按位置索引整条序列,只是中间状态被置空。这里就解释了一个容易困惑的现象:Mamba 每请求只常驻两三块,却要一张与最大长度等长的块表。
worker 侧在拼接输入时,按组依次把块号写进一张扁平块表;num_groups × max_blocks_per_group 的布局让注意力内核按组偏移取表。滑窗与全注意力的内核读表方式不同:滑窗内核会跳过空块,全注意力内核按块号直读。KVCacheManager 之外还有一个细节:num_cacheable_tokens 在协调器与 manager 两侧都出现,调度器只拿协调器的结果去决定「这段前缀能否复用」,而 manager 用它决定「哪些块要登记哈希」。
小结
把这篇的几条线收在一起:
- 一层缓存的描述是
KVCacheSpec,它以字节而非块数描述物理页。注意力层与 Mamba 层的页大小来源不同,这是后续所有分组的根源。 - 分组有两个步骤:先统一页大小(整除则调块大小,Mamba 与不整除的非 MLA 页补齐,MLA 拒绝补齐),再按重复模式把同类型层切成层数相同的若干组。n:1 模式取「1」,层数接近时取「大」,填充层要计入浪费。
- 协调器有三种,混合协调器在构造期校验 PCP/DCP 支持面、EAGLE 多模块约束与哈希粒度整除关系,并把 Mamba 的 checkpoint 语义与 EAGLE 重放边界对齐。
- 命中收敛是不动点迭代:全注意力只查一次并给出上界,滑窗与 Mamba 每次重查;简单混合提前退出;EAGLE 组多查一块再剪掉,缓存侧多登记一块再剪掉。
- 三个坑:窗口移动后的块回收与准入上限的一致性;EAGLE 尾块的污染;三类组结构的正确性尚未被通用实现覆盖。
读源码时,建议按「spec → 分组 → 协调器 → 单一管理器 → worker 块表」的顺序走一遍,中间随时用 max_admission_blocks_per_request 和 cache_hit_alignment_tokens 这两个字段作锚点:前者保证启动时算出的池容量足够、运行时不 OOM,后者保证调度侧与缓存侧对「命中多长」的理解一致。
参考资料
- vLLM KV cache 源码:kv_cache_interface.py
- vLLM KV cache 规划与分组:kv_cache_planning.py
- vLLM 混合 KV Cache 协调器:kv_cache_coordinator.py
- vLLM 单一类型管理器:single_type_kv_cache_manager.py
- vLLM 官方文档:Paged Attention
- Gemma 3 Technical Report
- Jamba: A Hybrid Transformer-Mamba Language Model
- Gated Delta Networks: Improving Mamba2 with Delta Rule
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



