


llama.cpp 源码完全拆解(二十七):工具调用的反向解析——PEG 解析器、AST 映射与流式增量如何把 token 变回 tool_calls
一条聊天请求在 llama.cpp 里要穿过三次翻译。第一次是 prompt 渲染:OpenAI 风格的 messages 被 Jinja 模板翻译成模型训练时见过的特殊 token 文本。第二次是分词:文本变成 llama_tokens,送进计算图。第三次发生在模型开始输出之后:token 流被反向翻译成 content、reasoning_content 和 tool_calls,再包装成客户端认识的 JSON。
前两次在 llama.cpp 源码完全拆解(十二):对话模板与消息解析里已经拆过。这一篇只讲第三次。
这次翻译比前两次更棘手。模型输出的是自由文本,工具调用的参数却必须是合法 JSON;客户端希望在参数第一个字符出现时就收到 tool_calls 的增量,而此刻 JSON 还不完整;不同模型的工具调用语法完全不同,有的把函数名放在 JSON 对象的 name 字段里,有的用 <function=foo> 标签包起来,有的把参数写成 <param=key>value</param>,还有的用 Python 风格的 foo(a="b")。服务端既不能为每个模型手写一个专用解析器,也不能用正则表达式硬啃嵌套 JSON。
llama.cpp 的解法是把这层做成一个真正的语法解析器:为当前模板生成一棵 PEG(Parsing Expression Grammar,解析表达式文法)语法树,用同一棵树既解析模型输出,又从它生成 GBNF 约束解码语法。解析过程产出带标签的 AST,映射器再把 AST 里的节点翻译成消息结构。流式输出时,每来一个 chunk 就把累积文本重新解析一遍,只把前后两次结果的差量发给客户端。
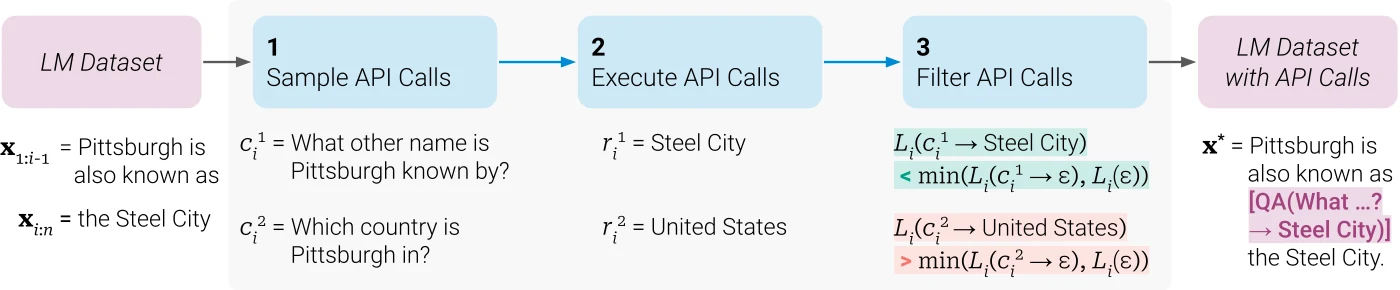
下图是工具调用范式最早的系统化工作 Toolformer 的整体思路(Meta AI,2023 年,arXiv:2302.04761):模型在文本中插入 API 调用,执行后把返回值拼回上下文,再继续生成。llama.cpp 这一层处理的,正是图中“模型输出 API 调用”这一段的工程化反解析。
先看一条真实的流式响应
假设模型正在输出一个 Qwen 风格的调用:它先写 <tool_call>,再写 {"name": "get_weather", "arguments": {"city": "Beijing"}},最后写 </tool_call>。客户端通过 SSE 收到的 delta 可能长这样:
data: {"choices":[{"delta":{"tool_calls":[{"index":0,"id":"call_abc","type":"function","function":{"name":"get_weather","arguments":""}}]}}]}data: {"choices":[{"delta":{"tool_calls":[{"index":0,"function":{"arguments":"{\""}}]}}]}data: {"choices":[{"delta":{"tool_calls":[{"index":0,"function":{"arguments":"city\": \"Bei"}}]}}]}...注意第一帧:函数名已经完整,参数却是空字符串;后面的帧只带参数片段,而且片段可以停在一个引号中间、一个 UTF-8 多字节字符中间、甚至一个 JSON 数字的一半。再往后,如果模型决定再调一次工具,会再开一个 index: 1 的调用,并且两个调用的参数是交错出现的。
这套协议要求服务端具备三种能力:
- 能从任意前缀的文本里判断“当前解析到哪一个调用、哪一个参数”;
- 每次只输出相对上一帧新增的部分,不能因为重新解析就把整段参数再发一遍;
- 在文本还不构成合法 JSON 时,也要给出一个自洽的、可拼接的参数前缀。
把这三件事拆开看,第一件是语法识别,第二件是差量计算,第三件是部分结果的语义补全。llama.cpp 分别用 PEG 解析器、common_chat_msg_diff 和 AST 映射器中的缓冲逻辑来解决。
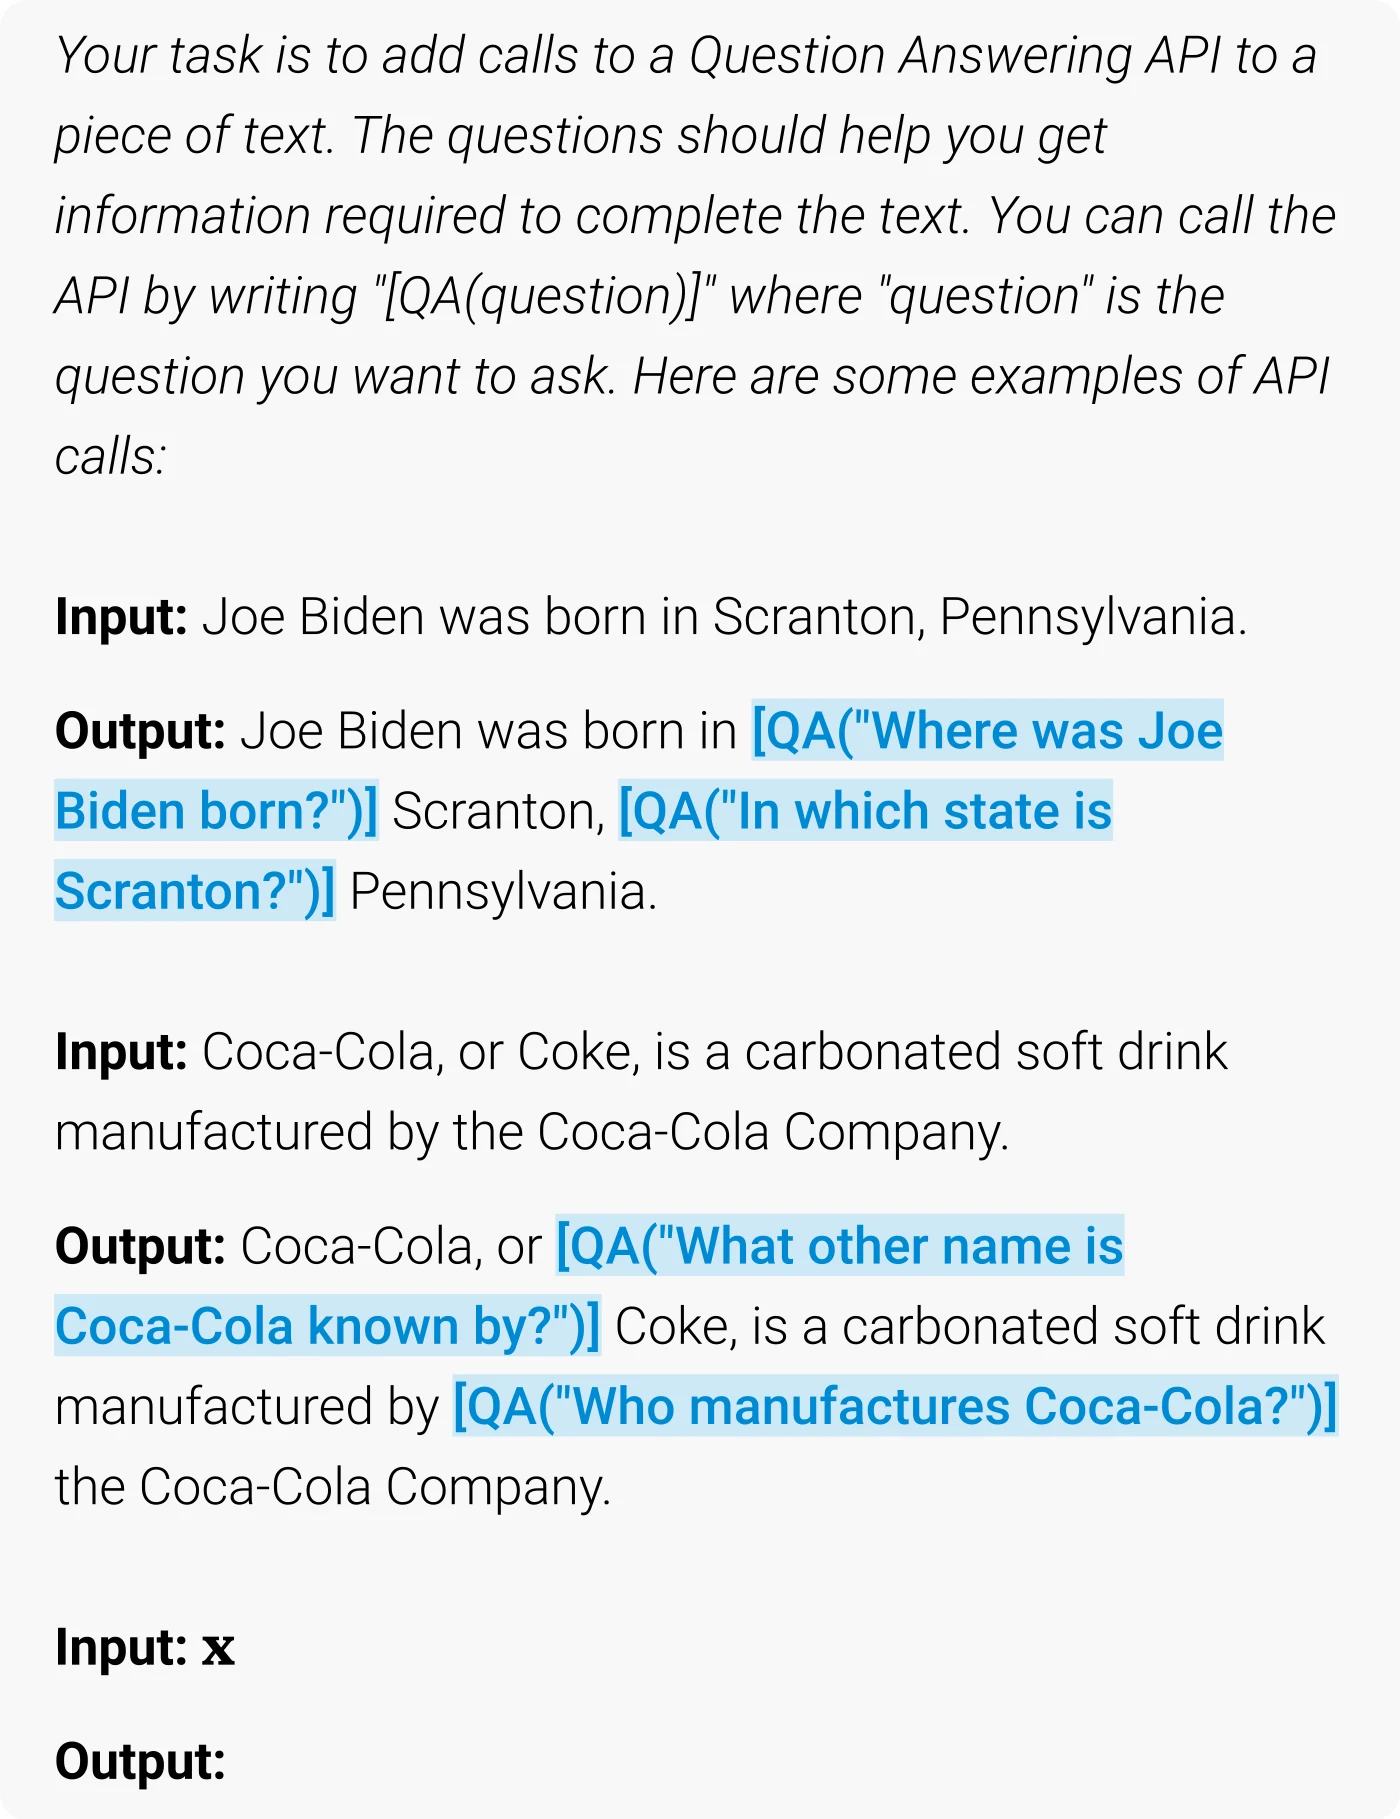
Toolformer 论文里的示例能说明“为什么文本里的调用不能靠肉眼识别”:模型把 API 调用写成文本中的一段特殊结构,参数、括号、字符串和自然语言混在一起,只有按语法解析才能稳定地区分调用边界和正文。
这层代码在服务端的什么位置
从进程结构看,解析发生在 tools/server 的任务结果状态里,不在推理 worker 里。worker 只负责按 llama_batch 跑前向、采样出 token;token 变成文本之后,由服务端线程维护的 common_chat_session 接管。
common_chat_session 的构造需要三样东西:模板集合 common_chat_templates、词表 llama_vocab、以及本次请求的 common_chat_templates_inputs(消息、工具定义、tool_choice、parallel_tool_calls、json_schema 等)。构造时它做四件事:
// 文件:common/chat.cpp(简化)common_chat_session::common_chat_session(...) { auto applied = common_chat_templates_apply(tmpls, inputs);
prompt_parts = std::move(applied.prompt); grammar_text = std::move(applied.grammar); grammar_lazy = applied.grammar_lazy; stops = std::move(applied.additional_stops); generation_prompt_text = applied.generation_prompt; thinking_start = std::move(applied.thinking_start_tag); thinking_ends = std::move(applied.thinking_end_tags);
parser_params.format = applied.format; parser_params.generation_prompt = vocab ? common_chat_input_tokenize(vocab, applied.generation_prompt) : common_chat_input(applied.generation_prompt); parser_params.parser = std::move(applied.parser);
if (vocab) { common_params_sampling resolved; resolved.grammar_lazy = applied.grammar_lazy; common_sampling_add_preserved_tokens(resolved, vocab, applied.preserved_tokens); common_sampling_add_grammar_triggers(resolved, vocab, std::move(applied.grammar_triggers)); preserved_tokens = std::move(resolved.preserved_tokens); grammar_triggers = std::move(resolved.grammar_triggers); delimiters.tokenize(vocab); }}这里有几个容易被忽略的细节。
applied.parser 和 applied.grammar 是同一套信息的两份产物:前者是运行时的 PEG 语法树,后者是从同一棵树导出的 GBNF 文本。它们都来自 common_chat_templates_apply,也就是说,模板分析只做一次,解析和约束解码共享同一份“这个模板长什么样”的结论。
generation_prompt 不只是给采样器用的停止前缀,它还会在解析时被拼到模型输出的前面。原因在于自动生成的 PEG 语法通常以 p.prefix(generation_prompt, reasoning_start) 开头,用来确认“这段输出确实接在正确的生成提示之后”。如果不把生成提示拼进去,解析器会在一开始就匹配失败。
preserved_tokens 是词表层面的保护:模板里的 <tool_call>、<|tool_call_begin|>、<think> 这类标记不能被杀采样器当成普通文本改掉,否则解析器永远等不到结束标记。grammar_triggers 则把“什么时候开始施加工具语法”变成可配置的触发词,后文会讲。
最后,服务端的 task_result_state 把 session 包起来,维护上一帧的 chat_msg、已经发送过名字的调用集合,以及生成工具调用 ID 的计数器:
// 文件:tools/server/server-task.cpp(简化)common_chat_msg task_result_state::update_chat_msg( const common_chat_input & added, bool is_partial, std::vector<common_chat_msg_diff> & diffs, bool filter_tool_calls) { auto msg_prv_copy = chat_msg; auto new_msg = is_partial ? chat_session.feed(added) : chat_session.finish(added); if (!new_msg.empty()) { new_msg.set_tool_call_ids(generated_tool_call_ids, gen_tool_call_id); chat_msg = new_msg; auto all_diffs = common_chat_msg_diff::compute_diffs(msg_prv_copy, chat_msg); // filter_tool_calls 决定是否把“名字先发、参数后发”重排成 OpenAI 期望的顺序 ... } return chat_msg;}feed() 用于流式中间帧,finish() 用于最后一帧。两者的区别不在“是否解析”,而在解析标志:feed() 允许解析器只消费输入的前缀,finish() 要求整段输入必须完整匹配语法。这个区别会决定出错时是“先返回部分结果”还是“直接抛出异常”。
为什么正则和 JSON.parse 都不够
最直接的实现冲动是:找到工具调用的起始标记,把标记之间的文本截出来,再交给 JSON 解析器。这个方案在小规模演示里能用,在真实服务里会同时撞上四堵墙。
第一堵墙是嵌套结构。 工具参数是任意 JSON Schema,可能包含嵌套对象、数组、字符串里带转义的 } 和 "。用正则找“最后一个 }”会在字符串内容含括号时出错;用括号计数又会被字符串中的括号干扰。要正确处理,需要一个能区分“字符串内部”和“结构内部”的递归下降解析器。
第二堵墙是流式前缀。 一帧里的参数可能是 {"city": "Bei。这不是合法 JSON,JSON.parse 直接失败。但客户端需要这个前缀来渲染“正在输入参数”的效果,服务端也不能等到调用结束才发第一帧,否则工具调用的首字延迟会等于整个参数的长度。
第三堵墙是多语法。 同一个服务端要同时支持 JSON 原生格式、XML 标签格式、Python 调用格式、GPT-OSS 的 channel 格式。为每种格式写一个手写状态机会形成大量分支,模板一变就要改代码。更麻烦的是,模板本身是模型自带的,用户还可以通过 --chat-template 覆盖,服务端不可能穷举。
第四堵墙是约束解码。 如果只想在生成时限制模型输出合法工具调用,需要一个 GBNF 语法;如果只想在生成后解析,需要一个解析器。两套东西各写一遍,必然出现“语法允许但解析器不认”或“解析器认但语法不允许”的漂移。
PEG 同时解决这四件事:它天然递归、可以只匹配前缀、语法由模板分析结果动态生成,而且同一棵语法树可以导出 GBNF。PEG 由 Bryan Ford 在 2004 年提出(POPL 2004),与 CFG 最大的区别是选择算子 / 有序且带回溯,适合“先试这个分支,不行再试下一个”的解析场景;对于工具调用这种“多个模板分支、每个分支内部又有递归 JSON”的问题,写起来比 CFG 直接得多。
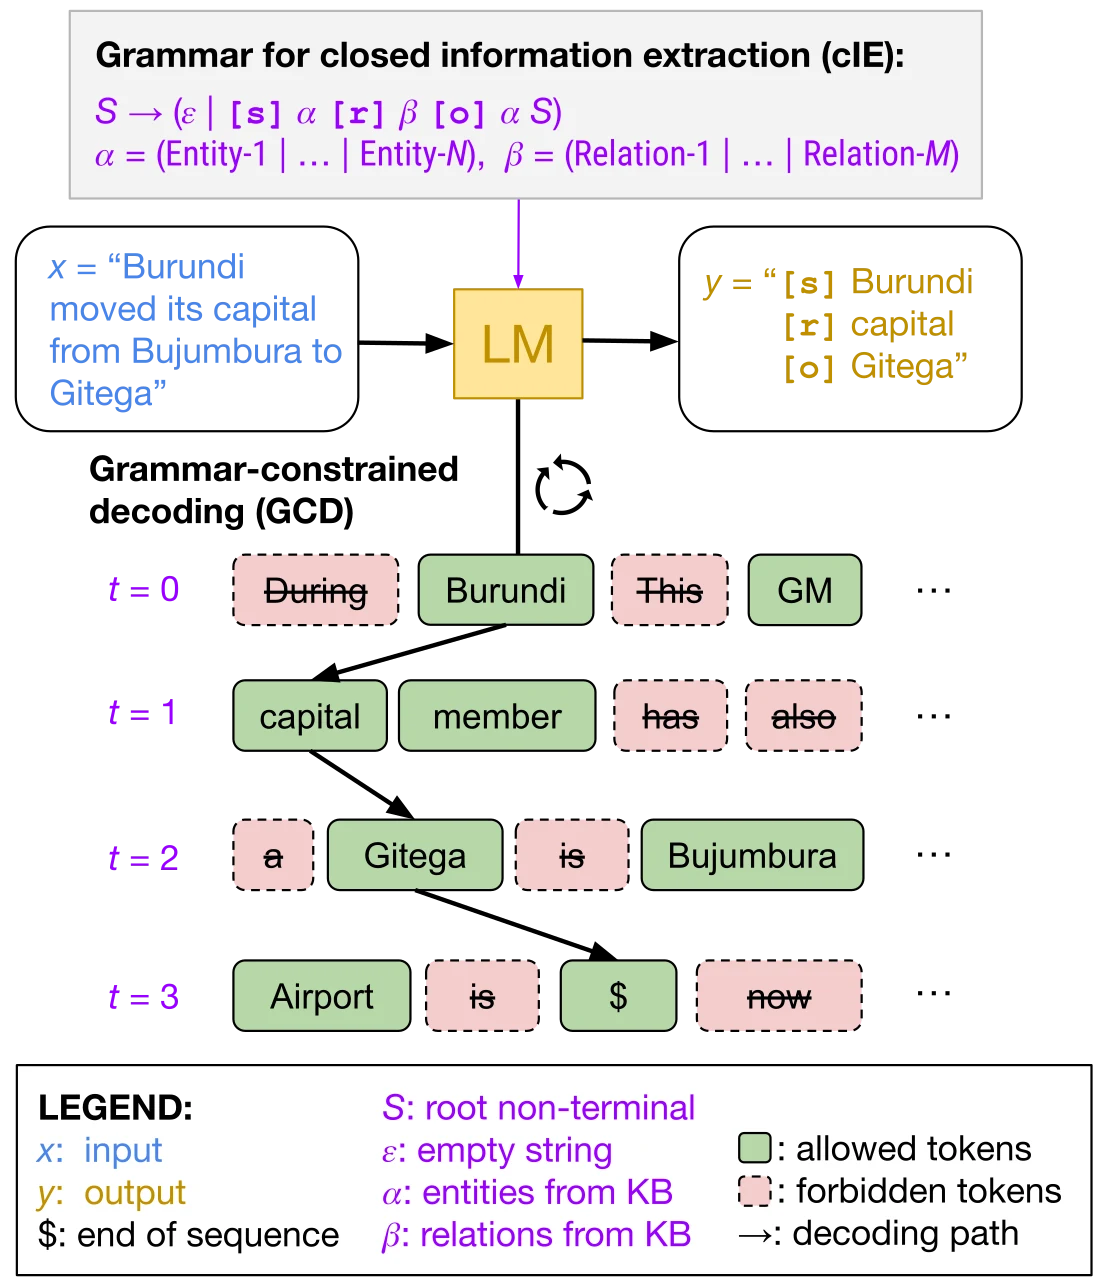
下图来自 Grammar-Constrained Decoding(Geng et al., 2023,arXiv:2305.13971)的引言示例:同一个模型在不同任务上需要不同的输出语法,语法约束把“自由文本生成”变成“在语法允许的 token 集合里采样”。llama.cpp 的工具调用语法正好属于这一类。
数据模型:一条消息的四种形态
在进入解析器之前,先把数据结构对齐。llama.cpp 的 chat 层用四个结构描述“一条消息在生命周期里的不同形态”。
common_chat_msg 是最终形态,也是客户端看到的东西:
struct common_chat_msg { std::string role; std::string content; std::vector<common_chat_msg_content_part> content_parts; std::vector<common_chat_tool_call> tool_calls; std::string reasoning_content; std::string tool_name; // role == "tool" 时,结果属于哪个工具 std::string tool_call_id; // 非 OpenAI 键,以 JSON 对象字符串保存,只给会读取它们的模板用(如 DeepSeek V4.1) std::string extra_json;};common_chat_tool_call 只有四个字段:name、arguments(字符串形式的 JSON)、id,以及可选的类型信息。arguments 之所以是字符串而不是对象,是因为 OpenAI 协议本身就这么定义,而且部分模板要求对象、部分模板要求字符串,保留原始字符串可以让适配层决定怎么给模板看。
common_chat_msg_diff 是流式增量:
struct common_chat_msg_diff { std::string reasoning_content_delta; std::string content_delta; size_t tool_call_index = std::string::npos; common_chat_tool_call tool_call_delta;};它只能表达“某一个调用的参数多了几个字符”或“正文多了几个字符”,不能表达“删除了几个字符”。这个限制来自一个前提:模型输出是单调增长的,解析结果也应当单调增长。但实际解析中,部分结果可能被修正,例如一个参数值先被识别为字符串 "Bei,补全后变成 "Beijing",这是增长;而模板标记被误识别后又回退,则可能是缩短。compute_diffs 对缩短有专门的处理,后文会讲。
common_chat_input 是解析器的输入,它同时保存文本和每个字节对应的 token id:
struct common_chat_input { std::string text; std::vector<llama_token> tokens; // 与 text 的字节一一对应,未知处为 LLAMA_TOKEN_NULL};为什么要把 token id 带进解析器?因为有些模板的标记是特殊 token,文本层面看起来是 <|tool_call_begin|>,但在词表里是一个 id;解析器在做“保留 token”判断、或在调试时定位是哪个 token 触发了分支,需要这个映射。append(piece, token) 会把一个 token 的文本展开成多个字节,并把 token id 放在第一个字节的位置,其余位置填 LLAMA_TOKEN_NULL:
void common_chat_input::append(const std::string & piece, llama_token token) { if (piece.empty()) { return; } tokens.push_back(token); tokens.resize(tokens.size() + piece.size() - 1, LLAMA_TOKEN_NULL); text += piece;}common_chat_session 则是把上面三者串起来的状态机:它持有累积输入 input、当前消息 result、解析参数 parser_params,以及从模板带过来的停止串、思考标记和消息分隔符。
PEG 引擎:不是正则的替代品,而是一台可组合的识别机
common/peg-parser.h 定义了一个小型 PEG 引擎,核心只有三样东西:解析器节点、解析上下文、AST。
节点类型
解析器节点用 std::variant 存在一个 arena 里,常见类型包括:
literal:匹配一段固定字符串;sequence:按顺序匹配子节点;choice:有序尝试子节点,第一个成功者胜出;repetition:带上下界的重复;until/until_one_of:一直消费到某个分隔串出现;any:消费一个字节;negate/peek:负向/正向先行断言;atomic:禁止内部回溯泄漏到外部;tag:给匹配到的子树打标签,供后续 AST 映射使用;rule/ref:命名规则与递归引用;schema:按 JSON Schema 约束一段结构;gbnf:嵌入一段 GBNF 子语法。
组合子由 common_peg_parser_builder 提供,写法接近 EBNF:
auto value = choice({ p.json_string(), p.json_number(), p.json_object(), p.json_array(), p.json_bool(), p.json_null() });auto member = p.json_string() + p.literal(":") + value;auto object = p.literal("{") + p.optional(member + p.zero_or_more(p.literal(",") + member)) + p.literal("}");这里的 + 是 sequence,| 是 choice,* 是 zero_or_more。所有节点最终被压进一个 common_peg_arena,规则通过 ref 解析成 id,解析时不需要再构造对象。
tag 是这层设计的关键。解析器不只回答“匹配成功没有”,还要告诉上层“这一段是工具名”“这一段是参数值”“这一段是思考内容”。标签随 AST 节点一起保存,映射器只需遍历 AST,按标签把文本填进 common_chat_msg,不需要再写一遍语法。
解析标志与部分匹配
common_peg_parse_flags 只有四个值:
COMMON_PEG_PARSE_FLAG_LENIENT:允许输入在语法需要更多字符时提前结束;COMMON_PEG_PARSE_FLAG_COMPLETE:要求整段输入被完整消费;COMMON_PEG_PARSE_FLAG_DEBUG:打印 AST 和规则命中情况;COMMON_PEG_PARSE_FLAG_NONE:默认。
解析结果有三种状态:SUCCESS、FAIL、NEED_MORE_INPUT。NEED_MORE_INPUT 是流式解析的核心:当解析器走到输入末尾、而语法还期待更多字符时,它不回退成失败,而是返回“还差输入”,并把已经匹配到的 AST 节点带回来。
common_chat_peg_parse 只在 is_partial == false 时加上 COMPLETE 标志:
common_peg_parse_flags flags = COMMON_PEG_PARSE_FLAG_LENIENT;if (!is_partial) { flags |= COMMON_PEG_PARSE_FLAG_COMPLETE;}这意味着流式中间帧允许“语法还没闭合”;最后一帧则必须闭合到根规则的 p.end()。如果最后一帧仍然有未消费的尾部,解析器会记录 result.end,并在日志里打印“unparsed output”,然后抛出异常——这是一条很实用的排障线索:看到这条日志,说明模型输出的格式和模板推断出的语法不一致。
为什么 until 比正则的 .*? 更可靠
until(delimiter) 的实现不是简单的字符串查找,而是在解析上下文里逐字节推进,并处理 UTF-8 边界。它只在当前层级寻找分隔串,不会跨越已经进入的子结构。这一点对工具参数非常重要:参数值里可能出现和结束标记相同的字符序列(例如字符串内容里写了 </tool_call>),until 在字符串规则内部不会把它当成分隔符,因为字符串规则会先消费掉引号内的内容。
tag_with_safe_content 进一步处理“内容里出现标记”的情况:
common_peg_parser common_chat_peg_builder::tag_with_safe_content( const std::string & tag_name, const std::string & marker, const common_peg_parser & p) { if (marker.empty()) { return zero_or_more(choice({ p, rule(tag_name, content(any())) })); } auto content_chunk = rule(tag_name, content(negate(literal(marker)) + any() + until(marker))); return zero_or_more(choice({ p, content_chunk }));}它的语义是:优先匹配结构化内容 p;如果匹配不上,就消费“不是结束标记的任意字节”,直到遇到标记。这样即使正文里出现了类似标记的片段,解析器也不会错位,而是把它归入内容。
语法从哪里来:两条生成路径
PEG 语法不是手写的,而是根据模板现场生成的。生成路径有两条,优先级从高到低。
路径一:专用模板处理器
有些模型的格式太特殊,差分分析难以稳定推断,llama.cpp 为它们保留了手写的 common_chat_params_init_*。模板初始化时会扫描模板源码,按特征字符串选择处理器:
// 文件:common/chat.cpp(简化)static common_chat_params_init_fn common_chat_template_detect_params_init(const std::string & src) { if (src.find("[SYSTEM_PROMPT]") != std::string::npos && src.find("[TOOL_CALLS]") != std::string::npos && src.find("[ARGS]") != std::string::npos && src.find("[CALL_ID]") == std::string::npos) { return common_chat_params_init_ministral_3; } if (src.find("<|channel|>") != std::string::npos) { return common_chat_params_init_gpt_oss; } if (src.find(">>>all") != std::string::npos && src.find(">>>${recipient}") != std::string::npos) { return common_chat_params_init_functionary_v3_2; } ... return nullptr; // 交给自动解析器}这条路径的存在说明一件事:模板生态并不整齐,自动推断不是万能的。专用处理器的价值在于把“已知的怪异格式”固化下来,避免每次请求都重新分析,也避免分析失败导致工具调用不可用。代价是新增模型时要维护代码。
路径二:差分自动解析器
没有专用处理器时,走 autoparser。它在模板初始化阶段只分析一次,结果缓存在 common_chat_template::analysis 里,后续每次请求直接复用。
分析的核心手法是“差分探测”:用同一套模板渲染两个只在某一个维度上不同的消息序列,比较两次渲染结果的差异,从差异里反推出标记。
// 文件:common/chat-auto-parser-helpers.cpp(简化)std::optional<compare_variants_result> compare_variants( const common_chat_template & tmpl, const template_params & params_A, const std::function<void(template_params &)> & params_modifier) { template_params params_B = params_A; if (params_modifier) { params_modifier(params_B); }
std::string output_A = apply_template(tmpl, params_A); std::string output_B = apply_template(tmpl, params_B); if (output_A == ERR_TMPL || output_B == ERR_TMPL) { return std::nullopt; }
compare_variants_result result; result.diff = calculate_diff_split(output_A, output_B); result.output_A = output_A; result.output_B = output_B; return result;}calculate_diff_split 把两次输出切成公共前缀、公共后缀、左侧差异和右侧差异四段。公共前缀是模板的稳定外壳,右侧差异就是“新增内容引入了什么标记”。
分析分三个阶段进行。
阶段一:推理标记。 比较“带 reasoning_content 的 assistant 消息”和“不带的 assistant 消息”的渲染结果。如果差异里出现了思考内容,就在差异文本里找包裹它的标记:先用“标记 + 内容 + 标记”的严格模式匹配,失败再退化为“内容 + 后置标记”的分隔符模式。然后比较 enable_thinking = true/false 两次生成提示的差异,补充只有前置标记、没有后置标记的情况。
阶段二:正文标记。 比较“纯 content 消息”和“带 tool_calls 的消息”,再比较“纯 content 消息”和“带 reasoning 的消息”。如果 content 在差异里是裸文本,说明模板不包裹正文;如果被标记包住,就把前后标记记下来。这里有一个容易误判的点:有些模板在只有推理内容时也会输出正文标记,分析器必须把 reasoning.end 之后的片段排除,否则会把思考标记误当成正文标记。
阶段三:工具调用格式。 先渲染“一条带工具的 assistant 消息”,把差异段作为 haystack。然后判断函数名和参数名在 haystack 里是否处于 JSON 引号内:
- 函数名在引号内 →
JSON_NATIVE,整个调用是一个 JSON 对象; - 参数名在引号内、函数名不在 →
TAG_WITH_JSON,函数名是标签,参数是 JSON; - 两者都不在引号内 →
TAG_WITH_TAGGED,函数名和参数都是标签。
// 文件:common/chat-diff-analyzer.cpp(简化)auto fun_quote = in_json_haystack(fun_name_needle);auto arg_quote = in_json_haystack(arg_name_needle);
if (fun_quote) { format.mode = tool_format::JSON_NATIVE;} else if (arg_quote) { format.mode = tool_format::TAG_WITH_JSON;} else { format.mode = tool_format::TAG_WITH_TAGGED;}确定大类之后,再逐项提取:section 的开始/结束标记、每个调用的开始/结束标记、函数名前缀/后缀/结束标记、参数容器标记、参数名前缀/后缀、参数值前缀/后缀、参数分隔符、调用 ID 的位置。对 JSON 原生格式,还要判断并行调用是数组包裹还是重复的 section;对非 JSON 格式,要判断是否有 per-call 标记。
最后,分析器把所有非空的标记收进 preserved_tokens。这一步决定了采样器会不会把 <tool_call> 拆成普通文本——如果拆了,解析器就永远等不到结束标记,表现为“工具调用一直不结束,直到 max_tokens”。
路径二点五:补丁
自动分析之后还有一层 workarounds。这是一组针对已知模板的定向补丁,只在模板源码命中特定字符串时生效。例如:
- 旧 Qwen 模板用
content.split('</think>')拆分思考内容,但不读reasoning_content,补丁手动补上<think>/</think>标记; - Granite 3.3 用
<think>包思考、<response>包正文,补丁同时设置推理和正文的模式; - Cohere Command R+ 的正文被
<|CHATBOT_TOKEN|>包裹,补丁补上正文标记和用户消息起点; - DeepSeek-R1-Distill-Qwen 的
<|tool▁call▁begin|>系列标记无法从差分里稳定推断,补丁直接写死 section 标记、函数名分隔符和闭合的 ```。
这层补丁不是“绕过解析”,而是把分析器难以稳定推断的边角信息补全。它和专用处理器的区别是:专用处理器完全接管参数生成,补丁只修改分析结果中的某几个字段。
把标记变成语法树
分析结果最终要落成一棵 PEG 语法树。入口是 autoparser::build_parser,它按优先级决定根规则:
// 文件:common/chat-auto-parser-generator.cpp(简化)common_peg_arena autoparser::build_parser(const generation_params & inputs, const std::string & generation_prompt) const { return build_chat_peg_parser([&](common_chat_peg_builder & p) { parser_build_context ctx(p, inputs); bool extract_reasoning = inputs.reasoning_format != COMMON_REASONING_FORMAT_NONE; ctx.extracting_reasoning = extract_reasoning && reasoning.mode != reasoning_mode::NONE; ctx.reasoning_parser = reasoning.build_parser(ctx);
bool has_tools = inputs.tools.is_array() && !inputs.tools.empty(); bool has_response_format = inputs.json_schema.is_object() && !inputs.json_schema.empty(); bool pure_content = reasoning.mode == reasoning_mode::NONE;
common_peg_parser parser; if (has_response_format) { auto response_format = p.rule("response-format", p.content(p.schema(p.json(), "response-format-schema", inputs.json_schema))); parser = ctx.reasoning_parser + p.space() + p.choice({ p.literal("```json") + p.space() + response_format + p.space() + p.literal("```"), p.space() + response_format + p.space() }) + p.end(); pure_content = false; } else if (has_tools && inputs.tool_choice != COMMON_CHAT_TOOL_CHOICE_NONE && jinja_caps.supports_tool_calls) { parser = tools.build_parser(ctx); pure_content = false; } else { parser = content.build_parser(ctx); } const std::string reasoning_start = trim_whitespace(reasoning.start); return pure_content ? p.prefix(generation_prompt, reasoning_start) + parser : p.prefix(generation_prompt, reasoning_start) << parser; });}这段代码里有四个值得解释的决定。
决定一:响应格式优先于工具。 如果请求同时给了 json_schema 和工具,语法只按 json_schema 生成。原因不是“只能二选一”,而是协议层在应用模板时已经禁止了“工具 + 任意 grammar”的组合;结构化输出和工具调用的参数约束在语义上冲突:前者约束整段输出,后者只约束工具参数段。
决定二:pure_content 决定根规则是否强制结束。 没有推理、没有工具、没有 schema 时,根规则是 content(rest()) + end(),即“剩下的全是正文”。有工具时,根规则必须是“推理段 + 工具段 + 结束”,因为工具段之后不能再有正文。
决定三:生成提示前缀被显式匹配。 p.prefix(generation_prompt, reasoning_start) 会截掉生成提示里位于推理开始标记之后的部分,只保留前半段作为字面量。这样做的目的是验证“模型输出确实从正确的 assistant 起始位置开始”,同时避免把模型还没生成的思考标记提前吃掉。
决定四:<< 与 + 的区别。 << 表示“左操作数是前缀,右操作数必须完整匹配”;+ 只是顺序拼接。对带推理的模板,根规则用 <<,因为推理段可能为空、工具段可能为空,但末尾的 end() 必须成立;对纯正文模板用 +,因为正文规则本身已经包含 end()。
推理段和正文段
推理段的语法非常短:
common_peg_parser analyze_reasoning::build_parser(parser_build_context & ctx) const { auto & p = ctx.p; if (!ctx.extracting_reasoning) { return p.eps(); } if (mode == reasoning_mode::TAG_BASED || mode == reasoning_mode::TOOLS_ONLY) { if (!end.empty()) { if (!start.empty()) { return p.optional(p.optspace(start) + p.reasoning(p.until(trim_whitespace(end))) + p.optspace(end)); } return p.optional(p.reasoning(p.until(trim_whitespace(end))) + p.optspace(end)); } } return p.eps();}它假设思考段最多出现一次,且一定以结束标记收尾。optspace 允许标记两侧有空白——这是对真实模型的妥协:模板渲染时标记和内容之间通常没有空格,但模型生成时经常多打一个换行。
正文段分两种形态。如果模板总是包裹正文(例如 <response>...</response>),语法是“推理段 + 正文标记 + until(结束) + 结束标记 + end”;否则是“推理段 + rest + end”。前者必须在标记内找结束,后者直接把剩余全部归入正文。
三种工具格式的语法
JSON 原生格式 的语法由 standard_json_tools 生成。它先按工具定义里的参数 schema 为每个工具建一条规则,再把规则组成 choice:
// 文件:common/chat-peg-parser.cpp(简化,nested keys 模式)for (size_t i = 0; i < tools.size(); i++) { const auto & function = tools[i].at("function"); std::string name = function.at("name"); ordered_json params = common_chat_tool_parameters(function);
auto nested_name = literal("\"" + nested_name_field + "\"") + space() + literal(":") + space() + atomic(literal("\"") + tool_name(literal(name)) + literal("\"")); auto nested_args = literal("\"" + nested_args_field + "\"") + space() + literal(":") + space() + tool_args(schema(json(), "tool-" + std::to_string(i) + "-schema", params));
auto nested_object = literal("{") + space() + nested_name + space() + literal(",") + space() + nested_args + space() + literal("}"); auto tool_parser_body = tool_open(literal("{")) + space(); // 可选的 id / tool_call_id 字段 tool_parser_body = tool_parser_body + optional(id_parser + space() + literal(",") + space()); tool_parser_body = tool_parser_body + nested_field + space() + tool_close(literal("}")); tool_choices |= rule("tool-" + std::to_string(i), tool(tool_parser_body));}这里每个工具都有独立的规则,函数名是字面量而不是 json_string()。这个选择看似限制了模型的自由度,实际上是把“函数名必须是已知工具之一”编码进语法:模型如果输出了不存在的工具名,解析器会在工具名分支全部失败后报错,而不是把它当成一个未知调用传给客户端。约束解码时,GBNF 也只允许这些字面量,从生成阶段就杜绝了幻觉工具名。
参数部分用 schema() 包住 json()。schema() 不是简单的“合法 JSON”检查,它把工具定义的 JSON Schema 编译成一棵带类型的 PEG 子树:字符串、数字、布尔、数组、对象、枚举、required 字段都会影响匹配。这样解析器可以在流式阶段就知道“这个参数应该是字符串”,从而在映射时决定是否给值加引号。
parallel_tool_calls 决定调用之间是否允许逗号分隔;array_wrapped 决定整个 section 是否被 [...] 包裹;function_is_key 处理 {"get_weather": {...}} 这种把函数名当键的格式;parameters_order 处理那些要求参数按固定顺序输出的模板。这些开关都来自前文的差分分析结果,不是写死的。
标签 + JSON 参数格式 的语法由 build_tool_parser_tag_json 生成。函数名是标签,参数段是 schema(json())。标签 + 标签参数格式 则由 standard_constructed_tools 生成:
// 文件:common/chat-peg-parser.cpp(简化)auto arg_rule = tool_arg( tool_arg_open(literal(param_key_prefix)) + tool_arg_name(arg_name_parser) + literal(param_key_suffix) + tool_arg_value(until(param_closer)) + tool_arg_close(literal(param_closer)));arg_choice |= arg_rule;args = zero_or_more(arg_choice + space());参数名在三种引号形态里选:裸名、双引号、单引号。参数值用 until(param_closer) 而不是 JSON 值,因为很多模板的参数值就是裸文本,不要求 JSON 转义。映射器在最后会把标签参数重新组装成 JSON 对象,这一过程需要处理引号、逗号和未闭合的大括号。
内容块的顺序:permute
有些模板把正文、推理、工具调用三块放在同一条消息里,但顺序不固定:有的先思考再正文再工具,有的先工具再正文。硬编码顺序会在另一种模板上失败。permute 用位掩码枚举所有排列:
common_peg_parser common_chat_peg_builder::permute( const std::string & rule_prefix, const std::vector<common_peg_parser> & parsers) { if (parsers.empty()) { return eps(); } if (parsers.size() == 1 || parsers.size() > COMMON_CHAT_MAX_PERMUTE) { return sequence(parsers); } std::map<uint32_t, common_peg_parser> rules; std::function<common_peg_parser(uint32_t)> remaining_of; remaining_of = [&](uint32_t remaining) -> common_peg_parser { if (remaining == 0) { return eps(); } auto alternatives = choice(); for (size_t i = 0; i < parsers.size(); i++) { const uint32_t bit = 1u << i; if (remaining & bit) { alternatives |= parsers[i] + remaining_of(remaining & ~bit); } } return rules.emplace(remaining, rule(rule_prefix + "-" + std::to_string(remaining), alternatives)).first->second; }; return remaining_of((1u << parsers.size()) - 1);}COMMON_CHAT_MAX_PERMUTE 是 6。超过 6 个块时退化为固定顺序,因为排列数按阶乘增长,6 个块已经有 720 种顺序,语法树规模会迅速膨胀。这个上限是一个典型的工程折中:真实模板的独立块很少超过 4 个,6 已经留足余量。
AST 映射:从标签到 tool_calls
语法树只负责“这段文本符合格式”,不负责“这段文本是什么意思”。把 AST 翻译成消息的是 common_chat_peg_mapper。
标签约定
映射器和语法树之间用一组固定的 tag 常量通信:
static constexpr const char * REASONING = "reasoning";static constexpr const char * CONTENT = "content";static constexpr const char * TOOL = "tool";static constexpr const char * TOOL_OPEN = "tool-open";static constexpr const char * TOOL_CLOSE= "tool-close";static constexpr const char * TOOL_ID = "tool-id";static constexpr const char * TOOL_NAME = "tool-name";static constexpr const char * TOOL_ARGS = "tool-args";static constexpr const char * TOOL_ARG_OPEN = "tool-arg-open";static constexpr const char * TOOL_ARG_CLOSE = "tool-arg-close";static constexpr const char * TOOL_ARG_NAME = "tool-arg-name";static constexpr const char * TOOL_ARG_VALUE = "tool-arg-value";static constexpr const char * TOOL_ARG_STRING_VALUE = "tool-arg-string-value";这些标签在语法树里出现的位置,就是映射器要读取的位置。TOOL_ARG_STRING_VALUE 和 TOOL_ARG_VALUE 的区别很重要:前者用于 schema 明确声明为字符串的参数,映射器会给值加引号并转义;后者用于 JSON 值或裸文本,映射器按原样处理,只在需要时做引号归一化。
工具调用的生命周期
一个工具调用在映射器里经历四个阶段:打开、命名、填参数、关闭。
打开时,TOOL_OPEN 创建一个 pending_tool_call,把参数缓冲 args_buffer 清空,参数计数归零,引号挂起标记复位。这个“挂起”状态是流式解析的关键:一个调用可能先出现参数、后出现函数名(有些模板把参数写在函数名之前),此时参数不能直接写进调用对象,因为还不知道它属于哪个函数。
命名时,TOOL_NAME 把节点文本填入 name,并把缓冲里的参数合并进来;如果缓冲为空,就给参数一个 { 作为起点。然后调用被推进 result.tool_calls,指针改为指向结果数组里的元素。这一步让流式增量可以立刻看到这个调用。
填参数时,映射器根据节点类型选择不同的写入方式:
if (is_arg_name && current_tool) { std::string arg_entry; if (arg_count > 0) { arg_entry = ","; } arg_entry += ordered_json(trim(node.text)).dump() + ":"; ++arg_count; auto & target = args_target(); if (target.empty()) { target = "{"; } target += arg_entry;}
if ((is_arg_value || is_arg_string_value) && current_tool) { std::string value_content = std::string(node.text); std::string value_to_add; if (value_content.empty() && is_arg_string_value) { value_to_add = "\""; closing_quote_pending = true; } else if (!value_content.empty() && is_arg_string_value) { if (!closing_quote_pending) { value_to_add = "\""; closing_quote_pending = true; } value_to_add += escape_json_string_inner(value_content); } else if (!value_content.empty()) { value_to_add += normalize_container_value(value_content); } args_target() += value_to_add;}args_target() 返回的是“当前应该写到哪里”:如果函数名已经出现,就写进当前调用的 arguments;否则写进 args_buffer。这个间接层让“参数先于函数名”的模板也能工作。
关闭时,TOOL_CLOSE 做四件收尾工作:如果函数名始终没出现但有缓冲参数,把缓冲写进 arguments;如果还有挂起的引号,补一个 ";如果大括号没有闭合,按嵌套深度补 };如果函数名非空,把调用推进结果数组。
这里最容易被忽略的是“补 }”的逻辑:
for (int d = json_brace_depth(current_tool->arguments); d > 0; d--) { current_tool->arguments += "}";}它只补大括号,不补中括号。原因是工具参数在 OpenAI 协议里必须是 JSON 对象,顶层永远是 {;数组只可能出现在对象内部,而对象的闭合会同时完成数组的语义。这个假设在 schema 允许“顶层参数就是数组”时不成立,但工具定义的顶层参数按规范就是对象,所以可以安全地简化。
部分结果与引号
流式解析最麻烦的是“值只到了一半”。以 {"city": "Bei 为例,AST 里会出现一个 TOOL_ARG_NAME 节点 city 和一个 TOOL_ARG_STRING_VALUE 节点 Bei,但引号还没闭合。映射器此时已经把 {"city": "Bei 写进 arguments,并设置 closing_quote_pending = true。下一帧到了 jing",节点文本变成 Beijing,映射器发现引号已经挂起,就只追加 jing,不再补开引号;到 TOOL_ARG_CLOSE 时再补一个 ",得到 {"city": "Beijing"。
这个状态机保证了一个性质:任意时刻的 arguments 都是“如果现在强行结束,补全后能得到合法 JSON”的前缀。客户端可以安全地拼接这些片段,不必担心中间帧出现无法解析的结构。
调用 ID 的稳定性
有些模板不提供调用 ID,只提供函数名和参数。OpenAI 协议要求每个 tool_call 有唯一 id,客户端用它把工具结果和执行请求对应起来。llama.cpp 的解法是在消息层生成并缓存:
void common_chat_msg::set_tool_call_ids(std::vector<std::string> & ids_cache, const std::function<std::string()> & gen_tool_call_id) { for (auto i = 0u; i < tool_calls.size(); i++) { if (ids_cache.size() <= i) { auto id = tool_calls[i].id; if (id.empty()) { id = gen_tool_call_id(); } ids_cache.push_back(id); } tool_calls[i].id = ids_cache[i]; }}ids_cache 按调用下标缓存。为什么不能每次解析都重新生成?因为流式帧是按调用下标增量发送的,如果第二帧的 id 和第一帧不同,客户端会把同一个调用当成两个。缓存把“第一次见到这个下标时生成”的 ID 固定下来,后续帧复用。
这里还有一个隐含约束:调用下标必须稳定。如果解析器在某一帧把两个调用合并成一个,或者改变了顺序,缓存就会错位。llama.cpp 的语法生成保证了调用按出现顺序追加、不重排,所以下标是单调的。
差量计算
common_chat_msg_diff::compute_diffs 比较前后两条消息,生成增量。正文和推理内容用 string_diff:
static std::string string_diff(const std::string & last, const std::string & current) { if (last.empty()) { return current; } if (!string_starts_with(current, last)) { if (string_starts_with(last, current)) { return ""; } throw std::runtime_error("Invalid diff: '" + last + "' not found at start of '" + current + "'"); } return current.substr(last.size());}它假设新字符串一定以旧字符串为前缀。这符合“模型输出只增不减”的直觉,但解析器的部分结果可能违反它:例如某个标记先被识别成内容、后来又被识别成结构,导致前面的文本被重新归类。llama.cpp 对这种情况的处理是“允许旧串是新串的前缀时返回空增量”,否则抛异常。抛异常不是逃避,而是把“解析结果不单调”当成真正的 bug 暴露出来,避免把错误的增量发给客户端。
工具调用的差量更复杂。compute_diffs 只比较最后一个已有调用的参数增量,新增调用则整条发送:
if (!msg_prv.tool_calls.empty()) { const auto idx = msg_prv.tool_calls.size() - 1; const auto & pref = msg_prv.tool_calls[idx]; const auto & newf = msg_new.tool_calls[idx]; // 允许函数名在增量解析中从空变非空、从短变长 if (pref.name != newf.name && !pref.name.empty() && !newf.name.empty()) { bool is_prefix = (newf.name.rfind(pref.name, 0) == 0); if (!is_prefix) { throw std::runtime_error("Invalid diff: tool call mismatch!"); } } const auto args_diff = string_diff(pref.arguments, newf.arguments); if (!args_diff.empty() || pref.id != newf.id || pref.name != newf.name) { auto & diff = diffs.emplace_back(); diff.tool_call_index = idx; if (pref.id != newf.id || pref.name != newf.name) { diff.tool_call_delta.id = newf.id; diff.tool_call_delta.name = newf.name; } diff.tool_call_delta.arguments = args_diff; }}为什么只比较最后一个调用?因为前面的调用在语法上已经闭合,不会再变;只有最后一个调用可能还在增长。这个假设同样依赖“调用按顺序追加、不重排”的语法设计。
流式:每来一个 chunk 就重解析一遍
common_chat_session::feed 的实现非常短:
const common_chat_msg & common_chat_session::feed(const common_chat_input & chunk) { GGML_ASSERT(!finished && "feed() after finish()"); input.append(chunk); auto msg = common_chat_parse(input, true, parser_params); if (!msg.empty()) { result = std::move(msg); } return result;}它没有维护“上次解析到哪个位置”的游标,而是把累积输入整体重新解析。原因有三个:
- PEG 的部分匹配没有稳定的增量边界。一个
until在上一帧可能停在输入末尾,下一帧可能因为新字符的出现而改变匹配长度;保存游标反而要处理回退。 - 模板标记可能跨越 chunk。一个特殊 token 的文本可能被拆成多个字节,增量解析必须在边界处重新判断。
- 重解析的实现复杂度远低于增量解析,而工具调用的输出通常只有几百到几千 token,PEG 解析的常数很小。
代价是复杂度:如果一条响应有 个 token、每个 token 触发一次解析,总解析量是 。llama.cpp 通过两个手段控制这个代价:服务端按 token 批量更新,而不是每个字节更新一次;解析器是编译好的 arena,匹配过程没有动态分配。对于典型的工具调用长度,这个开销可以接受;如果响应非常长,解析会成为 CPU 侧的一个可观成本。
finish 的区别只有一处:
auto msg = common_chat_parse(input, false, parser_params);is_partial = false 会加上 COMPLETE 标志。如果模型在工具调用中途因为 max_tokens 被截断,解析器会返回失败;此时服务端要么把已解析的部分结果发出去,要么返回一个格式错误,具体取决于调用方的容错策略。
服务端为什么要重排增量
compute_diffs 产出的增量是“按消息结构变化”的,不是“按 OpenAI 流式协议”的。OpenAI 期望的顺序是:先发一个带 id、name、空 arguments 的调用头,再发参数片段。而解析器可能在函数名出现之前就已经积累了参数,导致第一帧同时带名字和一大段参数。
task_result_state::update_chat_msg 里的 filter_tool_calls 分支就是做这个重排:
for (size_t i = 0; i < chat_msg.tool_calls.size(); ++i) { if (sent_tool_call_names.count(i) || chat_msg.tool_calls[i].name.empty()) { continue; } if (d.tool_call_index != i || !d.tool_call_delta.arguments.empty()) { common_chat_msg_diff header; header.tool_call_index = i; header.tool_call_delta.id = chat_msg.tool_calls[i].id; header.tool_call_delta.name = chat_msg.tool_calls[i].name; diffs.push_back(std::move(header)); sent_tool_call_names.insert(i); }}它维护一个“已经发过名字的调用下标”集合。当发现一个调用还没发过头、且当前增量不是“纯参数增量”时,先补一个只含 id 和 name 的 header,再把参数增量单独发。这样客户端收到的顺序就符合协议,不会出现“参数比函数名先到”的帧。
这个重排还处理了另一个边界:如果函数名在解析过程中从 get_ 长成 get_weather,sent_tool_call_names 已经记录了下标,后续帧只发参数,不再重复发名字。名字的最终形态以第一次发送时的完整值为准;如果解析器后来修正了名字,客户端不会收到修正,这是一个已知的取舍——函数名通常在一次解析内就完整出现,真正需要修正的情况很少。
特殊 token 与 UTF-8
流式解析还要处理两个字节级问题。
第一,特殊 token 的文本可能不是一个合法的 UTF-8 字符序列。llama.cpp 的 common_chat_input_tokenize 会把文本按词表切成 token,并记录每个 token 的字节范围;如果拼接后的文本和原始文本不一致(例如 tokenizer 的规范化改变了空格),它会退回纯文本模式,不携带 token 映射。这个回退保证了“解析器看到的文本”和“模型实际生成的文本”一致。
第二,AST 节点可能包含不完整的 UTF-8 序列。common_peg_ast_node 里有 invalid_utf8 字段,记录节点内无法解码的字节区间;sanitized_text() 会把这些区间替换成 U+FFFD。映射器在取文本时用 sanitized_text,避免把一个多字节字符的半个字节写进 JSON,导致客户端解码失败。
同一棵树,两种用途:解析与约束
前文多次提到 applied.grammar 和 applied.parser 来自同一份分析结果。这一节把这条链路讲完整。
autoparser::peg_generator::generate_parser 在生成解析器的同时,根据是否存在工具或 json_schema 决定是否生成 GBNF:
bool has_tools = autoparser.tools.format.mode != tool_format::NONE && inputs.tools.is_array() && !inputs.tools.empty();std::string trigger_marker = !autoparser.tools.format.section_start.empty() ? autoparser.tools.format.section_start : autoparser.tools.format.per_call_start;
bool has_response_format = !inputs.json_schema.empty() && inputs.json_schema.is_object();bool include_grammar = has_response_format || (has_tools && ((inputs.tool_choice == COMMON_CHAT_TOOL_CHOICE_AUTO && !trigger_marker.empty()) || inputs.tool_choice == COMMON_CHAT_TOOL_CHOICE_REQUIRED));
if (include_grammar) { data.grammar_lazy = !has_response_format && inputs.tool_choice == COMMON_CHAT_TOOL_CHOICE_AUTO; data.grammar = build_grammar([&](const common_grammar_builder & builder) { data.parser.build_grammar(builder, data.grammar_lazy); }); if (data.grammar_lazy) { data.grammar_triggers = {{ COMMON_GRAMMAR_TRIGGER_TYPE_WORD, trigger_marker }}; }}三个决定值得展开。
决定一:tool_choice = auto 时语法是惰性的。 如果强制在整段输出上施加工具语法,模型就没法先写一段自然语言解释再调用工具。grammar_lazy = true 让语法只在触发词出现后才生效:模型可以自由生成正文,直到它写出 <tool_call> 或 [TOOL_CALLS],从那一刻起,后续 token 必须符合工具语法。触发词就是前文分析出的 section 起始标记。
决定二:tool_choice = required 时语法从头生效。 这时模型不允许先聊天,必须直接输出工具调用,所以不需要触发词。
决定三:json_schema 优先且不惰性。 结构化输出要求整段响应就是一个 JSON 值,没有“先聊两句”的空间,所以 grammar_lazy 为 false。
common_peg_arena::build_grammar 把 PEG 节点翻译成 GBNF 规则。它处理 tag、atomic、schema 等包装节点时会先“解包”,找到真正影响语法的子节点;schema 节点如果声明为 raw 且允许字符串,会委托给子节点,避免把字符串内容也按 JSON 结构约束。这个细节保证了“解析时按字符串处理、生成时也按字符串约束”,不会出现两套语义。
惰性语法与解析器的配合
惰性语法只约束生成,不改变解析。解析器仍然按完整语法解析整段输出,包括触发词之前的正文。这带来一个微妙的一致性要求:解析器的根规则必须允许“正文 + 工具段”,而 GBNF 的惰性版本只约束工具段。两者不是同一棵树,但共享同一套标记分析结果。
如果分析器把触发词识别错了,会出现两种症状:生成阶段语法一直不生效,模型自由发挥,输出格式飘逸;或者语法过早生效,模型刚写一个 < 就被约束成工具语法,正文被截断。排查时看 --verbose 日志里的 grammar_triggers 和分析出的 section_start 是否一致,是最快的路径。
工程上的坑与边界
模板漂移
模板是模型自带的,模型升级时模板可能改一个空格、换一个标记。差分分析对空格不敏感(optspace 会容忍),但对标记的变化敏感。一个标记改了,preserved_tokens 里还是旧的,采样器可能把新标记拆开,解析器等不到结束。
llama.cpp 的应对是“分析失败就报错,不静默降级”:
if (!tmpl.analysis) { throw std::invalid_argument("Unable to generate parser for this template. Automatic parser generation failed: " + tmpl.analysis_error);}这个选择在服务场景里是对的:静默降级会让工具调用悄悄失效,客户端收到一堆正文而不是 tool_calls,排查成本更高。显式报错至少能在启动或首次请求时暴露问题。
函数名未知时的参数缓冲
前文讲过 args_buffer。这个设计的代价是:在函数名出现之前,解析器无法判断参数属于哪个工具,也就无法用该工具的 schema 校验参数。如果模型先写参数、后写函数名,且参数格式不符合任何工具的 schema,解析器只能先缓冲,等函数名出现后再决定。这个窗口期里,部分结果可能包含“看起来像参数但还没归属”的文本,映射器的处理是把它放进缓冲,不写进任何调用。
并行调用的交错
parallel_tool_calls 为 true 时,多个调用的参数可能交错出现。llama.cpp 的语法是“调用 A 完整、调用 B 完整、调用 C 完整”的序列,不允许交错;如果模型真的交错输出,解析器会在调用 A 的参数段遇到调用 B 的起始标记,匹配失败。
这不是解析器的缺陷,而是语法设计的取舍:交错输出在 JSON 原生格式里无法用简单的递归语法表达,除非把每个调用的参数都做成“可中断”的状态机。主流模型的训练格式本身也倾向顺序输出,所以 llama.cpp 选择不支持交错。工程上如果遇到交错输出的模型,正确做法是换模板或在服务端做缓冲重排,而不是改解析器。
工具调用与结构化输出不能同时硬约束
前文提到协议层禁止“工具 + grammar”。这个限制的根源是:工具语法的根规则是“推理 + 工具段 + end”,而结构化输出的根规则是“一个 JSON 值 + end”。两者对“整段输出”的约束互斥。如果强行合并,只能做成语法的并集,模型可能输出一个 JSON 值而不是工具调用,客户端无法区分。
llama.cpp 在应用模板时直接抛错:
if (params.tools.is_array()) { if (params.tool_choice != COMMON_CHAT_TOOL_CHOICE_NONE && !params.grammar.empty()) { throw std::runtime_error("Cannot specify grammar with tools"); }}这是一个“早失败”的设计,比在解析阶段发现歧义要好。
思考内容与工具调用的先后
有些模型先思考、再调用工具;有些模型在工具调用前不允许思考。分析器用 reasoning_mode::TOOLS_ONLY 区分后者:只有当消息里带工具调用时才提取思考内容,普通正文不提取。这个模式来自“带推理内容 + 工具调用”和“带推理内容 + 纯正文”两次渲染的差异比较。
如果模式判断错了,表现是:模型明明写了 <think>,但服务端把它当正文发给客户端;或者普通正文里的 <think> 被误当成推理标记,正文被截断。排查时看 common_chat_templates_get_caps 返回的 supports_reasoning 和 reasoning_mode 是否符合预期。
语言模型输出的是 token,不是字符
所有解析都发生在文本层,但文本是由 token 拼出来的。一个 token 可能包含多个字符、一个字符可能跨多个 token。llama.cpp 的处理是把 token 展开成字节,再让 PEG 在字节层匹配。这带来两个后果:
- 语法里的字面量必须按 UTF-8 字节匹配,不能假设“一个字符一个节点”;
- 部分匹配可能停在一个字符的中间,
NEED_MORE_INPUT必须能处理这种边界。
common_peg_ast_node 的 invalid_utf8 和 sanitized_text 就是为这个边界准备的。映射器不会把半个字符写进 JSON。
与其他框架的同一层对照
llama.cpp 的这一层在五个框架里是最“重”的:它把模板分析、语法生成、解析、映射、流式差量全部放在同一个 chat 层,服务端只负责搬运。其他框架的选择不同。
vLLM 的结构化输出走的是“后端编译语法 + 调度器位掩码”的路线,语法来自 xgrammar/outlines/guidance,解析则依赖各模型的 tool parser。它的优势是后端成熟、支持多种语法格式;代价是模板与解析器的对应关系需要按模型名注册,遇到新模板要加代码。站内 vLLM 源码完全拆解(十四):结构化输出 和 vLLM 源码完全拆解(二十八):结构化输出的语法约束 拆过这条链路。
SGLang 把采样、语法和工具解析放在 SamplingParams 与各模型的 tool_parser 里,语法后端同样可插拔。它的 tree mask 和 build_tree_kernel_efficient 处理的是投机解码下的树形验证,与 llama.cpp 的线性流式解析是两种问题。可参考 SGLang 源码完全拆解(十):Sampling、Grammar 与结构化输出。
TensorRT-LLM 的 Guided Decoding 在 executor 侧编译语法、在 sampler 侧做 bitmask,工具调用解析则由 tokenizer 与 postprocessor 完成。它的优势是与 CUDA Graph 和静态形状配合得好;代价是工具解析的模板适配不如 llama.cpp 动态。可参考 TensorRT-LLM 源码完全拆解(十八):Guided Decoding。
DeepInfer 把工具调用解析放在 HTTP 服务层与 tokenizer 之间,结构化输出使用语法树异步编译;它的投机解码路径要求解析器能处理被拒绝的草稿 token,这一点比 llama.cpp 的线性流更复杂。可参考 DeepInfer 源码拆解(六):结构化输出与确定性。
把这五家放在一起看,llama.cpp 的独特之处不是“解析得更快”,而是“把解析器变成了模板的产物”。它不依赖模型名注册表,而是从模板源码里反推格式;它不维护两套语法,而是让解析和约束共享一棵树;它不假设输出是完整 JSON,而是用部分匹配和 AST 映射处理任意前缀。代价是分析器本身的复杂度,以及分析失败时的显式报错。
小结
llama.cpp 的工具调用反向解析可以概括成一条链:
- 模板分析:用差分探测反推出推理、正文、工具调用的标记,产出
tool_format、标记集合和保留 token; - 语法生成:把标记和工具 schema 编译成 PEG 语法树,同时导出 GBNF;
- 流式解析:每来一个 chunk 就重解析累积文本,用
NEED_MORE_INPUT和LENIENT处理前缀; - AST 映射:按 tag 把节点文本填进
common_chat_msg,用缓冲和引号状态机处理不完整参数; - 差量计算:比较前后消息,生成
content_delta和tool_call_delta,由服务端重排成 OpenAI 协议顺序; - 约束解码:同一棵语法树导出 GBNF,按
tool_choice决定是否惰性、从哪里触发。
这条链的每一个环节都在回答同一个问题:模型输出的是文本,客户端要的是结构,而文本在任意时刻都可能不完整。PEG 的部分匹配解决“不完整也能识别”,AST 映射解决“识别了也要能组装”,差量计算解决“组装了还要只发新增”。三者缺一不可。
下一篇会继续沿 llama.cpp 的服务层往下走,讨论工具结果如何回填到下一轮对话、tool_name 与 tool_call_id 如何配对,以及多轮工具调用中前缀缓存如何被模板变化打断。
参考资料
- Toolformer: Language Models Can Teach Themselves to Use Tools
- Parsing Expression Grammars: A Recognition-Based Syntactic Foundation(POPL 2004)
- llama.cpp 仓库
- llama.cpp common/chat.h
- llama.cpp common/chat-peg-parser.cpp
- llama.cpp common/peg-parser.h
- llama.cpp 服务端文档
- GBNF 语法说明
- OpenAI Function Calling 文档
- Grammar-Constrained Decoding for Structured NLP Tasks without Finetuning
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



