


llama.cpp 源码完全拆解(三十):采样器链——logits 如何穿过惩罚、top-k、top-p、min-p 与语法,最后落成一个 token
这一篇要解决的问题
模型前向输出的是 logits:词表上每个 token 一个未归一化的分数,形状是一行长度为 的浮点数组。把这一行数组变成「下一个 token」,就是采样(sampling)。听起来很简单,但真实推理服务里,采样是十几个环节串成的流水线:logit bias、抑制 token、重复/频率/存在惩罚、DRY、top-k、top-p、top-n-sigma、min-p、XTC、典型采样、温度、分布抽样或贪心。它们的先后顺序会改变最终分布,而每一步的代价都要乘上「每个解码步」。
本文沿 llama.cpp 的 common/sampling.h 与 common/sampling.cpp(master 分支,对应 2026 年初的版本),把这条链从 API 装配拆到每一步的语义:
common_sampler的成员结构——为什么链外面还挂着一个 grammar 和一个 reasoning budget;common_sampler_init如何把命令行参数按用户给的顺序装配成链表,而不是按固定顺序;common_sampler_sample的「先抽样、再校验、失败就带语法掩码重抽样」路径,用代码逐行比对;- greedy 折叠的精确条件——为什么它要求
n_probs == 0; - backend sampling:新版本里 GPU 后端直接采出 token,CPU 链整套被绕过,以及它对语法/推理预算的硬排斥;
- 投机解码时
common_sampler_sample如何被复用于草稿验证,以及「贪心匹配」与「拒绝采样」两条验证路径的区别。
站内已有几篇从系统角度讲采样器:vLLM 源码完全拆解(九):Sampler(从 logits 到 token 的采样管线与输出回传)、SGLang 源码完全拆解(十):Sampling、Grammar 与结构化输出、TensorRT-LLM 源码完全拆解(十七):Sampler(分档执行的采样管线)、DeepInfer 源码拆解(三十六):选行与采样输入。这些文章的共同视角是「GPU 上批内采样」。llama.cpp 的默认路径刚好相反:采样跑在前端进程的 CPU 上,一次只处理一条序列的一行 logits,所以它的每一个设计都在回答同一个问题——单序列、每步都走一遍的链,怎样少做重复工作。本篇就围绕这个问题展开。
前置概念:logits、温度与概率
设词表大小为 ,模型在第 步给出 logits 。最朴素的采样是 softmax 后按概率随机抽:
温度 在 softmax 之前作用:
可以整体减去最大值而不改变概率(softmax 的平移不变性),实现里几乎都会这么做,防止 溢出。 时分布趋近于 argmax(贪心), 变大时分布被压平,低分 token 的机会增加。
top-k、top-p 等都是在 上做的截断:把一部分 token 的概率清零,再在剩余集合上重新归一化。截断的顺序很重要:先 top-k 后 top-p,与先 top-p 后 top-k,得到的候选集合不同——后者可能在 top-k 之前就已经按累计概率筛掉了 token。llama.cpp 把顺序的控制权交给用户:链里采样器出现的顺序,就是截断发生的顺序。
数据结构:common_sampler 里到底装了什么
common_sampler_init 在返回之前构造了这样一个结构(字段名取自源码):
auto * result = new common_sampler { /* .params = */ params, /* .grmr = */ grmr, // grammar 采样器,独立于链 /* .rbudget = */ rbudget, // reasoning budget 采样器,独立于链 /* .chain = */ chain, // 主采样链 /* .prev = */ ring_buffer<llama_token>(std::max(32, params.n_prev)), /* .cur = */ {}, /* .cur_p = */ {}, /* .rng = */ std::mt19937(llama_sampler_get_seed(chain) ^ 0x9e3779b9u),};几个字段值得逐个解释:
chain是主链,包含 logit bias、惩罚、所有截断采样器,以及链尾的dist(分布抽样)或greedy。grmr和rbudget不在链里。 这是 llama.cpp 与「把语法当作普通采样器挂在链上」的框架最根本的区别。语法采样器需要在两种时机以两种方式作用:常规时刻它只校验「已被抽中的那个 token」,回退时刻它要给整张词表做掩码。如果它挂在链中间,apply总是拿到整张词表,那第一次抽样前就得付一次全词表掩码的代价——这正是 llama.cpp 要避开的。所以语法被拎出来,由common_sampler_sample在链外调度(后文详述)。rbudget是 reasoning budget 采样器:它跟踪reasoning_budget_tokens,在思维链超预算后抑制继续「思考」的 token。它同样在链外、在链之前施加。prev是最近被采纳 token 的环形缓冲,最小长度 32。它喂给惩罚类、DRY 和n_probs记录。cur与cur_p:cur是当前步的候选数组(std::vector<llama_token_data>),cur_p是与之对应的llama_token_data_array视图,cur_p.data指向cur的缓冲区。rng是步级随机数发生器,种子来自链的种子异或一个常数0x9e3779b9u(黄金分割比例相关的哈希常数)。它给「链内随机」和「链外随机」(如 grammar 后校验的兜底、拒绝采样)共享同一个流。
这里有个容易忽略的约束:grmr、rbudget、chain 三者是独立的采样器对象,但 common_sampler_clone 与 common_sampler_copy 必须把它们一起克隆/复制,并且 common_sampler_copy 里有一行 dst->cur_p.data = src->cur_p.data ? dst->cur.data() : nullptr;——拷贝时要让 cur_p.data 重新指向目标自身的 cur 缓冲,而不是继续指向源对象的缓冲。否则两个 sampler 会共享候选数组,在投机解码(克隆草稿链)时产生极难排查的状态串扰。
common_sampler_init:按用户顺序装配链
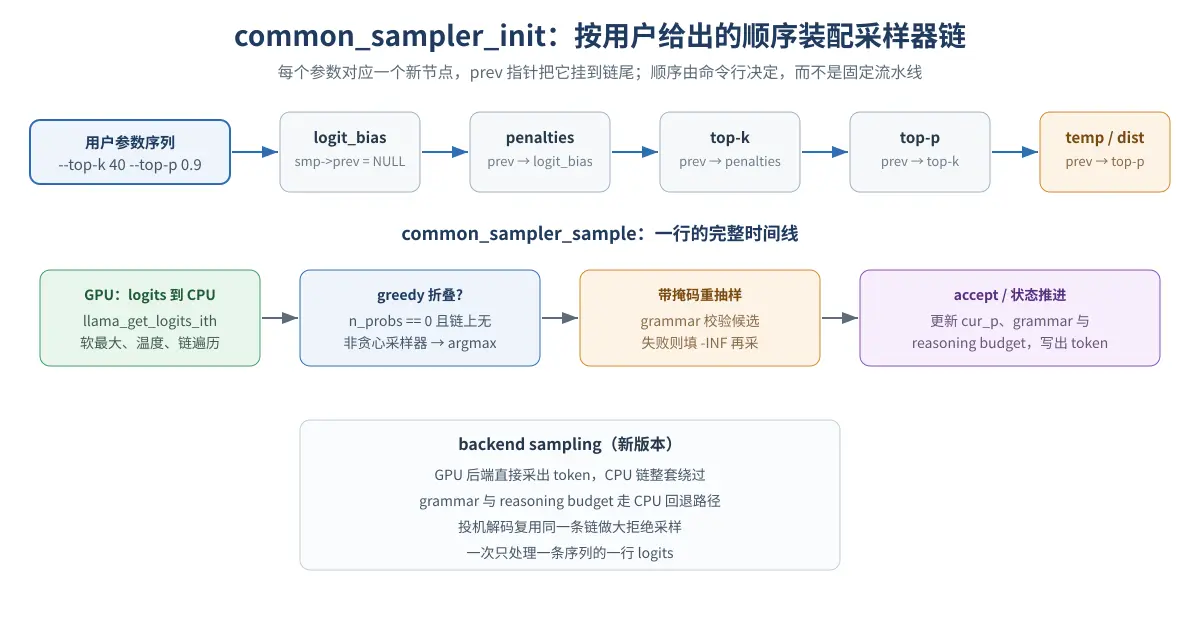
链头的固定部分
装配顺序在源码里是分段的。common_sampler_init 先处理语法与推理预算(它们是带 prefill 的独立采样器):
// 语法如果"需要预填"(输出格式、工具调用语法),先把 generation prompt 的 token 喂进去if (grmr && !params.grammar_lazy && common_grammar_needs_prefill(params.grammar)) { for (const auto & token : prefill_tokens) { llama_sampler_accept(grmr, token); }}
// reasoning budgetif (!params.reasoning_budget_start.empty() && !params.reasoning_budget_end.empty() && ...) { rbudget = common_reasoning_budget_init(vocab, {...}, ...); for (const auto & token : prefill_tokens) { llama_sampler_accept(rbudget, token); }}之后是链的第一段,固定顺序:logit bias。注意源码把用户给的 bias 和模型自带的「抑制 token」合并在一起——有些架构(如某些 Qwen/DeepSeek 版本)的 generation_config.json 里带 suppress_tokens,这些 token 必须永远不出现:
std::vector<llama_logit_bias> merged = params.logit_bias;int32_t n_suppress = 0;const llama_token * suppress = llama_vocab_get_suppress_tokens(vocab, &n_suppress);for (int32_t i = 0; i < n_suppress; ++i) { merged.push_back({ suppress[i], -INFINITY });}if (!merged.empty()) { samplers.push_back(llama_sampler_init_logit_bias(llama_vocab_n_tokens(vocab), merged.size(), merged.data()));}把抑制 token 实现成「logit bias = 」而不是一个单独的采样器,是因为 logit_bias 采样器本来就是「稀疏位置加减」的通用设施,复用它几乎零成本。 经过后续的任何排序、softmax 都仍然是「概率为 0」,不会因为截断环节的排序而被漏掉。
链主体:for (const auto & cnstr : params.samplers)
这是本篇最关键的一段。params.samplers 是一个有序的枚举列表,由命令行 --samplers "top_k;typ_p;top_p;min_p;temp" 解析而来。common_sampler_init 用一个 switch 把它逐个翻译成采样器对象:
for (const auto & cnstr : params.samplers) { switch (cnstr) { case COMMON_SAMPLER_TYPE_DRY: samplers.push_back(llama_sampler_init_dry(vocab, params.dry_multiplier, params.dry_base, params.dry_allowed_length, params.dry_penalty_last_n, c_breakers.data(), c_breakers.size())); break; case COMMON_SAMPLER_TYPE_TOP_K: samplers.push_back(llama_sampler_init_top_k(params.top_k)); break; case COMMON_SAMPLER_TYPE_TOP_P: samplers.push_back(llama_sampler_init_top_p(params.top_p, params.min_keep)); break; case COMMON_SAMPLER_TYPE_TOP_N_SIGMA: samplers.push_back(llama_sampler_init_top_n_sigma(params.top_n_sigma)); break; case COMMON_SAMPLER_TYPE_MIN_P: samplers.push_back(llama_sampler_init_min_p(params.min_p, params.min_keep)); break; case COMMON_SAMPLER_TYPE_XTC: samplers.push_back(llama_sampler_init_xtc(params.xtc_probability, params.xtc_threshold, params.min_keep, params.seed)); break; case COMMON_SAMPLER_TYPE_TYPICAL_P: samplers.push_back(llama_sampler_init_typical(params.typ_p, params.min_keep)); break; case COMMON_SAMPLER_TYPE_TEMPERATURE: samplers.push_back(llama_sampler_init_temp_ext(params.temp, params.dynatemp_range, params.dynatemp_exponent)); break; case COMMON_SAMPLER_TYPE_INFILL: samplers.push_back(llama_sampler_init_infill(vocab)); break; case COMMON_SAMPLER_TYPE_PENALTIES: samplers.push_back(llama_sampler_init_penalties(llama_vocab_n_tokens(vocab), params.penalty_last_n, params.penalty_repeat, params.penalty_freq, params.penalty_present)); break; case COMMON_SAMPLER_TYPE_ADAPTIVE_P: use_adaptive_p = true; break; }}由此可以读出几个设计事实:
- 没有「默认顺序」的推断逻辑。 链顺序完全由参数列表决定。参数列表在命令行层被解析,若用户没写
--samplers,命令行层会填入一份默认顺序,common_sampler_init本身不做任何「如果没给 top_k 就跳过」之类的推断——它只要遍历给出的列表。这意味着同一组top_k/top_p数值,在前端默认链与显式链下是不同的两条链。 - 同一个采样器类型可以出现多次。列表里写两次
top_p就会有两个独立的top_p对象,各自持有min_keep等状态。这对「先粗截断再细截断」是有意义的组合。 adaptive-p被延后到链尾。switch里只设置use_adaptive_p = true,不立即 push,因为 adaptive-p 像dist和mirostat一样是做最终选取的采样器,必须在所有截断之后。源码注释原文:the adaptive-p sampler is like dist and mirostat in that it selects a single token, so we will add dist at the end of the chain by default, unless the user specifically included adaptive-p。min_keep被打包进每个「可能清空候选」的采样器。top_p、min_p、xtc、typical的构造都带params.min_keep。这是对「截断后候选集为空」的兜底:无论阈值多严,至少保留min_keep个 token(默认 1)。没有这个兜底,极端参数下(比如top_p=1e-6)抽样阶段会面对空数组。
链尾:greedy 折叠的精确条件
链主体之后,mirostat == 0 的分支会追加最终选取器。这段代码是全篇最值得逐字读的部分:
if (use_adaptive_p) { samplers.push_back(llama_sampler_init_adaptive_p(params.adaptive_target, params.adaptive_decay, params.seed));} else { // Keep distribution sampling when callers request probabilities. const bool greedy = params.n_probs == 0 && !params.samplers.empty() && ((params.samplers.back() == COMMON_SAMPLER_TYPE_TEMPERATURE && params.temp == 0.0f && params.dynatemp_range == 0.0f) || (params.samplers.back() == COMMON_SAMPLER_TYPE_TOP_K && params.top_k == 1)); samplers.push_back(greedy ? llama_sampler_init_greedy() : llama_sampler_init_dist(params.seed));}逐条拆开:
params.n_probs == 0:如果调用者要求返回候选概率(API 的logprobs),就不能折叠成 greedy。为什么?greedy采样器只找 argmax,不保证候选数组被归一化、不保证cur_p被整理成「按概率排序的前若干个」。而n_probs的输出需要完整的分布视图。所以「要给概率,就必须走dist」——这条约束把采样器的选取语义和输出语义绑在了一起,是一个很干净的设计。- 温度 0 必须配合
dynatemp_range == 0:动态温度(dynatemp)会让实际温度在范围内浮动,即使基准temp == 0,动态范围会让它在某些步大于 0,于是不能折叠。 top_k == 1也被折叠为 greedy:只留一个候选再按分布抽,结果就是该候选本身,所以等价于 argmax。这是一个「语义等价就折叠」的优化,省掉一次 softmax 和一次随机数生成。samplers.back()必须是最后一个采样器:只有当温度或top_k=1是链尾时,折叠才成立。如果链尾是 min-p 或典型采样,它们的apply可能重新归一化或再截断,折叠为 greedy 会绕过它们。
折叠的实际效果:链尾的 dist 被替换成 greedy,而 greedy 的 apply 只做一次 argmax 扫描并设置 cur_p.selected,不生成随机数、不做 softmax。这是 llama.cpp 采样链里最大的单项优化——贪心场景下整条链的成本只剩前面各截断采样器的 logits 变换。
mirostat 分支
mirostat == 1/2 时,链尾是 temp + mirostat/mirostat_v2,且不经过上面那段 params.samplers 的截断循环(mirostat 自己控制截断)。mirostat 是一种自适应截断算法:用运行时估计的目标困惑度 动态调整截断阈值,无需 top-k/top-p 参数。llama.cpp 实现里 mirostat 的第三个参数 100 是 n_vocab 上限相关的初始候选规模,mirostat_v2 省掉了显式的 偏移量维护。这部分在默认部署里很少用到,但读源码时要注意它和 params.samplers 是互斥路径。
backend sampling 的禁用条件
链装配完之后还有一段:
if (grmr && params.backend_sampling) { LOG_WRN("%s: backend sampling is not compatible with grammar, disabling\n", __func__); params.backend_sampling = false;}if (rbudget && params.backend_sampling) { LOG_WRN("%s: backend sampling is not compatible with reasoning budget, disabling\n", __func__); params.backend_sampling = false;}backend sampling 是较新版本引入的路径:随机数、采样本身都在 GPU 后端完成,CPU 只负责取回 token。它与 grammar 不兼容的原因很直接:语法后校验需要「在 CPU 上拿到候选数组、失败后重新施加掩码再抽」;与 reasoning budget 不兼容是因为 budget 也是链外状态机。源码选择的是自动降级——打印警告、关掉 backend sampling,而不是报错。这体现了 llama.cpp 前端一贯的「参数能救就救」的风格。
common_sampler_sample:一行的完整时间线
采样入口的函数签名是:
llama_token common_sampler_sample(struct common_sampler * gsmpl, struct llama_context * ctx, int idx, bool grammar_first);idx 指明「取 batch 里第几行的 logits」,grammar_first 决定语法是在链前还是链后。把函数体按时间顺序拆开。
第一步:同步、计时、取 logits
llama_synchronize(ctx);const auto tm = gsmpl->tm();gsmpl->set_logits(ctx, idx);llama_synchronize 在计时开始之前——注释说明这是为了不把异步计算的时间算进采样耗时。set_logits 把第 idx 行的 logits 拷进 cur 候选数组,并初始化 cur_p。从这一刻起,cur_p 是整条链共享的工作区:每个 apply 都在原地修改它。
第二步:backend sampling 短路
id = llama_get_sampled_token_ith(ctx, idx);if (id != LLAMA_TOKEN_NULL) { for (size_t i = 0; i < cur_p.size; ++i) { if (cur_p.data[i].id == id) { cur_p.selected = i; break; } } return id;}如果后端已经采出 token,CPU 只需要在候选数组里找到它的下标(供 n_probs / 概率输出对齐),然后直接返回。这里有两个 GGML_ASSERT 保证语法与预算不会被越过——与前面装配阶段的「自动降级」配合,正常情况下走到这里时它们已被置空。
第三步:链前施加预算,然后做语法后校验
llama_sampler_apply(rbudget, &cur_p);
if (grammar_first && grammar_should_apply(gsmpl)) { llama_sampler_apply(grmr, &cur_p);}
llama_sampler_apply(chain, &cur_p);
id = cur_p.data[cur_p.selected].id;
if (grammar_first || !grammar_should_apply(gsmpl)) { return id;}grammar_first 为真时,语法作为普通掩码在链前施加,链的抽样自然只从合法集合里选,直接返回。这是「全程约束」路径。
grammar_first 为假(默认)时,先不管语法跑完整条链,得到候选 id,再进入后校验:
llama_token_data single_token_data = { id, 1.0f, 0.0f };llama_token_data_array single_token_data_array = { &single_token_data, 1, -1, false };llama_sampler_apply(grmr, &single_token_data_array);
const bool is_valid = single_token_data_array.data[0].logit != -INFINITY;if (is_valid) { return id;}这段是 llama.cpp 语法采样的核心技巧,也是 common/sampling.h 文件头注释写的「grammar-based rejection sampling」。它构造了一个只有一个元素的候选数组,把这个 token 喂给语法采样器。语法采样器看到单元素数组,成本从 降到 ,只检查这一个 token 在当前状态是否可以接受;可以,logit 原样保留;不可以,apply 把它置为 。于是后校验退化成「一次单点查询」。
grammar_should_apply 还有一层逻辑:语法被设为 lazy、并且 reasoning budget 处于活动状态时,语法暂不生效(思考阶段允许输出任意 token),等 budget 结束(DONE)再启用。这就是「思维链阶段不约束,正式回复阶段约束」的实现位置。
第四步:失败后的全量重抽样
gsmpl->set_logits(ctx, idx); // 重新拷一份原始 logits
llama_sampler_apply(rbudget, &cur_p);if (grammar_should_apply(gsmpl)) { llama_sampler_apply(grmr, &cur_p); // 这次是整张词表}llama_sampler_apply(chain, &cur_p);id = cur_p.data[cur_p.selected].id;注意这里重新 set_logits。因为第三步已经把 cur_p 原地改得面目全非(截断把大量位置设成了 或剔除),不能在此基础上再叠加语法掩码;必须回到原始分布重新跑整条链,这次语法在前,链只会在合法集合里抽样。
这条路径的成本:一次全词表语法掩码 + 一次完整链。它只在「随机抽到了非法 token」时发生。有多频繁?取决于模型在合法集合外的概率质量——对强约束语法(如 JSON 字段名枚举),越界率不高;对宽松语法(如自由文本 + 某几个触发器)几乎为 0。这正是「常见路径快、少见路径正确」的取舍:绝大多数步只付 ,少数步付两次链。
整体时间线小结
┌─ backend 已采出 token?──是──> 回填 selected,返回set_logits ────────┤ └─ 否 │ ├─ grammar_first ──> [rbudget] → [grammar 整表] → [chain] → 返回 │ └─ 默认 ├─ [rbudget] → [chain] → 候选 id ├─ 单元素语法检查:合法?──是──> 返回 └─ 否 set_logits(重拷原始分布) [rbudget] → [grammar 整表] → [chain] → 返回链上各个采样器的语义细节
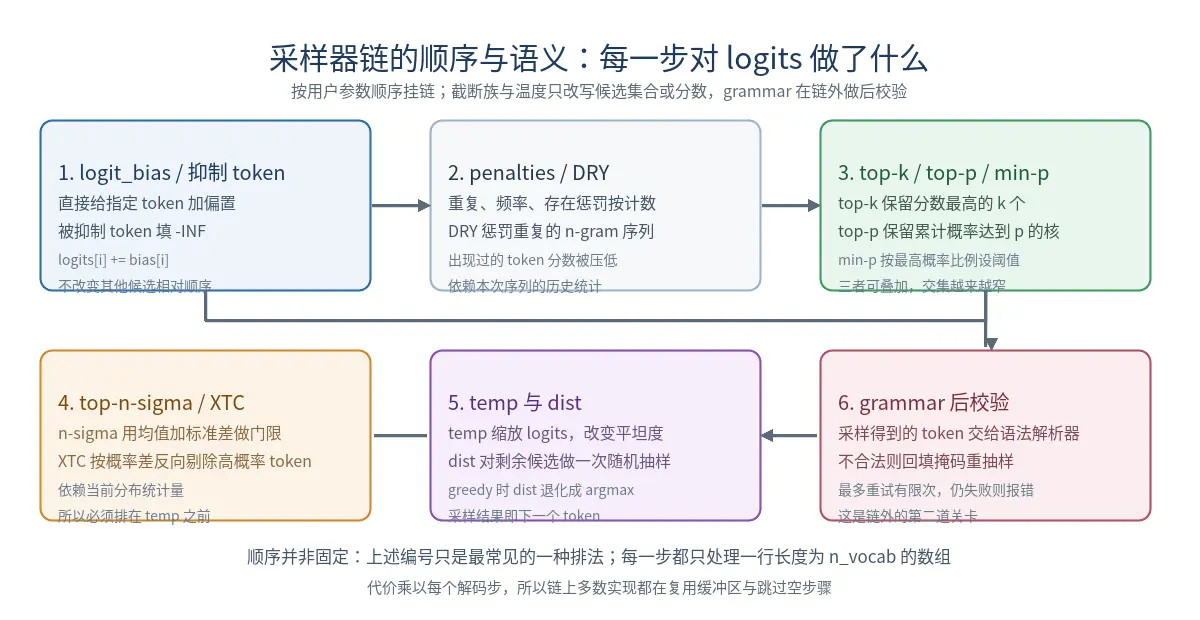
有了 common_sampler_sample 的骨架,再逐个看链上成员的 apply 实际做了什么。这里只讲对理解「顺序为什么重要」有帮助的语义,不逐行贴实现。
penalties:重复、频率、存在惩罚
三者合并在一个 llama_sampler_init_penalties 对象里,参数是 penalty_last_n、penalty_repeat、penalty_freq、penalty_present。设最近 penalty_last_n 个 token 中 token 出现 次:
- 重复惩罚 :若 则 ,否则 。只对出现过的 token 做乘除,符号敏感的处理保证「总是向 0 方向收缩」,而不是把负数乘成更负(那反而抬高了相对排名)。
- 频率惩罚 :,线性扣分,出现越多扣越多。
- 存在惩罚 :,只扣一次。
源码里 params.penalty_freq 与 params.penalty_present 默认都是 0,penalty_repeat 默认 1.0(即不惩罚)。历史窗口由 prev 环形缓冲提供,但 penalty_last_n 可以小于缓冲长度——窗口只取最近的若干个。窗口的存在解释了为什么惩罚没有「无限累积」问题。
顺序为什么重要:惩罚排在任何截断之前时,先压低再截断,被压低的 token 可能直接被 top-k 挤出候选;若排在温度之后,缩放又会改变惩罚的相对强度(惩罚是加法/乘法,与温度缩放不可交换)。llama.cpp 把顺序交给用户,但默认顺序(若命令行给出)是惩罚在前。
DRY:按字符 n-gram 的重复约束
DRY(Don’t Repeat Yourself)是社区提出的防复读采样器,参数包括 dry_multiplier、dry_base、dry_allowed_length、dry_penalty_last_n 和一组 dry_sequence_breakers。它的原理与「token 级重复惩罚」不同:它按字符序列找最长的已出现后缀,然后对「可能延续该 n-gram 的 token」施加以 dry_base 为底的指数惩罚:
其中 是匹配长度, 是 dry_multiplier, 是 dry_base(如 1.75)。匹配越长,惩罚越大;短于 dry_allowed_length 的匹配不罚。dry_sequence_breakers(如 \n、:、")用来切断匹配——跨过换行或冒号的重复视为「不同结构的重复」,不应惩罚。
DRY 需要维护「上下文中所有字符 n-gram 的最长后缀匹配」,实现上用后缀树/哈希表按长度分桶,每步只更新末尾新增的部分,不是每步全量重建。这是链里状态最重的采样器之一,也是它为什么必须支持 accept/reset/clone——投机解码的草稿链要复制它的状态。
top-k、top-p、min-p、top-n-sigma
-
top-k:保留分数最高的 个。当 且位于链尾时会被折叠为 greedy(前文)。实现需要一个「前 大」的选择,llama.cpp 实际做法是先对整个候选数组做降序排序(
std::partial_sort类思路),然后截断到前 。因为后续的 top-p 等常常共用同一份排序,避免重复排序是common_sampler里的一类优化(不同版本实现有差异,读源码时留意「候选数组在链中是否被复用」)。 -
top-p(核采样):在降序排列上累加 ,直到累计值达到阈值,保留前缀。这里的概率阈值是累计阈值而不是单个 token 的概率阈值——分布尖锐时可能只留几个 token,平缓时可能留几百个。
min_keep保证至少保留几个。 -
min-p:保留 的 token,即以最大概率为参照的相对阈值:
分布尖锐时自动收窄、平缓时自动放宽,不需要像 top-p 那样处理累加语义。
-
top-n-sigma:以 logits 的均值和标准差为参照,保留在 之内的 token,是另一种「相对阈值」形式,对 logits 尺度敏感。
-
typical(
typ_p):先用 得到条件熵 ,再按 的偏差保留「典型」token。 -
XTC:以
xtc_probability的概率触发,触发时把概率高于xtc_threshold的头部 token 排除(保留一个兜底),目的是打破「总是输出最常见短语」的惯性。
这些采样器的共同点是:读 cur_p、原地修改 logits、维护少量状态。它们的相对顺序决定了「截断作用于原始分布还是已缩放分布」「候选集是哪个阶段的结果」。
temp / temp_ext:动态温度
llama_sampler_init_temp_ext 同时携带 temp、dynatemp_range、dynatemp_exponent。动态温度在每一步根据当前熵在 内选取实际温度——熵低时选低温度(更自信),熵高时选高温度(更探索)。这也是前面 greedy 折叠要求 dynatemp_range == 0 的原因:动态温度意味着「实际温度每步都可能不为 0」。
温度在链中的位置决定它缩放的是「已经惩罚过的 logits」还是「原始 logits」。把温度放在链尾是最常见的写法,这样所有截断都在原始尺度上进行,温度只做最后一步缩放。
dist 与 greedy:最终选取
dist 在前缀和上做逆 CDF 采样:对归一化的候选计算累计概率 ,生成 ,二分找到第一个 。随机数来自 gsmpl->rng。greedy 只做 argmax。二者都不修改截断结果,只设置 cur_p.selected。
infill:FIM 中间填充
infill 采样器服务于「中间填充」(fill-in-the-middle)场景:用户给了前缀和后缀,要求模型在中间补全。它的作用是根据当前已生成内容推导 FIM 的哨兵 token(如 <|fim_prefix|>、<|fim_suffix|>、<|fim_middle|>,不同模型不同),在合适时机强制输出 <|fim_middle|>,使模型进入补全模式。它在链中的位置通常在截断之前,因为它是「结构性的强制约束」而不是概率调整。
投机解码:同一条链如何服务草稿验证
common_sampler_sample 被直接复用于投机解码(llama.cpp 的 --draft / 自带草稿模型),源码中有两组函数:
-
common_sampler_sample_and_accept_n(gsmpl, ctx, idxs, draft, grammar_first):贪心匹配验证。对每个草稿 token 位置调common_sampler_sample得到目标模型的选取id,若id == draft[i]则接受并accept(id, true);一旦不匹配就停下(注意它只在这条「已接受 + 下一个」的边界上做一次新的采样),返回接受的 token 序列。 -
common_sampler_sample_and_accept_n_rejection(...):拒绝采样验证。注释写得很清楚:Accept a drafted token with probability min(1, p/q), else draw from norm(max(0, p - q))。设目标分布 、草稿分布 ,以 的概率接受草稿 token;拒绝时从残差分布中重新抽取。这保证最终输出严格服从目标分布,即使草稿模型是随机采样而非 argmax——“accepts more often than matching does when the draft samples instead of taking its argmax”。
两条路径共用 common_sampler_sample,这意味着链的顺序、状态(prev、语法、DRY)在草稿验证和普通解码中完全一致。这是链式设计带来的可复用性回报:不需要为投机解码另写一套采样逻辑,只需在同一调用上换一个验证策略。
另外注意 common_sampler_sample_and_accept_n 里的一个细节:
if (draft[i] != id || (llama_vocab_is_eog(vocab, id) && i + 1 < draft.size())) { break;}草稿 token 之后若已是 EOG(结束符),不再继续接受后续草稿——结束符之后的 token 不进上下文,避免污染。
accept、reset、clone:状态机的一侧
采样器除了 apply 还有几类生命周期操作,common_sampler 把它们分别转发:
common_sampler_accept(gsmpl, token, is_generated):先让rbudget接受(若启用且是生成的 token),再根据grammar_should_apply决定是否喂给grmr,最后llama_sampler_accept(chain, token)并推入prev。is_generated的意义在前面提过:前端回填的提示词 token 也要推进语法状态,但不应计入「生成历史」的惩罚窗口。源码在 budget 进入DONE时还会把结束序列重放给语法:「if it is done, replay end sequence which may contain a grammar trigger」——推理预算的结束标记本身可能就是语法的触发器。common_sampler_reset:清空prev、各采样器状态、语法状态机、RNG 之外的预算状态,用于一条新请求复用同一个 sampler(比如 server 的 slot 复用)。common_sampler_clone/common_sampler_copy:整体复制,包括rng与prev缓冲。投机解码里草稿链需要与目标链状态一致;clone用于「fork 出一条并行验证」,copy用于「把克隆的状态抄回」。前面提到的cur_p.data重指向就发生在这里。
这几类操作在「批量框架」里几乎不存在(批量采样无状态),但在单序列 + 多 slot 复用的 server 里是必需品。这也是 llama.cpp 采样器接口看起来比 vLLM 的「采样参数结构体」复杂得多的原因。
性能与工程视角
把上述内容放到性能账上:
- 每步的固定成本是「一次
set_logits(拷贝一行词表大小) + 链上各apply」。词表 15 万时,一次 float 拷贝约 600KB;链上有 top-k 排序时,排序本身约 或 。这是 llama.cpp 在 CPU 上每步采样的下限。 - greedy 折叠省掉 softmax 与随机数,贪心场景下链只剩截断变换——大模型在 CPU 上做贪心推理时,采样耗时可忽略不计,瓶颈完全在 ggml 前向。
- 语法后校验把「每步全词表掩码」变成「每步一次单点检查」,只有越界步付全量成本。对结构化输出场景(JSON / 工具调用),这是能与 GPU 批处理框架相当的关键。
- backend sampling 把采样挪到 GPU,CPU 只读回 token,绕开上面所有成本;代价是不能用 grammar 和 reasoning budget——这与 batch-invariant 推理的取舍类似:确定性、可复现的采样需要把随机数固定在链里,而 GPU 批量采样的随机数通常按批内位置分配。站内 Batch-invariant 推理完全拆解 讨论了「同一请求在不同 batch 里结果漂移」的问题,llama.cpp 在链末尾用
dist采样时天然单序列、结果与 batch 无关;切到 backend sampling 后,就要重新审视这一点——这也是它只在没有语法/预算约束时启用的另一层原因。 - 投机解码复用:
common_sampler_sample与accept是同一套状态推进,草稿验证不引入第二套历史维护,避免「目标链和草稿链历史不一致」导致接受率统计错乱。
与其他框架的采样器对照
| 维度 | llama.cpp | vLLM | SGLang | TensorRT-LLM |
|---|---|---|---|---|
| 采样执行位置 | 前端 CPU(默认),后端采样可选 | GPU 内核,批量 | GPU 内核,批量 | GPU 内核,批量 |
| 链结构 | 显式有序链表,用户可控制顺序 | 请求级参数 + 批量内核 | 请求级参数 + 批量内核 | 采样器插件分档执行 |
| 语法约束 | 抽样后单点校验 + 失败全表重抽 | FSM 位掩码,逐请求 | 语法对象 + 批量掩码 | bitmask 掩码 + 草稿回滚 |
| 贪心 | 显式折叠为 greedy 采样器 | 内核分支 | 内核分支 | 内核分支 |
| 投机验证 | 贪心匹配 / 拒绝采样,复用同一条链 | 批量验证 | 批量验证 | one-model 草稿 + 验证 |
| 状态 | prev 环、DRY 后缀表、语法状态机随 sampler 携带 | 每步按请求计算 | 每步按请求计算 | 每步按请求计算 |
对照的核心结论:llama.cpp 把「采样」当作一个有状态的流式处理器,它的链可以被重置、克隆、复制,服务于多 slot 的 server 和投机解码;批量框架把「采样」当作无状态的逐请求函数,状态由请求对象(而非采样器)持有。前者在单序列下省掉大量重复计算,后者在批量下换来吞吐。两种设计各有边界:llama.cpp 的链一旦遇到「批内多序列共享采样器」就不再适用,这正是 backend sampling 出现的前提——把无状态部分挪到 GPU,让批处理重新成为可能。
本系列进度与下一篇
到本篇为止,llama.cpp 系列已覆盖架构全景、请求路由、slot 与 prompt cache、ubatch 切分、CUDA Graph 与图更新、量化推理(mmvq/mmq/quantize/imatrix)、ggml-cpu 与 ggml-cuda 算子(注意力融合、RoPE 家族)、张量并行与 Meta device、LoRA、RPC 后端、mtmd 多模态、嵌入与池化、对话模板(minja)、分词器词表、递归状态缓存、tool call 解析、router 模型生命周期与 HTTP 路由。本篇补上了「logits 到 token」这一段。
尚未单独展开的模块中,优先级较高的是:采样器的 GPU 后端与 backend sampling 的随机数布局(与 batch-invariant 的关系)、ggml 图调度器与内存复用(ggml-alloc / gallocr)、server 的 chat completions 完整路径(参数校验与推理预算、采样默认值合并)。下一篇拟从 backend sampling 的随机数布局入手,讲清「GPU 采出的 token 为什么不能与 CPU 链的随机流共用」。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



