


vLLM 源码完全拆解(三十四):推理内容解析器——同一个模型输出,为什么要拆成内容、思考与工具调用三段
背景与问题定义
一个推理模型返回给客户端的东西,表面上是”一段文本”,实际上同时承载了三种语义。以 OpenAI 兼容的 Chat Completions 协议为例,一条 assistant message 可以包含 content、reasoning 与 tool_calls 三个字段;在流式响应里,它们又以增量 delta 的形式分多帧到达。reasoning 是 vLLM 对推理模型思考过程的扩展字段,早期版本把它命名为 reasoning_content,后续已经改名,客户端如果仍读取旧字段,会在模型明明返回了思考内容时读到空值。
三种字段对应三类消费者。聊天前端把 reasoning 放进可折叠的”思考过程”面板,把 content 当作正式回答;Agent 执行器只关心 tool_calls 里的函数名和 JSON 参数,拿到后就去调用真实工具;普通 SDK 客户端可能只读 content,完全不想看到思维链。模型并不会分别输出三路 token,它只输出一条 token 流,中间夹杂着 ...、...、<tool_call>...</tool_call>、<parameter=...> 这类由训练时 chat template 定义的标记。把这些标记从一条流里剥离出来,再翻译成协议字段,就是解析器(parser)层的工作。
这件事看起来像字符串处理,真正落到在线服务里却处处是边界。第一,标记本身会被 tokenizer 切成多个 token,</think> 可能被拆成 </、think、> 三次解码;第二,tokenizer 的 detokenizer 为了正确处理多字节字符和字节级 BPE,会”扣住”末尾若干字节,直到下一个 token 到达才一起吐出,所以某一帧的 delta_text 可能不包含刚生成的那个标记;第三,工具调用的参数是 JSON,JSON 在流式过程中天然是不完整的,不能每帧都 json.loads;第四,工具名可能在参数之前出现,而一个 delta 也可能同时包含”思考结束 + 工具开始 + 函数名”三件事;第五,模型可能不输出起始标记,直接从思考内容开始,也可能在 max_tokens 截断时留下半个 <tool_call>。
因此,解析器不能只做 text.split("</think>")。它必须同时理解文本视图与token 视图:文本视图决定用户看到什么,token 视图决定结构化输出、思考结束判定和 token 计数。vLLM 在 vllm/reasoning/、vllm/tool_parsers/ 与 vllm/parser/ 三个目录里把这件事拆成了三层:最底层是模型格式(reasoning parser 与 tool parser),中间层是把两者组合起来的 Parser,最上层是 OpenAI 兼容服务层里的 ChatStreamProcessor。理解这三层,才能理解为什么同一个 delta_text 在不同模型上会被分到不同字段。
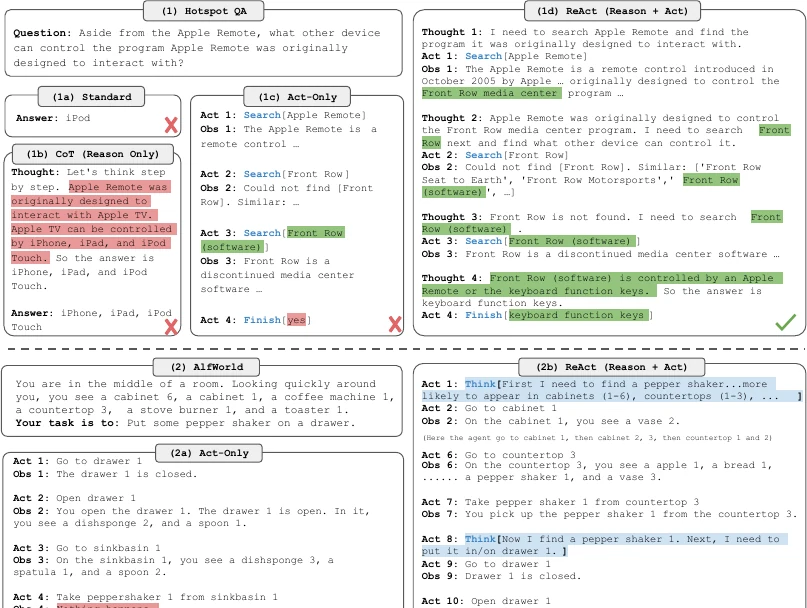
ReAct 在 2022 年把”推理”与”行动”放进同一条生成轨迹:模型先写出思考,再发出一个动作,观察结果后继续思考。今天推理模型与工具调用的输出格式,本质上是这条轨迹的工程化版本。区别在于 ReAct 用自然语言描述动作,而生产系统要求动作必须是可执行的 JSON,并且要在协议层被拆成独立字段。图片来源:ReAct 论文 Figure 1。
协议层:三个字段与一条增量
先看服务层拿到的数据结构。vllm/entrypoints/generate/base/protocol.py 里的 DeltaMessage 只有三个核心字段:
class DeltaMessage(OpenAIBaseModel): content: str | None = None reasoning: str | None = None tool_calls: list[DeltaToolCall] = Field(default_factory=list)DeltaToolCall 再携带 index、id、type 与 function,其中 function.name 只在第一次出现时给出,后续帧只带 function.arguments 的增量字符串。这个设计直接决定了工具解析器的状态:它必须记住”当前正在解析第几个调用、函数名是否已经发过、已经流出了多少参数字符”。
非流式响应则走另一条路径:parser.parse() 一次拿到完整输出,返回 (reasoning, content, tool_calls) 三元组,再由 assemble_chat_message_fields() 组装成最终 message。流式路径由 ChatStreamProcessor 驱动,每个 choice 一个实例,按引擎产生的 chunk 顺序调用 step():
delta = parser.parse_delta( delta_text=delta_text, delta_token_ids=delta_token_ids, request=request, prompt_token_ids=prompt_token_ids, finished=finish_reason is not None,)ChatStreamProcessor.step() 还做三件与解析同样重要的事。第一,keep_tool_calls 决定这一帧的 tool_calls 是否真的发给客户端;在 tool_choice="none" 或未开启自动工具调用时,即使模型吐出了工具标记,也要把 tool_calls 清空。第二,maybe_filter_parallel_tool_calls() 按 parallel_tool_calls 参数裁剪并行调用。第三,resolve_finish_reason() 把引擎的停止原因改写成协议语义:只要这一条请求实际流出过工具调用,finish_reason 就应该是 tool_calls,而不是 stop。
另一个容易被忽略的细节是元数据泄漏。ChatStreamProcessor 在构造时计算 hide_metadata:
self.hide_metadata = parser is not None and not request.include_reasoning当客户端明确表示不要思考内容(include_reasoning=false)时,vLLM 仍然让模型生成思考 token——这不影响模型质量——但会在响应里去掉 reasoning,并且把 logprobs 与原始 token_ids 一并隐藏。原因是 logprobs 里的 token 文本和 token_ids 解码后都能还原出思考内容;如果只删 reasoning 字段而保留这两项,等于把思维链从侧门漏了出去。非流式路径同样在 suppress_metadata 为真时把 logprobs 与 token_ids 置空,并通过 count_reasoning_tokens() 在 usage 的 completion_tokens_details 里单独报告思考 token 数。
这层协议语义解释了 parser 的职责边界:它不只是”切字符串”,还要让 finish_reason、usage、logprobs 与三个内容字段保持一致。
ReasoningParser:文本视图与 token 视图
vllm/reasoning/abs_reasoning_parsers.py 定义了 reasoning parser 的抽象接口。它看似方法很多,实际上围绕两个问题展开:思考在哪里结束,以及结束前后的文本分别属于谁。
class ReasoningParser: engine_based_streaming: bool = False
@abstractmethod def is_reasoning_end(self, input_ids: Sequence[int]) -> bool: ...
def is_reasoning_end_streaming( self, input_ids: Sequence[int], delta_ids: Iterable[int] ) -> bool: return self.is_reasoning_end(input_ids)
@abstractmethod def extract_content_ids(self, input_ids: list[int]) -> list[int]: ...
@abstractmethod def extract_reasoning(self, model_output: str, request) -> tuple[str | None, str | None]: ...
@abstractmethod def extract_reasoning_streaming( self, previous_text: str, current_text: str, delta_text: str, previous_token_ids: Sequence[int], current_token_ids: Sequence[int], delta_token_ids: Sequence[int], ) -> DeltaMessage | None: ...is_reasoning_end 接收 token id 而不是文本,extract_reasoning 接收完整文本。两套接口并存不是冗余:结构化输出后端(xgrammar 等)需要在 token 序列上判断”思考是否已经结束”,从而决定从哪个 token 开始施加 JSON/正则语法;而 API 层最终要返回字符串,必须做文本切分。count_reasoning_tokens() 也只看 token id,因为 usage 统计的单位是 token。
is_reasoning_end_streaming() 的默认实现直接复用 is_reasoning_end(input_ids),但具体 parser 往往会覆盖它。对 BaseThinkingReasoningParser 来说,流式判断只需要看 end_token_id in delta_ids,比每次扫描全部历史便宜得多。
接口里还有几个生命周期钩子。adjust_request() 允许 parser 修改请求参数(例如按模型的模板补一个字段);set_prompt_token_ids() 把渲染后的完整 prompt 交给 parser;adjust_initial_state_from_prompt() 在流式开始时根据 prompt 调整初始状态;prepare_structured_tag() 用来给结构化输出准备标记。它们解决的是同一个问题:思考是否在 prompt 里就已经开始了。例如 continue_final_message 会让 prompt 以一段未闭合的 ... 结尾,此时第一个生成 token 就应该算作思考,而不是内容。
注册表:名字如何变成类
ReasoningParserManager 维护两张表:reasoning_parsers 存已导入的类,lazy_parsers 存 (module_path, class_name)。--reasoning-parser qwen3 只传一个名字,服务启动时通过 get_reasoning_parser() 查表;如果是懒注册项,第一次访问才 importlib.import_module(),并把类缓存回 reasoning_parsers。vllm/reasoning/__init__.py 里的 _REASONING_PARSERS_TO_REGISTER 列出了全部名字,包括 deepseek_r1、deepseek_v3、deepseek_v4、deepseek_v41、qwen3、glm45、glm47、kimi_k2、gptoss、granite 等。懒加载的意义不只是启动速度:不同模型的 parser 可能依赖不同的模板工具,只有真正用到时才导入,可以避免一个模型的依赖拖垮整个服务。
BaseThinkingReasoningParser:一个反向扫描的判定器
绝大多数 ... 模型共享同一套逻辑。BaseThinkingReasoningParser 在构造时做了一件很关键的事:从 tokenizer 词表里查 start_token 与 end_token 的 id,查不到就直接抛 RuntimeError。这是一个启动期失败设计:如果用户把 --reasoning-parser qwen3 配到了一个词表里没有 ... 的模型上,服务应该在启动时拒绝,而不是在线上把整段输出都当成 reasoning。
start_token_id = self.vocab.get(self.start_token)end_token_id = self.vocab.get(self.end_token)if start_token_id is None or end_token_id is None: raise RuntimeError(...)判定函数从序列末尾往前扫:
def is_reasoning_end(self, input_ids): for i in range(len(input_ids) - 1, -1, -1): if input_ids[i] == self.start_token_id: return False if input_ids[i] == self.end_token_id: return True return False这个”从后往前、先遇到谁算谁”的写法同时处理了三种情况。正常输出是 ...:末尾先遇到 end,返回真;模型没有输出起始标记、直接从思考开始时,序列里只有 end,仍返回真;多轮对话的 prompt 里可能同时出现上一轮的 ... 和这一轮的 ...,从后往前找保证只看最近一段。若一个标记都没有,返回假,表示”当前仍处于思考中”。
extract_content_ids() 的细节更微妙:
if self.end_token_id not in islice(input_ids, 0, max(0, len(input_ids) - 1)): return []else: return input_ids[input_ids.index(self.end_token_id) + 1 :]它刻意排除了序列的最后一个 token。原因在于调用时机:当 is_reasoning_end_streaming() 判定本帧出现了 end token 时,parse_delta() 会把 delta_token_ids 传进来取”end 之后的 content ids”。如果 end 恰好是本帧最后一个 token,那么 end 后面没有内容,返回空列表;排除最后一个位置可以避免把 end 自己当成内容。index() 取第一次出现的位置,则对应”重复输出 </think>”的容错:后面的重复标记会被当作普通文本的一部分,而不是再次切换状态。
非流式解析用 partition() 完成:
parts = model_output.partition(self.start_token)model_output = parts[2] if parts[1] else parts[0]if self.end_token not in model_output: return model_output, Nonereasoning, _, content = model_output.partition(self.end_token)return reasoning, content or None如果输出里有起始标记,就丢掉起始标记及其之前的内容;如果没有起始标记,则假设整段输出从思考开始。没有 end 标记时,整段都算 reasoning,content 为 None——这正是 max_tokens 截断在思考中途时的正确语义:用户不应该看到一个被截断的”回答”。
流式解析把”起始标记在上一帧还是本帧”与”结束标记在上一帧还是本帧”组合成六种情况。核心代码如下:
if self.start_token_id in previous_token_ids: if self.end_token_id in delta_token_ids: end_index = delta_text.find(self.end_token) reasoning = delta_text[:end_index] content = delta_text[end_index + len(self.end_token):] return DeltaMessage(reasoning=reasoning, content=content or None) elif self.end_token_id in previous_token_ids: return DeltaMessage(content=delta_text) else: return DeltaMessage(reasoning=delta_text)elif self.start_token_id in delta_token_ids: ...else: return DeltaMessage(content=delta_text)这张分支表解决的是”一帧里同时发生状态切换”的问题。最常见的切换帧是 ... 后面紧跟 ...:这一帧的 delta_text 既包含思考的尾巴,也包含回答的开头。代码用 find() 在文本里定位 end 标记,切出 reasoning 与 content 两段,放在同一个 DeltaMessage 里。另一个分支 end_token_id in previous_token_ids 表示思考早已结束,本帧全部是 content。单个特殊 token 的帧会被直接跳过,避免把纯标记作为空内容发给客户端。
extract_reasoning_streaming() 还处理了”模型不输出起始标记”的兼容路径。elif self.start_token_id in delta_token_ids 分支只在起始标记出现在本帧时生效;如果整个输出都没有起始标记,会落到最后的 else,把全部文本当作 content。这对某些蒸馏模型是错的:它们直接从思考内容开始,没有 ...。所以 DeepSeekR1ReasoningParser 覆盖了流式方法,补上了”没有起始标记但存在结束标记”的分支:
if ( ret is not None and self.start_token_id not in previous_token_ids and self.start_token_id not in delta_token_ids): if self.end_token_id in delta_token_ids: end_index = delta_text.find(self.end_token) return DeltaMessage( reasoning=delta_text[:end_index], content=delta_text[end_index + len(self.end_token):] or None, ) elif self.end_token_id in previous_token_ids: return DeltaMessage(content=delta_text) else: return DeltaMessage(reasoning=delta_text)这段覆盖是 vLLM reasoning parser 里最值得注意的工程细节之一:同一个模型家族的不同微调版本,模板可能不同。R1 蒸馏版经常省略开头的 ...,如果沿用基类逻辑,整段思考会被当成正式回答。parser 不能假设模板永远完整,只能把”缺失起始标记”当作一种合法状态来处理。
count_reasoning_tokens() 用深度计数而不是简单的区间判断:
depth = 0for token_id in token_ids: if token_id == self.start_token_id: depth += 1 elif token_id == self.end_token_id: if depth > 0: depth -= 1 elif depth > 0: count += 1这样嵌套的 ... 不会被重复计数,孤立的 end token 也不会把计数减成负数。它只统计两个标记之间的普通 token,不把标记本身算进思考 token 数。
模型差异:DeepSeek V3 的按请求委托
DeepSeekV3ReasoningParser 展示了另一种常见结构:模型同时支持思考与非思考模式,parser 需要按请求决定用哪套逻辑。它在构造时读取 chat_template_kwargs:
thinking = bool(chat_kwargs.get("thinking", False))enable_thinking = bool(chat_kwargs.get("enable_thinking", False))thinking = thinking or enable_thinkingself._parser = ( DeepSeekR1ReasoningParser(...) if thinking else IdentityReasoningParser(...))随后把所有抽象方法原样委托给内部 parser。IdentityReasoningParser 不做任何切分,整段输出都是 content。这意味着 --reasoning-parser deepseek_v3 并不是”永远开启思考解析”,它把”是否思考”的决定权交给每个请求的 chat_template_kwargs。这也是为什么 parser 的构造参数里要带 model_config 与 chat_template_kwargs:parser 的行为不只由模型名决定,还由这一次请求的模板参数决定。
DeepSeekV3ReasoningWithThinkingParser 只是在没有显式指定时把 thinking 与 enable_thinking 都默认成真,供那些”默认思考”的模型别名使用。
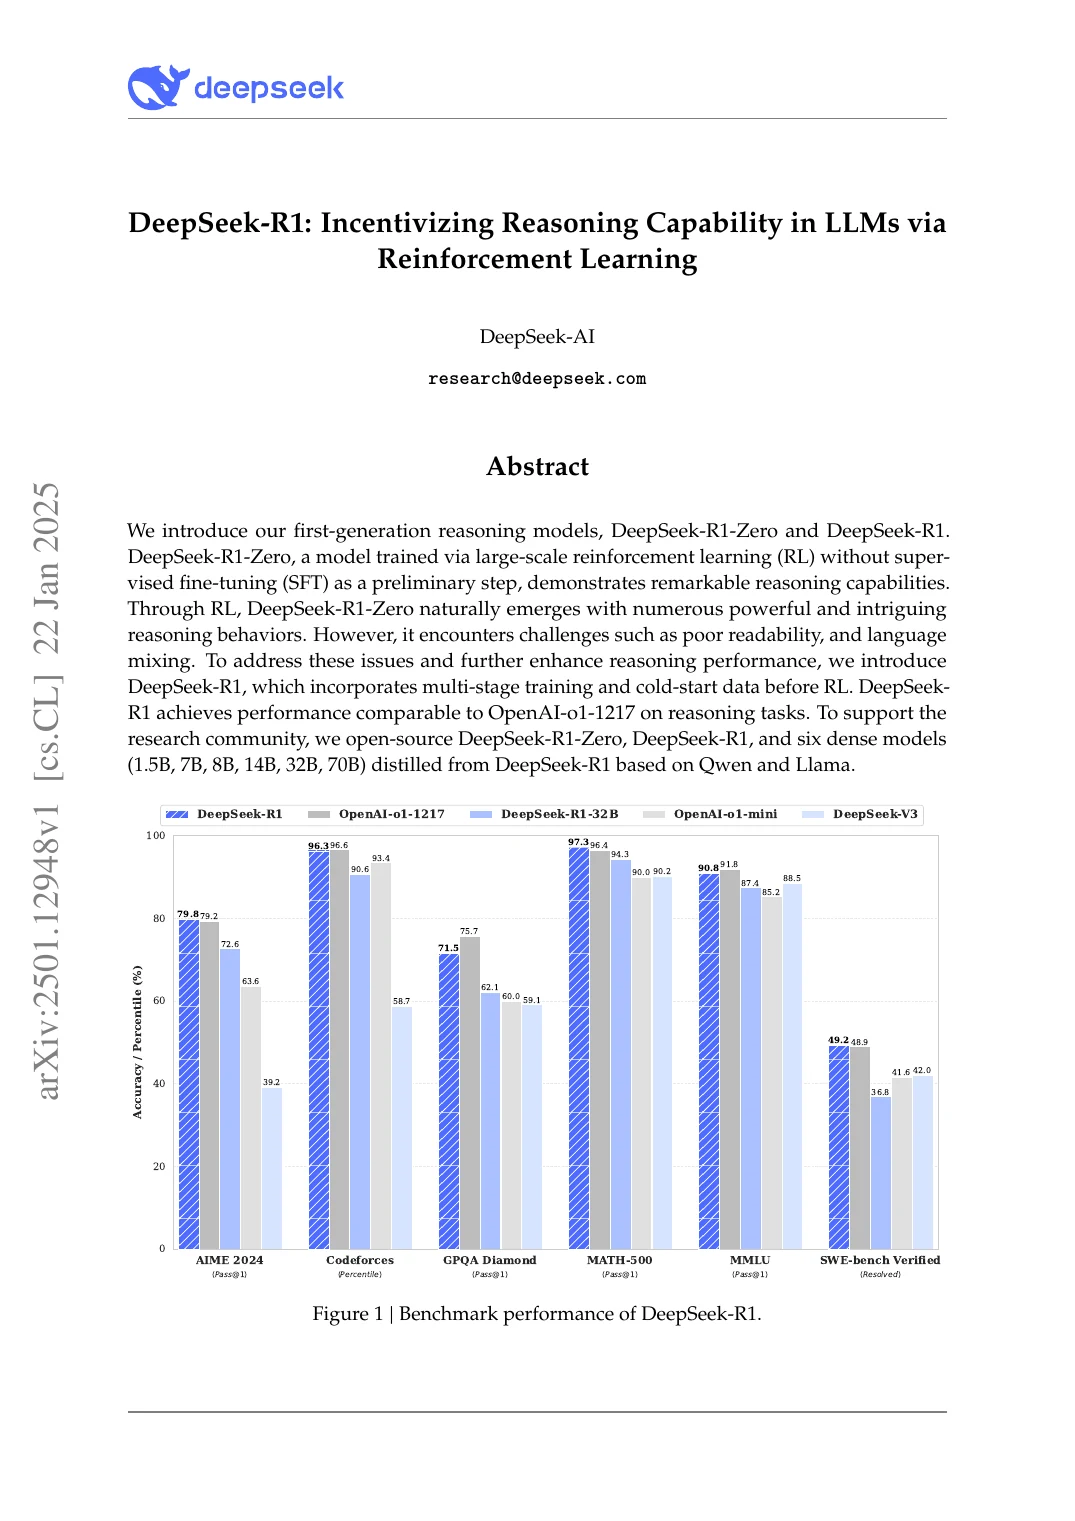
DeepSeek-R1 的 chat template 把 assistant 的输出组织成”思考块 + 回答块”。parser 之所以能在流式过程中稳定切分,是因为模板保证两个标记只会以固定字符串出现;而 tokenizer 又保证这两个字符串各自对应稳定的 token id。图片来源:DeepSeek-R1 论文 与官方仓库模板。
传统 ToolParser:契约与 tool_choice 的三种命运
reasoning parser 只负责切两块文本;工具解析要多做一步:把一段文本翻译成协议里的 tool_calls 数组,并且每个参数必须是合法 JSON。vllm/tool_parsers/abstract_tool_parser.py 的 ToolParser 定义了这套契约的核心字段:
class ToolParser: supports_required_and_named: bool = True structural_tag_model: str | None = None default_tool_strict_level: ToolStrictLevel = ToolStrictLevel.AUTO engine_based_streaming: bool = False
def __init__(self, tokenizer, tools: list[Tool] | None = None): self.prev_tool_call_arr: list[dict] = [] self.current_tool_id: int = -1 self.current_tool_name_sent: bool = False self.streamed_args_for_tool: list[str] = []四个实例字段几乎概括了所有流式工具解析器的状态机:prev_tool_call_arr 保存已解析出的调用(含函数名与参数对象),current_tool_id 是当前正在解析的调用下标,current_tool_name_sent 防止函数名重复发送,streamed_args_for_tool 记录每个调用已经流出多少参数文本。get_remaining_unstreamed_args() 用”应该流出的完整 JSON”减去”已经流出的前缀”,在流结束时补齐剩余参数:
expected = args if isinstance(args, str) else json.dumps(args, ensure_ascii=False)actual = self.streamed_args_for_tool[index]if expected.startswith(actual): return expected[len(actual):]return ""这个方法是”流末补差”的基础。模型可能在 max_tokens 截断时只输出了一半 JSON,解析器到结束时已经无法再等到后续 token;如果它选择把已解析对象重新序列化,那么它与真正流出的前缀之间会有差异。startswith 检查保证只在”已流出内容是完整内容的前缀”时才补齐,否则宁可不补,避免把两个不同的 JSON 拼在一起。
adjust_request:工具选择如何变成语法约束
ToolParser.adjust_request() 在请求进入引擎之前被调用。它做两件事:当 tool_choice="required" 或命名函数调用时,把 structured_outputs 设成由工具列表生成的 JSON Schema;并在需要结构标签时跳过已经由统一 parser 设置的标记。
json_schema_from_tool = get_json_schema_from_tools( tool_choice=request.tool_choice, tools=request.tools, parallel_tool_calls=request.parallel_tool_calls,)if json_schema_from_tool is not None: request.structured_outputs = StructuredOutputsParams(json=json_schema_from_tool) request.response_format = None这一步与解析器本身看似无关,却是”工具调用为什么能稳定解析”的前提。required 和命名调用走的是约束解码:模型被强制输出符合工具 Schema 的 JSON,解析器只需要把 JSON 解析出来,不需要应付各种自由格式的标记。代价是首次请求要编译语法自动机,官方文档提到命名函数调用的首次延迟会多出数秒,之后由缓存承担。
auto 模式则不同。auto 下模型可以不调用工具,可以直接输出文本,因此不能强制 JSON。vLLM 的做法是提供结构标签(structural tag):把工具调用的外层信封(标记与函数名)以及可选的参数 Schema 交给 xgrammar,让模型在”自由文本”与”工具调用格式”之间按语法选择。structural_tag_model 指明这个 parser 对应哪一种内置格式,ToolStrictLevel 控制约束强度:
AUTO:由tool_choice与每个工具的strict字段共同决定;FUNCTION:只要请求带工具,就约束工具调用的信封(标记与函数名),参数内容仍可自由;PARAMETER:进一步按每个工具的 Schema 锁定参数,等价于把所有工具都当成strict: true。
vllm/tool_parsers/tool_strict_level.py 把这三档定义成 IntEnum,服务端可以用 --tool-strict-level 抬高下限。文档特别强调”下限不会放松请求已有的约束”:客户端标了 strict: true 的工具在任何档位都保留 Schema。
这里有一个容易混淆的地方:结构标签约束的是”模型生成什么样”,解析器约束的是”生成结果如何被理解”。两者必须使用同一套格式知识。如果 parser 认为工具调用是 <tool_call><function=...>,而结构标签用的是 Hermes 的 JSON 信封,模型会在语法上被引导到一个 parser 不认识的格式。所以 structural_tag_model 与 parser 的实现是绑定的,不能只改其中一个。
tool_choice 的三种命运
DelegatingParser._extract_tool_calls() 是 tool_choice 语义的集中体现。它按优先级分成四条路径:
tool_choice="none":不解析任何工具调用。对 legacy parser,直接返回([], content),把模型输出原样当内容;对 engine-based parser,仍然走一遍工具解析,但最后清空tool_calls,以保持内容字段与流式路径一致。- 命名调用且 parser 支持 required/named:模型输出被当作被选中函数的参数 JSON,直接构造一个
FunctionCall(name=..., arguments=content),content置None。 required且 parser 支持 required/named:输出应当是FunctionDefinition数组,用 pydantic 的TypeAdapter校验后逐个转成FunctionCall。auto,或 required/named 但 parser 不支持:走 parser 自己的extract_tool_calls(),从模型的原生标记里抽取调用。
这四条路径解释了 supports_required_and_named 的含义。Hermes 这类模型在 required 下会被语法约束成标准 JSON 数组,所以可以直接用第 3 条;GLM 这类模型即使被约束,输出仍是 XML 风格的 <tool_call> 标记,标准 JSON 解析必然失败,因此必须设成 False,让 required 也回退到 parser 的原生解析。
第 4 条还有一个”流末一致性”细节:如果 engine-based parser 没有找到完整调用,它会返回 tool_call_info.content,把不完整的工具标记丢掉;legacy parser 则保留原始 content。这是两种 parser 在 max_tokens 截断时的不同取舍:engine-based 认为”半个工具调用不该出现在回答里”,legacy 认为”用户至少应该看到原始输出”。
_get_function_name() 与 _make_tool_call_id() 负责构造命名调用的协议字段。后者只对 tool_call_id_type == "kimi_k2" 的模型生成确定性 id,其他模型返回 None,由上层按随机或模板规则生成。
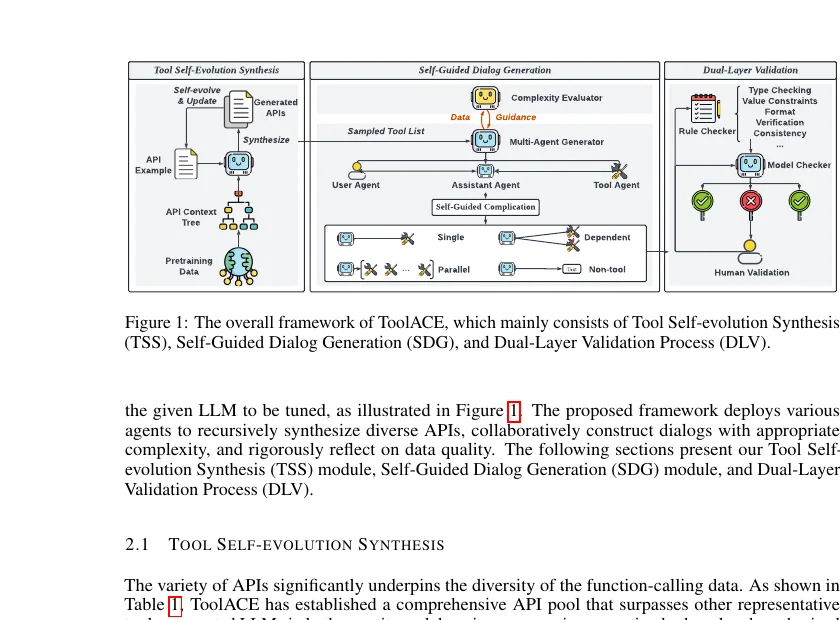
ToolACE 在 2024 年提出用”自演化 API 合成 + 双重校验”构造函数调用训练数据,核心目标之一是让模型学会稳定的调用标记与参数格式。解析器的复杂度,本质上是模型训练格式多样性的镜像:训练数据里有哪些信封、参数写法与容错路径,parser 就要在推理侧对应地认出来。图片来源:ToolACE 论文。
传统 parser 的天花板
手写 parser 的典型结构是”在新增文本里找开始标记,再找函数名,再找参数,再用正则或 JSON 解析”。这套结构在单模型、单格式下工作良好,但一旦要支持几十个模型,就会出现三类重复劳动:
- 每个模型都要重新处理”标记被拆到两帧""参数 JSON 不完整""函数名与参数在同一帧”这些相同的边界;
- 每个模型都要自己维护”当前调用下标、函数名是否已发、参数已流出多少”这三份状态;
- 每个模型都要自己实现
extract_content_ids()、is_reasoning_end()这些与具体标记无关的通用逻辑。
vllm/parser/ 的 ParserEngine 就是为消除这三类重复而出现的:把”格式”写成数据,把”边界处理”写进引擎。
ParserEngine:把模型格式写成状态机
vllm/parser/engine/parser_engine_config.py 把一种模型格式描述成一个 ParserEngineConfig:
@dataclass(frozen=True)class ParserEngineConfig: name: str terminals: Mapping[str, str | tuple[str, ...]] token_id_terminals: dict[str, str] transitions: dict[tuple[ParserState, str], Transition] content_events: dict[ParserState, EventType] initial_state: ParserState = ParserState.CONTENT arg_converter: Callable[[str, bool], str] | None = None arg_value_extender: Callable[[str], ArgValueExtender | None] | None = None tool_call_body_collection: ToolCallBodyCollection | None = None这里的 terminals 不是正则,而是”终结点”(terminal)的声明:THINK_START = "..."、TOOL_START = "<tool_call>"、PARAM_START = "<parameter="。一个终结点可以有多种拼写,tuple 形式就是别名。token_id_terminals 声明哪些终结点还可以按 token id 匹配;transitions 是状态机主体,键是 (当前状态, 终结点),值是 (下一状态, 要发出的语义事件)。
状态集是固定的一组:CONTENT、REASONING、MESSAGE_HEADER、TOOL_PREAMBLE、TOOL_NAME、TOOL_ARGS、TOOL_BETWEEN。事件集同样固定:TEXT_CHUNK、REASONING_START、REASONING_CHUNK、REASONING_END、TOOL_CALL_START、TOOL_NAME、ARG_VALUE_CHUNK、TOOL_CALL_END。这种”固定状态 + 固定事件 + 可配置迁移”的设计,使引擎本身可以完全与模型格式解耦,而格式差异只体现在一张迁移表上。
一条 Qwen3 迁移表
以 vllm/parser/qwen3.py 为例。Qwen3 的格式是:
...思考...<tool_call><function=name><parameter=key>value</parameter></function></tool_call>它的配置从 initial_state = REASONING if thinking else CONTENT 开始,声明了九个终结点,其中 THINK_START、THINK_END、TOOL_START、TOOL_END 同时按 token id 匹配。迁移表里最有信息量的是这几条:
(ParserState.REASONING, "THINK_END"): Transition( ParserState.CONTENT, (EventType.REASONING_END,)),(ParserState.REASONING, "TOOL_START"): Transition( ParserState.TOOL_PREAMBLE, (EventType.REASONING_END, EventType.TOOL_CALL_START),),(ParserState.CONTENT, "TOOL_START"): Transition( ParserState.TOOL_PREAMBLE, (EventType.REASONING_END, EventType.TOOL_CALL_START),),(ParserState.CONTENT, "FUNC_PREFIX"): Transition( ParserState.TOOL_NAME, (EventType.TOOL_CALL_START,)),(ParserState.TOOL_PREAMBLE, "FUNC_PREFIX"): Transition( ParserState.TOOL_NAME, ()),(ParserState.TOOL_NAME, "CLOSE_ANGLE"): Transition( ParserState.TOOL_ARGS, ()),(ParserState.TOOL_ARGS, "FUNC_END"): Transition( ParserState.TOOL_BETWEEN, (EventType.TOOL_CALL_END,)),第一条是正常结束思考。第二条是 Qwen3 最关键的设计:工具调用可以直接结束思考,不需要先输出 </think>。模型有时会在思考态里直接吐 <tool_call>,引擎把这次迁移当成”隐式思考结束”,同时发出 REASONING_END 与 TOOL_CALL_START。第三条覆盖”思考本来就未开启”的情况:CONTENT 状态下直接出现工具调用,也要发 REASONING_END,因为对 API 来说,从”可能还在思考”到”进入工具阶段”本身就是一次推理阶段切换。
第四条是”没有 <tool_call> 包裹的 <function=”降级路径:模型漏了外层信封,引擎仍把它当作工具调用开始。第六、七条是 Qwen3 的参数格式:<function=name> 后的 > 让状态从 TOOL_NAME 进入 TOOL_ARGS,</function> 结束调用。<parameter=...> 与 </parameter> 则留在 TOOL_ARGS 内部,作为参数值的边界。
迁移表里还有一组”畸形恢复”路径,来自真实回归问题(代码注释里标了 issue 58227):
TOOL_NAME状态下遇到</function>:函数名没有闭合>,直接结束调用,进入TOOL_BETWEEN;TOOL_NAME状态下遇到<tool_call>:上一个调用没闭合,又出现新的调用,先TOOL_CALL_END再TOOL_CALL_START;TOOL_NAME状态下遇到<function=:函数名没闭合又来了新函数,同上;TOOL_BETWEEN状态下遇到<tool_call>或<function=:连续调用没有外层闭合,直接开始下一个。
这些路径不是”可选的容错”,而是模型真实生成行为的产物。max_tokens 截断、训练数据里的边界样本、采样温度过高,都会让模型输出不完整信封。引擎把这些恢复动作写进迁移表,而不是散落在手写代码的 if 里,带来了一个直接好处:每一种格式的每一个边界都能用同一张表来审查和测试。
参数不是整块 JSON,而是被转换器增量重建
Qwen3 的参数原文是 <parameter=key>value</parameter>,但协议要求 function.arguments 是 JSON 字符串。_qwen3_arg_converter() 负责把原文转成 JSON:
def _qwen3_arg_converter(raw_args, partial, closed=None): params, open_param = _qwen3_parse_params(raw_args, partial, closed) if open_param is not None and open_param.group(1): params[open_param.group(1)] = _trim_wrapping_newlines(open_param.group(2)) return json.dumps(params, ensure_ascii=False)partial=True 表示流式中的原文可能还没闭合。正则 _PARAM_RE 匹配已闭合参数,_PARTIAL_PARAM_RE 匹配最后一个正在打开的参数;转换器把两者都放进字典,再用 json.dumps 重新序列化。这样每来一段参数文本,都能得到一个”截至目前的完整 JSON”。
但流式协议要的不是”完整 JSON 重发”,而是参数增量。arg_value_extender 承担这件事:它接收一段原文增量,返回该增量在 JSON 字符串里的转义形式;当遇到 </parameter> 或下一个 <parameter= 时返回 None,表示这个值的增量流结束。_param_value_extender() 的实现里有两个值得注意的细节:
window = _param_value_end_window(value)if _PARAM_VALUE_END_RE.search(text): return None...return json.dumps(text, ensure_ascii=False)[1:-1]第一,window 保留末尾可能正在形成 </parameter> 或 <parameter= 的一小段文本;如果直接把这段流给客户端,后面补齐标记时就会产生重复字符。第二,返回值用 json.dumps(text)[1:-1] 去掉外层引号,得到的是 JSON 字符串内部的转义文本——这正是 arguments 片段应该长的样子(例如原文里的换行要变成 \n,双引号要变成 \")。
_ClosedParams 是转换器的增量缓存。它记录”上一次解析到的最后一个闭合参数的位置、参数字典与参数外文本”,下一次转换时如果新原文以旧原文为前缀,就从 closed.end 继续扫描,而不是从头再跑一遍正则。流式参数往往每帧只多几个字符,如果每帧都全量解析,一个长参数会把 CPU 时间成倍放大。
三段流水线:token、词法、状态
引擎的流式路径是 StreamingParserEngine,注释里写得很清楚:
delta_text + delta_token_ids → TokenIDScanner (special token pre-lexing) → IncrementalLexer (text → terminal tokens with prefix buffering) → State Machine (terminal → semantic events) → list[SemanticEvent]TokenIDScanner:先用 token id 认标记
TokenIDScanner 接收 {token_id: terminal_name} 映射与 tokenizer。它逐个检查本帧 token id:命中映射的 token 变成 PreLexedTerminal(terminal, token_id, text),其余连续 token 合并成 TextChunk(text, token_texts, token_count)。这样,<tool_call>、</tool_call>、... 这类特殊 token 不依赖文本匹配,直接按 id 命中,既快也不会被文本里的同名子串误触发。
TokenIDScanner 处理了一个非常实际的边界:detokenizer 可能扣住文本。如果某个特殊 token 的文本还没有出现在 delta_text 里,scanner 不会立刻把它交给状态机,而是把它放进 _deferred_terminals,等后续帧的文本到达再解析;如果后续帧仍没有文本,flush_pending() 会在流结束时把扣住的 token 文本补出来。这个设计的理由是状态迁移的顺序必须与文本顺序一致。如果状态机先因为 token id 进入 TOOL_ARGS,但上一帧的思考文本还没吐出来,后面到达的文本就会被错误地归到参数里。
_recover_holdback_text() 是另一个细节:detokenizer 吐出的 delta_text 与逐 token 解码拼起来的文本可能不一致,scanner 会用 delta_text 作为权威文本,重新对齐 token 文本。TextChunk 里的 token_texts 与 token_count 分开保存,是为了让词法器既能按字符匹配终结点,又能按 token 统计推理 token 数。
IncrementalLexer:前缀缓冲
IncrementalLexer 维护一个 buffer。当 buffer 是某个终结点的前缀时,它不立即输出,而是等下一帧:
if self.buffer in prefix_set and not final: if best_match is not None: longer_match = any( len(lit) > best_match[2] and lit.startswith(self.buffer) ... ) if not longer_match: emit best_match break else: break这就是”前缀缓冲”:<tool_ 可能是 <tool_call> 的前缀,不能把它当普通文本发出去;等到下一帧补齐成 <tool_call>,才发出终结点;如果下一帧变成 <tool_x,说明它不是终结点,缓冲的文本会作为 CONTENT 输出。没有这层缓冲,每个被拆开的标记都会泄漏成用户可见的文本。
词法器对文本内容的快速路径也值得注意:
if not self.buffer and self._has_only_literals and self._literal_first_chars: for ch in text: if ch in self._literal_first_chars: break else: return [LexToken(self.content_terminal, text, sum(char_token_counts))]如果整段文本里没有任何终结点的首字符,直接整段返回为内容,跳过逐字符扫描。在线推理里,大多数 delta 都是普通文本,这个快路径决定了 parser 的 CPU 开销不会随吞吐线性膨胀。
状态机:未知终结点按当前状态归类
_on_terminal() 先查 (state, terminal) 迁移。查不到时,它不是报错,而是按当前状态的 content_events 把终结点文本当作内容发出。这处理的是”当前状态下出现了不该出现的标记”——例如 CONTENT 状态下又出现一个 ...。Qwen3 配置里特意把 CONTENT + THINK_END 映射为空迁移,就是为了静默吸收模型重复输出的 </think>。
引擎还有两个”投影”标志。skip_reasoning_parsing 让推理阶段把所有工具标记当作内容,用于 reasoning adapter 单独跑推理切分时不让工具阶段抢走文本;skip_tool_parsing 则相反,让工具阶段把工具标记当内容,用于 tool adapter 单独跑工具解析时保留推理文本。两个标志都只在特定组合路径里使用,避免两套 parser 互相吞掉对方的标记。
参数 JSON 的安全水位
当 tool_args_json=True 时,参数文本不是直接转发,而是经过 _feed_args_text() 逐字符处理。它维护四个状态:花括号深度 _args_brace_depth、是否在字符串内 _args_in_string、是否刚遇到转义符 _args_escape_next、以及安全水位 _args_safe_end。每来一个字符,先追加到 _args_buffer,再决定安全水位:
if ch in ("}", "]"): if self._args_brace_depth > 0: self._args_brace_depth -= 1 if self._args_brace_depth == 0: return [] self._args_safe_end = len(self._args_buffer) return self._flush_safe_args()顶层 } 或 ] 出现时,安全水位不前进,字符被扣在 buffer 里。原因是流式 JSON 的顶层闭合括号可能不是最终形态:如果模型后面还要追加一个字段,提前把 } 发出去,客户端会先收一个”完整 JSON”,随后又收到 ,"x":1},拼接后就是非法 JSON。只有等到下一个非空白字符或流结束,才能确认这个闭合括号是真的。
_flush_safe_args() 只发出 buffer[:safe_end],把不安全的后缀留在 buffer。这样每个 ARG_VALUE_CHUNK 都是”可安全拼接的前缀”,客户端可以边收边做流式 JSON 解析,而不是等到最后一次性拼。
finish():流末的三件事
StreamingParserEngine.finish() 做三件事:先 flush scanner 的 deferred terminals 与词法器 buffer;再把 _args_buffer 里被扣住的参数作为最后一个 ARG_VALUE_CHUNK 发出;最后根据当前状态收尾:
- 如果还在
TOOL_PREAMBLE、TOOL_ARGS、TOOL_NAME、TOOL_BETWEEN,发出TOOL_CALL_END,把状态切回CONTENT; - 如果还在
REASONING,发出REASONING_END; - 如果还在
MESSAGE_HEADER,把缓存的 header 文本作为TEXT_CHUNK发出。
这三件事分别对应三种截断:工具调用被截断、思考被截断、消息头被截断。流末的收尾不是为了”补全”,而是为了让协议字段闭合:客户端必须知道”这条调用已经结束”,哪怕它的参数并不完整。
适配器:把引擎塞回旧接口
引擎的接口是 feed()/finish() 返回 SemanticEvent,但服务层用的是 ReasoningParser 与 ToolParser 的方法。vllm/parser/engine/adapters.py 用两个适配器把两者接起来:
class ParserEngineReasoningAdapter(ReasoningParser): engine_based_streaming: bool = True
def extract_reasoning_streaming(...): with self._skip_tool_parsing(): return self._parser_engine.extract_reasoning_streaming(...)
def finish_streaming(self): with self._skip_tool_parsing(): return self._parser_engine.finish_streaming()_skip_tool_parsing() 是一个上下文管理器,临时把引擎的 skip_tool_parsing 置真,让推理适配器只关心思考段。engine_based_streaming=True 告诉上层 Parser:“这个 parser 的内部状态由引擎管理,不需要你替它维护 previous/current 文本。” has_engine_confirmed_reasoning_end() 返回引擎的 reasoning_ended,而不是重新扫描 token——因为引擎在处理标记时已经知道迁移是否发生,重复扫描反而会与 detokenizer 的延迟不一致。
工具适配器同理,只是它用 skip_reasoning_parsing 屏蔽推理标记。两个适配器的存在,让引擎可以逐步替换手写 parser:同一个 Parser 组合里可以一个用引擎、一个用 legacy,Parser 会按 engine_based 选择自己的状态推进方式。
DelegatingParser:一次 delta 的完整时序
有了 reasoning parser 与 tool parser,还需要一个把它们串起来的人。DelegatingParser 继承 Parser,是 ParserManager._compose_parser() 在没有特殊统一格式时返回的默认组合类。它持有两个实例 _reasoning_parser 与 _tool_parser,并用一个 StreamState 记录每个流的状态:
@dataclassclass StreamState: reasoning_ended: bool = False tool_call_text_started: bool = False prompt_reasoning_checked: bool = False previous_text: str = "" previous_token_ids: list[int] = field(default_factory=list) history_tool_call_cnt: int = 0 history_tool_call_cnt_initialized: bool = False tool_call_id_type: str = "random" function_name_returned: bool = False engine_based: bool = Falseadvance() 与 commit() 是两套状态推进方式的开关。legacy parser 需要 previous_text + delta_text 的拼接视图,所以 advance() 返回拼接后的文本,commit() 把 current 存成下一帧的 previous;engine-based parser 自己维护缓冲,advance() 直接返回 delta,commit() 清空 previous,避免上层重复累积。这个差异看起来只是实现细节,实际上决定了 extract_reasoning_streaming() 的入参语义:对 legacy parser,previous_text 是”本流到目前为止的全部文本”;对引擎适配器,previous_text 永远是空串。
Parser.__init__ 里还有一个组合级的判断:
self._engine_based = ( self._reasoning_parser is None or self._reasoning_parser.engine_based_streaming) and (self._tool_parser is None or self._tool_parser.engine_based_streaming)只有两个 parser 都是 engine-based 时,组合才按 engine-based 路径走。原因很实际:如果 reasoning 用引擎、tool 用 legacy,那么工具阶段的 legacy parser 仍然需要累积文本;如果组合整体被判定为 engine-based,previous_text 会被清空,legacy tool parser 就会拿到不完整的上下文。混合组合必须退回到 legacy 的状态推进方式,让引擎适配器自己忽略多余的前缀。
parse_delta 的八个阶段
DelegatingParser.parse_delta() 是整条链路的核心。它的输入是一帧的 delta_text、delta_token_ids、请求对象、可选的 prompt_token_ids,以及 finished 标志。按执行顺序可以拆成八个阶段。
第一阶段:初始化流状态。 首次调用时,如果拿到了 prompt_token_ids,会做一次”prompt 是否已经在思考段”的检查:
if not state.prompt_reasoning_checked and prompt_token_ids is not None: state.prompt_reasoning_checked = True self.set_prompt_token_ids(prompt_token_ids) if self._reasoning_parser is None or self.is_reasoning_end(prompt_token_ids): state.reasoning_ended = True else: self._reasoning_parser.adjust_initial_state_from_prompt(prompt_token_ids)如果 prompt 里已经包含 ...(例如 continue_final_message 把用户消息续写进思考段),reasoning_ended 初始为假,第一个生成 token 会进入思考通道;如果 prompt 已闭合思考,reasoning_ended 初始为真,第一个 token 就是内容或工具调用。没有拿到 prompt ids 时,默认从”未结束”开始,由流中的标记来切换。
第二阶段:推进当前文本。 state.advance() 按 engine/legacy 返回不同的 current/previous 视图。
第三阶段:推理通道。 如果 _in_reasoning_phase(state) 为真(有 reasoning parser 且 reasoning_ended 仍为假),调用 extract_reasoning_streaming():
delta_message = self.extract_reasoning_streaming( previous_text=state.previous_text, current_text=current_text, delta_text=delta_text, previous_token_ids=state.previous_token_ids, current_token_ids=current_token_ids, delta_token_ids=delta_token_ids,)这段调用返回的 DeltaMessage 只可能带 reasoning、content 或两者都有,带工具调用是不合法的。
第四阶段:判断是否切换。 对 engine-based reasoning parser,切换条件由引擎确认:has_engine_confirmed_reasoning_end()。对 legacy parser,调用 _is_reasoning_end_streaming(current_token_ids, delta_token_ids)。这一步与第三阶段的顺序不能颠倒:必须先让 reasoning parser 处理完这一帧,再判断是否切换;如果先切换,这一帧里”思考尾巴 + 回答开头”的文本就会被整个送到工具阶段,思考尾巴会丢失。
切换发生时,DelegatingParser 做四件事:
state.reasoning_ended = Truereasoning_transitioned = Truecurrent_token_ids = self._extract_content_ids(delta_token_ids)flush_delta = ( reasoning_parser.finish_streaming() if reasoning_parser is not None and reasoning_parser.engine_based_streaming else None)current_text = ( (delta_message.content if delta_message else None) or "") + ((flush_delta.content if flush_delta else None) or "")第一,翻状态位;第二,用 reasoning parser 的 extract_content_ids(delta_token_ids) 取”end 标记之后的 token id”,这个结果会作为工具阶段的 token 上下文;第三,对 engine-based parser 调用 finish_streaming(),把引擎在思考态里扣住的文本(例如 ... 结束标记后已经出现的 <)冲出来;第四,把这些内容拼成 current_text,作为下一阶段的输入。
这里有一个容易写错的点:current_text 只取 delta_message.content 与 flush_delta.content,不取 delta_message.reasoning。原因在于工具阶段只关心”内容与工具标记”,思考尾巴已经在上一阶段作为 reasoning 发出,不能再拼进工具输入,否则工具参数会混入思考文本。
第五阶段:准备工具阶段。 如果是 engine-based 组合且有工具 parser,切换帧的 content 被清空,交给工具阶段重新分类:
if self._engine_based: if self._tool_parser is not None: if delta_message: delta_message.content = None elif current_text: ...如果只有 reasoning parser 没有工具 parser(例如纯推理模型),flush 出来的 content 没有下一段来消费,于是直接作为 content 发出去,避免文本丢失。对 legacy 组合,delta_text = current_text,让工具 parser 从”本帧已有的内容”开始重新扫描。
第六阶段:工具通道。 如果 _in_tool_call_phase(state) 为真(有 tool parser 且 reasoning_ended 为真),首次进入时把 tool_call_text_started 置真并清空 previous:
if not state.tool_call_text_started: state.tool_call_text_started = True state.previous_text = "" state.previous_token_ids = [] delta_text = current_text delta_token_ids = current_token_ids这个清空非常关键。工具 parser 的 previous_text 如果还包含完整的思考内容,它的正则会在思考文本里找到”看起来像工具调用”的片段,产生误报;清空后,工具 parser 只看到切换到工具阶段之后的文本。
随后调用 _extract_tool_calls_streaming(),把返回的 DeltaMessage 里的 function_name_returned 存回状态,并把本帧的 reasoning 尾巴合并回去:
reasoning_from_this_batch = delta_message.reasoning if delta_message else None...if reasoning_from_this_batch: if delta_message is None: delta_message = DeltaMessage(reasoning=reasoning_from_this_batch) elif not delta_message.reasoning: delta_message.reasoning = reasoning_from_this_batch为什么需要合并?因为在切换帧里,reasoning parser 返回的 DeltaMessage 同时带 reasoning 和 content;content 被交给工具阶段,工具阶段可能返回一个新的 DeltaMessage(只带工具字段)。如果把整个 delta_message 覆盖掉,reasoning 尾巴就丢了。合并逻辑保证一帧里”思考尾巴 + 工具开始”能同时到达客户端。
工具调用计数也在这里更新。history_tool_call_cnt 初始值由 _initialize_history_tool_call_cnt() 从请求消息历史里统计(仅 kimi_k2 需要),工具 ID 生成依赖这个计数;每帧新增的调用则按 tc.id is not None 计数,兼容一个 delta 同时完成多个调用的 required 路径。
第七阶段:无阶段直通。 如果三个条件都满足——没有产生 delta_message、本帧没有发生推理切换、当前既不在推理阶段也不在工具阶段——则把整段 delta 作为 content 发出。这个分支处理的是”没有配 reasoning parser、也没有进入工具阶段”的普通文本流。
第八阶段:流末收尾与抑制。 如果 finished 为真,先 finalize_generation():
fallback_fn = getattr(self._reasoning_parser, "get_streaming_fallback_content", None)if fallback_fn is not None and not state.reasoning_ended: promoted = fallback_fn(state.previous_text, request) if promoted: delta_message.content = (delta_message.content or "") + promotedself._append_unstreamed_tool_args(delta_message)get_streaming_fallback_content() 是部分 reasoning parser 的可选能力:当流在思考中途结束时,parser 可以决定把某一段思考”提升”为 content。默认不实现,所以大多数模型在 max_tokens 截断时 content 为空。_append_unstreamed_tool_args() 则用 get_remaining_unstreamed_args() 把工具参数补齐。
最后是 include_reasoning 抑制:
if delta_message and not request.include_reasoning: delta_message.reasoning = None if not delta_message.content and not delta_message.tool_calls: delta_message = None注意这里的顺序:先清 reasoning,再判断”如果只剩 reasoning,就整帧不发”。如果先判断再清,就会把一整帧空消息发给客户端。ChatStreamProcessor 在此基础上还会隐藏 logprobs 与 token_ids,两层共同保证思考内容不会从任何字段泄漏。
非流式 parse:先推理,再工具
非流式路径简单得多:
def parse(self, model_output, request, enable_auto_tools=False, model_output_token_ids=()): self._initialize_history_tool_call_cnt(request) reasoning, content = self.extract_reasoning(model_output, request) tool_calls, content = self._extract_tool_calls( content=content, request=request, enable_auto_tools=enable_auto_tools ) return reasoning, content, tool_calls顺序是先切思考、再解析工具,因为工具解析只在 content 上进行。没有 reasoning parser 时,extract_reasoning() 返回 (None, model_output),工具 parser 拿到整段输出,这对应”纯工具模型”(如 Hermes)的情况。工具解析后,content 可能被置 None(整段都是工具调用),也可能保留工具调用之外的文本。
model_output_token_ids 参数在这一层没有被使用,但会被子类或上层用来做 token 级统计。ChatStreamProcessor 在非流式路径里另用 parser.count_reasoning_tokens(token_ids) 计算 usage。
阶段表
把上面的流程压缩成一张表,能更直观地看出每个字段在哪个阶段产生:
| 阶段 | 触发条件 | 输入 | 输出 | 关键副作用 |
|---|---|---|---|---|
| 推理 | 有 reasoning parser 且未结束 | previous/current/delta 文本与 ids | reasoning / content | 不翻转状态 |
| 切换 | end 标记出现在本帧 | delta ids | content + flush content | reasoning_ended=True |
| 工具准备 | 切换帧且有 tool parser | 切换帧 content | 清空 content | previous 文本复位 |
| 工具 | 已结束且有 tool parser | 工具阶段文本 | tool_calls / content | 调用计数更新 |
| 直通 | 无 parser 或阶段外 | delta | content | 无 |
| 流末 | finished=True | 状态 | fallback / 补差 | 关闭字段 |
| 抑制 | include_reasoning=False | delta | 去掉 reasoning | 空帧不发 |
结构化输出与工具调用的联动
解析器与约束解码之间有一层容易被忽视的接口:resolve_reasoning_ended()。
def resolve_reasoning_ended(self, parser, prompt_token_ids) -> bool | None: if not self.include_reasoning: return True if self._grammar_from_parser: return True if parser is not None and parser.reasoning_parser is not None: return parser.is_reasoning_end(prompt_token_ids) return None这个返回值的语义是”引擎从哪个 token 开始施加结构化语法”。True 表示从第一个生成 token 就开始;None 表示让引擎用自己那一侧的 reasoning parser 检查 prompt 后再决定。parser.is_reasoning_end(prompt_token_ids) 在 prompt 已闭合思考时返回真,prompt 仍在思考中时返回假,于是结构化输出不会在 ... 里面强制模型输出 JSON。
这个判断与解析器本身的 is_reasoning_end() 是同一套 token 视图。区别在于调用位置:解析器在 API 进程里,结构化输出引擎在 EngineCore 里。为了不把 Python parser 对象跨 ZMQ 传过去,_engine_reasoning_kwargs() 只传 chat_template_kwargs:
reasoning_parser_kwargs = { "chat_template_kwargs": self._engine_chat_template_kwargs(chat_template_kwargs),}EngineCore 侧用同样名字的 parser 类重新构造一个实例,读取同一份 chat_template_kwargs(例如 thinking、enable_thinking),从而保证两侧对”这个请求是否思考”的判断一致。如果两侧判断不一致,就会出现最坏的情况:API 侧把输出当思考解析,引擎侧却从第一个 token 就施加 JSON 语法,模型被强行在 ... 里输出 JSON。
parser.adjust_request() 与结构标签的关系前文已经讲过,这里补一个顺序问题。resolve_reasoning_ended() 的注释明确要求”在 adjust_request 之后调用”,因为 adjust_request 可能设置 _grammar_from_parser。Mistral 一类模型的语法里已经包含可选的 think? 规则,不需要再按 prompt 判断思考是否开始;如果先算 reasoning_ended 再调整语法,就会重复施加约束。
prepare_structured_tag() 是另一个联动钩子。它接收原始的 structured tag 与可选的 ToolServer,允许 parser 按模型格式替换标记。例如某些模型用 <tool_call> 而非标准 JSON 信封,结构标签需要把工具的 Schema 嵌进模型的标记里,这个转换必须由了解该模型格式的 parser 完成。
工具调用的约束还有一层”信封与参数分离”的语义。文档把结构标签约束分成两层:工具调用的信封(标记与函数名)在 required 与命名调用中总是被约束;auto 下只有当至少一个工具标了 strict: true 或服务端抬高了下限时才约束。单个工具的参数 Schema 只在该工具标了 strict: true(或 --tool-strict-level parameter)时锁定。这解释了为什么同一个请求里”一个工具 strict、另一个不 strict”时,模型可能对第一个工具输出严格 JSON、对第二个输出宽松 JSON——解析器必须两者都能接住。
VLLM_ENFORCE_STRICT_TOOL_CALLING=false 会整体关闭结构标签,但不会影响命名调用与 required 走的标准结构化输出。这个区分很重要:前者约束的是”模型原生标记格式”,后者约束的是”JSON 输出”,两条路径在 parser 里也分别对应第 4 条与第 3 条工具选择路径。
流式解析的边界与常见故障
解析器的正确性很难靠”端到端跑一遍”验证,因为大多数边界只在特定分块位置出现。下面这些故障模式,基本覆盖了线上会遇到的绝大部分问题。
标记被拆成多帧。 ... 可能拆成 </thi 与 nk>,<tool_call> 可能拆成 <tool_ 与 call>。文本匹配的 parser 如果每帧独立找标记,就会漏掉;engine-based parser 靠 IncrementalLexer 的前缀缓冲接住。legacy parser 靠 previous_text + delta_text 的拼接视图接住,但它必须保证 previous_text 是本流全部文本,而不是上一帧 delta——StreamState.commit() 存的正是 current_text。
detokenizer 扣住文本。 解码器为避免半个 UTF-8 字符或字节级 BPE 的边界问题,会延迟输出末尾字节。于是某一帧的 delta_token_ids 里已经有 end token,但 delta_text 还没包含 </think>。纯文本 parser 会以为这一帧没有标记;engine-based parser 的 TokenIDScanner 会把特殊 token 先识别出来,文本没到就 defer,等文本到达再迁移。has_engine_confirmed_reasoning_end() 用引擎的已处理状态而不是 token id 检查,正是为了避免”token 已到、文本未到”时提前切换。
模型不输出起始标记。 R1 蒸馏版常见。基类会把整段思考当 content;DeepSeekR1ReasoningParser 的覆盖分支把它归到 reasoning。判断依据是”是否有 end 标记”:有 end 但没有 start,说明模型从思考开始写;有 start 但没 end,说明思考被截断。
重复的 end 标记。 模型可能输出 ... ...。Qwen3 配置把 CONTENT + THINK_END 映射成空迁移,基类解析器则把重复 end 当作普通文本。两者都能工作,但语义不同:前者静默吸收,后者让重复标记出现在 content 里。生产上更希望前者。
工具参数 JSON 不完整。 流式参数每帧都可能停在字符串中间或嵌套对象里。engine-based parser 用安全水位扣住顶层闭合括号;legacy parser 通常在结束时用 get_remaining_unstreamed_args() 补齐。客户端如果对每个 arguments 片段直接 json.loads,在流结束前必然失败;正确做法是累积片段,或在流末再解析。
max_tokens 截断。 截断可能发生在思考中、工具信封里或参数 JSON 里。finish() 会关闭已打开的工具调用,finalize_generation() 会调用 reasoning parser 的可选 fallback。非流式路径下,engine-based tool parser 会丢弃不完整的工具标记,legacy parser 会保留原文。这里没有”绝对正确”的答案,只有”与协议一致”的选择:tool_calls 字段里不应该出现无法解析的 JSON。
并行工具调用。 某个 delta 可能同时完成多个调用。parse_delta() 用 sum(tc.id is not None for tc in delta_message.tool_calls) 更新计数,而不是只加一;maybe_filter_parallel_tool_calls() 在服务层再做一次裁剪。如果 parser 只按 current_tool_id += 1 记账,并行调用会把后续调用的 index 算错。
stop string 与标记重叠。 用户设置的 stop string 可能与模型标记共享前缀(例如 stop 里包含 <)。停止判定发生在采样侧,解析器只收到被截断后的文本。engine-based parser 的 flush_pending() 会在 finished 时把被扣住的半个标记作为文本吐出,避免文本丢失;但这也意味着用户可能看到半个 <tool_ca。是否要过滤这类残留,取决于产品语义,vLLM 选择保留原文而不是猜测。
logprobs 与 token_ids 泄漏。 前面已经讲过 hide_metadata。还有一个容易忽略的点:如果客户端显式请求 return_token_ids,而 parser 没有配置,思考 token 会通过 token_ids 字段直接暴露。ChatStreamProcessor 只在 include_reasoning=false 时隐藏,因此服务端要么确保配置了 reasoning parser,要么在网关层做字段裁剪。
思考开关按请求变化。 同一个 parser 类在不同请求下可能走不同分支(deepseek_v3 的 thinking 委托)。如果 parser 实例在多个请求之间复用,StreamState 必须按请求重置;Parser 的注释明确”每个请求一个实例”,服务层也是按请求构造。复用实例会把上一个请求的 reasoning_ended 带到下一个请求,导致第一个 token 就被当成内容。
性能账:解析器在关键路径上的成本
解析器运行在 API 进程的 CPU 线程里,与 GPU 前向是异步的。它的成本主要来自四块:逐字符词法扫描、JSON 参数转换、状态机迁移和文本拼接。engine-based 路径用三个手段把成本压住:
IncrementalLexer的”无终结点首字符”快路径,让普通文本整段通过;TokenIDScanner按 token id 直接命中特殊标记,避免正则扫描;- 参数转换用
_ClosedParams缓存已闭合参数,避免每帧从头解析。
legacy 路径的典型成本是每帧对 previous_text 做正则匹配;当思考文本很长时,正则的匹配范围会随帧数线性增长。engine-based parser 的状态机只处理当前 delta,不随历史增长。这也是 vLLM 逐步把新模型 parser 迁到引擎格式的直接原因:在线服务里,解析器的复杂度必须与”本帧”成正比,而不是与”整条输出”成正比。
但引擎路径也不是零成本。每个 delta 都要经过 scanner、lexer、状态机三层;如果 delta 很小(例如投机解码下每帧只有 1 个 token),三层调用本身的开销就会显现。StreamingParserEngine.feed() 为此写了快路径:如果 delta 没有任何特殊 token 的 id、lexer buffer 为空、且文本里没有终结点首字符,直接按当前状态发出内容事件,跳过 scanner 与 lexer。这个快路径在 decode 阶段命中率很高。
配置与选型:让解析器与模型格式对齐
vLLM 把 parser 的选择做成两个启动参数:
vllm serve <model> \ --reasoning-parser qwen3 \ --enable-auto-tool-choice \ --tool-call-parser hermes--reasoning-parser 决定思考段如何切分,--tool-call-parser 决定工具调用如何解析,--enable-auto-tool-choice 才允许 tool_choice="auto"。三者缺一不可:只配 reasoning parser,工具调用会被当成内容;只配 tool parser,思考内容会混进工具参数;配了 tool parser 但没开 auto tools,auto 请求的工具调用不会被解析。
选择 parser 的原则不是”按模型名猜”,而是按 chat template 的实际标记选。官方文档给出了模型系列与 parser 名的对照表,例如 DeepSeek-R1 系列用 deepseek_r1,Qwen3 系列用 qwen3,GLM-4.5 用 glm45,GLM-4.7 用 glm47,Granite 3.2 用 granite,Granite 4.2 用 granite_thinking_parser。同一个模型的不同微调版本可能用不同模板,应以 tokenizer_config.json 里的 chat_template 为准:
- 模板里有
...:需要 reasoning parser; - 模板里有
<tool_call><function=...>:需要能识别该格式的 tool parser(如qwen3的内置引擎格式或对应的 legacy parser); - 模板里是 Hermes 的
<tool_call>{"name":...}</tool_call>:用hermes; - 模板里是 Llama 3.1 的
<|python_tag|>:用llama3_json或pythonic。
工具调用的严格程度由 --tool-strict-level 控制,默认值因 parser 而异:glm47 默认 function,其他 parser 默认 auto。如果客户端普遍不写 strict,服务端可以显式抬高到 function,让信封被约束,至少保证工具标记本身不会畸形;代价是首次请求多一次语法编译。
调试时最有用的是”分块重放”:把一段完整的模型输出,按所有可能的切分位置切成两帧或多帧,喂给 parser,检查拼接后的 reasoning + content 是否与原始文本一致,工具参数 JSON 是否在每一帧都可安全拼接。这个测试能覆盖前缀缓冲、detokenizer 扣字、切换帧合并的大部分边界,比端到端请求更便宜也更可重复。
站内已经拆过 vLLM 的采样与输出侧:vLLM 源码完全拆解(九):Sampler——从 Logits 到 Token 的采样管线与输出回传 讲了 logits 如何变成 token;vLLM 源码完全拆解(十五):停止条件与增量解码 讲了 token 如何变成 delta_text。解析器正好接在这两者之后:它拿到 delta_text 与 delta_token_ids,决定这段增量属于哪个协议字段。把三篇连起来看,一条 token 的完整旅程才算闭环。结构化输出一侧可参考 vLLM 源码完全拆解(二十八):结构化输出的语法约束;投机解码下的解析器回滚可参考 vLLM 源码完全拆解(十):投机解码。llama.cpp 侧对同一问题的另一种解法,可参考 llama.cpp 源码完全拆解(二十七):工具调用的反向解析。
小结
vLLM 的推理内容解析器不是一段字符串补丁,而是推理模型输出格式与 OpenAI 协议之间的适配层。它做了三次分离:
- 格式与协议分离。 模型可以输出
<tool_call>、Hermes JSON、<function=...>等任意格式,协议只认content、reasoning、tool_calls。parser 层把格式知识收拢在各自 parser 与ParserEngineConfig里,协议层只处理DeltaMessage。 - 文本视图与 token 视图分离。 文本视图负责切分用户可见的内容;token 视图负责思考结束判定、结构化输出起点与 usage 统计。
TokenIDScanner与BaseThinkingReasoningParser的 token id 方法都是这条分离的体现。 - 推理阶段与工具阶段分离。
StreamState.reasoning_ended是一道闸门:闸门之前只允许 reasoning parser 消费文本,闸门之后只允许 tool parser 消费文本;切换帧的合并逻辑保证同一帧里两段文本都不会丢。
ParserEngine 把这套分离进一步抽象成”终结点 + 迁移表 + 事件”的数据结构。手写 parser 的天花板来自每个模型都要重复处理相同的边界;引擎把边界处理集中到 TokenIDScanner、IncrementalLexer、安全水位与 finish() 四处,模型差异只剩一张迁移表和几个转换函数。代价是配置本身变复杂,需要维护终结点拼写、token id 映射与畸形恢复路径;收益是新增模型时不必再写一套状态机,且每个格式的边界都能被同一套测试覆盖。
真正的工程难点不在”找到标记”,而在”标记被拆开、文本被扣住、JSON 不完整、请求中途停止”时仍让三个协议字段保持一致。理解 parse_delta() 的八个阶段、finish() 的三种收尾与 hide_metadata 的两层抑制,就能在线上定位绝大多数”思考内容混进回答""工具参数少一段""finish_reason 不对”的问题。
参考资料
- vLLM 官方仓库
- ReasoningParser 抽象接口与注册表
- BaseThinkingReasoningParser 源码
- Parser 与 DelegatingParser 源码
- ParserEngineConfig 声明式配置
- StreamingParserEngine 流式引擎
- IncrementalLexer 前缀缓冲实现
- Qwen3 ParserEngine 配置
- ToolParser 抽象接口
- ChatStreamProcessor 流式处理器
- vLLM Reasoning Outputs 文档
- vLLM Tool Calling 文档
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- Qwen3 Technical Report
- ReAct: Synergizing Reasoning and Acting in Language Models
- ToolACE: Winning the Points of LLM Function Calling
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



