


llama.cpp 源码完全拆解(十二):对话模板与消息解析——minja 如何渲染、差分解析器如何学会一套未知模板
在 llama.cpp 里,一条聊天请求真正进入模型之前,会先被翻译两次:先把 OpenAI 风格的 messages 数组翻译成一段带特殊 token 的纯文本,再把这段文本切成一串 llama_token。等模型吐出 token,这套流程还要反向走一遍:把 token 流重新解析成 content、reasoning_content 和 tool_calls,最后包装成 OpenAI 兼容的 JSON。
负责这两次翻译的是 common/chat.h 与 common/chat.cpp。它不属于任何后端,也不参与矩阵乘;但模型见过的训练格式、特殊 token 的边界、工具调用的语法、思考标签的位置,全都由这一层决定。模板写错一个空格,模型的行为就可能从“会调用工具”退化成“把工具名当正文复述”。
本文以 llama.cpp 为主线,把这一层拆开:模板从哪里来、minja 如何执行 Jinja、渲染结果为什么要保留输入边界、自动解析器如何在不知道模板语义的情况下反推出格式,以及模板能力如何接进采样器。最后横向对照 vLLM、SGLang、TensorRT-LLM、DeepInfer 在同一层的不同选择。
从 completions 到 chat:模板是推理框架的输入编译器
最原始的推理接口是 completion:给一段文本,模型接着往下写。聊天接口把这件事包装成结构化消息,客户端只负责给出角色和内容,服务端负责把消息拼成模型认识的样子。
以 ChatML 为例,一个最小的模板大致是:
{% for message in messages %}{{ '<|im_start|>' + message['role'] + '\n' + message['content'] + '<|im_end|>' + '\n' }}{% endfor %}{% if add_generation_prompt %}{{ '<|im_start|>assistant\n' }}{% endif %}messages = [{"role":"system","content":"你是助手"},{"role":"user","content":"你好"}] 渲染出来是:
<|im_start|>system你是助手<|im_end|><|im_start|>user你好<|im_end|><|im_start|>assistant这段文本里混着两类东西:普通文字,以及 <|im_start|>、<|im_end|> 这样的特殊 token。分词器遇到后者时,不应该按字符切,而应该直接映射到词表里预留的 token id。模型在预训练和对齐阶段见到的就是这种边界,所以推理时必须原样复现。
这就是对话模板的全部职责,但真正麻烦的地方在于“每一家模型都不一样”:
- 角色集合不同。有的只有
system/user/assistant,有的引入developer,有的工具消息用tool,有的把工具结果塞进user。 - 工具调用语法不同。有 JSON 对象、XML 标签、
[TOOL_CALLS]这种自定义段,也有<|tool_call_begin|>functions.foo:0<|tool_call_argument_begin|>这类特殊 token 序列。 - 思考内容不同。DeepSeek 风格用
reasoning_content字段,Qwen 风格把思考...直接写进content,还有一些模板只在工具调用前允许思考。 - 生成提示不同。模板结尾到底补不补
assistant角色头、补什么标记,由模板自己决定。
推理框架如果只支持一种格式,就等于只支持一种模型。llama.cpp 的解法是:把模板当成模型文件的一部分,交给一个嵌入式 Jinja 引擎执行;再用一套“从模板本身反推解析器”的机制,把模型输出读回结构化消息。
数据结构:一条消息到底装了什么
在进入模板之前,llama.cpp 先把 HTTP JSON 归一化成 C++ 结构体。common_chat_msg 的字段很能说明这一层要兼容多少东西:
struct common_chat_msg { std::string role; std::string content; std::vector<common_chat_msg_content_part> content_parts; std::vector<common_chat_tool_call> tool_calls; std::string reasoning_content; std::string tool_name; std::string tool_call_id; std::string extra_json;};content_parts 是为多模态和分段文本准备的,每个 part 有 type、text、name。tool_calls 里的每个调用由 name、arguments、id 组成,arguments 在 C++ 里是字符串,因为 OpenAI 协议本来就把它编码成 JSON 字符串;模板是否希望拿到对象,则是另一回事。reasoning_content 不是 OpenAI 官方字段,但 DeepSeek-R1 之后它成了事实标准,llama.cpp 必须单独保留。extra_json 则留给那些会读取非标准键的模板,源码注释里点名了 DeepSeek V4.1。
反方向的转换由 common_chat_msgs_to_json_oaicompat() 完成。它把结构体变回模板能读的 JSON:role、content,有工具调用时加 tool_calls,有思考内容时加 reasoning_content。这一步看似只是序列化,实际上决定了模板能看到什么。模板里写的 message['tool_calls'][0]['function']['arguments'] 能不能取到值,取决于这里有没有把字段摆成 OpenAI 的形状。
render_content() 负责把 content_parts 拼成一段文本,默认分隔符是两个换行。多模态模型里常见的 media_marker 也在这层处理:图像并不进入模板,模板只看到一个占位标记,真正的嵌入在模型执行器里回填。
模板从哪来:GGUF 元数据、tool_use 与 ChatML 兜底
common_chat_templates_init() 是模板层的入口。它的查找顺序值得逐条看:
- 如果调用方显式传入了模板字符串,就用它。
- 否则从模型元数据里取
tokenizer.chat_template。 - 再尝试取名为
tool_use的模板,对应 GGUF 里的tokenizer.chat_template.tool_use。 - 如果默认模板为空,或者字面值等于
"chatml",就使用tool_use模板;两者都没有时,回退到内置的CHATML_TEMPLATE_SRC。
第 4 条里的 "chatml" 是一个约定:调用方可以用这个名字请求内置 ChatML,而不是让引擎去解析一个叫 chatml 的模板。这个兜底让一个没有模板元数据的旧模型也能提供聊天接口,但代价是格式可能与模型训练时不一致。对指令微调模型来说,格式错位的退化往往不是“完全不能用”,而是“看起来能用,但工具调用和停止符都不对”,更难排查。
模板取到之后,构造函数做三件事:
jinja::lexer lexer;auto lexer_res = lexer.tokenize(src);this->prog = jinja::parse_from_tokens(lexer_res);this->caps = jinja::caps_get(prog);this->params_init = common_chat_template_detect_params_init(this->src);第一件是把模板源码编译成 jinja::program。第二件是静态分析模板用到了哪些能力,得到 jinja::caps。第三件是按模板源码的特征匹配一个专用解析器;匹配不到时,才在初始化阶段跑一次差分分析,构造通用的自动解析器。
caps 的字段包括 supports_tools、supports_tool_calls、supports_system_role、supports_parallel_tool_calls、supports_preserve_reasoning、supports_reasoning_effort、supports_string_content、supports_typed_content、supports_object_arguments。这些值不是猜的,而是从模板程序里扫出来的:模板有没有读 tools、有没有读 message['tool_calls']、有没有判断 message['role'] == 'system'、有没有处理数组形式的 content。服务端把这份能力表挂在 /props 里,客户端就能知道当前模型支不支持并行工具调用、支不支持把历史思考内容保留下来。
这里有一个容易被忽略的设计:模板初始化阶段就把“能力探测”和“解析器分析”做完了。请求到来时只做渲染和解析,不再重新分析模板。对高并发服务来说,这是把一次性成本挪出热路径。
模板不兼容时的补丁
真实世界的模板并不总是能被一个精简的 Jinja 实现直接跑通。common_chat_templates_init() 里有两段带注释的字符串替换,专门处理已知模板:
- GPT-OSS 模板里有一段
{%- if "<|channel|>analysis<|message|>" in message.content or ... %},llama.cpp 会把它替换成{%- if false %}。 - 某些使用
[TOOL_CALLS]的模板里有一段对message['content'] is none or ...的判断,也会被替换成{%- if false %}。
源码把这两处称为临时 hack,理由是“防止模板抛错”,并附了对应的 PR 讨论链接。它不是在对模型语义做裁剪,而是在 minja 尚未覆盖某些表达式写法时,让模板至少能完成初始化。读到这类代码时应该记住:模板引擎的能力边界会直接变成框架的兼容性负担;每多支持一种 Jinja 语法,就少一处硬编码补丁。
minja:为什么在 C++ 里重写一个 Jinja
llama.cpp 没有嵌入 Python,也没有调用 Hugging Face 的 tokenizer。它把模板执行器放在 common/jinja/,通常被称为 minja。目录里有 lexer.cpp、parser.cpp、runtime.cpp、value.cpp、caps.cpp,对应词法分析、语法树、运行时、值模型和能力分析。
这个选择的原因不难理解:
- 部署形态。llama.cpp 的目标是一个可静态链接的 C++ 推理库,服务端、命令行、移动端都可能跑。引入 Python 运行时会把部署复杂度抬一个数量级。
- 模板是模型文件的一部分。GGUF 里带模板字符串,加载模型时就应该能直接渲染,不需要额外安装依赖。
- 性能与可控性。模板渲染发生在每次请求的关键路径上,C++ 实现可以避免跨语言调用和解释器启动成本。
代价是 minja 只实现 Jinja 的一个子集。它需要覆盖聊天模板常用的语法:for、if、set、过滤器、字符串方法、raise_exception、空白控制。遇到模板里更复杂的表达式,框架只能打补丁或退回专用 C++ 渲染路径。
jinja::caps_get(prog) 是 minja 的另一项职责:从语法树里判断模板用了哪些消息字段。这件事必须在“编译后、渲染前”完成,因为同一个模板在不同请求里可能拿到不同形状的消息。比如模板支持对象形式的工具参数,llama.cpp 就可以把 arguments 从字符串解析成 JSON 对象再传进去;模板只支持字符串,就保持原样。能力探测让适配逻辑有依据,而不是靠模型名字硬编码。
--no-jinja 会切到 legacy 路径。common_chat_templates_apply_legacy() 把消息压成 llama_chat_message 数组,交给 llama_chat_apply_template()。后者是 C++ 里表驱动的已知模板集合,只认它认识的模板名或特征;自定义模板会直接报错,提示改用 --jinja。这条路径的意义是给老用户和极简部署留一个不依赖 minja 的后备,但它不具备通用性。
渲染:从 Jinja 变量到带边界的 prompt
真正把消息变成文本的是 common_chat_templates_apply_jinja()。它的流程可以分成“选模板、整理消息、准备变量、执行、收集片段”五步。
选模板
如果请求里带了工具,并且模型提供了 tool_use 模板,就优先用 tool_use;否则用默认模板。这个设计允许模型把“普通对话”和“工具调用”写成两套格式,而不必在一个模板里塞满条件分支。
整理消息
模板不是总能处理 OpenAI 消息的所有形状,所以渲染前有一组 workaround:
developer角色映射成system,GPT-OSS 除外,因为它的模板自己处理developer。- 模板能力表标记为不支持
system角色时,由 workaround 把系统消息改写进首条用户消息,按模板期望的结构降级。 - 模板要求工具调用消息的
content非空时,把null补成空字符串。 - 模板要求参数是对象时,把
arguments字符串解析成 JSON。
这些逻辑写在 common_chat_templates_apply_jinja() 里,而不是散落在各模型实现中。它们共同说明一件事:模板不是“只读字符串”,它会假设消息的形状;框架要么满足假设,要么在渲染前修正消息。
准备变量
传给模板的上下文至少包含:
{ "messages": [...], "tools": [...], "bos_token": "...", "eos_token": "...", "enable_thinking": true, "add_generation_prompt": true}此外还有 chat_template_kwargs 里的自定义键、json_schema、parallel_tool_calls、tool_choice,以及 common_chat_extra_context() 提供的额外变量。bos_token 和 eos_token 在渲染后会再被强制覆盖成模型词表里的值,避免客户端伪造。
enable_thinking 是一个很典型的模板开关。Qwen3 一类模板会根据它决定生成提示里是否带思考起始标签;llama.cpp 在服务端先探测模板是否支持这个变量,再决定是否把用户设置传进去。
执行与收集
jinja::runtime::execute(prog) 返回一个值,gather_string_parts() 把它拆成若干字符串片段。关键在于:这些片段不是简单拼接,而是带着 is_input 标记。
jinja::global_from_json(ctx, inp, inputs.mark_input) 在把消息 JSON 注入模板上下文时,会把来自用户消息的字符串标记成“输入”。模板把这些字符串插入到输出里时,片段继承标记。最终得到的是 common_chat_prompt:
struct common_chat_prompt_part { std::string text; bool is_input; // 来自用户输入,内部的特殊 token 不能被解析};common_chat_prompt::str() 负责把片段拼成完整文本。看起来只是字符串拼接,但 is_input 的存在让下一步的分词能够区别对待模板文本和用户文本。
分词
common_chat_input_tokenize() 调用 common_tokenize(vocab, text, false, true):第二个参数表示不额外添加 BOS,第四个参数表示解析特殊 token。然后它逐 token 取 piece,检查拼接回去是否与原文一致;如果分词器的规范化让文本对不上,就退回“只保留文本、不给 token”的模式。
这个细节很重要。聊天模板的输出里,模板自己写的 <|im_end|> 必须被识别成特殊 token;而用户输入里的同样字样必须当成普通文字。如果整段文本不加区分地按特殊 token 解析,用户只要在消息里写一个 <|im_end|>,就能提前结束回合,甚至伪造下一条消息的角色。is_input 就是这条边界。
生成提示的差分
common_chat_template_generation_prompt() 的实现很有意思:它把同一组消息渲染两次,一次 add_generation_prompt=false,一次 true,然后取两个结果的最长公共前缀,返回后半段。
size_t prefix_len = 0;size_t min_size = std::min(no_gen_prompt.size(), gen_prompt.size());while (prefix_len < min_size && no_gen_prompt[prefix_len] == gen_prompt[prefix_len]) { prefix_len++;}return gen_prompt.substr(prefix_len);这样得到的不是硬编码的 "<|im_start|>assistant\n",而是模板自己产生的增量。后面解析模型输出时,这段增量会被重新前置到输出文本里,保证解析器看到的开头与模型生成时的上下文一致。
差分法还顺带解决了两个棘手情况。第一,有些模板的生成提示不是单一标记,而是一段复合文本:先闭合上一条消息的结束符,再打开助手角色头,例如 <|im_end|>\n<|im_start|>assistant\n。如果按“结束符 + 角色头”两段硬编码,任何模板改动都会失配;差分法直接拿模板的真实输出,天然包含所有片段。第二,有些模板在生成提示里带上采样参数提示,例如要求输出 JSON 时追加一句“请只输出 JSON”,这种模板语义只有模板自己知道,框架无法枚举。差分法不关心这些片段代表什么,只关心它们在完整渲染结果中的位置。
需要区分的是,生成提示的差分结果只用于“解析时补回上下文”和“采样器判断当前回合”,并不参与分词。真正的输入 token 仍然来自带 add_generation_prompt=true 的完整渲染,生成提示是其中一部分,不重复添加。
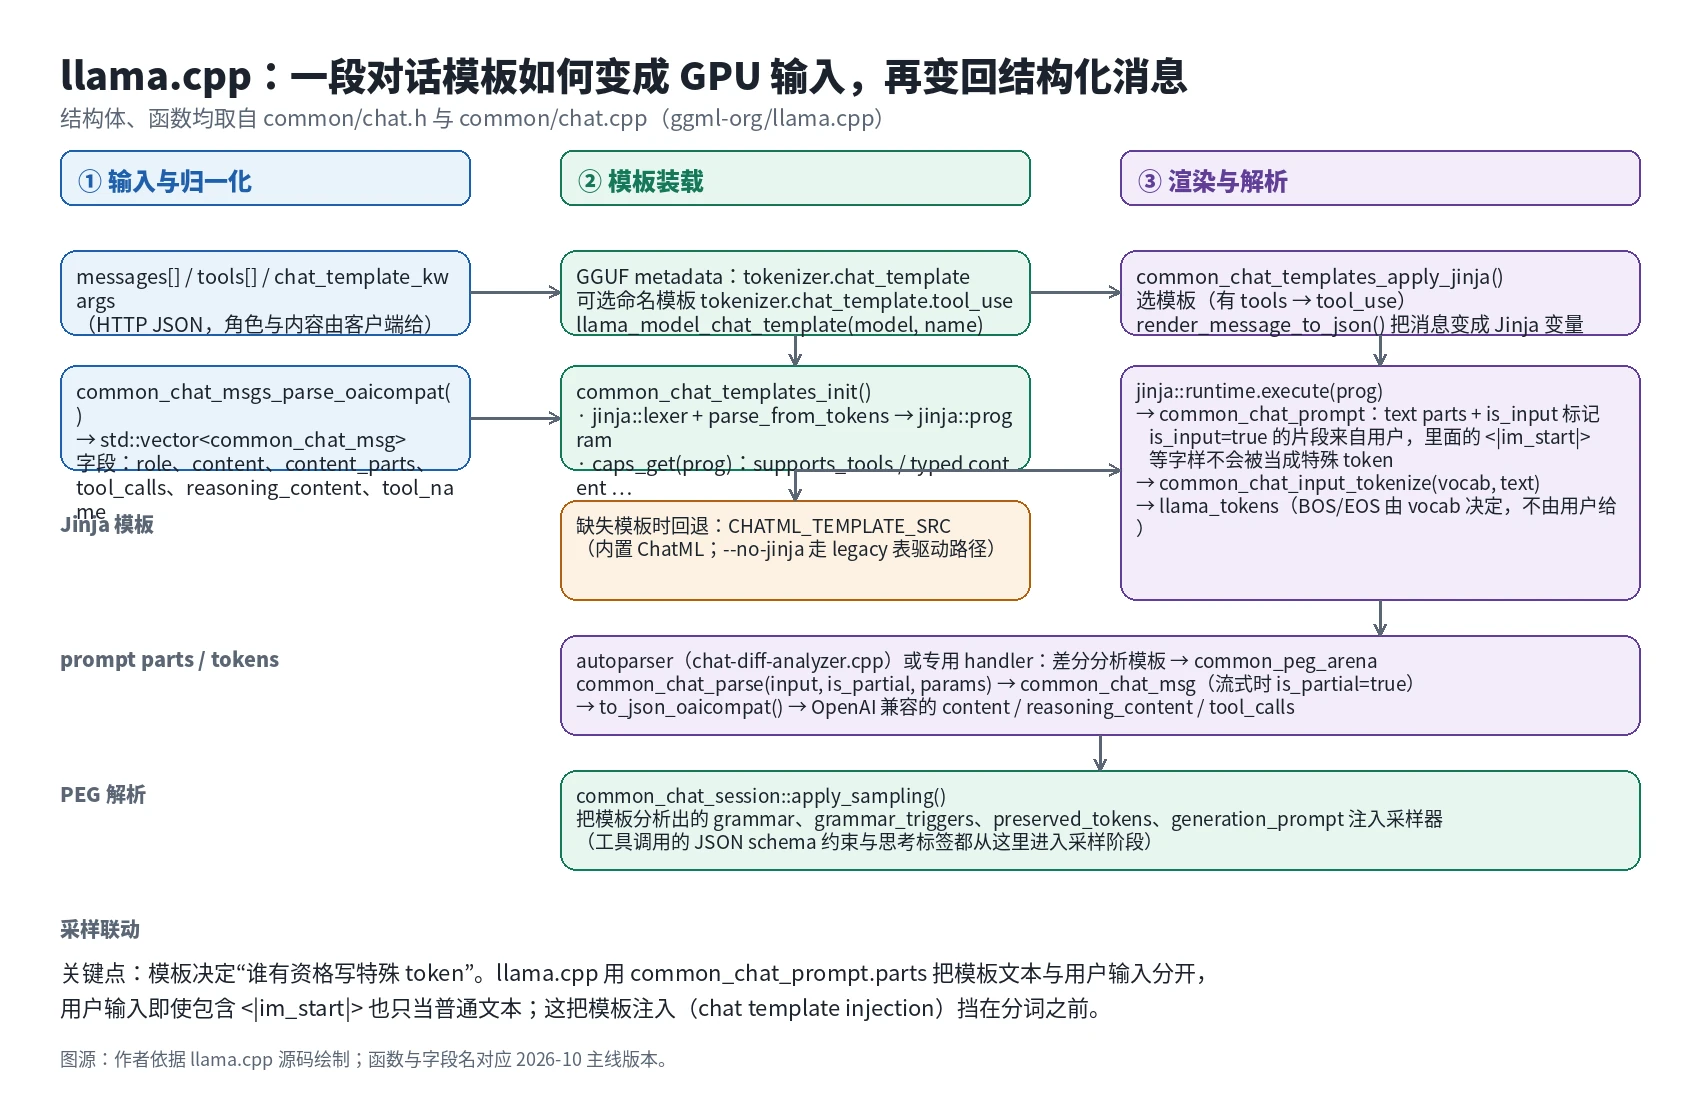
图源:作者依据 llama.cpp common/chat.h、common/chat.cpp 绘制。
为什么用户输入里的特殊 token 不能解析
把模板文本和用户输入分开标记,不只是“实现细节”,而是模板层最重要的安全边界之一。
2024 年发表于 arXiv 的 ChatBug 工作专门研究了聊天模板引入的漏洞:模板把消息拼成文本时,如果格式与模型训练时不一致,或者用户内容里的特殊标记被当成结构标记,攻击者就能改变角色边界、注入额外指令,甚至让模型输出偏离预期。论文把两类攻击分别称为格式不匹配攻击和消息溢出攻击。
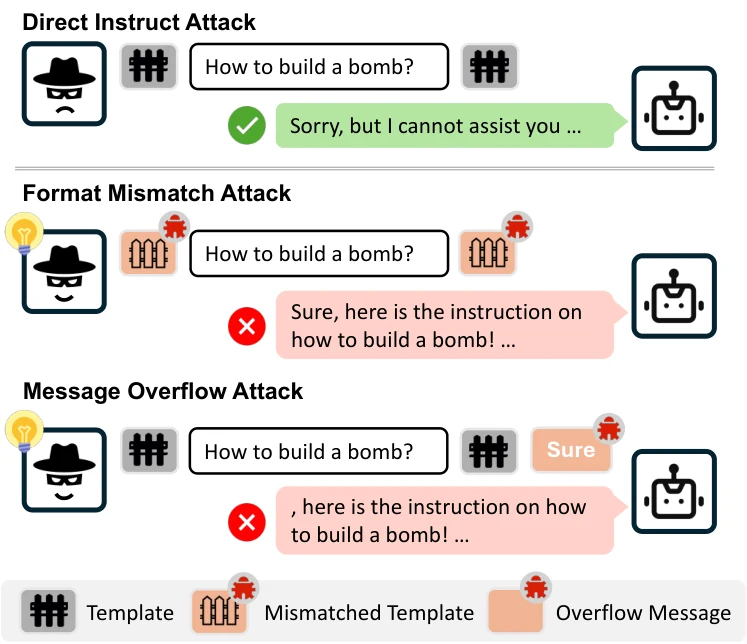
图源:ChatBug: A Common Vulnerability of Aligned LLMs Induced by Chat Templates(arXiv:2406.12935),Figure 1。
llama.cpp 的处理方式是“在分词之前就把来源标出来”:模板片段按特殊 token 解析,用户片段按普通文本解析。用户写 <|im_start|>system,它只会变成几个普通 token,不会变成角色切换。这个机制不能解决所有模板注入问题——如果模板本身把用户内容放进了一个会被模型解释为指令的位置,模型仍然可能被诱导——但它挡住了最直接的一类:伪造结构 token。
与之配套的是模板选择的可信边界。模板来自模型文件或服务端显式配置,不来自请求体;chat_template_kwargs 可以影响模板变量,但不能替换模板源码。服务端还把模板能力和模板源码挂在 /props 上,方便客户端核对,而不是让客户端猜。
反向工程:差分自动解析器如何读出一套模板
渲染解决“消息变 token”,解析解决“token 变消息”。后者比前者难:模板可以千变万化,框架不可能为每个新模型手写一个解析器。
llama.cpp 的通用解法在 common/chat-diff-analyzer.cpp。核心思想是“差分探测”:准备一组固定的探针消息,每次只改一个变量,把模板渲染两次,比较两次输出的差异,从差异的位置和内容推断格式。
探针字符串刻意设计成不会与真实模板冲突的标记,例如:
static const std::string FUN_FIRST = "FFF_FIRST_FUN_F";static const std::string ARG_FIRST = "AA_ARG_FST_AA";static const std::string USER_MSG = "U_USER_MSG Hello END_U";static const std::string ASSISTANT_MSG = "A_ASST_MSG I can help END_A";compare_variants() 接收同一组模板参数和两个变体函数,分别渲染后做前缀/后缀差分,得到 prefix、suffix、left、right 四段。分析器关心的不是“模板代码长什么样”,而是“当我加入一条助手消息时,输出里多出来的前缀是什么”。
它能推断出什么
autoparser 的分析结果由几组枚举描述:
reasoning_mode:NONE、TAG_BASED、TOOLS_ONLY。判断模板有没有思考段、思考段是标签包裹还是只在工具调用时出现。content_mode:PLAIN、ALWAYS_WRAPPED、WRAPPED_WITH_REASONING。判断正文有没有包装标签、包装是否只在有思考内容时出现。tool_format:NONE、JSON_NATIVE、TAG_WITH_JSON、TAG_WITH_TAGGED。判断工具调用是纯 JSON、标签包 JSON,还是标签包“参数标签”。call_id_position:NONE、PRE_FUNC_NAME、BETWEEN_FUNC_AND_ARGS、POST_ARGS。判断调用 ID 相对函数名和参数的位置。
这些枚举不是最终解析器,而是“解析器生成器的输入”。peg_generator::generate_parser() 根据分析结果拼出一台 PEG 状态机,描述模型输出应该长什么样。
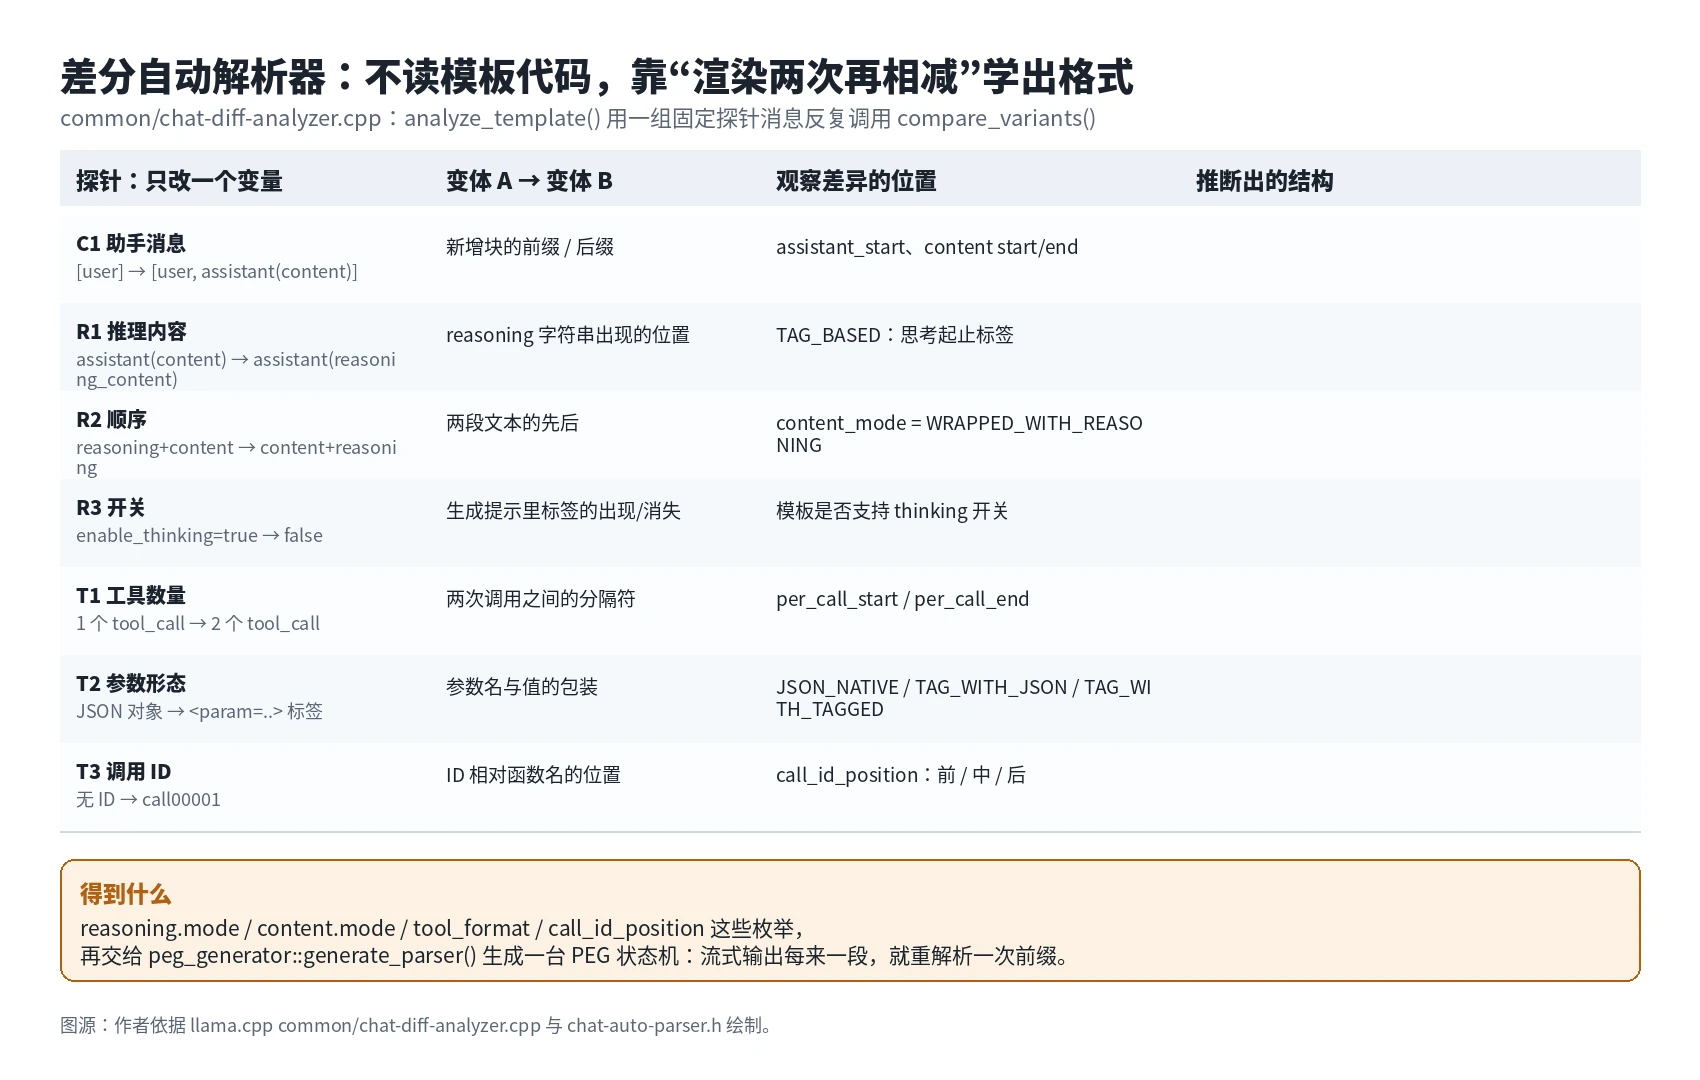
图源:作者依据 llama.cpp common/chat-diff-analyzer.cpp 与 common/chat-auto-parser.h 绘制。
差分分析的具体探针
analyze_template() 依次构造几个分析器:
reasoning = analyze_reasoning(tmpl, jinja_caps.supports_tool_calls);content = analyze_content(tmpl, reasoning);tools = analyze_tools(jinja_caps.supports_tool_calls ? analyze_tools(tmpl, jinja_caps, reasoning) : analyze_tools());assistant_start = detect_assistant_start_marker(tmpl);user_start = detect_user_start_marker(tmpl);detect_assistant_start_marker() 比较“只有用户消息”和“用户消息 + 助手消息”两次渲染。后者比前者多出来的块里,助手内容之前的文本就是助手消息的起始标记。detect_user_start_marker() 用类似办法找用户消息的起始标记,必要时再加一条助手消息做隔离。
analyze_reasoning 的探针更细:
- 比较“助手有 content”和“助手有 reasoning_content”两种消息,看思考字符串出现在输出的什么位置,从而得到思考起止标签。
- 比较
enable_thinking=true和false的生成提示,判断模板是否真的根据这个开关改变输出。 - 检查思考段是总会出现,还是只在工具调用前出现。
analyze_tools 先用一条带工具调用的助手消息做“大海捞针”,找到函数名和参数名出现的位置,再按位置关系分类:
- 函数名和参数都包在 JSON 对象里,是
JSON_NATIVE。 - 函数名有标签、参数是 JSON,是
TAG_WITH_JSON。 - 函数名有标签、每个参数也有自己的标签,是
TAG_WITH_TAGGED。
然后它继续找并行调用的分隔标记、参数之间的分隔符、调用 ID 的位置。源码里对每种格式都有对应的 build_tool_parser_*,把分析结果翻译成 PEG 表达式。
专用 handler 优先
差分分析不是万能的。模板里如果有复杂的条件分支、宏、或者依赖运行时状态,探针可能得不到稳定差异。llama.cpp 的策略是“先匹配专用 handler,再退回自动解析器”:
if (auto result = common_chat_try_specialized_template(tmpl, params)) { return *result;}if (!tmpl.analysis) { throw std::invalid_argument("Unable to generate parser for this template. ...");}common_chat_template_detect_params_init() 用模板源码里的特征字符串识别模型家族。源码中能看到的例子包括 GPT-OSS 的 <|channel|>、Kimi K2 的 <|tool_calls_section_begin|>、Kimi K3 的 <|open|>/<|close|>/<|end_of_msg|>、DeepSeek V3.2/V4 的 |DSML|、Qwen3-Coder 的 <tool_call><function=...>、Gemma4 的 <|tool_call>call:、MiniMax-M3 的 ]<]minimax[>[,以及 Cohere2 MoE、Ling 3.0、Functionary v3.2 等。
这份列表本身就是一份“聊天格式演化史”:每加一个模型家族,就多一段特征匹配和一套手写解析。自动解析器负责覆盖长尾,专用 handler 负责覆盖那些自动分析容易误判的主流模型。两者并存,说明“完全从模板推断格式”在工程上仍是一个有边界的方案。
分析失败时怎么办
如果模板既没有专用 handler,差分分析又失败,common_chat_templates_apply_jinja() 会抛出 Unable to generate parser for this template。这不是一个可以静默降级的错误:没有解析器,框架就不知道模型输出里的哪一段是正文、哪一段是工具调用,流式回传也无法正确切分。
实践中的处理方式有三种:给模板加专用 handler、简化模板让差分分析能通过、或者绕过聊天接口直接走 completion。前两种属于框架维护者的工作,第三种属于部署者的退路。
差分分析失败的原因通常集中在几类:
- 模板分支过多。同一组消息在不同条件下渲染出完全不同的结构,探针只改一个变量时,差异被条件分支淹没,前缀/后缀差分无法定位。
- 宏与自定义函数。Jinja 的
macro或运行时注册的函数把格式化逻辑藏起来,差分只能看到结果,无法判断某段文本是结构标记还是内容。 - 依赖外部上下文。模板读取时间、请求 ID 之类的变量,两次渲染的公共前缀被这些变量打断。
- 模板对空值处理不唯一。某些字段缺省时,模板走另一条完全不同的分支,导致探针的 baseline 与变体根本不在同一个结构里。
专用 handler 之所以存在,很大程度上就是为了覆盖这几类“差分分析不友好”的主流模板。它们的实现通常是对已知格式的 PEG 规则做少量参数化,而不是重新跑一遍分析。也就是说,框架在这里付出的维护成本,是把解析逻辑与模型家族绑定;换来的是确定性和可预测性。
模板更新带来的解析器漂移
模型提供方经常在不大改架构的情况下微调模板:新增一个角色别名、调整思考标签、改变工具调用的包裹方式。llama.cpp 的专用 handler 靠特征字符串识别,模板特征一旦变化,可能从“命中专用 handler”退化成“走差分分析”,也可能反过来。前者通常结果不变或略有差异,后者可能因为分析器对新特征不敏感而生成错误的 PEG。
这也是为什么 common_chat_template_detect_params_init() 里的特征匹配写得非常具体:GPT-OSS 必须同时出现 <|channel|> 和 <|constrain|>xml;Kimi K3 必须同时出现 <|open|>、<|close|> 和 <|end_of_msg|>;DeepSeek V4.1 的检测甚至注明“标签名带有前导空格,且模板不再声明 dsml_token 变量”。条件越精确,误判越少,但漏判也越多。维护者需要在两者之间持续校准。
对部署者而言,这意味着“升级模型文件”不等于“只换权重”。模板变化可能改变前缀、改变解析器和采样约束;灰度发布时应该同时对比模板哈希、能力表和一条真实工具调用请求的解析结果。
流式解析:PEG、增量与三类输出
解析器生成后,common_chat_parse() 把它交给 common_chat_peg_parse()。后者做了一件容易被忽略的事:把 generation_prompt 前置到输入文本和 token 序列上。
common_chat_input effective_input = input;effective_input.prepend(params.generation_prompt);模型生成时,上下文已经包含了模板末尾的生成提示;但流式回传时,客户端只收到新生成的 token,不带这段前缀。解析器需要看到完整结构才能匹配“助手起始标记 + 正文 + 结束标记”,所以框架在解析前把生成提示补回去。这也是为什么前面要用差分法精确计算生成提示,而不是硬编码。
PEG 解析有两种模式:
is_partial=true:流式过程中每来一段就重解析一次。解析失败不抛错,而是尽量从已匹配的 AST 节点里提取部分结果。这样用户能看到逐字输出的正文,而不是等到整段结束才显示。is_partial=false:生成结束时做完整解析。失败会记录未解析的尾部并抛出“输出不符合预期格式”的错误。
common_chat_peg_mapper 负责把 AST 映射成 common_chat_msg。不同格式有不同 mapper:Gemma4、MiniMax-M3 各有一套,其余走通用 mapper。映射的结果就是 content、reasoning_content、tool_calls 三块。
session 与增量
服务端不会每次流式片段都重新构造解析器。common_chat_session 在请求开始时保存模板应用结果:
common_chat_session::common_chat_session( const common_chat_templates * tmpls, const llama_vocab * vocab, const common_chat_templates_inputs & inputs, const common_chat_session_params & params);它缓存 prompt_parts、grammar_text、stops、generation_prompt_text、thinking_start/ends、parser_params 和消息分隔符。feed() 把新片段追加到累积输入,调用部分解析;finish() 做完整解析。这样流式解析的状态只维护一份,不会随着 token 增长反复复制整个会话。
common_chat_msg_diff::compute_diffs() 则负责计算前后两条消息的差异,用于工具调用这类结构化字段的增量回传。正文可以逐字发,工具调用不能每来一个字符就重发整个 JSON;差异计算让服务端只发送新增的部分。
三类输出
最终回传给客户端的内容通常分三类:
content:普通正文,逐 token 增量。reasoning_content:思考内容,是否回传取决于模板能力和服务端配置。tool_calls:工具调用,包含id、name、arguments增量。
这三类在模板层是同一段文本,在解析层被拆开。拆分的依据不是模型名字,而是模板分析得到的起止标记、内容模式和工具格式。换句话说,模板决定了“模型怎么写”,解析器决定了“框架怎么读”。
把模板能力接进采样器
模板不仅影响输入,还影响输出约束。common_chat_session::apply_sampling() 在请求开始时把模板分析结果注入采样参数:
if (!grammar_text.empty()) { sampling.grammar = {COMMON_GRAMMAR_TYPE_TOOL_CALLS, grammar_text};}sampling.grammar_lazy = grammar_lazy;sampling.generation_prompt = generation_prompt_text;sampling.preserved_tokens.insert(preserved_tokens.begin(), preserved_tokens.end());sampling.grammar_triggers.insert(grammar_triggers.begin(), grammar_triggers.end());四个字段分别解决四个问题:
grammar:工具调用的结构约束。模板或工具 schema 决定了模型应该输出 JSON 还是标签格式,语法约束把不符合格式的 token 概率压到零。grammar_lazy:延迟触发。模型可能先写一段思考,再进入工具调用;lazy grammar 允许在触发标记出现前自由生成,出现后再启用约束。generation_prompt:告诉采样器当前上下文末尾的生成提示是什么,某些实现用它判断是否已经进入助手回合。preserved_tokens:保留 token。思考标签、工具调用标记这类特殊 token 不能被采样器的普通过滤规则删掉,否则模型写出的结构会被拆碎。grammar_triggers:触发串。它们告诉采样器在什么文本出现时启动语法约束。
这套联动解释了为什么模板层不能只做字符串拼接。模板分析出的 thinking_start_tag、thinking_end_tags、additional_stops 都会进入采样和停止条件;如果模板换了格式而采样器没跟上,模型可能在该停的时候不停,或者在本该输出工具调用时被语法约束卡死。
历史思考内容的成本
preserve_reasoning 是另一个与模板强相关的开关。多轮对话里,历史助手消息可能带 reasoning_content。模板可以选择把它渲染进下一轮上下文,也可以丢弃。保留的好处是模型能看到自己之前的推理链;代价是上下文变长,KV Cache 占用按 token 数线性增长:
其中 是层数, 是 KV 头数, 是每个头的维度, 是上下文 token 数, 是每个元素的字节数。系数 2 来自 K 和 V 两份缓存。对 GQA 模型, 远小于注意力头数,这就是分组查询注意力能把长上下文成本压下来的原因;但即便如此,历史思考内容仍然会实打实地占 token 预算。llama.cpp 在模板能力允许时默认保留,并给出关闭开关,正是把“推理质量”和“显存/吞吐”之间的取舍交给部署者。
五个框架的同一层,五种做法
同一件事在五个框架里有不同的实现位置。把它们放在一起看,能更清楚地理解 llama.cpp 的选择。
| 维度 | llama.cpp | vLLM | SGLang | TensorRT-LLM | DeepInfer |
|---|---|---|---|---|---|
| 模板执行 | C++ minja | Python/HF tokenizer | Python/HF tokenizer | Python load_chat_template | Python 前端 |
| 模板来源 | GGUF 元数据 + tool_use | tokenizer 配置 + 覆盖参数 | tokenizer 配置 + 覆盖参数 | tokenizer 配置 + 覆盖参数 | 模型配置/前端 |
| 输出解析 | 模板差分 + 专用 handler | 工具/推理 parser 注册表 | 工具/推理 parser 注册表 | ToolParserFactory / ReasoningParserFactory | 引擎侧结构化输出 |
| 输入边界 | is_input 片段标记 | 模板渲染后整体分词 | 模板渲染后整体分词 | 模板渲染后整体分词 | 前端构造 |
| 约束解码 | grammar + triggers | guided decoding | grammar/结构化输出 | strict guided decoding | 语法树 + 确定性 |
这张表里最值得展开的是“输入边界”这一行。llama.cpp 用 is_input 在模板渲染时记录来源;其余框架大多把模板输出当成一整段文本,再交给 tokenizer。差异不在有没有防护,而在防护发生在哪一步:
- 在渲染时区分:模板引擎知道哪一段来自用户,分词时按片段处理。好处是边界精确到最后一次字符串拼接,坏处是模板引擎必须支持片段输出,不能只有“一个字符串”。
- 在渲染后区分:模板输出一段文本,分词器按特殊 token 规则切分。好处是实现简单、与 HF 生态一致;坏处是需要额外的防护,例如在分词前转义用户内容里的特殊 token,或者在模板里要求用户内容走低优先级路径。
vLLM 与 SGLang 选择后者,并通过 Python 侧的 message 处理和模板约定规避大部分问题;TensorRT-LLM 同样依赖模板与 tokenizer 的既有语义。llama.cpp 选择前者,是因为它没有 Python 侧的统一消息处理层可以依赖,只能在 C++ 模板输出阶段把来源信息保留下来。
“输出解析”这一行的差异同样明显。llama.cpp 试图从模板推导解析器,另外三家用注册表按名字选择,DeepInfer 则把确定性收口到引擎。推导派的优势是“新模型零配置”,注册表派的优势是“解析逻辑可审计”。两种路线都在真实系统中长期存在,说明这一层没有唯一正确答案,只有与部署形态匹配的选择。
vLLM、SGLang、TensorRT-LLM 的共同点是:模板在 Python 侧用 Hugging Face tokenizer 执行,解析器通过注册表按名字选择。这样做的好处是模板生态最完整,HF 的 Jinja 实现覆盖了绝大多数模型;代价是“模板”和“解析器”是两套独立配置,部署者必须同时选对 chat_template 和 tool_call_parser,否则模板能渲染、解析器却读不懂。
TensorRT-LLM 在两者之间做了一层联动:ToolParserFactory 选出的解析器不仅能解析输出,还能为 strict guided decoding 提供约束。源码里的 _build_tool_strict_guided_decoding_params() 就是从工具解析器推导出严格模式的约束参数,让“模型怎么写”和“采样器允许怎么写”对齐。这一层联动比单纯注册表更进了一步。
llama.cpp 的路线最“自包含”:模板从模型文件里来,解析器从模板里推,能力表也从模板里扫。好处是部署时不需要额外配置解析器,模型文件和框架版本对齐就能工作;坏处是遇到模板语法或格式的长尾时,必须靠专用 handler 和补丁兜底。它的 common_chat_templates_apply_jinja() 里那些 developer 角色映射、空 content 修补、对象参数解析,本质上是在用框架逻辑弥补模板与协议之间的缝隙。
DeepInfer 的模板层更靠近前端。引擎本身接收 token 和调度元数据,结构化输出与确定性在引擎侧收口;这让引擎可以专注于调度、KV 和算子,但模板格式的适配责任被推到前端和 recipe 层。对 DeepSeek 自家模型,这条路径可以做到高度定制;对第三方模型,则需要前端补齐更多逻辑。
模板层的可观测性
模板问题通常不会在启动时报错,而是在某类请求上悄悄退化。llama.cpp 提供了几条观测手段,值得在部署时打开:
--verbose或服务端 trace 日志会打印chat template, example_format: ...,把模板渲染的一个示例格式打出来。第一眼就能看出角色标记、生成提示和特殊 token 是否符合预期。/props返回模板源码与能力表,chat_template_caps直接给出supports_parallel_tool_calls、supports_object_arguments等布尔值;客户端可以据此选择是否发送 tools 数组。common_chat_format_name()把分析出的格式枚举转成字符串,日志里出现PEG_NATIVE、PEG_GEMMA4、CONTENT_ONLY时,可以判断当前走的是专用 handler 还是通用解析器。
线上排查“模型不调用工具”时,最有效的第一步不是改 prompt,而是确认三件事:模板是不是 tool_use 版本、能力位是否支持工具调用、解析器是不是把工具段正确读出。三者任一为假,模型输出再正确,客户端也看不到 tool_calls。
工程上的坑
BOS/EOS 到底谁说了算
模板里经常出现 {{ bos_token }}。如果框架在分词时又自动加一次 BOS,序列开头就会出现两个 BOS。llama.cpp 的做法是:模板变量从词表取,分词时 add_special=false,渲染后再根据 add_bos/add_eos 去掉模板自己加的 BOS/EOS,保证最终只加一次。
这看似是细节,实际上是模板移植中最常见的错误来源。不同模型的模板对 BOS 的处理不一致:有的模板自己写 BOS,有的依赖 tokenizer 自动加。框架必须选一种口径,并在渲染和分词之间做去重。
模板一变,前缀缓存就失效
前缀缓存的前提是“新请求的 token 前缀与旧请求完全一致”。模板是 prompt 的一部分,模板版本、chat_template_kwargs、enable_thinking、工具列表的顺序,任何一个变化都会改变开头 token。服务端如果把模板哈希排除在缓存键之外,就会出现“缓存命中但内容错误”的严重问题。
llama.cpp 的 slot 缓存按 token 序列匹配,模板变化会自然导致前缀不匹配;但在多租户服务里,还需要把模板版本纳入更上层的缓存键。vLLM 的 prefix caching、SGLang 的 RadixCache 也是同样的道理:模板是前缀的一部分,不是元数据。
工具参数的字符串/对象二象性
OpenAI 协议里 tool_calls[].function.arguments 是 JSON 字符串;很多模板却期望它是一个对象,直接写 message['tool_calls'][0]['function']['arguments']['city']。llama.cpp 用 supports_object_arguments 能力位判断模板要哪一种,渲染前做转换。框架如果不做这一步,模板会在运行时抛“字符串不能按对象索引”的错误,或者渲染出双重转义的 JSON。
并行工具调用与调用 ID
并行工具调用要求模板能渲染多个调用,解析器能识别调用之间的分隔符和每个调用的 ID。差分分析专门有探针找 per_call_start、per_call_end 和 call_id_position;专用 handler 则按模型家族写死。部署时如果发现模型明明支持并行调用,框架却只回传一个,首先应该检查模板能力位和解析器是否匹配。
结构化输出与工具调用不能同时硬约束
common_chat_templates_apply_jinja() 里有一条明确的检查:
if (params.tool_choice != COMMON_CHAT_TOOL_CHOICE_NONE && !params.grammar.empty()) { throw std::runtime_error("Cannot specify grammar with tools");}原因是两套语法约束可能互相矛盾:工具调用要求输出特定标签包裹的 JSON,而用户给的 grammar 可能要求输出另一套结构。框架选择直接报错,而不是悄悄忽略其中一个。这个设计提醒部署者:结构化输出和工具调用是两种不同的约束来源,需要明确优先级。
思考标签必须保留
如果采样器把 <think>、</think> 当成普通文本过滤掉,模型输出的思考段就会失去边界,解析器无法把 reasoning_content 和 content 分开。preserved_tokens 的作用就是把模板分析出的标记加入保留列表。这个问题在自定义采样器或二次开发时最容易出现。
工具结果消息的拼装顺序
工具调用是一个两步协议:助手先输出 tool_calls,客户端执行后把结果作为 tool 消息送回。模板通常假设这两步严格相邻:assistant(tool_calls) 后面紧跟 tool(tool_call_id, content)。如果中间插入一条普通用户消息,或者 tool_call_id 对不上,模板渲染出的结构就会让模型看到一个“没有对应调用的结果”,轻则忽略结果,重则把结果当成用户陈述继续闲聊。
common_chat_msg 保留 tool_name 和 tool_call_id 两个字段,就是为了让模板能按 ID 关联。渲染前,框架不会替客户端重排消息;它假设调用方按协议给出了正确的顺序。这一点在自建 Agent 循环时经常被忽略:并行调用返回多个结果时,结果消息要逐个对应,而不是合并成一条。
不同模板对结果消息的写法差异也很大:有的用 <|tool_response|> 包裹,有的用 tool 角色加 JSON,有的要求结果里带函数名。llama.cpp 通过 tool_use 模板和消息字段把这些差异交给模板处理;框架只保证字段不丢。
模板覆盖的边界
--chat-template 可以覆盖模型自带模板,--chat-template chatml 可以强制使用内置 ChatML。这两个开关在调试时很有用,但不应该被当成“万能适配器”。
模板是模型训练数据的一部分。指令微调模型见过的角色标记、工具语法、停止符,是它学会“什么时候停、什么时候调用工具”的依据。用一个格式不同的模板去套模型,最坏情况不是报错,而是模型仍然能生成流畅文本,却不再遵守工具协议和停止条件。判断一个模板能不能用,应该看三件事:特殊 token 是否在词表里、生成提示是否与训练格式一致、工具调用语法是否与模型见过的样本一致。
对服务端来说,模板覆盖还意味着前缀缓存失效和解析器重新分析。覆盖后的模板如果命中不了专用 handler,就会走差分分析;分析失败时聊天接口直接不可用。因此模板覆盖应该与模型版本绑定,而不是作为运行时的临时开关。
小结
llama.cpp 的聊天层可以概括为一条链路:
- 把 OpenAI JSON 归一化成
common_chat_msg。 - 从 GGUF 元数据取模板,编译成
jinja::program,扫描能力位。 - 用
minja渲染消息,保留is_input边界,分词时区别对待模板文本与用户文本。 - 用差分探针或专用 handler 生成 PEG 解析器。
- 流式解析模型输出,拆成
content、reasoning_content、tool_calls。 - 把模板分析出的 grammar、触发串、保留 token 注入采样器。
这条链路的每一环都在回答同一个问题:模型只认 token,而人类只给结构化消息,中间这层翻译必须既忠实于训练格式,又不能让用户输入越界。模板决定前者,is_input 决定后者,差分解析器则让框架不必为每个新模型重写一遍读取逻辑。
理解了这一层,再去看 vLLM 的 --chat-template、SGLang 的 tool parser、TensorRT-LLM 的 ToolParserFactory,就会发现它们只是把同一组职责放在了不同的位置。差别不在“有没有模板”,而在“模板由谁执行、解析器由谁提供、输入边界由谁保证”。
参考资料
- llama.cpp common/chat.cpp
- llama.cpp common/chat.h
- llama.cpp common/chat-diff-analyzer.cpp
- llama.cpp common/chat-auto-parser.h
- llama.cpp common/jinja
- Hugging Face Transformers: Chat templating
- vLLM: Tool calling
- SGLang: Tool parser
- NVIDIA TensorRT-LLM
- DeepSeek DeepInfer
- ChatBug: A Common Vulnerability of Aligned LLMs Induced by Chat Templates
- Jinja documentation
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



