


llama.cpp 源码完全拆解(五):采样管线与语法约束——采样器链、惩罚机制与 GBNF 如何把 logits 变成 token
采样在推理循环中的位置:logits 之后发生了什么
在 llama.cpp 的每一次解码里,模型前向算出的是一个长度为词表大小的 logits 向量:对词表里的每个 token,模型给出一个未归一化的打分。这个向量只是**原材料**,它还不是一个决定。从「一个 15 万维的浮点数组」到「下一个 token 是哪个」,中间那一段逻辑就是本文的主题——采样子系统。
前几篇已经把这条路径的上游讲完了:llama.cpp 源码完全拆解(一):整体架构与模块全景 给出了从 llama_decode 到 GPU 前向的全景;(三):GGUF 装载、mmap 与张量放置 讲了权重怎么进内存;(四):llama_context 与记忆系统 讲了 KV 缓存怎么组织一次解码。这一篇接在它们之后,回答一个看起来简单、实际上一整子系统的问题:logits 出来之后,凭什么变成 token。
如果只是一句「取 argmax」,这个子系统不需要存在。它之所以复杂,是因为下面这些需求全都落在同一段代码里:
- 要能让输出有随机性,而且随机性的强弱要可控(这就是 temperature 和 nucleus 采样)。
- 要能压制重复,模型很容易陷入「反复说同一句话」的退化状态(这就是 repetition penalty 与 DRY)。
- 要能接受外部约束,比如强制输出合法 JSON、合法的工具调用参数(这就是 GBNF 语法采样)。
- 要能横向拼装,不同的采样策略要能像积木一样串起来,而不是写死一个巨型函数。
- 要能在多序列、多请求并发时各自独立,一条请求的采样历史不能污染另一条。
llama.cpp 对上面每一条的回答,是同一套设计:把每个采样策略做成一个独立的小对象,每个对象只做一件事,然后用一条链把它们串起来。理解了「对象 + 链」这两件事,剩下所有采样器都只是填空题。
先看一个最直观的问题:为什么不能用一个 sample(logits, params) 函数把所有逻辑写在一起?因为采样策略之间有顺序依赖,而且这个顺序本身就是语义的一部分。top-k 之后再 top-p,和 top-p 之后再 top-k,得到的分布不一样;temperature 放在惩罚之前还是之后,效果也不一样。把这些策略硬编成一个函数,就等于把某一种固定顺序焊死,用户再也无法表达别的组合。链式设计把「顺序」变成了用户可以直接控制的量。
采样器链:顺序就是语义
llama.cpp 提供 llama_sampler_chain,它本身也是一个采样器,只不过它的 apply 就是把链上每个子采样器的 apply 依次跑一遍。看源码(src/llama-sampler.cpp):
static void llama_sampler_chain_apply(struct llama_sampler * smpl, llama_token_data_array * cur_p) { auto * chain = (llama_sampler_chain *) smpl->ctx;
bool is_backend = chain->is_init;
for (auto & smpl : chain->samplers) { if (is_backend && smpl.is_backend) { continue; // 已交给后端 kernel 的采样器,CPU 端跳过 } is_backend = false; // 一旦遇到第一个非后端采样器,其后全部走 CPU
if (smpl.ptr->iface->apply == nullptr) { continue; } llama_sampler_apply(smpl.ptr, cur_p); }}这段十几行的代码里有三个关键事实:
第一,链的 apply 是顺序、就地、共享的。所有子采样器操作的是同一个 cur_p(候选集),前一个采样器的改动直接成为后一个采样器的输入。这就是「顺序即语义」在代码层面的落地。
第二,apply == nullptr 的采样器会被跳过。链上确实存在只提供名字、不参与计算的角色——源码里的 llama_sampler_empty 就是这种空实现,它把 apply 留空,链在遍历时直接跳过。接口允许 apply 为空,正是为这类角色留的余地。
第三,is_backend 那段是后文要讲的后端采样的分支:如果链的前缀已经整体搬到了 GPU 上执行,CPU 端就不重复跑它们。这里先记一笔,后面专门讲。
链的生命周期由几个 API 管理,全部在 include/llama.h:
LLAMA_API struct llama_sampler * llama_sampler_chain_init(struct llama_sampler_chain_params params);LLAMA_API void llama_sampler_chain_add(struct llama_sampler * chain, struct llama_sampler * smpl);LLAMA_API struct llama_sampler * llama_sampler_chain_get(struct llama_sampler * chain, int32_t i);LLAMA_API int32_t llama_sampler_chain_n(const struct llama_sampler * chain);LLAMA_API struct llama_sampler * llama_sampler_chain_remove(struct llama_sampler * chain, int32_t i);注意 chain_add 的注释:它接管所有权,链被 free 时会把里面的采样器一起 free。所以「把采样器加进链之后再单独 free 它」是典型的双重释放 bug。这类所有权约定在 llama.cpp 的采样 API 里反复出现,读代码时必须盯着注释。
链还带一个不太显眼但很实用的字段——性能统计(见 struct llama_sampler_chain):
// timing mutable int64_t t_sample_us; mutable int32_t n_sample;t_sample_us 累计采样总耗时(微秒),n_sample 累计采样次数。配合 llama_perf_sampler_print,就能把「每一 token 的采样开销」单独打印出来。这个数字在后文讲语法采样器的开销时会用到——语法约束常常是采样阶段最重的一环,有了这个计时就能量化它到底吃掉了多少时间。
采样器的公共语言:llama_token_data_array
所有采样器不直接传 logits 数组,而是传一个结构体 llama_token_data_array(定义在 include/llama.h):
typedef struct llama_token_data { llama_token id; // token id float logit; // log-odds of the token float p; // probability of the token} llama_token_data;
typedef struct llama_token_data_array { // NOTE: this pointer can be modified by the samplers llama_token_data * data; size_t size; int64_t selected; // this is the index in the data array (i.e. not the token id) bool sorted; // note: do not assume the data is sorted - always check this flag} llama_token_data_array;四个字段各有用意,值得逐个解释:
data是一个可以被采样器修改的指针。注释写得很明确。有的采样器(比如 top-n-sigma、partial sort 路径)需要换一块缓冲区,直接改这个指针就行。size是当前候选集大小。这是最有用的字段:采样器不需要真的删除元素,只要把size改小,后面的采样器就看不到尾巴上的元素了。这就是「过滤」的实现方式——不是搬家,是改一个计数器。selected是最终选中的下标(不是 token id)。链上只有「真正做决定」的那一个采样器会写它(greedy、dist、mirostat)。写完之后,调用方读data[selected].id拿到 token。sorted是一个布尔标志,表示data当前是否已按 logit 降序排列。注释特意警告不要假定它有序。很多采样器(top-k、top-p)需要排序,但它们不假设上游排过,而是检查这个标志、必要时自己排,排完再把标志置为true,为下游省一次排序。
p 字段的存在也值得注意:logits 是 log-odds(未归一化打分),p 才是概率。有的采样器需要概率语义(top-p、min-p、typical、mirostat),有的只关心单调性(top-k)。所以链上往往会有一个「softmax 采样器」负责把 logit 填成 p,供后面的策略使用。
理解了这个结构体,就会发现一个设计上的统一:采样器的职责高度收敛为「读 cur_p,改 cur_p(改 logit、改 size、改 selected)」。这个统一是链式设计能成立的前提——所有策略共享同一种数据表示,才能任意拼接。
llama_sampler 的虚表:六个 C 函数指针
llama_sampler 本体小得出奇(include/llama.h):
struct llama_sampler { struct llama_sampler_i * iface; llama_sampler_context_t ctx;};它就是一个「虚表指针 + 私有数据指针」的组合,和 C++ 里手写的多态一模一样。虚表 llama_sampler_i 长这样:
struct llama_sampler_i { const char * (*name) (const struct llama_sampler * smpl); // can be NULL void (*accept)( struct llama_sampler * smpl, llama_token token); void (*apply) ( struct llama_sampler * smpl, llama_token_data_array * cur_p); // required void (*reset) ( struct llama_sampler * smpl); struct llama_sampler * (*clone) (const struct llama_sampler * smpl); void (*free) ( struct llama_sampler * smpl); // ... 实验性的 backend_* 函数指针见后文};只有 apply 是必需的,其余都可以为 NULL。六个方法的语义分别是:
apply:给定候选集,修改 logit、size,或写入selected。这是唯一「做实事」的方法。accept:告诉采样器「这次实际选出的 token 是它」。采样器据此更新内部历史。这是有状态采样器(重复惩罚、DRY)能工作的机制——它们必须知道真实输出序列。reset:把内部状态清空,准备开始一条新序列。多请求场景下每次新生成都要调用。clone:深拷贝。用于要复制整条链(比如给另一个序列一份独立的采样状态)时。free:释放。链析构时会调用。name:返回名字字符串,用于调试和日志。
accept 与 apply 的分离是整个设计里最关键的一步。想一下重复惩罚:它要惩罚「刚刚生成过的 token」。它必须知道刚刚生成了什么——这个信息不可能从当前这一帧的 logits 里推断出来。于是框架把「选 token」和「记住 token」拆成两件事:apply 影响分布,accept 在 token 确定后被回调,把 token 记进历史。这样任何需要历史的策略都能实现,而框架不需要为每种策略设计特殊通道。
看一个最小实现体会结构。llama_sampler_top_k 只存少量字段:
struct llama_sampler_top_k : public llama_sampler_backend { const int32_t k; const int32_t min_keep; // ... 后端相关字段};
static void llama_sampler_top_k_apply(struct llama_sampler * smpl, llama_token_data_array * cur_p) { const auto * ctx = (llama_sampler_top_k *) smpl->ctx; llama_sampler_top_k_impl(cur_p, ctx->k);}而 llama_sampler_top_k_impl 就是前面提到的「改 size」范例:
static void llama_sampler_top_k_impl(llama_token_data_array * cur_p, int32_t k) { if (k <= 0) { return; }
k = std::min(k, (int) cur_p->size);
// Sort scores in descending order if (!cur_p->sorted) { llama_token_data_array_partial_sort_inplace(cur_p, k); }
cur_p->size = k;}有几处值得细看:k <= 0 直接返回(=不启用);k 被夹到候选集大小以内;只有在未排序时才排序,而且用的是 partial_sort 而不是全排序——只需要找出前 k 大并让它们排在前面,不需要把尾巴也排好;最后一句 cur_p->size = k 就是「过滤」的全部动作。partial sort 之后会把 cur_p->sorted 置为 true,让下游免于重复排序。
partial sort 内部还藏着一个工程优化。当候选数超过 128 时,llama_token_data_array_partial_sort_inplace 不做全量排序,而是先用一个 128 个桶的直方图把 logits 按区间分桶,再只对包含第 k 名的那一个桶做 partial_sort:
static void llama_token_data_array_partial_sort( const llama_token_data_array & cur, int npartial, std::vector<llama_token_data> & res) { constexpr int nbuckets = 128; constexpr float bucket_low = -10.0f; constexpr float bucket_high = 10.0f; constexpr float bucket_scale = nbuckets/(bucket_high - bucket_low); // ...}这是典型的「用 O(n) 直方图替代 O(n log n) 排序」。词表动辄十几万,排序是采样里最常见的开销,桶化把它从「对数排序全体」降为「线性分桶 + 只排一小段」。代价是引入了 ±10 的截断范围和桶边界误差,但因为只需要保证前 k 名相对顺序正确(边界附近才需要精确排序),这个误差不影响最终结果。
一次采样的完整调用链
现在把上游接上。模型前向结束后,谁调用采样?答案是 llama_sampler_sample,它是几乎所有使用者的入口(src/llama-sampler.cpp):
llama_token llama_sampler_sample(struct llama_sampler * smpl, struct llama_context * ctx, int32_t idx) { const llama_token sampled_token = llama_get_sampled_token_ith (ctx, idx); // ... // If a backend sampler has already sampled a token, return it. if (sampled_token != LLAMA_TOKEN_NULL) { llama_sampler_accept(smpl, sampled_token); return sampled_token; }
// ... 从 ctx 取出 logits,填充 cur llama_token_data_array cur_p = { /* .data = */ cur.data(), /* .size = */ cur.size(), /* .selected = */ -1, /* .sorted = */ false, };
llama_sampler_apply(smpl, &cur_p);
GGML_ASSERT(cur_p.selected >= 0 && cur_p.selected < (int32_t) cur_p.size);
auto token = cur_p.data[cur_p.selected].id;
llama_sampler_accept(smpl, token);
return token;}这段函数把采样子系统的使用约定完整暴露了出来:
第一,开头那段「后端采样器已经选好了就直接返回」是 GPU 采样的快速路径。如果采样在设备上已经完成,CPU 只需要 accept 一下把 token 记进历史,不做任何计算。
第二,cur 的填充有三条分支,对应三种数据来源:设备已经算好 probs 的(同时拿到 id、logit、p);只有 logits 的(p 先填 0);以及最传统的「把整个词表的 logits 拷成 llama_token_data 数组」。第三种会构造 n_vocab 个条目——十几万个元素,是 llama.cpp 里少数会碰整词表的路径之一。
第三,cur 用的是链上预分配的缓冲区 chain->cur,而不是每次新申请:
if (smpl->iface == &llama_sampler_chain_i) { auto * chain = (llama_sampler_chain *) smpl->ctx; cur_ptr = &chain->cur; } else { cur_ptr = &cur_local; }采样是逐 token 高频调用的路径,每次 new 一个十几万元素的 vector 会非常痛;复用链上的 cur 避免了这笔分配开销。如果传进来的不是链而是一个单独采样器,则退化成局部临时 vector。
第四,selected 初始化为 -1,apply 跑完后 GGML_ASSERT 强制它落在合法范围。这是一条契约断言:任何做决定的采样器都必须写 selected,否则直接断言失败而不是返回垃圾 token。
再往上,是 llama_context 侧的封装。llama_context::sampling 结构体(src/llama-context.h)按序列 ID 保存采样器:
struct sampling_info { // !samplers.empty() to check if any samplers are active std::map<llama_seq_id, llama_sampler *> samplers;
buffer_view<float> logits = {nullptr, 0}; buffer_view<llama_token> sampled = {nullptr, 0}; buffer_view<float> probs = {nullptr, 0}; buffer_view<llama_token> candidates = {nullptr, 0}; // ... };注意 samplers 是一个 seq_id 到采样器的映射。这直接回答了「多序列并发怎么办」:每条序列有自己的采样器实例(或至少是独立状态),历史互不干扰。这也解释了为什么 clone 方法必不可少——当一个请求被复制成多个候选序列时(比如并行采样),需要把采样状态一并复制,而不是共享。
筛选型采样器:把候选集切小
链上第一大类采样器只做「砍候选集」这件事,不引入随机性。它们按顺序把不该出现的 token 逐层剔掉,为最后的「真正采样」缩小范围。
top-k 上一节已经看过,按 logit 保留前 k 个。它简单有效,但有个缺陷:不管分布是尖锐还是平坦,都固定保留 k 个。
top-p(nucleus sampling,核采样)解决这个问题。它不固定个数,而是固定「累积概率质量」:按 logit 降序累加概率,累到超过 p 就停。核心实现:
static void llama_sampler_top_p_apply(struct llama_sampler * smpl, llama_token_data_array * cur_p) { auto * ctx = (llama_sampler_top_p *) smpl->ctx;
if (ctx->p >= 1.0f) { return; }
llama_sampler_softmax_impl(cur_p, false); // 需要真实的概率
size_t k = cur_p->size; auto * pdata = cur_p->data; auto & buf_sort = ctx->buf_sort;
// if not sorted, try adaptive top-k sorting if (!cur_p->sorted && cur_p->size > 1024) { k = std::min<size_t>(256, cur_p->size); llama_token_data_array_partial_sort(*cur_p, k, buf_sort); pdata = buf_sort.data(); } else if (!cur_p->sorted) { llama_token_data_array_partial_sort_inplace(cur_p, k); }
float cum_sum = 0.0f; size_t last_idx = cur_p->size;
for (size_t i = 0; i < cur_p->size; ++i) { cum_sum += pdata[i].p; if (cum_sum >= ctx->p && i + 1 >= ctx->min_keep) { last_idx = i + 1; break; } // we exceeded the current top-k heuristic -> increase k and continue if (!cur_p->sorted && i == k - 1) { k = cur_p->size; llama_token_data_array_partial_sort(*cur_p, k, buf_sort); pdata = buf_sort.data(); } }
if (!cur_p->sorted) { std::copy(buf_sort.data(), buf_sort.data() + last_idx, cur_p->data); cur_p->sorted = true; }
cur_p->size = last_idx;}三个设计点:
为什么要先 softmax? 因为 top-p 的判据是「累积概率」,必须把 logits 变成概率。llama_sampler_softmax_impl 内部用「先减去最大值」防止指数溢出(数值稳定的标准做法),再算指数和归一化。
min_keep 是什么? 它是「至少保留几个」。如果分布极其尖锐,累积概率可能在第 1 个 token 就超过 p,此时若只有 min_keep=1 就会只剩一个候选,采样退化成贪心。min_keep 给了下限,保证候选集不至于退化。
那个「自适应 top-k」的 256 是什么? 这是性能与正确性的折中。当候选数超过 1024 时全排序太贵,于是先猜「大概前 256 个就够了」,只排前 256;然后开始累加,如果累到 256 个还没达到 p,说明猜小了,立刻把 k 扩到全体重排(正是 if (!cur_p->sorted && i == k - 1) 那个分支)。绝大多数情况下分布是尖锐的,256 一次就中,避免了全排序。
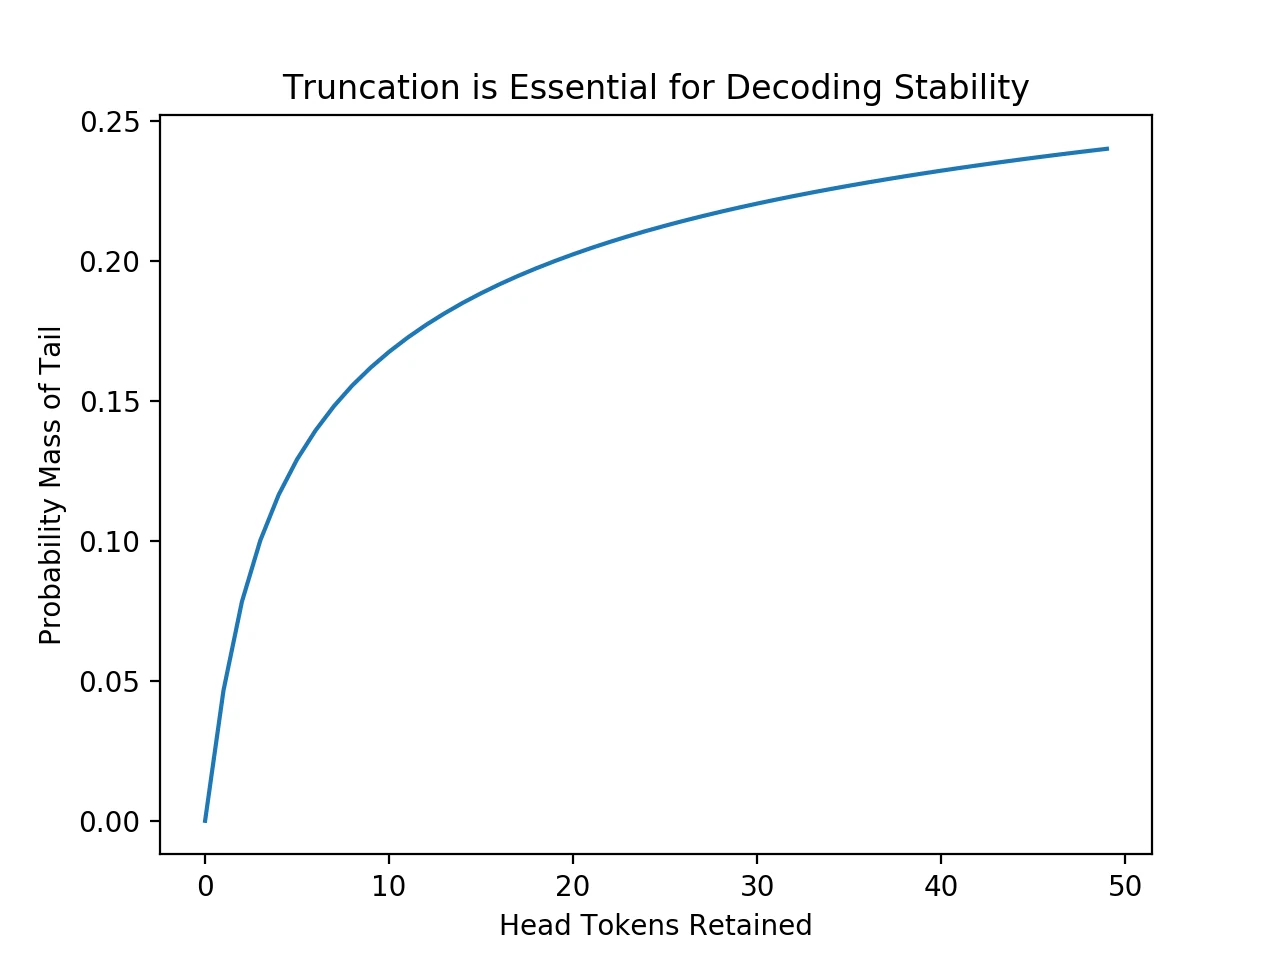
top-p 的动机值得补一张图。下图(来源:The Curious Case of Neural Text Degeneration,arXiv:1904.09751)画的是「只保留概率最高的前 x 个 token 时,被丢掉的尾部累积了多少概率质量」。曲线显示:只需要保留很少的头部 token,尾部剩下的概率质量就已经微不足道——这正是「按累积概率截断」而不是「按固定个数截断」的依据。固定 top-k 的毛病就在于,分布越平坦它砍得越不准,而 top-p 用「质量阈值」自适应了这个形状。
同一篇论文还给出了一张分布形状对比(宽分布 vs. 窄分布):
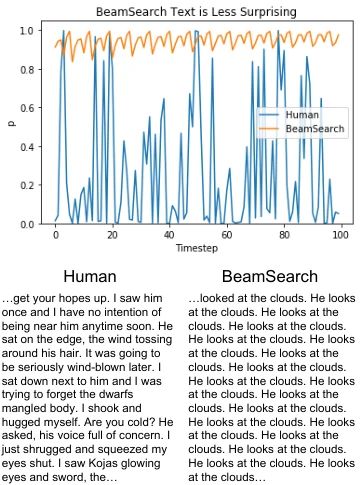
宽分布意味着有大量 token 各占一部分概率质量,窄分布则集中在极少数 token 上。同一个固定的 k 在这两种情况下显然不该等价——这也是 top-p / min-p 这类「按质量而非个数」的采样器存在的理由。min-p 更进一步:它用「最大概率的倍数」做门槛,让阈值随着分布尖锐程度自动伸缩。
min-p 的规则更简单:只保留 p >= min_p * max_p 的 token,即概率不低于「最大概率的 min_p 倍」的候选。它的过滤强度随分布尖锐程度自动调节:分布越尖锐(max_p 越大),门槛越高,砍得越狠;分布越平坦,门槛越低,保留越多。这是它相比固定 top-p 常被认为更鲁棒的原因。
typical sampling(llama_sampler_typical_apply)走的是另一条路,基于信息量而非概率大小。直觉是:自然语言里每个 token 的信息量该落在「典型」范围内——既不该总是最可预测的那个,也不该总选最意外的那个。它最小化每个候选的信息量与分布熵之差:
保留 score 最小的那批、直到累积概率达到 p。top-p 关心「概率质量」,typical 关心「信息量是否典型」。
top-n-sigma(llama_sampler_top_n_sigma_apply,来自论文 “Top-nσ: Not All Logits Are You Need”)是较新的一类:先对 logits 求均值和标准差,
然后只保留 logit > n * σ 的候选,其余置为 。它的作者观察到 logits 分布近似高斯,绝大多数 token 落在 附近属于「噪声区」,真正有意义的是远超 的尾部。相比 top-k/top-p,这个规则不依赖排序,是一个纯线性扫描,因此更适合搬到 GPU 上并行执行——后文讲后端采样时会再呼应。
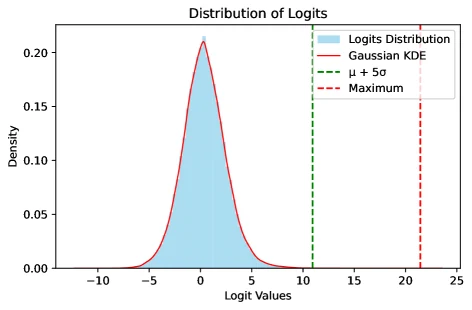
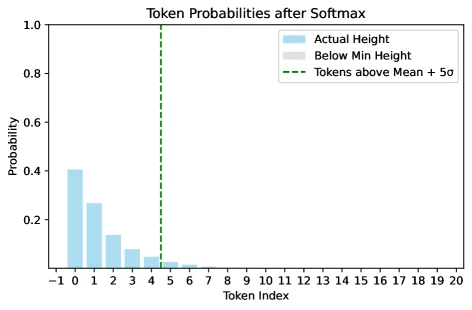
上图(来源:Top-nσ 论文,arXiv:2411.07641)左图是原始 logits 分布,右图是按概率降序排列后只显示前 20 个 token 的结果。可以看到尾部 token 的概率迅速压到极小——这正是各种「砍尾巴」策略的物理依据:尾巴上的候选加起来概率质量微乎其微,砍掉它们对分布形状几乎没有影响,却能把候选集从十几万缩到几十个。
第二张图(同源)给出 σ 距离与核大小在生成过程中的关系:σ 距离大(分布分散)时核小,σ 距离小(分布集中)时核大,两者呈反比。这解释了为什么基于 σ 的截断能自适应分布形状——它不需要用户手工调 k,而是跟着分布的统计量走。
分布重塑与随机源:temp、dist 与 mirostat
筛选型采样器只砍候选集,不改变保留下来的相对关系。第二类采样器则重塑分布本身或在其中做出随机选择。
temperature 是最简单的一种重塑。它的逻辑一行就够:把每个 logit 除以温度 t。
static void llama_sampler_temp_apply(struct llama_sampler * smpl, llama_token_data_array * cur_p) { const auto * ctx = (llama_sampler_temp *) smpl->ctx; llama_sampler_temp_impl(cur_p, ctx->temp);}
static void llama_sampler_temp_impl(llama_token_data_array * cur_p, float temp) { if (cur_p->size == 0) { return; }
if (temp <= 0.0f) { // find the token with the highest logit and set the rest to -inf size_t max_i = 0; float max_l = cur_p->data[0].logit; for (size_t i = 1; i < cur_p->size; ++i) { if (cur_p->data[i].logit > max_l) { cur_p->data[max_i].logit = -INFINITY; max_i = i; max_l = cur_p->data[i].logit; } else { cur_p->data[i].logit = -INFINITY; } } return; }
for (size_t i = 0; i < cur_p->size; ++i) { cur_p->data[i].logit /= temp; }}为什么「除以温度」就能调节随机性?因为在 softmax 之后,logit 差被放大 倍。 小 → 差距放大 → 分布更尖锐 → 更接近贪心; 大 → 差距缩小 → 分布更平坦 → 更随机。温度并不改变谁的排名,只改变「第一名领先多少」。这正是它和 top-k/top-p 的分工:温度调「整体有多尖」,top-k/top-p 调「切在哪」。
temp <= 0 的分支直接退化成 argmax(保留最大 logit,其余置 ),注意它的实现是「边扫描边把旧的最大值置 」,一次遍历完成。
dist(distribution sampling)是真正做出随机选择的地方,也是链上最后那个「做决定」的采样器:
static void llama_sampler_dist_apply(struct llama_sampler * smpl, llama_token_data_array * cur_p) { auto * ctx = (llama_sampler_dist *) smpl->ctx;
llama_sampler_softmax_impl(cur_p, false);
const int idx = llama_sample_dist(cur_p, ctx->rng);
cur_p->selected = idx;}它先 softmax 得到概率,然后按概率用 std::discrete_distribution 抽一个下标,写入 selected。llama_sample_dist 的实现里有个精巧点——它把 data[i].p 包装成一个自定义迭代器喂给标准库的离散分布:
struct probs_iterator { const llama_token_data * data; bool operator==(const probs_iterator & other) const { return data == other.data; } const float & operator*() const { return data->p; } probs_iterator & operator++() { ++data; return *this; } // ... };
std::discrete_distribution<int> dist(probs_iterator{cur_p->data}, probs_iterator{cur_p->data + cur_p->size}); return dist(rng);这样不用把概率另拷一份数组,直接对候选集做惰性迭代,标准库负责累积和二分查找。随机源是 std::mt19937。
greedy 是 dist 的退化版本——不采样,直接取 selected = 0(因为候选集已按 logit 降序,第 0 个就是最大者)。
mirostat(llama_sampler_mirostat_v2,来自论文 arXiv:2007.14966)是一类完全不同的思路:不设温度、不设 top-k,而是给生成的「惊讶程度」定一个目标值 ,然后动态调整截断阈值去逼近它。它维护一个可变的阈值 mu,用「观测到的惊讶程度」与目标 tau 的误差来更新:
static void llama_sampler_mirostat_v2_apply(struct llama_sampler * smpl, llama_token_data_array * cur_p) { auto * ctx = (llama_sampler_mirostat_v2 *) smpl->ctx;
llama_sampler_softmax_impl(cur_p, true);
// Truncate the words with surprise values greater than mu cur_p->size = std::distance(cur_p->data, std::find_if(cur_p->data, cur_p->data + cur_p->size, [&](const llama_token_data & candidate) { return -log2f(candidate.p) > ctx->mu; }));
if (cur_p->size == 0) { cur_p->size = 1; }
// Normalize the probabilities of the remaining words llama_sampler_softmax_impl(cur_p, true);
const int idx = llama_sample_dist(cur_p, ctx->rng); cur_p->selected = idx;
float observed_surprise = -log2f(cur_p->data[idx].p); float e = observed_surprise - ctx->tau;
// Update mu using the learning rate and error ctx->mu = ctx->mu - ctx->eta * e;}逐个符号解释:
- 惊讶程度(surprise)定义为 ,单位是比特。一个概率 的 token 惊讶度是 1 bit, 的 token 惊讶度约 10 bit。这是信息论里自信息的定义。
mu是当前的惊讶度上限:只保留惊讶度不超过mu的 token(即 )。tau是目标惊讶度。用户说「我希望平均每个 token 的惊讶度是 比特」。eta是学习率,控制mu更新的快慢。- 每采样一个 token,算出它的实际惊讶度
observed_surprise,误差e = observed_surprise - tau就是「比目标更惊讶还是更平淡」。如果实际比目标更惊讶(),就把mu调小(更严格地截断);反之调大。这是一个负反馈闭环,用梯度下降的形式把长期平均惊讶度推向tau。 mu初值设为 (在reset里),给一个宽松的起点。
为什么需要 mirostat?因为 temperature 和 top-k/top-p 都是静态的——无论分布为什么形状,都用同一套参数。mirostat 让「随机性的强弱」变成一个闭环反馈量,对分布形状变化更稳。它的代价是需要维护状态(mu 和 rng),并且必须放在链的最末端(因为它自己完成「选 token」这一步,和 dist/greedy 抢同一个位置)。这一点在源码注释里也明确写着:adaptive-p 这类「直接选 token」的采样器「must be last in the sampler chain (like mirostat, dist, greedy)」。
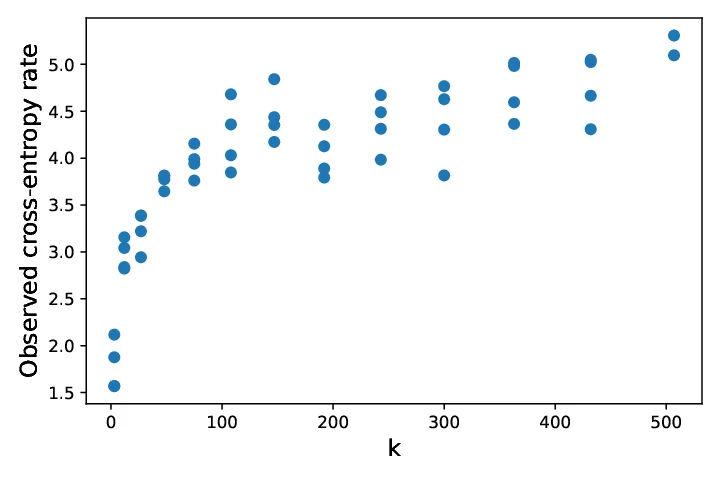
上图(来源:Mirostat 论文,arXiv:2007.14966)展示了惊讶度与截断词表大小的关系:给定一个 mu 阈值,词表被切成「惊讶度可接受」和「过于惊讶」两半。mu 越小,保留的 token 越少;mirostat 的动态更新就是在生成过程中让这个切点随分布漂移。
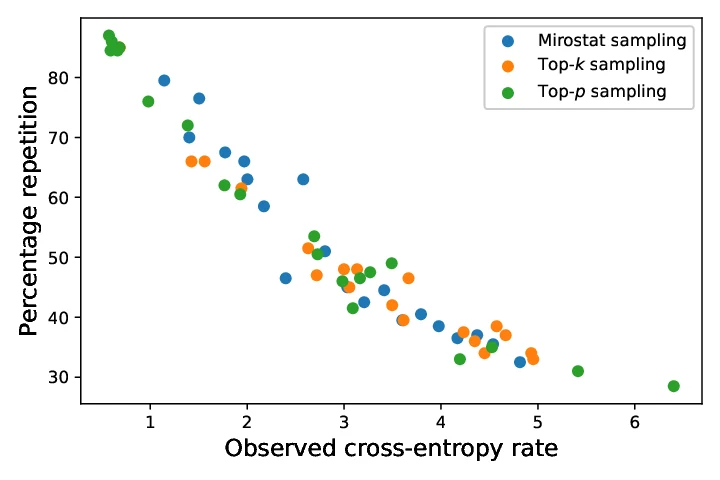
这张对比图(同源)给出各采样方法在重复率上的差异。mirostat 的设计目标之一正是缓解「循环重复」,它通过持续压制过于意想不到的 token 来避免模型陷入发散和重复的两极。
历史感知采样器:重复惩罚与 DRY
第三类采样器需要读历史,靠 accept 累积的状态来改分布。它们的存在是为了解决大模型最顽固的一个退化现象:重复。
penalties(llama_sampler_penalties)同时实现三种惩罚,由三个参数控制(src/llama-sampler.cpp):
struct llama_sampler_penalties : public llama_sampler_backend { const int32_t n_vocab; const int32_t penalty_last_n; const float penalty_repeat; const float penalty_freq; const float penalty_present;
ring_buffer<llama_token> prev;
// a frequency map to count token occurrences std::unordered_map<llama_token, int> token_count; // ...};三种惩罚落在同一个 apply 循环里:
static void llama_sampler_penalties_apply(struct llama_sampler * smpl, llama_token_data_array * cur_p) { auto * ctx = (llama_sampler_penalties *) smpl->ctx;
if (ctx->is_disabled()) { return; }
for (size_t i = 0; i < cur_p->size; ++i) { const auto token_iter = ctx->token_count.find(cur_p->data[i].id); if (token_iter == ctx->token_count.end()) { continue; }
const int count = token_iter->second;
// 乘而不是除:论文里用除法,但会让负 logit 的 token 变得更可能,这是常见修正 if (cur_p->data[i].logit <= 0) { cur_p->data[i].logit *= ctx->penalty_repeat; } else { cur_p->data[i].logit /= ctx->penalty_repeat; }
cur_p->data[i].logit -= float(count) * ctx->penalty_freq + float(count > 0) * ctx->penalty_present; }
cur_p->sorted = false;}三种惩罚分别是:
- 重复惩罚(
penalty_repeat):对出现过的 token,正 logit 除以系数、非正 logit 乘以系数。源码注释里那条「为什么不用除法」值得注意——原始论文的写法是统一除以系数,但如果 logit 是负数,除以一个大于 1 的数会让它「变大」(更接近 0),反而提升了该 token 的概率,与惩罚意图相反。llama.cpp 的修正就是按符号分情况处理,保证任何符号下都是「往更不可能的方向推」。 - 频率惩罚(
penalty_freq):减去count * freq,出现次数越多扣得越多,是线性惩罚。 - 存在惩罚(
penalty_present):只要出现过(count > 0)就扣一个固定量,不加倍。它只惩罚「出现过」这个事实,不关心次数。
三种惩罚需要每个 token 在窗口内的出现次数。这就是 token_count 和 prev 的组合:prev 是一个固定容量的环形缓冲区(ring_buffer<llama_token>),只保留最近 penalty_last_n 个 token;token_count 是一张频率表。accept 时向 prev 推入新 token 并给计数 +1,同时如果缓冲区满了,把被挤出的最老 token 计数 −1、归零时从表里删除:
static void llama_sampler_penalties_accept(struct llama_sampler * smpl, llama_token token) { auto * ctx = (llama_sampler_penalties *) smpl->ctx; if (ctx->penalty_last_n == 0) { return; }
ctx->token_count[token]++;
// if the ring buffer is full, remove the oldest token if (ctx->prev.size() >= (size_t) ctx->penalty_last_n) { const auto old = ctx->prev.front();
ctx->token_count[old]--; if (ctx->token_count[old] == 0) { ctx->token_count.erase(old); } }
ctx->prev.push_back(token);}用环形缓冲区 + 频率表而不用「每次遍历窗口重算」,是因为 apply 是逐 token 高频调用的热路径;把「滑动窗口频率」做成增量更新,apply 阶段就只需要一次哈希查找。ring_buffer 本身的实现(文件开头)是一个固定容量、逻辑环形、支持 rat(i) 反向索引的容器——注释里直说它「works similarly to std::deque, but with a fixed capacity」。用固定容量是为了避免动态扩容,也是逐 token 路径上的一贯取舍。
注意最后那句 cur_p->sorted = false。惩罚改动了 logit 值,原先的排序就失效了,必须把这个标志清掉,让下游知道「数据已经乱了,你要排序得自己排」。这是链上所有「改 logit」的采样器都遵守的纪律。
DRY(Don’t Repeat Yourself,llama_sampler_dry)是惩罚的「进阶版」,思想完全不同。它不是按 token 出现频率惩罚,而是检测重复的子串序列——如果你之前说过「abcde」,那么当模型又要开始说「abc」时,就在说「d」这一步重罚。它与「重复惩罚」的关键区别是:重复惩罚惩罚单个 token,DRY 惩罚序列模式。
它的状态比 penalties 更复杂:
struct llama_sampler_dry { const float dry_multiplier; const float dry_base; const int32_t dry_allowed_length; const int32_t dry_penalty_last_n;
std::unordered_multimap<llama_token, std::vector<llama_token>> dry_processed_breakers; std::vector<int> dry_repeat_count; std::unordered_map<llama_token, int> dry_max_token_repeat; ring_buffer<llama_token> last_tokens;};四个参数的含义:
dry_multiplier:惩罚强度的乘子,0 表示禁用。dry_base:惩罚的指数底数。这是 DRY 的核心设计——匹配到的重复串越长,惩罚越重,而且是指数级增长的。重复长度 对应的惩罚约为multiplier * base^(L - allowed_length)。底数大于 1,所以长重复受到的惩罚爆炸式增长。dry_allowed_length:允许重复的长度下限。短于它的重复(比如常见的「的」「了」)不惩罚。dry_penalty_last_n:只看最近多少个 token 的历史。
DRY 还有一个容易忽略但很重要的设计——断点序列(seq_breakers,默认包括 \n、:、" 等)。它的作用是把历史切成若干「段」,重复检测只在每一段内部进行,不跨越断点。为什么?因为文本结构上,跨过换行或冒号的「重复」往往不是真的退化——比如两行都以「- 」开头是正常的列表格式,不该被判为重复。断点序列就是给这些结构性的重复开一个后门,避免误伤。这在代码生成、Markdown 生成场景里尤其重要。
dry_repeat_count 逐个 token 记录「当前 token 是历史的多少长重复的延续」,dry_max_token_repeat 记录每个 token 上见过的最长重复长度;apply 时据此对相应 token 施加指数惩罚。get_overlapping_token_sequences 那个函数负责一个分词层面的细节:同一个字符串可能被切成不同边界,所以要把「与历史末尾匹配的各 tokenization」全部枚举出来,避免因为分词边界不同而漏检重复。
DRY 的实现从 Koboldcpp 移植而来(源码注释给出了原始 PR 链接),这也反映了 llama.cpp 采样生态的一个特点:很多采样策略先在社区工具里诞生,再被上游吸收。
除了这两个,llama.cpp 还有几个更专门的采样器值得一提。XTC(llama_sampler_xtc)做的是「排除 top 候选」——它以一定概率把概率最高的那个 token 从候选集里拿掉,逼模型不要总是选最保险的词,常用于创意写作场景。logit_bias(llama_sampler_logit_bias)允许用户对指定 token 直接加减一个常数 logit,是最直接的干预手段,结构化输出、禁词过滤都靠它。infill(llama_sampler_infill)则是为 FIM(fill-in-the-middle,代码补全)设计的特殊采样器,它的注释里给出了准确规则:把同一前缀的不同候选的概率合并、按 EOG 概率决定是否收尾,专门服务于「在中间填空」这种非自回归续写的场景。
这一整类采样器共同的工程含义是:它们都带状态,所以都必须是「每序列一份」。这也回到了 sampling_info::samplers 那个 seq_id → sampler 映射的必要性——重复历史是序列私有的,绝不能跨请求共享。
GBNF 语法采样器:把语法编译成状态机
前面所有采样器处理的都是「概率」,而语法采样器处理的是一套完全不同的东西:形式语言。它的目标不是调整概率,而是把「结构上非法的 token」直接判死,使得输出一定符合给定语法——比如一定是一段合法 JSON、一个符合 schema 的工具调用参数。
llama.cpp 用 GBNF(GGML BNF)来描述语法,格式类似 BNF 范式。一个最小例子:
root ::= objectobject ::= "{" ws pair ("," ws pair)* "}" wspair ::= string ":" ws valuevalue ::= string | number | "true" | "false" | "null"这套语法在采样阶段怎么用?核心思路是:把语法编译成一个「下推自动机」(pushdown automaton),用栈来表示「当前允许哪些后续字符」,然后逐个候选 token 判断它能不能被接受。 能接受的保留,不能接受的置为 。
语法的内部表示
语法在内存里被编译成一组规则(rule),每条规则是一串 llama_grammar_element(src/llama-grammar.h):
enum llama_gretype { LLAMA_GRETYPE_END = 0, // 规则定义结束 LLAMA_GRETYPE_ALT = 1, // 备选分支开始 LLAMA_GRETYPE_RULE_REF = 2, // 引用另一条规则(非终结符) LLAMA_GRETYPE_CHAR = 3, // 匹配一个字符 LLAMA_GRETYPE_CHAR_NOT = 4, // 反向匹配:[^a] LLAMA_GRETYPE_CHAR_RNG_UPPER = 5, // 字符范围上界:[a-z] LLAMA_GRETYPE_CHAR_ALT = 6, // 字符备选:[ab] LLAMA_GRETYPE_CHAR_ANY = 7, // 任意字符 . LLAMA_GRETYPE_TOKEN = 8, // 匹配指定 token <[id]> LLAMA_GRETYPE_TOKEN_NOT = 9, // 反向匹配指定 token};这个枚举是整个语法系统的「指令集」。一条规则就是一个元素数组,用 END 和 ALT 分隔各备选分支。这里最需要留意的是最后两个:LLAMA_GRETYPE_TOKEN 和 LLAMA_GRETYPE_TOKEN_NOT——语法可以直接引用具体的 token id,而不只是字符。这是为了处理「一个 token 就是一个不可分割整体」的情形(比如特殊控制 token),字符级的匹配在分词层面可能根本对不上。
下推栈:为什么是栈而不是状态号
一个有趣的设计选择:llama.cpp 的语法状态不用「整数状态号」,而是用栈表示:
using llama_grammar_rule = std::vector< llama_grammar_element>;using llama_grammar_stack = std::vector<const llama_grammar_element *>;
using llama_grammar_rules = std::vector<llama_grammar_rule>;using llama_grammar_stacks = std::vector<llama_grammar_stack>;llama_grammar_stack 里放的是指向规则元素的指针,栈顶是「当前正在等待的元素」。为什么用指针栈而不是状态号?因为 BNF 语法天然是递归的——value 里可以嵌套 object,object 里又可以嵌套 value。用栈,递归就变成了「压栈」;用有限状态号,就得把整个递归展开成显式状态,状态数会爆炸。栈是处理递归文法的标准做法,代价是状态比较需要按指针内容而不是整数比较。
栈的推进逻辑在 llama_grammar_advance_stack:给定一个栈,如果栈顶是 RULE_REF,就把被引用规则的第一个元素入栈(相当于「进入子规则」),并且把所有备选分支都展开成一棵待探索的栈集合;如果栈顶是字符类元素,就把它作为一个「可停留的栈」收进结果。函数内部用 std::set 去重,避免同一栈反复探索。
初始化时,llama_grammar_init_impl 会对起始符号调用 advance_stack,得到一组初始栈。之所以是一组不是单个,是因为 BNF 的备选分支(a | b)天然对应多条可能的解析路径,自动机必须同时维护它们。这也解释了为什么所有栈相关结构都是复数 stacks。
逐候选 token 判定
apply 的实现(src/llama-grammar.cpp)是这一节的核心:
void llama_grammar_apply_impl(const struct llama_grammar & grammar, llama_token_data_array * cur_p) { GGML_ASSERT(grammar.vocab != nullptr);
if (grammar.awaiting_trigger) { return; // 惰性语法:还没触发,不约束 }
bool allow_eog = false; for (const auto & stack : grammar.stacks) { if (stack.empty()) { // 栈空 = 语法已完整匹配,可以结束了 allow_eog = true; break; } }
std::vector<std::pair<std::vector<uint32_t>, llama_partial_utf8>> candidates_decoded; candidates_decoded.reserve(cur_p->size);
llama_grammar_candidates candidates_grammar; candidates_grammar.reserve(cur_p->size);
for (size_t i = 0; i < cur_p->size; ++i) { const llama_token id = cur_p->data[i].id; const std::string & piece = grammar.vocab->token_to_piece(id);
if (grammar.vocab->is_eog(id)) { if (!allow_eog) { cur_p->data[i].logit = -INFINITY; // 语法没结束,不许输出结束符 } } else if (piece.empty() || piece[0] == 0) { cur_p->data[i].logit = -INFINITY; // 空 piece / 特殊 token,直接禁 } else { candidates_decoded.push_back(decode_utf8(piece, grammar.partial_utf8)); candidates_grammar.push_back({ i, candidates_decoded.back().first.data(), candidates_decoded.back().second, id }); } }
const auto rejects = llama_grammar_reject_candidates(grammar.rules, grammar.stacks, candidates_grammar); for (const auto & reject : rejects) { cur_p->data[reject.index].logit = -INFINITY; }}这段代码里有几个非常关键的设计点,逐一拆开:
为什么要 decode_utf8? 因为语法是按 Unicode 码点定义的,而 token 的 piece 是字节串。一个中文 token 可能是多个字节、一个码点;一个 token 也可能只切到某个码点的中间几个字节(分词边界和字符边界不重合)。所以必须把 token 的字节串解码成码点序列。decode_utf8 返回一对值:完整的码点列表,和一个 llama_partial_utf8——后者记录「这个 token 末尾那个没解码完的码点,已经攒了多少位、还差几个字节」。这个部分状态会传给下一个 token 继续拼接。这就是 llama_partial_utf8 存在的理由:
struct llama_partial_utf8 { uint32_t value; // bit value so far (unshifted) int n_remain; // num bytes remaining; -1 indicates invalid sequence};为什么 EOG 要特别处理? EOG(end of generation)是「结束生成」的特殊 token,它的 piece 通常为空。如果语法允许结束(存在空栈),EOG 就保留;否则置为 强制模型继续按语法走。这就是「强制模型把 JSON 补完整」的实现机制——只要 JSON 还没闭合,模型就不被允许停下。
为什么空 piece 直接禁掉? 那些 piece 为空或首字节为 0 的 token 是控制类 token,它们不构成语法字符,放行会让语法状态机和实际输出脱节。
reject_candidates 的叠加语义:注意它是「对所有栈求交集」——
static llama_grammar_candidates llama_grammar_reject_candidates( const llama_grammar_rules & rules, const llama_grammar_stacks & stacks, const llama_grammar_candidates & candidates) { if (candidates.empty()) { return {}; }
auto rejects = llama_grammar_reject_candidates_for_stack(rules, stacks.front(), candidates);
for (size_t i = 1, size = stacks.size(); i < size; ++i) { rejects = llama_grammar_reject_candidates_for_stack(rules, stacks[i], rejects); }
return rejects;}这是「交替分支」的正确语义:一个候选 token 只有在所有可能的解析路径都拒绝它时才被砍掉。只要有一条路径能接受它,就必须保留。如果这里写成求并集,会过度砍杀、导致语法明明可满足却产生空候选集。
接受一个 token:状态如何推进
选定 token 之后,accept 负责推进状态机。它比 apply 更绕,因为要处理两件事:惰性语法的触发,和 token 内部多个码点的逐个推进。
void llama_grammar_accept_impl(struct llama_grammar & grammar, llama_token token) { const auto & piece = grammar.vocab->token_to_piece(token);
if (grammar.awaiting_trigger) { // ... 惰性语法:先缓冲输出,直到触发词/触发模式命中, // 命中后把缓冲里重叠的部分 replay 进语法 // ... return; }
if (grammar.vocab->is_eog(token)) { for (const auto & stack : grammar.stacks) { if (stack.empty()) { return; // 语法已完整结束,正常退出 } } GGML_ABORT("fatal error"); }
llama_grammar_accept_token(grammar, token, piece);}末尾那个 GGML_ABORT 是一个「不该发生」的断言:如果 EOG 被接受了,而语法栈却不是空的,说明前面某处约束被绕过——这是内部一致性检查,宁可崩也不静默产生非法输出。
llama_grammar_accept_token 才是真正的状态推进:把 piece 解码成码点,然后对每个码点调用 llama_grammar_accept_chr,逐个字符推进栈;推进方式是把「当前栈」替换成「接受了这个字符后的新栈集合」。它的内部逻辑与 advance_stack 配合:先匹配栈顶字符类元素,再 advance_stack 展开后续的 RULE_REF。
惰性语法:只在需要时约束
默认语法从第一个 token 就开始约束。但很多场景下这是有害的——比如让模型先自由地思考(输出解释文字),只有在它开始写 JSON 时才施加 JSON 语法约束。这就是惰性语法(lazy grammar)的用途。llama.cpp 提供 llama_sampler_init_grammar_lazy_patterns:
LLAMA_API struct llama_sampler * llama_sampler_init_grammar_lazy_patterns( const struct llama_vocab * vocab, const char * grammar_str, const char * grammar_root, const char ** trigger_patterns, size_t num_trigger_patterns, const llama_token * trigger_tokens, size_t num_trigger_tokens);它的状态在 struct llama_grammar 里:
// lazy grammars wait for trigger words or tokens before constraining the sampling. bool lazy = false; bool awaiting_trigger = false; // Initialized to true for lazy grammars only std::string trigger_buffer; // Output buffered by lazy grammar. Cleared once trigger is found. std::vector<token_pos> trigger_buffer_positions; // Tokens buffered by lazy grammar. Replayed when a trigger is found. std::vector<llama_token> trigger_tokens; std::vector<llama_grammar_trigger_pattern> trigger_patterns;机制是:awaiting_trigger 为真时,apply 直接返回不做任何约束(模型自由生成);同时所有输出被缓冲进 trigger_buffer,并记下每个 token 在缓冲里占据的区间(trigger_buffer_positions)。一旦某个触发 token 或触发正则命中:
for (const auto & trigger_pattern : grammar.trigger_patterns) { auto start = trigger_pattern.find(grammar.trigger_buffer); if (start != std::string::npos) { grammar.awaiting_trigger = false;
// replay tokens that overlap with [start, end) for (const auto & [tok, tok_pos] : grammar.trigger_buffer_positions) { auto [tok_start, tok_end] = tok_pos; if (tok_end <= start) { continue; } size_t piece_start = (tok_start < start) ? start : tok_start; size_t piece_len = tok_end - piece_start; auto tok_piece = grammar.trigger_buffer.substr(piece_start, piece_len); llama_grammar_accept_token(grammar, tok, tok_piece); } // ... } }注意那个 replay 循环的细节:触发可能发生在某个 token 的中间(一个 token 的 piece 里既包含触发前的内容也包含触发后的),所以它用 piece_start 做了部分切分,只把触发点之后的部分喂进语法。这个「部分 token」的处理是惰性语法实现里最容易出 bug 的地方,源码用一个显式的区间裁剪来解决。
惰性语法对工具调用(tool call)尤其重要:tool_choice=required 这类语义要求模型必须先输出一定内容、然后在特定位置开始受约束地输出参数——这正是「触发 + 约束」两段式语法要表达的。这部分与 vLLM/SGLang 里基于 xgrammar 的结构化输出思路可以对照,可参考 vLLM 源码完全拆解(十四):结构化输出——FSM 编译、语法 bitmask 与受限采样 与 SGLang 源码完全拆解(十):Sampling、Grammar 与结构化输出。
左递归检测
GBNF 不支持左递归(会导致 advance_stack 无限展开),所以解析时会主动检测并报错。llama_grammar_detect_left_recursion 用典型的「白灰黑」三色标记做 DFS:
static bool llama_grammar_detect_left_recursion( const llama_grammar_rules & rules, size_t rule_index, std::vector<bool> * rules_visited, std::vector<bool> * rules_in_progress, std::vector<bool> * rules_may_be_empty) { if ((*rules_in_progress)[rule_index]) { return true; // 灰节点再次被访问 = 环 } (*rules_in_progress)[rule_index] = true; // ...}它比朴素的三色标记多一层:还要判断某条规则是否可能推导出空串(rules_may_be_empty)。因为「A ::= B A」如果 B 能推出空串,就等价于左递归,同样会死循环。这个检测把这种间接的、经由空串的左递归也抓出来。语法用户在写递归规则(比如 JSON 的嵌套)时如果报左递归错误,根因就在这里。
语法与链的交互:位置与开销
语法采样器在链上的位置不是随意的。它有两类正当位置,语义不同:
放在链的前段(在 top-k/top-p 之前)。此时语法先于一切过滤生效,它会把所有非法 token 置为 。这看起来最正确,但有个性能问题:语法采样器必须遍历整个候选集(可能十几万条),对每条调 token_to_piece 并解码 UTF-8。这是链上最重的单步——它是个 O(候选数) 的字符级操作,而 top-k 是一个 O(n) 分桶。
放在链的后段(在 top-k/top-p 之后)。此时前面已经把候选集砍到几十个,语法只需要处理这些。快得多,但有正确性风险:如果被砍掉的 token 里包含「语法上唯一可行」的那些,就会产生空候选集。实践中因为分布尖锐、合法 token 通常都在前面,这个风险不大,但不能完全忽略。
llama.cpp 在 common/sampling.cpp 里的做法是把语法放在链的最前面(在 logit_bias 之后、DRY/penalties 之前),并提供了 n_grammar_first 之类的排序控制,让使用者可以在两种取舍间选择。这就是「顺序即语义」在语法这一环上的具体体现——它不是风格问题,而是「正确性 vs. 开销」的直接权衡。
要量化这个开销,llama_sampler_chain 的 t_sample_us / n_sample 就派上用场了:llama_perf_sampler_print 会把累计采样耗时打出来,和「每次生成的总耗时」一对照,就能看出语法到底占了多少。这也是把「采样」从「模型前向」里单独计时的价值所在。
另外,语法采样器和 GPU 采样之间有硬冲突:语法状态是纯 CPU 的字符级自动机,无法(也没有)实现 backend_* 接口,所以只要有语法在链上,后端采样就不可能覆盖整条链。这直接引出下一节。
后端采样:把采样搬上 GPU
回到链的 apply 里那段 is_backend 逻辑——它对应 llama.cpp 较新引入的一项能力:把采样搬上 GPU 执行。
为什么要搬到 GPU
要理解这件事的价值,先要看清默认路径的代价。标准的 CPU 采样路径是:模型前向在 GPU 上算出整个词表的 logits(十几万个数)→ 把 logits 从显存拷回主机内存(一次 D2H 拷贝)→ 在 CPU 上构造 n_vocab 条 llama_token_data → softmax、排序、过滤、采样。
这条路径有三个痛点:
- D2H 拷贝:十几万 float 大约几百 KB 到 1 MB,每条序列、每个 token 都要拷一次。在解码场景(逐 token 生成)里,这个拷贝开销不可忽略。
- CPU 构造候选集:把
n_vocab条数据逐条填进 vector,是纯 CPU 的循环。 - 序列并行时会放大:批里有 N 条序列,就要拷 N 份、构造 N 次。
后端采样的思路很直接:既然 logits 已经在 GPU 上,为什么不干脆在 GPU 上把「过滤 + 采样」也做了,只把最终选中的那个 token 拷回来? 这样 D2H 的数据量从「十几万 float」降到「一个 int」,而且全部采样计算并行化。
接口长什么样
虚表里那批 backend_* 函数指针就是为此新增的(include/llama.h):
// [EXPERIMENTAL] // backend sampling interface:
// return true if the backend supports all ops needed by the sampler and can handle up to // n_outputs_max_per_seq outputs per sequence bool (*backend_init)( struct llama_sampler * smpl, ggml_backend_buffer_type_t buft, uint32_t n_outputs_max_per_seq);
// call after .backend_apply() void (*backend_accept)( struct llama_sampler * smpl, struct ggml_context * ctx, struct ggml_cgraph * gf, struct ggml_tensor * selected_token);
void (*backend_apply)( struct llama_sampler * smpl, struct ggml_context * ctx, struct ggml_cgraph * gf, struct llama_sampler_data * data);
void (*backend_set_input)(struct llama_sampler * smpl); void (*backend_reset)(struct llama_sampler * smpl);注意这些签名和前六个 CPU 方法完全不同:它们接收的是 ggml_context 和 ggml_cgraph——也就是说,后端采样器不是直接算数,而是往计算图里加节点。backend_apply 往图里插入「这个采样器对应的算子」(比如一个 top-k 的 argmax、一个 softmax、一个门限比较),图构建完成后统一执行。这和 llama.cpp 的整体架构(本篇之前讲过的 ggml 图)是一致的:在 GPU 上做的事,都要先变成图节点。
copy_state 是另一个有意思的函数:
// copy mutable state from src into dst while keeping dst's references to the current sampling graph // src and dst must have the same type and configuration void (*copy_state)(const struct llama_sampler * src, struct llama_sampler * dst);为什么需要它?因为后端采样器的内部状态里有「指向当前采样图的张量指针」(比如 llama_sampler_penalties 里的 inp_token_ids、inp_counts)。当状态需要在两个采样器之间复制时,不能简单整体拷贝——那样会把旧图的指针也复制过去,导致引用一个已经销毁的图。copy_state 的语义是「只复制可变状态(历史、计数),保留目标自己的图引用」。这是把有状态算法搬到图模型上时必然要面对的额外复杂度。
链上的分段执行
llama_sampler_chain_backend_init 决定了链上哪一段能搬到后端:
for (auto & smpl : chain->samplers) { bool cur_prefix = backend_prefix;
// to be able to run a sampler on the backend, it has to: // - have the .backend_init() API implemented // - return true during .backend_init() // - support the requested per-sequence output limit if (cur_prefix && smpl.ptr->iface->backend_init) { if (!smpl.ptr->iface->backend_init(smpl.ptr, buft, n_outputs_max_per_seq)) { cur_prefix = false; } } else { cur_prefix = false; }注释把规则写得很清楚:一个采样器要能上后端,必须实现 backend_init、且在初始化时返回 true、且支持要求的「每序列输出上限」。cur_prefix 这个变量名说明了关键约束——只有链的「前缀」能上后端。一旦某个采样器不能上后端,从它开始(含它)之后的所有采样器都只能在 CPU 上跑。这解释了 chain_apply 里那段同名逻辑:
bool is_backend = chain->is_init;
for (auto & smpl : chain->samplers) { if (is_backend && smpl.is_backend) { continue; // 已交给后端 kernel 的采样器,CPU 端跳过 } is_backend = false; // 一旦遇到第一个非后端采样器,其后全部走 CPU // ... }为什么要限制成「前缀」而不是「任意子集」?因为链是有序的、状态递推的流水线。采样器 A 的输入是 B 的输出,如果 B 在 GPU、A 在 CPU,就必须把中间结果拷回来——那反而比全在 CPU 上还慢。只有「从链头开始连续的一段」能在设备上顺序执行,中间不需要回传。而链尾那个真正做决定的 dist/greedy 天然适合在 GPU 上做(一个 argmax 或一次 GPU 随机采样),所以典型的分段是「前缀过滤全在 GPU,最后把 token 传回来」。
这个前缀约束也解释了为什么 top-n-sigma 这类采样器更「后端友好」:它是纯线性扫描、不依赖排序,容易表达成并行的图算子;而需要全局排序的 top-p 要转成 GPU 算法就麻烦一些(llama.cpp 的后端实现里对应的是分块归约 + 阈值搜索)。
最后,llama_sampler_sample 开头那段就有了着落:
// If a backend sampler has already sampled a token, return it. if (sampled_token != LLAMA_TOKEN_NULL) { LLAMA_LOG_DEBUG("%s: Backend sampler selected token for idx %d. Skipping CPU samplers\n", __func__, idx); llama_sampler_accept(smpl, sampled_token); return sampled_token; }后端已经把 token 选好了,CPU 端只做 accept(把 token 记进历史,供有状态采样器使用)。整条路径从「拷十几万 float 回来再算」变成「拷一个 token 回来」。
从命令行到服务:默认链是怎么组装的
上面讲的都是单个采样器,实际用户看到的是一条已经配好的链。它由 common/sampler.cpp 里组装(common/sampling.cpp 的 common_sampler_init)。看它的分支顺序(省略了参数检查):
if (params.mirostat == 0) { // 正常路径:逐层过滤 + 温度 + 最终采样 samplers.push_back(llama_sampler_init_penalties(n_vocab, params.penalty_last_n, params.penalty_repeat, params.penalty_freq, params.penalty_present)); if (params.dry_multiplier > 0) { samplers.push_back(llama_sampler_init_dry(vocab, params.dry_multiplier, params.dry_base, params.dry_allowed_length, params.dry_penalty_last_n, ...)); } if (params.top_k > 0) { samplers.push_back(llama_sampler_init_top_k(params.top_k)); } if (params.top_p < 1.0f) { samplers.push_back(llama_sampler_init_top_p(params.top_p, params.min_keep)); } if (params.top_n_sigma > 0.0f) { samplers.push_back(llama_sampler_init_top_n_sigma(params.top_n_sigma)); } if (params.min_p > 0.0f) { samplers.push_back(llama_sampler_init_min_p(params.min_p, params.min_keep)); } samplers.push_back(llama_sampler_init_xtc(params.xtc_probability, params.xtc_threshold, params.min_keep, params.seed)); samplers.push_back(llama_sampler_init_temp_ext(params.temp, params.dynatemp_range, params.dynatemp_exponent)); samplers.push_back(llama_sampler_init_adaptive_p(params.adaptive_target, ... samplers.push_back(greedy ? llama_sampler_init_greedy() : llama_sampler_init_dist(params.seed)); } else { samplers.push_back(llama_sampler_init_temp(params.temp)); samplers.push_back(llama_sampler_init_mirostat(n_vocab, params.seed, ...)); // 或 mirostat_v2 }这条默认顺序本身就是一份「设计说明书」,逐条读下来能看出几个原则:
惩罚类在最前。penalties 和 DRY 都在链的最前面,因为它们要看到完整的候选集来做频率统计——如果放在 top-k 之后,被砍掉的 token 就统计不到了,惩罚会漏。而且它们只改 logit 不改 size,越早改,后续的过滤越能利用修正后的分布。默认 penalty_last_n=64(最近 64 个 token)。
语法(如果有)在 logit_bias 之后、惩罚之前。前面提过,这保证语法看到的是完整词表,不会因为先过滤而产生空候选集。
过滤从粗到细:top-k(按个数)→ top-p(按质量)→ top-n-sigma(按统计量)→ min-p(按相对阈值)。注意它们都是可关闭的——只有参数被显式设置时才 push 进链(if (params.top_k > 0) 等)。这意味着「默认链」里很多采样器其实不存在,用户不设就相当于不启用。这也是链式设计的另一个好处:没有的采样器根本不进链,不产生开销。
XTC 在过滤之后、温度之前。XTC 要「排除 top 候选」,所以必须在候选集已经被缩到合理大小之后做,否则它排除的「top」可能只是噪音。
温度在最后一批。温度改变整个分布的形状,放在过滤之后意味着「过滤基于原始分布,温度只影响最终采样的尖锐度」。反过来若温度在前,top-p 的累积概率就会在温度缩放后的分布上计算,语义完全不同。
做决定的采样器严格在最后。greedy 或 dist 是唯一写 selected 的,必须在整条链的末尾。mirostat 分支里则用自己的 temp + mirostat 组合,因为 mirostat 自己完成选择。
mirostat 是互斥分支。它不是和上面那条链叠加,而是另起一条链——因为 mirostat 的语义(动态惊讶度目标)与静态过滤是两套哲学,混在一起用户很难理解参数含义。
还有一个细节值得注意:llama_sampler_init_temp_ext 是「动态温度」,它根据分布的熵自动调节温度(论文 arXiv:2309.02772)——这是 mirostat 之外第二种「让随机性自适应分布」的路线。当 dynatemp_range = 0 时它退化成普通 temperature,所以默认链里就直接用它。
服务端与 CLI 的差异:llama-server 把每个请求的参数(temperature、top_p、grammar 等)通过 common_sampler_init 组装成每个 slot 一条链,与 llama_context 里那个 seq_id → sampler 的映射对应。所以并发请求各自的采样参数互不干扰,语法状态也是每请求独立的。这也是为什么 reset 在服务场景里必不可少——slot 被新请求复用时必须清掉上一条序列的采样历史。
与其他框架的采样管线对照
把 llama.cpp 的采样子系统放到四个框架的横向坐标里看,差异很能说明各自的定位。
| 维度 | llama.cpp | vLLM / SGLang | 说明 |
|---|---|---|---|
| 核心抽象 | llama_sampler 虚表 + 链 | LogitsProcessor 列表 + Sampler | 都是「一串可组合的小算子」 |
| 状态管理 | 每序列独立采样器(seq_id → sampler) | 按请求在 batch 内向量化处理 | llama.cpp 更贴近「单机多序列」,vLLM 更贴近「大 batch 服务」 |
| 语法约束 | GBNF 自研下推自动机 | xgrammar / outlines 编译成 FSM bitmask | 见 vLLM 结构化输出 |
| 后端采样 | 链前缀搬上 GPU(backend_*,实验性) | 默认就在 GPU 上算 logits 后回传 | vLLM 侧见 Attention Backend |
| 过滤策略 | 覆盖最广(top-k/p、min-p、typical、XTC、top-nσ、DRY、mirostat…) | 以 top-k/p、min-p、repetition 为主 | llama.cpp 是「采样策略的试验田」 |
三点值得展开:
第一,抽象层次不同。 vLLM/SGLang 的采样是「批处理优先」的:一个 batch 里所有请求的 logits 拼在一起,LogitsProcessor 用张量操作一次性处理整个 batch(温度缩放就是一次逐行除法,重复惩罚用 gather + scatter 更新计数)。llama.cpp 的采样是「对象优先」的:每条序列一个采样器对象,逐个 apply。前者吞吐导向,后者灵活性导向——llama.cpp 能塞进那么多冷门采样策略,正是因为每个策略是独立小对象,加一个不影响别人。这也和它的定位一致:单机、端侧、社区试验。
第二,语法实现路线不同。 前面已经点过:GBNF 是运行时的下推自动机,每个 token 都做一次字符级判定;xgrammar 则把语法编译成状态机的 bitmask(每个状态对应一个词表大小的 0/1 掩码),采样时只需查表按位与。bitmask 路线在每次判定上是 O(词表) 的位运算(极快),代价是编译期要枚举状态、内存占用随状态数增长;GBNF 路线的单步是 O(候选数 × 字符数),但状态是动态的、不需要预编译巨大表。两者是「预编译换运行时」的经典权衡。参考 SGLang 的 Grammar 实现 可以看到 bitmask 路线的工程细节。
第三,后端采样的方向一致。 无论哪个框架,都在往「少拷 logits」的方向走:llama.cpp 用链前缀 + 图节点,vLLM 用 fused logits processor kernel。共同动机是相同的——解码场景里 D2H 拷贝和 CPU 侧整词表处理是不可忽略的固定开销,而它在长上下文、高并发下会被放大。
小结
这篇文章把 llama.cpp 的采样子系统从下到上拆了一遍。回顾几个核心结论:
-
采样器是一个「虚表 + 链」的系统。每个策略是独立小对象,
apply改分布、accept记历史、reset清状态、clone复制。链把顺序变成了用户可控的语义。 -
所有采样器说同一种语言:
llama_token_data_array。过滤靠改size,改分布靠改logit,做决定靠写selected,排序状态靠sorted标志传递。 -
筛选型(top-k、top-p、min-p、typical、top-nσ)砍候选集,重塑型(temp、temp_ext)改分布形状,决定型(dist、greedy、mirostat)选出 token,历史型(penalties、DRY)读
accept累积的状态。四类职责清晰分工。 -
GBNF 语法是一条完全不同的技术路线:把 BNF 编译成下推自动机,逐候选 token 做字符级判定,用「所有解析路径都拒绝才砍」的交集语义保证正确性,用惰性语法实现「先自由输出、触发后约束」。
-
工程上的每个细节都在回答性能问题:partial sort + 直方图分桶、链上复用候选缓冲区、ring_buffer 增量维护频率、后端采样把 D2H 从十几万 float 降到 1 个 int。
-
默认链的顺序是一份设计说明书:惩罚最前(要看全词表)、过滤从粗到细、温度靠后、决定型严格在末尾、mirostat 走互斥分支。
如果说模型前向决定「模型想说什么」,采样这一段决定的是「最终说出口的是哪句」——它是 logits 到文本之间唯一的一道闸门,也是连接概率模型与形式约束(语法、禁词、结构化输出)的接缝处。理解了这条链,再去看任何一个框架的采样实现,都只是「有哪些采样器、按什么顺序拼、状态怎么归属」这三个问题的不同答案。
参考资料
- llama.cpp 仓库(ggml-org/llama.cpp)
- llama.cpp 采样源码 src/llama-sampler.cpp
- llama.cpp 语法源码 src/llama-grammar.cpp
- llama.cpp GBNF 语法文档 grammars/README.md
- The Curious Case of Neural Text Degeneration(top-k 与 nucleus sampling 原始论文)
- Locally Typical Sampling(typical sampling 原始论文)
- Mirostat: A Neural Text Decoding Algorithm that Directly Controls Perplexity
- Top-nσ: Not All Logits Are You Need
- Dynamic Temperature(temp_ext)论文
- llama.cpp 多 LoRA 与结构化输出可对照:SGLang Grammar 实现
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



