


vLLM 源码完全拆解(三十二):投机解码的配置层——SpeculativeConfig 如何把 method 变成一条执行路径
为什么值得单独讲配置层
前面几篇已经分别讲过 vLLM 的投机解码流水线、EAGLE 草稿、批量验证和 KV 回滚。那些文章回答的是“草稿 token 怎么生成、怎么验证、被拒绝的 KV 怎么释放”。但有一个更靠前的问题一直没有系统展开:vLLM 到底怎么决定这次服务走哪一条投机路径?
答案集中在 vllm/config/speculative.py 里的 SpeculativeConfig。它看起来只是一个 dataclass,实际上承担了三个职责:
- 把用户输入的 JSON、YAML 或旧式命令行参数,规范化成一组有约束的字段;
- 根据
method字段和草稿 checkpoint 的声明,选择对应的SpeculatorConfig实现类; - 把该实现类的能力标志(是否读目标模型隐状态、需要多少 lookahead KV 槽、是否独立 workspace)暴露给调度器、KV 管理器和模型执行器。
换句话说,投机解码在 vLLM 里的所有分支,最终都能追溯到这个对象上的某个字段或某个 ClassVar。本文基于 vLLM main 分支 2026 年 11 月的源码,按“字段 → 分派 → 派生配置 → 运行时契约 → 校验 → 实战”的顺序走一遍。文中出现的代码都是真实源码的节选,省略了与本主题无关的装饰器和类型注解。
SpeculativeMethod:一个封闭集合,外加一个注册表
先看方法名的类型定义。源码把内置方法写成一个 Literal 联合:
SpeculativeMethod = Literal[ "ngram", "draft_model", "suffix", "custom_class", EagleModelTypes, NgramGPUTypes, DSparkModelTypes,]其中 EagleModelTypes 又展开为:
EagleModelTypes = Literal[ "eagle", "eagle3", "extract_hidden_states", MTPModelTypes, DFlashModelTypes]MTPModelTypes 是一长串模型类型名,包含 deepseek_mtp、mimo_mtp、glm4_moe_mtp、ernie_mtp、nemotron_h_mtp 等。这些名字并不是让用户一个一个去记,而是为了兼容各家 checkpoint 在 model_type 字段里写下的不同 MTP 变体。构造阶段会把它们统一归一成 "mtp",细节在后面讲。
除了内置集合,源码还留了一个运行时注册表:
def register_speculative_method(name, config_cls): if name in get_args(SpeculativeMethod) or name in _CONFIG_BY_METHOD: raise ValueError(f"'{name}' is a built-in speculative method.") if name in _CUSTOM_CONFIGS and _CUSTOM_CONFIGS[name] != config_cls: raise ValueError(f"Speculative method '{name}' is already registered.") _CUSTOM_CONFIGS[name] = config_cls
def registered_speculative_methods() -> list[str]: return sorted(_CUSTOM_CONFIGS)注册表的存在,意味着插件可以定义自己的投机方法:写一个 SpeculatorConfig 子类,设置 speculator_class 指向自己的 BaseSpeculator 实现,然后在 vLLM 的 general plugin 里注册。SpeculativeConfig.method 的校验器会先查内置集合,查不到再查注册表:
@field_validator("method")def _validate_method(cls, value): if value is None or value in get_args(SpeculativeMethod): return value if value not in (registered := registered_speculative_methods()): raise ValueError( f"Unknown speculative method {value!r}. Built-in methods: " f"{sorted(get_args(SpeculativeMethod))}; registered custom " f"methods: {registered}." ) return value这是一个很典型的设计:内置方法用静态 Literal 获得类型检查和 IDE 补全,外部方法用动态注册获得扩展性,两条路径在同一个校验点汇合。错误消息同时列出两类方法名,部署脚本里写错方法名时能直接看到正确候选。
SpeculativeConfig 的字段全景
SpeculativeConfig 的字段很多,如果按源码顺序读会显得零散。按用途可以分成五组。
草稿来源与并行
| 字段 | 作用 |
|---|---|
model | 草稿模型、EAGLE 头或额外权重的路径 |
method | 方法名;为空时从 model 推断 |
custom_method | 注册的自定义方法名,构造期由 method 改写而来 |
draft_tensor_parallel_size | 草稿模型的 TP 度,只能是 1 或目标模型的 TP |
draft_parallel_config | 由目标并行配置派生的草稿并行配置 |
draft_load_config | 草稿权重的加载配置;为空时继承目标模型 |
这里有一个容易忽略的兼容字段 tensor_parallel_size。它只用于报错:如果用户误写 tensor_parallel_size 而不是 draft_tensor_parallel_size,_verify_args 会明确提示正确写法。这种“占位字段”是配置层常见的手法,比让参数被静默忽略要好得多。
预算与动态投机
| 字段 | 作用 |
|---|---|
num_speculative_tokens | 每步草稿多少 token,必须大于 0 |
num_speculative_tokens_per_batch_size | 按 batch size 区间动态选择草稿 token 数 |
parallel_drafting | 并行草稿(P-EAGLE、PARD),V1 专用,V2 由 DFlash/DSpark 内建 |
disable_padded_drafter_batch | 关闭草稿批的 padding,仅部分注意力后端支持 |
num_speculative_tokens_per_batch_size 的类型是 list[tuple[int, int, int]],每个元素是 (区间起点, 区间终点, 草稿 token 数),区间闭合。调度器在每步开始时根据当前活跃请求数落进哪个区间,决定这一步的 K。它的动机很直接:batch 很小时草稿的固定开销占比高,batch 很大时 GPU 已经接近满载,继续加大 K 只会让验证阶段变长。与其固定一个 K,不如给一张分段表。
草稿模型的独立覆盖项
草稿模型不一定和目标模型共享所有内核选择。源码提供了四个覆盖字段:
quantization:草稿权重的量化方法;moe_backend:草稿模型使用的 MoE 后端,为空时继承目标;attention_backend:草稿模型的注意力后端,例如 DFlash 需要支持非因果注意力的后端;kv_cache_dtype:草稿 KV 的数值类型,为空时继承目标。
其中 quantization 是草稿 ModelConfig 的构造参数;moe_backend、attention_backend、kv_cache_dtype 三项则走 apply_draft_overrides,分别叠加到目标 VllmConfig 的 kernel_config、attention_config、cache_config 副本上,只有非空字段才覆盖。为什么需要单独覆盖?考虑一种常见组合:目标模型是 FP8 量化的 MoE,草稿模型是未量化的稠密小模型。两者对 MoE 内核和量化内核的需求完全不同,如果强行继承,草稿模型可能加载失败,或者被套上一个并不适合它的 GEMM 实现。
另外两个字段与 EAGLE 系草稿头直接相关:
draft_lm_head_quantization:把草稿头共享的lm_head量化成 FP8 或 NVFP4。源码明确说明目标模型仍然用自己的头做验证,所以这个选项只可能改变接受长度,不会改变最终输出分布。use_local_argmax_reduction:草稿阶段用词表并行的局部 argmax,代替 all-gather 完整 logits。通信量从与词表大小成正比降到与 TP 度成正比,代价是拿不到完整草稿分布,只能做贪心草稿。
拒绝采样与验证策略
rejection_sample_method 有四个取值,这是 2026 年版本相对早期实现最大的变化之一:
| 取值 | 含义 |
|---|---|
standard | 标准的逐 token 概率比拒绝采样 |
synthetic | 按预设的接受率曲线接受草稿,不等目标分布 |
block | 把草稿 token 作为一个块联合验证 |
fly | FLy 的有损、熵门控延迟窗口验证 |
标准拒绝采样的数学在投机解码文章里已经推过:对草稿分布 和目标分布 ,以 的概率接受草稿 token,拒绝时从残差分布 重采样。synthetic 则完全绕开这个比值,直接给每个位置一个无条件接受率。源码里的注释写得很清楚:位置 的取值表示前 个草稿 token 全部被接受的概率,列表长度必须等于 K,每个元素在 内,且单调不增。
synthetic_acceptance_length 是同一件事的另一种表达:用户给一个目标平均接受长度,源码用“最小方差”调度把它转成逐位置概率:
其中 是目标平均接受长度。直觉是:先让前 个位置必然接受,再用一个小数概率表达“平均还会多接受零点几个”,其余位置概率为零。这个构造不是唯一解,但它的方差最小,适合做性能压测时固定接受率、排除模型质量波动。
fly 则需要 num_speculative_tokens >= 2,窗口大小默认 min(6, K-1) 且必须小于 K。源码在启用时会打一条警告,因为 FLy 是有损方法,可能改变输出分布。这个警告不是客套:有损投机解码意味着“接受”不再等价于“按目标分布采样”,线上服务如果对输出分布有严格要求,不应该开它。
特殊模式
use_heterogeneous_vocab 允许草稿模型和目标模型使用不同词表。启用后,初始化阶段会构建 token 级交集,把草稿 logits 限制在共享 token 上。源码把算法称为 TLI,并限定它只能配合 method="draft_model" 和贪心草稿采样。原因不难理解:如果草稿是概率采样,限制词表会改变草稿分布,拒绝采样的比值检验就不再成立;而贪心草稿只关心 argmax 是否落在交集里,处理起来简单得多。
suffix 是另一条特殊路径。它依赖 Arctic Inference 的 suffix decoding,num_speculative_tokens 不填时默认取 suffix_decoding_max_tree_depth。源码把它标记为 V1 model runner 专用,并且需要额外安装 arctic-inference==0.1.1。这类“外挂式”方法通常生命周期较短,读源码时要留意它是否已经被新架构取代。
post_init:一次构造,三层查找
SpeculativeConfig 的 __post_init__ 是整个配置层最核心的函数。它要在一个构造函数里完成方法推断、别名归一、配置类查找和草稿模型派生。可以把流程画成三层查找。
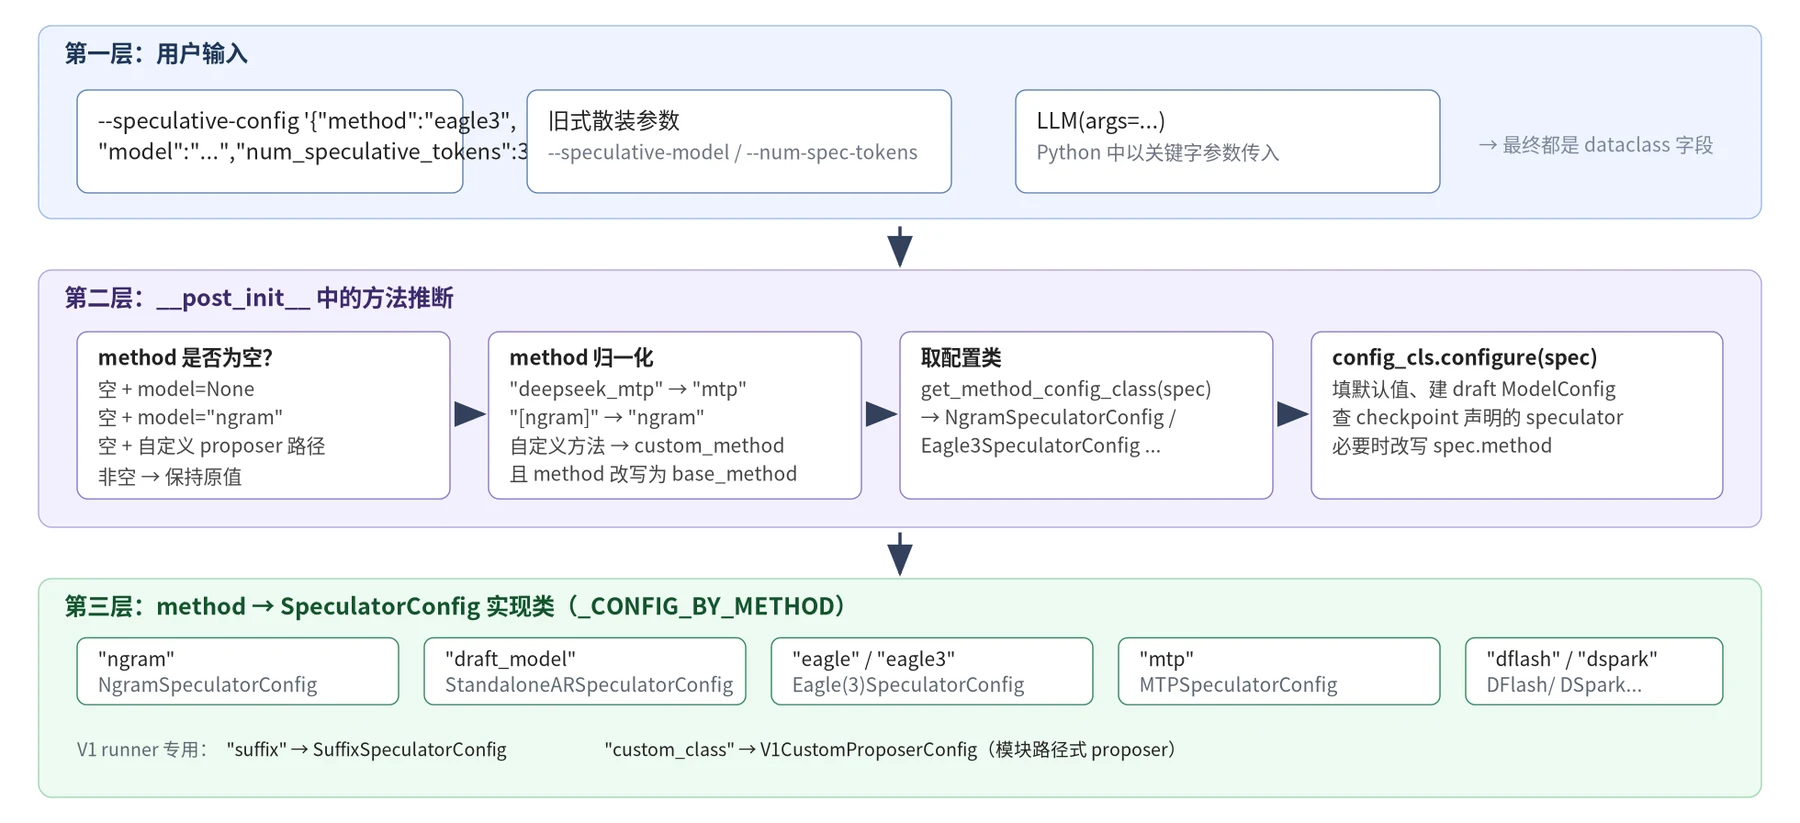
第一层是用户输入。无论用户写的是 --speculative-config '{"method": ...}'、旧式散装参数,还是 Python 里直接构造 SpeculativeConfig,最终都变成 dataclass 字段。真正完成这层归一的是 EngineArgs.create_speculative_config:它把 --spec-method、--spec-model、--spec-tokens 三个旧式参数合并进 --speculative-config 字典,检查同一个字段是否被两种写法同时指定,把连字符键名统一成下划线,再注入目标模型的 ModelConfig 与 ParallelConfig,最后调用 SpeculativeConfig(**kwargs)。源码在这里特意把 argparse 的类型设成 json.loads,就是为了推迟 Pydantic 校验——因为 SpeculativeConfig 的构造依赖目标模型配置,命令行解析阶段还拿不到它。
第二层是方法推断。源码的注释交代了设计意图:method 是后来引入的参数,用来描述“不依赖模型的草稿器”;model 仍然表示草稿模型、EAGLE 头或额外权重。如果用户没有显式给 method,源码会尽量从 model 推断;推断不出来就默认按 "draft_model" 处理。
推断顺序大致是:
if (custom_cls := get_custom_speculator_config_class(self.method)) is not None: self.custom_method = self.method self.method = custom_cls.base_methodelif self.method is None and SpeculativeConfig._is_custom_proposer_path(self.model): self.method = "custom_class"elif self.method is None and self.model in ("ngram", "[ngram]"): self.method = "ngram"elif self.method is None and self.model is None: self.method = "draft_model"注意第一支:如果 method 命中注册表,源码不会把它留在 method 里,而是先存进 custom_method,再把 method 改写成该自定义方法所继承的内置方法。后面的所有逻辑——找配置类、取 base_method、检查 supported_options——都只认内置方法名。这是一个很干净的隔离:自定义方法只需要声明“我基于哪一种内置形态”,框架不需要为它写一套平行分支。
接着是别名归一:
if self.method in get_args(MTPModelTypes) and self.method != "mtp": logger.warning("method `%s` is deprecated and replaced with mtp.", self.method) self.method = "mtp"elif self.method == "[ngram]": self.method = "ngram"老 checkpoint 里常见 deepseek_mtp、glm4_moe_mtp 这类方法名。源码保留它们作为输入别名,但内部统一按 mtp 处理,并打一条弃用警告。这样做的好处是旧部署脚本不会立刻失效,同时内部只有一条 MTP 路径需要维护。
第三层是配置类查找。get_method_config_class 把方法名映射到 _CONFIG_BY_METHOD 中的类:
_CONFIG_BY_METHOD = { "extract_hidden_states": "...ExtractHiddenStatesSpeculatorConfig", "draft_model": "...StandaloneARSpeculatorConfig", "ngram": "...NgramSpeculatorConfig", "ngram_gpu": "...NgramGPUSpeculatorConfig", "eagle": "...EagleSpeculatorConfig", "eagle3": "...Eagle3SpeculatorConfig", "mtp": "...MTPSpeculatorConfig", "dflash": "...DFlashSpeculatorConfig", "dspark": "...DSparkSpeculatorConfig",}"suffix" 和 "custom_class" 不在这个字典里,它们会走 V1 专用的 v1_speculator_configs 模块。这个分叉很重要:V1 的 suffix decoding 和“按模块路径注册 proposer”是旧模型执行器的能力,V2 speculator 架构没有对应实现,所以源码用 _V1_ONLY_METHODS 明确隔离。
拿到配置类后,执行 config_cls.default_model(self)。这个钩子决定“用户没给 model 时,草稿模型从哪里来”:
- N-gram 的默认模型是
None,因为它本来就不需要权重; - MTP 的默认模型是目标模型的权重路径。源码优先取
target.model_weights,因为某些加载器(如 runai_streamer)会把model改成本地缓存目录,而原始路径保存在model_weights里; - DSpark 对 DeepSeek 系列默认指向目标模型:V4/V4.1 的 DSpark 权重就放在目标 checkpoint 里,不需要单独下载;MiniMax-M3 等目标则走单独的草稿下载路径;
- EAGLE 和独立草稿模型没有合理默认值,必须由用户显式指定。
随后调用 config_cls.configure(self)。这个钩子做三件事:填默认值、构造草稿 ModelConfig、必要时改写 method。N-gram 的 configure 会补上 prompt_lookup_min = prompt_lookup_max = 5。源码的 TODO 写得很坦率:这两个值是“任意选的”,还没有系统调参。独立草稿模型的 configure 则要构造一份完整的 ModelConfig(runner="draft", ...),细节下一节展开。
configure 之后还有一个容易被忽略的步骤:get_speculator_config_class 会再查一次草稿 checkpoint 自己声明的 speculator_config_class:
declared_cls = _get_draft_declared_config_class(spec_config)if declared_cls is not None and issubclass(declared_cls, config_cls): return declared_clsreturn config_cls.specialize(spec_config)这解决了一个现实问题:同一个 method="mtp",不同 checkpoint 可能需要不同的草稿图。与其在 vLLM 里写一堆 if model_type == ...,不如让 checkpoint 自己声明配置类。specialize 是第二层机制,用于在同一个方法内部按字段细分,例如 MTPSpeculatorConfig.specialize 会在多模块 MTP 时返回 MultiModuleMTPSpeculatorConfig。
如果没有声明,就按固定顺序检测 checkpoint:
_CHECKPOINT_DETECTION_ORDER = ("eagle", "eagle3", "dflash", "dspark", "mtp")每个配置类的 matches 用模型路径或 model_type 判断。例如 EagleSpeculatorConfig.matches 检查路径里是否含 "eagle-",Eagle3SpeculatorConfig.matches 检查是否含 "eagle3",MTPSpeculatorConfig.matches 检查 hf_config.model_type 是否属于 MTP 类型集合。顺序有讲究:eagle 在 eagle3 之前,但 eagle3 的匹配串更长、更具体;如果路径同时包含两者,先命中 eagle 反而可能误判。源码目前按这个顺序写,实际部署时最好显式给 method,不要依赖路径猜测。
如果用户显式给了 method,而 checkpoint 声明的 base_method 与它不一致,源码会直接报错,并在消息里说明草稿模型实际是什么类型:
raise ValueError( f"speculative_config requested method={requested!r}, but " f"the draft model {draft.model!r} is a {declared!r} checkpoint ...")这类错误在部署阶段比运行阶段更有价值。它把“配置写错”与“权重不匹配”两类问题提前到了启动期。
最后是 supported_options 检查。源码维护一份方法专属选项列表:
_METHOD_SPECIFIC_OPTIONS = ( "dspark_draft_topk", "draft_lm_head_quantization", "index_share_for_mtp_iteration", "xpress_topc", "speculator_options",)如果某个选项非空,但当前配置类的 supported_options 不包含它,就报错。例如给 MTP 配 dspark_draft_topk,或者给 EAGLE 配 index_share_for_mtp_iteration,都会在启动期被拦下。这个机制比在每个方法里手写 if 更可维护:新增选项时只需要在对应配置类声明它支持,检查逻辑不用改。
SpeculatorConfig:方法能力的声明式描述
三层查找最终都会落到一个 SpeculatorConfig 实例上。它不是草稿器本身,而是草稿器的配置描述。源码把它的定位写得很清楚:默认值描述“一个没有草稿 checkpoint、也没有特殊要求”的草稿器;自定义草稿器可以继承它,或者继承某个内置草稿器的配置类。
SpeculatorConfig 用 ClassVar 声明静态能力,用 property 声明依赖配置字段的动态值。
静态能力标志
base_method: ClassVar[str | None] = Nonespeculator_class: ClassVar[str | None] = Nonesupported_options: ClassVar[frozenset[str]] = frozenset()
uses_target_hidden_states: ClassVar[bool] = Falseuses_separate_workspace_lane: ClassVar[bool] = Falseprefer_dense_token_history: ClassVar[bool] = Falseproposes_draft_tokens: ClassVar[bool] = Trueadaptive_verification_uses_draft_logits: ClassVar[bool] = Truedraft_has_own_vocab: ClassVar[bool] = Falsesupports_watermarking: ClassVar[bool] = Falsesupports_pcp: ClassVar[bool] = False逐个看这些标志的实际含义:
base_method:内置草稿器对应的method;自定义草稿器对应它所继承的内置方法。前面__post_init__把自定义方法改写成base_method,就是读这个字段。speculator_class:V2BaseSpeculator子类的全限定名,源码用延迟导入解析。uses_target_hidden_states:草稿器需要读目标模型的隐状态。EAGLE、EAGLE3、MTP、DFlash、DSpark 都是True。这一个标志影响到模型执行器是否要额外输出中间层隐状态。uses_separate_workspace_lane:草稿在自己独立的 workspace 里跑,不往目标 batch 里塞行。目前只有 DSpark 是True。prefer_dense_token_history:出于性能考虑,优先在 GPU 上保留请求的完整 token 历史,而不是走 UVA 内存。N-gram 需要频繁扫描历史,所以开这个标志。proposes_draft_tokens:是否真的产出草稿 token。extract_hidden_states是False,它的用途是抽取隐状态给别的组件用,不是一个完整的投机方法。adaptive_verification_uses_draft_logits:自适应验证是否基于草稿 logits 估计接受率。DSpark 有自己的置信度头,所以是False。draft_has_own_vocab:草稿模型有独立词表,默认必须与目标一致,除非开了use_heterogeneous_vocab。只有独立草稿模型是True。supports_watermarking:支持水印注入。EAGLE 和 DFlash 支持。supports_pcp:草稿器与 prefill context parallelism 兼容。MTP 和 DSpark 支持,多模块 MTP 不支持。
这些标志之所以要放在配置类上,而不是散落在调度器里,是因为它们需要被多处读取:调度器要知道 lookahead 槽数,KV 管理器要知道是否要回滚块,执行器要知道要不要输出 aux hidden states,可观测性模块要知道能否加水印。集中在一个声明式对象上,新增方法时就不会漏改某一处。
动态 property
@propertydef num_lookahead_tokens(self) -> int: return 0
@propertydef max_model_len(self) -> int | None: return None
@propertydef num_prefill_lookahead_tokens(self) -> int: return 1 if self.uses_target_hidden_states else 0
@propertydef max_num_new_slots_for_drafting(self) -> int: return 0num_lookahead_tokens 是最常被读的值。它的含义是:为了容纳草稿阶段产生的 token,每个请求需要预留多少额外的 KV 槽。不同方法差异很大:
- 基类是 0,因为 N-gram 不产生新的 KV;
StandaloneARSpeculatorConfig返回num_speculative_tokens,独立草稿模型有自己的一套 KV;EagleSpeculatorConfig返回num_speculative_tokens;DFlashSpeculatorConfig返回num_speculative_tokens + 1,因为 fill-in 草稿多一个 bonus query;DSparkSpeculatorConfig在 anchor-sampling 模式下返回num_speculative_tokens,否则回退到父类的K+1。
num_prefill_lookahead_tokens 专门处理 chunked prefill 的边界。读隐状态的草稿器至少要能看到下一个 token,所以返回 1;多模块 MTP 每个模块比前一个多看一个 token,所以返回 K。
max_num_new_slots_for_drafting 描述“除了每个解码请求已有的一个 query 槽外,还额外需要多少槽”。源码在 SpeculativeConfig 上直接附了一张表:
| 方法 | 并行草稿 | 额外槽数 |
|---|---|---|
| EAGLE3 | 否 | 0 |
| P-EAGLE | 是 | K-1 |
| DFlash | 是 | 0 |
| DSpark | 是 | 0 |
| MTP | 否 | 0 |
| N-gram | 否 | 0 |
| Draft model | 否 | 1 |
| PARD | 是 | K |
这张表解释了前面 StandaloneARSpeculatorConfig 的返回值:普通自回归草稿会保留一个未切片的 token 作为下一步输入,所以需要 1 个额外槽;PARD 不移动已有输入,K 个 query 位置都要新槽。EAGLE3 复用已有 query,所以是 0;P-EAGLE 只有被 mask 的 query 需要新槽,所以是 K-1。DFlash 和 DSpark 走完全独立的草稿 pass,不往目标 batch 加行,所以是 0。
这张表是配置层最实用的产出之一:调度器不必知道每种算法的细节,只读一个整数就能算本步的 KV 需求。
max_model_len 与位置编码
DraftModelSpeculatorConfig 有一个 shares_target_positions 标志,默认 True:草稿模型使用目标模型的位置,所以它的 max_position_embeddings 会被抬到目标的 max_model_len。但它只在 RoPE 类型允许时这么做。源码注释解释了原因:
_CACHE_ONLY_ROPE_TYPES = frozenset( {"default", "linear", "llama3", "ntk", "proportional"})对这几类 RoPE,max_position_embeddings 只用于决定 cos_sin_cache 的大小,调大它不会改变任何旋转频率,所以安全。而 yarn、deepseek 类型的 RoPE 会用 original_max_position_embeddings 定缓存大小,dynamic、longrope 会从它推导频率,直接改会改变模型行为。因此 _maybe_override_draft_max_position_embeddings 会先检查类型,再决定是否改写。
这个细节值得单独讲,因为它体现了一个通用的工程原则:配置层不能假设“调大上限”是安全操作。对位置编码这一类隐式依赖长的组件,上限本身就是模型行为的一部分。
StandaloneAR 的 configure:一份草稿 ModelConfig 怎么诞生
独立草稿模型是最容易理解的路径,也是观察 vLLM 配置层细节最好的样本。DraftModelSpeculatorConfig.configure 在用户给了 model 时会构造:
spec.draft_model_config = ModelConfig( model=spec.model, runner="draft", tokenizer=(spec.model if spec.use_heterogeneous_vocab else target.tokenizer), tokenizer_mode=target.tokenizer_mode, dtype=target.dtype, max_model_len=spec.max_model_len, spec_target_max_model_len=target.max_model_len, quantization=spec.quantization, hf_overrides=draft_hf_overrides, ...)可以按来源把这些字段分成三类。
第一类继承目标模型:tokenizer_mode、dtype、seed、trust_remote_code、enforce_eager、max_logprobs、config_format。这些字段不影响草稿模型的“身份”,只影响运行时环境,继承是为了减少配置负担。
第二类来自草稿专属字段:model、revision、code_revision、quantization。这些是用户为草稿模型单独指定的。
第三类需要特殊处理:
runner="draft"告诉ModelConfig这不是目标模型,某些校验和默认值会走草稿分支;tokenizer默认继承目标。只有开了use_heterogeneous_vocab才用草稿自己的 tokenizer,因为此时两边词表不同,需要各自的编码器;max_model_len用spec.max_model_len,可以为空;spec_target_max_model_len把目标模型的上限传进去,供ModelConfig在校验时参考。
hf_overrides 的合并也有一层讲究。源码把目标的 hf_overrides 分成两类:可调用的和字典形式的。字典形式的覆盖会改变目标模型的结构(例如替换注意力实现),不应该作用于草稿模型;可调用的覆盖通常是运行时开关(例如强制某个 RoPE 实现),两边都应该生效。compose_draft_hf_overrides 只把可调用部分传给草稿模型。
草稿 ModelConfig 构造完后,源码还会做几件事:
- 如果配置类声明
shares_target_positions,尝试抬高草稿的max_position_embeddings; - 调用
adapt_draft_model_config,例如 EAGLE 会把草稿的hf_config包一层EAGLEConfig; - 调用
resolve_num_speculative_tokens,从 checkpoint 的n_predict推导 K; - 校验
draft_tensor_parallel_size; - 调用
create_draft_parallel_config派生草稿并行配置。
第四步的校验函数很简短,但约束很强:
if speculative_draft_tensor_parallel_size is None: speculative_draft_tensor_parallel_size = target_parallel_config.tensor_parallel_sizeelif speculative_draft_tensor_parallel_size not in (1, target_parallel_config.tensor_parallel_size): raise ValueError( f"{speculative_draft_tensor_parallel_size=} cannot be " f"other value than 1 or target model tensor_parallel_size" )为什么只允许这两个值?因为草稿模型和目标模型必须跑在同一组 GPU 上,权重切分要么全切(与目标一致),要么不切(每卡一份)。中间值会让 TP 组的通信拓扑冲突。
第五步的 create_draft_parallel_config 还有一个细节:专家并行只在草稿本身是 MoE 时才继承。源码的判断是:
enable_ep = target_parallel_config.enable_expert_parallelif draft_model_config is not None: enable_ep = enable_ep and draft_model_config.is_moe如果目标模型是 MoE 并开了 EP,草稿是稠密小模型,那么草稿不应该被纳入 EP。否则执行器会按专家并行去切分一个没有专家的模型,要么报错,要么产生无意义的通信。
resolve_num_speculative_tokens 里有一条 MTP 专属校验也值得注意:
n_predict = getattr(spec.draft_model_config.hf_config, "n_predict", None)if spec.num_speculative_tokens is None: spec.num_speculative_tokens = n_predictelif spec.num_speculative_tokens > n_predict and spec.num_speculative_tokens % n_predict != 0: raise ValueError( f"num_speculative_tokens:{spec.num_speculative_tokens}" f" must be divisible by {n_predict=}" )MTP 层的数量由 checkpoint 决定,例如 DeepSeek 系列通常是一到若干层。如果用户想每步草稿超过层数,就必须是层数的整数倍,因为实现会循环复用这些 MTP 模块;不是整数倍就无法均匀分配,接受率也会变得难以解释。
compute_hash:配置如何进入编译缓存键
配置层还有一个容易被忽略的职责:产生哈希,作为编译缓存的键。compute_hash 的注释写得非常明确:
Provide a hash that uniquely identifies all the configs that affect the structure of the computation graph from input ids/embeddings to the final hidden states.
它列出的因素包括:
uses_aux_hidden_states:EAGLE3 和extract_hidden_states会额外返回中间层隐状态,图结构不同;- 草稿模型的
compute_hash(); eagle_aux_hidden_state_layer_ids:具体接哪几层,也改变图;custom_method;speculator_options的排序项;speculator_config.hash_factors()。
最后一项是各配置类自己补充的因素。MTPSpeculatorConfig.hash_factors 返回 index_share_for_mtp_iteration,因为是否共享稀疏索引会改变草稿图;DSparkSpeculatorConfig.hash_factors 返回 enable_adaptive_verification,因为自适应验证会改变 DSpark 的草稿图。
这里有一个容易踩坑的地方:新增字段时必须同步更新 factors。如果某个字段影响图结构却没进哈希,两个不同配置会命中同一份编译缓存,轻则性能不符预期,重则加载了错误的 kernel。注释用 WARNING 强调这一点,说明它确实发生过。
运行时:谁在读这些字段
配置层本身不做计算,它的价值在于被谁读取。按读者梳理一遍,可以更清楚它在系统中的位置。
调度器
调度器在每步开始时要回答两个问题:这一步给每个请求多少 token 预算?要不要临时关闭投机?
第一个问题读 num_speculative_tokens,或者 num_speculative_tokens_per_batch_size 在当前 batch 规模下对应的值。第二个问题依赖 batch 规模与 GPU 占用。vLLM 早期有一个 disable_by_batch_size 式的开关,逻辑简单粗暴:batch 超过阈值就关闭投机。新版本的动态 K 表是这个思路的延续,只是从“开/关”变成“分档”。
调度器还要读 max_num_new_slots_for_drafting 和 num_lookahead_tokens 来算本步的 KV 需求。这两个值决定了“这个请求还能不能塞进当前批”。
VllmConfig 的转发属性:为什么消费者不自己算
SpeculativeConfig 的字段不是被各处直接读取,而是先经过 VllmConfig 的一组转发属性。源码在 num_lookahead_tokens 的 docstring 里把原因写得很清楚:
Consumers must read this property rather than re-deriving their own per-method lookahead, so the scheduler and warmup cannot drift apart.
意思是:调度器和 worker 预热都会预留 KV 槽。如果两边各自按方法名推导“要预留多少”,一旦某个方法的实现改了,两处就会不一致,表现为预热时能跑、真实调度时越界。把推导集中到 VllmConfig.num_lookahead_tokens 这一个入口,所有消费者读同一个值,就不会漂移。
同类的转发属性还有两个:
num_prefill_lookahead_tokens:chunked prefill 在块边界上必须多算多少 token。调度器不能把 chunk 结束在草稿器还要读的范围内,KV 管理器要把尾部this - 1个 token 视为可重新预填充,而不是已定稿。num_hash_lookahead_tokens:前缀缓存块哈希要覆盖块后多少个 token。它只在启用前缀缓存、EAGLE 尾块丢弃开启、没有关闭 lookahead 哈希、且没有 KV connector 时返回非零值。KV connector 仍使用旧哈希,源码明确把这条分支排除在外。
这三个属性看起来只是简单转发,实际上定义了“配置层与调度层之间的接口协议”。新增一个草稿方法时,只要它的 SpeculatorConfig 正确实现了这几个 property,调度器和预热逻辑不需要任何改动。
KV 管理器和前缀缓存
needs_eagle_block_drop 是这里最关键的一个判断:
def needs_eagle_block_drop(self) -> bool: return self.use_eagle() and not (self.use_dflash() or self.use_dspark())
def use_eagle_block_drop(self) -> bool: return self.needs_eagle_block_drop() and not self.disable_eagle_block_drop注释解释得很清楚:EAGLE 风格的草稿器用“位置 p 的隐状态 + 下一个 token”构造位置 p 的草稿 KV,所以一个位置的前缀块在被下一个 token 确认之前是不稳定的。DFlash 和 DSpark 只用目标隐状态构造草稿 KV,不存在这个问题。因此只有 EAGLE、EAGLE3、MTP 需要丢弃尾部的前缀缓存块。
disable_lookahead_block_hashes 是同一问题的另一种解法:与其丢弃尾部块,不如让块哈希覆盖草稿器在每个块之后读到的 token。源码提醒,启用了共享 KV 存储或外部 KV 事件消费者的引擎必须使用相同设置,否则两边对“块是否有效”的判断会不一致。
模型执行器
执行器读 uses_target_hidden_states 来决定目标模型前向是否要额外输出中间层隐状态,读 uses_aux_hidden_states 和 eagle_aux_hidden_state_layer_ids 来决定输出哪几层。uses_separate_workspace_lane 决定草稿是否独立占用一份 workspace,这在显存预算是要单独留一块。
draft_lm_head_quantization 和 use_local_argmax_reduction 则影响草稿阶段的 kernel 选择和通信方式。
Proposer 工厂与 speculator
method 最终决定实例化哪个 BaseSpeculator。speculator_config.speculator_class 给出全限定名,源码用 resolve_obj_by_qualname 延迟导入。这样 vllm/config 不需要在导入时拉起所有草稿器的实现,避免循环依赖和启动开销。
_verify_args:启动期的静态检查清单
__post_init__ 末尾会调用 _verify_args。它把跨字段的约束集中在一个地方,可以作为部署前的检查清单。
基本约束
if self.tensor_parallel_size is not None: raise ValueError("'tensor_parallel_size' is not a valid argument in the " "speculative_config. Please pass 'draft_tensor_parallel_size' instead.")if self.num_speculative_tokens is None: raise ValueError("num_speculative_tokens must be provided with speculative model ...")if self.num_speculative_tokens <= 0: raise ValueError(...)第二、三条错误消息直接出现在启动日志里,省去了用户翻文档的时间。
合成接受率
synthetic 模式要求恰好提供 synthetic_acceptance_rates 和 synthetic_acceptance_length 中的一个,二者互斥:
if (rates is None) == (length is None): raise ValueError( "rejection_sample_method='synthetic' requires exactly one of " "synthetic_acceptance_rates or synthetic_acceptance_length." )如果给的是 rates,源码检查长度等于 K、每个值在 [0,1]、且单调不增。单调性的理由很直观:如果第 3 个位置的接受概率高于第 2 个,说明“前 3 个全接受”的概率比“前 2 个全接受”还大,这在逻辑上不可能。
如果给的是非 synthetic 模式却填了这两个字段,源码同样报错:
elif (self.synthetic_acceptance_rates is not None or self.synthetic_acceptance_length is not None): raise ValueError( "synthetic_acceptance_rates / synthetic_acceptance_length " "are only valid with rejection_sample_method='synthetic'." )这种“选项与模式绑定”的校验,是在配置层最值得投入的地方。运行期再发现,往往已经跑了一半。
异构词表
use_heterogeneous_vocab 有三条约束:只能配 draft_model,只能用贪心草稿,不能与局部 argmax 同时开。第三条的理由在源码里写得很直接:token 级交集需要完整的草稿 logits,而局部 argmax 根本不物化完整 logits。
FLy
FLy 的校验有四项:
- 草稿器必须真的产出草稿 token,
extract_hidden_states不行; num_speculative_tokens >= 2;- 窗口大小默认
min(6, K-1),显式指定时必须小于 K; - 启用时打一条“有损”警告。
第四项看似只是日志,实际上是在提醒使用者:这是一种会改变输出分布的方法,和标准拒绝采样的“无损”性质不同。
草稿并行配置校验
if self.draft_model_config: self.draft_model_config.verify_with_parallel_config(self.draft_parallel_config)这一步把草稿模型的 ModelConfig 和草稿并行配置放在一起检查,例如 TP 度能不能整除头数、EP 度能不能适配专家数。
N-gram 草稿器:配置项落到一个 KMP 扫描
N-gram 是唯一一个不需要任何权重的投机方法,也因此最适合用来观察“配置项如何落到算法”。它的配置只有三个字段真正参与计算:
prompt_lookup_min:最短匹配窗口;prompt_lookup_max:最长匹配窗口;num_speculative_tokens:最多取多少个后续 token。
NgramProposer.__init__ 把它们读成 min_n、max_n、k,再读目标模型的 max_model_len。然后预分配两个 max_num_seqs × k 的 int32 缓冲区,用于批量草稿结果。
真正有意思的是 _find_longest_matched_ngram_and_propose_tokens。它要回答的问题是:给定一条已经生成的 token 序列,找出它的后缀中与序列内部某个片段相同的最长 n-gram,然后把该片段后面的 k 个 token 当作草稿。
源码用了一个很巧的处理:先把整个序列翻转。翻转之后,“后缀匹配”变成“前缀匹配”,问题转化为标准的 KMP 前缀函数计算。注释里给出的定义是:
也就是“以位置 i 结尾的最长后缀,同时是整个翻转序列的前缀”。KMP 的递推逻辑是:
- 如果
tokens[prev_lps] == tokens[i],前缀长度加一; - 否则回退到
lps[prev_lps-1],继续尝试更短的前缀; - 当长度达到
max_n时,主动回退到lps[max_n-1],避免匹配超过配置上限。
源码里有一个容易忽略的细节:
if prev_lps >= longest_ngram: longest_ngram = prev_lps position = i这里用的是 >= 而不是 >。因为序列已经翻转,i 越大表示在原序列里越靠前。用 >= 会让相同长度的匹配保留更靠后的 i,也就是原序列里更早出现的位置。源码注释解释了动机:希望取原序列中最早出现的那个匹配,而不是最近的。
找到最长匹配后,还要把它映射回原序列:
start_position = total_token - 1 - position + longest_ngramk = min(k, total_token - start_position)return origin_tokens[start_position : start_position + k]第一行把翻转坐标还原成原坐标,并跳过匹配到的 n-gram 本身;第二行保证不会取到序列末尾之外。
整个扫描只依赖当前请求自己的 token 序列,不依赖一个全局语料库。这一点经常被误解:名字里的 “prompt lookup” 听起来像是在一个外部 prompt 集合里查找,实际上它只在当前序列内部找重复片段。因此它的收益高度依赖输入的结构:代码、表格、重复模板、few-shot 示例这类高重复文本收益明显;开放式创意写作几乎没有可匹配片段,草稿长度会经常为 0。
配置层的两个默认值也值得注意。NgramSpeculatorConfig.configure 在用户没给窗口时直接设成 5 和 5,源码的 TODO 写的是“任意选的,还没有调参”。这意味着默认配置并不是一个经过系统优化的值,只是能跑。实际部署时应该根据负载的重复度调整:重复度高的场景可以把 prompt_lookup_max 调大,让匹配更具体;重复度低时缩小窗口,避免匹配到过于泛化的短片段。
批量路径则用 Numba 并行。源码设了一个 8192 token 的阈值:批内总 token 数低于阈值时用单线程,高于阈值才启用多线程,避免线程调度开销盖过收益。线程数被限制为 min(1, cpu_count // 2) 再除以 TP 度,注释里保留了把上限从 1 提到 8 的 TODO,原因是当前 N-gram 还没有做 TP 并行化,所有 TP rank 都会跑同一份 proposer,线程开多了只会互相抢核。
NgramProposer.__init__ 末尾还会用一批 dummy 请求触发一次 JIT 编译。注释估计编译时间不到一秒,但如果不预热,第一个真实请求会承担这段延迟。对在线服务来说,这一秒的尾延迟很容易被监控抓到。
V2 的路径有所不同:NgramSpeculatorConfig.speculator_class 指向 NgramGPUSpeculator,而 ngram_gpu 这个独立方法名也映射到同一族实现。V1 则继续使用上面这个 CPU 版 NgramProposer。两套实现共享同一组配置字段,但执行位置不同。
草稿器的形态:从 EAGLE 到 Medusa,再到块扩散
配置层的 method 最终对应到不同的草稿图。理解这些图的形态,才能明白为什么某些字段只对某些方法有意义。
EAGLE 的核心是把“草稿”从 token 空间搬到特征空间。它不训练一个完整的小语言模型,而是复用目标模型倒数几层的隐状态,加上当前 token 的 embedding,输入一个小型 Transformer 来预测下一 token 的特征。论文给出的整体结构如下。
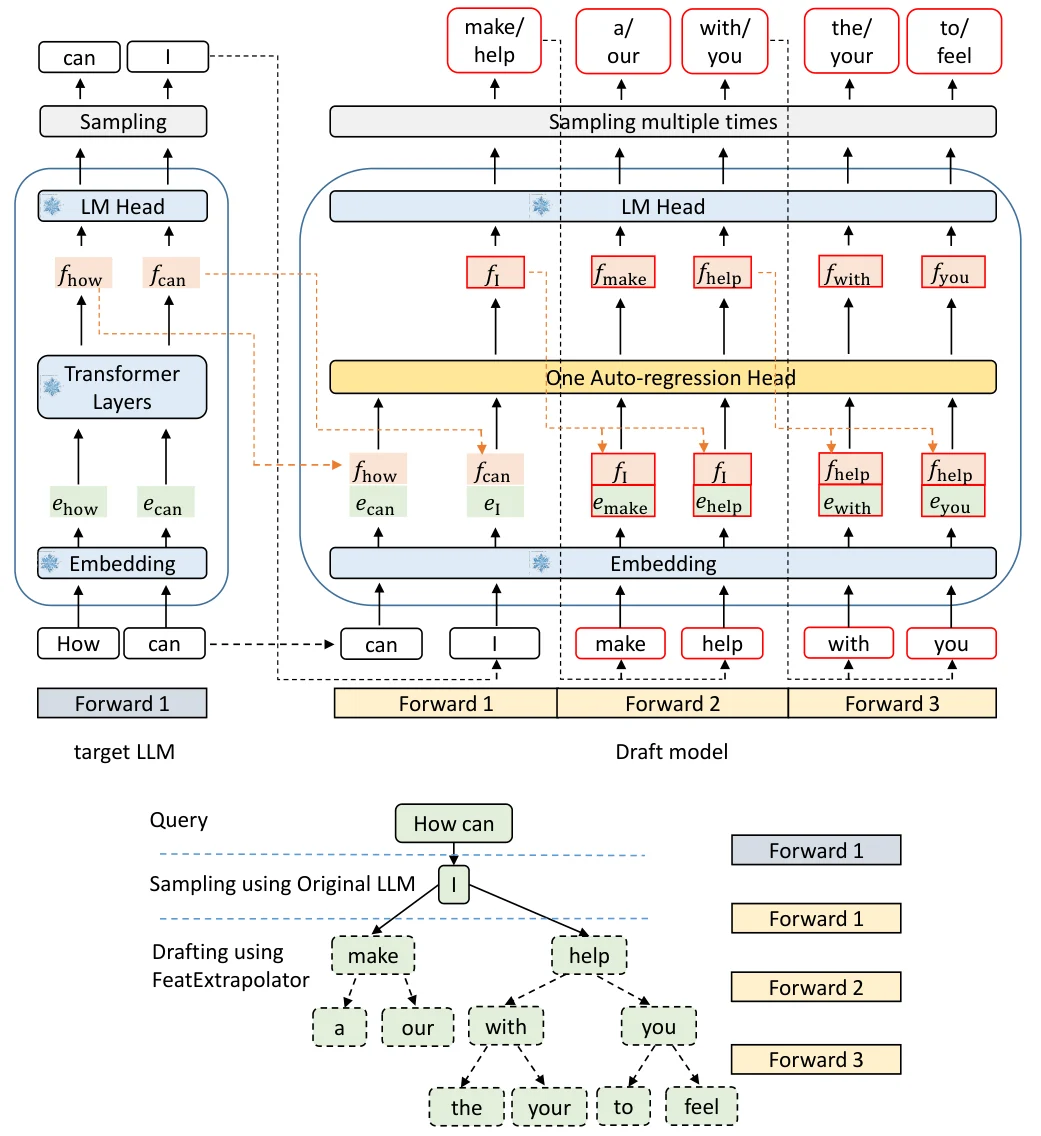
图源:EAGLE 论文(arXiv:2401.15077)图 1。
这张图解释了 uses_target_hidden_states 为什么是 EAGLE 系的核心标志:草稿头的输入不是原始 token,而是目标模型内部的特征。因此模型执行器必须在前向时额外输出中间层隐状态,eagle_aux_hidden_state_layer_ids 决定接哪几层。也解释了 needs_eagle_block_drop:位置 p 的草稿 KV 依赖位置 p 的隐状态和下一个 token,在下一个 token 被确认之前,这个 KV 是不稳定的。
Medusa 走了另一条路:不训练草稿头去预测特征,而是在目标模型最后隐状态之上接多个轻量头,每个头预测第 k 步之后的 token。它的结构如下。
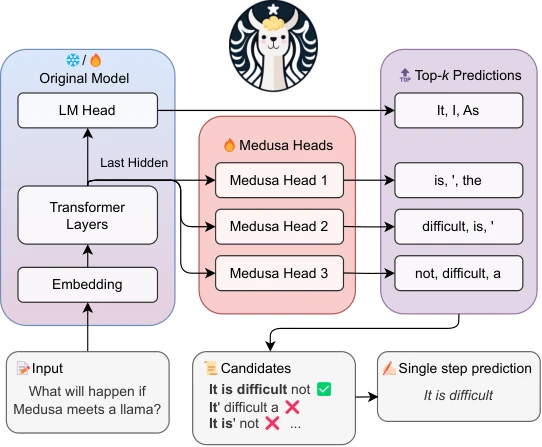
图源:Medusa 论文(arXiv:2401.10774)。
多个头并行预测,意味着候选 token 之间可能互相矛盾,验证时必须把它们组织成一棵树,而不是一条链。Medusa 论文里的树注意力示意如下。
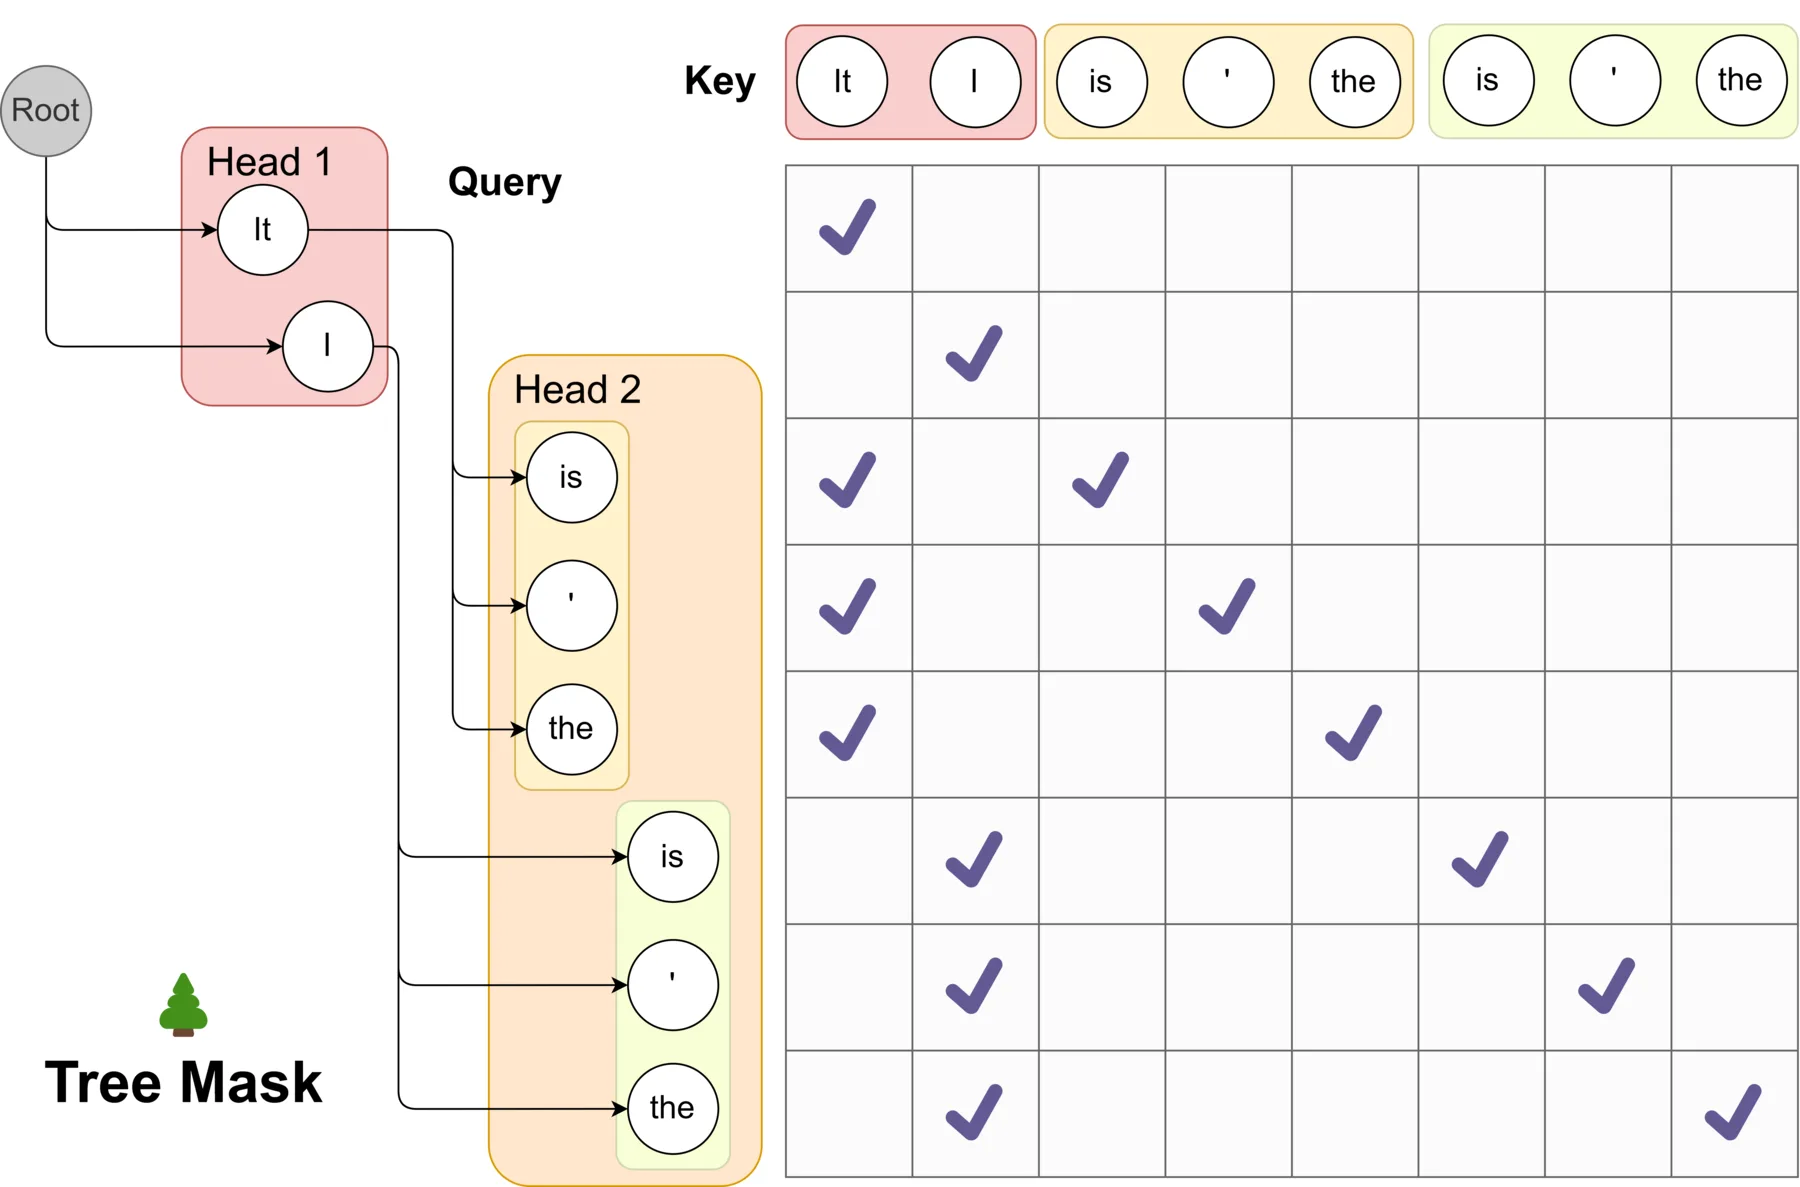
图源:Medusa 论文(arXiv:2401.10774)。
树状验证的代价是 mask 构造和输入布局更复杂。也正因为这个代价,2026 年的 vLLM 内置方法列表里已经没有 medusa:并行草稿的生态位被 DFlash 和 DSpark 占据,它们用块扩散或块并行草稿绕开了“多分支树验证”的复杂度。DFlash 的 num_lookahead_tokens = K+1 和 max_num_draft_seqs 就是为这种块式草稿准备的:后者直接用 max_num_batched_tokens // num_lookahead_tokens 算出草稿 pass 最多能容纳多少请求,因为它每个请求的草稿查询数比目标 batch 的每请求查询数更多。
这也说明配置层的 method 列表不是一张永久不变的表。旧方法会被移除,新方法会通过注册表加入;读源码时要同时看 SpeculativeMethod 和 _CONFIG_BY_METHOD,后者才是真正可用的映射。
方法之间的横向对比
把各 SpeculatorConfig 的能力标志放在一张表里,可以看出设计上的取舍。
| 方法 | 基础类 | 读目标隐状态 | 独立 workspace | lookahead | 额外槽 | 独立词表 | PCP |
|---|---|---|---|---|---|---|---|
| ngram | NgramSpeculatorConfig | 否 | 否 | 0 | 0 | 否 | 否 |
| ngram_gpu | NgramGPUSpeculatorConfig | 否 | 否 | 0 | 0 | 否 | 否 |
| draft_model | StandaloneARSpeculatorConfig | 否 | 否 | K | 1(PARD 为 K) | 是 | 否 |
| eagle | EagleSpeculatorConfig | 是 | 否 | K | 0 | 否 | 否 |
| eagle3 | Eagle3SpeculatorConfig | 是 | 否 | K | 0(P-EAGLE 为 K-1) | 否 | 否 |
| mtp | MTPSpeculatorConfig | 是 | 否 | K | 0 | 否 | 是 |
| mtp(多模块) | MultiModuleMTPSpeculatorConfig | 是 | 否 | K | 0 | 否 | 否 |
| dflash | DFlashSpeculatorConfig | 是 | 否 | K+1 | 0 | 否 | 否 |
| dspark | DSparkSpeculatorConfig | 是 | 是 | K(或 K+1) | 0 | 否 | 是 |
从这张表能读出几条设计规律。
第一,读目标隐状态的方法几乎都需要尾块丢弃。EAGLE 系用隐状态加下一个 token 造草稿 KV,DFlash/DSpark 只用隐状态,所以后两者不需要。这说明“隐状态怎么被使用”比“是否读隐状态”更能决定 KV 契约。
第二,独立 workspace 目前只有 DSpark 一个。它是一个特化的并行草稿,把整个草稿 pass 放到单独的 lane 里,避免和目标 batch 抢同一份 workspace 布局。这是一个很强的隔离,代价是显存要单独预留。
第三,PCP 支持集中在 MTP 和 DSpark,两者都是 DeepSeek 系的草稿形态。这说明 PCP 这条路径是为特定生产负载优化的,而不是通用能力。
工程实践:配置层最容易踩的坑
方法名与 checkpoint 不匹配
用户给 method="eagle",但 model 指向一个完整语言模型。源码在 __post_init__ 里不会仅凭路径判断,因为任何路径看起来都像模型。等到第一次加载草稿头时才会报张量形状不匹配。这类问题的排查成本高,是因为错误发生在加载阶段而不是构造阶段。
更推荐的做法是:model 指向带 eagle_ 前缀的头权重,让 matches 能识别;或者显式指定 method 并确保权重确实是对应形态。
草稿 TP 大于目标 TP
前面讲过,草稿 TP 只能是 1 或目标 TP。如果目标模型 TP=2,草稿给 4,_verify_and_get_draft_tp 会报错。错误消息会把两个值都打出来,定位很快。但如果用户写的是 tensor_parallel_size,会先命中占位字段检查,得到更明确的提示。
共享前缀缓存与尾块丢弃
线上服务如果同时挂了前缀缓存和 EAGLE,要注意 use_eagle_block_drop 的默认行为。前缀缓存会把已计算的 KV 块存下来,但 EAGLE 的最后一个块在被确认之前是不稳定的。源码默认丢弃这个尾块,或者启用 lookahead 哈希。多实例共享 KV 存储时,所有实例必须用同一设置,否则会出现“A 实例认为块有效、B 实例认为块无效”的不一致。
动态 K 表与 CUDA Graph
num_speculative_tokens_per_batch_size 会让每步的 K 变化。CUDA Graph 捕获时必须为每个可能的 K 捕获一份图,或者把 K 当作输入参数。前一种做法会显著增加捕获时间和显存;后一种要求草稿和验证的 kernel 能接受动态 K。
vLLM 在这件事上有一个直接的配置联动:_maybe_override_dynamic_sd_cudagraph_mode。只要启用动态投机、同时开了 full CUDA Graph、又没切到 V2 model runner,它就会把 cudagraph_mode 从 FULL 降级成 PIECEWISE,并打一条警告,提示用户如果要保留 full graph 需要设置 VLLM_USE_V2_MODEL_RUNNER=1。这是一个典型的“配置层替用户兜底”:动态验证长度会让完整图的静态形状假设失效,与其在运行期出现难以复现的崩溃,不如在启动期主动降级,把选择权明确交还用户。
此外 _maybe_disable_dynamic_sd_for_v1 处理的是另一侧:V2 在中心位置统一裁剪草稿,V1 则要求每个 proposer 自己支持变长草稿。源码维护了一份 V1 兼容的方法白名单——ngram、eagle、eagle3、mtp、draft_model、dflash。方法不在白名单里时,动态 K 会被直接清空,回退到静态 num_speculative_tokens,并打一条明确的警告。
_maybe_disable_dynamic_sd_for_data_parallel 则揭示了另一个更隐蔽的约束:数据并行下各 DP rank 可能选中不同的 K,导致各 rank 的验证长度不同、后续调度对不齐,最终出现 DP 间发散甚至死锁。源码的处理很保守——只要 DP 度大于 1 就关闭动态 K。
这三处逻辑合在一起的结论是:动态 K 是有使用条件的,而且条件不是“能不能跑”,而是“跑起来之后各组件还能不能对齐”。配置层选择在启动期直接关闭不可用的组合,而不是让用户在运行期看到偶发的卡死。
部署时如果开了动态 K,要一并评估 CUDA Graph 的成本。CUDA Graph 的桶与填充机制可以参考 CUDA Graph 的桶与垫:五个推理框架如何把动态解码批塞进静态图。
合成接受率不是加速
synthetic 拒绝采样常用于压测:固定接受率,排除模型质量波动。但它不保证输出分布与目标一致,不能当作“优化”。如果把它误用于线上,用户会发现输出质量和关掉投机时不同,但又不明白为什么。源码在注释里已经点明:它接受草稿 token 的概率是预设的,而不是由目标分布决定的。
一个完整的配置示例与逐步解析
下面这段配置同时启用了 EAGLE3 和多档动态 K,并给草稿头单独量化:
{ "method": "eagle3", "model": "org/eagle3-draft-head", "num_speculative_tokens": 4, "num_speculative_tokens_per_batch_size": [[1, 8, 4], [9, 32, 3], [33, 128, 2]], "draft_lm_head_quantization": "fp8", "draft_tensor_parallel_size": 1, "disable_eagle_block_drop": false}逐步走一遍:
method已给出且在白名单内,_validate_method直接通过;__post_init__不进入推断分支,因为method非空;get_method_config_class返回Eagle3SpeculatorConfig;model非空,configure构造草稿ModelConfig,把目标的hf_config包成EAGLEConfig;n_predict若存在,校验num_speculative_tokens与它的关系;get_speculator_config_class检查草稿是否声明了自己的配置类;未声明则用Eagle3SpeculatorConfig.specialize;_verify_args检查draft_lm_head_quantization:EagleSpeculatorConfig.supported_options包含它,但还需要草稿的head_dtype == dtype,否则报错;_verify_and_get_draft_tp确认 TP=1 合法;create_draft_parallel_config生成草稿并行配置;- 运行时调度器读
num_speculative_tokens_per_batch_size选择本步 K,KV 管理器读num_lookahead_tokens预留槽,执行器读uses_target_hidden_states输出隐状态,并读use_eagle_block_drop决定是否丢弃尾块。
第 7 步的细节值得展开。draft_lm_head_quantization 只在草稿头的 lm_head 与模型主体使用同一种 dtype 时合法。如果草稿头的 lm_head 本身已经是低精度,再套一层 FP8 量化会引入额外误差,而且目标模型验证时用的不是这个头,接受长度可能明显下降。源码选择在启动期拒绝,而不是运行时警告。
与其它框架配置层的对照
vLLM 的配置层是“声明式能力 + 运行时注册表”的组合。对照其它框架可以更清楚它的位置。
TensorRT-LLM 的投机配置分散在 builder 阶段和 executor 阶段:EAGLE-3 的草稿层和验证策略要在构建期就确定,运行期只能选择开关。它的优势是构建期可以做更激进的融合,劣势是换一种投机方法要重新构建引擎。相关实现可以参考 TensorRT-LLM 源码完全拆解(二十二):EAGLE-3 一体式草稿。
SGLang 的投机配置更接近 vLLM,同样是运行期选择 draft 模型或 EAGLE,但它的 SpeculativeAlgorithm 枚举和 vLLM 的 method 字符串不完全对应。SGLang 把“草稿器”和“验证器”分开描述,vLLM 则用一个 SpeculatorConfig 同时描述两者。
DeepInfer 的 DSpark 是另一类:草稿和验证都在一个 TileLang kernel 里完成,配置主要决定块大小和置信度调度,而不是“选哪一种草稿器”。相关实现可以参考 DeepInfer 源码完全拆解(五):投机解码。
这些差异说明:配置层的形状取决于框架把“多样性”放在哪一层。vLLM 把多样性放在 speculator 实现上,配置层只负责把它们统一成一组能力标志;TensorRT-LLM 把多样性放在构建期;DeepInfer 把多样性压缩到一个内核的参数里。
小结
SpeculativeConfig 不是一个简单的参数容器,而是 vLLM 投机解码的分派中枢。它做的事情可以归纳为四步:
- 把用户输入规范化成有约束的字段,并兼容旧参数与方法别名;
- 通过
__post_init__的三层查找,把method和草稿 checkpoint 解析成具体的SpeculatorConfig实现类; - 让实现类用
ClassVar声明能力、用 property 描述依赖字段的动态值,形成调度器、KV 管理器和执行器共同读取的契约; - 在启动期用
_verify_args把所有跨字段约束一次性检查完,把错误挡在加载之前。
读懂这一层之后,再看投机解码的草稿生成、批量验证和 KV 回滚,就能明白每一条分支的条件判断是在读哪个字段。配置层是理解整个投机解码实现的地图,后面的源码只是在照着这张地图走路。
下一篇将讨论 vLLM 的 speculator 基类与工厂:SpeculatorConfig.speculator_class 指向的那条类继承链,BaseSpeculator 的 propose 与 accept 接口约定,以及 V1 proposer 与 V2 speculator 两套实现如何在新旧模型执行器之间共存。
参考资料
- vLLM 仓库:vllm/config/speculative.py
- vLLM 仓库:vllm/v1/worker/gpu/spec_decode/speculator_config.py
- vLLM 仓库:vllm/v1/spec_decode/ngram_proposer.py
- vLLM 官方文档:Speculative Decoding
- EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads
- DeepSeek-V3 Technical Report(MTP 与多 token 预测)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



