


SGLang 源码完全拆解(十):Sampling、Grammar 与结构化输出——logits 变换、语法掩码与受限采样如何闭环
接上一篇:图重放之后,token 还不是答案
系列第九篇把 CUDA Graph 与编译路径讲完了:decode 整图捕获重放、prefill 分段图、形状分桶,以及图内张量地址必须稳定的约束。那一篇的最后留了一个明确的悬念——图重放结束之后,logits_output.next_token_logits 已经躺在显存里,但它还不是答案。一张 [batch, vocab_size] 的浮点矩阵要变成”这一轮每个请求各出一个 token”,中间还隔着整条采样流水线。
这一篇补上它。要回答的问题有四个:
- 采样参数是每请求不同的(温度、top-k、top-p、min-p、重复惩罚、
logit_bias),而 GPU 前向是一次批量的。SGLang 怎么把 N 个请求的参数压成一次设备侧运算? SamplingBatchInfo里那些is_all_greedy、need_top_p_sampling、simple_sampling_case布尔量到底在省什么?它们为什么能省出可观的延迟?- 结构化输出(JSON Schema、regex、EBNF、
structural_tag)要求在每一步只允许语法上合法的 token。这个”只允许”在设备侧是怎么表达的?语法编译为什么不能在主循环里同步做? grammar_needs_sync这条看似不起眼的判断,为什么直接决定了整个批次能不能走 overlap 调度?
先给结论式的路线:SGLang 把这一整段拆成三层——SamplingBatchInfo 负责把主机侧参数固化成设备缓冲,Sampler 负责在设备上把 logits 变成 token,GrammarManager + BaseGrammarObject 负责在设备上把不允许的 token 打成 -inf。三层之间只有一条不变量:候选 token 的最终概率分布,必须等于”先套用语法允许集,再套用采样裁剪”的结果——顺序错了,结构化输出就会和采样策略打架。
SamplingBatchInfo:把每请求参数压成设备缓冲
为什么不能逐请求算
最直觉的实现是这样的:给每个请求单独跑一遍采样,用 Python 循环遍历 reqs,每次挑出该请求的 logits 行,套用它自己的温度、top-k、top-p,然后走一次 multinomial。
这个实现在 batch size 为 1 时可以接受,在 batch size 为 200 时完全不可接受。原因不在于 Python 循环本身慢,而在于它会打碎 GPU 上的并行度:
- 每次单独采样需要一次 kernel launch。200 个请求就是 200 次 launch;按前一篇算过的每次数微秒量级,光提交开销就是毫秒级。
torch.multinomial对单行[1, vocab_size]的调用无法填满 SM。词表 15 万行、batch 1 的矩阵运算,GPU 占用率极低。- 更麻烦的是它会打断 CUDA Graph。图要求形状固定、地址固定,Python 循环意味着每步的 kernel 序列都不一样,图根本没法录。
所以 SGLang 的选择是把”每请求参数”一次性搬到设备上,变成几个行数与 batch 对齐的张量,然后整批一次算完。这就是 SamplingBatchInfo。
字段分组:五类张量加一组主机侧布尔量
SamplingBatchInfo 是 sglang/srt/sampling/sampling_batch_info.py 里一个 dataclasses.dataclass。把它的字段按用途分组,结构立刻清晰起来:
第一组:每请求标量参数,全部是设备张量。
temperatures: torch.Tensortop_ps: torch.Tensortop_ks: torch.Tensormin_ps: torch.Tensor四个张量的行数都等于当前批次的请求数。注意 top_ks 是 torch.int32 而另外三个是 torch.float——这不是随手写的,后面讲 top-k 掩码时会看到,int32 直接参与索引比较,省掉一次类型转换 kernel。
temperatures 的 shape 是 [-1, 1] 而不是 [-1]。原因很直接:它要参与 logits.div_(temperatures),而 logits 的 shape 是 [batch, vocab_size]。做成列向量才能借助广播,把”每一行整体除以该行自己的温度”表达成一次逐元素运算,而不是先 expand 出一个 [batch, vocab_size] 的温度矩阵。
第二组:主机侧布尔量,用来决定跳过哪些运算。
is_all_greedy: boolis_any_greedy: boolneed_top_p_sampling: boolneed_top_k_sampling: boolneed_min_p_sampling: bool这些字段存放在主机内存,只作为 Python 分支判断的量。它们的存在是为了解决一个纯工程问题:设备侧算子比主机侧分支贵得多。如果批次里每一个请求都用 top_p = 1.0(即不裁剪),那么 need_top_p_sampling 就是 False,整个 top-p 重归一化运算可以直接跳过——不是”算完发现没变”,而是根本不提交那个 kernel。
is_all_greedy 的作用更大。它标记的是”批内所有请求的 top_k <= 1”,也就是全部退化成 argmax。这种情况下采样根本不需要 softmax、不需要排序、不需要 multinomial,一次 torch.argmax(logits, -1) 就够了。这是整条采样路径上最大的一个捷径。
第三组:语法约束。
vocab_size: intgrammars: Optional[List[Optional[BaseGrammarObject]]] = Nonerids_int: Optional[torch.Tensor] = Nonebootstrap_room_ids_int: Optional[torch.Tensor] = Nonegrammar_mask: Optional[GrammarMask] = Nonegrammars 是一个列表,长度等于 batch,元素是每个请求对应的语法对象;普通请求对应 None。grammar_mask 是”已经填好的词表掩码 + 用哪个语法对象来应用它”,下一节展开。
第四组:惩罚项与自定义处理器。
penalizer_orchestrator: Optional[...BatchedPenalizerOrchestrator] = Noneacc_additive_penalties: Optional[torch.Tensor] = Noneacc_scaling_penalties: Optional[torch.Tensor] = Nonehas_custom_logit_processor: bool = Falsecustom_params: Optional[List[Optional[Dict[str, Any]]]] = Nonecustom_logit_processor: Optional[Dict[int, ProcessorEntry]] = Nonelogit_bias: Optional[torch.Tensor] = Noneacc_additive_penalties / acc_scaling_penalties 上各挂一句注释 Used in the overlap mode。这一点值得单独指出:在 overlap 调度里,惩罚项要在 CPU 侧提前算好并累积,因为设备侧执行和主机侧调度是并行的,采样时刻没有机会再回头读请求状态。非 overlap 模式下则直接在设备上调用 penalizer.apply(logits)。同一份语义,两条实现路径,差别只在于”什么时候算”。
第五组:采样结果回传与确定性推理。
sampling_seed: Optional[torch.Tensor] = Nonereturn_sampling_masks: Optional[List[bool]] = Nonereturn_sampling_support_logprobs: Optional[List[bool]] = Nonesampling_mask_batch_indices: Optional[torch.Tensor] = Nonesampling_support_logprobs_capture_indices: Optional[torch.Tensor] = Nonesampling_mask_top_ks: Optional[List[int]] = None最后还有一个容易被忽略的字段:
npu_top_k_top_p_eligible: bool = Falsemax_top_k: Optional[int] = Nonemax_top_k 的含义在注释里写得很清楚:所有行 top_k 的上界,若某行要从全词表采样则为 None。它后面会变成一个实打实的性能杠杆。
from_schedule_batch:一次遍历,四类固化
构造逻辑集中在 SamplingBatchInfo.from_schedule_batch。它接收 ScheduleBatch 和 vocab_size,返回一个填好的 SamplingBatchInfo。整个过程可以概括成”一次遍历请求列表,产出四类东西”。
第一类,逐请求标量张量。 用列表推导收集每个 req.sampling_params 的对应字段,构造 CPU 张量,再异步拷到设备:
_pin = is_pin_memory_available(device)temperatures = ( torch.tensor( [r.sampling_params.temperature for r in reqs], dtype=torch.float, pin_memory=_pin, ) .to(device, non_blocking=True) .view(-1, 1))这里 pin_memory + non_blocking=True 是标准配合。pin 内存的页不会被换出,DMA 引擎可以直接从它取数,H2D 拷贝不必等主机侧同步。如果源张量落在普通可分页内存上,CUDA runtime 会静默降级成同步拷贝——non_blocking 参数写了也没用。所以 is_pin_memory_available 必须真的检查,而不是想当然。
temperatures 拷贝完成后立刻 .view(-1, 1),把 [batch] 变形为 [batch, 1]。这个视图不产生拷贝,只是改 stride。
第二类,布尔量。 全部用 Python 的 all / any 在主机侧求出来:
is_all_greedy=all(r.sampling_params.top_k <= 1 for r in reqs),is_any_greedy=any(r.sampling_params.top_k <= 1 for r in reqs),need_top_p_sampling=any(r.sampling_params.top_p != 1.0 for r in reqs),need_top_k_sampling=any(r.sampling_params.top_k != TOP_K_ALL for r in reqs),need_min_p_sampling=any(r.sampling_params.min_p > 0 for r in reqs),注意 need_top_p_sampling 用的是 != 1.0 而不是 > 1.0。语义上 top_p = 1.0 等价于”不裁剪”,所以只有严格不等于 1.0 才需要真的跑 top-p 逻辑。need_top_k_sampling 用的是 != TOP_K_ALL,其中 TOP_K_ALL 是一个表示”-1 / 全词表”的哨兵值。
max_top_k 的构造同样值得看:
max_top_k=( max(r.sampling_params.top_k for r in reqs) if reqs and all(1 <= r.sampling_params.top_k < TOP_K_ALL for r in reqs) else None),它的语义是”当批内所有请求的 top_k 都落在有效区间时,取其中的最大值”。这句话之所以能成立为精确的上界而不是近似,是因为后面会看到:top-k 掩码会把排名在 top_k 之后的列全部清零,因此只有前 max_top_k 列可能保留非零概率。只对这 max_top_k 列排序,结果和全排序完全一致。
第三类,语法对象列表。 grammars=[req.grammar for req in reqs]。注意这里放的是引用而不是拷贝,因为语法状态是有状态的(每一步要 accept_token),必须与请求本体共享同一个对象。
第四类,惩罚项编排器。 构造一个 BatchedPenalizerOrchestrator,把四类惩罚器一起传进去:
penalizer_orchestrator = penaltylib.BatchedPenalizerOrchestrator( vocab_size=vocab_size, batch=batch, penalizers={ penaltylib.BatchedFrequencyPenalizer, penaltylib.BatchedMinNewTokensPenalizer, penaltylib.BatchedPresencePenalizer, penaltylib.BatchedRepetitionPenalizer, },)源码里这段代码上方有一段注释解释了为什么就算不需要惩罚也要无条件构造:每个惩罚器在自己的 _is_required() 里会先检查请求的 sampling_params,不需要就什么都不做,所以额外开销只是几个布尔判断。反过来,如果在构造阶段就做条件判断,ScheduleBatch 的 filter_batch / merge_batch 就必须处理”编排器可能不存在”这一分支,复杂度上升得比省下的判断多。
最后一步是 ret.adjusted_from_schedule_batch(batch, vocab_size),留给具体模型类的钩子。基类实现是 pass。
批参数如何跟着批变化走:filter、merge 与稀疏构造
布尔量为什么要换成设备索引
return_sampling_mask 这类能力是逐请求开启的:一个批次里可能只有 3 个请求要返回采样支持集,另外 197 个不要。天然的做法是做一个长度 200 的掩码张量,然后靠掩码选择。但那意味着采样器必须对 200 行都做捕获工作,最后再丢掉 197 行——白干。
SGLang 的做法是在主机侧先把行号筛出来,把布尔列表直接折成设备上的索引张量:
@staticmethoddef _make_sampling_mask_batch_indices( return_sampling_masks: List[bool], device: str) -> Optional[torch.Tensor]: """Build device row indices for requests that return sampling masks.""" indices = [ i for i, should_return in enumerate(return_sampling_masks) if should_return ] if not indices: return None return _rows_to_device_indices(indices, device)注意”没有任何一行需要”时返回的是 None,而不是空张量。这个区分很关键:None 让采样器连索引张量都不必创建,判断退化成一次 is not None;空张量则会走完整条捕获路径但产出零行。
_rows_to_device_indices 同样用了 pin 内存加非阻塞拷贝:
def _rows_to_device_indices( rows: List[int], device: str, pin: Optional[bool] = None) -> torch.Tensor: """Move batch row numbers to the device without blocking on a pageable copy.""" if pin is None: pin = is_pin_memory_available(device) return torch.tensor(rows, dtype=torch.long, pin_memory=pin).to( device, non_blocking=True )filter_batch:批变短时,所有行对齐张量都要跟着剪
调度器每轮都可能从批次里摘掉已完成的请求(filter_batch),或者在 overlap 模式下把新请求合进来(merge_batch)。前者对应”批变短”,后者对应”批变长”。采样参数张量的行数必须始终与 ScheduleBatch.reqs 对齐,否则第 17 个请求会拿到第 18 个请求的温度。
filter_batch 的顺序是按依赖关系排的:
def filter_batch(self, keep_indices: List[int], keep_indices_device: torch.Tensor): self.penalizer_orchestrator.filter(keep_indices_device)
if self.has_custom_logit_processor: self._filter_batch_custom_logit_processor(keep_indices)
for item in [ "temperatures", "top_ps", "top_ks", "min_ps", "sampling_seed", ]: value = getattr(self, item, None) if value is not None: setattr(self, item, value[keep_indices_device])
if self.logit_bias is not None: self.logit_bias = self.logit_bias[keep_indices_device] if self.return_sampling_masks is not None: self.return_sampling_masks = [ self.return_sampling_masks[i] for i in keep_indices ] ...三处细节值得记住:
- 惩罚器先过滤。惩罚器内部维持着”每个请求已经出现过哪些 token”的累积状态,这些状态同样是按行组织的;如果它和采样参数张量用不同的行顺序过滤,惩罚就会打到错误的请求上。
- 主机侧布尔列表用列表推导过滤,设备张量用
index_select。keep_indices是 Python 列表,keep_indices_device是同内容的设备张量。前者用于重建sampling_mask_batch_indices(必须回到主机侧枚举),后者用于张量切片(避免 H2D 同步)。 - 索引要重算而不是平移。
sampling_mask_batch_indices过滤后重新调用_make_sampling_mask_batch_indices全量重建。看起来是偷懒,其实是最稳的选择:keep_indices已经把旧行号映射到新行号了,重建一遍的复杂度是 O(batch),而”在旧索引张量上逐元素查找旧行号位置”的复杂度也是 O(batch) 但要处理映射,出错概率高得多。
merge_batch:一行注释背后的真实约束
merge_batch 里有一行顺序注释,是这批代码里少数带感叹号的地方:
self_len = len(self)other_len = len(other)
# Merge logit bias - note this has to come before the temperatures tensor update! Otherwise will cause crashes.# See note below on len(self) and len(other).self.logit_bias = merge_bias_tensor( self.logit_bias, other.logit_bias, self_len, other_len, self.device, 0.0)为什么”顺序错了会崩”?因为 SamplingBatchInfo.__len__ 的定义是:
def __len__(self): return len(self.temperatures)这一行的含义是:这个对象的行数由 temperatures 定义。而 merge_batch 后面会把 other 的 temperatures 追加到 self.temperatures 后面(torch.cat)。如果先追加再算 self_len,self_len 就变成了合并后的长度,merge_bias_tensor 会用错误的长度去铺零矩阵,行数直接错位。
这是一个典型的”隐式不变量”:对象长度没有独立字段,而是投影到某个张量上。凡是依赖长度的操作,都必须放在会改变该张量的操作之前。
logit_bias 为什么用三元组构造
logit_bias 的语义是”在某些 token 的 logits 上加减一个常量”。它是一个极其稀疏的操作:一个请求通常只影响几个 token,而词表有十几万项。如果为此分配一个 [200, 152064] 的稠密矩阵,光显存就是 200 × 152064 × 4 字节 ≈ 122 MB;即便全是零,也浪费了。
SGLang 的做法是:先分配稠密张量,但只往里写非零位置——用行号、列号、值三个列表描述:
logit_bias = Noneif any(r.sampling_params.logit_bias is not None for r in reqs): logit_bias = torch.zeros(len(reqs), vocab_size, device=device) rows, cols, vals = [], [], [] for i, r in enumerate(reqs): if r.sampling_params.logit_bias is not None: # Dedup on int(key) first ("1" and "01" collide): duplicate # indices make the index_put below nondeterministic on CUDA. row_bias = { int(key): value for key, value in r.sampling_params.logit_bias.items() } for token_id, value in row_bias.items(): rows.append(i) cols.append(token_id) vals.append(value) if rows: logit_bias[ _rows_to_device_indices(rows, device, _pin), _rows_to_device_indices(cols, device, _pin), ] = torch.tensor(vals, dtype=logit_bias.dtype, pin_memory=_pin).to( device, non_blocking=True )注释里的 "1" 与 "01" 是真实的坑:用户写 JSON 时键是字符串,{"1": 5.0, "01": -3.0} 在 int() 之后是同一个 token。如果不去重,index_put 会对同一个位置写入两次,而CUDA 上对同一地址的重复写入顺序是不确定的——同一份请求参数在不同 run 里可能得到不同的 bias,采样结果自然也不可复现。
还有一个容易忽略的细节:即便所有请求都没有 logit_bias,any(...) 为假时直接跳过整个构造,logit_bias 保持 None。稠密矩阵只在真的有请求用到时才分配。
自定义 logit 处理器:按来源字符串合并
custom_logit_processor 允许用户在请求里传一段 Python 代码字符串,服务端在加载时把它编译成一个处理器。同一批次里可能有多个请求传了完全相同的字符串。如果逐个请求各编译一份,就是重复开销。
构造阶段按字符串做了一次分组:
if has_custom_logit_processor: processor_dict = {} for i, r in enumerate(reqs): if r.custom_logit_processor is None: continue processor_str = r.custom_logit_processor if processor_str not in processor_dict: processor_dict[processor_str] = [] processor_dict[processor_str].append(i)
merged_custom_logit_processor = { hash(processor_str): ProcessorEntry( processor=CustomLogitProcessor.from_str(processor_str), rows=rows, indices=_rows_to_device_indices(rows, device, _pin), ) for processor_str, rows in processor_dict.items() }合并后的结构是”一份处理器实例 + 它作用的行列表 + 行列表的设备索引”。设备侧应用时,处理器内部可以一次处理多行(向量化的处理器),而不是每行一次 Python 调用。hash(processor_str) 作为 key 只是一种紧凑标识,真正决定等价性的是字符串本身——哈希碰撞的概率在这里可以忽略,因为同一批里的处理器数量是个位数。
惩罚项的顺序语义
惩罚项最终通过 apply_logits_bias 施加到 logits 上。这个函数把三个变换按固定顺序串起来:
def apply_logits_bias(self, logits: torch.Tensor): self._apply_pre_grammar_logits_transforms(logits)
if self.grammar_mask is not None: self.grammar_mask.apply(logits)
self._apply_post_grammar_logits_transforms(logits)其中 _apply_pre_grammar_logits_transforms 依次做三件事:
if self.acc_additive_penalties is not None: # Used in the overlap mode logits.add_(self.acc_additive_penalties)
if self.acc_scaling_penalties is not None: # Used in the overlap mode apply_scaling_penalties(logits, self.acc_scaling_penalties)
if self.penalizer_orchestrator and self.penalizer_orchestrator.is_required: # Used in the non-overlap mode self.penalizer_orchestrator.apply(logits)而 _apply_post_grammar_logits_transforms 只做一件事:
if self.logit_bias is not None: logits.add_(self.logit_bias)三段顺序背后的逻辑可以这样理解:
-
惩罚项是”软偏好”。重复惩罚、频率惩罚、存在惩罚都是在改变分布的相对大小,它们不保证任何 token 一定合法。它们必须在语法掩码之前施加,因为掩码会把不合法位置的 logits 直接打成
-inf;先打-inf再加减一个常数,-inf依然是-inf(数学上成立),但把惩罚放在掩码之后就会破坏掩码本身要表达的语义——如果惩罚刚好把一个被掩掉的 token 从-inf抬起来,非法 token 就漏出去了。实际上-inf + c仍是-inf,所以这一点在浮点算术上是安全的;真正的理由是另一条:掩码是硬约束,硬约束必须最后生效,避免任何后续运算意外给它留下缝隙。 -
logit_bias是”用户显式指定”,放在最后。它是用户对最终 logits 的直接干预,语义上应该作用在”已经经过所有系统级变换”的分布上。更重要的是:logit_bias可以用来提升某些 token 的分数,如果它作用在掩码之前,掩码可能把用户想要的 token 直接删掉,用户会看到一个”我明明加了 bias 却没用”的结果。放在最后,语义变成”在系统允许的候选集里,按用户的偏好加权”。 -
加性惩罚先于乘性惩罚。加性惩罚(
logits += penalty_slice)作用于原始 logits;乘性惩罚(重复惩罚是把 logits 除以或乘以一个缩放系数,apply_scaling_penalties)作用于更新后的 logits。顺序反过来会得到不同结果——这是设计选择,不是数学等价变换。SGLang 在accumulate_additive_penalties里明确把”只跑非乘法惩罚器”和”累积所有乘法惩罚器”分成了两个方法,为的就是让这两类在 overlap 模式下也能保持各自的相对顺序。
Sampler:从 logits 到下一个 token
调用点:前向结束的第一件事
在 ModelRunner 里,采样是前向返回后紧接着的一步。sample() 的开头还有两句容易被忽略的清理动作:
logits_output.auxiliary_device_output = Noneobserver = self.sampling_observer第一行注释解释了它的存在:
# LogitsProcessorOutput is normally invocation-scoped, but CUDA graph# runners may reuse backing objects. Never leak an auxiliary result from# a previous replay into a request with no observer state.这正是第九篇埋下的约束在采样侧的回声:图重放会复用对象。LogitsProcessorOutput 在普通路径上是每次调用新建的,但走图重放时承载它的对象可能是上一轮留下的。如果不显式清理 auxiliary_device_output,一个没开观察器的请求可能读到上一轮的辅助结果。
接着是真正的采样调用:
next_token_ids = self.sampler( logits_output, forward_batch.sampling_info, forward_batch.return_logprob, forward_batch.top_logprobs_nums, forward_batch.token_ids_logprobs, # For prefill, we only use the position of the last token. ( forward_batch.positions if forward_batch.forward_mode.is_decode() else forward_batch.seq_lens - 1 ),)六个参数里有五个是语义参数,只有最后一个是”计算位置”参数。它的表达式值得停下来看:decode 用 positions,prefill 用 seq_lens - 1。
原因是两个模式下的行语义不同:
- decode 时,batch 里每个请求刚好贡献一行 hidden state,那一行就是”该请求当前最后一个位置”。它对应的绝对位置就是
positions。 - prefill 时,一个请求可能贡献几千行(整个 prompt 的所有位置),但
LogitsProcessor只取其中最后一行的 logits 进入next_token_logits。这一行在序列里的绝对位置是seq_lens - 1(序列长度减一)。
这个位置值最终会被传给采样器,用于确定性采样的 seed 派生——同一请求在不同批组成下必须得到同一个随机数序列,位置是最自然的无状态随机源。
_preprocess_logits:两件必须在采样前做完的事
def _preprocess_logits( self, logits: torch.Tensor, sampling_info: SamplingBatchInfo) -> torch.Tensor: """Apply custom logit processors and sanitize non-finite logits.""" if sampling_info.has_custom_logit_processor: apply_custom_logit_processor(logits, sampling_info) sanitize_nan_logits(logits, "sampler: next_token_logits") return logits两件事的动机完全不同:
- 自定义处理器先跑。用户传进来的代码块可能做任何 logits 变换,它应当看到”模型原始输出”,而不是被清洗过的输出。
- NaN 清洗后跑。模型前向可能产出
NaN/Inf(数值溢出、量化反量化误差、fp8 scale 异常都会导致)。一旦某个位置是NaN,softmax 会把整行都变成NaN,然后multinomial会直接抛异常或返回未定义结果。清洗的做法是把非有限值替换成一个足够小的有限数,让这一行依然可采样——宁可采出一个”不好”的 token,也不要整条请求崩掉。
贪心路径:一行 argmax 解决大半批次
if sampling_info.is_all_greedy: if _use_aiter and not _disable_aiter_greedy_sample: batch_next_token_ids = torch.empty(...) _aiter_greedy_sample(batch_next_token_ids, logits) else: batch_next_token_ids = torch.argmax(logits, -1) if return_logprob: original_logprobs = logprobs = torch.nn.functional.log_softmax( logits, dim=-1 )在 AMD 平台(_use_aiter 为真且未被显式关闭)上会走一个融合的贪心采样 kernel,直接写 int32 输出;其余平台用 torch.argmax。
注意贪心分支完全跳过了:温度缩放、softmax、top-k/top-p/min-p 裁剪、multinomial。这就是 is_all_greedy 这个布尔量的全部价值——它把一个”排序 + 归一化 + 多项式采样”的序列压缩成一次归约。
但即便全贪心,如果请求要求 logprobs,还是要跑一次 log_softmax。这里没有用 log(softmax(x)) 的两步写法,而是直接调用 F.log_softmax。原因在下一节讲。
采样主路径的骨架
非贪心路径的骨架如下(去掉各后端细节):
else: simple_sampling_case = ( not sampling_info.need_top_p_sampling and not sampling_info.need_top_k_sampling and not sampling_info.need_min_p_sampling ) ... logits.div_(sampling_info.temperatures) ... # In-place op to save memory logits[:] = ( torch.softmax(logits, dim=-1) if self.enable_deterministic else sampler_softmax(logits) ) probs = logits batch_next_token_ids, sampling_mask_capture = self._sample_from_probs( probs, sampling_info, positions, simple_sampling_case )三行里各有讲究:
logits.div_(sampling_info.temperatures)。 温度缩放就是在 softmax 之前把 logits 除以 T。写成原地操作(div_)的理由是显存:[batch, vocab_size] 在这个规模上是几十到上百 MB,新建一个张量意味着在这条每步都要跑的路径上增加一次分配与一次读写。原地版本只读一遍写一遍。
logits[:] = torch.softmax(...) 而不是 probs = torch.softmax(logits, ...)。 同样是原地。这里用切片赋值而不是 logits = ... 是有意的:切片赋值保持原张量对象与地址不变,只改内容。这一点对 CUDA Graph 至关重要——图里记录的是地址,如果换成一个新张量,图内引用就悬空了。
softmax 的选择随 enable_deterministic 切换。 sampler_softmax 是 SGLang 自研采样算子包里的 kernel(from sglang.kernels.ops.sampling import softmax as sampler_softmax),走的是融合实现;torch.softmax 则是 framework 自带的实现。两者数学等价,但在浮点末位可能不同。确定性推理要求 bitwise 可复现,因此走 framework 的 torch.softmax。这是一个”为了可复现性牺牲一点性能”的取舍,且在 RL on-policy、评测复现这类场景下是必要代价。
概率裁剪的数学:三把刀的不同
在进入 _sample_from_probs 之前,先把三种裁剪的数学说清楚,因为后面几个后端的差异全都源于它们。
设当前行的 logits 为 ,温度为 ,则采样用的分布是
温度只改变分布的”尖锐程度”: 时分布趋近 one-hot(等价于贪心), 时趋近均匀分布。它在 softmax 内部起作用。
top-k 保留概率最高的 项,其余清零,然后重新归一化:
top-p(nucleus sampling)保留累积概率刚好超过 的最小前缀:
这里的写法(按”概率严格大于 的项之和小于 “来定义)和常见的”从大到小累加直到超过 “是同一件事的两种表述,只是它天然处理了概率相等时的并列——并列项要么全进集合,要么全不进。
min-p 与上面两把刀不同:它不是固定数量的裁剪,而是以当前分布自身为基准设阈值:
min-p 的价值在于自适应。当模型非常确定时( 接近 1),阈值几乎是 的一个固定比例,保留下来的候选很少;当模型不确定时( 可能只有 0.05),阈值也按比例缩小,候选集合自动变大。这正是固定 top-k 做不到的事情——固定 在模型确定时会引入大量无意义候选,在模型不确定时又会砍掉本该保留的可能性。
三个裁剪可以叠加。SGLang 在 flashinfer 后的 min-p 路径里按 top-k → top-p → min-p 的顺序逐步重归一化,最后把结果交给 min_p_sampling_from_probs;在没有 min-p 的路径里则交给一个融合的联合裁剪采样器(filter_apply_order="joint")。
后端分支:三条路径,三种语义边界
_sample_from_probs 在”非简单情形”下按 get_exec().kernel.sampling_backend 分流。
flashinfer / intel_xpu 后端。 这一段开头就是一个断言:
assert sampling_info.sampling_seed is None, ( f"Sampling seed is not supported for {backend} backend")种子采样与这个后端不兼容,必须在配置阶段就排除组合,而不是运行到一半才发现随机性不可复现。这个断言是”启动即失败”原则的体现。
接着按是否需要 min-p 分成两支:
if sampling_info.need_min_p_sampling: probs = top_k_renorm_prob(probs, sampling_info.top_ks) probs = top_p_renorm_prob(probs, sampling_info.top_ps) batch_next_token_ids = min_p_sampling_from_probs( probs, sampling_info.min_ps )else: batch_next_token_ids = top_k_top_p_sampling_from_probs( probs.contiguous(), sampling_info.top_ks, sampling_info.top_ps, filter_apply_order="joint", )有 min-p 时走”三次独立裁剪 + 一次采样”,每次裁剪都做重归一化(renorm);没有 min-p 时走一个融合算子,filter_apply_order="joint" 说明在这个融合核心里 top-k 与 top-p 是联合施加的,而不是先 k 后 p 的两段式。这两种顺序给出的分布不同——“joint”通常指同时按两个条件切出交集支撑集,而不是先裁 k 再在剩下的里面裁 p。
pytorch 回退后端。 走一段纯 torch 实现(top_k_top_p_min_p_sampling_from_probs_torch),源码注释直言 A slower fallback implementation with torch native operations.。这条路径的存在是为了在缺少 flashinfer/sgl-kernel 的环境里保持功能可用,代价是性能;而它也是唯一支持”种子采样 + 裁剪同时开启”的路径:
if need_min_p_sampling: # TODO: probs_sort should be re-normalized for the use of multinomial_with_seed assert sampling_seed is None, ( "With sampling seed, multinomial_with_seed will provide wrong results" ) min_p_thresholds = probs_sort[:, 0] * min_ps probs_sort[probs_sort < min_p_thresholds.view(-1, 1)] = 0.0注意那行 assert:min-p 与种子采样在 pytorch 路径上也不能同时开。理由是 min-p 需要按行最大值算阈值,而 multinomial_with_seed 的数值路径与这里裁剪后的权重语义不一致(注释里写的 probs should be re-normalized 是同一个问题)。这类”组合不可用”的显式断言,比悄悄给出错误分布要好得多。
Ascend 后端。 从 logits 直接采样:_forward_ascend_backend(logits, sampling_info, simple_sampling_case, return_logprob, positions)。它的存在说明采样层已经不是纯 CUDA 假设,而是按设备类型分派。
三条路径的共同语义是:都从同一份 probs 出发,按 top_ks / top_ps / min_ps 的行值裁剪,然后采样。差异只在于实现粒度与允许的参数组合。
max_top_k:一个精确的加速上界
pytorch 回退路径里有一段关于排序的注释,是这条路径上最值得读的工程细节:
# The top-k mask below zeroes every column at rank >= top_k, so the max_top_k# leading columns carry all the mass that survives and sorting only those is# exact. The seeded path keeps the full sort because the order of tied# probabilities may depend on k, which is a batch-wide value, and# deterministic inference must not depend on the batch composition.if ( max_top_k is not None and max_top_k < probs.shape[-1] and sampling_seed is None and not return_filtered_probs): probs_sort, probs_idx = torch.topk(probs, k=max_top_k, dim=-1, sorted=True)else: probs_sort, probs_idx = probs.sort(dim=-1, descending=True)这段话把”什么时候能只排前若干列”讲得很完整:
- top-k 掩码会把排名在
top_k之后的所有列清零,所以只有前 列可能保留概率()。对前 列做topk,等价于对全部列做sort后再截断。 - 但如果开了种子采样,必须全排序。原因写得非常精确:概率相等时的相对顺序可能依赖于 ,而 是一个批次级的值(同一行在不同批组成下可能拿到不同的
top_k截断),如果只排前 列,同一请求在不同批次里的排列顺序可能变化,随机数映射到 token 的结果就会变化——这正好破坏了确定性推理的定义。 - 第三/第四个条件是
return_filtered_probs(要返回完整支持集时不能截断)和max_top_k存在且小于词表。
max_top_k 就是前面 from_schedule_batch 里算出来的那个上界,而在 filter_batch 的注释里还专门写了”任何大于等于真实最大值的值都能保持精确”。这两处合起来构成一个完整的设计:上界只需要保守,不需要精确——保守上界只影响截断后的排序宽度,不影响结果的正确性。
logprobs 的数值一致性:为什么必须用同一个核
采样路径末尾,return_logprob 为真时要计算返回给用户的 logprobs。这里有一处非常细的分叉,源码用大段注释解释:
# Deterministic inference must derive the returned logprobs# from F.log_softmax — the same kernel prefill rescoring uses —# not log(softmax(x)) below: the two disagree at ~1e-6 despite# being mathematically equivalent, which breaks bitwise# prefill/decode logprob alignment.if ( return_logprob and self.enable_deterministic and logprobs_via_logsoftmax_kernel is None and not SGLANG_RETURN_ORIGINAL_LOGPROB): logprobs_via_logsoftmax_kernel = torch.nn.functional.log_softmax( logits, dim=-1 )
logits[:] = ( torch.softmax(logits, dim=-1) if self.enable_deterministic else sampler_softmax(logits))probs = logits...if return_logprob and not SGLANG_RETURN_ORIGINAL_LOGPROB: logprobs = ( logprobs_via_logsoftmax_kernel if logprobs_via_logsoftmax_kernel is not None else torch.log(probs) )数学上 与 完全相等,但在浮点算术里它们不是同一个函数:softmax 先把每一项归一化再取对数,log_softmax 则用对数空间里的稳定形式(减去最大值再取 log 与 exp 的组合)一次算完。两条路径的相对误差可以到 量级。
这个误差本身无关痛痒,但它会破坏 prefill 与 decode 之间的一致性:prefill 阶段重算 logprobs 用的是 log_softmax(rescoring),decode 阶段如果用 log(probs),同一个 token 在两个阶段拿到的 logprob 会差一点点。对于需要把两段拼起来做序列级似然计算的场景(RL on-policy 打分、评测的 per-token logprob 对齐),这一点差异足以让结果不可复现。所以确定性模式下强行统一到 log_softmax。
顺带一提,环境变量 SGLANG_RETURN_ORIGINAL_LOGPROB 为真时返回的是温度缩放之前的 logprobs——这时的 original_logprobs 在分支入口就独立算好了,避免被后面原地的温度和 softmax 覆盖。这两种口径(原始分布 vs 采样后分布)在 RL 场景里语义完全不同,必须靠开关明确区分,不能靠”看代码猜”。
LogitsProcessor 与 LogitsProcessorOutput:采样参数的容器
为什么要有独立的 LogitsProcessor
sglang/srt/layers/logits_processor.py 里的 LogitsProcessor 做的是从 hidden states 到 logits 这一步,即 LM head 的调用与并行分片的重组。它和采样器是上下游关系,但在源码里被刻意分成了两个模块。分开的理由有三条:
-
只有部分行需要 LM head。生成时只需要每个请求最后一行;如果一次前向有 8000 个 token 但只有 4 个请求要出 token,那只需要算 4 行的 logits。
LogitsProcessor通过_get_pruned_states把 hidden states 按需求裁剪,_get_hidden_states_to_store决定哪些行要留。这一层裁剪发生在 LM head 之前,能省掉大量矩阵乘。第九篇 讲的图重放之所以还能保留这一层裁剪,是因为裁剪本身也是在设备上做的(用索引张量),可以录进图。 -
词表并行需要 all-to-all。张量并行下 LM head 的词表被切成
tp_size份,每份产出一个[rows, vocab_shard]的局部 logits;要得到完整词表,需要把各个分片的词表维拼起来。源码里用_gather_attn_tp_logits或_tp_lm_head_all_to_all两条路径实现,后者还要在_reassemble_tp_lm_head_all_to_all_output里做一次布局转换。
第三点的注释把两种布局讲得很清楚:
def _reassemble_tp_lm_head_all_to_all_output( all_to_all_output: torch.Tensor,) -> torch.Tensor: """Convert source-major all-to-all output to row-major full-vocab logits.
Each source TP rank contributes ``[local_rows, vocab_shard]`` for this destination DP rank. ``all_to_all_single`` concatenates those contributions along dim 0, while the sampler expects the vocab shards concatenated along dim 1. """all_to_all_single 的语义是”沿第 0 维拼接各来源的贡献”,于是结果是 [tp_size * local_rows, vocab_shard]——来源优先(source-major)。而采样器需要的是 [local_rows, tp_size * vocab_shard]——行优先 + 词表拼接(row-major)。两者是同一个数据的不同排布,必须做一次显式 reshape + transpose 才能对齐。这段代码的存在说明一件事:并行策略的选择会一路渗到采样器接口,采样器必须知道自己拿到的 logits 是完整词表还是分片。
- “只算 logprob 不算 token”是一条独立路径。评分类请求(打分、重排序、多条目打分)只需要 logprobs,不需要采样。这时走的是
compute_logprobs_only,它直接跳过整个采样器主路径:
def compute_logprobs_only( self, logits_output: LogitsProcessorOutput, sampling_info: SamplingBatchInfo, top_logprobs_nums: List[int], token_ids_logprobs: List[List[int]],) -> None: logprob_result = self.output_logprob_processor.compute_logprobs_only( next_token_logits=logits_output.next_token_logits, top_logprobs_nums=top_logprobs_nums, token_ids_logprobs=token_ids_logprobs, preprocess_fn=partial(self._preprocess_logits, sampling_info=sampling_info), ) if logprob_result is not None: logprob_result.write_output_to(logits_output)注意 preprocess_fn 是把 _preprocess_logits(含自定义处理器与 NaN 清洗)以偏函数形式传进去的。也就是说,即便不算 token,logprobs 也必须经过和采样路径完全相同的预处理。这是一个正确性要求:用户拿到的 logprob 必须与”如果此时真的采样”所面对的那个分布一致,否则自定义处理器和惩罚项的效果就对不上。
LogitsProcessorOutput 的五段结构
LogitsProcessorOutput 的字段注释里自带分段,直接照着读就清楚了:
Part 1,由 LogitsProcessor 填充。
next_token_logits: Optional[torch.Tensor] # shape: [#seq, vocab_size]hidden_states: Optional[torch.Tensor] = None # 供 EAGLE 等投机解码使用hidden_states_token_indices: Optional[torch.Tensor] = Nonenext_token_logits 的注释里有一句重要的限定:Can be None for certain prefill-only requests (e.g., multi-item scoring) that don't need next token generation。也就是说,这个字段允许为空,下游必须处理。多条目打分这类请求只需要输入位置的 logprobs,根本不需要”下一个 token”。
hidden_states 是给投机解码(尤其是 EAGLE 系)留的:草稿头需要的不是 logits,而是最后一层(或若干层)的隐状态。所以 LogitsProcessor 在算出 logits 的同时把这些行也存下来,避免再来一次前向。
Part 2,由 Sampler 填充。
next_token_logprobs: Optional[torch.Tensor] = Nonenext_token_top_logprobs_val: Optional[List] = Nonenext_token_top_logprobs_idx: Optional[List] = Nonenext_token_token_ids_logprobs_val: Optional[List[Union[List[float], torch.Tensor]]] = Nonenext_token_token_ids_logprobs_idx: Optional[List] = Nonesampling_mask_output: Optional[SamplingMaskOutput] = Nonenext_token_sampling_mask_idx: Optional[...] = Nonenext_token_sampling_logprobs: Optional[...] = Nonenext_token_sampling_mask_status: Optional[List[Optional[int]]] = None三类语义要区分:
next_token_logprobs是实际选中 token 的 logprob。next_token_top_logprobs_*是”概率最高的 k 个 token 分别是什么、logprob 是多少”,用于展示与调试。next_token_token_ids_logprobs_*是”用户点名要的那几个 token 的 logprob”,用于特定分析。注释里明确写了它Can contain either lists or GPU tensors (for delayed copy optimization in prefill-only requests)——这是延迟拷贝优化:prefill 阶段先留在设备上不搬到主机,把 H2D 拷贝推迟到真正需要时。
sampling_mask_output 是前面 return_sampling_mask 一路追下来的产物,它的字段定义在 SamplingMaskOutput:
token_ids: torch.Tensorlengths: torch.Tensorselected_logprobs: torch.Tensorsupport_logprobs: Optional[torch.Tensor]statuses: torch.Tensornum_accept_tokens: Optional[torch.Tensor] = None
def map_device_tensors(self, fn) -> None: self.token_ids = fn(self.token_ids) ...map_device_tensors 把”对该结构中所有设备张量施加同一个变换”抽象出来。这个变换通常是 .cpu() 或 .numpy()——把整块结果一次性搬到主机。而 statuses 字段的类型是:
class SamplingMaskStatus(IntEnum): """Ordered by severity so distributed MAX reaches one policy decision."""
OK = 0 OVERFLOW = 1 INVALID = 2注释说明了为什么是”有序”的:在分布式场景里,各 rank 各自判断自己那部分的状态,用 MAX 归约就能得到”最严重的那个状态”,各 rank 因此对同一请求得出同一个策略决定。如果状态只是无序的枚举(比如用字符串或任意整数),就没法用归约来统一。这一个注释把”枚举值也必须设计顺序”讲透了。
Part 3,prefill-only 的输入位置 logprobs。
input_token_logprobs: Optional[torch.Tensor] = Noneinput_top_logprobs_val: Optional[List] = Noneinput_top_logprobs_idx: Optional[List] = Noneinput_token_ids_logprobs_val: Optional[List[Union[List[float], torch.Tensor]]] = Noneinput_token_ids_logprobs_idx: Optional[List] = Noneinput_logprobs_copy_done: Optional[torch.cuda.Event] = None注意 input_logprobs_copy_done 是一个 CUDA Event 而不是布尔量。它的用途是标记”从借来的图缓冲里拷出输入 logprobs”这件事已经完成。为什么需要它?因为前面讲过图重放会复用缓冲,如果不记录拷贝完成,下一轮重放可能覆盖掉还没落地主机的内容。用 Event 而不是同步等待,是为了让主机侧可以在真正需要数据时才 block,中间继续做别的事。
Part 4,扩散语言模型专用。
full_logits: Optional[torch.Tensor] = None扩散 LLM 一次前向要产出多个位置的完整 logits,不是”每请求一行”的结构,所以要单独一个字段。
Part 5,自定义信息。
customized_info: Optional[Dict[str, List[Any]]] = None一个设计观察:为什么采样结果不直接写在 SamplingBatchInfo 上
把 logprobs、top-logprobs、采样支持集都挂到 LogitsProcessorOutput 上,而不是挂回 SamplingBatchInfo,原因是生命周期不同:
SamplingBatchInfo是批次级对象,跟着ScheduleBatch走,它的生命周期是”这个批次存在多久”,并且在filter_batch/merge_batch时会被改写。LogitsProcessorOutput是一次前向调用的产物,它承载的是”这一轮所有请求各自的输出”,随后由调度器的结果处理器转成每个请求的增量。
如果采样结果写在批次对象上,那么在 overlap 模式下——前向还在设备上跑,主机侧已经在为下一轮改写批次结构——就会发生读写冲突。分开两个对象,等于把”这一轮的结果”和”下一轮的参数”物理隔离。
结构化输出:把语法变成每步的位掩码
请求带语法时,链路会多出一段
结构化输出的输入是一段语法描述;输出是”每一步只允许语法上合法的 token”。SGLang 支持的四种描述形式在 GrammarManager.process_req_with_grammar 里一目了然:
if ( req.sampling_params.json_schema is not None or req.sampling_params.regex is not None or req.sampling_params.ebnf is not None or req.sampling_params.structural_tag is not None):各自的语义:
json_schema:给一段 JSON Schema,输出必须是一个满足该 schema 的 JSON 对象。regex:给一段正则,输出必须匹配它。ebnf:给一段扩展巴科斯范式文法,输出必须由该文法生成。structural_tag:不是”整段输出都必须符合”,而是”某些片段必须符合”。典型用法是”输出{"name": <任意文本>, "arguments": <JSON Schema 约束的对象>}”——只有指定片段受约束,其余部分是自由文本。
把这四种描述翻译成”每步合法 token 集合”,需要先构造一个下推自动机(pushdown automaton,PDA)。为什么不能只用有限状态机?因为 JSON 的嵌套结构(对象里套数组、数组里套对象)在语言层面是上下文无关的,而有限状态机只能表达正则语言。XGrammar 的做法是用 PDA 解析 CFG,再把 PDA 的接受条件映射到词表上。
关于”从 schema 到自动机”这一步的直观形态,LMSYS 的压缩 FSM 技术解读里给了一个很清楚的例子:
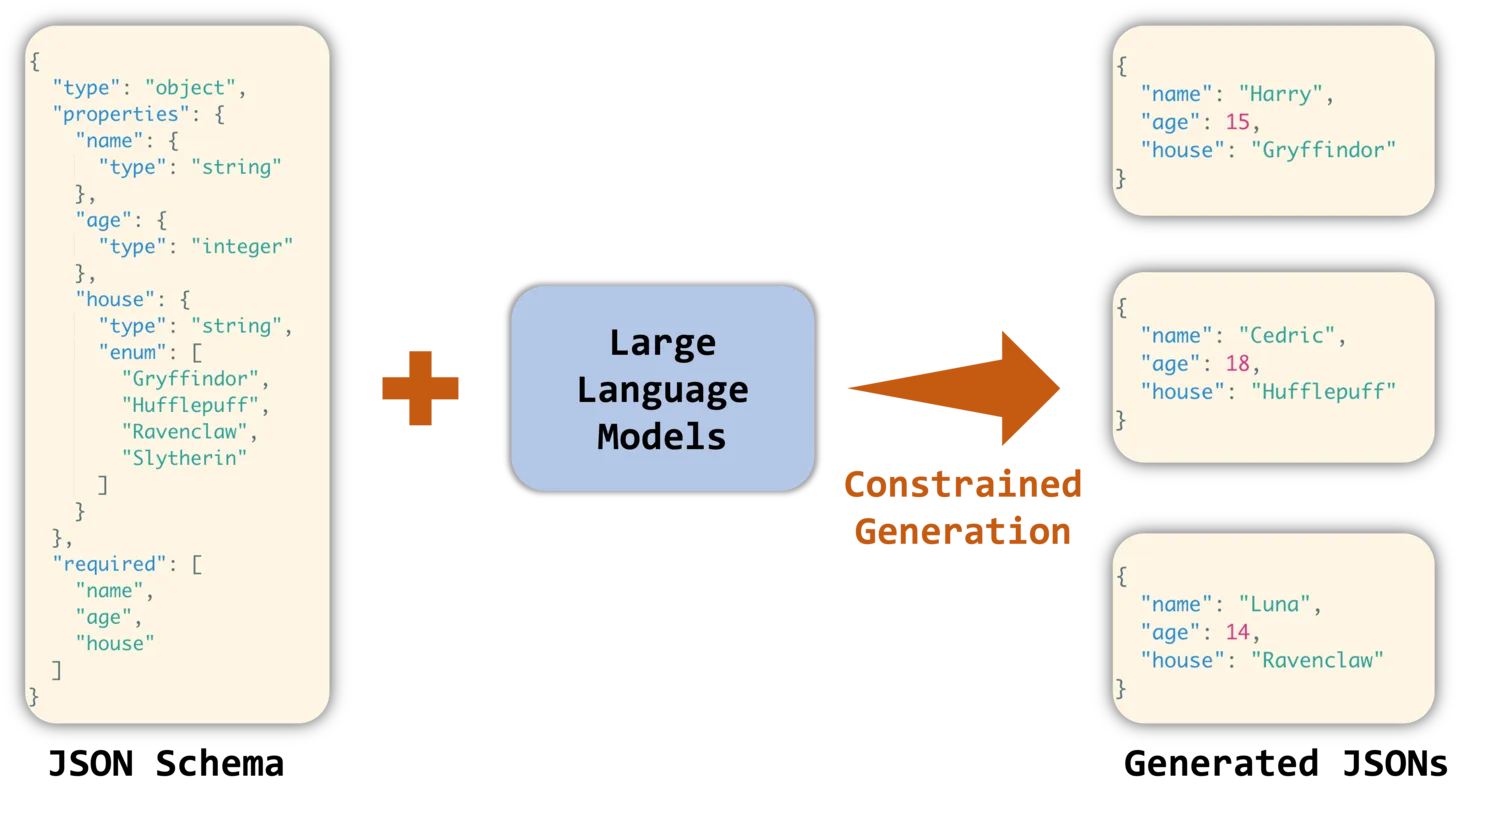
上图(来源:LMSYS 博客 Compressed Finite State Machine)演示的是约束如何落成状态机:初始状态只允许 {,进入对象后允许的转移变成键名、冒号、值……每走一步,状态机就前进一格。SGLang 的实现比这张图更复杂(它用 PDA 处理嵌套),但”约束 = 状态机 + 当前状态决定合法输入集合”这条主线是一致的。
编译必须异步:为什么请求要先在 grammar 队列里等
最容易踩的坑是把语法编译放在主循环里同步做。GrammarManager 用队列 + Future 的结构避免这件事:
value, cache_hit = self.grammar_backend.get_cached_or_future_value( key, req.require_reasoning)req.grammar = value
if not cache_hit: req.grammar_key = key add_to_grammar_queue = Trueelse: if isinstance(value, InvalidGrammarObject): error_msg = f"Failed to compile {key[0]} grammar: {value.error_message}" req.set_finish_with_abort(error_msg) else: self._apply_request_reasoning_config(req)
if add_to_grammar_queue: self.grammar_queue.append(req)几个关键点:
key 是二元组,类型在前。 从代码往上读可以看到键的构造方式:("json", schema) / ("regex", pattern) / (key_type, ebnf)(其中 key_type 可能是 ebnf 或 full_assistant_ebnf)/ ("structural_tag", tag)。类型必须进 key,否则同一段字符串作为 regex 和作为 EBNF 会被当成同一个缓存条目。
未命中时拿到的不是对象,而是一个 Future。 get_cached_or_future_value 的实现直接把编译任务丢进线程池并返回 Future:
def get_cached_or_future_value( self, key: Tuple[str, str], require_reasoning: bool) -> Tuple[BaseGrammarObject | Future[BaseGrammarObject], bool]: value = self.cache.get(key) if value: copied_value = value.copy() copied_value.maybe_init_reasoning(require_reasoning) return copied_value, True value = self.executor.submit(self._init_value_dispatch, key, require_reasoning) return value, False线程池(ThreadPoolExecutor)而不是进程池,因为编译是纯 Python 的解析工作(XGrammar 的 C++ 编译部分释放了 GIL,但调度层是 Python)。放进后台线程的目的不是”并行加速”,而是不阻塞主循环:主循环每轮要处理几百个请求的调度决策,一个语法编译可能几十毫秒,同步做就是几十毫秒的调度真空。
未就绪的请求不进 waiting_queue,而是留在 grammar_queue。 这是整个设计里最关键的一条纪律。语法没编译完,意味着”合法 token 集合未知”;如果让这种请求进入调度,调度器会正常给它分配 KV、正常前向、正常采样——采出的 token 可能是非法的。所以不能调度,必须等。
get_ready_grammar_requests:轮询、超时与分布式一致性
等到语法就绪这一步是个小型轮询循环:
start_time = time.perf_counter()while time.perf_counter() - start_time < self.SGLANG_GRAMMAR_POLL_INTERVAL: for i, req in enumerate(self.grammar_queue): if i in ready_req_idxs: continue
if (req.finished() or req.grammar is None): # It is aborted by AbortReq ready_req_idxs.add(i) continue
assert isinstance(req.grammar, futures.Future), f"{req=}" if req.grammar.done(): ready_req_idxs.add(i)
if len(ready_req_idxs) == len(self.grammar_queue): break
# Sleep a bit to avoid busy waiting time.sleep(self.SGLANG_GRAMMAR_POLL_INTERVAL / 10)三处工程考虑:
-
轮询有上限。 循环条件里的
SGLANG_GRAMMAR_POLL_INTERVAL是”最多等多久”,而循环内部每次sleep(interval/10)让 Python 有机会让出 GIL 并避免忙等(纯while自旋会把一个 CPU 核吃满,同时拖慢同进程里的前向主机侧逻辑)。 -
被 abort 的请求也算”就绪”。 注释写得很清楚:
It is aborted by AbortReq。一个已被取消的请求不会再有语法需要,把它标成 ready 是为了让它尽快离开队列,而不是永远卡在这里等待一个永远不会完成的编译。 -
失败判定在轮询结束之后统一做。 超过轮询上限仍未 ready 的请求,用
grammar_wait_ct计数;达到SGLANG_GRAMMAR_MAX_POLL_ITERATIONS才算失败。注释里给出了实际等待时间的量级估算:
# The actual waiting time is SGLANG_GRAMMAR_MAX_POLL_ITERATIONS * max(SGLANG_GRAMMAR_POLL_INTERVAL, GPU_forward_batch_latency)这句话的意思是:等待的粒度不是 poll interval,而是”poll interval 与每轮前向延迟的较大者”——因为轮询本身发生在调度循环里,每轮之间至少要等一次前向完成。所以想通过调小 poll interval 来缩短超时是无用的,真正的粒度被前向延迟锁住。
分布式一致性是这一段最容易出错的地方。 语法是否就绪的判断必须在所有 rank 上一致,否则会出现”A rank 认为这个请求能调度、B rank 认为不能”的分裂。源码的处理是:PP0 的每个 rank 各自算出本地 ready/failed 集合,然后在 DP/TP 组内做 all_gather_object:
synced_ready_req_idxs = set.intersection(*[x[0] for x in all_gather_output])synced_failed_req_idxs = set.union(*[x[1] for x in all_gather_output])ready 取交集、failed 取并集,两个方向的保守性刚好相反:
- ready 取交集 = “所有 rank 都认为就绪,才算就绪”。任何一个 rank 的编译还没完成,整个组就都等。
- failed 取并集 = “任何一个 rank 认为失败,就算失败”。不允许”某个 rank 觉得还能再等等”。
这两个选择合起来保证的是一条语义:宁可多等,不可分歧。然后在 PP 场景下,PP0 的决定还要通过 point-to-point 通信传给后续 stage:
if self.pp_size <= 1 or self.pp_group is None: return ready_req_idxs, failed_req_idxs
self._drain_pp_sync_work()data = (ready_req_idxs, failed_req_idxs)if self.pp_rank > 0: data = self.pp_group.recv_object( src=self.pp_rank - 1, tag=P2PTag.GRAMMAR_PP_SYNC, )if self.pp_rank + 1 < self.pp_size: self.grammar_pp_sync_work_list.extend( self.pp_group.send_object( data, dst=self.pp_rank + 1, async_send=True, tag=P2PTag.GRAMMAR_PP_SYNC, ) )return data为什么只在 PP0 做编译、其他 stage 等通知?因为只有 PP0 持有 tokenizer(create_grammar_backend(..., scheduler.tokenizer, ...) 用的就是 PP0 的 tokenizer)。后续 stage 没有 tokenizer,编译不出词表掩码,只能接受上游的决定。这是”职责与资源绑定”的自然结果。
_drain_pp_sync_work 里 p2p_work.work.wait() 的写法也值得一提:发送是异步的(async_send=True),发送句柄攒在列表里,下一次同步前统一 wait。如果每次都同步发送,PP 的同步点会变成串行的额外延迟。
编译缓存:为什么”复用编译结果、复制状态机”
BaseGrammarBackend 只做一件事:把编译结果按 key 缓存,把状态机按请求复制。
class BaseGrammarBackend: _enable_strict_thinking: bool = False
def __init__(self): self.executor = ThreadPoolExecutor() self.cache: Dict[Tuple[str, str], BaseGrammarObject] = {}命中缓存时返回的不是缓存对象本身,而是它的 copy():
if value: copied_value = value.copy() copied_value.maybe_init_reasoning(require_reasoning) return copied_value, TrueXGrammarGrammar.copy() 的实现揭示了”编译”与”状态”的分界线:
def copy(self): matcher = GrammarMatcher( self.ctx, max_rollback_tokens=MAX_ROLLBACK_TOKENS, override_stop_tokens=self.override_stop_tokens, ) if grammar_stats := self.grammar_stats: grammar_stats = dataclasses.replace( grammar_stats, is_cache_hit=True, tree_traversal_time=[] ) return XGrammarGrammar( matcher, self.vocab_size, self.ctx, self.override_stop_tokens, self.key_string, grammar_stats, )三样东西被区分开:
ctx(CompiledGrammar)共享。这是编译的产物——把 schema 变成可执行的语法结构,代价最高。它无状态,可以安全共享。matcher(GrammarMatcher)新建。这是逐请求的解析状态:当前走到了哪个节点、栈里有什么。两个请求即使 schema 相同,走的位置也完全不同,绝不能共享。grammar_stats复制并改写。缓存命中时标记is_cache_hit=True、清空tree_traversal_time。tree_traversal_time是”逐层的遍历耗时”统计,命中缓存时没有遍历发生,清空才符合语义。
grammar_stats 这个字段本身是 SGLang 加的观测能力(构造阶段 grammar_stats.compilation_time = time.perf_counter() - s 直接记录编译耗时):
if grammar_type is not None and grammar.grammar_stats is not None: grammar.grammar_stats.compilation_time = time.perf_counter() - s对于”为什么第一次请求结构化输出会明显变慢”这类线上问题,compilation_time 与 is_cache_hit 两个字段就能定性回答。这也是把缓存放在 backend 上而不是放在服务外层的理由:只有 backend 知道”这次是命中还是新编译”。
LMSYS 的技术博客用一组对比说明了”缓存与压缩”对吞吐的影响:
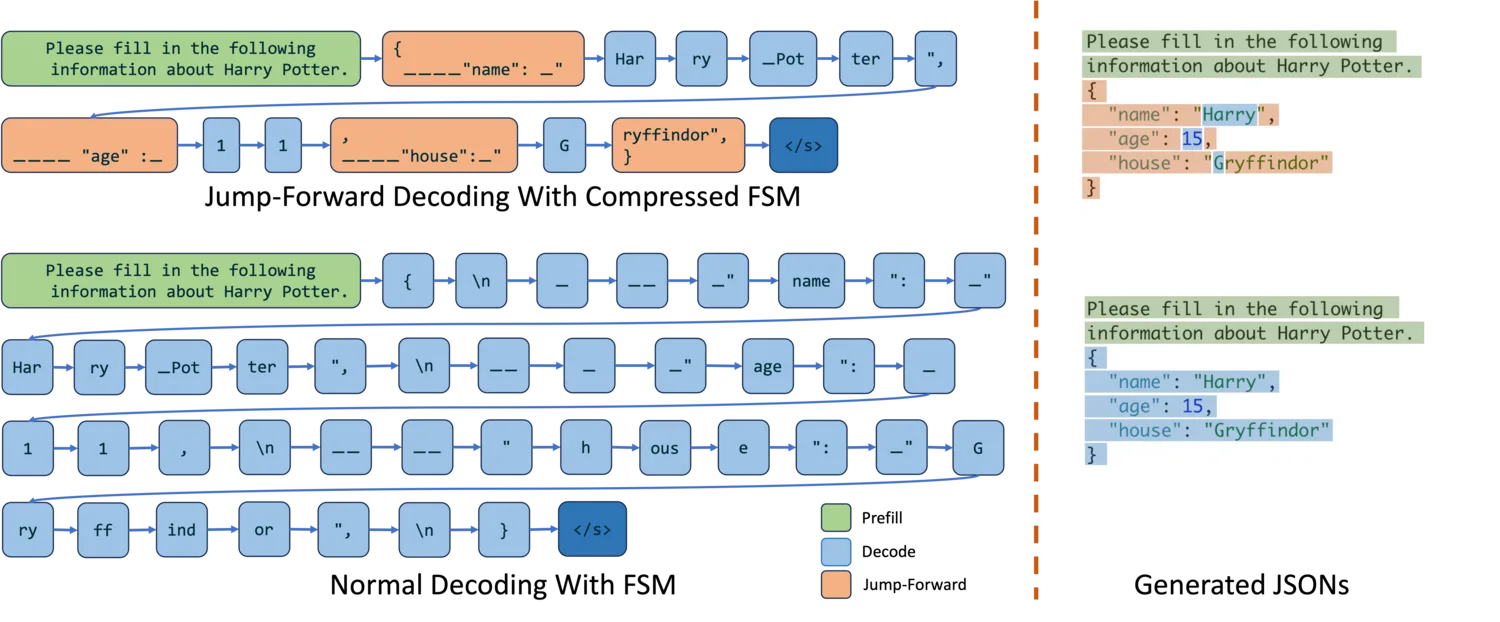
上图(来源:LMSYS 博客 Compressed Finite State Machine)比较的是同一类约束任务下两种实现的吞吐差异。它要说明的和 XGrammar 论文里的”自适应 token mask 缓存”是同一件事:语法约束的开销主要不在设备侧应用掩码,而在”每个位置要算出哪些 token 合法”这一步,所以缓存与压缩直接决定这条特性的可用性。
逐 token 推进:accept_token、rollback 与跳步
XGrammarGrammar 继承 BaseGrammarObject,把 matcher 暴露成四个动作:
def accept_token(self, token: int): if not self.is_terminated(): self.current_token = token accepted = self.matcher.accept_token(token) if not accepted: raise ValueError( f"Tokens not accepted: {token}\n" f"Accepted tokens: {self.accepted_tokens}\n" f"Key string: {self.key_string}" ) else: self.accepted_tokens.append(token)
def rollback(self, k: int): self.matcher.rollback(k) self.accepted_tokens = self.accepted_tokens[:-k]
def is_terminated(self): return self.matcher.is_terminated()accept_token 里的 raise ValueError 不是防御性编程的客套话,而是不变量断言:掩码已经保证只有合法 token 能被采出,所以这里的拒绝意味着”掩码与状态机不一致”,属于真正需要暴露的 bug。报错信息里带上 accepted_tokens 与 key_string,是为了让用户能直接复现出问题序列。
rollback(k) 服务于投机解码:草稿模型一次性提出 k 个 token,验证阶段发现第 j 个开始不匹配,就要把状态机退回到 j 之前的位置。没有 rollback,语法约束和投机解码就没法共存。MAX_ROLLBACK_TOKENS 是构造 matcher 时传入的容量,决定了最多能回退多远。
is_terminated() 有两个使用点:一是在采样时不必要再算掩码(语法已经完成,剩下的只能是停止条件处理),二是 ScheduleBatch.prepare_for_extend 里判断 req.grammar.is_terminated(),避免”已经完成的语法”继续参与后续逻辑。
跳步是另一类优化,针对的是”接下来若干个 token 其实已经被语法完全确定”的情形(例如 JSON 里紧接着必须是 ": " 或 "})。try_jump_forward 向 matcher 询问跳步串:
def try_jump_forward(self, tokenizer) -> Optional[Tuple[List[int], str]]: s = self.matcher.find_jump_forward_string() if s: return [], s return None找到之后,服务端可以用这个字符串一次性解码出多个 token,跳过中间的若干轮前向。但有一个必须处理的细节:跳步字符串重新分词后,可能与已输出的 token 序列不一致(分词是上下文相关的,'"}' 单独分词和跟在别的字符后面分词可能不同)。所以跳步落地时要做”回滚到公共前缀 + 重新接受”:
def jump_and_retokenize( self, old_output_ids: List[int], new_output_ids: List[int], next_state: int): k = 0 for i, old_id in enumerate(old_output_ids): if old_id == new_output_ids[i]: k = i + 1 else: break
# rollback to the last token that is the same if k < len(old_output_ids): self.matcher.rollback(len(old_output_ids) - k)
for i in range(k, len(new_output_ids)): if not self.matcher.accept_token(new_output_ids[i]): raise ValueError(...)这段代码的每一步都能解释:先用逐项比较求出新旧序列的公共前缀长度 k;如果 k 小于旧序列长度,把 matcher 回退 len(old) - k 步;然后从 k 开始把新序列的剩余 token 重新喂回状态机。状态机的最终位置与”逐个 token 走一遍”完全相同,而中间省略了那几轮前向。
顺带指出:jump_forward_str_state 在这个实现里返回 (data, -1),next_state 参数被忽略——因为 matcher 自身已经记录了状态,跳步不需要外部再传一个状态编号。
位掩码:一个 int32 覆盖 32 个 token
fill_vocab_mask 是”语法 → 设备数据”的落点:
def fill_vocab_mask(self, vocab_mask: torch.Tensor, idx: int) -> None: self.matcher.fill_next_token_bitmask(vocab_mask, idx)它把”第 idx 行当前允许哪些 token”写进 vocab_mask。这张掩码的形状由一个工具函数决定:
def _allocate_token_bitmask(vocab_size: int, batch_size: int) -> torch.Tensor: return torch.full( get_bitmask_shape(batch_size, vocab_size), -1, dtype=bitmask_dtype, pin_memory=is_pin_memory_available(), )三处细节:
-
形状由
get_bitmask_shape给出,而不是[batch, vocab]。 真实形状是[batch, ceil(vocab_size / 32)],dtype 是 int32——每一个 bit 表示一个 token 是否允许。词表 152064 时,一行掩码只占 字节 ≈ 18.6 KB,而不是完整布尔掩码的 152 KB,也不是 fp32 加法掩码的 608 KB。这是 8× 到 32× 的带宽下降。 -
初始值填
-1。 int32 的-1是全 1 位模式,含义是”这一行所有 token 都允许”。这是一个非常聪明的默认值:分配出来的缓冲天然是”无约束”状态,未被填过的行自动表示”不受语法限制”,不需要额外清零。 -
pin_memory由is_pin_memory_available()决定,注释给出了原因:
# Pin where pinning exists, so the later H2D can be a genuine non_blocking# copy (a pageable source silently downgrades it). MPS torch has no# pin-memory kernel and asserts on pin_memory=True.这与前面采样参数张量的处理是同一个模式:只要数据将来要上设备,就尽量固定在 pin 内存上,同时要检查平台支持(MPS 后端没有 pin 内存,硬写 pin_memory=True 会直接断言失败)。
掩码应用到 logits 上,就是一次”不合法的位置置 -inf”:
def apply_vocab_mask(self, logits: torch.Tensor, vocab_mask: torch.Tensor) -> None: if logits.device.type in {"cuda", "xpu", "musa"}: if _is_hip: apply_token_bitmask_inplace_cuda(logits, vocab_mask) else: apply_token_bitmask_inplace_triton(logits, vocab_mask) elif logits.device.type == "npu": import sgl_kernel_npu # noqa: F401 torch.ops.npu.apply_token_bitmask(logits, vocab_mask) elif logits.device.type == "cpu": # Used by the MLX backend, which builds its additive mask rows # on the CPU before inserting them into the lazy graph. from xgrammar import apply_token_bitmask_inplace apply_token_bitmask_inplace(logits, vocab_mask, backend="cpu") else: raise RuntimeError(f"Unsupported device: {logits.device.type}")四个设备分支对应四种后端实现,但语义只有一个:位为 0 的位置写 -inf。为什么用”位掩码 + in-place 置 -inf”而不是”加法掩码(不允许的位置加一个大负数)“?因为加法掩码会引入精度问题:如果原 logits 已经很大(比如 +50),加上 -1e9 之后是 -1e9 + 50 而不是精确的 -inf,经过 top-p 累积后有可能泄漏出非零概率。而显式置 -inf 在 softmax 之后是精确的 0,从根上杜绝了非法 token 被采出。
掩码具体怎么按 PDA 状态填充,XGrammar 论文里有一张很直观的例子图:
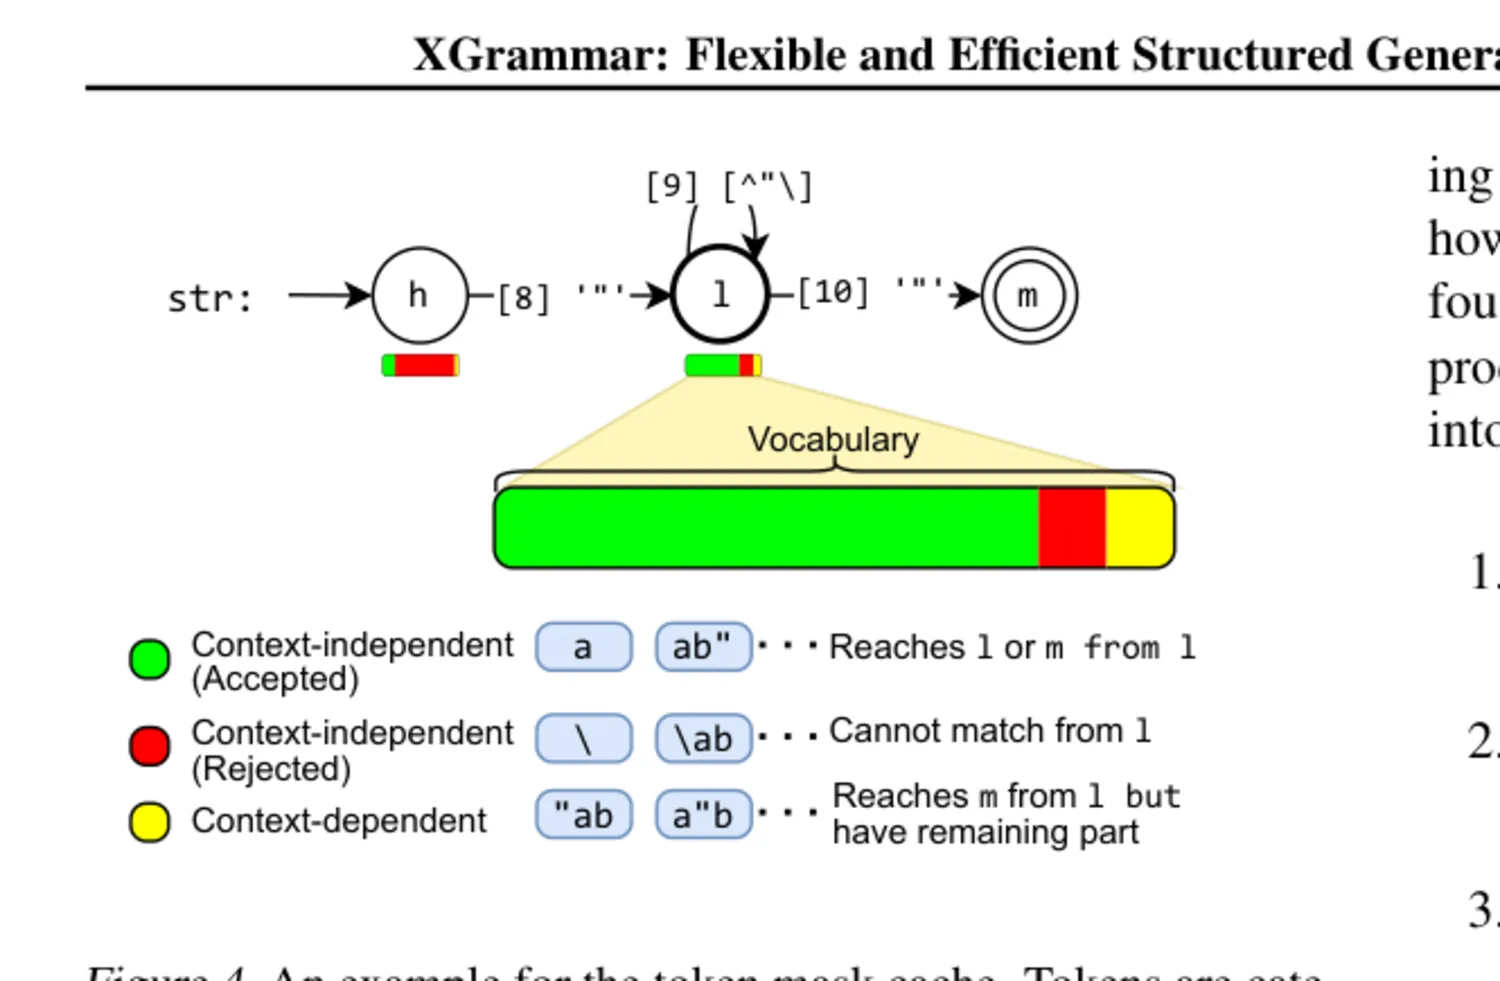
上图(来源:XGrammar 论文,图 4)说明的是”缓存”的粒度问题:词表里的 token 按”是否依赖当前上下文”以及”是否可接受”被分成三类——上下文无关且接受的 token 在任何状态下都合法,上下文无关但拒绝的 token 在任何状态下都不合法,只有第三类”上下文相关”的 token 需要每步重算。这个分类是”编译一次、逐步复用”的理论基础,也是缓存能把每步开销压到与状态无关部分的直接原因。
整个系统的全景(编译器、PDA、掩码缓存、LLM 引擎之间的关系)在论文的 Figure 1 里给了出来:
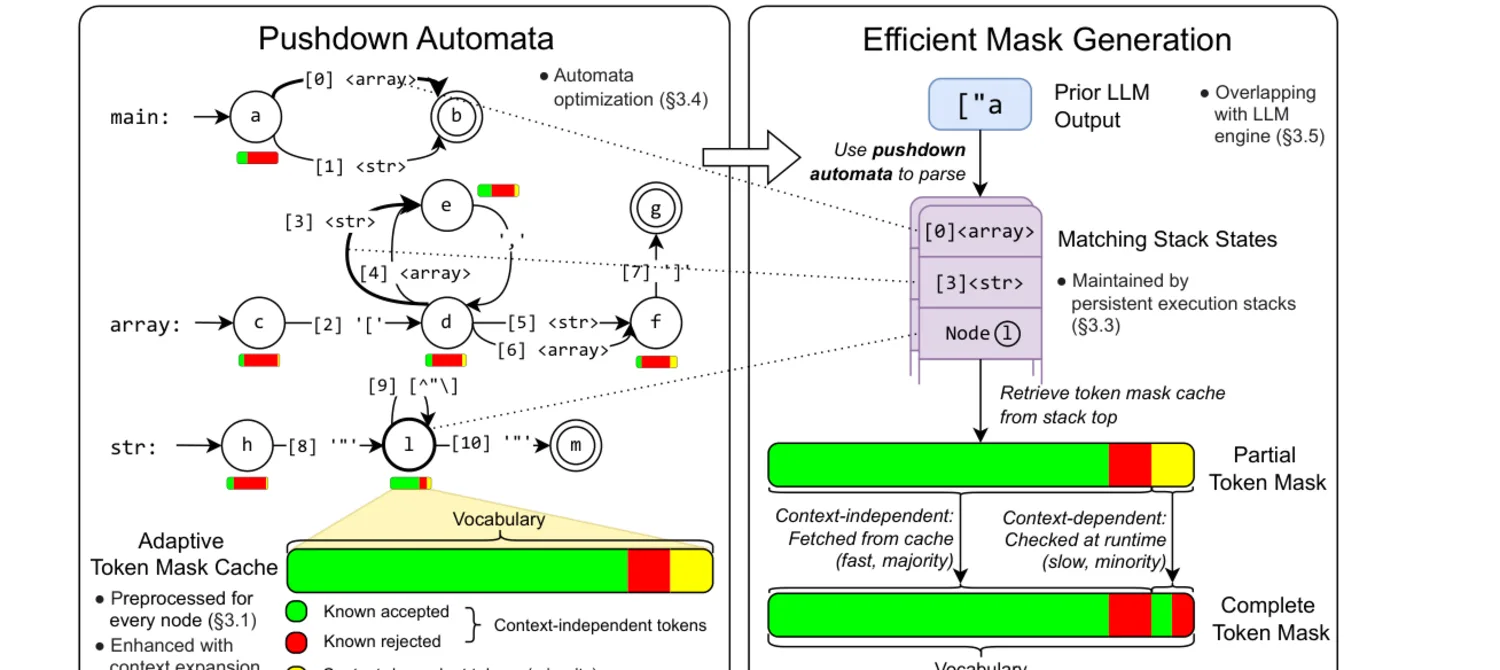
上图(来源:XGrammar 论文,图 1)把两侧分得很清楚:左侧是语法侧——Tokenizer 提供词表、Grammar 编译器把 schema 编译成 CFG、CFG 转成 PDA;右侧是引擎侧——Structured Output 模块根据 PDA 的当前状态产出词表掩码,交给 LLM Engine 在采样时应用。SGLang 的 GrammarManager + BaseGrammarBackend + BaseGrammarObject 三层,正好对应这张图的左半部分与左右衔接处。
掩码谁来填:update_regex_vocab_mask 与缓冲复用
SamplingBatchInfo.update_regex_vocab_mask 负责把批次里所有活跃语法对象的掩码合成一张:
def update_regex_vocab_mask(self): if not self.grammars: self.grammar_mask = None return
# Find a grammar from the list first_grammar = next(grammar for grammar in self.grammars if grammar)
vocab_mask = first_grammar.allocate_vocab_mask( vocab_size=self.vocab_size, batch_size=len(self.temperatures), device=self.device, )
# Rows omitted here (finished / terminated / non-grammar requests) retain # the freshly allocated buffer's unconstrained value. entries = [ GrammarRow(row=row, grammar=grammar) for row, grammar in enumerate(self.grammars) if grammar and not grammar.finished and not grammar.is_terminated() ] first_grammar.fill_vocab_mask_batched(entries, vocab_mask)
# Move the mask to the device if needed vocab_mask = first_grammar.move_vocab_mask(vocab_mask, self.device) self.grammar_mask = GrammarMask(first_grammar, vocab_mask)四个决策点:
任取一个语法对象来”代管”分配与应用。 注释在 GrammarMask 的类文档里解释了这个别扭的写法:
class GrammarMask(NamedTuple): """A filled vocab_mask plus the backend that applies it.
The grammar is any one of the batch's -- a handle, not per-request state. """
grammar: BaseGrammarObject vocab_mask: torch.Tensor
def apply(self, logits: torch.Tensor) -> None: self.grammar.apply_vocab_mask(logits=logits, vocab_mask=self.vocab_mask)关键句是 a handle, not per-request state:掩码是批次级的,应用它的方法来自任意一个语法对象,因为 apply_vocab_mask / allocate_vocab_mask / move_vocab_mask 都是与具体请求无关的后端能力(同一个后端,掩码的语义与布局相同)。把它挂在”第一个语法对象”上,是为了避免在 SamplingBatchInfo 里再存一个后端引用。
只填”活跃”的行。 过滤条件 grammar and not grammar.finished and not grammar.is_terminated() 排除三类行:没有语法的请求、语法已完成的请求、语法已终止的请求。被排除的行保留缓冲的初始值(全 1,无约束)——这正是前面”初始填 -1”设计的第二个用处:未填行天然表示不限,不需要显式写一遍全 -1。
move_vocab_mask 可能是 no-op。 如果掩码本来就在设备上(或分配时就指定了设备),这次调用什么都不做。它是接口的一部分,不是每轮必走的开销。
first_grammar 在批内不同后端混用时会失真吗? 理论上如果一批请求用了不同语法后端(比如一部分 xgrammar、一部分 outlines),掩码布局可能不同。SGLang 的做法是让 GrammarManager 在同一时刻只启用一个后端(create_grammar_backend 按服务配置创建单一后端),因此批次内后端是同质的,这个”任取一个”的简化是安全的。
关于后端编译性能还有一层:XGrammar 的掩码缓存做了自适应存储(accept-heavy 与 reject-heavy 用不同布局),论文里的 Figure 5 讲的就是这件事。SGLang 只是这个缓存的消费者——它每步关心的是”这次调用要花多久”,因此才有了 tree_traversal_time 这个逐层耗时数组的存在。
grammar_needs_sync:一条判断决定整批能不能 overlap
ScheduleBatch 里有一处判断值得单独拿出来讲:
has_grammar: bool = False...def grammar_needs_sync(self) -> bool: """Whether grammar forces this batch onto the synchronous path, i.e. the """ return self.has_grammar and not self.spec_algorithm.supports_grammar_overlap()它的语义是:如果批里有语法请求,且当前投机算法不支持语法重叠,这个批次就必须走同步路径。
为什么语法会和 overlap 调度冲突?回想第六篇讲过的 overlap 结构:主机侧调度与设备侧执行重叠,前向的输出是在下一轮才被消费的(future token)。但语法约束要求”采出的 token 必须立刻喂回状态机”——因为下一步的掩码依赖上一步接受了哪个 token。如果 token 要等到下一轮才回到主机侧,状态机就晚了一步,掩码算不出来,下一轮的 logits 就没有约束可应用。
所以只有支持在途处理语法的投机算法(supports_grammar_overlap() 为真)才允许带语法的批次走 overlap;否则整批退回同步路径——牺牲重叠换正确性。这条判断写在 ScheduleBatch 上而不是调度器里,是因为”这个批次能不能重叠”是批次的固有属性,任何需要判断的调用点都能一致地拿到答案。
与 vLLM 的对照
两家的采样侧在数据结构上几乎一一对应,但在工程边界上有几处明显差异。对照着看比单独读一家更容易记住。
采样参数容器。 vLLM 用 SamplingMetadata 承载每步的采样参数张量与布尔量,并用一系列 LogitsProcessor(MinTokensLogitsProcessor、PenaltiesLogitsProcessor、LogitBiasLogitsProcessor、MinPLogitsProcessor、LogitsProcessorWithMaxTokens 等)按顺序施加变换;SGLang 把它们分成两部分:惩罚项由 penalizer_orchestrator 与预累积缓冲处理,logit_bias 单独一步。本站的 vLLM 源码完全拆解(十):Sampler 里可以对照阅读,那篇讲的是”温度、top-k/top-p 过滤到采样执行”的同一段流程。
结构化输出。 vLLM 的 structured output 走 StructuredOutputManager + 后端(xgrammar / guidance / outlines),每步产出一张 bitmask 并用 apply_token_bitmask_inplace 应用到 logits 上;SGLang 用 GrammarManager + BaseGrammarBackend,掩码的设备侧应用方式是同一个 XGrammar 内核。真正的差异在调度前置:SGLang 把”语法未就绪不进调度”做成硬性队列纪律,而 vLLM 里编译也发生在请求真正开始处理之前。本站的 vLLM 源码完全拆解(十四):结构化输出 有对 FSM 编译与 bitmask 生成的完整拆解。
logprobs 的口径。 两家的 LogitsProcessorOutput / SamplerOutput 都会同时携带”选中 token 的 logprob”与”top-k logprob”;SGLang 额外把”用户点名的 token ids logprob”和”采样支持集(sampling_mask_output)“做成了正式的返回结构,用 SamplingMaskStatus 在分布式下统一策略决定。
可复现性。 两边都支持某种形式的确定性采样。SGLang 的差异在于把 seed 派生方式(按 positions)与”必须走 pytorch 后端”这两个约束写进了断言,而不是悄悄降级。
工程上容易踩的坑
把这一篇的内容压缩成几条可操作的注意事项:
一、采样参数张量必须与请求行严格对齐。 任何改变批次组成的地方(filter_batch / merge_batch / 投机解码的行扩展)都必须同步处理采样参数、惩罚器状态、logit_bias、以及采样掩码的行索引。漏掉一处的后果不是”轻微错误”,而是请求 A 用请求 B 的温度采样——这类 bug 只在特定批组成下出现,非常难复现。
二、合并时注意”长度依赖顺序”。 SamplingBatchInfo 的行数由 temperatures 定义,任何使用 len(...) 的操作都必须在该张量被改写之前执行。源码里那条 has to come before the temperatures tensor update 的注释就是事故幸存者留下的标记,移植这段逻辑时要原样保留顺序。
三、TP 间必须显式同步采样结果。 张量并行下同一个请求存在于多个 rank 上,若各 rank 独立采样会得到不同 token,后续 decode 前向立刻发散。SGLang 用 _sync_token_ids_across_tp 处理,并且 SYNC_TOKEN_IDS_ACROSS_TP 会影响采样掩码的构建方式(因为同步可能替换生产 rank 选中的 token,selected_weight 必须作废)。
四、确定性模式要统一 logprob 核。 log(softmax(x)) 与 log_softmax(x) 在浮点上相差约 ,跨阶段(prefill rescoring 与 decode 采样)混用会让同一 token 的 logprob 对不上;在确定性模式下必须两条路径都用 F.log_softmax。
五、语法请求会改变批次的调度属性。 grammar_needs_sync() 为真时整批退回同步路径。如果线上同时开着投机解码与结构化输出,先确认当前投机算法是否声明支持语法重叠,否则会看到”加了 grammar 之后整体吞吐下降”的现象——那不是采样慢,而是重叠没了。
六、位掩码的默认值语义。 缓冲初始化为全 -1(不限),未填的行天然是无约束。这意味着不要在复用的缓冲上做”部分更新”而不先重置——如果缓冲被复用而没有重新分配,上一轮填过的行会残留。SGLang 通过 register_vocab_mask_buffer / get_vocab_mask_buffer 管理缓冲生命周期,reset_vocab_mask 是后端提供的回退手段,扩展这块代码时必须理解每一个 -1 的来源。
小结
这一篇把 SGLang 采样侧的三层讲完了。可操作的结论有四条:
- 参数批量化是采样性能的基础。 把每请求的标量参数固化成与 batch 对齐的设备张量,再用行号索引表达”只有部分行需要某项能力”,这是把 N 次小运算变成一次大运算的关键。
- 布尔量是省下来的 kernel。
is_all_greedy省掉整个 softmax 与排序;need_top_p_sampling之类的逐项判断省掉对应的裁剪核;simple_sampling_case把 top-k/top-p/min-p 三种裁剪的联合处理收缩成一次采样调用。 - 语法的本质是掩码,掩码的本质是位图。 语法编译成 PDA,PDA 的当前状态决定词表里哪些 token 合法,这个集合用每 token 一位的 int32 位图表达并原位写成
-inf。编译必须异步、结果必须缓存、状态必须逐请求复制——三件事缺一不可。 - 正确性靠不变量,不靠运气。 “未就绪不进调度”、“ready 取交集、failed 取并集”、“采样参数的顺序依赖”、“确定性模式下 logprob 核唯一”——这些约束都以断言、注释或类型选择的形式固化在代码里,改动任何一条都必须重新评估整条链路。
本系列进度与路线图
已发布(vLLM 部分,共 16 篇):(一)整体架构与模块全景 → (二)请求生命周期 → (三)Scheduler 调度 → (四)KVCacheManager → (五)GPUModelRunner 输入批 → (六)Attention Backend → (七)PagedAttention Kernel → (八)MoE 层 → (九)Sampler 与采样 → (十)投机解码 → (十一)张量并行 → (十二)torch.compile 与 CUDA Graph → (十三)多模态输入 → (十四)结构化输出 → (十五)停止条件与增量解码 → (十六)源码阅读地图。
已发布(SGLang 部分,含本篇共 10 篇):
| 篇号 | 主题 | 状态 |
|---|---|---|
| (一) | 整体架构、进程拓扑与请求数据流 | 已发布 |
| (二) | 入口、分词与流式输出如何闭环 | 已发布 |
| (三) | Scheduler 请求状态机 | 已发布 |
| (四) | PrefillAdder 与 KV 预算 | 已发布 |
| (五) | KV 内存池与 RadixCache | 已发布 |
| (六) | Overlap Scheduler | 已发布 |
| (七) | ForwardBatch、TpModelWorker 与 ModelRunner | 已发布 |
| (八) | Attention Backend 与注意力 Kernel 落点 | 已发布 |
| (九) | CUDA Graph 与编译路径 | 已发布 |
| (十) | Sampling、Grammar 与结构化输出(本篇) | 已发布 |
SGLang 待讲模块清单:Speculative(EAGLE/EAGLE-3 草稿与验证在 SGLang 中的实现)、LoRA 与多 LoRA 批处理、Disaggregation(PD 分离调度)、多模态与 VLM 输入链路、权重加载与量化后端(--quantization 家族)、DP Attention 与负载均衡、Metrics 与可观测性、约束后端的横向对比,以及迁移到其他框架后的收尾对比篇。
下一篇将进入「Sampling 之后」的另一条线:SGLang 的投机解码实现——草稿模型如何复用同一套 SamplingBatchInfo、forward_batch 如何按 spec_algorithm 扩展行、验证阶段的 token 接受与回滚如何与语法状态机(本篇的 rollback)协同,以及 EAGLE 系草稿头在图重放下的形状约束。
参考资料
- SGLang 官方 GitHub 仓库
- SGLang 采样器源码(sampler.py)
- SGLang 采样批信息源码(sampling_batch_info.py)
- SGLang 采样参数定义(sampling_params.py)
- SGLang 惩罚器编排器源码(penaltylib/orchestrator.py)
- SGLang LogitsProcessor 源码(logits_processor.py)
- SGLang 语法后端基类源码(base_grammar_backend.py)
- SGLang GrammarManager 源码(grammar_manager.py)
- SGLang xgrammar 后端源码(xgrammar_backend.py)
- SGLang 批次对象源码(schedule_batch.py)
- SGLang ModelRunner 源码(model_runner.py)
- SGLang 调度侧 logprob 结果处理源码(logprob_result_processor.py)
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models(arXiv:2411.15100)
- LMSYS 博客:Compressed Finite State Machine
- SGLang 源码完全拆解(二):入口、分词与流式输出如何闭环
- SGLang 源码完全拆解(七):ForwardBatch、TpModelWorker 与 ModelRunner
- SGLang 源码完全拆解(八):Attention Backend——统一 metadata 如何落到不同注意力 Kernel
- SGLang 源码完全拆解(九):CUDA Graph 与编译路径
- vLLM 源码完全拆解(十):Sampler
- vLLM 源码完全拆解(十四):结构化输出——FSM 编译、语法 bitmask 与受限采样
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



