


GLM-5.3 推理全链路(十四):MTP 的三段前向——草稿、验证与 draft_extend 的算子与通信账
这一篇接在哪
前十三篇按时间顺序拆完了 GLM-5.3 的一条请求:HTTP 入口与模板、分词与 ZMQ、调度器的三本预算、DP Attention 的进出、DSA 注意力的索引器与稀疏选择、MoE 的 dispatch/combine、1M 上下文的 prefill 分块与上下文并行、PD 分离的数据面与控制面、混批、输出侧的反分词与 KV 回收,以及主 KV 与索引器缓存的分页账。这些篇目默认了一个前提:一次 decode step 只做一次目标模型前向。第一篇在讲 MTP 时提过一句,开启投机解码后这个前提不成立;第七篇讲输出侧时,也只交代了“一次验证会产生 k+1 行 logits”。
但 GLM-5.3 的生产部署基本都会开 MTP。开了之后,一条请求在 decode 阶段的每一步,GPU 上实际发生的是三段前向:草稿层的若干次小前向、目标模型一次多行验证前向、以及一次把接受段写回草稿层的 draft_extend。算子清单、通信字节数、KV 页的分配与回收,都随这三段一起变。前面各篇的账本如果直接套用,会少算草稿层的 MoE 权重流量、验证阶段的 6 倍 token 通信,以及接受段 KV 的搬移。
这一篇只做一件事:把这三段前向打开,按代码顺序列出每一段的算子、集合通信和 KV 操作,再把它们加回一次 decode step 的总账。站内已经有一篇 MTP 完全拆解,讲的是 DeepSeek 系 MTP 的结构与训练目标;这一篇不复述那部分,重点放在推理路径,以及 GLM-5.3 特有的 index_share_for_mtp_iteration 如何把草稿段的索引器开销压下去。
GLM-5.3 的草稿层到底长什么样
GLM-5.3 的 config.json 里有两个字段直接决定草稿段的结构:
{ "num_hidden_layers": 78, "num_nextn_predict_layers": 1, "hidden_size": 6144, "n_routed_experts": 256, "num_experts_per_tok": 8, "n_shared_experts": 1, "index_topk": 2048, "index_share_for_mtp_iteration": true}num_hidden_layers = 78 是主干层数,num_nextn_predict_layers = 1 表示 checkpoint 里只带一层 MTP。这一层的结构与 DeepSeek-V3 的 MTP 模块同源,SGLang 在 models/glm4_moe_nextn.py 里把它实现成 Glm4MoeModelNextN:
self.enorm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)self.hnorm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)self.eh_proj = nn.Linear(2 * config.hidden_size, config.hidden_size, bias=False)...self.decoder = Glm4MoeDecoderLayer(config, 0, ..., is_nextn=True)self.shared_head.norm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)一次 MTP 前向的输入有两路:当前 token 的 embedding,以及目标模型最后一层在同一个位置输出的 hidden state。两路各过一次 RMSNorm,拼成 12288 维,由 eh_proj 压回 6144 维,再走一个完整的 GLM Decoder Layer(MLA 注意力加 256 专家的 MoE),最后过 shared_head.norm 和共享的 LM Head。
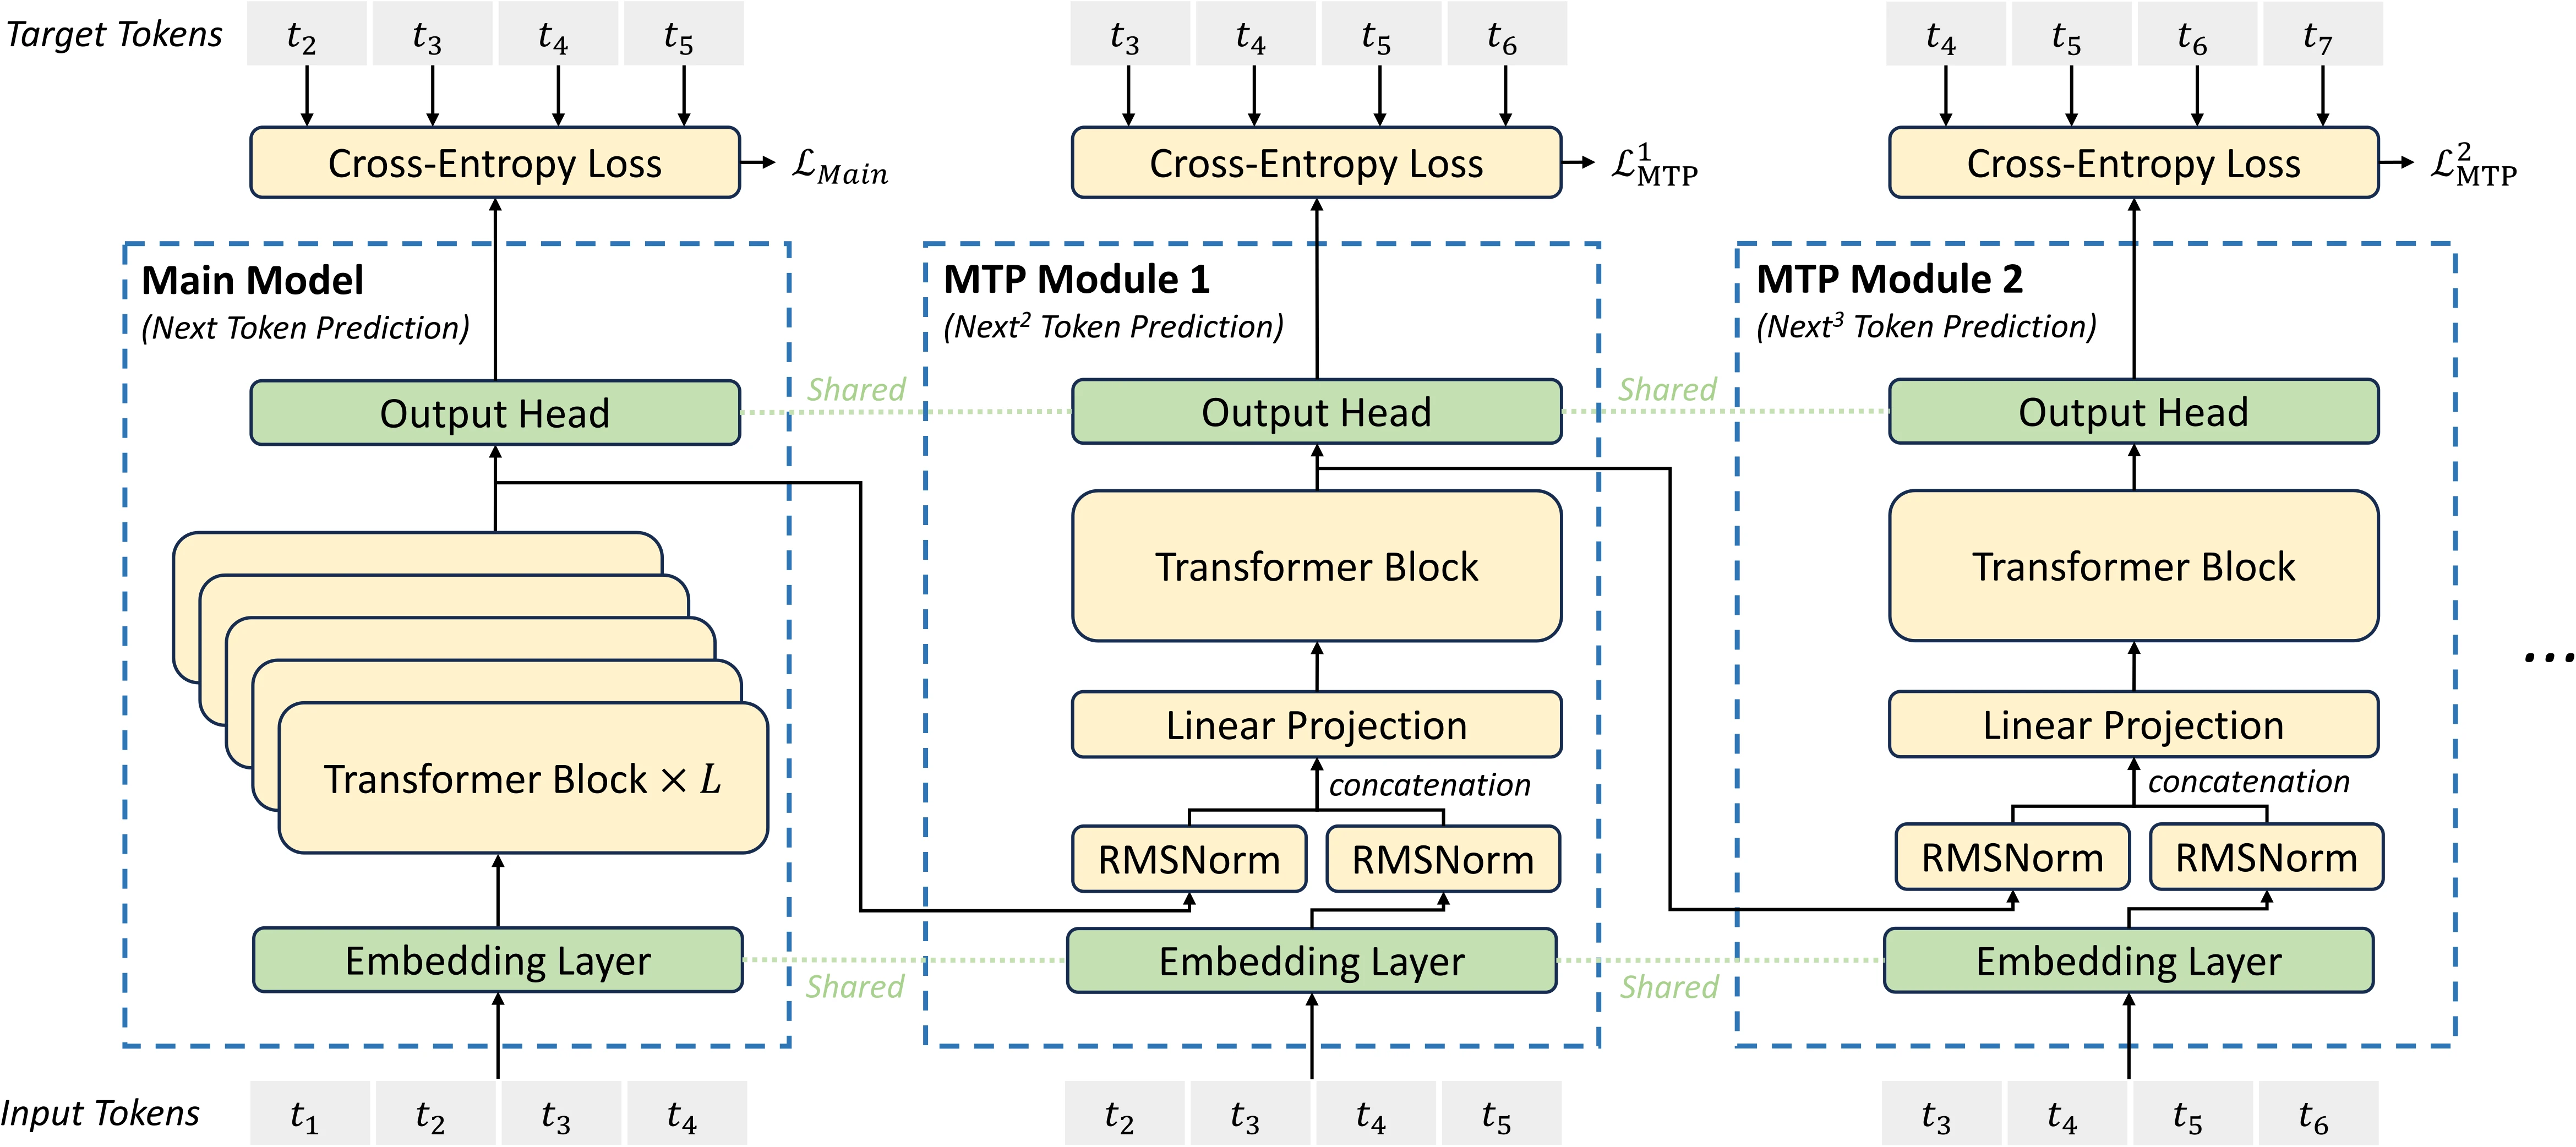
图源:DeepSeek-V3 技术报告 Figure 3,arXiv:2412.19437。GLM-5.3 的 MTP 层沿用这一结构,训练时共享三层参数,推理时只保留一层。
这里有一个容易被忽略的规模问题:草稿层虽然只有一层,但它的 MoE 仍然是 256 专家、top-8。按每个专家三组 6144×2048 的权重估算,单层 MoE 约 9.7B 参数;FP8 下接近 10GB。也就是说,MTP 层不是“额外一层注意力”那么轻,它的权重体量与主干任意三层 MoE 相当。开 MTP 之后,模型总权重从 744B 变成 754B 左右;在 EP8 下,这多出来的约 10GB 权重被切到 8 张卡上,每卡约 1.25GB,KV 池则多出一层(656 字节/token/层)。
GLM-5 的技术报告还交代了一个训练侧的设计:为了在预测多个 token 时不把 MTP 参数和 KV 按步数线性放大,GLM-5 在训练时让 3 个 MTP 层共享同一组参数,推理时只保留一层,并在每一步复用它。报告给出的接受长度是 2.76(DeepSeek-V3.2 为 2.55,同为 4 步草稿)。这个数字后面会用到:它决定了三段前向的总开销能不能被“一步多 token”赚回来。
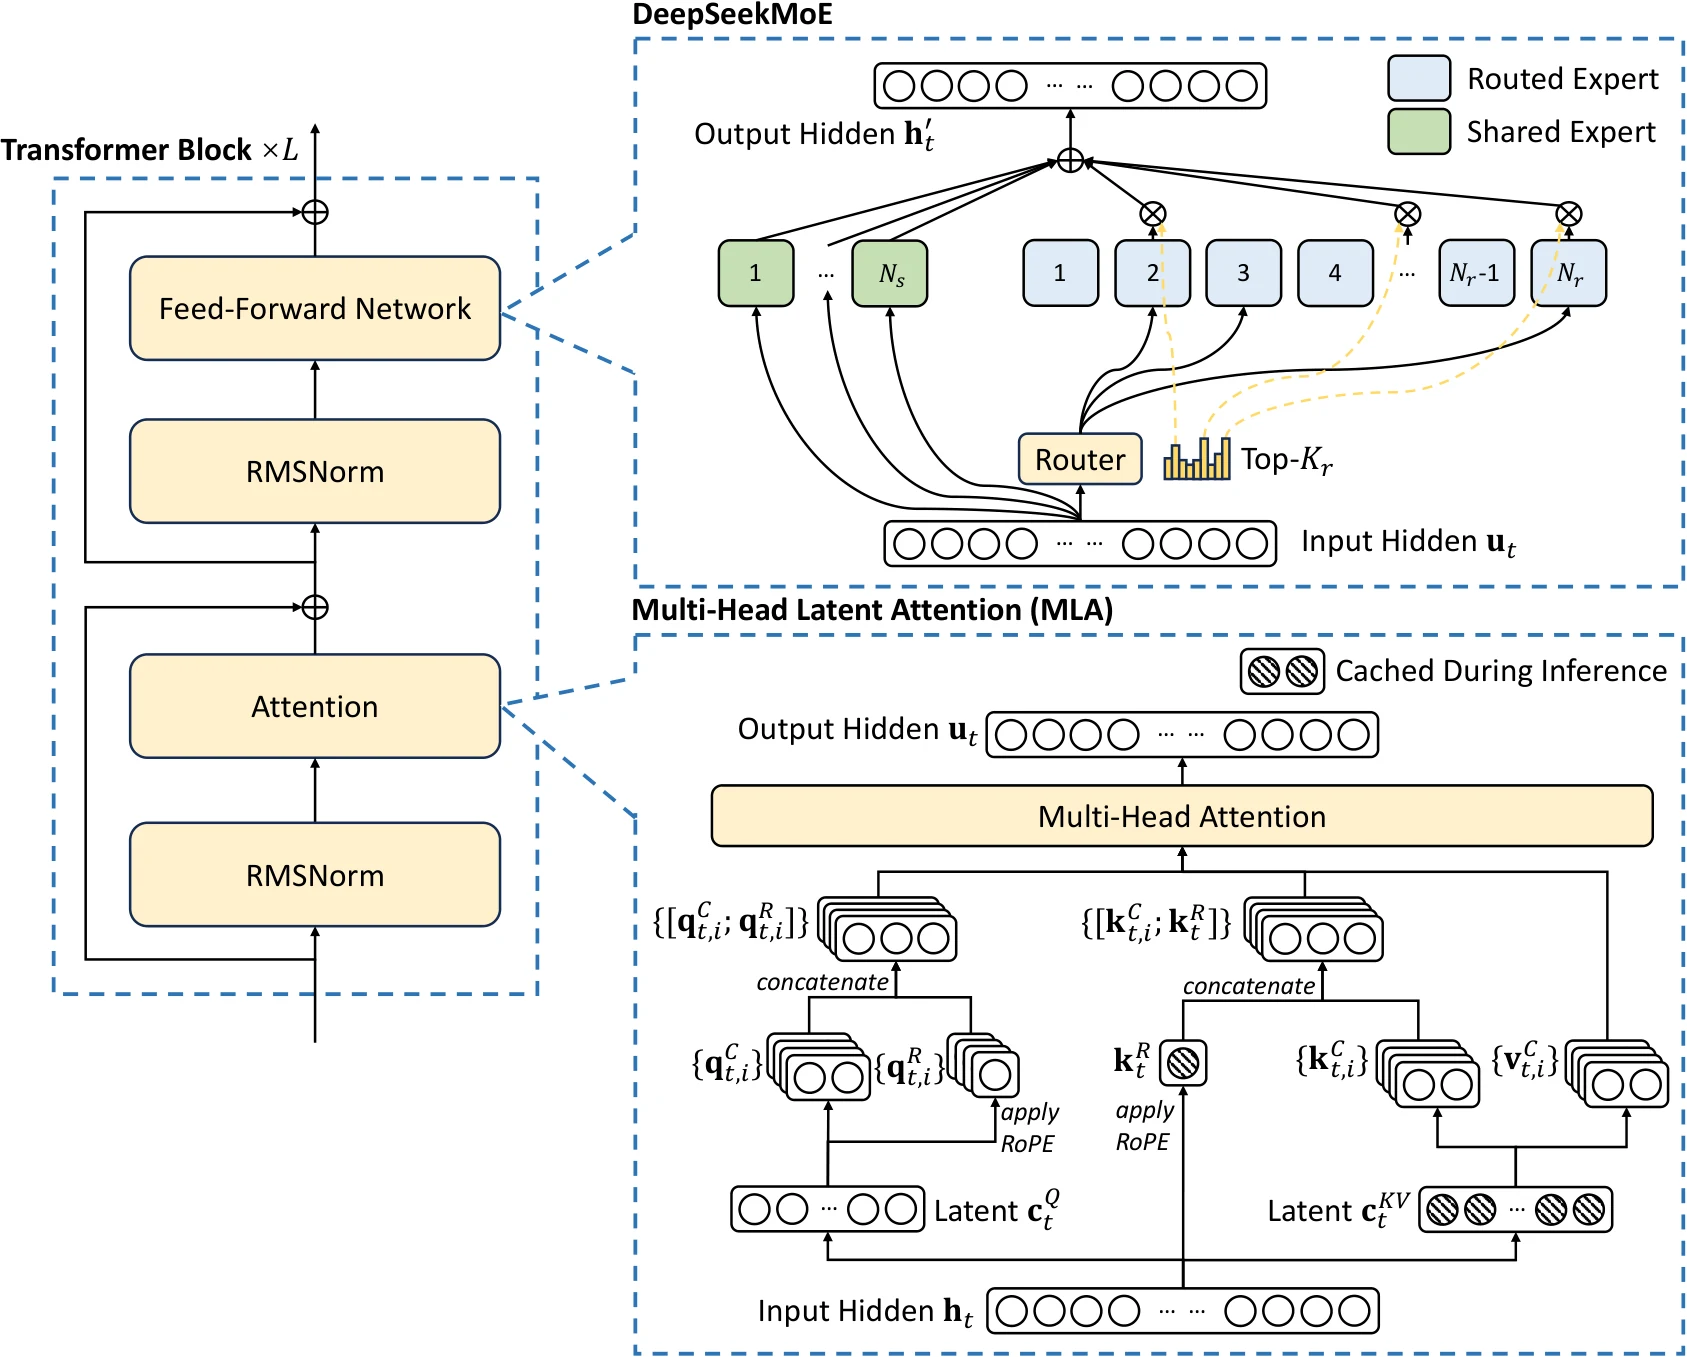
图源:DeepSeek-V3 技术报告 Figure 2。GLM-5.3 的
kv_lora_rank = 512、qk_rope_head_dim = 64与图中 MLA 的潜向量分解一致。
三段前向的分工
把一次开启 MTP 的 decode step 按时间顺序摊开,结构如下:
| 阶段 | 谁在算 | 每个请求的 token 数 | 前向次数(SGLang,5 步配置) | 主要产物 |
|---|---|---|---|---|
| draft | 1 层 MTP | 1 | 4 | 5 列草稿 token、草稿分布 |
| verify | 78 层目标模型 | 6 | 1 | 6 行 logits、接受长度 |
| draft_extend | 1 层 MTP | 接受长度 + 1 | 1 | 接受段的草稿层 KV 与 hidden |
5 步配置下,草稿循环并不是 5 次前向。SGLang 的 draft_forward 在最后一轮直接 break,把上一步的 top-k 结果落成最后一列,不再为它单独跑一次前向:
for i in range(self.speculative_num_steps): ... if i == self.speculative_num_steps - 1: break forward_batch.input_ids = input_ids forward_batch.out_cache_loc = out_cache_loc[i] logits_output = self.draft_runner.forward(forward_batch).logits_output ...所以 speculative_num_steps = 5 对应 4 次草稿前向、5 列草稿 token;加上 1 次 6 行的验证前向和 1 次 draft_extend,一次 decode step 里 GPU 上一共出现 6 次模型前向调用。第一篇按服务端参数把它写成“草稿层跑 5 步”,指的是 speculative_num_steps = 5 这个配置值;按 draft_forward 的循环,真正发起的前向是 4 次,最后一步只做 top-k 选择。这 6 次调用的形状完全不同:4 次是 [b, 1] 的单 token 小前向,1 次是 [6b, 1] 的验证前向,1 次是 [b × accept_len, 1] 的写回前向。
后面的账本都按这个形状展开。先把三段各自的输入准备讲清楚,因为真正的工程细节大多在“前向之前”。
草稿段:单 token 小前向,为什么还要走 MoE
输入准备:prepare_for_draft
SGLang 的 EagleDraftWorker.draft() 第一步不是调模型,而是 prepare_for_draft。它要算出三样东西:草稿层每一步往哪个 KV 槽位写(out_cache_loc)、每一步的位置(positions)、以及这张 ForwardBatch 能否被 CUDA Graph 整图重放。
topk = 1(单链草稿)时,SGLang 用 assign_draft_cache_locs_contiguous_func 一次性把所有步的槽位算好:
batch.out_cache_loc = torch.empty( (bs * topk * window_cols,), dtype=torch.int64, device=batch.device)assign_draft_cache_locs_contiguous_func( batch.req_pool_indices, req_to_token_pool.req_to_token, batch.seq_lens, batch.out_cache_loc, topk, window_cols, ...)window_cols = num_draft_tokens(这里是 6),也就是把验证窗口的 6 个槽位在 prepare 阶段一次分配,而不是草稿一步、验证一步各分配一次。草稿段只写前 5 列,第 6 列留给验证前向产生的 bonus token。这个设计来自 target_translator 与 IterationIds 机制:草稿段先“规划”整个迭代的写入窗口,draft() 返回的 iteration_ids 再交给验证和 draft_extend 复用。省掉的是每步一次槽位分配和一次 host 侧的元数据构造。
topk > 1 且 page_size > 1 时,路径完全不同:每个草稿分支按页对齐单独占一段区域,再把前缀页尾部的真实 KV 复制到每个分支的“洞”槽位上,保证整页读取时每个分支都能看到一致的上下文。这段代码在 duplicate_prefix_tail_to_draft_branches,单链配置(GLM-5.3 在 SGLang cookbook 里默认 topk = 1)不会走到。
草稿前向的逐层算子
单链草稿的每一次前向,batch 形状是 [b, 1],位置是每条请求“当前已提交长度”。层内算子与主干层同构,但因为只有一层,它的开销几乎全部落在权重读取而不是计算上:
| 序号 | 算子 | 形状 | 通信 |
|---|---|---|---|
| 1 | token embedding 查表 | 词表并行时一次 AllReduce,DP Attention 下退化为本地 | |
| 2 | enorm / hnorm 双 RMSNorm | 无 | |
| 3 | eh_proj(12288 → 6144) | 无 | |
| 4 | 输入 RMSNorm + A 投影 | 无 | |
| 5 | q_a / kv_a RMSNorm + RoPE | — | 无 |
| 6 | 索引器 K 投影与打分(仅 full 层) | 个 Top-K | 无 |
| 7 | 稀疏 MLA 注意力 | 个 query 对 2048 个 KV | 无 |
| 8 | o_proj | DP Attention 下 ReduceScatter;纯 TP 下 AllReduce | |
| 9 | 路由 gate + grouped top-k | 无 | |
| 10 | DeepEP dispatch | 个 token | all-to-all |
| 11 | 专家 GEMM(w1、w3、w2) | 无 | |
| 12 | DeepEP combine | all-to-all | |
| 13 | shared_head.norm + LM Head | 词表并行时 AllGather |
注意第 9 到第 12 行:草稿层同样走 256 专家、top-8 的 MoE。单个 token 只激活 8 个专家,这意味着一次草稿前向的权重读取量大约是 的单层 MoE 加上注意力权重,约 300MB 量级(FP8)。但这个读取量要重复 4 次——草稿链的每个 token 都要重新走一遍 MoE。这就是第一篇里“MTP 层虽然只有 1 层,MoE 权重读取却发生 5 次”的具体含义。
草稿段的通信:小 batch 下 all-to-all 的固定开销
草稿段 个 token 的 DeepEP dispatch,单次消息量只有 字节(FP8)。 时约 1.5MB,在 NVLink 上只是一次几微秒的小通信。真正的代价不在字节数,而在 all-to-all 的启动延迟:DeepEP 低延迟模式的 kernel 有固定的握手与缓冲区切分开销, 越小,这部分开销占的比例越高。4 次草稿前向就是 8 次小 all-to-all(dispatch 加 combine),再加 4 次注意力输出后的归约,通信次数比字节数更值得关注。
vLLM 的草稿段走的是同一思路但不同的实现。SpecDecodeBaseProposer.propose() 在 num_speculative_tokens > 1 时,先做一次“首轮”前向(含多行 indexer 的 Top-K 计算),然后循环里每一步都是 batch_size 个 token 的单行前向:
for token_index in range(self.num_speculative_tokens - 1): input_ids = draft_token_ids_list[-1].int() ... self.input_ids[:batch_size] = input_ids self.hidden_states[:batch_size] = hidden_states ... ret_hidden_states = self.model(**model_kwargs)vLLM 在每一步后都会重算 common_attn_metadata(位置、slot mapping、序列长度),因为草稿槽位是步内递增的。这一步在 SGLang 里被 out_cache_loc[i] 的切片替代:SGLang 在 prepare 阶段一次性算好 [num_steps, b] 的槽位矩阵,循环里只切一列。
索引器复用的收益与边界
GLM-5.3 的 index_share_for_mtp_iteration = true 是草稿段最值得单独讲的一行配置。DSA 在每一层需要一个索引器先给历史 KV 打分、选出 Top-2048,再做稀疏 MLA。对草稿段来说,如果 4 次前向每次都把索引器完整跑一遍,代价是:每次一个 token 对整段上下文做点积,索引器有 32 个头、每个头 128 维 K,读取量随上下文线性增长。长上下文下,这部分可能超过草稿的 MoE 权重读取。
SGLang 的处理是 IndexTopKShareState.mtp_iteration 上下文管理器:
@classmethod@contextmanagerdef mtp_iteration(cls, forward_batch, enabled=True, keep_carry_seed=False): if not enabled: yield None return spec_info = forward_batch.spec_info forward_batch.reuse_dsa_topk_indices = True if not (keep_carry_seed and spec_info.dsa_topk_indices is not None): spec_info.dsa_topk_indices = None try: yield cls.from_mtp_carry(forward_batch) finally: spec_info.dsa_topk_indices = None forward_batch.reuse_dsa_topk_indices = False进入上下文后,reuse_dsa_topk_indices = True,索引器层第一步算出的 Top-K 下标存在 spec_info.dsa_topk_indices 里,后续步骤直接读这份下标跳过打分。这带来三个直接的结果:
- 索引器的 读取从 4 次降为 1 次(每层),长上下文下收益最大;
- 草稿链的每步只看到同一组历史 KV,这在
topk = 1时成立:单链草稿的每一步都只是“当前已提交前缀 + 前面草稿 token”,历史部分完全相同,只有 query 不同; - 多链草稿(
topk > 1)不能共享,因为每个分支需要各自的历史选择。这也是 cookbook 推荐 GLM-5.3 用topk = 1的原因之一。
vLLM 的对应实现更直白,在 propose() 里用 set_skip_topk 开关:
# Step 0 of index_share_for_mtp_iteration: let the MTP layer# compute its own indices (skip_topk=False) so subsequent steps# can reuse them.if self._share_mtp_indices and hasattr(self.model.model, "set_skip_topk"): self.model.model.set_skip_topk(False)...# After step 0: switch to reuse mode so steps 1+ skip the indexer# and read the indices that step 0 just wrote into the shared buffer.if self._share_mtp_indices: self.model.model.set_skip_topk(True) self.model.model.compact_topk_indices(token_indices_to_sample)两者效果相同,差别在颗粒度:SGLang 按一次 mtp_iteration 的上下文切换,vLLM 按 set_skip_topk 标志位切换,并在切换时把多行 batch 的 Top-K 压缩成每请求一行(compact_topk_indices),因为后续步骤每个请求只有 1 行 query。
还有一条隐性约束:共享的 Top-K 下标是写进 GPU 缓冲区的,草稿段的 CUDA Graph 必须把这个缓冲区地址固定下来,否则图重放时会读到上一次迭代的旧下标。vLLM 和 SGLang 都把它放进静态缓冲;如果草稿 batch 形状超出图桶、回退到 eager,这条路径就会多出一次 D2D 拷贝。
验证段:6 行 batch 与一棵退化成链的树
验证输入是怎么拼出来的
草稿段结束时,draft() 返回一个 EagleVerifyInput。它的构造在 build_eagle_verify_input 里,核心是两步:先把 bonus_tokens 与 draft_tokens 拼成验证 batch,再为这 6 行构造注意力掩码。
tree_outputs = build_tree_kernel_efficient( draft_input.bonus_tokens, parent_list, top_scores_index, draft_tokens, batch.seq_lens, seq_lens_sum, topk, num_steps, num_draft_tokens, mask_mode, tree_mask_buf, fill_prefix_mask=fill_mask,)build_tree_kernel_efficient 的第一行就把答案写清楚了:
draft_tokens = torch.cat((bonus_tokens.unsqueeze(1), draft_tokens), dim=1).flatten()验证 batch 是 1 个 bonus token 加 5 个草稿 token,共 6 行,每行对应该请求的一段连续位置。parent_list 描述树结构:topk = 1 时它退化成一条链,第 行的父节点就是第 行;topk > 1 时才是一棵真正的树。
掩码模式由 TreeMaskMode 决定。单链场景下 SGLang 走 QLEN_ONLY 路径,掩码不必显式写出每个 query 能看到哪些草稿前缀,只需要记录每条请求的 query 长度,后端在 kernel 里按链式因果掩码处理。这省掉了一次 的掩码构造与显存写入——对长上下文,这个掩码本身可能比 6 行 hidden state 大几个数量级。
验证前向的 ForwardMode 是 TARGET_VERIFY,走目标模型的 78 层。位置张量不是简单的 seq_len + i:链式草稿的 6 行位置是 seq_len, seq_len+1, ..., seq_len+5,但树式草稿的 6 行可能共享前缀位置。SGLang 在 positions 里按树结构展开,vLLM 在 copy_and_expand_eagle_inputs 的 kernel 里做同样的事。
验证段的逐层算子
验证段的 78 层与普通 decode 的层结构完全一样,差别只在 token 数与掩码:
| 序号 | 算子 | 与普通 decode 的差别 |
|---|---|---|
| 1 | 残差加法 + RMSNorm | token 数从 变成 |
| 2 | A 投影(6144 → 2624) | 同上,GEMM 的 M 维变 6 倍 |
| 3 | q_a / kv_a RMSNorm + RoPE + 写 KV | 每请求写 6 个位置,槽位由草稿段规划好 |
| 4 | Q 上投影(2048 → 64×256) | 6 行 query |
| 5 | 索引器 K 投影与打分 | 21 个 full 层,每层对 6 个 query 各打一次分 |
| 6 | Top-K 选择 | 每个 query 选自己的 2048 个 KV,不能跨 query 复用 |
| 7 | 稀疏 MLA 注意力 | 6 个 query 对历史 KV 加树内可见前缀;链式时是标准因果掩码 |
| 8 | o_proj + 归约 | 6b 行的 ReduceScatter |
| 9 | 路由 + dispatch | 6b×8 个 token 的 all-to-all |
| 10 | 专家 GEMM | 6b 行的 grouped GEMM |
| 11 | combine | 6b 行的 all-to-all |
| 12 | LM Head | 只对 6 行都算 logits(验证需要每个位置的分布) |
| 13 | 采样与接受判定 | 一次产生 6 个候选、一个接受长度、一个 bonus |
第 12 行是验证段与普通 decode 最大的算子差异。普通 decode 每步只对最后一行算 logits;验证段要对 6 行都算,因为接受判定需要每个位置的目标分布。LM Head 的词表并行 GEMM 因此变成 6 倍,随后如果 TP 按词表切分,还要做一次 的 AllGather。第一篇给过这个数: 时单次约 59MB(BF16),这是验证段最容易被低估的一笔通信。
第 5、6 行也值得展开。索引器的跨层复用(indexer_types 里 21 个 full 层、57 个 shared 层)与 MTP 的跨步复用是两套机制:前者让 shared 层复用同一 token 在更早层算出的 Top-K,后者让草稿的后续步复用同一请求在第一步算出的 Top-K。验证段的 6 个 query 位置不同,跨层复用仍然成立(每个位置各自沿层复用),但跨 query 不能复用。所以验证段的索引器工作量是 个 query 的打分,而不是 。这一点在长上下文下很贵:6 个 query 各自对整段历史做 32 头、128 维的点积。
验证段的通信账
按 8 卡 DP Attention + EP8、、 计算,一次验证前向的通信如下:
| 通信点 | 次数 | 单次消息量 | 合计 |
|---|---|---|---|
| 进层前 DP AllGather | 1 | ≈ 2.36MB | 2.36MB |
| 每层注意力后 ReduceScatter | 78 | 2.36MB | 184MB |
| 稠密层 MLP AllReduce | 3 | 2.36MB | 7.1MB |
| MoE dispatch(FP8) | 75 | ≈ 9.4MB | 708MB |
| MoE combine(BF16) | 75 | 18.9MB | 1.42GB |
| 词表 AllGather | 1 | ≈ 59MB | 59MB |
| 合计 | — | — | 约 2.38GB |
这 2.38GB 里,MoE 的 dispatch 与 combine 占 90%。它和普通 decode 的通信结构完全相同,只是 token 数从 变成 。如果 MoE 的 combine 能与下一个 GEMM 重叠(第六篇讲的第三层重叠),实际落在关键路径上的只有 dispatch 和一部分 combine;但验证段的 6 倍 token 让重叠窗口变窄,因为第二个 GEMM 本身也变长了。
接受判定:greedy 与 rejection sampling
验证前向产出 6 行 logits 后,run_eagle_verify 调用 eagle_sample 做接受判定。greedy 与采样两条路径的语义不同:
- greedy:目标模型对第 行取 argmax,与草稿第 个 token 比较;相同则接受,遇到第一个不同就停止,后面的草稿全部丢弃。接受长度就是连续相同的个数。
- 采样:草稿分布 与目标分布 做拒绝采样,以 的概率接受;被拒绝的位置从修正后的分布里重新采样一个 token,作为该步的 bonus。
vLLM 把这条路径独立成 RejectionSampler,模型 runner 在 _sample() 里根据是否存在 spec_decode_metadata 分流:
if spec_decode_metadata is None: return self.sampler(logits=logits, sampling_metadata=sampling_metadata)
draft_probs = self._get_spec_decode_draft_probs(spec_decode_metadata)sampler_output = self.rejection_sampler( spec_decode_metadata, draft_probs, logits, sampling_metadata,)SGLang 的 eagle_sample 把惩罚项、温度、top-k/top-p、语法掩码都作用在 6 行 logits 上,再按链式结构从前往后判定。它返回三个东西:每请求的 predict(接受段加 bonus)、accept_lens(含 bonus)、accept_index(接受段在 6 行里的下标)。accept_index 是后面 KV 搬移的唯一依据。
这里有一个常被忽略的细节:接受长度是按 token 计的,不是按步计。GLM-5 报告给的 2.76 是 4 步配置下的平均接受长度;换到 5 步、6 个验证 token 的配置,接受长度会变,但不会线性变好。第 5、6 个草稿 token 的边际接受率通常低于前几个,因为草稿链越长,误差累积越多。生产上要看服务端上报的 accept length,而不是照搬报告里的数字。
KV 交账:接受段的搬移与拒绝段的回收
验证前向把 6 行的 KV 都写进了草稿段规划好的窗口槽位。接受判定后,只有前 accept_len 行(含 bonus)属于这条请求的新前缀,后面的行必须回收。SGLang 的处理是 move_accept_tokens_to_target_kvcache:
fill_front_out_cache_loc_func(num_correct_drafts + 1, batch.out_cache_loc, tgt_cache_loc)fill_accept_out_cache_loc_func(accept_index, batch.out_cache_loc, accept_out_cache_loc, size)token_to_kv_pool_allocator.get_kvcache().move_kv_cache(tgt_cache_loc, accept_out_cache_loc)这段代码做的是真正的 KV 搬移,不是只改元数据:把接受段在验证窗口里的 KV 复制到目标 KV 池的前排槽位,再把 seq_len 推进到接受长度。为什么要复制?因为验证窗口的 6 个槽位是按“草稿链的写入顺序”分配的,接受段可能只占前几列,而后续的 draft_extend 和下一轮验证要求这些 KV 落在一条连续的、可被前缀缓存索引的槽位序列上。
搬移量可以算:每请求 accept_len 个 token、78 层、每层 656 字节。、接受长度 2.76 时约 MB。字节数不大,但它是一个依赖前向结果的 D2D 拷贝 kernel,必须等 eagle_sample 的接受下标出来才能启动,落在关键路径上。SGLang 用 plan_stream 把槽位计算与搬移拆到独立流,尽量让拷贝和前向的尾部重叠。
vLLM 走的是另一条路:它不复制接受段,而是用 num_rejected_tokens_gpu 在下一步的 common_attn_metadata 里把 seq_lens 减去被拒绝的 token 数,让后续的 slot mapping 直接覆盖被拒绝的槽位。两种做法的账不同:SGLang 付一次拷贝,换来连续的前缀槽位;vLLM 付一次元数据修正,靠 slot mapping 的覆盖写避免搬移。前者对前缀缓存更友好,后者在短上下文、频繁验证的场景更省。
被拒绝的 6 行 KV 还有一个容易漏掉的点:索引器缓存的写入。验证段在 21 个 full 层里为 6 个 query 各写了一份索引器 K(128 维),这些写入发生在接受判定之前。拒绝段对应的索引器 K 会留在缓存里,直到页被回收。因为 seq_len 已经回退,这些位置不会被再次读到,不会影响正确性;但如果做前缀缓存复用,必须保证复用的前缀长度不超过接受长度,否则会把拒绝段的索引器 K 当成有效前缀。第十二篇讲的分页预算在这里有一个直接推论:索引器缓存的逻辑长度要跟着 seq_len 走,而不是跟着物理写入走。
draft_extend:把接受段写回草稿层
为什么需要这一步
草稿层有自己的 KV。每一轮草稿前向时,草稿层把“当前 token 的草稿 KV”写进自己的 KV 池;验证前向写的是目标模型的 KV 池。两套 KV 的长度必须保持同步:下一轮草稿要从“已提交前缀的末尾”开始,草稿层必须已经持有这段前缀(含刚被接受的 token)的 KV,否则它的注意力会缺历史。
把 6 行验证 batch 的 KV 一次性写进草稿层是最简单但最浪费的做法:被拒绝的行也要写,而且验证 batch 是 6 行,草稿层只需要接受段。draft_extend 只写接受段。
输入构造:prepare_for_draft_extend
SGLang 在 _draft_extend_for_decode 里先算出三个量:
num_correct_drafts, select_index, next_token_ids = prepare_draft_extend_inputs( batch_result.accept_lens, batch_result.next_token_ids, self.speculative_num_draft_tokens,)accept_lens 含 bonus,num_correct_drafts = accept_lens - 1 只算草稿;select_index 是每请求“接受段最后一行”在 6 行里的下标。draft_extend 的输入 token 是接受段的所有 token 加 bonus,hidden 是验证前向对应行的 hidden,位置从 seq_len 开始连续递增。
num_tokens_per_req 被设成 num_draft_tokens(6)而不是接受长度,注释解释得很清楚:这是为了让 topk > 1 时 DP 的 MLP-sync padding 保持一致的形状。也就是说,draft_extend 的 batch 在形状上是按 6 行每请求构造的,只有前 accept_len 行的输出被使用。多出来的行在 DP Attention 下参与 AllGather,但被 mask 掉,这是为了形状稳定换取的浪费。
这里还有一条流重叠的安排:prepare_for_draft_extend 在 plan_stream 上跑,等主计算流的验证前向完成后再 wait_stream。槽位计算与形状构造可以和验证前向的尾部重叠,draft_extend 本身仍在主计算流上。
draft_extend 的算子与通信
draft_extend 是一次 1 层 MTP 前向,形状是 [b × 6, 1](形状按窗口宽度构造)。逐层算子与草稿前向相同,差别在:
- KV 写入:接受段的槽位由
iteration_ids指定,与验证窗口的后半段对齐;被拒绝行的槽位不写。 - 位置:接受段的 6 个位置连续递增,跨请求之间有间隙。
- hidden 来源:验证前向的 logits_output.hidden_states,不是草稿层自己的输出。
- 索引器:
seed_dsa_topk_from_draft_extend开启时,draft_extend 会把索引器的 Top-K 写进一个种子缓冲区,供下一轮的草稿段第一步直接复用。这是在“跨步复用”之外再加一层“跨阶段复用”,把下一轮草稿第一步的索引器开销也省掉。
通信结构与草稿前向同构:6b 行的注意力归约加 6b × 8 个 token 的 DeepEP dispatch/combine。按形状满配估算, 时一次 draft_extend 的 combine 约 18.9MB,与验证段单层的 MoE combine 相同。实际有效的只是接受段,但按形状记,账要按 6b 记。
草稿层 KV 的账
草稿层的 KV 池与目标模型分池:目标模型 78 层,草稿层 1 层。每 token 草稿 KV 是 656 字节(同样的 fp8_ds_mla 布局),草稿层的 KV 池容量 = 目标 KV 池的 1/78。这个比例在规划显存时经常被忽略:如果目标模型占 57GB 的 1M 上下文 KV,草稿层需要约 0.73GB。加上草稿层 MoE 的 ~10GB 权重,开 MTP 的显存代价接近 11GB。
draft_extend 之后的草稿层 KV 与目标 KV 必须严格同步。有一个边界:如果接受段只包含 bonus token(接受长度 1,即第一个草稿就被拒绝),draft_extend 仍然要写 1 行——这个 token 是目标模型真正生成了的 token,它的草稿层 KV 下一轮会用到。反过来,如果接受段满载(6 行全接受),draft_extend 写 6 行,这与验证窗口完全重合,搬移量最大。
把三段加回一次 decode step 的总账
前面各篇算的“一次 decode step”是一条请求一步 1 个 token 的账。开启 MTP 后,同一条请求一步推进约 2.76 个 token,但付出的计算和通信不是按 2.76 倍缩放,而是按各段的形状相加。
以 SGLang、DP Attention + EP8、、5 步草稿、平均接受长度 2.76 为例:
| 账目 | 草稿段(4 次) | 验证段(1 次,78 层) | draft_extend(1 次) | 总账 |
|---|---|---|---|---|
| 前向调用 | 4 | 1 | 1 | 6 |
| 参与计算的 token 数 | 4b = 128 | 6b = 192 | 6b = 192(形状) | 512 |
| 实际推进的 token | — | — | — | ≈ 88 |
| 注意力层数 × 调用 | 4 × 1 | 78 | 1 | 83 |
| MoE 层数 × 调用 | 4 × 1 | 75 | 1 | 80 |
| MoE dispatch 次数 | 4 | 75 | 1 | 80 |
| MoE dispatch 字节(FP8) | ≈ 6MB | ≈ 708MB | ≈ 9.4MB | ≈ 724MB |
| MoE combine 字节(BF16) | ≈ 13MB | ≈ 1.42GB | ≈ 18.9MB | ≈ 1.45GB |
| 注意力后归约 | 4 × 0.39MB | 78 × 2.36MB | 1 × 2.36MB | ≈ 188MB |
| 词表 AllGather | 4 × 9.9MB | 59MB | 0(通常不算 logits) | ≈ 99MB |
| LM Head 行数 | 4 × 32 | 192 | 0(通常不算 logits) | 320 |
这张表最值得盯的两个数是:MoE 的 dispatch/combine 合计约 2.18GB,每步推进 88 个 token;不开 MTP 时,8 步(88 个 token)的 MoE 通信大约是 88 个 token 乘以每 token 的 8-way 消息,量级上与验证段的 6 倍放大接近,但草稿段的 4 次与 draft_extend 的 1 次是完全额外的开销。在不重叠的理想情况下,MTP 的通信开销比不开 MTP 多出约 10%~20%,换来的是 8 步合成 1 步的 kernel launch 节省、以及一步多 token 的流水线收益。
真正把 MTP 拉回正收益的,是计算侧的账不同。不开 MTP 时 8 步 decode 是 8 × 78 层的权重读取;开 MTP 后是 4 次 1 层草稿 + 1 次 6 行验证 + 1 次 draft_extend。验证段的每行 token 共享同一层权重的读取,6 行一起算时,MoE 的专家权重读取仍然是“激活专家数”级的,不会线性放大 6 倍,但 grouped GEMM 的 M 维变长、每卡分到的 token 数变多,专家命中更分散,权重读取总量会上升。这一点在第六篇讨论 DeepEP 低延迟模式时已经埋过伏笔:小 batch 下 MoE 是权重带宽受限,大 batch 下变成计算受限。验证段的 6b 正好落在两者之间。
草稿段的代价则是纯粹的权重读取放大:4 次单 token 前向不可能把 MoE 权重读取摊薄,每次都要读 8 个专家的权重。长上下文下,草稿段的注意力与索引器占比上升,但因为 index_share_for_mtp_iteration,索引器只跑一次,注意力本身在 2048 个 KV 的规模下开销很小。短上下文、小 batch 下,草稿段的总开销可能接近一次验证前向的 1/3,这是 MTP 在小 batch 下收益不高的原因;GLM-5 报告也指出 MTP 在小 batch 解码下最有效——这里的“小 batch”指的是每条请求的 token 少、排队少,而不是草稿段的开销小。
CUDA Graph 与形状
三段前向的形状不同,图捕获的桶也不同:
- 草稿段:4 次调用形状都是
[b, 1],可以共用同一张图,只要b落在桶内。SGLang 的EAGLEDraftCudaGraphRunner只捕获草稿前向本身,不捕 slot 分配。 - 验证段:形状是
[6b, 1],需要 6b 对应的桶。只捕获了b桶的部署会让验证段回退到 eager——第一篇提到过这一点,代价是每层重新走 Python 调度。 - draft_extend:形状是
[6b, 1],与验证段共用桶,但它的 attention backend 不同(草稿层只有 1 层,DSA 索引器可能被种子复用跳过),所以 SGLang 单独维护cuda_graph_runner_for_draft_extend。
这里有一个和第九篇混批直接相关的推论:混批时验证段不能和普通 prefill 共用同一张图。一条 8K prefill 并与 32 条 decode 时,验证段的 6b 行与 prefill 的 8192 行混在一个 batch 里,形状既不在 b 桶也不在 6b 桶,图重放失效。SGLang 在混批路径上把投机验证 batch 单独切出去,或者退化为 eager;vLLM 的 _determine_batch_execution_and_padding 在验证段也走 padding 到最近桶,pad 掉的行被 mask,不做 MoE。
几个真正会踩的坑
坑一:草稿层的 KV 页不够。 草稿段按 6 个槽位窗口规划 out_cache_loc,如果草稿层的 KV 池剩余页不足以放下这 6 列,assign_draft_cache_locs_contiguous_func 会写到越界槽位。上线前要核对准入预算:调度器的 token 与页预算是否把草稿层那 1 层 KV 计入。如果它只按目标模型的 78 层算,满负载、大量请求同时开 MTP 时就会先在草稿层出现页耗尽。
坑二:topk = 1 与多链切换时的图不匹配。 多链草稿(topk > 1)走 duplicate_prefix_tail_to_draft_branches,形状是 [b × topk, num_steps],图桶完全不同。SGLang cookbook 给 GLM-5.3 的默认配置是 topk = 1,如果按其他模型的 topk = 4 配置迁移,需要重新捕获草稿图,并检查 page_size 大于 1 时的页对齐分支。
坑三:索引器共享与语法约束并存。 当请求带语法约束(JSON、结构化输出)时,验证段的每个草稿位置都要过语法掩码;草稿段的 Top-K 共享不影响掩码,但草稿段本身也要过语法掩码,否则会生成不合法的草稿。SGLang 的 build_grammar_vocab_mask 在验证段构造树掩码,草稿段的语法掩码在 sampler 里按 step 叠加;两者都要从请求的 FSM 状态里取同一份约束,否则接受率会因为草稿不合语法而骤降。
坑四:PD 分离下草稿层 KV 的交接。 第四篇算的 57GB 是目标模型的 KV;草稿层的 1 层 KV 也要在 prefill 实例和 decode 实例之间交接,否则 decode 侧第一轮草稿就缺历史。上线前要确认 KV 连接器的层清单覆盖草稿层,并且索引器缓存与草稿层 KV 的同步顺序正确:草稿层 KV 必须在目标 KV 完成写入之后再写,因为 draft_extend 的 seed 索引器依赖目标前向的结果。
坑五:采样温度与草稿分布不一致。 草稿段在采样模式下需要输出草稿分布(draft_probs),目标段用它做拒绝采样。如果草稿段用了不同于目标的温度,p/q 的比值会失真,接受率下降但不影响正确性;如果草稿段用了 topk = 1 的 argmax,而目标段是采样,那就是把贪婪草稿配概率验证,语义上等价于“草稿只在 argmax 上给建议”,接受长度会明显低于报告值。
EAGLE 草稿与验证的数据流
三段前向的输入输出在 EAGLE-2 论文的概览图里有很直观的两格:草稿阶段消费目标模型的 hidden state 产出候选 token,验证阶段把候选拼成 batch 让目标模型一次性判定。EAGLE-2 的核心贡献是动态草稿树与树式验证的采样校验,这两格画的正是 GLM-5.3 在 SGLang 里走的两段前向。
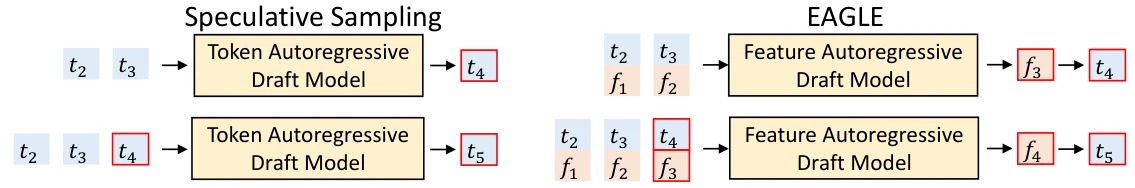
图源:EAGLE-2 论文 Figure 1(a),arXiv:2406.16858。GLM-5.3 的 MTP 层结构是 EAGLE 思路的一种特化:草稿层不是独立小模型,而是主干附带的一层,
speculative_num_steps就是这个循环的步数。
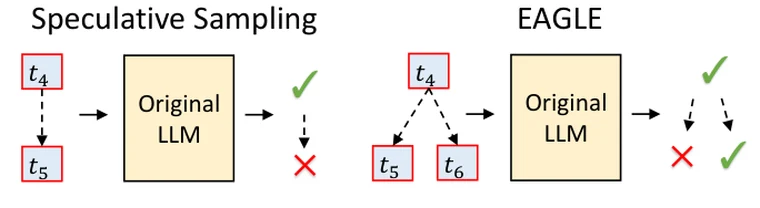
图源:EAGLE-2 论文 Figure 1(b)。验证段的批次形状由草稿 token 数决定,GLM-5.3 默认 6 行,接受判定走的就是图中“批量采样校验”那条路径。
这两张图对应的是“一段前向”的轮廓,缺的正是本篇要补的工程细节:草稿阶段在图里是“一次”,实现对单链草稿是 4 次小前向;验证阶段在图里是一整段,实现对 78 层 DSA 的逐层索引器复用;图里没有 KV 的流动,实现对接受段的 KV 搬移与拒绝段的回收单独记账。
与站内几篇的接口
- 第一篇给的是不开 MTP 的时间线,这一篇把“MTP 一步”展开成三段;两者的算子清单可以逐行对照。
- 第六篇讲的 MoE dispatch/combine 重叠,在验证段有一个直接推论:combine 与下一个 GEMM 的重叠窗口会被 6 倍 token 拉长,重叠的收益在验证段被稀释。
- 第七篇讲输出侧的
_trim_surplus_tokens与output_ids_through_stop,处理的是“一步多 token 时停止条件的截断”;本篇的接受判定产出多个 token,正是那套截断逻辑的输入。 - 第九篇的混批与本篇的图桶问题互相约束:混批的 batch 里含有验证段的 6b 行时,图路径必须单拎出来。
- 第十一篇的索引器跨层复用与本篇的跨步复用是两套独立机制,叠加后的索引器工作量是 个 query(验证段),草稿段只需 个 query 的索引器计算。
附:长上下文下草稿段的索引器账
上一节说“长上下文下索引器可能超过草稿的 MoE 权重读取”,这句话需要一个数量级的支撑。草稿段每次前向的索引器开销包括两部分:读索引器 KV、打分。
索引器 KV 每个 token 每层是 index_head_dim = 128,FP8 存储即 128 字节;21 个 full 层每层一份,合计 字节/token。草稿是单链,上下文长度 时一次草稿前向的索引器读取量是:
开启 index_share_for_mtp_iteration 后,第一步算一次、后续三步复用同一组 Top-K 下标,读取量变成:
按 FP8 算, 时不共享约 1.4GB、共享约 0.35GB; 时不共享约 11.3GB、共享约 2.8GB。草稿段的 MoE 权重读取则取决于 batch: 时每步约 300MB、4 步约 1.2GB; 时每步可激活约 32 个不同专家、每步约 1.2GB、4 步可到 4.8GB。两笔账的相对大小因此分三种情况:128K 上下文下,无论 batch 多大,共享后的索引器读取(0.35GB)都小于 MoE;1M 上下文、 时,索引器(2.8GB)反超 MoE(1.2GB);1M 上下文、 时,MoE 的 4.8GB 仍在索引器之上。索引器共享并没有把这一项消掉,它只是把系数从 4 降到 1;上下文越长、batch 越小,这一项越可能成为草稿段的最大开销。
这里有一个反直觉的推论:在长上下文 decode 中,草稿段的索引器开销由它“读多少历史”决定,而不由草稿步数决定。把草稿步数从 5 调到 7、验证 token 从 6 调到 8,草稿段的索引器读取不变(仍是 1 次),但验证段的索引器工作量从 变成 个 query,MoE 通信也从 6b 变成 8b。草稿步数越长,验证段的负担越重;草稿步数越短,接受长度越低。生产调参的真正目标不是“草稿越多越好”,而是让接受长度乘以验证段的边际成本与草稿段的固定成本相等。
如果把这三项写成一条近似等式(每步的成本,以字节为单位):
其中 是草稿步数, 是一次草稿前向的固定成本(权重读取加一次索引器读取), 是验证段每个 token 的边际成本(MoE 通信加注意力), 是写回成本。每步推进的 token 数是 ,即接受长度:
这一步推导给出的结论很直接:草稿段的固定成本要除以接受长度才能摊薄,所以 增大时,草稿段成本线性增长、接受长度次线性增长,后者追不上前者;验证段的边际成本和写回成本则被接受长度整除,收益递减。这就是为什么 GLM-5 报告只给了 4 步配置的接受长度,而生产上调大草稿步数往往收效甚微——真正的增益来自把 降下来,也就是本篇讲的索引器共享与草稿层的 MoE 权重读取优化。
最后一个容易被忽略的细节:草稿段和验证段在不同 DP rank 上是按请求切分的。DP Attention 下每个 rank 只算自己负责的请求,草稿段的 是本地 batch,验证段的 也是本地 batch;而 MoE 的 EP 是全组共享的,所以验证段的 6b 个 token 要在 EP 组内做 all-to-all。混批时,某个 rank 上可能只有 1 条请求开了 MTP、其余都是纯 decode,这时验证段的 6 行只属于一条请求,EP 的负载在 rank 之间极不均衡——这正是第六篇讨论的“decode 专家聚集”在 MTP 场景下的新形态:6 行都属于同一条请求的两个相邻位置,它们激活的专家高度重合,负载均衡器看到的“热门专家”会被进一步放大。
EAGLE 草稿的树形状:单链与多链在账本上的差别
上面整篇的账都按 GLM-5.3 在 SGLang 的推荐配置 topk = 1 展开。但草案段与验证段的形状设计是围绕“树”做的:parent_list、top_scores_index、tree_mask 这些字段只有在 topk > 1 时才真正用得上。理解这部分,才能解释为什么 GLM-5.3 在 SGLang 里推荐单链,以及如果真的切到多链,账会怎么变。
多链草稿的展开过程
topk > 1 时,草稿段每一步不是只保留一条链,而是从每行的 top-k 候选里保留前 topk 个,形成一棵宽度为 topk、深度为 num_steps 的树。SGLang 在 select_top_k_tokens 里做扩张:
@torch.compile(dynamic=True, disable=_is_npu or _is_xpu)def _select_top_k_tokens_later(i, topk_p, topk_index, hidden_states, scores, topk): topk_sq = topk * topk expand_scores = scores.unsqueeze(2) * topk_p.view(-1, topk, topk) topk_cs_p, topk_cs_index = fast_topk(expand_scores.flatten(start_dim=1), topk, dim=-1) topk_index = topk_index.view(-1, topk_sq) input_ids = torch.gather(topk_index, 1, topk_cs_index).flatten()第 步的每个节点有 topk 个子节点,要计算 个候选的“父分数 × 子概率”,再从中选出全局最好的 topk 个,作为下一步的输入。这也是为什么草稿段的 batch 形状会从 [b, 1] 变成 [b × topk, 1]:树干宽度决定了并行前向的 token 数。
对账本的三处影响
多链对前面算的三笔账都有影响:
- 草稿段:每次前向的 token 数从 变成 。MoE 的权重读取量近似不变(激活专家数不变、只是每卡 token 数变多),但如果跨卡分布变化,dispatch/combine 的字节数线性放大。索引器复用失效——每个分支要各自的历史 Top-K,所以索引器读取从 1 次变回每步 1 次、每次 行。
- 验证段:验证 batch 仍是
num_draft_tokens行(通常是num_steps + 1),不随topk放大;但树掩码变成真正需要写入的矩阵, 的掩码写入重新出现,长上下文下这笔写入可能比 hidden state 还大。这就是单链走QLEN_ONLY能省掉的那部分开销。 - draft_extend:接受段沿树的一条路径取,
select_index不再是简单的等差序列,prepare_draft_extend_inputs的 kernel 要从accept_index里取路径;如果接受段跨层,KV 搬移的目标槽位也要按树路径压缩。
所以 GLM-5.3 推荐 topk = 1 不是因为它不支持树,而是因为 index_share_for_mtp_iteration 只在单链时有效:共享的 Top-K 是“同一请求、同一段历史”的选择,多链恰恰需要每个分支有不同选择。单链配置下,草稿段的索引器读取被压到 1 次,这部分收益在多链下不存在。
验证段的图桶与批量形状选择
验证段的 batch 大小是 b × num_draft_tokens。在 DP Attention + EP 的部署里,这个值又被进一步乘上每条请求在验证时占用的“位置数”:单链草稿时是 6,多链时也是 6 但每行属于不同分支。
图捕获时,框架按 max_num_seqs 和 num_draft_tokens 的乘积给验证段预留桶。GLM-5.3 的 max_num_seqs 在 8 卡 DP8 上通常设为 16~32,验证段桶的上界就是 。如果调度器在某一步把 decode 与一条长 prefill 混在一起(第九篇的混批),验证段的 192 行会与 prefill 数千行拼成同一个 batch,桶不匹配,图重放失效。
SGLang 的做法是在混批时把投机请求的验证段拆成独立的 batch:先跑普通 decode 与 prefill 的混合 batch,再单独跑验证段。这样验证段的形状仍落在 192 桶里,但多了一次 kernel launch 与一次独立的前向调度。vLLM 的对应做法是在 _determine_batch_execution_and_padding 里把整个 batch pad 到最近的桶,验证段与非验证段共享一次前向,代价是 padding 的行被 mask,不做 MoE,但 ep dispatch 仍按 padded 的形状发送。两种做法的账不同:SGLang 付一次额外前向,vLLM 付一次 padding 的 MoE 空转。
小结
把 MTP 的三段前向压成几句话:
- 草稿段是 4 次
[b, 1]的单 token 前向,每次都要走完整的 1 层 MoE,MoE 权重读取无法像验证段那样被多行摊薄;index_share_for_mtp_iteration把索引器的 读取系数从 4 压到 1,长上下文、小 batch 下这是草稿段最大的一笔节省。 - 验证段是 1 次
[6b, 1]的 78 层前向,MoE 通信是普通 decode 的 6 倍 token 量,LM Head 对 6 行都算;接受判定按链式从前往后,接受长度决定后续所有 KV 操作。 - draft_extend 是 1 次按 6 行形状构造的 1 层前向,只写接受段,并把索引器种子留给下一轮草稿。
- 总账:一次 decode step 的 MoE 通信约 2.18GB(,DP8),比不开 MTP 的 8 步多出约 10%~20%,换来的是 kernel launch 合并与小 batch 下的权重读取摊薄;MTP 的收益不是无条件的,接受长度是决定性变量。
- 真正容易出错的地方不在数学,而在形状与预算:草稿层 KV 的额外预算、6b 的图桶、索引器与语法约束的交互、PD 分离下草稿层 KV 的交接顺序。
下一篇将讨论 GLM-5.3 推理链路在 PD 分离与 MTP 叠加时的 decode 实例显存规划:目标 KV、索引器缓存、草稿层 KV、CUDA Graph 缓冲四份预算如何在同一张卡上切分,以及在什么规模下必须把草稿层拆到独立的 rank 组上。
附:与不投机解码的对照时间线
最后把三段拼成一条时间线,与不开 MTP 的纯 decode 并列:
| 时间点 | 不开 MTP | 开 MTP(单链,5 步) |
|---|---|---|
| 调度器挑 batch | 每步 32 条请求 | 每步 32 条请求 |
| 输入构造 | b 行 token | 草稿窗口一次规划 6 列 |
| 前向 1 | 78 层,b 行 | 1 层草稿,b 行,× 4 |
| 前向 2 | — | 78 层,6b 行 |
| 前向 3 | — | 1 层草稿,6b 行(写回) |
| 采样 | 每请求 1 行 | 每请求 6 行,接受判定 |
| KV 更新 | 直接追加 1 个槽位 | 搬移接受段,回收拒绝段 |
| 词表 gather | b 行 | 验证段 6b 行 |
| 推进 token | 32 | ≈ 88 |
同样的墙钟时间预算下,开 MTP 的这条时间线多了两个前向类别,但推进 token 数增加了近 3 倍。收益能否兑现,取决于两点:草稿段的 4 次前向能不能被图重放压到接近“一次 launch 的开销”,以及验证段的 6 倍 MoE 通信能不能被重叠吸收。前者是 CUDA Graph 的事,后者是 DeepEP 重叠的事,两者在前面的篇目里都单独算过;本篇把它们放进 MTP 的形状里,得到的结论是:MTP 的账从来不是“多算一点换多出一点”,而是把不同形状的前向拼在一起,让每种形状落在它最便宜的执行路径上。
参考资料
- GLM-5: from Vibe Coding to Agentic Engineering
- GLM-5.3 模型卡(config.json 与架构字段)
- DeepSeek-V3 Technical Report:MTP 与基础架构
- EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
- EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees
- SGLang 源码:
python/sglang/srt/speculative/eagle_worker_v2.py - SGLang 源码:
python/sglang/srt/speculative/eagle_worker_common.py(run_eagle_verify、prepare_for_draft) - SGLang 源码:
python/sglang/srt/layers/attention/index_topk_share.py - SGLang 源码:
python/sglang/srt/models/glm4_moe_nextn.py(GLM MTP 层) - SGLang 源码:
python/sglang/srt/speculative/spec_utils.py - SGLang Cookbook:GLM-5.3 部署参数
- vLLM 源码:
vllm/v1/spec_decode/llm_base_proposer.py(propose与索引器复用) - vLLM 源码:
vllm/v1/sample/rejection_sampler.py - vLLM 源码:
vllm/model_executor/models/glm4_moe_mtp.py - 站内:GLM-5.3 推理全链路(一):一个请求在 SGLang 里经过哪些算子、哪些通信
- 站内:GLM-5.3 推理全链路(七):输出侧的最后一公里——采样、增量解码、停流与 KV 回收
- 站内:MTP 完全拆解:多 token 预测如何让 DeepSeek 自带草稿模型
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



