


GLM-5.3 推理全链路(七):输出侧的最后一公里——采样、增量解码、停流与 KV 回收
前六篇沿着 GLM-5.3 的一条请求,走完了入口、调度、Prefill、Decode、上下文并行、PD 分离和 MoE 的 dispatch/combine。到第六篇结尾,链路里还剩最后一个没有打开的黑盒:目标模型吐出 token id 之后,这些整数怎样变成文本、怎样在正确的位置停下、怎样以 SSE 的形式回到客户端,以及请求结束后占用的 KV 页与前缀缓存怎样被回收。
这一段常被当作“框架的收尾工作”,好像只要前向算得快,输出侧随手写写就行。实际并非如此。一个 1M 上下文的请求,KV 缓存动辄几十 GB;如果回收路径漏掉一次引用,几分钟内就能把整个实例的显存吃光。一个 stop string 如果跨两个 token 边界才出现,而实现只在“本步新增文本”里查找,请求就会多生成一段本不该出现的内容。一个 UTF-8 汉字被切成两个 token 时,如果增量解码器把半截字节直接送进 SSE,客户端会看到替换字符 �,而且后续文本的偏移全部错位。输出侧的每个细节都直接对应线上可见的错误。
这一篇仍然以 GLM-5.3 为对象,但讨论的是它与框架无关的那部分:SGLang 与 vLLM 在输出侧的分工完全不同,前者有独立的 Detokenizer 进程,后者把反分词放在前端进程里;两者的 stop string 检测位置、KV 回收时机、前缀缓存插入方式也不一样。把这些差异放在一起看,才能理解“模型决定什么、框架决定什么”。
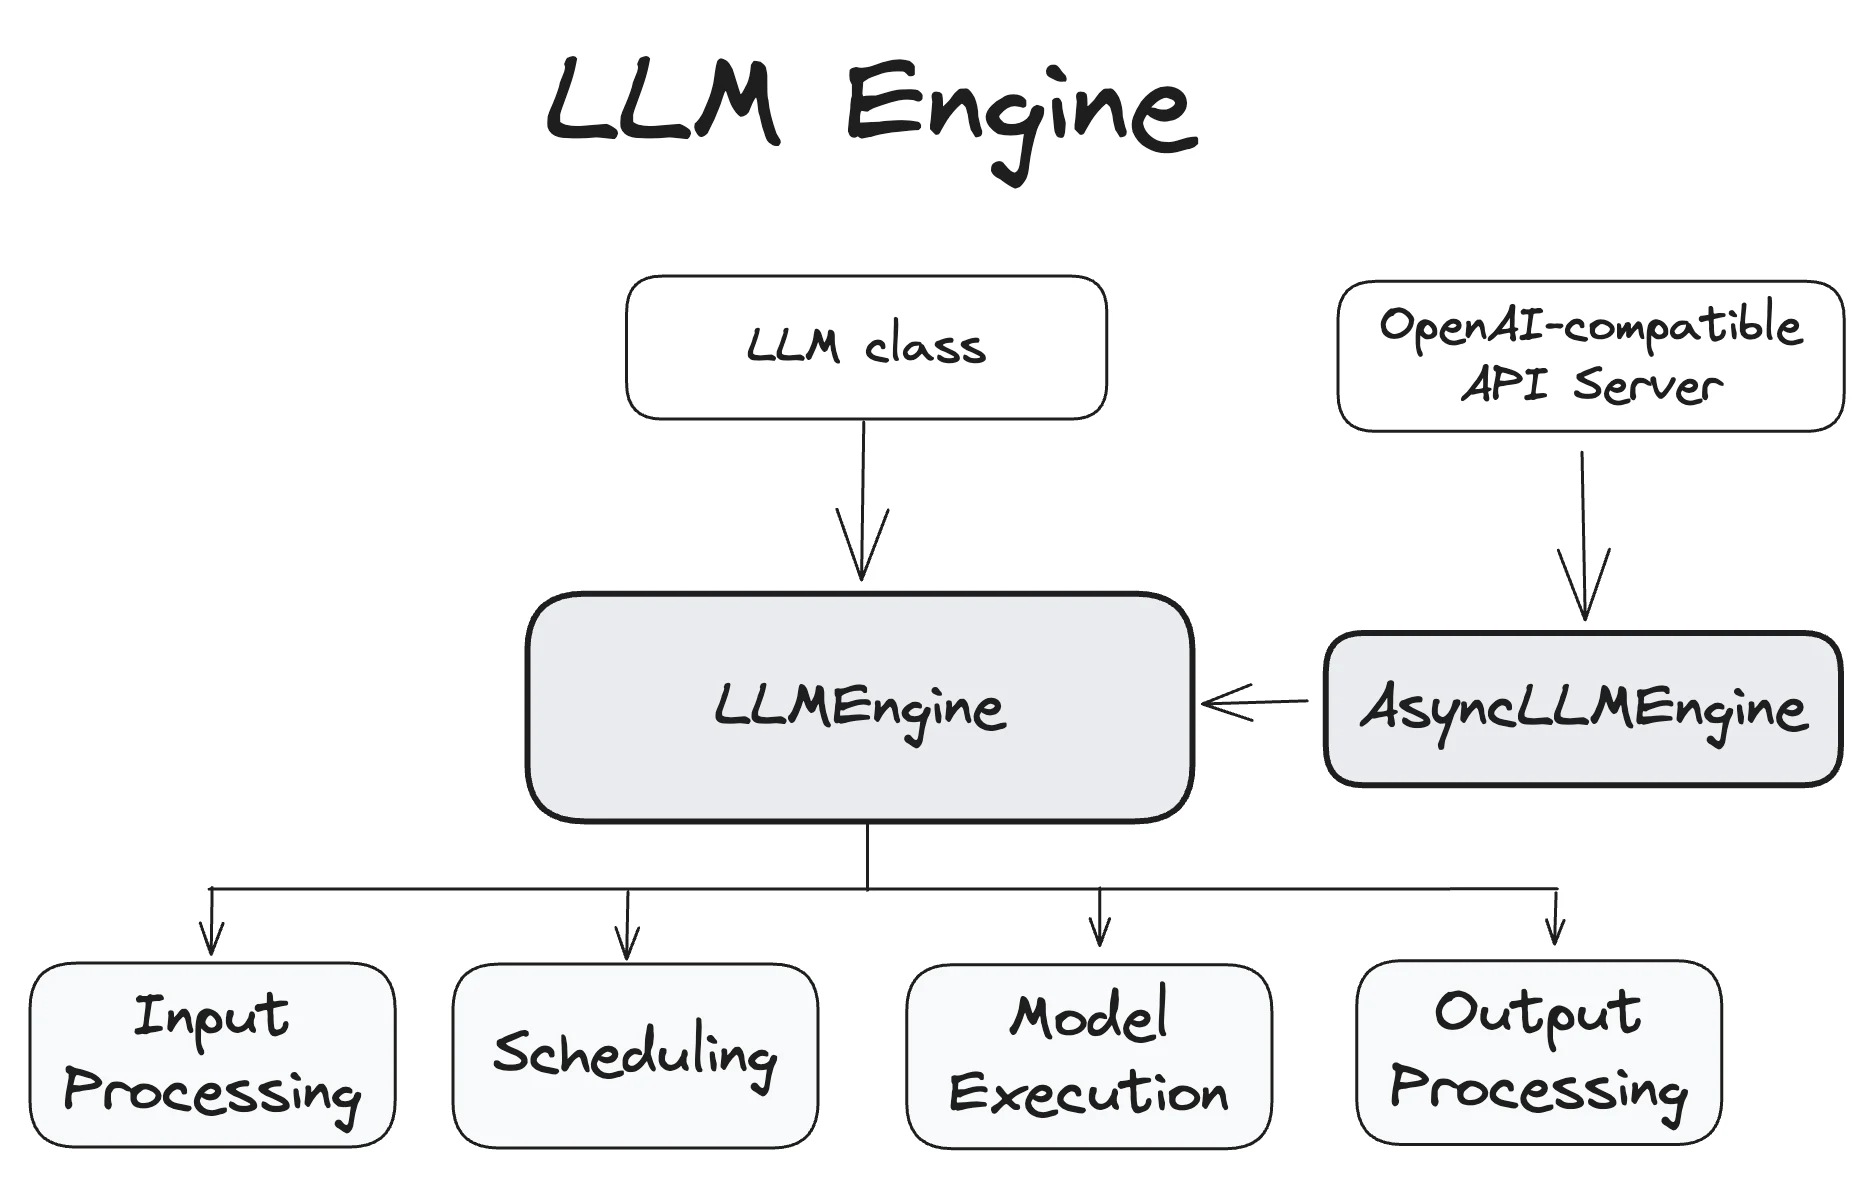
从最后一层 hidden 到 token id:输出边界在哪里
先把这个边界定清楚。GLM-5.3 的 78 层 decoder 跑完,最后一层输出的是形状为 [num_tokens, 6144] 的 hidden state。对 Prefill 来说,num_tokens 是整个 chunk 的行数;对 Decode 来说,通常就是 batch 里的请求数(每个请求一行);开了投机解码之后,则是“请求数 × 验证长度”的行数。hidden state 不会全部进入 LM Head:Prefill 只需要每个请求最后一个位置的 hidden 去采样,中间位置只用于写 KV;Decode 的每一行都要采样;投机验证则要把草稿的每个位置都算出来,再交给接受规则。
这个“选行”动作在框架里通常叫 logits_indices 或 sample_indices。它决定 LM Head 的输入行数,也决定后面词表 AllGather 的通信量。GLM-5.3 的词表是 151936,hidden 是 6144,LM Head 的权重在 FP8 下约 0.93 GB;如果 TP8 按词表维切分,每张卡只持有约 1/8 的词表行,输出 logits 也是按词表维分片的。采样需要完整的词表分布,所以采样前必须把各 rank 的 logits 拼成完整词表。
其中 是进入采样的行数, 是词表大小,4 是 FP32 的字节数, 是张量并行度。取 、,单次 decode step 的 AllGather 流量约为
在 400 GB/s 的 NVLink 上,这大约是 0.25 ms。它不算大,但也不是零:当 decode step 本身只有 3–5 ms 时,词表 AllGather 会占到几个百分点。更重要的是,这 102 MB 是“每步都发生”的固定开销,batch 越大越明显。也正因为如此,一些框架会在采样后只同步 token id,而不是把完整 logits 留在每个 rank 上;但采样之前的完整分布仍然需要一次 gather,除非采样算法本身支持分片归约。
SGLang 的 VocabParallelEmbedding 与 ParallelLMHead 走的是同一套词表并行逻辑:embedding 查表后做 AllReduce,LM Head 输出后做 AllGather。GLM-5.3 在 DP Attention 模式下,注意力和 MoE 按请求分片,但 LM Head 仍然要给出完整词表,所以这一步的通信不会因为 DP 而消失。vLLM 的 ParallelLMHead 在采样路径上同样设置 gather_output=True,由 tensor_model_parallel_all_gather 把 logits 拼起来。两边的差异主要在“谁来做 gather、在哪个进程做”,而不是“是否需要 gather”。
还有一个容易忽略的细节:logits 的 dtype。模型前向可能用 BF16 或 FP8 计算,但采样器通常会把 logits 转成 FP32 再算 softmax。原因是 top-p 的累积和、temperature 缩放后的指数、以及投机解码的残差概率,都对低精度很敏感;BF16 只有 8 位尾数,在 151936 个 logits 上做归一化,误差足以改变尾部 token 的排序。vLLM 的 Sampler.forward 里有一行很直接的 logits = logits.to(torch.float32),SGLang 也会在采样前把 logits 转成 FP32 或至少 BF16 再算。这个转换本身要分配一块 [B, V] 的 FP32 缓冲; 时是 117 MB,和 AllGather 的流量同一量级。输出侧的显存预算里,这块缓冲经常被漏算。
采样:temperature、top-k/top-p 与一次分布式随机
有了完整 logits,下一步是采样。GLM-5.3 的部署通常不会对所有请求用同一组采样参数:有的请求 temperature=0(贪心),有的 temperature=0.7、top_p=0.9,有的还带 presence/frequency penalty。框架不能为每个请求单独启动一个 kernel,而是把 batch 内所有请求的参数打包成张量,做一次“分档”的批量采样。
vLLM 的 Sampler.sample 把这条路径写得很清楚(采样器内部的 SamplingMetadata 打包、logits processor 顺序与 logprobs 计算,站内 vLLM 源码完全拆解(九):Sampler——从 Logits 到 Token 的采样管线与输出回传 已经逐行拆过;这里只保留与输出侧相关的部分):
# vllm/v1/sample/sampler.py(节选)def sample(self, logits, sampling_metadata, logprobs_mode_override=None): assert not (sampling_metadata.all_greedy and sampling_metadata.all_random) if sampling_metadata.all_random: greedy_sampled = None else: greedy_sampled = self.greedy_sample(logits) if sampling_metadata.all_greedy: return greedy_sampled, None
logits = self.apply_temperature( logits, sampling_metadata.temperature, sampling_metadata.all_random ) for processor in sampling_metadata.logitsprocs.argmax_invariant: logits = processor.apply(logits) random_sampled, processed_logprobs = self.topk_topp_sampler( logits, sampling_metadata.generators, sampling_metadata.top_k, sampling_metadata.top_p, ) sampled = torch.where( sampling_metadata.temperature < _SAMPLING_EPS, greedy_sampled, random_sampled, out=greedy_sampled, ) return sampled, processed_logprobs这段代码里有三个设计点值得展开。
第一,贪心与随机采样共用一次前向。greedy_sampled 先对原始 logits 做 argmax,随机路径再对缩放后的 logits 做 top-k/top-p 采样,最后用 torch.where 按每个请求的 temperature 选择结果。这样 batch 里同时存在 temperature=0 和 temperature>0 的请求时,不需要拆成两个 batch。temperature < 1e-5 被视为贪心,避免除零。
第二,argmax-invariant 的 logits processor 在 temperature 之后、top-k/top-p 之前执行。所谓 argmax-invariant,是指这些处理器只改变概率分布的“形状”,不改变最大元素的位置,例如重复惩罚、存在惩罚。把它们放在 temperature 之后,是为了让惩罚强度不受温度缩放影响;把它们放在 top-k/top-p 之前,是为了让过滤基于处理后的分布。这个顺序在不同框架里可能不同,但它会直接影响“带惩罚的 top-p 采样”结果,属于需要对齐的语义细节。
第三,随机数生成器是按请求持有的。sampling_metadata.generators 为每个请求维护一个 torch.Generator,种子来自请求参数。这样同一请求在重放、断点续跑或确定性评测时能得到同一串 token;不同请求之间又不会互相消耗随机数。对投机解码来说,验证阶段的接受/拒绝也要用同一套随机流,否则“无损”只是统计意义上的无损,而不是逐 token 可复现。
SGLang 的采样器走的是 FlashInfer 内核与 PyTorch 回退两条路径:
# sglang/srt/layers/sampler.py(节选)if simple_sampling_case: batch_next_token_ids = sampling_from_probs_torch( probs, sampling_seed=sampling_info.sampling_seed )else: if get_exec().kernel.sampling_backend == "flashinfer": ... if sampling_info.need_min_p_sampling: probs = top_k_renorm_prob(probs, sampling_info.top_ks) probs = top_p_renorm_prob(probs, sampling_info.top_ps) batch_next_token_ids = min_p_sampling_from_probs( probs, sampling_info.min_ps ) else: batch_next_token_ids = top_k_top_p_sampling_from_probs( probs, sampling_info.top_ks, sampling_info.top_ps, )simple_sampling_case 指的是没有 top-k、top-p、min-p 的纯多项式采样,这时直接用 sampling_from_probs_torch,避免 FlashInfer 的额外开销。有过滤条件时,Fused Kernel 把 top-k/top-p 重归一化、min-p 过滤与采样合并成一次内核调用;min-p 的路径先做 top-k/top-p 重归一化,再用 min_p_sampling_from_probs。这个分支结构说明:采样不是一个 kernel 包打天下,而是按请求集合的参数分布选择最快路径。一个 batch 里如果所有请求都是贪心,is_all_greedy 会直接走 argmax;如果所有请求都只有 temperature,没有 top-k/top-p,则走简单多项式采样;只有混合参数才进入完整路径。
从数学上看,top-k/top-p 做的事情是:
其中 是过滤后的候选集合。top-k 取 logits 最大的 个;top-p 取累积概率首次超过 的最小集合;min-p 则保留 的 token。三者的区别在于“阈值作用在排序后的名次、累积质量还是相对最大值”上。GLM-5.3 的部署里,top-p 是最常用的;min-p 在 creative writing 场景更常见;top-k 则多用于需要硬性限制候选数的评测。
采样之后,SGLang 有一个容易被忽略的动作:self._sync_token_ids_across_tp(batch_next_token_ids, sampling_info)。因为每个 TP rank 都持有完整 logits 的一份副本(或者至少持有相同的采样结果),采样本身是冗余执行的;但随机数流必须一致,否则不同 rank 会采出不同的 token。同步 token id 的通信量只有 字节,和词表 AllGather 相比可以忽略,但它是正确性的必要条件。vLLM 的做法类似:采样在每个 TP rank 上执行,随后通过 all_reduce 或 broadcast 对齐 token id;如果各 rank 的随机流不一致,就会出现“同一个请求在不同 rank 上生成不同 token”的灾难。
投机解码的输出行:一次前向里的 k+1 个 token
GLM-5.3 自带 MTP 草稿层,生产部署通常会开启 EAGLE 风格的投机解码。对输出侧来说,投机解码改变了两件事:采样的行数不再是“每请求一行”,而是“每请求 k+1 行”;停止条件也不再只检查最后一个 token,而要检查一次验证里被接受的所有 token。
以 MTP 为例:目标模型一次前向验证 1 个 bonus token 加 k 个草稿 token,共 k+1 行。每行的 logits 都要经过采样器,得到 k+1 个候选 token;然后按草稿树的结构做接受判定。被接受的 token 可能只有前 2 个,也可能 6 个全接受。输出侧必须把“实际接受的 token 数”和“KV 中已经写入的 token 数”分开记账:验证前向已经把 k+1 个位置的 KV 写进了分页缓存,但只有被接受的部分应该保留;被拒绝的后缀必须回滚。
vLLM 的 OutputProcessor 里有一段专门处理这种“多 token 一步”的截断:
# vllm/v1/engine/output_processor.py(节选)def _trim_surplus_tokens(req_state, output, num_prev_tokens): """Drop new tokens generated past a stop string matched by the detokenizer, e.g. when multiple tokens are accepted in one step.""" num_kept = req_state.detokenizer.num_output_tokens() - num_prev_tokens num_dropped = len(output.new_token_ids) - num_kept if num_dropped <= 0: return del output.new_token_ids[num_kept:] if output.new_logprobs is not None: output.new_logprobs = output.new_logprobs.slice_request(0, num_kept) if output.new_sampling_mask is not None: output.new_sampling_mask = output.new_sampling_mask.slice_request(0, num_kept) if output.routed_experts is not None: req_state.routed_experts_chunks[-1] = output.routed_experts[:-num_dropped]这段代码的触发条件是“stop string 在 detokenizer 里被匹配到”,而 engine 可能已经多生成了几个 token。num_prev_tokens 是本步之前已经输出的 token 数,num_kept 是 detokenizer 认为应该保留的数量,两者之差就是要丢弃的后缀。注意它不只是截断 token id,还要同步截断 logprobs、sampling mask 和 routed experts;任何一个没截断,都会让后续的统计或输出出现错位。
SGLang 的对应机制是 output_ids_through_stop 与 finished_len:
# sglang/srt/managers/schedule_batch.py(节选)@propertydef output_ids_through_stop(self) -> array[int]: """Get the output ids through the stop condition. Stop position is included.""" if self.finished_len is not None: return self.output_ids[: self.finished_len] return self.output_idsfinished_len 在检测到 stop string 时被定位到“包含 stop 的最后一个 token”,后续 token 即使已经生成,也不会进入流式输出。调度器在发送 BatchTokenIDOutput 时用 output_ids_through_stop 截断,detokenizer 再按 trim_matched_stop 做文本级裁剪。两层截断的分工是:调度器保证“不会把 stop 之后的 token 发出去”,detokenizer 保证“不会把 stop string 本身发出去”(除非请求要求包含 stop string)。
投机解码还会影响 max_tokens 的计数。一次验证接受 5 个 token,就相当于一步消耗了 5 个生成长度;如果框架按“步数”而不是“token 数”计费或截断,就会超出请求的 max_tokens。vLLM 在 RequestState.make_request_output 里用 num_output_tokens 做累计,SGLang 用 len(req.output_ids);两者都以 token 为单位,而不是以 step 为单位。这一点在压测时经常被忽略:开了投机解码之后,同样的 max_tokens 会更快到达,TTFT 之后的 TPOT 统计也会因为“一步多 token”而出现阶梯。
结构化输出:bitmask 怎样在采样前改写 logits
GLM-5.3 的 API 服务通常支持 JSON Schema、正则或 EBNF 语法约束。结构化输出的实现不在模型里,而在采样器之前:语法编译器把约束编译成有限状态机,状态机为当前状态生成一个词表大小的 bitmask,允许的 token 位为 1,禁止的为 0;采样前把 logits 中禁止的位置置为 ,再走正常的 top-k/top-p 采样。
SGLang 的 xgrammar 后端把这条路径拆成三个动作:
# sglang/srt/constrained/xgrammar_backend.py(节选)def accept_token(self, token: int): if not self.is_terminated(): self.current_token = token accepted = self.matcher.accept_token(token) if not accepted: raise ValueError(...) else: self.accepted_tokens.append(token)
def rollback(self, k: int): self.matcher.rollback(k) self.accepted_tokens = self.accepted_tokens[:-k]
def apply_vocab_mask(self, logits: torch.Tensor, vocab_mask: torch.Tensor) -> None: if ...: apply_token_bitmask_inplace_cuda(logits, vocab_mask) elif ...: apply_token_bitmask_inplace_triton(logits, vocab_mask)fill_next_token_bitmask 负责根据当前 FSM 状态填充 bitmask,apply_vocab_mask 负责把 bitmask 应用到 logits。CUDA 与 Triton 两个实现的分支说明:bitmask 的位布局必须和词表分片对齐;在 TP 下,每个 rank 只持有词表的一部分,所以 bitmask 也要按词表分片切分,或者每个 rank 都持有一份完整 bitmask 但只应用自己那一段。前者的通信量更小,后者实现更简单。SGLang 选择的是按 rank 切分 bitmask,并在语法状态推进时只让第一个 rank 做编译、其余 rank 同步状态。
投机解码与结构化输出叠加时,最麻烦的是回滚。假设草稿树一次验证了 6 个 token,语法状态机也跟着接受了 6 个 token;但目标模型只接受了前 3 个,那么第 4–6 个 token 对应的语法状态必须回滚。SGLang 的 rollback(k) 与 vLLM 的 matcher.rollback(num_accepted) 就是为此存在的。vLLM 的 xgrammar 后端在 accept_tokens 里先尝试接受,失败时回滚已经接受的部分;validate_tokens 则用于在验证阶段判断哪些 token 合法。没有这层回滚,语法状态会和实际输出错位,后续生成的 JSON 会在某个位置突然变成非法。
结构化输出的开销主要在 CPU:bitmask 的填充是逐 token 的 FSM 推进,词表大小 151936,每个 token 要处理约 19 KB 的 bitmask(1 bit/token)。一个 100 token 的 JSON 输出,大约要填充 100 次 bitmask;如果 batch 里有 64 个结构化请求,CPU 侧的语法推进很容易成为瓶颈。生产实现通常会把语法编译放到独立线程池、把 bitmask 填充与模型前向重叠,或者用 xgrammar 的批量接口一次处理多行。这些优化不在本文的范围内,但它们是输出侧延迟的重要组成部分。
token 变成文本:增量解码为什么不能每步全量 decode
采样得到的是 token id,客户端要的是文本。最朴素的做法是每步把“已生成的全部 token id”交给 tokenizer 做一次 decode,然后取新增部分。这个做法在短输出上没问题,但在长输出上是 :第 步 decode 个 token,总成本是 。一个 8K 输出的请求,tokenizer 要被调用 8K 次,累计处理 3200 万个 token;即使每次只要 0.1 ms,也要 5 分钟,远超模型前向的时间。
所以生产框架都做增量解码:只 decode 新增的 token,并保留一个“上下文前缀”来处理 tokenizer 的边界效应。vLLM 的 IncrementalDetokenizer 有两个实现:FastIncrementalDetokenizer 用 HuggingFace tokenizers 的 DecodeStream,把 token 逐个喂进去,内部维护字节级的解码状态;SlowIncrementalDetokenizer 用 detokenize_incrementally,保留 prefix_offset 与 read_offset,每次 decode 一小段并比较前缀与读取结果,取出新增文本。
# vllm/v1/engine/detokenizer.py(节选)class BaseIncrementalDetokenizer(IncrementalDetokenizer, ABC): def __init__(self, request: EngineCoreRequest): ... if self.stop and not self.include_stop_str_in_output: self.stop_buffer_length = max(len(s) for s in self.stop) - 1 else: self.stop_buffer_length = 0
def get_next_output_text(self, finished: bool, delta: bool) -> str: buffer_length = 0 if finished else self.stop_buffer_length if not delta: if not buffer_length: return self.output_text return self.output_text[:-buffer_length] length = len(self.output_text) - buffer_length last_offset = self._last_output_text_offset if last_offset < length: self._last_output_text_offset = length return self.output_text[last_offset:length] return ""stop_buffer_length 是“要扣住的字符数”,等于最长 stop string 长度减一。原因很直接:如果一个 stop string 是 "</answer>",当前文本以 "</ans" 结尾,那么最后 1 个字符可能是 stop string 的开头;如果立刻把 "</ans" 发出去,客户端会先看到一段本应被 stop 截掉的文本。扣住 max_len - 1 个字符,等下一段文本到来再判断,就能保证 stop string 不会跨越流式 chunk 泄漏。finished=True 时不再扣住,因为请求已经结束,剩余文本就是最终输出。
delta=True 时只用 _last_output_text_offset 之后的新文本;delta=False 时返回累计文本。这个布尔值对应 API 的 stream 语义:OpenAI 兼容接口默认是增量 delta,某些内部接口要累计文本。两种模式共用同一份 output_text,避免重复解码。
SGLang 的增量解码更复杂,因为它要处理“tokenizer 在 token 边界上产生半个 UTF-8 字符”的问题。它的 DecodeStatus 维护四个偏移:
# sglang/srt/managers/detokenizer_manager.py(节选)class DecodeStatus: decoded_text: str decode_ids: List[int] surr_offset: int read_offset: int sent_offset: int = 0
def append_decoded_text(self, text: str): ... self.decoded_text_chunks.append(text) self.decoded_text_len += len(text)surr_offset 是“代理上下文”的起点,read_offset 是“已确认可读”的终点,sent_offset 是“已经发给客户端”的终点。每个 step 做两次 decode:
surr_texts = decode(decode_ids[surr_offset:read_offset]),只 decode 上一轮确认过的前缀;read_texts = decode(decode_ids[surr_offset:]),decode 到当前全部 token;new_text = read_texts[i][len(surr_texts[i]):],取新增文本。
这个“代理上下文 + 全量读取”的技巧,是为了让 tokenizer 在解码新增 token 时仍然能看到前面的上下文,避免 byte-level BPE 在 token 边界上把空格、标点或 UTF-8 字节拼错。代价是每步要 decode 两段,但两段都不长:surr_offset 到 read_offset 通常只有几个 token,surr_offset 到末尾也只是“上一轮确认的前缀 + 本轮新增”,不会随输出长度线性增长。真正随长度增长的是 s.decode_ids 这个列表,以及 decoded_text 字符串;前者是 token id 的累积,后者是已发送文本的累积。它们占的是 CPU 内存,不是 GPU 显存。
当新增文本以替换字符 � 结尾时,说明当前 token 序列只包含某个 UTF-8 字符的一部分。SGLang 不会立刻提交这段文本,而是:
# sglang/srt/managers/detokenizer_manager.py(节选)if new_text and not new_text.endswith("�"): s.append_decoded_text(new_text) s.surr_offset = s.read_offset s.read_offset = len(s.decode_ids) s.sent_offset = s.decoded_text_len output_strs.append(new_text[pending:] if pending else new_text)else: # Incomplete UTF-8: emit the printable prefix only; do not commit. printable = find_printable_text(new_text) s.sent_offset = s.decoded_text_len + len(printable) output_strs.append(printable[pending:] if pending else printable)find_printable_text 找到 � 之前可以安全输出的部分,只把这段发给客户端;read_offset 不前进,下一轮带着更多 token 重新 decode,直到字符完整。这个细节对中文尤其重要:一个汉字在 UTF-8 下是 3 个字节,byte-level BPE 完全可能把它切成两个 token;如果不做半字符处理,客户端会在每个汉字边界上随机看到 �,而且后续的字符串偏移会错位。
停流:stop token、stop string 与 max_tokens 的三套账
停止条件有三类:stop token id、stop string、以及长度上限。三者的检测位置不同,语义也不同。
stop token 是 token id 级别的。模型词表里有 EOS、<|im_end|>、<|endoftext|> 等特殊 token,请求也可以额外指定 stop_token_ids。这类条件在采样之后立刻就能判断:只要本步接受的 token 里有一个命中,就可以把请求标记为完成。SGLang 的 _check_token_based_finish 遍历本步接受的 token,检查 stop_token_ids、eos_token_ids、tokenizer 的 EOS 以及额外 stop token;vLLM 的 Sampler/EngineCore 也在采样后做同样的集合判断。这个判断不需要文本,成本极低。
stop string 是文本级别的。它必须等 token 解码成文本之后才能判断,而且可能跨越 token 边界。检测位置有两种选择:
- 在调度器/引擎侧检测:SGLang 在
Req上维护tail_str,每个 decode step 用tokenizer.decode解码尾部一段窗口,检查 stop string 是否出现,或者尾部是否是某个 stop string 的前缀。一旦命中,设置finished_len,后续 token 不再进入输出。 - 在前端/detokenizer 侧检测:vLLM 在
OutputProcessor里调用detokenizer.update,由check_stop_strings在累计文本里查找 stop string;如果命中,前端把finish_reason改成 STOP,并截断多余 token。
SGLang 的调度器侧检测有一个明确的目的:在流式输出之前就决定是否要停。它的 tail_str 不是整个输出,而是“最长 stop string 长度 + 本步新接受 token 数 - 1”的尾部窗口:
# sglang/srt/managers/schedule_batch.py(节选)def _stop_match_tail_len(self, new_accepted_len: int = 1) -> int: max_len_tail_str = max(len(s) for s in self.sampling_params.stop_strs) return min( max_len_tail_str + max(new_accepted_len - 1, 0), len(self.output_ids) )
def tail_str(self, new_accepted_len: int = 1) -> str: ... tail_len = self._stop_match_tail_len(new_accepted_len) return self.tokenizer.decode(self.output_ids[-tail_len:])max_len_tail_str + new_accepted_len - 1 的来源是:stop string 最长 个字符,本步新接受了 个 token,那么 stop string 的起点最多在“尾部 个 token”之内。只解码这个窗口,既能覆盖跨 token 的 stop string,又不会随输出长度增长。new_accepted_len 是投机解码的关键:如果本步接受了 5 个 token,窗口要扩到 ,否则第 1 个新 token 里开始的 stop string 可能被漏掉。
检测到 stop string 之后,SGLang 还要判断“尾部是不是 stop string 的前缀”。这一步是为了流式输出:如果当前尾部是 "</ans",而 stop string 是 "</answer>",那么这段文本可能是 stop 的开头,不能立刻发出去;check_match_stop_str_prefix 会在这种情况下让 output_streamer 暂缓发送。等下一个 token 到来,如果补全成 "</answer>",就按 stop 处理;如果变成 "</ansx",就说明只是普通文本,继续发送。这个“前缀扣留”与 vLLM 的 stop_buffer_length 是同一类机制,只是实现位置不同。
max_tokens 是长度账。它在请求进入时就确定了上限,每步按实际接受的 token 数递减。SGLang 在 init_req_max_new_tokens 里还会把 max_new_tokens 与 KV 池的剩余容量做 min,避免请求因为显存不足而无法完成;vLLM 在调度器的 max_model_len 与 max_tokens 之间取小。这个账看起来简单,但在投机解码、chunked prefill、P/D 分离三种情况下都容易出错:投机解码一步多 token,chunked prefill 的 token 预算和生成长度是两本账,P/D 分离的 decode 实例只看到剩余长度。任何一个环节把“已生成”与“已调度”混在一起,都会导致请求提前结束或超出上限。
abort 是第四类停止:客户端断开、请求被取消、调度器抢占。它不是模型产生的停止条件,而是外部事件。SGLang 的 TokenizerManager._stream_one_response 在等待输出时用 request.is_disconnected() 检测断连,一旦发现就调用 abort_request 并抛出异常,终止整个调用栈;vLLM 的 AsyncLLM 在生成器被取消时触发 abort,由 OutputProcessor.abort_requests 清理请求状态。abort 的难点不在检测,而在回收:请求可能正在 GPU 上执行、可能已经写入了 KV、可能已经有一部分输出在队列里。回收路径必须能处理“执行中”“已调度未执行”“已完成未发送”三种状态,否则就会漏掉 KV 或重复释放。
流式回传:两段进程边界与三种输出模式
停流条件确定之后,文本要经过一条进程边界才能到达客户端。SGLang 与 vLLM 在这条边界上的拓扑不同,延迟和故障模式也不同。
SGLang 的路径是四段:
- Scheduler 进程完成一次前向,产出
BatchTokenIDOutput; - 该消息经 ZMQ 发给独立的 Detokenizer 进程;
- Detokenizer 增量解码后,把
BatchStrOutput发回 TokenizerManager; - TokenizerManager 把文本写进 SSE/JSON 响应。
BatchTokenIDOutput 不是简单的 token id 列表,它同时携带 decode_ids、read_offsets、finished_reasons、no_stop_trim、skip_special_tokens、spaces_between_special_tokens 等字段。read_offsets 是增量解码的关键:detokenizer 用它知道“这次新增的 token 从哪个位置开始算”,而不需要自己维护与调度器一致的 token 计数。finished_reasons 携带 stop token/stop string 的匹配信息,detokenizer 用 trim_matched_stop 做最后一次文本裁剪。no_stop_trim 对应请求参数 no_stop_trim:为真时保留 stop string 本身,为假时把它从输出里去掉。
Detokenizer 进程是单线程事件循环,内部按 batch 处理。_grouped_batch_decode 会把同一批里 (skip_special_tokens, spaces_between_special_tokens) 相同的行分组,再调用 tokenizer 的批量 decode;这是为了避免逐行调用 HuggingFace tokenizer 的 Python 开销。分组之后,每个请求的 DecodeStatus 仍然独立,增量文本按请求拼接。这个设计让 detokenizer 的吞吐随 batch 增大而提高,但也带来一个限制:如果 batch 里每个请求的 tokenizer 参数都不同,分组退化,逐行 decode 的成本会回到 次 Python 调用。
TokenizerManager 收到文本后,_stream_one_response 负责把它变成客户端可见的 chunk:
# sglang/srt/managers/tokenizer_manager.py(节选)async def _stream_one_response(self, obj, state, request=None): is_stream = getattr(obj, "stream", False) while True: try: if request is None: await state.event.wait() else: await asyncio.wait_for( state.event.wait(), timeout=_REQUEST_STATE_WAIT_TIMEOUT ) except asyncio.TimeoutError: if (request is not None and not obj.background and await request.is_disconnected()): self.abort_request(obj.rid) raise ValueError(...) continue
out_list = state.out_list state.out_list = [] finished = state.finished state.event.clear() ... if finished: yield out break if is_stream: yield outstate.event 把“调度器/反分词器有新输出”变成 asyncio 事件;out_list 一次取空,避免多个 chunk 在队列里堆积。finished 为真时只 yield 最后一个 chunk 并退出循环;否则每个 chunk 都直接 yield。断连检测放在 asyncio.wait_for 的超时分支里,而不是每次循环都轮询,是为了避免对每个请求每步都调用 is_disconnected();代价是断连最多延迟一个超时周期才被发现。
SGLang 还区分“增量流式”和“累计流式”。增量流式每个 chunk 只带新增文本,累计流式每个 chunk 带从开头到当前的全部文本。_coalesce_streaming_chunks 会在一次事件循环里合并多个增量 chunk,避免客户端收到过多小包。累计流式的文本构造是 ,所以 _handle_batch_output 在中间 chunk 上把 "text" 设为 None,等 _stream_one_response 真正要发送时再调用 state.get_text() 拼一次;这是一个用惰性构造换 CPU 的优化。
vLLM 的路径跨两段进程边界,分三步处理:
- EngineCore 进程完成前向,产出
EngineCoreOutput; - 前端进程的
OutputProcessor做反分词、停止判断、logprobs 处理,然后把RequestOutput放进每个请求的队列; AsyncLLM的generate()从队列取RequestOutput,转成 OpenAI 兼容的 SSE chunk。
OutputProcessor.process_outputs 的注释写得很明确:它是“唯一一个应该遍历整个 batch 的函数”,其他路径都尽量避免 Python 循环。这个设计是因为前端进程要处理所有请求的输出,循环开销会直接变成尾延迟。它的处理顺序是:先更新统计,再反分词并检查 stop string,再计算 logprobs,最后构造 RequestOutput 并放入队列。请求完成时调用 _finish_request 从 request_states 里删除状态;如果 stop string 是在前端检测到的,而 engine 还在继续生成,就把请求 id 放进 reqs_to_abort,由上层向 EngineCore 发 abort。
RequestOutputKind 决定输出模式:DELTA 只带新增 token,CUMULATIVE 带累计 token,FINAL_ONLY 只在完成时给一次。OpenAI 兼容接口通常用 DELTA;logprobs 或某些评测接口用 CUMULATIVE;批处理接口用 FINAL_ONLY。这个枚举看起来只是 API 细节,但它影响反分词器的 get_next_output_text(delta=...) 调用方式,也影响 RequestOutput 的构造成本。DELTA 模式下每步只拷贝新增文本,CUMULATIVE 模式下每步要拷贝全部文本,长输出时差距是数量级的。
每个请求还有一个 RequestOutputCollector,OutputProcessor 把 RequestOutput 交给它,AsyncLLM.generate() 用 get() 或 get_nowait() 取出。它并不是一个无界队列,而是“单个槽位 + 合并”:
# vllm/v1/engine/output_processor.py(节选)class RequestOutputCollector: def __init__(self, output_kind, request_id): self.aggregate = output_kind == RequestOutputKind.DELTA self.output = None self.ready = asyncio.Event()
def put(self, output) -> None: """Non-blocking put operation.""" if self.output is None or isinstance(output, Exception): self.output = output self.ready.set() elif isinstance(self.output, RequestOutput) and isinstance(output, RequestOutput): self.output.add(output, aggregate=self.aggregate)put 从不阻塞。如果消费者还没取走上一份输出,新输出会被 add 合并进槽位,而不是排队等消费者;aggregate=True 时(DELTA 模式)合并语义是拼接新增 token,aggregate=False 时是保留最新一份。这个设计的目标很明确:生产者(EngineCore 的输出循环)永远不被慢消费者拖住,代价是客户端读得慢时会“丢中间 chunk,只收到合并后的 chunk”。对 SSE 来说这是可接受的,因为客户端关心的是完整 token 序列和最终文本,而不是每个 step 的边界。SGLang 的 state.out_list 也是“攒一批再给”的结构,只是它放在 TokenizerManager 的 asyncio 事件循环里;两者的共同点都是“生产不等待消费”。
SSE 层还要处理 finish_reason 与 usage 的对齐。OpenAI 兼容协议的最后一个 chunk 通常带 finish_reason(stop、length、abort 等)和 usage(prompt tokens、completion tokens)。completion_tokens 必须按“实际作为输出提交给客户端的 token”计算,而不是按“模型前向里产生过的 token”计算:被 stop string 截掉的、被投机验证拒绝的、被 max_tokens 截断的,都不能算进去。反过来,finish_reason=length 时,completion_tokens 应该正好等于 max_tokens(除非请求提前 stop);如果少了,说明截断逻辑漏掉了某个 token 账。这个对齐是计费和评测的基础,但在投机解码 + stop string + 结构化输出三者叠加时,最容易出错。
两种拓扑的取舍很清楚:SGLang 把反分词放到独立进程,调度器进程不被 tokenizer 的 Python 开销拖慢,但多了一次 ZMQ 往返和一次进程间文本拷贝;vLLM 把反分词放在前端,少一次 IPC,但前端进程要同时承担 HTTP、tokenizer、grammar、detokenizer 的 CPU 工作,在高并发下更容易成为瓶颈。哪个更好取决于部署形态:SGLang 的分离式设计更适合“一个 scheduler 对多个 HTTP worker”的场景,vLLM 的集成式设计更适合单机、低延迟、请求体量不大的场景。
请求结束后的 KV 回收:前缀缓存是“延迟释放”,不是“不释放”
输出侧最容易被低估的工作,是请求结束后的 KV 回收。一个 1M 上下文的 GLM-5.3 请求,KV 缓存约 47 GB(FP8),索引器缓存另加约 2.8 GB;如果请求结束后只把 token 行标记为“完成”,却没有把物理页还给池子,几十个请求就能把 8 卡实例的显存吃光。更隐蔽的是前缀缓存:为了让后续请求复用前缀,框架会把已完成请求的 KV 插入前缀树/块池,这部分 KV 仍然占着物理页,只是从“请求私有”变成了“缓存共享”。回收路径必须同时处理“还给请求池”和“交给前缀缓存”两件事。
SGLang 的入口在 batch_result_processor:当 req.finished() 为真,先做多模态特征释放、Mamba 状态处理、HiSparse 协调,然后调用 release_kv_cache。核心函数在 mem_cache/common.py:
# sglang/srt/mem_cache/common.py(节选)def release_kv_cache(req: Req, tree_cache: BasePrefixCache, *, checkpoint: bool): ... owned_kv_len = req.owned_kv_len() checkpoint = checkpoint and not req.skip_radix_cache_insert if checkpoint: req.refresh_fill_ids() tree_cache.checkpoint(req, up_to=owned_kv_len) # The protected prefix is not this req's to free. tree_cache.free_kv_row(req.kv, [(req.kv.cache_protected_len, owned_kv_len)]) tree_cache.unlock(req.lock) req.lock = None _release_overallocated_kv_indices( req, owned_kv_len, req.kv.kv_allocated_len, tree_cache ) tree_cache.on_release(req, checkpointed=checkpoint) ... req.kv.mark_kv_released()这段代码把回收拆成四步。
第一步,checkpoint 把请求的 KV 插入 RadixTree。插入的 key 是 token id 序列(按页对齐),value 是 KV 页索引。插入后,树对这段前缀持有引用;请求不再独占它。req.kv.cache_protected_len 记录“已经被树接管的前缀长度”,这样下一步释放时不会把树的前缀也 free 掉。
第二步,free_kv_row 只释放 [cache_protected_len, owned_kv_len) 这一段。也就是说,树接管的前缀留给树,请求自己新生成的后缀(以及没有被树接管的部分)还给分配器。这个边界是 SGLang 前缀缓存正确性的核心:如果释放了树持有的页,后续命中该前缀的请求会读到已被复用的显存,输出直接变成乱码;如果少释放了请求私有的页,就会泄漏。
第三步,unlock 释放请求在树上持有的锁引用。RadixTree 的节点有 lock_ref,请求在运行期间锁住自己路径上的节点,防止被驱逐;请求结束后必须逐级解锁,节点才能进入 evictable 集合。on_release 是给不同缓存实现(RadixCache、MambaCache、HiCache)的钩子,负责把节点状态从“请求持有”切到“可驱逐”。
第四步,_release_overallocated_kv_indices 处理“分配了但没用到”的页。投机解码、stop string 提前结束、chunked prefill 的尾部页都可能造成 overallocated;这些页不在 owned_kv_len 内,必须单独还给分配器。代码里对页大小做了对齐,因为分页分配器的 free 以页为单位,边界不对齐会误释放仍在使用的页。
这四步之后,kv_storage_of(...).release_row(req) 把请求在 req_to_token_pool 里的槽位还给池子,最后 mark_kv_released() 把状态置为已释放。槽位是“请求 → token 位置 → KV 页”的映射表的一行;如果只还了 KV 页却没有还槽位,下一次新请求拿不到行号,调度器会报 “no free slot”,表现是吞吐突然掉到零,但显存看起来还有空闲。这个错误比 KV 泄漏更隐蔽,因为它的症状不在显存曲线上,而在调度器的准入失败日志里。
checkpoint 为假时(例如 abort、采样掩码失败),请求的 KV 不进入前缀树,直接释放。这是一个有意的取舍:被 abort 的请求可能只完成了半段生成,它的前缀仍然可能有效,但把“半成品”插入缓存会增加污染和一致性风险;SGLang 选择不缓存,vLLM 在 abort 路径上也通常不走 cache_blocks。代价是 abort 请求的前缀无法被后续请求复用,收益是回收路径更简单、更不容易泄漏。
RadixTree 的驱逐逻辑在 radix_cache.py 的 evict 里:从 evictable_leaves 建堆,按驱逐策略的优先级弹出叶子,调用 free_segment 释放页,删除叶子;如果父节点因此变成无子节点且 lock_ref == 0,把父节点也加入堆。这个“从叶子向上”的顺序很重要:前缀树的中间节点被多个请求共享,不能直接删;只有叶子没有消费者,才能安全释放。lock_ref 是防止“正在被请求使用的节点被驱逐”的引用计数,和 vLLM 的块引用计数是同一个思想。
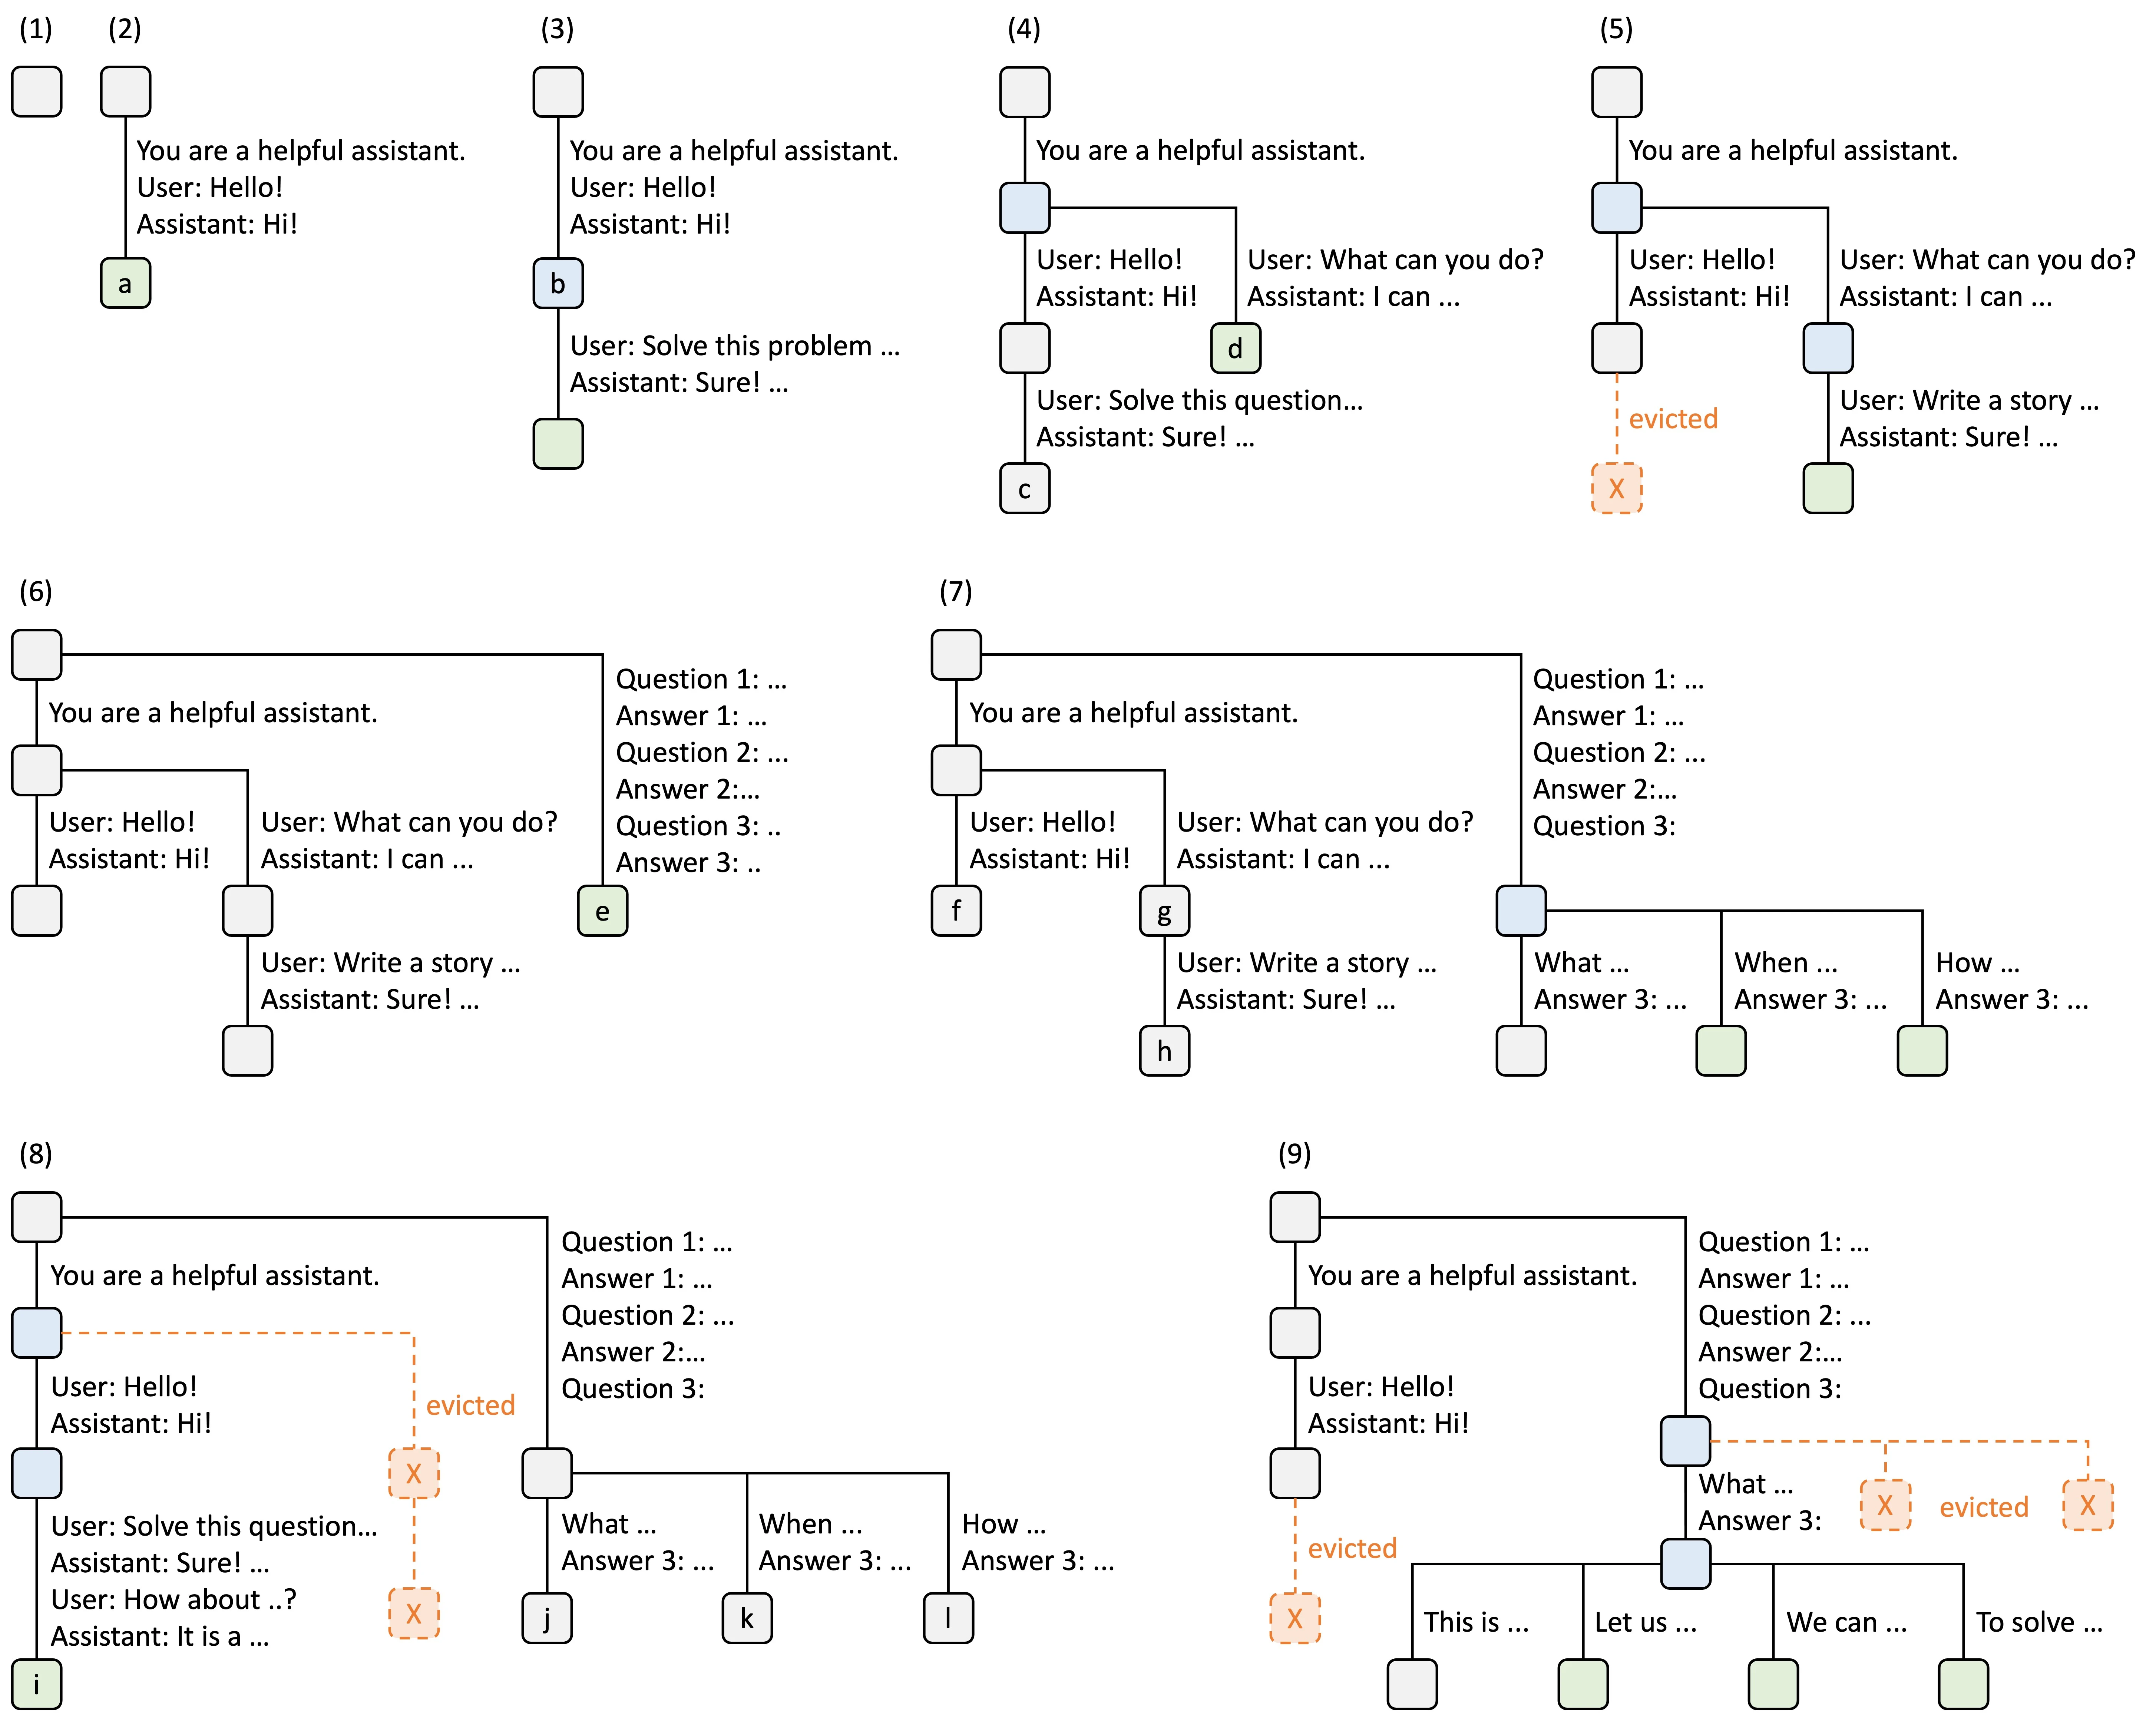
vLLM 的回收路径是块池 + 引用计数。KVCacheManager 对外的接口很薄:
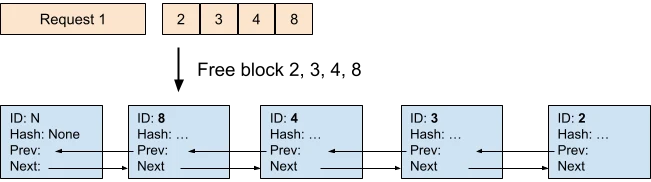
# vllm/v1/core/kv_cache_manager.py(节选)def free(self, request: Request) -> None: """Free the blocks allocated for the request. We free the blocks in reverse order so that the tail blocks are evicted first when caching is enabled.""" self.coordinator.free(request.request_id)
def cache_blocks(self, request: Request, num_computed_tokens: int) -> None: """Cache the blocks for the request, if enabled.""" if self.enable_caching: self.coordinator.cache_blocks(request, num_computed_tokens)free 的注释点出了顺序:倒序释放,尾部块先被驱逐。touch、evict、free 三者为什么不能交换、BlockPool 的 free queue 怎样维护双重身份,站内 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block 有过逐函数推演,这里只取与“请求结束后回收”直接相关的顺序结论。倒序的原因:前缀缓存按“从头部到尾部”的前缀命中,尾部块最不可能被后续请求完整命中;先释放尾部,可以让前缀部分保留更久,提高缓存命中率。块池里每个 KVCacheBlock 有 ref_cnt:请求持有块时 ref_cnt 增加,前缀缓存命中时也增加;free 减少引用,只有 ref_cnt 归零的块才回到空闲队列。前缀缓存不是“额外拷贝一份 KV”,而是“同一组物理块同时被缓存索引和请求块表指向”;缓存命中时 ref_cnt 增加,驱逐只处理 ref_cnt == 0 的块。因此缓存命中不需要复制 KV,只需要把块表指向同一组物理块。
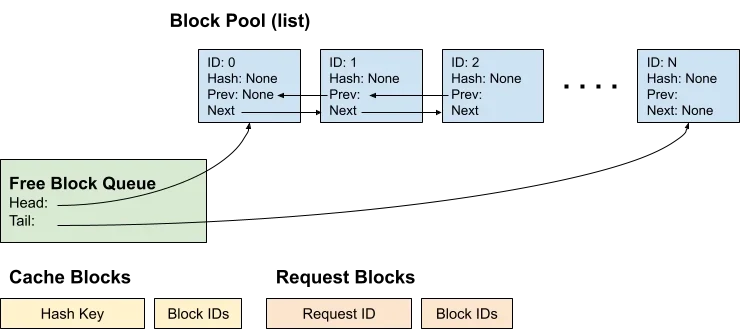
cache_blocks 在请求完成时被调用,参数 num_computed_tokens 是“已经算过的 token 数”,包括命中前缀和本请求新算的部分。管理器只把“满块”注册进前缀缓存:不足一个块的尾部 token 不进入缓存,因为块哈希要求块内 token 完整且位置确定。这个设计意味着前缀缓存的粒度是块大小,请求的最后一个不完整块不会被后续请求命中;这也是为什么“前缀长度刚好是块大小的整数倍”时命中率最高。块大小本身不是调优旋钮,而是模型与内核共同决定的常量:vLLM 的 CacheConfig.block_size 没有静态默认值,CUDA 平台兜底为 16,但 MLA 模型会被强制改写为 64,因为 FlashMLA 系内核的 tile 就是 64;站内 KV Cache 的页粒度:128 token 一块的账 已经把这本账算过一遍,这里不再展开。
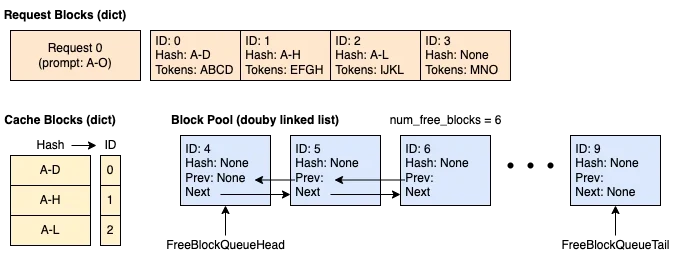
vLLM 还有两个与回收相邻的接口,分别处理“部分释放”和“跳过的块”。pop_blocks_for_free 的注释说明:它把请求的记账信息弹出并返回块列表,但不把块还给块池,调用方必须按倒序释放;这个接口用于需要先做一次设备到主机拷贝、或者需要先通知 KV connector 的场景。remove_skipped_blocks 则用于混合注意力或滑窗模型:当某段 KV 已经滑出窗口、不再需要时,把块表中的对应位置替换成 null_block,并把物理块还给池子。GLM-5.3 的 DSA 索引器缓存和主 MLA 缓存是两组不同的 KV group,它们的块大小、生命周期和回收时机都不同;remove_skipped_blocks 的 num_prompt_tokens 参数就是为“滑窗之外的 prompt 块”准备的。如果实现把所有 KV group 当成同一种块来释放,就会在混合模型上出现“主缓存已释放、索引器缓存还在读”的悬空引用。
前缀缓存的驱逐与请求回收共用同一个块池。当空闲块不足时,调度器触发 evict_blocks,按 LRU 或配置的策略把 ref_cnt == 0 的缓存块移出哈希表,放回空闲队列。这里有一个容易忽略的边界:一个块可能同时被多个请求的块表引用(前缀共享);缓存哈希只是索引,不构成独立的所有权。驱逐只能处理 ref_cnt == 0 的缓存块,不能动请求持有的块;引用计数把“请求所有权”和“缓存可驱逐性”分开,避免“缓存驱逐把正在运行的请求的 KV 释放掉”。
P/D 分离把回收路径拉长了(Prefill 与 Decode 两侧的 KV 所有权、传输完成通知与逐层交接,站内 GLM-5.3 推理全链路(四):PD 分离——57GB KV 与索引器缓存如何跨节点交接 已经算过完整账本;这里只补“输出结束后谁来释放”这一段)。Prefill 实例完成前向后,把 KV 交给 Decode 实例;Prefill 侧的 KV 什么时候释放,取决于传输是否完成、是否有前缀缓存、以及是否要保留给重传。Decode 侧收到 KV 后,把它挂到自己的块表;请求结束时,Decode 侧负责释放,Prefill 侧不能重复释放。SGLang 在 PD 解码侧还要经过 decode_offload_manager 的异步卸载路径:disaggregation_decode_enable_offload_kvcache 为真时,先把 KV 卸到主机内存,传输完成后再释放设备页。这条路径如果漏掉一次回调,表现就是“显存缓慢下降但请求数不变”,很难在日志里直接看到。
输出侧的通信与开销账本
把输出侧的所有动作按时间排开,可以得到一张与第一篇“输入侧账本”对称的表:
| 阶段 | 主要动作 | 通信/开销 | 量级(GLM-5.3,TP8,B=192) |
|---|---|---|---|
| LM Head | 词表分片输出 logits | AllGather 完整词表 | 约 102 MB/步,0.2–0.3 ms |
| 采样 | temperature/top-k/top-p | 张量内计算,token id 同步 | token 同步 字节 |
| 投机验证 | k+1 行采样与接受 | 无额外集合通信 | 行数 ×(k+1),采样与 logits 成本同比 |
| 结构化输出 | bitmask 填充与应用 | CPU FSM 推进 + GPU mask | 每 token 约 19 KB bitmask |
| 反分词 | token → 文本 | 进程内 Python/tokenizer | 每请求每步几十 µs |
| 流式回传 | SSE chunk | 进程间 IPC + 网络 | 文本字节数,通常 KB 级/步 |
| KV 回收 | 前缀树插入/块池释放 | CPU 哈希/引用计数 | 每块一次,10^2–10^4 次/请求 |
这张表里最容易被误判的是“反分词很便宜”。单请求单步确实便宜:一段 20 个字符的增量文本,tokenizer 的 decode 只要几十微秒。但高并发下,detokenizer 是单线程或少量线程,所有请求的文本都要经过它;一个 64 请求的 batch、每步 20 字符,就是 64 次 decode 调用、1280 个字符的字符串操作。如果每步 3 ms,detokenizer 的 CPU 占用会迅速接近一个核。SGLang 用批量 decode 分组来摊薄 Python 调用;vLLM 用前端进程的 OutputProcessor 一次循环处理整个 batch,避免逐请求调度。两者的共同点是:反分词必须是批量化的,逐请求起线程或逐请求加锁的实现,在吞吐场景下一定先崩。
词表 AllGather 的量级则取决于 batch 和 TP。 时约 102 MB/步; 时只有 8.5 MB/步,几乎可以忽略。这解释了为什么小 batch 的低延迟场景很少把“词表 gather”当成瓶颈,而大 batch 的吞吐场景需要认真考虑它。一个可选的优化是“采样后再 gather”:每个 rank 只对自己的词表分片做局部 top-k,然后把候选集合与局部最大值汇总,做一次全局 top-k,再在候选集合上采样。这样通信量从 降到 ,但实现复杂,且要处理 top-p 的全局累积概率;主流框架目前仍以完整 logits gather 为主。
KV 回收的 CPU 开销也常被低估。SGLang 的 RadixTree 插入要比较 token 序列、切分节点、维护锁引用;vLLM 的块哈希要对每个满块做一次哈希并查表。一个 100K token 的请求,按 64 token/块算,有 1563 个块;每块一次哈希/比较,单请求就是上千次 CPU 操作。高并发下,这些操作会和调度器的主循环竞争 CPU。SGLang 把反分词放到独立进程,部分原因就是把这类文本/缓存 CPU 工作从调度器关键路径上挪走;vLLM 则把前缀缓存注册放在 cache_blocks 里,尽量只对满块做一次,避免每步重复哈希。
工程上的几个坑
stop string 跨 chunk 与多 stop string 的优先级。 一个请求可以带多个 stop string,长度不同。vLLM 的 check_stop_strings 会在“本步新增文本 + 可能的跨边界后缀”里查找,并选择“最早完成”的那个;SGLang 的 tail_str 窗口按最长 stop string 扩展。如果实现只检查“本步新增文本”,跨 token 的 stop string 会漏掉;如果只按 stop 列表顺序检查,较短的 stop string 可能先匹配,导致截断位置比用户预期的更早。两边的处理方式不同,但语义都要求“取文本中最早完成的 stop”。
min_tokens 与 stop 的冲突。 有些 API 允许设置 min_tokens,要求至少生成这么多 token 才能停。EOS 或 stop string 在 min_tokens 之前出现时,不能立即停,要继续生成到下限;这期间的 stop string 要“忽略”,但不能把它从输出里删掉。SGLang 在 check_finished 里用 min_tokens 做门控,vLLM 在 SamplingParams 的 min_tokens 逻辑里处理。这个细节在评测“强制长输出”时经常暴露:如果实现一看到 EOS 就停,min_tokens 形同虚设。
UTF-8 半字符与 SSE 偏移。 前面已经讲过 SGLang 的 � 处理。vLLM 的 FastIncrementalDetokenizer 用 DecodeStream,它内部维护字节状态,通常不会输出半字符;SlowIncrementalDetokenizer 的 detokenize_incrementally 也通过“多 decode 一个 token、比较前缀”来避免半字符。如果自定义 tokenizer 或非 HuggingFace tokenizer 没有这套机制,就会在中文、emoji、组合字符上出现替换字符。排查方法是:用一段纯中文 prompt 流式输出,检查每个 chunk 的 UTF-8 边界;如果 chunk 以 0xE4/0xE5 等字节开头且长度不足 3,就是半字符泄漏。
投机解码下的 finish_reason 与 usage。 一次验证接受 5 个 token,其中第 3 个是 EOS;那么 finish_reason 应该是 stop,completion_tokens 应该只算到第 3 个(包含 EOS 与否取决于 API 语义),KV 要回滚到第 3 个位置。如果框架把 5 个都算进 usage,账单会偏大;如果把 KV 留在第 5 个位置,下一次请求复用前缀时会读到多余的 token。vLLM 的 _trim_surplus_tokens 和 SGLang 的 output_ids_through_stop 都在处理这个问题,但两者只截断“输出”,KV 的回滚在各自的投机 worker 里单独做。排查时要同时看 finish_reason、completion_tokens 和 KV 页数,三者对不上就是账错了。
abort 后的双释放与泄漏。 一个请求可能在“已经 release KV”之后又收到 abort;如果 abort 路径再次调用 release_kv_cache,就会 double free。SGLang 在 release_kv_cache 开头用 assert (not req.kv.holds_kv) == req.kv.is_kv_released 做状态校验,mark_kv_released() 把状态置为已释放;vLLM 的块池用引用计数,重复 free 可能让 ref_cnt 变成负数或者重复入队。线上表现是“偶发显存 corruption”或“空闲块数突然变多”,日志里不一定有 ERROR。防御方式是给请求状态加显式生命周期,并在 abort 路径检查“是否已经释放”。
detokenizer 状态的内存上限。 SGLang 的 decode_status 是一个 LimitedCapacityDict,容量由 DETOKENIZER_MAX_STATES 控制。请求数超过容量时,旧请求的状态会被驱逐;如果该请求后续还有输出,detokenizer 会抛 RuntimeError: Decode status not found。这不是内存泄漏,而是“状态缓存太小”。排查时看错误信息里的环境变量提示,调大 SGLANG_DETOKENIZER_MAX_STATES;如果请求很短但并发很高,也可以考虑让 detokenizer 不做增量、直接全量 decode(代价是 CPU)。
前缀缓存的污染与租户隔离。 前缀缓存按 token 序列命中,不同租户的相同前缀会共享 KV。如果业务要求隔离,需要用 cache_salt 或 extra_key 把租户标识混进缓存键;否则 A 租户的 prompt 可能命中 B 租户的缓存。SGLang 的 RadixKey 带 cache_salt,vLLM 的块哈希也支持 cache_salt。这个参数不是性能开关,而是安全边界;默认关闭时,前缀缓存只在“同一信任域”内安全。
CUDA Graph 与输出缓冲的复用。 开了 CUDA Graph 之后,logits 输出缓冲是图的一部分,地址固定。如果采样是异步的、而下一步前向又覆盖了同一块缓冲,就会出现“采样读到下一步 logits”的竞态。框架通常用双缓冲、事件同步或“采样完成后再启动下一步”来避免;SGLang 的 overlap scheduler 用 future token 和延迟提交来处理,vLLM 的 piecewise CUDA Graph 用静态输入输出缓冲加拷贝。排查方法是:关掉 CUDA Graph 后错误消失,基本就是缓冲复用问题。
小结:输出侧是四条账本的交汇点
把这一篇压缩成几句话:
- 输出边界从“选行”开始。Prefill 只采样最后一行,Decode 每行都采样,投机解码采样 k+1 行;LM Head 的词表 AllGather 是每步固定的通信开销,、TP8 时约 102 MB/步。
- 采样是分档批处理。贪心与随机共用一次前向,temperature/top-k/top-p/min-p 按请求参数打包;采样后 token id 要在 TP 组内同步,随机流必须逐请求可复现。
- 停止条件有三套账:stop token 在采样后立刻判断,stop string 要跨 token 窗口检测并扣留前缀,max_tokens 按实际接受 token 数递减。投机解码让“一步多 token”,三套账都容易错。
- 增量解码不是可选优化。全量 decode 是 ;生产实现用代理上下文、
DecodeStream或prefix_offset/read_offset,并单独处理 UTF-8 半字符。 - 流式回传的拓扑决定尾延迟。SGLang 的 Scheduler → Detokenizer → TokenizerManager 三段进程,换来了调度器不被文本处理拖慢;vLLM 的前端
OutputProcessor少一次 IPC,但前端要承担所有 CPU 工作。 - KV 回收是“延迟释放”。前缀缓存让已完成请求的 KV 继续被树/块池引用;释放时必须区分“树持有的前缀”和“请求私有的后缀”,并用引用计数防止驱逐正在使用的块。
- 输出侧的瓶颈通常在 CPU 与进程边界,不在矩阵乘。反分词、stop string 匹配、语法 bitmask、前缀哈希都是逐 token/逐块的 Python 或 CPU 操作,高并发下先于 GPU 饱和。
对 GLM-5.3 这种 1M 上下文、744B 参数的模型,输出侧还有一个规模效应:请求越长,KV 回收和前缀缓存的账越重;请求越短,采样和反分词的固定开销占比越高。部署调参时,--mem-fraction-static、--chunked-prefill-size、--stream-interval、detokenizer 状态容量、前缀缓存开关,分别对应这篇里的四条账本。把它们当成“收尾参数”随手设,线上就会以 �、重复文本、显存缓慢下降、finish_reason 不一致的形式反馈回来。
参考资料
- vLLM 源码:vllm/v1/engine/detokenizer.py(IncrementalDetokenizer、stop buffer 与 delta 文本)
- vLLM 源码:vllm/v1/engine/output_processor.py(process_outputs、stop string 检测与 surplus token 截断)
- vLLM 源码:vllm/v1/sample/sampler.py(temperature、贪心/随机分档与 top-k/top-p)
- vLLM 源码:vllm/v1/core/kv_cache_manager.py(块分配、cache_blocks 与 free)
- vLLM 设计文档:Prefix Caching(块哈希、引用计数与驱逐)
- SGLang 源码:python/sglang/srt/managers/detokenizer_manager.py(DecodeStatus、代理上下文与半字符处理)
- SGLang 源码:python/sglang/srt/managers/scheduler.py(输出发送、完成状态与 KV 释放入口)
- SGLang 源码:python/sglang/srt/managers/schedule_batch.py(tail_str、stop string 前缀与 finished_len)
- SGLang 源码:python/sglang/srt/mem_cache/common.py(release_kv_cache、checkpoint 与超额页释放)
- SGLang 源码:python/sglang/srt/mem_cache/radix_cache.py(前缀树插入、锁引用与驱逐)
- SGLang 源码:python/sglang/srt/constrained/xgrammar_backend.py(bitmask 填充、accept 与 rollback)
- SGLang 官方博客:Fast and Expressive LLM Inference with RadixAttention(前缀共享与树结构)
- vLLM 源码:vllm/v1/structured_output/backend_xgrammar.py(验证、接受与回滚)
- xgrammar 官方仓库(语法编译与 token bitmask)
- zai-org/GLM-5.3 模型卡(744B-A40B、FP8、1M 上下文)
- DeepSeek-V3.2 技术报告(DSA 与 MLA 结构,arXiv:2512.02556)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



