


GLM-5.3 推理全链路(九):混批——一条 8K 预填请求并进 32 条解码请求之后
前八篇的账本都默认了”纯批”
前八篇把 GLM-5.3 的一条请求拆成了入口、调度、解码层、prefill、PD 分离、MoE 通信、输出侧和一张总账(入口与解码层见 GLM-5.3 推理全链路(一),prefill 的分块见 (三))。每一篇的内部账本都成立,但它们共享一个不写在纸面上的前提:这一 step 里要么全是 prefill token,要么全是 decode token。纯 decode 时,每层读一遍 656 字节的 MLA KV,算一个头 192 维的稀疏注意力;纯 prefill 时,token 聚成一个大矩阵,走分块与上下文并行。两种形状各自的最优 kernel、最优并行方式、最优字节预算,都是从”批内同质”这个前提推出来的。
线上服务几乎没有这种同质批。一条 8K 的新请求到达时,32 条已经生成到一半的请求还在等下一个 token;调度器既不能为了新请求把 32 条全部挂起,也不能让新请求排到几十个 step 之后,否则 TTFT 会变成秒级。于是同一个 step 里,8K 个 prefill token 和 32 条 decode 行被塞进同一次前向。这个动作在 SGLang 里叫 mixed chunk,在 vLLM 里甚至没有专门的名字——V1 的调度器从一开始就只产出”每个请求这一步算几个 token”,同质只是它的一个特例。
混批不是一个调度开关那么简单。它把前八篇里所有”按批同质”算出来的数都改写了:注意力的形状变成两段,MoE 的 token 数变成两段之和,DP gather 的字节数按总行数走,CUDA Graph 的整图重放因为形状不匹配而退化成 piecewise 或 eager。这一篇打开这个被前八篇有意跳过的运行态,先把两个框架的实现讲清楚,再把混批一步的算子、KV 与通信重新记一遍。
混批有三种来源,不等价
“一个 step 里有两种 token”可以来自三个完全不同的机制,混在一起谈会得出错误结论。
第一种是分块预填与 decode 同批。一条长 prefill 被切成若干块,调度器在每块之间插入正在解码的请求。这时 prefill 段的 token 数由 chunked-prefill-size 决定,decode 段是每条请求一个(开了投机解码则是 k+1 个验证行)。两段共享一次前向,也共享这一层的权重读取。
第二种是投机解码的验证行。目标模型一次验证草稿模型给出的 k 个 token,再补一个 bonus 位置,于是每条 decode 请求在这一步贡献 k+1 行。它们全是”新 token”,但只有最后一行会被采样接受;前 k 行的 KV 是否保留,取决于验证结果。这仍然算同质批——因为所有请求都是 k+1 行——但它和”一条请求一行”的纯 decode 在形状上已经不同,前八篇里 192 行的算例就是这么来的。
第三种是PD 分离后 decode 实例的首步。prefill 实例把 KV 传过来,decode 实例的第一步要先把这批请求的上下文长度补齐到传输后的长度,再开始逐 token 解码。这一步在 SGLang 里可能被表示成一次 PREBUILT 或 EXTEND 前向,而不是普通 decode。
这一篇只讨论第一种:真正把”变长的 prefill 块”和”定长的 decode 行”放进同一个 batch。它是三种里唯一会让形状随请求长度连续变化的,也是唯一需要框架写专门合并逻辑的。
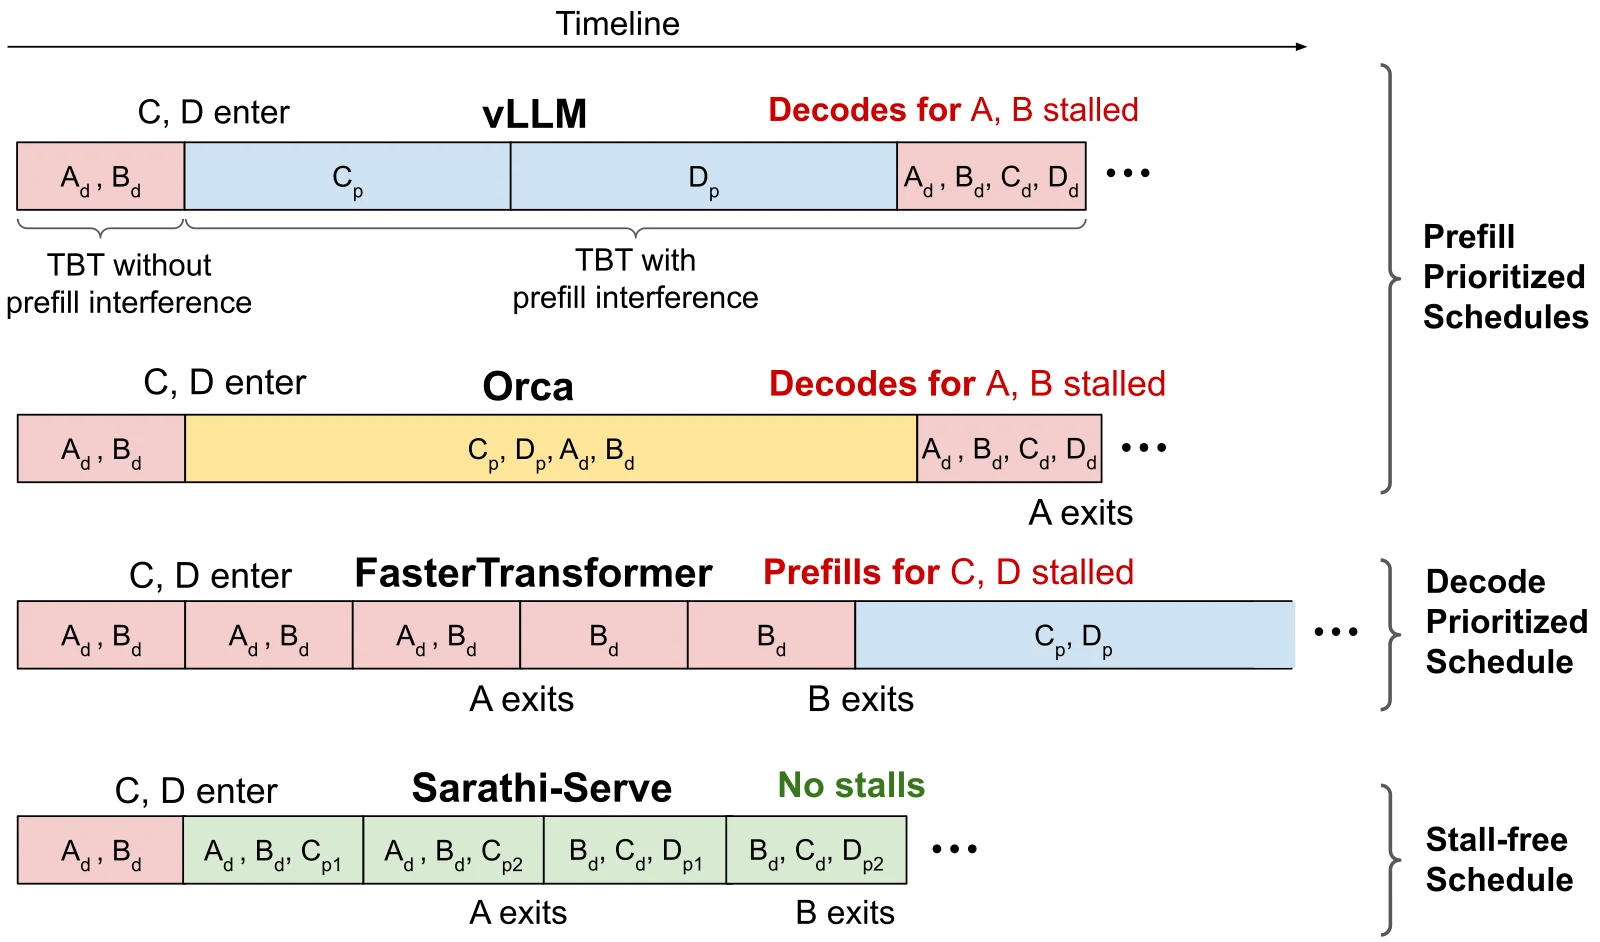
图源:Sarathi-Serve 论文图 7。图中 A、B 已处于 decode,C、D 后到达;最下方的调度把 C、D 的 prefill 切片后与 A、B 的 decode 同轮执行,使每轮工作量接近固定。混批要解决的就是这一行所示的状态:两类请求共享一次前向,但形状不同。
vLLM:调度器只记 token 数,不记批的类型
vLLM V1 的调度器没有 prefill 与 decode 两个队列。每个请求有一个 num_computed_tokens,调度器每轮为它分配 num_new_tokens,把所有请求的分配结果写进 SchedulerOutput.num_scheduled_tokens。一个请求这一步分到 8192 个 token,就是 prefill 块;分到 1 个,就是 decode;分到 k+1 个,就是投机验证。批的类型是这些数字的结果,不是输入。
预算的分配顺序决定了混批的形状。调度器先给 running 队列里的 decode 请求留出 token 预算,再用剩下的 input_budget 接纳 waiting 队列里的 prefill。相关代码在 vllm/v1/core/sched/scheduler.py:
num_new_tokens = min(num_new_tokens, token_budget, input_budget - draft_slots)这一行把三件事同时压进一个整数:这一步还剩多少 token 预算(token_budget)、新请求还能吃多少输入预算(input_budget)、以及要给投机草稿留出的槽位(draft_slots)。decode 请求的 num_new_tokens 通常是 1 或 k+1,几乎不占预算;一条 8K 的 prefill 如果原样放进来,会一次吃掉整个 input_budget,把其他请求挤到下一步。
所以 vLLM 还有第二道闸:long_prefill_token_threshold。当一条请求本步被分配的 token 数超过这个阈值时,调度器把它截断:
if 0 < long_prefill_threshold < num_new_tokens: num_new_tokens = long_prefill_threshold阈值默认是 0,即不启用;设为一个正值(例如 512 或 1024)后才生效。开启 adaptive_long_prefill_threshold 时,它还会把 input_budget // 可用请求数 作为下限,避免阈值小到让长请求每步只走几十个 token。它的作用不是限制 prefill 的总量,而是限制单条请求单步的占比:让一条长请求每步只贡献一个块,剩余预算留给其他 prefill 与 decode。这样做的代价是长请求要多走几个 step,收益是这一 step 的形状可控,decode 不会被一条 8K 请求拖成秒级停顿。
到了 worker 侧,这些 token 数被还原成三条索引:query_start_loc 给出每个请求在本步扁平 token 流里的起止位置,seq_lens 给出每个请求当前的上下文长度,logits_indices 给出哪些行需要采样。三者都不关心某一行来自 prefill 还是 decode。
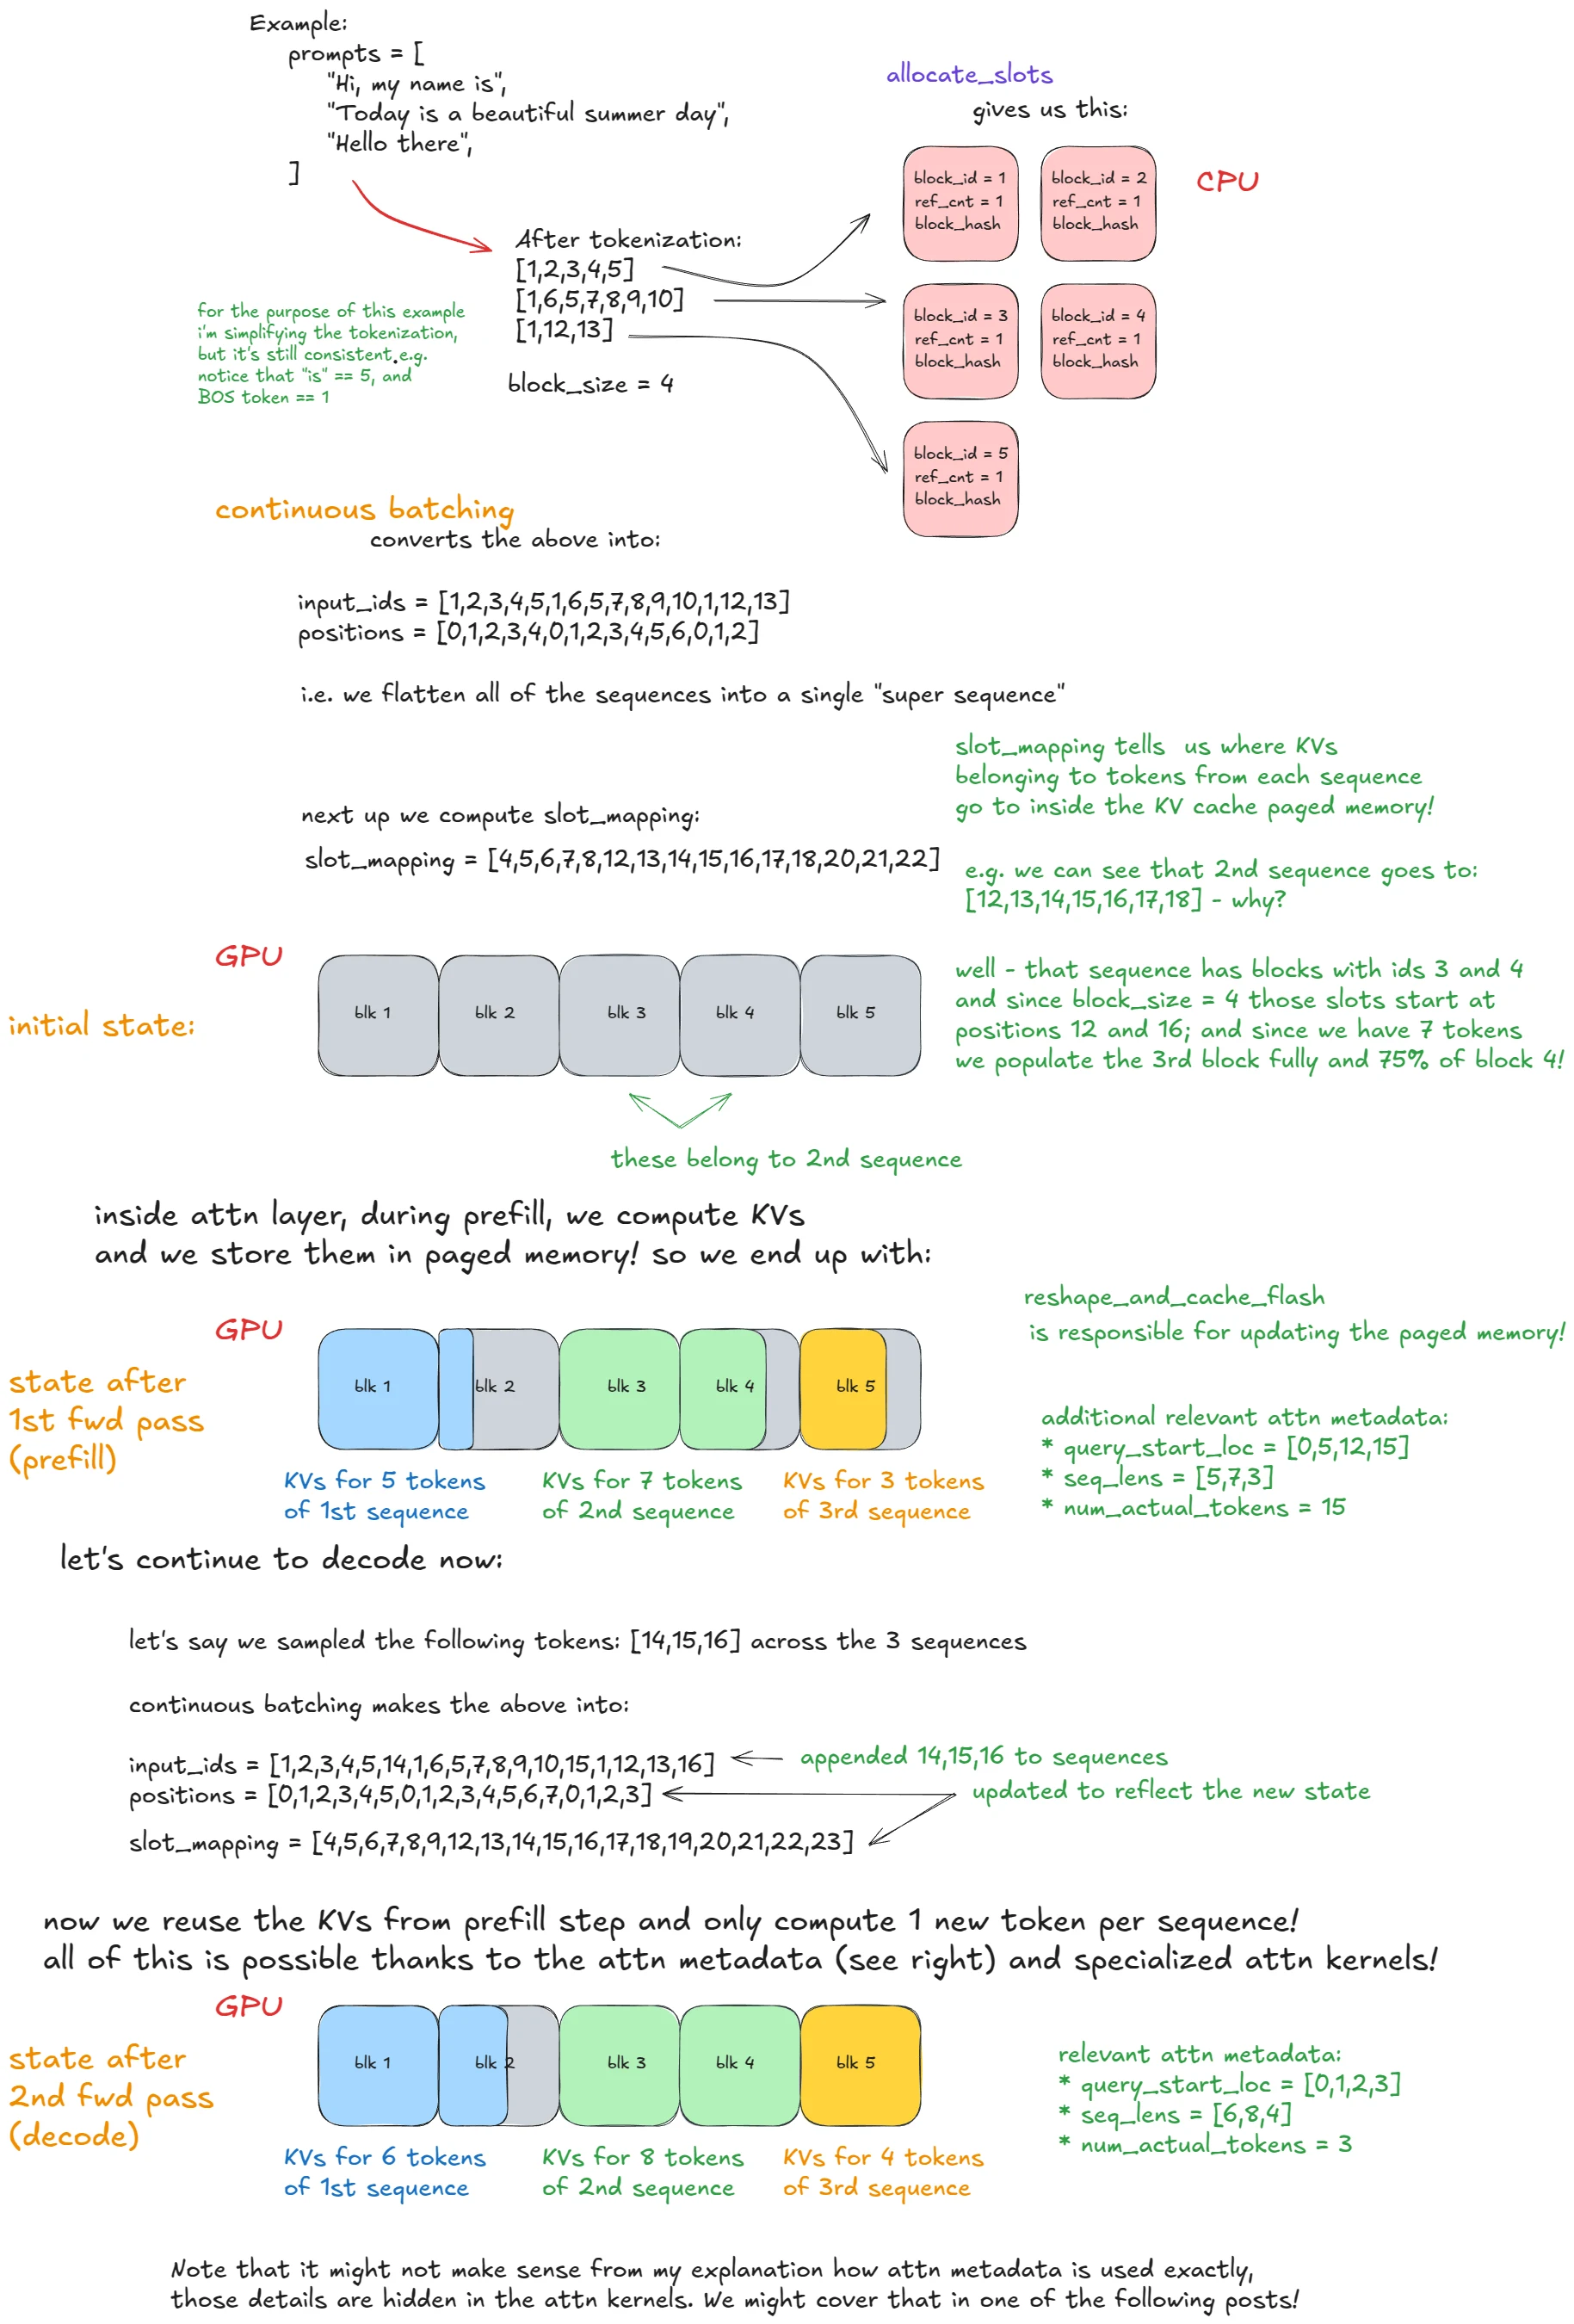
图源:Inside vLLM: Anatomy of a High-Throughput LLM Inference System。图中三个不同长度的 prompt 被压成一条扁平 token 流,input_ids、positions 与 slot_mapping 按行对齐;第二轮 decode 只追加每个请求的新位置。混批只是让这条流里同时出现”多行”和”一行”的请求。
投机解码让这条流多出一个必须显式区分的字段。runner 在构造采样元数据时,对 chunked prefill 的请求填 -1:
num_decode_draft_tokens = np.full(num_reqs, -1, dtype=np.int32)for req_id, draft_token_ids in scheduler_output.scheduled_spec_decode_tokens.items(): ... if num_scheduled_tokens[req_idx] == draft_len + 1: num_decode_draft_tokens[req_idx] = draft_len源码注释写得很直白:chunked prefill 用 -1 而不是 0 作为掩码,因为结构化输出(guided decoding)可能回滚投机 token。0 表示”这是一条 decode 请求,但本步没有草稿”;-1 表示”这不是 decode 请求,别按投机行处理”。混批里这两种情况会同时出现,一个整数掩码承担了区分职责。
混批与 CUDA Graph:形状不匹配,整图重放退出
纯 decode 能整图捕获,是因为形状只随 batch size 变化,用一组桶就能覆盖。混批把形状变成”prefill 块 token 数 + decode 行数”的二维组合,块 token 数又随请求长度连续变化,桶无法穷举。
vLLM 的判定写在一个静态方法里:
def _is_uniform_decode(self, max_num_scheduled_tokens, uniform_decode_query_len, num_tokens, num_reqs, force_uniform_decode=None): """Checks if it's a decode batch with same amount scheduled tokens across all requests.""" return ( (max_num_scheduled_tokens == uniform_decode_query_len) and (num_tokens == max_num_scheduled_tokens * num_reqs) ) if force_uniform_decode is None else force_uniform_decodeuniform_decode_query_len 是 1 + num_spec_tokens:没有投机解码时是 1,开了 5 个草稿时是 6。判定要求批内每个请求这一步都恰好分配这么多 token,且总 token 数正好等于”每请求 token 数 × 请求数”。混批里一条 8K prefill 加 32 条 6 行验证,两个条件都不满足,uniform_decode 为 False。
后续的图模式分派拿到这个布尔值后,FULL 模式的整图重放就不再是候选。vLLM 在 FULL 模式下还要对 attention 段做 padding:pad_attn = cudagraph_mode == CUDAGraphMode.FULL,只有整图模式才把 token 数与请求数补齐到捕获形状。混批大概率走的是 piecewise 或 eager,pad_attn 为假,padding 逻辑直接跳过,真实形状原样执行。
代价是 launch 次数。前一 step 的纯 decode 可能整图重放 78 层,只有一次 launch;混批这一步要逐 kernel 发射,SGLang 在 prefill 上测过:整图重放相对 eager 快 1.93 倍,分段捕获快 1.70 倍。混批更接近后者:它介于纯 prefill 与纯 decode 之间,能吃到一部分分段捕获的收益,但拿不到整图的收益。
vLLM 还有一个额外的形状约束叫 micro-batching(ubatching,把一步切成两半重叠执行)。它不能随便切,因为前缀缓存命中可能让一条请求的 attention 读取另一条请求本步正在写入的块:
readers = np.flatnonzero( (query_lens > (self.reorder_batch_threshold or 1)) & (computed > 0))注释解释得很清楚:整步执行时,所有 KV 写入发生在任何 attention 读取之前,命中成立;切成两半后,前半的 reader 会读到后半 writer 还没填完的块。混批里这类”本步写入 + 本步读取”的组合本来就多,所以 _allow_microbatching 在有 reader 时直接否决。也就是说,混批不仅失去整图,也常常失去 micro-batching。
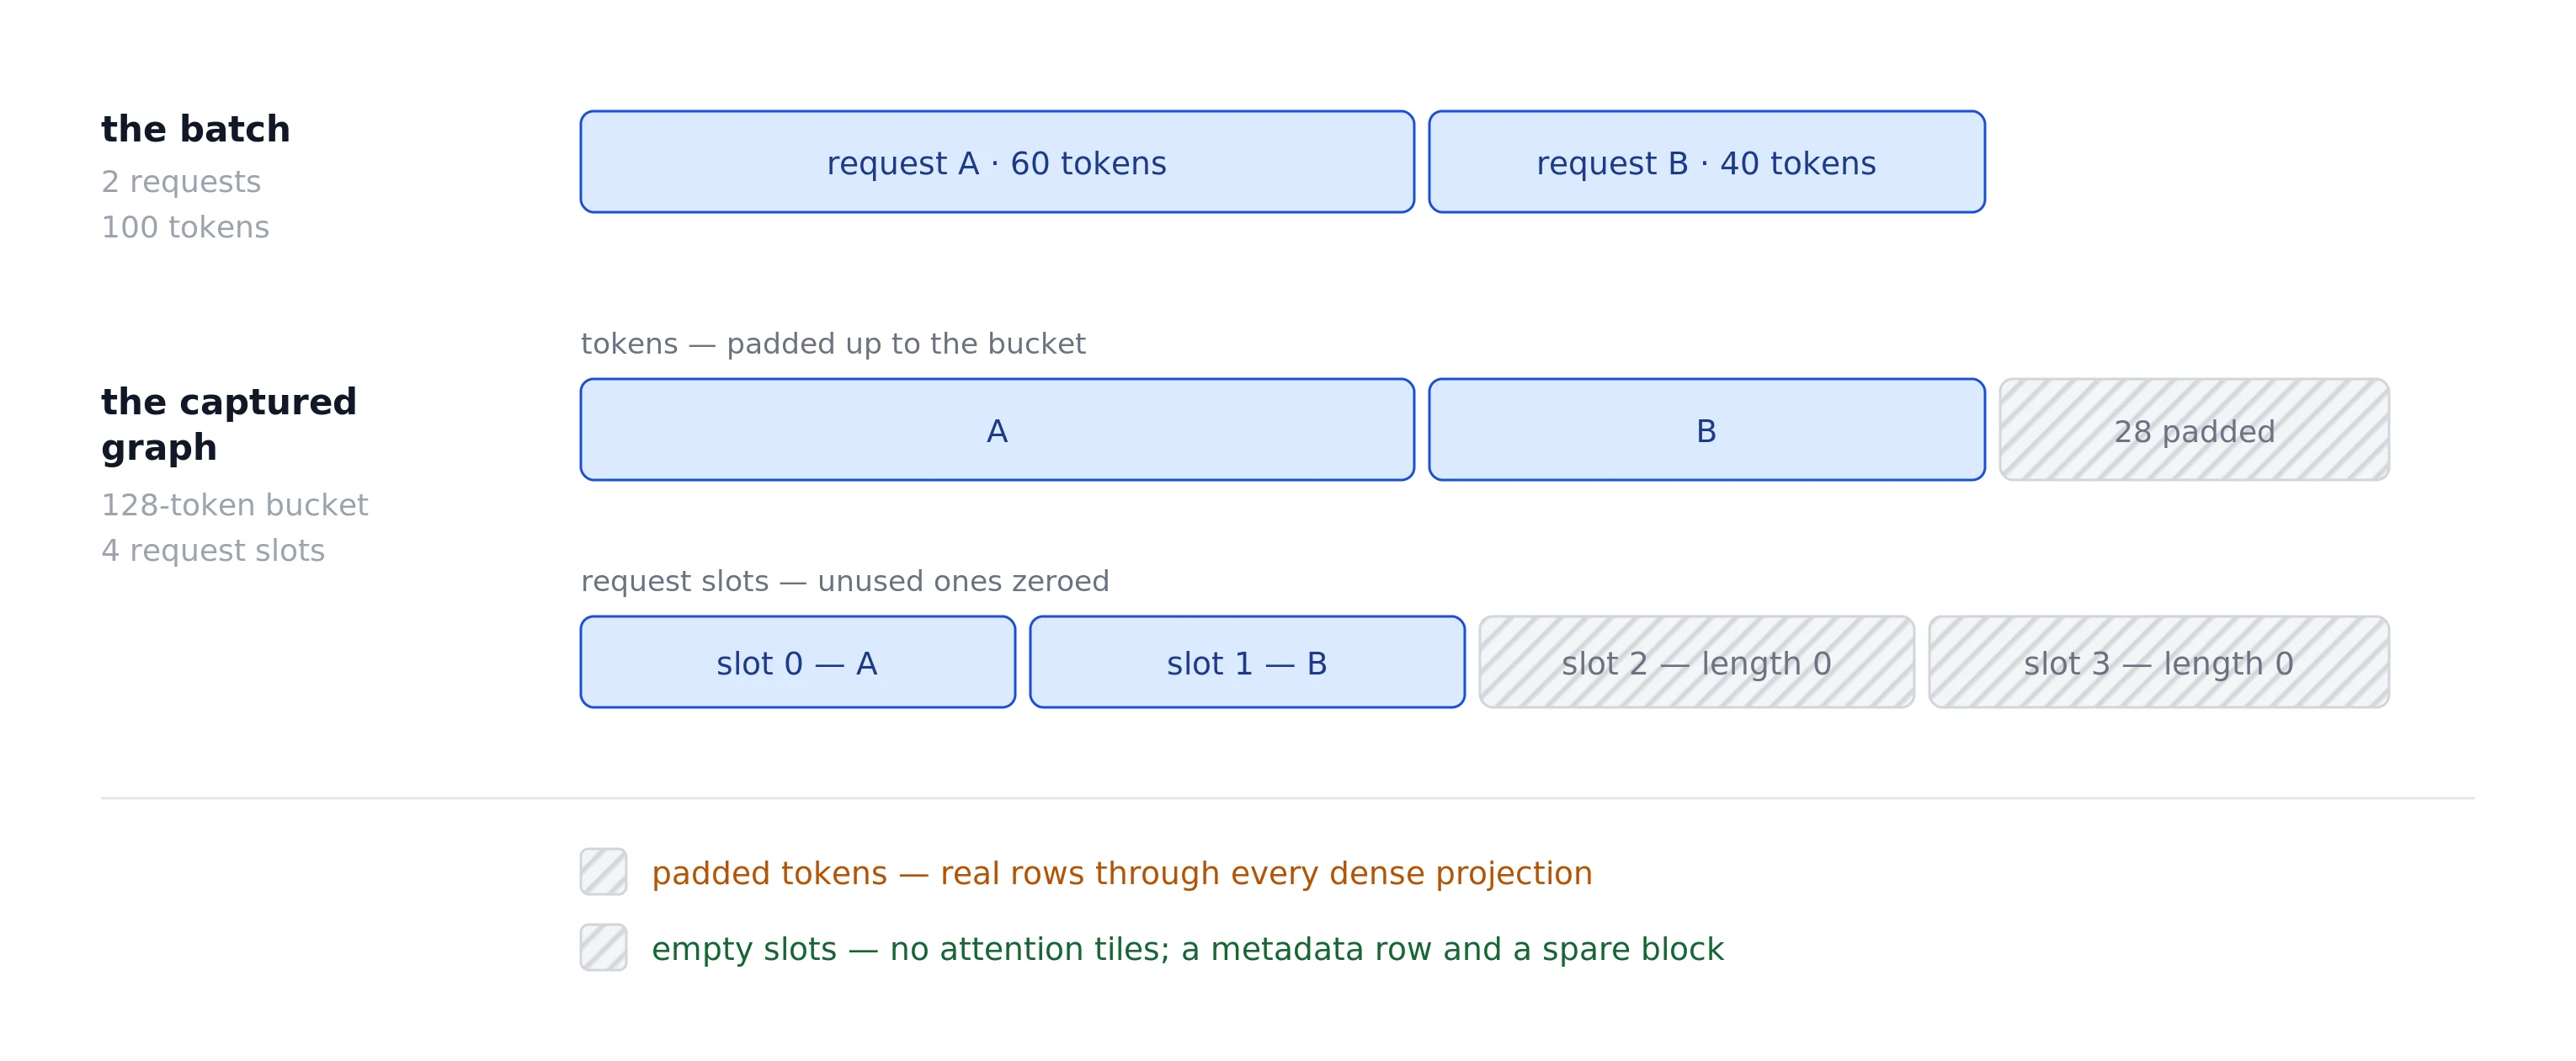
图源:SGLang 官方博客 Advanced CUDA Graph Techniques in SGLang。整图捕获把动态 prefill 批次补齐到固定形状;混批把”prefill 块 + decode 行”叠加进来,形状空间变成二维,桶不再够用。
SGLang:把 decode 行改写成 1-token extend,再合并
SGLang 走的是另一条路:不造”混合批”这种新类型,而是把 decode 行改写成 extend 行,再和一个普通的 prefill batch 合并。合并之后,整个批就是一次 extend 前向,走 extend 的 kernel、extend 的 metadata、extend 的 CUDA Graph 分段。
开关在 scheduler 构造时确定:
self.is_mixed_chunk = ( self.chunked_prefill_size is not None and get_schedule().enable_mixed_chunk)enable_mixed_chunk 是配置项,chunked_prefill_size 必须已设置。两者同时为真时,调度循环在一个 step 里先收 waiting 队列的 prefill,再检查 running 队列能否并进来。相关代码在 python/sglang/srt/managers/scheduler.py:
if ( self.is_mixed_chunk and not running_batch.is_empty() and not (new_batch.return_logprob or running_batch.return_logprob) and new_batch.input_embeds is None and all(r.beam_group is None for r in running_batch.reqs)): finishing_reqs = self._reqs_finishing_inflight(running_batch) running_batch.filter_batch(reqs_to_exclude=finishing_reqs) if not running_batch.is_empty() and running_batch.check_decode_mem(): running_batch.prepare_for_decode() new_batch.mix_with_running(running_batch) new_batch.decoding_reqs = running_batch.reqs这段条件列表本身就是一张边界说明。return_logprob 的请求被排除,是因为合并后 logprob 的起始位置需要按行重排,SGLang 还没有统一处理;input_embeds 不为空时,mix_with_running 会 cat input_ids 而不是 embeds,形状对不上;beam search 的束成员行也不能混进 extend 批。凡是越过这三条边界的请求,都退回到”这一 step 只跑 prefill,decode 下一步再说”。
check_decode_mem() 是第二道闸。这一步的 prefill 块先占了 KV 槽位,留给 decode 行的余量可能不够;不够时 running 队列原地不动,下一 step 单独解码。
注释写得很清楚:“这一步接纳的 prefill 可能没给 decode 行留出 KV 空间,它们就会在这一步缺席,到下一个 decode step 再解。“
mix_with_running:前缀与 extend 长度的重新定义
合并的核心在 ScheduleBatch.mix_with_running(python/sglang/srt/managers/schedule_batch.py):
def mix_with_running(self, running_batch: ScheduleBatch): self.forward_mode = ForwardMode.MIXED running_bs = running_batch.batch_size()
if self.spec_algorithm.is_none(): running_prefix_lens = [s - 1 for s in running_batch.seq_lens_cpu.tolist()] else: running_prefix_lens = [r.seqlen - 1 for r in running_batch.reqs] for req, prefix_len in zip(running_batch.reqs, running_prefix_lens, strict=True): req.refresh_fill_ids() req.extend_end = prefix_len + 1每一行 decode 被重新解释为”前缀长度 = 当前序列长度 − 1,extend 长度 = 1”。这不只是记账技巧:SGLang 的 extend kernel 用 extend_start_loc / extend_seq_lens 描述每一行 query 在原始序列中的位置,decode 行在这个坐标系里就是”最后一行”,位置是 seq_len − 1。改写之后,decode 行与 prefill 行使用同一套位置计算,因果 mask 也由同一份 metadata 生成。
改写的代价是 req.prefix_len 的语义短暂分裂。注释写道:“req.prefix_len 仍停在最后一次 prefill,所以这里的 req.extend_len 不是 1;这一行的前缀与 extend 长度记在 batch 上。“也就是说,请求对象本身的 prefix_len 不能直接拿来算这一行,真正的前缀长度在 batch 的 prefix_lens 列表里:
self.prefix_lens = self.prefix_lens + running_prefix_lensself.extend_lens = self.extend_lens + [1] * running_bsself.extend_num_tokens = self.extend_num_tokens + running_bs这三行把两段拼成一个批的账:prefix_lens 的前半是 prefill 请求已算完的长度(含前缀命中),后半是 decode 请求的 seq_len − 1;extend_lens 的前半是本步 prefill 块大小,后半全是 1;extend_num_tokens 是本步真正要算的 token 总数,等于 prefill 块大小加 decode 行数。
KV 槽位也要拼接。prefill 段有 self.out_cache_loc,decode 段有 running_batch.out_cache_loc;合并后一次性写进同一个张量:
out_cache_loc = torch.cat([self.out_cache_loc, running_out_cache_loc])投机解码的路径要单独处理,因为 decode 行的 out_cache_loc 在调度时还没确定。非投机分支直接用 running_batch.out_cache_loc;投机分支要根据每条请求的 seqlen − 1 去 token pool 里查 bonus 槽:
tail_base = torch.tensor([r.seqlen - 1 for r in running_batch.reqs], dtype=torch.int64, device=self.seq_lens.device)running_out_cache_loc = self.req_to_token_pool.req_to_token[ running_batch.req_pool_indices.long(), tail_base,].to(self.out_cache_loc.dtype)注释说明:“投机中继在调度时还未解析,所以 merge_batch 会把 seq_lens_cpu 置空;尾部要从请求状态重建。“合并之后,seq_lens 的后半段被重写为 tail_base + 1,因为这一步提交了 bonus token,attenion 必须看到这一行。
并进去之后,这一批是什么类型
ForwardMode.MIXED 的注释只有一句:“chunked prefill 时同时包含 EXTEND 和 DECODE。“这个枚举值在后续路径里被当作 extend 处理:
def is_extend(self, include_draft_extend_v2: bool = False): return ( self == ForwardMode.EXTEND or self == ForwardMode.MIXED or (include_draft_extend_v2 and self == ForwardMode.DRAFT_EXTEND_V2) or self == ForwardMode.TARGET_VERIFY or self == ForwardMode.SPLIT_PREFILL or self == ForwardMode.DLLM_EXTEND )这意味着混批走的是 extend 分支的 metadata 构造、extend 分支的 CUDA Graph、extend 分支的上下文并行判定(is_context_parallel_extend 同样把 MIXED 算进去)。decode 行只是”长度为 1 的 extend 行”,并没有被送到 decode kernel。
这个设计的好处是实现简单:不需要为混批写第十种 kernel,也不需要维护两套 CUDA Graph 捕获。代价是 decode 行失去了 decode kernel 的优化——decode kernel 为”单 token 跨长序列”设计过 KV 读取路径与低延迟调度,extend kernel 为”多 token 跨长前缀”设计过 tile 划分。用 extend 跑 1 行 decode,在上下文很长时会比 decode kernel 慢,但换来的是这一批形状统一、可捕获。
SGLang 的模型常量与并行方式沿用第一篇:78 层、hidden 6144、前 3 层稠密、后 75 层 MoE、256 选 8、MTP 1 层。这些不变,变的是这一步的批形状。下一节按这个形状把算子与通信重记一遍。
一个混批 step 的形状账
先选一个具体形状,后面所有数字都从它来。假设:
- 32 条 decode 请求正在运行,上下文都是 128K,开了 MTP、每步验证 6 个 token(k=5,加一个 bonus),于是 decode 段是 行;
- 一条新请求带 8192 token 的 prompt,前缀缓存命中 0,这一步被切成一个 8192 token 的块;
- 部署沿用第一篇的吞吐配方:单机 8 卡 H200,
--tp 8 --ep-size 8 --attn-dp-size 8,FP8 权重与 FP8 KV; - 记 为 prefill 段行数, 为 decode 段行数,总行数 。
一个关键的不变量:prefill 行的 KV 写入要早于本步的读取
混批和纯 prefill 有一个容易被忽略的区别:decode 行在这一步也会写入自己的新 KV,而它们的 attention 要读到这些新写入。vLLM 在 _allow_microbatching 的注释里把这条不变量写成了文字:“整步执行时,这一步的所有 KV 写入在任何 attention 读取之前发出。“SGLang 的 mix_with_running 用 out_cache_loc 的一次性 cat 保证同样的事:合并后的槽位在本步开头统一分配,attention 开始前所有写入已落盘。
如果框架为了省时间把”写 KV”和”算 attention”交错起来,decode 行会读到一半,索引器也可能对没有写完的条目打分。混批里这条不变量比纯 decode 更紧,因为纯 decode 的写和读都在同一行的同一位置,错位后是”读到旧值”,混批里则是”读到别人刚写的新值”。
第 0 层之前:embedding 与 DP gather
embedding 是逐行的查表, 行就是 次 gather,不受两段形状差异影响。真正改变的是 DP Attention 的 gather。在 --attn-dp-size 8 且 attn_tp_size = 1 的配置下,每张卡只持有分给自己的请求,MoE 却要在全局 batch 上路由,所以前向一开始要把 8 张卡的 hidden 拼成一份全局 batch。
字节数是 (BF16), 时约 103MB。纯 decode 时同样的 32 条请求只有 192 行、约 2.36MB。也就是说,混批把 DP gather 放大了 40 多倍——不是因为 decode 段变多了,而是 prefill 段本身就占了 的 98%。
这不是通信的浪费。prefill 行本来就要参与 MoE,MoE 按专家路由,而专家分布在 8 张卡上,所以 prefill 行必须离开自己所在的那张卡。混批只是把”prefill 的 gather”和”decode 的 gather”合并成一次。
第 1–3 层:稠密 MLP
前三层是稠密 MLP(first_k_dense_replace = 3),MoE 通信在这三层缺席。这三层的所有算子与纯 prefill 完全一样,区别只是行数里混入了 192 行长度 1 的 decode。稠密 MLP 的形状是 , 时是一个足够大的矩阵,Tensor Core 利用率不会因为 decode 段而下降。
A 投影与 Q/KV 上投影:按行分派
MLA 的四个投影在混批里最值得细看。A 投影把 6144 维压到 维,Q 上投影把 2048 维展开成 ,KV 上投影把 512 维展开成 ,再加上共享的 64 维 RoPE。四者的形状都是”行数 × 固定维度”,与行来自哪一段无关。
第一篇文章里写过的 GLM 专用路径在这一步起作用:GLM-5.3 在 decode 时使用一张窄 GEMM 表(vLLM 里是 glm52_low_latency_gemm.py),针对小行数的形状选择 kernel。混批的 远超出这张表的适用范围,于是这几层实际走的是普通 GEMM,与纯 prefill 没有区别。
这是混批的一个隐性收益:prefill 段把 GEMM 做大,decode 段的窄 kernel 本来就没有机会用;反过来,如果只混入几十个 token 的 prefill 块, 仍然很小,窄 GEMM 表反而会被优先选中,decode 行能保住低延迟路径。
稀疏注意力:两段的形状根本不同
这是混批里唯一一个两段必须分开算的算子。
decode 段的每一行只对 2048 个 Top-K KV 做注意力(index_topk = 2048),每个头 192 维 NoPE 加 64 维共享 RoPE。FlashMLA 的稀疏 kernel 为”1 个 query 对 2048 个 key”设计,KV 读取按 token 页展开。
prefill 段的每一行要对”前缀 + 块内之前的所有 token”做注意力。因果 mask 让块内形成下三角,跨块形成矩形。块大小 8192 时,块内注意力元素数是 个(每头每行对),跨块部分再按前缀长度线性增长。
SGLang 的 DSA backend 在 metadata 构造里用 forward_mode.is_decode_or_idle() 分流,MIXED 不在这个判定里,于是混批走的是 extend 路径。代码中的 RAGGED 路由注释甚至明确写下”MIXED 被排除”:某些按 ragged 段组织 attention 的路径不支持混批,因为混批的行在扁平流里交错,ragged 段不再连续。
vLLM 的稀疏 backend 同样按段分流:prefill 段走稀疏 MLA 的 prefill 内核,decode 段走 --dsa-decode-backend 对应的 MLA KV 内核;混批时两套内核在同一次前向里先后发射,KV 读取量是两段之和。
索引器:prefill 段才是大头
索引器(lightning indexer)是 GLM-5.3 的第二个二次方项来源。prefill 段里,每一行 query 都要对所有已写入的 key 打分,选出自己的 Top-K;decode 段里,每一行也要对整个上下文打分,选出 Top-K。
第三篇已经算过 prefill 块的索引器账: 个 query 对 个 key 的打分元素数是 , 时约 个(每头 128 维)。decode 段每行对 128K 个 key 打分,元素数是 个。两段同量级,prefill 段在 更大时迅速占主导。
索引器只在 21 个 full 层启用(第一篇文章的算例)。混批时这 21 层要同时处理两段:prefill 行做二次方打分,decode 行做线性打分。如果框架在混批里强行用同一套 kernel 同时处理两段,稀疏度与 tile 形状都会打架;实际实现是两段分别发射,只是共享同一次权重读取。
MoE:75 层,token 数是两段之和
从第 4 层到第 78 层是 MoE。混批在这一段的变化最直接:路由的 token 数是 ,而不是纯 decode 的 192 或纯 prefill 的 8192。
DeepEP 的 dispatch/combine 字节账按 token 数线性缩放。dispatch 用 FP8,每个 token 发往 8 个专家,一行 6144 维是 6KB,所以 dispatch 负载是 字节;combine 按 BF16 翻倍。 时一层 dispatch 约 0.41GB、combine 约 0.82GB,75 层合计约 92GB。
第六篇算过纯 decode 的对应数字:192 行、75 层,dispatch 约 9.4MB、combine 约 18.9MB,合计约 28MB。混批把它放大了三千倍。这些字节全都来自 prefill 段,decode 段只贡献 192/8384 ≈ 2.3%。
对 DeepEP 来说,这是模式的分水岭。低延迟模式(low-latency)为固定容量的 masked 布局设计,缓冲区大小在启动时定死,超出就报错;普通模式(normal)支持变长的 contiguous 布局。混批的 8384 行远超低延迟模式的缓冲容量,实际会走普通模式,与纯 prefill 相同。
这也是混批在 EP 规模上最危险的时刻:如果 MoE 跨节点,92GB 的 combine 负载在 50GB/s 的 IB 上要 1.8 秒,decode 行会被这条 prefill 块拖住。所以线上配置通常让混批只在节点内发生,跨节点的 EP 用 PD 分离把 prefill 与 decode 彻底拆开。
MTP:192 行的验证
MTP 层(第 79 层)只对 decode 段有意义。prefill 段没有草稿可验证,它们在这一步只走主模型,MTP 的验证 kernel 只处理 192 行 decode。
192 行的验证是一次小矩阵:MTP 层要验证 6 个 token 的接受情况,每个 token 要走一次目标模型的前向,再做一次采样与接受判定。第四篇和第五篇算过,MTP 的验证把 decode 后的每个 step 的 MoE 通信乘以 6;混批里这个乘数只作用在 192 行上,而不是整个 8384 行。
混批与 MTP 的交互还有一层:MTP 带来的 192 行会让 decode 段比”一条请求一行”大 6 倍。如果混批只看”行数”,会误以为 decode 段占了 192/8384,实际按请求数算它只占 32/33。这两个比例在算通信和算延迟时不能混用:通信按行数,延迟按请求数。
采样与输出行
采样器只处理需要产出 logits 的行。纯 decode 时每行都要采样(每行是一个待验证的草稿 token 或 bonus token);混批时 prefill 段只有每个块的最后一行需要采样(块中间的行被当作前缀,下一步继续)。
SGLang 的 mix_with_running 在 extend_logprob_start_lens 里为 decode 行补 0:
self.extend_logprob_start_lens = (self.extend_logprob_start_lens + [0] * running_bs)前缀长度等于 seq_len − 1 时,0 意味着这条 decode 行的输出位置就是它在序列里的位置;prefill 行则由批次原本的 extend_logprob_start_lens 决定。采样器拿到 extend_num_tokens 与 extend_logprob_start_lens 后,只对后者为有效值的行采样,混批的输出行数等于”prefill 块数 + decode 请求数 × (k+1)“在验证后的结果。
混批一步的账,和纯 decode 一步的账
把上面的数字放到同一张表里:
| 项 | 纯 decode(32 请求 × 6 行 = 192 行) | 混批(8192 prefill + 192 decode = 8384 行) | 倍率 |
|---|---|---|---|
| DP gather(每层 1 次,BF16) | 2.36MB | 103MB | 44× |
| MoE dispatch(单层,FP8) | 9.4MB | 0.41GB | 44× |
| MoE dispatch/combine(75 层合计) | 28MB | 92GB | 3300× |
| 主稀疏注意力 KV 读取(每层) | 32 × 6 × 2048 × 656B ≈ 258MB | 192 × 2048 × 656B + prefill 块 ≈ 258MB + 二次方项 | 至少 1×,prefill 块另算 |
| 索引器打分元素(单个索引器层) | 192 × 131072 | 192 × 131072 + 8192²/2 | 8192 块时约 2× |
| MTP 验证行 | 192 | 192 | 1× |
| CUDA Graph | 整图或分段重放 | 分段或 eager | 退回 |
表格里最能说明问题的是 MoE 通信。纯 decode 一步的 MoE 通信是几十 MB 量级,混批一步是百 GB 量级。这不是”混批变慢了”,而是混批把一步的 prefill 计算并了进来——同样的 8K prefill 如果单独跑一步,通信量也是一样的。混批改变的是”这一步的延迟由谁承担”,而不是”这一步要搬多少字节”。
由此可以得出几个判断:
第一,混批的收益在 decode 侧。8K prefill 如果单独占一个 step,32 条 decode 请求在这一 step 全部停摆,TBT 出现一个长尾;并入之后,它们在这一步照常出 token。Sarathi-Serve 论文正是用这个论证提出 chunked prefill:在 A100 上跑 Yi-34B 服务 arXiv 摘要轨迹时,vLLM 风格的完整 prefill 会让生成流出现持续数秒的停顿。
第二,混批的代价在 prefill 侧。prefill 块的 MoE 通信与 KV 写入被 decode 行”分摊”了少量行,但整体形状从”纯 prefill 的大矩阵”变成”带 192 行尾巴的大矩阵”,Tensor Core 的有效利用率略降。8K 的块里混入 192 行 1-token 的尾巴,对稠密 GEMM 影响可以忽略;对稀疏注意力则要把两段分开算,多一次 kernel 发射。
第三,混批把两套最优形状拉向均值。纯 prefill 适合大块与大通信,纯 decode 适合小块与低延迟;混批既不纯大也不纯小。这也是后来分块预填与 PD 分离同时存在的原因:分块预填让”混批”的形状可控,PD 分离则干脆把两段放到不同实例上,彻底避开混批的均值化。
三种边界:什么不能混、什么时候该分开
混批不是”越混越好”。从两个框架的实现看,有三条边界必须守住。
边界一:logprob 与结构化输出的回滚
vLLM 用 -1 掩码区分”chunked prefill 行”与”无草稿的 decode 行”,原因就是结构化输出的回滚。guided decoding 可能在验证后回滚草稿 token,如果 prefill 行被错误地当成”有草稿的 decode 行”,回滚逻辑会去改写一个不属于它的位置。
SGLang 的选择更保守:return_logprob 的请求直接不进混批。这不是性能问题,而是正确性问题——logprob 的起始位置、采样后的行映射、流式输出的 token 顺序,在混批里都要按两段重新编号,一旦有一处错位,用户看到的 logprob 就是错的。
结构化输出 + 投机解码 + 混批三者同时出现,是这套实现里最容易踩坑的组合。线上配置通常至少关掉一个:要么对结构化输出请求禁用投机解码,要么对它禁用混批。
边界二:KV 余量
check_decode_mem() 是一道朴素的闸:prefill 块先占槽位,decode 行若放不下就这一步不放。它的意义在于避免”为了混批而抢占其他 decode 请求的 KV”。
纯 decode 时,KV 增长是每请求每步一个 token,调度器可以精确预知下一步要多少;混批里,prefill 块可能一次吃掉几 GB 的 KV 池,decode 行的增量相对可以忽略。所以在 KV 接近满时,prefill 块与 decode 行是竞争关系,混批的调度器必须选择”先保证 decode 不中断”还是”先推进 prefill”。SGLang 的选择是先保证 decode(check_decode_mem 为假则不混),vLLM 的选择是 long_prefill_token_threshold 限制单条 prefill 的占比。
边界三:形状与图的连续性
混批会让 CUDA Graph 从整图退回分段。这在 decode 侧的代价是每 step 多几毫秒的 launch 开销;在延迟敏感的场景里,这几毫秒足以让 P99 的 TBT 越过 SLA。
所以线上常见的做法是按负载切换:低负载、请求短的时候关掉混批,让 decode 走整图;高负载、长请求多的时候打开混批,用吞吐换一点延迟。SGLang 的 enable_mixed_chunk 是静态配置,vLLM 的 long_prefill_token_threshold 是静态配置——两个框架都把这个权衡交给了部署者,而不是自动决策。
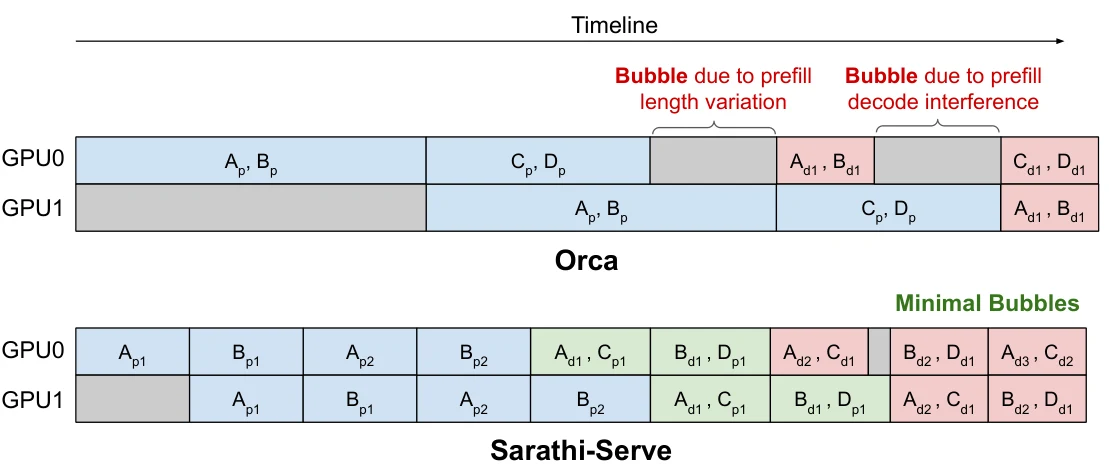
图源:Sarathi-Serve 论文中的流水并行空泡示意图。论文给出的例子是:4K token prefill 约需 1150ms,而 batch size 32 的纯 decode 迭代约需 200ms;若二者在流水并行的不同微批中交错,阶段间可产生约 950ms 的空泡。混批的目的是让这两类工作在时间上重叠,而不是让它们各自占满整轮。
与 PD 分离的关系:混批的退路
第四篇讲过 GLM-5.3 的 PD 分离:prefill 实例把 57GB 的 KV 与索引器缓存传给 decode 实例。PD 分离从根本上让混批不再必要——prefill 与 decode 在不同实例上跑,各自有同质的批,各自用最优 kernel。
但 PD 不是免费的。57GB 的传输本身就是一项开销,PD 分离还需要两套实例、两套调度、两套 KV 池。对于中小规模部署,PD 分离的收益可能抵不过它的复杂度,这时混批是更实际的选择。
两者的另一个关系是互补而非替代。PD 分离之后,decode 实例依然会遇到”首步的 EXTEND 前向”(第三种混批来源),prefill 实例依然会遇到”长请求的多个块”。混批逻辑在这些位置仍然被调用,只是不再用于把两类生产请求并在一起。
真实的大规模部署里,常见的是组合:PD 分离承载主要流量,同一实例内的混批处理”实例内剩余的长尾请求”,分块预填控制 prefill 实例的形状。三者在不同层上解决同一个问题——让变长的 prefill 不阻塞定长的 decode。
形状之外:调度器内部还有哪些计数会错位
上面几节都是从”前向形状”看混批。但混批对调度器自己的账本同样有影响,而且这些影响在第 0 层之前就已经发生。
token 预算与请求数预算
SGLang 的 PrefillAdder 在决定这一 step 收哪些 prefill 请求时,依据是 rem_chunk_tokens 与 KV 余量。混批打开后,running 队列的 decode 行会先占掉一部分 KV 与一部分”输出行”的预算,PrefillAdder 的可用余量随之变小。如果调度器不把这部分扣掉,prefill 块会算到一半发现 KV 不够,check_decode_mem 又把它退回,这一 step 就白走了。
代码里的处理顺序是”先 prefill、再混入 decode、混入失败则原样跑 prefill”,失败的那一步 decode 行全部缺席,下一 step 单独跑 decode。这与第三篇讲的 memory_budget.fit_chunk 是同一套逻辑,只是多了一个”给 decode 留位”的输入。
vLLM 的对应处理是 draft_slots:在给 prefill 分配 num_new_tokens 时,先扣掉本轮所有 decode 请求将要占用的投机槽位。这样 prefill 块不会把预算吃干净,下一步 decode 仍有位置。
批内请求顺序
纯 decode 时,批内请求顺序对结果没有影响:每一行独立采样,行间只通过 KV 页共享。混批时,prefill 行与 decode 行在扁平流里交错,query_start_loc 的边界、logprob 的起始位置、slot_mapping 的槽位都按顺序编号。如果框架把 prefill 行与 decode 行的顺序打乱(例如按到达时间排序而不是按两类分组),mix_with_running 里的 prefix_lens + running_prefix_lens 这种”前半 prefill、后半 decode”的拼接就会错位。
SGLang 选择”prefill 在前、decode 在后”的固定顺序,代价是两步拼接必须在同一张表上手工完成;vLLM 选择”由 token 数决定、不分组”,代价是每个请求在 worker 侧要做一次 num_computed_tokens 对照,才能知道行属于哪一段。
前缀缓存命中与正在写入的块
前缀缓存的匹配发生在调度时,命中长度的计算看到的是”缓存里已经有哪些块”。混批时,这一步正在写入的块还不完整,不能被下一次调度当作”已缓存”。如果调度器把本步 out_cache_loc 的一部分当成已完成块写进 radix tree,下一步的命中就会指向写了一半的页。
第六篇讲过 vLLM 在 _allow_microbatching 里用一段注释处理这件事;SGLang 在 mix_with_running 里则靠”decode 行只写 1 个槽位”把风险降到最低:一行 1 个 token 的写入本身不影响前缀匹配,因为它们的前缀在上一 step 已经是完整页。
一个真实的首步:8K 请求到达时发生了什么
前面几节都是”稳态混批”的账,即 decode 已经跑了一段时间、新请求在中间到达。更极端的情况是新请求就是第一条:decode 队列是空的,但 is_mixed_chunk 仍然为真,调度器第一步只跑纯 prefill。混批的价值要等 decode 队列起来之后才出现。
以第三篇的 SGLang 配置为例:--chunked-prefill-size 32768、--attn-dp-size 8、--speculative-num-steps 5。一条 1M 的请求到来时,第一步会按 32K 切块;32 个块跑完,第一条 token 才产出。如果在此期间有新的短请求到达,它们会排在 1M 请求的块与块之间,而不会与 1M 的块混批——因为 PrefillAdder 在长请求的块之间会优先给短请求一个小块,后者单独跑或与 decode 混批。
所以混批在真实服务里的作用,更多是”承载长尾”而不是”承载主力”。主力流量走 PD 分离或独立实例;长尾请求、短请求、缓存命中请求,在同一个实例里被混批与 decode 一起处理,保持 GPU 不空闲。
为什么 8K 以上的请求通常不混
原因在于一次 prefill 块的二次方项。索引器的打分元素是 ; 时约 3400 万个元素, 时约 5.4 亿个, 时约 86 亿个。混批里如果让一个 131K 的块并进 decode,索引器这几层的耗时会把整个 step 拉长到与纯 prefill 无异,decode 行的优势丧失殆尽。
实际配置里,chunked-prefill-size 与 long_prefill_token_threshold 都是 8K 到 32K 量级,没有配置会把一个 100K 以上的块并进 decode。这个门槛不是框架自动定的,而是部署者按索引器的二次方项估出来的。
为什么 1K 以下的请求也不一定混
反过来,极小的 prefill——例如前缀缓存命中了 95%、只剩 50 个 token 的新请求——如果并入 decode,会让这一 step 的 shape 从”192 行”变成”242 行”,而 decode 的整图桶是按 192 行捕获的,242 行要另选一个桶或退回分段。这一步的收益(50 个 token 的 prefill)可能抵不过失去整图的代价。
vLLM 对此的处理是”先解 decode 一步,下一步再处理这条小 prefill”,因为它知道 uniform decode 的判定会被 50 行的 prefill 打破。SGLang 的处理更直接:new_batch 的 prefill 与 running_batch 的 decode 只有同时满足 is_mixed_chunk 且通过 check_decode_mem 时才会合并,小请求往往第一步单独走 extend,不混。
把混批放回五框架的横向坐标
第五篇之后的几篇横向对比过前缀缓存、进程边界、CUDA Graph 在五个框架里的做法。混批在这里同样有一个横向坐标。
TensorRT-LLM 的 in-flight batching 与 vLLM 的连续批处理同源,但 TRT-LLM 在编译期就固定了 KV 最大长度与 max batch,混批的形状空间由引擎 profile 决定。“Paged KV 与 in-flight batching”的组合在 TRT-LLM 里是通过多个 profile 覆盖的,形状超出 profile 就退回 eager。这与 SGLang 的”extend 分段 + 分段图”是同一思路的不同落地。
llama.cpp 的批处理以”batch 内每个序列的 slot”组织,混批逻辑体现在 llama_batch 的 n_tokens 与每序列的 seq_id 上。它的混批更接近”把两段放进同一个 n_tokens”,没有统一的 extend 型 kernel,所以 decode 与 prefill 各自调用自己的 kernel,形状切换在 C 层做。
DeepInfer 的 SGLang 衍生路径在本篇的场景里与 SGLang 一致:enable_mixed_chunk 决定是否把 decode 行改写成 extend 行。差别在于它的调度器把 prefill 与 decode 的预算分成两层记账,混批的准入判断发生在第二层,而不像 SGLang 那样在 PrefillAdder 之后。
对 GLM-5.3 的部署者来说,这个横向坐标的意义是:混批的收益与代价在五个框架里量级一致,差异在”形状切换的粒度”。SGLang/vLLM 粒度细,混批能覆盖到很窄的形状;TRT-LLM 粒度粗,混批被 profile 边界限制;llama.cpp 粒度最粗,混批的吞吐收益最高,延迟稳定性最差。
逐算子清单:从第 0 层到第 79 层
把混批一步的每个阶段按执行顺序列出来,标清”两段共用”还是”两段分派”,这张表就是第八篇总账在混批状态下的展开。
| 阶段 | 算子 | 混批行为 | 说明 |
|---|---|---|---|
| 入口 | embedding gather | 共用 | 按行查表,两段无差别 |
| 进入前向 | DP gather(AllGather) | 共用 | 字节按总行数 计,prefill 段占大头 |
| 第 1–3 层 | RMSNorm、QKV 投影、稠密 MLP、残差 | 共用 | 形状 ,prefill 段把矩阵做大 |
| 第 1–3 层注意力 | MLA 投影、稀疏注意力 | 分派 | prefill 走 extend 路径,decode 走 1-token extend 或 decode kernel |
| 第 4–78 层 | RMSNorm、A/Q/KV 投影 | 共用 | 逐行计算,与段无关 |
| 第 4–78 层索引器 | indexer Q/K、打分、Top-K | 分派 | prefill 的 与 decode 的 分开算 |
| 第 4–78 层注意力 | FlashMLA 稀疏注意力 | 分派 | 两套 kernel,KV 读取量相加 |
| 第 4–78 层 MoE | 路由、dispatch、grouped GEMM、combine | 共用通信、共用 GEMM | token 数是两段之和,布局按普通模式 |
| 第 79 层 MTP | 验证前向、接受判定 | 仅 decode | prefill 段不参与 |
| 输出 | 采样、logprob、detokenize | 分行 | prefill 块只采最后一行,decode 行按验证结果采 |
这张表里,“共用”的算子占绝大多数。这也解释了为什么混批的实现成本主要在调度器与 metadata,而不在模型层:模型层的绝大多数算子天然按行工作,只有注意力与索引器需要知道”这一行属于哪一段”。
真正的分派点是两个:稀疏注意力与索引器。这两个恰好也是 GLM-5.3 推理开销最大的两处——前者决定 KV 读取,后者决定二次方项。混批把两个开销最大的算子拆成两套形状,剩下的算子合并,这是它能在工程上成立的原因。
共用算子的隐性代价
共用不等于零成本。以 A 投影为例,纯 decode 时 192 行是一个 的窄 GEMM,Tensor Core 的 tile 利用率低,但延迟短;混批时 8384 行是一个大 GEMM,利用率高,但延迟长。同一个 kernel 在大形状下效率更高,代价是 decode 行要等 prefill 段算完——它们的 token 在这一层被”顺带”算出来,不需要额外的 kernel,但需要等这一层的大矩阵结束。
这种”顺带”在稠密层是收益,在注意力层是代价。混批的净收益取决于两段的 token 比例:prefill 段越大,稠密层的利用率收益越明显,注意力层的形状冲突也越明显;prefill 段越小,两者都趋近于纯 decode。
怎么在线上看出混批正在发生
混批不是一个直接暴露的指标。SGLang 的 /metrics 里没有 mixed_batch 计数器,vLLM 也没有;要看出来,得从几条间接指标的组合推断。
第一条是 prefill 与 decode 的 token 数同时非零。 SGLang 的调度日志会打印每一步的 #new-token 与 #cached-token,vLLM 的 SchedulerOutput.num_scheduled_tokens 可以从 debug 日志或 profiler 里读到。如果某一步既有大于 chunked-prefill-size 量级的 token 分配,又有若干请求分到 1 或 k+1,混批就在发生。
第二条是 TPOT 的周期性尖峰。 纯 decode 的 TPOT 分布很窄,P50 与 P99 相差不到 2 倍;混批会在每次 prefill 块并入时出现一个尖峰,尖峰的高度近似等于”prefill 块的 MoE 通信时间 / decode 一步的时间”。32 条请求、8K 块、单机 NVLink 的场景里,这个尖峰通常是 5 到 10 倍。如果 P99 的尖峰周期与 prefill 块的到达周期一致,基本可以确认。
第三条是 GPU 利用率的锯齿。 纯 decode 的 SM 利用率低而稳定(显存带宽受限);混批在 prefill 块那一步把 SM 拉满,下一步又回到低利用率。Nsight Systems 的 timeline 上会看到”一宽一窄”交替的 kernel 序列,宽的正是 prefill 段。
第四条是 CUDA Graph 的重放计数。 vLLM 的 cudagraph_metrics 会记录 FULL 与 PIECEWISE 的重放次数。混批 step 的 FULL 计数不增加、PIECEWISE 增加,这就是形状退回的直接证据。SGLang 的 --enable-metrics 里有类似的分段图统计。
排障时最有用的是把这四条放在同一张时间轴上:如果 TPOT 尖峰、SM 锯齿、PIECEWISE 重放三者同相位,而 token 分配里又同时有两段,那么尖峰的原因就是混批,而不是 PD 传输或专家负载不均。
反过来,如果 TPOT 尖峰出现但 token 分配里只有 decode,问题在别处——可能是专家路由的热点、前缀缓存的失效、或者 PD 的 KV 传输。混批只是众多”周期性强干扰”里的一种,不能看到尖峰就归因于它。
混批对前缀缓存命中的改写
前缀缓存与混批在调度器里是相邻的两步:请求进入 waiting 队列时先算前缀命中长度,再进入 PrefillAdder 决定本步分多少 token。混批打开后,这一步的命中判断要处理一个额外情况——前缀的块里有一部分是本步正在被别的请求写入的。
第八篇的”前缀缓存命中如何改写账本”一节只讨论了命中之后的读取,没有讨论命中与写入同批的情形。混批把两者放在同一个 step 里:一条请求的前缀命中可能在另一条请求本步正在计算的块上,这在纯 decode 的批里不会出现(decode 只追加单 token,不产生新块),在纯 prefill 的批里也只发生在”同批的两个请求共享前缀”时。
vLLM 的 _allow_microbatching 注释正好描述这个情形:“一条请求可能在一个前缀缓存命中上被接纳,而它命中的块正是同批另一条请求此刻正在计算的。“整步执行时,写入先于读取,命中成立;切成两半后,前半的 reader 会读到后半 writer 还没写完的块。
SGLang 在 mix_with_running 里没有对应的显式检查,但它通过两个设计天然避开了问题:其一,decode 行只写 1 个槽位,不产生新块,不会让其他请求的命中指向半成品;其二,prefill 请求之间的共享前缀在 PrefillAdder 阶段已经按顺序处理,先算的请求先写块,后算的请求读到的都是完整块。
对账本的影响是:混批一步的”有效缓存字节”不是两段命中字节之和,而是”命中且已完整写入”的部分。一条请求的前缀命中了 4K,其中 1K 是本批另一条请求本步才写入的,那么对这 1K 的读取要等写入完成;这部分等待在纯 decode 的账本里不存在,在混批里是一次与块大小成正比的块内同步。
前九篇的账,到这里才完整
前八篇把 GLM-5.3 的一条请求拆开,每一篇都在”纯批”的假设下算账。这一篇补上了那个假设不成立时的账:混批让形状变成两段,让算子分派变成”一算子两形状”,让 CUDA Graph 从整图退回分段,让 MoE 通信从每 step 几十 MB 跳到上百 GB——但这些字节全都来自同一步的 prefill 计算,混批改变的是”谁来承担这一步的延迟”,而不是”这一步要搬多少字节”。
把这个结论放回总账(第八篇)里,一条请求的生命周期就有三本账:
- 纯 decode 一步:几十 MB 通信、每层几百 MB 的 KV 读取、整图重放,瓶颈在显存带宽;
- 纯 prefill 一步:百 GB 级 MoE 通信、二次方项索引器、分块与上下文并行,瓶颈在 Tensor Core 与 NVLink;
- 混批一步:两段之和,形状拉向均值,瓶颈由两段的 token 比例决定。
调度器的真正职责,不是选择”prefill 还是 decode”,而是决定”这一 step 的两段比例”。比例偏向 decode,TBT 稳定、TTFT 变慢;比例偏向 prefill,TTFT 变快、TBT 出现长尾。分块预填、混批、PD 分离,都是在这条比例轴上做选择的不同工具。
参考资料
- Sarathi-Serve: Stall-Free Batching for Efficient Large Language Model Serving(arXiv:2403.02310)
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA 与稀疏 MLA 结构,arXiv:2512.02556)
- vLLM 源码:v1/core/sched/scheduler.py(num_scheduled_tokens、long_prefill_token_threshold)
- vLLM 源码:v1/worker/gpu_model_runner.py(_is_uniform_decode、chunked prefill 的 draft 掩码、micro-batching 约束)
- SGLang 源码:managers/scheduler.py(is_mixed_chunk 与混批接纳条件)
- SGLang 源码:managers/schedule_batch.py(mix_with_running、check_decode_mem)
- SGLang 源码:model_executor/forward_batch_info.py(ForwardMode.MIXED 与 extend 判定)
- Inside vLLM: Anatomy of a High-Throughput LLM Inference System
- SGLang 官方博客:Advanced CUDA Graph Techniques in SGLang
- DeepEP:MoE dispatch/combine 通信库
- FlashMLA:MLA 解码内核
- vLLM GLM-5.3 部署配方(TP8、FP8 KV、MTP 与 DSA 后端参考)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



