


GLM-5.3 推理全链路(八):系列总账——把前七篇的算子、通信与字节数压进一条时间线
这一篇做什么
前七篇各自把一个请求的一段拆开:第一篇按时间顺序在 SGLang 里走了一遍,第二篇在 vLLM 里对照,第三、五篇处理 prefill 的 1M 上下文与上下文并行,第四篇处理 PD 分离的 57GB KV 交接,第六篇打开 MoE 的 dispatch/combine,第七篇收尾输出侧。
每一篇内部的账本都是自洽的,但读者要回答“一次请求到底经过多少算子、搬多少字节”时,还需要把七篇里的数字放到同一根时间轴上。这一篇做五件事:
- 画出一条贯穿入口到输出的完整时间线,标出每个阶段归属哪一篇;
- 把一次 decode step 与一次 prefill 前向的算子清单并列,指出两者共享哪些算子、各自多出哪些;
- 汇总一次 decode step 的集合通信清单,按 TP、EP、DP Attention、PD 交接四个类别核算次数与字节;
- 给出单位 token 的边际成本,说明为什么上下文越长,瓶颈从 FLOPs 转向显存带宽,再转向索引器读写;
- 把 1M prefill 的账本按 32 个 chunk 摊开,与 decode 的每步账本对照。
所有数字沿用前七篇的口径:744B 总参数、40B 激活、78 层、隐藏维 6144、256 专家激活 8 个、1M 上下文、FP8 权重与 FP8 KV。
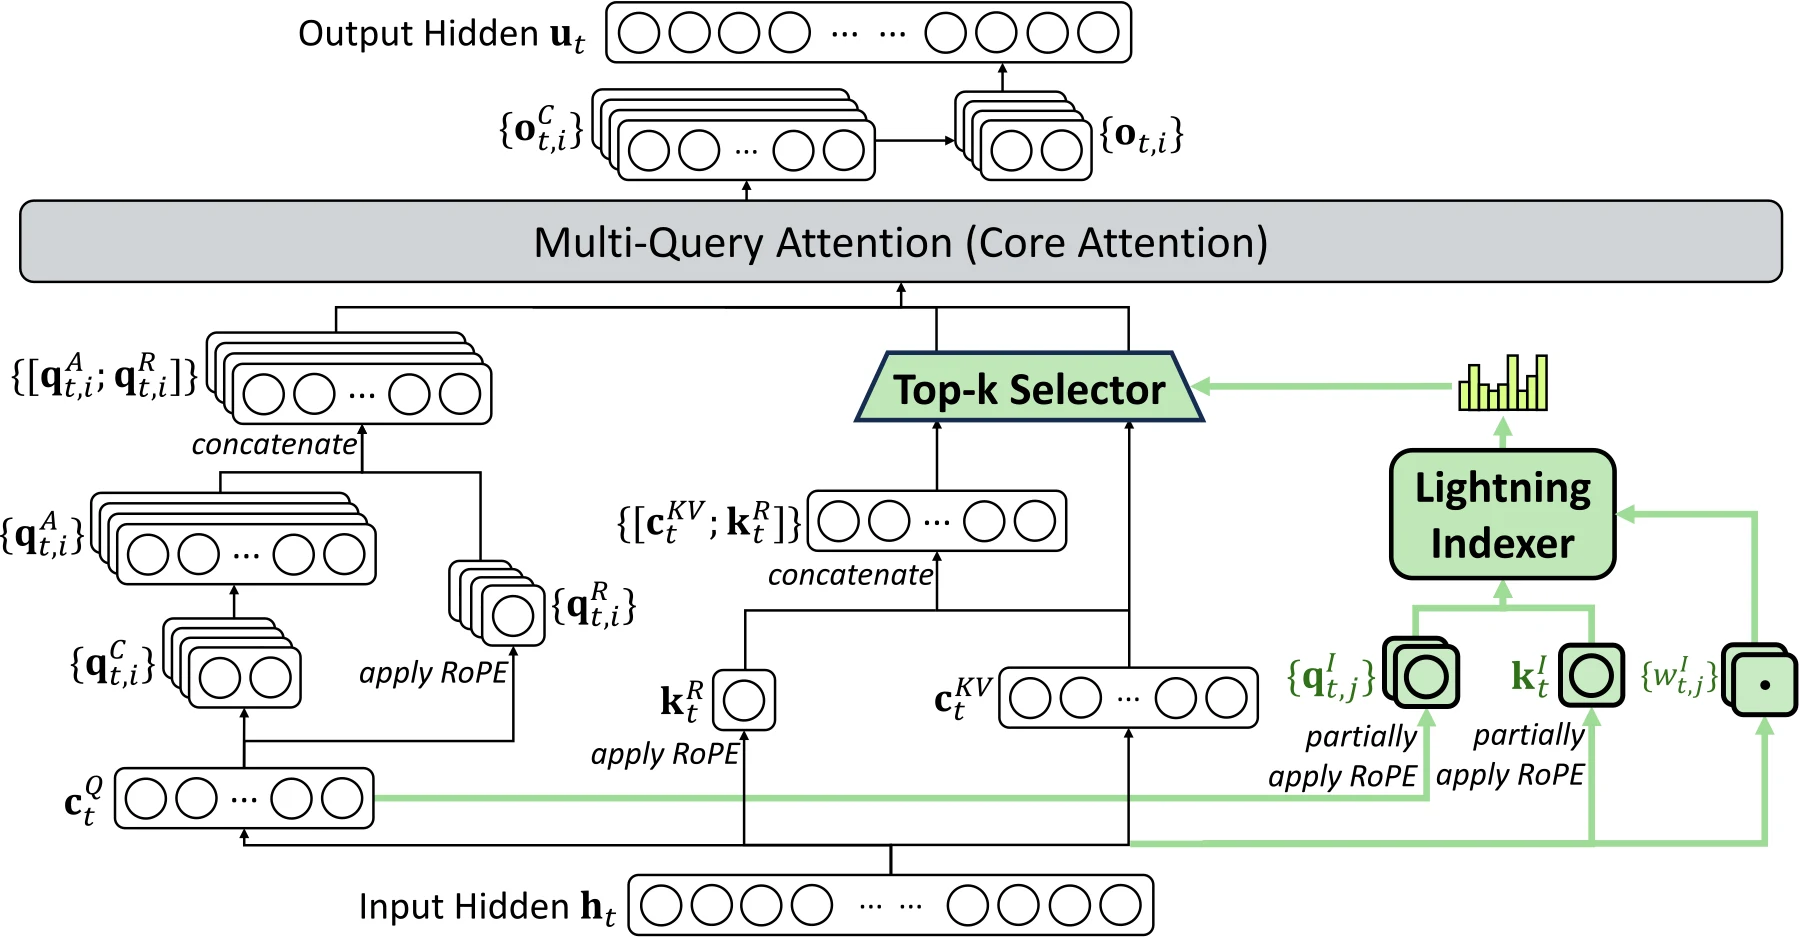
时间线:一次请求经过的十个阶段
把前七篇拼起来,一条请求从字节到文本的路径可以压成下表。第三列标注每一阶段的主要工作落在哪一篇里,方便按需回看:
| 阶段 | 内容 | 对应篇目 |
|---|---|---|
| 1. 接入 | OpenAI 兼容 HTTP、协议适配、chat template、分词 | 第一、二篇 |
| 2. 入队 | TokenizerManager 生成 Req、经共享内存进入调度进程 | 第一、二篇 |
| 3. 调度 | 调度器选请求、分配 token 预算与 KV 页、前缀匹配 | 第一、三、五篇 |
| 4. 输入构造 | InputBatch、块表、注意力元数据、CUDA Graph 桶 | 第一、二篇 |
| 5. 嵌入 | 词表并行查表 + AllReduce | 第一篇 |
| 6. 逐层前向 | RMSNorm、A 投影、norm+RoPE+写 KV、索引器、稀疏 MLA、MoE | 第一、二、六篇 |
| 7. 投机 | MTP 层 draft 与 verify 前向 | 第一、二篇 |
| 8. 输出边界 | LM Head 词表并行 GEMM 与 logits AllGather | 第一篇、第七篇 |
| 9. 采样与校验 | temperature、top-k/top-p、MTP 接受、语法掩码 | 第七篇 |
| 10. 反分词与回传 | 增量解码、stop string、流式 chunk、KV 回收 | 第七篇 |
阶段 5–9 主要在 GPU 上完成(阶段 9 的语法掩码构造与部分控制逻辑仍在 CPU),其余在 CPU 或进程边界上完成。真正需要逐 kernel 核算的是阶段 5–9;阶段 1–4 和阶段 10 的瓶颈通常在 Python 与 CPU 侧,用“每步多少微秒”来量更合适。
阶段 1–2:从字节到一条 Req
入口层做三件事:解析 JSON、按 chat template 把消息拼成文本、分词。分词是一次 CPU 侧的 tokenizer 调用,对一条 20K token 的 prompt,现代分词器在几十毫秒量级;这几十毫秒不进入 GPU 前向,但它决定了 TTFT 的起点。
分词结果经共享内存写进调度进程。SGLang 的 TokenizerManager 与调度器分属两个进程,请求对象要经过 pickle 或共享内存段传递;vLLM V1 把 ZMQ 作为控制面、共享内存作为数据面,避免大 prompt 的 token 数组在进程间复制两次。这一步没有集合通信,只有 IPC,但它是一个真实的、可以被高并发打满的瓶颈点:prompt 越长、请求越密,IPC 的拷贝时间越不可忽略。
阶段 3:调度器的算术
调度器每步要做三件事:从等待队列选请求、给每条请求分配“这次可以算多少 token”、为算出的 token 预留 KV 页。
prefill 阶段,这里的核心约束是 token 预算。一条 1M 上下文请求不能一次算完,SGLang 的 PrefillAdder 按三重容量(token 预算、KV 页预算、当前批次显存)切块,1M 请求会被切成几十个 chunk(按 32768 一块算是 32 个),每个 chunk 走一次独立的前向。decode 阶段,每条运行中的请求每步只算 1 个 token(开启 MTP 时最多 k+1 个),约束变成 KV 池的剩余页数;当页不足时调度器要抢占(preempt)一条低优先级请求,把它退回等待队列并释放其 KV。
调度器本身不产生集合通信,但它决定了后面每一阶段的 batch size,而 batch size 是通信字节数的线性因子。这是“调度器是通信账本的上游”的含义。
阶段 3 的另外一半:KV 页分配与前缀命中
调度器给出 token 预算之后,块管理器要为这批 token 找 KV 页。SGLang 的 KV 池按 64 token 一页分配,vLLM 由 page_size 决定;前缀缓存命中时,命中的前缀页不做分配,而是共享引用计数加一,只有未命中的尾部才新分配页。
这一步的 CPU 开销与“每条请求有多少新页”成正比。对 decode,每步每条请求只新增 1 个 token,通常复用已持有的尾页,除非尾页已满才分配新页;对 prefill,情况取决于框架与配置:SGLang 的 PrefillAdder 会为整条请求预留 KV,而不是只预留当前 chunk,一个 1M 请求就是约 57GB(主 KV 加索引器缓存)的一次性占用,这正是第三篇“1M token 的主 KV 必须先被预留出来”的来源;vLLM 则既支持按请求预留,也有按 chunk 逐步写入的模式。两种策略的账不同:前者把 KV 容量变成准入条件,一条长请求会挤掉若干短请求;后者让长请求与短请求可以共用 KV 池,但要在调度器里额外追踪“已写入多少页”。
阶段 4:把调度结果冻成 GPU 输入
InputBatch 把“这一步有哪些请求、每条请求的 token 在 KV 池的哪些页里”翻译成 GPU 能直接读的张量:input_ids、positions、out_cache_loc(新 token 该写进哪一页的哪个槽位)、以及注意力的块表与序列长度。
这一步的 CPU 工作量与 batch 线性相关,但 CUDA Graph 会把它压成“写进固定缓冲区”的一次 memcpy。SGLang 对 decode 做整图捕获,按 batch size 分桶;vLLM 对 decode 分桶、对 prefill 分段。两者共同的前提是:张量的地址固定,元数据写进预先分配的静态缓冲区。这就是第五篇说的“把动态批塞进静态图”的第二个作用——它不只是省 kernel launch,还省掉了每次重新构造 GPU 输入对象的 Python 开销。
阶段 4 的代价:元数据随 batch 线性增长
InputBatch 要构造的数组有几类:输入 token、位置、输出槽位、每条请求的序列长度、块表指针。这些数组的总长与“本步 token 数”和“本步请求数 × 每题页数”相关。decode 的 256 请求、每条 128K 上下文,块表项就是 个页号;即使只是把页号从 CPU 缓冲区拷到 GPU,也是一次几百 KB 的传输。
CUDA Graph 把这个拷贝固定成静态缓冲区的一次 memcpy,但它要求本步 batch 不超过桶的大小;超过时只能回退到 eager,重新构造输入,额外多出这部分 CPU 时间。这就是第二篇里“桶与垫”的实践含义:桶越细,回退越少,但图越多、显存里缓存的图缓冲也越多。
阶段 5:嵌入是第一个集合通信
embed_tokens 用词表并行查表,每个 rank 只持有 行的词向量。查表本身是 gather,不含浮点;但 TP 下每个 rank 只知道自己那一段的嵌入,要得到完整的 6144 维向量,必须在 attention TP 组内做一次 AllReduce。
这次通信发生在任何一层 Transformer 之前,是整条链路的第一个集合通信。对一个含 个 token 的 batch,消息量是 字节(BF16)。对 decode 的 256 个请求,约 3MB;对 prefill 的 32K chunk,约 400MB,需要在 8 卡间分摊。
逐层前向:算子清单与融合边界
一层解码器的算子顺序在第一篇已经给过,这里把它整理成可直接对照的清单,并与 prefill 并列:
| 序号 | 步骤 | decode 里有没有 | prefill 里有没有 | 融合情况 |
|---|---|---|---|---|
| 1 | 残差加法 + RMSNorm | 有 | 有 | 与上一次 MoE 的归约融合 |
| 2 | A 投影(6144 → 2624) | 有 | 有 | SGLang 四次 GEMM,vLLM fused_qkv_a_proj 一次 |
| 3 | q_a / kv_a RMSNorm + RoPE + 写 KV | 有 | 有 | 融合为 fused_norm_rope,索引器层顺带写索引器 KV |
| 4 | Q 上投影(2048 → 64×256) | 有 | 有 | 与索引器的 wq_b 共享输入 |
| 5 | 索引器 K 投影与打分 | 21 层独立 | 21 层独立 | 打分与 Top-K 选择常在同一 kernel |
| 6 | Top-K 选择(按页) | 有 | 有 | 块级筛选,输出选中块的紧凑下标 |
| 7 | 稀疏 MLA 注意力 | 有 | 有 | FlashMLA / FlashInfer 稀疏后端 |
| 8 | o_proj + 归约 | 有 | 有 | 末尾 ReduceScatter 或 AllReduce |
| 9 | 路由(gate + grouped top-k) | 75 层 | 75 层 | 路由与专家分发在同一 kernel |
| 10 | dispatch(all-to-all) | 有 | 有 | DeepEP,低延迟 / 高吞吐两种模式 |
| 11 | 专家 GEMM(w1、w3、w2) | 有 | 有 | grouped GEMM |
| 12 | combine(all-to-all 回传) | 有 | 有 | 可与第二个 GEMM 重叠 |
| 13 | LM Head | 仅最后一步 | 仅最后一个 chunk | 词表并行 GEMM |
| 14 | 采样 | 有 | 无 | GPU 内核 |
| 15 | MTP draft / verify | 开启投机时 | 无 | 独立前向 |
这张表里最关键的差别有三处。第一,prefill 不做采样:一个 chunk 的 个 token 里只有最后一个位置的 hidden 会去算 logits,其余位置的输出只用来写 KV。第二,索引器在 prefill 里的开销是二次方项,而 decode 里只有 1 个 query 对整段上下文打分,工作量与上下文线性相关。第三,MoE 在 prefill 里每个 token 激活的专家分布通常更均匀,dispatch 的负载均衡比 decode 好;decode 由于 token 少,容易在少数专家上聚集,DeepEP 的低延迟模式与专家冗余正是为此准备的。
融合的边界不是“能融就融”的自由选择,而是显存复用与 kernel 依赖的约束。fused_norm_rope 之所以能把写 KV 融进来,是因为它已经持有本层的 q、k、v 潜向量,不写 KV 也要把它们算出来;若把 LM Head 融进最后一层,就会破坏“每层结构一致”的假设,使 CUDA Graph 无法复用同一份图。这也是为什么框架的融合集中在层内,而跨层的归约融合(AllReduce 叠 RMSNorm)要用通信回调的形式,而不是把两层合成一个 kernel。
以第一项融合为例,SGLang 把上一层的 AllReduce 叠进 fused_add_rmsnorm:ring 通信每到达一个 chunk,就在该 chunk 上做残差加法与 RMSNorm。对 TP8 的一层,这把“通信 + 两次显存读写 + 归一化”压成“一次 ring 传输 + 就地归一化”,节省的是显存带宽而不是 FLOPs,通信次数不变。
一次 decode step 的集合通信总账
把上表的逐层算子乘上 78 层,一次 decode step 的通信清单如下。表中 是这一步 batch 里的请求数, 是 fp8_ds_mla 布局下每 token 每层的 KV 字节数。
| 拓扑 | 通信点 | 次数 | 单次消息量 |
|---|---|---|---|
| 纯 TP8 | 嵌入 AllReduce | 1 | |
| 纯 TP8 | 每层注意力输出 AllReduce | 78 | |
| 纯 TP8 | 每层 MLP 输出 AllReduce | 78 | |
| DP Attention + EP8 | 进层前 DP AllGather | 1 | |
| DP Attention + EP8 | 每层注意力后 ReduceScatter | 78 | |
| DP Attention + EP8 | 稠密层 MLP AllReduce | 3 | |
| DP Attention + EP8 | MoE dispatch | 75 | (FP8) |
| DP Attention + EP8 | MoE combine | 75 | (BF16) |
| 两种拓扑 | 词表 AllGather | 1 | |
| PD 分离 | KV 与索引器缓存传输 | 每请求一次 | + |
几个口径需要解释清楚。
为什么 DP Attention 的存在会让 78 层的 ReduceScatter 变成跨组通信。 开启 DP Attention 后,注意力按请求分片到各 rank,每个 rank 只算自己负责的请求;但 MoE 的权重按 EP 切分,所有 token 必须汇到一个共同的专家空间里。所以每层在注意力之后要把各 rank 的注意力输出合并(ReduceScatter),MoE 之后再合回(AllReduce)。这两步在纯 TP 下也存在,只是组的大小不同;字节数相同,但 DP Attention 改变的是组内成员和 page table 的归属。
MoE 的 8 倍因子。 每个 token 激活 8 个专家,这 8 个专家按 EP 切分后分布在不同的 rank 上。发送方视角的字节是 ,平均每个 rank 只收到 个 token 的副本(当 EP=8 且专家分布均匀时)。但通信的计时按最慢的那条链路算,所以账本要按发送总量算,而不是按均值算。
PD 分离的传输量的量级。 按第四篇的推导,每 token 每层 656 字节,78 层合计约 51.2KB/token;1M 上下文就是 53.7GB 主 KV。索引器缓存只有 21 层写入,每层每 token 约 132 字节(128 字节 FP8 key 加 4 字节 scale),合计 GB。两者相加正好是 56.6GB,这就是第四篇反复提到的“57GB”的由来。
把两种拓扑分开算,结论会完全不同。纯 TP8 下, 的 6144 维归约是 MB,在 NVLink 上约 0.63ms。DP Attention + EP8 下,这部分降到 MB(约 0.33ms),但每层 MoE 多出 dispatch 12.6MB(FP8)与 combine 25.2MB(BF16),75 层合计约 2.83GB,按 787GB/s 约 3.6ms——比纯 TP 的全部归约还大好几倍。所以 EP 从来不“省通信”:它的收益是把 91GB 的专家权重读取摊到 8 张卡、让每张卡少读 7/8 的专家,代价是把 hidden 搬运放进 all-to-all 的 8 倍扇出。判断 EP 是否值得,要看省下的权重读取时间是否超过多出的通信时间;在 decode 这种权重受限的场景里,答案通常是肯定的,在 prefill 这种计算受限的场景里则要看硬件拓扑。而无论哪种拓扑,decode 的通信字节数都随 batch 放大,能重叠的部分决定了它会不会暴露在关键路径上——这也是第一、二篇与第六篇反复强调重叠的原因。
第六篇的三个重叠层次,在总账里落在哪
第六篇把 MoE 通信与计算的重叠拆成三层:combine 与第二个专家 GEMM 重叠、两个子 batch 交替(TBO)、DP gather 与 MoE 的自然交错。放到本篇文章的时间线上,这三层分别改变了通信清单里不同行的时间位置:
- 第一层把 combine 的耗时挪到专家 GEMM 的阴影里,等于把 75 次 combine 的传输时间从关键路径上扣掉一部分;
- 第二层把 batch 一剖为二,让一个子批的 dispatch 与本子批的 attention 交错,代价是每层的通信次数不变、但每条消息量减半;
- 第三层让 DP AllGather 与相邻层的 MoE 共用同一段时间,因为两者访问的是不同的资源(一个读写显存、一个走 NVLink)。
三层的共同前提是:通信账本里的字节数不变,只有“在什么时间窗口里发生”变了。这解释了为什么优化通信首先应该问“能不能藏起来”,而不是“能不能少传”——在 TP8 的 decode 场景里,少传的唯一办法是降 batch,而降 batch 会让权重读取账急剧恶化。
从字节到毫秒:两套硬件下的同一笔账
把字节数乘以带宽倒数就能得到传输时间。下表用两类典型互连给出量级估算(只算单向传输,忽略协议开销):
| 配置 | 每步 TP 通信 | NVLink(ring 有效带宽约 787GB/s) | IB(200Gb/s ≈ 25GB/s) |
|---|---|---|---|
| TP8 | 157 × 6144 × 2 ≈ 1.9MB | ≈ 2µs | ≈ 77µs |
| TP8 | 157 × 256 × 6144 × 2 ≈ 494MB | ≈ 0.63ms | ≈ 20ms |
| EP8 dispatch/combine 单次 | 256 × 8 × 6144 × 3 ≈ 38MB | ≈ 48µs | ≈ 1.5ms |
同一个批大小,在 NVLink 上几乎可以隐藏在计算后面,在 IB 上就必须靠多级重叠(第六篇的三个层次)才能不被暴露。这也是为什么 EP 专家并行必须留在节点内,只有 P/D 分离这类“流量大、频率低”的传输才适合跨节点。
这张表还藏着一个容易被忽略的成本:通信次数本身。每次集合通信都有固定开销——kernel 启动、同步、协议头——在 NVLink 上每次约 3–5µs。 时,仅 TP 的 157 次通信,启动开销就是 0.5–0.8ms,与 1.9MB 的传输时间(2µs)相比高了两个数量级。这就是为什么低延迟场景里,减少通信次数(融合归约、用更大的 reduce 粒度)比减少字节数更有价值;而大 batch 时恰好相反,字节数成了主导。
单请求 decode 的通信量只有 1.9MB,每层两次通信乘上 78 层,kernel launch 与同步开销成为主要成本,CUDA Graph 正是为此存在的;批变大后通信字节线性增长,CUDA Graph 无法消除通信时间,重叠执行才成为关键。两种规模下的瓶颈根本不是同一个东西。
两卡规模的账:TP2 与 TP8 的差别不只是次数
最后看一个常被忽略的小拓扑:TP2。同样的 78 层、同样的字节公式,TP2 每层每请求的消息量()与 TP8 相同,但它只能分给 2 张卡承担;ring 的转发次数则少得多——8 卡的 ring 每卡要转发 7 份,2 卡的 ring 每卡只转发 1 份,单次传输的跳数更短。
两个因素的作用方向相反:TP2 的传输量要摊在更少的链路上,但 ring 的跳数从 7 降到 1;在 NVLink 全连通的 2 卡上,一次 AllReduce 的实际耗时通常在 8 卡的 倍以内,而不是字节数暗示的 4 倍。真正的差距在别处:每卡要存一半权重,KV 被切到 2 张卡上、注意力要跨卡读远端页,显存余量远小于 TP8。
对小集群,账本的结论是:优先用满 NVLink 域内的 TP,把 EP 留给专家权重读取真正成为瓶颈的场景;TP2 的账在 量级上,通信在每步时间中的占比会明显高于 TP8,权重读取每卡翻倍、KV 跨 2 卡读取——三项叠加后,小集群的单请求延迟通常不占优,吞吐劣势更明显。
把时间线换成 CPU 视角:每步的 Python 预算
前面的阶段表按 GPU 执行顺序排列,但对调度器来说,同一段时间线是另一串 Python 调用。每个 decode step,调度进程至少要完成:读取在途反馈、更新每条请求的已生成 token 数、把完成的请求移出、调用调度器选批、调用块管理器分配页、构造输入张量、发起前向、等待结果、把结果送回 TokenizerManager。
这些调用在 GPU 前向期间可以并行准备(SGLang 的 overlap 调度把“下一步的调度”放在“本步前向”的同一时间窗口里),但它们的 CPU 总耗时必须小于本步的 GPU 耗时,否则 GPU 会空转等 CPU。一次前向 3ms、每步调度 1.5ms,看起来还有余量;但 batch 越大、每条请求的记账越复杂,调度时间会线性增长,在 batch 翻倍时可能从 1.5ms 涨到 3ms,把余量吃光。
账本上没有这一项,但它决定“GPU 理论吞吐”能不能兑现。这也是为什么在计算通信账之前,通常先用一次 profiling 看 CPU 线程的占用:如果 CPU 在前向期间持续满载,任何 GPU 侧的优化都不会转化为吞吐。
算例:batch 32、128K 上下文的单步分解
把上面的账本套到一个具体配置:TP8 + EP8 + DP Attention,batch 32,每条请求 128K 上下文,decode 一步。各项开销如下(带宽按每卡 4.8TB/s HBM、787GB/s NVLink 有效带宽):
| 项目 | 字节/次数 | 单步时间 | 占比 |
|---|---|---|---|
| DP AllGather + ReduceScatter | 61MB,156 次 | 约 78µs + 0.8ms 启动 | 约 4% |
| DeepEP dispatch + combine | 339MB,150 次 | 约 0.43ms | 约 2% |
| 主 KV 读取 | 92MB/token × 32 ≈ 2.9GB | 约 0.6ms | 约 3% |
| 索引器读取(128K) | 352MB/token × 32 ≈ 11.3GB | 约 2.4ms | 约 10% |
| 权重读取(专家 91GB + 复制部分约 18GB) | 每卡约 109GB | 约 23ms | 约 85% |
| LM Head gather | 约 17MB | 约 20µs | 忽略 |
这张表给出的结论很直接:128K 上下文的 decode,时间主要花在把权重从 HBM 读进 SM,而不是花在通信上。 通信、KV 与索引器读取加起来不到 15%,即使把它们全部重叠掉,也只能改善这一小部分。这也是为什么第一篇说 MoE 推理的优化重点是 EP、FP8 与 EPLB——把 91GB 摊到 8 张卡、压成 FP8、让每张卡只读被路由到的专家,才是数量级的优化。
换成 1M 上下文,KV 读取仍是 92MB/token(Top-2048 不随上下文变),索引器读取涨到 2.8GB/token;若 batch 被压到 4,索引器读取约 11.2GB/步,仍在权重读取之下;但单请求的页面占用已经让 batch 无法再大。此时瓶颈从“权重读取”变成“KV 容量”,页分配与并发数成为第一约束——账本的三本账里,权重账是常数,KV 账是容量,只有索引器账随上下文增长,三者谁先撞墙取决于部署参数。
为什么“每步稳定”是 decode 账本最重要的性质
decode 的账本能成立,依赖一个前提:每步的字节数与算子数大致不变。每条请求每步只新增 1 个 token,层数固定 78,TP 通信每层一次,权重读取一遍;变化的只有 KV 的地址和页表,而字节数不变。
这个稳定性带来了三个直接的设计结果:
第一,CUDA Graph 可以按 batch 分桶重放,因为形状稳定;第二,连续批处理可以把不同请求塞进同一批,因为每步成本与 batch 近似线性,让权重读取摊薄;第三,性能曲线可以用“每步时间随 batch 的斜率”来描述,而不需要为每个上下文长度单独建模。
prefill 没有这个性质:每块的前缀长度不同,索引器成本随之变化;所以 prefill 的账本必须按块号逐块计算,不存在一张“每块恒定”的表。这也是为什么调度器对 prefill 与 decode 采用不同的预算方式:decode 按“每请求 1 token”记账,prefill 按“本步可算多少 token”切块。
输出侧:GPU 之外的两笔账
时间线的最后三段(LM Head、采样、反分词与回传)常被当成“前向之后的尾巴”,实际各有独立的预算。
LM Head 的 gather。 词表 154,880 按 TP8 切开,每个 rank 只有 19,360 行;采样器要看到完整分布,必须把各 rank 的 logits 拼起来。 时这一步约 102MB,按 787GB/s 算约 0.13ms; 时只有 8.5MB,几乎可以忽略。小 batch 低延迟场景很少把词表 gather 当瓶颈,大 batch 吞吐场景则要认真对待——这也是为什么有“先局部 top-k、再全局合并”的优化思路:通信量从 降到 ,代价是要正确处理 top-p 的全局累积概率。
反分词的 CPU 账。 单请求单步的增量解码只要几十微秒,但 detokenizer 通常只有少量线程,所有请求的文本都要经过它。一个 64 请求的 batch、每步 20 个字符,就是 64 次 decode 调用;每步 3ms 时,这部分 CPU 占用会迅速接近一个核。SGLang 把反分词放到独立进程、按批次分组调用,vLLM 在前端进程用 OutputProcessor 一次循环处理整个 batch,两者共同点是批量化——逐请求起线程或加锁的实现,在吞吐场景下会先崩。
KV 回收的 CPU 账。 请求结束后,前缀缓存不是“立即释放”,而是“延迟释放”:块进入缓存树,引用计数归零后才回到空闲队列;一个 100K token 的请求按 64 token/块算有 1563 个块(按满块计),每块一次哈希或比较,单请求就是上千次 CPU 操作。它与调度器主循环竞争 CPU,是“GPU 没满、吞吐上不去”的常见原因之一。
单位 token 的边际成本:三本账的切换点
decode 阶段每生成一个 token,真正的成本可以分成三本账:通信账、权重读取账、KV 与索引器读取账。三者随 batch 的变化规律完全不同,混在一起谈“每 token 成本”就会得出错误结论。
通信账。 一次 decode step 搬多少字节,等于“每个 token 的通信量 × batch”。摊到单个 token 上:纯 TP 下约 MB;DP Attention + EP 下,6144 维 hidden 的归约约 MB,MoE 的 dispatch 与 combine 合计约 MB。这个每-token 成本与 无关——batch 增大只会让一步搬得更多,不会让单个 token 的通信变便宜。连续批处理真正摊薄的是权重读取,不是通信。
权重读取账。 每个 decode step 要读一遍权重,但要读多少取决于这张卡上存了哪些专家、这一步被路由到了多少个。按第一篇的估算,EP8 下每卡专家权重约 91GB,复制部分再加约 18GB,合计 109GB;一个 batch 足够大、每个本地专家都被触发时,单卡要把这 109GB 从 HBM 读一遍。H200 的 HBM 带宽约 4.8TB/s,理论下限约 23ms,也就是单卡最多约 44 个 step/s。摊到每个 token: 时约 3.4GB/token、 时约 425MB/token——这是唯一随 batch 线性摊薄的账,也是连续批处理存在的原因。batch 很小时只有少数专家被触发,读取量按触发的专家数下降,这条“下限”并不成立;所以权重账要按“被触发的专家权重”计,而不是按 40B 激活参数的名义值计。
KV 与索引器读取账。 这是唯一随上下文长度增长的账。主 KV 在 decode 时按 Top-K 选中的条目读,Top-K 固定在 2048 量级,所以主 KV 读取不随上下文增长;但索引器要对整段上下文的每个页打分,读取量随 线性增长。第一篇给过一个实例:128K 上下文时主 KV 读取约 92MB/token,索引器读取约 352MB/token;到 1M 时主 KV 仍是 92MB 量级,索引器却涨到约 2.8GB/token。按每卡 4.8TB/s 折算,仅索引器读取在 1M 时就是约 0.6ms/token,且不随 batch 摊薄——它与权重读取的区别是:权重读取被 batch 摊薄,索引器读取不会。
三本账的切换点解释了为什么 GLM-5.3 的优化重心随场景变化:短上下文、大批量时,权重读取被摊薄后通信与索引器可能变成瓶颈;长上下文时索引器读取压过一切;Prefill 的 1M 请求则同时受制于索引器的二次方项与 KV 写入。
batch 的上限。 权重账靠 摊薄,但 不是想开多大就多大:它受 KV 池容量约束。1M 上下文的单条请求就占 53.7GB 主 KV 加 2.9GB 索引器缓存;装完 744GB 权重后,8 卡 H200 能留给 KV 的余量通常在 250GB 左右,只够 4 条 1M 请求同时持有 KV。长上下文场景下,权重账摊不开,通信与索引器读取又省不掉——这解释了为什么 1M 上下文的 decode 吞吐远低于同参数量的短上下文模型。
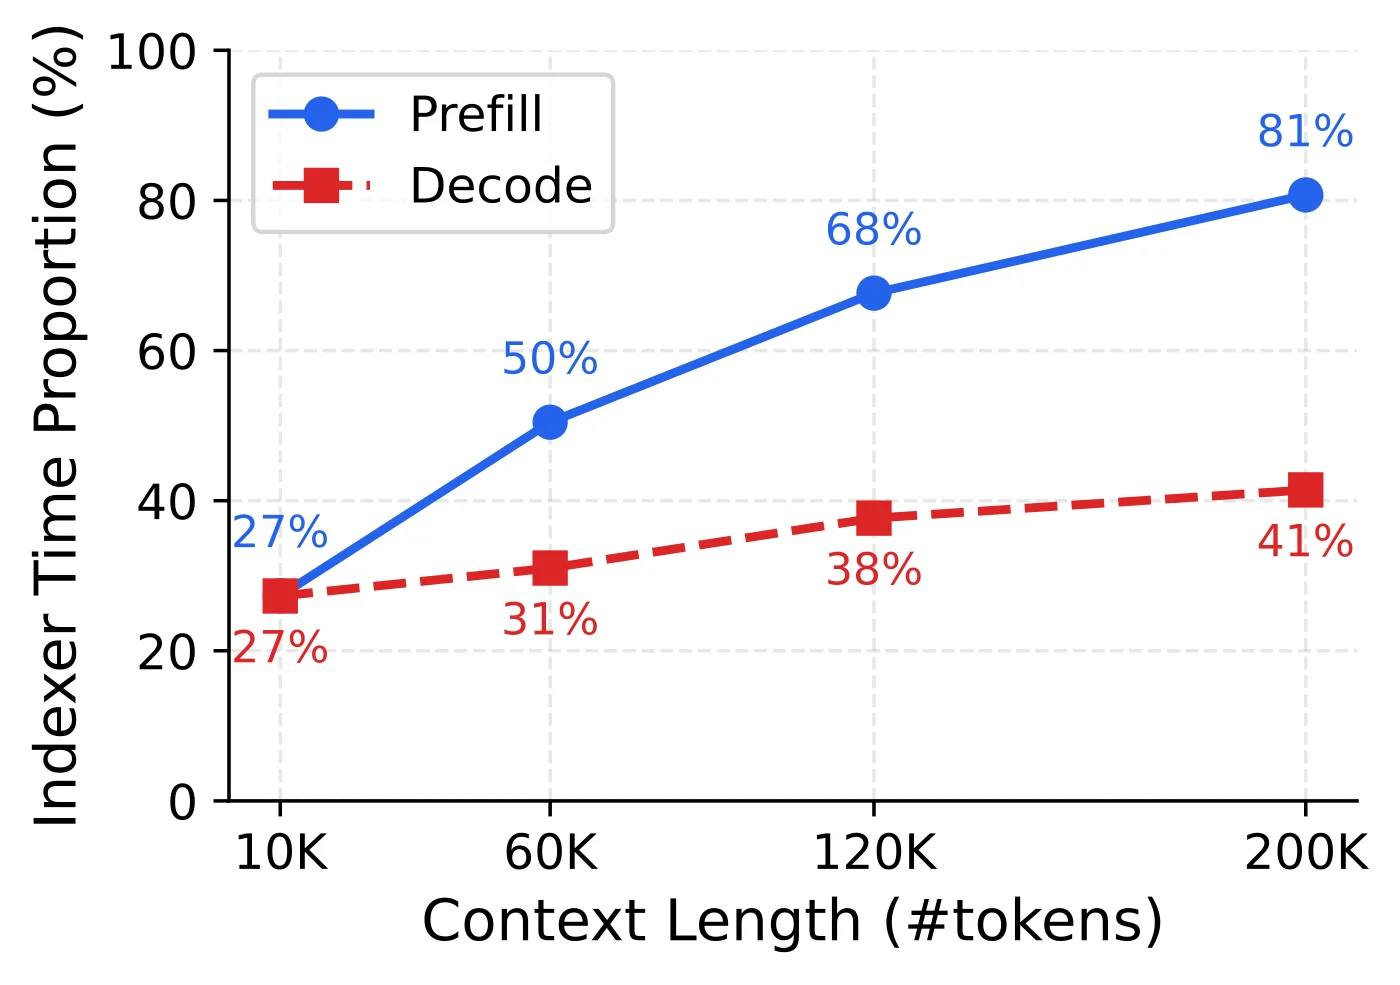
这三本账的切换点解释了为什么 GLM-5.3 的优化重心随场景变化:短上下文、大批量时关心权重读取与 TP 通信;长上下文时索引器读取压过一切;Prefill 的 1M 请求则同时受制于索引器的二次方项与 KV 写入。
拓扑对账本的重塑
同一张通信清单,在三种典型部署下的样子完全不同:
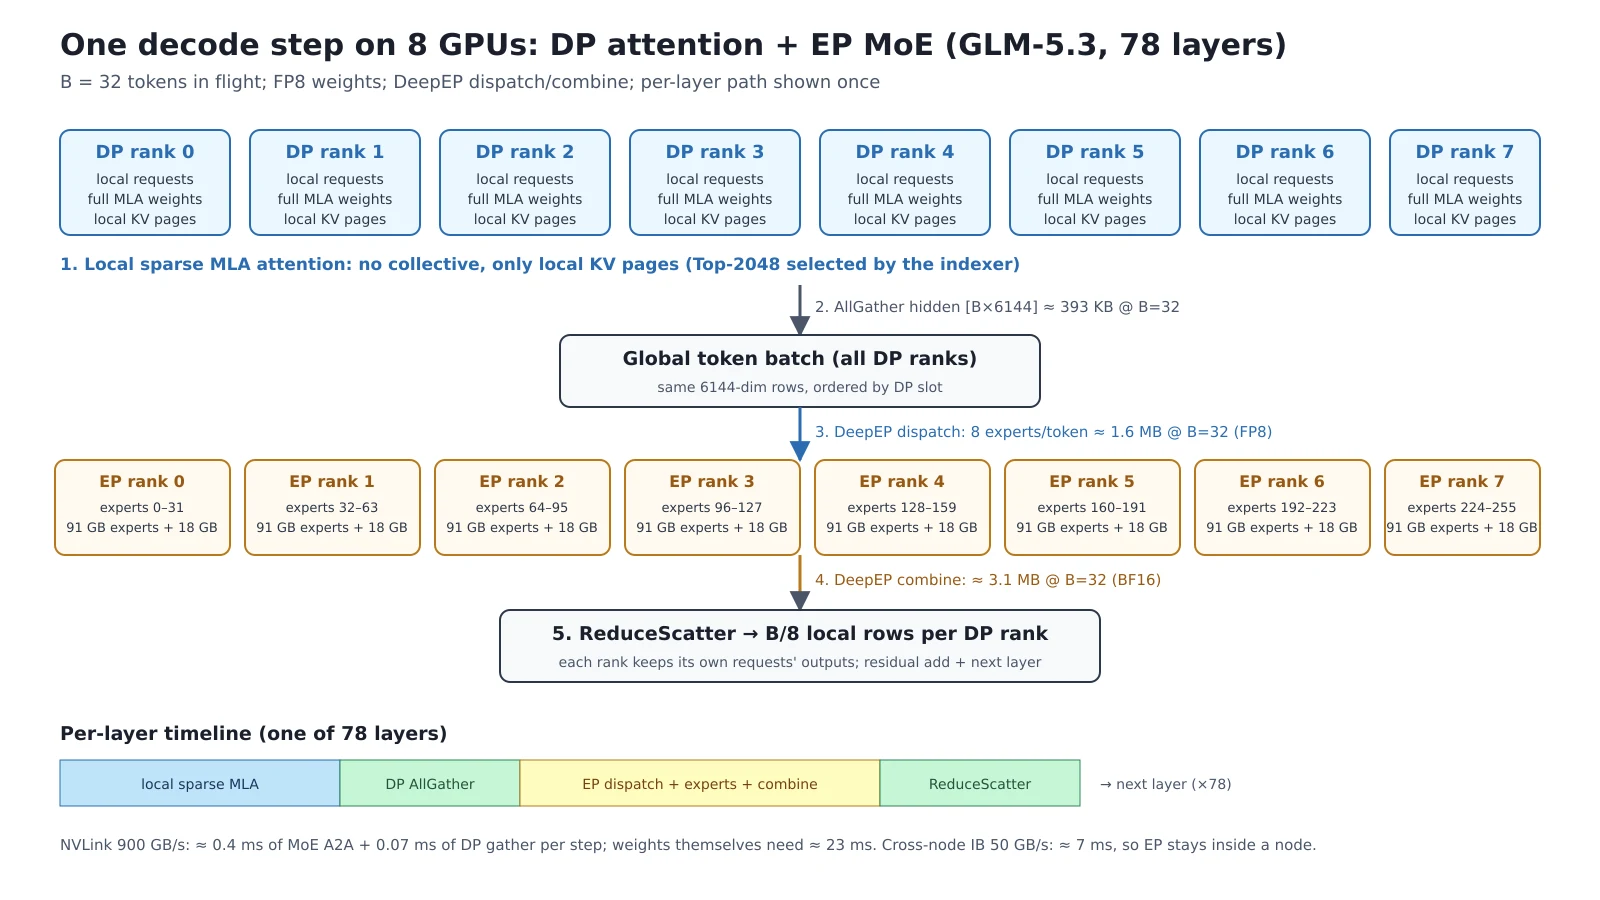
纯 TP 每层两次通信,最简单;但 744B 权重在多卡上按列/行切分,每卡仍要存全部专家的一部分,KV 也被切分到 8 张卡上,MLA 的 576 维潜向量在解码时要跨卡读取。TP + EP 把专家切开,注意力仍按头切分,每层仍是一次 o_proj 归约。DP Attention + EP 把注意力完全复制、按请求分片,代价是每层一次 AllGather + ReduceScatter,收益是注意力没有 TP 通信、KV 按请求本地化、前缀缓存更自然。
几种拓扑之间的取舍也可以用账本来判断:如果瓶颈在 TP 通信(纯 TP 下每层两次全卡 AllReduce),DP Attention + EP 用“注意力不走 TP”换掉了注意力侧的全部跨卡通信;如果瓶颈在专家权重读取,EP 把 724B 路由专家摊到 8 卡,每卡只读约 91GB。两者解决的问题不同,所以生产部署通常同时开启,代价是每层多一次 DP gather/scatter——这在 NVLink 上是可重叠的,在 IB 上是不可接受的。
对 1M 上下文,DP Attention 还有一层隐性收益:每张卡只保留自己请求的 KV,不需要为了 TP 切分把一份 KV 分散到 8 张卡上再跨卡读。MLA 的 KV 读取量是 decode 带宽开销的主要来源之一,本地化能显著减少跨卡流量——这正是第三篇讲上下文并行时要处理的同一类问题,只是从“切 query”变成“切请求”。
PD 分离则是另一种重塑:prefill 实例与 decode 实例的拓扑可以不同。prefill 关心长 chunk 的通信与索引器计算,decode 关心权重读取与 KV 本地化,两套配置可以各自调优,中间只承担 57GB 的一次性传输。
一个请求的生命周期:账本按阶段切换
把同一张账本按请求生命周期的阶段切开,可以看到每个阶段用的其实不是同一套账:
冷启动阶段(请求进入、首次 prefill):账本以索引器二次方项与 KV 写入为主,TP 通信占比低,瓶颈是索引器读取带宽与 KV 写入带宽。一条 1M 请求要几十秒,主要时间不在 GPU 算力上,而在 HBM 的读写循环上。
长 prefill 阶段(分块推进):账本随块号变化。前几个块索引器前缀短、计算量小,耗时被主干的线性项主导;后面几十个块,索引器前缀逼近 1M,索引器读取成为主导。如果把各块耗时画成曲线,会看到一条逐渐上翘的曲线,而不是一条水平线。
decode 阶段(首 token 之后):账本切换到“每步恒定”的形态——权重读取、TP 通信、KV 读取组成一个基本稳定的每步成本;唯一变化的是 KV 地址与页表,字节数不变。这个阶段的时间稳定,是缓存与连续批处理设计的基础。
收尾阶段(请求结束、KV 回收):账本切换到 CPU 侧——前缀树插入、页引用计数、反分词输出。GPU 上没有对应字节,但 CPU 开销可能比 decode 的一段更长。
这四个阶段对应四种完全不同的瓶颈。同一个优化对它们的效果可能相反:增大 batch 对 decode 有利,对长 prefill 会加剧 KV 预算冲突;延长前缀缓存对冷启动无效,对 decode 也不产生额外收益。用账本做规划时,先问“要优化的是哪个阶段”,比问“哪一项字节最多”更有效。
数字从哪里来:一手与二手的分界
本文引用的数字有三类来源,口径不同,混用会算错账。
模型常量:744B-A40B、78 层、256 专家激活 8 个、1M 上下文、词表 154,880、隐藏维 6144,来自模型卡与 config.json,可以直接当作事实使用。
布局常量:656 字节、132 字节这类每 token 每层的字节数,来自推理框架的 KV 布局定义(fp8_ds_mla、索引器缓存 spec)。它们随后端变化——换成标准 fp8_e4m3 就是 576 字节,换成 nvfp4_ds_mla 是 352 字节;引用时要说清楚用的是哪一种,否则同一篇文章里会出现互相矛盾的“每 token KV 大小”。
性能量级:19ms、55–65 秒这类时间估计,来自公开硬件规格的算术推导,而不是实测。它们用于判断瓶颈落在哪一类资源上,不适合直接当作 SLA 数字;真正的部署时间必须在目标硬件上测一遍,因为有效带宽、ring 效率、kernel 效率都与理论值有系统性差距。
把这三类分开标注,是账本能被复用的前提:常量可以复制,布局必须指明后端,时间只能作为量级参考。
CUDA Graph 在账本里的位置
前七篇多次提到 CUDA Graph,但它不在上面任何一张字节表里。原因是它不改变字节数,只改变“每次 kernel 启动的固定开销”和“CPU 构造输入的耗时”。
对 decode 的 78 层、每层十几个算子,eager 模式下每步有上千次 kernel launch,每次 3–5µs,累计 3–5ms,与计算时间同量级;CUDA Graph 把整图捕获后,一次 replay 只有一次启动。对 batch 1 的低延迟场景,这是数量级的改善;对 batch 256 的吞吐场景,计算与通信时间变大,启动开销的占比下降,但图仍然能省掉 CPU 构造 InputBatch 的时间,避免 CPU 成为瓶颈。
图也有代价:形状必须静态。batch 变化要分桶,序列长度变化要靠 padding,超出桶的请求回退 eager。账本上这体现为“同一份字节数,在桶内与桶外走两条时间线”;做容量规划时,必须把回退比例算进去,否则理论吞吐会被高估。
索引器的两笔账:跨层复用省了什么、没省什么
一次 decode step 里,21 个 full 层自己做索引器打分,57 个 shared 层复用同一个索引组产出的 Top-K。这一步省掉的是“打分 GEMM 与 Top-K 选择”的计算:如果 78 层全部独立打分,索引器计算量会是现在的约 3.7 倍。
复用的关键在“复用的是下标,不是权重”。索引组里存的是 logical_topk_indices 与换算后的 physical_topk_indices,shared 层拿着同一组下标去取自己的 KV——每层的 MLA 潜向量不同,所以 KV 仍要各自读取,省掉的是打分那一步。vLLM 把这件事做成了一个运行时对象 SparseMLAIndexGroup,换算到物理槽位安排在另一条 CUDA 流上,用事件与主计算流同步,让 shared 层在拿到下标后立刻开始稀疏 MLA,而不等换算完成。
这笔账在长上下文下的规模:索引 K 每 token 每层 128 字节(加 4 字节 scale),1M 上下文时每层约 132MB,full 层合计约 2.8GB 缓存。复用省下的计算虽然接近四分之三,但共享层依旧要读取自己的 KV,所以索引器的带宽账并没有被同比例削减。这也是为什么索引器缓存要单独列入 PD 传输的 56.6GB;它是独立的一份存储,不属于主 KV。
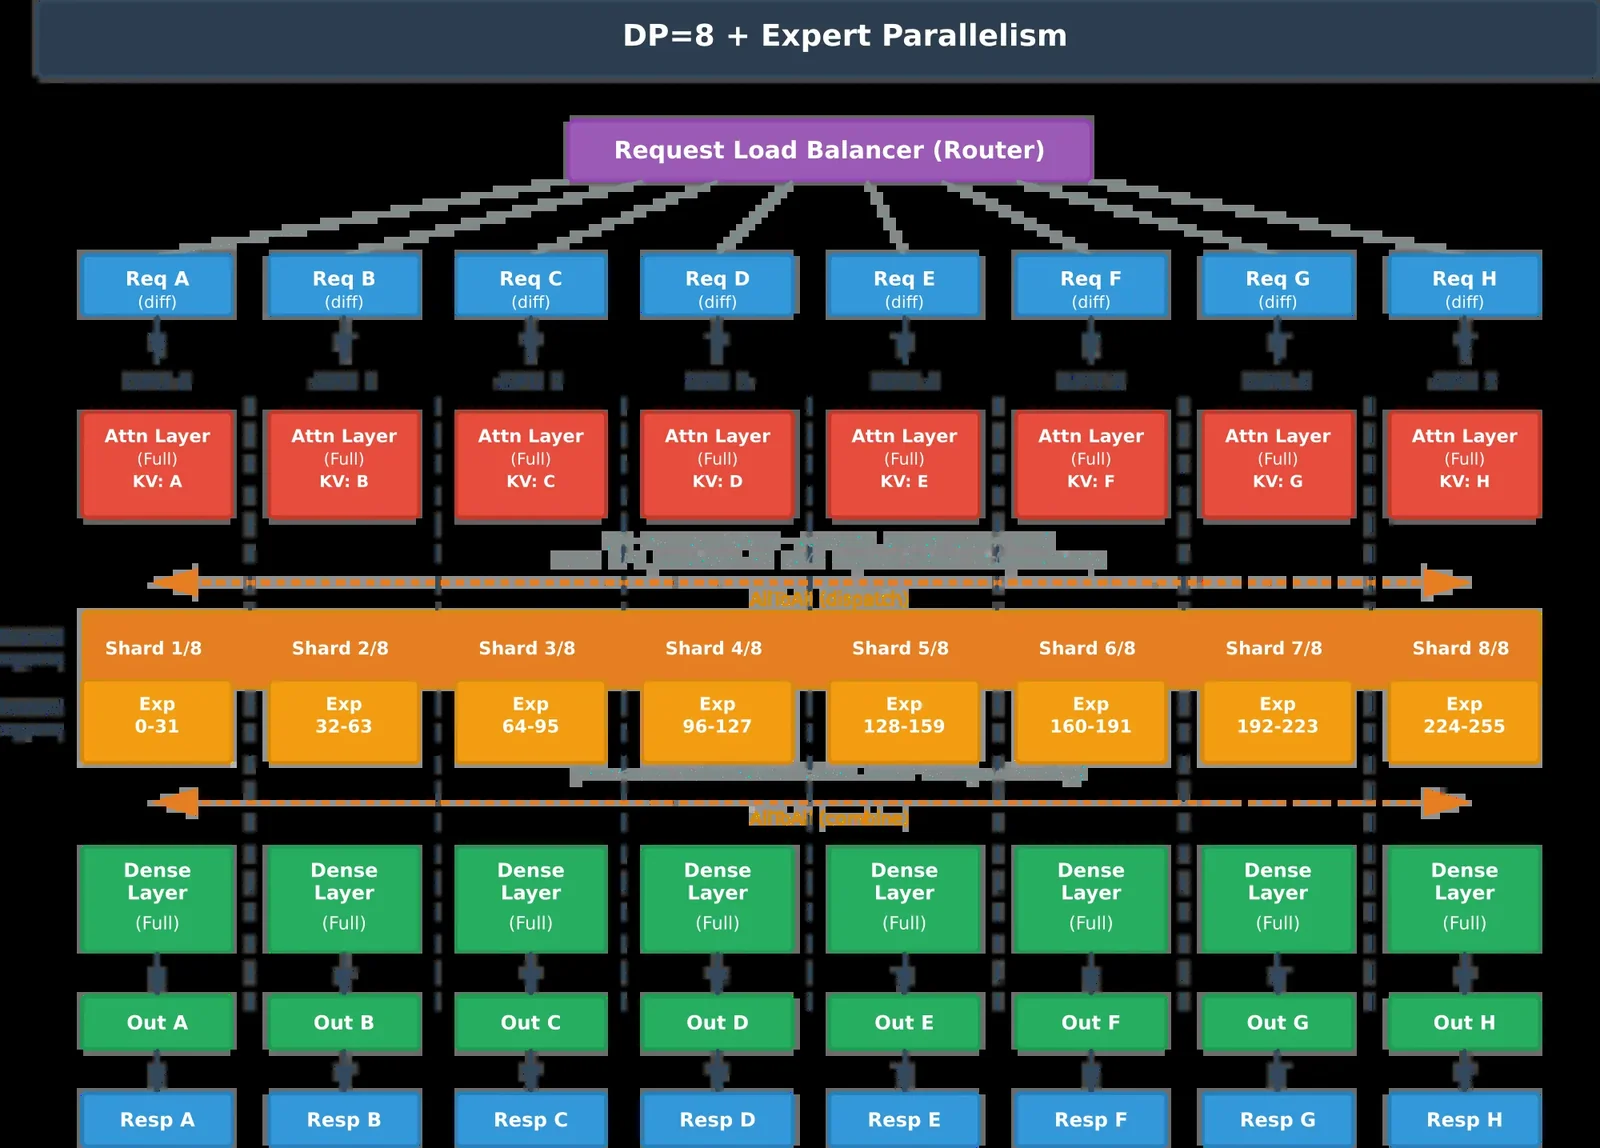
批内异构:一条 1M 请求混进 decode batch
线上服务最常见的麻烦不是纯 prefill 或纯 decode,而是一条超长请求混进短请求的批里。调度器要保证这条 1M 请求不被饿死,又不能让短请求被它拖慢;SGLang 在等待队列里给长请求保留位置,并按剩余未算 token 调整它在每步中的预算;vLLM 则用 long_prefill_token_threshold 限制长请求每步最多吃多少。
账本上,这意味着同一个 step 同时走两条路径:短请求做 decode,长请求做 prefill。两者的 kernel 形状不同,合在一次前向里要么共用一种形状(短请求被 padding 到 prefill 的形状,浪费计算),要么分包执行(GPU 利用率低)。SGLang 的混合调度与 vLLM 的 chunked prefill 都是在处理这件事;账本给出的判断是:经验上,当长请求的剩余 token 超过批内其他请求总和的数十倍时,混合的调度收益会被形状不匹配抵消,让长请求独占一步反而更稳。
一次 1M prefill:同一张表换成 prefill 的列
decode 的账是“每步乘 78 层”,prefill 的账则是“每块乘 78 层,再乘块数”。以第三篇的算例为基准——1M 上下文、单请求、SGLang 32768 一块、共 32 块——把 prefill 的清单按块拆开:
| 项目 | 每块 | 32 块合计 | 主导因素 |
|---|---|---|---|
| 主干 GEMM(注意力加专家) | 约 3.1 PFLOP | 约 100 PFLOP | 与 token 数线性 |
| 索引器打分 | 随块递增,最后一块最贵 | 约 94 PFLOP | 与 token 数的平方成正比 |
| 索引器 K 读取 | 随前缀长度递增 | 约 47TB | 与 token 数的平方成正比 |
| 主 KV 写入 | 32768 × 78 × 656 ≈ 1.7GB | 约 53.7GB | 与 token 数线性 |
| TP AllReduce / ReduceScatter | 每层两次,共 156 次 | 156 × 32 次 | 与 token 数线性 |
| dispatch / combine | 75 层 × 2 | 75 × 2 × 32 次 | 与 token 数线性 |
这张表里唯一按平方增长的是索引器的两行:打分 FLOPs 与索引 K 读取。主干 GEMM、KV 写入和 TP 通信都是线性的,所以 1M prefill 的耗时曲线是“越往后越慢”,而不是均匀的 32 份。
把 FLOPs 换算成时间,主干约 100 PFLOP、索引器约 94 PFLOP,合计约 194 PFLOP;8 张 H200 的有效算力在 10–12 PFLOPS 量级,纯计算下限 16–20 秒。但索引器是带宽受限的:它的读取量按缓存布局计算约 47TB,按每卡 4.8TB/s 分摊到 8 卡,理论下限也在秒级;两者叠加后,实际 TTFT 落在几十秒量级,这正是第三篇给出 55–65 秒估算的原因。
与 decode 对照,prefill 的通信账其实“更好摊”:32768 个 token 一个 chunk,每层 AllReduce 的消息量是 MB,156 次合计约 63GB,但它分散在几十秒的计算里,NVLink 的占比很低。prefill 的真正瓶颈是索引器的平方项与 KV 写入带宽,而不是集合通信——这和 decode 刚好相反,decode 的瓶颈是权重读取与每层通信的启动开销。
KV 布局如何进入账本:656 字节之外的两个开销
fp8_ds_mla 的 656 字节是“逻辑字节数”,实际访问时还有两项账本之外的开销。
scale 的读取。 每个 token 自带 4 个 FP32 scale(16 字节),与 512 字节的 FP8 数据交错存储;内核读 KV 时必须同时取到两者才能反量化。这意味着每次读 KV,实际从 HBM 搬的不止 512 字节的数据,还有这 16 字节的 scale,以及为定位 scale 多做的一次地址计算。页内 64 个 token 的布局固定,地址计算可以预先烘焙进块表,所以这部分开销在稳态下很小,但它是 656 这个数字里不可忽略的 2.4%。
RoPE 部分不量化的代价。 64 维 RoPE 留 BF16 是 128 字节,占总字节的近五分之一;相比全部 FP8 的 576 字节布局,RoPE 从 64 字节变 128 字节、加上 4 个 scale 的 16 字节,合计多 80 字节。为什么值得多花这 14%?因为 RoPE 是对角旋转,量化误差会变成角度误差,在长上下文的位置判别里被放大;留在 BF16 省掉的是每次注意力都要做的反量化步骤。账本上的字节数多 64 字节/token/层,但内核里少了一步反量化——这是“空间换时间”的又一例,与前面 NVLink 与 IB 的取舍属于同一类判断。
前缀缓存命中如何改写账本
上面的账都假设请求是全新的。真实服务里相当比例的请求带有共享前缀——系统提示、工具定义、多轮对话的历史——前缀缓存命中后,这部分 token 的 prefill 不再发生。
在账本上的体现是三个阶段被跳过:
- 阶段 5–6 里,命中部分的 token 不做前向,只做“引用已有 KV 页”:块管理器把命中前缀的物理页引用计数加一,新请求的页表直接指向这些页;
- 阶段 3 的 token 预算只计算未命中的后缀,一条 20K prompt 命中 19K 前缀时,本次 prefill 的 token 数变成 1K;
- 阶段 6 的索引器也不对命中前缀重新打分——索引器缓存与主 KV 一样落在页池里,命中时其下标可直接复用。
命中本身也有成本:块管理器要在 CPU 侧按每个满块(64 token)做哈希并查树,一个 19K 前缀的命中对应接近 300 次哈希比较;这部分成本通常小于重算,所以在重复前缀率高的场景里缓存几乎总是划算的。但它会把 CPU 时间推到调度器主循环上,这也是为什么在“高命中率、低延迟”的在线场景里,常见现象是 GPU 很闲、CPU 先撞顶——账本上的字节数下降了很多,CPU 侧的操作数却没降多少。
同一份字节数,两个方向看
同一次通信,站在发送方和接收方看到的字节数并不相同。ring AllReduce 分 reduce-scatter 与 allgather 两阶段,每张卡每阶段发送 份数据、接收同样多,合计 份;而 EP 的 dispatch,发送方按 8 个专家算,接收方按路由到本地专家的 token 算。账本里的字节数以“发送总量”为准,是因为带宽是被发送侧打满的;但延迟要按“最慢的接收方”算,因为一个接收方慢,整条 ring 都要等它。
这一点在 heterogeneous 部署里尤其重要:PD 分离时,prefill 实例与 decode 实例的 GPU 型号可能不同,HBM 带宽不一致,KV 传输的瓶颈落在慢的那一端;EP 跨节点时,每条链路的 IB 带宽与延迟也不一致。账本只能给出总量,最慢链路需要额外测一次——这也是为什么第六篇列了“失败模式”一节:账本没覆盖的恰恰是最难调的那部分。
把账本用于排障:四个可以立刻套用的判断
账本的价值不在数字本身,而在它能给出一组“先查什么”的判断顺序。
GPU 利用率高、吞吐却低于账本预测。 先查 CPU 侧:调度器每步的 Python 时间、反分词是否批量化、输出回传是否逐请求阻塞。GPU 侧账本算得再准,只要调度器喂不动 batch,账本都不会兑现。第一阶段和最后几段都是 CPU 侧的账,它们不出现在 GPU 侧的表格里,却是吞吐的常见天花板。
TTFT 随 prompt 长度超线性增长。 先查索引器:prefill 的索引器打分与索引 K 读取都是二次方项,1M 请求里跨块项占了 97%。如果 TTFT 曲线在大 prompt 处明显上翘,说明瓶颈在索引器而不是主干 GEMM,优化方向是分块策略与索引器的 q-chunk 切分,而不是增大 batch。
decode 每 token 时间随上下文变长。 先查索引器读取:主 KV 只在 Top-2048 的条目上读取,不随上下文增长;索引器却要对整段上下文打分。如果单请求时间随上下文近似线性上升,说明索引器读取已压过权重读取,此时跨层复用与 Top-K 规模的选择比调 batch 更有效。
命中率很高、GPU 却很闲。 先查前缀缓存的 CPU 成本与反分词线程:字节账下降不等于操作数下降,调度器与块管理器的 CPU 往往先于 GPU 撞顶。
三块尚未单独展开的地方——索引器缓存的跨层读取带宽、页粒度在大量短请求上的碎片率、调度器 CPU 与 GPU 的两套预算——都恰好是上面这些判断的下一层追问。它们适合作为后续各拆一篇的对象。
账本的边界
这张账本只覆盖推理路径,它有意忽略了三类东西:一是编译期开销——torch.compile 与 CUDA Graph 捕获发生在服务启动时,不进入每步账本,但它们决定了哪些融合能生效;二是首次请求的冷启动——JIT、图捕获、KV 池初始化都不在稳态吞吐的账本里,却决定了第一条请求的 TTFT;三是容错与恢复——专家掉线、请求抢占、PD 传输失败后的重算,都属于“账本之外的账”。
把这些排除在外不是简化,而是划清口径:账本描述的是稳态、健康、满负载下的一次请求,只有当服务确实处在那个状态时,账本才可以直接拿来对账。
小结
GLM-5.3 的一次请求在前七篇里被拆成了入口、decode、vLLM 对照、prefill、PD、MoE 通信、输出七段。本篇把它们按真实执行次序压回一条时间线:十个阶段、十五条算子、八类集合通信、三本边际成本账。整条链路的关键数字——656 字节、132 字节、57GB、494MB/步——全部可以从模型常量表重新算出来,框架决定的是融合边界与重叠方式,模型决定的是字节数本身。把账本放在一张表里之后,定位瓶颈只需问两个问题:这一步批量多大,时间主要花在字节搬运还是 FLOPs 上。
参考资料
- GLM-5: from Vibe Coding to Agentic Engineering(GLM-5 技术报告,arXiv:2602.15763)
- zai-org/GLM-5.3 模型卡
- SGLang GLM-5.3 Cookbook
- SGLang 源码:deepseek_v2.py
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(arXiv:2512.02556)
- IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse(arXiv:2603.12201)
- DeepEP:MoE dispatch/combine 通信库
- FlashMLA:MLA 解码内核
- vLLM GLM-5.3 部署配方
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



