


GLM-5.3 推理全链路(十九):负载账本与慢 rank——路由把请求分给谁,谁就决定下一步的时钟
这一篇接在哪
前十八篇沿着一条 GLM-5.3 请求,把 GPU 上的 78 层、跨卡的四类集合通信、PD 分离的数据面与控制面、MTP 的三段前向,以及 CPU 侧的重叠调度都拆开看了一遍。那些账本有一个共同的前提:这条请求落在哪一个 rank 上,是给定的。第三篇算分块预填的预算,按「一个 prefill 实例」算;第六篇算 DeepEP 的 dispatch 字节,按「EP 组内每张卡收多少 token、按最慢的接收方计」,却没有问这批 token 是从哪几条请求来的;第十六篇算一条 decode step 的 kernel 数,按「batch 32、每卡 4 条请求」算。账本里没有出现的问题是:这 4 条请求为什么是这 4 条?如果同一时刻某张卡上堆了 12 条、另一张卡上只有 2 条,账本会变成什么样?
对 GLM-5.3 这种部署形态,这个问题不是边角料。SGLang 文档给出的 DPA + EP 推荐形态是 --tp 8 --attn-dp-size 8 --ep 8(GLM-5.3 还要在此基础上打开 DSA 与 MTP 的开关,第三篇列过完整命令):注意力按请求分片到 8 个 DP rank,每个 rank 只算自己那几条请求的 DSA 与 MLA,各自维护自己的 KV Cache;但每层 MLP 之前要把 8 个 rank 的 hidden state 按全局 token 数拼起来(dp_gather),MoE 之后再按归约结果散回去(dp_reduce_scatter)。这两次集合通信的执行时间,按 8 个 rank 里最慢的那个 计时;而一个 rank 的快慢,直接取决于它手里有几条请求、这些请求的上下文有多长。于是「路由把请求给谁」这个发生在 CPU 上的决策,会通过每层两次的集合通信,变成 GPU 上一条所有 rank 都要等的时钟。
这一篇要回答的就是这一段:负载账本从哪里来、路由怎么据此分配请求、账本失真时会发生什么,以及当某张卡真的慢下来时,延迟怎样从一张卡扩散成全服务的尾延迟。前十八篇把「请求经过哪些算子、哪些通信」讲完了,这一篇补的是「这些算子和通信在哪个 rank 上发生,以及为什么是那个 rank」。
关于与第十八篇末尾预告的关系:那一篇写「下一篇将讨论进程间的那一段控制面」。逐条走完 tokenizer 进程、router、EngineCore 与前端之间请求路径的是第十篇与第十三篇;本篇不再重复消息怎么走,而是只看控制面里 与负载有关的那几条通知——负载快照、健康检查、调度统计,以及它们如何在时间上失真。
先把「慢 rank」这件事定义清楚
「慢」有三种完全不同的含义,混在一起谈会得出错误结论:
- 单点慢:某个 rank 的硬件或进程状态异常,比如某张卡降频、某条 NVLink 链路劣化、某个进程被其他任务抢了 CPU。这种慢是持续的、与请求无关的。
- 负载慢:所有 rank 的硬件一致,但请求分配不均。手里有 12 条请求的 rank,每步要读 12 条请求的 KV、算 12 条请求的注意力,自然比只有 2 条请求的 rank 慢。这种慢是瞬时的、与路由决策直接相关。
- 结构慢:慢来自并行策略本身。比如 EP 组内某个专家的 token 数远高于其他专家(专家热点),或者 MoE 的 dispatch 在某个接收方排队。这种慢与「哪张卡」关系不大,而与「这一批 token 的路由结果」有关。
三种慢在集合通信里的表现是一样的:所有 rank 等最慢的那个。但它们的解法完全不同——单点慢要换卡或隔离节点,负载慢要改路由与调度,结构慢要改并行布局或加冗余专家。负载账本只能解决第二种,而它恰好是最常见、也最容易被观测到的一种。
先给一个量级,而且要区分「总量」与「本地时间」。第十六篇算过 GLM-5.3 在 batch 32、8 卡 DP Attention + EP8 下一次 decode 的 GPU 侧时间约 30ms,其中 MoE 的权重读取约 19ms。这 19ms 是 gather 之后、所有 rank 都要读的全局权重总量——dp_gather 把 8 个 rank 的 hidden 拼成全局 batch,MoE 的权重读取量取决于全局 token 数而非某个 rank 的本地 token 数,所以 MoE 这一段的耗时对负载偏斜 不敏感:rank 之间怎么分,总 token 都是 32 行,权重都要读一遍。
真正对偏斜敏感的是 gather 之前的本地注意力。设正常时每卡 4 条请求、本地注意力 2ms;若某张卡堆到了 12 条,它的本地注意力按行数与 KV 读取量大约涨到 6ms,而其他 7 张卡只用了 1ms。此时 dp_gather 要等多 5ms,78 层累计约 390ms:一条 decode step 从 30ms 量级变成 400ms 量级。这个放大不是线性的百分之几十,而是「层数 × 每层等待」。反过来,如果偏斜发生在 token 层面(比如某卡多了一条 100K 上下文的请求),那么它对 MoE 的总量也有影响,但影响是加性的——全局多出 1 行 token,MoE 多读一行,而不是某张卡单独拖住所有人。
这两者的区别决定了排障方向:本地注意力偏斜会通过 gather 变成全员等待,MoE 总量增加只是匀速变慢。下面所有关于「慢 rank」的讨论,默认都是前者。
部署拓扑:谁在给谁分请求
先把参与者摆清楚。GLM-5.3 的单机 8 卡部署下,一条请求在到达 GPU 之前要经过三个可能做「分配」决策的地方:
- 前端 router(SGLang Router,或多 tokenizer 模式下的主进程)。若部署了多个 worker(多机、或多实例),router 决定这条请求去哪个 worker。router 能看到的是每个 worker 通过 HTTP 暴露的负载指标。
- DataParallelController(DPC)。单机 8 卡、
attn_dp_size=8时,DPC 是一个独立进程,从 tokenizer 进程收请求,再按负载均衡策略把请求推给 8 个 DP rank 各自的 scheduler。 - 每个 DP rank 的 scheduler。它决定这一步跑哪些请求、分多少 token 预算、要不要抢占(retract)。这一层不改变「请求属于哪个 rank」,但会改变「这个 rank 这一步有多忙」。
三层里,第二层是 GLM-5.3 特有的、也是本篇的重点:DP Attention 让「请求到 rank 的映射」变成了一个显式的、可配置的决策,而不是 TP 下那种「所有 rank 都算同一批请求」的隐式复制。官方文档对这一点的描述很直接:DPA 让每个 DP 副本「独立处理不同的 batch,可以处在不同的前向模式(prefill、decode 或 idle),并维护自己的 KV Cache」,这也正是它对 MLA 模型收益最大的原因——MLA 只有一个 KV 头,用 TP 切成 8 份时每张卡都存一份重复的 KV,切不出内存收益。
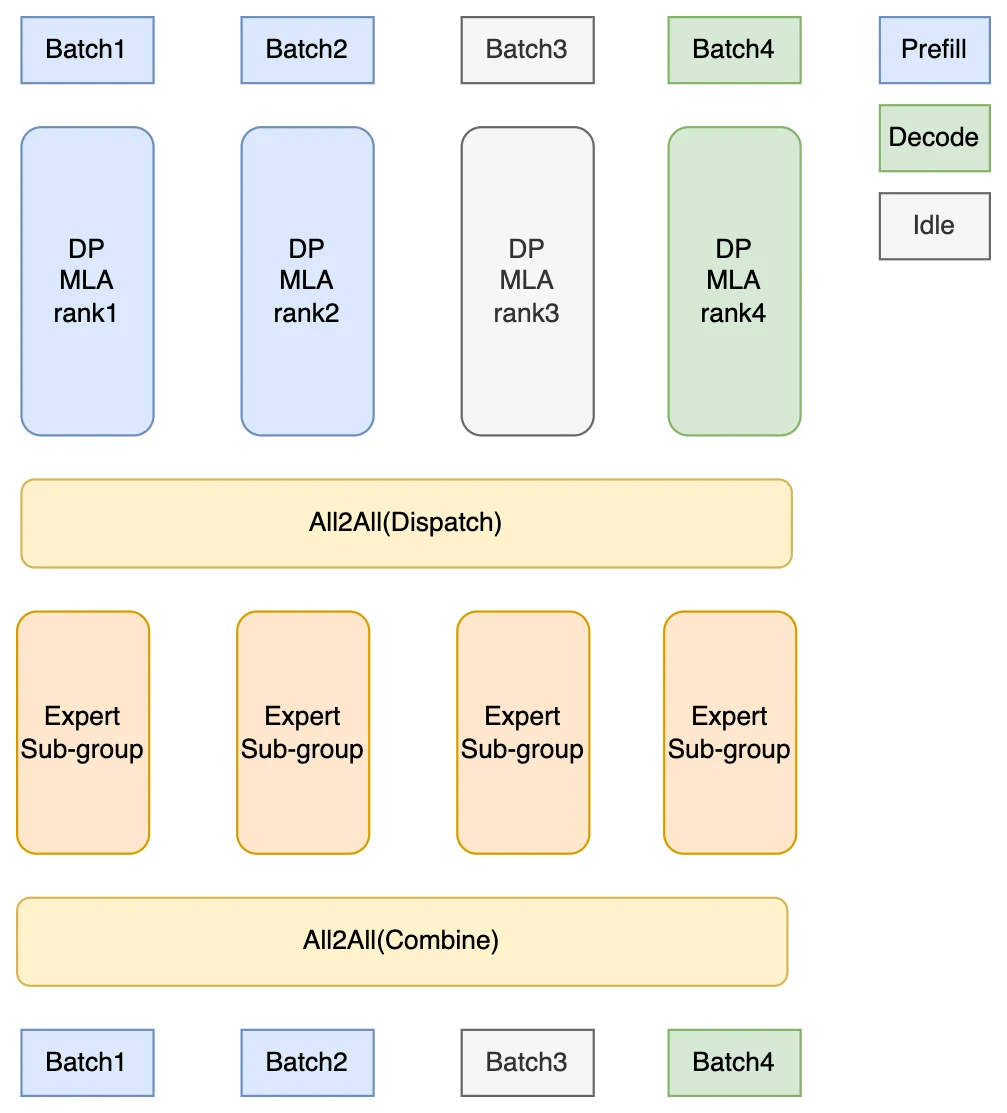
下图是第三篇与第六篇用过的 decode 拓扑,这里换个角度看:注意力区是「按请求切分」,MLP 区是「按专家切分」,两次集合通信把两块拼起来。
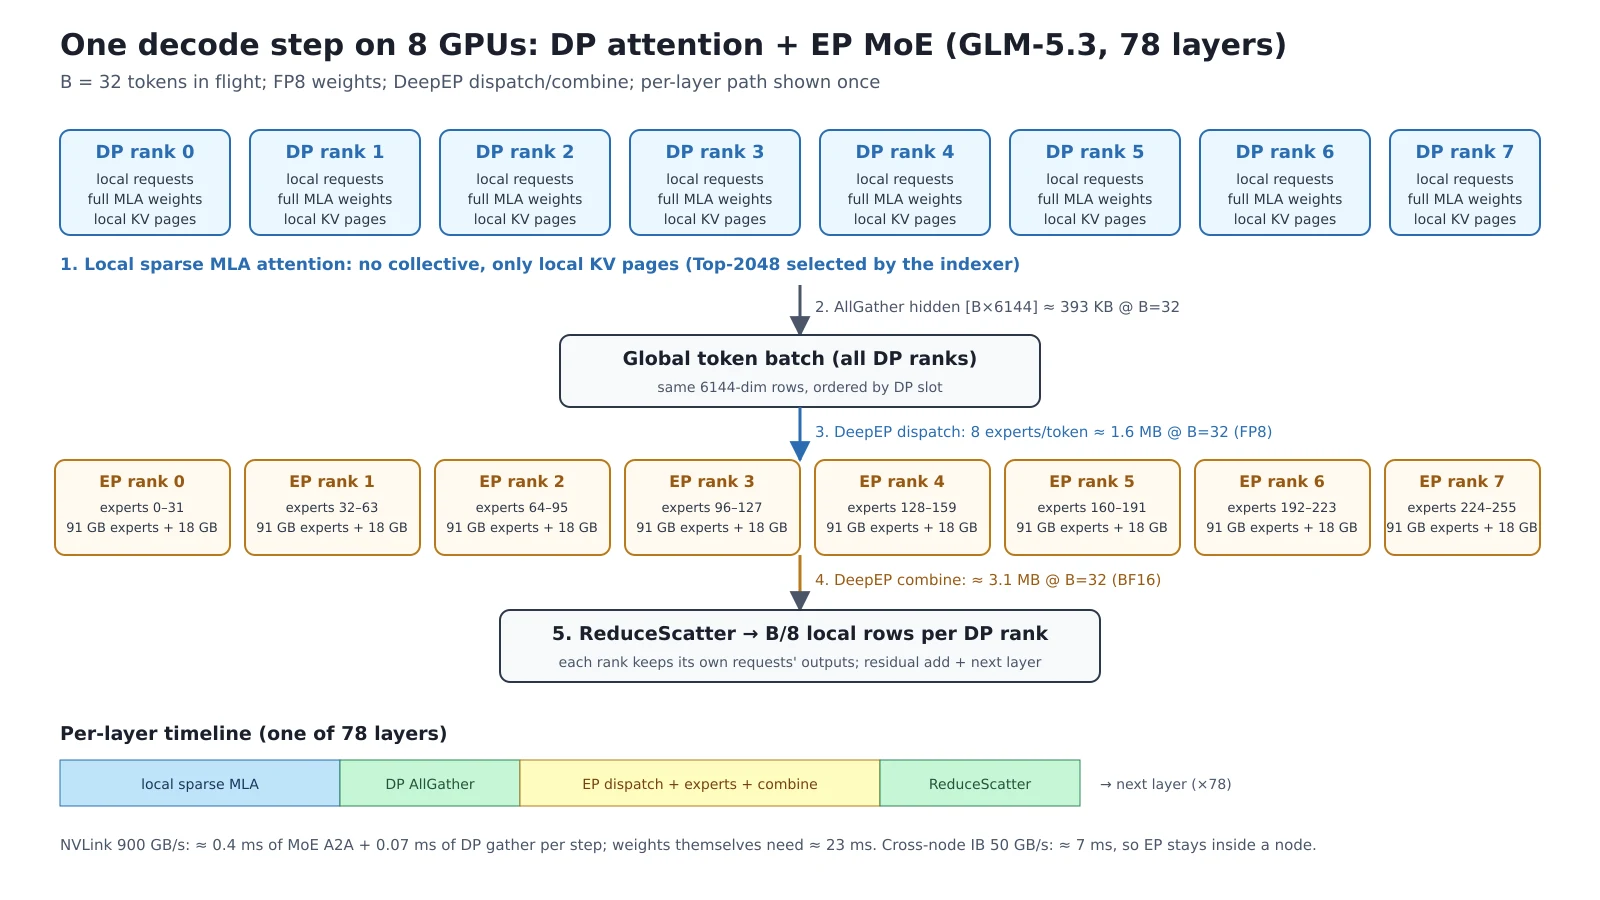
这张图里,dp_gather 和 dp_reduce_scatter 是两条横跨 8 个 rank 的粗箭头。它们的存在意味着:rank 之间的本地工作量差异,不会被流水线吸收,而是直接变成同步等待。TP 的 AllReduce 也是这样,但 TP 下每个 rank 算的是同一批 token 的不同头,负载天然一致;DP Attention 下每个 rank 算的是不同请求,负载天然不一致。这就是为什么 DP Attention 必须配一个负载均衡器,而 TP 不需要。
负载账本为什么能当锁的同步点:MLP 同步批次
在讲快照与路由之前,必须先把「每层都要对齐」这件事的代码落点看清楚。SGLang 每次要跑 MLP 的 step,都会先走一遍 prepare_mlp_sync_batch(scheduler_components/dp_attn.py),它构造一个 MLPSyncBatchInfo,把各 rank 这一步的「形状」用一个 11 列的整数张量打包,然后做一次 all-gather:
def _get_local_tensor(self, device, dtype=torch.int64) -> torch.Tensor: return torch.tensor( [ self.num_tokens, self.num_tokens_for_logprob, int(self.can_run_decode_cuda_graph), int(self.is_extend_in_batch), int(self.local_can_run_tbo), self.local_forward_mode, int(self.can_run_prefill_cuda_graph), self.prefill_cuda_graph_max_prefix_len, int(self.can_run_draft_cuda_graph), int(self.is_health_check), self.attention_pairs, ], device=device, dtype=dtype, )前两列是 token 数,第四列是「本批是否含 extend」,第五列是 TBO 可行性,最后两列是健康检查标记与因果注意力对数(attention_pairs)。all-gather 之后,每个 rank 拿到一个 [num_dp_ranks, 11] 的 CPU 张量,再由 tp0_info_cpu[:, k] 解出全局视图:
tp0_info_cpu = global_info_tensor.cpu()[:, 0, :]self.tp0_info_cpu = tp0_info_cpuself.global_num_tokens = tp0_info_cpu[:, 0].tolist()self.can_run_decode_cuda_graph = bool(tp0_info_cpu[:, 2].min())self.is_extend_in_batch = bool(tp0_info_cpu[:, 3].max())...self.global_attention_pairs = tp0_info_cpu[:, 10].tolist()self.sync_wait_seconds = time.perf_counter() - sync_start几处设计值得单独讲:
- collective 用 min 还是 max 是有讲究的。
can_run_decode_cuda_graph取 min(只要有一个 rank 不支持图捕获,整步都不用图,否则那个 rank 会以不同图形状参与同一批前向),is_extend_in_batch取 max(只要有一个 rank 含 prefill,整步就是混合模式),can_run_prefill_cuda_graph取 min,prefill_cuda_graph_max_prefix_len取 max。这不是抄随手,而是「所有人必须走同一条代码路径」的强制约束:图捕获要求形状固定,混合模式要求所有 rank 都按 extend 的图跑。 - 这一列的 all-gather 发生在调度器线程上,默认走 CPU 侧通信(gloo 的
cpu_group)。 代码在选 group 时有分支:如果关闭重叠调度、或显式设置SGLANG_NCCL_ALL_GATHER_IN_OVERLAP_SCHEDULER_SYNC_BATCH,就走设备组;否则走tp_group.cpu_group。原因很实际:重叠模式下调度器要在 GPU 前向还在跑的时候发出下一批,如果这个 gather 也排在 forward stream 上,它就要等前向结束,重叠就白做了。 sync_wait_seconds被记录了下来,并且在observe_dp_balance里以直方图sglang:dp_attention_sync_wait_seconds暴露。注释写得很清楚:在 gloo 路径(重叠调度的默认)上,这个时间就是「等最慢 rank 到达 gather」的时间。这就是本篇最重要的观测指标——它把「负载偏斜变成了多少等待」直接量化了。
gather 之后还有一个连带决策:要不要给某个空闲 rank 造一个 idle batch。prepare_mlp_sync_batch_raw 里:
need_idle_batch = max(mlp_sync_info.global_num_tokens) > 0batch_to_gather = local_batchif need_idle_batch: if local_batch is None: batch_to_gather = local_batch = get_idle_batch() ...含义是:只要别的 rank 这一步有活干,本 rank 就算没请求,也必须造一个 0-token 的 batch 参与 gather 与后续的集合通信,否则 DP 组会在通信点死锁。dp_attention_steps_total 里专门有 rank_state="idle" 这个标签来统计这种「只为锁步而跑」的步。对 GLM-5.3,这意味着 一条请求进入某个 rank 时,不仅占用了那个 rank 的时间,还让其余 7 个 rank 进入每一步都要同步的状态——第八篇把前七篇的算子与字节压进一条时间线,本篇补上的是那条时间线里「谁必须陪谁一起跑」的这一层。
还有一处与负载直接相关的联动:maybe_convert_decode_to_extend。当 gather 发现「某个 rank 本步有 extend」时,纯 decode 的 rank 会被改写成一个 extend 视图,好让整步复用 extend 的图;但它有一个前提——min(global_tokens) 不为 0 且有 rank 不支持 extend 图时就不转换。注释直白地写了理由:An idle rank makes the prefill runner reject replay for every rank。也就是说,只要有 rank 空闲,整步就从图捕获退回 eager。负载极度不均时(一条请求 + 七个空 rank),这不只是多等几毫秒,还会让所有 rank 失去 CUDA Graph 的收益。
负载账本的第一层:SGLang 的 LoadSnapshot
快照里到底有什么
SGLang 把每个 scheduler 的负载组织成一个结构体 LoadSnapshot,定义在 python/sglang/srt/managers/load_snapshot.py。它的字段可以分成五组:
| 组别 | 字段 | 说明 |
|---|---|---|
| 身份与时间 | dp_rank、timestamp | 哪个 rank、什么时候采的 |
| 队列 | num_running_reqs、num_waiting_reqs、queues | 正在跑的、在等的,以及按原因拆开的等待队列 |
| token | num_used_tokens、num_total_tokens、num_active_tokens、num_waiting_uncached_tokens | KV 已用、含待处理的总量、真正活跃的、还没算过的 |
| 容量 | max_total_num_tokens、max_running_requests、token_usage | 分母,用于算利用率 |
| 运行态 | gen_throughput、cache_hit_rate、utilization、speculative、disaggregation | 吞吐、命中率、投机接受长度与 PD 分离的队列状态 |
这些字段不是随便凑的。num_running_reqs 是「已经在这个 rank 的 running batch 里」的请求数,决定了本步注意力的行数;num_waiting_reqs 是排队数,决定了接下来几步会不会变忙;num_total_tokens 把两者加在一起,因为一个等待中的长请求一旦被调度,会立刻占用大量 KV 与 prefill 预算。只看 running 数会低估「刚进来一条 100K 请求」的负载——它还没跑,但马上要跑很久。
get_loads() 的实现(scheduler_components/load_inquirer.py)把这几组数拼起来。其中有一个细节值得单独说:等待队列不是一个队列,而是按状态拆成好几个。
waiting_queues = [self.get_waiting_queue()]pending_token_queues = [self.get_waiting_queue()]if self.disaggregation_mode == DisaggregationMode.PREFILL: prefill_bootstrap_queue = self.get_disagg_prefill_bootstrap_queue().queue waiting_queues.append(prefill_bootstrap_queue) pending_token_queues.append(prefill_bootstrap_queue)elif self.disaggregation_mode == DisaggregationMode.DECODE: decode_prealloc_queue = self.get_disagg_decode_prealloc_queue().queue decode_transfer_queue = self.get_disagg_decode_transfer_queue().queue decode_retracted_queue = self.get_disagg_decode_prealloc_queue().retracted_queue waiting_queues.append(decode_prealloc_queue) waiting_queues.append(decode_transfer_queue) waiting_queues.append(decode_retracted_queue) pending_token_queues = [decode_prealloc_queue, decode_retracted_queue] awaiting_kv_tokens = sum( req.seqlen for queue in (decode_prealloc_queue, decode_transfer_queue) for req in queue )PD 分离的 decode 侧有三类请求在等:prealloc(KV 槽位已预分配、等 prefill 端的输入)、transfer(KV 正在传输)、retracted(被抢占、等重新调度)。这三类在「占不占 KV」上完全不同:prealloc 与 retracted 已经占了 decode 侧的页,所以计入 num_total_tokens;transfer 的页虽然预分配了,但 KV 还没到,要单独算成 awaiting_kv_tokens 并从 num_active_tokens 里扣掉。这段代码解释了为什么负载快照不能只报一个「等待请求数」——在 PD 分离里,等待数的含义取决于它在哪个队列。
对 GLM-5.3 的部署,这个区分尤其重要:第四篇算过一条 1M 上下文的请求,其 KV 与索引器缓存合计约 57GB;decode 侧一旦预分配了这么多页,「负载」就已经发生了,哪怕这条请求还在等传输。如果路由只看 running 数,会把一个已经吃掉大半 KV 池的 rank 当成空闲。
快照里还有两项与本文主题直接相关:speculative 里的 accept_length 与 accept_rate,以及 disaggregation 里的 kv_transfer_speed_gb_s 与 kv_transfer_latency_ms。前者说明「这个 rank 上的 MTP 草稿接受得怎么样」(第十四篇),后者说明「KV 传得有多快」(第四篇)。这两项都直接影响「一个 rank 这一步实际要跑多久」:接受长度 2.8 与接受长度 4.0 的两张卡,同样是 batch 32 的请求,前者要多跑前向。但 DPC 的路由不看这两个数——它只看请求数与 token 数。
快照怎么到达路由
LoadSnapshot 从 scheduler 到路由有两条路径,源码里分得很清楚:
- 部署内路径:scheduler → 共享内存(SHM)或 ZMQ PUSH → node 0 的 DataParallelController / TokenizerManager。这一条服务于 DPC 的 DP 路由决策与
/v1/loads接口。 - 部署外路径:scheduler 通过自己的 ZMQ PUB socket 发布一个精简的
LoadStat,供只知道 worker URL 的外部 router 订阅。load_publisher.py的注释写得很直白:部署内的 SHM 路径,一个只知道 URL 的 router 订阅不到;所以端口通过/server_info暴露。
ShmLoadSnapshotReader.read_all() 用文件锁读所有 slot:
def read_all(self) -> list[LoadSnapshot]: if not self._attach(): return [] with file_lock(self.fd, fcntl.LOCK_SH): loads = [] ...共享内存的好处是读一次不经过 Python 对象的序列化,DPC 每来一条请求都能读一次;代价是 读写之间没有同步语义——读者拿到的是写入者上一次落下的快照,而不是「此刻」的负载。这不是实现缺陷,而是这类设计必然的取舍:要让账本实时,就得让每次调度都等一次跨进程往返;要让调度快,就得接受账本滞后。
ZmqShmLoadSnapshotReader 是 ZMQ 模式下的包装:它先把 PULL socket 里的快照排空写进 SHM,再从 SHM 读,所以调用方看到的仍然是「最近一次收发的快照」。这一层在跨机部署时会引入网络往返的抖动,单机 SHM 模式没有这个问题——这也是为什么单机 DP 部署总是优先用 SHM。
时间戳与「过期读」
快照里带 timestamp,DPC 的 DPBudget 用它来跳过没有更新的 slot:
def update_budget(self, loads): for load in loads: if load.timestamp == self.last_timestamp[load.dp_rank]: continue self.last_timestamp[load.dp_rank] = load.timestamp self.total_requests[load.dp_rank] = ( load.num_running_reqs + load.num_waiting_reqs ) self.total_tokens[load.dp_rank] = load.num_total_tokenstimestamp 相同意味着「这个 rank 自上次读以来没有发布新快照」,于是保留原有预算,不覆盖。这一步看起来只是省一次赋值,实际是在防一类具体故障:如果某个 rank 的发布线程卡住(比如它的 scheduler 正陷在一次长 prefill 里,走到了发布点之外),DPC 读到的会是同一个旧值;若不加判断,预算会被反复写成旧值,把已经派发过去的请求数抹掉,导致后续请求继续往这个 rank 上堆。
注意这里也有代价:时间戳相同就跳过,意味着 如果 DPC 本地的投机计数因为一批请求已经偏了,而下一个快照又没有更新,那么偏差不会被任何一次读纠正,直到那个 rank 发布新快照。refresh_load_budget 的 20ms 节流让「读」本身就很稀疏,这两个机制叠在一起,账本的最差滞后是「发布间隔 + 20ms + 一次突发时长」。
发布侧:同一份 get_loads 也是 /v1/loads 的来源
get_loads() 不只服务于 DPC。TokenizerManager 的 get_loads(tokenizer_control_mixin.py)会把所有 scheduler 的快照收集回来作为 /v1/loads 的响应,load_publisher.py 则从中取一个子集发布成 LoadStat。所以「DPC 看到的负载」「运维在 /v1/loads 里看到的负载」「外部 router 看到的负载」本质上是同一份数据的三个投影,只是采样频率与字段子集不同。这一点在排障时很关键:三个视图对不上,不是数据损坏,而是采样时刻不同。
路由决策:预算、投机加一与 20ms 节流
四种策略
data_parallel_controller.py 里定义了四种负载均衡方法:
class LoadBalanceMethod(Enum): ROUND_ROBIN = auto() FOLLOW_BOOTSTRAP_ROOM = auto() TOTAL_REQUESTS = auto() TOTAL_TOKENS = auto()ROUND_ROBIN:轮转,不看负载。简单、无状态,适合请求长度高度同质的场景。FOLLOW_BOOTSTRAP_ROOM:按 PD 分离的 room 走(第十三篇讲过 room 的路由语义),让 prefill 与 decode 的配对关系决定落点。TOTAL_REQUESTS:按「running + waiting」的请求数最少者。TOTAL_TOKENS:按num_total_tokens最少者,请求数做平局裁决。
对 GLM-5.3,TOTAL_TOKENS 通常比 TOTAL_REQUESTS 更合适:一条 100K 上下文的请求与一条 1K 的请求,在 KV 占用与 prefill 预算上差两个数量级,按条数均衡会把长请求集中到某个 rank。但 TOTAL_TOKENS 也有它的问题——它奖励「已经有很多短请求」的 rank,因为短请求的 token 总量小,于是短请求会继续往同一个 rank 上堆,直到该 rank 的请求数触到 max_running_requests。这是典型的「按总量均衡、按条数失衡」,而条数直接决定注意力 kernel 的行数与调度开销。
这里要说明一件容易被忽略的事:DPC 的这一层均衡是 请求级、在到达时决定 的;一旦请求落进某个 rank 的 waiting 队列,它就属于那个 rank 了,除非发生 retract 或前缀缓存重算,DPC 不会把它挪走。所以「路由均衡」只能保证「到达那一刻看起来均衡」,不能保证「运行中一直均衡」。
投机加一:账本必须自己往前走
真正的工程难点不在选哪个策略,而在「读到的账本永远落后于已经做出的决策」。DPC 每派一条请求,那个 rank 的负载就增加了一点,但快照要等到该 rank 下一次发布才会反映。如果 DPC 严格按快照派发,一个突发里的 20 条请求会全部落到「快照上最空」的同一个 rank。
源码用两个机制解决。第一是派发后立刻在本地账本上加一:
def dispatch(self, method: LoadBalanceMethod, estimated_tokens: int = 0): if method == LoadBalanceMethod.TOTAL_REQUESTS: target_rank = self.total_requests.index(min(self.total_requests)) elif method == LoadBalanceMethod.TOTAL_TOKENS: target_rank = min( range(self.num_dp_ranks), key=lambda i: (self.total_tokens[i], self.total_requests[i]), ) else: return None # Increment the load of that worker by one as a heuristic self.total_requests[target_rank] += 1 self.total_tokens[target_rank] += estimated_tokens return target_rankestimated_tokens 是这条请求的 token 估计(分词后的输入长度),派发时直接加进预算,让下一条请求看到「这个 rank 已经被我塞了一条长请求」。
第二是刷新节流:
def refresh_load_budget(self): # Throttle to at most once per 20ms. When a burst of requests # arrives, dispatching_with_trace() calls this before every # dispatch. Each call reads the latest scheduler snapshot and # overwrites the speculative +1 increments that DPBudget.dispatch() # added for previously dispatched requests in this burst. Without # throttling, the budget resets to the (stale) scheduler-reported # value on every request, causing the entire burst to land on a # single DP rank. The 20ms interval lets the burst complete # using speculative counters, then refreshes from the real # scheduler load for the next batch. now = time.perf_counter() if now - self._last_refresh_time < 0.02: return self._last_refresh_time = now self.dp_budget.update_budget(self.load_snapshot_reader.read_all())这段注释把问题与解法都写出来了:突发期间,如果每次派发前都刷新,快照会把本地的投机加一覆盖掉,20 条请求会全部落到同一个 rank;20ms 的节流让一整批突发用投机计数走完,再在下一批之前用真实快照校正。
这里的取舍值得展开。20ms 是一个经验值:它要大于一次请求派发的处理时间(否则节流失效),又要小于一次 decode step 的批量变化周期(否则账本太旧)。对 GLM-5.3 每步约几十毫秒的 decode,20ms 的刷新间隔意味着账本最多落后约一个 step。稳态下这没问题——负载变化是渐进的;但突发下,20ms 内可能涌入上百条请求,全部靠投机计数分配,而投机计数只加 estimated_tokens,并不知道这些请求会不会命中前缀缓存(命中后实际 prefill 成本大降),也不知道它们是不是同一批 agent 请求(几乎同时到达、长度相似、共享同一段系统提示)。
dispatch_batch_generate 对「批量到达」的场景做了一个小优化:一批里先刷新一次,然后整批用投机计数分配,避免批内每一条都触发一次读:
def dispatch_batch_generate(self, batch_req: BatchTokenizedGenerateReqInput): has_user_request = any( not is_health_check_generate_req(req) for req in batch_req ) if has_user_request and self.refresh_load_budget_on_dispatch: self.refresh_load_budget() for req in batch_req: self.dispatching_with_trace(req, refresh_load_budget=False)健康检查请求被特意排除在刷新之外——探针不该扰动真实负载的账本。
前缀缓存让账本更失真
第十篇讲过 SGLang 在排队之前做前缀匹配。对负载账本来说,这带来一个反直觉的结果:两条 token 数相同的请求,实际成本可能差一个数量级。一条命中 90% 前缀的 10K 请求,prefill 只需算 1K token;一条完全不命中的 10K 请求,要算 10K。DPC 的 estimated_tokens 只看分词后的长度,不看命中率。
LoadSnapshot 里有 num_waiting_uncached_tokens,是专门为这个偏差准备的:
def get_num_waiting_uncached_tokens(self) -> int: ... for req in self.get_waiting_queue(): if waiting_queue_prefix_matched: matched = req.num_matched_prefix_tokens uncached = max(0, req.seqlen - matched) ... else: # The historical hit rate already includes admitted storage hits. uncached = int(req.seqlen * cache_miss_rate) num_tokens += uncached这段代码区分了「精确知道匹配长度」与「只有历史命中率」两种情况:前者逐条减掉已匹配的前缀,后者用 1 - cache_hit_rate 乘总长度做估计。但注意,它是 scheduler 侧算给自己上报的,不是 DPC 派发时用的:DPBudget 用的是 num_total_tokens,而不是 num_waiting_uncached_tokens。所以路由与调度对「成本」的定义并不一致——路由按总 token 算,调度按未命中 token 算。这不是 bug,而是责任划分:路由必须在下发之前决策,那时还没有做前缀匹配;调度拿到请求后才在本地 radix tree 里查。后果是路由的负载估计系统性地偏高,且在共享前缀多的场景(系统提示词、few-shot 模板、agent 的同一份工具定义)里偏高得厉害。
前缀缓存还有一层更隐蔽的影响:它让「负载」本身变得不均匀。8 个 rank 各有自己的 radix tree;一条请求落到 A rank 能命中 90% 前缀、落到 B rank 只有 20%,而路由完全不知道这件事。按 token 数均衡,可能恰好把所有「共享系统提示的短请求」都送到 A rank(因为它短),A rank 上这批请求几乎不需要 prefill——于是 A rank 看起来很忙(token 总数大),实际很闲;B rank 看起来闲,实际每条都要全量 prefill。这种偏斜无法从 num_total_tokens 里看出来,只能从 num_waiting_uncached_tokens 或实际 prefill 耗时里看出来。
当账本失真:三种偏斜如何变成等待
偏斜一:突发落在同一个 rank
前面说的 20ms 节流防的是「全部落到最空的 rank」。但如果突发的第一批请求已经让那个 rank 变成「账本上最忙」,后续请求应该转向其他 rank——这时投机计数的精度就决定了偏斜程度。estimated_tokens 是分词长度,不是未命中长度,所以在共享前缀场景里,第一条 100K 请求会把目标 rank 的预算加 100K,实际只算 10K;账本把这个 rank 标成「很忙」,后续请求绕开它,结果这个 rank 反而空闲,其他 rank 被堆满。反向偏斜同样存在。
这类偏斜的特点是 持续时间短、幅度大:一个突发几十毫秒就过去,但在这几十毫秒里派出去的请求会跑几分钟(长上下文请求的 decode 可能持续数分钟)。于是「瞬时决策」变成了「长期负载」——这是所有无状态负载均衡器的共同问题,也是为什么 SGLang 在 PD 分离里引入了 retract 与 rebalance 机制。
偏斜二:长请求的尾巴
一条 1M 上下文的请求进入某个 rank 后,它的 prefill 会被切成多个 chunk(第三篇),每个 chunk 都占用该 rank 的 prefill 预算;在它 prefill 期间,同 rank 的其他请求的 decode 会被挤压。SGLang 的 chunked prefill 与 mixed batch 会尽量让 decode 与 prefill 共存,但预算总量是固定的。结果是:这个 rank 的 decode 请求 TPOT 变长,而这个变长会通过每层的 dp_gather 传给所有 rank。
一个具体的量级:假设 rank 3 上有一条 1M 请求在分块预填,每个 chunk 8K token;同 rank 上有 3 条 decode 请求。混批时,这一 step 的前向时间由 prefill chunk 主导。其他 7 个 rank 只有 decode,它们的前向时间远小于 prefill chunk,但 MLP 前的 dp_gather 要等 rank 3 把本步的全部本地计算跑完——混批意味着 rank 3 的本地部分同时包含 decode 行与 prefill chunk,它的耗时远大于其他 7 个 rank 的纯 decode。于是 7 个 rank 的请求,每步都被 rank 3 的 prefill 拖住。这就是为什么生产部署里,长上下文请求与短请求通常要分池:不是 GPU 算不动,而是 同步结构不允许一个 rank 单独忙。
偏斜三:专家热点与结构慢
MoE 的 dispatch 是另一条同步链。第六篇讲过 DeepEP 的两种模式与 combine 后的 reduce-scatter;从负载角度看,热点专家会让某个 rank 的 GEMM 变长,而 all-to-all 的完成时间取决于最慢的接收方。GLM-5.3 每个 token 激活 8 个专家、共 256 个专家、EP8 下每卡 32 个专家;如果某一批 token 大量路由到同一组专家,持有这些专家的 rank 就要算更多行,其他 rank 等它。DeepEP 的低延迟模式用固定容量与 masked 布局把这个差异「摊平」成固定形状的 GEMM——代价是算力浪费,收益是 时间可预测。第十六篇的 launch 账本里,decode 的 MoE 是约 19ms 的大头,正是因为这部分被设计成固定形状,才让每步时间稳定。
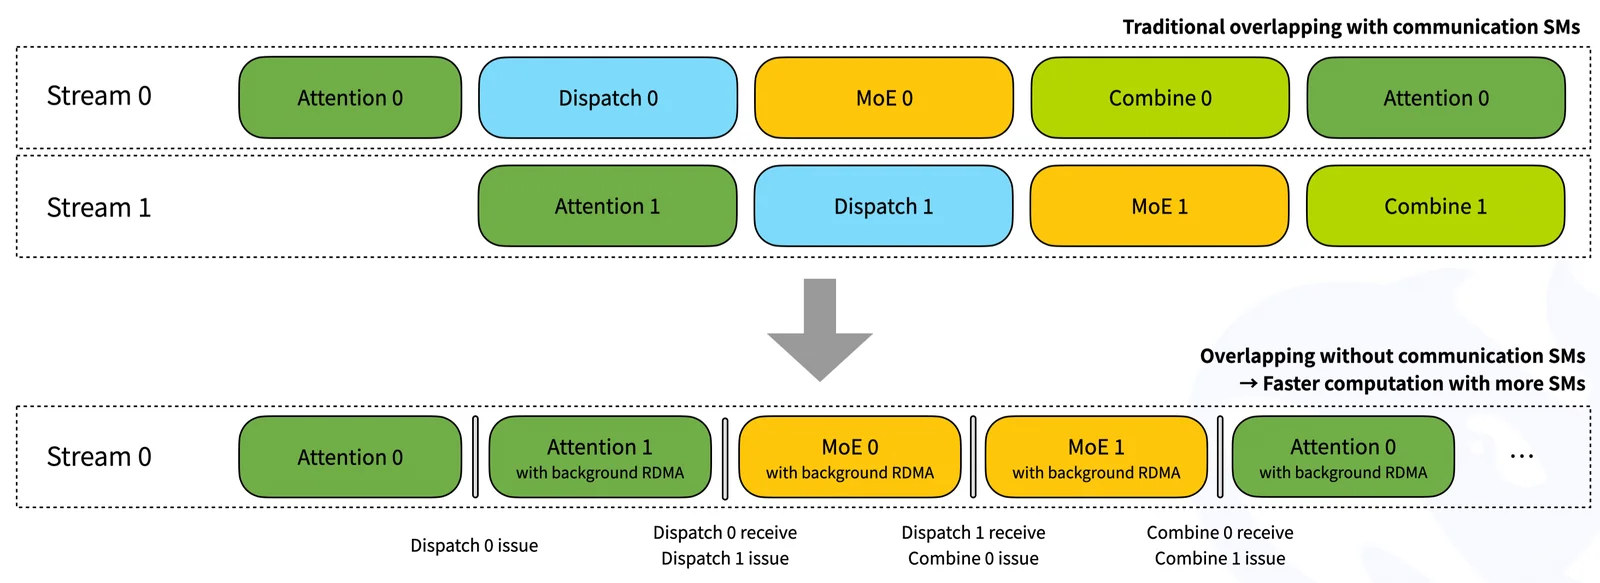
这张图与本文的关系是:masked 布局把「哪个专家收到多少 token」这个随路由变化的部分,变成了固定形状里的一段有效行,从而切断了「专家热点 → 形状变化 → 时间变化」这条链。但它切不断另一条链:每张卡本地 token 数不同 → 本地注意力时间不同 → gather 等待。前者靠布局设计,后者只能靠路由与调度。
结构慢无法靠路由解决。能做的只有三件事:换更细的专家切分(EP16/EP32,每卡专家更少、热点更分散)、加冗余专家(redundant experts,把热点专家复制到多张卡)、或者在 batch 组装时按专家负载做 token 重排。这三件都不在本篇的负载账本范围内,但要知道它们存在——否则会误以为「路由均衡了,慢 rank 就没了」。
另一套账本:vLLM 的 wave、请求计数与前端打分
vLLM 的 DP 与 SGLang 有一个结构性差异要先说清楚:vLLM 的 DP 只在 MoE 模型上走「锁步」路径。在 core.py 里,只有 data_parallel and model_config.is_moe 时才构造 DPEngineCoreProc;非 MoE 的 DP rank 会被 reconfigure_for_independent_dp_rank() 降级成互相独立的实例。GLM-5.3 是 MoE,所以它走锁步路径——这也意味着 GLM-5.3 的 vLLM 部署里,「某个 rank 慢」同样会让所有人等。
wave:一个比 step 更粗的同步单位
DPEngineCoreProc 引入了两个计数器:step_counter 与 current_wave。每跑一步 step_counter += 1;每 dp_sync_interval 步做一次跨 rank 的 all-reduce,判断「全局还有没有未完成的请求」:
def _has_global_unfinished_reqs(self, local_unfinished: bool) -> bool: # Sync step 1 too: an idle pause needs one dummy batch, not a full interval. self.step_counter += 1 if self.step_counter != 1 and self.step_counter % self.dp_sync_interval != 0: return True parallel_config = self.vllm_config.parallel_config has_unfinished, pause_consensus = parallel_config.sync_dp_state( self.dp_group, has_unfinished=local_unfinished, pending_pause=self.pending_pause, ) ...dp_sync_interval 默认是 16,注释是「Steps between DP finish-sync all-reduces; must match across DP ranks」。也就是说:vLLM 不要求每一步都做一次元数据同步,只要求每个 wave(约 16 步)结束时所有 rank 一致地看到「全局结束了」。一个 wave 的起点是「至少一个 rank 有新请求」,终点是「所有 rank 一起判断全局空闲」。
sync_dp_state 本身用一次 2 元素的 CPU all-reduce 把两件事合成一个 collective:
# [0] = 1 if this rank has unfinished work, else 0.# SUM > 0 ≡ logical OR across ranks → any rank has work.# [1] = 1 if this rank has a pending pause request, else 0.# SUM == dp_size ≡ all ranks reached pause consensus.第 0 位是「或」,决定整个 wave 要不要继续;第 1 位是「与」,决定所有 rank 是否都同意暂停。合成一个 collective 的好处很直接:一次通信同时回答「还跑不跑」与「能不能停」,省掉一次同步——在每 16 步才同步一次的频率下,这点开销本身不大,但两个判据用同一次通信保证 不会出现「有人说还要跑、有人说可以停」的中间态。
这个设计对负载的影响与 SGLang 不同:
- 在 wave 内部,rank 之间每步并不交换 token 数——MoE 的 all-to-all 本身要求各 rank 同时发出,天然形成了步级同步;但「哪一步开始」由 wave 决定。
- 某个 rank 提前空了之后不会立刻退出循环,它会执行 dummy batch(
execute_dummy_batch),注释写得很直接:Execute a dummy pass when no ready requests ran。这是为了让其他 rank 的 all-to-all 仍有一个对端参与,直到下一个 wave 边界大家一起暂停。 - 暂停后,一个新请求到来会让该 rank 唤醒整个 wave(
START_DP_WAVE)。协调器(DPCoordinator)负责把「wave 号与运行状态」广播给前端。
如果把 wave 里的 dummy batch 当成「空闲 rank 什么都不做」,就会误判:dummy batch 的耗时虽然短,但它同样参与 MoE 的 dispatch/combine,并且在 DP=8 时所有 rank 的 dummy 都要一起跑完,一次 wave 尾部就有 16 步的量级。
对 GLM-5.3 的负载账本,wave 带来一个具体后果:请求落点与 wave 的边界不一致时,会有一段「半空」的 wave。假设 8 个 rank 里有 3 个已经空了,另外 5 个还在跑;这 3 个会持续跑 dummy batch,直到第 16 步才一起暂停。如果此时新请求到达某个空的 rank,它会唤醒一个新的 wave,所有 rank 从暂停状态重新开跑——包括那些本来就已经很忙的 rank。一个慢 rank 造成的偏斜,最小的影响单位就是「一个 wave」。
请求计数:前端打分用的账本
vLLM 的负载账本有两层:scheduler.get_request_counts() 返回 (num_running, num_waiting),_maybe_publish_request_counts() 在 GPU step 的前后各发布一次到协调器;协调器再把 (engine_req_counts_list, current_wave, engines_running) 广播给所有前端进程。前端(AsyncLLM 的 get_core_engine_for_request)据此为每条请求挑一个 engine。
协调器发版的节奏是:统计有变化时每 stats_update_interval_ms(默认 100ms)发一次,没变化时每 5 秒心跳一次;并且在锁步 DP 下,enable_wave_coordination 为真时至少等 50ms,以收集同一 step 所有 rank 的计数:
# Wait at least 50ms to ensure we've received all stats for# the current step. Only applicable to lockstep (MoE) DP;# non-lockstep engines have no synchronized step boundaries.if self.enable_wave_coordination and last_step_counts is None: min_timeout = 50前端打分本身是这套账本里最细致的一段:
current_counts = self.lb_enginesnum_engines = len(current_counts)min_score: float = sys.maxsizeeng_index = 0for i in range(num_engines): idx = (self.eng_start_index + i) % num_engines waiting, running, kv_cache_usage = current_counts[idx] inflight = self.engine_inflight[self.core_engines[idx]] score: float = max(self.client_count * inflight, waiting + running) if waiting: # Waiting requests are penalized in proportion to KV cache # pressure: a queue on a KV-bound engine drains slowly, so # new requests should strongly prefer other engines. With # low KV usage the queue is transient (e.g. mid-burst) and # the penalty stays off, preserving exact round-robin. # Ramps from 0 at <=50% usage to 3x waiting at 100%. score += waiting * 6.0 * max(0.0, kv_cache_usage - 0.5) if score < min_score: min_score = score eng_index = idx这里有三处与 SGLang 的 DPBudget 对应、又处理得更细的地方:
- 本地 in-flight 计数:
self.engine_inflight[engine]是本前端进程自己派出去、还没回来的请求数。打分取max(client_count * inflight, waiting + running)——取最大值而不是和,是为了让「本地精确的在飞数」在快照滞后时仍然起作用。一个突发里即使快照还是旧的,inflight也会让分数立刻上涨,从而把突发摊到不同 engine。client_count是前端进程数,用来把「本进程的在飞数」放大到全服务尺度。 - 按 KV 压力加权等待:
waiting * 6.0 * max(0, kv_cache_usage - 0.5)。等待数在 KV 使用率低于 50% 时不计入,因为这种等待多半是突发中的瞬时排队,很快会消化;KV 使用率接近 100% 时,等待被放大到 3 倍(6 × 0.5),因为这样的队列排得很慢。这一项直接对应本文前面的「负载」定义:等待本身不慢,KV 快满的等待才慢。 - 平局时的轮转起点:
eng_start_index每次加一,扫描从不同的 engine 开始,避免「快照刚重置、所有 engine 看起来一样空」时所有请求都落到 0 号。
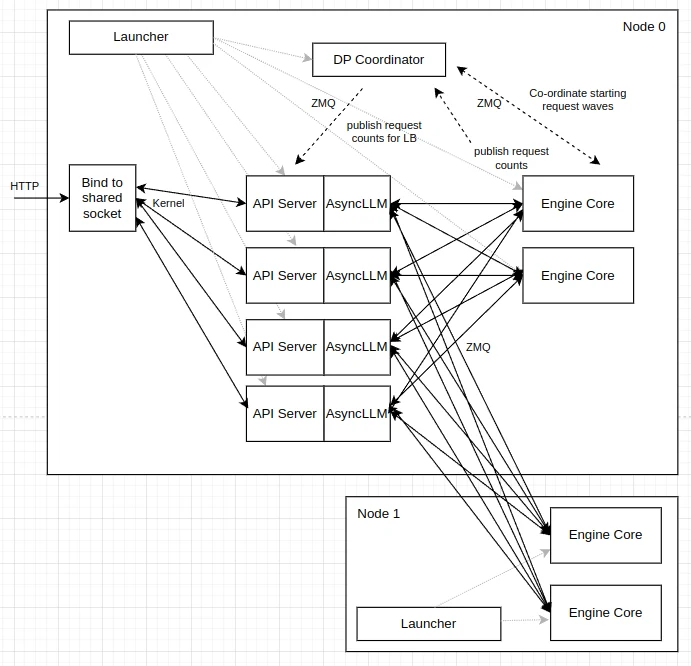
这张图解释了为什么 vLLM 的负载账本要经过一个协调器:前端不直接知道各 engine 的队列,协调器把计数汇总后以一播多(XPUB)的方式发给所有前端。多前端部署时,每个前端都拿同一份计数,再各自加上自己的 in-flight 计数——这正是上面打分公式里「快照 + 本地」两部分的来源。
两套账本的差别
把 SGLang 与 vLLM 的负载路径并排看:
| 维度 | SGLang DPC | vLLM 前端 + 协调器 |
|---|---|---|
| 路由决策者 | 独立的 DataParallelController 进程 | 每个前端 API server |
| 快照通道 | SHM(单机)/ ZMQ PUSH | 协调器 XPUB,100ms 有变化即发、5s 心跳 |
| 快照内容 | 全量 LoadSnapshot(含 KV、未缓存 token、投机接受) | 计数三元组 (waiting, running, kv_cache_usage) |
| 本地补偿 | 投机 +1 请求、+estimated_tokens | max(client_count * inflight, waiting + running) |
| 刷新节流 | 20ms | 100ms(且至少等 50ms 收齐同 step 计数) |
| 突发纠正 | 节流期间用投机计数 | 快照重置后靠轮转起点避免全部落同一 engine |
两套的共同点是 账本永远滞后,本地必须补偿;差别在于补偿的方式:SGLang 用「按请求数与 token 数加一」的显式预算,vLLM 用「本地 in-flight 下界」。后者对「同一前端进程内的突发」更精确,因为 in-flight 是精确计数;但多前端部署时,每个前端只知道自己的 in-flight,其他前端派出去的请求要等到协调器广播之后才体现——这就是为什么打分里要乘 client_count。
SGLang 的 estimated_tokens 在多前端场景下反而更稳:token 估计是「总量」口径,跨前端共享同一套快照,且不依赖各前端的本地状态。代价是 token 估计本身不准(前缀命中的问题)。两种设计各有其偏,但都只解决「路由时」的均衡,不解决「运行中」的均衡——这一点下面专门讲。
运行中的再平衡:retract、抢占与「挪不走」的请求
路由只能决定请求落在哪个 rank;一旦落定,请求的 KV 页已经在那个 rank 的池子里了。要让它在运行中换 rank,代价是把 KV 页搬过去——对 GLM-5.3,一条 1M 上下文的请求就是 57GB 量级,搬一次比重新算一遍还贵。所以实际系统中,「运行中再平衡」几乎都不是搬家,而是以下三种:
retract:把请求退回 waiting,让出 KV
SGLang 的 retract_decode(schedule_batch.py)在 KV 不足或 batch 超限时,会挑出一些请求退回 waiting 队列、释放它们的 KV 页。LoadSnapshot.queues 里的 retracted 就是统计这个数。retract 的挑法决定了偏斜是否会「自我修复」:如果系统总是优先 retract「最长的」请求,那么长请求在紧张时会反复被抢占、反复重算,形成抖动;如果优先 retract「最近最少使用」的,则长请求能稳定跑完。
从负载账本的角度,retract 有一个副作用:被 retract 的请求仍属于同一个 rank(它在那个 rank 的 waiting 队列里),不会触发 DPC 重新分配。所以一个 KV 长期不足的 rank,即使 retract 了一堆请求,账本上的 num_total_tokens 也不会降——它只是从 running 挪到了 waiting。这正是前面表里 TOTAL_TOKENS 策略需要 num_waiting_reqs 一起看的原因。
抢占与重算:更贵的再平衡
vLLM 的等价机制是 preemption,分 RECOMPUTE 与 SWAP 两种。RECOMPUTE 直接丢掉 KV、之后从头算;SWAP 把 KV 换出到 CPU。对长请求,RECOMPUTE 的成本极高——一条 100K 的请求被抢占后重算,等于多算了一次 100K prefill。SWAP 的成本取决于 PCIe 带宽与 KV 大小,对 MLA 的 576 字节/token/层来说,78 层合计约 45KB/token,100K token 就是约 4.4GB,一次换出换入要占用数秒级的 PCIe 带宽;索引器缓存的那一份(21 层的 K)还要一起搬。
无论哪种,preemption 都不是「均衡」:它只在某个 rank 的 KV 池撑不住时发生,发生之后该 rank 的负载暂时下降,但请求本身没去过别的 rank。负载均衡器看不到 preemption——SGLang 的 LoadSnapshot 有 num_paused_reqs 与 num_retracted_reqs,vLLM 的计数三元组里没有。
唯一的「真搬家」:PD 分离的 KV 传输
真正让请求换 rank 的,是 PD 分离:prefill 在一个 rank、decode 在另一个 rank,KV 通过传输搬过去(第四篇、第十三篇)。这也是 GLM-5.3 长上下文场景下唯一实用的再平衡手段——不是把请求从忙 rank 搬到闲 rank,而是把「prefill 重活」与「decode 轻活」分开到不同的池子,让两边的负载各自同质。第十三篇里 SGLang router 的 /route 校验与 room 机制,本质上就是在维持「这条请求的 prefill rank 与 decode rank 配对」。
对一个用 DP Attention 部署的 GLM-5.3 实例,可以把这段收成一句可操作的结论:路由负责「到达时」的均衡,PD 分离负责「结构上」的均衡,两者都不能解决「运行中」的均衡——后者只能靠 retract/preemption 的挑法来缓解,而挑法的核心是「别让长请求反复被抢占」。
观测:把「偏斜」与「单点慢」分开
排障时最常犯的错误是把负载偏斜当成硬件故障,或者反过来。下面这组指标按「从粗到细」的顺序排,前两项在任何部署里都有,后两项只有 SGLang 的 DP Attention 提供:
- 每 rank 的
num_running_reqs与num_total_tokens的比值。若各 rank 条数相近但 token 差很多,是长度偏斜;若 token 相近但条数差很多,是条数偏斜(短请求堆积);若条数与 token 都差很多,是路由与突发叠在一起。 - 每 rank 的
gen_throughput与cache_hit_rate。单点慢的 rank 吞吐会持续低于其他 rank,且与请求数无关;负载慢的 rank 吞吐会随请求数波动。命中率异常低的那张卡,往往不是慢,而是「没享受到前缀缓存」——它的 token 数看着一样,prefill 却更贵。 queues里的retracted与paused。retract 次数集中出现在某个 rank,说明该 rank 的 KV 长期不足,往往是长请求堆积的结果,而不是硬件问题。sglang:dp_attention_token_imbalance_ratio。每步统计「最忙 rank 的 token 数 / 平均 token 数」,1.0 是完全均衡,等于num_dp_ranks意味着只有一个 rank 有活干。这个直方图由 0 号 rank 的 scheduler 上报,是判断负载偏斜最直接的数。sglang:dp_attention_tokens_total{kind="imbalance"}与sglang:dp_attention_pairs_total{kind="imbalance"}。前者是「本 rank 比最忙 rank 少跑的 token 数」,后者是「少算的因果注意力对数」。token 数衡量的是 MoE 与投影的容量浪费(在 SUM_LEN padding 下是等待,在 MAX_LEN padding 下是填零算的废行);注意力对数衡量的才是真正会变成同步等待的部分。sglang:dp_attention_sync_wait_seconds。每次 MLP 同步 gather 的墙钟耗时,在 gloo 路径上它就是「等最慢 rank」的时间。把它与一次前向的时间比,就是重叠调度第十八篇里「重叠是否生效」判断的同一类问题:如果 gather 等待占了 step 的很大比例,那么不管重叠开没开,GPU 都在空等。sglang:dp_attention_steps_total{rank_state="idle"}。空闲 rank 为锁步而跑的步数占比。这个比例高,说明整体负载很轻或者极度不均;两种情况下,一个 rank 上的新请求都会让整组进入同步。
这几项里,imbalance_ratio 与 sync_wait_seconds 是互补的:前者说「账面上偏了多少」,后者说「偏了多少变成了时间」。有时候前者很高、后者很低——那是 token 偏斜但注意力对数接近(比如偏斜在很短的请求上);反过来,前者不高但后者很高,才是最难查的情况:token 数看起来均衡,但有一张卡的前向就是慢,这通常指向单点慢(降频、链路劣化、进程被抢 CPU),或者该卡的投机接受长度异常(它每步要多跑 MTP 的验证前向,却没有体现在 token 数上)。
还有一项需要单独测:集合通信的等待分布。sync_wait_seconds 只覆盖调度器侧的 MLP 元数据 gather;GPU 侧的 dp_gather/dp_reduce_scatter 与 DeepEP 的 all-to-all 的等待,要看 Nsight Systems 的时间线。做法是把 8 个 rank 的时间线并排:如果某个 rank 的注意力 kernel 早早结束、在 gather 前空等,等待时长就是它被其他 rank 拖住的时间;反过来,如果所有 rank 都早早结束却在通信上花很久,那是通信本身慢(链路或拥塞),不是负载。
一个可算的场景:三张卡的账
把上面的机制落到一个具体配置上,看一次 decode step 中「偏斜」如何逐层放大。设定:8 卡 DP Attention + EP8,batch 32、各卡 4 条;其中 3 条是 8K 上下文、1 条是 200K 上下文,且这 4 条全部落在 rank 0 上(其余 rank 各 4 条 8K 的),这是 TOTAL_REQUESTS 策略在「请求数相同、token 数完全不同」时可能造出的偏斜。
用第三篇的 MLA 口径:decode 每 token 每层的 KV 读取是 字节,其中 512 是 KV 潜向量、64 是 RoPE 部分。注意力对数按「每条请求一行 query 读它的全部历史」算:
- 8K 请求: 对;
- 200K 请求: 对。
rank 0 的注意力总对数:;其他 rank:。比例约 7:1。KV 读取量同理:rank 0 约 GB(若 DSA 层只读 Top-K,则这个数要按稀疏率打折,但 rank 之间的比例不变),其他 rank 约 GB。
这里先不讨论具体毫秒数——HBM 带宽、kernel 效率、DSA 稀疏率都会改变它——只讨论结构:
- rank 0 的本地注意力时间远大于其他 rank,这是「偏斜」的源头。
- MoE 的全局权重读取取决于全局 32 行,与偏斜无关;所以 MoE 这一段是匀速的。
dp_gather的等待出现在 rank 0 追到其他 rank 的那一段;每层都要等一次,78 层累加。- 如果这一步同时有 rank 需要 prefill,
is_extend_in_batch取 max,所有 rank 都走 extend 视图;rank 0 若还有 chunked prefill,等待会更大。
第 1 步里那个「约 7:1」就是 dp_attention_pairs_total{kind="imbalance"} 会记录的量:每个非 rank 0 的 rank 每步会累计 个「少算的对数」。如果按 78 层累计,每步约 1500 万对——这不是一个可以直接换算成毫秒的数,但它与 sync_wait_seconds 的直方图放在一起,就能判断「偏斜的主要来源是长上下文还是条数堆积」。
这个场景也解释了为什么 TOTAL_TOKENS 比 TOTAL_REQUESTS 更适合 GLM-5.3:在 TOTAL_REQUESTS 下,rank 0 的 4 条与别人的 4 条在请求数上完全相同,路由不会做任何调整;在 TOTAL_TOKENS 下,rank 0 的 总 token 会立刻让它成为「最忙」,后续请求会绕开它。但要注意,TOTAL_TOKENS 用的是 num_total_tokens,它含 KV 已用与待处理 token,对 decode 中的请求就是上下文长度——正是这个数。
反过来,如果路由选择 TOTAL_TOKENS,那么一条 200K 请求进入之后,该 rank 的 num_total_tokens 立刻增加 20 万,其他 7 个 rank 在剩余时间里都会被绕开。这又引出另一个问题:路由只按「现在」的负载做决定,不按「未来多久」。一条 200K 请求要跑很久,它落在一个 rank 上,就会把那个 rank 长期标成「最忙」;如果同期有很多短请求,它们会全部涌向其他 7 个 rank,导致其他 rank 反而更忙——负载均衡变成了「惩罚长请求所在卡」。这是 TOTAL_TOKENS 策略的结构性缺陷,也解释了为什么有些部署会把这个值按请求的未命中 token(而不是总 token)来算,或者干脆按「剩余 decode 步数」加权。
工程上的几条结论
把上面的机制收拢成可操作的判断:
- 负载均衡的目标不是「每卡请求数相等」,也不是「每卡 token 数相等」,而是「每卡这一步的墙钟时间相等」。 在 DP Attention 下,后者才是集合通信等待的依据。条数均衡只在请求长度同质时近似等价;token 均衡在长度异质时接近,但会被前缀命中率与 DSA 稀疏率扭曲。
- 账本永远滞后,滞后要被显式补偿。 SGLang 用投机加一 + 20ms 节流,vLLM 用本地 in-flight 下界 + 100ms 广播;两者都把「快照」与「本地状态」组合成最终决策。别指望「把快照频率调高」就能解决——频率一高,投机计数就被覆盖,突发会全部落到同一个 rank,这正是 20ms 节流注释里写的那条坑。
- 长请求要隔离。 一条 1M 请求的 prefill 会让整个 DP 组的 decode 变慢,这不是调度器能解决的,只能靠分池(长上下文实例与短请求实例分开)或 PD 分离把 prefill 挪走。对 GLM-5.3 的 1M 上下文,这一条几乎是必选项。
- 前缀命中率要进路由。 如果部署里共享前缀很多(系统提示、工具定义、RAG 的同一份文档),
estimated_tokens会系统性高估,路由会绕开实际上很空的 rank。把命中率或未命中 token 作为路由特征,是这类部署最值得做的一项改造;SGLang 的快照里已经有num_waiting_uncached_tokens,只是 DPC 还没用它。 - 结构慢与负载慢要分开处理。 前者靠并行布局(EP 细粒度、冗余专家),后者靠路由与调度;把两者混为一谈,会在错误的方向上调参。
- 同步的范围要按部署形态算。 SGLang 是每步一次元数据 gather + 每层两次设备侧集合通信;vLLM MoE DP 是每 16 步一次 finish-sync。前者把等待分散到每一步,后者把等待聚集到 wave 边界;排障时先确认自己看的是哪一种时钟。
- 单点慢只能从「与负载无关的持续差异」里找。 每 rank 的吞吐、每 rank 的 kernel 时长、降频日志,这几样与请求数解耦;负载慢的指标则一定与请求分布相关。把两者混看,会得出「加卡」或「改路由」这类并不对症的结论。
把三层账本放在一条时间线上
一条请求从进入到被调度,负载信息在三个地方各有一份,而且三份的定义不同:
| 层 | 账本 | 采样时机 | 失真来源 |
|---|---|---|---|
| 前端 router | worker 的 /v1/loads 或 LoadStat | 周期性 PUB / HTTP 拉取 | 网络往返 + 发布间隔;多 worker 时还有跨机时钟差 |
| DPC / 前端 | LoadSnapshot(SHM)或计数三元组 + 本地补偿 | SGLang 每 20ms 至多一次;vLLM 100ms 广播 | 快照滞后 + estimated_tokens 不含前缀命中 |
| scheduler | running/waiting 队列、KV 池、chunked req、sync_wait_seconds | 每次调度实时 | 无采样滞后,但只知道自己 |
三层里只有第三层是实时的,也只有第三层知道「未命中 token」与「KV 页够不够」。前两层都是它的有损投影。理解这一点,很多现象就解释得通:为什么 /v1/loads 显示的 num_running_reqs 与 DPC 实际用的预算对不上(刷新间隔不同);为什么 router 看到两个 worker 负载相同,实际 TPOT 差一倍(一个 worker 的长请求占比高,另一个短请求多,条数相同但 token 不同);为什么 DPC 刚派完一批请求,/v1/loads 里那个 rank 还是空的(快照还没发布)。
第四层不在这个表里,但它是最终决定结果的那一层:MLP 同步的元数据 gather 与设备侧集合通信。它不采样、不投影,只忠实地把「最慢 rank 的到达时间」变成「所有 rank 的出发时间」。
小结
这一篇把镜头从「一条请求经过什么」移到了「这条请求为什么在这个 rank 上」。GLM-5.3 的 DP Attention 让这个问题第一次变得重要:每个 rank 算不同的请求,而每层两次集合通信要求它们同时到达。于是负载账本的每一次失真——快照滞后、投机计数的长度估计、前缀命中的缺席——都会通过 78 层乘以两次通信的放大,变成全服务的尾延迟。
几处机制值得记住:
- SGLang 的 DPC 用
LoadSnapshot+DPBudget做请求级路由,用「投机加一 + 20ms 节流」补偿快照滞后;快照的timestamp相同就跳过,是防止把已派发负载抹掉的关键细节。 - vLLM 的 MoE DP 用 wave(默认 16 步)做完成同步,空闲 rank 跑 dummy batch 维持锁步;前端按
max(client_count * inflight, waiting + running) + KV 压力加权打分选 engine。 - 两套账本都只解决「路由时」的均衡;运行中的再平衡靠 retract/preemption,真正的「搬家」只有 PD 分离。
- 偏斜真正变成等待的地方,是
MLPSyncBatchInfo的每步元数据 gather 与每层的dp_gather/dp_reduce_scatter;sglang:dp_attention_sync_wait_seconds是这段等待的直接观测。 - 偏斜的代价不是线性的:本地注意力多 4 倍,step 时间可能多 10 倍,因为等待按层累加;而 MoE 的全局权重读取对偏斜不敏感,这是两种「慢」必须分开看的原因。
前十八篇解释了 GPU 上算了什么、跨卡搬了多少字节;这一篇解释了这些计算与通信为什么落在那些卡上,以及当分配不均时,等待如何沿着同步结构扩散。到这里,一条 GLM-5.3 请求从进入服务到离开服务的路径,连同它所在的部署形态与它所在的那个 rank,才算完整。
参考资料
- SGLang 源码:
python/sglang/srt/managers/data_parallel_controller.py(DPBudget、LoadBalanceMethod 与 20ms 刷新节流) - SGLang 源码:
python/sglang/srt/managers/load_snapshot.py(LoadSnapshot、ShmLoadSnapshotReader 与 ZmqShmLoadSnapshotReader) - SGLang 源码:
python/sglang/srt/managers/scheduler_components/load_inquirer.py(get_loads 与未命中 token 估计) - SGLang 源码:
python/sglang/srt/managers/scheduler_components/load_publisher.py(LoadStat 的 ZMQ PUB 发布) - SGLang 源码:
python/sglang/srt/managers/scheduler_components/dp_attn.py(MLPSyncBatchInfo、prepare_mlp_sync_batch 与 idle batch) - SGLang 源码:
python/sglang/srt/observability/metrics_collector.py(DPBalanceStats 与 dp_attention_sync_wait_seconds) - SGLang 文档:DP Attention(DPA + EP 架构与启动参数)
- vLLM 源码:
vllm/v1/engine/core.py(DPEngineCoreProc、wave 与 dummy batch) - vLLM 源码:
vllm/v1/engine/core_client.py(get_core_engine_for_request 的前端打分) - vLLM 源码:
vllm/v1/engine/coordinator.py(DPCoordinator 的计数汇总与广播节奏) - vLLM 源码:
vllm/config/parallel.py(dp_sync_interval 默认 16 步) - vLLM 文档:Data Parallel Deployment(内置与外部负载均衡)
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA 与 MLA 结构,arXiv:2512.02556)
- SGLang: Efficient Execution of Structured Language Model Programs(RadixAttention 与前缀共享,arXiv:2312.07104)
- Efficient Memory Management for Large Language Model Serving with PagedAttention(arXiv:2309.06180)
- 站内:GLM-5.3 推理全链路(一):一个请求在 SGLang 里经过哪些算子、哪些通信
- 站内:GLM-5.3 推理全链路(四):PD 分离——57GB KV 与索引器缓存如何跨节点交接
- 站内:GLM-5.3 推理全链路(六):token 跨卡的那一段——MoE dispatch/combine 的模式、缓冲与重叠
- 站内:GLM-5.3 推理全链路(十六):一条 decode step 的 kernel 账本——78 层里到底发了多少次 launch
- 站内:GLM-5.3 推理全链路(十八):重叠调度——GPU 前向还在跑时,调度器在 CPU 上做什么
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



