


GLM-5.3 推理全链路(十八):重叠调度——GPU 前向还在跑时,调度器在 CPU 上做什么
这一篇补的是前十七篇里最难看见的一段
前十七篇一直在追一个问题的两个侧面:一条 GLM-5.3 请求在 GPU 上要经过哪些算子、跨哪些卡、搬多少字节。无论是第九篇的混批、第十篇的 CPU 侧路径,还是第十六篇的 launch 账本,叙述的都默认了一个前提——调度器是「同步」的:调度器先构造这一批请求,把它交给模型跑完,拿到结果,再去处理结果、选择下一批。
真实的推理服务不是这样跑的。decode 阶段一条 GLM-5.3 请求每步只算 78 层里的一行 token,单个 rank 上的 GPU 前向只有毫秒量级;而调度器在这一步要做的事情却不少:处理上一批的采样结果与停止条件、写回 KV 引用计数、组装下一批的 request pool 下标与 KV 槽位、检查前缀树命中、发布路由用的负载信息,还要在 Python 里把一堆小张量搬到 GPU 上。这些 CPU 工作如果和 GPU 前向串行执行,GPU 会在每一个 decode step 之后空闲一大段,TPOT 就从「GPU 前向时间」膨胀成「GPU 前向时间 + 调度开销」。
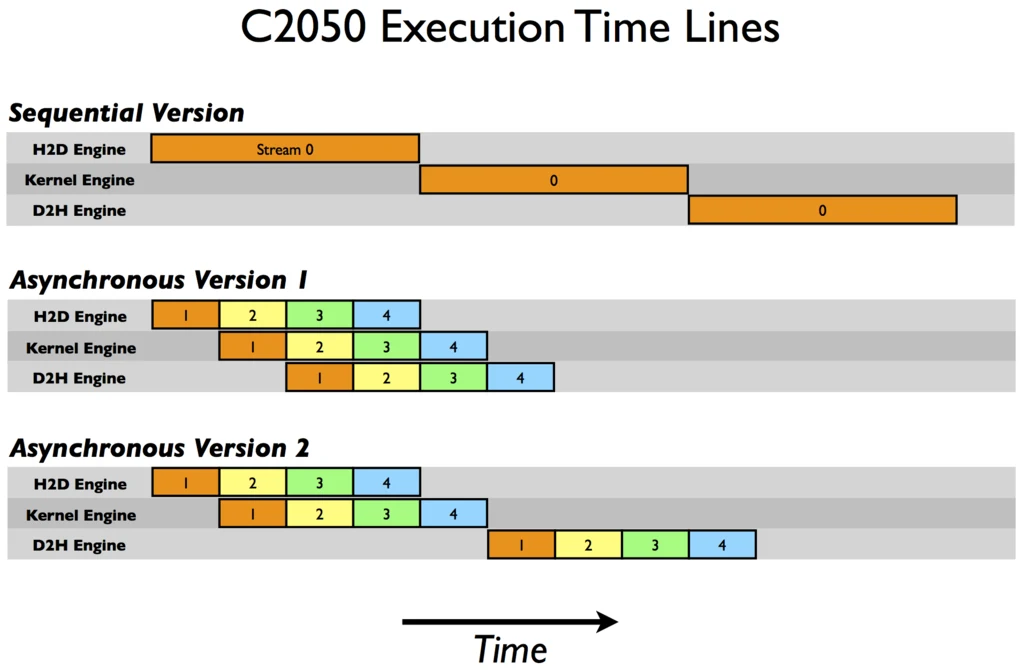
上图是 CUDA 视角下的「同步执行」:主机线程把拷贝与内核逐条压进 GPU 队列,然后在需要结果时同步;GPU 执行完毕、主机拷贝回来之后,才能继续准备下一条。推理服务里的同步调度就是这个形状——只不过「下一条」是下一批请求的全套输入准备,「结果」是采样出的 token。让两条流各自推进、只在必要处用事件相交,就是重叠调度的全部出发点。
SGLang 与 vLLM 都为此设计了重叠调度(overlap scheduling),但两者的做法、代码形态和代价完全不同:SGLang 是调度器在同一线程里「先发后收」,用一个等待队列把 CPU 处理推迟到下一个前向发射之后;vLLM 是把 EngineCore 拆成 step 循环与 worker 进程,并在 worker 侧引入了「上一批采样 token 直接在 GPU 内回填」的异步输入路径。更麻烦的是,重叠引入了一整套新的依赖:结果回读必须落在独立的流上、KV 池的写入必须给前向的读取让路(WAR 屏障)、上一批还没处理的结果要被下一批的调度逻辑「猜」出来(序列长度、结构化输出状态、投机草稿树)。
这一篇就把这段难看见的时钟拆开:先讲清楚哪几段 CPU 工作可以被藏进 GPU 前向里,再分别沿 SGLang 的 event_loop_overlap 与 vLLM 的 step / batch queue / async scheduling 三条路径逐行读过去,最后给出一张「什么情况下重叠会失效」的清单。GLM-5.3 在这两套框架里的部署形态(DP Attention + 专家并行 + MTP + DSA 稀疏注意力)会在每一处决定重叠能不能开、开了之后哪些地方必须显式同步,所以本篇不是脱离模型的框架通论,每一个例子都落回 GLM-5.3 的实际配置。
前十七篇的账本都默认「GPU 跑完这一批,才调度下一批」,本篇补上「GPU 跑这一批的同时,CPU 已经在准备下一批」这一段,账本才算按服务的真实时钟记账。
先分清:哪些 CPU 工作能藏,哪些藏不掉
在进入代码之前,得先有一个分类框架。把一个 decode step 拆成 CPU 侧与 GPU 侧的工作,可以分成四类:
|---|---|---|
| 类别 | 典型工作 | 能否藏进 GPU 前向 |
|---|---|---|
| H2D 准备 | 把 input_ids、positions、seq_lens、req_pool_indices、out_cache_loc 等小张量拷到 GPU;把 KV 槽位分配结果同步到设备 | 能,只要下一批在拷之前还不知道上一批的采样结果 |
| 读回 | 把本步采样出的 token id、logprob、accept length 从 GPU 拷回 CPU | 能,但必须放在独立的拷贝流上,并且这一批的结果处理要推迟到下一批发射之后 |
| 结果处理 | 采样结果写回请求对象、判断停止条件、释放 KV、前缀树插入、更新调度器计数、发出流式输出 | 能,代价是调度器在处理上一批时,读到的「上一个运行批」已经是再上一批 |
| 依赖采样结果的准备 | decode 下一批的输入 token 来自本批采样结果,且要参与下一批的 K/V 计算 | 不能完全隐藏,要么等回读、要么在 GPU 上原地回填 |
第四类正是重叠调度最棘手的地方。同步调度时,调度器在构造下一批前已经拿到了本批采样结果,input token 明明白白;重叠调度时,下一批必须在 GPU 还没跑完之前就发射出去,input token 还不存在。SGLang 和 vLLM 对这一个问题的回答截然不同:
- SGLang 的 overlap 主要解决「第 2、3 类工作藏进 GPU 前向」,第 4 类问题则通过
FutureMap的「延迟解析」处理:prepare_for_decode在调度阶段只把seq_lens加一(按一步一个 token 预测),并把本批的req_pool_indices交给FutureMap;真正的采样 token 由 worker 在forward_stream上「发布」到一张按req_pool_idx索引的缓冲里,等下一次run_batch进入前向时,再在 GPU 上把这些行 gather 进 input_ids——CPU 全程不碰 token 值。 - vLLM 的 step 循环本身只是「发射后阻塞等 future」,重叠度有限;真正激进的是
--async-scheduling:worker 在输入准备时直接读上一批停留在 GPU 上的prev_sampled_token_ids,用scatter把它写进当前 input_ids 的对应行,全程不经过 CPU 回读。
两者的共同点是:重叠不是「让 CPU 多干一点活」,而是改变了数据依赖的形状——原来「本批输出 → 下一批输入」是 CPU 侧的内存依赖,现在变成了 GPU 内部或跨流的张量依赖。
一笔算例:这段被藏起来的时间值多少
第十六篇算过 GLM-5.3 在 batch 32 时的一次 decode:GPU 侧约 30ms,其中 MoE 的权重读取约 19ms 是绝对大头;eager 模式下主机侧 2000 次 launch 约 10–20ms,所以实际部署必须用 CUDA Graph 把这部分折掉。图捕获之后,主机侧剩下的主要就是调度器自己的 Python 工作:schedule 遍历 running 队列、分配 KV、检查前缀、update_from_output 更新请求状态、前缀树插入、流式输出打包。
假设 batch 32 时这部分是 6–8ms,同步调度的 TPOT 就是「30ms 前向 + 6–8ms 处理 + 1ms D2H」约 37–39ms;重叠把处理与 D2H 藏进下一批前向之后,TPOT 回到约 30–31ms,改善 20% 左右。batch 降到 1 时,GPU 前向仍是约 10ms,而调度器的固定开销不会同比例下降,同步 TPOT 可能到 16–18ms;重叠后回到 10–11ms,改善接近 40%。这解释了为什么小 batch、低 QPS 的在线服务对重叠调度更敏感:GPU 越跑不满,CPU 的固定成本占比越高。
这笔账也说明了重叠调度与 CUDA Graph 的分工:CUDA Graph 折掉的是「每个 kernel 的提交开销」,重叠调度折掉的是「每批之间的调度开销」。两者解决的不是同一段 CPU 时间;图捕获之后,调度器仍然是那个每步都要跑一遍 Python 的单线程,重叠就是它唯一的藏身之处。
SGLang:同一线程里的先发后收
SGLang 的调度器是一个单线程 Python 循环,跑在 schedule_stream 上(启动时专门挑一个与 forward_stream 不同的流,避免两个流在同一硬件队列上互相挤占)。dispatch_event_loop 根据配置在两个循环之间选一个:
def event_loop_normal(self): while True: self.ingest_requests() plan = self.get_next_batch_to_run( running_batch=self.running_batch, last_batch=self.last_batch ) self.running_batch = plan.running_batch batch = plan.batch_to_run if batch: result = self.run_batch(batch) self.process_batch_result(batch, result) else: self.on_idle() self.last_batch = batchevent_loop_normal 就是开头说的同步形态:run_batch 发射前向后,会在同一个调用里把本批结果 D2H 拷回 CPU(batch_result.copy_to_cpu(...)),因此 run_batch 返回时 GPU 前向已经跑完;随后 process_batch_result 才在 CPU 上处理这份结果。整个 decode step 里,GPU 前向期间调度器线程没有别的事可做,只能等在同步拷贝上;下一批的调度必须等这一批处理完才能开始。
event_loop_overlap 则把「收」推迟了一个循环:
def event_loop_overlap(self): self.result_queue = deque()
def pop_and_process(): tmp_batch, tmp_result = self.result_queue.popleft() self.process_batch_result(tmp_batch, tmp_result)
while True: self.ingest_requests() plan = self.get_next_batch_to_run( running_batch=self.running_batch, last_batch=self.last_batch ) self.running_batch = plan.running_batch batch = plan.batch_to_run disable_overlap_for_batch = self.is_disable_overlap_for_batch( batch, last_batch=self.last_batch )
if disable_overlap_for_batch: pop_and_process()
if batch: batch_result = self.run_batch(batch) self._apply_war_barrier() self.result_queue.append((batch.copy(), batch_result)) else: batch_result = None self._sched_idled = True
if self.last_batch: if not disable_overlap_for_batch: pop_and_process() elif batch is None: self.on_idle()
if self.is_generation: self.launch_batch_sample_if_needed(batch_result, batch)
self.last_batch = batch把一次循环按时间顺序排开,就是:
时间 →
CPU(schedule_stream): | 调度第 N 批 | ─── 处理第 N-1 批 ─── | 调度第 N+1 批 ... ^run_batch(N)发射 ^process_batch_result(N-1)GPU(forward_stream): |==== 前向 N ====| |==== 前向 N+1 ====|CPU(copy_stream): |D2H N| ...关键点有三个。
第一,处理第 N-1 批发生在第 N 批已经发射之后。process_batch_result(N-1) 里的所有 Python 工作——更新请求状态、决定哪条请求被停止、把前缀树节点插入、统计计数、打包输出发回 tokenizer 进程——都在 GPU 跑第 N 批前向的这段时间里完成。这就是重叠的全部收益来源:调度器的「第 2、3 类工作」被塞进了 GPU 的阴影里。
但「塞进去」不等于「完全免费」。process_batch_result 内部读结果时会触发 copy_done 的同步等待,而 copy_done 绑在 copy_stream 的 D2H 上;如果 D2H 本身还没排到,调度器会先卡在这段等待上,随后才继续做 Python 处理。也就是说,process_batch_result 的耗时由「等 D2H」与「真处理」两段组成:前者被前向 N 覆盖,后者才是真正由 CPU 花掉的时间。判断重叠是否有效,本质上是判断前者是否足够小——这取决于 copy_stream 能否与 forward_stream 真正并发,而不是取决于 Python 代码本身快不快。
第二,等待队列 result_queue 的深度结构上最多为 2。循环回到调度点时,队列里恰好保留着「刚发射、还没处理」的那一批,深度为 1;run_batch 发射第 N 批之后、pop_and_process 处理第 N-1 批之前,深度短暂为 2。这个上界说明了一件事:如果 process_batch_result 比一次 GPU 前向还慢,队列并不会越积越多,而是下一批的发射被整体推迟——CPU 处理挤占了本应留给前向的时间,GPU 出现空档。因此「队列深度」不是判断瓶颈的好指标,真正要看的是两次 launch 的间隔与调度线程自己的耗时,后面会讲怎么观测。
第三,batch.copy() 被放进了队列。ScheduleBatch 是会被复用的对象:下一轮 get_next_batch_to_run 会在这同一个对象上合并新请求、重写 input_ids、推进 seq_lens、替换 spec_info,而队列里的结果要等到那一轮之后才处理。所以必须在发射时做一次快照,把「结果所属的批」与「正在被改写的批」分开。这个拷贝本身也是 CPU 工作量的一部分,属于重叠要藏进 GPU 阴影里的开销。
还有一层容易被忽略的保护:run_batch 里包着一个 _forward_isolation(batch, overlap=True)。它在发射前对 ScheduleBatch 的字段做快照,把 sampling_info 换成只读副本(避免一次前向里多次 init_new 重复累加惩罚),前向结束后再恢复字段;同时在 overlap 模式下把批对象与快照「钉」进 batch_record_buf 两个迭代,防止 CUDA 缓存的复用器过早回收前向仍在读的张量。换句话说,重叠调度不仅要让 CPU 与 GPU 并行,还要让同一个 Python 对象在三个时间层里同时有效:GPU 正在读的那一份、CPU 正在改写的那一份、以及等待被处理的快照。这是重叠实现复杂度的主要来源。
run_batch 在重叠模式下做了什么不同的事
run_batch 在 enable_overlap 分支里,主要工作都在 forward_stream 上完成:
with self.forward_stream_ctx: self.forward_stream.wait_stream(self.schedule_stream) self.future_map.resolve_seq_lens_cpu(batch) ... resolve_forward_inputs(batch, self.future_map) with self._forward_isolation(batch, overlap=True): future_indices = batch.req_pool_indices batch_result = self.model_worker.forward_batch_generation(batch) if batch.spec_algorithm.is_none(): self.future_map.publish(future_indices, batch.seq_lens + 1) batch_result.copy_done = self.device_module.Event() self._copy_result_to_cpu(batch_result, batch)这里 forward_stream.wait_stream(self.schedule_stream) 是第一步,含义是「GPU 前向开始之前,先把 schedule_stream 上已经排队的 H2D 拷贝与调度阶段的小内核跑完」。因为 resolve_forward_inputs 里会往输入缓冲里写待解析的 input_ids(来自 FutureMap),这些写入是排在 schedule_stream 上的(run_batch 本身所在的线程),而前向在 forward_stream 上,两者之间没有隐式顺序,所以需要一个显式的 wait_stream 把 schedule_stream 的队列「接进」forward_stream。
publish 在非投机路径下只做一件事:在 forward_stream 上登记一个「这一批的输出已经可用」的事件,并把本批的 req_pool_indices 存起来。它并不消费结果,只登记「结果在哪里、何时可用」。这是 SGLang overlap 里最巧妙的一处:调度器并不需要在 CPU 上拿到采样结果才能发射下一批;它只需要知道「结果的地址」与「结果可用的时机」。
_copy_result_to_cpu 负责把结果拷回 CPU,它被安排在 copy_stream 上:
def _copy_result_to_cpu(self, batch_result, batch): copy_fn = partial( batch_result.copy_to_cpu, return_logprob=batch.return_logprob, return_hidden_states=batch.return_hidden_states, ) self.copy_stream.wait_stream(self.forward_stream) with self.copy_stream_ctx: copy_fn()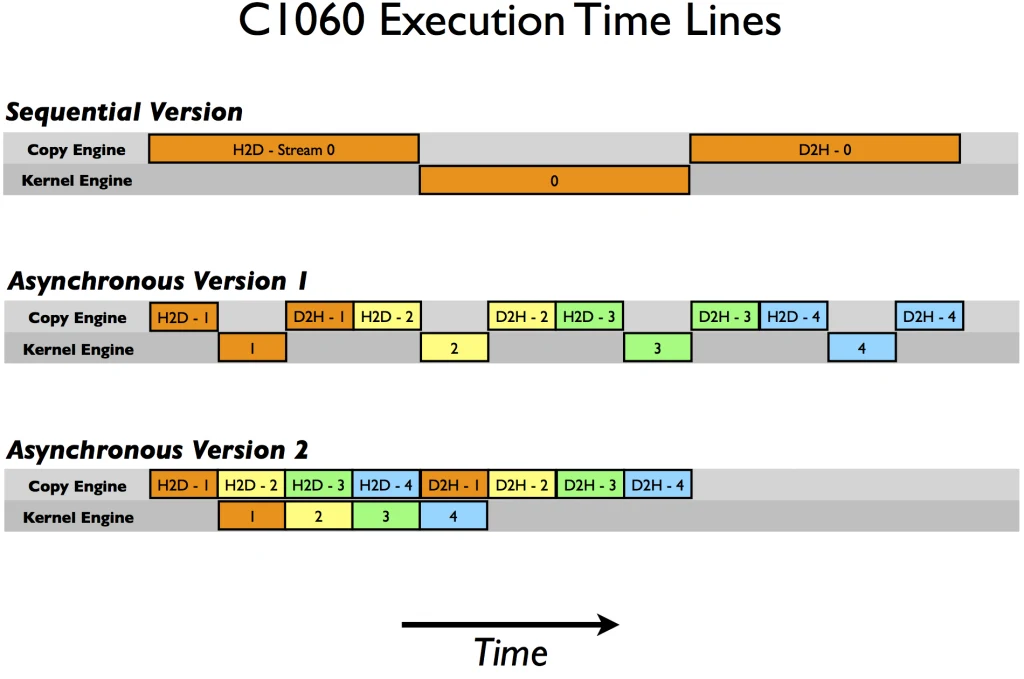
SGLang 的三条流正是这张图的实例:schedule_stream 上是调度器的 H2D 与输入 gather,forward_stream 上是 78 层前向,copy_stream 上是本批结果的 D2H。图中重叠区就是「调度第 N+1 批的同时前向第 N 批」。
copy_stream 是一个「叶子流」,只等待 forward_stream,forward_stream 从不会等它。它的存在意义是:D2H 拷贝(把本批采样出的 token id、logprob 拷回 pinned 内存)可以和下一批前向同时在 GPU 上排队。如果 D2H 直接排在 forward_stream 上,它会排在本批前向之后、下一批前向之前,process_batch_result(N-1) 就要等前向 N 跑完才能读到结果,等于把等待从一个 GPU 前向的跨度拉长到半个循环;如果 D2H 排在 schedule_stream 上并且同步执行,则又阻塞了调度器线程本身。独立拷贝流让这三方各自独立推进。
_copy_result_to_cpu 里还有一条 confidential computing(CC)分支:在 NVIDIA CC 模式下,per-step 的 D2H 回读会被强制同步,直接阻塞调度器线程 → 重叠失效。SGLang 的处理方式是把它交给一个后台线程 AsyncD2HCopyWorker 去等。这一条代码注释值得单独看,因为它证明了一件事:重叠调度依赖 GPU 侧「D2H 可以不阻塞提交线程」这一硬件行为;一旦底层 API 变成同步的,上层就必须自己造一条线程来模拟异步。
等待队列里到底存了什么,为什么是「上一批」
result_queue 存的是 (batch_copy, batch_result)。batch_result 内含若干还没被消费的设备事件(copy_done)以及 GPU 上的输出张量;batch.copy() 是发射后对调度批的快照。pop_and_process 把它们交给 process_batch_result,后者在 CPU 上读取结果时,必须先等 copy_done 事件(GenerationBatchResult.copy_to_cpu 把事件与拷贝绑定,读取时隐式同步)。所以在 event_loop_overlap 的执行序里,process_batch_result(N-1) 内部等待 copy_done(N-1) 的时间,正好被「前向 N 已经发射、GPU 正在算第 N 批」覆盖掉了——这段等待不再是裸露的 GPU 空闲,而是隐藏在前向 N 之下的等待。
这也是为什么结果处理和下一批发射的顺序必须是「先发后收」:先发,让 GPU 有事可做;后收,让等待有东西可藏。反过来写成「先收后发」就成了同步调度。
process_batch_result 里到底做了什么
把上一批结果「放到 GPU 阴影里」的,是 process_batch_result 这一整段。源码里它做的事比名字多:
def process_batch_result(self, batch, result): if self._deferred_responses: self.stream_released_deferred_outputs() # 轨迹上报在 overlap 模式下正好落在下一批前向的窗口里 flush_trace_batch(batch.reqs) snapshot = self.publish_load_snapshot(force=batch.forward_mode.is_extend()) self.load_publisher.publish_load_stat( self.load_inquirer.get_loads, force=batch.forward_mode.is_extend(), snapshot=snapshot, ) if batch.forward_mode.is_decode(): self.batch_result_processor.process_batch_result_decode(batch, result) elif batch.forward_mode.is_extend(): ... # 前缀树的待写回备份在下一步调度前提交 self.tree_cache.flush_pending_backups() self._record_step_counters(batch, result) self.metrics_reporter.log_batch_result_stats(batch, result)这里有三个值得注意的设计。其一,负载信息被放在结果处理路径里发布,而不是单独开线程:publish_load_snapshot 与 publish_load_stat 要把「当前 running 队列长度、KV 使用率」告诉 router,供它做缓存感知路由;重叠调度下这一步天然落在下一批前向的窗口里,等于把路由信息的刷新也免费了。其二,flush_trace_batch 把 trace 上报放在这里,理由相同——CPU 的 JSON 序列化与 ZMQ 发送都藏在前向背后。其三,tree_cache.flush_pending_backups() 把前缀树节点的宿主备份推迟到「下一批结果处理完、下一步调度前」,避免在发射窗口里做可能阻塞的写回。
这三个动作原来在同步调度下都会增加 step 的串行时间;重叠调度并没有让它们变快,只是把它们挪到了 GPU 已经在工作的时段。代价是它们读到的状态是「上一批的」——例如发布给 router 的 KV 使用率迟了一个 batch,router 基于它做的路由决策也迟了一个 batch。对缓存感知路由来说,一个 batch 的延迟通常可以接受;对「KV 快满了要立刻拒绝新请求」这类硬约束,就必须另设一条同步路径,不能依赖这条被推迟的信息。
四个需要显式同步的点
重叠把依赖从「线程内顺序」变成了「跨流顺序」,所以每一处原来看起来天然成立的顺序,现在都要显式声明。SGLang 的代码里能辨认出四个:
WAR 屏障:调度流的写入要排在上一批前向的读取之后
def _apply_war_barrier(self): runner = self.model_worker.last_shared_read_runner ev = runner.shared_read_done_event runner.shared_read_done_event = None if ev is not None and not envs.SGLANG_FORCE_COARSE_WAR_BARRIER.get(): self.schedule_stream.wait_event(ev) else: self.schedule_stream.wait_stream(self.forward_stream)WAR(Write After Read)是「写后读」的反向——这里真正的问题是不规则的:调度流的下一步要写输入缓冲里的某些行,而当前这一批的前向刚刚读过这些行。跨流时这两者没有顺序,CUDA 也不管。如果调度流抢在前向读取之前改写了输入缓冲的行,这一批前向就会读到下一批的数据,结果直接错。
代码给了两级:如果 worker 能精确知道「本批前向最后一次读共享缓冲是在哪」,就在那一处登记一个 shared_read_done_event,屏障只需 wait_event 那个事件;否则退化成粗粒度的 wait_stream(forward_stream)——整个前向都跑完才放行。精细版允许下一批的输入准备和前向的后半段重叠(例如前向的最后一层不再读输入缓冲,那么从那一刻起就可以写),粗粒度版则把重叠度限制在「前向之前的调度」与「前向并行」。在 GLM-5.3 的 MoE 与 DSA 路径下,输入缓冲会被注意力、MoE 的门控、DeepEP 的 dispatch 多处读到,所以大多数配置实际走的是粗粒度路径;这也是为什么 SGLang 提供了 SGLANG_FORCE_COARSE_WAR_BARRIER 来强制走粗粒度,用于排障对照。
注意 _war_barrier 是在 run_batch 返回后、result_queue.append 之前调用的,位置非常关键:它要在调度流已经准备好下一批的输入之后生效,而下一批的输入准备发生在 run_batch 内部(resolve_forward_inputs 部分),所以屏障必须放在「发射完这一批」之后。
结果处理与下一步调度之间的「样本」依赖
event_loop_overlap 末尾有一段:
if self.is_generation: self.launch_batch_sample_if_needed(batch_result, batch)注释说得很直白:它依赖上一批的处理结果(例如语法 FSM 的状态),所以要放在 pop_and_process 之后。这就是「延迟采样」:run_batch 在 delay_sample_func 不为空时只做了前向、没有做采样,采样函数的闭包被挂到 batch_result 上,等 process_batch_result(N-1) 把上一批的 grammar FSM 推进之后,才在 forward_stream 上执行采样。原因在于结构化输出的 bitmask:第 N 批的 bitmask 取决于第 N-1 批实际采样出的 token(FSM 的当前状态),而第 N-1 批的 token 现在还没在 CPU 上处理完。把采样推迟到「上一批处理完之后」,CPU 上的 FSM 推进与 GPU 上的采样内核之间形成了一个新的依赖,同时又保留了「采样本身还在 GPU 上跑、不阻塞调度」的性质。
序列长度:用「预言」的 seq_lens 构造下一批
resolve_seq_lens_cpu:
if self.needs_cpu_seq_lens: ... batch.seq_lens_cpu = batch.seq_lens.cpu()重叠时,调度器在构造第 N 批时,只能拿到第 N-1 批的预测序列长度(seq_lens + 1,因为 decode 一步加一)。对于非投机 decode 这是精确的;对于投机解码,接受多少个 token 取决于第 N-1 批的验证结果,而验证结果此时还在 GPU 上。SGLang 的处理是:如果注意力后端声明「需要 CPU 侧 seq_lens」,就 batch.seq_lens.cpu() 做一次同步读取——这一次读取会等 GPU,直接吃掉重叠;如果后端(例如 TP 组的 flashinfer 部分路径)不需要 CPU seq_lens,走 gpu_only_lens 路径,seq_lens 只在 GPU 上解析,CPU 侧不读。FutureMap.__init__ 里的 needs_cpu_seq_lens 就是判断依据。
GLM-5.3 的 DSA 稀疏注意力需要 indexer 知道每行的有效长度,decide_needs_cpu_seq_lens(attn_backends) 会遍历 attn_backends,只要有任何一个后端声明需要就把 needs_cpu_seq_lens 置真。所以 GLM-5.3 在 SGLang 上的重叠程度其实取决于注意力后端的具体实现——第十六篇讲的「8 个头的注意力按 64 个头算」在这里也有回声:DSA 后端是自定义的,它的 seq_lens 需求决定了「一行 D2H」是否要占掉 GPU 阴影。
投机解码:草稿树也要跨批传递
run_batch 里:
if not batch.spec_algorithm.is_none(): batch.spec_info = batch_result.next_draft_input batch.spec_info.future_dsa_topk_indices_available = ( batch.spec_info.dsa_topk_indices is not None ) batch.spec_info.future_indices = future_indicesMTP 的下一轮草稿输入,不是 CPU 上现算的,而是由 batch_result.next_draft_input 传过来——并且它本身也是「还没在 CPU 上解析的」设备张量。也就是说,在一次 overlap 循环里,第 N+1 批的草稿树、第 N 批的 accept 结果、第 N-1 批的前缀 KV 引用计数,同时在三个不同的「时间层」里流动。第十四篇讲 MTP 三段前向时只讲了 GPU 侧的算子,本篇补上这三段结果在 CPU 上是怎样被延后处理的。
PD 分离的 prefill 侧:搬运被推迟,早发被补齐
第十六篇讲过,PD 分离的 prefill 节点算完一批就要把 KV 交给 decode 节点。重叠调度会让这件事的时机整体后移,代码里有两处对应的补偿。
第一处是 KV 搬运被推迟。SGLang 的 schedule_batch.py 在 request 上留有注释:非重叠模式下每跑完一个 chunk 就在 process_prefill_chunk 里发 KV,而重叠模式下 KV 在那一刻还没就绪,于是搬运被推迟到 process_batch_result_disagg_prefill,并用 tmp_end_idx 记住「该发到哪」。run_batch 在 disaggregation_mode == PREFILL 时、进入前向前还会调用 maybe_send_cached_prefix_chunk,把已缓存的前缀先发出去、让它与后缀的前向重叠;但必须先用 load_pending 排除「这段前缀正被一次尚未完成的 HiCache load 写入」的情况,否则会发出还没写完的页。
if self.disaggregation_mode == DisaggregationMode.PREFILL: # 本批要早发的「缓存前缀」可能正被一次尚未完成的 HiCache load 写入, # 不能把它当成命中。 load_pending = batch.hicache_consumer_index >= 0 for req in batch.reqs: self.maybe_send_cached_prefix_chunk(req, allow_send=not load_pending)第二处来自注释 pending_bootstrap:在 overlap 序列里,建立 sender 时可能发现一个「乐观的」(optimistic)请求应当放弃后续 chunk,而这个标记要等到结果解析时才消费。于是调度器必须承认,一个已经发射的 chunk 只能等它的结果回来再处理:process_pending_chunked_abort 在调度步开头把 chunked_req 清掉,阻止下一个 chunk 发射;已经飞出去的那个 chunk 要到结果被解析时才被丢弃——重叠下这一解析晚一步发生,所以 batch-result 处理器里专门保留了 inflight_middle_chunks 记账,并在 process_batch_result_disagg_prefill 里按 is_aborted 丢弃。同步调度时这种「发了就撤」的时序问题根本不存在。
为什么 PP 走向了另一条路
SGLang 在 PP 场景直接关闭重叠(_pipeline_parallel_overlap_disable),代码里也留着 # FIXME: pp is not compatible with overlap。这不是随手加的限制,而是两种并行的目标冲突:流水并行要的是多个微批同时在飞,每个 stage 都在处理不同的 batch,靠「stage 之间错开」填满流水线;SGLang 的 overlap 则假设一次只有一批在前向,靠「这一批的结果处理」去填下一批的窗口。把两者硬叠在一起,ScheduleBatch 就不再只对应一次前向:它可能在 stage 0、stage 3、stage 7 各有一份在飞的结果,result_queue 里存的 batch_result 也不再是「上一批」,而是「上一批在某个 stage 上的代理张量」。SGLang 的调度器没有为这种多 stage 的结果排队建模,所以选择关掉重叠、由 PP 自己的微批流水来提供并行度。
vLLM 的选择相反:它没有沿用「一批一结果」的队列,而是把 batch_queue 做成可容纳 max_concurrent_batches 个 future 的环形队列。PP=4 时队列深度就是 4,四个 stage 各自的 future 都在队列里;调度器在队列未满时继续调度,队列满时才阻塞取最早的一个。于是「重叠」在 vLLM 里不是「先发后收」的时序技巧,而是队列深度本身:只要队列里有 future 在飞,GPU 就有活干;调度器本地要做的,只是保证每个 future 都携带正确的 SchedulerOutput,以便结果回来时能对上号。
这也解释了为什么 vLLM 的 async scheduling 在 PP 上受限:async 输入回填需要「上一批采样 token 直接留在 GPU 上」,而 PP 的中间 stage 根本不采样。代码里为此有一条跨 stage 的采样 token 广播:最后一个 stage 在 sample_tokens 里调用 _pp_broadcast_prev_sampled_token_ids,把形状为 [num_reqs, 1] 的采样结果用 torch.distributed.broadcast 发给所有 stage;中间 stage 收到后填进自己的 input_batch.prev_sampled_token_ids,再走与单机相同的 scatter 回填路径。广播异步发起(async_op=True),结果在 _prepare_input_ids 开头才 wait(),于是「广播在飞」的时间同样被这一 stage 的前向盖住。它只对 [num_reqs, 1] 成立——纯 decode 每请求正好一个 token;分块预填里采样的是 dummy token,代码直接跳过广播。即便如此,V1 Model Runner 的注释仍把 async + PP>1 + V1 标成「不完整支持」,max_concurrent_batches 因此只按 PP 度返回,不额外多留一批。
vLLM:step 循环、batch queue 与异步调度
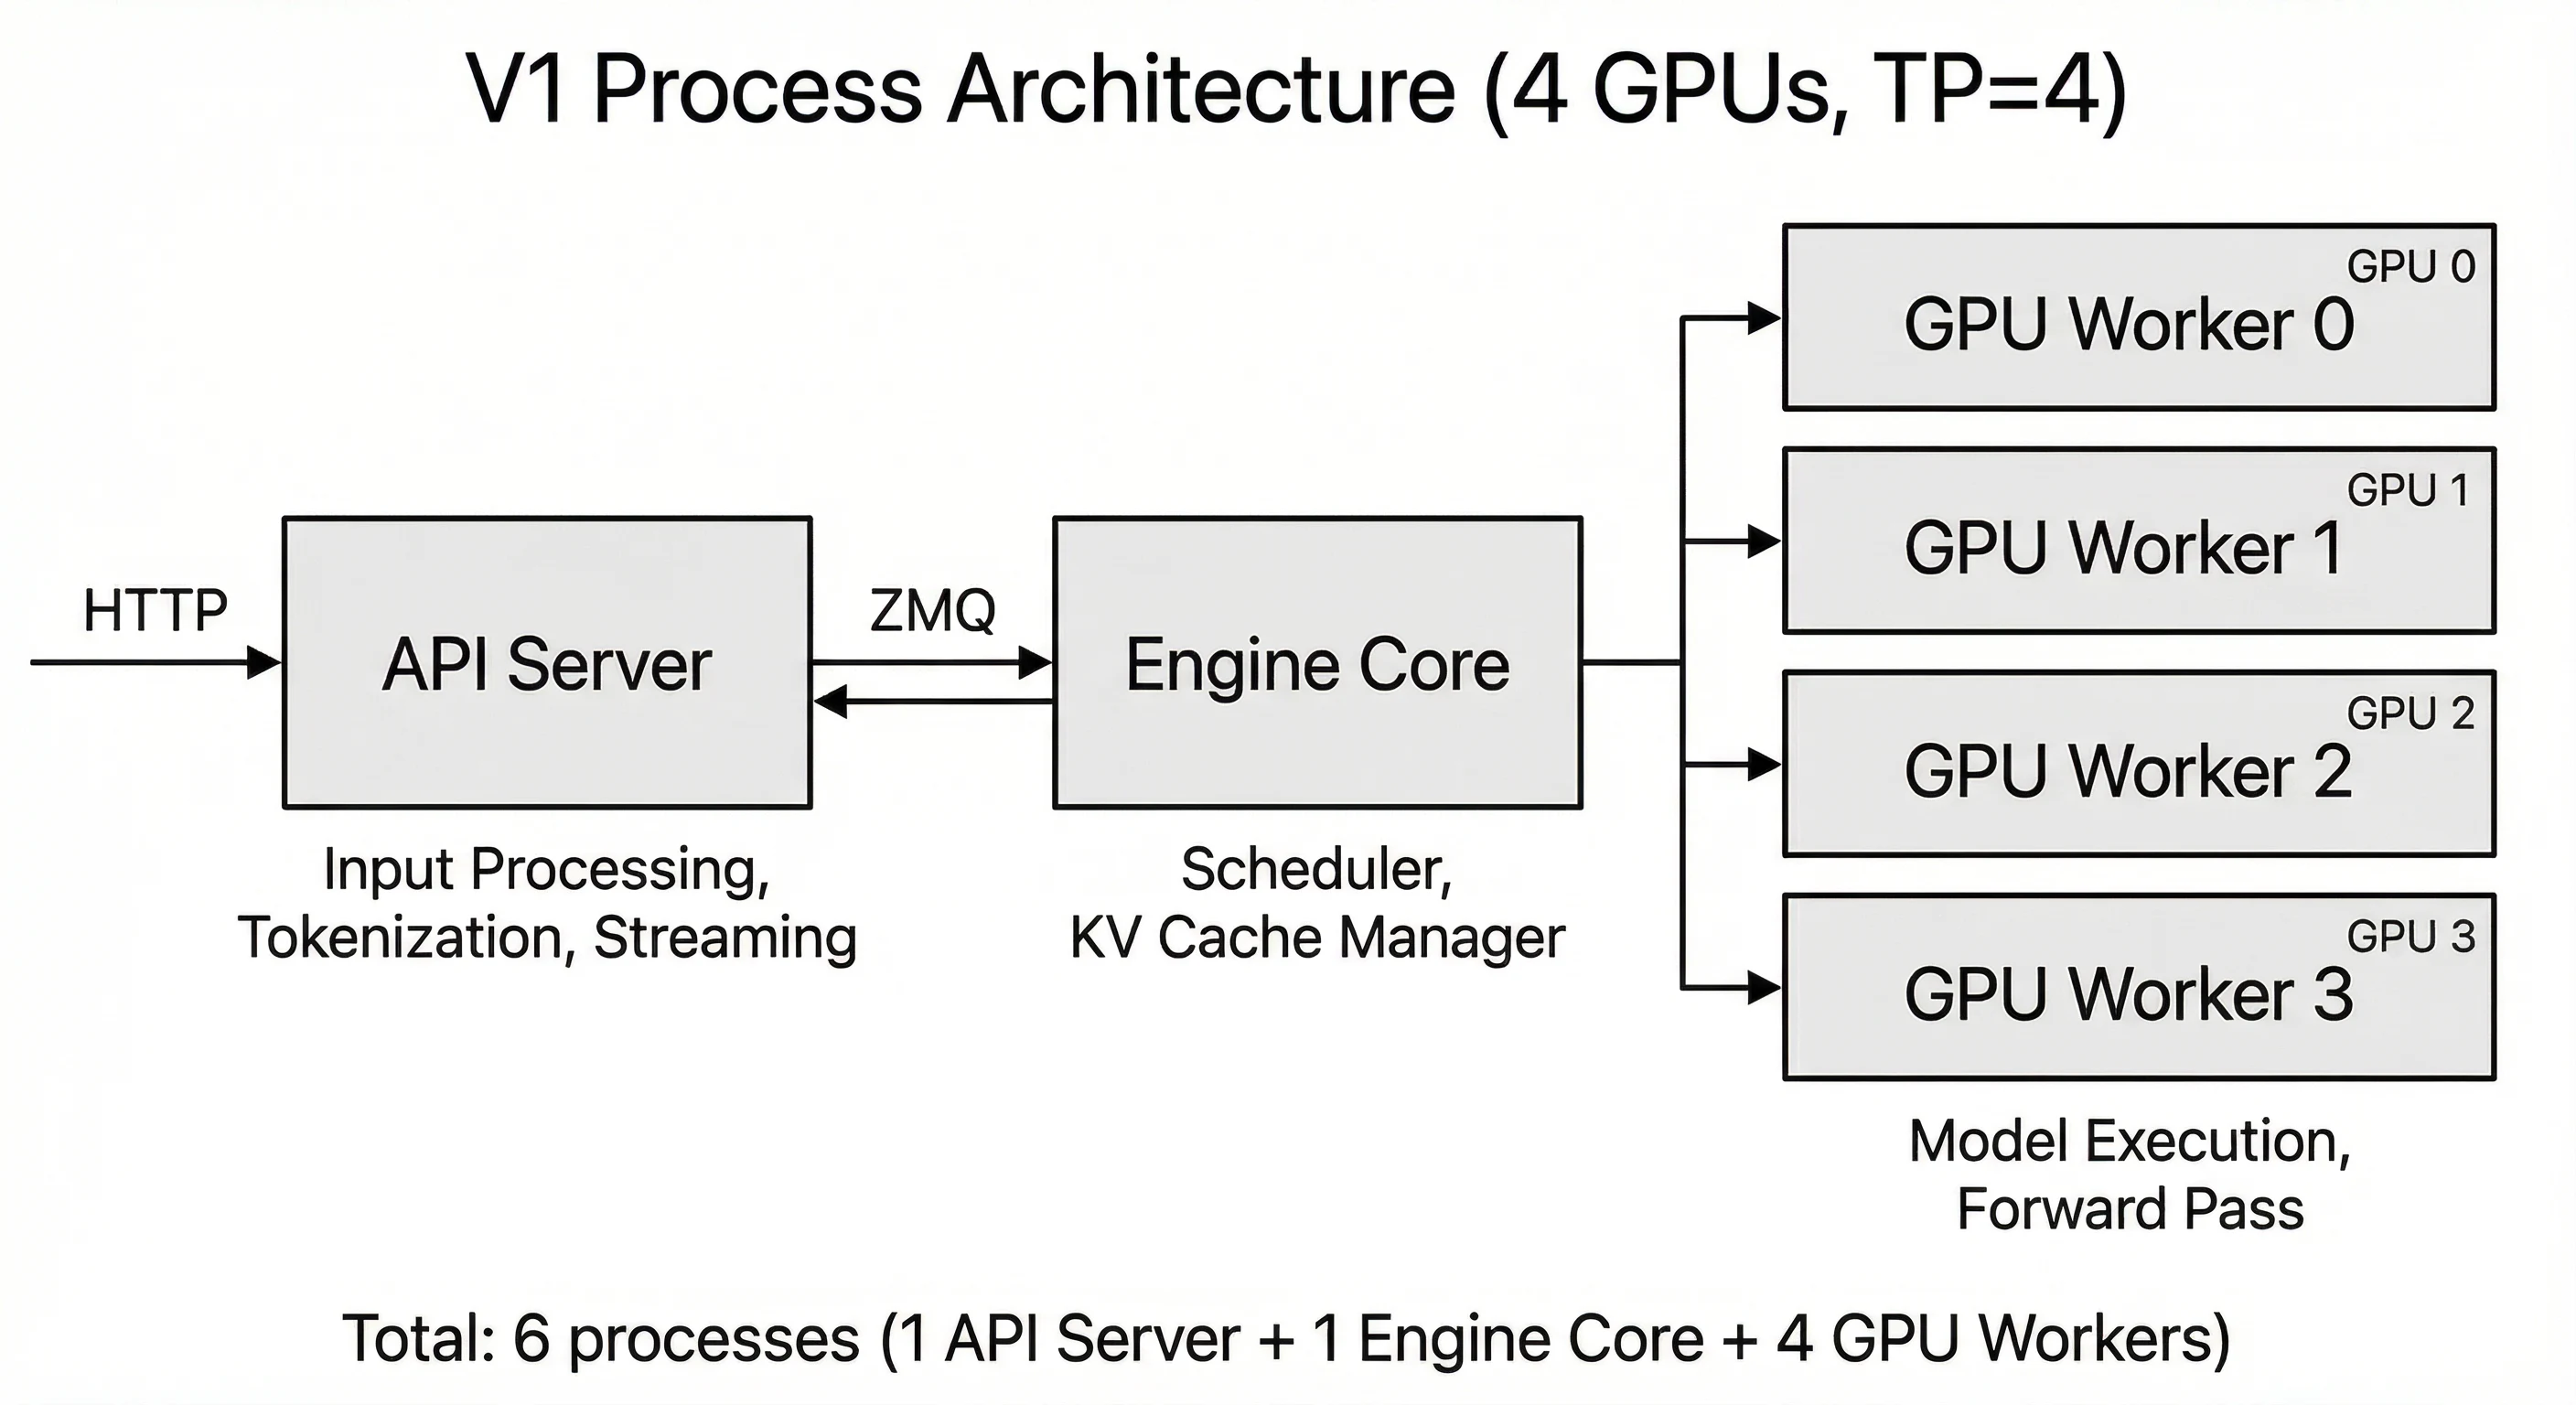
先看进程边界,因为这决定了 vLLM 能在哪里重叠。调度器在 EngineCore 进程里,模型前向在 worker 进程里;execute_model(non_block=True) 返回的是一个跨进程的 future,而不是本进程内可以随手读的张量。因此 vLLM 的「等待」天然带着一次 IPC 往返:调度器把 SchedulerOutput 发过去,worker 跑完再把 ModelRunnerOutput 发回来。想把这段等待藏起来,要么把多批 future 排成队列(batch queue),要么把输入 token 的回填也搬到 worker 里(async scheduling)。
vLLM 的调度器与 SGLang 的形态不同。vLLM V1 把 EngineCore 拆成一个单独的进程(EngineCoreProc),调度器在 EngineCore 主线程里跑,worker 在子进程里跑模型。主线程与 worker 之间通过 multiprocessing 的 future 与消息队列通信,模型前向的返回值不是张量,而是一个 Future[ModelRunnerOutput]。
普通 step:发射、阻塞、处理
EngineCore.step:
def step(self): if not self.scheduler.has_requests(): return {}, False scheduler_output = self.scheduler.schedule(self._should_throttle_prefills()) future = self.model_executor.execute_model(scheduler_output, non_block=True) grammar_output = self.scheduler.get_grammar_bitmask(scheduler_output) with self.capture_iteration_details(...): model_output = future.result() if model_output is None: model_output = self.model_executor.sample_tokens(grammar_output) self._process_aborts_queue() engine_core_outputs = self.scheduler.update_from_output(scheduler_output, model_output) ...future.result() 之前,只做了两件事:schedule 和 get_grammar_bitmask。future.result() 之后才是 update_from_output(结果处理)。也就是说,默认 step 里唯一被塞进 GPU 前向窗口的 CPU 工作是语法 bitmask 的计算;schedule 在发射之前,update_from_output 在等待之后,两者都还在前向之外串行。对 GLM-5.3 这种每步要遍历数百条 running 请求、计算 prefix cache 命中、分配 KV block 的模型,schedule 的 CPU 开销并不小,默认 step 会让它整段暴露在 GPU 空档里。
non_block=True 只是让 execute_model 立刻返回一个 future,而不是让调度器在等待时去干别的活:Python 主线程下一步就是 future.result(),中间只夹了一个 bitmask 计算。所以「异步 API」不等于「异步调度」——前者只是把等待点从调用内部挪到了显式的 future.result(),后者要改变「下一批在什么时候被构造」。
step_with_batch_queue:把「发射」与「消费」拉开
step_with_batch_queue 是 vLLM 对重叠的加强版。它是否启用由 max_concurrent_batches 决定:PP 度大于 1 时等于 PP 度(流水线本来就要多批同时在飞),开启 --async-scheduling 且 PP 度为 1 时等于 2。只要 batch_queue_size > 1,EngineCore 就把 self.step_fn 换成 step_with_batch_queue:
def step_with_batch_queue(self): batch_queue = self.batch_queue ... if self.scheduler.has_requests(): scheduler_output = self.scheduler.schedule(...) exec_future = self.model_executor.execute_model(scheduler_output, non_block=True) ... batch_queue.appendleft((future, scheduler_output, exec_future)) if len(batch_queue) < self.batch_queue_size and ( model_executed or self.scheduler.has_requests() ): return None, model_executed # 队列没满,先不消费 # 队列满了或者没有新请求可调度:阻塞等最早的一批 future, scheduler_output, exec_model_fut = batch_queue.pop() model_output = future.result() ... engine_core_outputs = self.scheduler.update_from_output(scheduler_output, model_output)batch_queue 的深度是 batch_queue_size,也就是上面那个 max_concurrent_batches——PP=4 时是 4,PP=1 加 async scheduling 时是 2。与 SGLang 的 result_queue 不同,vLLM 的队列里存的是多批的 future,并且「调度 → 发射 → 消费」以「队列满」为节奏推进。当队列未满,step_with_batch_queue 直接返回 None(表示本步没有输出可发),下一轮 _process_input_queue 再进来、再调度一批。等到队列满,才取最早的那一批阻塞等结果。
这带来了一个可观测的副作用:输出的发出节奏不是每个 step 一次,而是每 batch_queue_size 个 step 一次。在 async scheduling(深度 2)下,输出会以「两批一次」的粒度到达 tokenizer 进程与前端,SSE 按到达顺序拼接即可;代价是前端看到的首 token 与后续 token 的间隔呈现台阶状。GLM-5.3 在 vLLM 上测 TPOT 时,读数出现一段一段的台阶并不一定是 GPU 抖动,先确认是不是 batch queue 的节奏。
step_with_batch_queue 里还有一段专门处理结构化输出的 deferred 路径:
if not scheduler_output.pending_structured_output_tokens: grammar_output = self.scheduler.get_grammar_bitmask(scheduler_output) future = self.model_executor.sample_tokens(grammar_output, non_block=True)else: deferred_scheduler_output = scheduler_output当某一批里有结构化输出请求、且正在等待上一批的 token 来推进 FSM 时,采样不能立刻发,因为 bitmask 还依赖上一批的结果。vLLM 的做法是:先把前向 future 入队,但采样推迟到下轮消费完上一批的 model_output 之后再执行——在 step_with_batch_queue 末尾,deferred_scheduler_output 被拿出来、用最新处理过的 FSM 状态生成 bitmask,再发采样。这与 SGLang 的 delay_sample_func 本质相同:都要把「需要上一批结果的 CPU 工作」夹在两批之间。
async scheduling:在 GPU 上回填输入
--async-scheduling 是 vLLM 对重叠最激进的一版,也是本文最值得细读的一段。它要解决的问题是本章开篇说的第四类:decode 下一批的输入 token 来自本批采样结果,而这一批的采样结果还没回到 CPU。
worker 侧(gpu_model_runner.py)在 batch 未变化时不从 CPU 拷 input_ids,而是直接使用上一次前向留在 GPU 上的 prev_sampled_token_ids:
if self.input_batch.prev_sampled_token_ids is None: self.input_ids.copy_to_gpu(total_num_scheduled_tokens) return...if common_indices_match and max_flattened_index == (num_common_tokens - 1): # 批次未变化、无重排:一次切片拷贝即可 self.input_ids.gpu[:num_common_tokens].copy_( self.input_batch.prev_sampled_token_ids[:num_common_tokens, 0], non_blocking=True, ) return# 批次有变化:用 scatter 把各请求的采样 token 写到新位置self.input_ids.gpu.scatter_( dim=0, index=sampled_tokens_index_tensor, src=self.input_batch.prev_sampled_token_ids[prev_common_req_indices_tensor, 0],)把这段读透,需要理解 prev_positions 这个映射:它由 _compute_prev_positions 逐行填充,内容就是「当前批的第 i 行 = 上一批的第几行」,新请求为 -1。它依赖的 prev_req_id_to_index 是在上一批采样结束时按当时的 input_batch.req_ids 记录的:
self.input_batch.prev_req_id_to_index = { req_id: i for i, req_id in enumerate(self.input_batch.req_ids) if i not in invalid_req_indices_set}两批之间,input_batch 会删掉结束的请求、追加新请求,然后把空位「压紧」(condense() 把末尾的活动请求挪进空位)。这一挪动正是「行号会变」的来源——同一个请求在两批里的行号可能不同,甚至批次长度也不同。sample_flattened_indices 记录每个请求的「采样 token」在当前批展平 input_ids 里的位置(对 decode 请求就是该行最后一个 token),spec_flattened_indices 记录草稿 token 的位置;批次完全一致时走 fast path(一条切片拷贝),行号变动时走 scatter,按 prev_positions 把上一批的采样 token 散射到新位置。新请求的 prev_index 为 -1,直接跳过,它的输入由 CPU 侧的 input_ids.copy_to_gpu 提供。
draft token 的处理同理:prev_draft_token_indices 指向上一批草稿 token 在展平列表里的位置,用 self._draft_token_ids.flatten()[...] 取出后散射到本批的草稿位置。这样投机解码在 async 模式下也能在 GPU 内闭环,不需要 CPU 知道接受情况。
那么 CPU 侧怎么知道采样结果?答案是它也走一条独立的拷贝流:
self.async_output_copy_stream = torch.cuda.Stream()self.prepare_inputs_event = torch.cuda.Event(blocking=True)...self.valid_sampled_token_count_copy_stream = torch.cuda.Stream()self.valid_sampled_token_count_event = torch.Event()prepare_inputs_event 被设成 blocking(等待时睡眠而不是忙等),注释给的理由非常具体:在 TP 竞争下忙等 CUDA driver 锁会把等待膨胀,让这个 rank 成为 straggler。这是重叠调度在工程上的真实代价——每多引入一次跨流事件,就多一次对 CUDA driver 锁的争抢;在 8 卡 TP + GLM-5.3 这种每层都要 AllReduce 的配置下,任何一个 rank 的调度器抢不到锁而慢一拍,都会让整个 TP 组的下一步被拖慢。
调度器的「占位」记法
async scheduling 下,调度器不能在构造下一批前就知道本批采样出了什么——上一批的 KV 已经被 GPU 写进池子,但调度器「还没看到」。vLLM 的解法是 num_output_placeholders 与 num_in_flight_tokens,scheduler.py 的注释把它们讲得很清楚:
# 1. scheduler_output 必须包含本步调度的原始 token 数,worker 靠它决定输入。# 2. 调度完成后立即推进 num_computed_tokens,# 让同一请求在下一步还能马上被调度。# 3. 如果投机草稿被拒,num_computed_tokens 与 num_output_placeholders# 都会在 update_from_output 里按被拒数量回退。for req_id, num_scheduled_token in num_scheduled_tokens.items(): request = self.requests[req_id] request.num_computed_tokens += num_scheduled_token request.num_in_flight_tokens += num_scheduled_tokennum_computed_tokens 是「调度器视角已提交的 token 数」,num_in_flight_tokens 是「已经发射、结果还没结算的 token 数」,而 num_output_placeholders 是其中尚未被 CPU 确认的输出 token 占位。安排下一批时,请求能用的新 token 数是:
这个式子把两类 token 区分开:已经写进请求对象的 token(num_tokens_with_spec 包含已接受的输出与下一步的草稿)和还在 GPU 上、只占了位子的 token(num_output_placeholders)。两边都计入之后,n_{\text{new}} 恰好是本步要在输入里编码的 token 数——对纯 decode 是一条,「本步输出的占位」与「下一步的草稿」在一串减法里互相抵消,留下的是一个形状稳定的行。
schedule() 里还有两处直接用到占位计数。第一处判断「再调度一步也到不了 max_tokens」:
if ( request.num_output_placeholders > 0 # (num_computed_tokens + 1) - (num_output_placeholders - 1) and request.num_computed_tokens + 2 - request.num_output_placeholders >= request.num_prompt_tokens + request.max_tokens): req_index += 1 continue注释解释了 + 2 - placeholders 的含义:占位里可能夹着草稿 token,而草稿可能全部被拒,所以要按「最坏情况」判断是否还需要下一步,避免为一条已经到上限的请求多做一步前向。第二处是投机草稿的切片:
num_scheduled_spec_tokens = ( num_new_tokens + request.num_computed_tokens - request.num_tokens - request.num_output_placeholders)它只用「本步未占位的部分」来容纳草稿,保证每一步的草稿都以未确认的 token 为起点。
到了结果回来时,被拒的草稿要把两个计数一起回退:
if not output_is_stale: if request.num_computed_tokens > 0: request.num_computed_tokens -= num_rejected if request.num_output_placeholders > 0: request.num_output_placeholders -= num_rejected此外,worker 在异步模式下自己也在记账。gpu_model_runner.py 里有一段 deferred 的「投机修正」闭包:worker 在调度时先按「乐观接受数」推进 req_state.num_computed_tokens,等上一批的真实接受数 D2H 回来,再用 optimistic_num_accepted - num_accepted 的差值回退。注释里举的例子是三步:
step 1: num_computed_tokens = 0, spec_tokens = [], prev_num_draft_len = 0step 2: num_computed_tokens = 100, spec_tokens = [a, b], prev_num_draft_len = 0step 3: num_computed_tokens = 102, spec_tokens = [c, d], prev_num_draft_len = 2第 3 步时第 2 步的验证结果(接受了 a、b)还没回到调度器,但已经按「接受了 2 个」占位,并给下一步安排了新草稿 c、d。这套「先乐观、后修正」的记账与第十四篇 GPU 侧的 draft_extend 是同一个故事的两面:GPU 上算的是整桶的草稿,CPU 上记的「接受了几个」是一个迟到的标量。
等待队列的三种形态对照
把两套框架的等待队列并排看:
| 维度 | SGLang result_queue | vLLM batch_queue |
| --- | --- | --- |
| 队列存什么 | (batch_snapshot, batch_result) | (future, scheduler_output, exec_future) |
| 队列深度 | 循环边界为 1,处理瞬间为 2 | max_concurrent_batches:PP 度,或 async+PP1 时为 2 |
| 输入 token 来源 | FutureMap 在拷贝流上延迟解析 | CPU 侧 input_ids(同步回读) |
| 结果处理时机 | 发射下一批后 | 队列满时 |
| 主要工程代价 | WAR 屏障、needs_cpu_seq_lens | 输出节奏按队列深度成台阶 |
重叠会失效的场景:一张清单
重叠调度不是「开了就快」。下面这些场景下,重叠会明显打折或直接关闭,而且其中大部分在 GLM-5.3 的部署配置里真会发生:
连续两批都是 prefill。 SGLang 的 is_disable_overlap_for_batch 有一条判据是「连续两个 prefill 批则关闭重叠」。原因是 TTFT:两条 prefill 批叠加时,第二条 prefill 的发射会插到第一条的结果处理之前,导致第一条的 TTFT 反而变长。这条判据由环境变量 SGLANG_DISABLE_CONSECUTIVE_PREFILL_OVERLAP 控制,源码里的默认值是 False,即默认允许连续 prefill 重叠;只有显式打开这个开关,相邻 chunk 才会退回同步。对应到 GLM-5.3:第三篇讲的 1M 上下文分块预填里,每个 chunk 都是一次 prefill;是否在 chunk 之间保留重叠,取决于这台机器上 TTFT 与吞吐的权衡。混批(第九篇)中 8K 请求并进 decode 批,则不会触发这条判据。
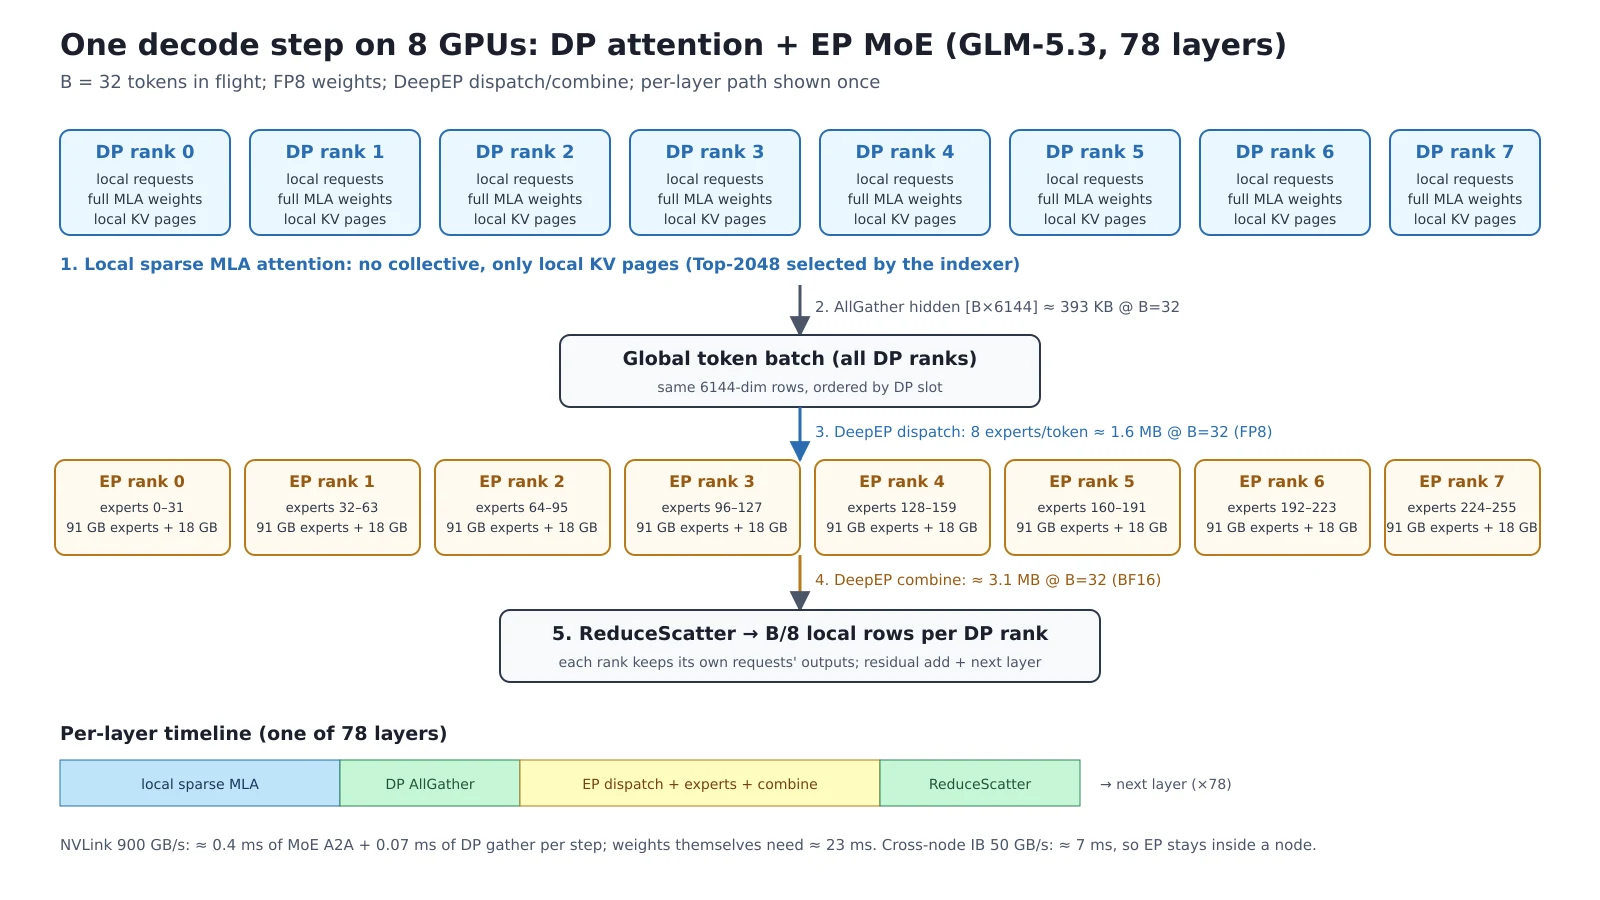
DP Attention 下各 rank 的重叠决策必须一致。 注释里写得很清楚:
if self.require_mlp_sync: is_extend = lambda b: b and b.is_extend_in_batchelse: is_extend = lambda b: b and b.forward_mode.is_extend()DP attention 下各 rank 处理的是不同的请求子集,但一次前向要在 MLP 后做 all_gather 同步 hidden state(第十七篇的 DP Attention 部分讲过),如果某个 rank 关闭了重叠、另一个没关,两边的发射节奏会错位,DP group 的同步点就会死锁。所以代码要求所有 rank 用全局同步过的 is_extend_in_batch 做判断,而不是各自的本地 forward_mode。这是一个典型例子:重叠逻辑的正确性依赖于全局一致性,而不是单 rank 局部的最优。
结构化输出与投机解码叠加。 is_disable_overlap_for_batch 的第二条:
need_grammar_sync = ( batch and not batch.spec_algorithm.is_none() and batch.grammar_needs_sync() and batch.forward_mode.is_decode() and len(self.result_queue) > 0)对支持 grammar-overlap 的算法,FSM 在 verify() 内部通过 grammar barrier 推进(_advance_pending_grammar),不需要关闭重叠。但不支持 grammar-overlap 的算法(如 host 侧草稿)在这里必须关闭重叠,做一次同步。GLM-5.3 的 MTP 是 GPU 侧草稿,且在 21 层 DSA 层上跑,是否支持 grammar-overlap 由 supports_grammar_overlap() 决定;这个开关一旦为假,每一步 decode 都会命中同步,重叠的收益直接归零。
GPU 只跑到一半,D2H 又必须在批内完成。 如果注意力后端需要 CPU 侧 seq_lens,resolve_seq_lens_cpu 会插入一次 .cpu();如果后端需要隐藏状态回传(return_hidden_states,例如 embedding 请求或某些 reward 模型),_copy_result_to_cpu 的 CC 分支也会退回同步。这些都在「每 step 一次」的粒度上加了一个隐式同步点。
整条重叠被框架自动关掉。 最彻底的一种失效并不发生在每次调度的判断里,而是启动时就被改写。SGLang 的 arg_groups/overrides.py 里有一组 register_post_process 钩子,会按模型与部署形态把 disable_overlap_schedule 强制读成 True:_pipeline_parallel_overlap_disable 判断 pp_size > 1 时打一条 warning 并关闭重叠;Mamba/线性注意力模型如果 mamba_radix_cache_strategy 退化成 no_buffer,同样关闭;embedding 模型的稀疏头、diffusion LLM 等也会关闭。GLM-5.3 的官方部署是 DP Attention + EP、PP=1,正好绕开了第一条;但只要为了把 1M 上下文塞进多机而启用 PP,重叠就被自动关掉,调度器的 Python 开销会重新暴露在每一步的前向之外。上线前值得把启动日志里的这类 warning 逐条核对一遍。
CPU 处理比 GPU 前向慢。 这不是配置问题而是负载问题:process_batch_result(N-1) 要做 prefix tree 插入、KV 引用计数、流式输出打包、采样计数,再加上 DeepEP 的 dispatch 元信息更新,在 GLM-5.3 的 78 层 + 9 专家结构下,这些 CPU 工作量并不小。一旦比前向慢,下一批的发射就被整体推到处理之后,GPU 出现空档,TPOT 反而变差。判断方式很简单:看 process_batch_result 的耗时与一次前向的时间比。
怎么判断重叠是否真的生效
重叠调度是「看不见就测不到」的一类机制,线上至少有四个可观测点:
第一,调度器线程真正占用的 CPU 时间。 SGLang 的 metrics 里有 scheduler time accounting(start_scheduler_time_accounting / record_scheduler_active),它用墙钟时间与 time.process_time_ns() 两条时钟做对照:调度器线程「醒了但没在算」的差值就是它被阻塞在同步点(.cpu()、事件同步、内核提交)上的时间。同步调度时,这段阻塞时间等于每个 decode step 的一次前向;重叠生效时,它应大幅缩小到只剩显式的同步点(WAR 屏障、事件等待)。
第二,结果张量的到达延迟。 把「第 N-1 批的采样数据实际可用」与「第 N 批被发射」两个时间戳相减。同步调度下前者总在后者之后;重叠调度下前者应该被前向 N 盖住,差值接近 0 或为负。
第三,decode step 的 launch 间隔。 _record_step_counters 用一个连续判据来统计「有效 decode 步」的时间:
contiguous = ( not batch.after_idle_gap and prev_iter + 1 == start_iter and prev_is_prefill == is_prefill)step_us = int((batch.launch_ts - prev_launch_ts) * 1e6)这个指标统计的是「两次 launch 之间的时间」,在重叠调度下约等于 GPU 前向时间加上少量发射开销;在同步调度下则包含完整的 CPU 处理时间。同一配置下两个模式的差值,就是重叠藏起来的那段。
第四,TPOT 的分布而不是均值。 GPU 在前向期间本来就是忙的,有没有重叠对 GPU 前向时长几乎没有影响,所以平均 TPOT 的差别有限;差别体现在分布上——同步调度会让每个 decode step 后面固定挂一段「GPU 等 CPU」的空档,P99 明显高于 P50;重叠调度把这段空档吃掉之后,分布会收拢,尾部变短。这正是重叠调度的主要收益:它主要改善的是尾延迟与时间线的平滑度,吞吐提升只是附带。
GLM-5.3 在 vLLM 上还要看一个额外指标:两次 step 的输出间隔是否呈现周期性台阶(batch_queue 的节奏)。台阶的深度就是 batch_queue_size 相关的延迟,在排查「前端看起来一卡一卡」时,先确认是否是 batch queue 的节奏,再去怀疑 GPU。
把 GLM-5.3 的部署参数对照一遍
把前文的判断落回 GLM-5.3 的实际启动参数,可以得到一张「哪些开关会改变重叠形态」的对照表:
| 部署选择 | 对重叠的影响 | 需要盯的地方 |
|---|---|---|
默认 --disable-overlap-schedule 不设置 | 重叠开启(enable_overlap = True) | 确认启动日志没有被 override 关闭 |
| DP Attention + EP(官方推荐) | require_mlp_sync=True,各 rank 用全局 is_extend_in_batch 做重叠决策 | 所有 rank 的 prefill/decode 判断必须一致,否则 MLP 同步点死锁 |
| 分块预填(1M 上下文) | 连续 prefill 默认仍可重叠;开 SGLANG_DISABLE_CONSECUTIVE_PREFILL_OVERLAP 才关闭 | TTFT 与吞吐的取舍;chunk 之间是否要同步 |
| MTP / EAGLE 投机 | 草稿树与 accept 结果跨批传递;grammar 是否可重叠取决于 supports_grammar_overlap() | 不支持 grammar-overlap 时每步 decode 强制同步 |
| 结构化输出 | delay_sample_func 把采样推迟到上一批 FSM 推进之后 | 采样闭包持有的 logits 与 vocab_mask 要及时释放,否则显存缓慢上涨 |
| PD 分离 prefill | KV 发送推迟到 process_batch_result_disagg_prefill;早发前缀要先排除在飞的 HiCache load | 分块预填的 tmp_end_idx 与 inflight_middle_chunks 记账 |
| 混批 | 重叠决策按「批内是否含 extend」统一判断;8K 请求并进 decode 批不触发连续 prefill 规则 | 混批的 KV 写入必须早于本步读取 |
| PP > 1 | SGLang 自动关闭重叠;vLLM 改用 batch_queue,深度=PP 度 | 启动 warning;TPOT 会重新包含调度开销 |
这张表里最容易被误判的是「默认开启」这一条:disable_overlap_schedule 的默认值是 False,所以 GLM-5.3 在单机 DP Attention 部署下通常就是重叠模式;但「默认开」不等于「实际生效」,前面列的 grammar 同步、PP override、needs_cpu_seq_lens 都会在运行时把某些 step 拉回同步。排障时不要只看启动参数,要看每一步的实际路径。
小结
重叠调度改变的是服务的时钟结构:同步调度时,GPU 的前向与 CPU 的处理是两个串行的阶段;重叠调度后,它们变成两条并行的流水线,中间只通过几个显式的同步点(WAR 屏障、D2H 事件、grammar barrier)相连。SGLang 用「同一线程里的先发后收 + FutureMap 延迟解析」实现,vLLM 用「step 循环 + batch queue + async 输入回填」实现,两条路线的共同点是:
- 发射这一侧被压到最小:调度器只登记「结果在哪里、何时可用」,不读结果;
- 消费这一侧被推迟:结果处理永远发生在下一批发射之后;
- 依赖这一侧被显式化:原先靠线程顺序保证的依赖,变成跨流事件、WAR 屏障、占位计数。
对 GLM-5.3 这类 DP Attention + 专家并行 + DSA + MTP 的模型,重叠并非全收益:连续 prefill、DP 一致性、grammar 同步、CPU 侧 prefix tree 更新都会在具体配置下开关它。第十六篇的 launch 账本与第十七篇的精度账本都默认「GPU 前向一结束、调度器立刻拿到结果」;本篇补上这一段后,一条请求在服务里真正的时间线才算完整——GPU 上的 78 层与 CPU 上的调度循环,是两条同时流动的河。
把两套框架的办法放在一起,可以归纳成三条通用原则,换成别的推理框架也同样适用:
- 先把等待点找出来:同步调用、
.cpu()、事件synchronize()、future.result(),每一个都是 CPU 与 GPU 之间的一次「握手」;重叠的改造就是逐个判断这次握手能否推迟、能否移到独立流上、能否用事件代替同步。 - 再给每个握手配一条流或一个事件:D2H 用拷贝流,输入写入用调度流加 WAR 屏障,输出可用性用事件;流的拓扑定了,重叠的形态也就定了。
- 最后为「看不到的结果」补记账:序列长度、占位 token、草稿接受数、语法状态,这些原本由同步读取直接得到的信息,在异步下必须改用预测加事后修正来维护,且所有 rank 的决策要保持一致。
还有一个容易被忽略的收尾问题:退出边界上可能还存在没被处理的结果。SGLang 的 event_loop_overlap 在 gracefully_exit 时直接 break,不会在循环里再把 result_queue 消费一遍;资源的善后交给 run_scheduler_process 的 finally——那里会停掉 async_d2h_worker、调用 release_host_resources(),异常路径还刻意跳过同步与销毁,避免 GPU 已经卡死时退出流程再挂一次。这类边界在同步调度下几乎不存在:同步时每条请求的结果都已经在 run_batch 返回时处理过,退出时没有「在飞但未处理」的对象;重叠之后,框架必须接受「最后一批结果可能不再进入调度器」这一事实,并把清理放到资源释放层,而不是调度层。
下一篇将讨论 进程间的那一段控制面:tokenizer 进程、router、EngineCore 与前端这四方在一条请求的生命周期里如何互相通知,以及当一个 rank 慢下来时,这种通知怎样把尾延迟放大。
参考资料
- GLM-5: from Vibe Coding to Agentic Engineering(GLM-5 技术报告,arXiv:2602.15763)
- zai-org/GLM-5.3 模型卡(744B-A40B、FP8、78 层、256 专家、1M 上下文)
- SGLang GLM-5.3 Cookbook(DSA 后端、MTP、DP Attention、PD 分离的启动参数)
- SGLang 源码:
scheduler.py(event_loop_overlap、result_queue、WAR 屏障与launch_batch_sample_if_needed) - SGLang 源码:
overlap_utils.py(FutureMap、publish、resolve_seq_lens_cpu与跨批张量中继) - vLLM 源码:
scheduler.py(num_output_placeholders、投机草稿切片与update_from_output) - vLLM 源码:
gpu_model_runner.py(async scheduling 的prev_sampled_token_ids回填与 deferred 修正) - vLLM Documentation: Optimization and Tuning(
--async-scheduling、CUDA Graph 与批调度选项) - Efficient Memory Management for Large Language Model Serving with PagedAttention(PagedAttention 与连续批处理,arXiv:2309.06180)
- SGLang: Efficient Execution of Structured Language Model Programs(RadixAttention 与前端/运行时结构,arXiv:2312.07104)
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA 与 MLA 结构,arXiv:2512.02556)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



