


GLM-5.3 推理全链路(十六):一条 decode step 的 kernel 账本——78 层里到底发了多少次 launch
这一篇在前十五篇的哪个位置
前十五篇沿着一条请求的时间线,把 GLM-5.3 在 SGLang 与 vLLM 里的入口、调度、DSA 注意力、MoE、PD 交接、MTP、输出侧、CPU 控制面、索引器缓存、冷启动逐段拆开。那些账本用的是三种单位:字节(一次前向读了多少 HBM、传了多少 NVLink)、阶段(请求走到了哪一步)、页(KV 与索引器缓存怎么分配和回收)。
这三个单位都回答不了同一个问题:这一步到底向 GPU 提交了多少个 kernel,它们之间怎么排队。 一次 decode step 在 SGLang 里不是「一次前向」这么简单,而是上千次 kernel launch 组成的一张依赖图。图的形状决定了三件事:
- CPU 侧能不能跟上。每个 launch 都有固定的提交开销,batch 越小、上下文越短,GPU 每个 kernel 跑得越快,CPU 越容易成为瓶颈。
- 融合的收益边界在哪里。把两个算子融进一个 kernel,省下的不只是一次显存往返,还有一次 launch 与一次调度间隙。
- 哪些 kernel 必须留在 CUDA Graph 外面。图捕获要求形状与控制流固定,任何需要主机侧读回数据的步骤都会把图切开,切开处就是一次 replay 边界。
这篇文章换一个记账单位:launch。对象是部署完成的 GLM-5.3:78 层 decoder、TP8 + EP8、FP8 权重与 FP8 KV、DSA 索引器只在前 21 个 full 层计算、decode 走 flashmla_kv 后端。代码取自 SGLang 主干的 glm_moe_dsa 实现,引用的文件路径都写在正文里。模型超参与缓存布局在前几篇已经算过,这里只在需要时引用结论。
需要先说明口径:下面的 launch 数是按 CUDA 路径逐段数出来的下界,不是某台机器上的 profile 结果。融合开关、量化格式、EP 后端、图捕获形态都会让数字上下浮动。账本的价值在于给出「哪些 launch 必然存在、哪些可以被融合消掉、哪些只在特定拓扑下出现」,而不是一个精确到个位的常数。
记账单位:什么算一次 launch
先把名词钉死。
kernel launch 指的是主机侧把一个 GPU 函数提交到某条 CUDA 流上。它包含参数打包、驱动校验、把命令写进通道,以及流上的顺序约束。一次 launch 在 GPU 上对应的是一段 grid 的执行;同一个流上的两个 kernel 默认串行,不同流上的 kernel 可以并发。
CUDA Graph 把这些提交录下来:捕获阶段把 kernel 节点和依赖边记进一张图,实例化之后,重放一次图只需要一次提交。重放时 GPU 仍然要执行图里的每一个 kernel,节点之间的依赖也仍然存在,只是主机侧不再逐个提交。
所以一笔账要分成两列:
| 列 | 计数对象 | CUDA Graph 是否改变 |
|---|---|---|
| CPU 提交列 | 驱动收到的 launch 次数 | 从「每 kernel 一次」变成「每张图一次」 |
| GPU 执行列 | 实际运行的 kernel 数 | 不变 |
| GPU 间隙列 | 相邻 kernel 之间的调度空隙 | 会变小,但不会消失 |
为什么提交开销值得单独记一笔?NVIDIA 在 2019 年的 CUDA Graphs 文章里给过一组 V100 上的数:一个执行时间 2.9µs 的短 kernel,在逐次提交并同步的模式下,每次要花 9.6µs;把提交重叠起来之后降到 3.8µs。也就是说,当 kernel 本身只有几微秒时,提交开销可以是执行时间的两倍以上。decode 阶段的很多 kernel 正是这个量级:batch 32 的一次 RMSNorm、一次 bf16→FP8 的量化、一次 KV 写入,执行时间都在几微秒到十几微秒之间。
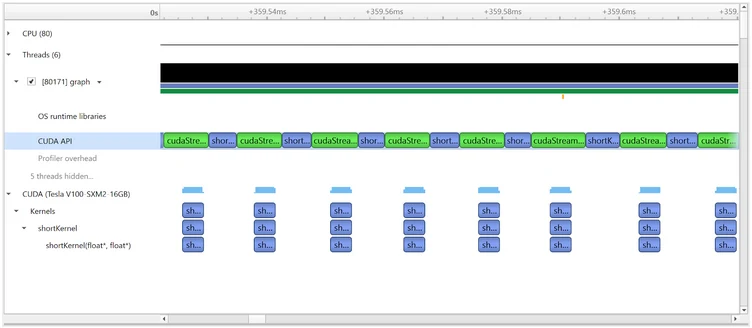
把这件事写成式子。设一步里有 个 kernel,第 个的执行时间是 ,相邻 kernel 的调度间隙是 ,主机侧每次提交的平均成本是 :
其中 是集合通信的时间, 是主机侧总成本。eager 模式下 ;图模式下 退化成「图的数量 × 一次重放的成本」,但 还在。这个式子解释了为什么推理框架同时需要融合与图:融合减少 ,图消掉 ,两者不能互相替代。
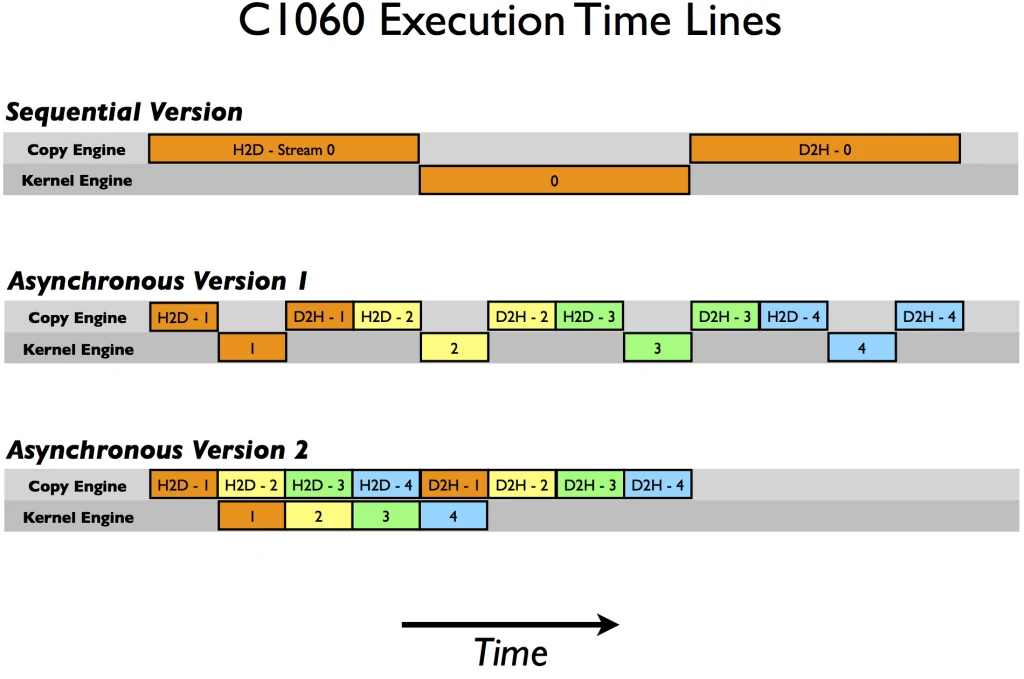
还有一条流。SGLang 在模型里显式用了第二条 CUDA 流:alt_stream。它的作用是把两个互不依赖的 kernel 放到时间线上重叠。重叠不减少 launch 数,但能改变关键路径:
一层 decoder 的 kernel 清单
先澄清一个容易走错的岔路。SGLang 的 glm4_moe.py 里有一个 Glm4MoeDecoderLayer,但它服务的是 GLM-4.5/4.6 那类标准 GQA 文本模型:QKV 走 QKVParallelLinear,注意力是稠密多头。GLM-5.3 的 architectures 是 GlmMoeDsaForCausalLM,它继承 DeepseekV2ForCausalLM,真正构造出来的 decoder 层是 DeepseekV2DecoderLayer,注意力是 DeepseekV2AttentionMLA,MoE 是 DeepseekV2MoE。glm4_moe.py 在这个模型里只贡献了少数类属性与 MTP 的适配。读源码时如果看错了文件,会得到一套完全不同的 kernel 清单。
DeepseekV2DecoderLayer.forward 的骨架在 python/sglang/srt/models/deepseek_v2.py:
hidden_states_orig = residual_access.buffer(hidden_states)hidden_states = self.attn_boundary.prepare( hidden_states, forward_batch, capture_gathered=..., quant_format=...)with self.self_attn.maybe_use_decode_attn_tp(forward_batch): hidden_states = self.self_attn(...)if isinstance(hidden_states, tuple): hidden_states, topk_indices = hidden_stateshidden_states = self.attn_boundary.finish(hidden_states, forward_batch)hidden_states = self.ffn_boundary.prepare(hidden_states, forward_batch)...hidden_states = self.mlp(hidden_states, forward_batch)hidden_states = self.ffn_boundary.finish(hidden_states, forward_batch)attn_boundary 与 ffn_boundary 是 sglang.srt.layers.layer_boundary 里的对象,prepare 负责「输入 norm 与下游量化」,finish 负责「残差相加、必要的归约、以及与共享专家输出的合并」。这个抽象的意义在于把融合决定从层代码里抽出来:同一个 prepare,在静态 per-tensor FP8 下可以是一次 fused_add_rmsnorm_quant,在 blockwise FP8 下就退化成 norm + 独立量化两个 kernel;同一个 finish,在 TP 下要把 AllReduce 融进来,在 DP Attention 下则不用。launch 数不是层代码写死的,是量化格式与并行拓扑选的。
注意力内部还有一层同样的拆分。DeepseekV2AttentionMLA.forward 调用 forward_prepare 再调用 forward_core,前者准备 Q/K/V、跑索引器、写 KV,后者才进 self.attn(*inner_state)——这才是稀疏 MLA kernel 的入口。inner_state 里装的是吸收后的 Q、KV latent 与 Top-K 下标。也就是说,一层里的 kernel 被分成了「注意力之前」「注意力」「注意力之后」三段,中间夹着真正的稀疏注意力调用。
把一层拆开,逐段数列。下表是一次 decode(每条请求一行 token)在 TP8 + EP8、--dsa-decode-backend flashmla_kv、 fused top-k 打开时的清单:
| # | 段 | kernel | 作用 | launch |
|---|---|---|---|---|
| 1 | 输入 norm | fused_add_rmsnorm | 残差相加 + RMSNorm + 写回 | 1 |
| 2 | QKV 低秩投影 | fused_qkv_a_proj_with_mqa | 6144 → 2624 的一次 GEMM | 1 |
| 3 | Q 低秩 norm | q_a_layernorm | 2048 维 RMSNorm | 1 |
| 4 | KV 低秩 norm | kv_a_layernorm | 512 维 RMSNorm | 1 |
| 5 | Q 上投影 | q_b_proj | 2048 → 16384 的 GEMM | 1 |
| 6 | RoPE | rotary_emb | q_pe 与 k_pe 一起转 | 1 |
| 7 | 查询吸收 | bmm_fp8 / grouped_gemm_nt_f8f8bf16_masked | 192 → 512 的逐头 bmm | 1–2 |
| 8 | KV 写入 | store_mla | 512 latent + 64 rope 落页 | 1 |
| 9 | Top-K 转页表 | transform_index_page_table_decode | 逻辑下标 → 物理页 | 0 或 1 |
| 10 | 稀疏 MLA | flash_mla_sparse_fwd | 读 Top-2048 个 KV 行 | 1 |
| 11 | 输出吸收 | bmm | 512 → 256 的逐头 bmm | 1 |
| 12 | 输出投影 | o_proj | 16384 → 6144 的行并行 GEMM | 1 |
| 13 | 归约 | AllReduce | TP 组内求和 | 1 |
| 14 | 输出 norm | fused_add_rmsnorm | 残差相加 + RMSNorm | 1 |
再加上 MoE 段的 7–9 个,一层 decode 的 launch 数落在 21–23 之间。这个数字比「一层十几个算子」的直觉要多,原因是每个算子背后并不总是一个 kernel:低秩投影融合了一次,norm 与残差融合了一次,Top-K 与页表转换融合了一次,但 FP8 的激活量化、KV 写入、吸收 bmm 都各自独立。
下面逐段解释这些 kernel 为什么长这样。
残差与 RMSNorm 为什么是一个 kernel
SGLang 的 RMSNorm.forward_cuda 在带残差的分支里调用的是:
fused_add_rmsnorm(x, residual, self.weight.data, self.variance_epsilon)result = x, residual这一个 kernel 做了三件事:residual += x、对更新后的 residual 求 RMSNorm、把结果写回 x。两个张量都是原地更新,所以它返回的是一对张量,而不是一个。这个设计在 transformer 里非常划算:每层有两次「残差相加 + norm」,如果拆成 add、norm 两个 kernel,一层就多两次显存往返,而 6144 维的 bf16 向量在 batch 32 下只有 384KB,正好是那种「数据不大、开销固定」的典型,融合的收益主要在 launch 与访存次数上。
更激进的一层融合是把下游的 FP8 量化也塞进来。RMSNorm.forward_with_per_tensor_quant_fusion 调用:
_flashinfer_fused_add_rmsnorm_quant( out, x, residual, self.weight.data, scale, self.variance_epsilon)一次 launch 完成「残差相加 + RMSNorm + 静态 per-tensor FP8 量化」,输出直接是下游 w8a8 线性层要的 FP8 张量。这条路径只对静态 per-tensor 量化成立:scale 是权重加载时定好的常数。
GLM-5.3 的 FP8 权重是 blockwise 的,块大小 128×128。blockwise 的激活量化不是 per-tensor,而是每个 token 的每 128 个通道一组 scale,必须动态算。所以在这条路径上,norm 之后还要单独跑一次 per_token_group_quant_fp8,再进 dispatch_w8a8_block_fp8_linear。代码里两条分支并存:
if self.block_quant: ... return self.w8a8_block_fp8_linear(x, ...)...# 预量化的激活来自 fused RMSNorm+FP8 quant:x 已经是 fp8这解释了一个常见的疑惑:为什么同一个框架里,有的模型每层 norm 后面跟着一个量化 kernel,有的没有。不是版本差异,是量化格式决定的融合边界。
QKV 低秩投影为什么合成一个 GEMM
MLA 的入口有三个投影:Q 的低秩投影(6144 → 2048)、KV 的低秩投影(6144 → 512 + 64)。SGLang 把它们合成一个 ReplicatedLinear:
self.fused_qkv_a_proj_with_mqa = ReplicatedLinear( self.hidden_size, self.q_lora_rank + self.kv_lora_rank + self.qk_rope_head_dim, ...)输出 2624 列,一次 GEMM 之后按 [2048, 512+64] 切开。合并不是为了省显存,而是因为 decode 的 M 很小(batch 32),三个独立的 GEMM 每个都只有几十微秒,launch 与 tail effect 占比高;合成一个 N=2624 的 GEMM,tensor core 的 tile 利用率更高,还少两次 launch。这个投影是 ReplicatedLinear,不是列并行:2624 列在所有 TP rank 上完全相同,每个 rank 都算一遍。这是 MLA 低秩入口的特性,也是后面索引器能复制权重复用的前提。
切出来的 q 先过 q_a_layernorm(2048 维),latent_cache 的前 512 维过 kv_a_layernorm。两个 norm 在同一段代码里,但被放到了两条流上:
if self.alt_stream is not None and get_is_capture_mode(): current_stream = torch.cuda.current_stream() self.alt_stream.wait_stream(current_stream) q = self.q_a_layernorm(q) with torch.cuda.stream(self.alt_stream): k_nope = self.kv_a_layernorm(k_nope) current_stream.wait_stream(self.alt_stream)else: q = self.q_a_layernorm(q) k_nope = self.kv_a_layernorm(k_nope)只有在图捕获模式下才分叉。原因是图里的流与事件必须被显式记录,eager 模式下两条流的分叉与汇合本身有主机开销,反而可能更慢。这个细节说明「重叠」不是免费的:两个几微秒的 kernel,分流的收益可能被 wait_stream 的同步成本吃掉,所以 SGLang 只在捕获时采用。
decode 时索引器与 q_b_proj 的重叠
q_b_proj 是 2048 → 16384 的列并行 GEMM,batch 32 时约 2.1 GFLOP,是层内第二大 GEMM(仅次于 o_proj)。索引器的一组计算与它没有数据依赖,于是 decode 时两者被放到两条流上:
if (self.alt_stream is not None and get_is_capture_mode() and forward_batch.forward_mode.is_decode_or_idle() and q_lora is not None): ... if self.should_run_indexer(prev_topk_indices): topk_indices = self.indexer(x=hidden_states, q_lora=q_lora, ...) ... with torch.cuda.stream(self.alt_stream): q = self.q_b_proj_forward(q) current_stream.wait_stream(self.alt_stream)主流的顺序是「先发索引器,再发 q_b」。这个顺序不是随手写的:图重放时,join 点必须落在主流上,索引器先入队,q_b_proj 才会在另一条流上真正并行。如果反过来,wait_stream 会排在索引器前面,两条流退化成串行。
这一段的账本意义是:索引器的 6–7 个 kernel 与 q_b_proj 的一个大 GEMM 在时间线上重叠,但launch 数是相加的。重叠省的是关键路径,不是提交次数。
RoPE、吸收与 KV 写入
RoPE 只作用在 64 维的 q_pe 与 k_pe 上,一次调用同时处理两个张量:
q_pe, k_pe = self.rotary_emb(positions, q_pe, k_pe)这是 DeepSeek 系的 YaRN 变体,位置编码缓存是预计算好的 cos/sin 表,kernel 只做查表与旋转。64 维很小,batch 32 时数据量只有几十 KB,属于典型的「launch 占比高于计算」的 kernel。
查询吸收把 192 维的 q_nope 投到 512 维潜空间。SGLang 有三条实现:torch.bmm、bmm_fp8、DeepGEMM 的 masked grouped GEMM。bmm_fp8 路径前面还有一次 per_tensor_quant_mla_fp8:
q_nope_val, q_nope_scale = per_tensor_quant_mla_fp8(q_nope.transpose(0, 1), ...)q_nope_out = bmm_fp8(q_nope_val, self.w_kc, q_nope_scale, self.w_scale, torch.bfloat16)所以这一段是 2 个 launch:量化 + bmm。如果 w_kc 是 bf16,就退化成 1 个 torch.bmm;如果走 DeepGEMM,则是一次 per_token_group_quant_mla_deep_gemm_masked_fp8 加一次 grouped_gemm_nt_f8f8bf16_masked,还是 2 个。形状上,64 个头、每头 ,batch 32 时约 0.4 GFLOP,真正的开销在 64 个小矩阵的调度上。
KV 写入走 store_mla,把 512 维 latent 与 64 维 rope 写进分页池。这一写很关键:GLM-5.3 的 KV 是「一份 latent + 一份 rope」,不是传统 K/V 两份。写入量在第四篇按 656 字节/token 算过,这里只记 1 个 launch。索引器缓存的写入是另一笔,只发生在 21 个 full 层,放在下一节。
Top-K 到页表的转换:能融则融
注意力 kernel 要的是物理页地址,索引器给出的是逻辑位置。中间有一次转换:
page_table_1 = transform_index_page_table_decode( page_table=metadata.page_table_1, topk_indices=topk_indices, page_size=1,)当 SGLANG_DSA_FUSE_TOPK 打开时,这次转换不单独发生,而是与 Top-K 选择融进同一个 kernel。dsa_topk_backend.py 里的注释写得很清楚:v2 内核「fuses top-k selection and the page-table transform in one launch and consumes the indexer’s own page_size>=1 table directly, so no page_size=1 table is materialized」。这段代码还强调了另一件事:融合是一个确定性的分派决定,不是「尽力而为」——一旦形状匹配,decode 图里就不再保留 page_size=1 的表,也就不会在运行时悄悄退回老路径。
这条注释值得单独拎出来,因为它解释了融合对图捕获的影响:省掉的不只是一个 kernel,还有一张每步都要重建的页表。表不在了,图的输入就少一个动态张量,捕获与重放的约束随之变少。
稀疏 MLA 与输出吸收
真正的注意力是 flash_mla_sparse_fwd:
o, _, _ = flash_mla_sparse_fwd( q=q_input, kv=kv_cache, indices=indices_input, # (s_q, 1, topk) sm_scale=sm_scale, d_v=v_head_dim, attn_sink=sink_input, topk_length=topk_length,)indices 的形状是「每行查询、1 个 KV 头、topk 个位置」,topk_length 是这一行真正有效的下标数。上下文不足 2048 时,下标尾部用 -1 填充,topk_length 让 kernel 跳过整段尾部,而不是逐元素判断。这是一个很小的优化,但它把「短上下文的 decode」从「扫满 2048 个槽」变成「只扫有效长度」,对首 token 之后的早期解码有实际意义。
输出侧还有一次吸收:注意力给出的是 512 维潜向量,要乘 W_UV 回到 256 维的 V 空间,然后进 o_proj。这是 1 个 bmm 加 1 个行并行 GEMM。o_proj 的 reduce_results=True,所以 GEMM 之后紧跟一次 AllReduce。下一节会把这次归约单独记账。
把上面这些加起来:一层 decode 的注意力部分约 14 个 launch,MoE 部分 7–9 个,索引器在 21 个 full 层额外 6–7 个。这个清单是后面总算账的基础。
索引器:21 层里最重的那一段
GLM-5.3 的配置里有一张 indexer_types 表:78 个位置,只有 21 个是 full,其余是 shared。这张表决定了 DeepseekV2AttentionMLA 构造时要不要建索引器:
if not self.skip_topk or is_nextn: indexer_cls = IndexerKPool if get_dsa_index_kpool(config) > 1 else Indexer self.indexer = indexer_cls(...)skip_topk 为真的层根本没有 indexer 子模块,也就没有索引器的权重、没有索引 K 的写入、没有打分 kernel。它们的 Top-K 下标从上一个 full 层沿 prev_topk_indices 传下来:
topk_indices = maybe_capture_indexer_topk(self.layer_id, prev_topk_indices)这一行在 launch 账本里等于「零」。57 个 shared 层每层省掉的不是一个 kernel,而是整段 6–7 个 kernel 的计算与提交。
一个 full 层的索引器在 decode 时做什么,按顺序是:
wk_weights_proj融合投影:把「索引 K 的投影」与「头门控权重」合成一个 GEMM。没有融合时是wk与weights_proj两个。wq_b:把 2048 维的q_lora投到 32 个头 × 128 维。- 激活量化:
act_quant(key, block_size=128, scale_fmt="ue8m0"),把索引 K 量化成 FP8,每 128 维一组 scale。 fused_store_index_k_cache:量化与写页融合成一个 kernel,写进 132 字节/token 的索引缓存。fp8_paged_mqa_logits:用 FP8 的 Q 与分页的索引 K 打分,得到每行查询对全上下文的 logits。fast_topk_transform:选 Top-2048,并把逻辑下标翻成物理页表。
第 1 步的融合由 use_dsa_indexer_fusion 控制。融合之后,wk 与 weights_proj 共享一次读 hidden_states,少一次 launch、少一次 6144 维向量的读。第 3、4 步也能融合:can_use_dsa_fused_store(...) 为真时,量化结果直接写进页,不再落一个中间张量。
第 5 步是索引器的算术大头,也是最容易被低估的 kernel。它的形状是:
注意 是整个上下文长度,不是 Top-2048。128K 上下文时,单个 full 层要算 个分数,读 MB 的索引 K。21 个 full 层乘起来是 363MB 的读取量,与第一篇按 352MB 估算的口径一致。相比之下,主注意力的稀疏 MLA 每层只读 Top-2048 行、约 1.2MB。索引器的读取量随上下文线性增长,主注意力不随上下文增长——这是 DSA 在长上下文下的真正瓶颈所在,也是跨层复用能带来 1.2 倍端到端加速的原因(IndexCache 论文,arXiv 2603.12201)。
这个 kernel 的算术强度也很低:每读 132 字节只做 次乘加,约 62 FLOP/字节。H200 的 HBM 带宽是 4.8TB/s、FP8 算力是 PFLOPS 级,这个比例远低于平衡点,所以它是纯带宽 kernel。带宽 kernel 的 launch 数不是主要成本,读多少字节才是。
还有一层与 launch 直接相关的设计:索引器会按显存预算决定是否把 logits 计算切块。dsa_indexer.py 里引入了 mqa_logits_should_chunk、mqa_logits_budget_bytes 一组函数,切块之后同一个 full 层里第 5 步会变成多次 launch,每次处理一段查询行或一段上下文。上下文越长、batch 越大,切块越可能发生。也就是说,索引器的 launch 数不是常数,它随 KV 长度增长。这一点在后面的总账里要单独标注。
Top-K 的选择也有后端之分。DSATopKBackend 有三个值:sgl-kernel、torch、flashinfer。sgl-kernel 走 fast_topk_v2,torch 走 torch.topk 加掩码,flashinfer 走 top_k_page_table_transform。三者中只有 sgl-kernel 的 v2 路径能把「选 Top-K」与「查页表」融成一个 kernel,并直接消费 page_size≥1 的表;另外两条都要先生成 page_size=1 的表,再交给注意力。这个差别在账本上是 1 个 launch,在显存上是每步多一张 [b, 2048] 的 int32 表,在图上则多一个动态输入。默认值选 sgl-kernel 不是偶然。
主注意力:8 个头的注意力为什么要按 64 个头算
这是这篇文章里最反直觉的一段账。
GLM-5.3 有 64 个查询头。TP8 时 attn_tp_size = 8,每张卡分到 64 / 8 = 8 个头:
num_local_heads = num_heads // attn_tp_size但稀疏 MLA 的内核要求头数是 64 的倍数(Hopper)或 128 的倍数(Blackwell)。_forward_flashmla_kv 里写得很直白:
required_padding = 128 if self.device_sm_major >= 10 else 64need_padding = num_heads % required_padding != 0if need_padding: assert required_padding % num_heads == 0, ( f"num_heads {num_heads} cannot be padded to {required_padding}. " "TP size may be too large for this model." ) q_padded = q_all.new_zeros((num_tokens, required_padding, head_dim)) q_padded[:, :num_heads, :] = q_all q_input = q_paddedTP8、8 个头,Hopper 上要补到 64。也就是说,这个 kernel 的 MMA 作业量是按 64 个头排的,其中 56 个头全是零。补零的 Q 仍然会走 tensor core 的 tile,只是乘出来的结果被丢弃;o[:, :num_heads, :] 再把输出裁回 8 个头。
为什么内核要这样要求?稀疏 MLA 的 tile 布局按固定的头块组织 WGMMA:一个 CTA 处理 64 个查询头的一段,K/V 是共享的单个 latent 头(MQA)。头数不整齐时,tile 无法对齐,内核要么退化成标量循环,要么直接不支持。框架的选择是补零,把不整齐的形状变成整齐的形状,代价是 87.5% 的 MMA 槽位在做无用功。注释里那句 “TP size may be too large for this model” 就是这个意思:TP 切得越细,每卡头数越少,补零比例越高。
这笔浪费是否体现在时间上,取决于 kernel 是算力受限还是带宽受限:
- 上下文很长、Top-K 取满 2048 时,每层每 token 要读 字节的 latent,约 1.18MB;8 个真实头的算术量只有 MFLOP。带宽受限,补零的 MMA 可以藏在访存后面,浪费不明显。
- 上下文很短、
topk_length只有几十时,读取量骤降,kernel 变成算力受限,64 个头的 tile 仍然要跑完,补零的代价就暴露出来。这也是为什么topk_length那条「跳过 -1 尾部」的优化对短上下文特别重要。
还有一笔更隐蔽的账:TP8 下每张卡都要读同一份 KV latent。MLA 的 KV 只有 1 个头,不做头切分,8 张卡各自读一遍 1.18MB,跨卡读的是同一段地址。带宽被放大了 8 倍。这两件事——补零与 KV 复制——共同解释了为什么 GLM-5.3 的生产部署更愿意用 DP Attention:--attn-dp-size 8 时 attn_tp_size = 1,每张卡保留完整的 64 个头,不需要补零;每张卡只算自己的请求,KV 也只读自己那一份。第一篇从「KV 本地化」的角度讲过这一点,从 kernel 账本看,它同时还消掉了补零与复制两笔开销。
这也意味着同一份模型在三套拓扑下的注意力 kernel 时间不能直接比:TP8 的 kernel 处理 64 个头(8 真 56 假),DP8 的 kernel 处理 64 个头(全真)但只跑自己请求的行。前者用算力换并行度,后者用显存副本换效率。
MoE:从门控到分组 GEMM 的 launch 数
GLM-5.3 的 MoE 在 DeepseekV2MoE 里(deepseek_v2.py),不是 glm4_moe.py 的 Glm4MoeSparseMoeBlock。两者的结构相似,但真正的执行路径、双流顺序与融合钩子都在 DeepseekV2MoE 上。
一层 MoE 的 decode 计算链是:
self.gate(hidden_states):6144 → 256 的路由打分。门控权重是 FP32,输入也被 cast 到 FP32。self.topk(hidden_states, router_logits):分组 Top-K。GLM-5.3 用 grouped noaux_tc 规则:256 个专家分 8 组,先选 4 个组,再在组内选 8 个专家,选完后用e_score_correction_bias修正分数。- 路由输入的量化(可选):
routed_quant_stream上跑quantize_routed_input,把 hidden 量化成专家 GEMM 要的 FP8 格式。 self.experts(...):分组 GEMM。第一次是 gate_up(每专家 6144 → 2×2048),中间是 SiLU 与逐元素乘,第二次是 down(2048 → 6144)。- 共享专家:
DeepseekV2MLP,两个 GEMM,走另一条流。 - 合并:
maybe_fuse_routed_scale_and_shared_add,把routed_scaling_factor的缩放与共享专家的加法融成一个 kernel。 - 归约:
post_experts_all_reduce(reduce_results=True时)。
第 1 步为什么单独存在、为什么不融进专家 GEMM?因为路由必须在所有专家计算之前完成,而专家 GEMM 需要路由结果作为索引。它是一个真正的依赖边界,不是融合没做好。门控用 FP32 也是同样的道理:Top-K 是离散选择,分数差一点就可能换专家,FP8 或 BF16 的舍入会让路由在相邻 step 之间抖动;e_score_correction_bias 本身就是 FP32 参数,与它相加的分数也必须是 FP32。
第 2 步是一个 kernel,但内部是两段:先按组求 Top-2 分数之和选出组,再在选中组内选专家。SGLang 的 TopK 把这两段合成一次 launch,use_grouped_topk=True、num_expert_group=8、topk_group=4 三个参数就是这段逻辑的开关。如果把它拆成「组打分」「组选择」「专家选择」三个 kernel,账本会多两次 launch 和两次 256 维向量的往返;合成一个之后,中间结果留在寄存器与 shared memory 里。
第 4 步的专家 GEMM 是一个「分组」kernel:本地有多少专家、每个专家收到多少 token,都在 kernel 内部按 offset 处理,不是每个专家一次 launch。EP8 时每卡 32 个专家,如果按专家逐个 launch,一层就是 32 次;分组 GEMM 把它压成 2–3 次(gate_up、激活、down)。这是 MoE 账本里最大的一笔融合收益。
双流的顺序值得单独讲。forward_normal_dual_stream 里,routed 分支先发,共享专家后发:
# Shared expert on alt stream, issued AFTER the main (routed) branch.with torch.cuda.stream(self.alt_stream): shared_output = self._forward_shared_experts(...)current_stream.wait_stream(self.alt_stream)注释给了三条理由:捕获时只复用一条 alt 流,不会产生多条流;routed 是主流上最后一个 kernel,能与残差加法做 PDL 重叠;DeepGEMM 不会释放 hidden_states,而共享专家在另一条流上还要读它。顺序反过来的话,共享专家会先占住 alt 流,主流的 routed 链在等待 join 时被拉长。
账本上,这段双流让「共享专家的 2 个 GEMM」与「routed 的 3 个 kernel」在时间线上重叠,但 launch 数是 5 个相加,不是 3 个。重叠只改变关键路径。
最后一步的合并也有融合空间。maybe_fuse_routed_scale_and_shared_add 把「乘 routed_scaling_factor」与「加共享专家输出」合成一个 kernel。如果路由的缩放因子已经在 Top-K 里乘进权重(routed_scaling_factor_fused_in_topk),这一步就只剩加法。更激进的是 MoeDeferredFinalize:把加法推迟到下一层的 boundary,由下一层的 norm kernel 顺带完成,这样一层 MoE 的收尾 kernel 直接消失。这类「把收尾推迟到下一个消费者」的手法,是 2026 年 SGLang 在 layer boundary 抽象里做得最彻底的一件事。
把一层 MoE 的 launch 数摆出来(TP + EP、无 EP 通信、双流打开):
| 段 | launch |
|---|---|
| 门控 GEMM | 1 |
| 分组 Top-K | 1 |
| 路由输入量化 | 1 |
| routed gate_up 分组 GEMM | 1 |
| 激活与乘 | 0–1(融进 GEMM epilogue 时为 0) |
| routed down 分组 GEMM | 1 |
| 共享专家 gate_up | 1 |
| 共享专家 down | 1 |
| 缩放 + 共享加法 | 0–1 |
| 专家输出 AllReduce | 0–1(DP 或 boundary 融合时不同) |
合计 7–9 个。开 DeepEP 之后,前面还要加 dispatch 与 combine 两个通信 kernel;它们各自内部是多次 NVLink/RDMA 传输,但在 CUDA 账本上只算 2 个 launch。
通信在账本里占几行
集合通信在字节账本里是绝对主角,在 launch 账本里却只占很小的一角:一次 AllReduce 不管传 393KB 还是 3MB,在 CUDA 上都是一个 kernel(NCCL 的内部实现可能拆成多个,但对外是一次集合操作)。
TP8 下,一层有两次归约:o_proj 之后一次(注意力输出),MoE 之后一次(FFN 输出)。78 层就是 156 次。若每次归约都单独发一个 kernel,账本多 156 行;若把归约融进紧随其后的 RMSNorm,账本只多 0 行,因为 fused_add_rmsnorm 变成了 allreduce + add + rmsnorm 一个 kernel。SGLang 的 RMSNorm 提供了这条路径:
def forward_with_allreduce_fusion(self, x, residual=None, ...): return _forward_with_allreduce_fusion( self, x, residual, post_residual_addition, self.weight, use_attn_tp_group )这正是 layer boundary 的 finish 在做选择:如果后端支持 fused AllReduce + RMSNorm,就把归约并进 norm;否则先归约再 norm。第二篇讲 vLLM 时提过同一手法,两个框架在这里的动机完全一致——156 次小归约的提交开销,可能比归约本身的传输时间还大。
DP Attention 下账本会变厚。注意力不做 TP,每张卡只算自己的请求,但 MoE 要在全局 batch 上路由,所以每层多出一次 dp_gather(AllGather)与一次 ReduceScatter。78 层就是 156 次额外集合操作。第一篇按字节算过这笔账,结论是 DP Attention 的通信量比 TP 大,但注意力侧的 KV 读取本地化、无需跨卡。从 launch 角度看,DP Attention 用「更多次、更小的集合操作」换「更少的注意力 kernel 内跨卡访问」,是一个明确的取舍。
DeepEP 的 dispatch 与 combine 在账本上是每层 2 个 kernel,75 个 MoE 层就是 150 个。它们与 AllReduce 的区别在于:AllReduce 是固定形状的规约,dispatch/combine 是变长的按专家分组搬运,kernel 内部要做路由表的读取、缓冲区的偏移计算、以及 NVLink/RDMA 的混合传输。第六篇拆过这两种模式的内部结构,这里只记它们在 CUDA 账本上的行数。
通信在 CUDA Graph 里的处境比计算 kernel 复杂。集合通信要求所有 rank 以相同顺序进入同一个集合操作,图捕获必须把「进入/离开集合」的顺序也录进去;一旦某个 rank 的图在集合前后被切开,两侧的 rank 就可能对不上。SGLang 因此提供了可捕获的归约实现(pynccl 与自定义 AllReduce kernel),并在捕获前把通信组、缓冲区、信号量都固定下来。这些准备工作不在 decode 的账本里,它们发生在第十五篇讲的冷启动阶段。
CUDA Graph 把账本折叠之后
到这一步可以回答开头那个问题了:一步上千个 kernel,CPU 怎么跟得上。答案是图。
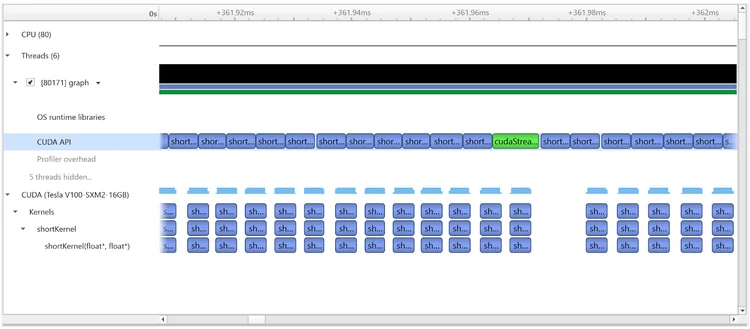
捕获阶段,SGLang 在固定的输入形状上把整段前向跑一遍,驱动把每个 kernel 节点、每条依赖边、每个内存地址记进图里。实例化之后,一次重放只需要一次提交:
折叠之后,账本变成三行:
| 项 | eager | graph |
|---|---|---|
| CPU 提交次数 | ≈ 1900 | 每个图分片 1 次 |
| GPU 执行 kernel 数 | ≈ 1900 | ≈ 1900 |
| 主机侧 Python 开销 | 每个算子一次 dispatch | 一次重放 |
关键点在于:图减少的是提交,不是执行。GPU 仍然要按依赖顺序跑完 1900 个 kernel,节点之间仍然有调度间隙。图能做的,是把间隙从「驱动逐个派发」的微秒级压到「图内节点直接跳转」的亚微秒级。按每个节点 0.5–1µs 的间隙估算,1900 个节点就是 1–2ms 的固定底噪;这在 batch 32、单步几十毫秒的尺度上占几个百分点,在 batch 1 的短上下文解码里可能占两位数。
图的形状还受 DSA 影响。第十五篇讲过,GLM-5.3 的图在索引器处是「可断开」的:Top-K 的结果决定后续注意力读哪些页,而页表、序列长度这些元数据每步都要从主机侧刷新。断开意味着一次重放结束、一次主机侧重新准备、再一次重放开始。每多一个断点,就多一次提交与一次同步,账本上的「CPU 提交次数」从 1 变成断点数。这也是为什么框架宁愿把索引器的打分与 Top-K 都放进图里,只把「元数据刷新」留在图外——刷新的数据量小,断点少。
MTP 让这件事更复杂。一次 decode step 在开启 MTP 后是「draft → verify → draft_extend」三段前向,三段各有自己的图分片。第十四篇算过三段前向的算子与通信账;从 launch 账本看,三段意味着三次图重放的固定成本,以及三段之间必须插入的主机侧调度。投机解码的收益必须覆盖这部分固定成本,否则接受长度再高也划不来。
一次 decode step 的总账
把前面的分段乘起来。假设:78 层、75 层 MoE、3 层稠密 MLP、21 个 full 索引器层、TP8 + EP8、FP8 blockwise 权重、FP8 KV、flashmla_kv decode、fused top-k 打开、CUDA Graph 捕获但不计断点。
| 段 | 单层 launch | 层数 | 小计 |
|---|---|---|---|
| 注意力与前后 norm、投影、吸收、KV 写入 | 14 | 78 | 1092 |
| 索引器(仅 full 层) | 6–7 | 21 | 126–147 |
| MoE(含共享专家、路由、合并) | 8 | 75 | 600 |
| MoE 的 DeepEP dispatch/combine | 2 | 75 | 150 |
| 稠密 MLP(前 3 层) | 3 | 3 | 9 |
| 嵌入、最终 norm、LM Head、采样 | — | — | 约 4 |
| MTP 草稿层与索引器 | — | — | 约 20 |
合计约 2000 个 kernel,误差主要来自三处:融合开关(Top-K 与页表、缩放与共享加法、归约与 norm)、索引器是否切块、MTP 是否开启。取中间值 2000,batch 32 时每个输出 token 分摊约 62 个 kernel。
这个数字要放进两个预算里看。
主机侧预算。 eager 模式下,每个算子除了 CUDA launch 还有 Python 调用、Tensor 元数据检查、dispatcher 分派。按每次 5–10µs 估,2000 次就是 10–20ms。这还没算 Python 的 GIL 与调度抖动。对 batch 32、单步 30ms 量级的 decode,主机侧已经接近或超过 GPU 时间;对 batch 1、单步 10ms 的 decode,主机侧是绝对瓶颈。这就是为什么 SGLang 在 decode 阶段必须用图,而不是「用更快的 Python」。
GPU 侧预算。 2000 个节点,每个 0.5–1µs 的调度间隙,是 1–2ms 的固定成本。索引器的 363MB 读取(128K 上下文、21 层)在单卡 4.8TB/s 上约 76µs,主注意力的 78 × 1.2MB ≈ 94MB 约 20µs。MoE 的权重读取要按「被触发的不同专家数」算,不是按 token 数:batch 32、每 token 8 个专家,共 256 个专家-令牌对,在 256 个专家上近似全覆盖;EP8 之后每个 rank 只读自己那 32 个专家,约 1.2GB/层,75 层约 90GB,单卡 4.8TB/s 上约 19ms。这是 decode 真正的带宽大头,而它随 batch 增长得比 token 数慢——batch 越大,每个专家被越多 token 复用,权重的边际成本越低。
把 batch 从 32 拉到 128,kernel 数几乎不变(索引器可能因 logits 预算切块而增加),每个 token 分摊的 launch 从 62 降到 16。batch 从 32 降到 1,分摊从 62 升到 2000。launch 成本对 batch 的敏感度是线性的,而 GPU 计算对 batch 的敏感度是次线性的——这解释了为什么小 batch 服务的吞吐曲线那么差,也解释了为什么连续批处理(continuous batching)是推理服务的第一性原则:它不是在「省 kernel」,而是在「摊 kernel」。
再看拓扑的影响。TP8 的注意力 kernel 要补零到 64 个头,DP8 不用;TP8 每层两次 AllReduce,DP8 换成 AllGather + ReduceScatter,并且 MoE 要 gather 全局 batch。前者的 launch 数少、单 kernel 浪费多;后者的 launch 数多、单 kernel 更「实」。哪一个更快,取决于上下文长度与 batch:长上下文时 DP8 的 KV 本地化收益压过额外的集合操作;短上下文、大 batch 时 TP8 的通信次数优势更明显。这也是为什么同一个模型在不同业务下会选不同拓扑,而不是有一套「最优解」。
最后是索引器的变数。前面按「每层 6–7 个、不切块」算。128K 上下文、batch 32 时,单个 full 层的 logits 是 个 FP32 值,约 16.8MB;21 层如果同时驻留就是 352MB。SGLang 用 mqa_logits_budget_bytes 给这块中间结果设预算,超了就切块,切块就是多次 launch。上下文到 1M 时,这个矩阵涨到 128MB/层,切块几乎必然发生。索引器的 launch 数在长上下文下不再是常数,它随着 logits 的工作集增长。 这一点在按「层数 × 每层固定 launch」估算时最容易被漏掉。
工程含义与排障
把账本落到工程上,有四条可以直接用的判断。
第一,融合的目标是「小 kernel」,不是「大 kernel」。 o_proj、q_b_proj、专家 GEMM 这些几百微秒的 kernel,融合收益主要来自少一次显存往返;真正需要融合的是那些几微秒的 norm、量化、页表转换、缩放加法。账本里 2000 个 kernel,绝大多数是后者。这也是为什么 SGLang 把 layer boundary 单独抽出来做融合决策:融合的机会集中在层与层的接缝处,而不是层内部的大矩阵乘。
第二,跨层复用比微观融合值钱得多。 57 个 shared 层不建索引器,一步省掉约 57 × 6.5 ≈ 370 个 kernel,同时省掉 57/78 的索引 K 读取。任何单点融合都到不了这个量级。IndexCache 这类工作的价值不在「让某个 kernel 快 10%」,而在「让 57 层根本不发这些 kernel」。
第三,拓扑决定 kernel 的形状,不只是数量。 TP8 的注意力 kernel 按 64 个头排 tile,其中 56 个是零;DP8 的 kernel 按 64 个真实头排,但只跑自己的请求。两者的 launch 数接近,单 kernel 的时间却不可比。调优时如果只盯着「TP8 比 DP8 少几次集合通信」,会错过补零与 KV 复制这两笔更大的账。
第四,图断点的成本是「一次主机往返」,不是「一个 kernel」。 判断一个改动该不该放进图,标准不是它有几个 kernel,而是它是否需要主机侧的数据。需要在图上读回 Top-K 结果、需要在图上重算页表、需要按主机侧的新序列长度改形状——这些都会把图切开。反过来,只要形状固定、数据留在显存里,哪怕它是一串 kernel,也应该进图。
在真机上验证这份账本,最直接的工具是 Nsight Systems。采集一次 decode,按下面的顺序读:
- 先看总 kernel 数。一步的 kernel 数在 1800–2200 之间是正常的;明显偏少,说明图把多个步折叠了,或者采集漏了节点;明显偏多,检查索引器是否切块、MTP 是否多跑了一段。
- 按名字聚合。
fused_add_rmsnorm应该出现约 156 次(78 层 × 2),flash_mla_sparse_fwd约 78 次,fp8_paged_mqa_logits约 21 次。这三个数是最容易对上的锚点。 - 看间隙。相邻 kernel 之间超过 2µs 的空隙,要么是主机侧在准备元数据,要么是图断点,要么是集合通信在等对端。把空隙的位置与层号对上,就能判断是哪一类。
- 看 H2D。每步如果有一条固定的 H2D 拷贝(页表、序列长度、采样参数),它通常落在图断点附近;这条拷贝的延迟会直接进 TTFT 之后的每一步。
几个常见的误读也要提一下。
- 「kernel 多所以慢」:不对。2000 个 kernel 里大部分是并行或重叠的,真正决定时间的是关键路径上的那几个大 kernel 与集合通信。kernel 多主要影响主机侧提交,图能解决。
- 「用了图,kernel 就少了」:不对。图减少的是提交,GPU 仍然执行同样多的节点。nsys 里看到的 kernel 数不会因为开图而下降。
- 「融合越多越好」:不对。融合会改变数值路径(例如把量化融进 norm 会改变舍入顺序),也会让 kernel 的寄存器压力上升、occupancy 下降。SGLang 在 static per-tensor 与 blockwise FP8 之间选择不同的融合边界,就是因为后者融不了。
- 「TP 越大越快」:对 GLM-5.3 的注意力不成立。TP 越大,每卡头数越少,补零比例越高,KV 复制份数越多。超过某个点之后,增加 TP 只是在增加通信与浪费。
小结
这篇文章把 GLM-5.3 的一条 decode step 从「一次前向」拆成了约 2000 次 kernel launch,并给出三列账:CPU 提交、GPU 执行、GPU 间隙。
几个可以带走的结论:
- 一层 decode 的注意力部分约 14 个 kernel,MoE 部分 7–9 个,索引器在 21 个 full 层额外 6–7 个。78 层乘下来,一步在 2000 个上下。
- 融合边界由量化格式与并行拓扑决定。静态 per-tensor FP8 可以把量化融进 norm,blockwise FP8 不行;TP 可以把 AllReduce 融进 norm,DP Attention 不用融。
- 索引器是唯一一个「launch 数随上下文增长」的段:logits 的工作集按预算切块,1M 上下文下必然多段。
- GLM-5.3 的 64 个头在 TP8 下变成每卡 8 个,稀疏 MLA 内核要求补到 64;补零与 KV 复制是 TP 注意力两笔隐藏成本,DP Attention 同时消掉它们。
- CUDA Graph 折叠的是提交,不是执行。图断点的代价是一次主机往返,所以判断标准是「是否需要主机侧数据」,不是「有几个 kernel」。
- 小 batch 的瓶颈在 launch 分摊,大 batch 的瓶颈在 MoE 权重带宽。连续批处理摊薄的是前者,EP 摊薄的是后者。
下一篇会回到单点,把稀疏 MLA 内核本身拆开:Top-K 下标如何在 tile 内被消费、KV 页在 shared memory 里怎么排、64 个头的 tile 如何映射到 WGMMA,以及补零的 56 个头在硬件上究竟占不占带宽。
参考资料
- SGLang:
deepseek_v2.py(MLA、MoE 与 decoder 层) - SGLang:
dsa_indexer.py(DSA 索引器) - SGLang:
dsa_topk_backend.py(Top-K 与页表融合) - SGLang:
dsa_backend.py(稀疏 MLA 后端与头补零) - SGLang:
layernorm.py(fused_add_rmsnorm 与 AllReduce 融合) - SGLang:
forward_mla.py(MLA 吸收前向与双流重叠) - SGLang:
fp8.py(blockwise FP8 线性层) - SGLang:
topk.py(分组 Top-K) - FlashMLA:MLA 解码内核与分页 KV 实现
- IndexCache:Accelerating Sparse Attention via Cross-Layer Index Reuse
- DeepSeek-V2:A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- NVIDIA:Getting Started with CUDA Graphs
- NVIDIA:How to Overlap Data Transfers in CUDA C/C++
- GLM-5.3 模型卡
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



