


GLM-5.3 推理全链路(十二):主 KV 与索引器缓存的分页预算、前缀命中与驱逐
这一篇接在哪
前十一篇把 GLM-5.3 的一条请求从 HTTP 字节拆到了 GPU 上的最后一个 kernel:入口与模板、调度、DSA 注意力、MoE 的 dispatch/combine、1M 上下文的 prefill、PD 分离的 KV 交接、混批、输出侧的反分词,以及索引器缓存的跨层读写。第十一篇把索引器缓存的读写带宽算清楚了,也在结尾留下了一个没有展开的问题:主 KV 和索引器缓存各自要占多少页,调度器给它们分页时会不会互相挤占,前缀缓存命中时这两份缓存是不是一起命中,请求结束或显存不足时它们又如何一起回收。
这一篇就回答这四个问题。它们看起来是“内存管理”的细节,实际上决定了三件很具体的事:
- 一条 1M 上下文请求在准入时到底要预留多少显存。按主 KV 算是 53.7GB,按主 KV 加索引器缓存算是 56.6GB;差的 2.9GB 足以让一条本来能跑的长请求被拒绝。
- 前缀缓存命中时,省掉的到底是多少计算。命中的前缀不再做前向,主 KV 与索引器 K 都不再重算,但后缀的 query 仍然要对整段前缀做索引器打分;省掉的是前缀内部的两两打分,不是后缀对前缀的交叉项。
- 显存不足时,驱逐一条请求会不会只释放主 KV、把索引器缓存留在池子里。两个主流框架的答案都是“不会”,但实现方式不同:SGLang 用同一个槽位号索引两套物理缓冲,vLLM 把两份缓存打进同一个物理 block。
文中的部署口径与前十一篇保持一致:单节点 8×H200,SGLang 走 TP8 + DP Attention + EP8,vLLM 走 TP8,GLM-5.3 使用 FP8 权重与 fp8_ds_mla KV 布局,上下文上限 1,048,576 token。模型常量取自 GLM-5.3 的配置:78 个 Transformer 层、21 层 full 索引器、57 层 shared 索引器、256 个路由专家、每 token 激活 8 个。
先把两份缓存的字节账摆出来
GLM-5.3 的 KV 不是一份连续的 K/V,而是两份结构完全不同的缓存:
- 主 KV:每个 token 每层存一段 MLA latent。
fp8_ds_mla布局把 512 维的 KV latent、64 维的 RoPE 分量,以及 5 个 128 元素块各 4 个 FP32 scale 打包在一起。512 + 64 = 576 字节,5 个块各 16 字节 scale,合计 656 字节。78 层都写这份缓存。 - 索引器 K 缓存:DSA 的 lightning indexer 只需要一份单头、128 维的 K,量化成 FP8 后再带一个 4 字节的 FP32 scale,每个 token 每层 132 字节。只有 21 个
full层写它,57 个shared层不写,也不读自己的索引器缓存。
把这两份账按 token、按页、按 1M 上下文各算一遍:
| 项目 | 每 token 每层 | 层数 | 每 token | 64-token 页 | 1M token |
|---|---|---|---|---|---|
| 主 KV | 656 B | 78 | 51,168 B | 3.12 MiB | 53.7 GB |
| 索引器 K | 132 B | 21 | 2,772 B | 173.25 KiB | 2.9 GB |
| 合计 | — | 99 层等效 | 53,940 B | 3.29 MiB | 56.6 GB |
索引器缓存按字节只占主 KV 的 5.4%,按 1M 上下文算也只有 2.9GB。这个比例很容易让人得出“索引器缓存可以忽略”的结论。但在分页这件事上,比例不是唯一的变量:索引器缓存和主 KV 共用同一个分配单位,任何一次页分配都要同时满足两份缓存的布局要求;索引器缓存的页粒度还被 DSA kernel 固定成 64 token;它的工作区(logits 与 top-k 下标)又是另一笔完全独立的显存开销。三笔账要分开看。
先明确一个口径:本文的 132 字节/token/层是未压缩的索引器布局,也是第十一篇与前文统一使用的口径。vLLM 的 GLM-5.x 路径支持 index_kpool 压缩,把每 N 个 token 的索引状态合成一个,此时索引器页的有效 token 容量会按压缩比缩小。为了和前文的字节账对得上,下面的计算都按 index_kpool = 1 展开;涉及压缩路径时会单独说明它会改变哪一项。
SGLang:一个槽位号,两套物理缓冲
SGLang 的 DSA 缓存管理集中在 DSATokenToKVPool。它继承 MLATokenToKVPool,在主 KV 的 kv_buffer 之外,额外持有一个 IndexKeyCache。这个类的构造函数里有两行决定布局的代码:
self.index_page_size = self.page_size // index_kpool...assert physical_page_size == 64, ( f"DSA requires 64-token physical pages, got page_size={self.page_size} " f"with index_kpool={index_kpool}")第一行说明索引器缓存有自己的物理页大小。index_kpool = 1 时它就是主池的 page_size;打开 kpool 压缩后,索引器页会变成主池页的 1/N。第二行是 CUDA 路径上的硬约束:DSA 的索引器 kernel 只接受 64 token 的物理页。也就是说,SGLang 的主 KV 与索引器缓存虽然可以共用逻辑页号,但索引器的物理页粒度被 kernel 钉死在 64,调度器的页大小必须与它对齐。
索引器缓存本身按层分配,每层一个二维 uint8 缓冲区:
def _buffer_shape(self, num_pages: int) -> tuple[int, int]: pool = self.pool return ( num_pages, pool.page_size // pool.index_kpool * (pool.index_head_dim + pool.index_head_dim // pool.quant_block_size * 4), )
def _layer_num_pages(self, layer_idx: int, num_pages: int) -> int: # Layers that reuse the previous layer's top-k never write index-K, so # they get a 0-row placeholder that keeps ``buffer`` layer-aligned. return 0 if self.pool.skip_topk_layers[layer_idx] else num_pages_buffer_shape 的第二个维度就是每页的字节数:64 / 1 * (128 + 128 / 128 * 4) = 64 * 132 = 8448 字节。21 个 full 层各分配 num_pages 行,57 个 shared 层拿到的是 0 行占位张量。这样做的目的不是省内存的“技巧”,而是让 buffer 的层下标与模型层号一一对应:读第 30 层的索引器缓存时直接用 buffer[30],不需要再维护一张“第几层映射到第几个缓冲区”的表。0 行张量不占显存,但保留了层对齐。
这部分结构在第十一篇已经出现过,这一篇关心的是它如何进入显存预算。SGLang 的池大小不是按主 KV 单独算的,pool_configurator.py 的 _compute_cell_size 会把索引器缓存加进每个 token 的成本:
cell_size = ( calculate_mla_kv_cache_dim(model_config=model_config, kv_cache_dtype=kv_cache_dtype) * effective_num_layers * kv_size)...if is_deepseek_dsa(model_config.hf_config): indexer_cell_size = self._compute_dsa_indexer_cell_size( kvc=kvc, num_layers=num_layers, ) if not kvc.is_draft_worker: indexer_cell_size *= dcp_size cell_size += indexer_cell_size_compute_dsa_indexer_cell_size 的返回值是:
indexer_size_per_token = ceil_div( index_head_dim + index_head_dim // DSATokenToKVPool.quant_block_size * 4, get_dsa_index_kpool(kvc.model_config.hf_config),)...return int( indexer_size_per_token * num_indexer_layers * element_size * indexer_ratio)代入 GLM-5.3 的常量:index_head_dim = 128、quant_block_size = 128,所以 indexer_size_per_token = 132;num_indexer_layers = 21;element_size = 1(uint8 缓冲)。索引器每 token 的成本是 2,772 字节。主 KV 的成本是 656 * 78 = 51,168 字节。cell_size 就是 53,940 字节。
这个数字随后被用来算 token 容量,calculate_pool_sizes 的两行代码就是全部逻辑:
max_total_num_tokens = available_bytes // self._cell_sizemax_total_num_tokens = max_total_num_tokens // page_size * page_size先按每 token 成本整除,再向下对齐到页。也就是说,SGLang 的 KV 池只有一个 token 维度的大小,主 KV 和索引器缓存在这个维度上是同一本账。池子分配出 size 个 token 槽位后,主 KV 按 size 分配 kv_buffer,索引器缓存按 size 分配 21 层的 IndexKeyCache;两份缓冲的槽位号完全相同,第 i 个 token 的主 KV 在第 i 个槽位,索引器 K 也在第 i 个槽位。
这也解释了一个容易被忽略的现象:把 indexer_types 从 21/78 改成 39/78,池子的 token 容量会下降。表面上看只是多写了 18 层索引器缓存,实际上每 token 的成本增加 18 × 132 = 2,376 字节,从 53,940 涨到 56,316 字节;同样的显存能装下的 token 少了约 4.2%。如果只看主 KV 的 51,168 字节,就会误以为容量没变。
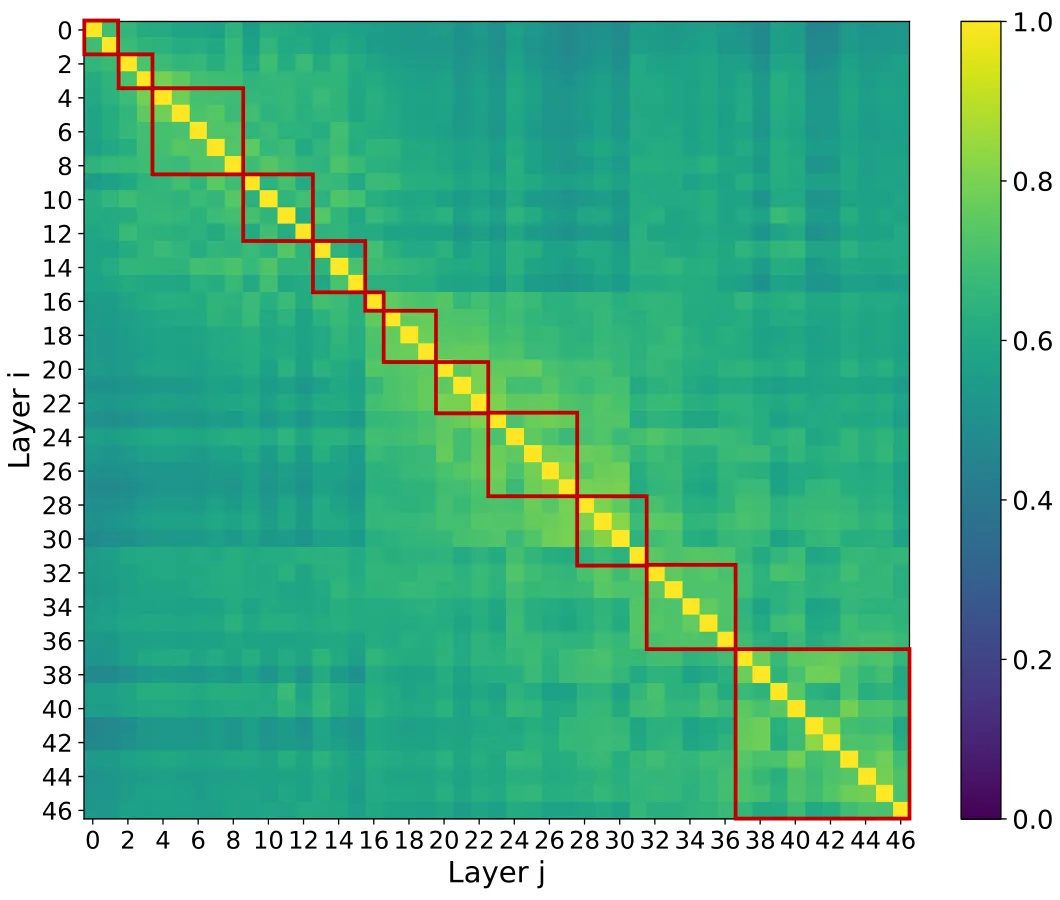
图中展示的是索引器跨层复用的基本结构:只有部分层真正写索引器 K,其余层复用上一层产出的 top-k。SGLang 把这个结构落到 IndexKeyCache 的 0 行占位张量上,池子大小按真实写入层数计算。图源:跨层索引复用研究与 SGLang 源码注释。
还有一处容易被忽略的细节:index_buf_size 并不总等于主池的 size。在 DCP(decode context parallel)开启时,索引器 K 在 DCP 组内是复制的,而主 KV 的 latent 是切分的,所以索引器的槽位空间要按 dcp_size 放大:
if index_buf_size is None: dcp_size = get_parallel().attn_dcp_size index_buf_size = ( size if dcp_replicated else (size + self.page_size) * dcp_size - self.page_size )这段代码的直接后果是:索引器缓存的物理页数在上限上约为主 KV 的 dcp_size 倍(dcp_replicated 时退化为 1 倍),但它复用的仍然是主池的槽位号,复制发生在各 rank 的物理地址上。对调度器来说,可分配的 token 数仍由主池的 size 决定;对显存预算来说,索引器缓存的实际占用要按 index_buf_size 算,不能按 size 算。第十一篇在讨论 PD 传输时提到的 57GB,就是按这个口径把主 KV 与索引器缓存加起来的。
两笔不落在页里的开销:top-k 下标与 logits 工作区
主 KV 和索引器 K 都存在分页池里,但索引器一次 decode 还需要两种临时量:每个 query 行选出的 2,048 个 top-k 下标,以及打分用的 FP32 logits。这两笔开销不属于任何一条请求的 KV,也不随请求结束释放,它们在引擎启动时就分配好,大小由调度配置决定。
vLLM 的 topk_indices_buffer
vLLM 在模型层里分配一份全局的 top-k 下标缓冲,所有层共用:
if self.is_v32: topk_tokens = config.index_topk topk_indices_buffer = torch.empty( vllm_config.scheduler_config.max_num_batched_tokens, topk_tokens, dtype=torch.int32, device=self.device, )大小是 max_num_batched_tokens × index_topk × 4 字节。默认 max_num_batched_tokens 通常取 2,048 到 8,192 之间,index_topk 为 2,048,那么这份缓冲是 16MB 到 64MB。它被当作 topk_buffer_width 传给 MLA 层,也被 DeepseekV32IndexerCache 当作“本层需要写入多少列下标”的依据:
def get_kv_cache_spec(self, vllm_config: VllmConfig) -> KVCacheSpec: return MLAAttentionSpec( block_size=self.cache_config.block_size, num_kv_heads=1, max_tp_shards=1, head_size=self.head_dim, dtype=self.dtype, cache_role=SparseCacheRole.INDEXER, ) # Only has one vector instead of K + V注意这里的 cache_role=SparseCacheRole.INDEXER。它不是装饰性字段:vLLM 的 MLAAttentionSpec.merge 要求同一组内的 spec 具有相同的 cache_role、topk_buffer_width、is_index_group_leader 等字段,这些字段决定索引器层能不能与同组的主 KV 层合并成一个物理页。下面会详细拆。
SGLang 的 logits 预算
SGLang 的索引器打分使用一份 [num_rows, num_cols] 的 FP32 logits 矩阵,num_cols 是整段上下文的 token 数。1M 上下文、一行 query 的 logits 就是 4MB;如果是 prefill 的 32K 行,不做切片就是 128GB。mqa_logits_utils.py 把这件事写成显式的预算检查:
MQA_LOGITS_BYTES_PER_ELEM = 4MQA_LOGITS_STATIC_SKIP_ELEMS = 8_000_000MQA_LOGITS_TOTAL_MEM_FRACTION = 0.3MQA_LOGITS_ROW_ALIGN_ELEMS = 256
def mqa_logits_static_budget_bytes(*, device_index: int) -> int: total_mem = get_device_module().get_device_properties(device_index).total_memory total_mem_budget = int(total_mem * MQA_LOGITS_TOTAL_MEM_FRACTION) mem_fraction_static = get_schedule().mem_fraction_static if mem_fraction_static is None: budget = total_mem_budget else: static_free_mem = int(total_mem * max(0.0, 1.0 - mem_fraction_static)) budget = min( int(static_free_mem * mqa_logits_free_mem_fraction()), total_mem_budget ) return max(1, budget)三个常量决定了这笔预算的形状:MQA_LOGITS_TOTAL_MEM_FRACTION = 0.3 表示 logits 最多占用整卡显存的 30%;MQA_LOGITS_ROW_ALIGN_ELEMS = 256 表示每一行的 logits 会按 256 个 FP32 列对齐,即每行 1KB 的步长,这是 DeepGEMM 的 paged-MQA kernel 要求的;MQA_LOGITS_STATIC_SKIP_ELEMS = 8_000_000 表示小于 8M 个元素(约 32MB)的 logits 矩阵不做预算检查,因为它的规模不至于冲击显存。
当 num_rows * num_cols 超过预算时,mqa_logits_should_chunk 返回 need_chunk = True,索引器把 query 行切成多段,每段单独打分、单独做 top-k,最后再把各段的结果合并。这就是第三篇提到的“按行切块会拉长 kernel 启动”的来源:切块越多,kernel 启动次数越多,但单次 logits 缓冲不超过预算。
在 decode 阶段,num_rows 是 batch 内的 token 数(开启 MTP 时是 batch × (k+1)),num_cols 是上下文长度。MTP 打开后,行数变成 6 倍,同样的 1M 上下文,logits 从 4MB × batch 变成 24MB × batch,切块阈值会更容易被触发。
这笔预算还有一个副作用:它按“整卡显存减去 mem_fraction_static 之外的部分”计算,而 KV 池只占 mem_fraction_static 那部分。两者在同一个显存池里竞争,索引器切块时 kernel 需要的临时缓冲如果正好落在 KV 池的地址附近,就会触发碎片化或分配失败。第十一篇把这类临时缓冲称为“按 4RL 量级增长的隐性瓶颈”,这里补上它的具体来源:它来自 logits 矩阵,不是来自 KV 本身。
前缀命中:一份命中,两份覆盖,但计算只省一部分
前缀缓存的核心假设是:如果两条请求的前缀 token 完全相同,那么这段前缀的 KV 只算一次。对 GLM-5.3 来说,这个假设要同时覆盖主 KV 和索引器 K,否则命中的请求会拿到底层不一致的缓存。
SGLang 的 RadixCache 与 DSA 池的槽位等价
SGLang 的 RadixCache 用一棵前缀树保存 token 序列到物理槽位的映射。match_prefix 做最长前缀匹配:
key = params.keykey, _ = key.maybe_to_bigram_view(self.is_eagle)if self.disable or len(key) == 0: return self._empty_match_resultkey = key.page_aligned(self.page_size)if len(key) == 0: return self._empty_match_resultvalue, last_node = self._match_prefix_helper(self.root_node, key)return MatchResult( device_prefix_len=sum(len(v) for v in value), last_device_node=last_node, last_host_node=last_node, best_match_node=last_node,)几个关键点:
maybe_to_bigram_view:EAGLE 草稿模式下,前缀树按 bigram(两个 token 一组)索引,而不是按单 token。GLM-5.3 的 MTP 层在投机解码时会扩展出 5 个草稿 token,bigram 视图让草稿树的分支能复用更多的前缀。page_aligned(self.page_size):命中长度向下取整到页边界。SGLang 的页大小与索引器物理页对齐(64 token),所以“命中一个页”意味着主 KV 的 64 个槽位和索引器 K 的 64 个槽位同时在树上。value是一个槽位下标张量。因为DSATokenToKVPool的索引器缓存与主 KV 使用同一个槽位号,value不需要任何转换就能同时指向两份缓存的对应位置。
inc_lock_ref / dec_lock_ref 是引用计数。命中时,命中节点的 lock_ref 加一,这些槽位就从 evictable_leaves 集合里移出去,不会在请求运行期间被驱逐:
def inc_lock_ref(self, node: TreeNode) -> IncLockRefResult: if self.disable: return IncLockRefResult(delta=0) delta = 0 while node != self.root_node: if node.lock_ref == 0: self.evictable_size_ -= len(node.key) self.protected_size_ += len(node.key) delta -= len(node.key) node.lock_ref += 1 self._update_leaf_status(node) node = node.parent return IncLockRefResult(delta=delta)由于主 KV 与索引器缓存共享槽位号,lock_ref 保护的也是两份缓存。命中前缀之后,引擎只需要为新请求的未命中后缀分配槽位;主 KV 的未命中部分会被写入,索引器 K 的未命中部分也会被写入。两份缓存是同步扩展的。
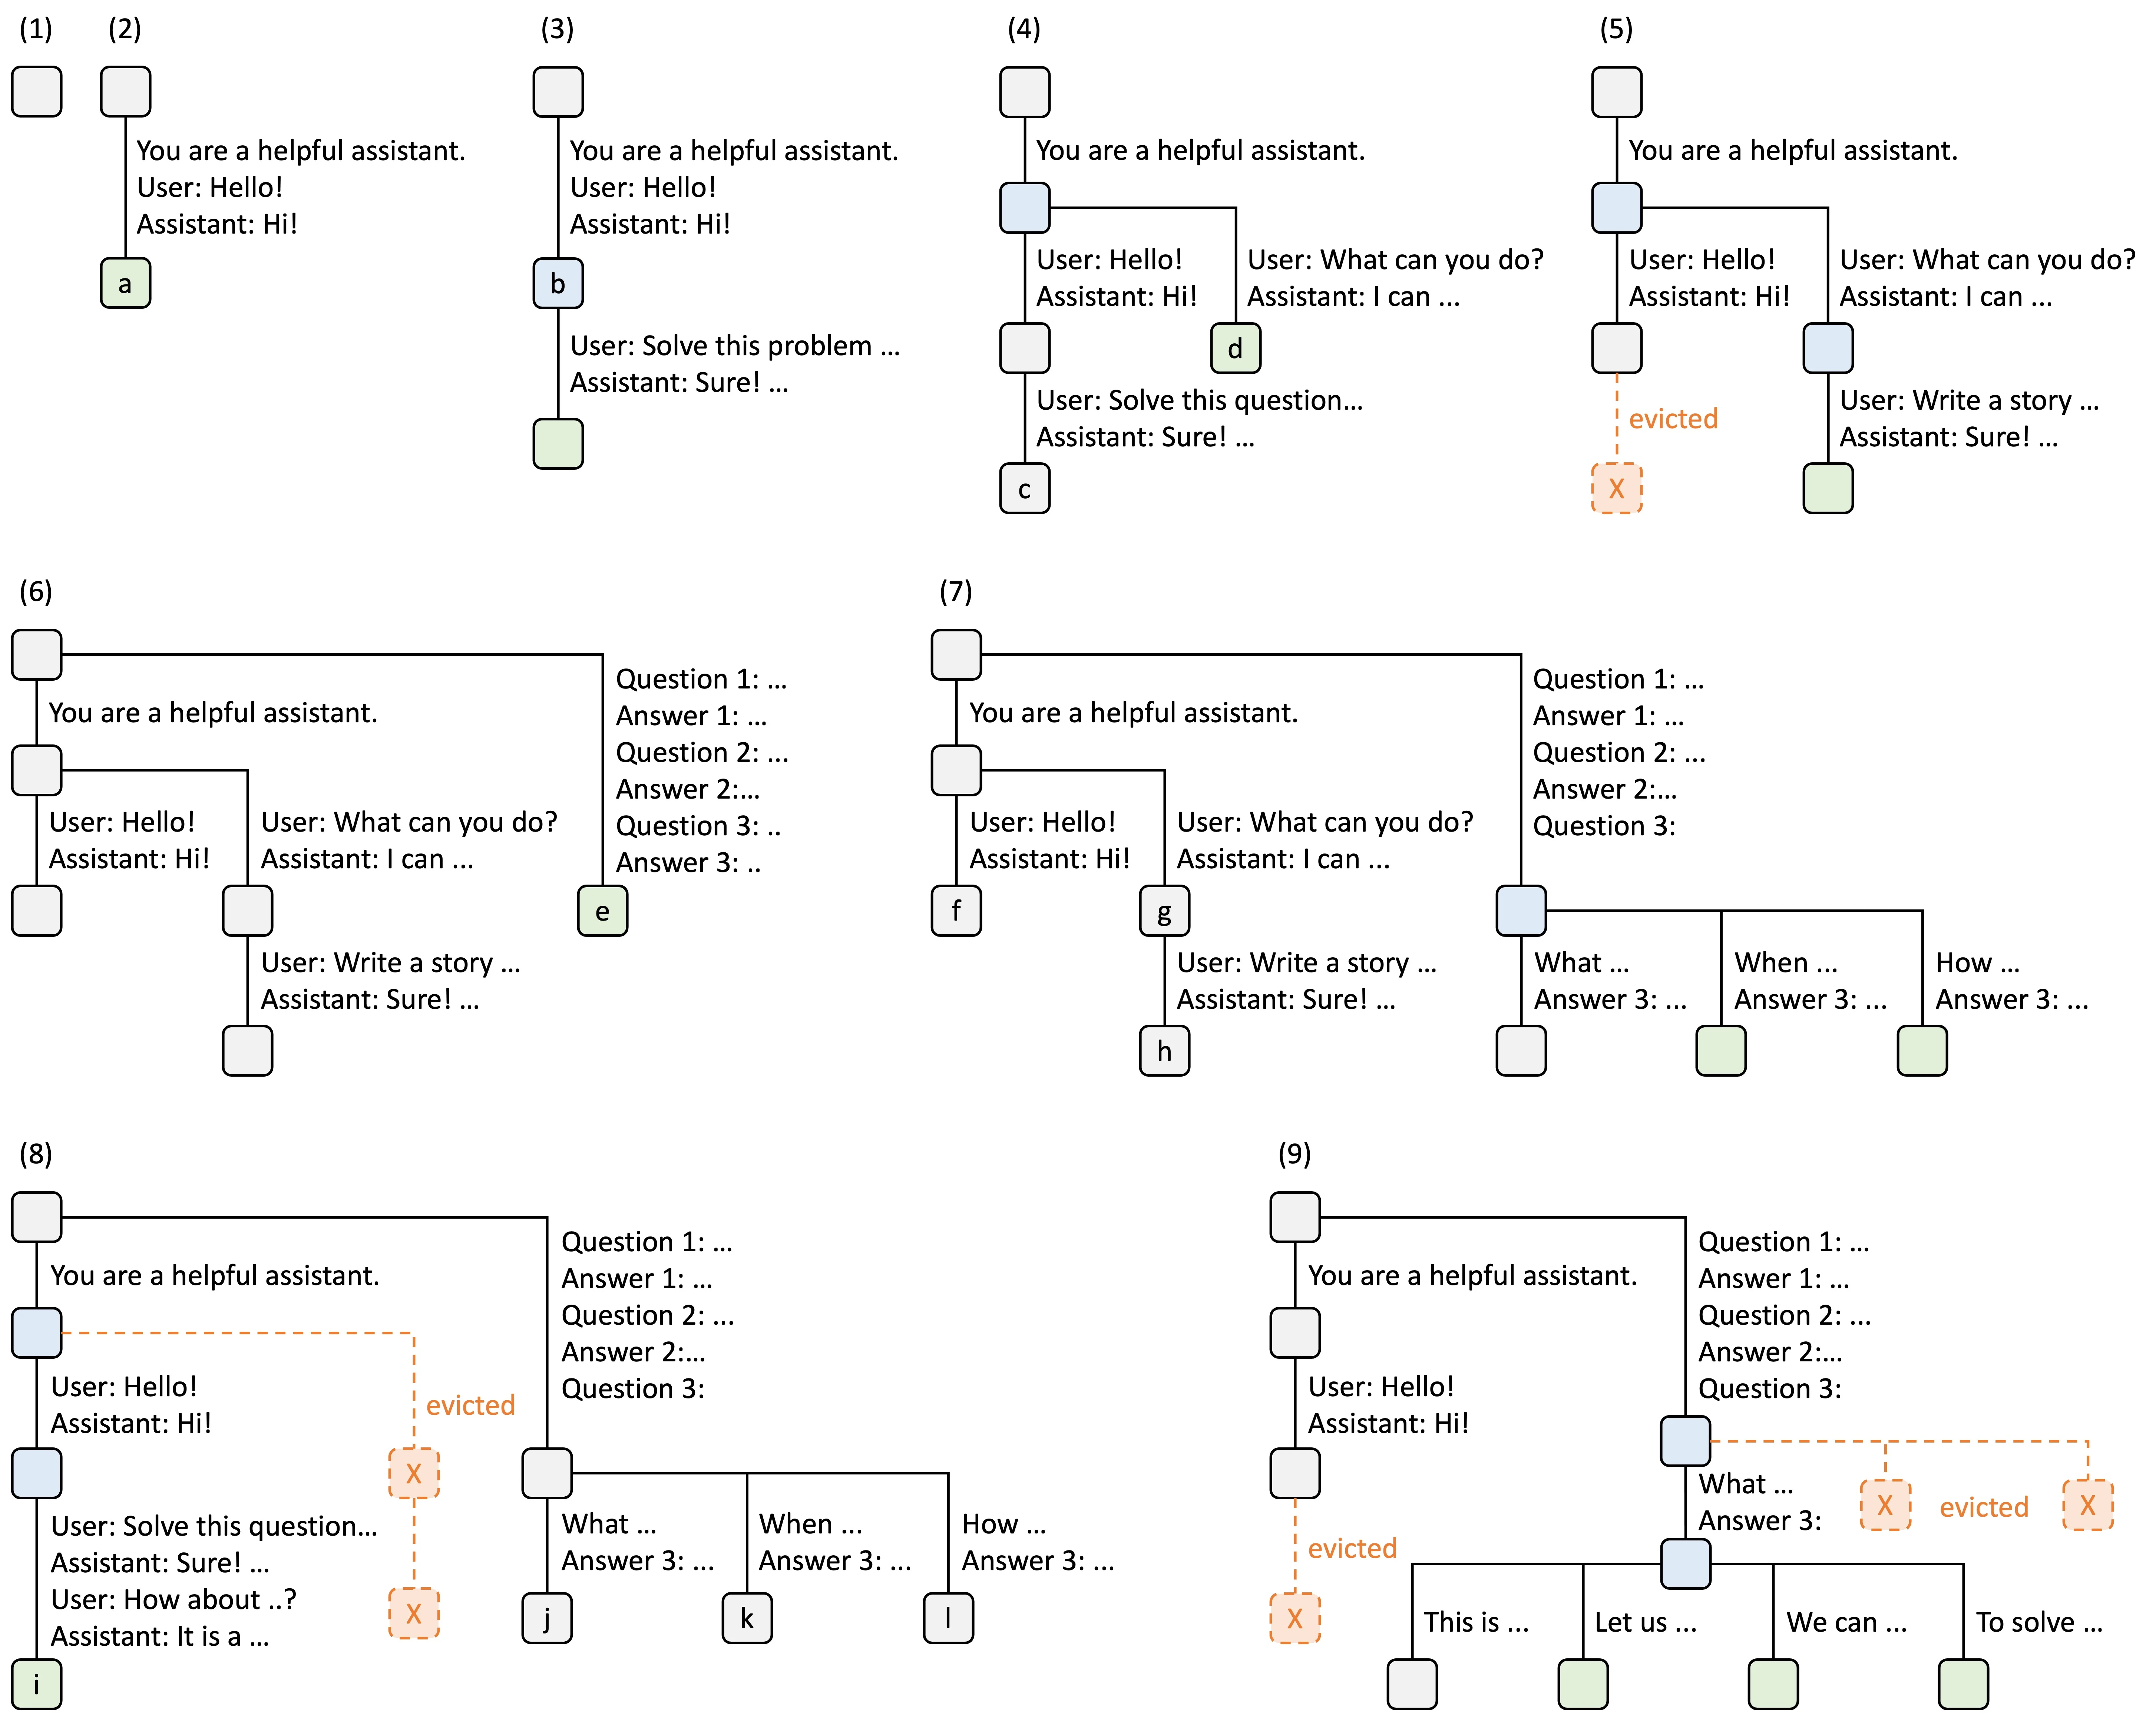
图中是 RadixAttention 的前缀树结构:不同请求共享相同的前缀节点,节点里保存的是 KV 槽位号;SGLang 的 DSA 池让这些槽位号同时对应主 KV 与索引器 K,因此一次树上的命中覆盖两份缓存。图源:SGLang RadixAttention 官方博客。
命中之后,树怎么更新
前缀命中只发生在读侧;请求结束或 prefill 完成后,RadixCache 还要把新算出的后缀插入树。插入逻辑在 _insert_cache 里:
kv_indices = self.req_to_token_pool.req_to_token[ req.kv.req_pool_idx, : len(token_ids)]radix_key = RadixKey( token_ids, req.extra_key, is_bigram=self.is_eagle, cache_salt=req.cache_salt,).page_aligned(self.page_size)...values = kv_indices[:key_len].to(dtype=torch.int64, copy=True)result = self.insert(InsertParams( key=radix_key, value=values, inserted_len=req.kv.cache_inserted_len, priority=priority,))...self.token_to_kv_pool_allocator.free_segment( kv_indices[req.kv.cache_protected_len : result.prefix_len], start_pos=req.kv.cache_protected_len,)这里有两个容易忽略的点:
values是kv_indices的切片拷贝,不是视图。树节点持有自己的槽位号副本,请求结束后即使req_to_token行被回收,树仍然能用这份副本找到物理页。insert返回的prefix_len是树中已经存在的公共前缀长度;free_segment把请求自己重复持有的那一段槽位还回分配器,避免“树和请求各持一份引用”造成泄漏。因为索引器缓存与主 KV 共享槽位号,这段free_segment同时也把索引器缓存的重复槽位释放了。
RadixKey 的 page_aligned 会把 key 截到页边界,values 也按同样的长度截断。落在尾页里的不足 64 个 token 不会进入树,也不会被前缀缓存复用;它们的主 KV 和索引器 K 仍然写在池子里,但只属于当前请求。下一次请求即使有相同的前缀,也只能命中到前一个完整页。
但必须说清楚:命中省下的是前缀内部的计算,不是后缀对前缀的索引器打分。前缀命中的 token 不再做 QK、不再写 KV,这部分是对的。后缀的 query 要对整段上下文(包括命中的前缀)做 lightning indexer 打分,因为 top-k 选择依赖当前的 query,而不是前缀 token 的 KV 内容。所以:
- 省掉:前缀 token 作为 query 时的全部计算,包括主 KV 写入、索引器 K 写入、MoE、MLP;
- 没省掉:后缀 token 对前缀的索引器打分、后缀对前缀的稀疏 MLA 读取;
- 省掉的比例:对长度 L 的请求,命中 P 个 token,prefill 计算量从 O(L²) 降到 O((L-P)²) 加上后缀与前缀的交叉项 O((L-P)·P)。P 越大,节省越接近 1 - ((L-P)/L)²。
1M 上下文中命中 512K 前缀的极端情况下,前缀内部的索引器打分从 1M² 级别降到 512K² 级别,是 4 倍的计算节省;但后缀 512K 对前缀 512K 的交叉项仍然存在,总计算量约为原来的 1/4 加交叉项。这个口径比“hit ratio 50% 就是省 50% 计算”精确得多。
vLLM 的单池 BlockPool 与按组哈希
vLLM 走的是另一条路:所有 KV 层共享一个 BlockPool,这套块池与 PagedAttention 的分页思想同源,主 KV 与索引器 K 被组织进同一个 UniformTypeKVCacheSpecs,共享一个块表和同一个 block ID。这个结论的推导要看 _get_kv_cache_groups 的分组顺序。它先判断所有层的 spec 是否完全相等;不相等时尝试 UniformTypeKVCacheSpecs.from_specs,后者要求同组层的 is_uniform_type 为真:
@classmethoddef is_uniform_type(cls, kv_cache_specs: dict[str, KVCacheSpec]) -> bool: block_sizes = set(spec.block_size for spec in kv_cache_specs.values()) if len(block_sizes) > 1: return False if len({spec.dcp_sharded for spec in kv_cache_specs.values()}) > 1: return False first_spec = next(iter(kv_cache_specs.values())) return first_spec.is_uniform_with_collection(kv_cache_specs)is_uniform_with_collection 的默认实现只检查注册表里的分组基类:
def is_uniform_with_collection(self, kv_cache_specs: dict[str, KVCacheSpec]) -> bool: uniform_type_base_spec = KVCacheSpecRegistry.get_uniform_type_base_spec(self) ... return all( isinstance(spec, uniform_type_base_spec) for spec in kv_cache_specs.values() )MLAAttentionSpec 注册时的 uniform_type_base_spec 是 FullAttentionSpec。主 KV 层的 spec 是 MLAAttentionSpec,索引器缓存的 get_kv_cache_spec 返回的也是 MLAAttentionSpec;两者的 block_size 都取自 cache_config.block_size,dcp_sharded 都是默认值,MRO 里都有 FullAttentionSpec。所以 GLM-5.3 的 78 个主 KV 层和 21 个索引器层会被包进同一个 UniformTypeKVCacheSpecs,而不是拆成两个组。
UniformTypeKVCacheSpecs 的页大小是组内各层页大小的和:
@propertydef page_size_bytes(self) -> int: return sum(spec.page_size_bytes for spec in self.kv_cache_specs.values())代入 GLM-5.3:主 KV 层每层每页 656 × 64 = 41,984 字节,78 层合计 3,274,752 字节;索引器层每层每页 132 × 64 = 8,448 字节,21 层合计 177,408 字节。一个 block 的字节数是 3,452,160 字节,约 3.29MiB。这个 block 就是“主 KV 与索引器 K 共享的物理块”:块内先放 78 层 MLA latent 的页,再放 21 层索引器 K 的页,两层共用同一个块表和同一个块号。
_get_kv_cache_bytes_per_block 的注释把这个布局画了出来:
# block-outer (the same packing repeats for every block):# group 0: | blk 0 [ A | B | pad ] | blk 1 [ A | B | pad ] | ...# group 1: | blk 0 [ C | D ] | blk 1 [ C | D ] | ...# |<--- bytes_per_block --->|对单组的 GLM-5.3 来说,A/B 是 MLA latent 与 scale,C/D 是索引器 K 与 scale;它们被装进同一个块,块尾可能还有对齐填充。块数由可用显存除以每块字节数得到:
bytes_per_block = _get_kv_cache_bytes_per_block(kv_cache_groups, layout)num_blocks = available_memory // bytes_per_block这解释了为什么 vLLM 不需要单独给索引器缓存分配一个池:索引器层的页就是同一个 block 里的一段连续区域。调度器分配一个 block,主 KV 的 64 个 token 槽位和索引器 K 的 64 个 token 槽位同时到位。前缀缓存也只维护一份块哈希:块命中时,主 KV 与索引器 K 一起命中;块被驱逐时,两份缓存一起失效。
cache_role=SparseCacheRole.INDEXER 和 tokens_per_state 仍然有意义:它们标记哪些层是索引器层、每个索引状态覆盖多少 token。当模型的索引器层与主 KV 层在 block_size 或 dcp_sharded 上不一致时,is_uniform_type 返回 False,两层会被拆成不同的组,各自有块表和块哈希;那时命中长度才需要取各组的最小值。GLM-5.3 的默认配置不属于这种情况,但 index_kpool 压缩会改变每层页大小,page_size_bytes 的求和结果也随之变小,规划块数时要按压缩后的值算。
vLLM 的另一个细节是 EAGLE_GROUP 的最后一块处理:投机解码的草稿头需要命中断点前一个 token 的 hidden state,所以命中长度要回退一个块或一个哈希单元。GLM-5.3 的 MTP 层会在后缀第一步用到这个 hidden state,如果命中块被“整块保留”而没有回退,草稿头拿到的就是旧 token 的 hidden state,草稿质量会明显下降。find_longest_cache_hit 的 drop_eagle_block 参数就是为此存在:
if drop_eagle_block and hit_length > 0: hit_length -= min(alignment_tokens, block_size)这条回退规则在混批和 PD 分离下都要保持一致。PD 分离时,prefill 实例计算前缀后把 KV 与索引器缓存一起传给 decode 实例;如果 decode 实例的前缀树记录的长度没有按 EAGLE 规则回退,MTP 的第一次验证就会用错上下文。第十篇提到 PD 分离时 indexer_types 两份名单都要核对,这里再补一条:回退长度也要两边一致。
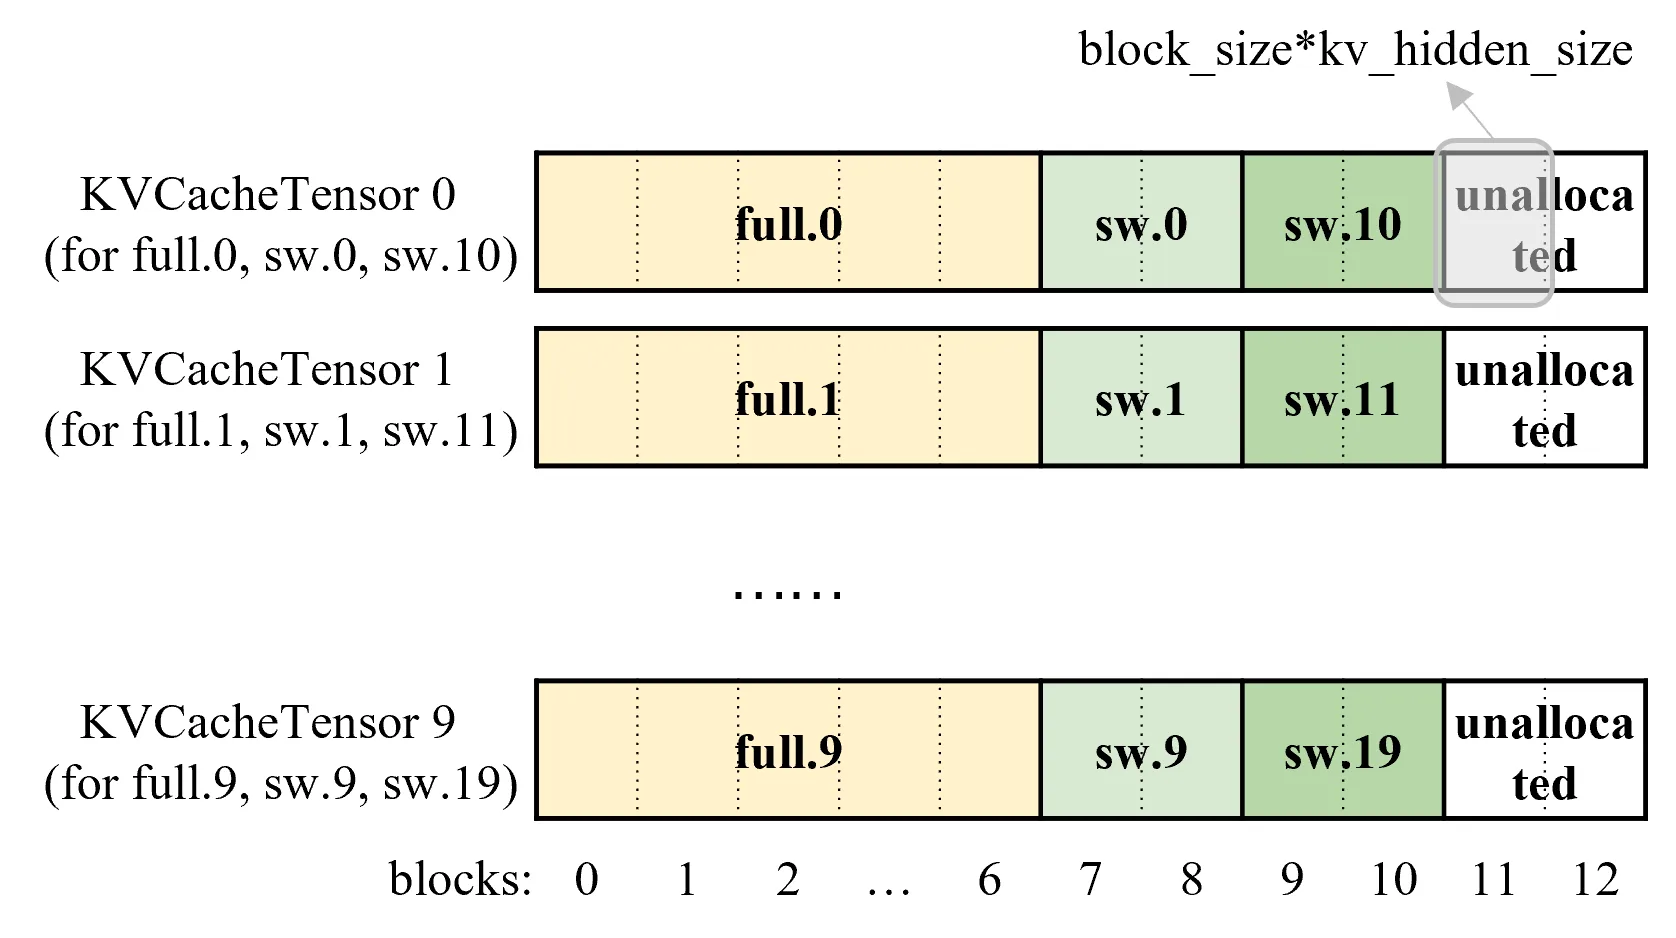
图中展示的是 vLLM 对不同 KV Cache 组的物理块布局。不同组的页大小和层数可能不同,但共享同一个 BlockPool 的块号空间;命中判定要求所有参与前缀缓存的组在同号块上都命中。图源:vLLM 文档 docs/design/hybrid_kv_cache_manager.md。
驱逐与回收:一次释放必须同时释放两份缓存
前缀命中和运行时占用会让缓存池里的块逐渐被用完。当调度器需要为新请求分配页而池子不足时,它会做两件事之一:驱逐(evict)已缓存的块,或抢占(preempt)正在运行的请求。两条路径都必须让主 KV 和索引器缓存同步释放。
SGLang:free_segment 作用于共享槽位
SGLang 的 RadixCache.evict 从 evictable_leaves 里按驱逐策略拿叶子节点,调用 token_to_kv_pool_allocator.free_segment(x.value, start_pos=0),然后 _delete_leaf 把节点从树上摘掉:
def evict(self, params: EvictParams) -> EvictResult: if self.disable: return EvictResult() start_time = time.perf_counter() num_tokens = params.num_tokens leaves = list(self.evictable_leaves) eviction_heap = [ (self.eviction_strategy.get_priority(node), node) for node in leaves ] heapq.heapify(eviction_heap) num_evicted = 0 while num_evicted < num_tokens and len(eviction_heap): _priority, x = heapq.heappop(eviction_heap) self.token_to_kv_pool_allocator.free_segment(x.value, start_pos=0) num_evicted += len(x.value) self._delete_leaf(x) if len(x.parent.children) == 0 and x.parent.lock_ref == 0: new_priority = self.eviction_strategy.get_priority(x.parent) heapq.heappush(eviction_heap, (new_priority, x.parent)) self.kv_events.record_remove(x) self.update_eviction_metrics(num_evicted, start_time) return EvictResult(num_tokens_evicted=num_evicted)x.value 是槽位号张量,free_segment 把这些槽位还给分配器。分配器归还的槽位号,会在下一次分配时被重新赋予给新请求;新请求写入主 KV 时,同一槽位号的索引器 K 也会被覆盖。这就是“一次释放两份缓存”的实现方式:没有显式调用 IndexKeyCache.free,因为索引器缓存没有独立的分配器,它的生命周期完全绑定在槽位号上。
抢占(preempt)的路径也依赖同一个槽位号。当一个运行中的请求被抢占时,调度器释放它的槽位,主 KV 和索引器 K 一起失效;下次恢复时,请求要么从等待队列重新 prefill,要么从 CPU offload 的副本恢复。DSA 池的 CPU 副本显式处理了这一点:
def get_cpu_copy(self, indices, mamba_indices=None, req_pool_index=None): # Retraction reuses index-cache pages; offload index/scale with KV so resume cannot read another request's entries. kv_cache_cpu = super().get_cpu_copy(indices, mamba_indices=mamba_indices) cpu_copy = { "kv": kv_cache_cpu, "index_k": self.index_key_cache.cpu_copy(indices), } ...注释写得很直白:如果不把 index/scale 一起 offload,恢复时请求会读到别的请求写进同一页的索引器条目。因为索引器缓存与主 KV 共享槽位号,抢占后槽位会被复用,索引器页的内容就属于新请求了。
有一个边界情况要注意:如果索引器缓存是 DCP 复制的(index_buf_size 按 dcp_size 放大),槽位号在主 KV 与索引器缓存上不是一一对应,而是“主 KV 的一个槽位对应多个 DCP rank 上的索引器槽位”。move_kv_cache 的实现同时移动主 KV 和索引器缓存,避免压实之后槽位错位:
def move_kv_cache(self, tgt_loc: torch.Tensor, src_loc: torch.Tensor): """Move latent KV and the DSA indexer cache (key + scale) in lockstep.""" super().move_kv_cache(tgt_loc, src_loc) self.index_key_cache.move(tgt_loc, src_loc)IndexKeyCache.move 里的注释补充了页内布局:每个物理页先存所有 key 字节,再存所有 scale 字节;所以迁移时不能按整个页拷贝,必须按 token 位置处理 key 和 scale 两个区域:
# Each physical page stores all key bytes followed by all scale bytes.# Locations identify tokens; copying whole pages overwrites neighbors.vLLM:块级引用计数与组级同步释放
vLLM 的释放入口在 BlockPool.free_blocks 与 SingleTypeKVCacheManager.free:
def free(self, request_id: str) -> None: self.block_pool.free_blocks(reversed(self.pop_blocks_for_free(request_id)))每个块有 ref_cnt,归零后回到 free_block_queue 的尾部,成为第一顺位的驱逐候选。驱逐时 _maybe_evict_cached_block 把块从 cached_block_hash_to_block 里摘掉:
def _maybe_evict_cached_block(self, block: KVCacheBlock) -> bool: if self.metrics_collector: self.metrics_collector.on_block_evicted(block) evicted_hashes = self._remove_cached_block_hashes(block) if not evicted_hashes: return False self._emit_block_removed_events(evicted_hashes) return True主 KV 组和索引器组各有自己的 SingleTypeKVCacheManager,但它们的块来自同一个 BlockPool。一个块在某个组里的哈希被摘掉,不代表它在另一个组里的哈希也失效。命中判定要求的“所有组都命中”,保证了一旦主 KV 组的某个块失效,索引器组即使还有哈希也不能单独命中。但如果反过来——索引器组的块因为某种原因先被驱逐——主 KV 组的命中不会自动失效,命中长度会停在索引器组最早失效的那一块。这是 find_longest_cache_hit 的逐块循环决定的:循环在第一个未命中的块处 break,不会继续往后查。
这个顺序设计的结果是:命中长度取各组的 min,不会出现“主 KV 命中 10 块、索引器只命中 3 块”却返回命中 10 块的错误。代价是:如果两个组的驱逐节奏不同,整体命中率会被较弱的那个组拖住。
free 的路径则是一起释放:pop_blocks_for_free 取的是整条请求持有的块列表,主 KV 组和索引器组都在其中;free_blocks 按逆序(先释放尾部块)把引用计数减到零。逆序的原因在代码注释里没有展开:尾部块是最近写入的,驱逐优先级最高;先放尾部块,块表在逻辑上保持连续,下一次前缀匹配在尾部边界处更容易命中。
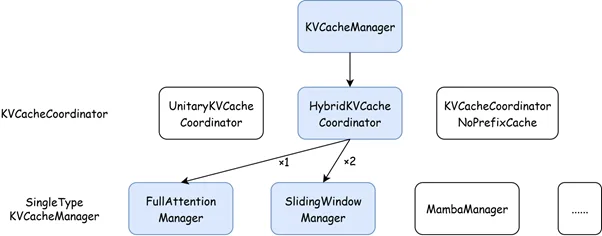
图中给出的是混合缓存管理器的总体结构:多个组从同一个块池取块,命中判定以组为单位汇总。主 KV 组与索引器组都参与前缀缓存时,命中取两者的最短公共前缀。图源:vLLM 文档 docs/design/hybrid_kv_cache_manager.md。
三笔开销,两本账:谁和谁耦合,谁真正独立
把前面的内容收拢成一张表:
| 开销 | 存放位置 | 大小口径 | 是否随请求结束释放 | 与 KV 分页的关系 |
|---|---|---|---|---|
| 主 KV | 分页池 | 656 B/token/层 × 78 | 是(引用计数归零后) | 分配单位本身 |
| 索引器 K | 分页池的平行区 | 132 B/token/层 × 21 | 是(随槽位/块一起) | 与主 KV 同一分配单位 |
| top-k 下标 | 全局缓冲 | max_num_batched_tokens × index_topk × 4 | 否(进程级) | 无关,独立分配 |
| logits | 临时工作区 | num_rows × num_cols × 4 | 否(进程级/按次) | 无关,独立预算 |
这张表回答了一个常见的误解:主 KV 和索引器缓存不是两份可以独立伸缩的预算。它们在 SGLang 里共用 cell_size,在 vLLM 里共用 page_size_bytes;你无法只给主 KV 扩池而让索引器缓存保持原大小,也无法在驱逐时只释放主 KV。真正独立的只有 top-k 下标和 logits 工作区,而这两笔恰恰是按 max_num_batched_tokens 和上下文长度增长的,调大 batch 或上下文时它们会比 KV 更早撞墙。
这种耦合带来两个直接后果:
第一,容量规划不能只看主 KV。以 1M 上下文为例,主 KV 是 53.7GB,加上索引器缓存是 56.6GB,多出的 2.9GB 相当于 53 个 64-token 页的容量。如果按 53.7GB 规划一个 56GB 的池子,表面上看能放一条 1M 请求,实际准入时会因为差 2.9GB 被拒绝,或者更糟:前向跑到一半才发现索引器缓存分配不出来。
第二,改变 indexer_types 的比例会改变池子的 token 容量。把 21 层改成 39 层,每 token 成本从 53,940 涨到 56,316 字节,同样的显存容量下降 4.2%。这个变化在短上下文下不明显,在 1M 上下文下是 2.3GB 的差距。调 indexer_types 时不重新算池子大小,线上会出现“模型能加载、长请求跑不动”的现象。
一次 1M 请求的完整账
把上面的数字放进一条具体的请求,看看分页和命中如何一步步发生。
SGLang 路径
请求输入 1M token,要求生成 256 token。调度器准入时先算 KV 需求:
- 主 KV:
1,048,576 × 51,168 = 53,687,091,712字节,约 53.7GB; - 索引器 K:
1,048,576 × 2,772 = 2,906,652,672字节,约 2.9GB; - 合计 56.6GB,按 64-token 页算 1,048,576 / 64 = 16,384 页。
如果池子的 max_total_num_tokens 是 1,100,000,这条请求能准入;如果是 1,000,000,它会被拒绝,因为 1M 请求本身就要 1,048,576 个槽位,池子连一条都放不下。PrefillAdder 的准入条件不只是 token 数,还要看当前空闲页数、运行中请求的预留页数和 rem_total_tokens。一条 1M 请求会在准入阶段一次性预留全部 16,384 页,这也是为什么第三篇说长请求会挤掉短请求。
Prefill 按 32,768 token 一块切分,共 32 块。每块需要 32,768 / 64 = 512 页,约 1.69GB 的写入量。注意:虽然准入时已经预留了全部页,prefill 的每一块只写自己那 512 页的主 KV 与索引器 K;未写的页是空的,但已经被这条请求占用,其他请求不能用。
如果这条请求的前缀命中了 100K token(比如系统提示词相同),命中部分占 100,000 / 64 = 1,562 页,约 5.39GB 的主 KV 和 277MB 的索引器 K。命中页的引用计数加一,不重新写入;未命中的 948,576 token 需要新分配 14,822 页。前缀命中省下的写入量是 5.39GB 主 KV 加 277MB 索引器 K,省下的索引器打分是前缀内部的约 100K² / 2 = 5×10⁹ 对 query-key 分数。按每个分数 32 头 × 128 维 × 2 FLOPs ≈ 8,192 FLOPs 计算,约 41 TFLOP;在 1 PFLOP/s 量级的索引器算力下,这是几十毫秒级的差别。
但后缀的 8K token 仍然要对 100K 前缀做索引器打分,交叉项约 8K × 100K = 8×10⁸ 对分数,约 6.6 TFLOP。这部分不会因为前缀命中而消失。索引 K 的读取量也不是按 query 行数乘出来的:一个 prefill 块里,索引器 kernel 把 100K 前缀的 K 读进片上缓存后复用于所有 query 行,读取量约 100K × 132 × 21 = 277MB,与 query 行数基本无关。前缀命中省掉的是前缀自己的打分计算,不是这次读取。
Decode 阶段每一步只新增 1 个 token。如果当前页还有空槽,直接写入;否则分配一个新页。每 64 步才分配一页,索引器 K 也只在 21 个 full 层写入这 1 个 token。decode 的 KV 分配开销被摊薄到 64 步一次,但索引器读取仍然每一步都要读整段上下文,这就是第十一篇说的“存储按页摊薄、读取按上下文线性增长”。
请求结束后,RadixCache 把请求的槽位插入前缀树,dec_lock_ref 释放引用计数;如果没有其他请求共享,这些节点进入 evictable_leaves。下一次池子不足时,evict 从最久未访问的叶子开始,free_segment 把 16,384 页还给分配器;主 KV 与索引器 K 同时可被覆盖。
vLLM 路径
同一个 1M 请求在 vLLM 里按块分配。一个块 3.29MiB,1M token 需要 1,048,576 / 64 = 16,384 块。num_gpu_blocks 在启动时由 available_memory // bytes_per_block 算出;如果日志显示 GPU KV cache size: 1,100,000 tokens,那么块数是 1,100,000 / 64 ≈ 17,187,足够一条 1M 请求加少量并发。
Prefill 按 max_num_batched_tokens 切块。假设 32K,每块 512 个块;调度器在 allocate_slots 里为新 token 申请块,块表按 block ID 记录。前缀命中 100K 时,find_longest_cache_hit 逐块查哈希;因为 GLM-5.3 是单组,主 KV 与索引器 K 在同一个块上,命中 1,562 块就是两份缓存同时命中。MTP 开启时,drop_eagle_block 会把命中长度回退一个块(64 token),保证草稿头能拿到断点前一个 token 的 hidden state。
Decode 每一步 1 个 token,通常复用已持有的尾块;尾块满了才分配新块。CUDA Graph 捕获时,块表是静态输入,新块分配发生在图外,图内只更新块表指针。混批时,prefill 的 512 块和 decode 的几十块在同一个 BlockPool 里竞争,调度器按 token 预算和块预算决定先满足谁。
请求结束后,free 把整条请求的块按逆序还给 free_block_queue;如果块被前缀缓存引用,ref_cnt 归零后仍留在 cached_block_hash_to_block 里,直到下一次分配把它驱逐。主 KV 与索引器 K 在同一个块里,所以一次 free 同时释放两份缓存。
页尾浪费
两条路径都有一个共同的浪费:请求的 token 数不是 64 的整数倍时,最后一个页只装了一部分 token。SGLang 的页大小是 64,尾页平均浪费 32 个 token;按每 token 53,940 字节算,每个请求约浪费 1.73MB。1000 条短请求同时在线,就是 1.73GB 的尾页浪费。短请求越多、上下文越短,这个比例越高;长上下文请求的尾页浪费可以忽略。
vLLM 的块大小同样是 64(MLA 的 kernel block size 约束),尾块浪费的口径相同。区别在于 vLLM 的块是多个组共享的,尾块里主 KV 与索引器 K 一起浪费;SGLang 的尾页里两份缓存也一起浪费。两者没有本质差别。
同一套公式,四种上下文长度
把 53,940 字节/token 的代价值代入不同上下文长度,可以看到索引器缓存的绝对量如何随长度变化:
| 上下文 | 主 KV | 索引器 K | 合计 | 64-token 页数 | 索引器占比 |
|---|---|---|---|---|---|
| 8K | 419 MiB | 22.7 MiB | 442 MiB | 128 | 5.4% |
| 128K | 6.7 GiB | 363 MiB | 7.1 GiB | 2,048 | 5.4% |
| 512K | 26.9 GiB | 1.45 GiB | 28.3 GiB | 8,192 | 5.4% |
| 1M | 53.7 GB | 2.9 GB | 56.6 GB | 16,384 | 5.4% |
比例始终是 5.4%,但绝对量从 22.7MiB 涨到 2.9GB。短上下文下,索引器缓存确实可以忽略;128K 时它相当于 363MiB,已经接近一个小模型的权重;1M 时它是 2.9GB,和一张卡的剩余显存同一量级。判断“要不要为索引器缓存单独做优化”,不能只看比例,要看绝对量和它所在的上下文区间。
前缀命中的收益也随长度变化。命中一半前缀时,写入量按比例减半:1M 请求命中 512K,主 KV 少写 26.9GB,索引器 K 少写 1.45GB。索引器打分的节省是前缀内部的二次方项:1M 请求省掉 512K²/2 对分数,8K 请求只省掉 4K²/2 对分数;后者的绝对量很小,短上下文的前缀缓存主要省的是主 KV 写入和 MoE 计算,不是索引器。
这也解释了为什么前缀缓存对短请求的收益主要体现在 TTFT 的线性部分,对长请求才主要体现在索引器的二次方部分。部署时如果流量以短请求为主,前缀缓存的价值在 KV 复用和调度;如果以 128K 以上的长请求为主,索引器打分的节省才是主要收益。
分页的 CPU 账:块表与页表
两份缓存在 GPU 上共享分配单位,在 CPU 上也要共享一张映射表。SGLang 的 ReqToTokenPool 为每个请求槽位维护一行 req_to_token,长度是 max_context_len:
self.req_to_token = torch.zeros( (size, max_context_len), dtype=torch.int32, device=device)一个 1M 上下文的请求需要 1,048,576 个 int32 条目,即 4MiB 的页表;32 条并发就是 128MiB。这张表只记录主 KV 的槽位号,索引器缓存不另建表,因为它的槽位号与主 KV 完全相同。前缀命中时,命中部分的页表项直接指向已有槽位,不新分配;未命中部分才追加。
vLLM 的块表按块号记录,一行长度是 max_num_blocks_per_req。1M 上下文、64-token 块,一行是 16,384 个 int32 条目,即 64KiB;32 条并发是 2MiB。GLM-5.3 的单组布局只有一张块表,主 KV 与索引器 K 共用;如果拆成多组,块表要按组各存一份,CPU 和 GPU 的块表拷贝量都会翻倍。这是“单组”带来的一个不太显眼的好处。
块表的构造发生在每个 step 的输入准备阶段。SGLang 的 InputBatch 把页表指针、序列长度、输出槽位拼成张量;vLLM 的 AttentionMetadata 把块表传给注意力后端。块表越长,这一步的 H2D 拷贝越大;1M 上下文下,单条请求的块表就是 64KiB,32 条是 2MiB,按 PCIe 带宽算是几十微秒,但在 decode 的每步预算里不能忽略。CUDA Graph 捕获后,块表指针固定,只有内容更新,拷贝量不变。
前缀命中对 CPU 账的影响是减少新页表项:命中 100K 就少写 1,562 个页表项,约 6KiB;对 1M 请求的整体块表来说只是 4%,真正的大头是未命中的 900K。这也是为什么长上下文的前缀缓存优化不能只看命中率,还要看命中长度:命中 100K 和命中 500K,对块表构造的节省差 5 倍。
索引器缓存的写入路径
索引器 K 的写入发生在每个 full 层的注意力前向里。DSATokenToKVPool.set_index_k_scale_buffer 调用 IndexKeyCache.store_quantized,后者把 FP8 key 与 FP32 scale 写进当前 token 对应的页内偏移:
def store_quantized(self, layer_id, loc, index_k, index_k_scale): buf = self._kernel_view(self.buffer[layer_id - self.pool.start_layer]) dsa_index_k_cache.SetKAndS.execute( pool=self.pool, buf=buf, loc=loc, index_k=index_k, index_k_scale=index_k_scale, )一次 prefill 块 32K token,21 个 full 层各写 32,768 × 132 = 4.3MB,合计 90.8MB。一次 decode 每请求写 1 × 132 × 21 = 2.8KB;MTP 开启时一次验证写 6 × 132 × 21 = 16.6KB。写入量与 token 数线性相关,与上下文长度无关;读取量才与上下文长度线性相关。
前缀命中时,命中部分的 token 不进入前向,store_quantized 不会被调用;未命中的后缀照常写。驱逐时没有“清零”操作:槽位被归还后,下一次写入直接覆盖旧内容。这也意味着索引器缓存不需要单独的 free,它的“释放”只是槽位号重新可用。
有一个与 MTP 相关的细节:投机解码的草稿 token 也会写索引器 K,验证失败后要回滚。IndexKeyCache 没有按 token 回滚的接口,回滚依赖主 KV 的页表截断:把被拒绝的 token 对应的页表项去掉,下一次写入覆盖即可。因为索引器缓存与主 KV 共享槽位号,页表截断同时让两份缓存的尾部失效。这个设计比“给索引器缓存单独维护一个回滚栈”简单,但也要求回滚时严格按 token 边界截断,不能只截断主 KV 而留下索引器缓存的脏尾。
64 token 页的由来
SGLang 的 DSA 池断言 CUDA 路径必须是 64-token 物理页;vLLM 则把后端支持的 kernel 页大小列出来,DSA 的通用后端在 CUDA 上返回 [64]:
@staticmethoddef get_supported_kernel_block_sizes(kv_cache_spec=None) -> list[int | MultipleOf]: return [1, MultipleOf(16)] if current_platform.is_rocm() else [64]这个 64 不是随便选的。DSA 的索引器打分用 paged MQA logits kernel,DeepGEMM 的 paged-MQA 路径按 64 个 token 一页读取 K;GLM-5.x 的 Glm5NextIndexerBackend 在 index_kpool > 1 时返回 index_kpool × n,其中 n 取自 get_paged_mqa_page_sizes()(除 SM120 只有 64 外,H200 这一代为 32 或 64);页太小,kernel 的页表项和启动开销上升;页太大,一次读取的 K 超出片上缓存,且尾页浪费增加。64 是“页表开销、片上缓存容量、尾页浪费”三者的折中;不同框架在页粒度上的取舍,可参考五个推理框架的 KV 页大小对照。
主 KV 的页大小可以和索引器不同。SGLang 的 index_page_size = page_size // index_kpool 允许主池页是 64 的倍数:当 index_kpool = 2 时,主池页可以是 128,索引器物理页仍是 64;主池的页表项少一半,索引器 kernel 仍按 64 读取。这个设计把“主 KV 的页粒度”和“索引器 kernel 的页粒度”解耦,代价是索引器页的编号要按 index_kpool 折算,store_quantized 的 loc 也要做对应的除法。
vLLM 的 tokens_per_state 是同一件事的另一种表达:索引器 spec 的 tokens_per_state = index_kpool 表示一个索引状态覆盖 N 个 token,kernel block size 取 index_kpool × 64。主 KV 的块大小仍由 cache_config.block_size 决定,两者在 page_size_bytes 求和时各自按自己的页大小计算。这也是为什么 index_kpool 压缩不仅省索引器字节,还会改变块内布局和 kernel 的页表读取方式。
工程判断:什么时候该单独关注索引器缓存
索引器缓存只占 5.4% 的字节,但它在四种场景下会成为主要矛盾:
- 长上下文 prefill。索引器的打分计算是 O(L²),1M 上下文下它占总 prefill 时间的一半以上(第三篇的实测比例)。前缀命中能省掉前缀内部的 P²/2,但省不掉后缀对前缀的 P×S 交叉项;P 和 S 都很大时,交叉项仍然主导。判断是否值得为前缀缓存扩容,要看命中前缀的长度分布,而不是只看命中率。
indexer_types调整。增加full层会同时增加索引器缓存字节和打分计算;减少full层会降低质量。这个取舍不能只看存储,要看每层的 top-k 重叠率和质量评测。第十一篇的跨层复用数据是 1/2 几乎无损、1/4 需要搜索模式、1/8 明显退化;GLM-5.3 的 21/78 正好在 1/4 附近,是一个经过质量验证的比例。- PD 分离。KV 传输量按 57GB 算,其中索引器缓存 2.9GB,占 5%。传输时间按 IB 带宽折算,2.9GB 在 400Gbps 链路上是 58ms 量级;如果只传主 KV,decode 实例的索引器缓存是空的,后缀的第一次 top-k 就要重新打分,TTFT 会增加。第四篇的 PD 交接把索引器缓存单独列为一类张量,原因就在这里。
- MTP 与投机解码。每个 draft step 都要写索引器 K,验证失败还要回滚。
index_share_for_mtp_iteration=true且topk=1时,MTP 迭代内可以复用上一轮的 top-k,减少重复打分;如果--speculative-eagle-topk 5,每个 draft 位置都要单独选 top-k,复用失效,索引器计算按 draft 数放大。这个开关在源码里不会单独打日志,部署时要显式核对。
反过来,有三种场景不需要为索引器缓存做特殊优化:
- 短上下文(小于 2K):索引器打分只占很小一部分,主 KV 的权重读取和 MoE 是瓶颈;
- 纯 decode、batch 很大:每步只写 1 个 token 的索引器 K,写入量可以忽略,读取量按上下文线性增长但被 batch 摊薄的程度有限,仍要关注;
- 前缀命中率极低:命中省不到索引器计算,扩容前缀缓存没有收益。
故障排查:线上看到哪几个数,就知道问题在分页还是索引器
把这篇的账落到运维上,可以整理出四个判断:
max_total_num_tokens与期望值对不上。期望值 = 可用显存 / 53,940 × 页对齐。如果实际值比期望小 5% 左右,先查indexer_types是否多于 21 层full;如果少了约dcp_size倍,查 DCP 是否开启且索引器缓存按复制口径计入。- 长请求准入失败但短请求正常。看
PrefillAdder的rem_total_tokens与rem_total_pages;如果 token 还够但页不够,说明页池被长请求一次性预留占满,索引器缓存的 2.9GB 也在其中。此时调低--max-num-seqs比调大池子更直接。 - 前缀命中率高但 TTFT 没降。命中只省前缀内部的索引器打分;如果命中前缀很短(小于 2K)、后缀很长,交叉项 P×S 占主导,收益会被稀释。看命中长度分布,不看命中率。
- decode 每步耗时随上下文线性涨、且不随 batch 摊薄。这是索引器读取量
L × 132 × 21的线性项,不是权重读取(被 batch 摊薄)。降低上下文、开启跨层复用或减少full层可以缓解;单纯加大 batch 无效。
这四个判断都来自同一本账:主 KV 与索引器缓存共享分配单位,但读取带宽是两份独立的线性项,只有前者被 batch 摊薄。
常见误解与纠正
误解一:索引器缓存只有 5%,可以按主 KV 规划显存
纠正:存储上确实只有 5.4%,但分配上它和主 KV 是同一个单位。SGLang 的 cell_size 把 2,772 字节加进每 token 成本,vLLM 的 page_size_bytes 把 21 层的页加进每块字节数。按主 KV 规划会少算 2.9GB(1M 上下文),长请求准入失败或运行中 OOM。
误解二:前缀命中会同时省掉索引器的全部计算
纠正:只省掉前缀 token 作为 query 的那部分计算。后缀 token 仍然要对整段前缀做打分,交叉项 P×S 不会消失。命中 100K、后缀 8K 时,前缀内部省掉约 5×10⁹ 对分数,交叉项仍有 8×10⁸ 对;后者是前者的 16%,但在 1M 上下文下会涨到与前者同量级。
误解三:主 KV 和索引器缓存可以独立扩缩
纠正:两个框架都把两份缓存绑在同一个分配单位上。SGLang 共享槽位号,vLLM 共享 block ID。不能只给主 KV 扩容;改变 indexer_types 比例会改变整个池子的 token 容量。
误解四:驱逐时索引器缓存需要单独释放
纠正:SGLang 的 free_segment 只操作槽位号,索引器缓存没有独立分配器;vLLM 的 free 释放整条请求的块,索引器层在同一个块里。两份缓存的生命周期由同一个引用计数/块号管理。
误解五:页大小只影响碎片率
纠正:DSA 索引器的 CUDA 路径要求 64-token 物理页。页大小同时决定前缀缓存的命中粒度、索引器 kernel 的页表布局和尾页浪费。把页调小会提高前缀命中精度,但可能违反 kernel 约束;把页调大能减少页表项,但尾页浪费和一次性写入量都会增加。
局限与尚未解决的问题
- 本文的字节数是模型常量,不是实测吞吐。656 与 132 来自
fp8_ds_mla与索引器布局;实际占用还要加上对齐、scale、DCP 复制和分配器碎片。线上应以max_total_num_tokens与num_gpu_blocks日志为准。 index_kpool压缩会改变索引器页的有效 token 容量。本文按未压缩口径计算;vLLM 的 GLM-5.x 路径在index_kpool > 1时,每个索引状态覆盖多个 token,tokens_per_state进入 spec,页大小和块数都要重算。压缩对 top-k 质量的影响没有公开的端到端评测。- 前缀命中率与命中长度分布没有公开数据。本文用 100K 命中做算例,不代表 GLM-5.3 在生产中的典型命中长度;真实收益要用请求轨迹统计。
- 页碎片与索引器读取带宽的定量关系缺乏模型。64-token 页在大量短请求下会产生尾页浪费,但碎片率对索引器 kernel 有效带宽的影响没有公开测量;本文只给了尾页浪费的上界。
- DCP 复制下的索引器缓存预算。
index_buf_size按dcp_size放大,实际占用可能比本文的 2.9GB 高出数倍;具体取决于dcp_replicated与部署拓扑,需要按实际配置核算。
小结
把这篇的结论按一条线串起来:
- 两份缓存的字节账:主 KV 656 B/token/层 × 78 = 51,168 B/token;索引器 K 132 B/token/层 × 21 = 2,772 B/token;合计 53,940 B/token。1M 上下文是 53.7GB + 2.9GB = 56.6GB,索引器占 5.4%。
- SGLang 的分配单位是槽位号:
cell_size把两份缓存加在一起,max_total_num_tokens只有一个维度;IndexKeyCache的 57 个shared层是 0 行占位,21 个full层按页分配;free_segment一次释放两份缓存。 - vLLM 的分配单位是 block ID:主 KV 与索引器层被
UniformTypeKVCacheSpecs包进同一组,page_size_bytes是组内各层页大小之和,一个 block 同时装下两份缓存;块哈希只有一份,命中与驱逐天然同步。 - 前缀命中省的是前缀内部的计算:前缀 token 不再做前向、不再写主 KV 与索引器 K,索引器打分省掉 P²/2;后缀对前缀的 P×S 交叉项仍然存在,索引 K 的读取量按上下文线性增长,不随命中消失。
- 真正独立的预算是 top-k 下标与 logits 工作区:vLLM 的
topk_indices_buffer是max_num_batched_tokens × index_topk × 4;SGLang 的 logits 是num_rows × num_cols × 4,按预算切行。调大 batch 或上下文时,这两笔会比 KV 更早撞墙。
把这五条放回第八篇的时间线,一条请求的 KV 账本现在有了完整的四个阶段:准入时按 cell_size 或 page_size_bytes 预留;prefill 时按页/块写入两份缓存;decode 时按尾页追加;结束时按引用计数或块号一起回收。前缀命中改变的是第二阶段的写入量和索引器打分的计算量,不改变分配单位,也不改变驱逐的粒度。理解这一点,才能解释为什么“索引器缓存只占 5%”却能让一条 1M 请求在准入阶段被拒绝,也才能解释为什么 PD 分离的 57GB 传输里那 2.9GB 不能省。
参考资料
- GLM-5.3 模型卡(zai-org/GLM-5.3)
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA 与稀疏 MLA 结构,arXiv:2512.02556)
- SGLang 源码:
python/sglang/srt/mem_cache/memory_pool.py(DSATokenToKVPool与IndexKeyCache分配) - SGLang 源码:
python/sglang/srt/mem_cache/index_key_cache.py(按层缓冲区与页内 key/scale 布局) - SGLang 源码:
python/sglang/srt/mem_cache/radix_cache.py(match_prefix、insert、evict与lock_ref) - SGLang 源码:
python/sglang/srt/model_executor/pool_configurator.py(cell_size与 DSA 索引器成本) - SGLang 源码:
python/sglang/srt/layers/attention/mqa_logits_utils.py(logits 工作区预算与切行) - vLLM 源码:
vllm/v1/kv_cache_interface.py(MLAAttentionSpec、UniformTypeKVCacheSpecs与页大小定义) - vLLM 源码:
vllm/v1/core/kv_cache_planning.py(分组、bytes_per_block与num_blocks) - vLLM 源码:
vllm/v1/core/block_pool.py(块哈希、引用计数与驱逐) - vLLM 源码:
vllm/model_executor/models/deepseek_v2.py(DeepseekV32IndexerCache.get_kv_cache_spec) - vLLM 源码:
vllm/models/glm5next/common/attention.py(Glm5NextIndexerCache与块共享注释) - vLLM 文档:Hybrid KV Cache Manager 设计
- vLLM GLM-5.3 部署配方(FP8 KV、MTP 与 1M 上下文)
- SGLang 官方博客:RadixAttention 与前缀缓存
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



