


vLLM 源码完全拆解(三十):显存预算——从 gpu_memory_utilization 到 KV 块数,那一次 profile_run 到底测了什么
vLLM 启动时总会打印这样一行日志:Available KV cache memory: 41.73 GiB,接着是一句 “GPU KV cache size: 261,648 tokens”。很多部署问题的第一现场就在这里——日志显示 KV 池比预期少了一大截,却不知道这条推算公式的每一格是怎么来的;把 --gpu-memory-utilization 从 0.92 调到 0.95,多出来的 2 GiB 既没有反映到可用 KV,反而出现了莫名其妙的 OOM。
这些现象都指向同一件事:vLLM 的显存不是一个数,而是一本按档记的账本。本文沿着 V1 的启动路径(Worker.init_device → EngineCore._initialize_kv_caches)把这本账逐页翻开:初始化时刻留下的基线与预算、哑跑测出的峰值、CUDA Graph 的预留、KV 每块字节数的除法、TP/PP/DCP 下跨 rank 的对齐,以及围绕这些数字的一圈工程保护措施。读完之后,Available KV cache memory 与 GPU KV cache size 这两行日志里的每一个数,都能反推出来自哪里。
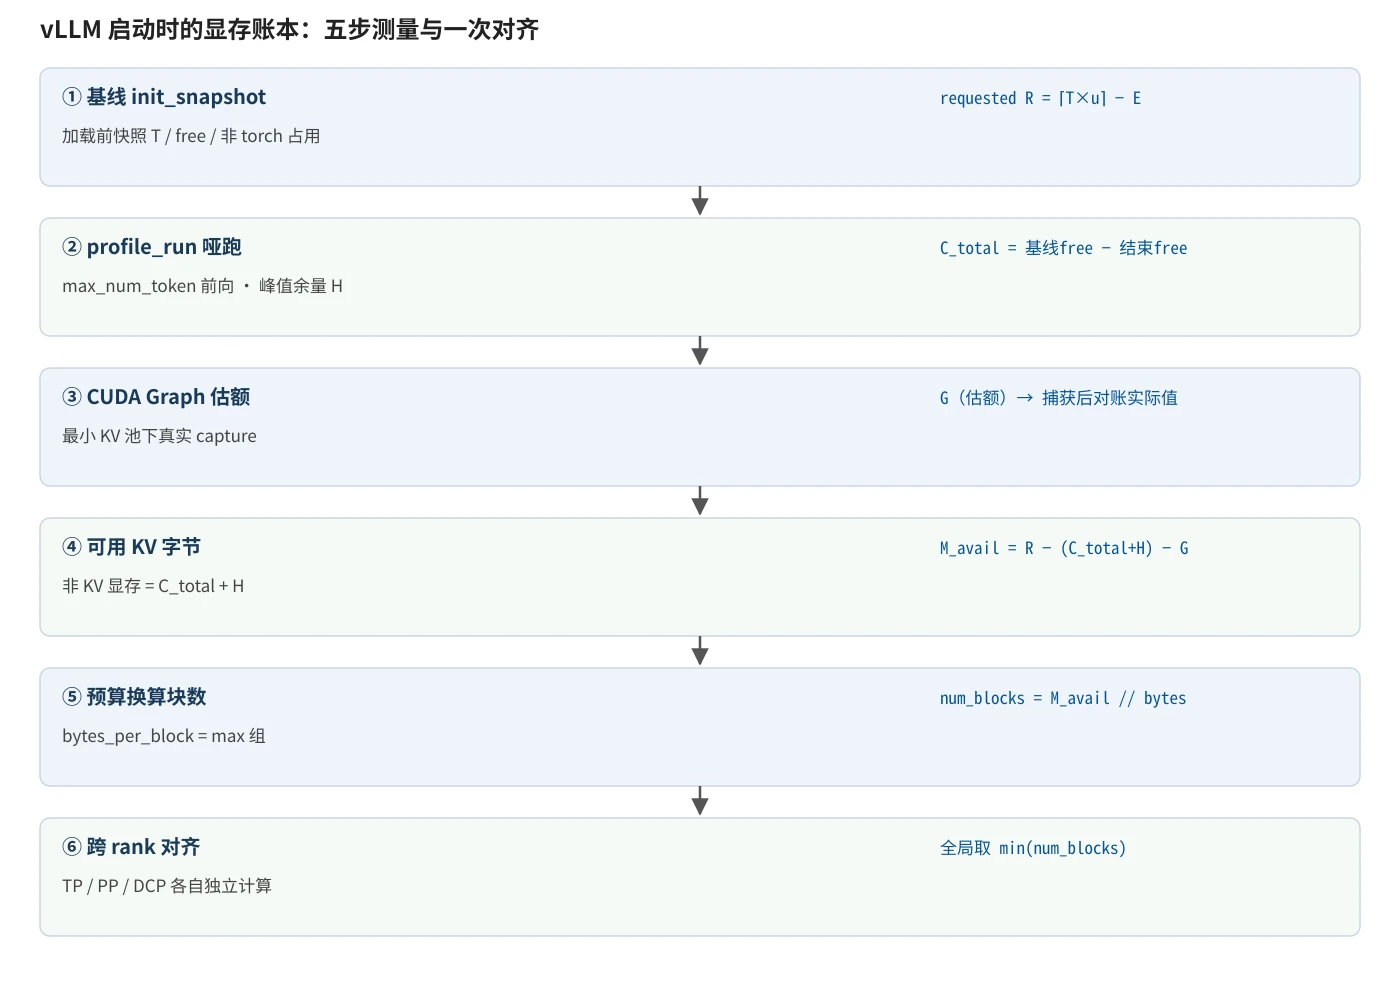
图源:按
vllm/v1/worker/gpu_worker.py、vllm/utils/mem_utils.py与vllm/v1/core/kv_cache_planning.py的调用顺序绘制。
开局留下的基线:init_snapshot 与 requested_memory
显存账本的第一页不是在跑模型时记的,而是在模型加载之前记的。Worker.init_device() 在完成设备初始化、分布式环境初始化、NCCL 通信器创建之后,先做两件不太起眼但很关键的事:
# vllm/v1/worker/gpu_worker.py(摘自 init_device)# cuBLAS(Lt) 直接向 CUDA 申请 handle 内存,torch 看不见,# 先把这几次调用做掉,让它们计入基线x = torch.ones(16, 16, dtype=self.model_config.dtype, device=self.device)torch.mm(x, x)torch.nn.functional.linear(x, x, x[0])del x
gc.collect()torch.accelerator.empty_cache()self.init_snapshot = init_snapshot = MemorySnapshot(device=self.device)self.requested_memory = request_memory( init_snapshot, self.cache_config, external_weight_memory)为什么要先“空跑”一次 torch.mm 和 linear?源码注释解释得很直白:cuBLAS 与 cuBLASLt 的 handle 是直接向 CUDA 申请的,PyTorch 的缓存分配器看不到这笔分配。如果等到 profiling 阶段再第一次调用 cuBLAS,此时 PyTorch 缓存已经把显存撑满,cuBLAS 申请失败时 torch 不会替它释放缓存,结果是“明明还有空闲显存却 OOM”。所以 vLLM 把首次 cuBLAS 调用提前到快照之前,让这部分内存在基线里计一次、且只计一次。
紧接着 MemorySnapshot.measure() 采集一组数,它们构成了后续所有推算的起点:
| 字段 | 来源 | 含义 |
|---|---|---|
total_memory / free_memory | torch.accelerator.get_memory_info | 设备总显存与当前空闲显存(UMA 平台如 GH200 改用 psutil 可用内存) |
torch_memory | memory_reserved() | PyTorch 缓存分配器已向 CUDA 申请的字节数 |
cuda_memory | total_memory - free_memory | 整卡已被占用(含非 torch)的字节数 |
non_torch_memory | cuda_memory - torch_memory | NCCL、cuBLAS handle 等 torch 账外占用 |
torch_peak | allocated_bytes.all.peak | 分配器统计的峰值(读的是 allocated 而非 reserved) |
一个容易误读的细节是 torch_peak 读的是 allocated_bytes 而不是 memory_reserved。源码注释说明:调用 reset_peak_memory_stats() 之后,memory_reserved 只会增长,直到 empty_cache() 或真正 OOM 才可能回退,因此用它做峰值没有意义。这里选择“应用程序实际点名要的内存”作峰值口径。
拿到快照后,request_memory() 把预算算出来:
# vllm/v1/worker/utils.py(摘自 request_memory)requested_memory = math.ceil( init_snapshot.total_memory * cache_config.gpu_memory_utilization)# external_weight_memory > 0:权重由外部装载进程持有,需要从预算中扣掉engine_memory = requested_memory - external_weight_memory...if init_snapshot.free_memory < requested_memory: raise ValueError("Free memory on device ... is less than desired GPU memory utilization ...")这里有一个经常被问到的口径问题:gpu_memory_utilization 是相对 total_memory 的比例,不是相对 free_memory 的比例。默认 0.92 意味着 vLLM 打算占用整卡 92% 的显存,而不是“当前空闲显存的 92%”。因此如果同一张卡上还跑着别的进程,哪怕空闲显存只剩一半,0.92 依然会算出近乎整卡的预算,然后在 free_memory < requested_memory 这一个检查上直接失败。日志中给出的建议 “Decrease GPU memory utilization or reduce GPU memory used by other processes” 对应的就是这条检查。这也解释了为什么多实例共卡时,每个实例都应该显式给一个小的利用率;源码注释里给的建议是“两个实例各设 0.5”,而不是让默认值去分摊。
external_weight_memory 是第二条路径:某些装载器(例如把权重加载在另一个进程里再共享过来)会在快照时刻之外持有权重,这部分显存虽然算在整卡里,却不在本进程预算内。request_memory 会把这份外部权重先从预算中扣掉,只把这笔“留给引擎自己”的额度返回给后续流程。
一次哑跑要测什么:profile_run 的形状
有预算之后,下一张要翻的是模型实际会吃掉多少非 KV 显存。这一步由 GPUModelRunner.profile_run 完成——用一份 dummy 输入跑一次完整前向,在上下文的 memory_profiling 中测出峰值与残留。
先看这次哑跑输入的形状,它决定了测出来的峰值能代表哪种场景:
# vllm/v1/worker/gpu_model_runner.py(摘自 _dummy_run 的非 uniform_decode 分支)num_reqs = min(num_tokens, max_num_reqs)min_tokens_per_req = num_tokens // num_reqsnum_scheduled_tokens_list = [min_tokens_per_req] * num_reqsnum_scheduled_tokens_list[-1] += num_tokens % num_reqsnum_tokens 传入的是 self.max_num_tokens(即 max_num_batched_tokens,默认通常是 8192),num_reqs 则被 max_num_seqs 截断(不同版本默认 256 或 1024)。因此默认参数下哑跑并不是“8192 条请求、每条 1 个 token”,而是把 8192 个 token 尽量均匀地摊到 max_num_seqs 条请求上——例如 256 条请求、每条 32 个 token,最后一条补上余数。这个形状并不随意:vLLM 想保证的是任何一次真实调度都不会超过哑跑所测的 token 总量,因为调度器的 token 预算上限就是 max_num_batched_tokens。
还有一个容易忽略的分支:只有 force_attention 为真或 CUDA Graph 模式为 FULL 时,_dummy_run 才会真正构造注意力元数据。profile 阶段传入的是 is_profile=True,走的是 eager 路径,不构造完整的注意力元数据;attention backend 的缓冲要等到 KV 配置确定、initialize_attn_backend 建立之后才有固定尺寸。换句话说,哑跑测的是模型本身(embedding、每层的 GEMM、MoE、norm、采样、logits),而 attention backend 的私有缓冲不在这一轮计入。也正因为这个缺口,determine_available_memory 在 profile_run 之后还要在最小 KV 缓存下真实 capture 一遍 CUDA Graph——那一轮会把 attention backend 在静态图形态下的缓冲也带出来。
多模态模型走的是 profile_run 的前半段:按照 mm_budget 给出的 encoder 预算与单条样本的最大特征尺寸构造 dummy 图像,完整跑一遍 embed_multimodal,再把结果塞进 encoder_cache。这段代码的意义是把视觉编码器在“一个 batch 内最大图像数量 × 最大分辨率”下的峰值也测进来——视觉塔的激活值常常比 LLM 主干更占内存,而且它的峰值与文本 token 数无关。这也解释了日志里那行 “Encoder cache will be initialized with a budget of N tokens, and profiled with M items of the maximum feature size”。
dummy 跑完之后,如果模型是 pooling 模型,还会再跑一遍 _dummy_pooler_run;如果是生成模型,则跑 _dummy_sampler_run,后者会额外把 rejection sampler 在投机解码形态下跑一遍。目的只有一个:把采样器侧所有可能按最大批形状分配的缓冲都提前物化,免得它们在真实请求到达时把原本给了 KV 的显存挤掉。
memory_profiling 的三类账与 total_consumed
profile_run 被包在 memory_profiling 上下文里。这个上下文有一个写得很详细的文档字符串,用一组数字把显存分成三类:
Before creating the vLLM instance: cat1: 1 GiB cat2: 0 GiB cat3: 0 GiBAfter creating and loading: cat1: 1 GiB cat2: 2 GiB cat3: 0.5 GiB (权重 + NCCL)During profiling (peak): cat1: 1 GiB cat2: 4 GiB cat3: 1 GiB (激活峰值 + attention backend 缓冲)After profiling: cat1: 1 GiB cat2: 3 GiB cat3: 1 GiB (激活释放,其余保留)- 类别 1:不属于本 vLLM 实例的显存(其他进程、驱动开销)。
- 类别 2:本实例中由 torch 分配器管理的显存。
- 类别 3:本实例中不经过 torch 分配器的显存(NCCL、cuBLAS handle、某些 attention backend 直接 cudaMalloc 的缓冲)。
这个例子最后给出三段推导:权重 2 GiB 直接来自 weights_memory 参数;峰值激活 2 GiB 来自 allocated_bytes.all.peak 在 profiling 前后的增量;NCCL 与 backend 缓冲 1 GiB 来自 non_torch_memory 从创建实例到 profiling 结束的增量。三者相加得到 non_kv_cache_memory = 5 GiB。
源码里实际的计算路径和这段说明一一对应:
# vllm/utils/mem_utils.py(摘自 memory_profiling)diff_profile = result.after_profile - result.before_profilediff_from_create = result.after_profile - result.before_createresult.torch_peak_increase = diff_profile.torch_peakresult.non_torch_increase = diff_from_create.non_torch_memory# 用 mem_get_info 测得的总占用,避免 cumem 等可插拔分配器绕过 torch 统计result.total_consumed = ( result.before_create.free_memory - result.after_profile.free_memory)# total_consumed 已包含常驻分配,这里只补“瞬时峰值余量”,避免重复计入result.transient_peak_headroom = ( result.after_profile.torch_peak - result.after_profile.torch_allocated)result.non_kv_cache_memory = result.total_consumed + result.transient_peak_headroom这里有两个设计理由值得展开。
第一,为什么用 mem_get_info 而不是 memory_reserved。源码注释提到:在使用可插拔分配器(如 cumem,某些扩展会接管一块显存)时,memory_reserved 会给出负数。free_memory 的差值是物理意义上“这块卡确实变少了多少”,不依赖 torch 的账面,因而更稳。
第二,为什么 non_kv_cache_memory 是 total_consumed + transient_peak_headroom 而不是 total_consumed + torch_peak_increase。上下文退出前会 gc.collect() + empty_cache(),激活张量被释放回缓存分配器,free_memory 上升;如果只看 total_consumed(即“结束时还占着多少”),就会漏掉“峰值时曾经多占了的那部分”。但如果直接把峰值增量再加一次,又会和 total_consumed 中已包含的常驻部分重复。因此这里只补“峰值减去结束时仍在分配器里的那部分”——即瞬时峰值余量。这个余量本质上是“未来任何时刻都有可能再次同时出现的那块瞬态内存”,必须在 KV 分配前为它留出空间。
对 gpu_worker.py 后续推算来说,真正被消费字段其实是 total_consumed、transient_peak_headroom 与 non_kv_cache_memory 三个,torch_peak_increase 与 non_torch_increase 主要用于日志诊断。
一个容易忽略的干扰:max_split_size_mb=20
在 profile_run 外层,gpu_worker.py 套了一层看起来很小但很关键的保护:
# vllm/v1/worker/gpu_worker.py(摘自 determine_available_memory)with ( memory_profiling(...) as profile_result, # 限制分配器可切分的最大块,避免小张量在大块里被切走,把整块钉死 self._scoped_allocator_max_split(split_size_mb=20), set_current_vllm_config(self.vllm_config),): self.model_runner.profile_run(...)源码注释给出的背景是这样的:MoE 的 workspace 在哑跑过程中会按台阶生长——先是小 buffer,逐渐增长为大 buffer,并且在增长过程中释放每一个较小的 buffer。而 torch 的缓存分配器默认会把一块刚被释放的大段内存重新切分成更小的块给新申请;如果没有 split 上限,某次小申请正好落在刚释放的多 GiB 段里,就会把整段“钉住”——memory_profiling 结束时 empty_cache() 无法回收整个段,于是这一段会被当成“已消耗”,从 KV 池里扣掉。
把 max_split_size_mb 临时限制到 20 MiB 之后,超过 20 MiB 的块不再被切分,所有大段都保持可整体回收。退出这个上下文后,分配器上限恢复原值,因此不会影响真实推理中的大块复用(例如激活、MoE workspace 的正常增长)。
这条细节和之前的 “cuBLAS 先跑” 一样,都属于“记账本身有副作用,所以记账过程需要被约束”这一类工程保护。写推理框架时很容易遇到这种问题:测量工具本身改变了被测对象。
CUDA Graph 的预留与默认开启
profile_run 结束后,determine_available_memory 还要补一笔:CUDA Graph 的显存。
# vllm/v1/worker/gpu_worker.py(摘自 determine_available_memory)cudagraph_memory_estimate = 0if (current_platform.is_cuda_alike() or current_platform.is_xpu()) and ( self.use_v2_model_runner or self.vllm_config.compilation_config.cudagraph_mode != CUDAGraphMode.NONE): cudagraph_memory_estimate = self.model_runner.profile_cudagraph_memory()
cudagraph_memory_estimate_applied = ( cudagraph_memory_estimate if envs.VLLM_MEMORY_PROFILER_ESTIMATE_CUDAGRAPHS else 0)profile_cudagraph_memory 做的事情是先按 min(max_num_reqs, max_cudagraph_capture_size) 申请最小 KV 缓存(每个请求一块),然后对 capture_descs 里列出的每一个图桶真正 capture 一遍,记录这些 capture 一共吃掉了多少显存。这样测的是一个和最终 KV 块数无关的量:CUDA Graph 的显存由每张图捕获时的中间激活决定,而不是由 KV 池大小决定。这就是为什么这里可以“用最小 KV 缓存”测一笔准确的估额。
这里还有一层口径变化:VLLM_MEMORY_PROFILER_ESTIMATE_CUDAGRAPHS 的默认值从 v0.21.0 起改为开启(源码注释写作 “default since v0.21.0”)。在旧口径里,CUDA Graph 的显存完全不在 profile 阶段计入,于是用户把 gpu_memory_utilization 调到刚刚好时,KV 池刚好够用,一到图复放就 OOM。新口径把估额显式计入,并会在日志里同时打印三个利用率:当前值、等价的旧口径值、以及维持原有 KV 池需要上调到的目标值。三者之间的差额就是 G / T——这也是不少升级后“KV 池突然变小”的原因。反过来,如果显式关掉估额,可用 KV 会恢复,但捕获 CUDA Graph 时可能 OOM;日志会为这种选择给出 warning。
capture 结束后,initialize_from_config 还会把 cudagraph_memory_estimate 与真实值做一次对账:
CUDA graph pool memory: <actual> GiB (actual), <estimated> GiB (estimated),difference: <diff> GiB (<ratio>%).这条 log 的意义不仅是确认估额靠谱;如果实际值明显大于估额,说明模型里有图桶没有被 profile 阶段覆盖——这是排查 “KV 池刚刚够但图复放 OOM” 类问题的首要线索。
最终公式:预算减非 KV 显存
三笔数都齐了,determine_available_memory 在末尾把这些数压成一行:
# vllm/v1/worker/gpu_worker.py(摘自 determine_available_memory)self.total_consumed = profile_result.total_consumedself.peak_activation_memory = ( profile_result.transient_peak_headroom + cudagraph_memory_estimate_applied)self.cudagraph_memory_estimate = cudagraph_memory_estimate
self.available_kv_cache_memory_bytes = ( self.requested_memory - profile_result.non_kv_cache_memory - cudagraph_memory_estimate_applied)把这几项代入 memory_profiling 的定义,available_kv_cache_memory_bytes 展开成:
其中 是本进程预算(requested_memory), 是设备总显存, 是 gpu_memory_utilization, 是外部装载进程持有的权重字节数; 用 mem_get_info 测出“从创建实例到 profiling 结束,整卡被本进程占走的字节”,其中已经包含权重、激活释放后残留的缓存、以及 NCCL 等 torch 账外占用; 是瞬时峰值余量,即结束时 torch_peak - torch_allocated,对应“还会再次出现的峰值激活”; 是 CUDA Graph 估额。
换成“分类账”的视角更清楚:
其中前三项被包在 里,CUDA Graph 显式列出,采样器与 workspace 与前三项一起测出。
几个能从这里直接读出结论的数据点:
- 权重不显式扣除,但被隐式计入。
memory_profiling把weights_memory当作输入参数放在MemoryProfilingResult里,但non_kv_cache_memory的计算式里没有出现它——因为C_{\text{total}}是用物理空闲显存差值得出的,加载模型那一步“占掉的字节”自然在差值里。weights_memory参数主要用于日志展示;真正的扣减由C_{\text{total}}完成。 - 预算越小,KV 池越小,但小到一定程度会触发
available_kv_cache_memory <= 0的错误。错误信息里的 “(this flag also controls CPU memory reservation on the CPU backend, despite its name)” 说明 CPU 后端下这个参数还被借用来控 CPU 内存,这是跨后端的复用。 - 瞬态余量 是“为将来预留的峰值”。哑跑一次测出的峰值是“这一种批形态”的峰值,而真实推理中还会出现更大的 batch、投机验证与多模态编码器等其他形态,所以必须把峰值与常驻之间的差额留出来。
memory_profiling 之外的显式模式:kv_cache_memory_bytes 与冗余缓冲
determine_available_memory 还有一条分支值得说清楚:
if kv_cache_memory_bytes := self.cache_config.kv_cache_memory_bytes: with set_current_vllm_config(self.vllm_config): self.model_runner.profile_run(...) # 仅为编译、不测内存 ... return reserve_mm_ipc_gpu_memory(kv_cache_memory_bytes, ...)当用户显式给了 --kv-cache-memory 时,profiling 被跳过,KV 池大小直接等于用户指定的字节数,gpu_memory_utilization 完全不起作用(CacheConfig 文档中亦写明“when not-None, ignores gpu_memory_utilization”)。这条路径的用途是给调参场景一个可复现的数字——用户从启动日志里拿到 --kv-cache-memory=41.73GiB 这样的建议值后,就能锁定 KV 大小而不受 profile 波动影响。
另一种提示来自 initialize_from_config 阶段,这里用 cuda_graph_memory_bytes 的实际捕获字节数(不再用估额)做了一次显式的“建议”,并保留 150 MiB 冗余缓冲:
# vllm/v1/worker/gpu_worker.py(摘自 initialize_from_config)redundancy_buffer_memory = 150 * (1 << 20) # 经验上 profile 会略微低估,留 150MiBnon_kv_cache_memory = ( self.total_consumed + self.peak_activation_memory + cuda_graph_memory_bytes)kv_cache_memory_bytes_to_gpu_limit = ( self.init_snapshot.free_memory - non_kv_cache_memory - redundancy_buffer_memory)kv_cache_memory_bytes_to_requested_limit = ( int(self.requested_memory) - non_kv_cache_memory - redundancy_buffer_memory)这条提示把两种上限都算出来:按“当前空闲显存能装多少”(最大化利用)和“按预算能装多少”(保持利用率约束)。日志中建议用户根据场景选择 --kv-cache-memory 的哪一个,正是前面提到的“可复现口径”的来源。
从字节到块:num_blocks 与每块字节数
available_gpu_memory 拿到后,EngineCore._initialize_kv_caches 调用 get_kv_cache_configs,把字节数换成块数。
第一层:每块多少字节。 默认布局(block-outer),一个块跨越所有组的物理显存布局;每块字节数由“最宽的那个组”决定:
# vllm/v1/core/kv_cache_planning.py(摘自 _get_kv_cache_bytes_per_block)bytes_per_block = max( sum( _get_per_layer_spec(group, layer_name).page_size_bytes for layer_name in group.layer_names ) for group in kv_cache_groups)这里用了 max 而不是 sum,原因在源码注释里写清楚:每个组各自从同一个块池中按自己的块表要求取块,所以一个请求的占用是“各组块数之和 × 同一份块字节数”,而不是“所有组的字节数相加”。这也是为什么混合注意力模型的“每个 token 的 KV 字节”是一个组级概念(后文会展开),而不是一个层级的加和。
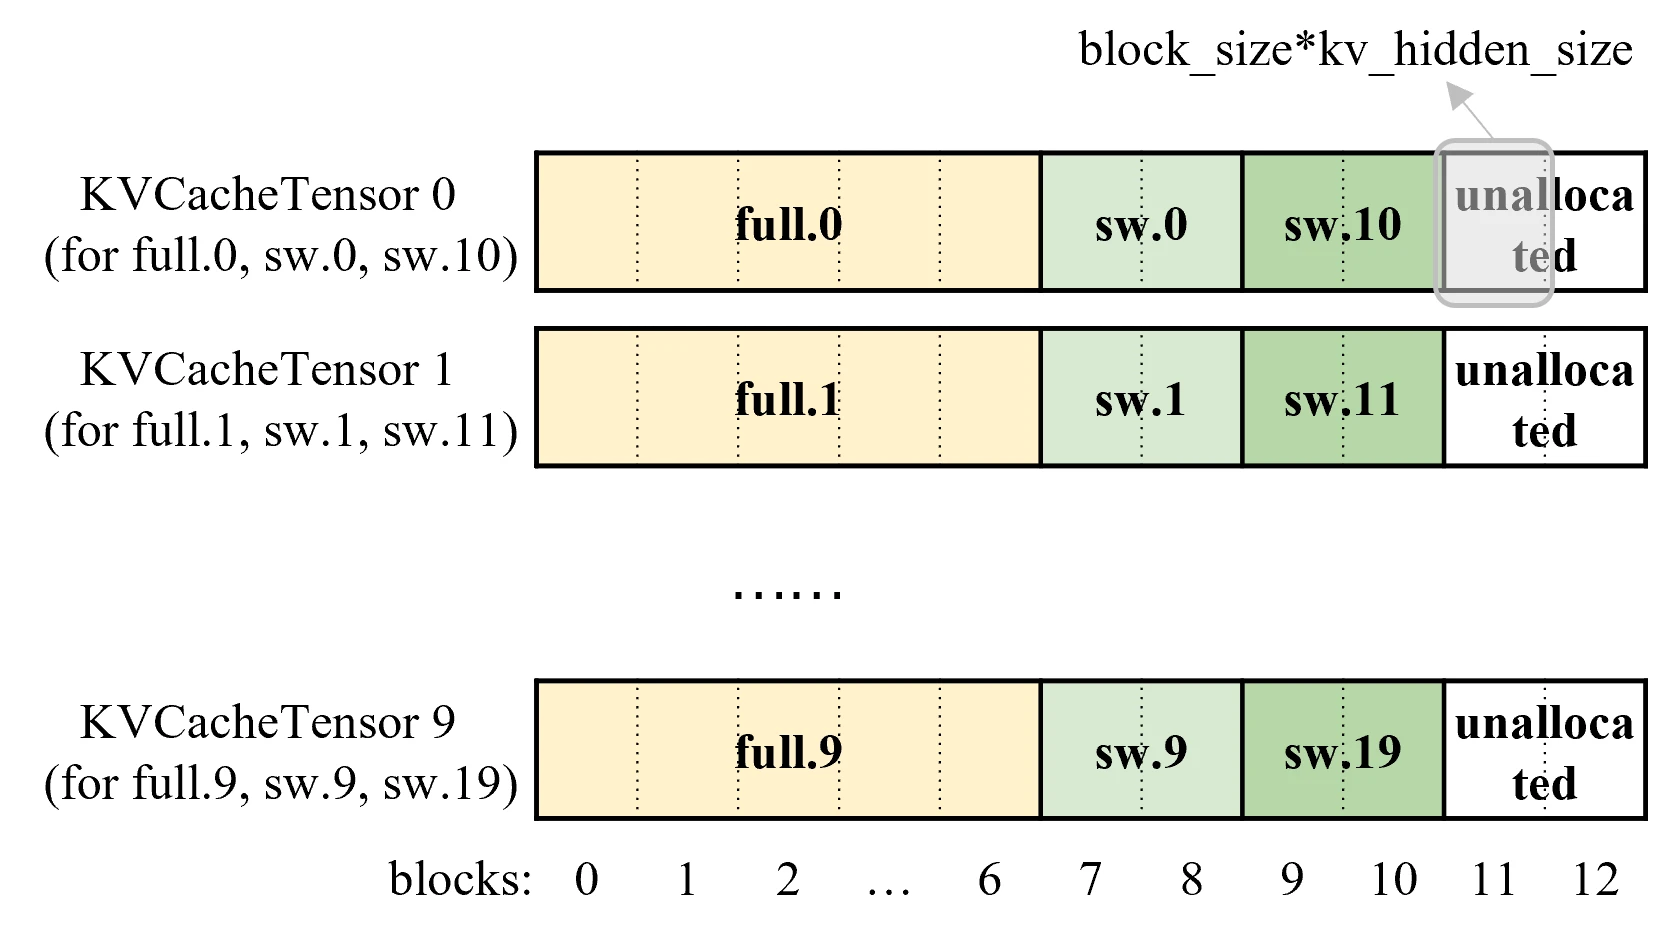
图源:vLLM 官方文档 hybrid KV cache manager 设计文档中的
memory_layout图。图中不同组的张量共享同一个块号空间,物理内存按“最宽组”的页大小对齐,因此块数由max而不是sum决定。
第二层:块数。 用可用字节数去除:
# vllm/v1/core/kv_cache_planning.py(摘自 get_kv_cache_config_from_groups)bytes_per_block = _get_kv_cache_bytes_per_block(kv_cache_groups, layout)num_blocks = available_memory // bytes_per_blocknum_blocks = may_override_num_blocks(vllm_config, num_blocks)size = bytes_per_block * num_blocks这是整数除法,余数被丢弃。丢掉的那部分字节不影响正确性,但会在日志里表现为 num_gpu_blocks * block_size 算出来的 token 数与 Available KV cache memory 不完全对得上(差额就是余数)。
num_gpu_blocks_override 在这一层生效:如果用户给了该参数,may_override_num_blocks 会直接用覆盖值替代除法的结果,显式指定的块数会无视可用字节数。这是为测试抢占而设计的,但也会在某些场景被误用来“强制放大块数”而导致随后的 allocate OOM。
第三层:每块多少 token。 page_size_bytes 由 AttentionSpec 给出:
# vllm/v1/kv_cache_interface.py(摘自 AttentionSpec)@propertydef unpadded_page_size_bytes(self) -> int: return self.num_heads * self.num_states * self.state_content_size_bytes
@propertydef state_content_size_bytes(self) -> int: if self.state_content_bytes is not None: return self.state_content_bytes return (self.head_size + self.head_size_v) * get_dtype_size(self.dtype)对普通的 MHA/GQA 层,num_heads = num_kv_heads,num_states = block_size(每块 token 数),state_content_size_bytes = (head_size + head_size_v) × dtype_size。所以每个 KV 头的每 token 字节是 (head_dim_k + head_dim_v) × dtype_size——对 BF16 的 128 头维模型来说是 (128 + 128) × 2 = 512 字节。乘上 kv 头数与块大小就是一块的字节。对 MLA 层,head_size_v = 0,num_heads 即 latent 头数,state_content_size_bytes 里只算 latent 那一段;对 DeepSeek-V4 的存储压缩格式(tokens_per_state > 1),一个 state 覆盖多个 token,num_states 相应变小。
对单组模型,日志中那句 “GPU KV cache size: N tokens” 的换算就是一个乘法:
混合注意力模型不能直接套这个乘法:一个 token 会同时占用多个组各自的块,池子的“token 容量”要按组账本折算,具体留给混合 KV Cache 组账本处理。
在分布式下把账对齐
上面的算式每一行看起来都只有一个 rank 的数字。但在 TP、PP、DCP、DP 同时存在的部署中,“用哪一份数字算块数”这个问题变得很微妙。
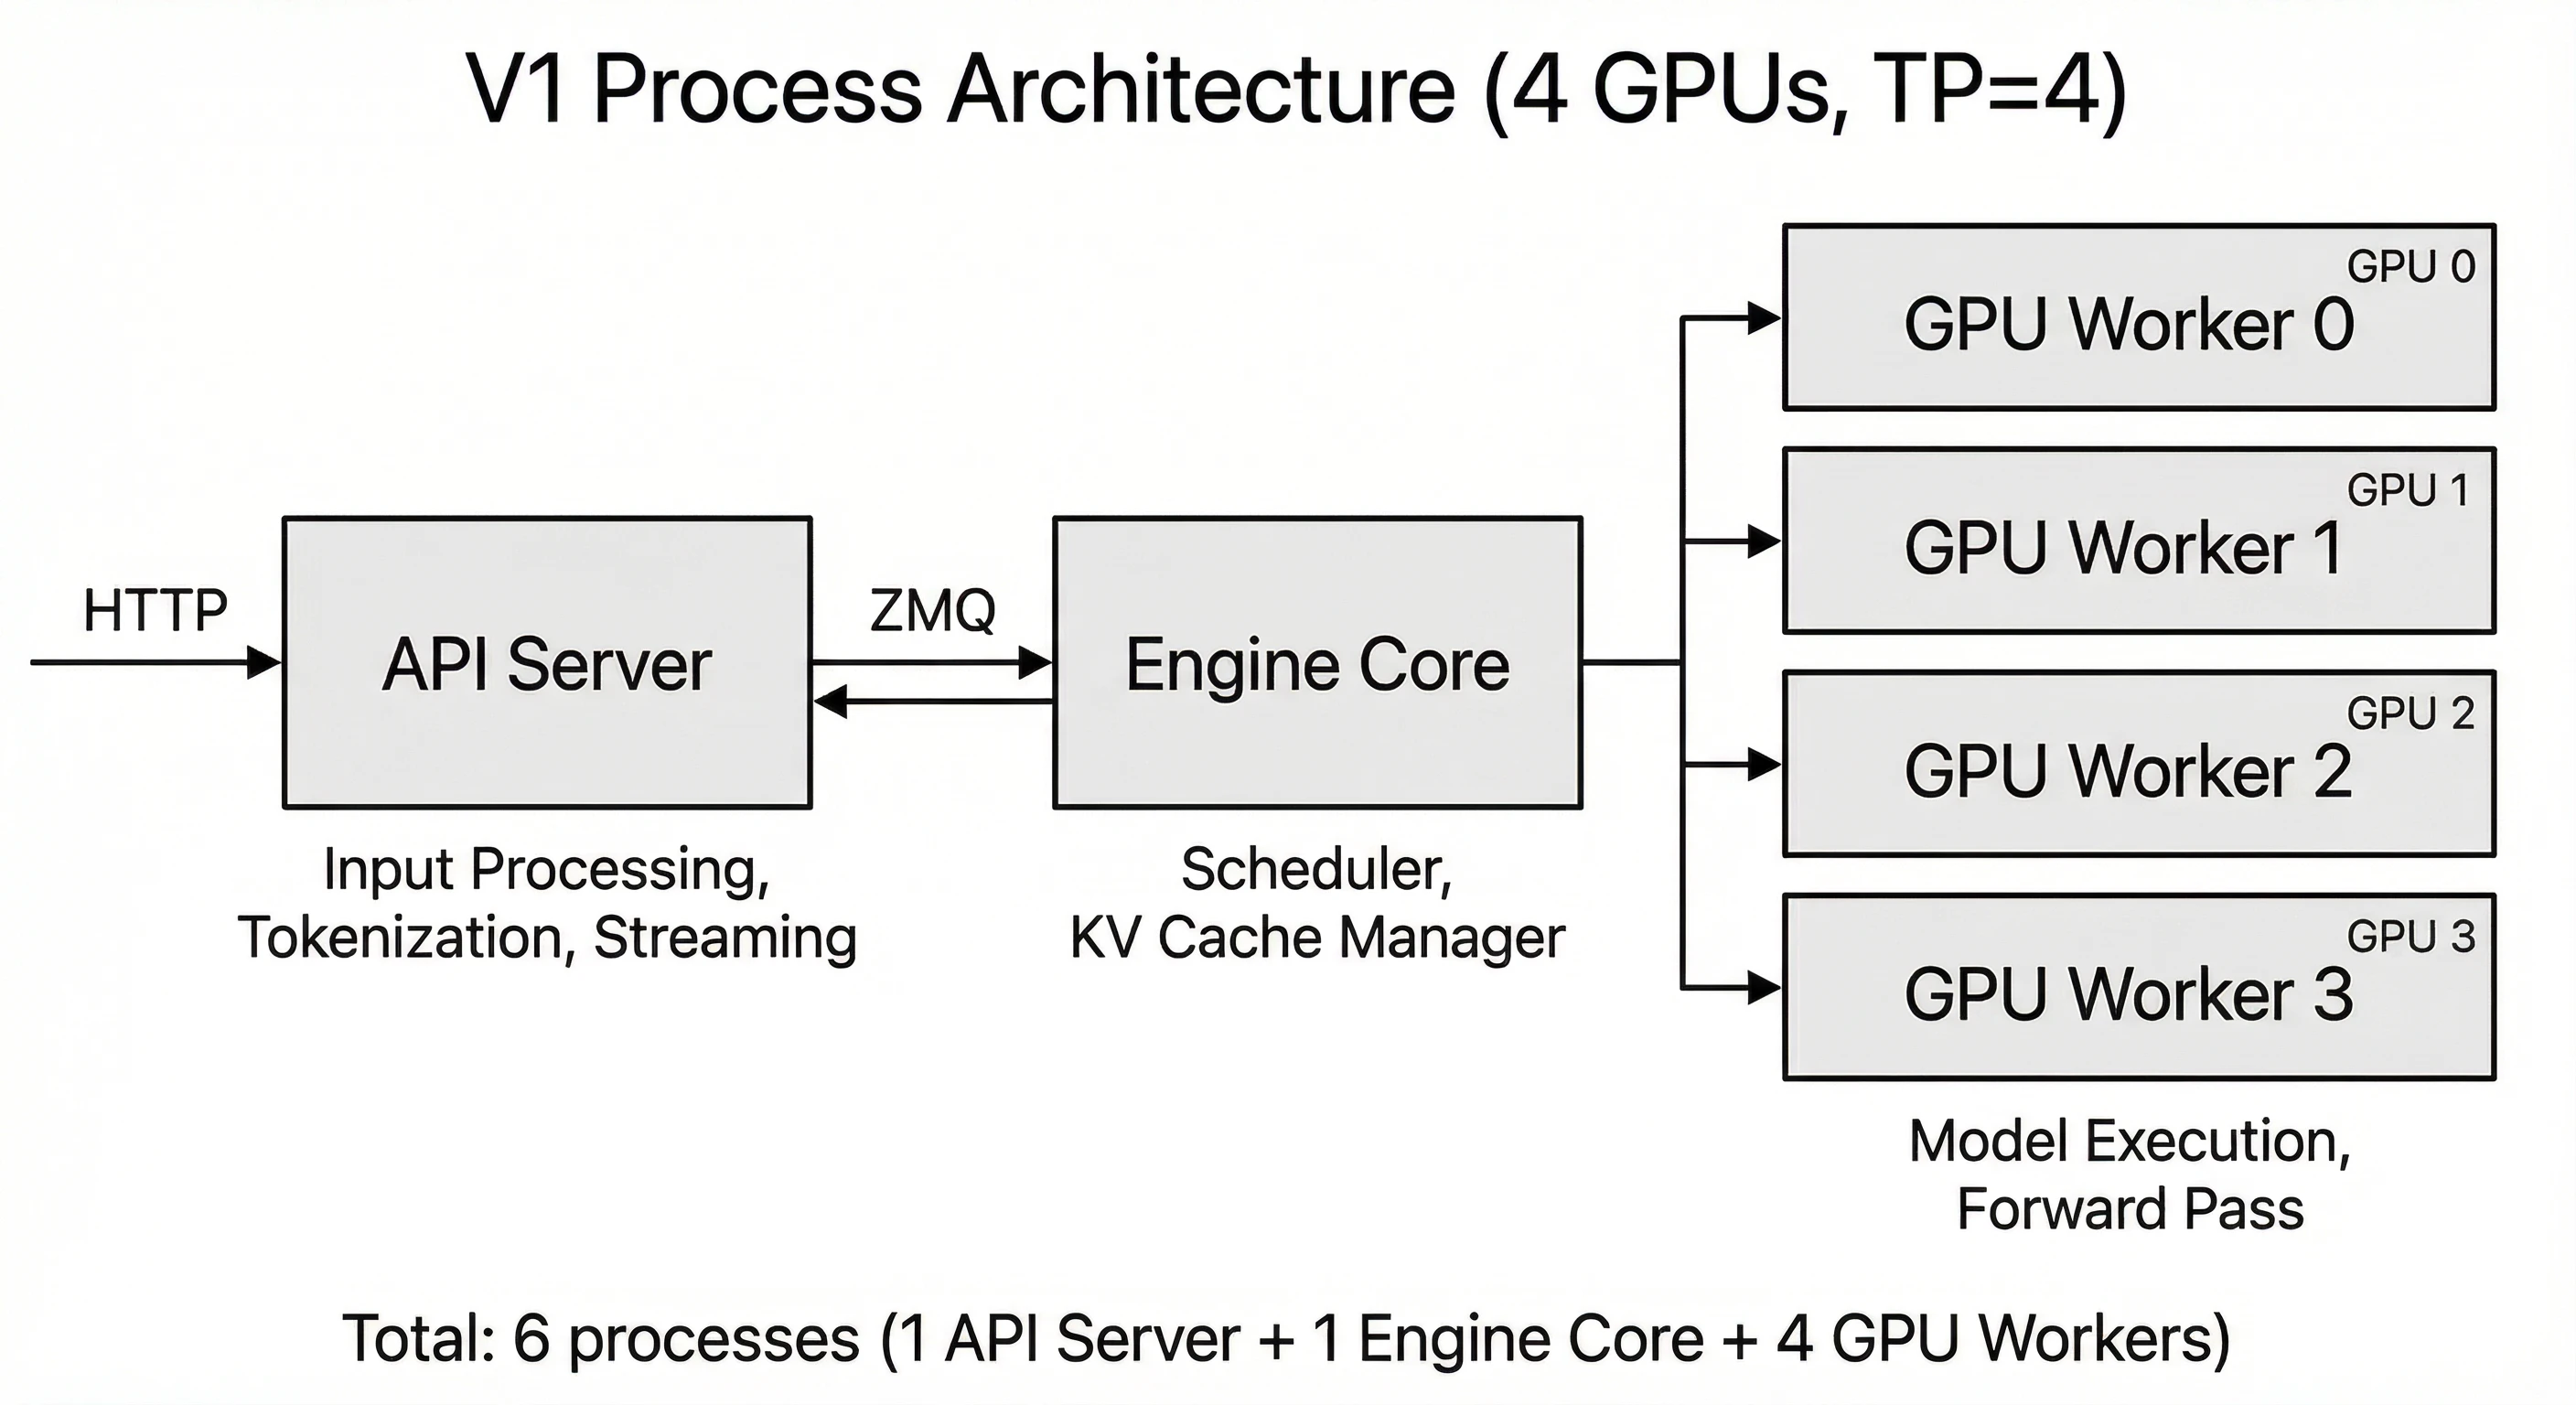
图源:vLLM 官方文档 V1 架构总览中的
v1_process_architecture_tp4图。图中每个 Worker 进程都会独立执行init_device与determine_available_memory,因此每 rank 的可用字节数与块数可能不同,最后才由 EngineCore 统一取最小。
get_kv_cache_configs 的 docstring 把这五步写得很清楚:
1. 合并所有 worker 的 KV cache spec,得到全模型级的 spec2. 按全模型层比例分组(含 hybrid 模型的 spec 统一)3. 自动适配 max_model_len,并按 PP 切片后的每 worker 组做内存检查4. 按每个 worker 的组生成 KVCacheConfig5. 把所有 worker 的 num_blocks 统一为最小值,并按比例收缩张量尺寸其中第 3 步的 auto-fit 与第 5 步的“取最小”是两处最容易出问题的地方。
auto-fit:当用户传入 max_model_len=-1,vLLM 用二分查找找“在可用 KV 显存中装得下多长的上下文”。二分搜索的对象不是“块数”,而是按每个 worker 的 projected_groups 计算的最大模型长度:
# vllm/v1/core/kv_cache_planning.py(摘自 _estimate_max_model_len_from_groups)def fits(model_len: int) -> bool: vllm_config.model_config.max_model_len = model_len ... return _max_memory_usage_bytes_from_groups(...) <= available_memory...left, right = 1, original_maxwhile left <= right: mid = (left + right) // 2 if fits(mid): result = mid; left = mid + 1 else: right = mid - 1_max_memory_usage_bytes_from_groups 对每个组按 spec 计算“在 max_model_len 时该请求需要多少块”,再乘每块字节数并求和。这一步是 auto-fit 的真正核心:它必须与调度器的块表构造使用同一套页大小/块大小,否则二分搜索结果在真实分配时会对不上。源码也把这一约束写在 docstring 里:“同一个页大小/块大小是单点事实源”。
在 PP 下,“投影到 worker”这一步先按 PP 切片出每个 worker 实际拥有的层,再按 worker 组分别计算。auto-fit 取所有 worker 中结果最小的那个——这就是为什么某些 PP 部署下调整 max_model_len 之后表现像“瓶颈在某一级”。
取最小:生成每 worker 的 num_blocks 后,最后一步把全局 min_num_blocks 应用回所有 rank:
# vllm/v1/core/kv_cache_planning.py(摘自 get_kv_cache_configs)min_num_blocks = min( kv_cache_config.num_blocks for kv_cache_config in kv_cache_configs)for i, kv_cache_config in enumerate(kv_cache_configs): if kv_cache_config.num_blocks == min_num_blocks: continue kv_cache_configs[i] = builder.get_kv_cache_config_from_groups( vllm_config, kv_cache_config.kv_cache_groups, min_num_blocks, )为什么要取最小而不是取最大?调度器是集中式的,所有 rank 必须看到同一份块账本;如果某个 rank 多出一些块,调度器分配出去之后,其他 rank 会因为“没有对应物理块”而写入越界。取最小之后多出的显存被显式“浪费掉”——源码注释写的是“shrink tensor sizes proportionally to avoid allocating unused memory”,即用一次重新规划把张量尺寸收缩到真实需要的字节。
为什么每个 rank 测出的可用显存会不同? 常见来源:NCCL 在不同 rank 上的缓冲大小不同(某些拓扑下 ring/tree 的成员不同,缓冲大小不同);CUDA Graph 捕获时的中间激活峰值可能因 rank 角色不同而不同(最后一个 PP rank 有 logits 与采样器,前几个 rank 没有);PP 各分段的层数不同。所以每个 rank 都独立跑一遍 determine_available_memory 与 num_blocks 计算,最后再取最小。
DCP(解码上下文并行) 情况稍特殊。AttentionSpec 有 dcp_sharded 字段,max_num_blocks_per_req 中 DCP 会把位置切分到各个 rank:
kv_shard_count = ( parallel_config.decode_context_parallel_size if self.dcp_sharded else 1)return cdiv(max_len, self.block_size * kv_shard_count)也就是说在 DCP 下,每个 rank 存储的是“位置被切分后的 KV”,每 rank 的块表长度是全局长度的 1/dcp。max_memory_usage_bytes 同样按 DCP 切分 max_model_len 后计算——这就是为什么 FullAttentionSpec 的 max_memory_usage_bytes 里会先做 cdiv(max_model_len, dcp_world_size)。
数据并行(DP) 的语义与 TP/PP 完全不同:每个 DP rank 是一个独立引擎,各有一本账;引擎侧打印的 Available KV cache memory 是每个 DP rank 的数值,而不是总和。因此要得到整台机器的 KV 池总量,必须把每个 DP rank 的数值相加,而不是只看其中一个 rank。
启动日志里的两行字
回到开头引用的两行日志。把前面的账全部对上之后,每行的来源就都能推出来:
INFO Available KV cache memory: 41.73 GiBINFO GPU KV cache size: 261,648 tokens第一行来自 gpu_worker.py 的 logger.info_once("Available KV cache memory: %s GiB", ...),值就是 available_kv_cache_memory_bytes,也就是 。它反映的是本进程预算下、扣除模型固有开销之后剩下多少字节。
第二行由 EngineCore 在拿到 kv_cache_configs 之后计算,本质是“块字节数整数除法之后、再乘以 block_size”;对单组模型,261,648 tokens 可以反推 num_gpu_blocks = cdiv(261648 / block_size);若 block_size=16,就是 16,353 个块。用 41.73 GiB 除以 16,353,得到每块约 2.74 MiB。拿 page_size_bytes 的公式核对:若这是 BF16、head_dim=128 的 GQA 模型,每块字节数对应约 42 个层、8 个 KV 头——16 × 8 × (128 + 128) × 2 × 42 ≈ 2.63 MiB,与上面的 2.74 MiB 同量级;差异来自整数除法丢弃的余数、日志四舍五入以及层数并非整数。反过来,只要知道日志里的块数,也能核对出 num_gpu_blocks × block_size 是否与 token 数一致。
两条日志之间还夹着一条不那么显眼但很有用的信息:
INFO Available KV cache memory: 41.73 GiBINFO GPU KV cache size: 261,648 tokensINFO Requested to load Fp8Config, loading 1 adapters.INFO KV cache 41.73 GiB -> 261648 tokens (per GPU).如果这一行里出现 per GPU,就是提醒:这是单个 rank 的数值,不是整机房。在 --tensor-parallel-size 8 的节点上,整节点的 KV 池是“每 rank 字节 × 8”,但“token 数”并不乘 8——因为 TP 下每 rank 只存 1/8 的 kv 头,8 个 rank 合起来放的是同一批 token。这一点常常把“显存总量”与“可承载 token”之间的关系搞混。
三档显存占用:什么数对应什么问题
前面所有推导都可以归纳进这张表,用来诊断 “KV 太少”“OOM 了却还有剩余”“调高利用率没用” 三类问题:
| 档位 | 对应变量 | 来源 | 主要影响因素 |
|---|---|---|---|
| 权重 | model_memory_usage | 装载路径 | 模型大小;量化、TP 切分会降低它 |
| 非 KV 常驻 + 峰值余量 | C_total + H | profiling 期间的物理空闲差值 | 更大的 max_num_batched_tokens/max_num_seqs、更大的 MoE 结构 |
| CUDA Graph | cudagraph_memory_estimate_applied | 最小池下真实 capture | 缩小:减少捕获桶、降低 max_cudagraph_capture_size |
| KV 池本身 | num_blocks × bytes_per_block | 三档减法后剩余 | 提高 gpu_memory_utilization;用 FP8 KV 或压缩表示可减小每块字节数 |
三类典型问题的定位路径:
- “调高利用率,KV 只多了几 GiB” —— 多出来的部分按利用率换算过来是
ΔR = T × Δu,但C_total + H + G与 无关。所以多出的字节会全部进入 。如果这个增量远小于T × Δu,通常说明同一张卡上还有别的进程在争用显存,或者该版本里还有其他随预算增长的常驻缓冲(例如某些后端会按显存预算预留对称通信缓冲)。排查时以init_snapshot里的free_memory与non_torch_memory为准,而不是只看total_memory。 - “KV 池只装得下几万 token,模型上下文明明是 128K” ——
max_model_len=-1的 auto-fit 会主动把长度缩到“内存装得下”的值,日志里会有一行Auto-fit max_model_len: reduced from ... to ...。若 auto-fit 日志显示full model context length ... fits,但之后请求仍然因“需要 N GiB KV”而失败,就是单条请求的最大占用超过了池子:池子由并发请求共享,但单条请求在max_model_len下的最大占用必须先装得下,否则连一条都跑不起来——此时需要更多显存,或在表示上压缩 KV(FP8、V4 的压缩表示等)。 - “日志显示还有空闲显存,但启动失败” —— 大概率是
init_snapshot.free_memory < requested_memory这一条预算检查,或者在 ROCm 上跑到了 profiling 回退路径(maybe_rocm_profiling_fallback):如果测量到的total_consumed为负——也就是 GPU 空闲显存在 profiling 期间反而变多了,通常是别的进程释放了显存——vLLM 会改用“torch 预留增量”作为下限,并打印一行Free memory grew by ... during profiling的 warning。前者把gpu_memory_utilization降下来;后者按 warning 里的换算口径核对。
为什么“测”而不是“算”
回到方法层面,vLLM 的这一套账还有一个值得单独展开的选择:为什么不直接用“参数量 × 字节数 + 假设的激活峰值”去推导,而是要跑一次哑跑?
答案在于“模型固有开销”这一项在真实部署中不是一个可算的数。MoE 的 workspace 大小取决于路由后的 token 分布与融合 kernel 的具体实现;注意力 backend 的私有缓冲(例如 FlashInfer 的 page layout 缓冲、Triton attention 的 segm scratch)取决于 backend 选型;采样器的 rejection sampler 缓冲取决于投机解码形态;NCCL 缓冲区取决于拓扑与算法。这些都属于“代码实现细节”,任何静态公式都会随版本而变化。
而“跑一次再测”的代价是几秒的启动时间,以及前面提到的两条副作用保护(cuBLAS 预热与 split 尺寸限制)。对一个需要长期在线、频繁重启的推理服务来说,这几秒远比“上线后第五分钟因为某个缓冲没算进去而 OOM”便宜。
这也解释了为什么 profile_run 需要真实地跑一次而不是“仅物化一下内存”。只有跑过,allocator 里面才会有这个 buffer 的真实尺寸;只有跑过,某些 backend 的懒加载缓冲才会出现。initialize_from_config 里的 kernel_warmup 与 capture_model 则是对“未在 profile 阶段出现”的部分再做一次兜底——initialize_from_config 中的那段 redundancy_buffer_memory = 150 MiB 就是为了“profile 低估了一点点”的经验性修正。
顺带一提 --kv-cache-memory 这条路:因为 profile 会跑一次,所以“即使跳过内存测量也仍然执行 profile_run” 是有意的——profile_run 同时负责编译(max_num_batched_tokens 触发 Dynamo 编译的动态形状)。把“测内存”和“编译”两件事合并在同一个函数里,是一个小而实用的取舍。
小结
vLLM 启动时的显存账本可以分成三档:
- 基线:
init_snapshot在模型加载前采集一次,加上提前跑 cuBLAS 的预热,把 NCCL、cuBLAS handle 等 torch 账外占用固化到基线里。 - 峰值:
profile_run用max_num_batched_tokens个 token 的 dummy 前向,在memory_profiling上下文里测出total_consumed + transient_peak_headroom;CUDA Graph 的预留由profile_cudagraph_memory在最小 KV 缓存图下 capture 实测。 - 除法:用
requested_memory - (非 KV 显存) - (CUDA Graph)除以“每块字节数”,得到num_blocks,再逐层换算成 token 数。
围绕这条主路径,有三处工程保护:cuBLAS 预热、max_split_size_mb=20 的碎片保护、150 MiB 冗余缓冲。分布式下还有三处对齐:PP 下取全局最小块数、DCP 下按 shard 数切分块表、DP 下每 rank 独立一本账。
读完之后,那两行日志里的每个数字都可以反推:Available KV cache memory 是预算减去固有开销,GPU KV cache size 是每块字节数的除法。当出现 “KV 池不够”“预算内还有剩余却 OOM”“调高利用率没效果” 时,也就能立刻定位到三档里的哪一档。
顺着这本账本,还有一项最难量化的部分可以继续展开:MoE workspace 的大小与增长曲线,以及它在不同融合 kernel 下的真实开销。
参考资料
- vLLM 源码:
vllm/v1/worker/gpu_worker.py - vLLM 源码:
vllm/utils/mem_utils.py - vLLM 源码:
vllm/v1/worker/utils.py - vLLM 源码:
vllm/v1/worker/gpu_model_runner.py - vLLM 源码:
vllm/v1/core/kv_cache_planning.py - vLLM 源码:
vllm/v1/kv_cache_interface.py - vLLM 源码:
vllm/config/cache.py - vLLM 源码:
vllm/v1/engine/core.py - vLLM 文档:Conserving Memory
- vLLM V1: A Major Upgrade to vLLM’s Core Architecture
- vLLM 设计文档:Hybrid KV Cache Manager
- PyTorch 文档:CUDA memory management
- CUDA 文档:cuMemGetInfo
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



