


Mamba 状态空间模型推理完全拆解:没有 KV Cache 的模型,服务系统要替它重新记一本账
从一个被反复引用的数字说起
Transformer 解码时,每生成一个 token 都要把历史全部重新”看”一遍。为了让这件事不至于太贵,所有推理框架都在做同一件事:把历史 token 的键值算一次、存下来、之后反复读。这份存储在显存里的东西就是 KV Cache。代价也是明摆着的——上下文越长,它越大;并发越多,它翻倍得越快;到某个点上,一张卡的显存装不下几个请求,吞吐就被显存而不是算力卡住了。
PagedAttention 把 KV Cache 切成页、按需分配;GQA 让多个查询头共享一组键值;MLA 把 KV 压成一个低秩潜向量;DeepSeek-V4 的混合注意力 把大部分层换成更省的注意力形态。这些工作有一个共同前提:历史必须以某种形式留在显存里,哪怕被压缩得只剩几百字节每 token。
Mamba 走的是另一条路。它在解码时不保存历史,只维护一个固定大小的状态,每来一个 token,就用新输入把状态推进一格。序列长度从一千涨到一百万,显存占用一点都不变。2023 年 12 月,Albert Gu 与 Tri Dao 发表 Mamba: Linear-Time Sequence Modeling with Selective State Spaces,把这一家族推到接近同规模 Transformer 的语言建模水平;2024 年 5 月,两人又发表 Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality,简称 Mamba-2,用矩阵分解的语言把状态空间模型和注意力联系起来。
从”省显存”这个角度看,这几乎是一劳永逸的解法。但真正把它放进生产系统时,会遇到另一类麻烦:状态是逐 token 递推的,请求之间无法天然地拼成一个批;长度不一的请求在同一个批里如何同步;状态存在哪里、怎么在前缀命中和抢占之后恢复;预填充阶段那套矩阵算法怎么和分块调度对上。这些问题不在论文正文里,而在推理框架的源码里,也在 vLLM 这类系统的块管理器设计文档里。
这篇文章按照”模型在算什么 → 解码为什么快 → 预填充怎么并行 → 服务系统要重做哪些账 → 还有哪些代价”的顺序来讲,尽量把每一步的动机和数字都说清楚。
序列模型的两难:卷积、递归与注意力的三角关系
要理解 Mamba 的选择,先要看清序列建模三种基本形态之间的取舍。
卷积是对历史做加权求和,权重由核决定,与当前位置无关:
核长 固定,所以每步只看最近 个 token。它在时间维度上可以并行(一次算完整个序列的所有输出),但无法记住比 更远的东西,而且权重是时间不变的——同一个模式在序列开头和结尾被同样对待。
递归(循环神经网络)维护一个隐状态 ,每步更新:
理论上状态可以无限累积历史,但传统 RNN 的连接矩阵是时间不变的,训练时又难以并行(必须按时间步展开),梯度长期传播能力有限。
注意力不做压缩,每个位置直接与所有历史交互:
它没有长程遗忘问题,训练完全并行,代价是与序列长度的平方关系和解码时对全部 KV 的重复读取。
Mamba 的出发点是一个很朴素的观察:这三种结构不是彼此排斥的,而是同一个”状态转移”体系在不同参数化下的特例。如果能让状态转移矩阵随输入变化(data-dependent),递归就能根据当前内容选择记住什么、忘掉什么,从而兼具注意力的选择性和递归的线性复杂度。难的是:一旦状态转移与输入相关,原来那套用卷积核并行计算整个序列的方法就失效了——因为每一步的有效权重都不同了。Mamba 的全部工程价值,就在于把”输入相关”这个能力重新变得可并行。
从 S4 到 Mamba:选择性从哪里来
SSM 的标准形式
连续时间状态空间模型写成一对微分方程:
是隐状态, 描述状态如何自我衰减或混合, 描述输入如何进入状态, 描述状态如何读出。把序列当作对连续信号的采样,用零阶保持(ZOH)离散化,得到递推形式:
其中 、, 是采样步长。对角 时两个式子都是逐元素计算: 就是一个标量指数, 也按同一方式逐元素展开。
S4 系列模型的矩阵 都是时间不变的:与输入无关。这带来一个极好的性质——把上式展开,可以写成
即整个序列的处理等价于与一个长度为 的卷积核做卷积。卷积核可以预先算好,然后用 FFT 或线性递归方式 O(T log T) 地一次性处理整段序列,训练完全并行。
代价是同样的时间不变性带来的问题:模型对每个 token 的处理方式相同,无法根据内容决定是否忽略一个输入(离散模态如文本不像连续信号那样平滑,选择性极重要),也无法在需要时保持状态不变。论文用一个合成任务说明了这一点:标准复制任务里输入与输出间隔固定,时间不变的模型可以靠卷积核”数间隔”完成;而”选择性复制”任务里间隔是随机指定的,只有能读懂内容、按内容决定写入哪些位置和何时读出状态的模型才能完成。时间不变的 S4 在这种任务上失败,选择性模型能做到接近 100%,而 S4 只有 18% 左右(论文图 4 的选择性复制实验结果)。
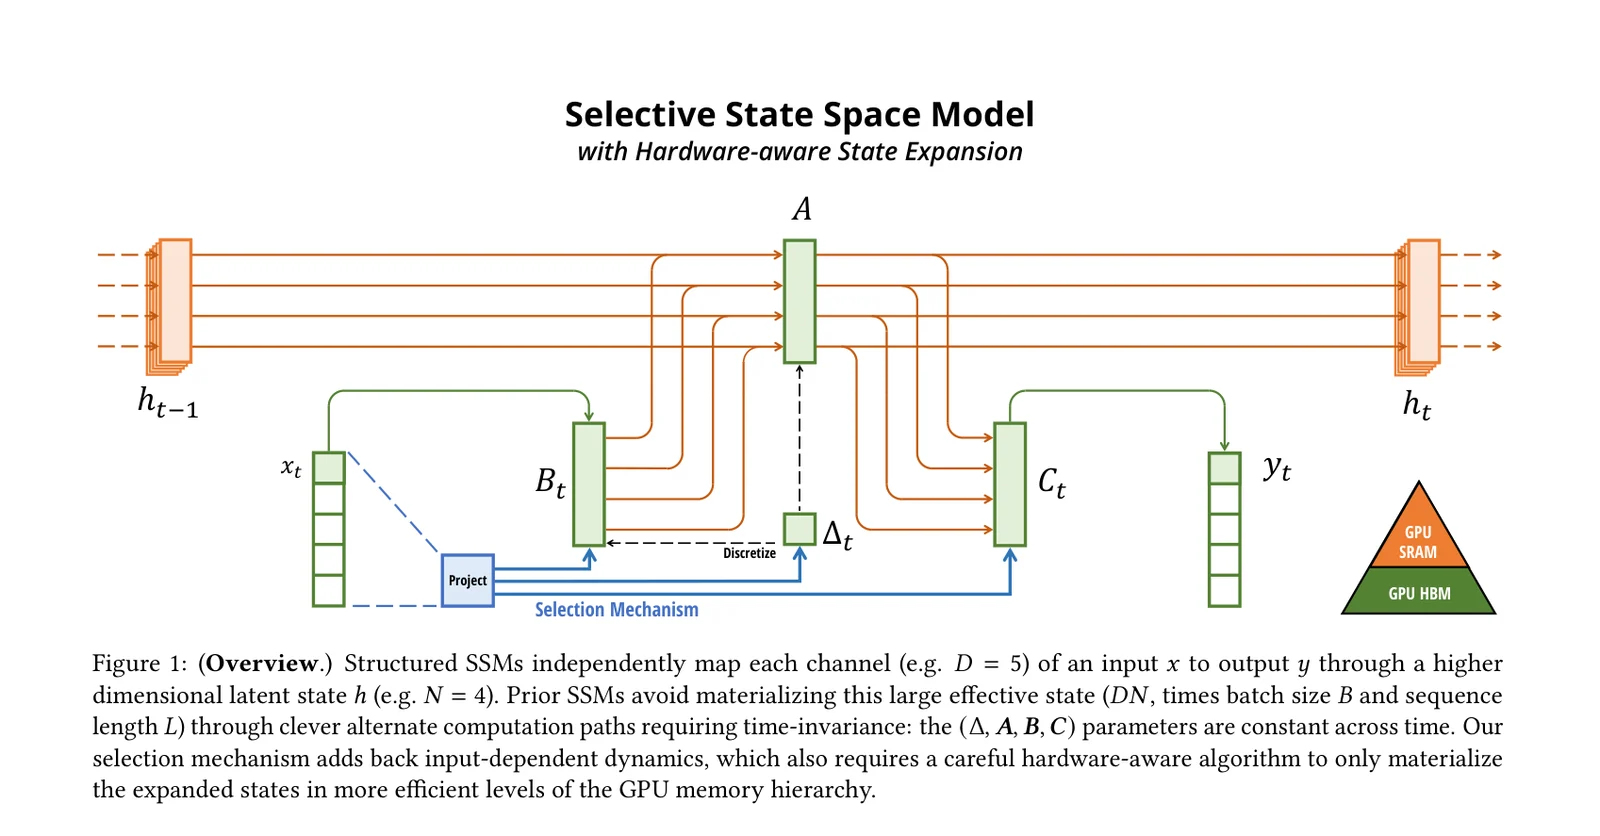
下图(Mamba 论文图 1)是标准 SSM 的结构:每个通道独立地经过一个更高维的隐状态,状态维度为 、通道数为 ,所以有效状态大小是 。Mamba 论文特意指出:此前的 SSM 之所以能绕开”显式展开这个 大小的状态”,靠的正是时间不变性——同一套卷积核可以在序列维上并行计算,从不需要把每个位置的中间状态写回显存。一旦状态转移随输入变化,这条路被封死,就必须面对”每层、每通道、每状态维都要逐 token 推进”的现实。这也解释了下面为什么需要一套专门的硬件友好算法。
选择性:让参数随输入变化
Mamba 做了三件事:
第一,把 都变成输入的函数。输入先经过投影得到每个 token 专属的 和步长 。 决定当前内容向状态里写什么, 决定从状态中读什么, 决定写入强度和忘记程度—— 大时状态更多地被当前输入覆盖(类似”重视这个输入”), 很小时状态几乎不变(类似”忽略这个输入”)。这正是”选择性”的具体含义。
第二,把 简化为对角矩阵,并用一个标量先验 参数化。对角 意味着各维度独立演化, 可以逐元素计算,硬件上容易做。 的取值决定了每个状态维的衰减时间常数——负得越多,记忆越短。这条线索在数学上就是矩阵的谱,站内 特征值与特征向量 一文里对”特征值刻画长期行为”有更一般的讨论。
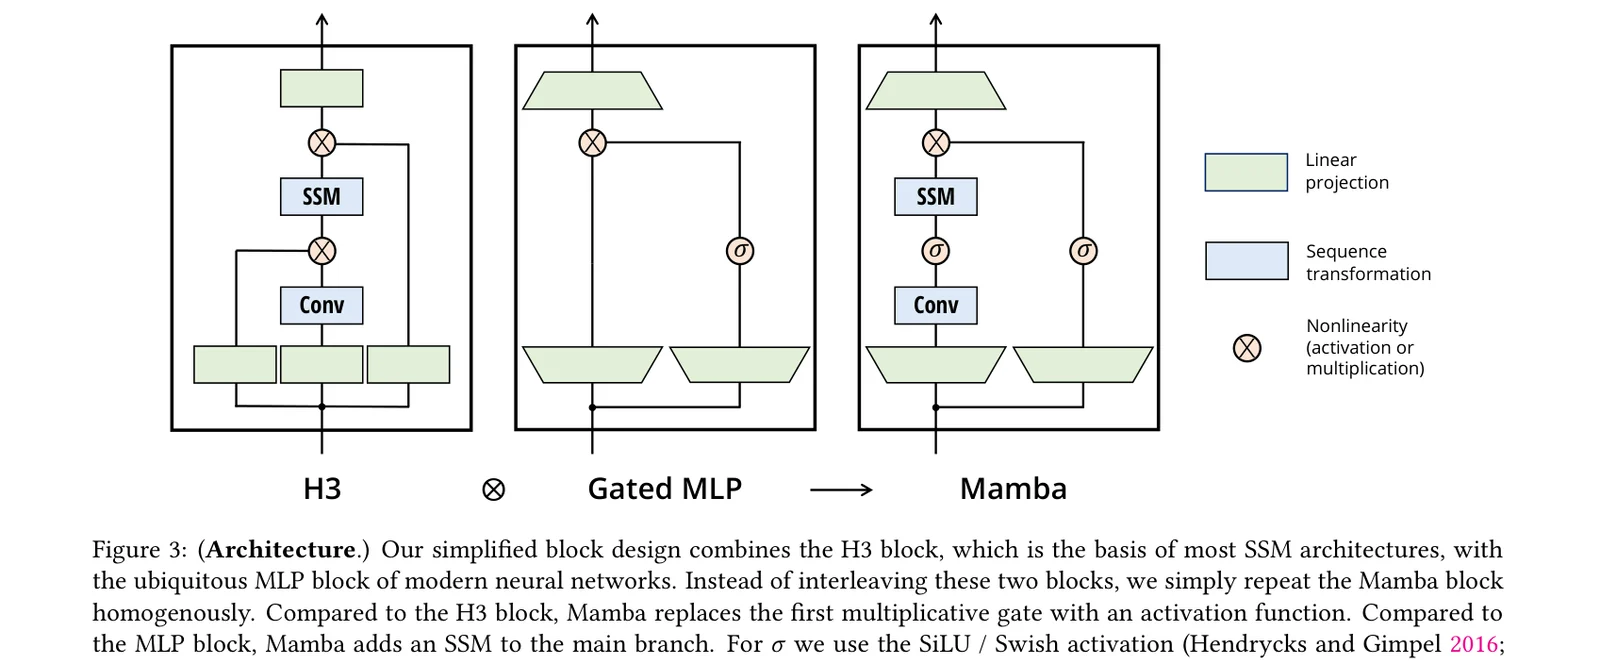
第三,在 SSM 层前加一个一维因果卷积(conv1d)和 SiLU 激活,让局部信息先混合,再由 SSM 做长程处理。这一层很关键: 的投影只看当前 token,如果没有任何局部上下文,模型只能靠单点信息决定取舍。卷积给它一个几 token 的窗口。
下图是 Mamba 块的整体结构:输入先分成两路,一路依次经过输入投影、conv1d、SiLU、SSM 与门控 ,另一路经过线性投影作为门,两路相乘后输出。门控乘法和 Transformer 的 FFN 很像,是让模型可以在逐元素层面控制信息流动。
Δ 为什么是”门”:三个参数各自的角色
把选择性 SSM 和门控 RNN 放在一起看, 的作用最清楚。对单个通道,离散递推是
当 (Mamba 用 保证这一点)时,。于是 同时控制两件事:保留多少旧状态和写入多少新输入。 时,、第二项也趋近 0,状态原封不动,模型相当于忽略当前 token; 很大时,旧状态被迅速衰减,新输入几乎覆盖状态。这正是 LSTM 遗忘门与输入门的合并版,但门值不是由另一组参数独立算出来的,而是由同一套连续时间动力学中的步长给出。
这也解释了参数化上的几个细节。Mamba 不直接学 ,而是学 再取负指数:这样 永远在负实轴上,状态不会指数爆炸。 先通过一个低秩投影(论文默认秩为 1,即每个头一个标量,再广播到通道),再经过 softplus 保证为正,最后加上一个可学习的偏置——偏置的初始化决定了训练初期模型偏向”记住”还是”忘记”。这些细节看起来琐碎,却直接决定了长序列训练能否稳定。
与 则分别负责”写什么”和”读什么”。它们由输入投影得到,因此每个 token 都有一组专属的写入、读出权重。把三者放在一起,选择性 SSM 的一层其实在做:根据当前内容算出写入门、读出向量和遗忘速度,然后在一个固定大小的记忆上做一次读-改-写。这个”记忆”就是后来推理系统要管理的状态。
并行扫描:把随输入变化的递推重新变成可并行运算
选择性的引入,把上面那个”卷积核”方法废掉了: 都随 变化,卷积核不再固定。Mamba 的做法是回到线性递推本身,但用并行扫描(parallel scan)算法在 GPU 上算。
线性递推 有一个结合律结构:两个递推段可以合并为一段。把每段表示为三元组 ,合并规则是
并行扫描在 层里把整个序列的递推”折叠”成一次前缀运算。每一层的运算都是逐元素乘加,可以映射到 GPU 的 warp shuffle 和共享内存。
这里有一个容易被忽略的账:扫描的运算量随序列长度线性增长,但它的算术强度很低——每个元素只做一次乘加,却要从 HBM(高带宽显存)里读入、写回,再读回来做下一轮。GPU 的算力远大于带宽,于是这类逐元素内核几乎一定跑在带宽上限附近。Mamba 论文的处理方式是把整个 selective scan 融进一个 GPU 内核,并在反向传播时用重计算代替存储中间状态,使这个融合层的显存需求与使用了 FlashAttention 的 Transformer 相当。论文报告,相比标准的 PyTorch 逐点实现,融进内核后的扫描训练时快约 40 倍(图 8 左侧)——这个倍数主要是省下中间状态读写带来的,而不是算得更少。
对推理来说,这个细节的意义在于:预填充阶段如果仍然用扫描,瓶颈会是带宽而不是算力。Mamba-2 换成矩阵乘的动机正来自此。
解码时只需要算一步,扫描退化为单步递推,简单到几乎可以忽略开销。这一点正是推理路线成立的基础。
解码:一个 token 的增量账
解码时的计算量
设模型为单层、通道数 、状态维 、扩张因子 ,则内部维度 。每个 token 解码时的主要运算:
- 输入投影:,共 量级的乘加( 是一个标量投影);
- conv1d:核长 的卷积,;
- 扫描: 的逐元素计算与状态更新 ,约 ;
- 读出:,;
- 门控乘法与输出投影:。
这里的量级说明两件事。第一,主体是矩阵-向量乘法(逐个 token 的投影)和逐元素运算,没有与序列长度相关的项。第二,状态更新部分的运算量与 成正比,而 通常取 16 左右:Mamba 论文的默认配置是 、、,每层状态大小约为 字节(假设 FP16 存储 与 各占 ),每层约 128 KB。论文 350M 档配置是 24 层、、、,于是单序列全部层的状态合计约 。对比 KV Cache:同规模 Transformer 每层每 token 存 K、V 各 个元素,FP16 即每层 4 KB、每 token 全部 24 层约 98 KB;8K 上下文约 800 MB,128K 上下文约 12.6 GB。Mamba 的 3.1 MB 与序列长度无关。
这张账里最值得记住的一点是:Mamba 的状态大小与上下文长度无关。128K 和 8K 的请求占显存完全一样;而 Transformer 的 KV 项会随长度线性膨胀,1024 个并发请求各带 128K 上下文时,KV 的体量已经不是单卡能装下的量级。
为什么 Transformer 的吞吐在长上下文下会掉,而 Mamba 不会
Transformer 解码的每个 token 要读全部 KV:设层数 、每 token KV 字节数为 、上下文长为 ,则每步读取量为 。显存带宽固定时,阅读时间与 成正比,于是解码速度与上下文长度成反比。这是”解码是内存带宽受限”的直接体现。
Mamba 解码每步只读状态(大小恒定)、权重(大小恒定)和当前输入。总读取量与 无关,所以解码速度基本不随上下文增长变化。论文的效率测试显示,Mamba 的解码吞吐能达到同规模 Transformer 的 4 到 5 倍,原因不是单个请求算得更快,而是没有 KV Cache 之后,同样的显存可以装下大得多的批。论文甚至给出一个有些反直觉的例子:未训练的 6.9B Mamba,推理吞吐高于比它小 5 倍的 1.3B Transformer(Mamba 论文图 8 右侧与 E.5 节)。
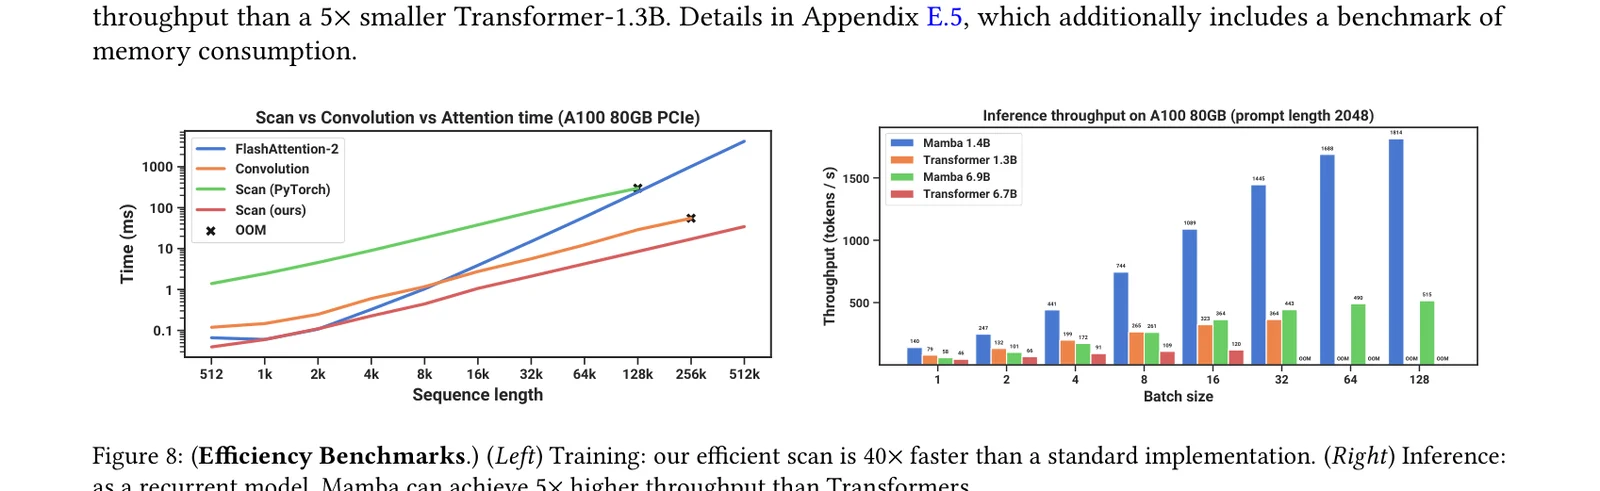
这里的数字需要谨慎引用:它是同一规模下的对比,受权重、精度、批量、序列长度等条件影响,不能外推为”所有情况下都快 4 到 5 倍”。但方向的结论是清晰的:Mamba 把解码从”读历史”变成”读状态”,读取量与长度解耦。
预填充:为什么训练里的算法不能直接拿来服务
服务系统里,真正让工程师头疼的是预填充。解码的增量计算简单,但用户发来 10K token 的提示时,初始状态必须从零开始一步步推进吗?如果每层都要串行走 10K 步,预填充会慢到不可接受。
训练时为什么能并行
Mamba 在训练时处理整段序列,依赖两条:
- 并行扫描把层层递推折叠为 轮逐元素运算;
- 由于扫描可以在芯片上按块进行, 的总运算量里大部分是逐元素操作,在 GPU 上是”足够快”的。
但服务系统的预填充和训练不同:提示长度差异极大,批量里每个请求长度不同;显存和片上存储有限,分块调度要随时切换;而扫描对每个请求都要在序列维上做归约,这会与动态批处理、chunked prefill、跨请求拼接产生复杂交互。
Mamba-2 的 SSD:把 SSM 写成矩阵运算
Mamba-2 的思路是换一个视角。前面说过 SSM 可以写成与一个”半可分矩阵”相乘:
当 是对角矩阵时,乘积 可以分解为每个维度的标量连乘,于是 有一个特殊结构:半可分(semiseparable)。矩阵的任意 位置的值可以写成低秩分解形式,整块子矩阵的秩不超过状态维 。这正是它与注意力的桥梁:注意力矩阵也是低秩的(秩不超过头维 ),只不过 是带因果掩码的、并且”掩码”本身是被 参数化的指数衰减。
Mamba-2 的核心结论是:当 为标量时,SSM 的序列变换矩阵 可以表示为
其中 由 与 的幂次构造, 是一个由 决定的掩码矩阵(当 时退化为标准的因果掩码)。也就是说,SSM 可以看作一种”结构化掩码的注意力”:数据结构与注意力相同,只是掩码由状态衰减决定,且不使用 softmax。论文把这个视角命名为结构化状态空间对偶(Structured State Space Duality, SSD)。
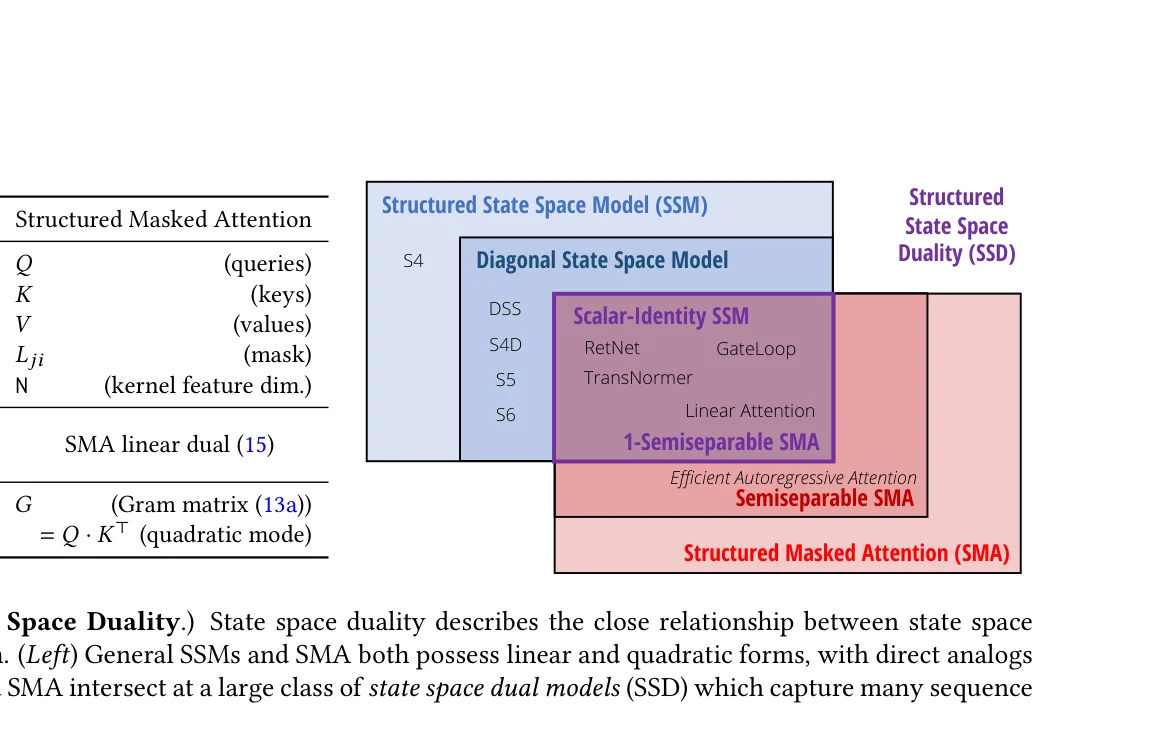
这个视角的价值在于:同一层的前向可以有两种算法。序列很长时用线性递推(状态视角,每步 每通道);序列较短或在预填充的分块内时,用分块矩阵乘法(二次视角中的对角块),交给 Tensor Core。
这个对偶不是数学上的巧合,它带来三个可操作的结论。
第一,SSM 可以继承注意力的工程生态。既然 与注意力矩阵同构,那么张量并行、序列并行、FlashAttention 式的分块与重计算、甚至用于注意力的编译器优化,都可以平移过来。Mamba-2 论文明确把”利用 Transformer 系统优化的积累”列为 SSD 的动机之一。
第二,状态维可以被放大。Mamba-1 的 只有 16,原因之一是纯扫描实现里状态扩大会线性拖慢速度;SSD 用矩阵乘处理块内, 从 16 提到 64 甚至 128,速度只轻微下降。论文的效率测试给出了量级:对 的大状态,SSD 比 Mamba 的融合扫描快 2 到 8 倍;在序列长度 2K 附近与 FlashAttention-2 持平,16K 时约快 6 倍。这组数字说明 Mamba-2 的主要收益不是”模型更聪明”,而是”同样的状态规模终于能跑得动了”。
第三,“注意力”与”SSM”的边界变成了掩码的选择。标准注意力使用全 1 的下三角掩码;SSM 使用由 生成的衰减掩码。两者都可以写成”低秩矩阵乘 + 掩码”,区别只在于掩码是否随输入变化、是否需要 softmax 归一化。这个统一视角让混合层不再是”两套完全不同的算子拼接”,而是同一算子在掩码与归一化上的不同参数化——这也是后面混合模型能够共用部分基础设施的前提。
分块算法怎么算
Mamba-2 的分块算法把序列切成大小为 的块。对每个块 ,做四步:
- 状态读取:用块内所有位置的 与块起始状态 相乘,得到”从历史带来的部分”;
- 块内对角:块内各位置之间的影响,用块内矩阵乘法 计算——这就是”掩码注意力”,可以走 Tensor Core 的 GEMM;
- 块内累加:第 1、2 步的结果相加得到该块输出;
- 状态写出:用块内所有位置的 与输入,更新出块结束状态 ,供下一块使用。
块内是矩阵-矩阵乘(高吞吐),跨块是”块与状态”的矩阵乘(代价随块数线性增长)。因此,整个预填充的运算量约为 :第一项来自块内矩阵乘,块数 乘每块 ;第二项来自跨块状态传递。对固定的块大小 ,两项都对 线性;同时块内运算落在 GEMM 上,利用率比纯逐元素的扫描高很多。上面这张 Mamba-2 论文图 5 就是这个分块结构。
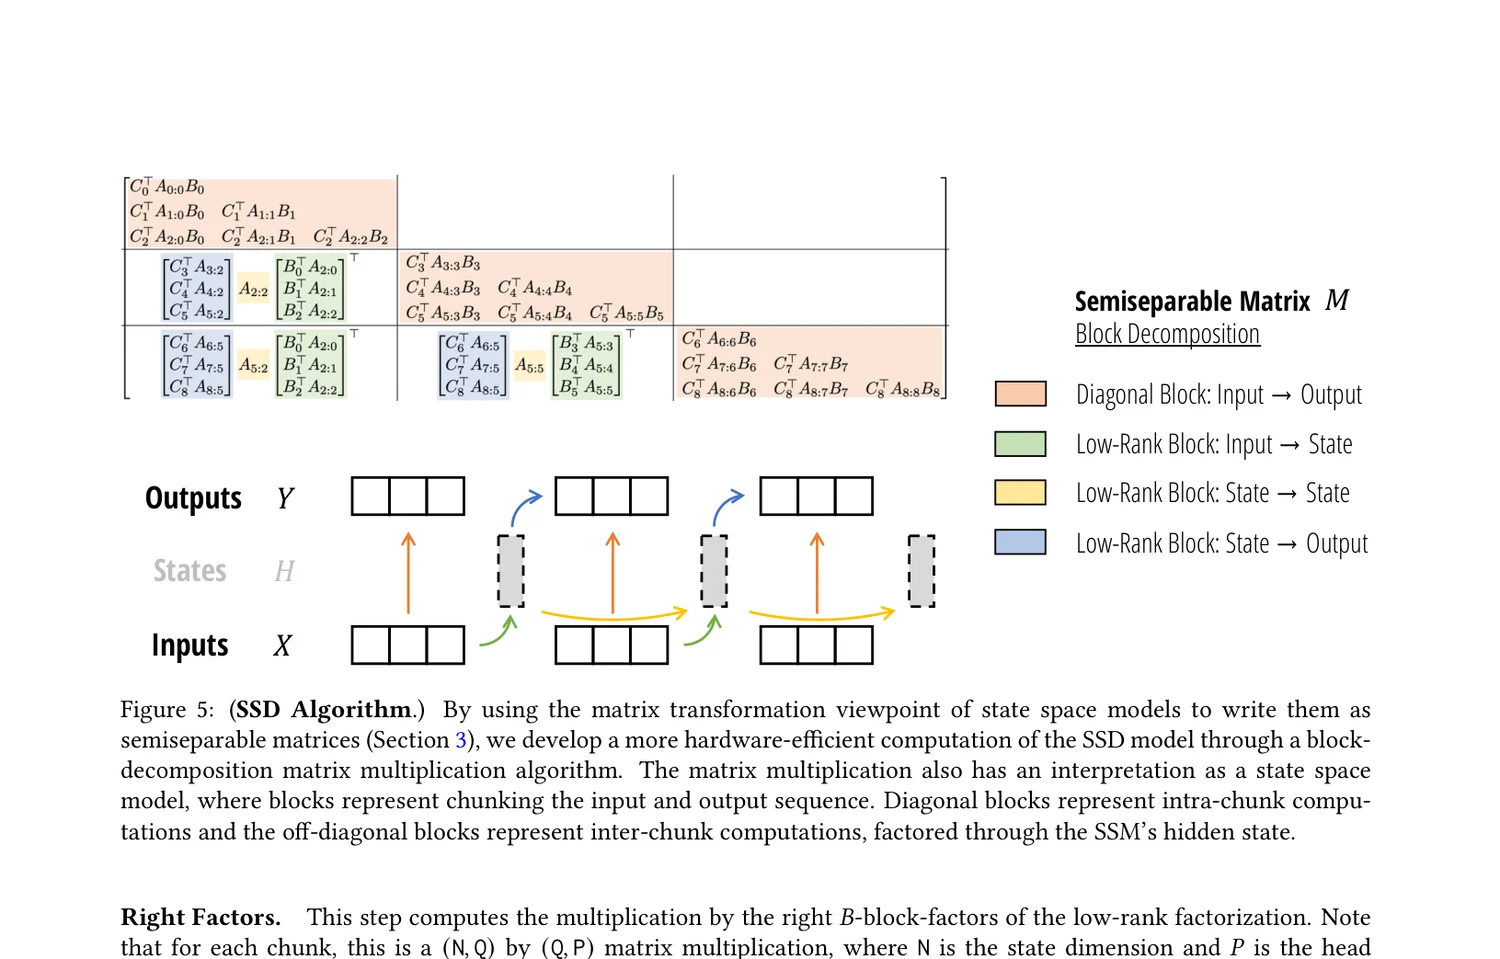
值得注意的是:分块算法里”块起始状态”的概念,与推理系统的 chunked prefill 天然一致。一个长提示可以分成若干块递推执行,块与块之间只需传递 ;这恰好是服务系统调度分块的前向单位。
服务系统需要重写哪些账
模型结构变了,推理框架里围绕 KV Cache 建立的那套账本不再适用,但并不意味着状态就没有工程问题。vLLM 的 Hybrid KV Cache Manager 设计文档 直接列出这类混合模型:Bamba、Jamba、Minimax 等 Mamba + full attention 混合结构。这说明工业上”纯 Mamba”并不是主流形态,混合结构才是落地途径。下面几类问题是混合结构服务的核心。
一:状态不是 KV,但同样需要被分配、复用与抢占
一个纯 Mamba 层的状态大小是每层 个元素,与序列长度无关,但与序列数成正比。显存分配的单位从”页”变成”槽”(slot),每个请求占一个固定大小的槽。问题随之而来:
- 调度器如何估算一个请求需要多少显存?纯注意力模型里,预算来自最大上下文长度;纯 Mamba 模型里,预算来自批大小,与长度无关。混合模型里两者都要。
- 请求被抢占时,状态不能像 KV 页那样留在池子里等它回来——因为状态已经被后续 token 覆盖了。这等于说,纯 Mamba 没有”重放历史”的能力,除非框架额外保存了状态快照或者 KV 副本。
这在工程上是一个硬约束:一个被抢占的 Mamba 请求,如果状态没有保存,恢复时只能从头重新预填充它的全部历史。推理框架为 Transformer 设计的抢占机制——换出 KV 块、换入后直接继续——在纯 Mamba 上不成立。
二:混合结构的页大小对齐
vLLM 文档的核心问题是:一个分页缓存池只能有一种页大小,而不同层类型对”一页该存多少东西”的要求不同。文档把页大小定义为
全注意力层要为每个 token 保留 K、V;滑窗层只为最近一个窗口保留;Mamba 层则要为每层保留一份状态。三者的”每 token 开销”不同,如果各自定义页大小,就无法共享同一个物理池。
vLLM 的处理分两步。第一步,把层按注意力类型分组,使组内层类型相同、所需块数相同,从而共享同一组块号;组与组之间按固定比例分配,例如 Gemma-2 的 1:1、Llama 4 的 3:1。第二步,解决混合 Mamba 模型里”状态比 KV 大”的问题。文档明确指出:对 Bamba、Jamba、Minimax 这类交错结构,每个 Mamba 层的状态大小可能远大于注意力层的 kv_hidden_size。在单一页大小的约束下,只能把注意力层的 调大,直到
再把 Mamba 状态按这个乘积补齐(padding)。文档也提醒,这会让注意力 block size 涨到 400 以上,代价过高;另一种按注意力层总页大小对齐的策略仍在完善中。这一段工程细节很能说明问题:Mamba 节省的是”随长度增长”的显存,不是”每请求”的固定开销。在混合模型里,状态甚至可能成为页大小设计的主导项。
前缀命中规则也要按组分别执行。文档的缓存键是 (block_hash, group_id),同一个 token 前缀在不同组里独立缓存、独立淘汰;新请求到来时,对每个组分别求最长命中前缀,再取交集作为整个请求的命中长度。对全注意力层,命中要求该前缀的所有 token 都在池中;对滑窗层,只要求最近一个窗口;对 Mamba 层,则要求对应的状态块还在池中。这就避免了”一个组命中、另一个组没命中”时读到不一致的状态。
三:批内不同长度的请求如何拼接
注意力层可以把多个请求的 token 拼成一个变长序列,用块表把每段映射到各自的分页块。Mamba 层做不到:每个请求有自己的状态,状态不能拼。于是推理框架必须做两件事:
- 把状态放在按请求槽位索引的连续缓冲区里,而不是按 token 位置索引的分页表。vLLM 的混合模型实现里,Mamba 层需要单独的”状态存储”和张量,而不是复用 KV 的页表抽象。
- 在批内同步推进每个请求的状态。这一层的每个 token 只更新自己请求的状态,因此内核要按请求槽位寻址,而不是按序列位置寻址。这会让内核实现从”一维 token 索引”变成”请求 + token 两维索引”。
四:预填充与解码的状态语义不同
预填充阶段需要给一个新请求算初始状态。如果该请求命中了前缀缓存,那么它应当从缓存中的状态开始,而不是从头扫描。但前缀缓存里存的是什么?对纯 Mamba 层来说,只有”某个 token 位置结束时的状态”才有意义;对注意力层来说,是那个位置之前的所有 KV。两者对”位置”的粒度要求不同:
- 纯注意力模型的前缀缓存可以命中任意长度前缀,只要能找到对应的块;
- 纯 Mamba 模型只可能命中事先保存过状态快照的那些位置,其他位置要重算。
所以,混合模型的前缀缓存设计通常选择把”状态快照 + KV 块”成对存储,命中粒度以快照位置为准。这也是为什么在工业实践中,Mamba 前缀缓存经常不是逐 token 的,而是按块或按预先切好的段落做快照。
五:投机解码的草稿与回滚
投机解码(可参考 EAGLE 与 MTP 的拆解)在推理侧依赖两件事:用较小的代价先生成若干候选 token,再一次性验证这些候选。对注意力模型,验证失败时只需要丢弃未确认的 KV 页;对 Mamba 层,验证过程已经把这些候选 token 写进了状态,回滚意味着恢复验证前的状态。
这带来一个直接的实现约束:草稿阶段开始前必须保存一份状态副本,验证通过 个 token 后丢弃副本、保留覆盖后的状态;若只通过 个,则从副本出发重新推进 步。副本的大小与状态相同,因此投机解码对 Mamba 层的额外显存开销与”最大草稿长度无关、与草稿次数正相关”。相比注意力模型只需按页回退,Mamba 的回滚成本更高,但也不是不可承受——它换来的好处是:草稿阶段本身不产生随长度增长的 KV 读取。
此外,验证阶段需要对所有候选位置并行计算 ,然后逐位置推进状态——这又是一次”块级短序列内的扫描”。若草稿长度取 8 或 16,块内运算量很小,框架往往会选择直接用分块矩阵乘(把整段草稿当一个块处理),再一次性写回状态。
六:并行策略的选择面变了
注意力模型沿头维切张量并行非常自然:每个 rank 拿一部分头和对应的 KV。Mamba 层的张量并行要切的东西更多——输入投影、 的投影、状态本身。一旦状态也要切,状态更新就变成了部分和部分之间的逐元素关系,通信次数与状态维相关。Mamba-2 论文在系统章节讨论了这一点:SSD 可以在序列维、头维和状态维上做出不同的并行选择;状态维若要切分,状态更新就需要额外的跨 rank 同步,因此常见实现倾向于让每个 rank 持有完整状态、只切特征。
这也解释了为什么工业上的混合模型常把 Mamba 层放在专家并行或数据并行下,而把少数注意力层单独做张量并行:两者的切分自由度不同,强行共用一套并行拓扑会让其中一方吃亏。
混合结构:工业落地的现实形态
纯 Mamba 在召回精确性上会退化:状态是压缩的,不能像注意力那样”要看什么就看什么”。它的近亲——门控线性注意力与 delta 规则——也在同一谱系上做取舍,站内 Kimi Delta Attention 一文展示了另一条”固定状态 + 门控更新”的路线。于是主流做法是混合:一部分层是 Mamba(或线性注意力),一部分层是注意力。Bamba、Jamba、Minimax、Phi 系列的混合模型都走这条路。
为什么要混合,Mamba-2 论文给出了一个很直接的消融:350M 参数、48 层的模型,从 0 个注意力层逐次增加到 24 个,困惑度先降后升。纯 SSD 是 8.60,1 到 7 个注意力层落在 8.38 到 8.27 之间,在 6 个(约 12.5%)时最低为 8.26,再往上增加反而回落到 8.50 附近,纯 Transformer++ 则是 8.68。论文的解读是:SSM 层擅长通用的序列映射,注意力层充当检索通道,两者各司其职;混合层数超过一定比例后,SSM 的容量被挤占,收益消失。
这个”约一成”的比例对服务系统有两层含义。一是收益上限:如果只有约 1/8 的层是注意力,那么 KV Cache 的体量可以降到全注意力模型的约 1/8,而不是完全消失。二是系统复杂度不会随比例下降——只要还有一层是注意力,框架就必须同时维护页池和状态槽两套机制。
混合结构对服务系统的影响是:
- 吞吐的收益与注意力的占比相关。如果 1/4 的层是注意力、3/4 是 Mamba,那么 KV Cache 的体量降到原来的 1/4 左右,解码时对 KV 的读取也降到 1/4。相对全注意力模型,这是很可观的显存与带宽节省。
- 系统实现要同时管理两本账:注意力层的页池与 Mamba 层的状态槽。任何一边出问题都会让整体吞吐掉下来。
- 状态快照的存储与迁移比 KV 更”贵”:对同长度的上下文,状态快照是固定大小,但保存它的时间点必须与 token 位置对齐。P/D 分离场景下,一个提示的预填充在 P 节点完成,然后要与状态一起转交给 D 节点;如果混合层的前缀缓存只保存 KV,D 节点还得重新计算一遍状态。
- 缓存淘汰策略要按层类型分化。注意力层可以只保留最近滑窗或全量 KV,Mamba 层的状态只有一份,丢弃就等于丢掉整个上下文信息。这直接影响缓存池里不同类型条目的生命周期设计。
内核里的几笔细账
selective scan 的状态放在哪
Mamba-1 的融合扫描内核,标准做法是把 等参数先加载到片上 SRAM,再在片上按块做扫描,最后只把输出 写回 HBM。这样做的前提是:每个块内的状态和参数总量能装进 SRAM。以 、通道数 2048 为例,一个块(比如 2048 个 token)的中间量会远超 SRAM,所以实现上必须沿通道维和时间维同时分块,块大小是”通道块 × 时间块”的二维 tile。
对解码,情况简单得多:batch 里的每个请求只有一个 token,状态更新是 的逐元素操作,整个 batch 的状态可以常驻显存,按请求槽位索引读取。瓶颈变成了”读状态、读权重、算投影”三件事,其中权重读取是大头——每步都要把整个模型的权重扫一遍,所以小 batch 时解码是权重带宽受限,而不是状态带宽受限。这与 Transformer 解码的结论相同:batch 小的时候,两者都被权重读取支配;batch 大、上下文长的时候,KV Cache 的读取才会成为 Transformer 的额外负担,而 Mamba 没有这一项。
状态用 FP32 还是 FP16
状态是逐 token 累积的,误差会随步数累积。工程上常见的折中是:状态的存储可以是 FP16/BF16,但状态更新与 的计算用 FP32 累加,必要时把状态本身也放在 FP32 的缓冲区里,只在输出时降精度。Mamba-2 的官方实现允许单独指定 state dtype;推理框架是否把它暴露成配置,取决于该框架的实现成熟度。在长上下文、高并发场景下,FP32 状态会让状态显存翻倍,但显著降低数值漂移。这与 KV Cache 的精度选择逻辑类似,却更敏感:KV 的每一项是独立写入的,误差不会跨 token 传播;状态是递推的,一次舍入误差会沿着整条链累积。
分块大小与头维
Mamba-2 的分块算法中,块大小 决定了块内 GEMM 的规模和跨块状态传递的频率。 太小,块内矩阵乘的形状不友好,Tensor Core 利用率低; 太大,块内 项会重新变成主导,同时中间矩阵占用更多 SRAM。官方实现默认用 256,并允许按头维 与 SRAM 预算调整。头维本身一般取 64 或 128,与 Transformer 的 head_dim 对齐,这样同一个 GEMM 内核可以复用。
卷积与门控的融合
Mamba 块的顺序是:输入投影 → 因果 conv1d → SiLU → SSM → 与门控相乘 → 输出投影。推理实现里,conv1d 与 SSM 的输入投影可以融合为一次”读权重、算两路”的操作;门控乘法与输出投影也可以融合。融合的收益不是减少 FLOPs,而是减少中间张量的 HBM 往返。对解码这种每步只有一两个 token 的场景,中间张量的读写往往比计算更贵,因此融合程度直接决定小 batch 解码的延迟。
代价:压缩必然有损
到这里需要把 Mamba 的代价也说清楚,否则容易得出一个片面的结论:一个不需要 KV Cache 的模型,解码又快,是不是全面优于 Transformer?
第一,状态压缩是有损的。 Mamba-2 每层状态是 个元素(每个头 ,多个头拼起来),在 、、FP16 时每层约 128 KB;它保存的是整段历史的运行摘要,不是每个 token 的键值。这与 MLA 那种”每 token 压成低秩潜向量”有本质区别:MLA 仍可按 token 找回近似 KV,而 Mamba 的状态一旦被后续输入覆盖,就无法还原出某个具体 token 的表示。代价是:模型无法在生成时精确检索很久以前的具体 token。
论文的合成实验里,Mamba 在选择性复制和归纳头任务上表现很好(归纳头可外推到训练长度的 4000 倍),这容易让人误以为它没有检索短板。后续独立研究给出了更细的边界:Repeat After Me 系统比较了复制任务,发现 Transformer 在需要逐 token 复制未见过的字符串时明显更强;The Illusion of State in State-Space Models 则从表达力角度指出,固定大小状态在需要精确状态跟踪的任务上存在理论上限。Mamba-2 论文的混合实验也印证了这一点:在 350M、48 层的对照中,纯 SSD 的困惑度为 8.60,加入 6 个(12.5%)注意力层后降到 8.26,优于纯 Transformer++ 的 8.68。作者的解释很直接:SSM 层擅长做通用的序列到序列映射,注意力层则充当检索机制,避免把所有上下文都压进状态里。
第二,状态递推让”续写”失去了天然的重放点。 Transformer 的 KV Cache 可以保留历史中间版本,便于做分支采样、树状草稿与回滚;Mamba 状态只能顺序覆盖,要回到某个中间点必须保存快照或重算。这对投机解码中的”验证失败回滚”和”多候选分支”都有影响:对纯 Mamba 层,草稿被拒绝后,状态已经走了几步,必须回退状态,而回退需要保存草稿开始时的状态副本。
第三,训练侧的代价在这里只能一句话带过。 选择性 SSM 对并行扫描的依赖使得其算子与序列长度强耦合,很多推理优化(比如把解码和前向融成一个大内核)都要重新设计。本文只讨论推理侧,不展开训练。
推理侧的工程线索
把这些观察落到可以动手的层面:
- 状态槽是新的显存分配单位:容量估算从”每 token 每层多少字节”变成”每请求每层多少字节”,调度器的准入判断要以批大小而非最大上下文为参数。
- 状态快照与 KV 前缀缓存一起设计:在混合模型里,命中前缀的粒度选择要与状态快照的保存点一致;宁可少做命中,不要在命中后重算状态。
- 抢占回收要分类型:不能让纯 Mamba 请求像注意力请求那样”整块换出、换入继续”,否则会触发整段重算;常见的做法是限制被抢占请求的类型,或在抢占时保存状态快照并计入缓存预算。
- 内核寻址按请求槽位:状态更新内核的索引是”请求槽 × 头 × 状态维”,而不是”token × 层 × 头”;块表对状态没有意义。
- 预填充分块算法与调度分块对齐:Mamba-2 的分块算法天然以块为单位传递状态,chunked prefill 的切块可以复用这个结构,把块内 GEMM 走 Tensor Core、块间状态递推交给扫描。
三本账放在一起看
把全注意力、纯 Mamba 与混合模型放在同一张表里,很多设计差异会变得直观(表中的”注意力层”均指全注意力,滑窗等变体另算):
| 维度 | 全注意力模型 | 纯 Mamba 模型 | 混合模型 |
|---|---|---|---|
| 解码时随历史增长的开销 | KV 读取随上下文线性增长 | 只读固定状态,与长度无关 | 只有注意力层随长度增长 |
| 每请求显存 | 随上下文线性增长 | 每层固定状态,与长度无关 | 两者相加,通常以注意力层为主 |
| 预填充的并行方式 | 分块注意力 + GEMM | 分块 SSD,块间传状态 | 两套算法共存 |
| 请求拼接 | 变长 token 拼接 + 块表 | 按请求槽位,状态不能拼 | token 拼接只对注意力层有效 |
| 抢占恢复 | 换出/换入 KV 块 | 需状态快照或整段重算 | 分层处理 |
| 前缀命中粒度 | 任意 token 前缀 | 仅状态快照位置 | 以快照位置为准,兼顾 KV 块 |
| 长距离精确检索 | 强 | 弱,依赖混合层弥补 | 由注意力层承担 |
| 系统复杂度 | 一套页池 | 一套状态槽 | 两套机制同时维护 |
这张表也说明了一件事:Mamba 并不是把推理系统的复杂度”消灭”了,而是把它从”管理不断增长的历史”转移到了”管理固定大小的状态及其快照”。前者的问题主要是容量和带宽,后者的问题主要是生命周期、快照一致性与调度语义。两类问题的工程解法完全不同。
小结
Mamba 的核心贡献是把递归模型的状态转移变成输入相关的,同时用并行扫描与 SSD 的对偶视角,让这种”输入相关”既能在训练时并行计算,也能在推理时落成高效的矩阵乘。对推理系统来说,它最显眼的好处是:解码不读历史,状态大小与上下文解耦,因此长上下文解码的吞吐不再被带宽和显存拖住。
真正复杂的部分在服务系统:状态不是 KV Cache,不能分页、不能天然拼批、不能像 KV 一样在被抢占后原样保留,前缀命中需要与状态快照粒度对齐;混合模型还要同时维护两本账。vLLM 的混合 KV 缓存管理器对页大小对齐与按层类型命中规则的处理,是这一工程现实的一个具体样本。理解 Mamba 推理,最好把它看成”换了一套记账规则”,而不是”省掉了记账”。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



