


DeepInfer 源码完全拆解(三):KV 内存与 SWA 有界重放——两本块账、YoCo 截断与等价性验证
从总览留下的问题说起
DeepInfer 源码完全拆解(一):整体架构与模块全景 给出的七篇路线图里,第三篇定的是「KV 内存与 SWA 有界重放」,并把它拆成三个具体问题:
cache_engine.py如何把显存切成 KV 池与状态池?- 两本块账(KV 块 + 状态槽)各自的记账规则是什么?
- YoCo 截断的 mask 与 compact 两种模式,凭什么说它们等价?
第二篇(异步调度与零开销调度 ZOS)把 decode step 的三件事重新排了序,重点在时间维度上——把 CPU 的簿记挪出关键路径。本篇转向空间维度:同一个 step 里,GPU 显存被切成几块、每块归谁管、账怎么记。
先给出全篇的一句话结论:DeepInfer 的显存管理不是「一个 KV 池 + 一个块分配器」这种通用框架的标准形态,而是两本互相独立的账。一本是经典的分页 KV 块账(paged KV cache),管的是「压缩后」的注意力条目——它们有块表、有引用计数、能跨请求复用前缀。另一本是定长状态槽账(state cache),管的是「还没有压缩的序列状态」——每个序列一个固定大小的槽位,没有块表、没有引用计数、序列结束整体回收。这两本账的存在,直接来自 DeepSeek V4 那一套异构注意力(DeepSeek V4 注意力机制完全拆解)。
而「SWA 有界重放」(SWA Bounded Replay)解决的是另一个问题:滑动窗口注意力的 KV 一旦缺失,要不要重算、重算多少。DeepInfer 的答案是「只重算最近 128 个 token,并且把注意力窗口截断在重算段内」——这个截断就是 YoCo(You Only Cache Once)思想在推理侧的直接落点。
背景:V4 的注意力为什么逼出两本账
要理解 DeepInfer 为什么要维护两本账,得先回到 V4 的注意力结构。本站 DeepSeek V4 注意力机制完全拆解 已经把论文侧讲得很细,这里只把对显存管理有直接后果的部分重述一遍。
V4-Pro 有 61 层,前 2 层是纯 HCA,之后 CSA 与 HCA 交错;V4-Flash 有 43 层,前 2 层是纯滑窗注意力(SWA),之后同样 CSA/HCA 交错。也就是说,模型里同时存在三种「缓存的东西」:
- CSA 的压缩条目(压缩率 4:1 的稀疏路径);
- HCA 的压缩条目(压缩率 128:1 的稠密路径);
- 滑窗 KV(SWA,窗口 )。
前两者的共同点是:token 进来之后,要攒够 个( 是压缩块大小)才能压成一个条目。序列末尾不足 个的 token 没法压缩,必须以原始形态存着。压缩后的条目是「历史」,长度随上下文线性增长,但被压缩率除过,所以相对便宜;未压缩的尾部是「未成形的历史」,长度有界(最多 个)。
滑窗 KV 的性质完全不同。它只与当前位置有关:第 个 token 到来时,窗口头部被踢出、窗口尾部加入新的 KV。它是一个随时在变的滚动缓冲区,长度恒定为 。
官方那份 DeepSeek V4.1 Flash 推理部署 Q&A 把这条洞察写得很直白:滑窗 KV 与未压缩尾部这两类数据的共同点是,它们都是「序列状态」而不是「序列历史」——只依赖当前位置,一旦更新,旧值就没用了。
这个区分是整篇的基础,值得再展开一层:
| 维度 | 序列历史(压缩条目) | 序列状态(SWA / 未压缩尾部) |
|---|---|---|
| 长度增长 | 随上下文线性增长 | 有界(SWA 恒为 ,尾部 ) |
| 是否可跨请求复用 | 可以(相同前缀 → 相同条目) | 只有末尾一小段可复用 |
| 生命期 | 与序列同生共死,但可被驱逐 | 与序列同生共死,序列结束即失效 |
| 查找方式 | 需要块表把逻辑位置映射到物理块 | 直接按序列定位到槽位 |
| 驱逐策略 | 需要(LRU / codec 压缩 / 注意力驱逐) | 不需要 |
既然性质差这么多,用同一套数据结构去管就是自找麻烦。用统一的分页池来管 SWA,你会白白为「窗口不存在的那部分」分配块,还要维护块表和引用计数;用统一的状态槽来管压缩条目,槽位会随着上下文无界增长,直接爆掉。
DeepInfer 的选择是:分开建两套池、分开记两本账。这就是 cache_engine.py 的全部主题。
两个尺寸:ring 到底有多长
在进入池的切分之前,必须先解决一个尺寸问题:SWA 的 ring 到底要多大? 这个数字不是简单的「窗口大小」,它由三个部分叠加而成,而且推理侧(CE,Compute Engine / decode)和落盘侧(PE,Prefill Engine)的答案不一样。这是本节最容易看错的一处。
推理侧:窗口 + 回退
cache_engine.py 里给推理侧 ring 定尺寸的函数是:
def get_inference_swa_block_size(window_size: int) -> int: """swa_block_size 等于 window_size 加上为回退功能额外存的部分。"""它的返回值对应代码里的 swa_block_size_inference。官方 Q&A 给出的具体数字是:
128 是窗口本身,这个好理解。6 是回退余量(backtracking),来源是投机解码:一次 decode step 里可能一次接受多个草稿 token,如果验证后被拒绝了一部分,KV 就要回滚。回退的最坏情况需要多保留几个位置,DeepInfer 取 6 作为上界。
注意这里的一个语义细节:ring 比窗口多出的这 6 个位置,就是「回退缓冲区」。这意味着 ring 里的 134 个位置,任意时刻只有窗口那 128 个是「有效窗口」,另外最多 6 个是「刚刚被踢出但还留着以便回滚」的位置。这个设计让「踢出窗口头部」变成一个纯粹的指针移动,而不需要真的擦除数据。
落盘侧:为什么要加长到 396
同一个 cache_engine.py 里还有第二个函数:
def get_kvstore_swa_block_size(window_size: int) -> int: """kvstore 视角的 swa_block_size:inference 大小 + prefill 落盘多存的部分。
YoCo 截断开启时再叠加锚点回退余量 get_yoco_store_extra_tokens()。 """官方 Q&A 给出的 PE 侧数字是 396:
为什么落盘侧要多存这么多?Q&A 的解释是:store 只在 128 的整数倍处触发,而 prefill chunk 的边界不会正好落在整倍数上。
把这句话拆开:SWA 的持久化(store)有一个硬性约束——只在 token 位置是 128 的整数倍时才存。这个约束来自下面的「边界对齐」一节:只有对齐在 128 边界上,才能保证跨请求复用时不出现「半截窗口」这种没法对齐的状态。
但 prefill 是按 chunk 跑的,一个 chunk 的结束位置是在任意位置的。假设当前 chunk 算完停在位置 ,而 不在 128 的整数倍上,那么最近的一个 128 边界在 之前若干位置。要能从这个 ring 里「重排出一个完整可写的 134-token 窗口」,ring 就必须比 134 多留一段——多留的这段就是 PREFILL_STORE_EXTRA_SIZE = 128 与 YOCO_PREFILL_KEEP_TOKENS = 134。
cache_engine.py 里对应的代码路径是先判断是否开启 extra-state:
return get_inference_swa_block_size(window_size) + ( (envs.DEEPINFER_PREFILL_STORE_EXTRA_SIZE + get_yoco_store_extra_tokens()) if envs.DEEPINFER_PREFILL_STORE_EXTRA_STATE else 0)而 get_yoco_store_extra_tokens() 只在截断模式不为 off 时返回非零:
def get_yoco_store_extra_tokens() -> int: """YoCo 截断开启时,参与落盘重排的 state ring 额外多存的 token 数。""" return max(0, envs.DEEPINFER_YOCO_PREFILL_KEEP_TOKENS) \ if envs.DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE != "off" else 0Q&A 里还有一句关键区分:CE 不开这个 extra,ring 就是 134。也就是说 396 只发生在 prefill 引擎(PE)侧,decode 引擎的 ring 保持 134。这不难理解——落在 128 整数倍处的重排需求只出现在 prefill 阶段,decode 阶段是通过「副本区」的机制来做 store 的(见下文)。
两个尺寸的对照
把两个数字放在一起:
| 角色 | ring 长度 | 组成 | 为什么 |
|---|---|---|---|
| Decode(CE) | 134 | 128 窗口 + 6 回退 | 只需支持投机解码回滚 |
| Prefill(PE) | 396 | 134 + 128 extra + 134 YoCo keep | 需要从任意 chunk 边界重排出对齐窗口 |
这个表也解释了 cache_engine.py 里为什么 StateBlock 要同时持有 swa_block_size_kvstore 与 swa_block_size_inference 两个字段——它们对应不同的物理缓冲,一个给引擎用,一个给落盘重排用。
显存布局:StateBlock 里的三段
尺寸确定之后,看显存怎么切。cache_engine.py 的核心数据结构是 StateBlock,它的注释直接写出了布局:
[stored region: SWA][dropped region: YOCO consumer SWA | compression state]代码里的注释更完整:
class StateBlock: """... inference 布局的前 state_size_to_disk 字节,按长度截断即可排除整个 dropped region。 开启 extra-state 时先把 kvstore ring 重排为 inference 窗口;关闭时可直接截取原 buffer。 ... [dropped region: YOCO consumer SWA | compression state] ... state_size_to_disk 仅包含需落盘 SWA 的 inference 窗口。 ... Consumer SWA 保留完整 kvstore ring 长度以匹配公共 slot mapping;extra-state 模式的 PE→CE 对两组 SWA 做 ring 重排,对 compression state 直接复制。 """官方 Q&A 给这张布局配了一张示意图,把两本账的介质与归属画在了一起:
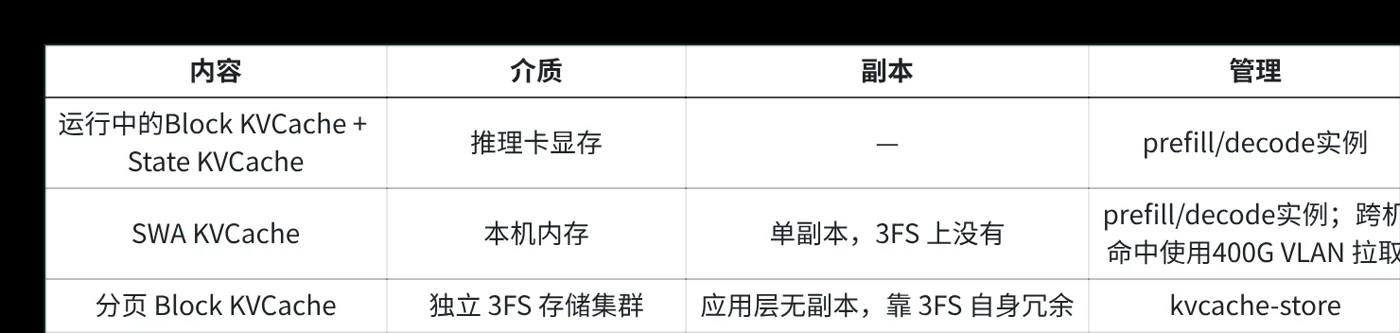
(图源:DeepSeek V4.1 Flash 推理部署 Q&A 官方 PDF 配图。图中展示了 KVCache 在「Block KVCache(进 3FS 存储集群、可跨机命中)」与「SWA KVCache(留本机内存、entrypoint 内存目录索引)」之间的分工——这正是本篇所说的「两本账」在部署形态上的直接体现。)
把这段注释翻译成一维地址空间:
三段各自的性质:
第一段(stored region: SWA)是需要跨请求持久化的 SWA 窗口。长度是 state_size_to_disk。Q&A 给出了这个值的算法:
三个因子的含义:20 层是 V4.1 需要 store 的层数(Q&A 原文「V41 store 的层是前 20 层」);134 就是推理侧 ring 长度;528 B/token 是 MXFP8 格式的 SWA KV 每 token 每层的字节数。注意 528 是单层单 token 的大小,所以三层因子相乘才是每序列的总量,约 1.35 MiB。
第二段(dropped region: YOCO consumer SWA)包含两类东西,按 StateBlock 的注释:
# [dropped region: YOCO consumer SWA | compression state]具体是哪两类,Q&A 写得很清楚:
dropped region 包含 YOCO consumer SWA 层(恢复依赖 prefill 重算)和 C2 压缩的边界累加器
ca_state/ica_state(压缩窗口边界天然对齐在 store 粒度 128 的整数倍上,没有跨边界的依赖)。
所以 dropped region 里的两类数据是:YOCO consumer SWA 层,以及压缩的边界累加器。它们被放进 dropped region 的共同理由是:
- YOCO consumer SWA 的恢复依赖 prefill 重算,不需要持久化,落盘没意义;
- 边界累加器的对齐性质天然成立(压缩窗口边界本来就对齐在 128 的整数倍上),也不存在跨边界的依赖,同样不需要额外持久化。
cache_engine.py 里划分哪一层属于 YOCO consumer 的逻辑是:
def _is_dropped_swa_layer(cfg: AttrDict, layer_id: int) -> bool: """按模型配置划分 YOCO consumer SWA,不依赖 PE/CE 的截断模式。"""注意最后半句——不依赖 PE/CE 的截断模式。这是一个重要设计:哪些层属于 dropped region 是由模型配置决定的,而不是由运行时开关决定的。因为层的归属是模型结构的固有属性,跟这一次要不要截断无关。把这两件事解耦,避免了「换一个截断模式,层的物理布局就变了」这种脆弱的耦合。
第三段(compression state)是非持久化的 fp32 压缩状态。代码里对应的分配函数:
def _alloc_state(self, num_state_token: int, head_dim: int) -> torch.Tensor | None: """Allocate non-persisted fp32 compression state after the dropped SWA rings."""注意 fp32——压缩状态用的是全精度,不再量化。这和 528 B/token 的 MXFP8 SWA KV 形成对比:状态数据量小(有界),精度要求高(它是累加器,误差会累积),所以不省这个空间。
两本块账:KV 池与状态槽
现在到了本篇的核心。DeepInfer 的显存不是被切成两块就完事,而是同一块显存被两套索引体系同时记账。
第一本账:KVCache 类里的四张表
cache_engine.py 的 KVCache 类把「逻辑 KV tensor」和「state tensor」分开描述。类里的注释把各张表的形状写得很明确:
class KVCache: """index attn state: [num_state_seqs, ring_size, 2, index_dim], fp32.""" """compressed attn state: [num_state_seqs, ring_size, 2, dim], fp32.""" """sliding window attn cache: [num_state_seqs, swa_block_size, 1, 528], uint8.逐条解释形状里的每个维度:
[num_state_seqs, ring_size, 2, index_dim](index attn state,fp32)
num_state_seqs是状态序列数——不是 token 数,是「有多少个序列能同时持有状态」。这个数由get_num_state_slots(max_num_seqs)决定。ring_size是压缩 ring 的长度,由get_inference_compress_block_size(compress_ratio)给出(下详)。2是 K 和 V 两个分量。index_dim是索引头的维度。- fp32:状态是累加器,不量化。
[num_state_seqs, ring_size, 2, dim](compressed attn state,fp32)
同样是 ring 结构,但存的是压缩条目的中间状态,dim 是压缩条目的维度。
[num_state_seqs, swa_block_size, 1, 528](sliding window attn cache,uint8)
swa_block_size就是前面推出来 134(推理侧)。1是占位维度,保持与其它表统一的四维形状。528是每 token 每层的字节数。- uint8:这里是字节视图,实际的量化格式(MXFP8)由内核在读写时解释。用 uint8 做容器类型是常见做法——显存就是一串字节,格式语义交给 kernel。
注意这三张表的第一维都是 num_state_seqs。这正是「状态槽」的本质:状态是按序列分配的固定大小块,不是按 token 分配的。
压缩 ring 长度:再加上回退历史
get_inference_compress_block_size 的注释只有一句,但信息量很大:
def get_inference_compress_block_size(compress_ratio: int) -> int: """Compression ring plus rollback history; environment changes require clearing the cache."""「Compression ring plus rollback history」——压缩 ring 也不是单纯的 个位置,同样要加上回退历史。原因和 SWA 一样:投机解码被拒绝时要回滚。
后半句「environment changes require clearing the cache」对应一个显式的失效接口:
def clear_compress_block_size_cache() -> None: """Clear cached ring sizes after changing DEEPINFER_MAX_BACKTRACKING_TOKENS."""这说明 ring 长度是按环境变量算完就缓存的,运行时改 DEEPINFER_MAX_BACKTRACKING_TOKENS 必须手动清理缓存,否则新的 ring 长度不会生效。这是一个很容易踩的坑:改了环境变量但没清缓存,池子还是按老尺寸分配的,越界写入就会发生。
第二本账:块表的记账规则
第一本账讲的是「状态槽」,第二本账是经典的分页 KV 块。第二篇里提到的 1.4 TB/卡 这类容量数字、以及 prefill 侧也用 paged KV(Q&A:「在 prefill 侧同样是 paged KV cache」),说的都是这本账。
两本账的关键区别,用一张表对照:
| 维度 | 分页 KV 块(第一本账) | 状态槽(第二本账) |
|---|---|---|
| 分配粒度 | 按块(block),块内多个 token | 按序列,整块固定大小 |
| 索引方式 | 块表(block table)逻辑位置 → 物理块 | 序列 id → 槽位,无间接层 |
| 引用计数 | 需要(跨请求前缀复用) | 不需要(序列独占) |
| 驱逐 | 需要(LRU / codec / 驱逐策略) | 不需要 |
| 生命周期 | 可长于单个请求(持久化到 3FS) | 随序列结束整体回收 |
| 谁在用 | 压缩后的 CSA/HCA 条目 | SWA、未压缩尾部、压缩中间状态 |
Q&A 里描述的「命中策略」一节给出了两本账在前缀复用上的配合方式,这段非常关键:
命中的原则是:命中长度由 Block KVCache 决定,最后一个 block 是否需要重算由 SWA KVCache 决定,若 SWA KVCache 未命中,就退一块重算。具体地,根据 YOCO 截断要求,对于输入长度 L,最大的命中长度最多为 L - 134(窗口 128 + 投机回退 6)。在这个上限下,首先查询 Block KVCache 命中情况,假设命中长度为 L1(L1 为 block size=128 的整数倍),再查询 SWA KVCache 命中情况。假如在 L1 - 128 至 L1 长度范围内,存在 SWA KVCache 则命中长度为 L1,否则命中长度为 L1 - 128,其中 128 为重算窗口。
把这段算法化的规则拆成四步:
第一步,确定命中上限。 命中长度最多 。为什么不是 ?因为还要留出投机回退的 6 个位置——这是 YoCo 截断的硬要求。也就是说,最后 134 个 token 永远不会来自缓存,一定是本次实算的。
第二步,查第一本账。 在 的上限下查 Block KVCache,得到命中长度 。 按定义是 block size(128)的整数倍——块表只能按整块命中。
第三步,查第二本账,只查最后一块的范围。 在 这个区间里查 SWA KVCache 是否存在。
第四步,二选一。 区间内 SWA 存在 → 命中长度 ;不存在 → 命中长度 。
第 3、4 步的语义是:压缩条目命中到哪里,还不足以决定能复用到哪里。因为注意力的最后一层是滑窗,如果最后一个 block 的滑窗 KV 不在,那么这一块的注意力就没法正确算出来——但压缩条目本身是对的。于是 DeepInfer 选择「退一块」:放弃最后一个 block 的复用,把它连同后面的内容一起重算。
「退一块」这个动作对应 128 的粒度,正好等于一个 block size。所以这套规则的粒度是干净的:要么命中到最后一块,要么退一整块,不存在「命中到块中间」的中间状态。
为什么状态槽不需要驱逐
对比一下通用框架(比如 vLLM 或 SGLang)的 KV 管理:它们要处理的是「块是共享资源,序列之间争用」这个问题,所以需要引用计数、需要 LRU、需要抢占(preemption)时把某个序列的块换出。
状态槽完全不需要这些,理由在上面那张表里已经列出:槽位是序列独占的,没有共享,所以没有争用,自然不需要驱逐。序列结束的时候,整个槽位一次性归还给池子。
这也解释了 KVCacheManager 里那个看起来像是「重复校验」的 finalize():
def finalize(self) -> None: # 校验 process 累加出的 state offset 与 StateBlock 预计算的总量一致,防止两处逻辑 drift sb = self._state_block注释说得很明白:state offset 是 process() 累加出来的,而总量是 StateBlock 预计算好的,两处逻辑各自演进就会 drift(漂移)。所以需要一个 finalize() 去断言二者一致。这是一种防御性编程:布局算错了不会表现为「慢一点」,而是会表现为显存越界或数据错位,所以宁可在初始化时直接报错。
YoCo 截断:mask 与 compact 两种模式
前面反复提到「YoCo 截断」。现在正面讲它。
YoCo(You Only Cache Once)的核心思想是:不要为每一层都存一份完整的 KV,而是只在一部分层上存,其余层的 KV 由这些层的输出重算得到。这样显存占用直接按「存了的层数 / 总层数」的比例下降。
原始论文《You Only Cache Once: Decoder-Decoder Architectures for Language Models》于 2024 年由微软团队发表(arXiv:2405.05254),它给出的架构把 decoder 拆成两段:self-decoder(做高效的自注意力,只用滑动窗口这类廉价注意力)与 cross-decoder(用 cross-attention 去attend self-decoder 的全局 KV)。注意下图里左右两侧的缓存差别——这正是「只 cache 一次」的字面含义:
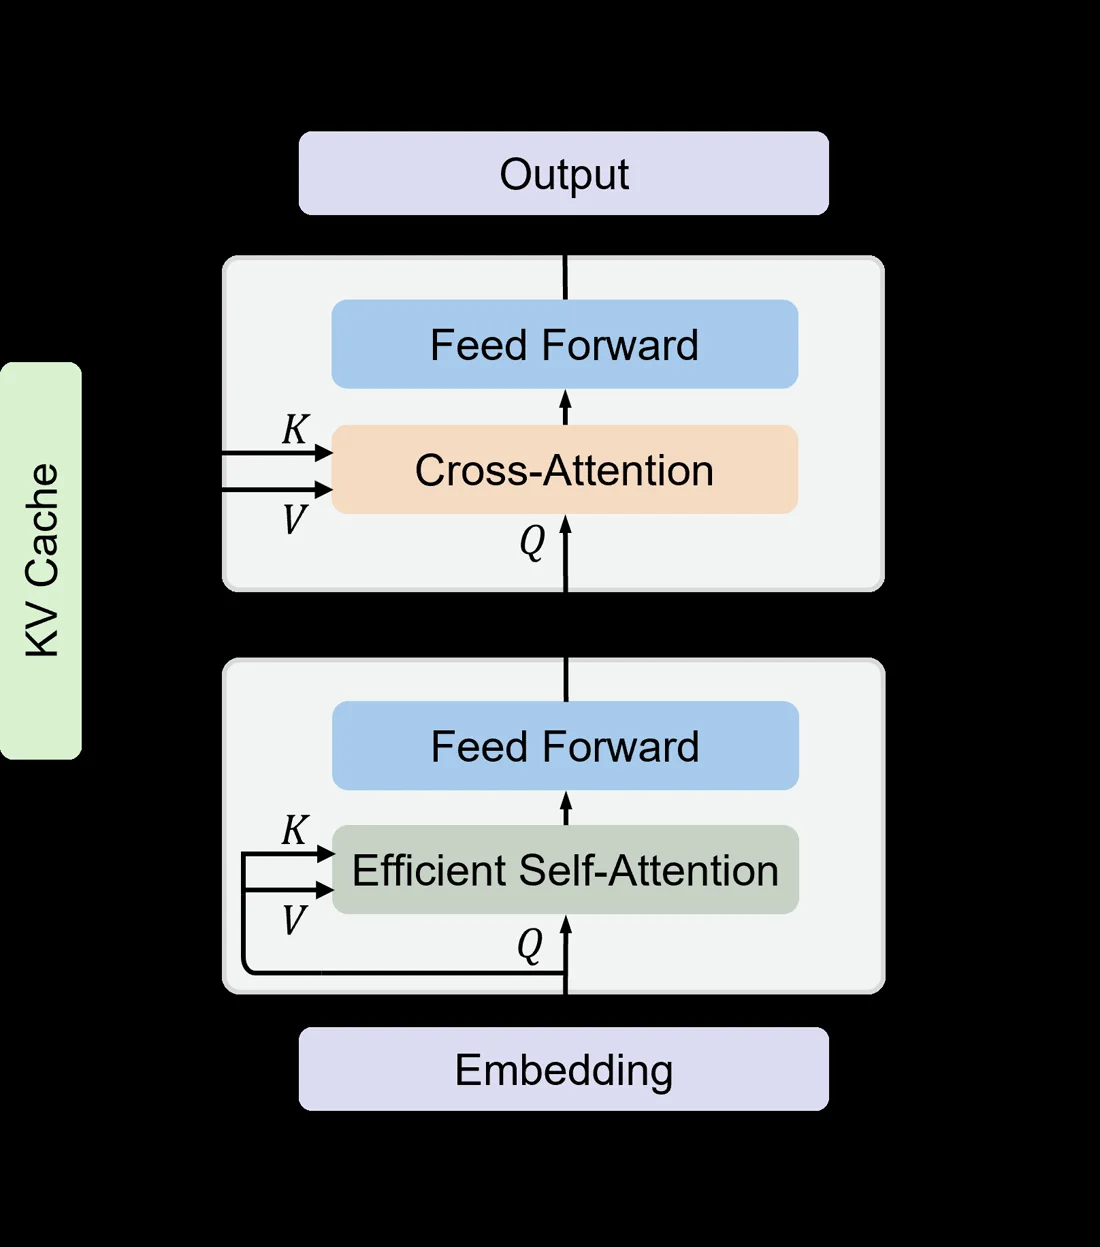
(图源:YOCO 论文 Figure 2,arXiv:2405.05254。图中左侧 self-decoder 的 Local KV Cache 只服务当前层窗口,右侧 cross-decoder 通过 cross-attention 访问 Global KV Cache——全局 KV 只存一份,其余层的 KV 被省掉,这正是 DeepInfer 截断模式的理论依据。)
DeepInfer 里对应的是两组环境变量。cache_engine.py 顶部能看到它们的使用:
envs.DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE # 截断模式:off / mask / compactenvs.DEEPINFER_YOCO_PREFILL_KEEP_TOKENS # 截断时保留多少 tokenenvs.DEEPINFER_PREFILL_STORE_EXTRA_SIZE # 落盘额外留的尺寸envs.DEEPINFER_PREFILL_STORE_EXTRA_STATE # 是否启用 extra-state 模式总览篇已经点出过一条硬约束:启用 YoCo 截断时 DEEPINFER_YOCO_PREFILL_KEEP_TOKENS 必须显式设置(默认 0),且保留长度必须覆盖 SWA 窗口加最大回溯长度。这一条现在可以理解了:如果 keep tokens 设成 0,等于「什么都不保留」,而 SWA 窗口加回退需要 134 个位置——池子会按错误尺寸分配。所以这是一个典型的「默认值不安全」的参数,必须显式给。
两种模式各自的机制
mask 模式:不物理移动数据,只把窗口外的位置标记为无效。
mask 的做法是在注意力计算时施加一个掩码,让 query 只 attend 到被保留的那部分 KV。物理缓冲还是完整长度,只是「不看了」。好处是实现简单、不需要搬数据;代价是显存占用没有真正下降(该占的位置还占着),省的是计算而不是空间。
compact 模式:把保留的 KV 物理搬到缓冲区的连续前段。
compact 的做法是真的把数据搬过去,缓冲区后面的位置被腾出来。好处是显存占用真的下降;代价是有一次数据搬运,而且要保证搬运之后所有指向这些位置的索引都被正确更新。
从 cache_engine.py 的注释里能看出 compact 涉及的具体动作——state_size_to_disk 的计算在 extra-state 模式下要先做 ring 重排:
# inference 布局的前 state_size_to_disk 字节,按长度截断即可排除整个 dropped region。# 开启 extra-state 时先把 kvstore ring 重排为 inference 窗口;关闭时可直接截取原 buffer。「先把 kvstore ring 重排为 inference 窗口」——这就是 compact 的核心动作:ring 长度从 396 重排成 134,重排之后前 state_size_to_disk 字节就是可以整体落盘的连续区域。
等价性怎么验证
「两种模式等价」不是一个可以靠读代码就断定的事。DeepInfer 的做法是提供一个专门的验证方法,总览篇的参考资料里就列了它:
examples/yoco/run_yoco_equiv_l2.sh配套的脚本是 examples/yoco/yoco_equiv.py(51 KB,是个实打实的验证程序),README 在 examples/yoco/README.md。脚本名里的 l2 是这套验证方法的关键线索——用 L2 距离衡量两种模式的输出差异。
验证的逻辑可以推断为:
- 同一批输入、同一个模型权重;
- 分别用 mask 模式和 compact 模式跑一遍前向;
- 逐位置比对两者输出的 hidden state(或 logits);
- 用 L2 距离度量差异,并在一个容许阈值内判定「等价」。
这个验证方法的价值在于它把「等价」变成了可执行的断言,而不是一个口头承诺。mask 与 compact 的差别在数学上是「看不看某些位置」与「这些位置在哪」——只要掩码逻辑与搬运逻辑一致,输出就应该逐位相同(在浮点误差范围内)。用 L2 距离而不是逐位相等,是因为搬运本身不引入数值误差,但不同的内存访问模式会改变 kernel 的归约顺序,从而产生浮点层面的微小差异。
这也顺带解释了一个容易被误解的地方:compact 模式的显存收益是真实的,但它不改变模型语义。如果它改变了语义,L2 距离就不会接近 0,这个验证脚本也就永远跑不过。
与抢占的交互:一条写在注释里的既定行为
step() 里有一句注释,总览篇引用过,这里值得再提一次因为它直接关系到截断模式:
NOTE 开启 yoco 截断时,允许抢占导致的结果变化
含义是:截断模式下 KV 只保留了有界后缀,一旦发生抢占需要重算,重算出来的结果可能与不抢占时不同。注释明确说这是「可接受的既定行为,而非 bug」。
为什么会有差异?因为在截断模式下,重算路径与原始路径处理的 KV 集合不完全相同——原始路径的中间状态是从更早的位置一路累积下来的,而重算路径是从保留的锚点重新开始的。累加器的历史不同,数值结果就会有细微差别。
这条的实操含义:任何把「同输入必同输出」当作硬要求的场景(比如确定性采样),必须同时考虑这一条。总览篇的另一条约束在这里形成闭环——要确定性就必须 DEEPINFER_ENABLE_MTP_VARLEN=0(因为变长验证的草稿长度由运行时估计决定),而截断与抢占的交互是确定性要求的第二个障碍。
SWA 有界重放:只重算最后 128 个 token
现在讲本篇标题里的另一半。
问题定义
前缀缓存要能命中,就需要知道「命中到哪里」。而命中之后会有一个尴尬的问题:命中部分的 SWA KV 可能不在。
压缩条目(第一本账)是持久化的、存在 3FS 上的、能跨机命中的——Q&A 说得很清楚:「Block KVCache(Main KV + Indexer K)使用独立 3FS 存储集群存储」。但 SWA KV(第二本账的一部分)不进持久化缓存:
SWA KVCache 不进持久化缓存,而是留在产生它的那台机器的内存里,由一个逻辑上统一、实际按 key 分开存放在各台 Entrypoint 上的内存目录记录在哪台机器,命中时本机没有就跨机取回。
这句话有几个直接后果。第一,SWA KV 的命中率天然低于压缩条目,因为它只存在「产生它的那台机器」的内存里。第二,跨机回拉需要走网络(Q&A:「跨机命中靠 entrypoint 的内存目录配合 400G VLAN 回拉」)。第三,也是最关键的——当 SWA KV 缺失时,你只有一个选择:重算。
问题是重算多少。
朴素做法为什么不可行
最朴素的想法是「SWA 缺了就重算整个命中前缀」。这不可行,因为重算量与上下文长度成正比——一个 100K 上下文的前缀,为了拿回最后 128 个位置的滑窗 KV,就要把 100K 全部前向一遍。这等于把前缀缓存的收益整个抹掉。
第二种朴素想法是「只重算最后 个 token 的前向」。这看起来对,但有一个隐藏问题:滑窗注意力在重算段内的边界怎么处理?
假设从位置 开始重放,重算段是 。对于位置 的 query,按正常滑窗逻辑它应该 attend 到 。但位置 到 这一段在重算段之外,我们没有它们的 KV。如果不做处理,这些位置要么被当成「空」从而得到错误结果,要么需要额外把重算段向左扩展 128——那就变成重算 256 个 token 了。
DeepInfer 的答案:截断在重算段内
官方 Q&A 给出的解法只有一句话,但完全解决了上面的问题:
采用 SWA Bounded Replay 只重算最近 128 个 token,并把注意力窗口截断在重算段内:从位置 s 起回放,位置 i 的 query 只和 max(s,i−127)到 i 区间的 key 计算,重算得到近似的 SWA KVCache。重算代价由此降为与上下文长度和层数无关的常数。
把这个公式抄下来:
对比正常滑窗公式:
唯一的差别是把下界的 换成了 ,其中 是重放起点。
这个替换的后果是:对于位置 ,它看到的窗口比正常情况短——正常应该看 128 个位置,而这里只看到 个。也就是说,重算段的开头部分,注意力被截断了。
Q&A 用词很准确:「重算得到近似的 SWA KVCache」。这是近似的,不是精确重建。
重算的边界为什么可以接受
为什么近似可以接受?这里有三层理由,每一层都值得说清楚。
第一层:受影响的 kv 数量是有限的、且位于窗口边缘。 在重算段 里,只有前 128 个位置(正好是整个重算段)的 query 会遇到「窗口比正常短」的情况——更准确地说,位置 看到的窗口长度是 。当 时窗口只有 1 个位置,当 时窗口终于达到 128。
第二层:真正进入缓存并服务于后续 decode 的,只有最后一段。重算得到的是「近似的 SWA KVCache」,但后续 decode 的 query 位置都在 之后(因为命中长度最多 ,重算段覆盖到接近 )。对于这些 query,它们的窗口是 ,而 意味着 ——窗口完全落在重算段内部,且完整。
这就解释了 Q&A 那句「重算代价由此降为与上下文长度和层数无关的常数」背后的真正机制:重算段里开头那部分的截断,其影响被限制在重算段内部,不会向外传播。因为后续所有的 query 只依赖重算段的后 128 个位置的 KV,而这部分的 KV 是精确的。
第三层:这个近似与 YoCo 的设计意图一致。 YoCo 的前提就是「只 cache 一次、其余重算」,而重算本身就被接受为一个近似操作。SWA Bounded Replay 是这个思路在推理侧的落地:既然重算被接受,那就把重算范围压到最小。
两处重放:Encoder 侧与 Decoder 侧
Q&A 里把 SWA Bounded Replay 的用途分成两处,两处的动机完全不同。这一段是全文里最容易读漏、但信息量最大的部分。
Encoder SWA Bounded Replay
前缀缓存命中长度从此只依赖 Block KVCache。SWA KVCache 缺失时,重算命中前缀的最后 128 个 token,与未命中后缀一同前向;重算段只重建 SWA KVCache,Block KVCache 原样复用、不重算不覆写。
拆开来看:
「前缀缓存命中长度从此只依赖 Block KVCache」——这是重放带来的最大好处。没有重放机制时,命中长度被两本账同时约束(见前文的四步算法);有重放机制后,SWA 缺失不再是「退一块」的理由,而是「重算一小段」的操作。命中长度的决定权收归到压缩条目这一本账上。
「重算段只重建 SWA KVCache,Block KVCache 原样复用、不重算不覆写」——这句划清了重算的作用范围。重算段跑完前向,只把 SWA KV 写进状态槽,不碰压缩条目。压缩条目是持久化的、跨机的、贵重的,绝不能因为一次局部重算就覆写掉。
这里有个设计上的克制值得注意:重算段为什么不顺便把压缩条目也算出来? 因为压缩需要对 个 token 的窗口做累加,而重算段只有 128 个 token;如果 大于 128,重算段根本凑不出一个完整的压缩块。更重要的是,压缩条目本来就在缓存里命中了,重算一遍纯属浪费。
Decoder SWA Bounded Replay:省掉一半 prefill
第二处的动机完全不同,也更激进:
Decoder SWA Bounded Replay:prefill 计算仅在 encoder 层进行。CED 架构下 decoder 层的 Block KVCache 由 encoder 末层 hidden state 投影得到,仅 decoder SWA KVCache 需各层自算,精确重建要 20 个 decoder 层跑最后 2560 个 token;改为每次 prefill 在 decoder 层只重算 prompt 末尾 128 个 token,产出仅供 decode、不进前缀缓存,总 prefill 计算量近乎减半。
这段需要逐句拆。
「prefix 计算仅在 encoder 层进行」——这是 CED(Cross-Encoder-Decoder,或类似的双段架构)的基本设定。encoder 层负责把 prompt 完整跑一遍。
「decoder 层的 Block KVCache 由 encoder 末层 hidden state 投影得到」——关键点在这里。decoder 的压缩条目不是自己算的,是从 encoder 最后一层的 hidden state 投影过来的。这意味着 decoder 的 Block KVCache 不需要重算——它有现成的来源。
「仅 decoder SWA KVCache 需各层自算」——但 SWA 不行。SWA 是每层自己的注意力窗口,没法从别处的 hidden state 投影出来,必须各层自算。
「精确重建要 20 个 decoder 层跑最后 2560 个 token」——这是不截断的代价。20 层 × 2560 token。2560 这个数字的来源 Q&A 没在本篇展开,但它显然是「窗口 × 层数相关量」的组合。关键是对比:精确重建要算 20 × 2560。
「改为每次 prefill 在 decoder 层只重算 prompt 末尾 128 个 token」——截断之后变成 20 层 × 128 token。工作量降了 20 倍。
「产出仅供 decode、不进前缀缓存」——这一句是整段里最重要的限定。decoder 层重算出来的 SWA KV 不进入前缀缓存。为什么?因为它只覆盖了 prompt 末尾 128 个 token,这个范围太短、复用价值太低,而写缓存需要持久化和跨机管理,成本远大于收益。所以它的产物直接投喂给紧随其后的 decode 步,用完即弃。
「总 prefill 计算量近乎减半」——这是最终收益。为什么是「近乎减半」而不是更多?因为减掉的只是 decoder 层 SWA 的重算部分,prefill 里还有其他开销(encoder 层的完整前向、压缩、投影等)。减半是一个合理的量级描述。
官方仓库给出的 prefill 侧 Pareto 曲线交代了这一侧的目标位置——横轴是首 token 延迟(TTFT),纵轴是 prefill 吞吐:
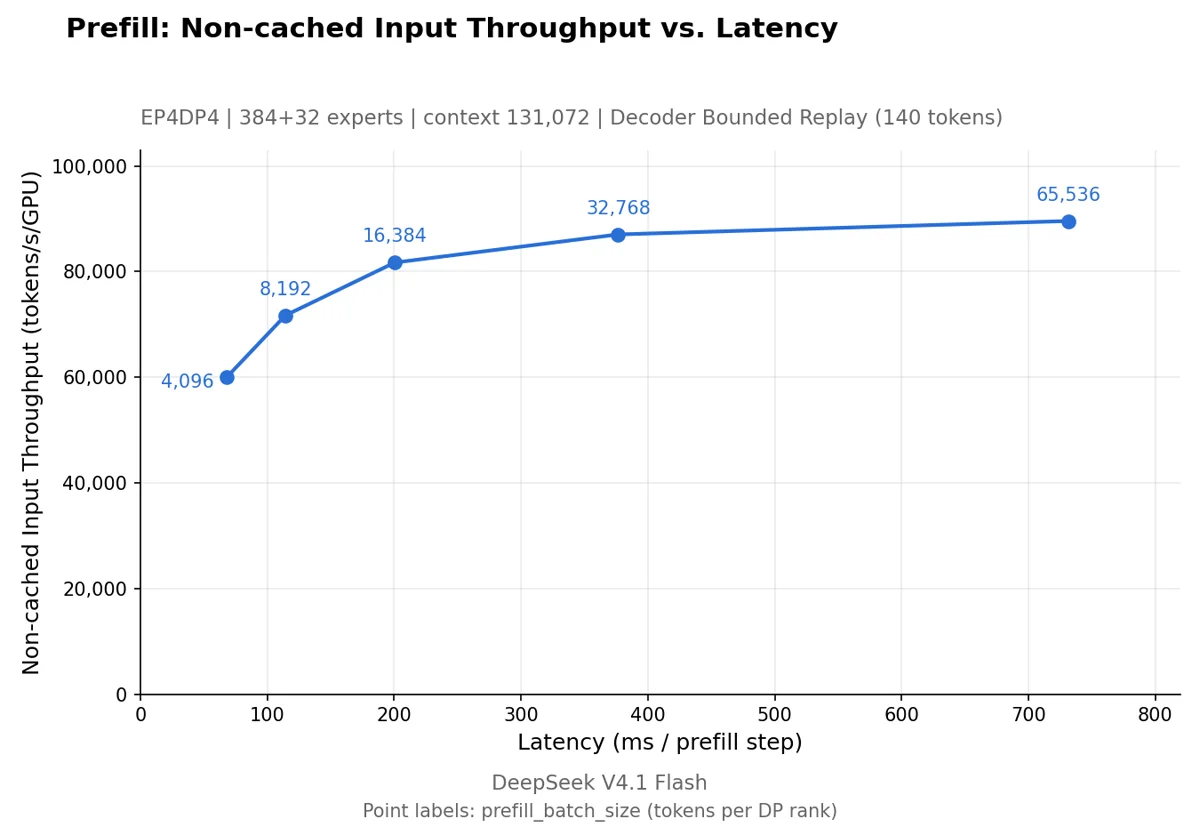
(图源:DeepInfer 官方仓库 doc/images/prefill_pareto.png。Bounded Replay 想动的是这条曲线可及的前沿——它不改变单次前向要算多少 FLOPs,而是把「重建 SWA 状态」这块本可以避免的重复计算砍掉,让同样的算力能落到更多的有效 token 上。)
两处重放的对照
| 维度 | Encoder SWA Bounded Replay | Decoder SWA Bounded Replay |
|---|---|---|
| 解决什么 | 命中后 SWA 缺失怎么办 | prefill 时 decoder 侧 SWA 重建太贵 |
| 重算范围 | 命中前缀的最后 128 token | prompt 末尾 128 token |
| 产物去向 | 重建 SWA KVCache(供后续 decode 用) | 仅供本次 decode,不进前缀缓存 |
| 对 Block KVCache | 原样复用,不重算不覆写 | 由 encoder 末层 hidden state 投影得到 |
| 收益 | 命中长度不再被 SWA 拖累 | prefill 计算量近乎减半 |
一句话概括两处重放的共同点:都是把「重算」的作用范围限制在 128 个 token、限制在重算段内部,从而把重算代价变成常数。差异在于产物是否值得写进缓存——encoder 侧值得(它会支撑后续多次命中),decoder 侧不值得(它只服务当前这一次请求)。
与磁盘缓存三档策略的关系
本站 DeepSeek V4 注意力机制完全拆解 里介绍过论文侧给磁盘 KV Cache 的共享前缀的三套 SWA 策略:
| 策略 | 存什么 | 命中时 | 权衡 |
|---|---|---|---|
| Full SWA Caching | 全部 token 的滑窗 KV | 读最后 个 token,零重算 | 存储充足;SSD 写入模式差 |
| Periodic SWA Caching | 周期性存滑窗 KV | 读最近的周期点,重算一小段 | 存储与重算折中 |
| Zero SWA Caching | 不存任何滑窗 KV | 用压缩条目重算最后 个 token | 存储紧张;重算量 |
SWA Bounded Replay 就是 Zero SWA Caching 那一档在工程上的落地方式。「Zero」听起来很吓人——完全不存滑窗 KV,每次都要重算。但有了 Bounded Replay,重算量从「与上下文长度成正比」降到「常数」,Zero 策略才真正可用。论文里那句「重算量 远小于全 prefill」,讲的就是这件事。
从工程视角看,DeepInfer 并没有全局采用 Zero 策略。Q&A 明确说了 SWA KV 是 「留在产生它的那台机器的内存里」,并有 entrypoint 内存目录做跨机索引——这是「存了一部分」的做法,介于 Full 与 Zero 之间。Bounded Replay 是兜底机制:当那份 SWA KV 因为跨机、重启、驱逐等原因拿不到时,用常数代价重算一小段,而不是退化成全量重算。
落盘与跨机:store 的边界对齐
前面提到「store 只在 128 tokens 的整数倍位置上存储」。这一节把这条规则讲透,因为它解释了两个 ring 尺寸的差异,也解释了为什么会有「副本区」这个额外机制。
Prefill 侧的 store
Q&A 的描述:
Prefill 阶段结束后存储:位置取序列末尾留出一个 token 后向下对齐到 128 所得的位置,不足一个 128 tokens 则本轮不存储;chunked prefill 中途不存储,只有最后一个 chunk 才存储。
拆开三个动作:
「位置取序列末尾留出一个 token 后向下对齐到 128 所得的位置」——公式化:
「留出一个 token」是为了保证锚点处已经是完整 token;「向下对齐」保证落在块边界上。
「不足一个 128 tokens 则本轮不存储」——如果 , 会是 0,没有可存的东西。短 prompt 直接跳过 store。
「chunked prefill 中途不存储,只有最后一个 chunk 才存储」——这是一个很实用的优化。chunked prefill 把一个长 prompt 切成多个 chunk 依次前向,如果每个 chunk 结束都存一次,就会在同一次请求里反复做落盘,浪费 IO。只在最后一个 chunk 存,等于「一个请求一次落盘」。
Decode 侧的 store:副本区机制
Decode 阶段的情况不一样,因为没有「最后一个 chunk」这种天然的结束点。Q&A 给出的方案:
Decode 阶段在显存中另开一块副本区,每跨过一个 128 tokens 边界就把该请求当前的窗口在显存内拷入副本区,请求结束时从副本区中最近一次完成拷贝的位置存储,附着点向下对齐到 128 边界,拷贝位置最多越过边界 5 个 token,由 ring 比窗口多出的 6 个位置吸收。
这段的机制值得逐步还原:
「另开一块副本区」——为什么不能直接存主 ring?因为主 ring 是滚动缓冲区,一直在变。如果从主 ring 直接落盘,落盘的瞬间窗口可能正在被改写(比如 next token 正在写入),就会拷出一个不一致的状态。副本区提供的是一个稳定的快照点。
「每跨过一个 128 tokens 边界就把该请求当前的窗口在显存内拷入副本区」——拷贝的触发条件是「跨过 128 边界」。这意味着副本区里始终有一份「最近一次对齐的完整窗口」。
「请求结束时从副本区中最近一次完成拷贝的位置存储」——请求结束的时候,从副本区取,不从主 ring 取。
「拷贝位置最多越过边界 5 个 token,由 ring 比窗口多出的 6 个位置吸收」——这一句终于解释了那 6 个回退余量的第二个用途(第一个用途是投机解码回滚)。
拷贝在「跨过边界」时触发,但触发检测是有粒度的:可能一次前进多个 token 才检测到跨界。所以实际拷贝位置可能在边界后若干位置——Q&A 给出的上界是最多越过 5 个 token。为什么是 5?这来自 prefill 之外的另一个约束(decode 一次最多推进的 token 数),Q&A 没有展开,但给出了结果:5 ≤ 6,正好被 ring 多出的 6 个位置吸收。
这是一个很漂亮的尺寸论证:ring 多出的 6 个位置,同时承担了投机解码回滚(需要 6)和 store 拷贝越界(需要最多 5)两个需求。取两者最大值 6,一个余量解决两个问题。如果这两个需求没有对齐——比如拷贝可能越界 8 个——那么 ring 就得多留 2 个位置,整个布局的三个尺寸推导都要重来。
store 内容与介质
Q&A 把落盘的内容算得很具体:
落进 store 的只有 state_size_to_disk = 20 层 × 134 token × 528 B = 1,415,040 B/seq。528 B/token 是 MXFP8 的 SWA KV 格式。SWA KVCache 不进持久化缓存,而是留在产生它的那台机器的内存里……
三点:
只有 state_size_to_disk 这部分落 store。 也就是 StateBlock 的第一段(stored region)。dropped region 不落——它的恢复依赖重算。
按 20 层的量算。 不是全部 43 层(V4-Flash 的总层数)。这与「V41 store 的层是前 20 层」一致。
介质是「产生它的那台机器的内存」,不是持久化集群。 与 Block KVCache 走 3FS 完全不同。这带来两个后果:SWA KV 在机器重启后丢失(必须重算);跨机命中要走 400G VLAN 回拉(Q&A:「跨机命中靠 entrypoint 的内存目录配合 400G VLAN 回拉」)。
顺带看一下这套设计与 3FS 的分工。Q&A 关于 3FS 的描述提到 Block KVCache 用纠删码存储(10+2 Erasure Coding,每个 EC 组容忍 2 节点同时故障)、GC Worker 按 LRU 周期性淘汰、TTL 对于 agent 流量 3 天、chatbot 7 天。这些机制只服务第一本账。第二本账(状态槽里的 SWA KV)走的是完全不同的路径:本机内存 + entrypoint 内存目录 + VLAN 回拉。
两本账的介质差异,其实是它们性质的必然推论:
- 压缩条目是「序列历史」,值得持久化、值得纠删码保护、值得跨机共享;
- SWA KV 是「序列状态」,只与当前位置有关,持久化的价值低(换了位置就没用了),跨机共享的收益也低(只有窗口那一小段)。
跨机取回的两种路径
Q&A 提到 SWA KVCache「命中时本机没有就跨机取回」。这里的权衡是:跨机取回需要走网络,而重算只需要 GPU 时间。什么时候取、什么时候算?
虽然没有直白的阈值公式,但从机制上可以推断出决策依据:取回 1.4 MB 的 20 层窗口,与重算 128 个 token 的 20 层前向,谁便宜。这个比较依赖于具体的网络带宽(400G VLAN)与 GPU 算力,也依赖当前的 GPU 是否空闲。如果 GPU 恰好闲着而网络拥塞,重算更划算;反之取回更划算。
Q&A 里还有一条关于 overlap 的描述,说明取回路径本身是精心设计过的:
取 KV 在独立进程里异步做,把 KVCache 从 3FS 搬进宿主机 shm;换入从 shm 到 HBM 在 engine 进程内的线程里做,目标是实现逐层 H2D 传输与前向计算重叠,由于 CUDA copy engine 对于 KVCache Block 细粒度的拷贝性能不佳,换入使用 GDR 实现,用 RDMA 网卡就能打满 PCIe 带宽,并且不占 SM。
这段讲的是 Block KVCache(第一本账)的取回,但它揭示的工程要点对两本账都适用:用 GDR(GPUDirect RDMA)而不是 CUDA copy engine 做换入。理由是「CUDA copy engine 对于 Block 细粒度的拷贝性能不佳」——细粒度小拷贝会打不满带宽。用 RDMA 网卡直接写 GPU 显存,既能打满 PCIe,又不占用 SM(流多处理器)。这是一个典型的「省下 SM 去算注意力」的优化。
与其他框架的对照
「KV 池 + 块表」是通用推理框架的标准形态,DeepInfer 的两本账是一个明显不同的选择。把五家放在一起看会更清楚。
vLLM 的 PagedAttention 是分页 KV 的起点,本站 PagedAttention 完全拆解 讲过它的机制:逻辑块到物理块的映射表、块内连续、块间可以不连续。vLLM 只有一本账——所有 KV 都在同一个池里,靠块表索引,靠引用计数支持前缀共享和 CoW(写时复制)。这套设计的前提是「所有 KV 同质」:每层的 K/V 形状一致、长度一致、生命周期一致。V4 的异构注意力打破了这个前提——SWA 长度有界、压缩条目长度无界、两者的复用语义完全不同。硬塞进一个池,要么浪费空间,要么让块表逻辑变得极其复杂。
SGLang 的 RadixAttention 是另一种一本账的形态,本站 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环 拆过它:用前缀树组织 KV,节点按 token 序列共享,靠锁引用做所有权管理。它比 vLLM 更激进地做前缀复用,但同样假设 KV 同质。面对 V4 这种异构缓存,SGLang 生态的应对是引入 Shadow Radix——逻辑前缀树的一个节点同时投影到 SWA、C4 压缩、C128 压缩、索引器键、压缩状态环五个物理池(见 DeepSeek V4 注意力机制完全拆解 引用的社区方案)。注意这个做法:它还是「一棵逻辑树 + 多个物理池」,逻辑层统一、物理层分裂。DeepInfer 的选择更彻底——连逻辑层也分裂成两本账,因为它只服务一个模型,不需要为通用性保留「统一逻辑前缀树」这个抽象。
TensorRT-LLM 的 KVCacheManager 走的是第三条路,本站 TensorRT-LLM 源码完全拆解(四):KVCacheManager 与块管理 拆过:两级池、块表构造、前缀复用树。它同样是一本账,但支持多级存储(GPU 显存 / 主机内存 / 磁盘)的分层。DeepInfer 的状态槽更像 TensorRT-LLM 的「非持久化侧资源」——都是不走块表、不走引用计数的直接定位。
llama.cpp 的 llama_memory_i 抽象是第四种形态,本站 llama.cpp 源码完全拆解(四):llama_context 与记忆系统 讲过:它把「KV 缓存」抽象成一个可替换的接口,底下可以有统一 KV、可以有 SWA 的滚动窗口实现。llama.cpp 的 SWA 处理方式是把窗口当作 ring buffer 直接覆盖——没有重算机制,也没有跨请求复用 SWA。这是因为它面向单机、单用户优先的场景,前缀复用的收益不足以支撑那套复杂度。
把五家压成一张表:
| 维度 | DeepInfer | vLLM | SGLang | TensorRT-LLM | llama.cpp |
|---|---|---|---|---|---|
| 账本数 | 2(压缩块账 + 状态槽账) | 1(统一块池) | 1 逻辑树 + 多物理池 | 1(分级池) | 1(可替换抽象) |
| SWA 处理 | 定长状态槽 + Bounded Replay | 统一分页 | Shadow Radix 多池投影 | 统一分页(分级) | ring buffer 覆盖 |
| SWA 缺失时 | 重算 128 token(常数代价) | 不适用(统一池) | 重算(由框架统一处理) | 不适用 | 无缓存,本来就重算 |
| 前缀复用粒度 | 块(128) | 块 | token | 块 | token |
| 服务模型数 | 1(V4.1) | 任意 | 任意 | 任意 | 任意 |
一句话总结这张表:通用框架要在「任意模型」的前提下做统一抽象,所以只能一本账;DeepInfer 只服务一个模型,所以可以按模型结构把账本劈开。这是一个「放弃通用性换实现简洁」的典型取舍——两本账各自的逻辑都比「统一池 + 复杂块表语义」简单得多,代价是换一个模型就要重写。
工程边界与陷阱
这一节把散落在各处的硬约束集中列出。它们的共同点是:都不是可调优的参数,而是不满足就出错或崩溃的前提。
DEEPINFER_YOCO_PREFILL_KEEP_TOKENS 必须显式设置。 默认 0,而保留长度必须覆盖 SWA 窗口加最大回溯长度(134)。设小了池子按错误尺寸分配。
改 DEEPINFER_MAX_BACKTRACKING_TOKENS 必须清 compress block size 缓存。 clear_compress_block_size_cache() 的 docstring 直说了这一点。不清缓存等于改了参数不生效,而池子已经按新参数预计算了总量——两处尺寸不一致正是 finalize() 要拦的情况。
_is_dropped_swa_layer 只依赖模型配置,不依赖截断模式。 层的归属是模型结构属性。任何试图「按运行时开关切分层的物理位置」的改动都会破坏这个不变量。
dropped region 不能被误落盘。 state_size_to_disk 的定义就是「按长度截断即可排除整个 dropped region」。任何直接用 state_total_in_bytes 做落盘的代码都会把 dropped 数据也写出去,白占 IO 带宽。
extra-state 模式下的 PE→CE 传输需要 ring 重排。 StateBlock 注释说得很清楚:「extra-state 模式的 PE→CE 对两组 SWA 做 ring 重排,对 compression state 直接复制」。两组 SWA(stored 与 consumer)都要重排,compression state 反而可以直接 memcpy——因为后者的布局在两种模式下相同。
与抢占的交互只在截断模式下出现。 前面已经讲过。这条不是 bug,但它要求所有对「确定性」有硬要求的路径显式避开截断模式。
CPU-GPU 无同步的约束仍然适用。 第二篇讲的 forbid_cuda_sync 守卫在落盘路径上同样有效——store 的触发不能引入同步点,否则 ZOS 的重叠就被破坏。
小结
把本篇的结论收拢。
为什么是两本账。 V4 的异构注意力让显存里同时存在两类性质完全不同的数据:长度无界、可跨请求复用、需要驱逐的「序列历史」(压缩条目),与长度有界、序列独占、无需驱逐的「序列状态」(SWA 窗口、未压缩尾部、压缩中间状态)。用一套结构管两者必然浪费或复杂化,所以 DeepInfer 劈成两本账:分页 KV 块账(块表 + 引用计数 + 3FS 持久化)与状态槽账(定长槽位 + 序列独占 + 内存/跨机取回)。这是一个「放弃通用性换简洁」的取舍。
三个尺寸从哪来。 推理侧 ring = 128 窗口 + 6 回退 = 134;落盘侧 ring = 134 + 128 extra + 134 YoCo keep = 396。6 这个余量同时承担投机解码回滚(需要 6)与 store 拷贝越界(最多 5)两个需求。396 只在 prefill 侧出现,因为「从任意 chunk 边界重排出对齐窗口」的需求只在那里存在。
两本账怎么配合。 前缀命中的四步算法:上限 → 查块表得 → 只在 里查 SWA → 有则命中 ,无则退一块命中 。这套规则的粒度是干净的:要么命中到最后一块,要么退一整块。
YoCo 截断的两种模式。 mask 只标记不搬(省计算),compact 物理搬运(省空间)。等价性的判据不是口头承诺,而是一个可执行的脚本 yoco_equiv.py + run_yoco_equiv_l2.sh,用 L2 距离在容许阈值内判定。截断与抢占的交互会带来结果变化,这是写在注释里的既定行为。
SWA Bounded Replay 的核心是一个 max。 把正常滑窗的 换成 ,其中 是重放起点。这个替换让重算段开头部分的窗口被截断,但截断的影响被限制在重算段内部——后续所有 query 需要的窗口都完整落在重算段里,所以是精确的。重算代价因此变成与上下文长度、层数都无关的常数。
两处重放的差异在产物去向。 Encoder 侧重建的 SWA KVCache 会进入缓存(支撑后续多次命中),且不覆写 Block KVCache;Decoder 侧重算的产出仅供本次 decode,不进前缀缓存(因为只覆盖末尾 128 个 token,复用价值低于持久化成本),收益是 prefill 计算量近乎减半。
Bounded Replay 让 Zero SWA Caching 变得可用。 论文侧的三档磁盘 SWA 策略(Full / Periodic / Zero)里,Zero 那一档听起来不可行——完全不存滑窗 KV。Bounded Replay 把「重算」从与上下文长度成正比降到常数,Zero 才真正成为一个可选项。DeepInfer 的实际部署介于 Full 与 Zero 之间(本机内存留存 + entrypoint 目录索引),Bounded Replay 是拿不到那份 KV 时的兜底。
下一篇按路线图讨论 MoE 专家并行与 EPLB:logical / physical expert 的放置算法、冗余专家的取整规则(为什么 prefill 每卡 4 个冗余起步、decode 每卡 1 个)、以及 DeepEP 的 dispatch / combine 在引擎侧如何组织。
参考资料
- DeepInfer 官方仓库(README 与功能清单)
- DeepSeek V4.1 Flash 推理部署 Q&A(官方 PDF,SWA KVCache、命中策略、重算方式、落盘对齐等章节)
- DeepInfer cache_engine.py(StateBlock 布局、KVCache 表形状、KV Cache Manager 分配与 finalize 校验)
- DeepInfer YoCo mask/compact 等价性验证脚本目录(README 与 run_yoco_equiv_l2.sh)
- DeepInfer yoco_equiv.py(L2 等价性比对实现)
- DeepInfer block_manager.hpp(分页 KV 块管理)
- DeepInfer scheduler.hpp(schedule 主流程与抢占处理)
- DeepInfer prepare_tensor_input_zos.py(输入构造与 seqlens 修正)
- DeepInfer v4_modules/yoco.py(YoCo 在模型层的实现)
- DeepInfer environ.py(全部 DEEPINFER_* 环境变量,含 YOCO / PREFILL_STORE_EXTRA / MAX_BACKTRACKING_TOKENS)
- DeepInfer 官方示例与 benchmark 口径说明
- DeepSeek-V4.1-Flash-1017 模型卡
- Together AI:Serving DeepSeek V4——为什么百万 token 上下文是推理系统问题(Shadow Radix 与 HiSparse 的社区实践)
- vLLM 官方文档:PagedAttention 与 KV Cache 管理
- SGLang 官方文档:RadixAttention 与前缀缓存
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



