


llama.cpp 源码完全拆解(十九):量化流水线——llama-quantize 如何给每张张量挑类型,imatrix 又如何改写块内量化
从「文件长什么样」到「文件是怎么造出来的」
前面几篇把 llama.cpp 的量化看得很细:GGUF 的文件布局与 k-quants 块位布局、mmq 的 GPU 矩阵编队、ggml-cpu 的量化点积。这些都回答了一个问题,也就是一个已经存在的量化模型文件,在推理时如何被装载、被乘、被还原。但文件本身从一个 fp16 或 bf16 的原始权重出发,经历了什么,还没有展开。一个 70B 级别的模型从 FP16 变成 Q4_K_M,中间要发生三件事:读进来的权重怎么被切成块、每个 32 或 256 元素的块用什么公式挑 scale 与 min、整个文件里七张不同角色的张量分别用几 bit。其中最后一件,也就是谁该多给几位、谁可以狠一点,是 llama.cpp 量化最有个性、也最容易踩坑的地方。
这一篇沿着三条源码线走:src/llama-quant.cpp(约 1500 行,决定「每张张量用什么类型」和「怎么流式写文件」)、tools/imatrix/imatrix.cpp(统计重要性矩阵)、ggml/src/ggml-quants.c(真正做块内量化的数学)。前半段是工程规则,后半段是数值算法,两者靠一个重要矩阵串起来。
三件套:llama-quantize、llama-imatrix 与 ggml-quants.c
先建立地图。量化在 llama.cpp 里不是一个函数,而是三个层次的协作:
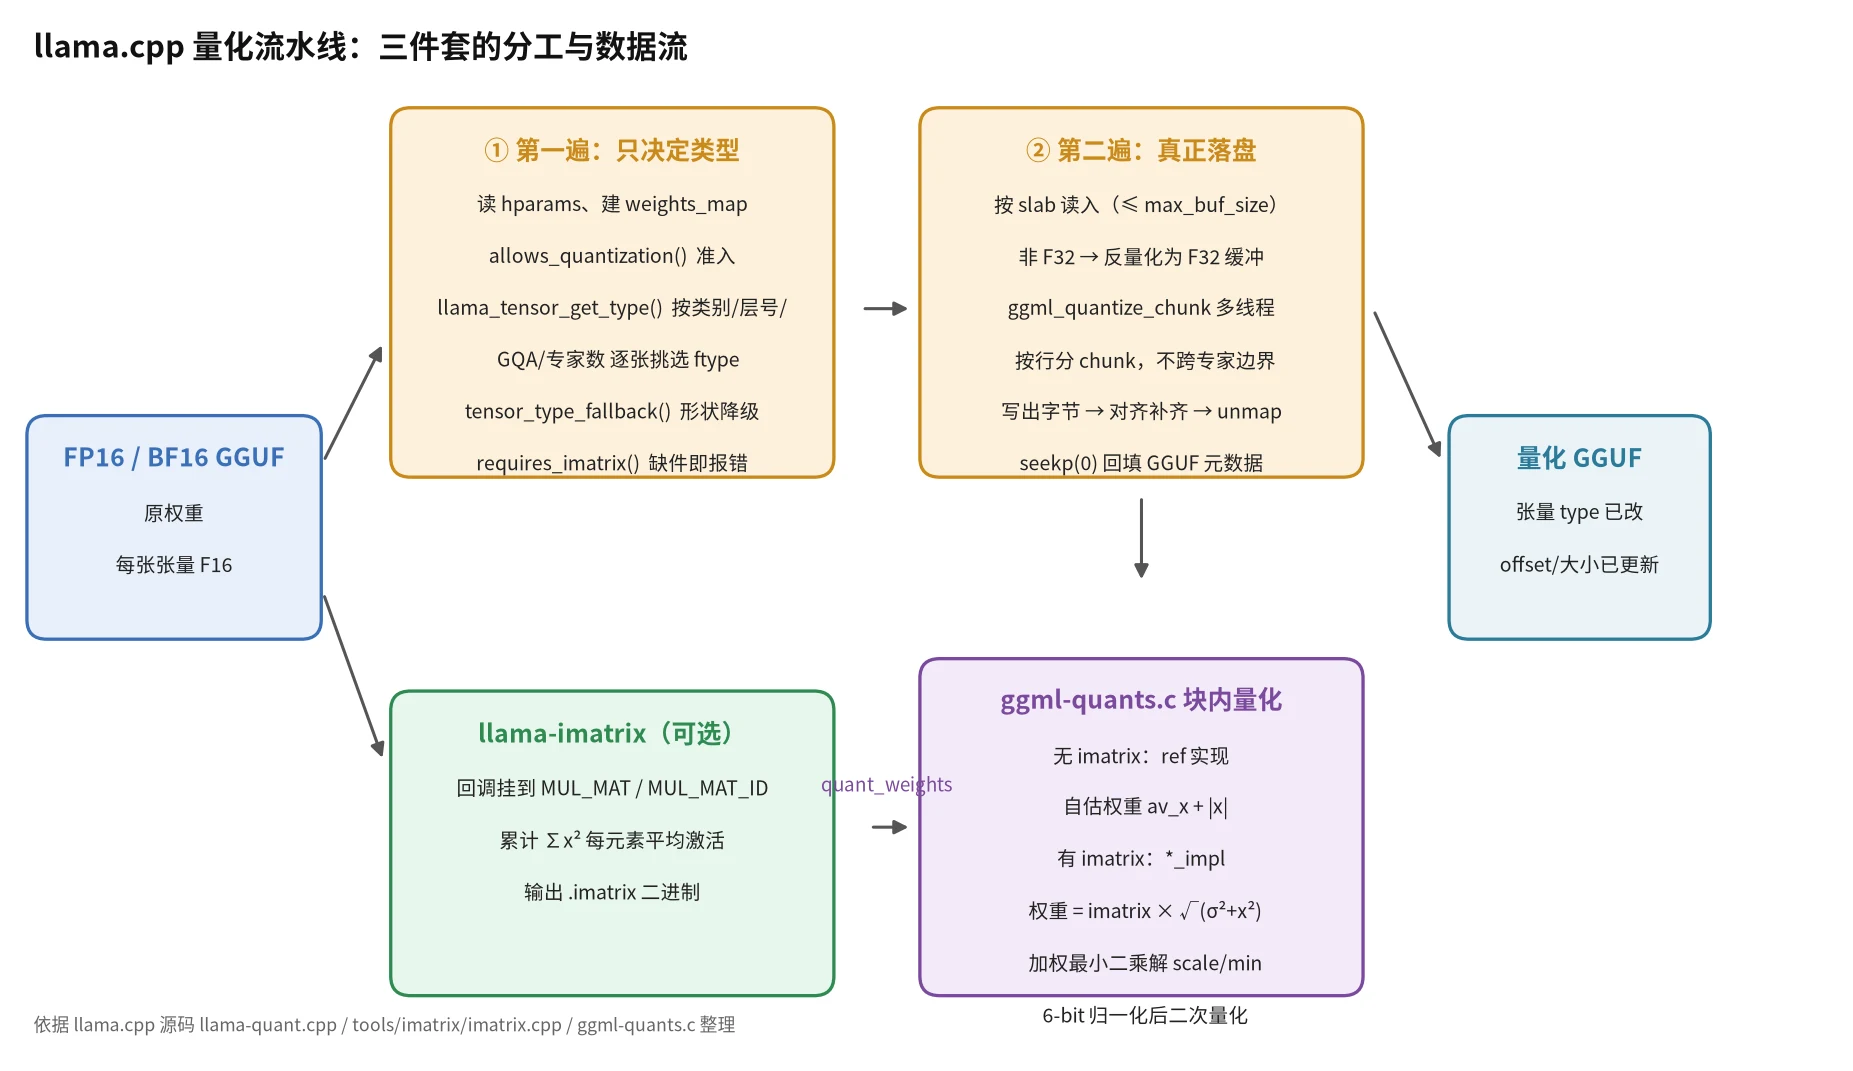
tools/imatrix对应llama-imatrix可执行文件。它加载一份 fp16 模型,在少量校准文本上跑几步前向,把每个矩阵乘的输入激活统计下来,写成二进制.imatrix文件。src/llama-quant.cpp对应llama-quantize。它先读入模型的超参数与张量清单,为每张张量决定目标ggml_type,再按行分片读原始权重、转成 f32、调用 ggml 的量化内核、流式写出新的 GGUF。ggml-quants.c提供quantize_q4_K这类入口。它有两个分支:没有 imatrix 时走「只看本块内的数值」的参考实现,有 imatrix 时走「按权重求加权误差最小」的实现。
这三件套的分工对应一个清晰的分层:类型选择是策略层,块内量化是数值层,imatrix 是把策略层的先验(哪些权重重要)带给数值层的中介。下文按这个顺序展开。
骨架:一次量化的五个阶段
llama_model_quantize_impl 是整个流程的主函数。把它压成伪代码后,结构非常清楚:
1. 打开输入文件,mmap 映射,但不复制张量数据2. 读超参数(层数、GQA 比例、专家数、是否共享 embedding)3. 建一张 weights_map:所有张量名 -> 文件偏移4. 第一遍:遍历张量,只决定类型 - allows_quantization(名字, 形状, 架构) ? - target_type = llama_tensor_get_type(...) - requires_imatrix(target_type) ? 若没提供就报错 顺带把每个 split 的 GGUF 元数据写在内存里5. 第二遍:遍历张量,真正落盘 - 按 max_buf_size 切 slab 读入 - 非 F32 的先反量化到 F32 缓冲 - 调 ggml_quantize_chunk,多线程按 chunk 分配 - 写字节,补齐对齐,unmap 释放6. 回填 GGUF 元数据头(文件开头先写 0 占位)并关闭文件两个细节值得停下来看。第一,类型选择与数据搬运被刻意分开。第一遍只需要张量的形状和名字,不碰数据;第二遍拿到的 metadata[i].target_type 是第一遍算好的结果,直接使用。这样做的好处是 --dry-run 能几乎零成本地报出每个张量会变成多少 MiB,也让「缺少 imatrix」这类致命错误在写任何字节之前就抛出。
第二,文件头采用「先占位后回填」。GGUF 的元数据在前、数据在后,但张量的最终大小要等量化完才知道,于是 new_ofstream 先写一段全零占位,末尾 close_ofstream 再 seekp(0) 把元数据覆盖上去。这条设计在下一篇之外没什么可讲,但它解释了为什么量化中途被杀掉会留下一个头部全零、无法加载的半成品文件。
GGUF 完全拆解里已经详细讲过这样生成的文件如何被解析。这里只需要记住:量化输出仍然是一个合法 GGUF,只是每个张量信息表里的 type 字段和 offset 字段被改成新的。
第一遍:哪些张量根本不让量化
tensor_allows_quantization 是整条流水线最长的 if 链之一。它的逻辑可以归纳成一条原则:只有大的二维以上矩阵乘权重才值得量化;小块、查找表、逐元素权重、对数值敏感的部件一律保持原类型。
几类典型拒绝:
- 维度小于 2 的张量不量化。RMSNorm 的权重、LayerNorm 的权重都是一维向量,量化后每个块只有一个 scale 会让相对误差爆炸。
- 名字不以
weight结尾的张量不量化。这层过滤几乎覆盖了所有非权重张量,比如位置索引、RoPE 缓存。 _norm.weight显式排除。有些架构的 norm 权重是二维的分组形式,维度检查拦不住,需要按名字补一刀。ffn_gate_inp.weight(MoE 路由门控)不量化。专家分配是离散决策,量化误差会直接改变路由结果,这是 MoE 量化里最脆弱的部位之一。ffn_gate_tid2eid.weight是整数查找表,量化没有意义。engram_gate.weight做逐元素乘法而不是矩阵乘,不属于大矩阵。- 小型投影(
per_layer_model_proj、MiniMax 的indexer.*_proj、attn_gate.weight、*_q_a/*_q_b这类低秩分解)在多个架构上都被显式保护。 - Mamba/SSM 的
ssm_conv1d、视觉编码器里的patch_embd、patch_merger、音频编解码器a.conv1d.*都不量化,理由各不相同:有些是卷积核需要完整精度,有些是码本输出对量化极其敏感。
这张名单会随着新架构不断补丁,代码注释里能看到很多「TODO:换成按类别判断」。读它的正确方式不是背名单,而是理解背后的三条判据:维度是否足够大、量化误差是否会进入离散决策、是否参与矩阵乘。三条都满足才允许量化。
第一遍:llama_tensor_get_type 的优先级链
通过了准入检查,下一层是决定目标类型。这里的函数调用链分三段:
llama_tensor_get_type外层:先处理用户显式指定的--token-embedding-type、--output-tensor-type、--tensor-type正则覆盖,然后处理「纯量化模式」(--pure,跳过所有 ftype 调优),最后调用内核。llama_tensor_get_type_impl内核:这是 ftype 规则的真正所在。tensor_type_fallback:如果目标类型的块大小与张量第一维不能整除,逐级降级。
外层的第一优先级是用户指令。--tensor-type 接受 attn_q=q8_0 这种写法,在 quantize_state_impl 构造时编译成正则,每次匹配一次。匹配成功就跳过内核,但仍然会经过 fallback,因为用户也不一定能保证维度一致。--pure 则相反,让每张能量化的张量都用 ftype 的默认类型,不做任何按层、按类别的调整,多用于生成「纯净」的对比基准。
内核对 ftype 的细分,是 llama.cpp 量化最像「手工调参」的部分。它的骨架是三层:
if (是 output 或共享 embedding) { 用 output_tensor_type,或者对低比特 ftype 抬到 Q5_K/Q6_K} else if (ftype == MXFP4_MOE) { 专家张量 -> MXFP4,其余 -> Q8_0} else if (是 token embedding) { 低比特 ftype 下用 Q2_K / IQ3_S / Q4_K} else if (是极低比特 ftype: IQ1_S/IQ2_XXS/IQ2_XS/IQ2_S/IQ1_M) { 按 GQA 比例、专家数、张量类别给不同张量分配「豁免位」} else if (是 attn_v/attn_qkv/attn_kv_b) { 不同 ftype 下给几种 Q*_K,GQA >= 4 的一律 Q4_K 70B 模型单独抬到 Q5_K 8 专家模型单独抬到 Q8_0} else if (...) { 按张量类别 }为什么输出层与 embedding 几乎总是特殊对待?这是量化里公认的现象:输入嵌入和 lm_head 直接映射词表,一点误差会被 softmax 放大成分布漂移。llama.cpp 的做法是:对 Q4_K_M 这类中档 ftype,输出层至少给 Q6_K;对 IQ1/IQ2 这类极限压缩,输出层反而给 Q5_K——因为总预算已经低到极限,此时「多给输出层几位」是性价比最高的一刀。共享 embedding 的模型(token_embd 与 output 共用权重)跟 output 一起走,否则会出现一个张量被算两次的矛盾。
为什么 GQA 比例会影响 attn_v 的类型?n_gqa() >= 4 意味着 K/V 头的数量远少于 Q 头,attn_v.weight 在物理上被多个 Q 头共享,体积相对小。按 70B 那段注释,8 个 Q 头共享一份 V 权重,V 张量只有 Q 的八分之一。既然体积小,多给几位对总大小的影响可以忽略,却直接提升每个 V 头的精度。--pure 之外的规则本质都是同一件事:按字节收益排列优先级。
再看 use_more_bits:
auto use_more_bits = [](int i_layer, int n_layers) -> bool { return i_layer < n_layers/8 || i_layer >= 7*n_layers/8 || (i_layer - n_layers/8)%3 == 2;};这个三元组是 k-quants 系列里流传最广的经验规则。它把层分三段:最前和最后的各 1/8 层被保护,中间部分每三层保护一层。前段靠近输入,后段靠近输出,误差在后段容易被放大;中间层则「每三选一」做轮换保护。这条规则从早期 k-quants PR 一直沿用到今天,不同 ftype 在 attn_v 与 ffn_down 分支里都调用它,只是抬升的档位不同。
fallback:块大小与形状不兼容时怎么办
tensor_type_fallback 处理一个朴素但现实中常出现的问题:k-quants 要求第一维(行内元素数)能被块大小整除,Q*_K 要求 256 整除,Q4_0/Q4_1/Q5_0/Q8_0 要求 32 整除。形状不满足的权重(比如某些视觉编码器的小投影,第一维 24 或 100)不能按目标类型存。
代码的处理方式是硬编码一张降级表:
| 目标类型 | 降级到 |
|---|---|
| IQ1_S / IQ2_XXS / IQ2_XS / IQ2_S / IQ3_XXS / IQ3_S / IQ4_XS | IQ4_NL |
| Q2_0 / Q2_K / Q3_K / TQ1_0 / TQ2_0 | Q4_0 |
| Q4_K | Q5_0 |
| Q5_K | Q5_1 |
| Q6_K | Q8_0 |
| 其余 | 若是 32 块类型,退到 F16 |
两个设计点值得讲清楚。第一,降级是往上抬,不是往下压。Q4_K 掉到 Q5_0 反而多了 1 bit,看起来是亏了,但对单张「不兼容」的小张量来说,多 1 bit 的代价远小于整张留 F16。第二,降级表必须保持块大小能整除。Q4_K 降 Q5_0 的原因是 Q5_0 也是 32 块;如果把 Q4_K 直接降到 Q4_0(同为 32 块)似乎也行,代码却选了 Q5_0,理由是 Q4_K 的两层 scale 精度更高,简单降到 Q4_0 会在这张「本来就不兼容」的张量上再丢一次精度。这类细节都写在注释里,是维护者长期调出来的经验。
降级后仍然不整除(极罕见,第一维不是 32 的倍数),最后落到 F16 并打一条警告。qs.n_fallback 会在结束时汇总,用来提示「有 N 张张量被迫降级」。一个常被忽略的点是:这些 fallback 张量只占模型很小一部分,却会让最终 BPW 略高于标称值,评估量化效果时应以实际 BPW 为准。
imatrix 要求:极低比特为什么必须要它
tensor_requires_imatrix 判断目标类型是否必须依赖重要性矩阵。它和 ggml_quantize_requires_imatrix 的结论一致:IQ2_XXS、IQ2_XS、IQ1_S 这几种必须带,部分 IQ 类型在有 imatrix 时质量明显更好。
原因在第二遍代码里写得很直白:
LLAMA_LOG_ERROR("Missing importance matrix for tensor %s in a very low-bit quantization\n");LLAMA_LOG_ERROR("The result will be garbage, so bailing out\n");throw std::runtime_error(...);IQ1/IQ2 的表示能力只够表达「这一行里相对重要的几个元素」,如果没有激活统计告诉它哪些位置重要,普通量化会按数值大小平均分配精度,结果就是这些超低比特格式对语言模型来说几乎不可读。llama.cpp 干脆把它设成强制项:不给 imatrix 就报错,而不是静默生成一个看着能加载、实际不能用的文件。这一点是防御式设计:宁可让用户在量化阶段失败,也不要让用户花几个小时下载一个废文件后才发现。
第一遍:preliminary 循环在统计什么
第一遍对每张张量做的事不止挑类型,它还维护了几个计数器:n_attention_wv、n_ffn_down、n_ffn_gate、n_ffn_up,以及对应的「已经处理到第几张」的 i_*。原因藏在 GQA 分支与 use_more_bits 里:它们需要知道「当前是第几层」。对稠密模型,张量在文件中按层排列,用计数器 / 总数就能推层号;但 MoE 模型的专家张量并不连续,Mixtral 的专家权重是零散穿插的,因此 layer_info 对 MoE 模型改为解析张量名 blk.%d.。这段代码注释是作者自己踩坑的记录,也是一份读源码时常见「计数器不可靠」的提醒。
第二遍:流式量化与分片调度
主循环的核心是「按 slab 读入、按 chunk 分给线程」。llama_tensor_quantize_impl 里有两个很值得学的工程决策:
第一,分块单位选的是行,而且按全局行号跨专家切分。注释写得很清楚:
// quantize rows [first_row, first_row + nrows), indexed globally across all expert matrices// note: chunks never cross an expert boundary since each expert has its own imatrix sliceMoE 专家的张量在 GGUF 里是三维修约的(ne[0] 是行内元素,ne[1] 是每专家行数,ne[2] 是专家数)。imatrix 是按专家各自存一份的,因此每个线程处理的工作单元必须落在同一个专家范围内,否则会用错权重。代码用 nrows_per_expert - row_global % nrows_per_expert 截断,保证线程永远不跨专家。
第二,chunk 大小至少 32 * 512 个元素,但不跨行。当行内元素不足 16K 时,一个 chunk 打包多行;行更长时,一个 chunk 就是一行。这样既保证了并行度(小张量也能分给多线程),又让每行的行内公式(scale、min)不会因为线程切分而错乱。
另外,写入磁盘后再 ml.unmap_weight(weight),逐张量释放 mmap 页。这让量化大模型时的内存峰值主要由 slab 缓冲决定,而不是整个模型。max_buf_size 默认 8 GiB,单 tensor 太大也会被自动切成 slab。
块内量化:一个 32 元素块的极简起点
数值层从最简单的 Q4_0 看起:
// 每 32 个元素一个块,一个 fp16 scale dfloat amax = 0.0f, max = 0.0f;for (j = 0; j < qk; j++) { if (amax < fabsf(x[i*qk + j])) { amax = fabsf(x[i*qk+j]); max = x[i*qk+j]; }}const float d = max / -8;const float id = d ? 1.0f/d : 0.0f;for (j = 0; j < qk/2; ++j) { const uint8_t xi0 = MIN(15, (int8_t)(x0 + 8.5f)); // x0 = x[j] * id const uint8_t xi1 = MIN(15, (int8_t)(x1 + 8.5f)); y[i].qs[j] = xi0 | (xi1 << 4);}d 取绝对值最大的元素除以 -8,意味着最绝对值大的元素恰好被映射到 -8,其余按 x*id 落在 [-8, 8] 附近,加 8.5 后取整并截断到 [0, 15]。用 +8.5 而非 +8 是为了四舍五入而非向下取整,MIN(15, ...) 则兜住略超范围的值。这个公式是「对称量化 + 单块极值 scale」,优点是简单、快,缺点是 32 个元素共用一个 scale,块内有离群值时其余元素全部被压向 0,精度损失明显。
Q4_1 改进为「非对称量化」:块内取 min 和 max,d = (max-min)/15,另存一个 fp16 的 m = min,还原时 x ≈ L*d + m。这样能表达任意区间,代价是每块多 2 字节。Q5_0/Q5_1 同理,只是多了 1 bit 和一个专门的第 5 位数组 qh。
这些 32 块格式之所以今天还存在,主要因为老 llama.cpp 量化模型仍在流通,以及 IQ4_NL 降级路径会落回它。真正主力是 k-quants 的 256 块格式。
k-quants 的块内:先对子块求 scale,再统一编码
Q4_K 的结构在前一篇已经讲过:一个 256 元素超级块,8 个子块每块 32 元素,每子块有独立的 6-bit scale 和 6-bit min,外加超级块级 fp16 d 与 dmin。这一篇要看的是:这些子块的 scale 和 min 是怎么算出来的。
for (int j = 0; j < QK_K/32; ++j) { float sum_x2 = 0; for (int l = 0; l < 32; ++l) sum_x2 += x[32*j + l] * x[32*j + l]; float av_x = sqrtf(sum_x2/32); for (int l = 0; l < 32; ++l) weights[l] = av_x + fabsf(x[32*j + l]); scales[j] = make_qkx2_quants(32, 15, x + 32*j, weights, L+32*j, &mins[j], Laux, -1.f, 0.1f, 20, false);}三个量需要解释:
av_x = sqrt(mean(x²))是该子块的均方根振幅。它让每个元素的权重至少包含「块的整体强度」,避免一个几乎全零的子块因某个小离群点而被过度重视。weights[l] = av_x + |x[l]|是「局部重要度」的近似。这只是量化器在没有 imatrix 时的自估,远不等于真实对输出的重要度——这正是 imatrix 要补的那一块。make_qkx2_quants(n, nmax, x, w, ...)在给定权重下,找一个 scale 和 min 使得加权误差平方和最小。它的搜索策略是:从 (max, min) 出发做初始量化,然后在nstep次中,把 scale 的候选往iscale = (rmin + rdelta*is + nmax)/(max-min)的方向线性扫一遍,每次用加权最小二乘闭式解出(this_scale, this_min)。
闭式解的那两行值得推导一下。设每块有一个「量化档位」,候选的 scale 为 、min 为 ,目标是最小化加权误差:
对 和 分别求偏导并置零,得到正规方程:
记 ,,,,,则分母 ,解为:
代码里的 D > 0 检查、this_min > 0 时改为 this_min = 0, this_scale = S_xl/S_l2(对称退化)都直接来自这个解。当 (所有 相同,权重退化)时闭式解失效,跳过一次即可。这里的 use_mad 参数为 false,即衡量平方误差,与推导一致;某些格式用绝对误差时会传入 true。
这就是 make_qkx2_quants 的全部:先粗量化得到档位 ,再把 当作固定量用加权最小二乘反解 scale 和 min,最后比较加权误差决定是否采纳。nstep=20 表示扫描 21 个候选 scale,rmin=-1, rdelta=0.1 表示扫描从 (-1 + 15)/(max-min) 到 (1 + 15)/(max-min),即 14 到 16 倍 max 的范围——量化档位固定为 15 级时,最优 scale 通常略偏离「max/15」,这个范围是经验值。
得到 8 个子块的 scale 与 min 之后,代码把它们统一归一化到 6-bit:inv_scale = 63.f/max_scale,inv_min = 63.f/max_min,每子块存 round(inv_scale * scales[j])。之后再用归一化后的 6-bit scale 重新量化每块,保证编码时用的 scale 就是解码时会用的 scale。这个「两轮量化」很关键:子块 scale 与超级块 d 一旦落进 6-bit,便不是原来的浮点值,若仍用浮点值算块内档位,解码误差会与估算误差叠加。
imatrix 如何进入块内量化
有了上面的基础,imatrix 的作用可以一句话讲清楚:它替换了 make_qkx2_quants 里那个自估的 weights[l]。
看 quantize_q4_K 的分支:
size_t quantize_q4_K(const float * src, void * dst, int64_t nrow, int64_t n_per_row, const float * quant_weights) { size_t row_size = ggml_row_size(GGML_TYPE_Q4_K, n_per_row); if (!quant_weights) { quantize_row_q4_K_ref(src, dst, (int64_t)nrow*n_per_row); } else { ... quantize_row_q4_K_impl(src, (block_q4_K*)qrow, n_per_row, quant_weights); }}quant_weights 就是这一行的 imatrix 数据。在有它时,quantize_row_q4_K_impl(与 ref 共享绝大部分逻辑)把 weights[l] = av_x + |x[l]| 换成「imatrix 值 × 本行激活 RMS 因子」。以 Q4_1 的实现为例:
for (int j = 0; j < n_per_row; ++j) sum_x2 += x[j]*x[j];float sigma2 = sum_x2/n_per_row;for (int j = 0; j < QK4_1; ++j) weight[j] = qw[j] * sqrtf(sigma2 + xb[j]*xb[j]);qw[j] 是 imatrix 存的值(在 imatrix 工具里是 的累计),sqrtf(sigma2 + xb[j]*xb[j]) 是行的整体强度乘以该元素的局部强度。两者相乘形成一个「全局重要度 × 局部重要度」的权重。这个乘积的形状在代码里出现于几乎所有量化器的 impl 版本——Q4_0、Q4_1、Q5_0、IQ4_NL——说明它是 llama.cpp 对「重要性」的统一表示。
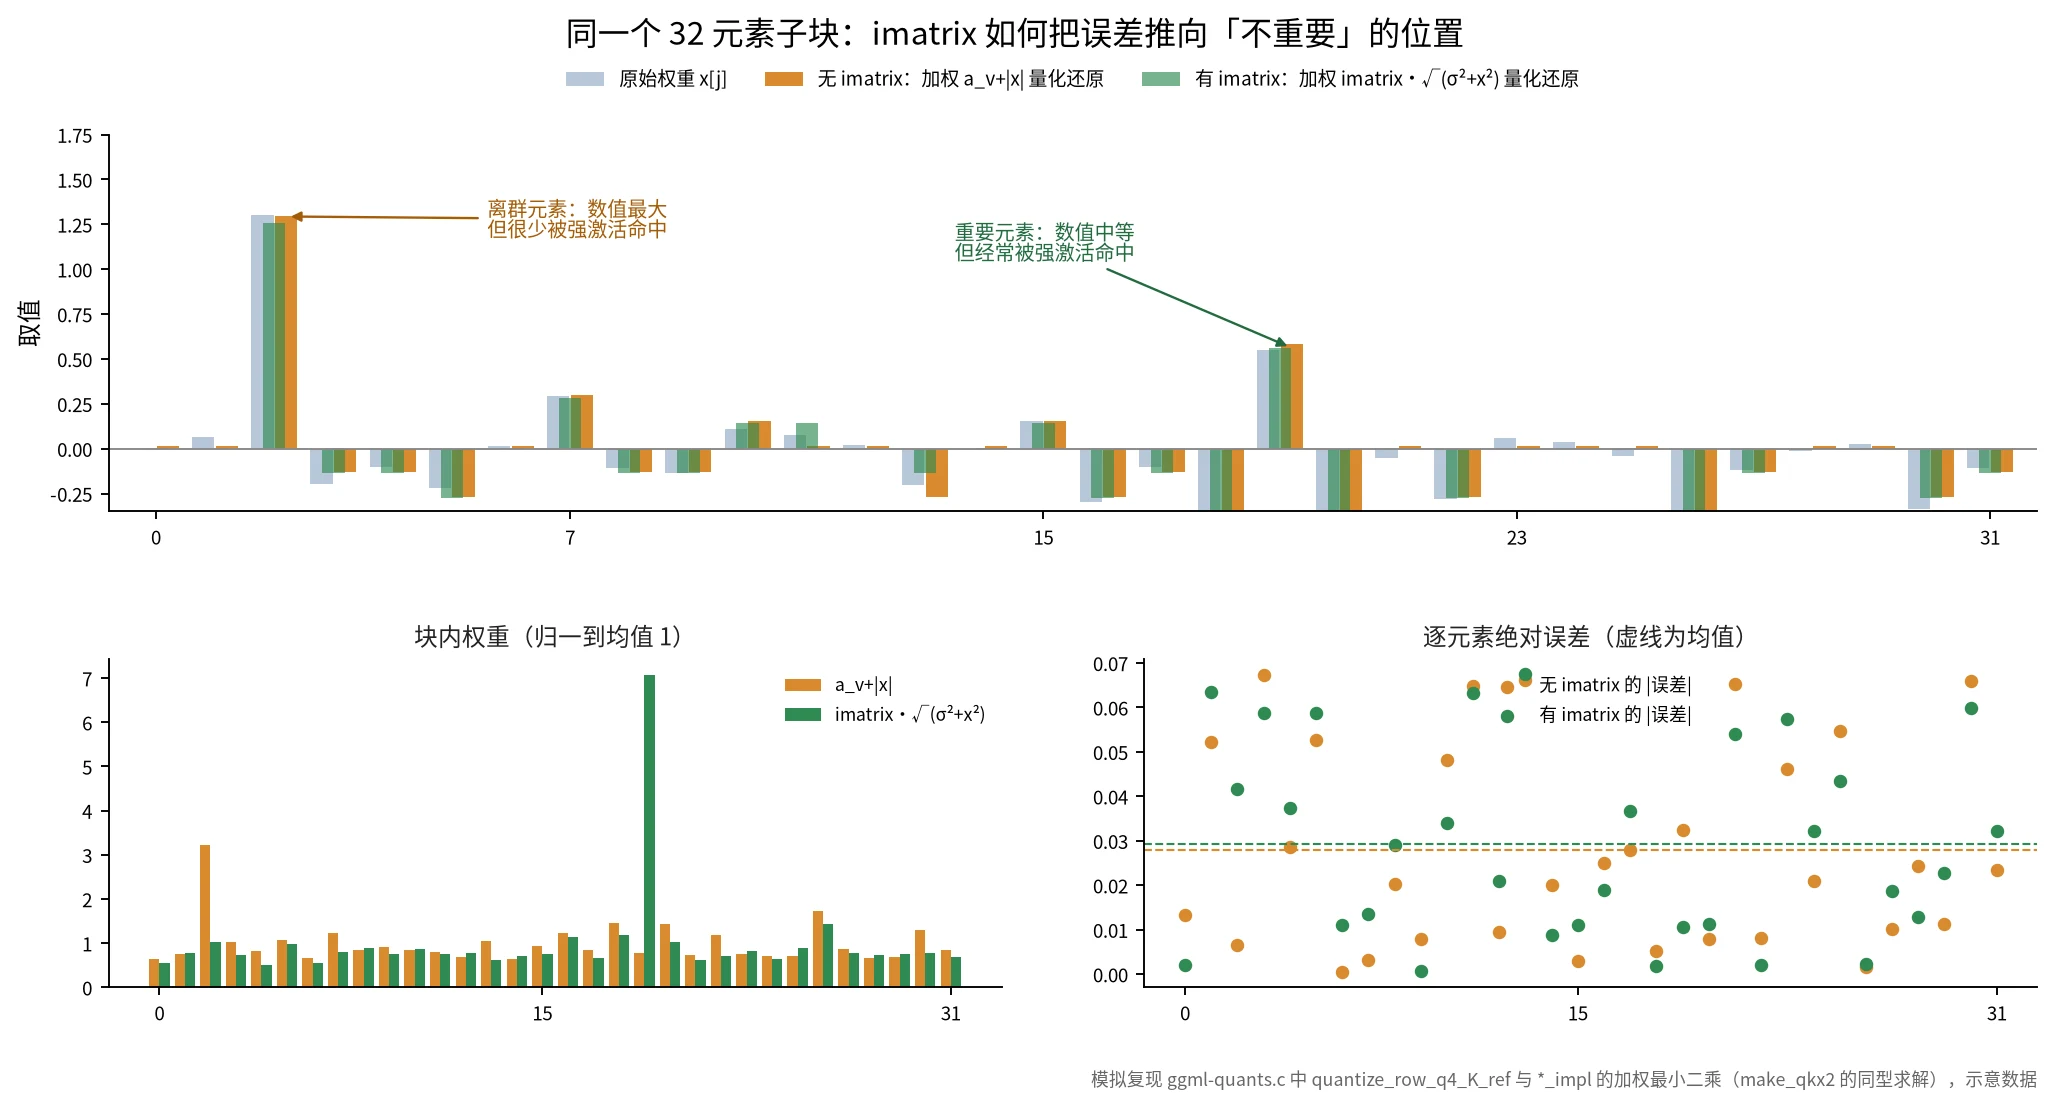
一个 32 元素子块里,如果没有 imatrix,量化器按 av_x + |x| 给所有元素差不多的权重,离群的那一个会主导 scale,其余元素被压得很粗。有 imatrix 时,权重由激活统计决定:一个在训练或推理中很少被大激活命中的位置,即便数值不小,也可以被分配很低的权重,允许它有更多量化误差;反过来,一个数值不大、但经常被很强激活命中的位置,会被保护得更精细。这正是「权重绝对大小」和「对输出的影响」两种衡量方式的区别。
imatrix 是怎么统计出来的
imatrix.cpp 的实现思路是「挂一个回调到计算图里」。llama.cpp 的 ggml 后端有一个可插拔的 ggml_callback 机制:每个算子在执行前会先被问一次「你要不要这个结果」。IMatrixCollector::collect_imatrix 实现这个回调:
if (ask) { if (t->op == GGML_OP_MUL_MAT_ID) return true; // MoE 专家矩阵乘 if (t->op != GGML_OP_MUL_MAT) return false; // 只关心矩阵乘 if (src1->ne[1] < 16 || src1->type != GGML_TYPE_F32) return false; const bool is_output = wname == "output.weight" || wname == "token_embd.weight" || wname == "nextn.post_projection.weight"; if (!(wname.substr(0,4) == "blk." || (process_output && is_output) || (load_mtp && is_nextn))) return false; return true;}这里 src0 是权重,src1 是激活(MUL_MAT 的右乘输入)。它只统计 blk. 开头的矩阵乘,默认不统计输出层和 token_embd(--process-output 才开),因为这两张权重太大、统计收益有限,且它们本来就已被类型选择保护。src1->ne[1] < 16 过滤掉小行数——解码阶段每次只算 1 行,统计没有意义,imatrix 工具跑的是批量前向,每步喂满一个 chunk。
真正的累计只做两个加法的平方:
const int64_t ne0 = src1->ne[0];for (int64_t i3 ...; i2 ...) { float * acc = e.values.data() + mat_id * ne0; for (int64_t row = 0; row < src1->ne[1]; ++row) { const float * x = ...; for (int64_t j = 0; j < ne0; ++j) acc[j] += x[j] * x[j]; }}每个权重元素对应一个标量 acc[j],它累计的是「所有命中这个元素的激活平方」。同时有一个 act[j] += x[j] 的激活和,用于计算均值(use_activations 模式)。保存时归一化成「平均每 chunk 的值」:
tmp[i] = (value / count) * static_cast<float>(ncall);ncall 是已处理的 chunk 数,count 是该矩阵对应的激活行数。除以 count 得到平均平方激活,乘以 ncall 是为了让所有矩阵的数值量级可比。所以 imatrix 存的不是一个概率,而是平均激活能量的近似。这也解释了为什么在量化时还要再乘行 RMS:imatrix 的绝对值只有相对意义,绝对量级会随模型层、chunk 大小而变。
MoE 的处理稍复杂。GGML_OP_MUL_MAT_ID 的 src2 是路由 ids,形状 [topk, n_tokens];src1 是激活,形状 [cols, topk, n_tokens]。每个专家有自己的统计切片,代码用一个 touched 标记数组判断某专家在这一个 chunk 里是否被选中,未选中的专家不做非有限值检查,避免误报。这背后的设计约束是:一个稀疏专家可能在很长一段校准语料里从未被激活,不应因为它「没被激活过」而被错误地标记为坏数据——这类专家在量化时自然拿到默认权重。
imatrix 文件格式与版本
保存逻辑在 save_imatrix 里。最终格式很简单,按顺序写:
int32 n_entriesrepeat n_entries: int32 name_len char name[name_len] int32 ncall # 该矩阵在统计中被调用的 chunk 数 int32 nval # 数据元素个数 float vals[nval] # 已归一化的逐元素平均激活int32 m_last_chunk # 统计结束时共处理了多少 chunkint32 dataset_lenchar dataset[dataset_len]nmat 字段(每矩阵的专家数)在新版实现里并没有写进文件,读端根据名字和模型超参数推断。一个常见的坑是在不同版本的 llama-imatrix 之间混用文件——早期格式直接保存累计值不归一化,新版归一化后读入端会自动按 ncall * chunk_size 换算。llama.cpp 在旧格式兼容上做了不少处理,具体可以看 quantize.cpp 里的 load_imatrix。
这里也可以解释为什么 MoE 模型中 imatrix 文件会很大:一个 MoE 模型的专家矩阵数量是稠密模型的几倍,每个专家有一份独立的激活统计。若模型有 256 个专家、60 层、每层两张专家权重,imatrix 文件大小可达稠密模型的十几倍。实际使用中常见做法是对 imatrix 也做逐层检查,只保留真正的 blk.*.ffn_*_exps 部分。
完整的一次 imatrix 工作流
把一个 Qwen 级别的稠密模型做成 Q4_K_M + imatrix,实际命令大致如下:
# 1. 把模型转成 gguf(这里假设已经是 F16 gguf)# 2. 统计重要性矩阵llama-imatrix \ -m model-f16.gguf \ -f calibration.txt \ -o model.imatrix \ --chunks 200 \ --ctx-size 512 \ --threads 16
# 3. 量化,带 imatrixllama-quantize \ --imatrix model.imatrix \ --output-tensor-type q6_k \ --token-embedding-type q6_k \ model-f16.gguf model-Q4_K_M.gguf Q4_K_M
# 可选:先看一眼每种类型的张量占比llama-quantize --dry-run model-f16.gguf model-dry.gguf Q4_K_M--chunks 是校准语料的 token 总数除以 chunk 大小后的上限,常用 100-500 之间。太小统计噪声大,太大则时间线性增长;对多数 7B-30B 模型,200 chunk 已经足以让各层的激活平均稳定。--ctx-size 影响 chunk 大小,从而影响 imatrix 中 ncall 的口径,但相对误差不受影响。
校准语料的选择比参数更重要。llama-imatrix 的默认 calibration.txt 是 llama.cpp 提供的通用文本;对于中文或代码类模型,用对应领域的语料统计效果更好,这是因为 imatrix 的本质是「这个模型在实际会被喂什么样的激活」。没有行业语料时,WikiText-2 这类通用文本足以避免灾难性失准,但专门把某些稀疏部件的权重全部用通用文本统计,等于给了不相关的先验。
几个常见坑与判据
为什么带着 --imatrix 也会有时报错「did not find weights」? 主循环里:
if (it->second.size() == (size_t)tensor->ne[0]*tensor->ne[2]*tensor->ne[3]) imatrix = ...else if (!tensor_name_match_token_embd(tensor_name)) throw ...imatrix 的 nval 必须恰好等于 ne[0] * ne[2] * ne[3],即「行内元素 × 专家数(稠密张量时为其他维度的乘积)」。这个等式不成立的原因通常是:imatrix 是用另一个版本的模型统计的、或模型经过 --prune-layers 后层号重映射但 imatrix 未重映射。代码对 token_embd 放行,因为共享 embedding 在部分模型里会被特殊处理,其余一律报错。
--allow-requantize 是什么时候需要? 当输入文件已经是量化格式(比如 Q5_K 想再压成 Q4_K),默认会拒绝二次量化,因为浮点→量化的误差会叠加。仅在用户明确知道输入是较高精度的量化(如 Q8_0 或 FP8)时才开启。
--keep-split 与 split 文件 适用于模型已按层分片的情况,代码会按输入的 split 编号排序并分别写多个输出文件,元数据里保留 split.* 字段。这个选项与 imatrix 互斥程度不高,但需要 imatrix 本身来自同一分片方案。
量化结果怎么判断好不好? llama.cpp 的常用口径是困惑度(PPL):用同一份 wikitext 在 F16 模型和量化模型上分别跑,对比 PPL 增幅。BPW(bits per weight)从日志最后两行即可读出:
llama_model_quantize_impl: model size = 13 400.00 MiB (16.02 BPW)llama_model_quantize_impl: quant size = 4 050.00 MiB (4.84 BPW)4.84 BPW 高于 Q4_K_M 的标称 4.5 BPW,就是因为有输出层、embedding 和张量形状降级占了更高的位数。理解这个差异,才能把「我到底拿到了多少量化」说清楚。
把这一篇放回 llama.cpp 系列
到现在为止,llama.cpp 系列已经覆盖:整体架构、ggml 计算图与分配器、GGUF 装载与 mmap、llama_context 与 KV、采样与语法、图构建与注意力、后端与 GPU kernel、server 调度、投机解码、多模态、嵌入重排、对话模板、CPU mul_mat、mul_mat_vec_q、MMQ、LoRA、RPC、slot 与 prompt cache,再加上这篇量化流水线。量化是 llama.cpp 与其他推理框架差别最大的一块:vLLM 和 SGLang 的量化更多依赖 FP8/INT8 的 GPU Tensor Core 路径和 AWQ/GPTQ 等离线方法,llama.cpp 则把「端侧能跑的最大模型」作为目标,开发出 k-quants 和 IQ 系列,并配套了类型选择与 imatrix 两个工程层。
与站内的 AWQ 完全拆解 和 GPTQ 完全拆解 相比,llama.cpp 的 imatrix 在思路上更接近 AWQ 的「激活重要度」,但实现手段完全不同:AWQ 用激活重要度决定每通道的放大倍数后做静态 scale,imatrix 用激活重要度改写块内量化的加权损失。前者影响的是整体尺度,后者影响的是每个元素的近似方向。
下一篇回到 TensorRT-LLM 系列,讨论它如何把 MoE 的专家并行和层间负载均衡组织成一次可重叠的 GPU 前向。
小结
量化流水线可以压缩成四句话:
- 准入:只量化大的矩阵乘权重,逐元素、查找表、稀疏决策门控、小而敏感的投影保持原类型。
- 策略:按张量名和类别、层号、GQA 比例、专家数,在 ftype 规则上做手工加减,核心是最前最后 1/8 层和中段每三层一次的保护。
- 数值:块内量化从「极值 scale」演进到「子块加权最小二乘 scale」,并做两轮量化保证编码和解码的 scale 一致。
- 先验:imatrix 用校准前向统计每元素的平均激活能量,替换块内量化器的自估权重,使误差集中在很少被激活的位置。
理解这四层之后,再看任何一条 llama-quantize 的命令或日志,都能对应到具体的源码行号。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



