


llama.cpp 源码完全拆解(二十):分词器与词表——llama_vocab 如何把字节、BPE 与 SPM 收进同一套编解码接口
从 llama.cpp 的源码地图里补上一块地基
前面十九篇沿着一次前向和一条请求把 llama.cpp 走了一遍:图构建、KV 缓存、采样、server 的 slot 调度、量化、LoRA、RPC,乃至 ggml-cpu 与 ggml-cuda 的量化内核。所有这些路径共用一个起点——一串文本必须先被切成一串整数 token,模型与 GPU 才开始干活;生成结束后,吐出来的整数还得被拼回人能读的文字。这正是 src/llama-vocab.cpp 的工作。
这一篇专门拆词表层。它看起来像「外围工具」,但恰恰是很多线上问题最集中的地方:把 UTF-8 文本切成 token 时多出一个空格、chat template 拼出来的 BOS 被加了两次、某个 emoji 被拆成四个字节 token 后模型开始胡言乱语、工具调用里模型只吐 JSON 片段却拿不到整句。这些问题的答案都在词表里。模板那一层如何把消息拼成字符串,可参考 llama.cpp 源码完全拆解(十二):对话模板与消息解析;采样器最终输出的是 token id,它依赖的属性定义就在本文这一层,可对照 llama.cpp 源码完全拆解(五):采样管线与语法约束。
先把这篇要建立的主线摆出来:
- llama_vocab 不是一个分词算法,而是一个「类型 + 属性 + 编解码接口」的容器。模型文件里存一个
tokenizer.ggml.model字符串,加载时被映射成llama_vocab_type枚举;所有编码、解码入口都只认这一层接口。 - 不同分词器实例被收进同一个虚基类
llm_tokenizer,但真正干活的是每次调用新建的*_session对象。所谓「同一套接口」,统一的是入口函数llama_vocab::impl::tokenize()与detokenize(),而不是内部算法。 - 字节是三种主流分词器之间的公共地基:SPM 用
<0xNN>字节级回退,BPE 用 GPT-2 字节到 Unicode 映射表(或同样的<0xNN>)保证任意字节都能表示,WPM 则干脆在词表外吐 UNK。理解了字节这一层,才能看懂解码为什么比编码绕。
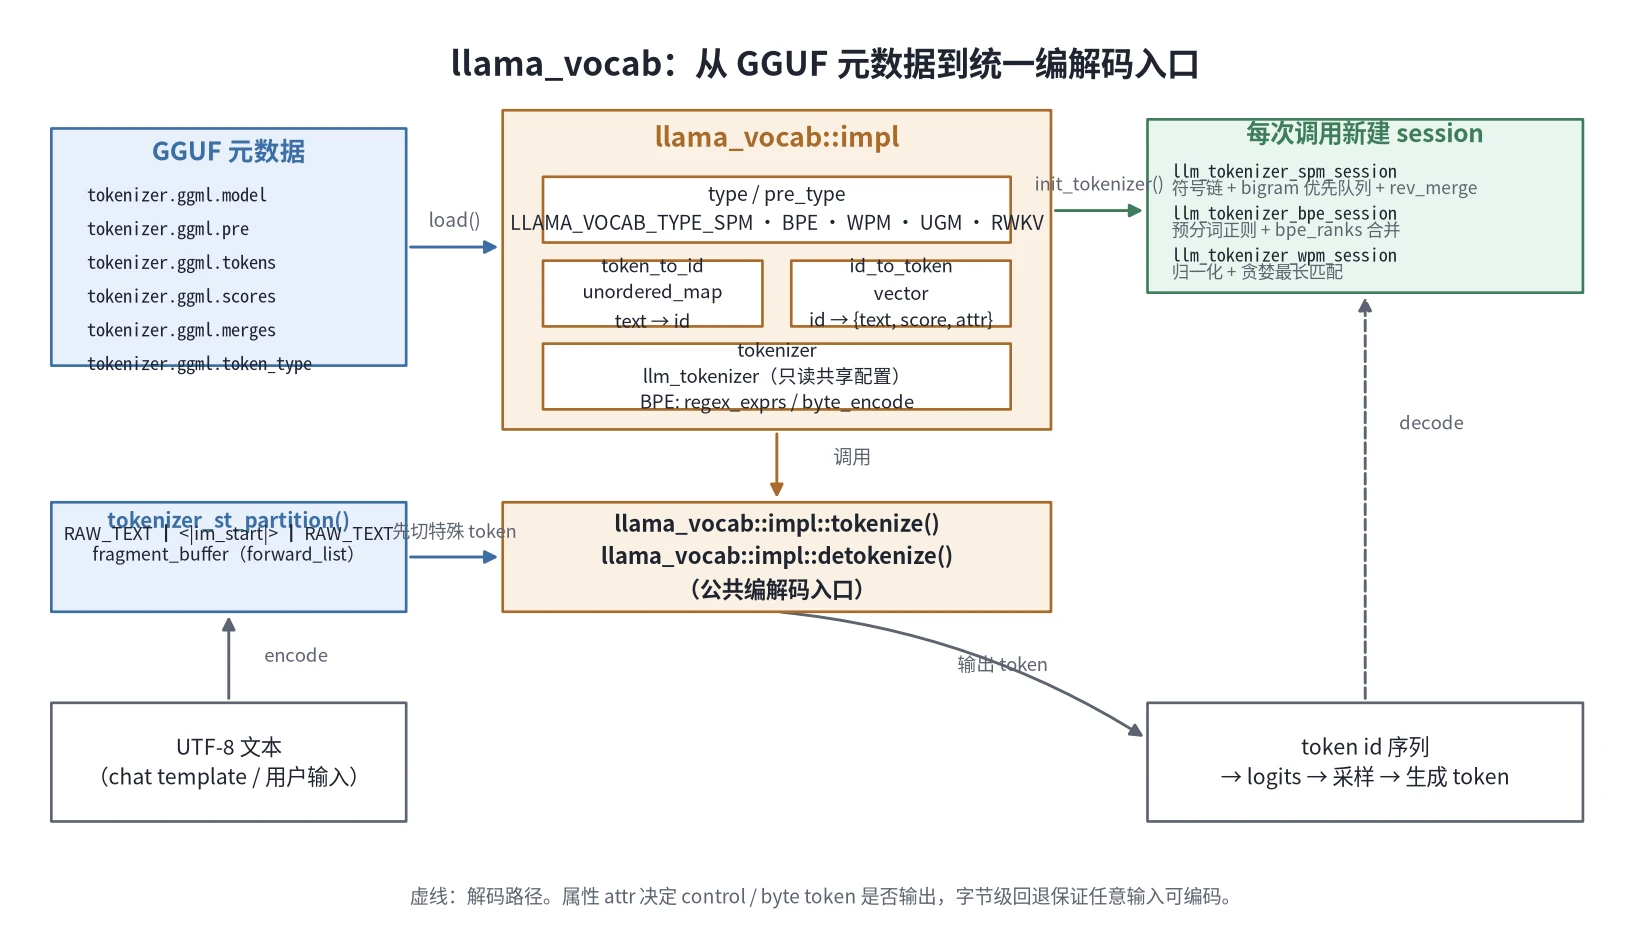
(图源:自制图,依据 llama.cpp 仓库 src/llama-vocab.cpp、src/llama-vocab.h 的结构整理)
llama_vocab 的角色边界:模型里存了什么,llama.cpp 补了什么
GGUF 里的词表元数据
一个 llama.cpp 能加载的模型文件是 GGUF 格式,词表相关的 KV 元数据由 src/llama-arch.cpp 中的 kv_llm_keys 表定义,键名大致如下。不同导出工具会写不同的字段,llama.cpp 加载时按需读取,缺省字段按内置默认值补齐:
| GGUF 元数据键 | 类型 | 用途 |
|---|---|---|
tokenizer.ggml.model | string | 分词器类型字符串:llama、gpt2、bert、t5、rwkv、plamo2 等,加载时映射到 llama_vocab_type |
tokenizer.ggml.pre | string | 预分词器名字(如 llama3、qwen2、deepseek-v3、starcoder),决定 BPE 用哪组切词正则 |
tokenizer.ggml.tokens | string 数组 | token 的「字面形式」,不一定是一段可读文字,也可能是 <0xNN> 这样的字节标记 |
tokenizer.ggml.scores | float 或 int 数组 | SPM 用作 unigram 分数,T5 的 UGM 也用它;BPE 不靠它 |
tokenizer.ggml.merges | string 数组 | BPE 的合并规则,每个元素形如 "Ġ t",以下标作为合并优先级 |
tokenizer.ggml.token_type | int 数组 | 每个 token 的类型:normal / unknown / control / user defined / unused / byte |
tokenizer.ggml.bos_token_id / eos_token_id / eot_token_id / eom_token_id | int | 特殊 token 编号 |
tokenizer.ggml.unknown_token_id / padding_token_id / seperator_token_id | int | 其余特殊 token(注意 GGUF 里分隔符键名拼写是 seperator) |
tokenizer.ggml.add_bos_token / add_eos_token / add_sep_token | bool | 编码时是否自动加 BOS/EOS/SEP |
tokenizer.ggml.add_space_prefix / remove_extra_whitespaces / clean_spaces | bool | 与空格相关的开关 |
tokenizer.ggml.precompiled_charsmap | uint8/int8 数组 | SPM(以及 T5 的 UGM)用的编译版 NFKC 归一化表 |
tokenizer.ggml.normalizer.nfc / lowercase / strip_accents | bool | WPM 归一化选项 |
tokenizer.ggml.metaspace.prepend_scheme | string | SentencePiece 风格的 metaspace 前置空格策略 |
tokenizer.ggml.fim_pre_token_id / fim_suf_token_id / fim_mid_token_id / fim_pad_token_id / fim_rep_token_id / fim_sep_token_id | int | 代码补全(fill-in-the-middle)相关 token |
tokenizer.ggml.suppress_tokens | int 数组 | 建议在采样阶段压制的 token |
tokenizer.chat_template | string | 对话模板,见第十二篇 |
注意 scores 在较新版本的加载代码里允许 int32 或 float32 两种数组类型,读取后统一转成 float 存进 token_data.score。这一点和第(五)篇采样器里的分数不是一回事:这里的 score 只参与分词算法,不会进入 logits。
类型判定:加载时一次性完成
llama_vocab::impl::load() 的第一件事是读 tokenizer.ggml.model 并映射类型。源码里的分支很直白:
ml.get_key(LLM_KV_TOKENIZER_MODEL, tokenizer_model);ml.get_key(LLM_KV_TOKENIZER_PRE, tokenizer_pre, false);
if (tokenizer_model == "no_vocab" || tokenizer_model == "none") { type = LLAMA_VOCAB_TYPE_NONE; // ... return;}
if (tokenizer_model == "llama") { type = LLAMA_VOCAB_TYPE_SPM; special_bos_id = 1; special_eos_id = 2; special_unk_id = 0; // ...} else if (tokenizer_model == "bert") { type = LLAMA_VOCAB_TYPE_WPM; special_bos_id = 101; special_eos_id = LLAMA_TOKEN_NULL; special_unk_id = 100; special_sep_id = 102; special_pad_id = 0; special_mask_id = 103; add_sep = true;} else if (tokenizer_model == "gpt2" || tokenizer_model == "hybriddna" || tokenizer_model == "whitespace") { type = LLAMA_VOCAB_TYPE_BPE; // 读 merges,建立 bpe_ranks} else if (tokenizer_model == "t5") { type = LLAMA_VOCAB_TYPE_UGM; // 读 precompiled_charsmap} else if (tokenizer_model == "rwkv") { type = LLAMA_VOCAB_TYPE_RWKV;} // ...这张映射表有几个值得说的地方。
第一,特殊 token 的默认编号是「按类型」给的,而不是通用的。llama 默认 BOS=1、EOS=2、UNK=0;bert 默认 BOS=101、SEP=102、UNK=100、PAD=0、MASK=103;gpt2 默认 BOS=EOS=11、UNK 为空;t5 默认 EOS=1、UNK=2、PAD=0。这些默认值是给转换工具「忘记写显式 id」时兜底用的,真实模型一般会在 GGUF 里显式写入 bos_token_id 等键覆盖它们。这解释了为什么「同一个 llama.cpp、不同模型、BOS 位置不一样」——不是 llama.cpp 在猜,而是模型文件的元数据说了算。
第二,字符串到类型的映射和公开枚举不完全一一对应。公开头文件 include/llama.h 里 llama_vocab_type 目前有 NONE、SPM、BPE、WPM、UGM、RWKV、PLAMO2、TEST、PLAMO3 九个值;而 tokenizer.ggml.model 字符串还有 gemma4 这样的特例,它落到 BPE 枚举值上,但在分支里顺手把 tokenizer_pre 预设成 "gemma4"。所以读源码时不要假设「字符串名 = 枚举名」,要看 load() 里的分支。
第三,BPE 分支在加载阶段就把所有 merges 读进 bpe_ranks,后续分词时只做哈希查找。bpe_ranks 的键是 std::pair<std::string, std::string>,值是该条 merge 在数组里的下标(下标越小优先级越高)。这是一个 unordered_map,源码还专门写了 pair_hash 把两个字符串的哈希异或起来(第二个左移一位)作为组合键。这个写法不是最严谨的抗冲突哈希,但对 BPE merges 这种键空间基本不碰撞是实用的。
token 数组的两套索引
加载时会把 tokenizer.ggml.tokens 一次性展开成两套结构:
std::unordered_map<std::string, llama_token> token_to_id; // 字面文本 -> idstd::vector<token_data> id_to_token; // id -> {text, score, attr}token_data 定义在 llama_vocab 内部:
struct token_data { std::string text; float score; llama_token_attr attr;};token_to_id 用于「文本查 token」(编码路径里每次合并尝试都要做;text_to_token() 就是它的薄封装);id_to_token 用于「token 查文本和属性」(解码路径和采样辅助都要做)。两者在建表时保证 size() 相等,源码还有一条 GGML_ASSERT(id_to_token.size() == token_to_id.size()) 守着这个不变量。
attr 由 tokenizer.ggml.token_type 数组决定,默认是 LLAMA_TOKEN_ATTR_NORMAL。GGUF 里的 LLAMA_TOKEN_TYPE_* 一共七种:UNDEFINED、NORMAL、UNKNOWN、CONTROL、USER_DEFINED、UNUSED、BYTE。llama.cpp 把它们翻译成位掩码形式的 llama_token_attr(LLAMA_TOKEN_ATTR_NORMAL、LLAMA_TOKEN_ATTR_CONTROL 等),后面解码时用 attr & (attr_special) 这种按位判断判断「这个 token 要不要输出到用户可见文本」。这一步是后面「解码为什么会多/少空格」的伏笔。
分词器的统一入口:session 对象与 fragment buffer
为什么不是「一个虚函数 tokenize()」
直觉上分词器应该是一个 class llm_tokenizer,里面有一个纯虚函数 tokenize()。llama.cpp 实际上只把 tokenizer 当作配置容器:
struct llm_tokenizer { llm_tokenizer() {} virtual ~llm_tokenizer() = default;};llm_tokenizer_spm、llm_tokenizer_bpe、llm_tokenizer_wpm 等都只比它多存一些构造期算好的数据(BPE 存 regex_exprs 和 byte_encode 标志,UGM 存 precompiled_charsmap)。真正的分词逻辑在另一组 *_session 对象里,每次调用新建一个:
llm_tokenizer_spm_session session(vocab);session.tokenize(text, output);这个拆分不是纯粹的美学选择。session 每次编码都会构建自己的一套临时数据结构:
- SPM session:
symbols(字符级符号链表)、work_queue(bigram 优先队列)、rev_merge(文本到合并对的映射); - BPE session:
symbols、symbols_final(跨词维持顺序用)、work_queue; - WPM session:没有持久状态,但内部按词循环。
把这些状态做成 session 成员,而不是 tokenizer 成员,可以保证多线程并发调用 llama_vocab::tokenize() 时互不干扰。tokenizer 对象是只读的共享配置,session 是每次调用私有的工作区——这是 llama.cpp 能安全地在多线程里并发分词的关键。
fragment buffer:先把特殊 token 切出来
统一的入口 llama_vocab::impl::tokenize() 做的第一件事不是分词,而是特殊 token 分区:
std::vector<llama_token> output;std::forward_list<fragment_buffer_variant> fragment_buffer;
if (!raw_text.empty()) { fragment_buffer.emplace_front(raw_text, 0, raw_text.length()); tokenizer_st_partition(fragment_buffer, parse_special);}fragment_buffer 是一个前向链表,每个节点要么是「原始文本片段」(带 offset 和 length 指向源字符串),要么是一个已确定的「特殊 token id」。tokenizer_st_partition() 会遍历 cache_special_tokens,对每个特殊 token 的文本做一次 std::string_view::find,命中的位置被切出来变成 TOKEN 节点,左右两侧保留为 RAW_TEXT 节点。
这个设计有三个细节值得深挖。
第一,特殊 token 的匹配是「按字符串字面」的,不是正则匹配。 比如 <|im_start|>、<|endoftext|>、<|tool_call_begin|>,都是精确匹配。这保证了 chat template 渲染出来的特殊字符串一定能被识别,前提是模型的 chat template 和 tokenizer 的特殊 token 表一致。模板写错一个字符(比如把 <|im_end|> 多写一个空格),这个 token 就退化成普通文本,被 BPE 拆成一堆碎片 token,模型行为会明显异常。这就是第十二篇讲模板时强调「模板与 tokenizer 必须来自同一个模型」的原因。
第二,parse_special == false 时会跳过 CONTROL 和 UNKNOWN 属性。 源码:
if (!parse_special && (data.attr & (LLAMA_TOKEN_ATTR_CONTROL | LLAMA_TOKEN_ATTR_UNKNOWN))) { continue;}// User-defined tokens are still pre-tokenized before everything else默认情况下 llama_tokenize() 的 parse_special 参数是 false,也就是说用户直接传进来的文本里就算写了 <|im_start|>,也会被当作普通文本切碎,不会变成特殊 token。这是安全设计:普通用户输入不应该能伪造特殊 token 来影响对话角色。对话模板渲染的结果则通过 parse_special = true 传入,让模板生成的标记真正成为特殊 token。
第三,LSTRIP / RSTRIP 属性会吃掉相邻空格。 源码在切出特殊 token 后,根据 token_data.attr 中的 LSTRIP 去掉左侧空白、RSTRIP 去掉右侧空白。这对应 SentencePiece 里 <0x0A> 这类 token 的语义,避免「换行字节 token + hello」之后 hello 前面多出一个本不属于它的空格。
入口分派:一次 switch 决定走谁
分区完成后,tokenize() 用一个大的 switch (get_type()) 分派到各自 session:
switch (get_type()) { case LLAMA_VOCAB_TYPE_SPM: { // add_bos 由 vocab 配置决定,is_prev_special 控制要不要前置空格 llm_tokenizer_spm_session session(vocab); session.tokenize(text, output); } break; case LLAMA_VOCAB_TYPE_BPE: { // 按 tokenizer_model 再细分 hybriddna / whitespace / 普通 BPE const llm_tokenizer_bpe * tok_bpe = static_cast<const llm_tokenizer_bpe *>(tokenizer.get()); std::unique_ptr<llm_tokenizer_bpe_session> session; if (vocab.get_tokenizer_model() == "hybriddna") { session = std::make_unique<llm_tokenizer_hybriddna_session>(vocab, *tok_bpe); } else if (vocab.get_tokenizer_model() == "whitespace") { session = std::make_unique<llm_tokenizer_whitespace_session>(vocab, *tok_bpe); } else { session = std::make_unique<llm_tokenizer_bpe_session>(vocab, *tok_bpe); } session->append_bos(output); for (const auto & fragment : fragment_buffer) { // RAW_TEXT: 可选 escape_whitespaces,然后 session->tokenize // TOKEN: session->append(fragment.token, output) } session->append_eos(output); session->check_double_bos_eos(output); } break; case LLAMA_VOCAB_TYPE_WPM: { // 前面加 BOS,后面加 SEP } break; // UGM / RWKV / PLAMO2 / PLAMO3 / TEST / NONE}这个 switch 里藏着 SPM 与 BPE 的第一个关键差异:SPM 和 BPE 对「片段前后的空格」处理方式不同。
SPM 分支用一个局部变量 is_prev_special 跟踪「上一个片段是不是特殊 token」:
bool is_prev_special = true; // 首个片段当作「前一个特殊」处理
if (add_special && add_bos) { output.push_back(special_bos_id); is_prev_special = true;}
for (const auto & fragment : fragment_buffer) { if (fragment.type == FRAGMENT_BUFFER_VARIANT_TYPE_RAW_TEXT) { std::string text; if (add_space_prefix && is_prev_special) { text = ' '; // 开头补一个空格 } text += fragment.raw_text.substr(fragment.offset, fragment.length); llama_escape_whitespace(text); session.tokenize(text, output); is_prev_special = false; } else { output.push_back(fragment.token); is_prev_special = true; }}也就是说,SPM 在每个特殊 token 之后、每段文本之前,只要 add_space_prefix 为真,就补一个空格,再被 llama_escape_whitespace() 替换成 ▁(U+2581)。这对应 SentencePiece 的 metaspace 约定:每段文本的开头相当于前面有一个空格。add_space_prefix 是从 GGUF 的 tokenizer.ggml.add_space_prefix 读来的,SPM 默认 true;BPE 默认 false(BPE 有独立的前置空格策略)。
BPE 分支则完全不在入口处理这个前置空格,而是交给 session 外层的 metaspace_prepend_scheme 判断(只有 prepend_scheme == "first" 且是第一个 fragment 时才补 ▁)。这一段代码位于 BPE 分支的循环里:
static const std::string escaped_space = "\xE2\x96\x81";if (metaspace_prepend_scheme == LLAMA_METASPACE_PREPEND_SCHEME_FIRST && &fragment == &fragment_buffer.front() && text.rfind(escaped_space, 0) != 0) { text.insert(0, escaped_space);}它只在「整个输入的第一个 fragment」补一次,而不是在每个特殊 token 之后补。这是 SentencePiece 风格的 BPE(比如 Gemma 系列)和 GPT-2 风格的 BPE 混在同一个类型下的后果:BPE 的「前置空格」语义现在变成由 metaspace_prepend_scheme 额外控制,而不是像 SPM 那样无条件补。
第二个关键差异是 BPE 有 check_double_bos_eos() 这个警告:如果 add_bos 为真、而且输出里第二个 token 已经等于 BOS,说明模板自己写了 BOS、llama.cpp 又自动加了一次,日志里会打印 Added a BOS token to the prompt ... 2 BOS tokens。这条警告非常有用:chat template 和 add_bos 配置冲突时,这就是唯一能看到的信号。SPM 分支有同样功能的警告,只是写在循环结束之后。
第三个差异是 WPM 自动加 SEP 而不是 EOS:add_special 为真时,WPM 在头部加 BOS,尾部加 SEP。这与 BERT 的训练格式一致。注意 BERT 的「token type / segment id」概念:n_token_types 字段也是从 tokenizer.ggml.token_type_count 读的,但目前它只在加载记录里,编码时并没有生成 BERT 的 segment id。换句话说,llama.cpp 对 BERT 类模型的支持只覆盖「输入 token 化」,下游需要 segment 时得由调用方自己处理。
naive_trie:名字比用途更显眼的数据结构
文章里最常见的说法是「llama.cpp 用 trie 做最长前缀匹配」。读源码会发现实际结构叫 naive_trie,而且全文件只被两处使用:
- UGM session 里的
user_defined_token_matcher和token_matcher(T5 的 Unigram 分词); - RWKV session 里的
token_matcher(RWKV 的贪婪分词)。
SPM、BPE、WPM 的分词路径一个都没用到 naive_trie。SPM 的合并尝试直接在 token_to_id 里查整段文本;BPE 的前缀匹配靠预分词正则保证边界,再对每个片段做合并;WPM 的「最长匹配」是在 text_to_token() 里用 max_token_len 限制窗口长度、从长到短试子串。
naive_trie 的定义很短:
struct naive_trie { naive_trie() : has_value(false), value(0) {} void insert(const char * key, size_t len, int32_t value = 0) { if (len == 0) { has_value = true; this->value = value; return; } char c = key[0]; auto res = children.find(c); if (res != children.end()) { res->second.insert(key + 1, len - 1, value); } else { auto res = children.insert(std::make_pair(c, naive_trie())); res.first->second.insert(key + 1, len - 1, value); } } // get_longest_prefix / traverse ... std::map<char, struct naive_trie> children; bool has_value; llama_token value;};它叫 naive 是有原因的:
- 每个节点一个
std::map<char, naive_trie>,插入/查找都是O(log 子节点数)的树查找;整棵 trie 的节点数等于所有词的总字符数,内存放大相当可观,构造时还有大量递归。 get_longest_prefix()只沿着「有子节点」往下走,不记录沿途的has_value,因此「最长前缀」是「最长的、被插进树里作为路径的字符串」,而不是「最长的、在词表里作为 token 的前缀」。如果前缀树里出现「路径 A 长于 token A’」,它返回的是路径末端,而不是中途某个 token 终点。traverse()用std::map::find做逐字符匹配,而不是哈希表或数组。
那为什么 UGM 和 RWKV 还要用它?因为这两个分词器的需求是「从当前位置,尽可能长地吃掉一个词」,而它们本身没有像 BPE 那样的正则预分词兜底边界。get_longest_prefix() 正适合这种场景:输入整段文本,从 offset 0 开始沿树走到第一个断点,返回「已匹配前缀」的位置和长度,然后对剩余部分继续。UGM session 用 token_matcher 对归一化后的文本分段,在每个分段内再进入自己基于 Viterbi 的动态规划;RWKV 则直接用每段最大匹配的结果查 token。
另一个值得注意的点是 get_longest_prefix() 的返回类型:std::pair<const char *, size_t>,第一个元素是「原指针」,第二个是「已匹配字节数」,不是「一个结束指针」,也不是「匹配到的字符串」。调用方需要知道「原指针 + 返回值.second」才是匹配终点。如果把它当成「返回匹配字符串本身」,很容易误判。
SPM:SentencePiece 的分数驱动合并
符号链表而不是字符串
SPM session 的第一步是把文本切成 UTF-8 字符级 symbol:
int index = 0;size_t offs = 0;while (offs < text.size()) { llm_symbol sym; size_t len = unicode_len_utf8(text[offs]); sym.text = text.c_str() + offs; sym.n = std::min(len, text.size() - offs); offs += sym.n; sym.prev = index - 1; sym.next = offs == text.size() ? -1 : index + 1; index++; symbols.emplace_back(sym);}注意 sym.n = std::min(len, text.size() - offs):遇到「看起来是 N 字节 UTF-8 首字符、但实际剩余字节不够」的畸形输入,就把它截到剩余长度,不越界。这种防御在网络输入里很重要——上游可能截断一个 emoji,只剩前两个字节。
llm_symbol 里存的是 const char * text 和 size_t n,合起来才是当前符号覆盖的字节区间。prev / next 是下标,-1 表示结束。合并时不是真的把字符串拼起来,而是把右符号的长度加到左符号上、把右符号长度置零:
left_sym.n += right_sym.n;right_sym.n = 0;left_sym.next = right_sym.next;if (right_sym.next >= 0) { symbols[right_sym.next].prev = bigram.left;}这一步非常关键。由于 left_sym.text 指向源字符串,left_sym.n 增加后,left_sym.text + left_sym.n 恰好覆盖到 right_sym.text + right_sym.n(因为两个符号在源字符串里相邻且连续)。所以合并全程零字符串拷贝,只有长度和链表指针在变。这是 SPM 实现里性能最好的部分。
双向合并与得分
合并的候选是一个 bigram 优先队列,比较器是:
bool operator()(llm_bigram_spm & l, llm_bigram_spm & r) { return (l.score < r.score) || (l.score == r.score && l.left > r.left);}也就是说:分数高的先合并;分数相同则左侧位置靠前的先合并。std::priority_queue 默认是大顶堆(按比较器「更小」的排后面),所以这个比较器实现的是「score 大优先,left 小优先」。
初始化时把所有相邻字符对都尝试加入队列:
for (int i = 1; i < (int) symbols.size(); ++i) { try_add_bigram(i - 1, i);}try_add_bigram(left, right) 做的是:
const std::string text = std::string(symbols[left].text, symbols[left].n + symbols[right].n);auto token = vocab.text_to_token(text);if (token == LLAMA_TOKEN_NULL) return;if (static_cast<uint32_t>(token) >= vocab.n_tokens()) return;const auto & tok_data = vocab.get_token_data(token);bigram.score = tok_data.score;bigram.size = text.size();work_queue.push(bigram);rev_merge[text] = std::make_pair(left, right);这里有几个细节:
第一,text_to_token 查的是 token_to_id 哈希表,不是 trie。所以 try_add_bigram 的性能瓶颈是「拼接两个字符串 + 哈希查找」,而不是前缀匹配。
第二,rev_merge 记录「文本 → 合并对」,它不参与合并过程,只在最后 resegment() 时用来递归拆分没在词表里的中间合并产物。这是 SPM 实现里最容易让人困惑的结构:合并过程中产生的中间字符串(比如 ▁He 合成了但 ▁Hel 没在词表里)也要记录下来,因为最终「整段文本若不在词表」时需要能回溯出更小的 token 组合。
第三,score 是 token_data.score,来源于 GGUF 的 tokenizer.ggml.scores。在 SentencePiece 的 unigram 模型里,这个分数与「对候选词打分的概率」有关:分数高的词更可能出现、优先合并。这和 BPE 的「merges 下标即优先级」完全不同:SPM 的优先级是学习出来的分数,BPE 的优先级是合并文件里的顺序。
合并循环
while (!work_queue.empty()) { auto bigram = work_queue.top(); work_queue.pop();
auto & left_sym = symbols[bigram.left]; auto & right_sym = symbols[bigram.right];
if (left_sym.n == 0 || right_sym.n == 0 || left_sym.n + right_sym.n != bigram.size) { continue; // 已被合并或长度不一致,跳过 }
left_sym.n += right_sym.n; right_sym.n = 0; left_sym.next = right_sym.next; if (right_sym.next >= 0) { symbols[right_sym.next].prev = bigram.left; }
try_add_bigram(left_sym.prev, bigram.left); // 左边新相邻 try_add_bigram(bigram.left, left_sym.next); // 右边新相邻}这个循环有两个不能省的检查。left_sym.n == 0 || right_sym.n == 0:优先队列里可能还留着「已经被合并过的对」,例如 [a, b] 合并后 b 长度为 0,队列里原本的 [b, c] 就失效了。left_sym.n + right_sym.n != bigram.size:即使两边长度都不为零,合并后的总长度也可能和当初入队时的长度不同,说明这对在排队期间两侧发生过合并,不能合并。这两条保证了队列里的 bigram 总是对当前符号链有效。
合并后立即对新产生的两个相邻对调用 try_add_bigram:合并后的符号左边和后一个、合并后的符号右边和前一个。不重新扫描整条链,这是「合并次数 × 常数」的关键。
resegment:回退拆解
合并结束后,遍历链表:
for (int i = 0; i != -1; i = symbols[i].next) { auto & symbol = symbols[i]; resegment(symbol, output);}resegment() 递归处理一个符号:
void resegment(llm_symbol & symbol, std::vector<llama_token> & output) { auto text = std::string(symbol.text, symbol.n); auto token = vocab.text_to_token(text);
if (token != LLAMA_TOKEN_NULL) { output.push_back(token); return; }
const auto p = rev_merge.find(text); if (p == rev_merge.end()) { // 逐字节回退 for (int j = 0; j < (int) symbol.n; ++j) { llama_token id = vocab.byte_to_token(symbol.text[j]); output.push_back(id); } return; }
resegment(symbols[p->second.first], output); resegment(symbols[p->second.second], output);}三种情况:
- 整段文本在词表里:直接输出;
- 不在词表,但记录过是怎么合出来的:按
rev_merge记录的两半递归拆分,直到每一半都能变成 token; - 不在词表,也没有合并记录:这是「从未形成过合法 bigram」的单个字符(或合并结束后遗留的片段),逐字节回退——每个字节都走
vocab.byte_to_token()变成一个<0xNN>字节 token。
第 3 种情况就是 SPM 的「字节级回退(byte fallback)」。它的意义在于:SentencePiece 词表本身是完整的 Unicode 子集,但任何 Unicode 字符都能用它的 UTF-8 字节序列表示。比如词表里没有 😀(U+1F600),它的 UTF-8 是 F0 9F 98 80,回退后会产出 <0xF0> <0x9F> <0x98> <0x80> 四个 token。解码时这四个字节又拼回 😀。这条链路是 SPM 能「任意输入、无损输出」的根本保证。
不过回退只保证不丢字节,不保证语义稳定:如果一个字符经常被拆成四字节,模型在这个字符上的表现会变差,因为训练时它很可能作为单个 token 出现过。这也解释了为什么某些 emoji 或生僻字在 llama.cpp 里表现差:不一定是模型不会,而是 tokenization 把它拆碎了。
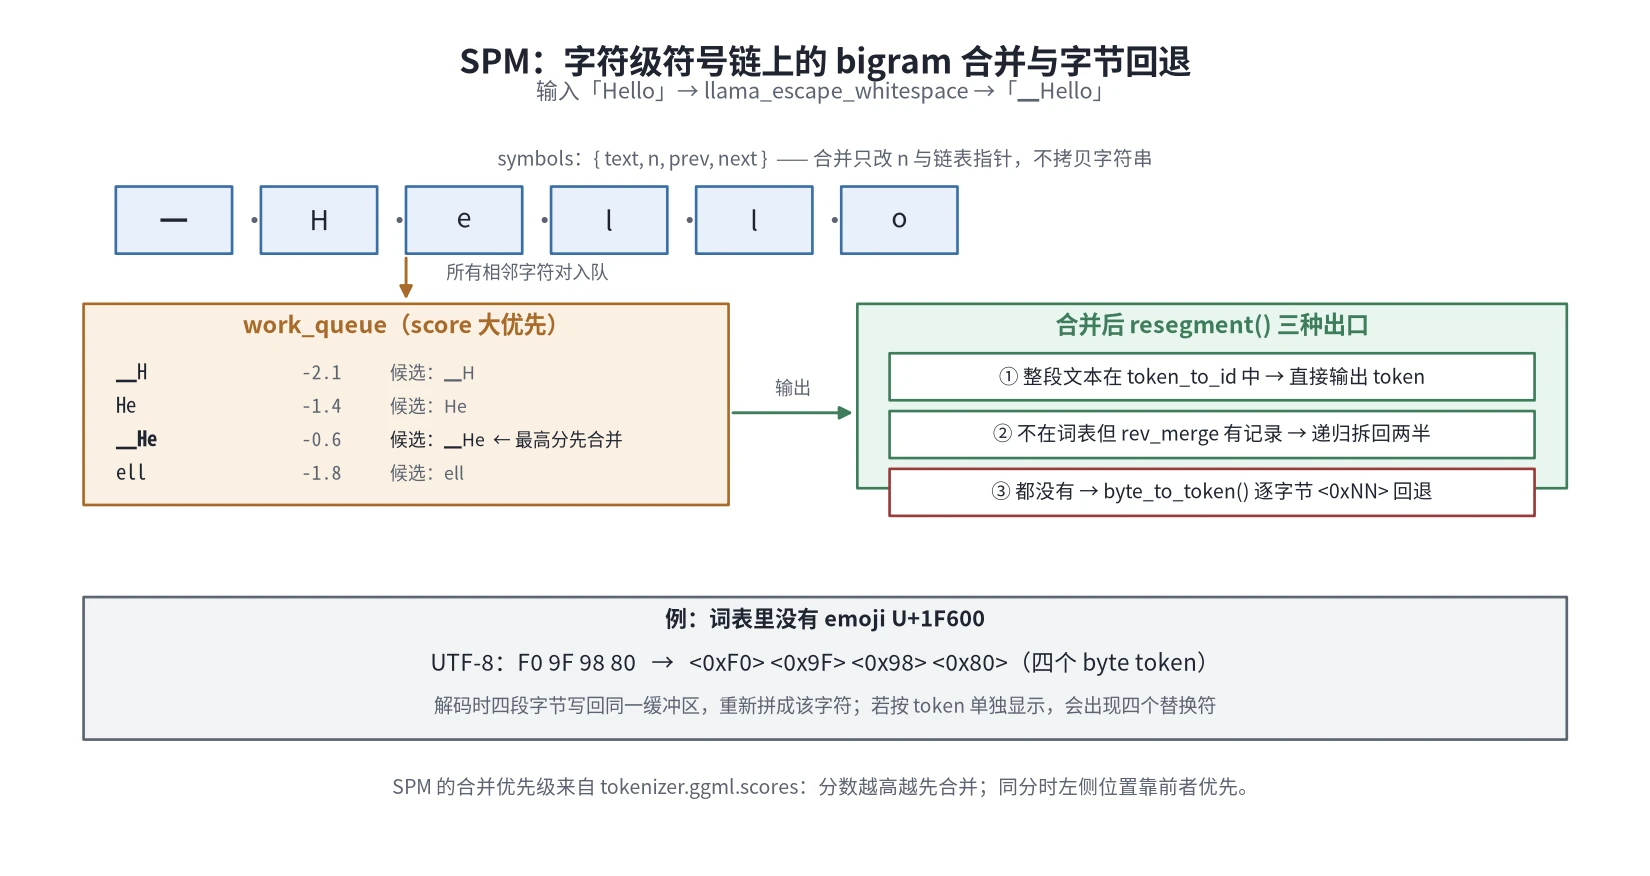
(图源:自制图,依据 llama.cpp 仓库 src/llama-vocab.cpp 中 llm_tokenizer_spm_session 的结构整理)
一个容易误读的细节:symbols 成员「不跨调用清空」
llm_tokenizer_spm_session::tokenize() 在开头并没有 symbols.clear()。看起来像 bug,但要看调用方:SPM 分支每次遇到一个 RAW_TEXT fragment 就新建一个 llm_tokenizer_spm_session:
llm_tokenizer_spm_session session(vocab);session.tokenize(text, output);所以 symbols 的「累积」只在同一个 session 的同一个 tokenize() 调用内有效,跨 fragment 的 session 是全新的。BPE session 则是同一个 session 处理所有 fragment,所以它显式管理 symbols 和 symbols_final 的切换(见下文)。读源码时如果不注意这个生命周期差异,会误以为 SPM 的符号链会跨 fragment 串起来。
BPE:正则预切词 + 排名合并
预分词正则决定一切
BPE 的第一步不是合并,而是把文本切成「词」。这一步不是「按空格切」,而是一组正则表达式,按模型类型不同而不同。llm_tokenizer_bpe 的构造函数里保存 regex_exprs,每条正则都是一条候选规则,实际执行由 unicode_regex_split() 按顺序尝试。
以 LLAMA3 预分词器为例:
regex_exprs = { "(?:'[sS]|'[tT]|'[rR][eE]|'[vV][eE]|'[mM]|'[lL][lL]|'[dD])" "|[^\\r\\n\\p{L}\\p{N}]?\\p{L}+" "|\\p{N}{1,3}" "| ?[^\\s\\p{L}\\p{N}]+[\\r\\n]*" "|\\s*[\\r\\n]+" "|\\s+(?!\\S)" "|\\s+",};这一串规则的顺序就是优先级,从左到右:
- 英文缩写
's、't、're、've、'm、'll、'd,大小写都覆盖; - 字母串,允许前面带一个非字母非数字字符(用来把标点与后面的词绑定,比如
(hello); - 数字串,最多 3 位(
\p{N}{1,3}); - 标点/符号串,允许前面带一个空格;
- 换行串;
- 行尾空白(后面没有非空白的空白);
- 其它空白。
为什么数字是 {1,3} 而不是任意长度?因为 GPT-2/BPE 词表里预训练时常把数字切成 3 位一组,保证大数也能被稳定表示。中文呢?\p{L} 在 Unicode 分类里包含中日韩文字,所以「你好世界」会被一条 \p{L} 规则整段吃成「一个词」,再对这一个词做 BPE 合并。没有单独的 CJK 规则时,中文合并效果完全取决于词表里有多少中文 token。
不同模型的差异往往就在这组正则里:
- QWEN2 是
[^\\r\\n\\p{L}\\p{N}]?\\p{L}+|\\p{N}| ...:数字只切单个,不做 3 位合并; - DEEPSEEK3_LLM 增加了
[一-龥-ゟ゠-ヿ]+这一条,把中日文单独成段; - STARCODER 加了
\\p{N}这一条,保证每个数字单独切,配合它的「代码数字不合并」的词表; - LLAMA3 把缩写统一成大小写显式列出(
(?i:)大小写不敏感组在 C++ 的 std::regex 里支持不佳,所以展开成显式列表); - GEMMA4、SARVAM_MOE、MMBERT 使用
[^\\n]+|[\\n]+这种粗粒度规则,并把byte_encode置为 false,走「SPM 风格 BPE」(空白先变▁,不做 GPT-2 字节映射)。
byte_encode 这个标志很关键。BPE 默认使用「GPT-2 字节到 Unicode 映射表」:把 256 个字节映射到 256 个「看起来可打印」的 Unicode 字符,保证每个字节都能在 UTF-8 文本里表示。这个映射的构造方式是先把「可打印的 33–126、161–172、174–255」原样保留,剩下的字节按顺序分配到 U+0100 之后的空洞里(代码在 src/unicode.cpp)。所以 GPT-2 token Ġ 实际对应空格字节 0x20,Ċ 对应换行 0x0A。解码时 llama_decode_text() 反向查表把 Unicode 字符还原成字节。
如果模型用的是 <0xNN> 字节 token 而不是 GPT-2 映射,那么 BPE 就必须走非 byte_encode 路径,byte_encode = false 的预分词器类型正是为了这个。
还有一个值得单独说的类型:SOPRANO 在 regex_exprs 之前先做一遍自定义归一化——把连续空白压成一个空格,并把字符做 Unicode 小写(unicode_tolower()),且 Unicode 全大写无点 I(U+0130)被特判展开成 i 加组合点。这一步不是 SPM 的 NFKC,而是针对特定模型的定制逻辑,位置写死在 llm_tokenizer_bpe_session::tokenize() 的 tok_pre == LLAMA_VOCAB_PRE_TYPE_SOPRANO 分支。
符号链与合并队列
预分词产生的每个「词」单独构建符号链:
for (const auto & word : word_collection) { work_queue = llm_bigram_bpe::queue(); symbols.clear();
int index = 0; size_t offset = 0;
if (vocab.get_ignore_merges() && vocab.text_to_token(word) != LLAMA_TOKEN_NULL) { // 整词已在词表,跳过合并 symbols.emplace_back(llm_symbol{-1, -1, word.c_str(), word.size()}); offset = word.size(); }
while (offset < word.size()) { llm_symbol sym; size_t char_len = std::min(word.size() - offset, (size_t) unicode_len_utf8(word[offset])); sym.text = word.c_str() + offset; sym.n = char_len; offset += sym.n; sym.prev = index - 1; sym.next = offset == word.size() ? -1 : index + 1; index++; symbols.emplace_back(sym); } for (int i = 1; i < (int) symbols.size(); ++i) { add_new_bigram(i - 1, i); } // ... 合并循环 ...}ignore_merges 是 BPE 特有的「整词直通」优化:如果预分词后的整词已经在词表里(比如常见的单个词 token),就不做逐字符合并,直接用这个词的 token。llama3、qwen2 等预分词器都开启 ignore_merges。这个优化对应 Hugging Face tokenizer 里「整词已在词表则直接命中」的快路径。
add_new_bigram() 通过 vocab.find_bpe_rank(left_token, right_token) 查 bpe_ranks 哈希表:
int rank_found = vocab.find_bpe_rank(left_token, right_token);if (rank_found < 0) return;bigram.left = left;bigram.right = right;bigram.text = left_token + right_token;bigram.size = left_token.size() + right_token.size();bigram.rank = rank_found;work_queue.push(bigram);BPE 的合并循环与 SPM 几乎一样,但有一个额外检查:
std::string left_token = std::string(left_symbol.text, left_symbol.n);std::string right_token = std::string(right_symbol.text, right_symbol.n);if (left_token + right_token != bigram.text) { continue; // Skip this bigram if it's outdated}BPE 用 bigram.text 存「这对合并后的文本」,再和当前左右两边的文本拼起来比较,防止「符号已经发生变化但 bigram 还是旧的」被错误合并。SPM 用 bigram.size 比较总长度,BPE 用完整文本比较更严格,代价是每次比较都要拼字符串。
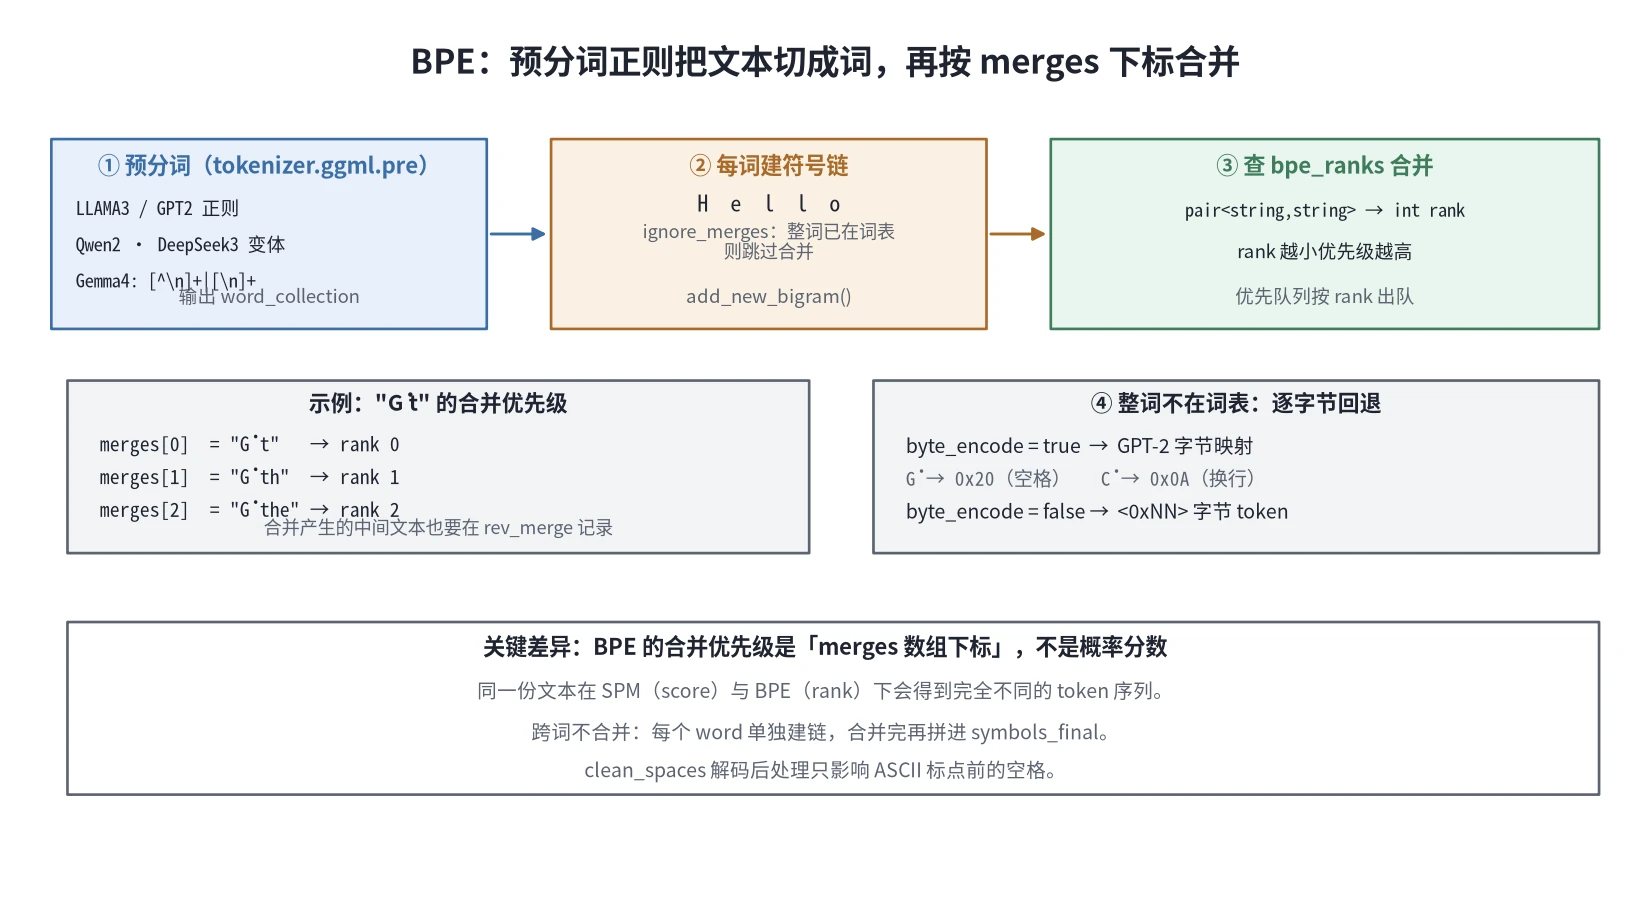
(图源:自制图,依据 llama.cpp 仓库 src/llama-vocab.cpp 中 llm_tokenizer_bpe、llm_tokenizer_bpe_session 的结构整理)
跨词顺序:symbols_final
BPE session 处理多个「词」时,每个词的符号链单独存进 symbols,合并结束后再按顺序追加到 symbols_final:
for (auto & sym : symbols) { if (sym.n > 0) { sym.prev = final_prev_index; sym.next = -1; if (final_prev_index != -1) { symbols_final[final_prev_index].next = symbols_final.size(); } symbols_final.emplace_back(sym); final_prev_index = symbols_final.size() - 1; }}注意这里只遍历 symbols(当前词的符号),而 symbols 在每个词开头被 clear(),所以追加进 symbols_final 的是「当前词合并后的符号」。sym.prev / sym.next 被重写为指向 symbols_final 整体的下标。所有词处理完后:
symbols = symbols_final;从这里开始,符号链是一条跨所有词的完整链,后面的输出循环沿 next 走:
for (int i = 0; i != -1; i = symbols[i].next) { const std::string str = std::string(symbol.text, symbol.n); const auto token = vocab.text_to_token(str); if (token == LLAMA_TOKEN_NULL) { // 逐字节回退(下面展开) } else { output.push_back(token); }}这个「先每词合并、再拼链」的设计,比让所有词共享一条大符号链更省事:合并队列只维护一个词的边界,不会跨词合并。BPE 的语义本来就不允许跨词合并,所以这个边界是算法要求,不是优化。
BPE 的字节回退
BPE 在「合并后整词不在词表」时的回退与 SPM 不同:
if (token == LLAMA_TOKEN_NULL && tok_pre == LLAMA_VOCAB_PRE_TYPE_SOPRANO) { output.push_back(vocab.token_unk());} else if (token == LLAMA_TOKEN_NULL) { for (auto j = str.begin(); j != str.end(); ++j) { llama_token token_multibyte = LLAMA_TOKEN_NULL; if (tokenizer.byte_encode) { std::string byte_str(1, *j); token_multibyte = vocab.text_to_token(byte_str); } else { // byte tokens use <0xXX> format static const char * hex = "0123456789ABCDEF"; const uint8_t ch = (uint8_t)*j; const char buf[7] = { '<', '0', 'x', hex[ch >> 4], hex[ch & 15], '>', 0 }; token_multibyte = vocab.text_to_token(buf); } if (token_multibyte != LLAMA_TOKEN_NULL) { output.push_back(token_multibyte); } }}这里 byte_encode 为真时,str.begin() 到 str.end() 遍历的是已经经过 GPT-2 字节映射的字节(unicode_regex_split 在前一步已经做了映射)。所以直接拿单个字符查 text_to_token 就能命中 Ġ、Ċ 这类 token。
byte_encode 为假时,构造 <0xNN> 字符串查词表。注意这种模式下 str 是原始 UTF-8 字节,查的是逐字节的 <0xNN> token——这也是 Gemma4 等「SPM 风格 BPE」模型能处理任意字节的原因。
SOPRANO 的回退是「一个词对不上就吐 UNK」,不做字节级回退。它的预训练约定里,无法表示的字符直接丢弃(作为 UNK),这是特定模型的选择,不是通用规则。
WPM:WordPiece 的贪婪最长匹配
预归一化
WPM session 的第一步是 preprocess():按 Unicode 码点处理归一化、大小写、重音折叠,并按空白、标点、CJK 字符切词。
std::vector<uint32_t> cpts = unicode_cpts_from_utf8(text);if (normalizer_opts.strip_accents) { cpts = unicode_cpts_normalize_nfd(cpts);}normalizer_opts 的默认值来自 llama_vocab::normalizer_options:nfc = false、lowercase = true、strip_accents = true。WPM(BERT)使用的分词约定正是:
- 全部小写;
- 去除重音(NFD 后再去掉组合标记);
- 中文每个字单独切;
- 标点符号单独切。
具体实现里,每个码点先根据 unicode_cpt_flags_from_cpt() 得到标志位(空白、标点、控制、重音标记等),然后:
if (flags.is_whitespace) { if (words.back().size()) words.emplace_back(); continue;}if (cpt == 0 || cpt == 0xFFFD || flags.is_control) continue;if (normalizer_opts.strip_accents && flags.is_accent_mark) continue;
const std::string s = unicode_cpt_to_utf8(normalizer_opts.lowercase ? unicode_tolower(cpt) : cpt);if (flags.is_punctuation || (cpt < 0x7F && flags.is_symbol) || is_chinese_char(cpt)) { if (words.back().size()) words.emplace_back(); words.back() = s; words.emplace_back();} else { words.back() += s;}is_chinese_char() 是 BERT 原版 Rust 实现的直译,覆盖 CJK 统一表意文字及其扩展区、CJK 兼容区等区间。源码里留了一句注释 this should be 0x2B820 but in hf rust code it is 0x2B920,说明 llama.cpp 刻意跟随 Hugging Face 的实现,即使它和 Unicode 官方区间有偏差——分词器要复现的是训练时的行为,而不是「最正确的」行为。这种细节是分词器移植里最容易出错的地方:任何一处和参考实现不一致,都会导致同一段文本在不同框架里切出不同 token。
仿 SentencePiece 的前空格
切词后,每个词前加一个 ▁:
const std::string word1 = "\xe2\x96\x81" + word;const int n = word1.size();为什么用 ▁ 而不是 BERT 原版的 ##?因为 GGUF 转换时已经把词表里的 ## 前缀转换成了 SentencePiece 风格的 ▁。这样做的好处是 WPM 与 SPM 可以共用「空格 = ▁」的解码约定,减少解码分支。
最长匹配 + 回退
每个词从当前位置开始,尝试所有长度:
for (int i = 0; i < n; ++i) { bool match = false; for (int j = std::min(n, i + vocab.max_token_len() + 1); j > i; j--) { auto id = vocab.text_to_token(word1.substr(i, j - i)); if (id != LLAMA_TOKEN_NULL) { output.push_back(id); match = true; i = j - 1; break; } } if (!match) { output.resize(current_tokens); break; }}if (current_tokens == output.size()) { output.push_back(vocab.token_unk());}这里有几个细节:
第一,长度上限是 max_token_len + 1。max_token_len 是加载时对所有 token 文本的 str.size() 取最大值。+1 是因为 j 是「结束位置(不含)」,当 j - i = max_token_len 时 substr 长度正好是 max_token_len;但如果 i 不是 0,word1.substr(i, j - i) 最长也只能取到 max_token_len,所以 +1 是冗余但无害的上界。
第二,j > i 而不是 j >= i,保证最小子串长度是 1,不会出现空字符串查找。
第三,整个词必须能切完,否则回滚到词开始前的长度并吐一个 UNK。output.resize(current_tokens) 就是回滚:如果前面几个子词匹配上了、中间某个位置没有匹配,就把这个词的全部输出丢弃。这对应 WordPiece 的「一个词要么全部可分解,要么整体 UNK」语义。
第四,为什么 WPM 比另外两种慢:内层循环对每个起始位置 i 都尝试最多 max_token_len 种长度,每种长度都要 substr(一次拷贝)加一次哈希查找。对长词(比如很长的英文标识符或 URL)代价明显高于 SPM/BPE 的合并队列。llama.cpp 没有为 WPM 提供 trie 或前缀哈希的加速,这在实际使用中通常可接受,因为 BERT 的输入长度一般远小于生成类模型。
WPM 是最「简单」的分词器,也最「保守」:它没有 SPM 的字节级回退,没有 BPE 的合并优先级,一个词对不上就 UNK。这对应 BERT 的训练方式:BERT 的输入是短文本分类/检索,UNK 的代价可以接受;而生成模型必须能输出任意文本,所以 SPM/BPE 都必须有字节兜底。
解码:比编码多出来的三层逻辑
第一层:特殊/控制 token 过滤
detokenize() 和 token_to_piece() 共享一个属性判断:
static const int attr_special = LLAMA_TOKEN_ATTR_UNKNOWN | LLAMA_TOKEN_ATTR_CONTROL;const llama_token_attr attr = token_get_attr(token);if (!special && (attr & attr_special)) { return 0;}意思是:UNKNOWN 和 CONTROL 属性的 token 默认不输出。llama_tokenize() 生成 <|im_end|> 这类控制 token 时,add_special 为真时把它们加入序列;但用户读文本时不需要看到它们。special = true 的调用场景是「需要保留完整序列」——比如调试、日志、或者再喂给模型之前想看原始形式。
token_data.score 不参与解码;attr 决定输出与否。这是解码的第一层语义。
第二层:UTF-8 跨 token 拼接
编码时 😀 被拆成四个字节 token;解码时四个 <0xNN> 字节 token 必须拼回去。token_to_piece() 对 BYTE 属性 token 的处理是:
char byte = (char) token_to_byte(token);return _try_copy((char*) &byte, 1);SPM/UGM 的 token_to_byte() 从 <0xNN> 文本的第 3、4 个字符解析十六进制:
auto buf = token_data.text.substr(3, 2);return strtol(buf.c_str(), NULL, 16);然后 detokenize() 把每个 token 的输出依次追加到同一个 buffer:
int32_t n_chars = token_to_piece(tokens[i], text, avail, remove_space || remove_first_space, unparse_special);注意 token_to_piece() 每次只输出「一个 token 的字节」。四个字节 token 就是四次追加四个单字节到同一缓冲区——跨 token 的 UTF-8 拼接完全靠「调用方把它们写进同一段文本」来实现。llama.cpp 不需要知道 😀 是一个字符,它只知道「这些字节应该连续」。如果上游按 token 逐个取字符串、再各自显示,就会看到四个乱码替换符。
这就是为什么「流式输出」对字节 token 要特别小心:如果服务端在每个 token 后立即 flush 一个 chunk,客户端就会收到四个不完整的 UTF-8 片段。llama.cpp 的 server 在 SSE 流式输出阶段是按 token 粒度输出的,并不保证每个 chunk 落在字符边界。想要字符边界安全的流式输出,调用方需要自己缓冲字节 token,等凑成一个完整 UTF-8 字符再发出。
第三层:▁ 空格还原与 lstrip
token_to_piece() 对 NORMAL 属性 token 的处理有三条不同的分支,取决于分词器类型:
case LLAMA_VOCAB_TYPE_WPM:case LLAMA_VOCAB_TYPE_SPM:case LLAMA_VOCAB_TYPE_UGM: { if (attr & (attr_special | LLAMA_TOKEN_ATTR_USER_DEFINED)) { return _try_copy(token_text.data(), token_text.size()); } if (attr & LLAMA_TOKEN_ATTR_NORMAL) { std::string result = token_text; llama_unescape_whitespace(result); return _try_copy(result.data(), result.size()); } // ...}case LLAMA_VOCAB_TYPE_BPE: { if (attr & LLAMA_TOKEN_ATTR_NORMAL) { if (pre_type == LLAMA_VOCAB_PRE_TYPE_SOPRANO) { return _try_copy(token_text.data(), token_text.size()); } if (escape_whitespaces) { std::string result = token_text; llama_unescape_whitespace(result); return _try_copy(result.data(), result.size()); } std::string result = llama_decode_text(token_text); return _try_copy(result.data(), result.size()); } // ...}SPM/UGM/WPM 一律把 ▁ 替换回空格(llama_unescape_whitespace 就是 replace_all(word, "\xe2\x96\x81", " "))。BPE 分三种:
- SOPRANO:原样输出,不做替换;
escape_whitespaces == true(SPM 风格 BPE,如 Gemma):▁替换成空格;escape_whitespaces == false(GPT-2 风格 BPE):调用llama_decode_text(),把每个 Unicode 字符按 GPT-2 字节映射表还原成字节。Ġ变成0x20(空格),Ċ变成0x0A(换行),普通 ASCIIa保持a。
llama_decode_text() 的异常处理也值得注意:
try { decoded_text += unicode_cpt_to_byte(cpt);} catch (const std::out_of_range & /*e*/) { const auto utf8 = unicode_cpt_to_utf8(cpt); decoded_text += "[UNK_BYTE_0x"; for (const auto c : utf8) { decoded_text += format("%02x", (uint8_t) c); } decoded_text += text + "]";}如果某个字符不在 GPT-2 映射表里(理论上不应该,因为 GPT-2 映射覆盖全部 256 字节),输出一个可读的错误标记,而不是崩溃或静默丢弃。这对排查损坏的词表很有用。
lstrip 与前导空格
detokenize() 传入的 lstrip 参数最初来自 add_space_prefix:
bool remove_space = add_space_prefix;然后在 token_to_piece() 的 _try_copy 里,遇到 NORMAL token 且只输出一个 token 时,会跳过 lstrip 个前导空格:
for (int32_t i = 0; i < lstrip && size && *token == ' '; ++i) { token++; size--;}这个逻辑对应 SPM 的 metaspace 约定:编码时每段文本开头补了空格(变成 ▁),解码时要把这个额外的前导空格去掉。remove_space 只在第一个 token 生效(之后置为 false),所以只会去掉整个序列开头的那个空格。
注意 remove_space = false 的特殊情况:remove_special && add_bos && tokens[0] == bos 时,BOS 被跳过,remove_space 强制为假。这个判断的意图是「BOS 后面紧跟的文本开头空格是用户真实文本的一部分,不应该被 lstrip 吃掉」。但如果模板生成的序列是 BOS + ▁Hello,那么 BOS 被删掉后、▁Hello 的前导空格不删,结果是多出一个前导空格而不是 Hello。这个行为容易被误以为 bug,实际上是「BOS 已消费了开头的 metaspace 语义」的有意设计。
对应地,BPE 的 metaspace_prepend_scheme == "first" 用另一个变量 remove_first_space 处理:只对第一个被渲染的 piece 去掉前导空格,一旦第一个 NORMAL token 被渲染就置为 false。这是 SentencePiece 风格 BPE 在解码时补齐同一个语义。
clean_spaces:后处理三段清洗
BPE 默认 clean_spaces = true(源码里 LLAMA_VOCAB_TYPE_BPE 分支统一设置),对应 Hugging Face tokenizer 的 clean_up_tokenization_spaces。detokenize() 拼完所有 piece 后,如果 clean_spaces 为真,做三遍原地压缩:
第一遍:去掉标点前的空格。
if (text[i - 1] == ' ') { if (x == '?' || x == '!' || x == '.' || x == ',') { // " ?", " !", " .", " ," total--; // remove space }}"Hello !" 变成 "Hello!"。这一遍只处理 ? ! . , 四个 ASCII 标点,不处理中文全角标点。
第二遍:去掉「夹在两个空格中间的单引号」的多余空格。
if (x == '\'' && i + 1 < total2 && text[i - 1] == ' ' && text[i + 1] == ' ') { total--; text[++i] = '\0';}"he ' hello" 变成 "he'hello"。
第三遍:处理 's、'm、're、've 这类缩写的空格。
if (text[i - 1] == ' ') { if (x == '\'') { if (x1 == 's' || x1 == 'm') total--; else if (x1 == 'l' && x2 == 'l') { /* 不删 */ } else if ((x1 == 'r' && x2 == 'e') || (x1 == 'v' && x2 == 'e')) total--; }}"it 's" 变成 "it's"。注意 't 和 'd 是故意不删空格的:"he 'd" 保留成 "he 'd" 而不是 "he'd"。代码里的注释 //NOTE: this makes sense? 也承认这个规则有些可疑。这个不一致来自 Hugging Face tokenizer 的历史实现,为了保持「llama.cpp 和 Python 端输出一致」,只能照抄。
这三遍清洗都是原地压缩:text -= total 回退到缓冲区开头,再用 text[total++] = x 边读边写。因为写指针永远不超过读指针,原地压缩是安全的。这里也是「解码只按字节操作、不解析 UTF-8」的延续:三遍清洗把空格当成单字节 ' ',不关心上下文是不是 UTF-8 多字节字符的中间部分。对 BPE 的 clean_spaces 来说这不影响正确性,因为这些清洗规则只影响 ASCII 标点前的空格。
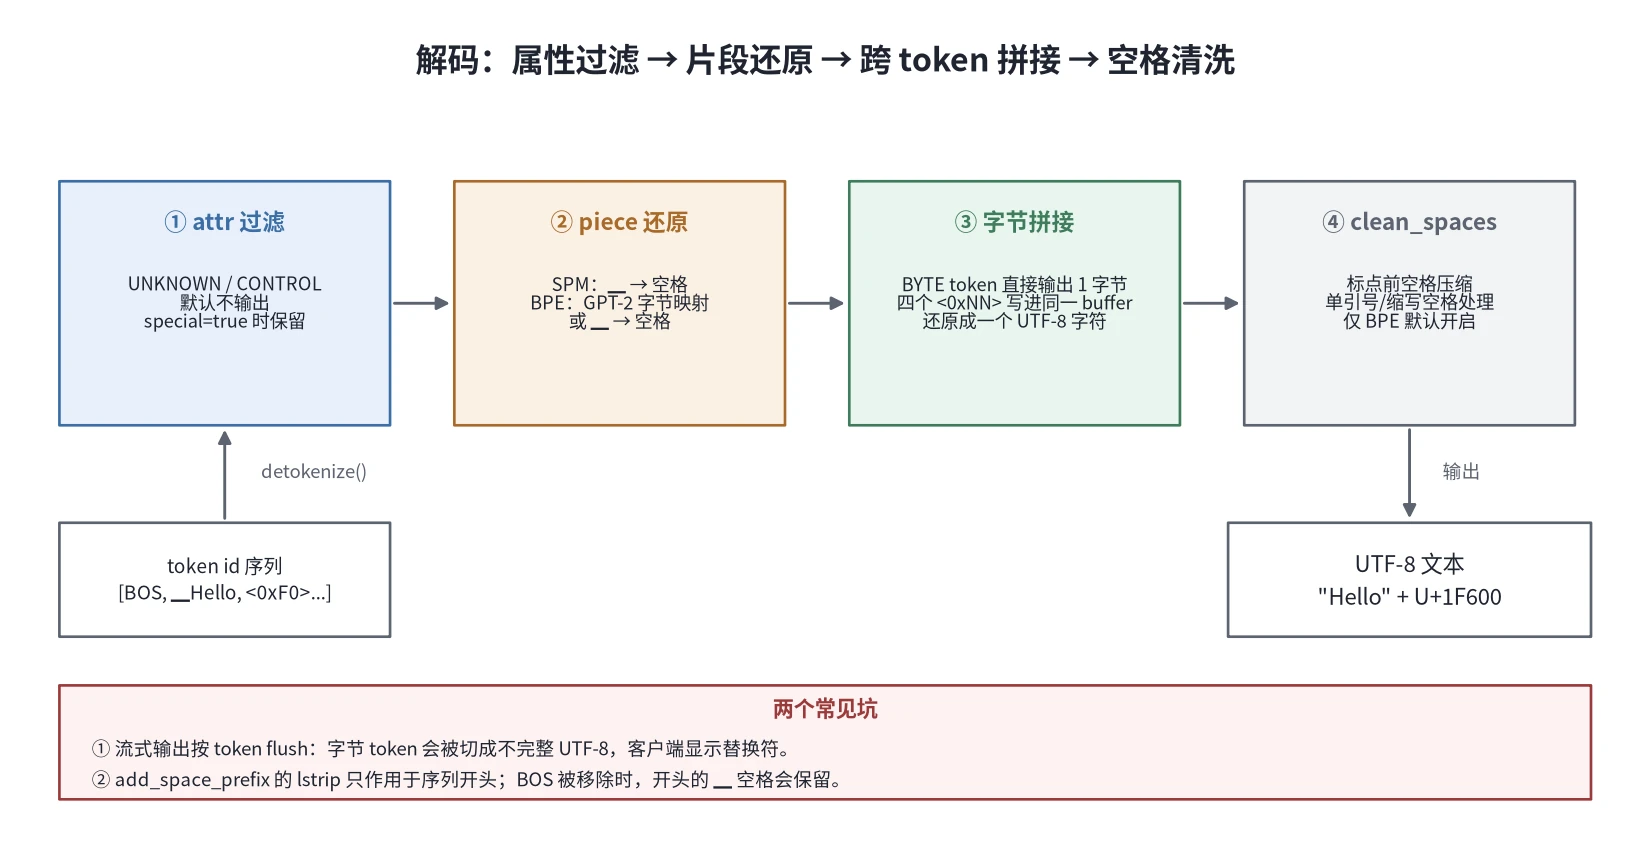
(图源:自制图,依据 llama.cpp 仓库 src/llama-vocab.cpp 中 llama_vocab::impl::token_to_piece()、detokenize() 的结构整理)
三种分词器的横向对比
| 维度 | SPM(SentencePiece) | BPE(GPT-2 风格) | WPM(WordPiece) |
|---|---|---|---|
| 初切 | UTF-8 字符 | 正则预分词成词,再逐字符 | 归一化后按空白/标点/CJK 切词 |
| 合并依据 | tokenizer.ggml.scores 分数 | merges 数组下标 | 无(贪婪最长匹配) |
| 合并方式 | 双向 bigram 优先队列 | 双向 bigram 优先队列(带完整文本校验) | 每个起点从长到短试子串 |
| 空格约定 | ▁ 表达前导空格 | escape_whitespaces 控制,GPT-2 走字节映射 | ▁(转换时由 ## 改写) |
| 字节兜底 | 逐字节 <0xNN> | GPT-2 字节映射或 <0xNN> | 无,整词 UNK |
| 解码 | ▁ 替换回空格;BYTE 直接输出 | 字节映射反查;BYTE 直接输出 | ▁ 替换回空格 |
| 特殊 token | BOS/EOS 可选 | BOS/EOS 可选 + 双 BOS 警告 | BOS/SEP 必加 |
这张表最值得记住的是编码和合并的优先级完全不同:SPM 靠分数,BPE 靠顺序(merges 文件里的行号),WPM 靠长度(贪婪)。同一个文本在这三种分词器下切出的 token 序列没有任何关系。很多「模型 A 的 tokenizer 换成模型 B 的」实验失败,原因就是把这个优先级表混用了。
与 llama.cpp 其它层的衔接
编码:llama_tokenize 的两个参数
llama_vocab::impl::tokenize() 有两个重载:一个返回 std::vector,一个写进调用方 buffer。两者都需要调用方传入 add_special 和 parse_special:
add_special = true:SPM/BPE 加 BOS/EOS,WPM 加 BOS/SEP;再由tokenizer.ggml.add_bos_token等配置进一步控制;parse_special = false(默认):普通用户文本里的特殊 token 字符串被当作普通文本;true:模板渲染结果里识别特殊 token。
这两个参数由 llama_tokenize() 公共 API 暴露,server 的 completions 与 chat completions 接口分别选择「parse_special=false」和「parse_special=true」,这就是为什么 chat 接口里 <|im_start|> 能变成特殊 token、而 completions 接口里同样的字符串被当普通文本。
解码:llama_token_to_piece 与 llama_detokenize
token_to_piece() 的输出是「单个 token 的字节串」,detokenize() 的输出是「整个序列的文本」。两者的区别不仅是批量与单条:
token_to_piece()不做跨 token 的字节拼接,所以对字节 token 会输出不完整 UTF-8;detokenize()也不做「按 Unicode 字符对齐」的切分,但它保证clean_spaces与lstrip后处理作用于整个序列;- 两者都只按
attr过滤 UNKNOWN/CONTROL。
流式输出时应该用 token_to_piece(),但要做自己的字节缓冲;需要一段完整文本时用 detokenize()。这是两个 API 的使用边界。
与采样层:特殊 token 的抑制
tokenizer.ggml.suppress_tokens 会被加载成 vocab.suppress_tokens,在采样阶段作为候选集过滤的参考。token_data.score 在采样阶段不参与 logits 计算,分词器的分数只用于分词。这一点和第(五)篇的采样器设计保持一致:分词器的分数是「文本表示」的分数,模型的分数是「下一个 token 的概率」的分数,两者不能混。
与对话模板:<|im_start|> 的双重身份
第十二篇讲过,模板把消息渲染成 <|im_start|>system、正文、<|im_end|> 这样的字符串。这一层字符串进入词表后:
tokenizer_st_partition()识别出<|im_start|>和<|im_end|>,切成特殊 token;- 中间的
system和正文作为 RAW_TEXT 进入对应分词器; - 如果
add_bos为真、模板又以 BOS 开头,check_double_bos_eos()会打印警告。
所以「BOS 被加了两次」这类线上问题,可以在分词器日志里直接看到,不需要去猜模板。
小结
llama_vocab 的设计可以浓缩成四句话:
- 类型是加载时定的:
tokenizer.ggml.model一次映射到llama_vocab_type,之后所有路径都按类型分派。tokenizer.ggml.pre再细分 BPE 的预分词正则。 - 统一的是入口,不是算法:
tokenize()/detokenize()是公共接口,内部的 SPM、BPE、WPM session 各自独立,各自有自己的队列、符号链、回退规则。 - 字节是兜底:SPM 靠
<0xNN>字节 token,BPE 靠 GPT-2 字节映射或<0xNN>,WPM 干脆不兜底。编码能「任意输入」,解码必须「无损拼接」,所以解码比编码多出三层逻辑。 naive_trie不是主流路径:它只服务 UGM 和 RWKV 这类需要「从当前位置最长匹配」的分词器,SPM/BPE/WPM 都用哈希查表或正则边界。把它说成「BPE 的前缀匹配树」是不准确的。
如果要把这一层和 llama.cpp 其它层串起来看,可以按「文本 → token → logits → token → 文本」走一遍:文本先到这里变成 token;模型前向在 llama.cpp 源码完全拆解(四):llama_context 与记忆系统 讲的 KV 缓存和图里处理;采样在第(五)篇把 logits 变回 token;生成的 token 又回到这里 detokenize() 成文本。这一圈里最容易被忽略、又最容易出错的,恰恰是本文这一层。
参考资料
- llama.cpp 仓库 llama-vocab.cpp 源码
- llama.cpp 仓库 llama-vocab.h 源码
- llama.cpp 公开 API 头文件 llama.h
- SentencePiece 论文:Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates
- Hugging Face tokenizers 文档
- GPT-2 论文:Language Models are Unsupervised Multitask Learners
- BERT 论文:BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
- llama.cpp PR #6920:BPE 预分词正则的讨论
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



