


RadixFlow 完全拆解:混合注意力 LLM 的前缀缓存,为什么命中却跑不进一个 batch
前缀缓存(prefix caching)在推理框架里几乎被当成一条公理:只要请求的前缀在缓存里命中,这段前缀就可以跳过预填充(prefill),调度器把它放进当前 batch 就行。vLLM 的分页前缀缓存、SGLang 的 RadixAttention 前缀树、TensorRT-LLM 的复用树,都是围绕这条公理建立的。对全注意力(full attention)模型,这条公理确实成立——一个 token 位置的历史信息全部存在该位置的 Key/Value 里,命中前缀就等于拿到了那段计算的全部结果。
混合注意力模型(hybrid LLM)把这条公理打破了。这类模型的部分层不是全注意力,而是线性注意力(linear attention)、状态空间模型(SSM)或滑动窗口注意力,它们不保存逐 token 的 KV,而是维护一个固定大小的循环状态(recurrent state);另外还有一层短卷积(short convolution)状态,负责把最近的若干 token 混进来。这意味着:即便前缀索引报告”这两个分支共享前 4096 个 token”,要真正从第 4096 个 token 处继续算,你还得拥有那个边界上的循环状态。而循环状态是逐 token 递推出来的,不能由前缀里的 KV 重建——线性层压根没有 KV。
更麻烦的是状态的生产时序。假设同一轮 batch 里有分支 P 正在计算共享前缀,分支 A 命中了同一段前缀但需要 P 还没算完的状态。vLLM 的混合状态管理器会拒绝 A 的分配请求;而调度器的等待队列扫描遇到这次分配失败就会停止,排在 A 后面的分支 D——它与 P、A 毫无关系,资源也够——因此被一起挡在门外。论文把这种”合法可填却被空着的容量”称为可避免的执行气泡(avoidable execution bubble)。
这篇要拆的是 2026 年 10 月挂在 arXiv 上的 RadixFlow(arXiv:2610.18143)。它只改了一件事:扫描等待队列时,遇到”消费者等待同一轮生产者”的情形,只拦住这个消费者,继续往后扫;被拦住的分支进等待队列,下一轮再检查。论文在 vLLM 0.29 上实现了这套策略,在五个混合模型上把平均客户端延迟降低了 3%–24%,前缀复用率的变化不超过 0.03 个百分点。
一个缓存命中,为什么排不进这一轮
先把问题的最小形态摆出来。RadixFlow 论文的 Figure 1 用一个理想化例子说明了全部矛盾:两条调度路径处理同样的 15 个工作片段、同样的 12,970 个 token,一条要六轮,另一条只要四轮。
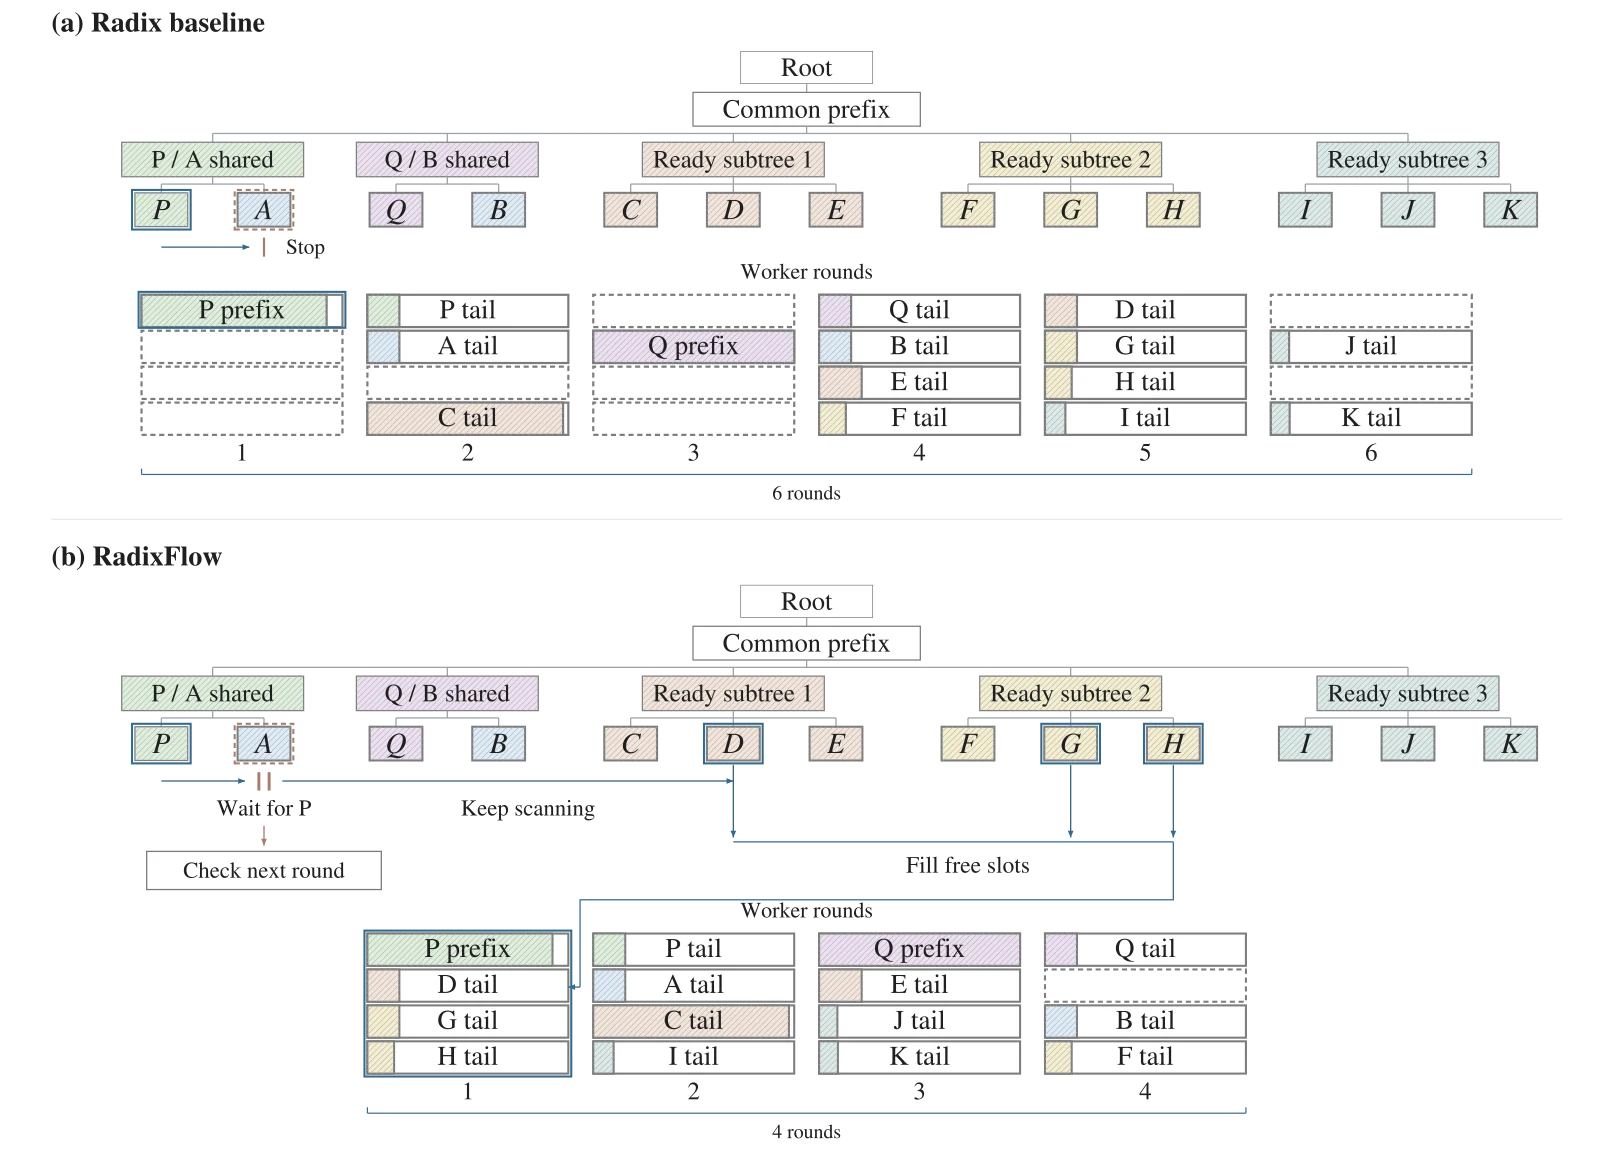
图中每个格子代表 worker 一轮里的一个行槽位(row slot),一轮最多四行。蓝色轮廓是第一轮被选中的片段,斜线格是空槽,格子的长度示意 token 负载。左半部分是基线的行为:分支 P 先被选中,它负责计算共享前缀;随后扫描到分支 A,A 的前缀与 P 相同,但 A 需要 P 在这一轮还没写回的状态,于是 A 的分配失败,扫描到此结束。问题不在 A 本身——A 确实不该在这一轮跑;问题在于排在 A 后面的 D 也被跳过了,而 D 的状态早就发布、剩余预算也够,它完全可以填进空着的行。
右半部分是 RadixFlow 的行为:A 被放进等待队列,扫描继续,D 被选中。A 在下一轮被唤醒并重新做一次原生状态检查。两边的 token 总量一致,轮数从六降到四,空槽从九个降到一。
这个例子暴露了一个在框架代码里很容易被忽略的事实:前缀索引回答的是”这段 token 之前算过吗”,调度器需要回答的是”这段计算结果现在可用吗、能放进这一轮吗”。这两个问题在全注意力模型上几乎等价,在混合模型上是三件不同的事。论文把它们拆成三层:
- 前缀身份(prefix identity):索引能找到的最长 token 匹配,记作 。
- 状态就绪(state readiness):该边界上所有状态分量都已发布并通过原生状态检查,最大的可用边界记作 。
- 可执行性(executability):这个分支在当前轮剩余的行预算和 token 预算下能被合法接纳。
全注意力模型的 ,通常 ;混合模型的 ,只要匹配边界上的循环状态缺失,就会出现 。这个不等式就是整篇文章的起点:命中的长度与可用的长度不是一回事。
混合模型的“缓存”到底存了什么
要理解状态就绪为什么是一个独立问题,得先看清混合模型在前向计算时留下了什么。
全注意力层的记忆是显式的、逐 token 的:每个历史位置都有一份 Key 和一份 Value,缓存大小随序列长度线性增长。一层中 KV 缓存占用的字节数可以写成
其中 是已缓存的 token 数, 是该层的 KV 头数, 是每个头的维度, 是每个元素的字节数,前面的 2 对应 K 和 V 两份。对 GQA 或 MLA, 或有效维度会小很多,但增长方式不变:它仍然是 。
线性注意力层和状态空间层不是这样。它们不为每个历史位置保存任何东西,而是维护一个固定大小的状态,每来一个 token 就更新一次。以 Mamba-2 这一类 SSM 层为例,状态可以理解为若干个头、每个头一个 的矩阵,更新形式是
是第 步之后的状态, 是随输入变化的衰减/转移系数, 是当前 token 写入状态的外积。这里的关键是: 的尺寸与 无关,它是把整段历史压缩进一个固定容量的“记忆”,而不是把历史原样存下来。线性注意力(如 DeltaNet、GLA、KDA 一类)同样维护一个固定尺寸的递推矩阵,只是更新规则不同。
此外还有一层短卷积状态。混合模型普遍在循环层之前放一个宽度很小的因果卷积(深度可分离卷积),把最近几个 token 的信息混进来,卷积核宽度通常在 4 左右。它需要保存最近 个 token 的输入,也是一个与序列总长度无关的固定缓冲。
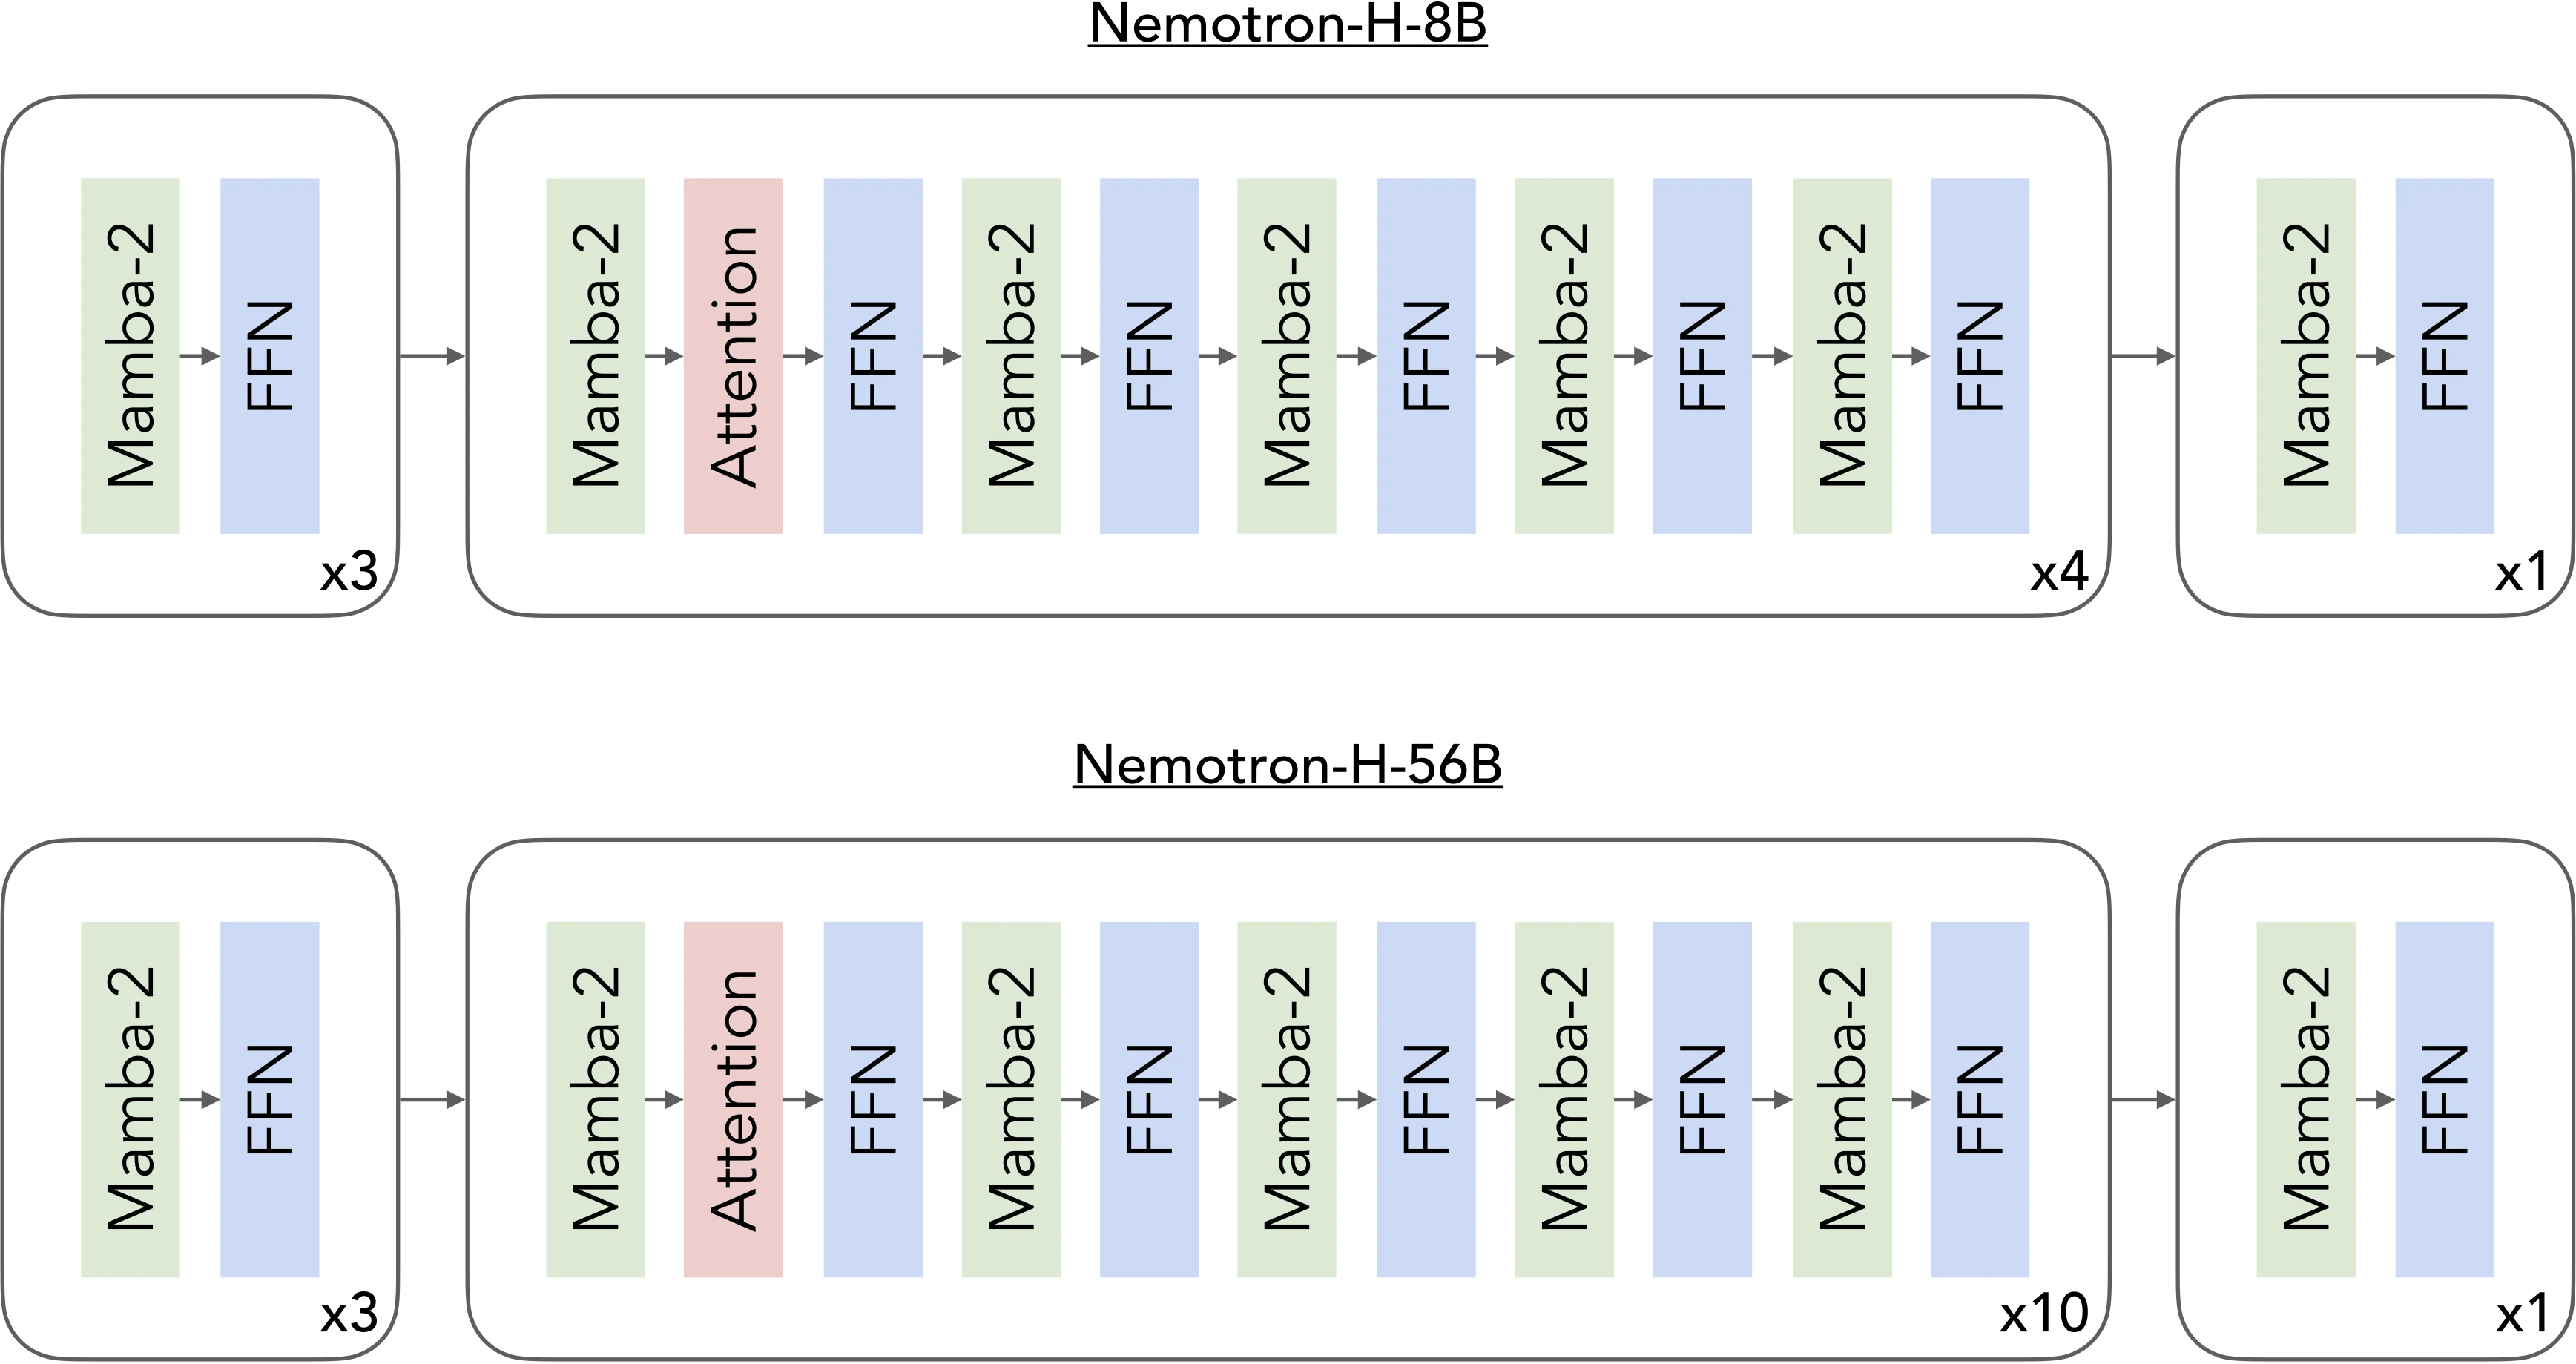
上图来自 Nemotron-H 的技术报告(arXiv:2504.03624),它画出了一个典型混合模型的层排布:绝大多数层是 Mamba-2,少数全注意力层被均匀地插在中间。论文实验中的 Nemotron-Nano-9B-v2 就属于这一族;Qwen3.5 的 0.8B/4B/9B/27B 四个模型在 RadixFlow 的实验中也被归为混合模型。这张图解释了一个容易被忽略的事实:同一个模型里,历史信息同时存在于两种介质中——注意力层里是逐 token 的 KV,循环层里是固定尺寸的状态。
于是“前缀缓存”在混合模型上必须存两份东西。论文把状态分量集合记作
是注意力层的分页 KV, 是循环层的递推状态, 是短卷积的窗口状态。全注意力模型只有 ;混合模型三个分量缺一不可。
这里就出现了第一个工程约束:状态必须在边界上做快照。KV 可以按 token 分页,任意位置都能寻址;但循环状态是递推出来的,想从第 个 token 处恢复,必须拥有恰好跑到第 步时的 和 。如果只在某些块边界保存快照,那么命中点落在两个快照之间时,要么从更早的快照开始重放中间那段 token,要么干脆从零重算。vLLM 的混合缓存管理器把状态按块保存,并用块哈希把 token 块与状态快照对应起来;这也是为什么“前缀匹配”在混合模型上会退化:索引可以精确到 token,状态却只能精确到快照边界。
第二个约束是快照的代价。每个边界都存一份状态,内存会按层数乘以状态尺寸线性膨胀;如果为了省内存只存稀疏的边界,重放成本又回来了。论文在讨论设计取舍时明确把“在任意分支处保存 checkpoint”列为另一条独立的设计路线,而不是顺手就能做的事(见后文对备选方案的讨论)。
从 token 匹配到状态就绪
把这些约束形式化,就得到论文的三层区分。
设 是第 轮开始时已经发布、并通过原生状态检查的状态集合,集合元素是“前缀 的某个分量 ”。一个边界 对分支 是就绪的,当且仅当对该分支前 个 token 组成的每个分量 ,都有 。分支 的就绪长度 是满足条件的最大边界; 表示只能冷启动。
前缀索引给出的则是另一件事:最长 token 匹配 。显然 。对全注意力模型,命中的 KV 页通常就在池子里,两者一般相等;对混合模型,只要匹配边界上的 还没发布,就会出现严格不等式
这个不等式就是全部问题的来源。它说的是:索引知道这段 token 算过,但引擎手里没有从这段 token 继续算所需的状态。
论文把这三个事件拆得很清楚:
- 找到前缀(prefix match):索引报告最长匹配。
- 拥有完整状态(state readiness):匹配边界上 KV、循环状态、卷积状态全部可用。
- 放进合法的一轮(round placement):该分支能被当前轮的行预算和 token 预算接纳。
传统调度器把 1 当成 2,又把 2 当成 3。在全注意力时代这个近似几乎总是成立;混合模型把 1 和 2 撕开了。
论文借用了操作系统的说法:负责算出这份状态的分支叫生产者(producer),需要读这份状态才能继续的分支叫消费者(consumer)。当生产者和消费者落在同一轮 batch 里,消费者就有一个同轮依赖(same-round dependency):它的前缀确实命中,但它要读的状态要等这一轮的生产者执行完才存在。论文的实现语义是严格的:第 轮产生的状态进入 ,而不是 。同一轮内的扫描看不到本轮尚未发布的结果。
这也解释了一个反直觉的现象:即使工作负载是“冷流”(不同问题之间完全不共享缓存),同轮依赖依然会出现。RadixFlow 的实验负载把每个问题拆成四个分支:文档 + 问题 + 一个候选答案。四个分支共享同一篇文档的前缀,第一个分支算出文档部分的状态后,另外三个分支才能从文档末尾继续。冷流只是说问题与问题之间不共享,问题内部的分支照样共享。
气泡是从哪一行漏出来的
把调度器行为抽象出来,问题就变成一个在线装箱问题。论文定义了每轮的两种预算:最多 行(row)、最多 个待调度 token。
一轮开始时,等待集合 里是已到达、已通过准入、仍有未调度 token 的分支。调度器按原生顺序 逐个检查,每次检查会得到一个“就绪结果”,取值只有三种:
是当前已构造的部分 batch。 表示 仍然可行——注意这是比“状态就绪”更强的条件,它还要求分支能装进剩余预算。 表示这次拒绝的唯一原因是:匹配边界 上的某个分量正被当前批次里某个生产者 写入,也就是发生同轮依赖。 则涵盖其余所有失败原因:预算溢出、索引未命中的分配失败等等。
有了这三种结果,就可以精确定义问题。用 表示本轮空着的行数。可避免的执行气泡指的是:
也就是说:这一轮明明还有空行,而且等待集合里明明有分支在剩余预算下完全合法,它却没有被选中。
再看基线是怎么产生这种气泡的。论文考察的参考路径是 vLLM 0.29.0 的 Scheduler.schedule:它按顺序扫描等待队列,对每个请求尝试从分配器取块,一旦取块失败就结束整个等待队列的扫描。混合模型的缓存管理器(Mamba 一类状态的管理器)遇到“本步已缓存块”的哈希再次被请求时,会报一个超过池容量的需求——这是它拒绝“在同一轮里复用刚生产、尚未发布的状态”的方式。这个“本步已缓存块”集合在下一步才会被清空,所以同一轮内状态永远不会对本轮可见。
于是扫描规则可以写成一句话:顺着原生顺序 走,遇到第一个结果不是 的分支就停。论文把这种规则叫作 prefix-stop。一旦某个生产者被选进 batch,它后面的消费者就会得到 ,扫描在消费者处终止,消费者之后的所有 分支全部落选——这正是操作系统里的队首阻塞(head-of-line blocking)。
Figure 1 的量化结果:两条调度路径处理同样的 15 个片段、12,970 个 token,prefix-stop 路径用了六个四槽轮次、留下九个空槽;继续扫描的路径用了四轮、只留一个空槽。这不是一个微小的调整,而是吞吐结构上的差别。
顺带给出一个关于“还能压缩多少轮”的下界,论文用它说明四轮已经接近最优。对固定的一组工作片段,设总 token 数为 、总行访问次数为 、依赖链深度为 ,任何把这些片段排进轮次的调度都满足
三项分别来自 token 预算、行预算和依赖链。在 Figure 1 里 、,,,依赖链最深为两段,所以四轮恰好达到容量下界。这个下界只针对固定工作片段成立;在真实在线流中,还会被到达时间和缓存轨迹影响。
只拦住消费者:state-ready traversal
RadixFlow 的核心改动只有一条,论文叫它 state-ready traversal(状态就绪遍历)。它保留原生顺序、原生状态检查和原生缓存管理,只改变“遇到非就绪结果时怎么办”。
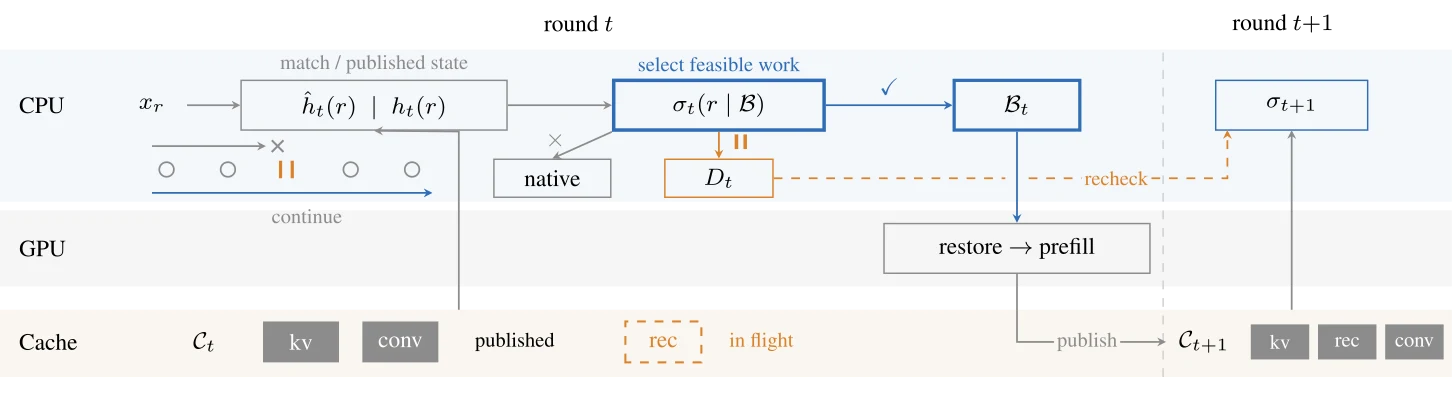
上图(论文 Figure 2)把一次分支的生命周期和扫描的关系画清楚了。一个分支要先做前缀查找,再做原生状态检查;通过检查的分支才能进入 batch 构造;被选中的分支随后要恢复状态、执行恢复后的前向、发布新状态,之后才能被下游消费者复用。图下方的小图对比了两种队列形态:基线在第一个不满足条件的消费者处截断;RadixFlow 跳过它继续往后看。
算法本身短得可以整段背下来:
1: 对已到达分支做有界准入2: B ← ∅ ; D_t ← ∅3: for r in 已准入分支,按原生顺序 ≺:4: σ ← σ_t(r | B) # 原生状态检查5: if σ = Ready:6: 通过原生分配器选中 r7: B ← B ∪ {r}8: else if σ = Blocked:9: D_t ← D_t ∪ {r} # 保留登记,进入等待队列10: 继续扫描11: else:12: 执行原生动作 # Other:可能直接停止扫描13: 执行 B_t = B;把新状态发布进 C_{t+1}14: 唤醒 D_t 中的分支,下一轮重新检查这里有三个容易被忽略的设计点。
第一, 是在扫描位置“当场”读取的,参照的是到目前为止已构造的部分 batch,而不是最终的 batch。这意味着一个分支的结果取决于它前面已经选了谁。先选生产者、后选消费者,消费者才 ;顺序反过来,消费者在本轮开始时的状态就是就绪的(甚至可能压根不需要生产者)。顺序敏感性是原生的,RadixFlow 没有改它。
第二, 走原生动作,不继续扫描。论文专门解释了为什么:继续扫描所有分配失败会把不同原因混在一起。 是因为“生产者已在同一批里”,只等一轮就能解决; 可能是资源上限或者别的失败,继续硬扫没有意义,还可能把基线里本就存在的保护逻辑绕过去。区分这两类失败,是这套改动安全性的关键。
第三,被拦住的分支并不是被丢弃。它保持登记状态,进入本轮等待队列 ,下一轮开始时重新做一次原生检查。如果那时生产者已经发布,它就变成 。
两条性质
论文证明了两件事(附录 D 的 Proposition 2)。
可行性:RadixFlow 在任意固定轮里构造出的 batch 都是合法的。证明靠归纳:初始 可行;第 7 行只在 (即 可行)时加入;第 9 行只动等待队列、不往 batch 里加东西; 的原生动作不会加入一个通不过原生检查的分支。所以整个扫描过程中每个部分 batch 都合法。
包含关系:在固定状态 和固定顺序下,prefix-stop 得到的 batch 一定是 RadixFlow 得到 batch 的子集。证明是逐位置对比:两个扫描在遇到第一个非 分支之前看到的是同一个部分 batch、同样的结果、同样的 token 配额;如果那个分支是 ,两者动作相同、batch 相同;如果是 ,RadixFlow 只会继续加入分支,不会移除,于是前缀-stop 的 batch 被包含。
无剩下气泡:如果扫描没被 终止,且“就绪性随 batch 增长单调不减”(Assumption 1: 时,若 则 ),那么本轮不存在可避免气泡。理由直白:扫描看遍了所有分支,任何没被加入的分支在当时的部分 batch 下都不是 ,而部分 batch 只增不减,由单调性它在最终 batch 下也不是 。
单调性假设并不总是自动成立的:加入更多分支意味着可能引入新的生产者,而新生产者恰恰会让原本 的分支变成 。论文明确把这一点限定在它所评估的同步调度器上——该调度器在扫描期间不发布任何本轮完成的状态,而且“本步已缓存块”的拒绝在下一步前一直有效,所以一个被拦住的消费者不会随着 batch 变大而变得可选。换到别的后端,这条性质需要重新验证。这是这类“改选择规则”的系统工作最值得保留的一句提醒:不变式是后端语义给你的,不是算法本身给的。
代价
继续扫描要多做两类工作:额外的队列访问,以及被拦住分支的重复状态检查。每个被拦住的分支每次扫描只会被访问一次,所以额外开销随被检查的分支数线性增长。论文没有给出详细的微基准,但从结果看这部分开销远小于它回收的轮数。
准入:什么时候把到达的工作放进来
traversal 解决的是“扫描途中被截断”,但它有个前提:工作得在等待集合里。如果到达的分支还没来得及进等待队列,扫描也没法选它们。这就是第二个组件 flexible admission(弹性准入)。
准入本身是一个古老的权衡:等久一点,能凑出更大的 batch、更少的轮数;等短一点,单个请求等待时间更短。现代框架里常见的做法是有界动态批处理(bounded dynamic batching):先等一小段固定时间再开扫。论文的做法不改变等待机制,而是决定释放条件。
论文把准入截止时间设为 5 ms。这个数字不是凭空来的:在 Qwen3.5-0.8B 上,原生 worker 调用的平均间隔是 52.95 ms,5 ms 大约是这个间隔的 9%。更重要的是它在所有模型上固定不变,而不是拿评估结果去调优。
一个分支可以比截止时间更早被释放,条件有三个,满足任意一个即可:
- worker 里已经有正在运行的工作——既然这一轮本来就有事做,不必再等。
- 已经持有的分支填满了可用行数。
- 已持有分支的剩余 token 需求量填满了 token 预算。
第三个条件里的“剩余需求”按当前原生缓存可用性计算:如果某个分支现在只能冷启动,那它会消耗全部 token;如果它有命中,剩余需求就小。这个细节让释放条件贴合真实负载形状——一个几乎全命中的分支不该单独占住一个等待周期。
论文还明确了另一件事:一个分支不会为了等同组其它分支而滞留。每次分支单独参与准入,不等整个请求组到齐。这和后面要讲的备选方案直接相关。
为了把准入与 traversal 的效果分开,论文设计了 Radix+Flex 这个消融:保留弹性准入、移除 state-ready traversal。另外还有 Radix+Timer5 / Radix+Timer10 两个只用固定截止时间的对照。这样四个实验臂的差别就很清楚:Radix 是原生;Radix+Flex 只改准入;RadixFlow 在它上面再加 traversal;RadixFlow+Frag 再加一个碎片处理。Table 1 里每个模型一组数字,可以直接把三种增益拆开读。
碎片处理:为什么它只是消融
第三个组件 fragmentation extension(碎片处理)针对的是残余预算太小的情况。假设一行的 token 预算还剩一点,只能把一个分支切出一小段来跑,这次拆分会让该分支下一次的对齐片段变短。RadixFlow+Frag 在这种情况下先推迟这个分支,回头去找别的更合适的片段放进剩余预算;实在找不到再让它拆。
这个思路可以减少“切得太碎”造成的重复行访问,但它也可能拖延有效进展——被推迟的片段本可以马上跑。论文把它放在消融位置而不是主方法,理由在附录 A.4 里说得很直白:碎片处理会同时影响后面的 batch 打包和缓存边界,进而影响后续消费者的命中轨迹,是一个耦合并发效应。作者不想在看到哪个变体赢了之后再挑主方法,所以默认主方法就是不带 Frag 的版本。实验里 Frag 的确在 27B 上又降了 5.0% 延迟、还多出 1.66 个百分点的复用(因为推迟拆分会改变之后消费者遇到的缓存边界),但也并非所有模型都更好。
实验:五个混合模型,一组全注意力对照
设置
负载由 QuALITY(Pang 等人,2022)的 1034 道阅读理解题(62 篇文章)和 RACE-M(Lai 等人,2017)的 517 道题(128 篇文章)组合而成。每道题对应一个逻辑请求,拆成四个分支,每个分支包含文档、问题和一个候选答案,每个分支只生成一个 token。这样构造的理由是:每个问题里四个候选答案共享同一篇文档,正好模拟“多候选打分”和“候选对比评判”这类 prefill 主导的负载——生成侧几乎没有 decode,重点完全落在预填充调度上。
三种负载流用缓存命名空间实现:冷流(问题之间不共享缓存)、复用流(同一文档上的问题重复出现)、混合流(文档交错出现)。每种流两种输入顺序,三种流两种顺序一共给每个策略 9306 个逻辑请求。
所有策略跑在 A800 上,vLLM 0.29,eager 执行,关闭异步调度,分配器利用率 0.8。六个策略共享同一套前缀索引、状态检查、模型权重与缓存原语,唯一的差别就是调度规则。这点很重要:如果换一个框架版本对比,收益可能来自实现质量而不是调度思想。
模型有五个混合:Qwen3.5-0.8B、4B、9B、27B,以及 Nemotron-Nano-9B-v2(Mamba2 混合)。还有一个 Qwen3-8B 作为全注意力对照组(FA)。
行预算 和 token 预算 并不是随意取的:先用 64 道留出题,按 vLLM 的自动调优器只对原生调度器标定一次,然后冻结,所有策略共用。这是防止“某策略恰好配到了好预算”的关键。Qwen 系列统一给 5 req/s 的到达率,对较大的模型构成过载;Nemotron 给 1.5 req/s,约是其标定原生吞吐的 80%。
主结果
Table 1 的最直观读法:同条件、同预算、同到达轨迹下,只比较策略。
| 模型 | 预算 | Radix 延迟 | RadixFlow 延迟 | 轮数变化 | 复用率变化 |
|---|---|---|---|---|---|
| Qwen3.5-0.8B | , | 0.256 s | 0.232 s | 19,803 → 17,610 | 81.362% → 81.366% |
| Qwen3.5-4B | , | 13.1 s | 10.0 s | 13,424 → 10,146 | 80.405% → 80.431% |
| Qwen3.5-9B | , | 26.7 s | 24.8 s | 11,042 → 7,444 | 79.686% → 79.696% |
| Qwen3.5-27B | , | 164 s | 159 s | 11,748 → 6,529 | 68.497% → 68.508% |
| Nemotron-9B | , | 2.44 s | 2.15 s | 14,338 → 9,613 | 75.939% → 75.950% |
| Qwen3-8B(全注意力) | , | 16.4 s | 16.4 s | 9,223 → 6,746 | 85.243% → 85.250% |
延迟下降幅度分别是 9.3%、23.6%、7.1%、3.1%,Nemotron 是 12.0%。复用率变化都在 0.03 个百分点以内——这个数字回答了最关键的正确性问题:RadixFlow 没有牺牲缓存命中来换速度,它只是在同样的命中下把工作塞得更密。
对比延迟和轮数两列,能看到一个值得注意的现象:27B 的轮数减了 44%,延迟只降了 3.1%。这不是策略失效,而是负载过载时排队延迟主导了客户端延迟;轮数减少主要体现为吞吐和总耗时。4B 和 9B 则处在能看见延迟收益的区间。再注意一下全注意力对照:轮数从 9223 降到 6746,但延迟完全没有变化(16.4 s vs 16.4 s)。这个看起来反直觉的数据恰恰是论证的核心——下面单独讲。
增益来自哪里:准入还是遍历
Table 1 里的 Radix+Flex 和 RadixFlow 只差一个 traversal。在 Qwen3.5-27B 上,Radix+Flex 相对 Radix 只省了 1.6% 的轮数,而 RadixFlow 省了 44%。在冷、混合、复用三种流里,traversal 在 Flex 之上分别再减 44%、43%、44% 的轮数。冷流里依然有这么大的增益,印证了前面的分析:问题内四个分支共享文档前缀,同轮依赖不需要跨问题共享就能出现。
Table 2 从另一个角度给出了证据:每轮平均行数和首次选中等待时间。
| 模型 | Radix 行数/轮 | RadixFlow 行数/轮 | Radix 首次选中 | RadixFlow 首次选中 |
|---|---|---|---|---|
| Qwen3.5-0.8B | 3.63 | 4.10 | 0.057 s | 0.049 s |
| Qwen3.5-4B | 5.42 | 7.31 | 12.576 s | 9.273 s |
| Qwen3.5-9B | 6.61 | 10.02 | 25.682 s | 23.255 s |
| Qwen3.5-27B | 6.51 | 12.11 | 160.538 s | 153.314 s |
| Nemotron-9B | 2.91 | 4.38 | 1.898 s | 1.582 s |
| Qwen3-8B(FA) | 4.28 | 5.86 | 15.817 s | 15.813 s |
27B 上每轮行数从 6.51 涨到 12.11,接近翻倍;首次选中等待减少了 4.5%。行数越满,能扫到的可行分支越多,说明气泡被填上了,而不是靠更长的等待换来的。
Nemotron-9B 的分解不一样:它的增益主要来自准入——单准入就减了 27% 的轮数,traversal 再减 8%。原因是它的原生占用只有 16 行里的 2.91 行,在较低到达率下,准入有足够空间把工作攒到一起;遍历在这上面能腾出的额外容量相对少。这个差异说明两部分机制在不同负载形状下权重不同,不能只报一个总数字。
全注意力对照(Qwen3-8B, FA)给出了最关键的反证。准入在它上面仍然有效——Radix+Flex 的轮数从 9223 降到 6782,因为同前缀分支仍可以被准入攒到一起。但从 Flex 到 RadixFlow 只从 6782 降到 6746,几乎不动;延迟保持在 16.4 s。原因很直接:全注意力模型里循环状态检查根本不活跃,同轮依赖这一信号不存在,traversal 自然没有可扫的 分支。如果没有这组对照,读者完全有理由怀疑收益只是“多等了 5 ms”或者“改了准入”的副作用。
轮数不等于时间:成本账单
轮数少了,时间不一定同比增长。一方面,一个大轮次比几个小轮次更便宜——kernel 启动、调度开销被摊薄;另一方面,变大以后的轮次,每轮的单次成本也可能变化(不同的 kernel 形状、更长的时间线)。论文用一个精确的恒等式把这两部分分开。
记每个 worker 调用的耗时为 (host 侧 wrapper 的耗时区间,包含 CPU 工作和等待 GPU 的时间),设
是非空全局 worker 调用轮数, 是平均每轮成本。对基线(下标 0)与策略(下标 1),总耗时差可以精确拆成
第一项是“少做了多少次调用”的收益,第二项是“剩下每次调用变贵了多少”的代价。这个恒等式没有近似:两项相加严格等于总耗时的变化。
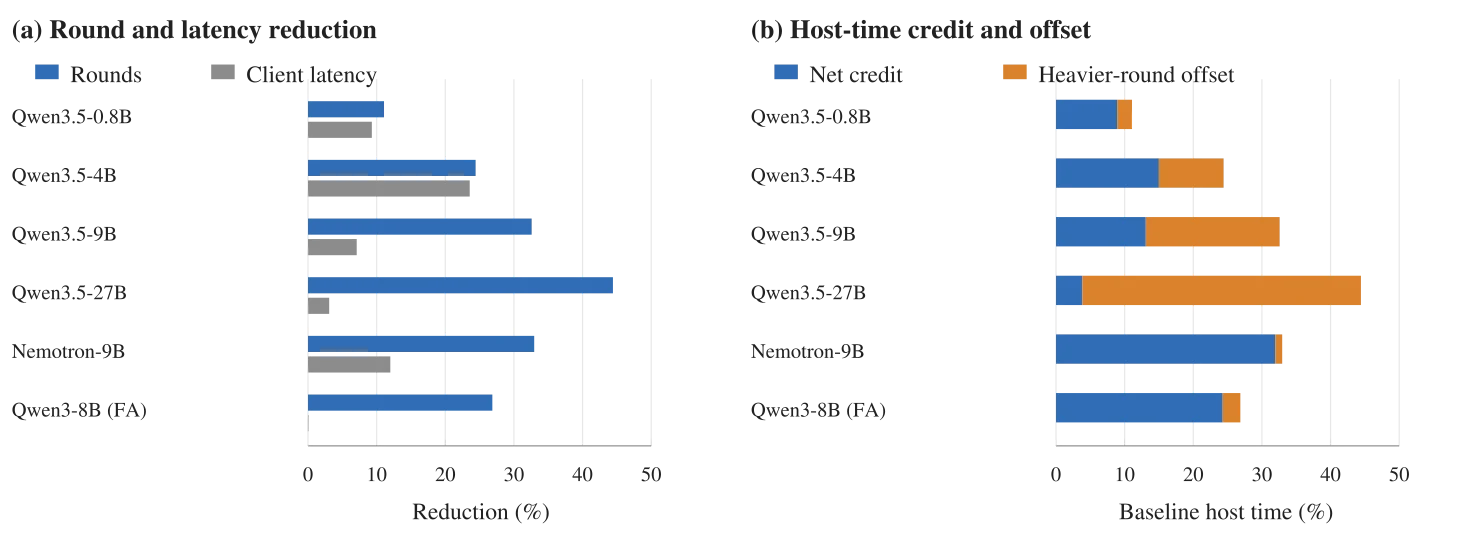
上图(论文 Figure 3)就是这条恒等式的可视化。几个具体数字值得记下来:27B 上每轮 token 数涨了 80%,但每千个被调度 token 的 host 成本从 183 ms 降到 175 ms——也就是说,大轮次在按 token 计摊薄之后其实更便宜;总 host 耗时下降 3.8%,与 3.0% 完成吞吐提升一致。9B 上,成本漂移抵消了约 60% 的轮次收益。4B 是两者都讨好的情况:轮数降了约 24%,剩余轮成本没有明显变贵,于是延迟降幅也最大。
这解释了为什么必须报告“轮次收益”和“成本漂移”两个分量:只看轮数会高估延迟收益,只看延迟又看不出机制是否生效。
轮次饱满度与尾延迟
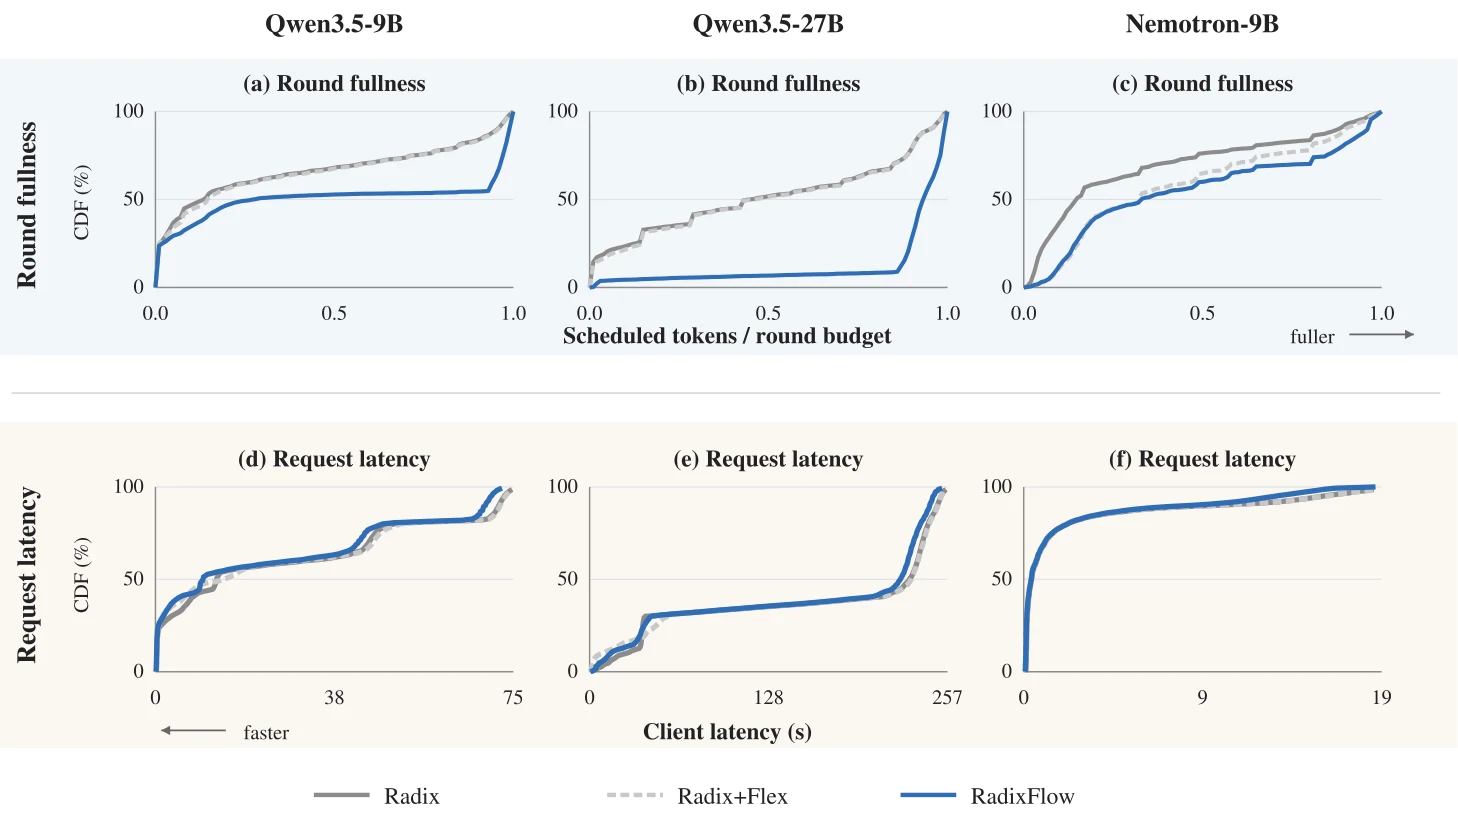
上图(论文 Figure 4)把分布层的效果画出来了。上排三个子图是每轮行数分布:RadixFlow 的曲线整体右移,说明“半空的轮次”在减少;下排是请求级延迟分布,右移意味着更慢的请求变少。分布变化比均值更能说明问题——调度器改善通常先体现在尾部,因为尾部往往就来自被阻塞的那些请求。
9B 上 p95 从 73.3 s 降到 70.6 s,而全注意力对照组尾部分布基本重合。
还有一条补充证据:解码输出的首 token 一致性。在五个混合模型上,RadixFlow 与 Radix 的首 token 完全一致的比率为 98.477%(0.8B)、99.850%(4B)、99.680%(9B)、99.995%(27B)、99.688%(Nemotron),全注意力对照 99.441%。没有做到 100% 的原因是:调度改变了 batch 组成,在 eager、非确定性的 GEMM 归约下,浮点累加顺序会变动,个别 token 因此翻转。这正是 Batch-invariant 推理完全拆解:五个推理框架如何让同一请求不再随 batch 漂移 讨论的那类问题,调度层面的改动天然会触碰它。
与边界条件的关系
论文在附录里系统扫了到达顺序、负载水平、数据集和扩展版本。结论可以概括成两句:在每一个混合模型上、两种输入顺序下,平均客户端延迟都下降;但延迟下降的幅度取决于队列长度——队列短时,更早被选中直接缩短等待;过载时,打包更多体现在排空积压的效率上(27B 就是这种情形)。数据集的相似性问题不属于本文的讨论范围,但作者明确说明只用了精确前缀命名空间,没有引入任何近似语义缓存。
为什么没有选另外几条路
论文的附录 A 记录了四条被放弃的设计路线,这些讨论对理解设计边界很有价值。
为什么不用更精细的索引? 第一个念头是把索引做得更准,把更多精确匹配变成“可执行的命中”。但作者的结论是:索引能定位共享 token 边界,但混合模型在该边界上可能缺状态;把这种匹配计为可执行命中会高估复用。于是他们把目标从“省 token”改成了“省轮次”——更短的片段不一定让全局轮数减少,因为可能受行限制、对齐块或依赖顺序影响。这两个量互为补充,都不等价于耗时。
为什么不在每个分支都存 checkpoint? 在一个新观察到的分支处存 checkpoint,只有完整状态可用时才有意义;为它专门跑一次串行的 prefill,成本可能等于它想省下的时间。在普通前向中顺手捕获可以避免额外的生产者,但仍有状态拷贝、发布、临时缓冲和保留成本。作者的原型里出现过“未被使用的 checkpoint”和“逻辑节点失效后仍然驻留的内存”。于是最终选择很保守:checkpoint 的构造和淘汰交给原生后端,只改变对已知同轮依赖的反应。这是一个常见的工程判断:把收益明确、边界清楚的一小块改掉,把不确定的大块留给专门的后续工作。
为什么不整组等待? 等整个请求组到齐可以凑出更密的 batch,但也可能让一个冷分支在其它分支还没到时一直干等,期间没有任何可用的共享状态;等到之后再验证正确性也无法退还等待时间。所以论文把准入和状态就绪拆成两个层面:准入只依据已到达的工作和一个很短的等待上限;recheck 只针对一个具体的原生拒绝,而不是让整组一起等。
为什么不单独最小化轮数? 多行的轮次可能比它替代掉的几个轮次更贵;打包方式的微小变化也可能让执行落到不同的 kernel 形状。开发阶段就出现过“token 更少、轮数更少,但完成时间没有缩短”。这直接催生了上面的成本恒等式,也解释了为什么全注意力对照如此重要——一个不该生效的规则,不能靠准入的收益拿分。
横看:淘汰策略如何毁掉前缀复用
RadixFlow 的整个故事围绕一件事:命中不等于可执行。同样的直觉在完全不同的工作负载上会以另一种形态出现——Agent 场景。
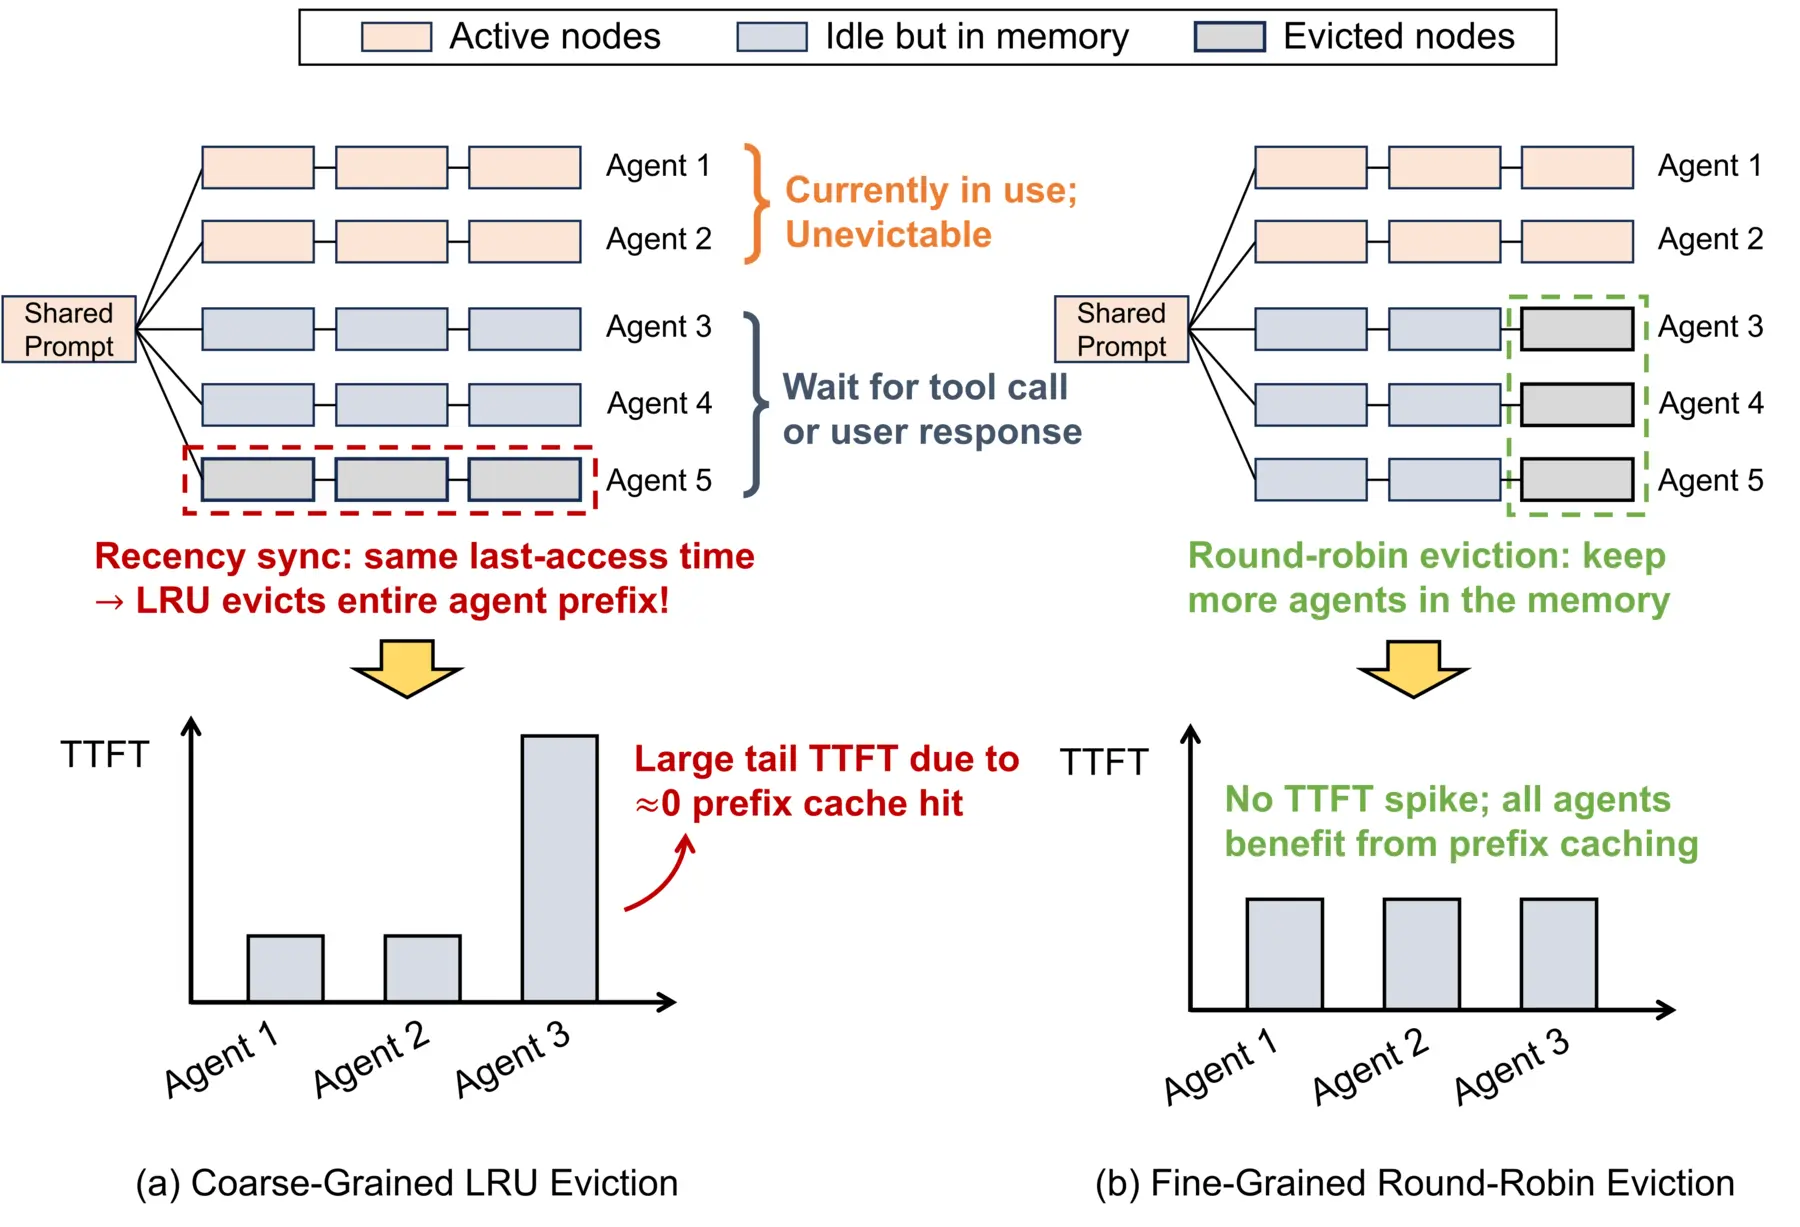
Agent 系统的调用是长周期、多轮次的:每个新请求都在上一次的上下文后面追加内容,因此每次请求都会命中“这个 Agent 迄今为止的全部历史”。前缀匹配会把这条路径上的所有缓存节点同时刷新——这就是 RR-Evict(arXiv:2609.32278)所说的新旧同步(recency synchronization)。节点级 LRU 在这种访问模式下会退化成 Agent 级淘汰:一旦需要回收内存,最久没被访问的那个 Agent 的整条历史几乎全部被清掉;等它回来,命中只剩下那段短共享系统提示,几乎等于全量重算,TTFT 出现离群值。
RR-Evict 的做法是把回收需求在空闲 Agent 之间轮转,每次只从一条轨迹的尾部切一块,保证留下的部分仍然是一段连续的、可复用的前缀。论文把有用区间形式化为:当 ( 条轨迹、其中约 条处于活跃状态、 是前缀当量的缓存容量)时,理想轮询给每个空闲轨迹保留相同比例
是每个 Agent 处于空闲状态的时间占比、 是可保留比例、 是返回时需要重算的比例。LRU 保留 个完整前缀、清掉其余 个,两者的期望重算成本相同(都是 ),但分布完全不同:LRU 把全部成本压在一小部分返回的 Agent 上,轮询把它均摊。于是尾延迟 分位上,LRU 在 时出现整条缺失,轮询只出现 比例的缺失。实现落在 SGLang 上,P99 TTFT 最多降 75.4%,P99 未命中 token 数最多降 65.7%。
两类问题放在一起看,能得到一个更一般的结论:前缀缓存的收益由三个独立环节决定——命中身份(匹配到哪一段)、可执行性(混合模型要状态就绪,Agent 要轨迹级淘汰策略)、放置与公平(同一段的命中应该先给谁、内存压力时该丢谁的尾巴)。第一环的索引技术已经相当成熟;后两环才是近年系统性工作的主战场。
站内已有的几篇可以串起来读:RadixAttention 完全拆解:用前缀树自动复用 KV Cache 讲清了前缀树的节点组织与最长匹配;前缀缓存淘汰完全拆解:为什么 14 种复杂算法赢不了 LRU 讨论了常规负载下 LRU 的优势与计算感知淘汰;SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环 给出了锁引用与写回的具体实现;vLLM 源码完全拆解(三):Scheduler.schedule 如何分配 Token 预算与 KV Block 展示了 RadixFlow 所改写的那个扫描循环原生长什么样。混合模型本身的递推状态机制,可以顺着 Kimi Delta Attention 完全拆解:固定循环状态如何替代不断增长的 KV Cache 和 YOCO 完全拆解:Decoder-Decoder 架构如何让 KV Cache 只存一次 往下读。
工程落点:在真实框架里落地要改什么
把这篇论文放回真实的框架,可以整理出四条与实现直接相关的结论。
第一,扫描循环的“遇到失败就停”是一条隐式不变式,它建立在一个前提上:失败就意味着“这个请求现在不能跑”。在混合模型上这个前提不再成立——存在一类失败,它的语义只是“这个请求等一轮就行”。把这两类失败区分开,是改动的最小单元。在 vLLM 0.29 里,对应的就是调度器扫描对分配失败的处理,以及混合缓存管理器在“本步已缓存块”上的拒绝。读者如果去比对自己的框架版本,可以按这个特征去对:是否存在一套“只在当步可见”的缓存标记,以及它对未命中分配返回的是什么错误。
第二,正确性靠的是原生检查没有被绕过。RadixFlow 的证明只依赖“ 才加入”和“ 走原生动作”,不依赖任何新的缓存语义。这意味着改造时最安全的方式是:不加新状态、不改淘汰、不动恢复路径,只在“拒绝”上做分支。
第三,单调性假设是后端语义给的。同一个算法,换一个允许扫描过程中发布状态的异步后端,或者换一个把生产者的部分结果提前暴露的实现, 的可避免性定义就必须重新推。这一点在写其他调度的对比时同样适用:调度算法的“最优性”往往是对某个具体后端的语义而言的。
第四,收益要对账。RadixFlow 给出的成本恒等式是一个很好用的工具:在任何调度改动之后,把“轮次收益”和“成本漂移”分开报告,才不会把“每轮变贵”误读成“调度变差”,也不会把“轮数大降”误读成“延迟大降”。全注意力对照同理:任何针对混合模型的改动,都应该配一个在规则不活跃时毫无收益的对照组。
局限与还没答的问题
论文的局限写得很克制:实验集中在“候选条件下的预填充、每分支生成一个 token”这一种形状,模型、预算、到达轨迹都是冻结的。worker 调用计时和解码一致性是主要测量对象。作者自己也列出负载扫描、生产级调度和更细粒度的依赖追踪是下一步。
从机制角度看,还有几个值得跟踪的点:
状态快照的粒度与调度是耦合的。RadixFlow 保留了原生快照策略,但快照间隔会影响 与 的差距,也会影响 traversal 能扫出多少可行分支。如果把快照策略一起优化,收益可能会再往前走一步——但这需要重新处理内存与重算的权衡。
多个生产者的链式状态。实验负载里每道题四个分支共享同一段文档,依赖是单层的。如果依赖形成链(例如多段增量文档逐段追加),RadixFlow 仍会每轮推进一层,但轮数上界会被依赖深度 卡住;这时准入和快照策略的重要性会更高。
与投机解码、分块预填充等机制的交互。论文使用的是 eager 执行和关闭异步调度,避免了“步与步之间可见性”的复杂度。在开启异步调度的现代框架里, 的判定语义会变,论文的单调性假设不再自动成立,需要重新定义。
与全注意力模型的差异是否在所有负载下都显著,取决于混合模型在全注意力层的占比和层的分布。Nemotron-H 的 8% 全注意力层只是一个典型配置;不同混合方案会对“同轮依赖出现的频率”产生直接影响。
小结
RadixFlow 的贡献可以浓缩成三句话。
第一,它指出前缀缓存的可执行性在混合模型上被一条隐式不变式掩盖:缓存命中在过去等价于“能跑”,现在不再等价。论文把这个问题拆成前缀身份、状态就绪与轮次放置三层,并给了一个精确的“可避免气泡”定义。
第二,它用一个极小的改动回收漏掉的容量:只拦住等待同轮生产者的那一个消费者,继续扫描;其它失败照旧。这个改动不改变任何缓存语义,只改变选择规则,并且可以证明在固定轮里得到更满的 batch。
第三,它诚实地记录了收益的构成:在五个混合模型上平均延迟降低 3%–24%、复用率几乎不变;在轮数减少和延迟下降之间,用成本恒等式把“少跑几次”和“每次更贵”分开;用全注意力对照证明,规则真正生效的地方只在混合模型上。
把这些放回更长的路线来看:混合模型把“记忆”从一张逐 token 的 KV 表,变成了 KV 表加一组固定尺寸的递推状态。新的数据结构必然带来新的调度问题——状态就绪只是第一个。下一次你看到一个前缀命中却卡住的请求,可以顺着这条链去查:命中在哪、状态在哪、生产者在哪一轮。
参考资料
- RadixFlow: Filling Execution Bubbles in Prefix-Cached Hybrid LLM Serving
- RadixFlow 论文 HTML 全文(图表与附录)
- RR-Evict: Fine-Grained Prefix Cache Eviction beyond LRU for Agentic LLM Serving
- Nemotron-H: A Family of Accurate and Efficient Hybrid Mamba-Transformer Models
- Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality(Mamba-2)
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- SGLang: Efficient Execution of Structured Language Model Programs
- SGLang GitHub 仓库
- vLLM GitHub 仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



