


SGLang 源码完全拆解(十四):多模态输入——图像如何在文本流里占位、编码与回填
前十三篇走完了一条完整的文本推理链路:请求入口、Scheduler 状态机、PrefillAdder 的预算、Radix Cache 的所有权、Overlap Scheduler 的重叠、ForwardBatch 到 ModelRunner 的执行边界、注意力后端、CUDA Graph、采样与语法、投机解码、P/D 分离、多 LoRA。这条链路的共同前提是:一条请求的内容就是一串 token id,它们全都来自词表,位置关系就是下标关系。
多模态输入打破了这两个前提。图像进入模型时,既不是词表里的 id,长度也不由用户显式指定——一张 1024×1024 的图会被视觉编码器切成多少 token,取决于 patch 大小、切图策略和分辨率处理规则,而这个数字要到预处理完成后才知道。于是整条调度链路必须回答几个新问题:图片 token 在预算阶段怎么计数?KV Cache 怎么知道哪些位置属于图片、不该被覆盖?前缀缓存怎么判断两张图是不是同一张?分块预填充把图片从中间切断时,视觉编码器要不要重跑?答案藏在 multimodal_processor、mm_utils、mm_schedule 和 ScheduleBatch 的几处关键代码里。这一篇就沿这些代码走一遍。
从两个前提出发:图像为什么不能像文本一样处理
先看 Qwen2-VL 的处理链路:图像按原始分辨率切成 patch,patch 数量决定视觉 token 数量,ViT 输出再压缩后接入语言模型。M-RoPE 的位置外推能力是这条链路能处理长视频的前提——论文在 Video-MME 中等长度视频上的测试显示,借助 M-RoPE,模型在推理长度超过 16384 token 的最大训练长度时仍保持稳健表现。
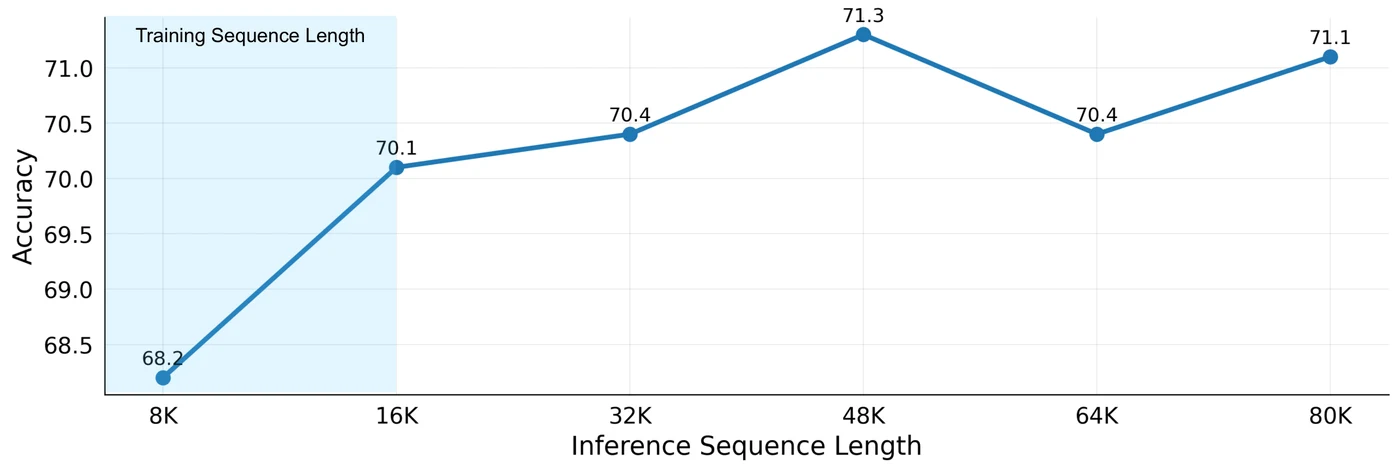
(图片来源:Qwen2-VL 论文 arXiv:2409.12191 Figure 5)
关键点在于:视觉 token 的数量是动态的。Qwen2-VL 引入了 naive dynamic resolution,图像按原始分辨率切 patch,不做固定尺寸重采样。论文 Figure 4 的说明是:小图会被上采样到超过指定的 min_pixels 阈值再送入模型;在合理范围内增大图像尺寸,InfoVQA、HallusionBench、OCRBench 这类感知任务的表现会提升。
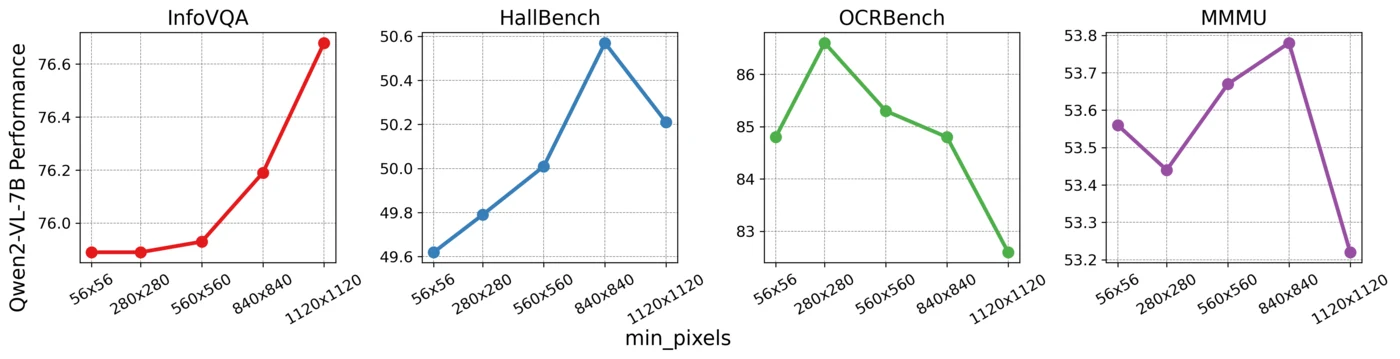
(图片来源:Qwen2-VL 论文 arXiv:2409.12191 Figure 4)
这句话透露了推理系统的第一个麻烦:同一张图,用户设置的 min_pixels 不同,产生的 token 数就不同。token 数不同意味着 KV 槽位数量不同、显存占用不同、调度预算不同。
下一步看这条链路在系统层面意味着什么。Qwen2.5-VL 的框架图说明写得很直接:视觉编码器按原始分辨率处理输入,支持动态 FPS 采样;不同尺寸的图像和不同帧率的视频被动态映射成不同长度的 token 序列,而 MRoPE 在时间维度上把时间 ID 对齐到绝对时间。
(图片来源:Qwen2.5-VL 技术报告 arXiv:2502.13923 Figure 1)
「动态映射成不等长 token 序列」这一句,正是推理系统全部复杂度来源的浓缩表述。一个模型如果约定「每张图固定 576 个 token」,调度器只需要在遇到图像标记时加上 576 就能完成预算;而动态分辨率下,这个数字要等预处理算完 patch 数才知道。
第二个麻烦来自位置编码。文本的 RoPE 只需要一个下标,图像需要二维坐标,视频需要三维坐标。Qwen2-VL 用 M-RoPE 把旋转位置编码拆成时间、高度、宽度三个分量:
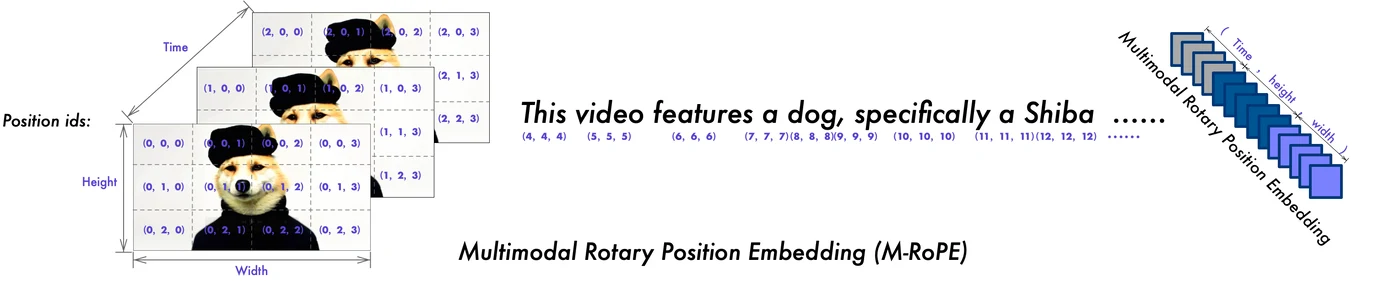
(图片来源:Qwen2-VL 论文 arXiv:2409.12191 Figure 3 M-RoPE 示意图)
论文的消融表显示,用 M-RoPE 相比 1D-RoPE 在视频基准上提升明显(NextQA 43.9 → 46.0,STAR 55.5 → 57.9),在图像基准上也有小幅提升(MathVista 39.2 → 43.4)。这说明位置信息不是可选的装饰,而是模型正确理解空间关系的前提。于是推理系统必须为每条请求额外计算、存储并传递一套 M-RoPE 位置张量。
DeepSeek-VL2 走的是另一条路:它把图像切成若干局部 crop,每个 crop 送进一个共享的 ViT,同时保留一张全局缩略图,再用一个视觉语言适配器对齐维度。
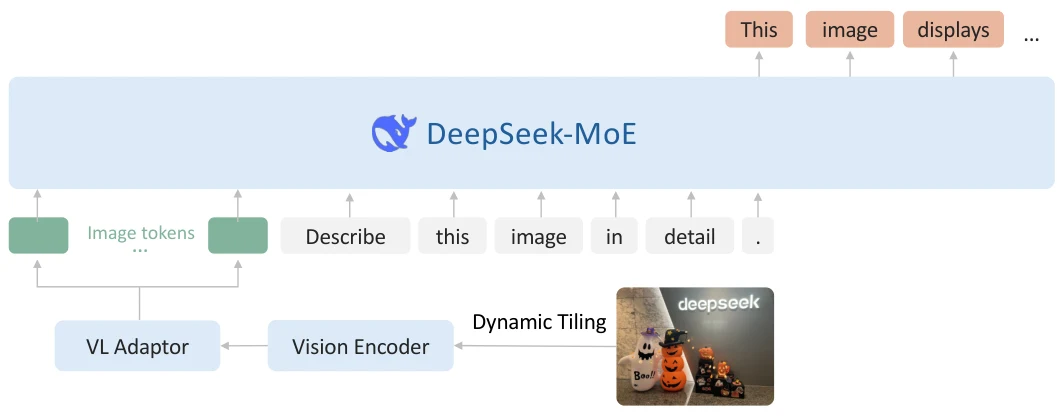
(图片来源:DeepSeek-VL2 论文 arXiv:2412.10302 主框架图)
两种设计的具体切图策略不同,但对推理系统提出的要求是一样的:
- 一条请求里可能有 N 个多模态 item(N 张图、或图 + 音频 + 视频)
- 每个 item 产生的 token 数在预处理完成前未知
- 每个 item 在 input_ids 里占据一段连续区间,这段区间的位置必须被记录
- 这段区间的内容会随 item 内容变化而变化,前缀缓存必须能识别这种变化
SGLang 的解法是把这一切压缩进两个数据结构:MultimodalDataItem 和 MultimodalInputs。
第一层抽象:MultimodalDataItem
打开 python/sglang/srt/managers/schedule_batch.py,找到 MultimodalDataItem:
class MultimodalDataItem(msgspec.Struct, kw_only=True, dict=True, array_like=True): """ One MultimodalDataItem represents a single multimodal input (one image, one video, or one audio). For example, if there are 3 images and 1 audio, there will be 4 MultimodalDataItems.
Each item has its own hash and pad_value, enabling per-image RadixAttention caching. """
modality: Modality hash: Optional[int] = None pad_value: Optional[int] = None offsets: Optional[List[Tuple[int, int]]] = None
format: MultimodalInputFormat = MultimodalInputFormat.NORMAL
# the raw features returned by processor, e.g. pixel_values or audio_features feature: Optional[MultimodalDataValue] = None # the precomputed embeddings, passed as final encoder embeddings precomputed_embeddings: Optional[MultimodalDataValue] = None keep_device_embedding: bool = False
model_specific_data: Dict[str, MultimodalDataValue] = msgspec.field( default_factory=dict )
identity: Optional[bytes] = None pad_values: Optional[Tuple[int, ...]] = None逐字段解释。modality 是枚举,只有三种取值:
class Modality(Enum): IMAGE = auto() VIDEO = auto() AUDIO = auto()offsets 是 item 在 input_ids 中占据的区间列表,List[Tuple[int, int]],每个元组是 (起始下标, 结束下标),两端都包含。为什么是列表而不是单个区间?因为一个视频可能被切成多段占位、一个 item 可能对应多个不连续的占位区间。build_token_modalities 里对 offsets 做了重叠检查:
if any(token_modalities[index] for index in range(start, end + 1)): raise ValueError( f"Overlapping multimodal token offsets at ({start}, {end})" )这段代码说明一个硬约束:不同 item 的占位区间不允许重叠。如果重叠,前缀缓存的哈希序列就无法唯一确定,后面会看到为什么。
feature 和 precomputed_embeddings 是一对互斥字段,源码注释写得直接:「One and only one of the feature and precomputed_embeddings will be empty」。区别在于:
feature是处理器输出的原始张量,比如 vision backbone 需要的pixel_values。它还没有经过 ViT,是待编码的输入。precomputed_embeddings是已经算好的最终 embedding。它已经是语言模型 hidden size 维度的张量,可以直接 scatter 进 input_embeds,跳过 ViT 前向。
这两个字段的存在本身就是一条优化路径的开关。默认走 feature 路径:调度器在 GPU 前向时现场跑 ViT。如果走 EPD(Encoder-Prefill-Decode 分离)架构,encoder 实例已经把 embedding 算好并通过传输通道送过来,接收方拿到的就是 precomputed_embeddings,不需要再跑 ViT。
format 字段对应这个区分:
class MultimodalInputFormat(Enum): NORMAL = auto() PROCESSOR_OUTPUT = auto() PRECOMPUTED_EMBEDDING = auto()model_specific_data 是一个开放字典,用来存各家模型自己的额外字段。__getattr__ 和 __setattr__ 被重写,让未知字段自动落到这个字典里:
# 读:未知字段从 model_specific_data 里取,取不到才抛 AttributeErrordef __getattr__(self, name: str) -> MultimodalDataValue: if name in self.model_specific_data: return self.model_specific_data[name] raise AttributeError( f"'{self.__class__.__name__}' object has no attribute '{name}'" )
# 写:声明过的字段走 msgspec 正常赋值,其余一律落进 model_specific_datadef __setattr__(self, name: str, value: MultimodalDataValue) -> None: if name in self.__struct_fields__: if name == "hash" and isinstance(value, int): value &= _MM_HASH_MASK msgspec.Struct.__setattr__(self, name, value) else: self.model_specific_data[name] = value这个设计让通用的调度代码不需要知道任何模型特有的字段名。Qwen2-VL 要传 mrope_positions,直接 item.set("mrope_positions", tensor) 就行,调度器不关心。代价是类型安全性下降——model_specific_data 的值类型是 object,运行时才可能报错。
identity 和 pad_values 是最微妙的一组字段,它们是整个多模态前缀缓存的基石,下一节专门讲。
占位符:让图像在 input_ids 里有一个可被识别的身份
现在来看核心问题:图像 token 如果不存在于词表里,它们在 input_ids 中是什么?
答案在 _compute_pad_values:
# Constant used as the base offset for MM (multimodal) pad values.# This ensures pad_values don't overlap with valid text token IDs.MM_PAD_SHIFT_VALUE = 1_000_000_MM_HASH_MASK = (1 << 64) - 1_MM_IDENTITY_BYTES = 32_MM_WIDE_PAD_TAG = b"sglang-mm-wide-pad-v1"
# Keep MM_PAD_SHIFT_VALUE + sentinel below 2**63 so it fits an int64 token ID._MM_WIDE_PAD_MASK = (1 << 62) - 1
def _compute_pad_values(identity: bytes) -> Tuple[int, ...]: """derive shared wide sentinels from an item hash or full identity digest""" digest = hashlib.sha256(_MM_WIDE_PAD_TAG + identity).digest() # prefix matching can stop after one sentinel, so each must retain wide bits return tuple( MM_PAD_SHIFT_VALUE + (int.from_bytes(digest[i : i + 8], byteorder="big") & _MM_WIDE_PAD_MASK) for i in range(0, _MM_IDENTITY_BYTES, 8) )一步步读。MM_PAD_SHIFT_VALUE 是一百万,所有占位值都从这个基数往上加。这样做的目的是让占位值不落在词表的 token id 范围内,避免了”占位符和真实 token 撞号”的问题。源码里还有一道保险:
@lru_cache(maxsize=1)def sanity_check_mm_pad_shift_value(vocab_size: int) -> None: if vocab_size > MM_PAD_SHIFT_VALUE: raise ValueError( f"Model vocab_size ({vocab_size}) exceeds MM_PAD_SHIFT_VALUE " f"({MM_PAD_SHIFT_VALUE}). " f"MM pad_values may overlap with valid token IDs. " f"Please increase MM_PAD_SHIFT_VALUE in schedule_batch.py." )报错信息里把补救措施也一并带上,直接指到 schedule_batch.py 里那个常量。
如果词表超过一百万(当前主流模型远小于这个数),启动时就报错,而不是等到运行时出现诡异的串扰。
占位值本身是对 identity 做 SHA-256 得到的。_MM_WIDE_PAD_MASK 取 62 位,加上 1000000 之后仍然小于 2^63,正好塞进 int64。_MM_IDENTITY_BYTES = 32 表示每次从 digest 里取 8 字节,循环四次,得到四个占位值。
如果只取 32 位做哈希,会有碰撞风险;取 62 位已经很大,但设计者仍然给了四个值。注释给了解释:「prefix matching can stop after one sentinel, so each must retain wide bits」。四个值轮流铺满整个占位区间,而不是重复同一个值。这样做的意义在下一节解释。
padding_sequence 负责把四个值循环铺开:
def padding_values(self) -> Tuple[int, ...]: return self.pad_values or (self.pad_value,)
def padding_sequence(self, length: int) -> List[int]: values = self.padding_values() repeats, remainder = divmod(length, len(values)) return list(values) * repeats + list(values[:remainder])一个长度为 10 的区间,四个值会铺成 [v0,v1,v2,v3,v0,v1,v2,v3,v0,v1]。
hash 字段是 64 位版本,用 _MM_HASH_MASK 截断。identity 是完整的 32 字节摘要。两者的关系在 set_identity 里写得很清楚:
def set_identity(self, identity: bytes) -> None: """Adopt a full 32-byte digest and derive four 62-bit pad sentinels.
``hash`` keeps the leading 64 bits for scalar consumers such as the embedding cache; the radix key uses the full sentinel pattern. """ if len(identity) != _MM_IDENTITY_BYTES: raise ValueError( f"multimodal identity must be {_MM_IDENTITY_BYTES} bytes, " f"got {len(identity)}" ) self.identity = bytes(identity) self.hash = int.from_bytes(identity[:8], byteorder="big", signed=False) self.pad_values = _compute_pad_values(self.identity) self.pad_value = self.pad_values[0]注释里的两个消费者是关键:embedding 缓存用 hash(单个 64 位值当 key),radix 前缀缓存用整串 sentinel 模式。这个区分不是随意划分的,它对应两种缓存的不同匹配粒度。稍后展开。
现在看占位是怎么被写进 input_ids 的。有两个入口,对应两种模型的占位约定。
第一种是 build_padded_input_ids,用于处理器已经给出了 padded ids 的情况:
@staticmethoddef build_padded_input_ids(input_ids, mm_items: List[MultimodalDataItem]): """pad the input_ids with mm_items if it's not already padded""" if input_ids is None or not mm_items: return None
for item in mm_items: if item.pad_value is None or item.offsets is None: return None
if isinstance(input_ids, torch.Tensor): padded_input_ids = input_ids.flatten().tolist() else: padded_input_ids = list(input_ids)
for item in mm_items: for start, end in item.offsets: padded_input_ids[start : end + 1] = item.padding_sequence( end - start + 1 ) return padded_input_ids第二种是 pad_mm_token_pairs,用于模型用一对起止 token 标记图像区间的约定(典型是 Qwen-VL 系的 <|vision_start|> ... <|vision_end|>):
def pad_mm_token_pairs( input_ids: array, mm_inputs: MultimodalInputs, *, data_token_pairs: Optional[List[Tuple[int, int]]], data_start_token_ids: Optional[List[int]] = None,) -> array: """Pad enclosed tokens without mutating input_ids; record item start offsets.
data_start_token_ids identifies new items, so slices can reuse an item's pad value. By default, every start token begins a new item. """ assert_int64_array(input_ids, "input_ids") pad_items = mm_inputs.mm_items mm_inputs.data_offsets = [] if data_token_pairs is None: data_token_pairs = [mm_inputs.im_start_id, mm_inputs.im_end_id] if data_token_pairs is None: print_warning_once( "No data_token_pairs provided, RadixAttention might be influenced." ) return input_ids start_token_ids = {s for s, _e in data_token_pairs} end_tokens_ids = {e for _s, e in data_token_pairs}
padded_ids = array("q") last_idx = 0 data_idx = -1
start_indices = [i for i, x in enumerate(input_ids) if x in start_token_ids] end_indices = [i for i, x in enumerate(input_ids) if x in end_tokens_ids]
if len(start_indices) != len(end_indices): return input_ids
for start_idx, end_idx in zip(start_indices, end_indices): padded_ids.extend(input_ids[last_idx : start_idx + 1])
if input_ids[start_idx] in data_start_token_ids: data_idx += 1 mm_inputs.data_offsets += [start_idx]
if data_idx >= len(pad_items): data_idx = len(pad_items) - 1
num_tokens = end_idx - start_idx - 1 if num_tokens > 0: padded_ids.extend(pad_items[data_idx].padding_sequence(num_tokens))
last_idx = end_idx
padded_ids.extend(input_ids[last_idx:])
assert len(input_ids) == len(padded_ids), "Length validation fails" return padded_ids这段有几个值得注意的细节。
array("q") 是 Python 标准库的 array 模块,元素类型 q 表示有符号 64 位整数。用它而不是 list,是因为长 prompt 可能有几十万个 token,list 的 Python 对象开销比紧凑数组大得多。assert_int64_array 也说明了这一点:input_ids 在这个阶段是 int64 数组,因为占位值可能超过 int32。
data_start_token_ids 的语义是「哪些 token 标志着一个新 item 的开始」。默认情况下每个 start token 都开启一个新 item,但如果模型用嵌套结构(比如一张图的 crop 各自有 start/end,但整张图又是一个 item),就可以只把外层 start 传进来,让内层区间复用当前 item 的 pad 值。
assert len(input_ids) == len(padded_ids) 是长度不变性检查。占位替换是就地等长替换,不改变序列长度。这一点非常重要,因为后面所有基于 offsets 的区间计算都假设长度不变。
还有一个细节值得强调:函数注释说「without mutating input_ids」。padded_ids 是新数组,原 input_ids 不动。duplicate_pad_mm_input_ids 里也有一句类似的话:
def duplicate_pad_mm_input_ids( input_ids: array, mm_inputs: MultimodalInputs, pad_input_ids_func: Callable[[array, MultimodalInputs], array],) -> array: """Validate and duplicate model-padded tokens for scheduler ownership.""" padded_ids = pad_input_ids_func(input_ids, mm_inputs) assert_int64_array(padded_ids, "pad_input_ids result") # Preserve scheduler ownership: no-op models return the unpadded input, # and other models can retain the result in multimodal metadata. return padded_ids[:]「Preserve scheduler ownership」这句注释点出动机:有些模型的 pad 函数是 no-op,直接返回原数组;如果不复制,调度器持有的就是处理器内部对象的引用,后续任何修改都会串到别处。padded_ids[:] 强制切片复制,把所有权明确交给调度器。
到此为止,占位机制的全貌是:在预处理阶段,把图像区间的每个位置替换成一个由图像内容决定的、远大于词表的 62 位整数。这个整数序列有两个作用,下一节展开。
前缀缓存哈希:为什么是四个哨兵而不是一个
RadixAttention / Radix Cache 的核心是按 token 序列做前缀匹配。文本场景下,序列就是 token id 序列,两个请求如果前 500 个 token 完全一样,就能共享这 500 个位置的 KV。
多模态场景下,如果图像区间被替换成一串固定的占位符(比如全填 0 或者全填同一个特殊 id),就会出问题:两张完全不同的图会产生相同的前缀序列,于是前缀缓存会错误命中。请求 B 会读到请求 A 留下的、属于 A 那张图的 KV,输出完全错误。
SGLang 的方案是把图像内容摘要编码进占位值本身,让不同的图产生不同的前缀序列。这样前缀缓存的匹配逻辑完全不需要改动——它依然只是比较 token id 序列,只是这个序列里现在包含了内容信息。
那为什么是四个 62 位哨兵,而不是一个 62 位值重复填充?
原因在前缀匹配的粒度上。Radix Cache 通常按块(block)做匹配,块大小常见是 16、32、64 这样的整数。如果一个图像区间被切成多个块,而每个块内填的是同一个值,那么:
- 一个块内的所有位置长得完全一样
- 多个块之间也长得完全一样
假设一块 16 个 token,图像区间有 100 个 token。如果只用一个值填充,这 100 个位置在 token 序列上看起来就是「100 个重复的同一个 id」。此时匹配算法无法区分「第 1 个块」和「第 6 个块」——它们的内容相同。这在正确性上不算错(因为整个区间的身份由那一个值唯一决定),但在部分命中的场景下会带来语义模糊:如果两个请求的图像区间长度不同,前者是 64 个 token,后者是 100 个 token,前缀匹配会在 64 处停止,这符合预期;但如果长度也不同、内容也不同,只用一个值就可能导致「长度不同的两个区间共享了前缀」。
用四个值轮转填充后,模式变成 v0 v1 v2 v3 v0 v1 v2 v3 ...,块与块之间的相对位置可以从模式里区分出来。源码注释对此的表述是:「prefix matching can stop after one sentinel, so each must retain wide bits」——每个哨兵都必须保留完整的高位宽度,因为匹配可能在任意一个哨兵处停下。如果某个哨兵的取值空间被压缩(比如只取低几位),那么在这个位置停下时的区分度就会不足。
用 set_hash 和 set_identity 两条路径可以看到两种粒度的分工:
def set_hash(self, hash_value: int) -> None: self.hash = hash_value self.identity = None self.pad_values = _compute_pad_values(self.hash.to_bytes(8, byteorder="big")) self.pad_value = self.pad_values[0]set_hash 用 8 字节(64 位)派生出哨兵序列,粒度是「哈希值相同即相同」。set_identity 用完整 32 字节,粒度更细。两者产生的 radix key 不同,但都满足「不同内容 → 不同前缀」的要求。
哈希本身怎么算?mm_utils.py 里有 data_hash、tensor_hash、hash_feature 三层:
def data_hash(data) -> int: hash_bytes = hashlib.sha256(data).digest()[:8] return int.from_bytes(hash_bytes, byteorder="big", signed=False)
def tensor_hash(tensor_list) -> int: """ hash a tensor or a tensor list """ tensor = tensor_list if isinstance(tensor_list, list): tensor_list = flatten_nested_list(tensor_list) tensors = [ x.flatten() if isinstance(x, torch.Tensor) else x for x in tensor_list ] # GPU path: concat + triton hash (unchanged) if any(isinstance(t, torch.Tensor) and t.is_cuda for t in tensors): tensor = torch.concat(tensors) return gpu_tensor_hash(tensor.cuda()) # CPU path: hash each tensor incrementally without concat hasher = hashlib.sha256() for t in tensors: t = t.detach().cpu().contiguous() hasher.update(memoryview(t.reshape(-1).view(torch.uint8).numpy())) hash_bytes = hasher.digest()[:8] return int.from_bytes(hash_bytes, byteorder="big", signed=False)注意 GPU 分支:如果张量已经在 GPU 上,会 concat 之后走 gpu_tensor_hash(一个 triton kernel),而不是搬到 CPU 再哈希。原因很实际——pixel_values 可能几十 MB,t.detach().cpu() 会触发一次同步 D2H 拷贝,在调度路径上这是几十毫秒的阻塞。用 GPU 哈希把这段开销留在设备上。
CPU 分支的写法也值得看:逐张量增量哈希,不做 concat。这样峰值内存只有单个张量的大小,而不是所有张量之和。对一个视频的几十个帧 feature,这个差别很大。
哈希的输入是什么?预处理器的 hash_feature。这里有一个上游设计选择:哈希原始 feature(pixel_values)还是哈希最终 embedding?源码里两类都存在,且语义不同:
- 哈希
feature:两张视觉上相同但存成不同 JPEG 的图,pixel_values 可能不同,哈希不同,缓存不命中。粒度偏严。 - 哈希
precomputed_embeddings:只有当 embedding 完全一致才命中。粒度更严。
外部路由系统还可以直接注入哈希,绕开内部计算。tokenizer_manager.py 里的处理逻辑:
caller_mm_hashes = getattr(obj, "mm_hashes", None)if caller_mm_hashes and mm_inputs and mm_inputs.mm_items: if len(caller_mm_hashes) != len(mm_inputs.mm_items): logger.warning( "mm_hashes length (%d) != mm_items length (%d); " "ignoring caller hashes for this request.", len(caller_mm_hashes), len(mm_inputs.mm_items), ) else: for item, hex_hash in zip(mm_inputs.mm_items, caller_mm_hashes): if not isinstance(item, MultimodalDataItem): continue try: item.set_hash(int(hex_hash, 16)) except (TypeError, ValueError): logger.warning( "Ignoring malformed mm_hashes entry %r; " "this item will fall back to hash_feature().", hex_hash, )注释解释了为什么允许外部注入:
Caller-supplied per-image hashes (external KV routers, e.g.routing-aware orchestrators that compute a content-addressedhash before dispatch). Setting MultimodalDataItem.hash hereshort-circuits the internal hash_feature() recompute insideset_pad_value(), making the derived pad_value deterministicfrom the caller's hash. That alignment lets the router'srouting decision agree with sglang's prefix-cache key forthe same image.这段话的逻辑链是:路由决策发生在请求分发之前,它需要知道这张图会被分到哪个实例。如果路由用的哈希和 SGLang 内部前缀缓存用的哈希不一致,路由就会做出错误判断(比如把请求发给一个没有这张图缓存的实例)。所以让调用方把哈希传进来,两边用同一个值。
容错设计也值得一提:长度不匹配就整体忽略,单个哈希格式错误就单独忽略该 item,并回退到内部计算。任何一条坏数据都不会让请求失败。
MultimodalInputs:请求级的多模态状态
MultimodalDataItem 是单 item 的抽象,请求级别还有一层容器:
@dataclasses.dataclassclass MultimodalInputs: """The multimodal data related inputs."""
# items of data mm_items: List[MultimodalDataItem] padded_input_ids: Optional[List[int]] = None image_pad_len: Optional[list] = None num_image_tokens: Optional[int] = None token_modalities: Optional[List[int]] = None
# image im_token_id: Optional[int] = None im_start_id: Optional[int] = None im_end_id: Optional[int] = None slice_start_id: Optional[int] = None slice_end_id: Optional[int] = None
# video video_token_id: Optional[int] = None
# audio audio_token_id: Optional[int] = None audio_start_id: Optional[int] = None audio_end_id: Optional[int] = None
# QWen2-VL related mrope_positions: Optional[torch.Tensor] = None mrope_position_delta: Optional[torch.Tensor] = None mrope_position_delta_repeated_cache: Optional[torch.Tensor] = Nonemm_items 是 item 列表。num_image_tokens 是整条请求的视觉 token 总数,这个字段后面会被调度器用来做预算。token_modalities 是每个 token 的模态标记数组,0 表示文本,非零表示对应模态。看 build_token_modalities:
token_modalities = [0] * num_tokensfor item in mm_items: if not item.offsets: continue modality = item.modality.value for start, end in item.offsets: if start < 0 or end < start or end >= num_tokens: raise ValueError( "Invalid multimodal token offsets: " f"offset=({start}, {end}), num_tokens={num_tokens}" ) if any(token_modalities[index] for index in range(start, end + 1)): raise ValueError( f"Overlapping multimodal token offsets at ({start}, {end})" ) token_modalities[start : end + 1] = [modality] * (end - start + 1)每个位置填 modality.value,Modality.IMAGE = 1、VIDEO = 2、AUDIO = 3。用途在多模态模型的前向里:某些模型需要对不同模态的 token 施加不同的处理(比如 mRoPE 位置、或者 modality-specific 的 norm),靠这个数组做条件分发,而不需要重新解析 offsets。
mrope_positions 和 mrope_position_delta 是 Qwen2-VL 系的特需字段。_maybe_compute_mrope_positions 展示了补充计算的路径:
def _maybe_compute_mrope_positions(self, req) -> None: """Compute M-RoPE positions when they are missing (e.g. gRPC preprocessed path).""" if self._mm_processor is None: return mm = req.multimodal_inputs if mm is None or mm.mrope_positions is not None: return
mrope_positions, mrope_position_delta = ( self._mm_processor.compute_mrope_positions( req.origin_input_ids, mm.mm_items ) ) if mrope_positions is not None: mm.mrope_positions = mrope_positions mm.mrope_position_delta = mrope_position_deltamrope_position_delta 的语义是:图像或视频内部的二维/三维位置展开成线性序列后,总长度与把它当作纯文本时的长度之差。后续文本 token 的位置必须从这个 delta 之后继续,否则位置会串。
MultimodalInputs.from_processor_output 是把处理器输出(MultimodalProcessorOutput)转成调度器可用对象的转换点:
@staticmethoddef from_processor_output(obj, requires_mm_token_modalities=False): mm_items = obj.mm_items assert isinstance(mm_items, list) mm_items = [item for item in mm_items if item.is_valid()] ... mm_inputs = MultimodalInputs( mm_items=mm_items, ... )item.is_valid() 过滤掉空 item。这个过滤在处理器的输出可能有占位空项时很重要——比如某些多图请求里某张图下载失败,会留下一个空壳。
还有 merge 方法,用于把多个来源的 mm_inputs 合并(比如 session 场景下把上一轮的 items 带到下一轮):
def merge(self, other: MultimodalInputs): ... "mm_items",处理器注册与选择
multimodal_processor.py 只有 89 行,是整个多模态子系统的入口分发器。它不实现任何具体模型的处理逻辑,只负责按 HF config 的 architecture 名字找到对应的处理器类:
PROCESSOR_MAPPING = {}
def import_processors(package_name: str, overwrite: bool = False): package = importlib.import_module(package_name) for _, name, ispkg in pkgutil.iter_modules(package.__path__, package_name + "."): if not ispkg: try: module = importlib.import_module(name) except Exception as e: logger.warning(f"Ignore import error when loading {name}: {e}") continue all_members = inspect.getmembers(module, inspect.isclass) classes = [ member for name, member in all_members if member.__module__ == module.__name__ ] for cls in ( cls for cls in classes if issubclass(cls, BaseMultimodalProcessor) ): assert hasattr(cls, "models") for arch in getattr(cls, "models"): if overwrite: for model_cls, processor_cls in PROCESSOR_MAPPING.items(): if model_cls.__name__ == arch.__name__: del PROCESSOR_MAPPING[model_cls] break PROCESSOR_MAPPING[arch] = cls这是扫描式自动注册:遍历 sglang.srt.multimodal.processors 包下的所有模块,找出继承 BaseMultimodalProcessor 的类,把它们 models 类属性里列出的 architecture 注册进映射表。
member.__module__ == module.__name__ 这个条件排除了 import 进来的类,只保留模块内定义的。否则同一个类会被注册多次(每次被 import 的模块都会看到它)。
logger.warning(f"Ignore import error when loading {name}: {e}") 是容错:某个模型处理器的依赖(比如特定版本的 transformers)没装,不应该导致整个服务起不来,只跳过这一个。
选择逻辑:
def get_mm_processor_cls(hf_config, model_config=None): """The class :func:`get_mm_processor` would instantiate, or ``None`` when the architecture has no registered processor.""" model_impl = str(get_model().model_impl).lower() uses_transformers_backend = model_impl == "transformers" if model_impl == "auto" and model_config is not None: from sglang.srt.model_loader.utils import get_resolved_model_impl
uses_transformers_backend = ( get_resolved_model_impl(model_config) == ModelImpl.TRANSFORMERS )
for model_cls, processor_cls in PROCESSOR_MAPPING.items(): if model_cls.__name__ not in hf_config.architectures: continue if not uses_transformers_backend or getattr( processor_cls, "supports_transformers_backend", False ): return processor_cls
if uses_transformers_backend: from sglang.srt.multimodal.processors.transformers_auto import ( TransformersAutoMultimodalProcessor, )
return TransformersAutoMultimodalProcessor
return None两级回退:先在注册表里找匹配当前 architecture 且有专用处理器的类;找不到时,如果用的是 transformers 后端,回退到通用的 TransformersAutoMultimodalProcessor。最后返回 None,由调用方抛错:
def get_mm_processor( hf_config, server_args: ServerArgs, processor, transport_mode, model_config=None, **kwargs,) -> BaseMultimodalProcessor: processor_cls = get_mm_processor_cls(hf_config, model_config) if processor_cls is None: raise ValueError( f"No processor registered for architecture: {hf_config.architectures}.\n" f"Registered architectures: " f"{[model_cls.__name__ for model_cls in PROCESSOR_MAPPING.keys()]}" ) return processor_cls(hf_config, server_args, processor, transport_mode, **kwargs)错误信息里带上已注册的 architecture 列表,这在排查”为什么我的模型起不来”时非常有用——可以直接看出是模型不支持还是注册失败。
server_args 和 transport_mode 是构造函数参数,后者决定 feature 张量怎么在进程间传(共享内存、CUDA IPC、内联)。这部分在 mm_utils.py 的 TransportProxyTensor 和 ShmPointerMMData 里实现,涉及跨进程传大张量时不复制的问题,本文不展开。
调度器侧的接入
处理器选好、预处理完成、MultimodalInputs 构造好之后,它要进入调度器。接入点在 scheduler.py:
if get_mm().enable_broadcast_mm_inputs_process: return self._process_and_broadcast_mm_inputs(mm_inputs)return MultimodalInputs.from_processor_output( mm_inputs, requires_mm_token_modalities=self.model_config.requires_mm_token_modalities,)以及 padded ids 的复用:
@staticmethoddef _try_apply_padded_mm_input_ids(recv_req, req, image_inputs) -> bool: """setup origin_input_ids with trying to reuse existing MultimodalInputs.padded_input_ids first, if absent, call pad_input_ids_func""" padded_input_ids = image_inputs.padded_input_ids if padded_input_ids is None or recv_req.input_ids is None: return False
recv_input_len = len(recv_req.input_ids) if len(padded_input_ids) != recv_input_len: return False
prefix_len = len(req.origin_input_ids) - recv_input_len if prefix_len < 0: return False
padded_input_ids = array("q", padded_input_ids) if prefix_len == 0: req.origin_input_ids = padded_input_ids else: req.origin_input_ids = req.origin_input_ids[:prefix_len] + padded_input_ids return True这个函数处理的是带前缀的请求(前缀缓存命中后只发送增量部分)。prefix_len = len(req.origin_input_ids) - recv_input_len 算出已缓存前缀的长度,然后把新收到的 padded ids 拼接上去。长度校验失败就返回 False,让调用方走回退路径重新 pad。
一个关键约束:padded ids 的长度必须和收到的 input_ids 长度完全一致。这保证了占位替换是等长的,前缀拼接在语义上成立。
编码器缓存的判定在 prepare_encoder_info_extend:
def prepare_encoder_info_extend( self, input_ids: List[array[int]], seq_lens: List[int]): _pin = is_pin_memory_available(self.device) encoder_lens_cpu = [] encoder_cached = []
for req in self.reqs: im = req.multimodal_inputs if im is None or im.num_image_tokens is None: # No image input encoder_lens_cpu.append(0) encoder_cached.append(True) else: encoder_lens_cpu.append(im.num_image_tokens) encoder_cached.append( self.forward_mode.is_decode() or req.prefix_len >= im.num_image_tokens ) self.encoder_lens_cpu = encoder_lens_cpu self.encoder_cached = encoder_cached
self.encoder_lens = torch.tensor( self.encoder_lens_cpu, dtype=torch.int64, pin_memory=_pin ).to(self.device, non_blocking=True)逐条解释。encoder_lens_cpu 是每条请求的视觉 token 数,直接取 im.num_image_tokens。encoder_cached 判定这条请求的视觉编码是否已经算过并存下来了,条件是两个:
self.forward_mode.is_decode()—— decode 阶段所有 token 都已经过了 prefill,视觉 embedding 必然已经算过req.prefix_len >= im.num_image_tokens—— 前缀长度覆盖了全部视觉 token,说明视觉部分的 KV 已经在缓存里
任一条成立,就不需要重跑 ViT。
pin_memory=_pin 加 non_blocking=True 是标准的异步 H2D 拷贝模式:先在固定内存里建张量,再异步拷到设备,避免阻塞主机线程。_pin 由 is_pin_memory_available(self.device) 决定,因为某些设备(比如某些 NPU 或 CPU-only 场景)没有固定内存。
后面的「strip encoder infos」段把视觉部分从序列里剥出来单独记账:
# Strip encoder infospt = 0decoder_out_cache_loc = []encoder_out_cache_loc = []extend_lens = self.extend_lens[:]prefix_lens = self.prefix_lens[:]for i, req in enumerate(self.reqs): encoder_len = self.encoder_lens_cpu[i] seq_lens[i] -= encoder_len
if req.prefix_len < encoder_len: # NOTE: the encoder part should be considered as a whole assert req.prefix_len == 0 input_ids[i] = input_ids[i][encoder_len:] encoder_out_cache_loc.append(self.out_cache_loc[pt : pt + encoder_len]) decoder_out_cache_loc.append( self.out_cache_loc[pt + encoder_len : pt + req.extend_len] ) extend_lens[i] -= encoder_len self.extend_num_tokens = self.extend_num_tokens - encoder_len else: decoder_out_cache_loc.append( self.out_cache_loc[pt : pt + req.extend_len] ) prefix_lens[i] -= encoder_len注释「the encoder part should be considered as a whole」和紧随其后的 assert req.prefix_len == 0 说明了核心约束:视觉编码部分在序列里的位置必须整体位于前缀之后。如果 prefix_len 小于 encoder_len 且不为零,意味着视觉区间被前缀从中间切开,这种状态是被禁止的。
这个约束是分块预填充安全的根本。后面会看到,它决定了 chunk 边界不能落在视觉区间内部。
seq_lens[i] -= encoder_len 把视觉 token 从序列长度里扣除,因为语言模型看到的序列长度不包含视觉占位;extend_lens[i] -= encoder_len 同理。但 encoder_lens 单独保留,因为视觉前向需要知道要处理多少 token。
编码与回填:ViT 在哪里跑,embedding 怎么塞回序列
现在到最关键的一段:视觉 embedding 怎么进到语言模型的输入里。入口是 general_mm_embed_routine:
def general_mm_embed_routine( input_ids: torch.Tensor, forward_batch: ForwardBatch, language_model: nn.Module, multimodal_model: Optional[nn.Module] = None, data_embedding_funcs: Dict[Modality, DataEmbeddingFunc] = None, placeholder_tokens: Optional[dict[Modality, List[int]]] = None, use_deepstack: Dict[Modality, bool] = {}, feature_dtypes: Optional[Dict[Modality, torch.dtype]] = None, **kwargs,) -> torch.Tensor: """ Process multimodal inputs and forward through language model. """ input_embeds = prepare_mm_inputs( input_ids, forward_batch, language_model, kwargs, multimodal_model, data_embedding_funcs, placeholder_tokens, use_deepstack, feature_dtypes, )
with torch.profiler.record_function("sglang.vlm.language_model_prefill"): hidden_states = language_model( input_ids=None, forward_batch=forward_batch, input_embeds=input_embeds, **kwargs, ) return hidden_states注意 language_model(input_ids=None, ..., input_embeds=input_embeds):多模态前向不传 input_ids,只传 input_embeds。这是必要的——占位值是超过词表范围的大整数,直接送进 embedding 表会越界。
prepare_mm_inputs 内部调 embed_mm_inputs。这是回填的核心,逐段读:
def embed_mm_inputs( mm_inputs_list: List[MultimodalInputs], extend_prefix_lens: List[int], extend_seq_lens: List[int], input_ids: torch.Tensor, input_embedding: nn.Embedding, multimodal_model: nn.Module = None, data_embedding_func_mapping: Dict[Modality, DataEmbeddingFunc] = None, placeholder_tokens: dict[Modality, List[int]] = None, use_deepstack: Dict[Modality, bool] = {},) -> Optional[torch.Tensor]: """ Embed multimodal inputs and integrate them with text token embeddings. """ other_info = {} if mm_inputs_list is None: return None
# 1. Calculate the multimodal data which exists in input_ids, # with the help of pad_values # we assume that multimodal data are represented with its pad_values # in input_ids item_flatten_list = [] for mm_inputs in mm_inputs_list: item_flatten_list += [item for item in mm_inputs.mm_items if item is not None]第一步是把所有请求的 item 拍平成一个列表。跨请求批处理的含义是:一个 batch 里 8 条请求,各自带 1-3 张图,总共可能有 20 个 item,它们要合并成一次 ViT 调用。
# deepstack_embeddings: per-modality modalities, embeddings, masks, deepstack_embeddings = [], [], [], []
# 2. Get multimodal embedding separately for modality in Modality.all(): items = [ item for item in item_flatten_list if item.is_modality(modality=modality) ] embedder = ( None if data_embedding_func_mapping is None else data_embedding_func_mapping.get(modality, None) ) if embedder is None: # "image", "video", etc modality_id = modality.name.lower() embedder = getattr(multimodal_model, f"get_{modality_id}_feature", None) if len(items) != 0: assert embedder is not None, f"no embedding method found for {modality}"第二步是按模态分组。Modality.all() 返回 [IMAGE, VIDEO, AUDIO],循环里对每种模态取出对应的 item 列表,各跑一次编码。分成三次而不是一次,是因为不同模态走的是完全不同的编码器(ViT / 视频编码器 / 音频编码器),张量形状和 dtype 都不一样。
embedder 的解析有两条路径:优先用 data_embedding_func_mapping 里注册的函数;没有就按命名约定找 multimodal_model.get_image_feature / get_video_feature / get_audio_feature。命名约定让新模型只需要实现约定名的方法就能接入,不用改调度代码。
pad_values = [value for item in items for value in item.padding_values()] if input_ids.device.type == "cuda": # Pinned staging keeps the placeholder copy asynchronous on CUDA. placeholder_cpu = torch.tensor( pad_values, dtype=torch.int64, device="cpu", pin_memory=True ) placeholder_tensor = placeholder_cpu.to( input_ids.device, non_blocking=True ) else: placeholder_tensor = torch.as_tensor( pad_values, device=input_ids.device )这段构造 placeholder_tensor:把这一轮所有 item 的哨兵值收集起来,作为待会儿在 input_ids 里做 isin 查找的模式集合。CUDA 路径用固定内存 + 异步拷贝,注释写明了原因。
# calculate per request items length offset items_size = [0] items_offsets = [] for mm_inputs in mm_inputs_list: mm_items = [ item for item in mm_inputs.mm_items if item.is_modality(modality=modality) ] items_size.append(items_size[-1] + len(mm_items)) items_offsets.append( flatten_nested_list([item.offsets for item in mm_items]) )items_size 是累积边界数组,形如 [0, 2, 5, 7] 表示请求 0 占 item 0-1,请求 1 占 item 2-4,请求 2 占 item 5-6。这个数组让后面能把编码结果按请求切回去。items_offsets 是每个请求内所有 item 的区间列表。
embedding, mask, input_ids = get_embedding_and_mask( data_embedding_func=embedder, embedding_items=items, placeholder_tensor=placeholder_tensor, input_ids=input_ids, items_size=items_size, prefix_length=extend_prefix_lens, extend_length=extend_seq_lens, items_offset_list=items_offsets, )关键调用。get_embedding_and_mask 返回三样东西:编码后的 embedding、标识占位位置的布尔 mask、可能被改写的 input_ids。
# 3. Get input embeddings vocab_size = input_embedding.num_embeddings # Important: clamp after getting original multimodal regions # Clamp input ids. This is because the input_ids for the multimodal tokens # are filled with the hash values of the multimodal for the prefix matching # in the radix attention. # There values are useless because their embeddings will be replaced by # vision embeddings anyway. input_ids.clamp_(min=0, max=vocab_size - 1) input_embeds = input_embedding(input_ids)第三步才查文本 embedding 表。注释解释了 clamp_ 的必要性:「the input_ids for the multimodal tokens are filled with the hash values … for the prefix matching in the radix attention. There values are useless because their embeddings will be replaced by vision embeddings anyway」。
顺序很重要:先拿到 mask 和原始 offset 信息,再 clamp。如果先 clamp,占位值就被改成了 vocab_size - 1,后面就无法从 input_ids 里识别出哪些位置是图像了。注释里「Important: clamp after getting original multimodal regions」点明的正是这个次序约束。
clamp 之后查表得到的 embedding 在视觉位置上是垃圾值(都等于最后一个 token 的 embedding),但它们马上会被覆盖:
# 4. scatter embeddings into input embedding for i, modality, embedding, mask in zip( range(len(embeddings)), modalities, embeddings, masks ): if embedding is None or mask is None: continue _scatter_mm_embedding(dest=input_embeds, mask=mask, src=embedding) if use_deepstack.get(modality, None): _scatter_mm_embedding( dest=input_deepstack_embeds, mask=mask, src=deepstack_embeddings[i] )
return input_embeds, other_info_scatter_mm_embedding 做的是按 mask 把视觉 embedding 散射(scatter)进 input_embeds 的对应行。掩码是 [num_tokens, 1] 的布尔张量,src 是 [num_mm_tokens, hidden],目标是把 src 的第 k 行写到 mask 为真的第 k 个位置上。
这个设计的一个精妙之处是:clamp 产生的垃圾 embedding 让所有位置都是合法的稠密张量,语言模型的输入永远是一个完整张量,不需要处理”某些行不存在”的情况。代价是一点点无用计算(对占位位置查一次表),但换来的是前向路径无分支。
deepstack 分支是给那些在多个层接入视觉特征的模型准备的(比如某些需要在中间层注入视觉信息的架构)。input_deepstack_embeds 是一个额外张量,形状是 input_embeds.shape[:-1] + (hidden * num_deepstack),零初始化,然后把 deepstack 的那部分视觉特征 scatter 进去。
mask 是怎么算出来的
回到 get_embedding_and_mask:
def _get_multimodal_mask( input_ids: torch.Tensor, placeholder_tensor: torch.Tensor) -> torch.Tensor: return torch.isin(input_ids, placeholder_tensor).unsqueeze(-1)就一行:torch.isin(input_ids, placeholder_tensor),判断每个位置的值是否落在哨兵集合里,然后 unsqueeze(-1) 加一个维度变成 [num_tokens, 1],便于后面和 [num_mm_tokens, hidden] 做广播对齐。
这就是为什么哨兵值必须远大于词表:如果哨兵值和某个真实 token id 相同,isin 就会把那个真实文本位置也标成图像位置,视觉 embedding 会被错误地写进去。sanity_check_mm_pad_shift_value 检查的正是这个。
这个实现也解释了为什么占位值必须逐 item 不同(不同 item 的哨兵集合不重叠):如果两个 item 用同一组哨兵,那么在同一个 batch 里,isin 无法区分哪个位置属于哪个 item,embedding 会错位。
再看主函数:
def get_embedding_and_mask( data_embedding_func: DataEmbeddingFunc, embedding_items: List[MultimodalDataItem], placeholder_tensor: torch.Tensor, input_ids: torch.Tensor, items_size: List[int], prefix_length: List[int], extend_length: List[int], items_offset_list: List[List[Tuple[int, int]]],) -> Tuple[torch.Tensor | None, torch.Tensor | None, torch.Tensor]: """ Generate multimodal embeddings and create a mask for identifying their positions in the input sequence. """ original_input_ids = input_ids num_mm_tokens_in_input_ids = _count_mm_tokens_in_extend( prefix_length, extend_length, items_offset_list, )
# 1. Get embedding embedding = _get_precomputed_embedding( embedding_items, items_size, prefix_length, extend_length, items_offset_list ) if embedding is None: embedding, input_ids = _get_chunked_prefill_embedding( data_embedding_func, embedding_items, items_size, prefix_length, extend_length, items_offset_list, input_ids, ) if embedding is None: return None, None, input_ids # 2. Get mask if _is_npu: torch.npu.current_stream().synchronize() special_multimodal_mask = _get_multimodal_mask(input_ids, placeholder_tensor) # 3. Adjust embedding length if needed if input_ids is not original_input_ids: # EVS rewrites placeholder spans after pruning, making the original # offsets stale. num_mm_tokens_in_input_ids = special_multimodal_mask.sum().item() else: maybe_assert_sum( special_multimodal_mask, num_mm_tokens_in_input_ids, "MM placeholder count derived from offsets does not match input_ids", ) embedding = _adjust_embedding_length(embedding, num_mm_tokens_in_input_ids, logger) return embedding, special_multimodal_mask, input_ids三条路径的顺序是:
- 先试
_get_precomputed_embedding—— 如果 item 带的是precomputed_embeddings(EPD 场景),直接取用,不跑 ViT - 否则走
_get_chunked_prefill_embedding—— 现场编码,并处理分块 - 两条都拿不到就返回 None,让上层回退
torch.npu.current_stream().synchronize() 是 NPU 专用同步。这段代码存在的原因值得说一句:在 NPU 上,torch.isin 的实现可能依赖前面异步操作的结果,需要显式同步流才能保证数据就绪。CUDA 路径没有这行,因为 CUDA 的流语义在 isin 内部已经处理好了。这是硬件后端差异渗入框架代码的典型例子。
_count_mm_tokens_in_extend 是纯主机侧计算,不读 GPU:
def _count_mm_tokens_in_extend( prefix_length: List[int], extend_length: List[int], items_offset_list: List[List[Tuple[int, int]]],) -> int: """Count MM placeholders from host offsets without reading back the GPU mask.""" num_mm_tokens = 0 for i, (extend_start, items_offset) in enumerate( zip(prefix_length, items_offset_list) ): extend_end = extend_start + (extend_length[i] if i < len(extend_length) else 0) for item_start, item_end in items_offset: overlap_start = max(item_start, extend_start) overlap_end = min(item_end + 1, extend_end) num_mm_tokens += max(overlap_end - overlap_start, 0)
return num_mm_tokens注释说得很清楚:「without reading back the GPU mask」。如果实现成 mask.sum().item(),那会触发一次 GPU 同步——item() 必须等 kernel 完成才能返回。在热路径上做 GPU 同步会打乱流水线,尤其是在 Overlap Scheduler 试图让 CPU 决策和 GPU 执行重叠的时候。用主机侧的 offsets 做区间求交,把这段计算彻底留在 CPU。
求交的写法:每个 item 有区间 [item_start, item_end],本轮的 extend 区间是 [extend_start, extend_end),交集长度是 min(item_end+1, extend_end) - max(item_start, extend_start),负值截断为 0。这个数字就是本轮前向里实际会出现的视觉 token 数。
_adjust_embedding_length 是最后一道长度校验:
def _adjust_embedding_length( embedding: torch.Tensor, num_mm_tokens_in_input_ids: int, logger,) -> torch.Tensor: num_mm_tokens_in_embedding = embedding.shape[0] if num_mm_tokens_in_input_ids != num_mm_tokens_in_embedding: logger.warning( f"Number of tokens in multimodal embedding does not match those " f"in the input text. " f"Got {num_mm_tokens_in_input_ids} tokens in the text but " f"{num_mm_tokens_in_embedding} tokens from multimodal embeddings." ) if num_mm_tokens_in_input_ids < num_mm_tokens_in_embedding: chunked_prefill_size = get_schedule().chunked_prefill_size if chunked_prefill_size != -1: logger.warning( "You may want to avoid this issue by raising " "`chunked_prefill_size`, or disabling chunked prefill" ) # extract from the end: this is a compromise if embedding.dim() == 2: embedding = embedding[-num_mm_tokens_in_input_ids:, :] else: num_multimodal = num_mm_tokens_in_input_ids // embedding.shape[0] embedding = embedding[-num_multimodal:, :] else: raise RuntimeError( f"Insufficient multimodal embedding length: " f"{num_mm_tokens_in_input_ids=} vs " f"{num_mm_tokens_in_embedding=}. This is an internal error" ) return embedding两种情况不对称处理:
- 文本里的占位少于编码出的 token:从末尾截取。注释说「extract from the end: this is a compromise」——这是分块预填充导致的常见情形:ViT 一次编码了整张图(比如 1000 个 token),但本轮 chunk 只覆盖了后 300 个占位位置,于是需要从那 1000 个 embedding 里挑出对应的 300 个。从末尾取是一个近似,因为视觉 token 的空间顺序与序列顺序之间没有严格的一一对应保证,但在实践中对多数模型够用。
- 文本里的占位多于编码出的 token:直接抛
RuntimeError,并标注「This is an internal error」。因为这意味着 ViT 少算了,属于框架 bug,不能静默降级。
logger.warning 里还给了可操作的建议:调大 chunked_prefill_size 或关闭分块预填充。这条提示直接指向了下一个话题。
分块预填充下的视觉编码
分块预填充是长 prompt 场景的必备机制:一条 32K token 的请求不会一次吃完 GPU 显存,而是切成若干 chunk 逐轮推进。落到多模态上,就产生了一个新问题:一个 chunk 可能只覆盖图像的一部分。
_count_mm_tokens_in_extend 的区间求交正是为了处理这个情况——它只数本轮 chunk 实际覆盖到的视觉 token。而编码策略在 _get_chunked_prefill_embedding 里。
核心思路是先看缓存,再看是否需要编码:
def _get_chunked_embedding_full( data_embedding_func: DataEmbeddingFunc, embedding_items_per_req: List[MultimodalDataItem], items_offset: List[Tuple[int, int]], extend_prefix_len: int, extend_seq_len: int, input_ids: torch.Tensor, device: torch.device,) -> Tuple[Optional[torch.Tensor], torch.Tensor]: """ Fallback: encode all items at once, cache combined result, extract chunk. Used for non-bundled items or EVS results. """ item_hashes = [item.hash for item in embedding_items_per_req] embedding_items_hash = MultiModalStaticCache.combine_hashes(item_hashes) embedding_per_req = embedding_cache.get(item_hashes)
# A compact feature hash can collide for inputs with different token # counts. Never feed a stale cache entry into the scheduler: the length # mismatch would otherwise surface much later in _adjust_embedding_length # as an unrecoverable prefill crash. if embedding_per_req is not None and not isinstance( embedding_per_req, EVSEmbeddingResult ): expected_token_count = sum(end - start + 1 for start, end in items_offset) cached_token_count = _embedding_token_count(embedding_per_req.embedding) if cached_token_count != expected_token_count: _discard_mismatched_cached_embedding( embedding_items_hash, expected_token_count, cached_token_count ) embedding_per_req = None
if embedding_per_req is None: _move_items_to_device(embedding_items_per_req, device, data_embedding_func) embedding = data_embedding_func(embedding_items_per_req) if isinstance(embedding, list): embedding = _flatten_embedding_result(embedding) embedding_per_req = ( EmbeddingResult(embedding=embedding) if isinstance(embedding, torch.Tensor) else embedding ) embedding_cache.set(embedding_items_hash, embedding_per_req)
# cache hits keep raw-input leases until request cleanup # for eviction/re-prefill
if isinstance(embedding_per_req, EVSEmbeddingResult): item = embedding_items_per_req[0] input_ids, items_offset = ( embedding_per_req.redistribute_pruned_frames_placeholders( input_ids, items_offset, item=item, extend_prefix_len=extend_prefix_len, extend_seq_len=extend_seq_len, ) )
embedding_per_req_chunk, _, _ = get_embedding_chunk( embedding=embedding_per_req.embedding, extend_prefix_len=extend_prefix_len, extend_seq_len=extend_seq_len, items_offset=items_offset, ) return embedding_per_req_chunk, input_ids几个关键决策。
缓存 key 用 item_hashes 列表,不是单个 hash。一张图一个 hash,多条请求的多个 item 组成列表。这样同一个请求在多个 chunk 之间能命中同一个缓存条目。
缓存命中要校验 token 数。注释写得很重:「A compact feature hash can collide for inputs with different token counts. Never feed a stale cache entry into the scheduler: the length mismatch would otherwise surface much later in _adjust_embedding_length as an unrecoverable prefill crash」。
逻辑链是:哈希是 64 位,理论上有碰撞可能;如果碰撞发生,缓存里存的是另一张图的 embedding,长度大概率不同。如果不校验,这个错误会一直被带到 _adjust_embedding_length,在那里变成 RuntimeError——一次不可恢复的 prefill 崩溃,而且崩溃点离根因很远,极难排查。所以在这里提前校验,长度不符就丢弃缓存条目并重新编码。
这是”错误尽早暴露”的工程实践:宁可多跑一次 ViT,不要留下一个会导致服务崩溃的隐患。
缓存未命中就编码,然后把结果存进 embedding_cache。注意 _flatten_embedding_result:编码返回的可能是 list(每个 item 一个张量),会被拍平成一个张量再缓存。缓存里存的是整条请求级别的拼接结果,不是单个 item 的结果。
注释「cache hits keep raw-input leases until request cleanup for eviction/re-prefill」 揭示了一个生命周期设计:缓存命中时不能立即释放原始输入(pixel_values),因为如果后面发生抢占(retract)或需要重新 prefill,还得重新编码。原始输入必须留到请求真正结束。这是一个典型的”用内存换确定性”的取舍。
从整条请求的 embedding 里切出本轮 chunk:
embedding_per_req_chunk, _, _ = get_embedding_chunk( embedding=embedding_per_req.embedding, extend_prefix_len=extend_prefix_len, extend_seq_len=extend_seq_len, items_offset=items_offset, )get_embedding_chunk 按前缀长度和扩展长度从完整 embedding 里截取对应区间。这样即使整张图只编码一次,每个 chunk 也能拿到自己那一份。
但这条路径有个明显代价:每个 chunk 都要从完整 embedding 里切,意味着完整 embedding 必须在缓存里活着,占用显存。对一张产生 1000 token 的图,embedding 是 [1000, hidden],hidden 假设 4096、bf16,就是 8MB。批里 20 张图就是 160MB。
另一条路径是按 item 分别处理:
@dataclassclass PerImageRequestInfo: """Metadata for a single request using the per-image encoding path."""
req_idx: int items: List[MultimodalDataItem] items_offset: List[Tuple[int, int]] extend_prefix_len: int extend_seq_len: int overlapping: List[Tuple[int, MultimodalDataItem, int]] = field(default_factory=list)def _batch_encode_per_image_misses( data_embedding_func: DataEmbeddingFunc, per_image_requests: List[PerImageRequestInfo], device: torch.device,) -> Dict[Tuple[Optional[int], int], torch.Tensor]: """ Collect cache misses across ALL per-image requests, deduplicate by hash and expected token count, encode in a single ViT call, and populate the cache.
Returns: hash_to_embedding: mapping from (item.hash, token_count) to its full embedding tensor. Including the token count prevents two colliding hashes with different placeholder spans from being deduplicated within the same batch. """返回值的键是 (item.hash, token_count) 而不是 item.hash。注释解释了:「Including the token count prevents two colliding hashes with different placeholder spans from being deduplicated within the same batch」。这是同一个防碰撞思路在批内去重上的应用。
批内去重的流程分两个阶段:
unique_misses: Dict[Tuple[Optional[int], int], Tuple[MultimodalDataItem, int]] = {} hash_to_embedding: Dict[Tuple[Optional[int], int], torch.Tensor] = {}
# Phase 1a: find overlapping items per request and collect cache misses for req_info in per_image_requests: chunk_start = req_info.extend_prefix_len chunk_end = chunk_start + req_info.extend_seq_len # exclusive overlapping = [] if req_info.extend_seq_len > 0: for idx, item in enumerate(req_info.items): token_count = _item_overlap(item, chunk_start, chunk_end) if token_count is not None: overlapping.append((idx, item, token_count)) req_info.overlapping = overlapping
for _idx, item, expected_token_count in overlapping: cache_key = (item.hash, expected_token_count) if cache_key in hash_to_embedding: continue cached = embedding_cache.get_single(item.hash) if cached is not None: cached_embedding = cached.embedding cached_token_count = _embedding_token_count(cached_embedding) if cached_token_count == expected_token_count: hash_to_embedding[cache_key] = cached_embedding else: _discard_mismatched_cached_embedding( item.hash, expected_token_count, cached_token_count ) unique_misses[cache_key] = (item, expected_token_count) elif cache_key not in unique_misses: if ( item.offsets[0][0] >= chunk_start and item.offsets[-1][1] < chunk_end and item.can_defer_cuda_ipc_feature_reconstruction() ): item.model_specific_data[BORROW_CUDA_IPC_FEATURE_KEY] = True unique_misses[cache_key] = (item, expected_token_count)Phase 1a 做三件事:
- 对每条请求,找出本轮 chunk 实际覆盖到的 item(
_item_overlap返回交集 token 数,不重叠返回 None) - 命中的直接从缓存取,同时也做长度校验
- 未命中的收集到
unique_misses,并且按(hash, token_count)去重——同一个 batch 里两条请求用了同一张图,只编码一次
有个细节:if item.offsets[0][0] >= chunk_start and item.offsets[-1][1] < chunk_end 这个条件判断「这个 item 的整个区间都落在本轮 chunk 内」。只有整体落在 chunk 内,才允许设置 BORROW_CUDA_IPC_FEATURE_KEY——意思是这个 feature 可以延迟重建,因为本轮一定会用到它,不会有跨 chunk 的生命周期问题。这是一个非常具体的优化,用一条范围判断换掉一次 CUDA IPC 重建开销。
Phase 1b 把所有未命中合并成一次 ViT 调用:
# Phase 1b: single ViT call for all unique cache misses if unique_misses: ordered_cache_keys = list(unique_misses.keys()) miss_items = [unique_misses[key][0] for key in ordered_cache_keys] token_counts = [unique_misses[key][1] for key in ordered_cache_keys]
_move_items_to_device(miss_items, device, data_embedding_func) all_miss_embedding = data_embedding_func(miss_items)
if isinstance(all_miss_embedding, list): # Per-item embeddings: no split needed, and each cache entry owns # its storage (a torch.split view would pin the whole concatenated # buffer for as long as any single item stays cached). Mirrors # _get_chunked_embedding_by_item. assert len(all_miss_embedding) == len(miss_items), ( f"per-item embedding count {len(all_miss_embedding)} != " f"cache-miss item count {len(miss_items)}" ) split_embeddings = [ emb.reshape(-1, emb.shape[-1]) for emb in all_miss_embedding ] else: all_miss_embedding = all_miss_embedding.reshape( -1, all_miss_embedding.shape[-1] ) split_embeddings = torch.split(all_miss_embedding, token_counts, dim=0) for cache_key, emb in zip(ordered_cache_keys, split_embeddings): if embedding_cache.set(cache_key[0], EmbeddingResult(embedding=emb)): cached = embedding_cache.get_single(cache_key[0]) if _embedding_token_count(cached.embedding) == cache_key[1]: emb = cached.embedding # Keep a local ref (no extra GPU memory) so assembly never fails # due to LRU eviction. hash_to_embedding[cache_key] = emb批内合并去重带来的收益很直接:8 条请求各带 1 张图,其中 3 条用的是同一张商品图(比如同一份文档被多次提问),那么去重后只需要编码 6 张图而不是 8 张。对图像编码这种计算密集操作,20-30% 的节省是可观的。
torch.split 的注释解释了为什么优先返回 list 而不是一个拼接张量再切:「a torch.split view would pin the whole concatenated buffer for as long as any single item stays cached」。torch.split 返回的是视图,不是拷贝。如果缓存里存的是视图,那么只要有一条缓存还在,整个拼接 buffer 就无法释放。返回 list 让每个 item 独占自己的存储,缓存淘汰时能真正释放那一块显存。
最后那句注释是关键的正确性保障:「Keep a local ref (no extra GPU memory) so assembly never fails due to LRU eviction」。embedding_cache.set 可能因为容量限制立刻把刚存进去的条目淘汰掉。如果不保留本地引用,后面组装时 embedding_cache.get_single 会返回 None,整个 prefill 失败。保留一个本地引用不额外占显存(只是同一块显存的另一个引用),但保证了本轮组装的确定性。
set 返回布尔值表示是否成功写入,写入失败就用缓存里现有的(可能已被其他条目替换)——这段逻辑处理的是 LRU 缓存在写入时的临界情况。
显存与生命周期:视觉特征什么时候能释放
embedding_cache 是为多模态单独建的一层缓存,和 KV 的 Radix Cache 是两回事,也在 mm_utils.py 里:
def init_mm_embedding_cache(max_size: int = 0): ...它缓存的是视觉编码的输出(embedding 张量),key 是 item 哈希,容量由配置控制。这一层缓存的意义在于:一条请求分 10 个 chunk 推进,如果每个 chunk 都重跑 ViT,代价是 10 倍的视觉编码开销。有了 embedding 缓存,只在第一个覆盖到该图的 chunk 编码一次,后续 chunk 直接取。
生命周期上的三条规则:
规则一:视觉特征保留到请求结束。 _maybe_clear_mm_inputs 是清理点:
def _maybe_clear_mm_inputs(self, batch: ScheduleBatch) -> None: for req in batch.reqs: if not req.finished() or not (mm_inputs := req.multimodal_inputs): continue # For session requests, keep mm_inputs for the next request if req.session: if isinstance(req.finished_reason, FINISH_ABORT): req.release_mm_inputs_on_abort() continue # For non-session requests, clear features and mm_inputs mm_inputs.release_features() req.multimodal_inputs = None三个分支:
- 未完成的请求不动
- session 请求(多轮对话复用同一 session)保留 mm_inputs,让下一轮可以复用视觉特征,避免每轮重跑 ViT。这是多轮图像对话场景的重要优化。
- 普通请求在结束时释放 features 并把 mm_inputs 置空
abort 的 session 请求走 release_mm_inputs_on_abort,和正常结束区分开:
def release_mm_inputs_on_abort(self) -> None: ... for item in self._session_mm_items: ... self._session_mm_items.clear()规则二:抢占必须能重新编码。 当显存不足触发抢占(retract),请求会被踢出 running batch,KV 也可能被释放。如果这时把视觉特征也释放了,重新调度时无法重建视觉 embedding,请求就废了。这就是前面「cache hits keep raw-input leases until request cleanup for eviction/re-prefill」那句注释的动机。
关联的是 mm_utils.py 里的 mRoPE 位置修补:
def extend_mrope_positions_for_retracted_request(...)抢占后重放时,序列可能被拼接成新的形状,mRoPE 位置需要相应扩展。
规则三:跨进程传输要么零拷贝,要么明确所有权。 TransportProxyTensor 是 torch.Tensor 的子类,通过重写 __getstate__ / __setstate__ 让 pickle 走 CUDA IPC 而不是复制数据:
def __getstate__(self): ... transport_mode = self._metadata.get("transport_mode", "default")
if transport_mode == "cuda_ipc" and self.is_cuda: try: storage = self.untyped_storage() handle = storage._share_cuda_()
state["ipc_extra"] = { "handle": handle, "shape": self.shape, "dtype": self.dtype, "stride": self.stride(), "device_index": self.device.index, "storage_offset": self.storage_offset(), } state["tensor_data"] = None except Exception: # Failed to get CUDA IPC handle (possibly tp). Falling back # to default transport. state["metadata"]["transport_mode"] = "default" state["tensor_data"] = self.as_subclass(torch.Tensor) else: state["metadata"]["transport_mode"] = "default" state["tensor_data"] = self.as_subclass(torch.Tensor)
return statestorage._share_cuda_() 拿到 CUDA IPC handle,接收端用 torch.UntypedStorage._new_shared_cuda 在同一块显存上重建张量视图,不复制数据。对一个几百 MB 的视频 feature,这避免了跨进程拷贝。
异常回退很重要:「Failed to get CUDA IPC handle (possibly tp)」——在某些张量并行配置下 IPC 句柄不可用(比如设备可见性问题),此时静默回退到内联传输(把张量数据整个 pickle 过去)。功能不中断,只是慢。
共享内存路径由 ShmPointerMMData 实现:
class ShmPointerMMData: def __init__(self, tensor: torch.Tensor, precomputed_hash: Optional[int] = None): ...
def materialize(self) -> torch.Tensor: ...
def close_and_unlink(self) -> None: ...materialize 是按需把共享内存映射成张量,close_and_unlink 负责释放和删除共享内存段。__del__ 也做了清理,作为兜底。
_wrap_shm_or_inline 显示分配失败会回退到内联:
def _wrap_shm_or_inline(tensor: torch.Tensor, precomputed_hash: Optional[int] = None): ...注释提到「wrapping falls back to inline transport per element when shm allocation fails」——共享内存可能因为系统限制分配失败,此时单个张量走内联。这解释了为什么 hash_feature 里要处理「A list may mix ShmPointerMMData and plain tensors」的混合情况:
def hash_feature(f): if isinstance(f, list): # A list may mix ShmPointerMMData and plain tensors, since wrapping # falls back to inline transport per element when shm allocation fails. if len(f) > 0 and any(isinstance(x, ShmPointerMMData) for x in f): return tensor_hash( [x.tensor if isinstance(x, ShmPointerMMData) else x for x in f] )哈希时必须先解包(x.tensor),否则哈希的是 Python 对象而不是张量内容,同一批数据会产生不同的哈希。
与 P/D 分离、前缀缓存的相互作用
多模态输入和其他子系统的耦合点值得单独列一下。
与 Radix Cache:占位值序列就是缓存 key 的一部分。这意味着两条请求共享图像的前提是哈希完全一致。用户上传同一张 JPEG 两次,如果字节完全一致,哈希一致,缓存命中;如果重新压缩过,哪怕视觉上一样,哈希不同,缓存不命中。这是内容寻址缓存的固有限制——它保正确性,牺牲一部分潜在命中率。
prefix_len >= num_image_tokens 这个判定在 prepare_encoder_info_extend 里用的正是同一套机制:如果前缀缓存已经覆盖了整张图,就不需要重跑 ViT。
与 Chunked Prefill:视觉区间不能跨越 chunk 边界被切开——prepare_encoder_info_extend 里的 assert req.prefix_len == 0 是这个约束的运行时检查。如果违反,说明某种调度组合产生了非法状态。这也解释了 _adjust_embedding_length 的 warning 为什么建议调大 chunked_prefill_size:chunk 越小,切到图像内部的概率越高,需要从完整 embedding 里截取的次数越多,误差累积风险越大。
与 P/D 分离(disaggregation):前面提到过 EPD 形态——encoder 单独成实例。此时 prefill 实例收到的不再是 feature(像素张量),而是 precomputed_embeddings(已经编码好的 embedding 张量)。MultimodalInputFormat.PRECOMPUTED_EMBEDDING 就是这个形态的标记。传输通道有 CUDA IPC、共享内存、ZMQ 等选项,由 transport_mode 配置决定。
tokenizer_manager.py 里的分支展示了这个架构:
if get_disagg().language_only: mm_inputs = await self.mm_receiver.recv_mm_data( request_obj=obj, mm_processor=self.mm_processor, prompt=mm_processor_input, need_wait_for_mm_inputs=obj.need_wait_for_mm_inputs, ) _reject_missing_dispatched_encoder_embedding(obj, mm_inputs)if mm_inputs is None: if get_disagg().language_only: logger.warning( "Encoder embedding not available, falling back to local mm processing" ) mm_inputs = await self.mm_processor.process_mm_data_async( image_data=obj.image_data, audio_data=obj.audio_data, input_text=mm_processor_input, request_obj=obj, max_req_input_len=self.max_req_input_len, )language_only 模式表示这个实例不加载视觉编码器。它等待 encoder 实例把 embedding 送过来;等不到就回退到本地处理(并打 warning)。_reject_missing_dispatched_encoder_embedding 的命名说明有些情况是不允许回退的——如果路由系统已经决定把这条请求交给这个实例处理,那 encoder embedding 缺失就是错误,不能静默降级,否则用户会收到一个错误的答案而不是一个明确的失败。
还有 --language-model-only 的保护:
raise ValueError( "Multimodal inputs are not supported when --language-model-only " "is set; the encoder is not loaded. Restart without the flag.")错误信息直接给出了修复动作。
与投机解码:多模态请求在 decode 阶段和普通请求一样走验证流程,占位 token 在 decode 阶段不再产生新的视觉位置,因此投机解码路径不需要对多模态做特殊处理。但要注意 num_image_tokens 在 decode 阶段的记账——encoder_cached 里 self.forward_mode.is_decode() 直接判为 True,正是这个原因。
与调度器预算:PrefillAdder 需要知道这条请求会占多少 KV 槽位。视觉 token 在序列里虽然被剔除了(seq_lens[i] -= encoder_len),但它们在 KV Cache 里仍然占位置——视觉特征是作为 KV 存下来的。所以预算必须把 encoder_lens 算进去。这是多模态请求比同长度文本请求更吃显存的原因:相同文本长度下,多模态请求额外多出 num_image_tokens 个 KV 槽。
一套完整流程串起来
把上面的机制按时间顺序串一遍,看一条带图请求的完整路径。
阶段一:预处理(tokenizer manager 进程)
should_run_mm_processor判定这条请求是否含多模态输入(contains_mm_input or is_mossvl)get_mm_processor_cls按 architecture 找到处理器类,找不到走 transformers 通用回退process_mm_data_async跑具体模型的预处理:解码图片、切图、跑图像 processor、算 feature- 每条 item 计算哈希(或接受调用方注入的
mm_hashes),派生pad_values哨兵序列 pad_mm_token_pairs/build_padded_input_ids把占位写进 input_ids,记录offsetscompute_mrope_positions算 M-RoPE 位置和 delta- 构造
MultimodalInputs,随请求一起发给调度器
阶段二:调度(scheduler 进程)
_try_apply_padded_mm_input_ids拼接 padded ids(带前缀时)- Radix Cache 匹配:占位序列作为 key 的一部分参与前缀匹配
PrefillAdder预算:num_image_tokens计入 KV 槽位需求prepare_encoder_info_extend构造encoder_lens/encoder_cached,剥离视觉部分
阶段三:前向(GPU)
general_mm_embed_routine→prepare_mm_inputsembed_mm_inputs按模态分组,拍平所有请求的 item- 查询
embedding_cache;未命中则批内去重后一次 ViT 调用 - 分块情形下从完整 embedding 切出本轮 chunk
torch.isin(input_ids, placeholder_tensor)生成 mask_adjust_embedding_length校验长度input_ids.clamp_(0, vocab_size-1)后查表得文本 embedding_scatter_mm_embedding按 mask 把视觉 embedding 写入language_model(input_ids=None, input_embeds=input_embeds, ...)
阶段四:清理
- 请求结束时
_maybe_clear_mm_inputs:session 请求保留,普通请求释放 - 抢占发生时保留原始输入 lease,保证可重建
- abort 的 session 请求单独走
release_mm_inputs_on_abort
设计取舍的回顾
回头看,SGLang 的多模态实现有几个值得记住的设计决策。
用”超词表哨兵”而不是”特殊 token”作为占位。特殊 token 用同一个 id 会导致所有图像的前缀序列相同,缓存必然误命中。用内容派生的哨兵序列,前缀缓存逻辑一行都不用改,正确性由哈希保证。代价是 input_ids 里出现了超出词表的值,所有下游消费者(clamp、调度记账、序列化)都必须知道这件事。
四个哨兵而不是一个。让块级别的部分匹配有区分度,代价是每个位置的取值空间从 64 位缩到 62 位。
hash 和 identity 双粒度。embedding 缓存用 64 位单值当 key(快、够用),radix 缓存用 32 字节完整摘要派生四哨兵(细、用于匹配)。同一份数据服务两个不同粒度的消费者。
两套长度校验,都在最靠前的位置。_get_chunked_embedding_full 里校验缓存命中长度,_adjust_embedding_length 里校验最终长度。前者防的是”哈希碰撞导致的陈旧缓存”,后者防的是”框架计算错误”。注释明确写了前者「otherwise surface much later … as an unrecoverable prefill crash」——这个取舍是拿一次多余的 ViT 编码换掉一次难排查的服务崩溃。
主机侧计数不读 GPU。_count_mm_tokens_in_extend 用区间求交算视觉 token 数,不用 mask.sum().item()。这是为了让 Overlap Scheduler 的 CPU/GPU 重叠不被一次隐式同步打断。
batch 内按 (hash, token_count) 去重。同一批里重复的图像只编码一次,同时 token count 进 key 防止同批内的哈希碰撞被错误合并。
session 请求保留视觉特征。多轮图像对话里,每轮都重跑 ViT 是不可接受的代价;保留 mm_inputs 让后续轮次直接复用。
传输层三级回退。CUDA IPC 优先(零拷贝),不可用时退到共享内存,再不行退到内联 pickle。每一级都是静默回退,功能不中断。
小结
这一篇把多模态输入链路从预处理到回填走了一遍,核心是三件事:
- 占位机制:图像在 input_ids 里被替换成由内容哈希派生的 62 位哨兵序列,位置信息记在
MultimodalDataItem.offsets里。哨兵序列让前缀缓存不需要任何特殊逻辑就能区分不同的图像,四个哨兵的轮转设计提供了块级别的匹配区分度。 - 编码与回填:视觉编码在语言模型前向时现场发生,批内按
(hash, token_count)去重合并成单次 ViT 调用;结果通过torch.isin生成的 mask 散射进input_embeds,语言模型以input_ids=None的方式接收纯 embedding 输入。 - 分块与缓存:分块预填充把图像切开时,靠
embedding_cache保证整图只编码一次,每个 chunk 从完整 embedding 里截取自己那一份;两处长度校验把哈希碰撞的风险挡在 prefill 崩溃之前。
下一篇沿 schedule_batch.py 剩下的部分继续,进入「内存池与显存管理」这条线:ReqToTokenPool 和 TokenToKVPoolAllocator 如何把逻辑序列位置映射到物理 KV 槽、HybridReqToTokenPool 在混合架构(全注意力 + 线性注意力层)下如何维护两套账本、以及 MLA 的压缩 KV 如何在这套分配器里单独记账。前面十四篇反复出现「KV 槽位」「页分配」「超额分配」这些词,但真正的物理账本一直没打开,下一篇把这块补齐。
参考资料
- Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution
- DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
- Qwen2.5-VL Technical Report
- SGLang: Efficient Execution of Structured Language Model Programs
- SGLang GitHub 仓库
- SGLang
multimodal_processor.py - SGLang
mm_utils.py - SGLang
mm_schedule.py - SGLang
schedule_batch.py - vLLM 源码完全拆解(十三):多模态输入——从图像预处理到 Placeholder Range 嵌入
- SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



