


vLLM 源码完全拆解(三十五):Renderer 与分词输入侧——文本如何变成 token、又怎样被预算截断
前三十四篇把 vLLM 的引擎主干、调度、KV Cache、注意力、采样、输出侧逐段拆完,却一直绕开了请求进入 GPU 之前的那段路。它看起来只是「把字符串交给 Hugging Face tokenizer」,实际上在 vLLM 的前端进程里,文本要经过模板渲染、分词、字符级预截断、token 级截断、padding、长度校验、多模态占位符对齐,最后才被封成 EngineCoreRequest 送进 ZMQ 队列。这条路径上的每一个数字都决定请求会不会被拒绝、被截掉哪一端、以及 max_tokens 还剩多少预算。
本篇以当前 vLLM main 分支的 vllm/tokenizers/、vllm/renderers/ 与 vllm/v1/engine/input_processor.py 为准,回答五个问题:tokenizer 从哪里来;为什么它要被复制成一池;模板渲染与分词如何分工;TokenizeParams 的三个预算数字怎样推导;异步前端如何避免分词阻塞事件循环。
系列位置与本篇的问题
前三十四篇的重心在引擎内部:请求已经变成 token ID 之后,调度器如何分块、KV 如何分配、注意力后端如何执行。输入侧的拆解在系列里只出现过两次:第二篇顺带提到分词不应阻塞关键路径,第十五篇讲的是输出侧的增量 detokenizer。中间这段「文本 → token ID」的完整路径一直缺席。
这段路径值得单独成篇,因为它的失败模式与引擎内部完全不同。引擎内部的错误通常是显存不足、块分配失败、kernel 越界;输入侧的错误则多是语义性的:
- 模板把 system prompt 渲染了两遍,token 数比用户以为的多;
truncate_prompt_tokens从错误的一端截断,把系统提示整段丢掉;- 字符级预截断为了省时间砍掉文本,但 token 偏移没有同步修正,多模态占位符对不上;
- 分词跑在异步事件循环线程里,一个超长 prompt 让整个 API server 停止响应。
vLLM 当前把这一层拆成了两个显式的组件:TokenizerRegistry 负责「用哪种 tokenizer 实现」,Renderer 负责「怎样把消息渲染成 prompt、再分词成 token」。两者都在前端进程,不在 EngineCore 里。先把这个边界固定下来,后面的代码才有位置感。
全景:一条文本在进入 EngineCore 之前走了哪几步
先给出一张按源码调用关系画的路径图。图中的函数名都来自当前 main 分支,后面的章节会逐个展开。
OpenAI API / LLM.generate │ ▼AsyncLLM.add_request() │ 原始 prompt 是字符串或消息列表 ├─ 已经是渲染好的 EngineInput? → InputProcessor.process_inputs()(同步) └─ 原始 prompt? → await InputProcessor.process_inputs_async() │ make_async,跑在 renderer 线程池 ▼ Renderer.render_cmpl() / render_chat() │ ├─ parse_model_prompt / parse_chat_messages ├─ safe_apply_chat_template(可选) ├─ TokenizeParams.apply_pre_tokenization │ ├─ _text_len_check(字符级上界) │ └─ _text_lowercase ├─ BaseRenderer._tokenize_prompt │ └─ tokenizer(text, **encode_kwargs) ├─ TokenizeParams.apply_post_tokenization │ ├─ _token_truncation │ ├─ _token_padding │ └─ _token_len_check └─ 多模态:占位符展开后的二次截断 ▼ EngineCoreRequest {prompt_token_ids, sampling_params, mm_features, ...} │ ZMQ ▼ EngineCore这张图里有两个容易被忽略的分界。第一,模板渲染和分词都在前端,EngineCore 只收 token ID;因此 tokenizer 的版本、特殊 token、截断策略全部由 API 进程决定。第二,同步与异步是两个入口:已经渲染好的 EngineInput 走同步 process_inputs,原始字符串或消息列表走 process_inputs_async。后者的「异步」不是指分词本身变成非阻塞,而是把它丢进线程池,让事件循环能继续处理其他请求。
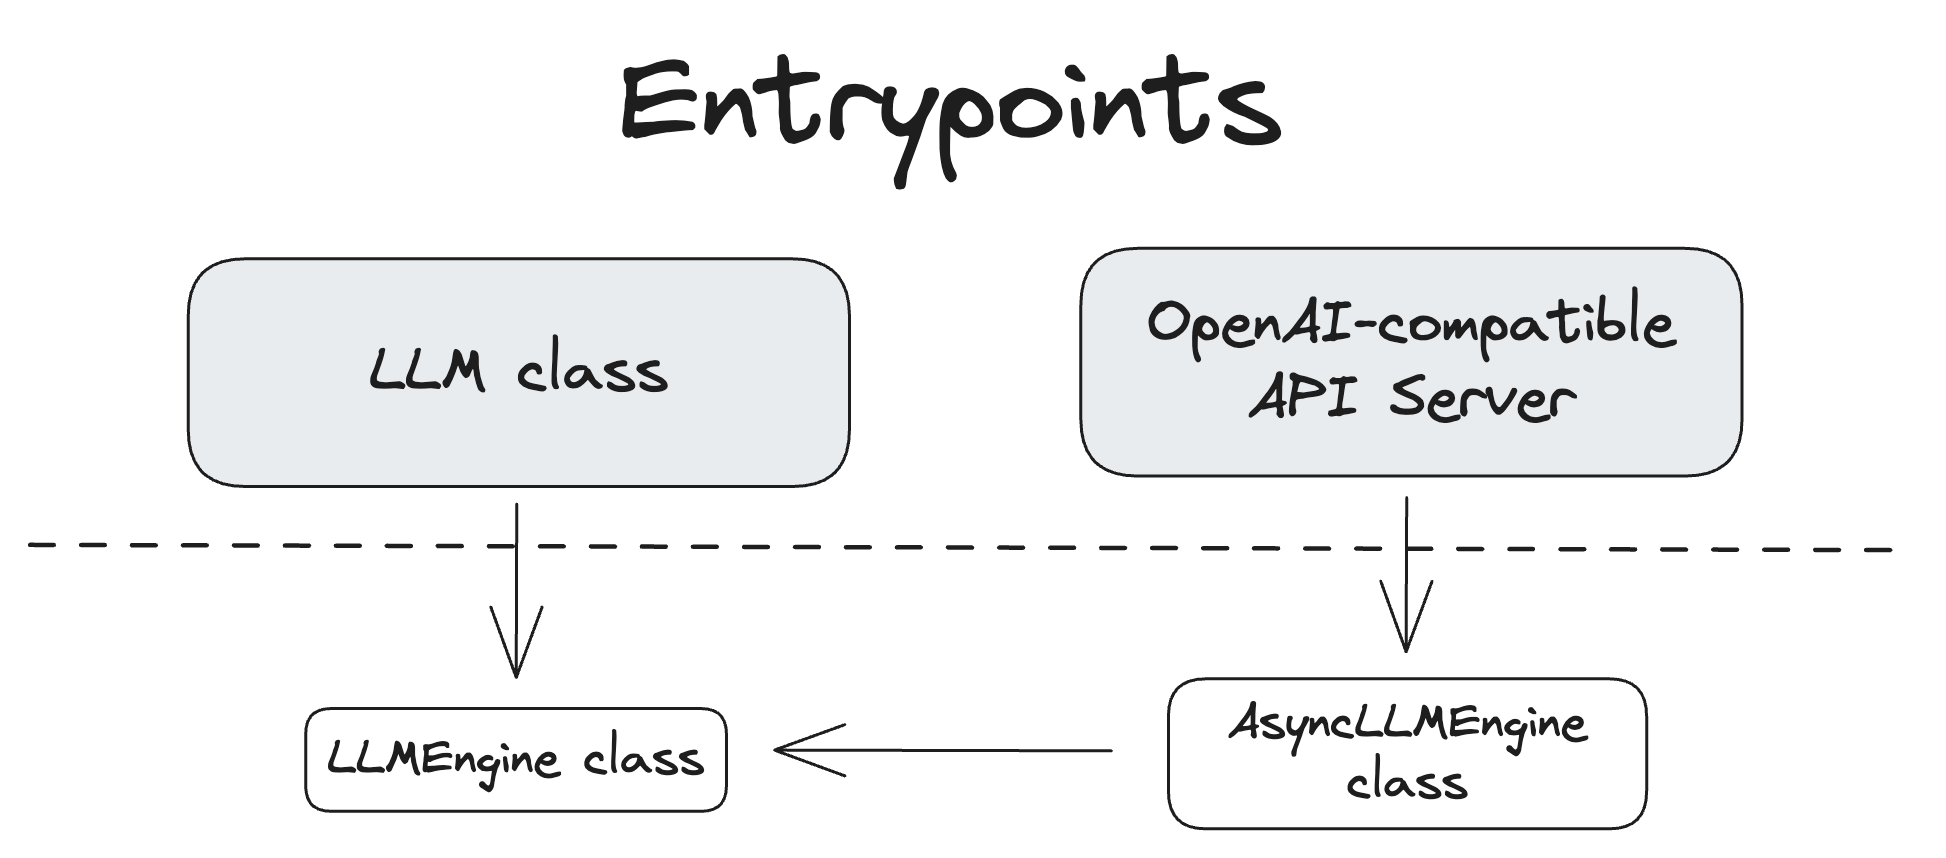
上图是 vLLM 官方架构文档里的入口示意图。左侧的 API server、Renderer 与 tokenizer 都位于前端进程,右侧 EngineCore 只面对已经 token 化的请求。本篇讨论的正是左侧从 HTTP 请求到 EngineCoreRequest 的那一段。图源:vLLM 官方 Architecture Overview。
Tokenizer 从哪里来:TokenizerRegistry 与 get_tokenizer
注册表:tokenizer_mode 不是「快慢」二选一
早期 vLLM 的 tokenizer_mode 只有 auto、slow、mistral 三个选择:auto 使用 fast tokenizer,slow 强制慢实现,mistral 走 Mistral 的专用分词器。当前实现把它扩展成一张注册表:每个 mode 映射到一个模块和一个类,auto 只是「先探测、再回退」的入口。
_VLLM_TOKENIZERS = { "hf": ("hf", "CachedHfTokenizer"), "mistral": ("mistral", "MistralTokenizer"), "deepseek_v32": ("deepseek_v32", "DeepseekV32Tokenizer"), "deepseek_v4": ("deepseek_v4", "DeepseekV4Tokenizer"), "deepseek_v41": ("deepseek_v41", "DeepseekV41Tokenizer"), "kimi_audio": ("kimi_audio", "KimiAudioTokenizer"), "alpamayo2_super": ("alpamayo2_super", "Alpamayo2SuperTokenizer"), # ... 其余专用 tokenizer}
TokenizerRegistry = _TokenizerRegistry( { mode: (f"vllm.tokenizers.{mod}", cls) for mode, (mod, cls) in _VLLM_TOKENIZERS.items() })这张表背后是一个很重要的设计判断:分词不是纯文本问题,它和模型家族绑死。DeepSeek V3.2/V4 的 tokenizer 要处理特殊的 BOS、EOS 与编码规则;Mistral 的 Tekken tokenizer 有自己的词表格式;Kimi Audio 要把音频 token 与文本 token 放进同一个序列。把这些差异塞进一个 AutoTokenizer 分支会让代码变成无数个 if model_type == ...,注册表把差异收敛到「mode → 类」的一条映射上。
resolve_tokenizer_args 负责把用户传入的 auto 解析成具体 mode,顺序是:
- 如果设置了
VLLM_USE_MODELSCOPE,先从 ModelScope 下载 tokenizer 文件,并忽略权重文件; - 按 runner 类型设置默认截断方向:
generate/draft用left,pooling用right; - 如果仓库里有
tekken.json或tokenizer.model.v*,并且是 Mistral 模型仓库,自动切到mistral; - 仍然为
auto就回退到hf; hf模式下强制mistral_format=False,并从快照目录中排除权重,避免为了一个 tokenizer 拉下几十 GB 权重。
第 2 步的截断方向值得单独解释。生成请求默认从左边截断,保留尾部;池化请求默认从右边截断,保留头部。原因不是随意的:生成模型通常把系统提示放在开头,但上下文窗口不够时,用户更关心最近的对话,所以保留尾部;嵌入/重排模型要对整段文本做 pooling,截掉尾部比截掉开头更符合「保留开头主旨」的直觉。这个默认值会被后面的 TokenizeParams.truncation_side 覆盖,但它解释了为什么同一个 tokenizer_mode 在两个 runner 下行为不同。
get_tokenizer:一次加载,长期缓存
get_tokenizer 的职责比名字看起来重。它要做五件事:
def get_tokenizer(tokenizer_name, *args, tokenizer_cls=TokenizerLike, ...): if envs.VLLM_USE_FASTOKENS: from .fastokens import apply_fastokens_patch apply_fastokens_patch()
requested_name = str(tokenizer_name) tokenizer_mode, tokenizer_name, args, kwargs = cached_resolve_tokenizer_args(...)
if tokenizer_cls == TokenizerLike: tokenizer_cls_ = TokenizerRegistry.load_tokenizer_cls(tokenizer_mode) else: tokenizer_cls_ = tokenizer_cls
config = get_config(tokenizer_name, config_format=..., ...) # 某些模型的 hub tokenizer_class 是错的,直接绕过 AutoTokenizer if model_type in _MODEL_TYPES_WITH_INCORRECT_TOKENIZER_CLASS: tokenizer_cls_ = TokenizersBackend
tokenizer = tokenizer_cls_.from_pretrained(tokenizer_name, *args, **kwargs) if not tokenizer.is_fast: logger.warning("Using a slow tokenizer. This might cause a significant slowdown.") return tokenizer三个细节值得展开。
第一,cached_resolve_tokenizer_args 是 lru_cache 包住的。 解析 mode 需要访问 Hugging Face Hub(判断是不是 Mistral 仓库、有没有 Tekken 文件),如果每个请求都做一次,网络抖动会直接变成请求延迟。缓存键包含 tokenizer 名称、revision、runner 类型、tokenizer_mode 等参数,因此同一个模型的不同 revision 不会串味。
第二,_MODEL_TYPES_WITH_INCORRECT_TOKENIZER_CLASS 是一张「Hub 元数据不可信」名单。 名单里的模型(例如 internlm2、step3_vl、unlimited-ocr)在 Hub 上声明的 tokenizer_class 与权重实际使用的分词器不一致,AutoTokenizer 会选错类。vLLM 的处理是绕过 AutoTokenizer,直接用通用的 TokenizersBackend 加载。这不是优雅的长期方案,源码注释也写明:更好的修法是让 Transformers 维护同样的名单,或者让模型作者修正 Hub 元数据。工程代码经常要在「等上游修」和「先让用户跑起来」之间做这种局部妥协。
第三,config 被显式传给 AutoTokenizer。 正常情况下 AutoTokenizer.from_pretrained 会自己重新读 config.json;vLLM 已经把 config 读进来了,再读一次不仅浪费,还存在竞态:两次读取之间 Hub 缓存被刷新,第二次可能读到不完整的文件。源码用 kwargs.setdefault("config", config) 复用第一次的结果,并在需要时把 _name_or_path 改回用户请求的 Hub ID,避免日志里出现本地快照路径。
CachedHfTokenizer:把重复属性计算缓存起来
Transformers 的 tokenizer 有很多「每次访问都重新算」的属性:all_special_ids、all_special_tokens、get_vocab()、__len__。对一个每秒处理上千请求的服务,这些属性会被反复访问,累积起来不可忽略。get_cached_tokenizer 用一个动态生成的子类把这些值固定在实例上:
class CachedTokenizer(tokenizer.__class__): @property def all_special_ids(self): return tokenizer_all_special_ids
@property def max_token_id(self): return max_token_id
@property def max_chars_per_token(self): return max_chars_per_token
def get_vocab(self): return tokenizer_vocab
def __len__(self): return tokenizer_lenmax_chars_per_token 是这里最关键的派生量:它等于词表中最长 token 字符串的字符数。它给了 vLLM 一个不需要分词就能算出的字符上界——如果一段文本有 个字符,那么它的 token 数至少是 ,其中 就是 max_chars_per_token。反过来,如果 ,这段文本一定超过 个 token。下一节的字符级预检查就建立在这个不等式上。
max_token_id 的推导还处理了一个边界:某些 tokenizer(例如 Qwen 系列)的 vocab_size 包含实现里额外添加的特殊 token,但这些 token 不在 get_vocab() 里。源码取两者最大值,保证后续按 token ID 上界做分配或校验时不会因为少算特殊 token 而越界。
渲染与分词是两个职责:Renderer 的上下两层
为什么把模板渲染塞进 tokenizer 是不行的
早期 vLLM 的聊天请求处理方式是:拿到 messages 列表,调用 tokenizer.apply_chat_template(..., tokenize=True) 一步得到 token ID。这个写法简单,但把三件事耦合在了一次调用里:
- 模板渲染:根据 Jinja 模板把消息列表转成一段文本,这一步需要知道
tools、reasoning_effort、内容格式(string还是openai分块)等模板参数; - 分词:把文本转成 token ID;
- 多模态对齐:图像/音频在模板里是一个占位符,分词之后要把它换成一串 token,并记录这串 token 在序列中的位置。
第三步在多模态模型里尤其麻烦:模板渲染时并不知道图像占多少 token,要等视觉处理器算出 patch 数量;而分词又只能处理文本。如果这三步都在 apply_chat_template 里,任何一处的策略变化都要改动同一个函数。
当前实现的拆法是:BaseRenderer 定义了 render_prompt(把原始输入变成 DictPrompt)和 tokenize_prompts(把 DictPrompt 变 token)两个可独立重写的阶段;render_cmpl / render_chat 是两个顶层入口,各自按顺序调这两个阶段,最后调用 process_for_engine 组装多模态特征与引擎输入。
def render_chat(self, conversations, chat_params, tok_params=None, ...): arrival_time = time.time() if tok_params is None: tok_params = self.default_chat_tok_params
rendered = [self.render_messages(c, chat_params) for c in conversations] ... tok_prompts = self.tokenize_prompts(dict_prompts, tok_params) ... eng_prompts = [ self.process_for_engine(p, arrival_time, skip_mm_cache=skip_mm_cache, tok_params=tok_params) for p in tok_prompts ] return out_conversations, eng_prompts注意 render_chat 返回的是二元组:out_conversations 是「模板层面理解后的会话」,eng_prompts 是引擎输入。前者用于输出侧的增量解码与工具调用解析——这些解析器需要知道 user 与 assistant 的分界在模板里的确切形式,而不是从 token 流里猜。
默认 TokenizeParams 的两个差异:add_special_tokens
default_cmpl_tok_params 与 default_chat_tok_params 只差一个字段,但理由不同:
# CompletionTokenizeParams(max_total_tokens=model_config.max_model_len, do_lower_case=encoder_config.get("do_lower_case", False), add_special_tokens=True)
# ChatTokenizeParams(max_total_tokens=model_config.max_model_len, do_lower_case=encoder_config.get("do_lower_case", False), add_special_tokens=False)补全请求的输入是原始文本,用户期望模型看到的正是他写的文本,因此 tokenizer 的默认行为——自动补 BOS——是合理的。聊天请求的输入是「模板已经渲染好的文本」,好的 chat template 已经把 BOS 或 <|im_start|> 等特殊 token 写进了文本;如果再让 tokenizer 补一次,就会出现两个 BOS。这不是理论问题:Qwen 系列的模板以 <|im_start|>system 开头,Llama 3 的模板同样显式放入 <|begin_of_text|>,重复补 BOS 会让模型行为明显走样。
多模态模型的情况又不同:如果渲染器挂着 mm_processor,两个默认值都取自 mm_processor.info.default_tok_params。原因在于视觉占位符的 token 化参数要与多模态处理器自己算出的 token 数保持一致——处理器按 default_tok_params 预算图像 patch 的 token 数,如果分词侧用了别的参数(例如多加了 BOS),两边就会错一位,后面所有 offset 与 length 全部错位。
把渲染与分词合并会放大截断的错误
把模板渲染与分词拆成两个阶段,除了职责清晰,还消除了一个合并实现时的典型错误:apply_chat_template(tokenize=True) 内部的截断语义与用户的 truncate_prompt_tokens 不一致。HF 的 apply_chat_template 在 tokenize=True 时会先渲染文本,再调用 tokenizer;它支持 max_length 与 truncation 参数,但截断侧取自 tokenizer 的默认值,而不是用户为这次请求指定的方向。更麻烦的是,它会在渲染后立刻做截断,此时多模态占位符还是一个 token,展开之后又会超预算,而 apply_chat_template 本身无法在此之后重新校验。
拆开之后,每一段职责都持有自己的参数:渲染阶段只关心文本如何拼接、特殊 token 是否由模板提供;分词阶段只关心文本如何变成 token、截断预算与并行偏移;多模态展开阶段只关心占位符如何替换与对齐。任何一段出问题,错误信息都指向具体那一段,而不是笼统的「tokenizer 报错」。
safe_apply_chat_template 做的三件防御性工作
模板渲染本身也有工程细节。safe_apply_chat_template 在调用 Jinja 之前会:
- 解析模板来源:从 tokenizer 自带的
chat_template、用户请求里传入的chat_template、或模型配置的默认模板中确定最终模板;如果三者都没有,直接抛出ChatTemplateResolutionError,说明 Transformers v4.44 之后不再允许隐式使用默认模板。 - 处理
developer角色:OpenAI 协议新增了developer角色,但很多模型的模板只认识system。如果模板里没有developer分支,函数会把这类消息转换成system并合并相邻的 system 消息。这一步必须在渲染之前做,否则 Jinja 会走到else分支把消息当作用户消息处理。 - 统一
return_dict:Transformers v5 把apply_chat_template(tokenize=True)的默认返回类型改成了BatchEncoding,而 vLLM 下游期望一个扁平的 token 列表。函数在 kwargs 没有显式指定return_dict时强制设为False,保证 v4 与 v5 下行为一致。
第三点是典型的「上游默认值变更」问题。推理框架的依赖范围很宽:部署环境里 Transformers 可能是 v4 也可能是 v5,如果代码依赖的是默认值,升级就会静默地改变返回类型,最终表现为「渲染结果是一个 dict,prompt_token_ids 取出来是 None」这类难以定位的错误。显式设置参数,抵消上游默认值变更,是框架层常用的兼容手段。
模板错误如何变成 400
模板本身可以在渲染时抛出异常,例如用户给 reasoning_effort 传了一个模板不支持的值,模板里可能写 {{ error("unsupported reasoning_effort") }} 或直接比较失败。源码的处理是把这类异常转换为 VLLMValidationError,并提取模板里的原因:
except Exception as e: # 模板通过抛异常来拒绝不合法的用户输入; # 把它暴露成 400,并带上模板自己的原因(通常列出支持的值) logger.warning("Chat template rejected the request: %s", e) raise VLLMValidationError(_template_error_reason(e)) from e如果不做转换,模板异常会一路冒泡成 500,用户看到的是服务器内部错误,而实际原因是自己的参数不合法。区分 400 与 500 对客户端重试策略影响很大:400 不应该重试,500 往往值得重试。
模板渲染与生成配置的交互
InputProcessor.process_inputs 在拿到引擎输入之后做两件与采样参数有关的事:
sampling_params.update_from_generation_config( self.generation_config_fields, self.renderer.get_eos_token_id(),)if self.tokenizer is not None: sampling_params.update_from_tokenizer(self.tokenizer)generation_config_fields 来自模型的 generation_config.json,它包含模型作者给出的默认温度、top_p、EOS 等。如果客户端没有显式传这些参数,vLLM 会用生成配置补全。update_from_tokenizer 则从 tokenizer 的 eos_token_id 等信息补全停止 token。这两步都必须发生在渲染之后,因为 EOS 列表要同时包含 generation_config 与 tokenizer 各自声明的值——不同模型的 EOS 可能不止一个(例如 <|endoftext|> 与 <|im_end|> 都可能是合法停止点)。
如果渲染阶段把某些特殊 token 当作普通文本处理,或者分词阶段把 EOS 当成了普通 token 的一部分,停止条件就会失效,请求会一直生成到 max_tokens 才停。输入侧与采样侧的这种「隐式契约」是调试中最隐蔽的问题之一:输出看起来正常,只是特别长。
needs_detokenization:给调用方的「可读文本」选项
TokenizeParams 里还有一个不太显眼的字段 needs_detokenization。它的注释特意说明不要与 SamplingParams.detokenize 混淆:后者管理的是模型输出是否要解码成文本,而前者管理的是输入在 token 化之后是否需要重新解码出原始文本。当 needs_detokenization=True 且输入是 token ID 而不是文本时,_tokenize_singleton_prompt 会执行:
if params.needs_detokenization and "prompt" not in prompt: prompt = self._detokenize_prompt(prompt)它把给定的 token 序列解码回文本,放进 prompt["prompt"]。为什么需要这个?一些下游路径(例如结构化输出解析、内容解析、日志展示)需要原始 prompt 文本,而客户端可能只提供了 token ID(例如已经按 token 计费的前端)。_detokenize_prompt 的注释说明了执行时机:「在截断之后解码,使文本与发送给引擎的 token 匹配」——如果先解码再截断,prompt 文本就是完整未截断的版本,与引擎实际收到的 token 不一致,日志与调试信息会误导人。这个先后顺序看起来是小细节,实际上决定了「日志里看到的 prompt」与「模型看到的 prompt」是否一致。
TokenizeParams:三个预算数字的推导
TokenizeParams 是这一层里最值得逐字段拆的结构体。它不是一个「截断参数集合」,而是一组相互约束的预算:
@dataclassclass TokenizeParams: max_total_tokens: int | None # 模型上下文上限,输入 + 输出 max_output_tokens: int | None = 0 # 本次要生成的 token 上限;0 = 池化 pad_prompt_tokens: int | None = None # 补齐到多少 token truncate_prompt_tokens: int | None = None # 保留多少 token;-1 = 用 max_input_tokens truncation_side: Literal["left", "right"] | None = None do_lower_case: bool = False add_special_tokens: bool = True return_token_offsets: bool = False needs_detokenization: bool = False三个派生量:max_input_tokens、max_truncation_tokens、max_input_chars
@propertydef max_input_tokens(self) -> int | None: # max_output_tokens 不在这里扣除:这个值代表模型上下文长度本身 return self.max_total_tokens
@propertydef max_truncation_tokens(self) -> int | None: max_input_tokens = self.max_input_tokens if max_input_tokens is None: return None if self.max_output_tokens == 0: return max_input_tokens return max(0, max_input_tokens - 1)max_input_tokens 刻意不扣除输出预算。这一点容易误解成 bug:模型总上下文是 ,用户要求生成 个 token,那么 prompt 最多只能是 ,为什么这里返回 ?
答案在于「拒绝」和「截断」是两套口径。max_input_tokens 是「不截断时允许的 prompt 上限」,即整个上下文全给输入时能放多少——如果 prompt 本身就有 个 token,那它是合法的输入,只是输出预算为 0。真正要扣输出预算的是截断上限:max_truncation_tokens 在生成请求下返回 。源码注释写得很直白:如果截断到完整的 ,下游 get_max_tokens() 会把采样预算钳到 0,一个超长 prompt 会变成「静默地生成零个 token」,用户既没报错也没输出。
池化请求(embedding、rerank)没有生成阶段,max_output_tokens = 0,因此截断上限就是 ,把整个上下文用于输入。这个 0 是有意义的标记而不是「未设置」,判断逻辑必须用它来区分生成与池化,不能写成 if not max_output_tokens 后混入 None。
第三个派生量来自 tokenizer:
其中 ,。它给出一个不必分词就能算出的字符上限:任何 token 至多对应 个字符,所以 个 token 的文本不可能超过 个字符。反过来讲,如果文本长度超过 ,那么它一定超过 个 token,不需要真的分词就能拒绝它。
这个不等式在长文本上的意义值得算一下。对一个典型的约 128k token 上下文的模型,假设 ,则 字符。如果用户不截断地送进 5M 字符的文档,直接分词要处理几十 MB 的 Python 字符串并在 Rust/Rayon 分词器里构建大块中间结构,可能消耗数秒 CPU 与上百 MB 内存;而字符检查在 的 len(text) 之后就能返回 400。先做字符级上界检查,是给最坏情况设一道廉价的闸门。
字符级预截断与 token 级截断
_text_len_check 按三条分支处理:
max_input_chars = max_input_tokens * tokenizer.max_chars_per_token
if self.truncate_prompt_tokens is None: if len(text) > max_input_chars: raise VLLMValidationError("... your prompt contains ...")elif self.truncation_side is not None and len(text) > max_input_chars: if self.truncation_side == "left": text = text[-max_input_chars:] else: text = text[:max_input_chars]return text三条分支对应三种意图:
- 不截断(
truncate_prompt_tokens is None):超长就报错,让用户自己处理。这里不能悄悄截断,因为生成的截断结果与用户预期相差很远,而且字符级截断的边界可能切在 token 中间。 - 显式指定截断方向:字符级先截一刀,把送入分词器的字符数压到 之下。这只是一道资源闸门,不能保证最终 token 数一定不超过 : 是「单个 token 最多覆盖多少字符」, 个字符在极端文本上(例如每个 token 只覆盖 1 个字符)仍可能切出超过 个 token。最终的精确 token 预算仍由后面的
_token_truncation负责,字符级截断只是保证分词器不会处理一个无限长的字符串。 - 指定了截断数量但没有指定方向(
truncation_side is None):跳过字符级预截断,交给 tokenizer 自己的truncation=True处理。为什么这里不做预截断?因为 tokenizer 的默认截断侧可能与我们需要的方向不一致,而且如果不做字符级预截断,tokenizer 在get_encode_kwargs()里会用max_length = max_input_tokens + 1把输出限制在上限加一,从而既不会浪费资源,又能让_token_len_check准确报出「至少超了多少」。
第三分支里 +1 的细节值得单独说。get_encode_kwargs 中:
max_length = self.truncate_prompt_tokensif max_length is not None and max_length < 0: max_length = self.max_truncation_tokenselif max_length is None and self.max_input_tokens is not None: # 防止 tokenization 消耗超过必要的资源, # 同时仍然让 _token_len_check 按用户预期失败 max_length = self.max_input_tokens + 1如果直接用 max_input_tokens 作为 tokenizer 的截断上限,那么超长 prompt 会被截断到恰好 ,后面的 _token_len_check 看到长度不超过上限就放行了——错误被「成功截断」掩盖。截到 则相反:超长 prompt 被截到上限加一,_token_len_check 看到 就会报错,并在错误信息里用 at least 限定词说明真实长度可能更大。这是「不截断时保证报错」的实现技巧:用一个精心选择的边界值,让校验函数在压缩后的数据上仍然能做出正确判断。
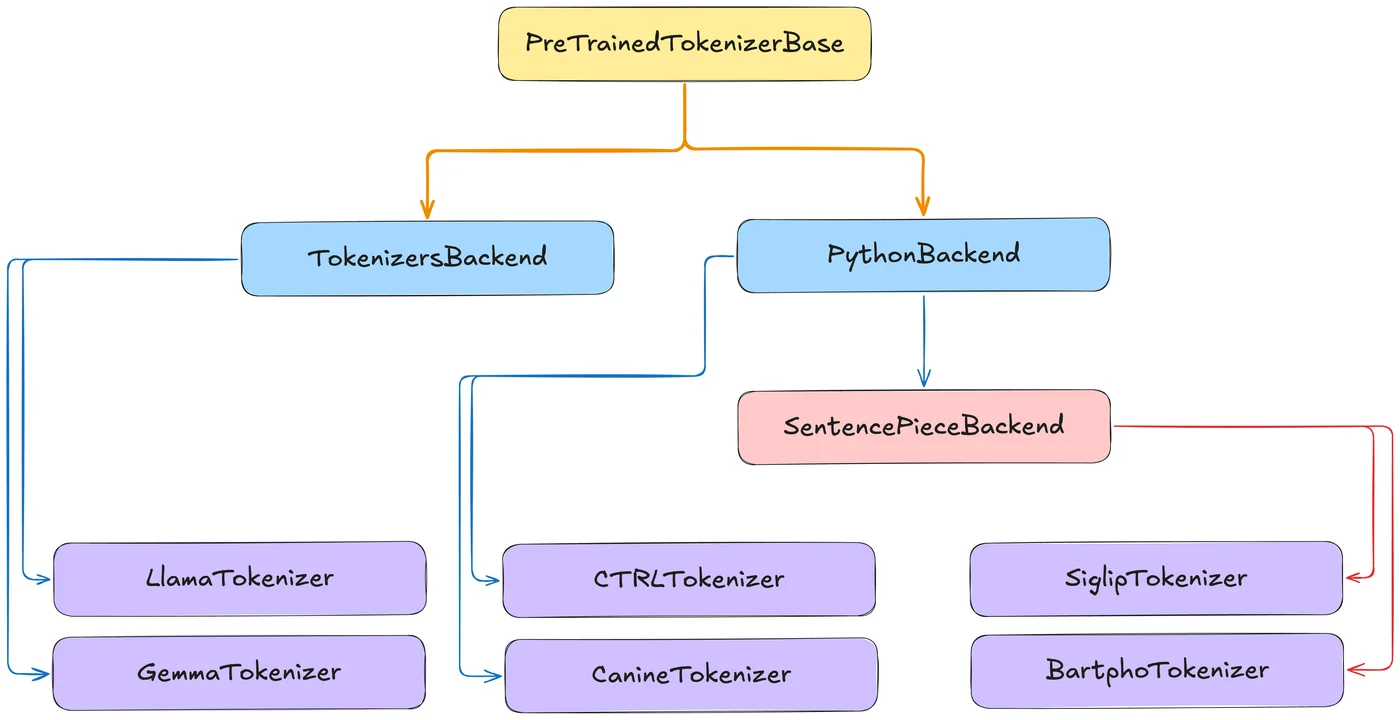
上图展示 Transformers 的 tokenizer 类继承层次:统一接口 PreTrainedTokenizerBase 位于上层,下面区分实际执行分词的后端和模型专用类。它不是 Normalizer → PreTokenizer → Model 的处理时序图,两者需要分开理解。一次 encode 的内部处理还包括规范化、预分词、模型分词和特殊 token 后处理;vLLM 的字符级截断发生在这些步骤之前,而 max_chars_per_token 反映的是词表里最长 token 的字符数,因此这一字符预算是安全但偏保守的上界。图源:Hugging Face 官方博客。
token 级校验:截断、补齐、长度检查的顺序
apply_post_tokenization 走三个校验器,顺序是截断 → 补齐 → 长度检查:
for validator in ( self._token_truncation, self._token_padding, self._token_len_check,): tokens = validator(tokenizer, tokens)顺序不能交换,源码注释给了一个具体的反例:如果先补齐再截断,并且截断侧是 left,那么补齐刚追加的 pad_token_id 恰好位于尾部,左截断会把它们全部保留而把真正的 prompt 全部丢掉——用户拿到一条只有 pad 的「空请求」,然后模型在空序列上生成。先截断再补齐则不会出现这种情况:截断只作用在真实 token 上,补齐是最后一步。
还有一个容易被忽略的约束:并行字段必须用同一个切片。
_PARALLEL_TO_PROMPT_TOKENS = ( "prompt_token_offsets", "prompt_is_token_ids",)
for key in _PARALLEL_TO_PROMPT_TOKENS: parallel = prompt_dict.get(key) if parallel is None: continue truncation = self._truncation_slice(tokenizer, len(parallel)) if truncation is not None: prompt_dict[key] = parallel[truncation]prompt_token_offsets 是每个 token 在原始文本里的字符区间,prompt_is_token_ids 标记哪些 token 来自用户直接给定的 ID。这两者与 token 序列一一对应,任何只截 token 不截它们的实现,都会让第 个 token 对应错误的字符偏移。偏移用在哪里?结构化输出和内容解析需要把 token 回推到原文位置;多模态处理器需要根据 prompt_token_offsets 定位占位符。偏移一旦错位,下游的错误往往表现为「模板里明明有图,模型却说没看到」。
字符级预截断后的偏移重映射
如果字符级预截断从左侧砍掉了 个字符,分词得到的偏移就是相对于截断后文本的。_get_text_truncation_offset 返回这个 ,随后 _apply_prompt_char_offset 把它加回每个偏移:
if char_offset == 0: return promptoffsets = prompt.get("prompt_token_offsets")if offsets is not None: prompt["prompt_token_offsets"] = [ (start, end) if (start, end) == (0, 0) else (start + char_offset, end + char_offset) for start, end in offsets ](0, 0) 被特判跳过。Fast tokenizer 对特殊 token(BOS、EOS、模板插入的控制 token)返回 (0, 0),它不是真实的字符区间;如果也加上 ,这些特殊 token 会被「定位」到原文本的第 个字符附近,和它们实际的位置毫无关系。这个特判保证特殊 token 保留原来的「无位置」语义。
多模态:占位符展开之后的二次截断
apply_post_tokenization 作用在「占位符还是单个 token」的阶段。多模态模型的下一个阶段会把一个占位符展开成几十甚至上千个 token(一个 的图块在 Qwen-VL 中约占 256 个 token),展开之后 prompt 可能重新超过 truncate_prompt_tokens。_truncate_expanded_prompt 负责这一步:
if engine_input["type"] != "multimodal": returnif params is None or params.truncate_prompt_tokens is None: return
num_tokens = len(prompt_token_ids)truncation = params._truncation_slice(self.tokenizer, num_tokens)if truncation is None: returnstart, stop, _ = truncation.indices(num_tokens)
for modality, positions in mm_placeholders.items(): for position in positions: end = position.offset + position.length if position.offset >= start and end <= stop: continue raise VLLMValidationError( f"truncate_prompt_tokens=... would split or drop a(n) {modality} item ..." )关键的策略是:多模态片段永远不切开。普通的文本截断可以把一段文字切掉一半,但图像与文本的对应关系不是线性的——切掉一半图像 token,模型会看到一张「半张图」,输出的语义完全不可预期。因此这里的做法是:如果截断切片会切到任何多模态片段,直接报错让用户调整;如果不切,则把所有片段的 offset 平移 start,与截断后的 token 序列重新对齐。
注意函数的第一个分支:只有 multimodal 输入才会走到这里。纯文本的 token 输入在多模态展开阶段不会增长,apply_post_tokenization 已经处理过,再截一次只会重复计算。
这一段的实践含义是:多模态请求的截断预算要把展开后的 token 数算进去。一个请求在 API 层看起来只有 100 个 token,但里面带了三张图,展开后可能到 900 token。如果 max_model_len 只按文本长度评估,会在 InputProcessor 的模型输入校验阶段被拒绝,而不是在渲染阶段给出一个清晰的「截断预算不够」错误。vLLM 把两处都做了校验——渲染阶段保证不切图,InputProcessor._validate_model_inputs 再做一次总长检查——是为了让错误尽量在离用户最近的地方出现。
异步前端:分词为什么不能跑在事件循环里
AsyncLLM.add_request 有两个分支,源码给出的理由很具体:
if isinstance(prompt, dict) and "type" in prompt: # 已经渲染好的 EngineInput;无需阻塞式预处理 request = self.input_processor.process_inputs(...)else: # 原始 prompt 需要分词与(可能)多模态处理, # 不能阻塞事件循环 request = await self.input_processor.process_inputs_async(...)process_inputs_async 在 InputProcessor.__init__ 中用 make_async 包了一层:
self.process_inputs_async = make_async( self.process_inputs, executor=self.renderer._executor)这里的 executor 是渲染器的线程池,不是一个新的池。原因有三:
- 复用既有资源:渲染器已经为分词/多模态准备了一个线程池,再创建一个会让线程总数翻倍,每个线程的 Python 对象与线程局部状态都要额外占用内存;
- 单一并发源:所有阻塞性预处理都经过同一个池,池的大小就是预处理并发度的上限,便于监控与调参;
- 超时后可以整体替换:渲染器有
_SwappableExecutor,当模板渲染卡死(例如恶意或过于复杂的 Jinja 模板)时,可以整池丢弃旧线程,而不影响其他组件。
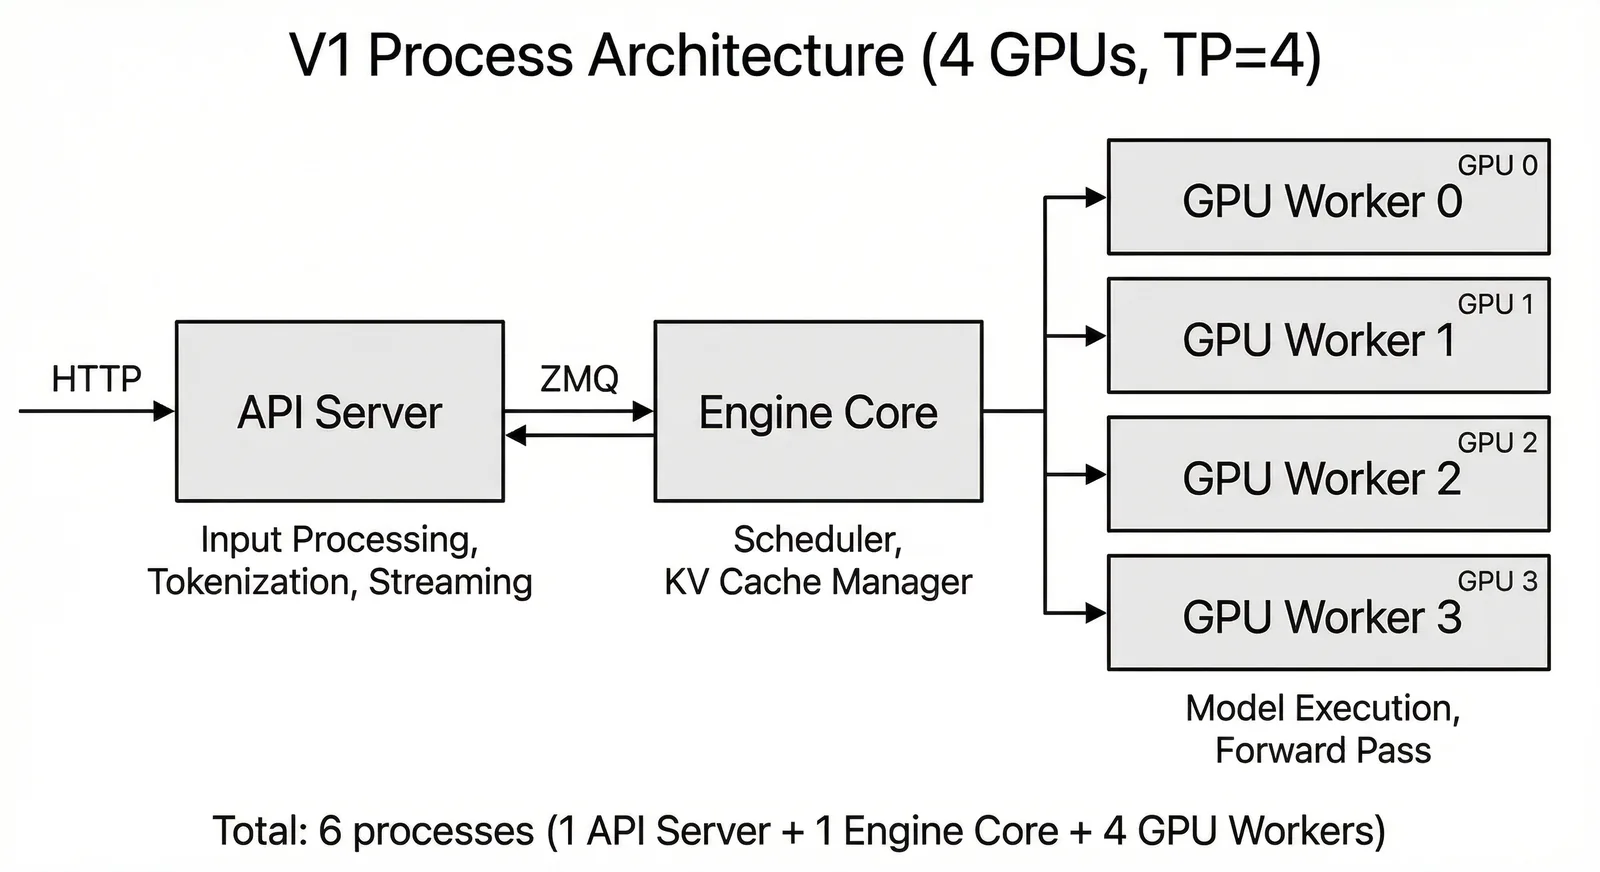
上图是 vLLM 官方文档给出的 V1 进程架构(张量并行度 4)。每个 rank 上的 engine 进程都有完整的模型副本与 KV 显存,而 API server 与前端(包含 Renderer、tokenizer 与输入处理)位于独立的 API 进程,通过 ZMQ 与所有 engine 通信。分词发生的位置越靠前,越能体现出一个事实:所有请求都要先在前端完成 token 化,再分发到各 engine;输入侧的线程池与 tokenizer 副本也只在前端存在。图源:vLLM 官方 Architecture Overview。
关于第 3 点,源码的注释说得更直接:
def _replace_executor(self) -> None: """Replace the inner render pool after a stuck worker.
Called after a render timeout so that the stuck thread (which CPython cannot interrupt) does not permanently block all subsequent renders. """ self._executor.replace_inner()CPython 无法强行中断一个正在执行 C 扩展或 Rust 分词器的线程。asyncio.wait_for 超时之后协程返回了,但被丢弃的那个线程仍然在跑。如果下一个请求复用同一个线程池里的空位,就会与卡住的线程争抢同一份 tokenizer 状态。_replace_executor 把旧的内部池整体替换为新池,旧线程在后台继续跑直到自然结束或进程退出,但新请求不再经过它。这解释了 _SwappableExecutor 的名字:对外部暴露的 executor 对象保持不变(make_async 绑定的就是它),只是内部替换实际工作线程。
超时本身由环境变量控制:
timeout = envs.VLLM_CHAT_TEMPLATE_RENDER_TIMEOUT # 默认 30 秒30 秒对于正常模板渲染是极宽松的,它的目标不是性能而是可用性:一个恶意构造的模板(例如在 Jinja 循环里做指数级展开)可以让一个请求吃掉 CPU 数十秒,如果没有超时,所有后续请求都会排队等这个线程。超时后抛出的错误也明确告知用户这是模板问题,并给出可以调整的环境变量。
tokenizer 的线程安全:一池 deepcopy 而不是一把锁
分词器在服务端会被多个线程并发调用。Hugging Face 的 TokenizersBackend 本身不保证线程安全:它的 encode 在底层是 Rust 对象方法,多数情况下是只读的,但模板相关的配置、后处理器的缓存、以及部分 Python 实现的分词器在首次调用时会惰性初始化内部状态。若多个线程同时触发这个初始化,就会出现竞态。
vLLM 的选择是一池 deepcopy 的实例轮转,而不是加锁:
def maybe_make_thread_pool(tokenizer, copies: int = 1): og_tokenizer = copy.copy(tokenizer) tokenizer_pool: queue.Queue = queue.Queue() for _ in range(copies): tokenizer_pool.put(copy.deepcopy(og_tokenizer))
@contextlib.contextmanager def _borrow_from_pool(): try: tok = tokenizer_pool.get_nowait() yield tok except queue.Empty: tok = copy.deepcopy(og_tokenizer) yield tok finally: tokenizer_pool.put(tok)
class TokenizerPool(tokenizer.__class__, ThreadSafeHFTokenizerMixin): def encode(self, *args, **kwargs): with _borrow_from_pool() as tok: return tok.encode(*args, **kwargs) # decode / apply_chat_template / batch_* 同理 def __reduce__(self): return maybe_make_thread_pool, (og_tokenizer, copies)这个设计的三个决策需要解释。
为什么用池而不是一把锁? 分词是 CPU 密集型操作。一把锁会把所有请求串行化,多核服务器上线程池形同虚设。用池之后, 个线程可以同时分词,并发度由池大小决定。
池大小怎么定? HfRenderer.__init__ 里是 copy.deepcopy 的数量等于 renderer_num_workers + 1。为什么是加一?渲染器自己的执行池有 renderer_num_workers 个线程,另外多模态处理器有自己的单线程执行器 _mm_executor;两者都可能同时调用 tokenizer,所以需要比工作线程多一个的副本。多出来的一个不是浪费,而是避免「多模态线程恰好拿到分词线程正在用的副本」时的排队。
池空了怎么办? _borrow_from_pool 在队列为空时现场 deepcopy 一个新实例,用完再放回队列。这保证了在极端并发下不会卡死:代价是临时多复制一份 tokenizer(几十 MB 内存),但比阻塞请求要划算。用完放回使得池会「自然扩容」到历史峰值大小。
__reduce__ 为什么必须返回 maybe_make_thread_pool? 因为 TokenizerPool 是在运行时动态创建的类,pickle 时找不到它的模块路径。如果不定义 __reduce__,序列化会失败或反序列化出 None。源码里专门有一行注释提醒此事(issue #45433)。这是「动态生成类」的一个通用陷阱:内存里能工作,一旦要跨进程传输就需要显式重建路径。
还需要注意一个边界:只有 TokenizerLike 的公开接口是线程安全的,_tokenizer 属性与 add_special_tokens、add_tokens 这类修改方法不在保护范围内。源码注释明确写出:相邻两次方法调用可能落到不同的 deepcopy 上。因此渲染器在加载完 tokenizer 之后、启动服务之前就要完成所有「加特殊 token」之类的修改,运行期不能再改。多模态处理器会收到一份独立的 deepcopy tokenizer(源码 #36557),这样多模态预处理与文本分词在同一个池之外也能并发。
输入侧在真实工作负载中的位置
要理解这一层为什么值得单独优化,不妨看看它在真实工作负载中的位置。Agent 与多轮对话场景的特点是:每轮调用都携带一整个会话历史,新增加的内容相对很小。TokTier 的论文(Zhenyu Zhang 与 Zhichao Cao,Arizona State University,2026 年 7 月发表于 arXiv)统计了 153,951 次交互式调用,其图 2 给出了「上下文 token 数 」与「每次新增 token 数 」的联合分布:会话续轮集中在比首次会话小一到三个数量级的新增 token 区间,也就是说绝大多数调用的内容是「大上下文 + 小增量」。
这个分布与分词层的两个设计直接相关。第一,如果每次请求都对完整文本重新分词,成本与 成正比,而新信息只有 ,这就是 vLLM 与大多数前端仍存在的结构性浪费;TokTier 提出的方向是利用会话状态只对增量做分词,并处理「追加可能改变旧 token 边界」的修复问题。第二,正是因为我们讨论的这层代码对每次请求都做完整截断预算,max_input_tokens 附近的请求才会成为热点——大多数续轮请求的 都很大且接近上限。理解这两点,就能明白为什么 vLLM 把字符级上界检查放在分词之前:大量请求的 接近上限,字符级检查是成本最低的第一道门。
需要说明的是,TokTier 目前发表在 arXiv、尚未被主流推理框架默认合并,它描述的是一种路线而非 vLLM 当前实现;把它的工作负载数据拿来参照的意义在于,它说明了输入侧优化的收益空间有多大。
缓存与懒加载:一次分词能省下多少
lru_cache 包住的两个函数
get_tokenizer 与 resolve_tokenizer_args 都被 lru_cache 包过一遍。它们的结果对同一个 (模型, revision, mode, runner_type) 是稳定不变的,缓存命中意味着:
- 不会再次访问 Hub 判断 Mistral 仓库;
- 不会重复调用
AutoTokenizer.from_pretrained,避免重新读取几 MB 的tokenizer.json; - 不会重复构建
CachedTokenizer子类。
在一个多进程部署里,每个 API server 进程都会加载一次 tokenizer,但每个进程内的请求共享同一实例。这是 vLLM 的常规部署模型:tokenizer 是进程级单例,不是请求级对象。
CachedHfTokenizer 的收益量化
max_chars_per_token 的缓存收益可以粗略算一下:Transformers 的 get_vocab() 每次返回一个新的 dict 拷贝,一个 15 万词的词表在 Python 里每次拷贝都要重新分配几 MB 到十几 MB 的字典,耗时在毫秒量级;all_special_ids 与 __len__ 也类似。若每个请求访问一次 max_chars_per_token,在没有缓存的情况下服务吞吐会受 CPU 侧显著拖累。缓存之后,这些值在 tokenizer 加载时算一次,代价只有一次 遍历。
max_chars_per_token 本身的计算也值得注意:它遍历整个词表求最长 token 的字符数。对一个混合了英文 BPE 与中文字符的 tokenizer,最长 token 往往是少数「粘贴了大量字符」的特殊 token,所以这个值有时会偏大。偏大的上界只会让字符级截断更保守(留下更长的文本交给分词),不会造成正确性问题。
分词与字符长度的关系:不是线性的
字符级上界不等式只用了词表里最长 token 作为系数,但真实的分词比例取决于文本内容。英文自然语言的约 4 个字符对应一个 token(常见 BPE 词表下),中文则在约 1 到 1.5 个汉字一个 token,代码由于符号多、长标识符少,往往更接近 3 个字符一个 token。这意味着 通常远大于平均比例(例如 而英文平均约 4), 对常规文本的估计偏保守约三倍。
保守的上界有个直接后果:字符级预截断不会截掉太多不该截的内容,但它也不会真正把文本压到接近 的真实长度。因此字符级截断之后仍然需要 token 级截断,两层截断的职责不同:字符级保证「不会因为分词本身吃光资源而崩」,token 级保证「语义上的预算不超」。如果只有字符级,截到 字符的英文文本按 4 字符/token 估算可能仍有约 个 token,远超预算,最终仍要由 token 级截断砍掉大部分;反过来,对平均 token 很长的文本, 个字符又可能不到 个 token,字符级截得不够狠。两层截断缺一不可。
截断方向对缓存命中的影响
truncation_side 的选择除了语义,还影响前缀缓存的命中率。生成请求默认左截断保留尾部:多轮对话里最新的几轮内容在尾部,保留它们让模型看到最近的上下文;前缀缓存按 token 序列前缀匹配,左截断意味着每轮截断后的序列开头都不同,前缀命中率很低。池化请求默认右截断保留头部,前缀是稳定的文档开头,命中率高。
这是一个真实存在的权衡:左截断更符合对话语义,但牺牲缓存;右截断更省算力,但可能丢掉最新的指令。对需要高吞吐的批处理场景,显式设置右截断并组织文档让头部包含关键上下文,能显著提高前缀复用;对交互式对话,左截断几乎总是更合适。vLLM 把这个选择交给用户与 runner_type 的默认值,而不是写死。
max_num_batched_tokens 与输入侧的关系
调度器的 max_num_batched_tokens 控制每步调度的 token 预算,它作用于已经进入引擎的请求。输入侧截断决定了单条请求最大能贡献多少 token:如果 max_model_len 是 128k 而 max_num_batched_tokens 是 8192,那么一条 128k 的请求在开启分块预填充时会以 8192 token 为一块,被拆成 16 个调度步。输入侧的长度校验与调度器的分块是两套不同的机制:前者决定请求是否合法,后者决定合法请求如何被拆开执行。理解这一点,才能明白为什么 truncate_prompt_tokens 不能设置为「反正调度器会分块」——分块解决的是显存与步骤粒度,不解决请求超长被拒绝的问题。
与系列中其他框架的横向对照
vLLM 的输入侧有几个值得对照的设计点:
- Hugging Face tokenizers 的原生支持:llama.cpp 的词表解析是自己实现的
llama_vocab,它把 SPM、BPE、字节级回退统一到一套编解码接口(见 llama.cpp 源码完全拆解(二十):分词器与词表)。这一路线的优势是零 Python 依赖、权重文件里直接带词表;代价是需要自己处理所有特殊 token 与后处理规则。vLLM 则复用 HF 的 tokenizer 生态,把「词表格式差异」交给 Transformers 与 tokenizer mode 解决。 - 增量解码的位置:vLLM 把 detokenizer 放在输出侧、前端进程,并且使用「prefix/read offset」机制减少重复解码(见 vLLM 源码完全拆解(十五):停止条件与增量解码)。输入侧的文本截断与输出侧的增量解码共享同一个关键约束:token 与字符之间不是简单的一对一关系,任何在文本层面的操作都必须同步维护偏移。
- 多模态占位符与 token 预算:vLLM 的渲染阶段只负责「占位符对齐」,实际展开在
process_for_engine与多模态处理器中;TensorRT-LLM 与 SGLang 也都采用「文本模板 + 占位符展开」的方案,区别在于占位符展开后如何与调度器的 token 预算交互。 - 线程模型:SGLang 的
TokenizerManager运行在独立于调度器的 tokenizer 进程里(见 SGLang 源码完全拆解(二):入口、分词与流式输出如何闭环);vLLM 的选择是同一 API 进程内用线程池 offload,部署更简单,但需要自己处理线程安全与卡死线程。
真实故障形态:输入侧出问题时,你看到的是什么
前面各节说的机制,最好对照几种线上常见的现象,才能知道查哪里。
现象一:请求被 400 拒绝,但用户认为文本不长。 错误信息里的 token 数远大于用户按字数估算的预期。常见原因有:system prompt 被模板重复渲染(例如 template 里既有 messages[0] 又有手写的 system 前缀);工具定义的 JSON Schema 也被模板完整写进了 prompt,用户只看文本没看工具;或者图片展开了几百个 token。排查顺序是:打印渲染后的文本长度、看 prompt_token_ids 的实际长度、对照 max_total_tokens。
现象二:请求成功,但模型「没看到最开始几段」。 这是左截断的典型后果。生成请求默认保留尾部,长会话的开头被静默截断。EngineCoreRequest 里只有 token ID,前端日志若不打印截断信息,用户就无从得知。部署时应把 truncate_prompt_tokens 的使用与计数记录到指标里,让截断成为可见事件。
现象三:模型输出突然变成无意义的重复。 可能是 BOS 被补了两次,或者模板里的特殊 token 被当成普通文本词表项处理。前者检查 add_special_tokens 的取值与模板是否自带 BOS;后者检查模板与 tokenizer 是否匹配——例如用了别的模型家族的 chat template,模板里的 <|im_start|> 在这个 tokenizer 里可能被切成普通字符。
现象四:服务在某个请求之后整体变慢,甚至卡住。 最可能是模板渲染卡死在一个线程里,后续请求排队。VLLM_CHAT_TEMPLATE_RENDER_TIMEOUT 与 _SwappableExecutor 针对的正是这一现象。
现象五:多模态请求偶发失败。 报错是「截断会切开图像」。这时要么提高 truncate_prompt_tokens,要么减少图片数量,而不是关掉截断——关掉截断之后请求可能在更后面的模型输入校验里失败,错误信息更远离原因。
这些问题有一个共同的排查方法:在前端打印三样东西——渲染后的文本长度(字符)、分词后的 token 数、截断后的 token 数。三者的差异能直接区分是模板、分词还是截断环节的问题。vLLM 的 Metrics 管线(见 vLLM 源码完全拆解(二十六):Metrics 与统计管线)报告的是 engine 侧指标,输入侧的这三项指标需要在 API 层自行补充。
一次聊天请求的完整时序账
把前面各段串成一条可复现的路径,用一个具体例子走一遍:
- 协议层:HTTP 请求体里有
messages、model、max_tokens=512、temperature。API server 把max_tokens与模型max_model_len一起交给InputProcessor。 - 模板渲染(
HfRenderer.render_messages):解析消息为ConversationMessage,提取多模态数据,调用safe_apply_chat_template。如果模板拒绝请求(例如reasoning_effort的取值不被模板支持),这里抛出VLLMValidationError,最终映射为 HTTP 400。 - 构造 TokenizeParams:
max_total_tokens = max_model_len,max_output_tokens = 512,所以max_input_tokens = max_model_len,max_truncation_tokens = max_model_len - 1。如果用户传了truncate_prompt_tokens,会与max_input_tokens比较,超出直接报错。 - 字符级预检查:渲染后的文本若超过
max_input_tokens × max_chars_per_token个字符,无截断时立即报错,有显式截断方向时先截一刀。 - 分词:
tokenizer(text, truncation=..., max_length=...)。若max_length是max_input_tokens + 1,超长文本被压到上限加一。 - token 级校验:按截断 → 补齐 → 长度检查的顺序执行。长度检查在
max_input_tokens与max_truncation_tokens的口径差异下给出正确判断。 - 参数补全:
sampling_params.max_tokens若未设置,使用max_model_len - prompt_len;若显式设置超出,会在输出侧被钳住或在get_max_tokens中处理。update_from_generation_config与update_from_tokenizer把模型自带的 EOS 与停止 token 合入采样参数。 - 多模态展开与二次截断:如果带图,占位符被展开,重新检查截断切片是否切图。
- 组装
EngineCoreRequest:InputProcessor.process_inputs把 prompt token、采样参数、多模态特征、LoRA 请求等聚成一个对象,经 ZMQ 发往EngineCore。
这条时序里,第 4、5、6 步是三个不同层次的「预算」,它们各自解决不同的问题:
| 层次 | 对象 | 目的 | 失败方式 |
|---|---|---|---|
| 字符级 | 文本长度 vs | 阻止最坏情况消耗大量 CPU/内存 | 直接 400,或按方向预切 |
| tokenizer 级 | tokenizer 的 max_length | 限制分词器内部的工作量与输出长度 | 被 tokenizer 静默截断 |
| token 级 | 最终 token 列表 | 保证语义正确(不切多模态、不丢全部 prompt) | 明确报错,或按方向截断 |
三层都在,但它们的错误信息与处理方式不同。实现里最怕的不是「没有检查」,而是「某一层做了检查但没告诉用户」——tokenizer 级的静默截断就是这样一个位置,vLLM 用 +1 技巧把它变成了可检测的错误。
工程视角:这层代码为什么容易出问题
字符与 token 的双重坐标系
输入侧所有偏移、长度、截断都涉及两套坐标系:字符与 token。大多数 bug 出现在两套坐标系之间的转换上:
- 字符级截断改了文本,token 偏移必须同步平移;
- token 级截断改了序列,并行的偏移数组必须同步切片;
- 多模态展开改了序列长度,占位符的
offset必须随之平移; _text_len_check在小写化之前执行,而do_lower_case会改变字符数(某些 Unicode 字符小写后长度不同),所以同一段文本经过_text_lowercase后长度可能变化,偏移的假设要在这个前提下成立。
最后一点在源码里有一个隐式的顺序保证:_validate_text 依次执行 _text_len_check 与 _text_lowercase。如果小写化让文本变长(例如土耳其语中某些字符的规则),偏移仍以原始文本为准,这是因为小写化发生在分词之前,分词本身是在小写后的文本上执行,偏移自然对应小写后的文本——但是 _apply_prompt_char_offset 只补了 left 截断的偏移,没有补小写化造成的偏移,这一点在通用文本上没有问题,在特殊语言上值得留意。
多进程下的 tokenizer 一致性
vLLM 支持数据并行与张量并行,但 tokenizer 并不在每条 engine 进程里,而是位于前端(API server)进程;engine 只接收 token ID。多前端部署时,每个前端进程都会独立加载一份 tokenizer,因此必须保证它们完全相同:同样的 mode 解析结果、同样的特殊 token、同样的 max_chars_per_token。resolve_tokenizer_args 的 lru_cache 只在进程内生效,跨进程的一致性依赖的是 Hub 快照路径的规范化(get_non_weight_snapshot_path)与 HF 缓存本身——同一个 revision 会解析到同一份本地文件。如果不同前端用了不同的 tokenizer_mode(例如有人手改了某个进程的参数),同一段文本就会得到不同的 token 序列,前缀缓存的命中率骤降,因为前缀块无法重合。这也是为什么 tokenizer_mode 属于 ModelConfig 的一部分,而不是可以在运行时单独修改的变量。
部署建议
从这层代码可以直接推出几条部署实践:
- 不要手动指定
tokenizer_mode=slow。慢 tokenizer 在 Python 里逐字符处理,吞吐会下降一到两个数量级,源码会在日志里给出明确 warning。 - 生产环境显式设置模板渲染超时。默认 30 秒的意图是防止一个请求卡死服务,但如果有用户提交超长 system prompt 导致模板渲染接近这个时间,可以调大;反过来,如果模板本身有性能问题,调小能让故障更早暴露。
- 多模态服务不要用
renderer_num_workers > 1搭配池化缓存。源码在ModelConfig校验里明确禁止:池化模型的mm_processor_cache不是线程安全的,多 worker 会并发操作同一个缓存,因此要求renderer_num_workers = 1或关闭缓存。 - 截断方向要显式指定。依赖 tokenizer 的默认截断侧会在更换 tokenizer 版本时悄悄改变行为,显式
truncation_side可以让行为稳定。
小结
vLLM 的输入侧并不是简单的「调用 tokenizer」,而是由三个组件按明确边界协作:
TokenizerRegistry把「模型家族与词表格式」的差异收敛到一张 mode → 类的映射上;CachedHfTokenizer把重复计算的属性固化为实例值,其中的max_chars_per_token支撑了字符级上界检查;Renderer把「模板渲染」与「分词」拆成两个阶段,默认TokenizeParams根据补全与聊天请求的语义差异设置add_special_tokens,并根据多模态处理器对齐;TokenizeParams用三个相互约束的预算数字(max_input_tokens、max_truncation_tokens、max_input_chars)定义了截断与校验的口径,并用+1的技巧把 tokenizer 的静默截断转化为可检测的错误。
异步前端的分词 offload 与 tokenizer 线程池是两个相互独立的工程决定:前者保证事件循环不被阻塞,后者保证多线程分词不产生竞态。_SwappableExecutor 在模板卡死时整池替换,是「CPython 无法中断线程」这一约束的直接体现;而 maybe_make_thread_pool 用 deepcopy 池替代锁,是「分词是 CPU 密集操作,串行化会毁掉吞吐」这一事实的直接体现。理解了这两个约束,就能理解这一层的所有设计。
下一篇继续沿输入侧向外延伸,讨论渲染器与多模态处理器之间的边界:图像的占位符在渲染阶段如何被识别、在展开阶段如何与 token 预算对齐,以及 prefix caching 如何利用这套偏移信息判断前缀是否可复用。
参考资料
- vLLM 源码:
vllm/tokenizers/registry.py - vLLM 源码:
vllm/tokenizers/hf.py - vLLM 源码:
vllm/renderers/base.py - vLLM 源码:
vllm/renderers/params.py - vLLM 源码:
vllm/renderers/hf.py - vLLM 源码:
vllm/v1/engine/input_processor.py - vLLM 官方文档:Architecture Overview
- Hugging Face Blog:Tokenizers
- Hugging Face 文档:Tokenizers Pipeline
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention (SOSP 2023)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



