


vLLM 源码完全拆解(二十四):池化模型——嵌入、重排与分类如何借用 LLM 推理的引擎
一个不生成 token 的模型,为什么也要挤进生成引擎
vLLM 的名字、文档和绝大多数源码路径都围绕「生成」展开:请求进来,调度器排批,模型前向,采样器吐 token,detokenizer 流式回传。但在同一条 GPU 前向路径上,还有一类模型只做前半段——把一段文本编码成隐藏状态,然后在这段隐藏状态上取一个向量、一组分类 logits,或者每个 token 一个向量,然后结束。它们不采样、不解码、不追加 token,一次请求只跑一次 prefill。
这类模型在 vLLM 里叫池化模型(pooling model)。嵌入模型(embedding)、重排模型(reranker)、分类模型(classifier)、奖励模型(reward model)、稀疏检索模型(SPLADE、BGE-M3 的稀疏头)都属于这一类。它们的共同点是:输出不是「下一个 token」,而是对整段输入的某种压缩表示。注意力仍然要算,KV 仍然要写进分页块,MoE 路由、张量并行、CUDA Graph 这些基础设施一样要用;区别只在于前向结束之后走哪条尾巴。
vLLM 官方文档对这件事的定位说得很直白:支持池化模型主要是为了「方便」,并不保证比直接用 Hugging Face Transformers 或 Sentence Transformers 更快,后续才会针对池化模型做优化。这句话很重要,它解释了为什么池化路径在源码里看起来像「生成路径的一个分支」而不是一个独立引擎:vLLM 先复用了已有的调度、KV、并行与 kernel 基础设施,再在输出端加了一层适配。
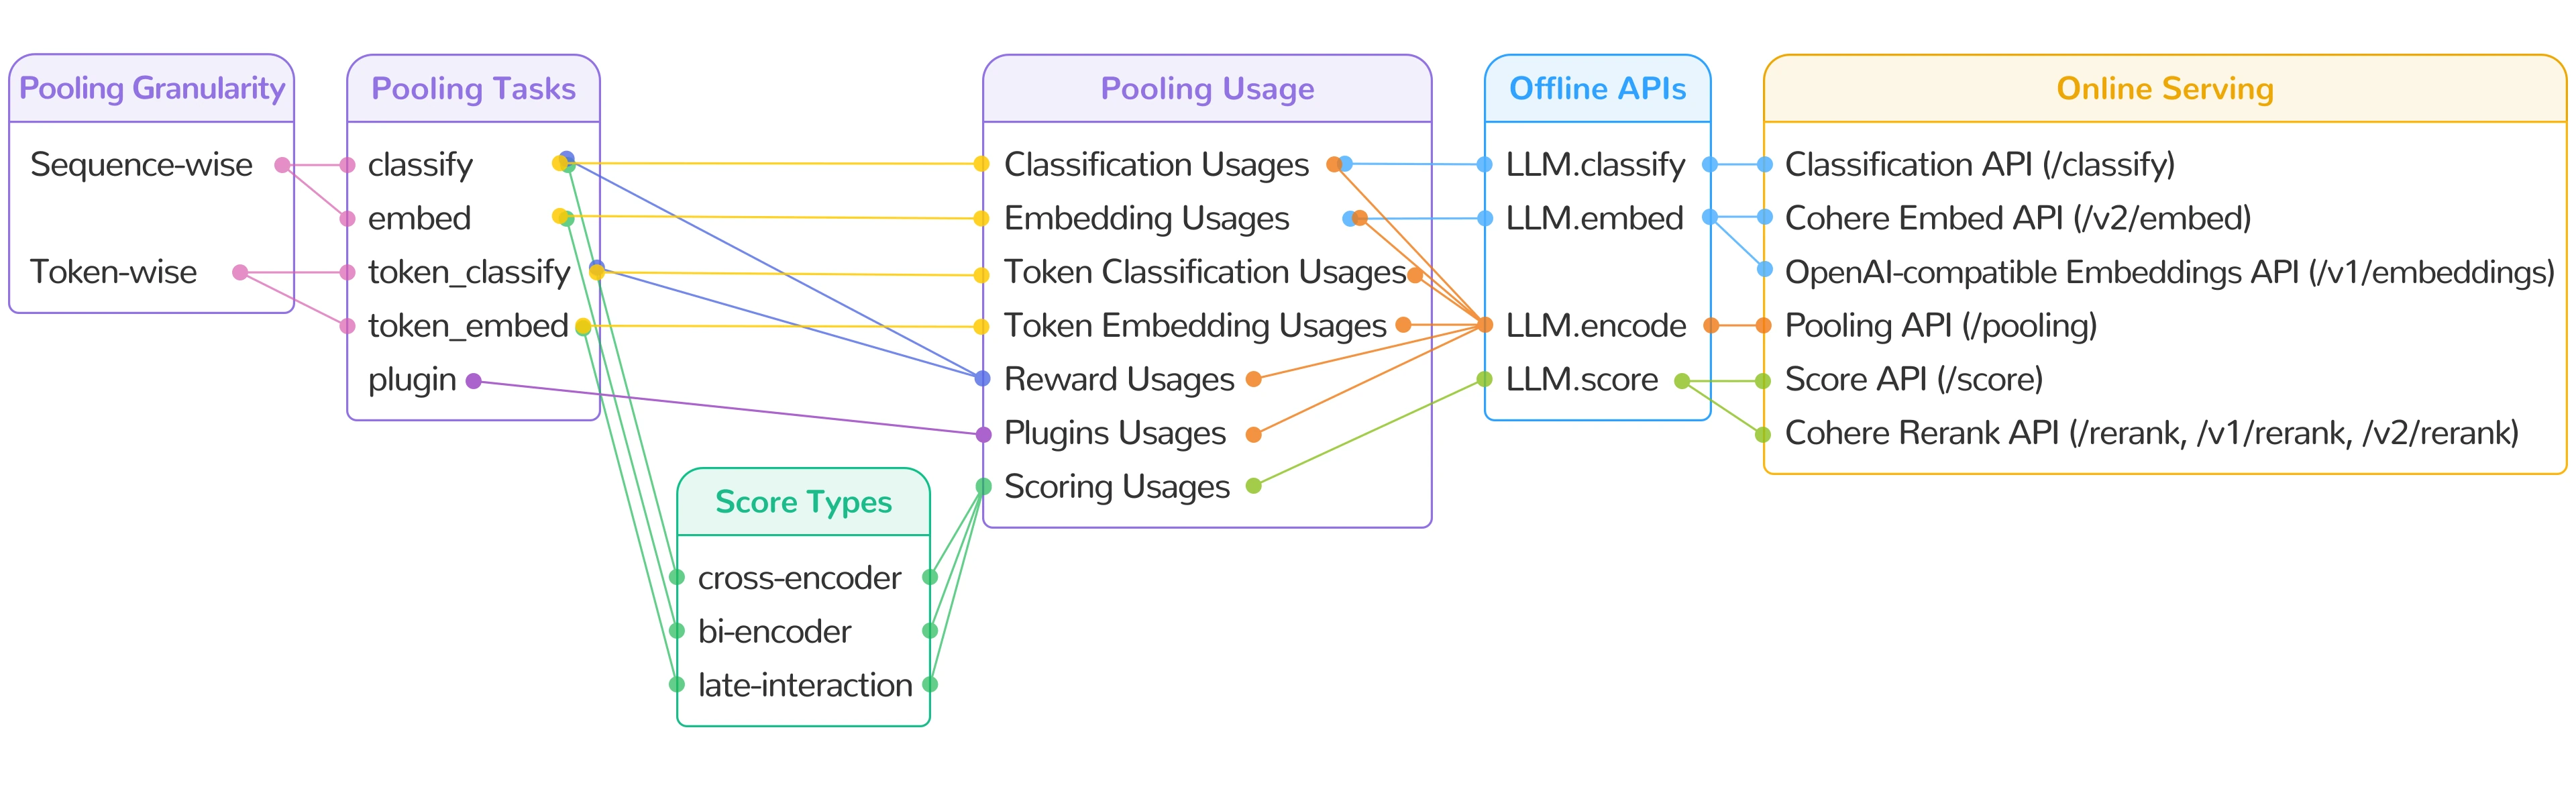
(图源:vLLM 官方文档 Pooling Models,docs/models/pooling_models/)
这篇文章只讨论推理侧:一个池化请求如何被识别、如何进入调度器、如何在 GPU 前向上被切出「每个序列的槽位」、池化层如何把隐藏状态压成输出,以及分类、嵌入、重排三条打分路线在源码里如何分叉。训练、微调、对比学习损失都不在范围内。
runner_type:模型加载时就已经分好的岔路
池化模型和生成模型共用 ModelConfig、共用 GPUModelRunner、共用调度器,但在模型配置解析阶段,vLLM 就给每个模型定了一个 runner_type。这个字段决定了后面一系列行为:请求要不要采样、调度器要不要为采样 token 预留上下文位置、输出走 logits 还是走 pooler、LLM.encode() 能不能用。
vllm/config/model.py 里解析逻辑大致是:
runner_type = self._get_runner_type(architectures, self.runner, self.convert)--runner auto 时,默认类型由 _get_default_runner_type 决定。它的判断顺序值得逐条看:
# Some Sentence Transformers models use *ForCausalLM archsif get_pooling_config(self.model, self.revision): return "pooling"
for arch in architectures: if arch in registry.get_supported_archs(): if registry.is_pooling_model(architectures, self): return "pooling" if registry.is_text_generation_model(architectures, self): return "generate"
match = try_match_architecture_defaults(arch) if match: _, (runner_type, _) = match return runner_type
return "generate"第一行的注释点出了一个历史包袱:一些 Sentence Transformers 模型沿用了 *ForCausalLM 的架构名,但它们的用途是嵌入,不是生成。只要模型仓库里带有池化配置(get_pooling_config 读取模型目录里的 config_sentence_transformers.json 一类信息),就直接判为 pooling。这条规则优先于架构名,避免把嵌入模型误判成生成模型。
接下来按注册表判断:模型类被标记为池化模型就走 pooling,能生成就走 generate。再往后是架构名的默认映射,最后兜底为 generate。这个顺序说明 runner_type 不是从「模型能不能生成」推出来的,而是从「模型声明自己是什么」推出来的。一个 BERT 既可以只输出隐藏状态,也可以在顶部接一个 masked LM 头,vLLM 判断的是注册的模型类有没有 is_pooling_model 标记。
显式指定 --runner 时直接采用;指定 --convert 时则隐含走池化,因为 convert 的语义就是「把生成模型改造成池化模型」。配置解析还会做反向校验:
if (is_pooling_model and not is_generative_model and self.runner_type in ("draft", "generate")): raise ValueError( f"Embedding models do not support `--runner {self.runner_type}`. " "Use `--runner pooling` or `--runner auto` for embedding models.")以及当 runner_type == "pooling" 但模型本身不支持池化时,要求显式给出可用的 --convert 选项。这两条校验把「模型能力」和「运行模式」绑定起来,避免用户把嵌入模型当生成模型跑出无意义的采样结果。
模型侧的标记很轻。vllm/model_executor/models/interfaces_base.py 里定义了一个 Protocol:
class VllmModelForPooling(VllmModel, Protocol): is_pooling_model: ClassVar[Literal[True]] = True pooler: Pooler """The pooler is only called on TP rank 0."""模型类只要设置 is_pooling_model = True 并挂一个 pooler 属性,就完成了声明。default_pooling_type 装饰器则给出这个模型的默认池化方式,例如 BERT 默认 CLS,GPT 类因果模型默认 LAST:
@default_pooling_type(seq_pooling_type="CLS")class BertModel(nn.Module, SupportsQuant): is_pooling_model = True这里的默认值不是随便定的。BERT 是双向注意力,第一个 token 的表示在预训练时就承担了「整句摘要」的角色;GPT 类模型是因果注意力,只有最后一个 token 能看到完整前缀,所以取最后一个位置的隐藏状态才合理。池化方式选错,向量语义就错了,后面再归一化、再算余弦相似度都救不回来。
五个池化任务与三种打分路线
池化的第一层抽象是「任务」,定义在 vllm/tasks.py:
PoolingTask = Literal[ "embed", "classify", "token_embed", "token_classify", "plugin", "embed&token_classify",]这六个名字对应两种粒度和两种输出语义,外加两个特殊形态:
| 任务 | 粒度 | 输出 | 典型模型 |
|---|---|---|---|
embed | 序列级 | 每条输入一个向量 | BERT、E5、GTE、BGE dense |
classify | 序列级 | 每条输入一组类别概率或分数 | 重排模型、分类模型、奖励模型 |
token_embed | token 级 | 每个 token 一个向量 | ColBERT 类多向量检索、BGE-M3 稀疏头 |
token_classify | token 级 | 每个 token 一组类别概率 | NER、token 级奖励模型 |
plugin | 自定义 | 由 IO Processor 决定 | 遥感、地理空间等专用模型 |
embed&token_classify | 混合 | dense 向量与稀疏权重拼接 | BGE-M3 |
「序列级」和「token 级」是理解后面所有代码的分水岭。序列级任务最终要把一条输入的所有 token 压成一个结果,token 级任务则保留每个 token 的结果,或者按 token id 筛选出一部分。两条路线在源码里对应两个不同的池化平面:seqwise 与 tokwise。
打分模型(scoring model)不是第六个任务,而是建立在已有任务上的用法。tasks.py 里有一张映射表:
ScoreType = Literal["bi-encoder", "cross-encoder", "late-interaction"]SCORE_TYPE_MAP: dict[PoolingTask, ScoreType] = { "embed": "bi-encoder", "classify": "cross-encoder", "token_embed": "late-interaction",}三种打分路线的区别不在池化层,而在「两个输入如何进入模型」以及「输出如何比较」:
- bi-encoder:两段文本分别编码成向量,再算余弦相似度。池化任务是
embed,模型只需要看一段文本。 - cross-encoder:两段文本拼成一条输入送进模型,模型直接输出一个相关性分数。池化任务是
classify,并且分类头只有 1 个 label。 - late-interaction:两段文本分别编码成「每个 token 一个向量」的矩阵,再用 MaxSim 逐 token 比较。池化任务是
token_embed。
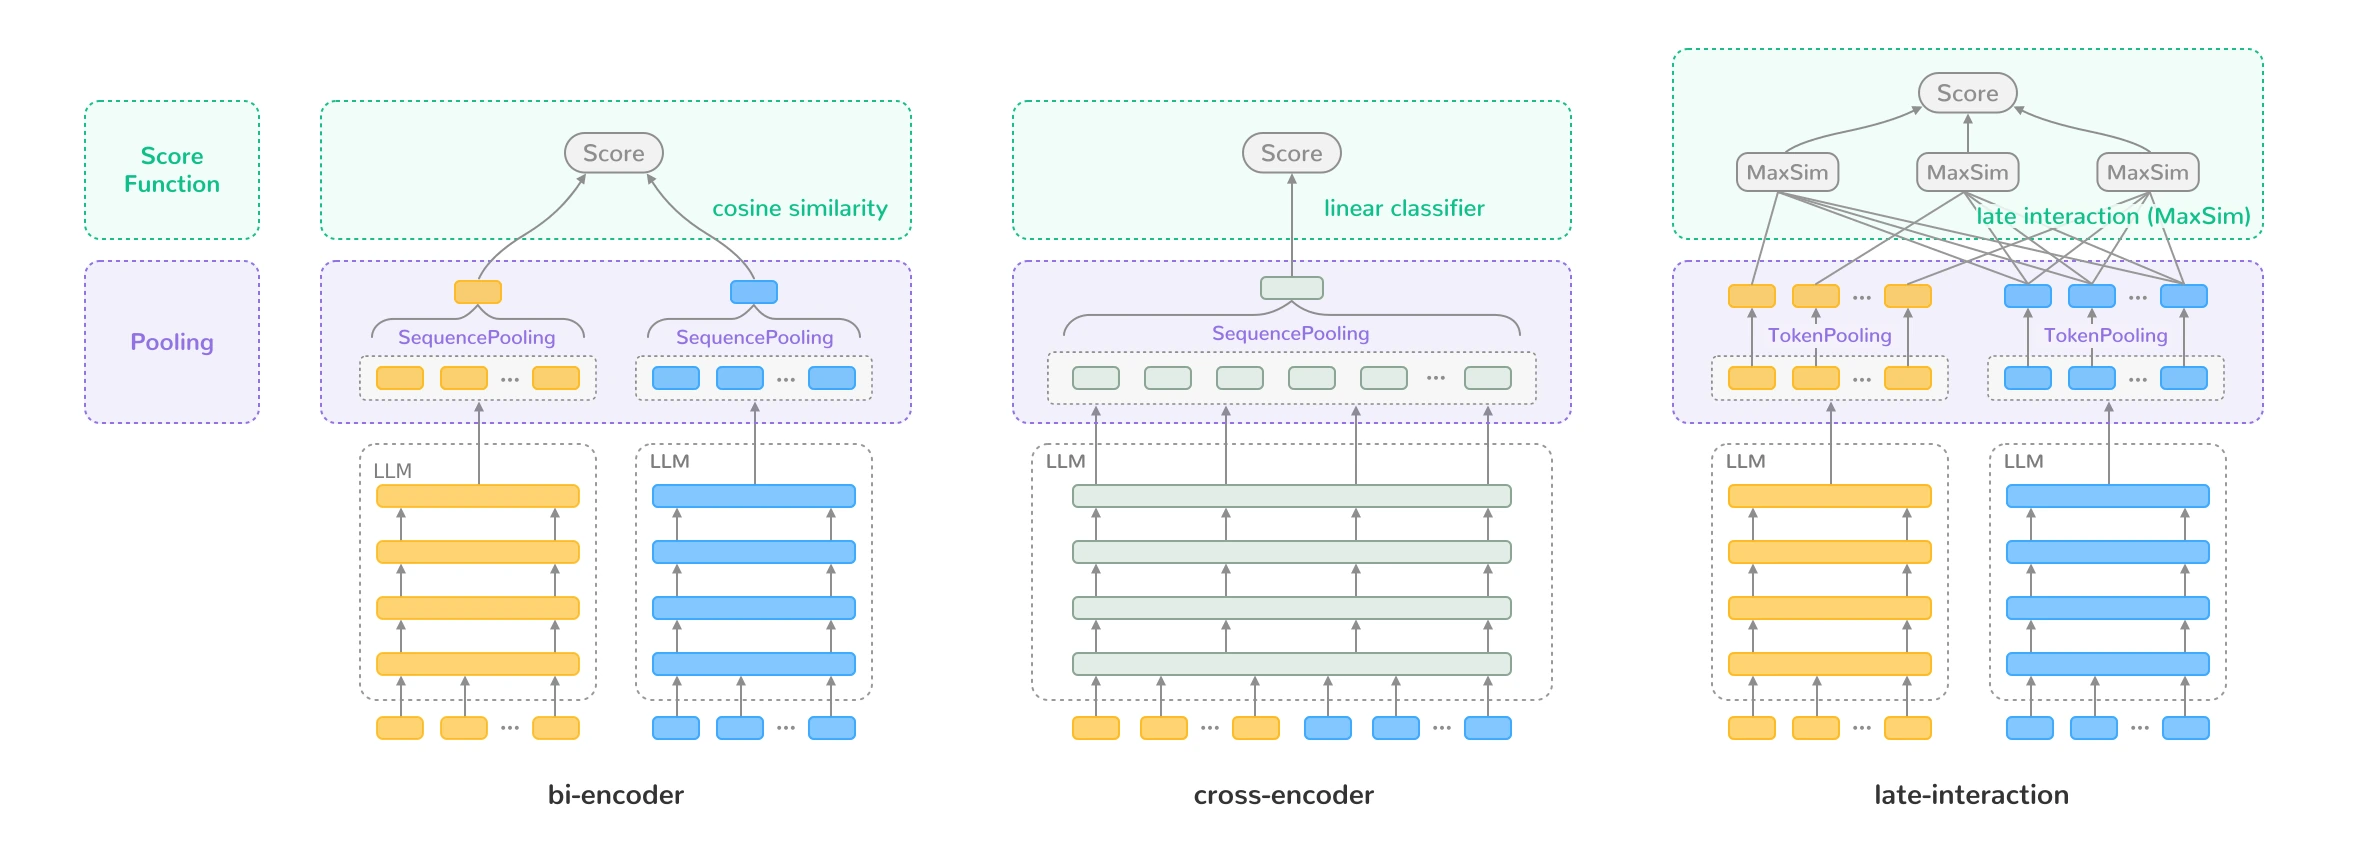
(图源:vLLM 官方文档 Pooling Models,docs/models/pooling_models/)
一个容易踩的细节是:当前 vLLM 主线的 PoolingTask 里已经没有 score 和 encode 这两个任务名了。check_removed_pooling_task 会在配置阶段直接报错,并提示 score 改用 classify、encode 改用 token_embed 或 token_classify。但用户侧的 LLM.score() 接口仍然存在,它根据模型的 score_type 自动选择底层任务。也就是说,「打分」是 API 层的概念,「池化任务」是引擎层的概念,两者不再一一对应。读源码时如果拿旧文档里的 task="score" 去对照,会找不到实现。
还有一个限制:只有分类模型输出 num_labels == 1 时,才能当作 cross-encoder 打分模型使用,其打分 API 才会被打开。多分类模型的 classify 输出是一组概率,语义上是「属于哪一类」,不是「两段文本有多相关」,vLLM 不会把它解释成相关性分数。
Pooler 的三个构件:方法、头与任务分发
池化层的抽象在 vllm/model_executor/layers/pooler/abstract.py,接口只有三个方法:
class Pooler(nn.Module, ABC): @abstractmethod def get_supported_tasks(self) -> Set[PoolingTask]: ...
def get_pooling_updates(self, task: PoolingTask) -> PoolingParamsUpdate: return PoolingParamsUpdate()
@abstractmethod def forward(self, hidden_states, pooling_metadata) -> PoolerOutput: ...get_supported_tasks 决定这个模型能接哪些 API;get_pooling_updates 是「按任务改写请求参数」的钩子,目前只做一件事——告诉引擎这个任务需不需要 CPU 侧的 prompt token ids;forward 拿到的是本步前向产生的隐藏状态,以及一个描述「这批请求怎么切」的元数据对象。
真正干活的是两个组合类。序列级叫 SequencePooler,由「池化方法 + 池化头」两段拼成:
class SequencePooler(Pooler): def __init__(self, pooling, head): self.pooling = pooling self.head = head
def forward(self, hidden_states, pooling_metadata): pooled_data = self.pooling(hidden_states, pooling_metadata) pooled_data = self.head(pooled_data, pooling_metadata) return pooled_datatoken 级叫 TokenPooler,结构相同,但头是可选的。方法负责「从隐藏状态里取出哪些行、如何聚合」,头负责「取出之后怎么投影、怎么归一化、怎么变成概率」。把这两件事拆开,是为了让同一套池化方法可以服务不同任务:CLS 方法既能接嵌入头,也能接分类头;同一个分类头既能接 CLS 方法,也能接 Mean 方法。
第三个构件是 DispatchPooler。一个模型往往同时支持多个任务,比如 BERT 既能做 embed 也能做 classify,BGE-M3 同时支持 embed 和 token_classify。分发器按任务把请求路由到对应的子池化器:
@classmethoddef for_embedding(cls, pooler_config): return cls({ "token_embed": pooler_for_token_embed(pooler_config), "embed": pooler_for_embed(pooler_config), })
@classmethoddef for_seq_cls(cls, pooler_config, *, pooling=None, classifier=None): return cls({ "token_classify": pooler_for_token_classify( pooler_config, classifier=classifier), "classify": pooler_for_classify( pooler_config, pooling=pooling, classifier=classifier), })分发器有两个执行路径。如果一批请求的任务完全相同(最常见的情况),直接走快路径,把整批隐藏状态交给一个子池化器。如果一批里混着不同任务,就按任务分组,每组切出自己那一段隐藏状态,再把游标索引平移到切片起点:
for task, group in groupby(pooling_metadata.tasks): pooler = poolers_by_task.get(task) num_items = len(list(group)) group_metadata = pooling_metadata[offset : offset + num_items] num_group_tokens = int(group_cursor.num_scheduled_tokens_cpu.sum()) group_hidden_states = hidden_states[token_offset : token_offset + num_group_tokens] ...这段代码解释了为什么 PoolingMetadata 必须支持切片:混任务批次里,每个子池化器只应该看到自己那几条请求的 token,但 SequencePooler 的方法又是直接按「第一个 token / 最后一个 token 的全局下标」去索引隐藏状态的。切片时如果不把 first_token_indices_gpu 和 last_token_indices_gpu 减去 token_offset,索引就会指到别的请求的数据上。代码里显式做了这个平移,并用 dataclasses.replace 生成新的游标和元数据,避免污染原对象。
分发器还承担一个隐含职责:让同一批里的任务分组顺序与请求顺序一致。groupby 只看相邻元素,所以上游必须保证 pooling_metadata.tasks 是按请求顺序排列的;PoolingMetadata.__post_init__ 会从 pooling_params 里逐个取 task,顺序天然一致。
五种池化方法:取哪一行,怎么平均
序列级方法只有三种:CLS、LAST、MEAN。token 级方法有两种:ALL、STEP。官方文档里有一张图把五种方式画在一起:
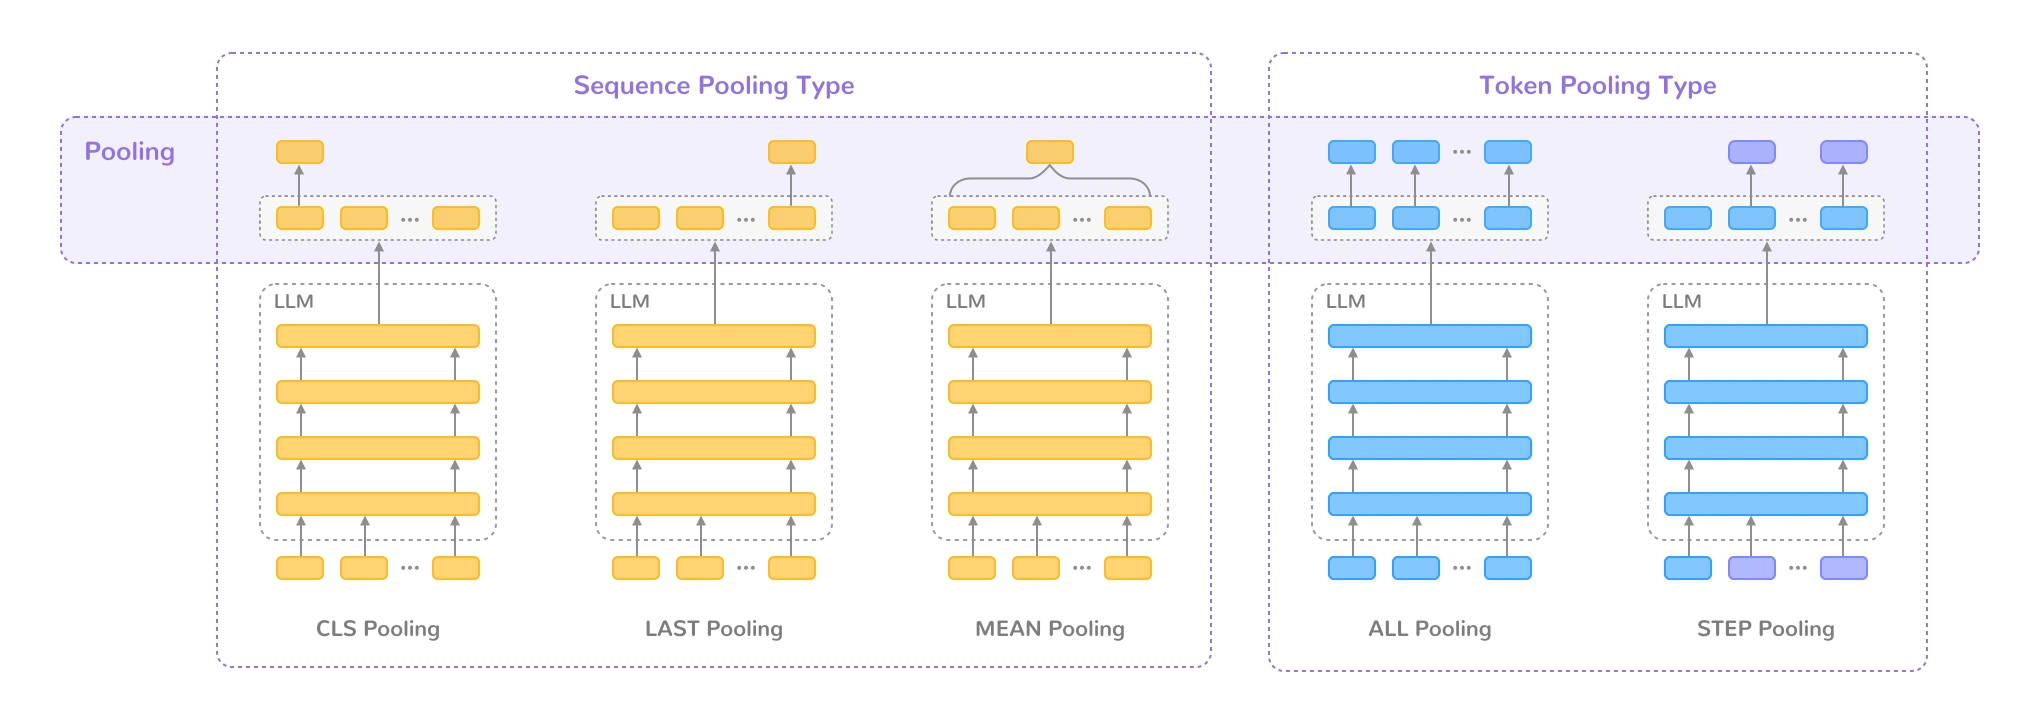
(图源:vLLM 官方文档 Pooling Models,docs/models/pooling_models/)
CLS 与 LAST:一次索引
CLSPool 的实现只有一行有效代码:
class CLSPool(SequencePoolingMethod): def forward(self, hidden_states, pooling_metadata): pooling_cursor = pooling_metadata.get_pooling_cursor() if pooling_cursor.is_partial_prefill(): raise RuntimeError("partial prefill is not supported with CLS pooling") return hidden_states[pooling_cursor.first_token_indices_gpu]first_token_indices_gpu 是本批里每条序列第一个 token 在扁平隐藏状态里的行号。LastPool 对称,取 last_token_indices_gpu。两者的差别只在下标,但语义差别很大:CLS 位置是预训练时专门用来承载句子表示的槽位,LAST 位置是因果模型唯一能看到完整前缀的位置。
CLSPool 对分块预填充直接报错,原因藏在 PoolingCursor 的构造里:当一条请求只调度了一部分 prompt token 时,first_token_indices_gpu 指向的是「本块的第一个 token」,不一定是整条序列的第 0 个 token。如果这一块不是第一块,取到的就不是 [CLS]。LastPool 没有这个检查,看起来更宽松,但它取到的也是「本块最后一个 token」,对未完成的请求同样是错的;区别在于 _pool 之后会用 finished_mask 把未完成请求的输出丢掉,所以 LAST 在分块预填充下能跑,只是中间块的结果不会被返回。
MEAN:分块累加,避免一次性大张量
MeanPool 麻烦得多。它要对每条序列的所有 token 求平均,而一批请求的隐藏状态是扁平的 [总 token 数, hidden],没有 batch 维。实现用 repeat_interleave 造出 segment id,再用 index_add_ 按段累加:
segment_ids = torch.repeat_interleave( torch.arange(num_seqs, device=hidden_states.device, dtype=torch.long), prompt_lens, output_size=int(prompt_lens_cpu.sum()),)segment_sums = torch.zeros((num_seqs, hidden_size), dtype=torch.float32, device=hidden_states.device)
bytes_per_token = hidden_size * torch.finfo(torch.float32).bits // 8chunk_size = max(1, _MEAN_POOL_ACCUMULATION_CHUNK_BYTES // bytes_per_token)
for start in range(0, hidden_states.shape[0], chunk_size): end = min(start + chunk_size, hidden_states.shape[0]) segment_sums.index_add_(0, segment_ids[start:end], hidden_states[start:end].to(dtype=torch.float32))
return segment_sums / prompt_lens.unsqueeze(1)三个细节值得展开。
第一,累加用 FP32。BF16 的隐藏状态在每个元素上只有 8 位有效尾数,直接把几千个 token 的 BF16 值相加,误差会随 token 数累积。池化输出要拿去做余弦相似度或分类,误差会直接改变排序。把每个元素先转 FP32 再累加,是这类 reduction 的标准做法。
第二,累加按 16 MiB 分块。_MEAN_POOL_ACCUMULATION_CHUNK_BYTES 是 16 MB,按 hidden_size * 4 换算出每块能放多少个 token。这样做的目的不是省显存——累加结果本身只有 [batch, hidden]——而是控制 hidden_states[start:end].to(float32) 产生的临时张量大小。一次把几十万 token 的 BF16 转成 FP32,临时缓冲区会瞬间多出几百 MB,在长上下文嵌入场景里足以把显存顶爆。分块之后,临时缓冲区被限制在 16 MB 量级,代价是多几次 index_add_ 调用。
第三,prompt_lens 用的是整条 prompt 的长度,不是本步调度的 token 数。这也是 MeanPool 拒绝 partial prefill 的原因:如果只调度了一半 token,分母仍然是完整长度,平均值会偏小。同理,num_seqs == 0 时直接返回空张量,避免对空 batch 做除法。
ALL 与 STEP:token 级的两条路
token 级方法在另一个文件里。AllPool 的核心是按 num_scheduled_tokens_cpu 把扁平隐藏状态切成每序列一段:
hidden_states_lst = list( torch.split(hidden_states, pooling_cursor.num_scheduled_tokens_cpu.tolist()))这里用 CPU 侧的 num_scheduled_tokens_cpu.tolist() 而不是 GPU 张量,是为了避免一次 device-to-host 同步。切分之后,如果模型需要在输出宽度上做截断(output_sizes_fn),再对每段做列切片。
AllPool 还要处理分块预填充:一条长序列可能跨多个 step 才能算完,token 级输出不能在中间块就返回。它把每块的隐藏状态追加到 pooling_states.hidden_states_cache,等 finished_mask 为真时再把所有块拼起来:
for p, hs_chunk, finished in zip(pooling_states, hidden_states_lst, finished_mask): needs_owned_storage = not finished or ( self.clone_finished and not p.hidden_states_cache) p.hidden_states_cache.append( hs_chunk.clone() if needs_owned_storage else hs_chunk)clone_finished 与异步调度有关:开启 async scheduling 后,下一步前向可能在输出还没拷回 CPU 时就复用隐藏状态缓冲区,所以已完成请求的输出必须持有自己的存储。这个细节说明池化路径并不是「前向完就完事」,它也要遵守异步调度的生命周期约束。
StepPool 继承 AllPool,多了一步筛选:先按 returned_token_ids 取列,再按 step_tag_id 取行。它通过 get_pooling_updates 声明 requires_token_ids=True,让引擎在 CPU 侧保留 prompt token ids,筛选时不需要把 GPU 上的 token id 拷回来:
def get_pooling_updates(self, task): return PoolingParamsUpdate(requires_token_ids=True)这类「用 CPU 副本换一次同步」的取舍在池化路径里反复出现。嵌入、分类的输出本来就要拷回 CPU,但 token id 的筛选如果发生在 GPU 上,就得先把 step_tag_id 传下去、再在 GPU 上做比较、再把结果拷回来;不如一开始就留一份 CPU 副本,在 CPU 上算出索引,再一次 async_tensor_h2d 传上去。
池化头:取出来的向量还要再加工
方法只负责「取行」,头负责「加工」。序列级嵌入头 EmbeddingPoolerHead 做了五件事,顺序不能乱:
class EmbeddingPoolerHead(SequencePoolerHead): def forward(self, pooled_data, pooling_metadata): pooling_params = pooling_metadata.pooling_params if isinstance(pooled_data, list): pooled_data = torch.stack(pooled_data) if self.head_dtype is not None: pooled_data = pooled_data.to(self.head_dtype)
if self.projector is not None: embeddings = self.projector(pooled_data) else: embeddings = pooled_data
dimensions_list = [p.dimensions for p in pooling_params] if any(d is not None for d in dimensions_list): ... embeddings = embeddings[..., :d]
if self.activation is not None: flags = [p.use_activation for p in pooling_params] ... embeddings = self.activation(embeddings)
return embeddings第一,把 list 形式的池化结果堆成矩阵。SequencePooler 的方法通常返回 [batch, hidden] 张量,但某些自定义方法会返回 list,统一堆叠之后头才能做批量矩阵乘。
第二,切到 head_dtype。这一步和模型的注意力、MLP 精度可以不同:主干可能用 BF16 跑,池化头却希望用 FP32 做投影,避免低精度下的归一化误差。head_dtype 来自模型配置,不由请求决定。
第三,过 projector。标准 Sentence Transformers 模型在池化之后往往还有一个 Dense 层(可能带激活),vLLM 把它加载成 projector,作用在池化结果上。BERT 自己的 pooler 就是一个典型:BertPooler 把 dense(hidden_size, hidden_size) 加 Tanh 包成 projector:
self.head = EmbeddingPoolerHead( head_dtype=head_dtype, projector=lambda x: self.act_fn(self.dense(x)),)这里用 lambda 而不是直接传 nn.Sequential,注释写得很清楚:避免 self.head 下过早注册参数,权重加载时按 pooler.dense.* 的原始名字映射。这个细节说明池化头不仅要算得对,还要和 checkpoint 的参数命名对齐。
第四,Matryoshka 截断。PoolingParams.dimensions 允许请求方指定输出维度,头把向量截到前 维。这依赖 Matryoshka Representation Learning(MRL):训练时让前 维本身就是一个可用的低维表示,所以截断不是随便砍掉尾部,而是取一个被训练过的前缀。截断发生在归一化之前,否则截断后的向量就不再是单位向量。代码里对不同请求的 dimensions 做了分组:如果整批维度相同就一次切片,不同就逐条切片。
第五,归一化。pooler_for_embed 构造 EmbeddingPoolerHead 时固定传入 activation=PoolerNormalize(),也就是 L2 归一化:
def pooler_for_embed(pooler_config): pooling = get_seq_pooling_method(pooler_config.get_seq_pooling_type()) ... head = EmbeddingPoolerHead( head_dtype=model_config.head_dtype, projector=_load_st_projector(model_config), activation=PoolerNormalize(), ) return SequencePooler(pooling=pooling, head=head)但归一化是否执行由每条请求的 use_activation 决定。PoolingParams.use_activation=None 表示用池化器默认值,而 PoolingNormalize 的默认是执行。只有请求显式设成 False 才会跳过。这个开关的存在是因为有些下游系统希望拿到未归一化的向量自己做相似度计算,或者需要保留模长信息。
分类头 ClassifierPoolerHead 的结构对称,但多了一个可选的 classifier(通常是一个 Linear(hidden, num_labels))和一对校准参数:
if self.classifier is not None: logits = self.classifier(pooled_data)else: logits = pooled_data
if self.logit_mean is not None: logits = logits - self.logit_meanif self.logit_sigma is not None: logits = logits / self.logit_sigmalogit_mean 与 logit_sigma 实现的是 Platt scaling 形式的仿射校准:先减均值、再除标准差,最后过激活函数。重排模型的原始分数往往是任意实数,不同模型之间不可比;校准之后映射到概率尺度,才能设定统一的阈值。这两个参数来自 PoolerConfig,在模型配置里给出,不随请求变化。
最后的激活函数由 resolve_classifier_act_fn 决定。它先看 Hugging Face 配置里的 problem_type:
regression→ 恒等映射,输出原始分数;single_label_classification→ softmax;multi_label_classification→ sigmoid。
如果 problem_type 没给出,再看 Sentence Transformers 配置里的 activation_fn 或 sbert_ce_default_activation_function。这里有一条安全限制:只允许加载 torch.nn.modules. 前缀下的激活函数,防止模型配置里写一个任意可调用对象,在加载时执行代码。找不到配置时兜底为 PoolerClassify:num_labels < 2 用 sigmoid,否则用 softmax。
sigmoid 与 softmax 的选择不是风格问题。单标签分类的各类别互斥,softmax 归一化到和为 1;多标签分类的每个标签独立,sigmoid 逐项压缩到 ;回归输出不应该被压缩,否则分数的大小关系还在,但数值含义被破坏。重排模型通常只有 1 个 label,所以走 sigmoid,输出一个 的相关性分数。
token 级的头在结构上类似,但每个请求的输出是一段 [token 数, hidden] 或 [token 数, num_labels],不是一行。TokenPoolerHead.forward_chunk 还承担 late chunking 的均值压缩:把一段 token 状态按固定 chunk_size 求平均,累加同样用 FP32:
def _mean_pool_chunks(data, chunk_size): chunk_size = min(chunk_size, len(data)) num_full, remainder = divmod(len(data), chunk_size) full_end = num_full * chunk_size full_chunks = data[:full_end].reshape(num_full, chunk_size, data.shape[-1]) if not remainder: return full_chunks.mean(dim=1, dtype=torch.float32) return torch.cat([ full_chunks.mean(dim=1, dtype=torch.float32), data[full_end:].mean(dim=0, keepdim=True, dtype=torch.float32), ])late chunking 的语义是「先让模型看到完整上下文,再把 token 状态按块平均」,这样每一块的向量都带着整段文本的上下文信息,而不是块内独立编码。LateChunkingParams 的注释里特别说明:特殊 token 计入块边界,也会被算进块均值,包括通常会被 BGE-M3 过滤掉的 BOS。这个设计选择影响输出分布,不能想当然地删掉。
一批请求怎么被切出「槽位」
前面所有方法都依赖一个对象:PoolingMetadata。它描述「这一批池化请求在扁平隐藏状态里的布局」,核心字段是:
@dataclassclass PoolingMetadata: prompt_lens: torch.Tensor # CPU tensor prompt_token_ids: torch.Tensor | None prompt_token_ids_cpu: torch.Tensor | None pooling_params: list[PoolingParams] pooling_states: list[PoolingStates] pooling_cursor: PoolingCursor | None = Noneprompt_lens 是每条请求的完整 prompt 长度,放在 CPU;prompt_token_ids 是 GPU 上的扁平 token id(需要时才填),prompt_token_ids_cpu 是对应的 CPU 副本;pooling_states 是每条请求的跨 step 状态,目前只有 token 级分块预填充用到的 hidden_states_cache。
真正的索引账本在 PoolingCursor:
@dataclassclass PoolingCursor: first_token_indices_gpu: torch.Tensor last_token_indices_gpu: torch.Tensor prompt_lens_cpu: torch.Tensor seq_lens_cpu: torch.Tensor num_scheduled_tokens_cpu: torch.Tensor partial_prefill: bool finished_mask: list[bool]四个张量分别回答四个问题:每条序列的第一个 token 在扁平张量里的行号、最后一个 token 的行号、整条 prompt 有多长、本步调度了多少 token。partial_prefill 比较 prompt_lens_cpu 与 num_scheduled_tokens_cpu;finished_mask 比较 prompt_lens_cpu 与 seq_lens_cpu,即「这条请求的 prompt 是否已经全部算完」。
build_pooling_cursor 的关键是前缀和:
if query_start_loc_gpu is None: cumsum = torch.zeros(n_seq + 1, dtype=torch.int64, pin_memory=True, device="cpu") torch.cumsum(num_scheduled_tokens_cpu, dim=0, out=cumsum[1:]) cumsum = cumsum.to(device, non_blocking=True)else: cumsum = query_start_loc_gpu
self.pooling_cursor = PoolingCursor( first_token_indices_gpu=cumsum[:n_seq], last_token_indices_gpu=cumsum[1:] - 1, ...)有 query_start_loc_gpu 时直接复用,没有时在 CPU 上算好、用 pinned memory 异步拷到 GPU。first 是每段起点,last 是每段终点减一。这个构造和 FlashAttention 变长前向里的 cu_seqlens 是同一套思路,只是这里用来索引池化行,而不是切分注意力。
PoolingCursor.__getitem__ 支持按请求切片,切片时必须重新计算两个布尔量:
partial_prefill=not torch.equal(prompt_lens_cpu, num_scheduled_tokens_cpu),finished_mask=torch.eq(prompt_lens_cpu, seq_lens_cpu).tolist(),因为切片之后的子集可能处于不同的完成状态。DispatchPooler 的混合任务路径正是靠这个切片,把每条任务组的「部分完成」状态独立出来。如果切片后沿用了原游标的 partial_prefill,一个已经完成的嵌入请求可能被误判成 partial,直接触发 MeanPool 的异常。
PoolingMetadata.__post_init__ 还做了一次强制校验:每个 pooling_params 都必须有 task。这不是多余的防御,而是分发器的前提——没有 task 就无法选子池化器,也无法分组。任务是在 GPUModelRunner.add_request 阶段写进参数的:
if self.is_pooling_model: assert pooling_params is not None task = pooling_params.task assert task is not None, "You did not set `task` in the API" model = cast(VllmModelForPooling, self.get_model()) to_update = model.pooler.get_pooling_updates(task) to_update.apply(pooling_params)注意顺序:先拿到 task,再让池化器根据 task 改写参数。get_pooling_updates 只能改 requires_token_ids,所以这一步必须在请求进入 batch 之前完成,否则后面构造 PoolingMetadata 时 prompt_token_ids_cpu 可能是空的。
一次前向的后半段:_pool 做了什么
GPUModelRunner.execute_model 在模型前向之后有一个分叉。生成模型走 compute_logits → sampler;池化模型走 _pool:
if self.is_pooling_model: return self._pool( hidden_states, num_scheduled_tokens, num_scheduled_tokens_np, kv_connector_output)_pool 本身不长,但每一步都有讲究:
def _pool(self, hidden_states, num_scheduled_tokens, num_scheduled_tokens_np, kv_connector_output): num_reqs = self.input_batch.num_reqs assert num_reqs == len(self.input_batch.pooling_params), ( "Either all or none of the requests in a batch must be pooling request")
hidden_states = hidden_states[:num_scheduled_tokens] seq_lens_cpu = self.optimistic_seq_lens_cpu[:num_reqs]
pooling_metadata = self.input_batch.get_pooling_metadata() pooling_metadata.build_pooling_cursor( num_scheduled_tokens_np, seq_lens_cpu, device=hidden_states.device, query_start_loc_gpu=self.query_start_loc.gpu[: num_reqs + 1])
model = cast(VllmModelForPooling, self.model) raw_pooler_output = model.pooler( hidden_states=hidden_states, pooling_metadata=pooling_metadata)
finished_mask = pooling_metadata.get_pooling_cursor().get_finished_mask() ... if raw_pooler_output is None or not any(finished_mask): self._sync_device() model_runner_output.pooler_output = [None] * num_reqs return model_runner_output第一,切片。前向产生的 hidden_states 可能按最大 batch 形状分配,实际有效行数是 num_scheduled_tokens。不切的话,池化方法会读到 padding 行。
第二,seq_lens_cpu 用 optimistic_seq_lens_cpu。这是调度器维护的「预期序列长度」,避免每步都从 GPU 同步真实长度。对池化模型来说,seq_lens 等于 num_computed_tokens + num_scheduled_tokens,在 prefill 阶段可以直接算出来,不需要读 GPU。
第三,调用池化器。注意 model.pooler 只在 TP rank 0 上被调用(接口注释明确写了这一点)。隐藏状态在 TP 下是切分的,池化之前的 all-reduce 或 all-gather 已经由模型层完成,所以池化器看到的是完整 hidden 维。如果模型在最后一层后还有 row-parallel 的 LM head,池化模型通常没有这个头,输出直接取 hidden states。
第四,完成掩码。finished_mask 为假的请求,本步不返回结果。这一步决定了分块预填充下哪些请求能提前结束:只要一条请求的 prompt 没算完,它的池化结果就是 None。_copy_pooler_output_to_cpu 会按掩码把 None 填回去,保持输出列表与请求顺序一一对应。
第五,异步拷贝。CUDA 平台上,_pool 不直接做同步拷贝,而是返回一个 AsyncGPUPoolingModelRunnerOutput:
return AsyncGPUPoolingModelRunnerOutput( model_runner_output=model_runner_output, raw_pooler_output=raw_pooler_output, finished_mask=finished_mask, async_output_copy_stream=self._get_or_create_async_output_copy_stream())构造函数在一条独立的 CUDA stream 上发起 D2H 拷贝,并记录一个 blocking event;真正的 get_output() 在需要结果时才 event.synchronize()。这样下一步的 GPU 前向可以和上一步的输出拷贝重叠。对嵌入服务来说,输出向量往往有几百 KB 到几 MB,拷贝时间不可忽略;把拷贝放进独立 stream,是池化路径少有的、明显区别于生成路径的性能优化。
_copy_pooler_output_to_cpu 还要处理两种输出形态:张量与 list。张量形态下,如果整批都完成就一次 to("cpu");只有部分完成时用 index_select 只拷完成的行。list 形态下逐条判断 finished_mask。两种形态都返回 list[Tensor | None],长度等于请求数——这个「用 None 占位」的约定让上层可以按 req_id_to_index 直接对齐,不需要额外的映射表。
PP 场景还有一个边界:池化输出只由最后一个 pipeline rank 计算。非最后一个 rank 返回 IntermediateTensors;而 broadcast_pp_output 分支里显式写了 assert not self.is_pooling_model,说明「把 logits 广播给所有 rank」的那条路径不适用于池化模型。池化模型不需要每个 rank 都拿到输出,只需要最后一个 rank 把结果回传。
调度器为池化模型让出的三处空间
池化模型没有 decode 阶段,调度器必须知道这件事,否则会多算、错算。Scheduler.__init__ 里有这样一段:
self.num_sampled_tokens_per_step = ( 0 if (vllm_config.model_config.runner_type == "pooling" or vllm_config.model_config.is_diffusion) else 1)生成模型每步前向之后会追加一个采样 token,调度器在计算「本步能塞多少 token」时,要为这个额外 token 预留一个上下文位置。池化模型不采样,所以预留量是 0。这个数字看着小,影响却不小:在 max_model_len 边界上,生成模型最后一步可能因为「预算 + 1」超出上限而无法调度,池化模型则可以把最后一段 token 完整吃下。
第二处是请求结束条件。调度器在 _update_request_with_output 附近判断:
elif request.pooling_params and pooler_output is not None: # Pooling stops as soon as there is output. request.status = RequestStatus.FINISHED_STOPPED stopped = True生成请求要等采样器给出 EOS、stop string 或达到 max_tokens 才结束;池化请求只要本步产生了池化输出就结束。这个「有输出即结束」的语义和 finished_mask 是配套的:_pool 只对已完成 prompt 的请求返回非 None 输出,调度器看到非 None 就把请求标记为完成。
第三处是分块预填充的闸门。调度器在切分长 prompt 时有一段注释:
# chunked prefill has to be enabled explicitly to allow# pooling requests to be chunkedif (not self.scheduler_config.enable_chunked_prefill and num_new_tokens > request_token_budget and not self.is_mm_encoder_only): break池化请求默认不参与分块预填充。原因前面已经出现过:CLSPool 和 MeanPool 都会在 partial prefill 时报错,如果调度器擅自把一条嵌入请求切成两块,第一步就会抛出异常。只有显式开启 enable_chunked_prefill,调度器才允许切分池化请求;此时能安全工作的组合是 LAST 池化(中间结果被掩码丢弃)和 token 级池化(AllPool 会把各块缓存起来拼接)。MEAN 池化在分块预填充下仍然会报错,这是一个真实的组合限制,配置时要么关掉分块预填充,要么换池化方式。
调度器还要为池化请求分配 KV 块。池化模型虽然不 decode,prefill 阶段的注意力仍然要把 K/V 写进分页池,后续层还要从池里读前面 token 的 K/V。区别在于请求结束得早:prefill 一完成,块就被释放或转成前缀缓存,不会像生成请求那样长期占着块等待 decode。这让池化服务的 KV 占用呈现「短时高峰、快速回落」的形态,和生成服务的「长尾占用」很不一样;做容量规划时不能直接套用生成模型的块数公式。
三个真实模型的池化层:BERT、SPLADE 与混合输出
抽象讲完,落到具体模型上会看到三种完全不同的池化形态。
BERT:CLS + Dense + Tanh
vllm/model_executor/models/bert.py 里,BertPoolingModel 是「带 pooler 的 BERT」,BertEmbeddingModel 是「只做嵌入、不带 pooler 权重」的版本。前者构造 BertPooler,后者构造分发器:
class BertPoolingModel(BertModel): is_pooling_model = True
def __init__(self, *, vllm_config, prefix="", embedding_class=BertEmbedding): super().__init__(...) self.pooler = BertPooler(vllm_config.model_config)BertPooler 继承 SequencePooler,方法用 BertPooler 自己构造的 get_seq_pooling_method(pooler_config.seq_pooling_type),头是带 Dense 与 Tanh 投影的 EmbeddingPoolerHead。注意 BertPooler 并没有把 PoolerNormalize 挂到头上,BERT 官方嵌入接口本身不做 L2 归一化,归一化交给调用方;而走 BertEmbeddingModel 与 DispatchPooler.for_embedding 的通用路径则会挂 PoolerNormalize。同一个架构、两个模型类,输出是否归一化不同,这是选模型类时最容易忽略的差异。它有一个容易忽略的初始化技巧:先用 nn.Identity() 占住 head 位置,再在 dense、act_fn 建好之后替换成真正的头,并用 lambda 包 projector。注释写明原因是「避免过早向 nn.Module 注册参数」——如果先把 dense 放进 head,参数名会变成 pooler.head.dense.weight,和 Hugging Face checkpoint 里的 pooler.dense.weight 对不上,权重加载就会失败。
BertEmbeddingModel 则走通用路径:
def _build_pooler(self, pooler_config): return DispatchPooler.for_embedding(pooler_config)它不需要 BERT 自带的 pooler 权重,而是用通用的 pooler_for_embed:get_seq_pooling_method + EmbeddingPoolerHead(projector=_load_st_projector(...), activation=PoolerNormalize())。这就是为什么同一个 BERT 架构在 vLLM 里会有两个模型类:一个要加载 pooler.dense,一个不要。选错类,权重加载会报缺参数或多参数。
SPLADE:词表维的稀疏权重
BertSpladeSparseEmbeddingModel 继承 BertEmbeddingModel,额外挂一个 MLM 头,并把 embed 子池化器换成自定义的 SPLADESparsePooler:
return DispatchPooler({ "token_embed": pooler_for_token_embed(pooler_config), "embed": SPLADESparsePooler( mlm_head=self.mlm_head, cls_token_id=cls_id, sep_token_id=sep_id, pooling=pooling_mode, # "max" or "sum" remove_cls_sep=True, ),})SPLADESparsePooler 在 embed 任务下直接取代通用嵌入头。它的前向逻辑是:
logits_i = projection(hs[start_idx:end_idx])if self.pooling == "sum": pooled_i = torch.log1p(torch.relu(logits_i)).sum(dim=0)else: # "max" pooled_i = logits_i.amax(dim=0)它先用 MLM 头把每个 token 的隐藏状态投到词表维,过 relu 去掉负值,再对整段做 max 或 sum,最后 log1p 压缩动态范围。输出的不是 hidden_size 维向量,而是 vocab_size 维的稀疏词权重——大多数词权重为 0,只有被模型认为重要的词有值。这个输出可以直接喂给倒排索引做稀疏检索。
这个例子里有两个细节值得记住。第一,remove_cls_sep=True 会按 token id 去掉首尾的特殊 token,所以它声明了 requires_token_ids=True,需要在 CPU 侧拿 prompt token ids。第二,max 与 sum 两种池化的顺序不同:sum 分支先 log1p(relu(...)) 再求和,max 分支先取 max 再 relu_().log1p_()。代码注释解释了为什么可以交换顺序——relu 与 log1p 都是单调函数,max 与单调函数可交换。这不是随手写的优化,而是数学上等价才敢这么做。
BGE-M3:dense 与 sparse 拼成一个输出
special.py 里还有一个 BgeM3Pooler。它同时持有 token_classify_pooler 和 embed_pooler,前向时各算一次,再把两个结果展平拼接:
embed_outputs = self.embed_pooler(hidden_states, pooling_metadata)token_classify_outputs = self.token_classify_pooler(hidden_states, pooling_metadata)pooler_outputs = []for embed_output, token_classify_output in zip(embed_outputs, token_classify_outputs): pooler_outputs.append(torch.cat( [embed_output.view(-1), token_classify_output.view(-1)], dim=-1))return pooler_outputs它声明的任务是 embed&token_classify,get_pooling_updates 把两个子池化器的更新按位或起来。拼接后的向量同时包含 dense 语义向量和稀疏词权重,调用方按约定切出两段分别使用。这个设计说明 vLLM 的池化任务不是封闭枚举:PoolingTask 里专门留了 embed&token_classify 这种复合任务,模型可以自定义组合方式。
打分 API:三条路在入口层就已分流
LLM.score() 的签名看起来只是「给两段文本打分」,但它背后要处理三种完全不同的模型形态:bi-encoder 要分别编码两段文本再比向量,cross-encoder 要拼接后过一次模型,late-interaction 要保留两段文本的 token 向量做 MaxSim。入口层必须先把模型归类,再决定怎么构造请求。
离线入口在 vllm/entrypoints/pooling/offline.py 的 PoolingOfflineMixin。__init__ 先确定这个模型的默认池化任务:
self.pooling_task = self.model_config.get_pooling_task(self.supported_tasks)if self.pooling_task is not None: logger.info("Supported pooling task: %s", self.pooling_task)然后建 chat template 配置和 IO processor。encode() 是所有池化 API 的公共底座,它做的第一件事是校验:
def _verify_pooling_task(self, pooling_task): if self.runner_type != "pooling": raise ValueError( "LLM.encode() is only supported for pooling models. " "Try passing `--runner pooling` to use the model as a pooling model.")接着要求显式给出 pooling_task,并检查它是否在该模型的支持列表里。错误信息里给了两条修复路径:嵌入类任务建议用 --convert embed,分类类任务建议用 --convert classify;如果模型支持多个任务但默认任务不对,提示用 PoolerConfig(task="...") 切换。这套提示把「模型能力」「运行模式」「默认任务」三个概念区分得很清楚,排查时按提示逐层检查即可。
embed()、classify()、score() 都是 encode() 的薄包装。score() 额外处理输入配对:支持 1 -> 1、1 -> N、N -> N 三种形态,1 -> N 时把第一个输入复制 N 份。对 cross-encoder 来说,每一对会被拼成一条 prompt 送进模型;对 bi-encoder 来说,两段文本分别编码,再在客户端算相似度;对 late-interaction 来说,两段文本各自产出 token 向量矩阵,再由 MaxSim 打分。
late-interaction 在引擎侧还有一套缓存机制。PoolingParams.late_interaction_params 是一个 msgspec.Struct,有两个模式:
cache_query:把 query 的 token 向量缓存起来,query_key作为缓存键,query_uses声明这份缓存会被多少个文档请求复用;score_doc:拿一个文档来和已缓存的 query 打分。
query_key 同时用于数据并行路由和 worker 侧缓存查找——同一个 query 的后续文档请求必须落到同一个 worker,否则缓存找不到。这个设计把「一对多打分」的常见形态(一个 query 对多个候选文档)优化成了「query 只编码一次」。PoolerConfig.enable_flash_late_interaction 控制引擎侧是否使用融合的 flash-maxsim Triton 内核;服务端可以用 --disable-flash-late-interaction 关掉它,回退到参考实现。融合内核与参考实现的数值结果应当一致,但实现路径不同,排查精度问题时可以先关掉融合内核做对照。
还有一个容易忽略的请求参数:PoolingParams.output_kind 默认是 FINAL_ONLY。池化输出是一次性的向量,不存在「逐步生成」的语义,所以流式接口对池化模型只会给最终结果。如果拿生成模型的流式习惯去接嵌入接口,会误以为每个 chunk 都是一段增量向量。
长文本嵌入:分块处理与调度分块不是一回事
池化模型遇到超长输入时,vLLM 有两条不同的「分块」路径,名字很像,机制完全不同。
第一条是 PoolerConfig.enable_chunked_processing。它针对的是「输入长度超过模型最大位置编码」的嵌入模型:把长输入切成若干块,分别编码,再按权重做加权平均,得到一个仍然合法的向量。配置注释明确写了「多模态输入不支持」,默认关闭。这条路发生在输入预处理阶段,不改变调度器的 batch 结构,也不依赖 enable_chunked_prefill。
第二条是调度器的分块预填充(chunked prefill)。它针对的是「单条 prompt 太长,一步装不下」的情况:把一条请求的 prefill 拆到多个 step,每步算一段。这条路会改变 PoolingCursor 的 partial_prefill 状态,因此受池化方式限制——CLS 与 MEAN 会直接报错,LAST 的中间结果会被 finished_mask 丢弃,token 级池化靠 hidden_states_cache 跨步累积。
两条路径的配置项也分开:enable_chunked_processing 在 PoolerConfig 里,enable_chunked_prefill 在 SchedulerConfig 里。前者是「模型装不下长输入」的补救,后者是「一步算不完长输入」的调度策略。把两者混为一谈,就会出现「开了 chunked processing 却仍然被调度器切块」或者「关了 chunked prefill 却以为长输入不能处理」的误判。
PoolerConfig.max_embed_len 则是一个独立的长度上限:设置之后,嵌入请求可以接受超过 max_embed_len 的输入,具体怎么处理仍按原来的 max_model_len 校验逻辑走;不设置时默认等于 max_model_len。它解决的是「嵌入模型的位置编码上限比生成模型小」的问题,和分块处理配合使用。
late chunking 是第三种「分块」,但它不是切输入,而是切输出:模型仍然看完整上下文,只是把 token 状态按固定 chunk_size 求平均,得到若干块向量。它的注释说明请求会重算全部 prompt token、绕过前缀缓存读取,因为块均值依赖完整上下文,复用半段前缀缓存会得到不同的结果。这也是 PoolingParams.skip_reading_prefix_cache 存在的原因——某些池化任务在语义上不能安全复用前缀 KV。
工程上的坑与排查清单
把池化路径读完之后,最容易出错的点可以归成一张清单。
第一,任务名用了旧版。 task="score" 或 task="encode" 会在配置阶段被 check_removed_pooling_task 拒绝,提示改用 classify 或 token_embed/token_classify。这不是模型不支持,而是任务名已经重构。
第二,池化方式与分块预填充冲突。 CLSPool 与 MeanPool 在 partial_prefill 时抛 RuntimeError。如果服务同时开了 enable_chunked_prefill 又用 MEAN 池化,长请求会在第一步就失败。要么换 LAST/token 级池化,要么关掉分块预填充,要么限制单请求长度。
第三,num_labels 与激活函数不匹配。 分类模型如果配置里 num_labels 缺失或为 0,PoolerClassify 会退化为 sigmoid 并打 warning。重排模型应当是 1 个 label + sigmoid;多分类模型应当是多 label + softmax。配置错了,输出分布就不对,阈值全部失效。
第四,归一化开关的默认值。 PoolerConfig 里旧的 normalize 参数已被移除,构造时会直接报错并提示改用 use_activation。pooler_for_embed 默认挂 PoolerNormalize,请求不显式设置 use_activation=False 就会做 L2 归一化。如果下游自己要做归一化,重复归一化不会改变方向,但会改变模长;如果下游要保留模长,必须显式关掉。
第五,requires_token_ids 没被设置。 STEP 池化、SPLADE、BOS/EOS 过滤都依赖 CPU 侧 token ids。如果自定义池化器忘了在 get_pooling_updates 里声明 requires_token_ids=True,PoolingMetadata.get_prompt_token_ids_cpu() 会直接抛错。这个钩子必须在请求入 batch 之前生效,所以池化器要挂对位置。
第六,projector 与 checkpoint 命名不一致。 BERT 的 pooler 权重在 checkpoint 里叫 pooler.dense.weight,如果模型类把 dense 注册到了别的层级,AutoWeightsLoader 会报缺参数。BertPooler 用 lambda 延迟注册、BertPoolingModel 覆盖 hf_to_vllm_mapper 去掉 pooler. 前缀,都是在处理这件事。
第七,token type id 的 30 位编码。 交叉编码器需要区分两段文本,BERT 用 token_type_ids。vLLM 为了不给 torch.compile 增加持久张量,把 token type id 编码进 input_ids 的第 30 位:
TOKEN_TYPE_SHIFT = 30
def _encode_token_type_ids(input_ids, token_type_ids): input_ids[: token_type_ids.shape[0]].bitwise_or_(token_type_ids << TOKEN_TYPE_SHIFT)
def _decode_token_type_ids(input_ids): ids_mask = 1 << TOKEN_TYPE_SHIFT tokens_mask = ~ids_mask token_type_ids = (input_ids & ids_mask) >> TOKEN_TYPE_SHIFT input_ids.bitwise_and_(tokens_mask) return token_type_ids词表规模远小于 ,所以高位是空的;第 32 位留空是为了避免出现负数。这个技巧只在 *ForClassification 这类模型外层使用,进入 BERT 的 embedding 层之前会解码回两个张量。读交叉编码器源码时看到 input_ids 最高位有值,不要以为是数据损坏。
第八,池化批次不能混生成请求。 _pool 里断言「要么全是池化请求,要么全不是池化请求」。runner_type 是模型级配置,正常情况下一个 runner 不会同时服务两类请求;但自定义模型或多任务适配层如果试图在一个 batch 里混跑,会直接命中断言。需要混合服务时,应该按模型拆实例,而不是在一个 runner 里混。
第九,None 占位不是错误。 池化输出列表里出现 None,表示这条请求本步还没完成(分块预填充的中间步)。上层必须按 req_id_to_index 对齐,不能把 None 当成失败。真正的失败会走异常或 finish_reason,不会用 None 表示。
第十,PP 下不要期待每个 rank 都有输出。 池化只由最后一个 pipeline rank 计算,broadcast_pp_output 分支断言不适用于池化模型。做多机排查时,如果在非最后 rank 上找 pooler 输出,会一无所获。
与 llama.cpp 的池化实现对照
llama.cpp 也有嵌入与重排能力,但抽象层次与 vLLM 不同。它在 llama.h 里把池化类型做成一个枚举:LLAMA_POOLING_TYPE_NONE(不池化)、MEAN、CLS、LAST,以及 LLAMA_POOLING_TYPE_RANK——注释写明它是「给重排模型把分类头挂到计算图上」;池化在计算图里是一个显式算子,输出通过 llama_get_embeddings 或 llama_get_embeddings_seq 按序列读取。服务端的 /embeddings 与 /rerank 端点直接消费这个结果。
两者的差异可以归成三点。
第一,任务模型不同。llama.cpp 的池化类型主要服务「序列级向量 + 重排分数」,token 级输出和复合任务的支持范围较窄;vLLM 把任务拆成六个名字,显式区分序列级、token 级、插件与混合输出,DispatchPooler 负责按任务路由。
第二,头与方法的耦合程度不同。llama.cpp 的池化算子直接输出最终向量,归一化、投影等后处理分散在调用方或服务端;vLLM 把「方法」与「头」拆成两个可组合对象,projector、Matryoshka 截断、归一化、分类器、校准参数都在头里统一处理,模型只需要声明支持哪些任务。
第三,服务语义不同。llama.cpp 的 server 以 slot 为单位管理上下文,嵌入请求也走 slot;vLLM 把池化请求纳入统一的调度器与分页 KV 体系,复用连续批处理、前缀缓存、P/D 分离这些机制,代价是要处理 partial_prefill、finished_mask、异步拷贝这些额外的状态。llama.cpp 的嵌入链路更短,vLLM 的链路更「生成引擎化」。
如果想看 llama.cpp 侧的实现细节,站内 llama.cpp 源码完全拆解(十一):嵌入、重排与池化 从 ggml 图、掩码矩阵与序列读取的角度拆过一遍;llama.cpp 源码完全拆解(一):整体架构与模块全景 则交代了它的上下文与 slot 模型。把两篇放在一起看,能更清楚地理解「池化」这件事在两种引擎里为什么长成了不同的形状。
小结:池化模型是生成引擎的一次「减法」
如果把这篇的机制压缩成几句话:
- runner_type 先分叉。 模型声明
is_pooling_model与pooler,配置解析决定走 pooling 还是 generate;后面所有行为——采样、上下文预留、输出路径——都由这个字段推导出来。 - 任务先于池化器。
PoolingTask决定 API 能力与分发路径;DispatchPooler按任务选子池化器,混任务批次靠切片与游标平移保持索引正确。 - 方法是「取哪些行」,头是「怎么加工」。 CLS/LAST 是一次索引,MEAN 是 FP32 分段累加,ALL/STEP 是 token 级切分与筛选;projector、Matryoshka、归一化、分类器、校准都在头里完成。
- 槽位账本靠前缀和。
PoolingCursor用cu_seqlens式的first/last索引把扁平隐藏状态切给每条请求,partial_prefill与finished_mask决定中间结果丢不丢。 - 调度器做三处减法。 不预留采样 token、有输出即结束、池化请求默认不参与分块预填充;这三处减法让池化请求在生成引擎里跑得通,但也留下了 CLS/MEAN 与分块预填充不兼容的边界。
- 打分是 API 概念。 bi-encoder、cross-encoder、late-interaction 分别落到
embed、classify、token_embed三个任务;score任务名已移除,但LLM.score()仍在,按score_type自动分流。
用一张表把关键对象与职责收拢:
| 对象 | 所在位置 | 职责 |
|---|---|---|
runner_type | ModelConfig | 决定生成/池化路径与调度语义 |
PoolingTask | vllm/tasks.py | API 能力、分发键、打分路线映射 |
Pooler | layers/pooler/abstract.py | 声明支持任务、按任务改写参数、产出输出 |
SequencePooler / TokenPooler | pooler/seqwise、pooler/tokwise | 方法 + 头两段式组合 |
DispatchPooler | pooler/special.py | 按任务路由、混任务切片 |
PoolingMetadata / PoolingCursor | v1/pool/metadata.py | 槽位账本、部分完成与完成掩码 |
_pool | v1/worker/gpu_model_runner.py | 切隐藏状态、调池化器、异步拷贝 |
num_sampled_tokens_per_step | v1/core/sched/scheduler.py | 池化不预留采样 token,输出即结束 |
池化模型没有让 vLLM 变得更简单,反而暴露了生成引擎里许多原本被 decode 掩盖的假设:批内请求必须同构、上下文位置要预留、输出要按请求对齐、分块预填充要保证语义完整。vLLM 的处理方式是把这些假设一条条写成断言、掩码和配置闸门,而不是另起一套引擎。理解这些闸门在哪里,比记住「池化模型支持 embed/classify」更有用——它们决定了哪些模型能跑、哪些组合会报错、哪些结果可以安全复用。
参考资料
- vLLM Pooling Models 官方文档
- vLLM 源码:Pooler 抽象接口
- vLLM 源码:序列池化方法与头
- vLLM 源码:token 级池化方法与头
- vLLM 源码:DispatchPooler 与 BgeM3Pooler
- vLLM 源码:PoolingMetadata 与 PoolingCursor
- vLLM 源码:GPUModelRunner 的池化执行路径
- vLLM 源码:调度器的池化处理
- vLLM 源码:PoolerConfig 配置项
- vLLM 源码:BERT 池化模型与 SPLADE 池化器
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(arXiv:1810.04805)
- Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks(arXiv:1908.10084)
- Matryoshka Representation Learning(arXiv:2205.13147)
- ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT(arXiv:2004.12832)
- BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation(arXiv:2402.03216)
- ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction(arXiv:2112.01488)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



