


vLLM 源码完全拆解(二十一):分布式执行器——一台多卡机器怎么把一组进程接成一条流水线
到目前为止,本系列一直把一个 vLLM 实例当作“一个引擎”来拆:请求从入口进、调度器给出一步的计划、GPU 前向跑出 logits、采样之后回到调度器记账。前面的 整体架构与模块全景 已经画出过大的分工图,但那张图里有一整层被有意略过去了:调度器并不直接调用 CUDA。它发出的每一步(execute_model)要经过一个执行器(Executor),执行器再决定这一脚踩在哪个进程、哪张卡、哪台机器上。
这一层就是分布式执行器。它要回答的问题非常具体:
- 一个
vllm serve -tp=8的命令行,最后在操作系统里变成了几个进程?谁是谁的父进程? - 调度器每个 step 产生的一份
SchedulerOutput(里面可能有几千个 token 的批、上百条请求的元数据),怎么从调度进程送到 8 个 GPU 工作进程手里,又怎么把 8 份结果收回来? - 每个 GPU 进程各自看到几张卡、各自的 rank 是多少、
cuda:0在这台机器上到底对应物理 0 号还是 5 号卡? - 张量并行(TP)、流水线并行(PP)、数据并行(DP)、上下文并行(PCP/DCP)、专家并行(EP)这些“组”,是在哪一行代码里被拆出来的?
- Ray 和不用 Ray 的 mp(multiprocessing)后端,本质区别在哪里?为什么在很长一段时间里,跨机部署必须装 Ray,而现在
--nnodes就能直接跑?
本文按一条真实的启动路径走一遍:从命令行进入引擎,到执行器选择、进程创建、消息队列握手、并行组构造,最后到第一个 EngineCore.step() 把计划送进 GPU。读完这一篇,应该能对着 nvidia-smi、ps -ef 和日志里那几行 world_size=... rank=... local_rank=... distributed_init_method=... 讲清楚每个进程在做什么。
一、先看清对象:调度器和 GPU 之间隔着一个执行器
1.1 调用链的最短版本
从调度器视角,一步的前向就是一次阻塞调用。EngineCore.step() 的主干可以缩成下面几行(vllm/v1/engine/core.py):
scheduler_output = self.scheduler.schedule(...)future = self.model_executor.execute_model(scheduler_output, non_block=True)grammar_output = self.scheduler.get_grammar_bitmask(scheduler_output)model_output = future.result() # 收结果engine_core_outputs = self.scheduler.update_from_output(scheduler_output, model_output)self.model_executor 是哪一类对象,在 EngineCore.__init__ 里就已经定了:
self.model_executor = executor_class(vllm_config)而 executor_class 是外面算好了传进来的,来自 Executor.get_class(vllm_config)。也就是说,执行器的具体类型是配置决定的,调度器对它是多进程还是单进程、有没有 Ray 一无所知。它只认识四个方法:
| 方法 | 谁调用 | 语义 |
|---|---|---|
execute_model(scheduler_output) | EngineCore.step | 按计划做前向,一般返回 None 或异步输出 |
sample_tokens(grammar_output) | 同上(异步调度时) | 在前向结果上做采样,产出 ModelRunnerOutput |
collective_rpc(method, args, ...) | 引擎各处 | 在所有 worker 上调用任意方法,如 determine_available_memory、compile_or_warm_up_model、synchronize_device |
initialize_from_config(kv_cache_configs) | KV 缓存初始化 | 把算好的 KV 配置下发到各 worker,真正切出 KV 池 |
这个极窄的接口是整个设计的关键。collective_rpc 被有意设计得足够宽——后来加的 LoRA 热加载、sleep/wake_up、CUDA Graph 预热、结构化输出同步,都是通过它转发到 worker 的同名方法,而不需要执行器接口再长出新方法。
1.2 四个后端
Executor.get_class() 在 vllm/v1/executor/abstract.py 里,把字符串映射到类:
distributed_executor_backend | 类 | 形态 |
|---|---|---|
"uni" | UniProcExecutor | 单进程,引擎和 GPU 在同一进程里 |
"mp" | MultiprocExecutor | 每张卡一个子进程,调度进程是父进程 |
"ray" | RayExecutorV2 | 每张卡一个 Ray actor,跨机靠 Ray 集群 |
"external_launcher" | ExecutorWithExternalLauncher | 外部进程(如 torchrun/MPI)自己拉起 worker,vLLM 只做 rendezvous 与通信 |
任何 Executor 子类 | 原样使用 | 测试、TPU、插件 |
uni 与 mp 并列,是单独的实现(uniproc_executor.py)。它把 WorkerWrapperBase 直接放在当前进程里,没有子进程、没有消息队列,collective_rpc 就是一次普通的 run_method 调用。它存在的意义是:在 world_size=1 时去掉所有进程和队列开销,也是多进程路径最干净的参照实现。
这个表与 vLLM 源码完全拆解(十一):模型并行与 Worker 层 里那张表相比有两处变化:Ray 后端的类从原来的 RayDistributedExecutor 换成了 RayExecutorV2,并且 uni 从 MultiprocExecutor 的一个特例拆成了独立文件。那篇文章的重点是张量并行怎么切权重、GroupCoordinator 怎么做 all-reduce;本篇补的是同一层里“进程从哪来、消息怎么走、组怎么拆”的部分。两份代码快照之间 vLLM 的 executor 层改动不小,所以下文引用的都是当前主干的实现,遇到与旧文片段对不上的地方,以这里的调用链为准。
external_launcher 只留了一行,本系列后面会单独写;Ray 和 mp 这两个才是本篇的主角。
二、进程拓扑:一个命令行到底拉起多少进程
2.1 进程计数表
vLLM 官方设计文档里给了一张很干净的计数表。对于 N 张 GPU、TP 为张量并行度、DP 为数据并行度、A 为 API server 数量:
| 进程类型 | 数量 | 职责 |
|---|---|---|
| API server | A(默认 DP) | HTTP 接入、分词、模板、反分词 |
| Engine core | DP(默认 1) | 调度器、KV 记账、执行器 |
| GPU worker | N(= DP × PP × TP) | 一张卡一个,做前向 |
| DP coordinator | DP > 1 时为 1 | DP 各 rank 之间同步“还有没有活” |
于是 vllm serve -tp=4 单机 4 卡:1 个 API server + 1 个 engine core + 4 个 GPU worker = 6 个进程。
vllm serve -tp=2 -dp=4,8 卡:4 个 API server + 4 个 engine core + 8 个 GPU worker + 1 个 DP coordinator = 17 个进程。
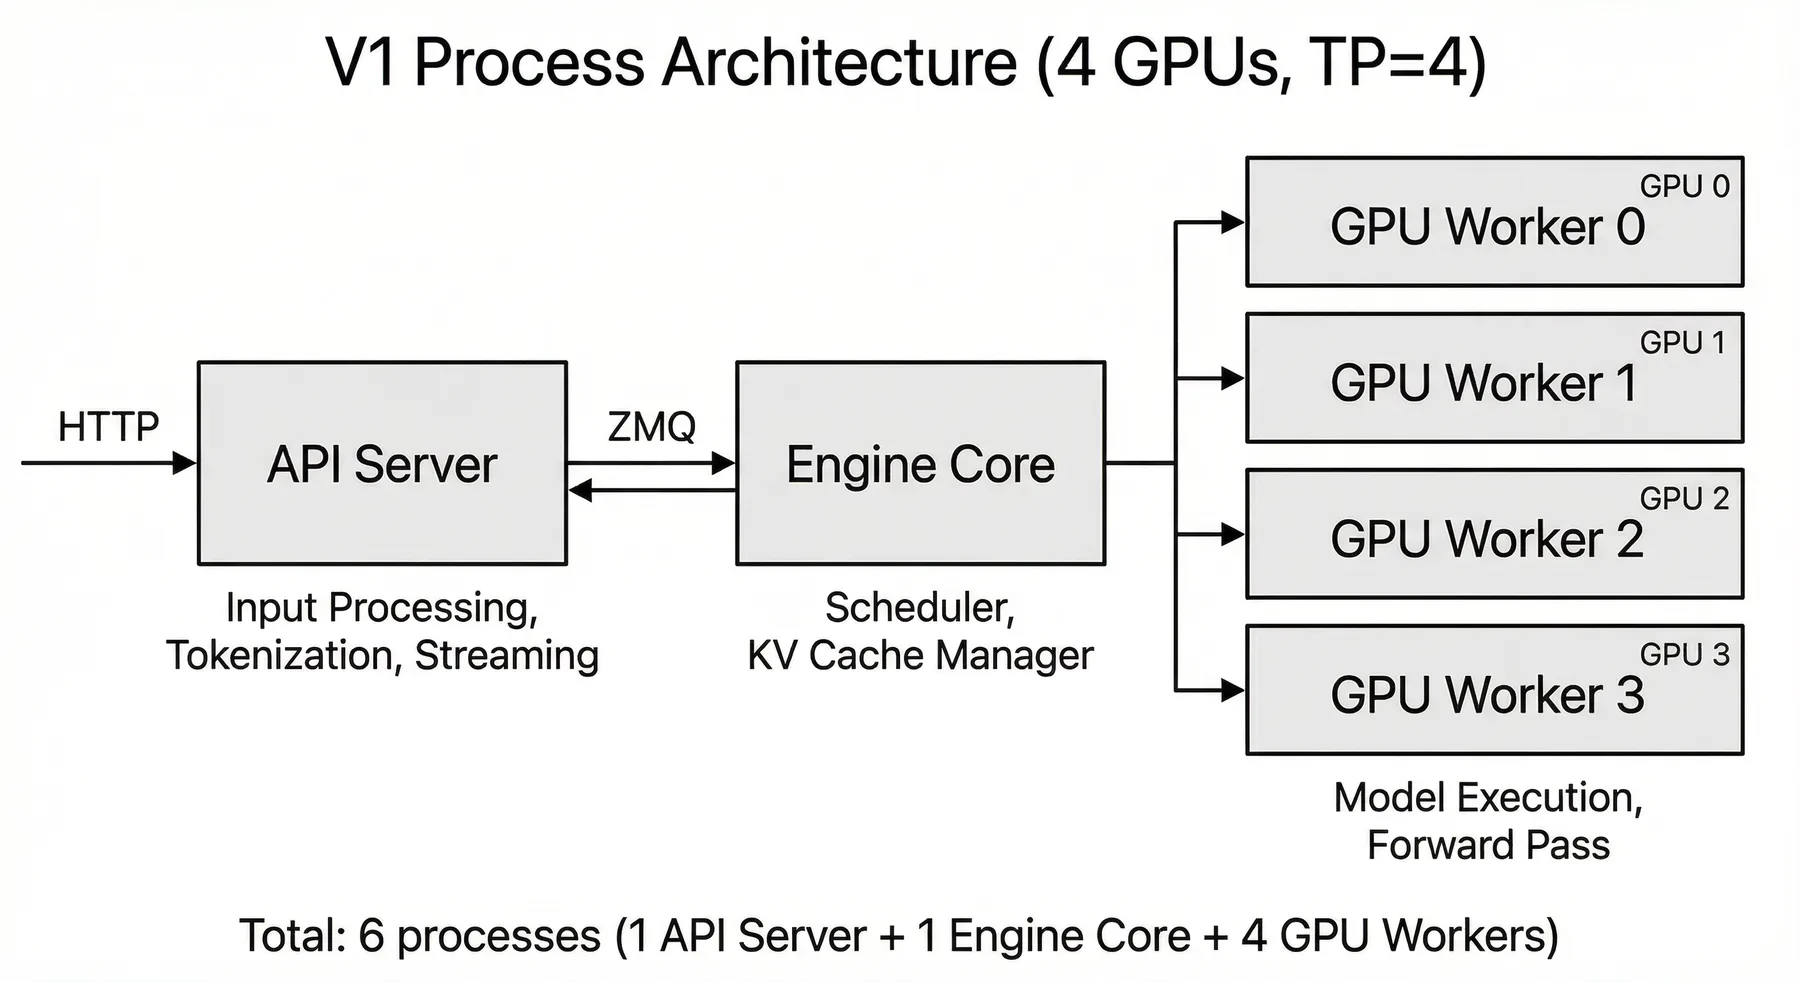
上图是官方文档给的 TP=4 拓扑(图来自 vLLM 设计文档 docs/design/arch_overview.md,下同)。注意三件事:
- Engine core 与 API server 之间也是一条进程边界,走 ZMQ + pickle(前文 前端与引擎之间的那道进程边界 专门拆过)。本篇只关心 engine core 往下的那一条:engine core 与本机 GPU worker 之间。
- worker 进程是 engine core 的子进程(mp 后端)。这意味着
kill掉 engine core 的整个进程组,或者父进程异常退出,worker 要能自己知道并退出——后文的 death pipe 就是这个机制。 - TP 的 4 个 worker 同属一个组,它们之间的通信(all-reduce 等)由 NCCL 与 vLLM 的自定义集合通信负责,不经过 engine core。engine core 只负责把同一份计划广播给 4 个 rank,收结果时只需要其中一个 rank 的模型输出。
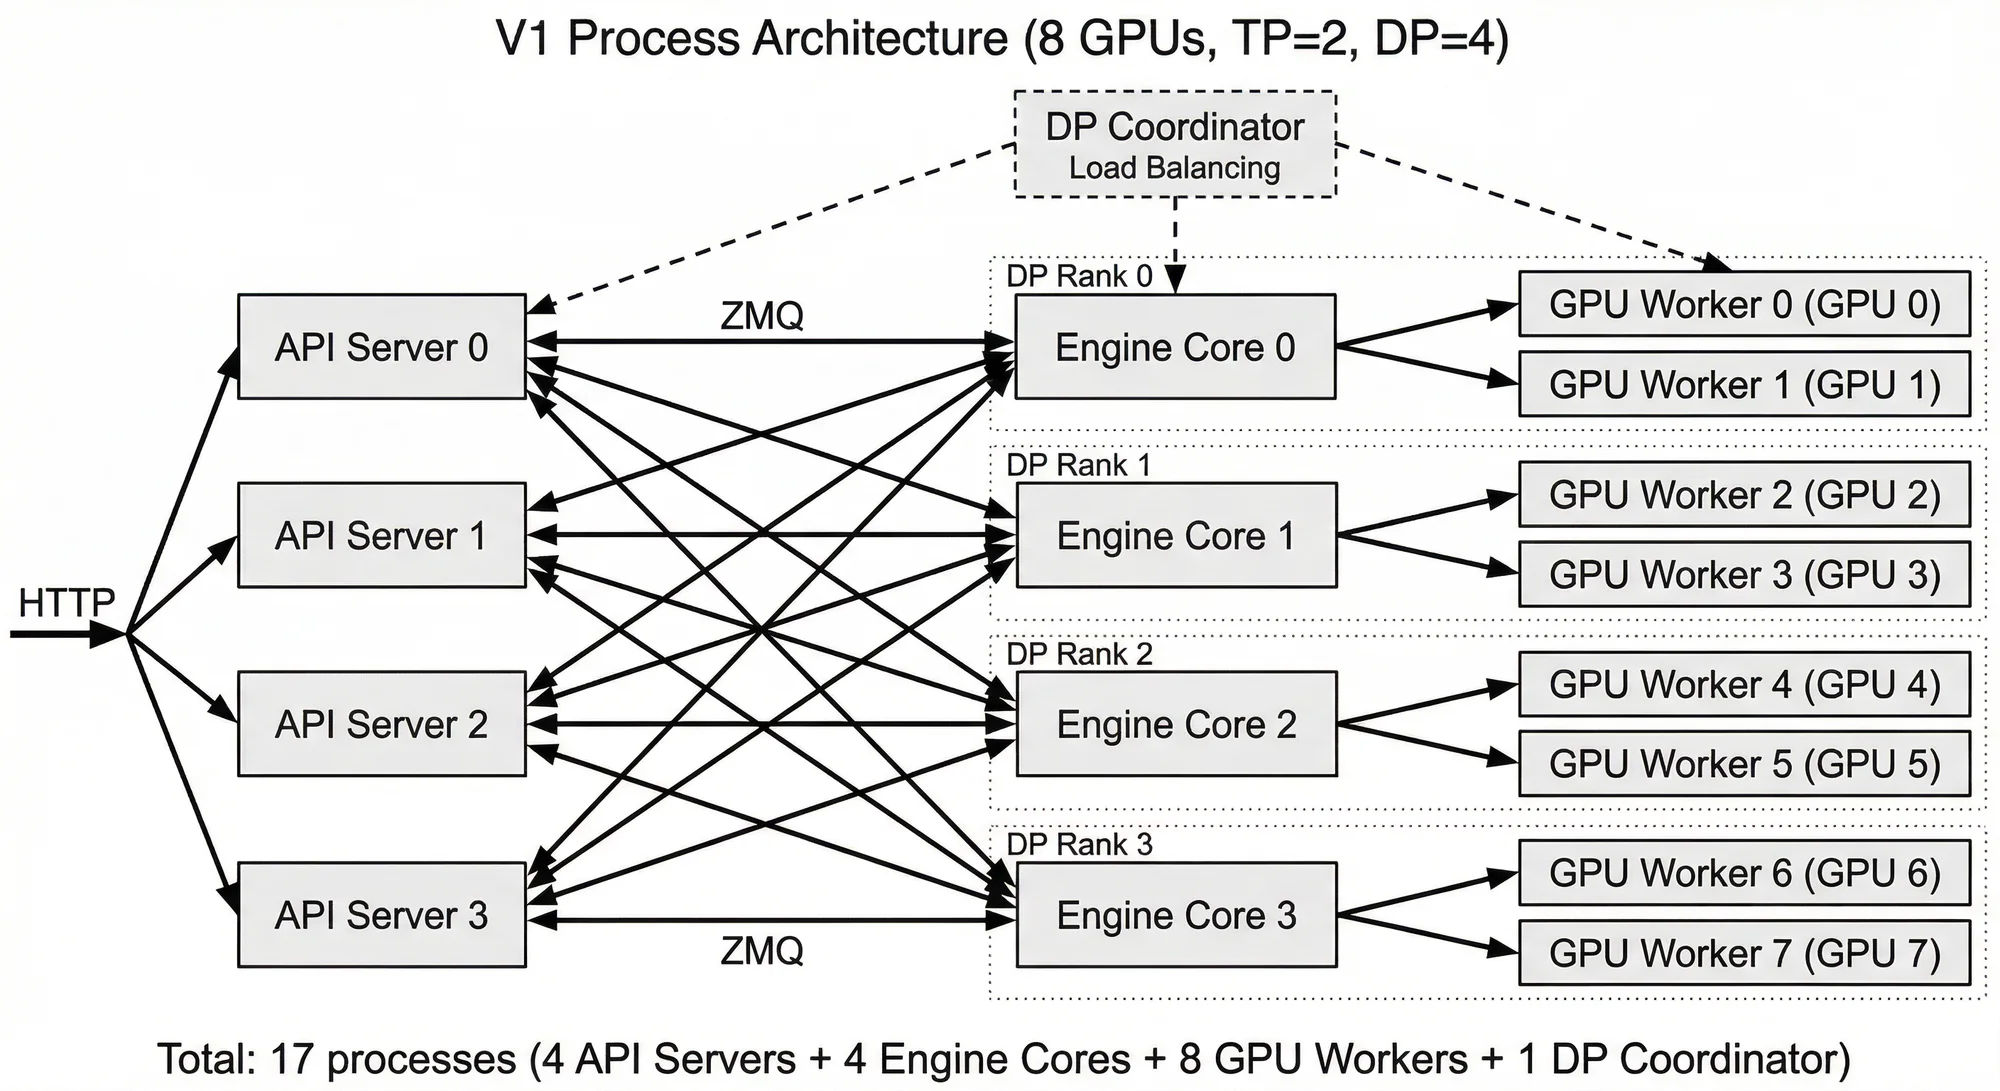
第二张图在同一份文档里,是 DP 的情况,信息量大得多:
- 每个 DP rank 是一个独立的引擎副本,有自己的调度器、自己的 KV 池、自己的 2 张卡。
- 各 DP rank 的 engine core 之间必须同步步调:因为 Moe 模型的 EP 组横跨多个 DP rank,一次 all-to-all 需要所有参与方同时进来,否则就死锁。所以
DPEngineCoreProc每一步末尾都会做一次 all-reduce,判断“全局还有没有未完成的请求”,没有就全体同步暂停(wave 结束)。 - DP coordinator 是让不同 DP rank 的 API server 感知“哪个 rank 空闲”的负载均衡信息来源。
2.2 为什么 worker 是子进程,而不是线程
一个自然的疑问:每张卡一个线程不行吗?不行。GPU 上下文、CUDA context、NCCL 通信器都是进程级状态;NCCL 本身的 GIL 释放和不完全线程安全、Python 解释器里 torch.cuda.set_device 是线程局部的全局变量(每个线程需要自己的设备绑定)、以及 fork 之后 CUDA 状态失效等问题,让“一个进程用一张卡”成为最稳妥的形态。PyTorch 自己的分布式文档就明确建议:每张 GPU 一个进程。
这也解释了下面一节里 fork/spawn 的折腾。
三、启动方法:fork 还是 spawn,vLLM 用了什么策略
3.1 三种方法的权衡
Python 的 multiprocessing 在 Linux 上的启动方法有三种:
fork:直接os.fork()。最快,子进程继承父进程全部内存映射,任何已加载的模块、已建好的数据结构都不用重新导入。但子进程也继承了父进程的线程状态,而 fork 只复制调用线程,子进程里其他线程的存在会让某些库(libgomp、NCCL 内部线程)进入未定义行为。CUDA 在 fork 后也不可靠:已经在父进程初始化的 CUDA runtime 在 fork 出的子进程里使用会出错。spawn:重新启动一个 Python 解释器,子进程只拿到 pickled 的参数。兼容性最好,但需要重新 import 所有模块(vLLM 的 import 链很长),而且如果使用方(例如一个用户脚本)没有if __name__ == "__main__":保护,子进程重执行主模块会导致无限递归。forkserver:先起一个干净的 server 进程,之后从它 fork。兼顾了速度与干净,但对库使用者仍需要__main__保护。
vLLM 作为库被 from vllm import LLM 使用,也在作为命令被 vllm serve 使用,这两类使用者对 __main__ 保护一事的控制能力完全不同,所以它没法统一选一种。官方文档里记录了这个取舍。
3.2 实际策略:默认 fork,按需强制 spawn
实现上,vLLM 用一个环境变量 VLLM_WORKER_MULTIPROC_METHOD 记录当前选择,并且在子进程创建之前运行 _maybe_force_spawn(),只要命中下列任一条件就强制改成 spawn:
reasons = []if is_in_ray_actor(): os.environ["RAY_ADDRESS"] = ray.get_runtime_context().gcs_address reasons.append("In a Ray actor and can only be spawned")if any(arg.split("=",1)[0].replace("_","-") in ("--numa-bind", "--numa-bind-nodes", "--numa-bind-cpus") for arg in sys.argv): reasons.append("NUMA binding requires spawn method")if cuda_is_initialized(): reasons.append("CUDA is initialized")elif xpu_is_initialized(): reasons.append("XPU is initialized")if in_wsl(): reasons.append("WSL is detected and NVML is not compatible with fork")if reasons: logger.warning("We must use the `spawn` ... Reasons: %s", "; ".join(reasons)) os.environ["VLLM_WORKER_MULTIPROC_METHOD"] = "spawn"几个条件的动机值得逐条说明:
- CUDA 已初始化 → 必须 spawn。这是库使用场景最常见的触发:用户脚本先
import torch; torch.zeros(1, device="cuda"),再构造LLM(...)。父进程的 CUDA context 已经存在,fork 出的子进程继承了一个不可用的 context 句柄。日志里那句 “CUDA is initialized” 就是给这种情况准备的。 - 在 Ray actor 里 → 必须 spawn,因为 Ray 的 actor 进程内部状态复杂,而且 spawn 后子进程需要
RAY_ADDRESS才能重新连上 Ray 集群(fork时环境变量本来就会继承,但spawn时也需要显式设置,所以这条代码同时做了两件事)。 - NUMA 绑定 → 必须 spawn。这一条比较隐蔽:vLLM 的 NUMA 绑定是通过把子进程的可执行文件替换成
numactl包装实现的(exec 劫持),而fork路径下是直接复制地址空间的,没有 exec 的机会。 - WSL → 必须 spawn,因为 WSL 下 fork 与 NVML 不兼容。
而用 vllm serve 命令行启动时,父进程完全可控,所以 vLLM 在 CLI 入口里直接选 spawn,避免继承任何状态。
$ vllm serve ... -tp=4(1) CLI 入口设置 VLLM_WORKER_MULTIPROC_METHOD=spawn(2) EngineCore 构造 -> MultiprocExecutor._init_executor(3) set_multiprocessing_worker_envs(num_local_procs) # 设置 OMP_NUM_THREADS 等(4) get_mp_context() # 返回 spawn 上下文(5) 依次/并行创建 4 个 WorkerProc 子进程(6) 每个子进程 import vLLM、init_device、load_model,向父进程报 READYset_multiprocessing_worker_envs 里有一处和 fork 有关的细节:它会提前算好每个 worker 应该用的 OMP_NUM_THREADS 写进环境变量。原因是 torch.set_num_threads() 会立即创建线程池,如果在 worker 启动中途才设置,会与共享库的 dlopen 竞争,或者在 fork 的 worker 里死锁。与之配合,get_mp_context() 在确定启动方法是 fork 时,会先调用 _release_libgomp_threads() 让父进程的 OpenMP 线程池在 fork 前退出——libgomp 不是 fork-safe 的,带着它 fork 出的子进程可能在第一次进入并行区时卡住。
还有一个细节是并行启动:_start_workers_concurrently 会把多个 worker 的创建并发进行,因为 spawn 最慢的部分是每个子进程重新 import vLLM 的加载时间,串行启动 8 个 worker 时这 8 份 import 时间会累加,并行之后主要耗时只剩最长的那一份。但它的启用条件是严格的:
def _can_start_workers_concurrently(self, inherited_fds): return ( inherited_fds is None # 必须是 spawn and self.local_world_size > 1 and not current_platform.is_cpu() # CPU 后端要按 rank 设置 OpenMP 环境 and not self.parallel_config.numa_bind # numactl 包装要按 worker 改环境与可执行文件 )注释里点明了原因:fork 路径下 inherited_fds 要在 worker 之间逐个累积(下一个 worker 需要显式关闭前几个 worker 的 pipe),这个累积天然是串行的;CPU 后端与 NUMA 绑定都会按 worker 修改进程级全局状态(os.environ、multiprocessing 的“可执行文件”设置),多线程同时改就会互相踩。所以“并行启动”只在“spawn、非 CPU、非 NUMA 绑定”时使用。这再次说明启动方法的选择不只是性能问题,而是决定了整个创建流程能不能安全并行。
四、MultiprocExecutor:父进程负责什么
4.1 父进程手里的资产
MultiprocExecutor._init_executor() 的主干如下(省略日志与错误处理):
tp_size, pp_size, pcp_size = self._get_parallel_sizes()assert self.world_size == tp_size * pp_size * pcp_size
num_local_procs = self.local_world_size * max(1, parallel_config.data_parallel_size_local)set_multiprocessing_worker_envs(num_local_procs)
if aiter_requires_tcp_store(): distributed_init_method = get_distributed_init_method(get_loopback_ip(), get_open_port())else: distributed_init_method = get_file_store_init_method()
# 1) 创建广播队列(只有本 DP rank 的 leader 节点)if parallel_config.node_rank_within_dp == 0: self.rpc_broadcast_mq = MessageQueue( self.world_size, self.local_world_size, max_chunk_bytes=..., connect_ip=get_ip(), ...) scheduler_output_handle = self.rpc_broadcast_mq.export_handle()
# 2) 创建 worker 子进程,等所有 READY...self.workers = WorkerProc.wait_for_ready(unready_workers)
# 3) 收集每个 worker 的回传队列句柄self.response_mqs = [...]for mq in self.response_mqs: mq.wait_until_ready()这段代码里有几个概念第一次出现,需要逐个解释:
world_size:模型并行的 GPU 数,即TP × PP × PCP。DP 不在这里——每个 DP rank 都是独立的引擎副本,各自有一个 MultiprocExecutor。DP 的大小体现在“有几个这样的执行器”。local_world_size:本节点上属于这个执行器的 worker 数。单机时等于world_size,跨机时小于world_size。它由world_size // nnodes_within_dp得来,而不是“数一下本机有几张卡”——所以卡数规划错误(例如某节点少装了一张卡)会在启动时以进程组规模不匹配的形式暴露出来。node_rank_within_dp:在 DP 分组里,本节点是第几个;只有 0 号节点负责建广播队列,其余节点上的 worker 通过远端订阅接入。distributed_init_method:PyTorch 分布式初始化(rendezvous)的方法。vLLM 用file://或tcp://两种,不是env://。原因简单:env://要求所有 rank 都拿到同一组MASTER_ADDR/MASTER_PORT环境变量,而 vLLM 用 spawn 起子进程,环境变量虽然会继承,但更干净的做法是把一个字符串作为参数直接传给子进程——一个文件路径或tcp://ip:port字符串。
关于 file:// 与 tcp:// 的选择:默认用 FileStore——在一个共享文件系统路径(默认 /tmp 下构造的路径)上建 rendezvous 文件,不占端口,也没有端口冲突风险。但如果后端是 aiter(AMD 环境下某些通信库需要 TCP store),则改用 tcp://。FileStore 有一个实际限制:所有节点必须能访问同一路径,所以跨机时若 /tmp 不共享会被迫用 TCP。
4.2 为什么需要一个“广播队列”而不是每步发 N 条消息
每步的 SchedulerOutput 对 同组所有 rank 是同一份(除了少数按 rank 拆的元数据)。如果父进程对每个 rank 单独 send 一次,那么在 tp=8 时,同一份可能几 MB 的消息要被序列化并传输 8 次。消息队列 MessageQueue 的设计是 单写多读:父进程 enqueue 一次,本机所有 reader 从共享内存环形缓冲里各自读取,跨机 reader 通过 ZMQ 订阅 pub/sub 收到的也是同一份字节。
所以父进程手里的核心资产只有两样:
- 一个广播队列
rpc_broadcast_mq,作为整个组的输入通道; - 一组回传队列
response_mqs,每个 rank 一条,因为每个 rank 的输出可能不同(尽管通常只有output_rank的输出会被使用)。
五、WorkerProc:子进程的一生
5.1 构造顺序
worker 子进程的入口是 WorkerProc.worker_main。它按以下顺序执行:
- 重新配置日志、设置
SIGTERM/SIGINT处理(收到信号置shutdown_requested,并抛SystemExit;SystemExit只抛一次,以免退出过程中抛到__del__里); - 关闭父进程传给它的“不归自己管”的 pipe fd(
inherited_fds)——这一步在 fork 下有重要意义,见 5.3; - 构造
WorkerProc:包装一个WorkerWrapperBase,init_worker、init_device、load_model; - 根据分到的 rank 初始化消息队列;
- 启动死亡监控线程;
- 向父进程通过
ready_pipe发送{"status": "READY", "handle": ...}; - 进入
worker_busy_loop()。
WorkerProc.__init__ 的顺序尤其值得注意:
self.worker.init_device() # 设置设备、初始化 NCCL 与并行组self.setup_proc_title_and_log_prefix(enable_ep=...) # 并行组初始化后再取名字if envs.VLLM_ELASTIC_EP_SCALE_UP_LAUNCH: self.worker.elastic_ep_execute("load_model")else: self.worker.load_model()...self._init_message_queues(input_shm_handle, vllm_config) # 必须在 init_device 之后init_device在load_model之前:权重加载需要知道自己在哪个 rank、要切哪些 head、要复制哪些专家。- 消息队列的初始化在
init_device之后:跨机(nnodes_within_dp > 1)时,worker 需要借助已经建好的并行组获取create_mq_broadcaster的句柄,并行组没建好之前拿不到。 - 进程标题在并行组初始化前后各设一次:
init_device之前只知道全局rank,标题只能是Worker;之后才知道 DP/PP/TP/EP 各维度的 rank,标题变成Worker_DP0_PP0_TP3这样,日志前缀也改成同样的名字。《DeepInfer 源码拆解(二十四):NUMA 绑核与 CPU 亲和》讲过推理进程与 CPU 亲和的关系,vLLM 这一层同样在进程创建时通过numa_utils.configure_subprocess申请了绑定。
5.2 父进程如何等待“全部就绪”
子进程初始化失败时,父进程不能傻等。所以每个子进程有一个 ready_pipe(单向 pipe,子写父读)。wait_for_ready 的实现是:
pipes = {handle.ready_pipe: handle for handle in unready_proc_handles}while pipes: ready = multiprocessing.connection.wait(pipes.keys()) for pipe in ready: unready_proc_handle = pipes.pop(pipe) response = pipe.recv() # EOFError 表示子进程死了,立刻抛异常 if response["status"] != "READY": raise e idx = unready_proc_handle.rank % len(ready_proc_handles) ready_proc_handles[idx] = WorkerProc.wait_for_response_handle_ready(response, unready_proc_handle) pipe.close()它不按 rank 顺序等,而是“谁先好谁先报”,用 multiprocessing.connection.wait 同时监听所有 pipe。任何子进程的 pipe 出现 EOFError(进程退出、pipe 关闭)都会立刻抛出异常,因为正常初始化的子进程在发完 READY 之后才会关闭 ready_writer。这就是为什么开头那句注释说“必须先创建所有 worker 再 wait_for_ready,否则 init_device() 里的设备同步会死锁”:如果串行地“建一个等一个”,第一个 worker 在 init_device 里等 NCCL 或进程组,而其他 worker 还没被创建,父进程又卡在等第一个——形成一个没有人能满足的循环。
5.3 death pipe 与 fd 继承
子进程如何知道父进程已经死了?death_pipe:子进程持 death_reader,父进程持 death_writer。父进程若正常退出会关闭 death_writer,但如果父进程被 kill -9,pipe 也会被内核关闭,子进程的 death_reader.recv() 收到 EOFError,进入 death_pipe_monitor:
def death_pipe_monitor(queues_to_shutdown): try: death_pipe.recv() except EOFError: logger.info_once("Parent process exited, terminating worker queues") get_watch_dog().handle_failure("shutdown") shutdown_requested.set() for mq in queues_to_shutdown: mq.shutdown()然后 worker 以 shutdown 状态退出。这条路径保证了父进程异常退出后不会有遗留的 worker 进程继续占着 GPU——这一点在容器化的推理服务里很实际:supervisor 重启引擎时,最怕看到旧 worker 还挂着显存。
inherited_fds 是 fork 路径下的另一个隐患。fork 之后,子进程会继承父进程在这一刻打开的所有 fd,包括前面已经创建的 worker 的 death_writer 与 ready_pipe。于是第二个 worker 手里拿着第一个 worker 的 death_writer——即使父进程正常关闭了它,第一个 worker 的 death_reader 也不会收到 EOF,因为第二个 worker 还开着写端。结果就是:父进程退出后第一个 worker 永远不退。vLLM 的做法是让每个子进程在入口处显式关闭自己不该持有的 fd:
for fd in kwargs.pop("inherited_fds", []): try: os.close(fd) except Exception: ...这是一个典型的“fork 会继承不该继承的东西”的坑,spawn 路径因为不复制 fd 表,没有这个问题(代码里 inherited_fds 在 spawn 时是 None)。
六、消息队列:把一份计划送到 N 个进程
6.1 一写多读的共享内存环
vllm/distributed/device_communicators/shm_broadcast.py 的 MessageQueue 把读者分成两类:
- 本机 reader(
local_reader_ranks):直接从一块ShmRingBuffer共享内存里读取。写方把一条消息写进环形缓冲的一个 slot,此时先把所有 reader 的“已读”标志清 0,再把该 slot 的“已写”标志置 1;reader 读完后把自己的“已读”标志置 1。写方在写入某个 slot 之前,先检查它是“未写”还是“已被所有 reader 读完”。 - 远端 reader:通过 ZMQ 的
XPUB/SUB发布订阅接收。写方对每条消息,只要存在本机 reader 就往共享内存里写一份,只要存在远端 reader 就remote_socket.send_multipart发一份;如果消息总长超过max_chunk_bytes,共享内存里只写一个“溢出”标记,内容全部走 ZMQ。
要注意的是,本机 reader 也不是“共享内存里就是全部”:当消息溢出时,本机 reader 同样要从本机的 XPUB/SUB(ipc:// 地址)上收大消息。也就是说,无论是本机还是远端,大消息都走发布订阅,只有小消息走零拷贝的共享内存环。
环形缓冲的内存布局直接从 ShmRingBuffer 的文档字符串里看最清楚:
data metadata | | | (current_idx) | (current_idx) v v+-------------------------------+----------------------------------------+| chunk0 | chunk1 | ... | chunk | metadata0 | metadata1 | ... | metadata |+-------------------------------+----------------------------------------+每个 slot 的 metadata 是 n_reader + 1 个 int:第 0 个是“已写”标志,后 n_reader 个是每个 reader 的“已读”标志。写方用自旋 + sched_yield 等待;memory_fence() 保证先重置各 reader 的已读标志,再把 written_flag 置 1,防止弱内存序的 CPU 上 reader 先看到 written 再看到旧的已读标志。这个“先清零后置位”的顺序在代码里有明确注释,是这套无锁环的正确性根基。
这种结构的最大的好处是:小消息一写多读,拷贝只发生一次。SchedulerOutput 的绝大多数字段(请求 ID、块表、每个请求本轮要跑几个 token)都是小对象,正好落在 ring 里;真正大的东西(1024 条请求的 grammar bitmask)走 ZMQ 发布订阅,一次 send_multipart 也是所有本地与远端订阅者共享同一批字节,而不是每个进程各发一份。默认 max_chunk_bytes 是 24MiB,注释里写明 “chosen to be large enough to accommodate grammar bitmask tensors for large batches (1024 requests)”。
enqueue 的序列化还有一层优化:它用 pickle.Pickler 的 buffer_callback,把大于 1MiB 的 out-of-band 缓冲(例如大的 bytes 或 CPU 张量)单独列为 all_buffers 的后续元素,不拷进 pickle 字节流本身;dequeue 时用 pickle.loads(all_buffers[0], buffers=all_buffers[1:]) 把外带缓冲重新挂上。CPU 张量通过 _reduce_tensor 注册到 pickler 的 dispatch table,以 out-of-band 形式发送。这是 Python 标准库自带的零拷贝机制,vLLM 只是把它用在了自己的 RPC 上。
6.2 句柄传递与握手
子进程怎么知道共享内存在哪里?父进程不能直接传一个 MessageQueue 对象(带的是 ZMQ socket 和 shm 的 fd 引用,fork 时还行,spawn 时完全不可序列化到另一个进程可用)。所以 MessageQueue.export_handle() 只导出位置信息:
Handle(local_reader_ranks, buffer_handle, local_subscribe_addr, local_notify_addr, remote_subscribe_addr, remote_addr_ipv6, tensor_arena_handle)buffer_handle是共享内存的名字与形状;local_subscribe_addr是本机 ZMQipc://端点(用于溢出消息);remote_subscribe_addr是对外的tcp://端点;local_notify_addr是通知事件的ipc://端点(reader 自旋之外的轻量唤醒)。
子进程用 MessageQueue.create_from_handle(handle, rank) 重新“连上”这条队列,并根据 rank in handle.local_reader_ranks 判断自己是本机读还是远端读。因此握手有两个方向的需求:
- 父进程需要子进程的回传队列句柄,才能读结果;
- 写方(父进程)需要知道所有 reader 都已经订阅上,才能开始写——否则第一条消息会丢。
vLLM 用 wait_until_ready() 解决了后者:写方等待所有 reader 的订阅计数到位。这是一个对顺序敏感的屏障:子进程必须先 SUB 订阅远端 socket,再 wait_until_ready;父进程必须等所有子进程报 READY,再 wait_until_ready。代码注释写着 “Will deadlock if re-ordered”,两处(父进程与子进程)的注释完全一致,因为这是一个跨进程的契约,只能靠两边都遵守。
6.3 回传:为什么每个 rank 一条队列
response_mqs 是每个 rank 一条。原因有两个:
- 结果需要“按 rank 区分”,因为不同 rank 的输出可能不同(例如 PP 最后一段的 rank 才有有效 logits,KV connector 会让每个 rank 返回自己的 KV 输出);
- 结果需要“非阻塞地取”,
FutureWrapper包装一条结果队列的读取,future.result()时才真正dequeue。这使得异步调度可以在前向还没回来时继续做下一轮的 CPU 侧工作。
FutureWrapper.result() 的实现是懒取:result 被调用时才 _wait_for_response,也就是按 get_response() 逐个从对应的队列 dequeue。这里的超时是按 deadline 计算的:每次 dequeue 的超时是“总 deadline 减去已经花掉的时间”,而不是每一条都重新给一个完整超时。
七、execute_model 与 collective_rpc:RPC 的两种语义
7.1 广播 vs 单点收集
MultiprocExecutor.execute_model 只是 collective_rpc 的一层包装:
def execute_model(self, scheduler_output, non_block=False): return self.collective_rpc( "execute_model", args=(scheduler_output,), unique_reply_rank=self.output_rank, non_block=non_block, timeout=envs.VLLM_EXECUTE_MODEL_TIMEOUT_SECONDS, kv_output_aggregator=self.kv_output_aggregator, ec_output_aggregator=self.ec_output_aggregator, )关键参数是 unique_reply_rank。当它不为 None 时:
- 消息里打包的
output_rank就是该 rank; - 父进程只对这一个 rank 的
response_mq做dequeue,其余 rank 的队列不碰; - 因此 worker 侧
_execute_worker_rpc只在output_rank is None or self.rank == output_rank时才回传结果。
其他 rank 仍然必须执行这次 RPC——广播队列是单写多读,所有 reader 都会读同一条消息、都会执行 execute_model;只是不回传。这点很重要:TP 的每个 rank 都要跑它那一份计算,TP 之间的 NCCL 通信会在 execute_model 内部完成。如果只在 output_rank 上执行,NCCL 会因为有人没进通信而挂住。
output_rank 怎么确定?_get_output_rank() 一般选最后一个 PP stage 的一个 rank(PP 场景),再加上 DP 内 leader 节点的约定。对单机 TP、无 PP 的情况就是 0。
当需要聚合结果时(例如带 KV connector 时,除了模型输出,每个 rank 还可能有自己的 KV 传输状态),unique_reply_rank 不能只看一个:collective_rpc 改成读取所有 rank 的回传,然后用 KVOutputAggregator.aggregate(outputs, output_rank) 把每个 rank 的 connector 输出合并到 outputs[output_rank] 上。这一层已经在《vLLM 源码完全拆解(十七):KV Connector》里讲过,本篇只需知道它是执行器级聚合,而不是调度器自己去做。
7.2 collective_rpc 的三段
method, args, kwargs, output_rank = ...self.rpc_broadcast_mq.enqueue((send_method, args, kwargs, output_rank))
response_mqs = self.response_mqs if output_rank is None else (self.response_mqs[output_rank],)
def get_response(): for mq in response_mqs: status, result = mq.dequeue(timeout=...) # SUCCESS / FAILURE / FAILURE_WITH_KV_OUTPUT ...
future = FutureWrapper(self.futures_queue, get_response=get_response, aggregate=aggregate)return future if non_block else future.result()有几处值得展开:
method可以是字符串,也可以是函数。字符串是 worker 的同名方法;函数会先cloudpickle.dumps成字节,在 worker 里再反序列化,并绑定到self.worker上执行:partial(cloudpickle.loads(method), self.worker)。这个能力让 KV connector、weight updater 等组件可以把自定义闭包发到所有 worker 执行,而不用改主类。self.futures_queue是父进程按发送顺序入队的一列 future。因为广播队列是有序的,所以子进程回复也是有序的;但是FutureWrapper的聚合发生在result()调用时,需要保证“先等的先取”。队列里记录了所有发送过的 future,FutureWrapper在执行get_response时若发现队列头不是自己,就要先从队列头开始按顺序取。这就是为什么non_block=True时要把 future 放进队列,而不是直接把它交给调用者。- 失败状态分三种:
SUCCESS、FAILURE、FAILURE_WITH_KV_OUTPUT。后者是 worker 在异步输出路径上同时有 KV 传输结果、又出现异常。这时如果不能容忍故障,直接抛;如果启用了容错,则把 KV 结果交给聚合器,再抛错。这说明在 worker 失败时执行器仍尽量让 KV 连接器“看到”已经发生的传输,避免对端等待超时。
7.3 worker 侧:dequeue-execute-reply
worker 的 worker_busy_loop 是一个“一进一出”的循环:
while True: with get_watch_dog().disable(): rpc_request = self.rpc_broadcast_mq.dequeue(indefinite=True) self._execute_worker_rpc(rpc_request) del rpc_request两个细节:
watch_dog在 dequeue 时被关闭:dequeue(indefinite=True)可能长时间阻塞(没有请求的时候),watchdog 是监督“计算是否超时”的,空闲时不应当被误杀;执行 RPC 时watchdog.feed()两次:一次在执行前,一次在执行后但序列化回传前,因为序列化大输出可能耗时,也可能超过超时窗口。_execute_worker_rpc与 dequeue 不在同一个栈帧里(del rpc_request),代码注释说这是为了让 RPC 执行帧更干净——调试时看到的调用栈更短。这是个细小的可维护性选择,但写在这里是因为以后遇到“worker 卡住时栈帧里全是调度代码”时,知道这些改动就是为此准备的。
异常处理路径同样重要:_execute_worker_rpc 捕获异常、加上完整 traceback、把它交给 handle_output,后者若 output_rank 匹配,就把它 enqueue 到回传队列;父进程在 get_response 里看到 FAILURE 状态,于是抛 RuntimeError。异常从子进程穿过消息队列回到父进程,再从父进程抛给调度器。这意味着日志里常常会看到两段堆栈:一段是 worker 的 traceback(通过消息传过来),另一段是父进程的 “One or more workers failed”。
7.4 异步调度下的输出线程
当 async_scheduling 打开时,handle_output 不是直接 enqueue,而是放进一个 queue.Queue,由 async_output_busy_loop 线程取走并 enqueue。为什么要一个线程?
- 主要因为在异步调度下,worker 的执行线程不能阻塞在结果的序列化与入队上,否则“计算→采样→回传”这条链会在回传环节串行化;
- 这个线程需要自己设置 CUDA 设备:注释明确写着“线程不会继承主线程的上下文,CUDA runtime 调用会隐式在 device 0 上创建新的 context,额外占显存”。于是
async_output_busy_loop一开始调用current_platform.set_device(self.worker.device),并注释说明这是为了与主线程共用同一个 context。
这是个非常典型的“Python 线程与 CUDA context 之间没有自动关联”的坑,读者如果自己写过基于线程的推理服务,应该很熟悉。
八、并行组:init_distributed_environment 之后的“拆组”
8.1 worker 的 init_device:先建世界,再建小组
GPUWorker.init_device 在设置好设备之后,在测量显存之前初始化分布式环境。代码注释写得很清楚:
# Initialize the distributed environment BEFORE taking memory snapshot# This ensures NCCL buffers are allocated before we measure available memoryinit_worker_distributed_environment( self.vllm_config, self.rank, self.distributed_init_method, self.local_rank, current_platform.dist_backend,)这个顺序直接决定了“可用 KV 显存”的准确性:NCCL communicator、cuBLAS handle 等固定开销都在快照之前建立,快照结果是真正可以留给 KV 池的显存。如果快照在前,NCCL 后来分配的显存就变成“未知的开销”,KV 池就可能超出预算。同一段代码里还主动执行了两次 torch.mm 和 F.linear,为了触发 cuBLAS/cuBLASLt handle 的分配——注释解释了原因:“torch 自己的 cudaMalloc 失败时会自动清空缓存重试,但 cuBLAS 自己向 CUDA 申请的句柄内存 torch 看不到;profile 把缓存撑满后,第一次 cuBLAS 调用就会失败”。这些都是分布式启动阶段与显存预算交叉的地方。
init_worker_distributed_environment 做两件事:
init_distributed_environment(world_size, rank, init_method, local_rank, backend, timeout)ensure_model_parallel_initialized(tp, pp, pcp, dcp)第一步创建 WORLD 组(一个包含整个执行器全部 rank 的 PyTorch ProcessGroup),第二步在 WORLD 之上切出 TP/PP/PCP/DCP/DP/EP/ETP/EPLB 各个子组。
8.2 DP 对 world 的改写
init_distributed_environment 里有一处会被误解的改写:当 nnodes > 1 或 data_parallel_size > 1 时,它把 world_size 换成 world_size_across_dp = world_size × dp_size,把 rank 换成 dp_rank × world_size + rank。也就是说,WORLD 组是跨 DP 的全体进程,不只是 TP/PP/PCP。
这很容易让人以为“TP 组也跨 DP 了”。不是。真正的拆组在 initialize_model_parallel 里,用的是 parallel_config.data_parallel_size,而不是 WORLD 的规模。
8.3 initialize_model_parallel:一次 reshape 加 transpose 拆出所有组
这是整篇里最值得逐行读的一段,因为它把五个维度的组在十几行里全部定义完。核心是把 GPU 的全局编号排列成一个多维张量:
# layout order: ExternalDP x DP x PP x PCP x TPall_ranks = torch.arange(world_size).reshape( -1, data_parallel_size, pp_size, pcp_size, tp_size)reshape 的语义是“按维度顺序填充”:最后一维变化最快。所以连续的 tp_size 个 rank 是同一 TP 组;tp_size 之后的下一组是另一个 TP 组,等等;当 TP 维走完一轮,PCP 维加一;PCP 走完一轮,PP 维加一;PP 走完,DP 维加一。这正是 vLLM 的约定:同一 TP 组的 GPU 全局编号连续,同一 PP 组的是跨 TP 间隔的编号。
要拆出某个维度的组,只需把这个维度挪到最后一维,然后按该维度大小 reshape:
| 组 | 操作 | 结果 |
|---|---|---|
| TP | all_ranks.view(-1, tp_size) | 连续 tp_size 个一组 |
| PCP | all_ranks.transpose(3, 4).reshape(-1, pcp_size) | 同一 TP 索引下、相邻 PCP |
| PP | all_ranks.transpose(2, 4).reshape(-1, pp_size) | 同一 TP/PCP 索引下、相邻 PP |
| DP | all_ranks.transpose(1, 4).reshape(-1, dp_size) | 同一 TP/PCP/PP 索引下、相邻 DP |
| EP | all_ranks.transpose(1, 2).reshape(-1, dp×tp×pcp) | 同一 PP/TP 索引下,跨 DP、PCP、TP 的全部专家 |
| EPLB | 与 EP 相同的 rank 集合,但另建一个独立组 | 把负载均衡通信与 MoE 前向通信隔离 |
| DCP | 若 dcp_size>1 先 transpose(-1, -2) 再 reshape | 跨 PCP 再到 TP |
这就是官方注释里那个例子:
8 GPUs,TP=2,PP=4:TP 组: [g0,g1] [g2,g3] [g4,g5] [g6,g7]PP 组: [g0,g2,g4,g6] [g1,g3,g5,g7]为什么 PP 组是 g0,g2,g4,g6? 因为 all_ranks 的 PP 维是 (-1, DP, PP, PCP, TP) 中索引 2 的那一维;把索引 2 和 4 交换后,PP 是最后一维,reshape 之后每个 PP 组包含“固定 TP 索引、PP 从 0 到 3”的四个 rank。这正是 TP=2、PP=4 时把 8 张卡切成 4 段流水线、每段 2 张卡的布局。PP 组里的相邻两个 rank(同一段)编号相差 2,说明 TP 组是“连续编号”的。
为什么要求 rank 0..7 在同一台机器上? 因为如果 TP 组跨机器,每一层 all-reduce 都会跨网络;如果 PP 组跨机器,相邻 PP 段之间的激活传输跨网络,而每段内部 TP 通信则留在本机。vLLM 的文档明确写着 “for efficiency, the caller should make sure adjacent ranks are on the same DGX box”。所以启动时怎么给每个 rank 分配 IP、怎么保证连续编号落在同一节点,是部署规划的一部分。
GroupCoordinator 为每个组同时创建两个 PyTorch 组:
device_group = torch.distributed.new_group(ranks, backend=nccl, timeout=device_timeout)with suppress_stdout(): cpu_group = torch.distributed.new_group(ranks, backend="gloo", timeout=cpu_timeout)为什么每个组要两套?因为有些集体通信是控制面的:例如 EPLB 在负载均衡时只交换小整数、broadcast_object 传的是 Python 对象、以及各种 barrier 只需要 CPU 参与——这些在 CPU 上做更安全(不占 GPU stream、不需要设备同步),而 gloo 只能走 CPU。真正的前向通信(TP 的 all-reduce、EP 的 all-to-all)走 NCCL device group。两个组共享同一批 rank,于是同一拓扑上可以按“数据面 / 控制面”选择通道。
每个组还可能有自己的 device_communicator:TP 组通常用 CustomAllreduce 替换 NCCL 的 all-reduce。CustomAllreduce 的约束值得记录:
- 支持的 world_size 是
[2, 4, 6, 8, 16]; - 要求同节点的所有 GPU 两两 P2P 可达(
gpu_p2p_access_check); - 跨节点时只有在全部 rank 都是 Blackwell 级(compute capability ≥ 100)并且具备 MNNVL 多播能力的 NVLink 域内才会启用;
- 单卡或不满足条件时静默回退到 torch NCCL,日志里给 warning。
initialize_model_parallel 里 TP 组(以及 DCP 组)还带了一个 use_message_queue_broadcaster=True:GroupCoordinator 会额外用 cpu_group(gloo 组)建一条 MessageQueue,大小为 4MiB、6 个 chunk。它接管了 GroupCoordinator.broadcast_object 的路径——所有 broadcast_object 调用(例如给每个 rank 同步采样种子、draft token ids 这类 Python 对象)不再走 torch.distributed.broadcast_object_list,而是从 rank 0 一次 enqueue、各 rank 从共享内存环里读取。限制也写在断言里:这条通道只支持 src=0。在 TP=1 时不创建、直接返回。
8.4 DP 的组是另一种东西
需要注意 _DP 组:在非弹性 EP 模式下它也是 torch.distributed.new_group 建的普通组,但这并不代表 DP 的调度器之间 用它通信——DP 的 engine core 之间用的是 stateless_init_dp_group 创建的无状态组(不依附于 WORLD),因为 DP 的 engine core 可能不是同一个进程组的成员。这在 DPEngineCoreProc._init_data_parallel 里:
dp_group, dp_store = parallel_config.stateless_init_dp_group(return_store=True)为什么需要无状态组?因为当 DP 的 engine core 分布在多个节点上时,如果都走 WORLD 的 rendezvous,就要让所有 DP rank 的所有 worker 都参与同一次 WORLD 初始化——但每个 DP rank 有自己的进程、自己的初始化时机,混合在一起会让世界规模变成 world_size × dp_size,同步点更重、失败面更大。无状态组用同一个 TCPStore 作为协调点,只连 DP rank 之间的少数进程。
九、Ray 路径:在 mp 之上替换“子进程”
9.1 设计上发生了什么
RayExecutorV2 继承 MultiprocExecutor,复用了整个 collective_rpc、FutureWrapper、WorkerProc.worker_busy_loop 等逻辑。差异集中在 _init_executor() 里:
initialize_ray_cluster(parallel_config)连接 Ray 集群,创建或复用 placement group;- 根据 placement group 的 bundle 到节点映射,给每个 rank 分配一个 bundle;bundle 的节点就是 worker 要跑的位置;
- 父进程创建
rpc_broadcast_mq,n_local是与 engine core 同节点的 bundle 数——其余 rank 走 TCP; - 每个 rank 起一个
RayWorkerProcactor,num_cpus=0(不占 CPU 资源配额),绑定到对应 bundle; - 等 actor 起来,询问每个 actor Ray 实际分给它的物理 GPU ID(
get_accelerator_ids); - 计算每台节点上的 local_rank(该 rank 在本节点所有 worker 中的序号),并把“本节点的 GPU ID → 逻辑 local_rank 映射”传给
initialize_worker; - 由 rank 0 的 actor 创建 rendezvous(
TCPStore(port=0)然后返回tcp://host:port); - 所有 actor
initialize_worker(...),然后run(),再wait_until_ready()。
和 mp 相比,Ray 路径的通信机制没有变:还是共享内存环 + ZMQ。真正不同的是:
- 进程的父进程:mp 下是 engine core;Ray 下是 Ray 的 worker 进程(一个长期存在的“Raylet”管理的执行器);
- GPU 的可见性:mp 下 worker 通过
CUDA_VISIBLE_DEVICES看到逻辑编号;Ray 下 engine core 在创建 actor 时设置了RAY_EXPERIMENTAL_NOSET_CUDA_VISIBLE_DEVICES,Ray 不再改写CUDA_VISIBLE_DEVICES,而是由 vLLM 拿到物理 GPU ID 后通过assigned_physical_gpu_ids映射到逻辑 local rank。
9.2 为什么要绕开 CUDA_VISIBLE_DEVICES
CUDA_VISIBLE_DEVICES 是进程启动时读取的。Ray 默认的做法是:给每个 actor 设置一份 CUDA_VISIBLE_DEVICES,让 actor 里只能看到自己那张卡,这样 actor 内部直接用 cuda:0 即可。问题在于这种“启动时改写”在多实例共存时会冲突:节点上同时有多个 vLLM 实例(各自请求一部分 GPU),每个实例的 actor 都要设 CUDA_VISIBLE_DEVICES,但 Ray 给每个 actor 设的是它自己拿到的卡;不同实例之间只要它们不重叠,好像没问题——真正的冲突来自 vLLM 自己的一些子进程(如 NUMA 绑定、fork 出来的 CUDA 上下文初始化)需要看到同一实例内全部卡,而 Ray 只给单卡可见。另外,placement group 可以被外部管理,vLLM 未必能在创建 actor 的那一刻知道 bundle 对应哪张物理卡。
vLLM 的解法是“不依赖环境变量,改为显式映射”:
- Ray 拿到
get_node_and_physical_gpu_ids(),然后RPC给每个 actor 告诉它自己的逻辑 local rank; - actor 把每张物理卡映射到逻辑
cuda:{local_rank}; torch.accelerator.set_device_index(device)在一个可见多卡的进程里选择设备。
这个映射的副作用是多实例可以共存于同一节点:每个实例只使用自己 placement group 里的 bundle,不通过 CUDA_VISIBLE_DEVICES 互相干扰。代价是 vLLM 要自己管映射,而 CUDA_VISIBLE_DEVICES 这条路在 mp 下仍然是默认做法。
9.3 跨机时 Ray 与 mp 的真正区别
从功能上看,跨机部署 mp 已经能做:
- 每个节点上启动一个 engine core(
--nnodes=N --node-rank=i); - 0 号节点的 worker 承担 leader 角色,负责广播队列;
- 其他节点的 worker 通过 TCP 订阅广播队列、通过 TCP 回传结果;
- 进程组的 rendezvous 用
master_addr/master_port(mp 跨机时init_distributed_method自动变成tcp://)。
Ray 的价值在于:
- 资源调度:Ray 负责把 actor 放到有 GPU 的节点上,处理节点故障探测、资源不足重试;
- placement group:多个实例共享集群时,Ray 保证一个实例的 bundle 不会被另一个实例打断;
- 统一日志/指标:Ray dashboard 能看到每个 actor 的状态;
- 弹性与多租户:外部 Ray 集群可以统一管理多组推理任务。
而 mp 路径的价值是零额外依赖、零调度开销、最短启动链路:不需要装 Ray、不需要起 Ray 集群、不需要 GCS,几个进程直接起来。两者的 worker 内部代码完全一样(RayWorkerProc 继承 WorkerProc),只是在“谁创建进程、谁分配 GPU、谁等就绪”这三件事上不同。
一个容易忽略的点:Ray 路径不适用于所有平台/设备。current_platform.ray_device_key 为空时直接报错;TPU 平台通常走 Ray(XLA SPMD 模式下走 uni);CUDA 与 ROCm 两者都支持。aiter_requires_tcp_store() 为真时,mp 路径被迫使用 TCP Store,而 Ray 路径一直用 TCP Store——这也是为何 Ray 的 create_dist_init_method 总是起 TCPStore。
十、DP 多引擎:当调度器本身也要成组
DP 不是把调度器复制一下那么简单。DPEngineCoreProc 是 engine core 的 DP 版本,每个 DP rank 一个,它们的调度器各自独立,但每一步都要一起走:
executed = self._process_engine_step()self._maybe_publish_request_counts()
local_unfinished_reqs = self.scheduler.has_unfinished_requests()if not executed: if not local_unfinished_reqs and not self.engines_running: continue elif not self.model_executor.is_sleeping: with self.capture_iteration_details(None) as iteration_details: self.execute_dummy_batch() # 空转一步,保证与别人同步...self.engines_running = self._has_global_unfinished_reqs(local_unfinished_reqs)三个机制在这里联合工作:
- wave:DP 的请求被组织成“波(wave)”。同一波里的请求需要所有 DP rank 同步推进,因为 EP/DP 的通信要同步参与。
data_parallel_rank的 engine core 把请求按 wave 分配,current_wave记录当前波号。 - dummy batch:如果某个 rank 这一轮没有要执行的请求,但它不能直接跳过——其他 rank 的 EP all-to-all 还在等它。于是它执行一个 dummy batch(空批前向),以保持通信对齐。这就是
execute_dummy_batch存在的意义。 _has_global_unfinished_reqs:一步结束后所有 DP rank 一起 all-reduce,只有全局都没有未完成请求时才同步停机(engines_running=False)。如果只有本地没有请求,就继续以 dummy batch 跟随全局。
控制面上的 START_DP_WAVE 由 _handle_client_request 处理:某个 rank 来了新请求时,它把“新波号 + 发起者索引”发给其他 rank,其他 rank 若 new_wave >= current_wave 就进入 engines_running 并开始步进;ignore_start_dp_wave 为真时则丢弃这些消息,避免暂停过程中被旧消息重新唤醒。暂停则是两阶段:先设 pending_pause,等所有 rank 都设好(通过 all-reduce 确认),再集体停;否则一个 rank 停了、其他 rank 还在跑,一次 all-to-all 就可能挂死。《GLM-5.3 推理全链路(十九):负载账本与慢 rank》讨论过 DP 的负载不均衡如何把单卡延迟放大到全局 step——这里从代码上看到了它的根:DP 的同步步调要求所有 rank 的时钟被最慢的那个对齐,dummy batch 只是在等待期间“占位”,不解决不均衡问题。
十一、一次启动的完整时间线
把前面所有片段串成时间线,以单机 8 卡 -tp=8 的 mp 部署为例:
| 时刻 | 进程 | 做了什么 |
|---|---|---|
| t0 | API server | 加载配置、创建 EngineCoreClient,准备通过 ZMQ 与 engine core 通信 |
| t1 | engine core | 创建 EngineCore;Executor.get_class → MultiprocExecutor(world_size=8,单机 8 卡,默认走 mp) |
| t2 | engine core | set_multiprocessing_worker_envs(8):OMP_NUM_THREADS 提前写好;get_mp_context(),CLI 下是 spawn |
| t3 | engine core | 创建 rpc_broadcast_mq(8 读者、8 本机)、导出 Handle |
| t4 | engine core | 并行起 8 个子进程,每个传 distributed_init_method(file://...)、input_shm_handle、ready_pipe、death_pipe |
| t5 | 8 个 worker | 每个 import vLLM;init_device → 设置设备、init_distributed_environment(WORLD,8 rank)+ ensure_model_parallel_initialized(TP=8 的组,因为 TP=8 时 TP 组就是 WORLD);load_model |
| t6 | 8 个 worker | _init_message_queues:从 Handle 里映射环形缓冲,订阅 ZMQ,建回传队列;向 ready_pipe 写 READY |
| t7 | engine core | wait_for_ready:收到 8 个 READY,收集 8 个回传队列句柄;rpc_broadcast_mq.wait_until_ready();response_mqs.wait_until_ready() |
| t8 | engine core | EngineCore._initialize_kv_caches:collective_rpc("get_kv_cache_specs") → 各 rank 的 determine_available_memory(已经扣除了 NCCL 与 cuBLAS 的基线)→ 算出 KV 块数 → initialize_from_config 让每个 worker 切池 |
| t9 | engine core | collective_rpc("compile_or_warm_up_model"):CUDA Graph 捕获(可参考 CUDA Graph 的桶与垫) |
| t10 | API server/engine core | 第一条 add_request → EngineCore.step() → execute_model → 广播 → 8 个 worker 各自前向 → rank 0 回传 → sample_tokens → 调度器更新 |
注意 t5 的细节:当 TP=8 时,TP 组与 WORLD 组是同一批 rank,但仍然是两个 GroupCoordinator,因为 TP 组需要 device_communicator(CustomAllreduce)和 mq_broadcaster,WORLD 组不需要。当 TP=2、PP=4 时,WORLD 有 8 个 rank,而每个 TP 组只有 2 个,共 4 个 TP 组——这是 §8.3 的 reshape 拆组给出的。
十二、常见问题与“为什么”
12.1 启动时报错 “distributed_executor_backend must be a subclass of Executor”
说明 --distributed-executor-backend 传入了一个能被 import 但不是 Executor 子类的类。这是给扩展留的口子:传一个类名(qualname)会直接实例化。插件式的执行器(例如测试用例、自定义硬件)就是靠它接入,不需要改 get_class。
12.2 “world_size 大于本机 GPU 数” 与 --nnodes
默认后端选择逻辑在一个条件分支中明确处理了这个错误:
elif current_platform.is_cuda() and current_platform.device_count() < self.world_size: raise ValueError( f"World size ({self.world_size}) is larger than the number of " f"available GPUs ({gpu_count}) in this node. If this is intentional " "and you are using: - ray, set '--distributed-executor-backend ray'.\n" "- multiprocessing, set '--nnodes' appropriately.")也就是说,跨机时默认后端仍然是 mp(current_platform.is_cuda() and self.nnodes > 1 → backend = "mp"),必须显式设置 --nnodes;而如果有 Ray,也可以显式 --distributed-executor-backend ray。这个默认选择的逻辑现在(本篇文章写作时)与若干早期版本不同,读者如果在旧版本上看到的默认行为是 Ray,不要以旧日志为准。
12.3 Worker 启动很久才就绪
spawn 路径下每个 worker 都要重新 import vLLM(包括 torch、CUDA 扩展、FlashAttention/FlashInfer 等)。_start_workers_concurrently 的存在就是为了把 N 份 import 变成并行的 N 份。日志里如果看到 worker 一个接一个慢慢起,很可能是并行路径没生效(例如 fork 路径下需要顺序记录 inherited_fds,见 §5.3)。
12.4 kill 之后 GPU 显存没释放
如果 kill 的是 engine core 而不是整个进程组,worker 应该通过 death pipe 感知并退出。worker 以 daemon=True 创建,父进程正常退出时 Python 的 daemon 机制会顺带终止它们;但 kill -9 父进程时 daemon 机制来不及执行,只有 death pipe 能兜底。如果还是没退,先看 §5.3 的 fd 继承问题(fork 下其他 worker 持有本 worker 的 death_writer 会让 EOF 永远不到),再确认 kill 是否真的只打到了 engine core 而 worker 被 reparent 到 init。
12.5 为什么 determine_available_memory 每次都是 collective rpc
因为显存可用量取决于每个 rank 自己的设备、NCCL 缓冲、CUDA Graph 预留、每张卡上的上下文开销等。EngineCore._initialize_kv_caches 里读取返回的列表,然后按 最小值(或多个维度的分配规则)算 KV 池大小——所有 rank 要用等数量的 KV 块来同步,否则注意力内核里块表对不上。这正是 KV 块的三张映射表 讲过的“逻辑块号、物理块号、KV 槽号”在跨卡时的对齐要求。
小结
执行器是调度器与 GPU 之间的最后一层抽象,它把“一步前向”从一个函数调用扩展成一个跨进程、跨卡、可跨机的 RPC:
- 接口极窄:
execute_model、sample_tokens、collective_rpc、initialize_from_config四个方法覆盖了引擎需要的全部能力; - 后端选择:
uni、mp、ray、external_launcher,默认策略是单机 mp、跨机需显式--nnodes,Ray 只在显式或已经在 Ray 环境里时才使用; - 进程形态:engine core 是父进程,每张卡一个 worker 子进程;父进程是唯一的广播者,worker 是只读的消费者,只有
output_rank回传结果; - 通信机制:共享内存环形缓冲 + ZMQ pub/sub 的单写多读队列,跨机靠 TCP 订阅;每个 rank 一条回传队列,异步调度下用 future 懒取;
- 并行组:在 WORLD 之上用一个多维 reshape + 多次 transpose 切出 TP/PCP/PP/DP/EP/DCP,每个组同时有 NCCL 设备和 Gloo CPU 两套通道;
CustomAllreduce只在支持的规模与拓扑上启用,否则回退; - DP:多个独立引擎必须同频推进,用 wave、dummy batch 与全局 all-reduce 保证 EP 通信不死锁;
- Ray 路径:复用了 mp 的全部通信机制,差别只在“谁起进程、谁分配 GPU、谁等就绪”,它绕开
CUDA_VISIBLE_DEVICES以支持多实例共存。
下一篇将沿着这条执行路径往 worker 内部走:WorkerWrapperBase 如何把配置、模型和 ModelRunner 装配起来,worker 的 init_device / load_model / determine_available_memory / compile_or_warm_up_model 四个阶段各做了什么,以及 worker 扩展(worker_extension_cls)机制如何在不改核心代码的前提下给 worker 加方法。
参考资料
- vLLM 官方设计文档:Architecture Overview
- vLLM 官方设计文档:Python Multiprocessing
- vLLM 源码:vllm/v1/executor/abstract.py
- vLLM 源码:vllm/v1/executor/multiproc_executor.py
- vLLM 源码:vllm/v1/executor/ray_executor_v2.py
- vLLM 源码:vllm/distributed/device_communicators/shm_broadcast.py
- vLLM 源码:vllm/distributed/parallel_state.py
- vLLM 源码:vllm/config/parallel.py
- PyTorch 文档:CUDA in Multiprocessing
- Ray 文档:Placement Groups
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



