


llama.cpp 源码完全拆解(十七):RPC 后端——一次前向如何跨机器执行
为什么一个本地推理框架需要 RPC
llama.cpp 的默认形态是单进程、单机:权重通过 mmap 或 ggml_backend_buffer 落在本机显存,计算图由 ggml_backend_sched 切给本地后端执行。模型变大之后,第一道墙是显存。docs/multi-gpu.md 给出的办法是把设备集合扩大:--split-mode layer 把连续若干层放在不同 GPU 上,KV 缓存跟着层走;--split-mode tensor 用 meta device 把单个张量切开,每层做一次 allreduce。两种模式都假定设备在本机、通过 PCIe 或 NVLink 相连。
RPC 后端把“设备”这个概念又往外推了一步:它把另一台机器上的 ggml 设备注册成本机设备。主控机上的 llama-cli 或 llama-server 仍然以为自己只是在做普通的多设备调度,但其中一个设备实际位于远端,权重和 KV 缓存在远端显存里,计算图要跨网络提交。跨机并不是一种新的并行策略,而是把已有的设备抽象延伸到网络上。
这个定位需要先说清楚,因为它决定了 RPC 后端能做什么、不能做什么:
- 它没有请求路由、没有 KV 传输协议、没有故障恢复,也没有多租户调度。一个
ggml-rpc-server只是在网络上暴露本机的 ggml 设备,语义上等价于一块插在网线上的 GPU。 - 它不做“层与层之间的流水线重叠”。
ggml_backend_sched仍然按顺序执行各个子图,跨机边界是一次同步拷贝,而不是 GPipe 那种 micro-batch 流水。 - 它的收益主要是“装得下”和“能用到远端闲置设备”,而不是线性加速。网络带宽和往返延迟会直接进入每个 decode step 的关键路径。
与 Petals 那类地理分布式推理系统相比,RPC 后端更“底层”也更“脆弱”:Petals 解决的是不可信节点、动态加入、隐私与容错;llama.cpp 的 RPC 解决的是“让 ggml 的 buffer 和 graph 能落在另一台机器上”,默认双方在可信内网,协议没有认证,README 明确警告不要暴露在公网。
下面按一条数据的实际路径拆:设备如何注册、缓冲区如何分配、张量地址如何跨进程表达、计算图如何序列化、执行结果如何取回,以及张量切分时那一次跨机 allreduce 如何完成。
模块全景:客户端后端、服务端进程与传输层
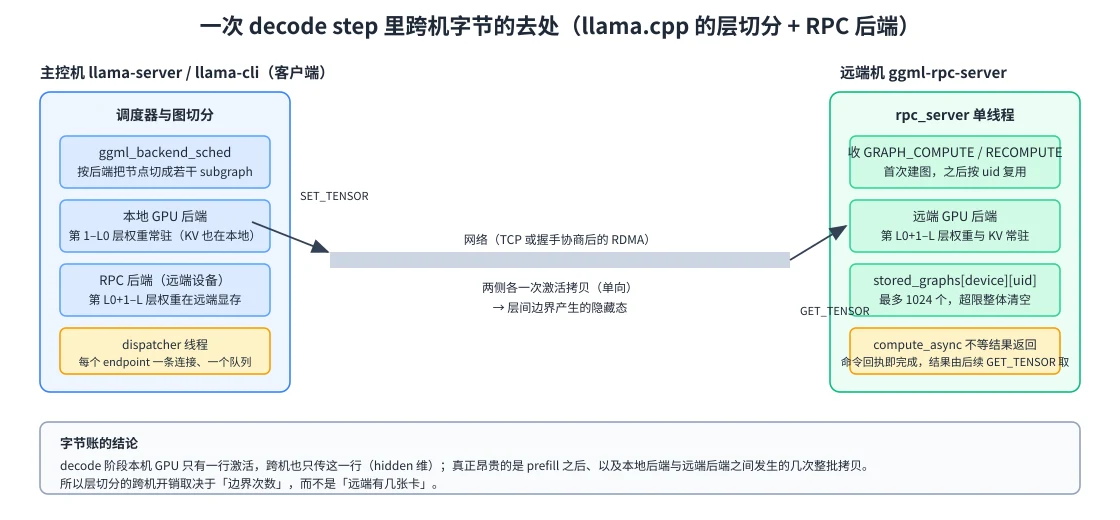
图里画的是 --split-mode layer 切一刀的情形。左边是主控机:ggml_backend_sched 把计算图切成若干子图,前半段交给本地 GPU 后端,后半段交给 RPC 后端;RPC 后端内部有一个 rpc_dispatcher 线程,负责把命令写到连接上。右边是远端机:ggml-rpc-server 进程持有远端 GPU 的 ggml_backend_t,收到 GRAPH_COMPUTE 后在远端建图并异步执行,权重和 KV 都留在远端显存。中间那条线是 TCP,或者在握手协商成功后的 RDMA。
拆开看,RPC 后端由三块组成。
第一块是客户端侧的后端实现,源码在 ggml/src/ggml-rpc/ggml-rpc.cpp。它被编译成独立的 backend library,注册名为 RPC。ggml_backend_rpc_add_server(endpoint) 会向 endpoint 发起一次连接、查询设备数量,然后为每台远端设备创建一个 ggml_backend_device,命名为 RPC0、RPC1 这样的形式,描述字段则记录 host:port。这些设备通过 ggml_backend_register 进入全局注册表,之后 --list-devices、--device、-ngl、--tensor-split 都能像对待本地设备一样对待它们。
第二块是服务端进程,入口在 tools/rpc/rpc-server.cpp。它解析 -H/--host、-p/--port、-d/--device、-t/--threads、-c/--cache,把选中的设备初始化成 ggml_backend_t,然后调用 ggml_backend_rpc_start_server 进入接受连接的循环。默认只监听 127.0.0.1:50052;默认暴露本机所有加速设备,如果没有加速设备则暴露一个 CPU 设备。-c 打开本地文件缓存,目录是 $LLAMA_CACHE/rpc 或 $XDG_CACHE_HOME/llama.cpp/rpc。
第三块是传输层,源码在 ggml/src/ggml-rpc/transport.cpp 和 transport-apple.cpp。它把 socket 抽象成 socket_t:send_data、recv_data、flush、accept、get_caps、update_caps、transport_name。同一个 socket_t 在握手前是 TCP,握手后可能被透明升级为 RDMA;上层 ggml-rpc.cpp 不需要知道自己跑在哪种传输上。
客户端并不是“每个设备一个连接”。get_dispatcher(endpoint) 以 endpoint 字符串为键,维护一个 weak_ptr<rpc_dispatcher> 表;同一台远端机上的多张卡共享同一个 dispatcher 和同一条 socket。dispatcher 内部只有一个工作线程和一个 FIFO 队列,因此对同一个 endpoint 的所有 RPC 命令是串行发送的。这一点在后面讲并发和性能时很关键:同一远端机上的两张卡不会并行收到命令,除非应用层把它们拆到不同的 endpoint。
协议:一字节命令、八个字节长度与打包结构体
RPC 协议是手写的二进制协议,没有使用 protobuf 或 flatbuffers。所有结构体都放在 #pragma pack(push, 1) 里,保证跨编译器的字节布局一致。请求帧的格式是:
RPC request : | rpc_cmd (1 byte) | request_size (8 bytes) | request_data (request_size bytes) |RPC response: | response_size (8 bytes) | response_data (response_size bytes) |命令字是一个字节,枚举从 0 开始。前 14 个命令的位置被固定下来,源码里有一行静态断言:
static_assert(RPC_CMD_HELLO == 14, "RPC_CMD_HELLO must be always 14");这是为了让旧客户端在遇到新服务端时至少能把 HELLO 认出来,从而得到一个明确的版本错误,而不是把某个新命令误当成握手。握手请求携带 24 字节的 conn_caps,响应返回主、次、补丁版本号和同样 24 字节的能力位图:
struct rpc_msg_hello_req { uint8_t conn_caps[RPC_CONN_CAPS_SIZE];};
struct rpc_msg_hello_rsp { uint8_t major; uint8_t minor; uint8_t patch; uint8_t padding; uint8_t conn_caps[RPC_CONN_CAPS_SIZE];};客户端的版本检查只有两条:主版本必须相等,服务端次版本不能高于客户端次版本。检查通过后,sock->update_caps(response.conn_caps) 尝试把连接升级成 RDMA;失败就继续用 TCP。这个设计的好处是命令行完全不用改,坏处是“能不能用 RDMA”取决于两端网卡、GID 和路由,排障时要看 transport_name() 的日志。
rpc_tensor 是整个协议里最重要的结构,它把一张 ggml_tensor 的元数据压成固定长度:
struct rpc_tensor { uint64_t id; uint32_t type; uint64_t buffer; uint32_t ne[GGML_MAX_DIMS]; uint32_t nb[GGML_MAX_DIMS]; uint32_t op; int32_t op_params[GGML_MAX_OP_PARAMS / sizeof(int32_t)]; int32_t flags; uint64_t src[GGML_MAX_SRC]; uint64_t view_src; uint64_t view_offs; uint64_t data; char name[GGML_MAX_NAME]; int32_t use_count;};字段的含义分别对应:id 是客户端进程里的张量指针,作为跨进程的临时标识;buffer 是远端缓冲区句柄;ne、nb 是形状和步长;op、op_params、flags 描述算子;src、view_src、view_offs 描述依赖和视图;data 是远端地址;use_count 让服务端能正确设置图的引用计数,避免提前释放中间张量。sizeof(rpc_tensor) % 8 == 0 也被静态断言,保证后面的 8 字节对齐字段不会错位。
命令按用途可以分成五组:
- 握手与发现:
HELLO、DEVICE_COUNT、GET_DEVICE_MEMORY、GET_ALIGNMENT、GET_MAX_SIZE、GET_ALLOC_SIZE。 - 缓冲区生命周期:
ALLOC_BUFFER、FREE_BUFFER、BUFFER_GET_BASE、BUFFER_CLEAR。 - 张量读写:
SET_TENSOR、SET_TENSOR_2D、GET_TENSOR、GET_TENSOR_2D、SET_TENSOR_HASH、MEMSET_TENSOR、INIT_TENSOR、COPY_TENSOR。 - 图执行:
GRAPH_COMPUTE、GRAPH_RECOMPUTE。 - 跨机集合通信:
COMM_INIT、COMM_ALLREDUCE、COMM_FREE。
协议没有认证、没有加密、没有请求签名。服务端把客户端传来的 buffer 当作指针直接 reinterpret_cast,再用一个 std::unordered_set<ggml_backend_buffer_t> 检查它是不是自己分配过的句柄;data 也会被检查是否落在对应缓冲区的地址范围内。这些检查能挡住明显的越界和伪造,但挡不住一个能连上端口的攻击者做其他事情。README 的警告不是客套话。
远端设备是怎样「长」在本地的
命令行入口在 common/arg.cpp。--rpc 的处理函数先确认当前构建支持 RPC,然后按逗号切分 host:port 列表,逐个调用动态取到的 ggml_backend_rpc_add_server:
static void add_rpc_devices(const std::string & servers) { auto rpc_servers = string_split<std::string>(servers, ','); ggml_backend_load_all(); ggml_backend_reg_t rpc_reg = ggml_backend_reg_by_name("RPC"); auto fn = (ggml_backend_rpc_add_server_t) ggml_backend_reg_get_proc_address(rpc_reg, "ggml_backend_rpc_add_server"); for (const auto & server : rpc_servers) { auto reg = fn(server.c_str()); ggml_backend_register(reg); }}ggml_backend_rpc_add_server 内部先发一次 DEVICE_COUNT,拿到远端暴露的设备数;如果为 0 就直接返回空。然后为每台设备建一个 ggml_backend_rpc_device_context,其中保存 endpoint、远端设备索引、本地显示名和描述。设备名由全局递增的 dev_id 生成,所以同一进程里先注册的远端设备叫 RPC0,再注册另一台机器的设备叫 RPC1,名字里不带 endpoint;endpoint 放在描述字段里。--list-devices 打出来的就是这两列。
这里有一个容易被忽略的行为:ggml_backend_rpc_device_get_type 永远返回 GGML_BACKEND_DEVICE_TYPE_GPU,即使远端暴露的是 CPU 设备。源码里留着 TODO,说明还没有从服务端查询真实类型。这个返回值会影响上层的 offload 启发式,也会影响日志和 --list-devices 的显示。把一台只有 CPU 的机器通过 RPC 接进来时,它在主控机眼里仍然是一块“GPU”。
设备的属性通过 get_props 一次性填好:名字、描述、类型、远端空闲/总显存,以及能力位:
props->caps = { /* .async = */ true, /* .host_buffer = */ false, /* .buffer_from_host_ptr = */ false, /* .events = */ true, /* .mmap_support = */ true,};async = true 让调度器可以用异步提交;events = true 让它可以插入事件做跨后端同步;mmap_support = true 则让模型装载器认为远端缓冲区可以接受 mmap 语义的张量放置。注意这些是客户端声明的能力,服务端并没有逐项协商。
缓冲区类型按 (endpoint, device) 组合缓存。名字形如 RPC0[192.168.1.10:50052],对齐和最大尺寸在第一次创建时向服务端查询一次,之后不再变。源码注释写明这些 buffer type 是故意不释放的:进程生命周期内数量有限,反复创建会带来悬空指针问题。
最值得注意的是 supports_op:
static bool ggml_backend_rpc_device_supports_op(ggml_backend_dev_t dev, const struct ggml_tensor * op) { GGML_UNUSED(dev); GGML_UNUSED(op); //TODO: call the remote backend and cache the results return true;}它对所有算子都返回“支持”。调度器因此可能把远端后端实际上不支持的算子分到这一段,直到服务端执行时才失败。实践中远端通常是 CUDA、Metal 或 Vulkan 后端,算子覆盖面和本地 GPU 接近,所以这个问题不常暴露;但把远端设成 CPU 后端、或者模型用了某个后端特有的算子时,就会看到远端 abort。这个 TODO 是理解 RPC “设备虚拟化不完整”的一个具体例子。
缓冲区与指针:远端地址如何伪装成本地地址
这是整个 RPC 后端最巧、也最容易讲错的部分。先看分配:
static ggml_backend_buffer_t ggml_backend_rpc_buffer_type_alloc_buffer( ggml_backend_buffer_type_t buft, size_t size) { auto request = std::make_shared<rpc_msg_alloc_buffer_req>(); request->device = buft_ctx->device; request->size = size; rpc_msg_alloc_buffer_rsp response; dispatcher->send(RPC_CMD_ALLOC_BUFFER, request, sizeof(*request), &response, sizeof(response)); ...}服务端收到 ALLOC_BUFFER 后,用该设备的默认 buffer type 分配一块真实的缓冲区,然后把 reinterpret_cast<uint64_t>(buffer) 作为 remote_ptr 返回。也就是说,客户端拿到的不是一个数据地址,而是服务端 ggml_backend_buffer_t 结构体的指针值,作为后续所有操作的句柄。这个句柄对客户端完全不透明,客户端只负责原样回传。
客户端随后用 ggml_backend_buffer_init 建一个本地 buffer 对象,大小采用服务端返回的 remote_size(可能因为对齐或 padding 比请求的 size 大),context 里保存 dispatcher、remote_ptr,以及一个初始为空的 base_ptr。get_base 是惰性的:
static void * ggml_backend_rpc_buffer_get_base(ggml_backend_buffer_t buffer) { if (ctx->base_ptr != nullptr) return ctx->base_ptr; auto request = std::make_shared<rpc_msg_buffer_get_base_req>(); request->remote_ptr = ctx->remote_ptr; rpc_msg_buffer_get_base_rsp response; ctx->dispatcher->send(RPC_CMD_BUFFER_GET_BASE, request, sizeof(*request), &response, sizeof(response)); ctx->base_ptr = reinterpret_cast<void *>(response.base_ptr); return ctx->base_ptr;}服务端返回的是 ggml_backend_buffer_get_base(buffer),对 CUDA 来说就是设备指针。客户端拿到这个“远端基地址”之后,ggml_backend_sched 的资源分配器就会在这块 buffer 上按偏移放置张量,于是每张张量的 data 等于“远端基地址 + 偏移”。这个指针在主控机进程里没有任何可解引用的意义,但它会被原样写进 rpc_tensor.data 发给服务端;服务端用 deserialize_tensor 校验它确实落在自己那块 buffer 的 [base, base+size) 区间内,然后把它当作真实地址使用。
换句话说,跨进程传递的不是“数据在哪”,而是“服务端的地址算术结果”。这个设计让客户端不需要维护一套影子偏移表,张量的 data、view_offs、src 关系可以原样保留;代价是客户端绝不能解引用这些指针,而且服务端必须做边界校验。deserialize_tensor 里那段检查就是为此存在的:
if (tensor->data + tensor_size < tensor->data || tensor->data < buffer_start || tensor->data + tensor_size > buffer_start + buffer_size) { LOG_ERROR("... out of buffer bounds ..."); return nullptr;}分配尺寸也不是总等于 ggml_nbytes。有些后端会对量化张量做 padding:CUDA 要求 ne[0] 向上取整到 512 的倍数,否则某些内核的访存会出问题。客户端在 init_tensor 里只对“量化、ne[0] % 512 != 0、且不是视图”的张量发一次 INIT_TENSOR,让服务端调用它自己的 buffer->iface.init_tensor 完成 padding。注释说得很直白:为了省带宽,不是所有张量都值得走这一趟。
还有一个细节是 get_alloc_size。对普通张量,客户端直接用 ggml_nbytes;对可能需要额外空间的量化张量,以及 ggml_op_alloc_size_may_expand 列出的算子,客户端会向服务端查询真实分配尺寸,并按“设备、类型、算子、参数、形状、步长”做缓存。缓存键故意不包含 src 的形状,原因是 GPU 后端的预留图会按最大维度分配,缓存值只会偏大不会偏小;如果把 src 也算进去,KV 缓存增长会导致每个 ubatch 都 miss,把主线程堵在在途的 GRAPH_COMPUTE 后面。
源码里还留了一条注释:返回尺寸不能小于 ggml_nbytes,因为 rpc_tensor 的 nb[] 是 32 位,超过 4 GiB 的步长在协议里会被截断,服务端算出来的尺寸可能偏小。这是一个已知的协议限制,短期内靠 std::max 兜底。
写入与读取:哈希缓存、二维拷贝与边界校验
SET_TENSOR 的负载是“结构体头 + 数据”:
| rpc_tensor | cache_flag (1 byte) | offset (8 bytes) | data |客户端在发送前会判断是否值得走哈希缓存:
static bool rpc_use_hash_cache(const ggml_tensor * tensor, size_t size) { return size > HASH_THRESHOLD && tensor->buffer->usage == GGML_BACKEND_BUFFER_USAGE_WEIGHTS;}HASH_THRESHOLD 是 10 MiB。满足条件时,客户端先算数据块的 FNV-1a 哈希,发 SET_TENSOR_HASH;服务端在缓存目录里找以 16 位十六进制哈希命名的文件。命中就直接把文件内容写进目标张量,客户端不再发送数据;未命中则回一个 miss,客户端再把 cache_flag=1 的完整 SET_TENSOR 发过去,服务端顺手把数据落盘。
这段逻辑的注释值得抄下来,因为它记录了一个真实的坑:
// the hash cache is meant for weights, so that a model reload can skip re-sending them.// compute-buffer inputs (the activations ggml_backend_sched copies between backends) must not// take this path, otherwise with `rpc-server -c` every ubatch above the threshold is written// to the cache directory and later served from there.也就是说,缓存必须只对 usage == WEIGHTS 的 buffer 生效。计算缓冲区里的激活值也会被调度器跨后端拷贝,如果它们进入缓存路径,每个超过 10 MiB 的 ubatch 都会在服务端磁盘上留下一个文件,而且后续还可能被错误命中。这个判断把“权重”和“激活”在协议层分开了。
SET_TENSOR_2D 是另一个容易被忽略的命令。它的负载在 rpc_tensor 后跟四个 64 位字段:
| offset | size | n_copies | stride | data (size × n_copies) |语义是把 n_copies 段长度为 size 的数据,按源侧的 stride_data 取出,写到目标张量从 offset 开始、步长为 stride_tensor 的位置。它适合“同一个张量的多行需要从一段连续或半连续的内存里填进去”的场景,比如把多行嵌入或 KV 行批量写入。服务端会校验 size × n_copies 与负载长度一致,并检查整个写入区间不越过张量和缓冲区的边界。
读取方向对称:GET_TENSOR 只带张量、偏移和长度,响应就是原始字节;GET_TENSOR_2D 额外带 n_copies 和 stride,服务端可以按目标步长打包返回,客户端再按自己的步长拆开。读取之前,服务端会调用 sync_all_backends(),因为前面的图计算是异步提交的,不排空就可能读到旧数据。
二维命令的校验比一维更细,因为它涉及“多段数据 + 步长”的组合,容易在乘法上溢出。服务端先检查 size × n_copies 是否等于负载长度,再检查 (n_copies - 1) × stride + size 是否越过张量和缓冲区的边界;前一个乘法用 size > UINT64_MAX / n_copies 判断,后一个用 n_copies - 1 > (UINT64_MAX - size) / stride 判断。只有这两组检查都通过,才调用 ggml_backend_tensor_set_2d。读取侧的 GET_TENSOR_2D 在客户端还有一个“步长是否等于长度”的分支:相等时直接把响应读进目标内存,不等时先读进一个紧凑的临时 vector 再按行拆开,避免协议层做额外的分段。
除了 set/get,缓冲区还有几条“小命令”值得知道。MEMSET_TENSOR 用来给一段区间填常量,服务端会校验偏移、长度和 data 指针三者都不越界,并要求目标 buffer 的 iface.memset_tensor 非空;BUFFER_CLEAR 清整块 buffer,通常在分配后或释放前使用;INIT_TENSOR 只对需要 padding 的量化张量发,让服务端调用自己的初始化钩子。FREE_BUFFER 会让服务端排空所有在途计算、清掉引用该 buffer 的缓存图,然后再释放。这些命令都很短,但每一条都遵循同一个顺序:先同步,再校验,最后执行。
COPY_TENSOR 只在一种情况下走远端:
if (src_ctx->dispatcher != dst_ctx->dispatcher) { LOG_DBG2("src and dst are on different servers, falling back to a host copy"); return false;}源和目标必须在同一个 endpoint 上,服务端才能在本机做一次 ggml_backend_tensor_copy。跨 endpoint 时函数返回 false,调度器会退化成“从源读回主机、再写到目标”,也就是两次网络往返加一次主机内存中转。这个细节决定了多台远端机之间搬张量的成本,也解释了为什么“每台机器一个 endpoint”比“把所有卡塞进一个 endpoint”在跨机拷贝上更贵。
服务端的每个数据命令入口都先做 sync_all_backends(),再校验句柄和边界,失败就关闭连接。客户端侧对协议错误有一个统一的断言:
#define RPC_STATUS_ASSERT(x) if (!(x)) \ GGML_ABORT("Remote RPC server crashed or returned malformed response")这意味着服务端崩溃、返回长度不符、或者协议版本错位,在主控机看来都是直接 abort,而不是抛一个可恢复的异常。llama.cpp 的很多路径本来就不适合做细粒度错误恢复,但这也意味着 RPC 连接不适合放在一个“随时可能抖动”的网络里。
计算图执行:序列化、重建与按 uid 复用
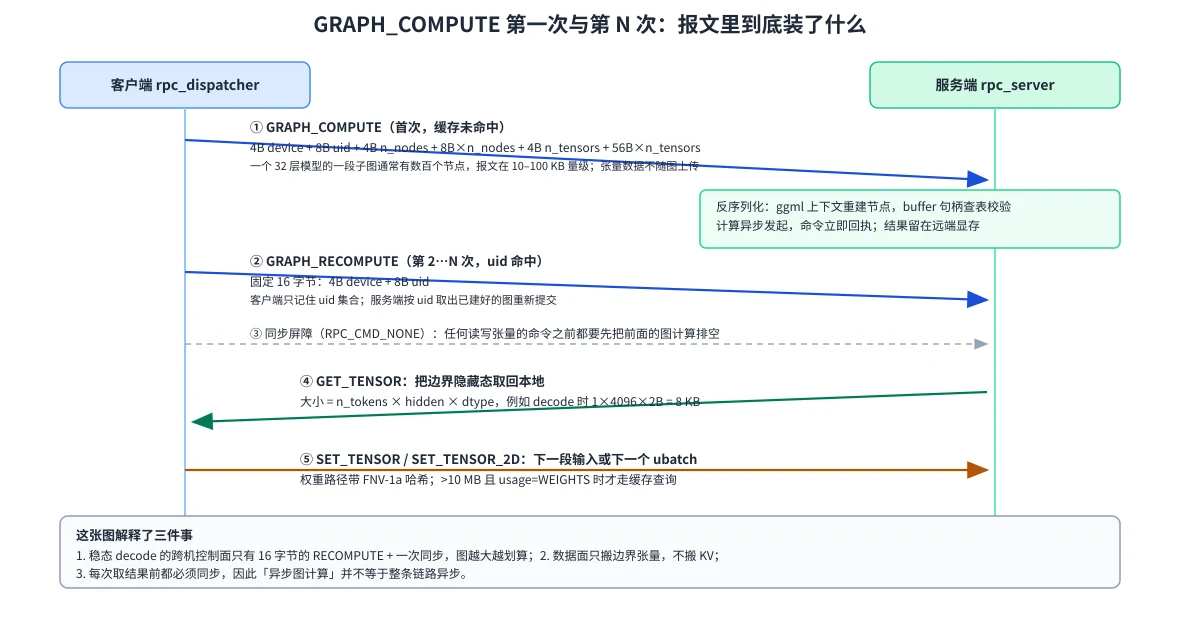
图执行是 RPC 后端的核心。客户端拿到一个 ggml_cgraph 后,先做一次深度优先遍历,把所有节点、它们的 src、view_src 收集进一个 std::vector<rpc_tensor>,并用 visited 集合去重。每个 rpc_tensor.id 直接取客户端张量指针,use_count 从图的 visited_hash_set 和 use_counts 里查出来,保证服务端重建后引用计数一致。
序列化格式是:
| device (4B) | uid (8B) | n_nodes (4B) | nodes (8B × n_nodes) || n_tensors (4B) | tensors (56B × n_tensors) |节点数组里放的是 id,张量数组里放的是完整结构体。注意这里没有传任何张量数据:权重和 KV 早就在远端缓冲区里,激活值要么是远端缓冲区里的中间结果,要么是客户端刚刚 SET_TENSOR 写进去的输入。图报文只描述“算什么、依赖谁、地址在哪”。
服务端收到后,先在 stored_graphs[device] 里按 uid 找缓存。uid 为 0 的图不缓存;非 0 且缓存已满 1024 条时,整体清空。这个 1024 是客户端和服务端共享的常量 GRAPH_CACHE_MAX,源码注释强调两边必须一致,否则清空时机错位,客户端会发出一个服务端已经丢掉的 uid。
未命中时,服务端用 ggml_init 建一个 no_alloc = true 的上下文,按 ggml_tensor_overhead() * (n_nodes + n_tensors) + ggml_graph_overhead_custom(...) 预留内存,然后递归 create_node:
deserialize_tensor重建张量,校验类型、blck_size、ne和data边界,把buffer句柄还原成指针并查buffers集合。- 递归还原
src[i]和view_src,任何非零 id 还原失败都会让整张图失败。 - 把
use_count写回图的visited_hash_set对应位置。
建好之后调用 ggml_backend_graph_compute_async(backends[device], graph),把图存进 stored_graphs[device][uid],然后立刻返回。服务端在这一步只测量“反序列化和建图”的耗时,真正的计算是异步的;客户端看到的往返时间只覆盖到命令回执。
稳态执行因此变得非常便宜:客户端第二次遇到同一个 uid 时,只发:
struct rpc_msg_graph_recompute_req { uint32_t device; uint64_t uid;};固定 16 字节。服务端从缓存里取出 ggml_cgraph,再次 graph_compute_async。这就是为什么 decode 阶段跨机控制面几乎可以忽略:图结构不变,变的只是输入张量的内容,而输入张量的地址也没变。
缓存的生命周期有两道保护。第一道是上限 1024,超过就整体清空;第二道是 free_buffer 时把所有缓存图的 graph 指针置空:
// Discard all cached graphs to avoid use-after-free in graph_recompute,// since their nodes may hold pointers to the buffer being freed.for (auto & sgs : stored_graphs) { for (auto & sg : sgs) { sg.second.graph = nullptr; }}释放后客户端如果还发同一个 uid 的 GRAPH_RECOMPUTE,服务端会找不到图并返回失败。正常情况下,缓冲区释放意味着调度器会重建图、分配新的 uid,所以这条路径不会经常触发;但它说明缓存键只保证“图结构相同”,不保证“图里的缓冲区还活着”。
另一个关键语义是“异步但不乱序”。ggml_backend_sched 在需要读回结果、写新输入、释放缓冲区之前,会调用后端的 synchronize。RPC 的实现是往队列里塞一个 RPC_CMD_NONE 哨兵消息并等待它完成;dispatcher 的 work() 循环遇到 NONE 只做一个同步屏障,不发送任何字节。这样保证前面所有已入队的 GRAPH_COMPUTE 都已经被写到 socket 上,服务端也按顺序处理完。
dispatcher 还有一个“忙等窗口”:当上层连续提交命令时,工作线程会在队列上自旋最多 100 ms,避免每次命令都经历一次条件变量睡眠/唤醒;空闲超过 100 ms 就回到阻塞等待,不长期占用一个核。这个细节对 decode 这种“每步几条命令、步与步之间可能很密”的负载有意义。
与 ggml-backend 调度器的配合:什么时候会发生跨机拷贝
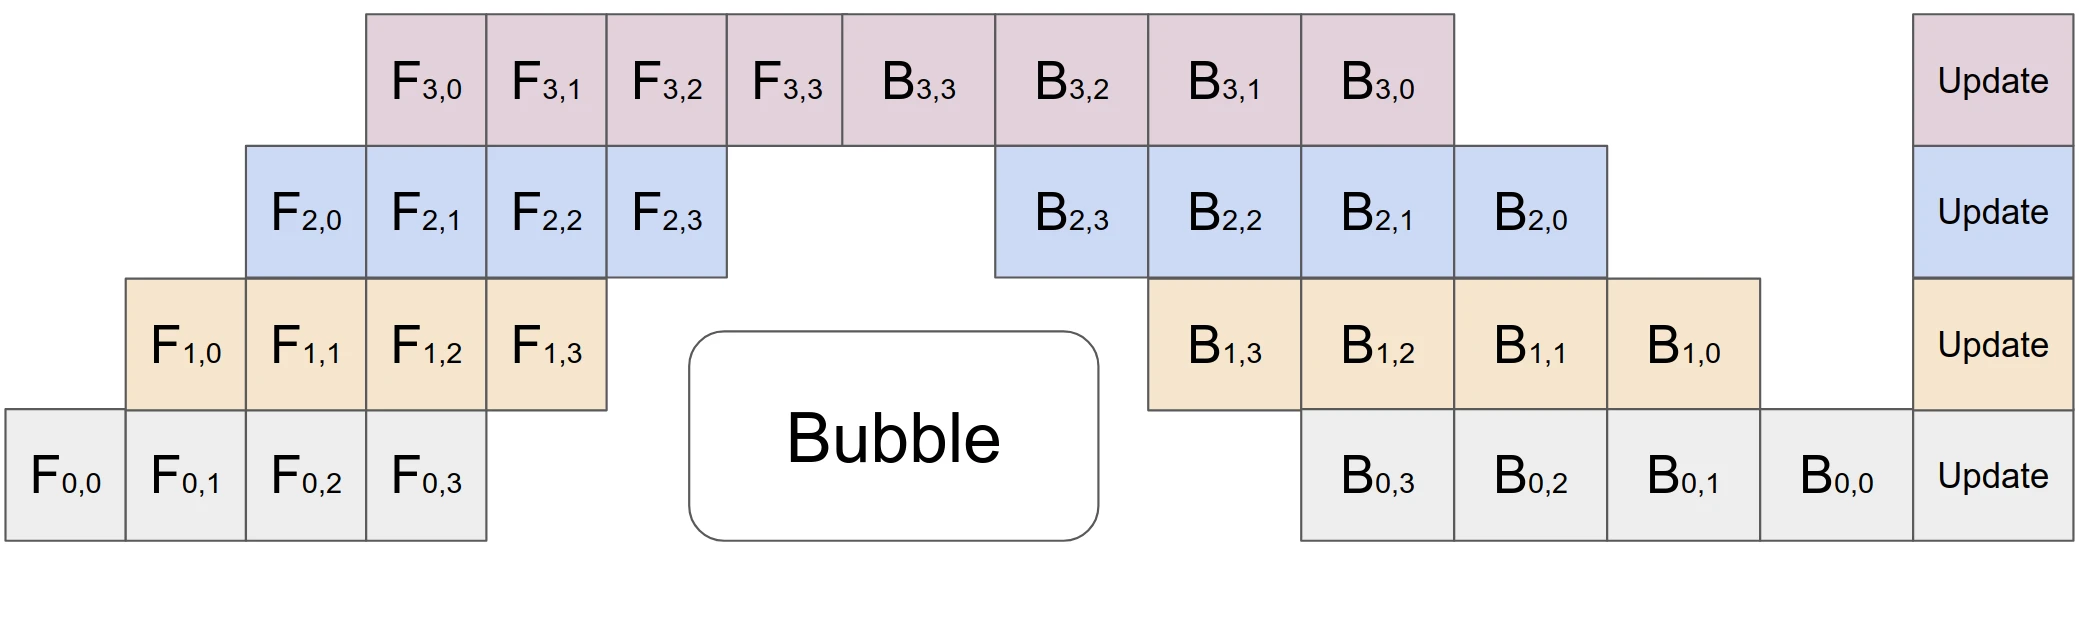
GPipe 的图展示的是“把一个 mini-batch 切成多个 micro-batch,让不同 stage 同时在跑”,从而把流水线气泡填满。llama.cpp 的 --split-mode layer 在概念上也是按层切 stage,但执行方式不同:ggml_backend_sched 把一张图切成若干子图后,是按顺序提交的,一个 ubatch 依次穿过本地段和远端段,段与段之间没有重叠。RPC 层切分带来的是“模型能放下”,不是 GPipe 那种吞吐提升。这一点在图旁边必须先说清楚,否则很容易把两种“流水”混为一谈。
调度器决定切分的依据是每个节点的后端归属。它先问每个后端 supports_op,再结合张量当前所在的 buffer 和用户给的 offload 参数,把节点分配到后端;然后在后端边界插入拷贝。对 RPC 来说,边界拷贝有两种命运:
- 如果源和目标在同一个 endpoint 上,
COPY_TENSOR可以让服务端在本机完成拷贝,客户端只发一条命令。 - 如果源在本地、目标在远端(或反过来),
COPY_TENSOR返回 false,调度器退化为get_tensor+set_tensor,也就是一次网络读回加一次网络写入。层切分的边界正是这种跨机拷贝。
因此,层切分的跨机流量等于“每个边界、每个 ubatch 的隐藏态大小”,而不是“整个模型的激活大小”。以 32 层、hidden 4096、bf16 为例,切一刀时每个 token 的边界张量是 字节;prefill 512 token 时是 MiB。KV 缓存不跨机,因为第 层的注意力节点被分到了拥有第 层的设备上,它的 K/V 读写都在远端完成。
权重装载走另一条路。模型加载器把权重从磁盘读进主机内存,再由调度器 set_tensor 到各个后端;对 RPC 后端来说,这就是一次 SET_TENSOR,大张量会走前面说的哈希缓存。第一次装载要把整个远端分片的权重过一遍网络,第二次起如果服务端开了 -c 且权重没变,客户端只发哈希,服务端从本地文件缓存恢复。这个优化对“反复重启 llama-server、权重不变”的场景很有用,对“每次换模型”的场景没有帮助。
--tensor-split 和 -ngl 仍然照常工作,只是设备列表里多了 RPC0、RPC1。按显存比例自动切分时,客户端会向每台远端设备查询空闲显存,所以远端机的显存占用会参与比例计算。--device 可以限制只用哪些设备,--list-devices 能看到远端设备的描述。--split-mode tensor 则走 meta device:它把参与的张量按轴切开,每层末尾做一次 allreduce;这条路径依赖下一节的跨机通信。
跨机 allreduce:为张量切分准备的点对点通信
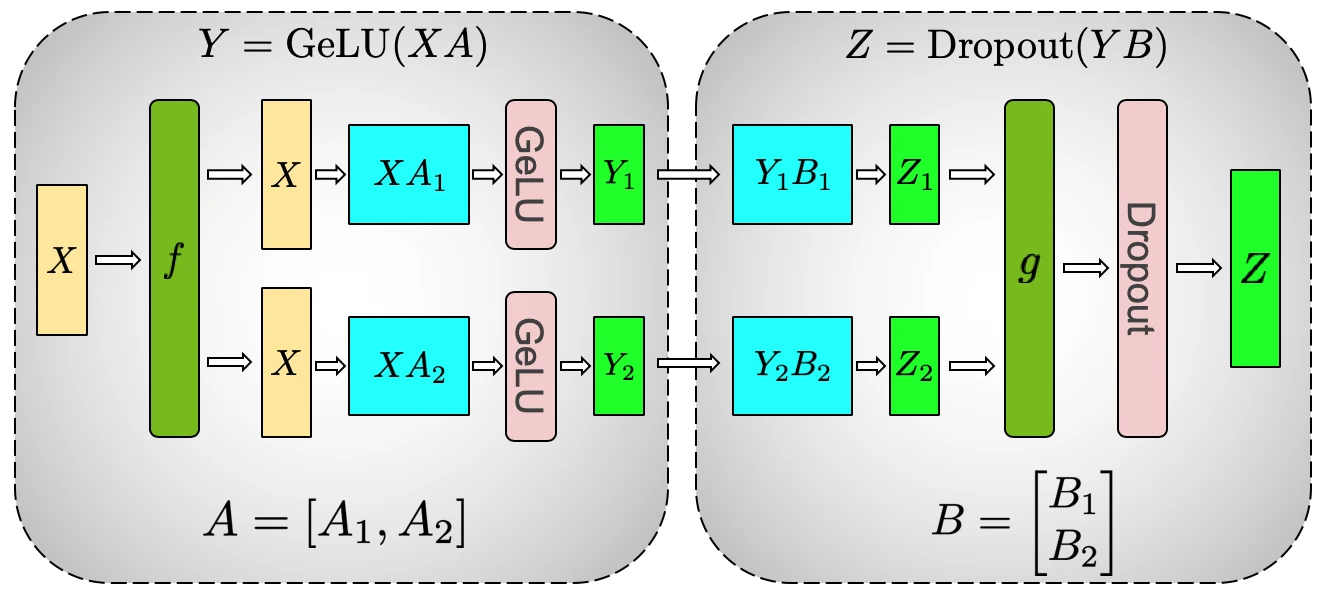
Megatron-LM 的图展示了张量并行的基本账:MLP 的 f 和 g 两个线性层各切一半,前向在 f 之后做一次 allreduce,反向在 g 之后再做一次。llama.cpp 的 meta device 在推理时做的是同一类事:把张量按轴分给多个后端,每个子图末尾把各后端的部分和加起来。区别在于,llama.cpp 的 RPC 只实现了两个 rank 的点对点版本。
ggml_backend_comm_init 的客户端实现直接限制规模:
if (n_backends != 2 || std::getenv("GGML_RPC_NO_COMM") != nullptr) { return nullptr;}两个后端必须都是 RPC 后端,而且不能共用同一个 endpoint。每个 rank 的通信端口由 endpoint 端口加 1000 得到,rank 0 在 0.0.0.0 上监听,rank 1 主动连接。服务端的 comm_init 里,rank 0 先 accept,双方交换 24 字节 caps(和主连接一样,可能把这条对等连接升级成 RDMA),然后记录 rank、world 和 peer。rank 1 的连接带重试:最多 100 次、每次间隔 50 ms,因为 rank 0 可能还没开始监听。
真正的 allreduce 在服务端完成,客户端只发“开火”命令:
struct rpc_msg_comm_allreduce_req { uint32_t device; rpc_tensor tensor;};服务端收到后:
ggml_backend_synchronize(backend),等产生这个部分和的子图算完。- 把张量数据读回主机。如果元素数不少于 32768,先转成 bf16 再上网,把线缆字节减半;小张量保持 f32,因为额外的转换和同步比省下的字节更贵。
- rank 0 先发后收,rank 1 先收后发,避免大负载互相等待造成死锁。
- 把收到的数据写进 scratch 缓冲区,建一个
GGML_OP_ADD节点,把本地部分和与对端部分和相加,结果写回原张量。 - 返回。客户端在后续需要结果时统一
synchronize。
这条路径的带宽账很直接:每个被切开的张量、每次 allreduce 要搬“元素数 × 2 字节(或 4 字节)”的线缆数据,而且是双向各一次。它适合 decode 这种每步只有一行激活的场景;prefill 时激活很大,跨机 allreduce 会成为瓶颈。
限制也很明确:只支持两个 rank。三个以上后端时 comm_init 返回空,meta device 会退回自己的 allreduce_fallback,用主机内存做多轮归约。这一步在源码里写得很清楚:comm_ctx 为空就调用 fallback,成功与否决定整个子图是否继续。换句话说,RPC 的“张量切分”目前是双机点对点,而不是 N 卡环形 allreduce。想跨三台以上做张量并行,要么回到层切分,要么接受 fallback 的主机中转。
走读一条命令:从 ggml_backend_rpc_graph_compute 到远端 compute_async
前面分块讲了协议、地址和缓存,这一节按控制流把一次 GRAPH_COMPUTE 从头到尾串一遍,标出每一步的检查点和可能的失败点。
第 1 步:上层发起。 调度器决定这一段子图属于 RPC0,调用 backend->iface.graph_compute(backend, cgraph)。RPC 的实现只有一行:
static enum ggml_status ggml_backend_rpc_graph_compute(ggml_backend_t backend, ggml_cgraph * cgraph) { ggml_backend_rpc_context * rpc_ctx = (ggml_backend_rpc_context *)backend->context; rpc_ctx->dispatcher->graph_compute(rpc_ctx->device, cgraph); return GGML_STATUS_SUCCESS;}注意它总是返回成功。真正的失败要等到后续同步或读回时才会以 abort 或错误日志的形式暴露。调度器在同一后端连续提交多段子图时,graph_compute 之间没有等待,所以这里能形成一小段“排队提交”。
第 2 步:客户端判定复用。 rpc_dispatcher::graph_compute 先拿 graph_mutex,因为 graph_uids 是 dispatcher 共享的。判断条件有两个:cgraph->uid != 0,且该设备的 device_graph_uids 集合里已有这个 uid。有就发 GRAPH_RECOMPUTE,否则先把 uid 插入集合、再把整张图序列化后发 GRAPH_COMPUTE。
这里的 uid 来自 ggml_backend_sched:在 ggml_backend_sched_split_graph 里,切完子图后对每个 split 执行 sched->splits[i].graph.uid = ggml_graph_next_uid()。ggml_graph_next_uid 是一个进程级原子计数器,从 1 开始递增;0 被保留为“不缓存”。这意味着同一个进程里,每次重新切图都会拿到一批新 uid,服务端缓存里旧 uid 的图会一直待到 1024 条上限才被整体清掉。
第 3 步:序列化。 serialize_graph 遍历 cgraph->nodes,对每个节点递归 add_tensor。递归顺序是先 src 再 view_src 最后自己,这样服务端 create_node 可以按相同顺序递归依赖。visited 用 unordered_set<ggml_tensor*>,因为同一个张量可能在多个节点里作为输入出现。serialize_tensor 在写 buffer 和 data 时有一个保护:
if (ctx != nullptr && (dispatcher == nullptr || ctx->dispatcher.get() == dispatcher)) { result.buffer = ctx->remote_ptr; result.data = reinterpret_cast<uint64_t>(tensor->data);} else { result.buffer = 0; result.data = 0;}也就是说,只有当张量所在的 RPC buffer 属于当前这个 dispatcher 时,才暴露远端句柄和地址;否则把两者都置 0。为什么需要这个保护?因为一台主控机可能同时连多台远端机,张量指针是进程内全局唯一的,但远端缓冲区属于不同的连接。把 A 服务器的句柄发给 B 服务器,B 的 buffers 集合里找不到它,会拒绝;提前置 0 至少避免把一个属于另一条连接的指针当成“本连接的合法句柄”送进校验路径。调度器在切图时本来就会在端点边界插入拷贝,正常情况下不会把别的 endpoint 的张量塞进这一段,这个判断是给异常路径兜底的。
第 4 步:入队与发送。 send_async 把消息推进 message_queue,工作线程 work() 弹出后调用 send_rpc_cmd。send_rpc_cmd 分三次 send_data:命令字节、长度、负载,最后 flush()。对 TCP 来说 flush 是空操作;对 RDMA 来说它会把最后一个不完整的帧补发出去。无响应命令(GRAPH_COMPUTE、GRAPH_RECOMPUTE、SET_TENSOR、COMM_ALLREDUCE 等)只发不收;有响应命令(ALLOC_BUFFER、HELLO、GET_TENSOR 等)会同步等待对应长度的响应。
第 5 步:服务端分发。 rpc_serve_client 先处理 HELLO,然后进入命令循环。它每次只读 1 个字节的命令字,超过 RPC_CMD_COUNT 就立即断开。对 GRAPH_COMPUTE,它把整个负载读进 std::vector<uint8_t>——注意这里是“先按长度分配再读”,恶意或损坏的长度字段会导致一次大分配,源码对 std::length_error 和 std::bad_alloc 做了捕获并返回失败。
第 6 步:服务端建图。 rpc_server::graph_compute 先校验负载长度至少能放下 device、uid、n_nodes,再校验 device < backends.size(),然后按 n_nodes 和 n_tensors 做多级长度检查,避免短包被当成完整结构体读取。之后如果 n_tensors 里存在重复 id,tensor_ptrs.emplace 只保留第一个;后面的 create_node 都指向同一个副本。上游 #31190 这个补丁讨论的正是“重复节点”是否应该直接拒绝,说明这条路径还在加固中。
第 7 步:异步执行与回执。 ggml_backend_graph_compute_async 在远端后端上提交,状态不是 GGML_STATUS_SUCCESS 会直接 GGML_ABORT——注释写着“Unsuccessful graph computations are not supported with RPC”。也就是说,远端算子失败没有“返回错误码”的路径,只能让服务端进程 abort,客户端在下一个命令上收到断连。
第 8 步:同步与取回。 调度器需要结果时调用 synchronize,dispatcher 推入 RPC_CMD_NONE,工作线程仅设置 promise 的值;随后 GET_TENSOR 在服务端先 sync_all_backends() 再读数据。到这里,一个边界的隐藏态才真正回到主控机,进入下一段本地子图。
把这八步放在一起看,RPC 的“异步”只存在于第 7 步:命令回执不等计算完成。第 8 步的全局同步把它拉回同步执行。如果想让层间真正重叠,需要把 sync_all_backends 收窄到“只同步与本次读取相关的后端”,并给每个 buffer 或图维护独立的完成事件;这正是 issue #29287 一类讨论在推进的方向。
工程现实:单线程 accept、失效模式与安全边界
RPC 后端的代码里有很多“能用但 fragile”的痕迹,读源码时值得逐条记下来。
第一,服务端是单线程 accept 循环:
while (true) { auto client_socket = server_socket->accept(); rpc_serve_client(backends, cache_dir, client_socket);}rpc_serve_client 会一直服务当前连接,直到对端关闭。这意味着同一时刻只有一个客户端能被服务。llama.cpp 的 issue #28908 记录了这个后果:在 router 模式下,第一个模型子进程保持一条长连接,第二个模型子进程再连上来时,握手永远收不到回复,warmup 卡死。issue 里给出的本地复现是“连接 A、HELLO、保持 A 打开;连接 B、HELLO,B 永远等不到回复”。这不是配置问题,而是 accept 循环的结构问题。要用多个客户端,就得给每台远端机起多个 server 进程、监听不同端口,或者等这个循环改成每连接一个线程。
第二,协议没有认证。服务端把客户端传来的 buffer 当作指针、把 data 当作地址,虽然有集合和边界检查,但攻击面仍然很大。README 的警告是“proof-of-concept、fragile and insecure,永远不要放在开放网络”。把 -H 0.0.0.0 用在公网上是明确错误。
第三,supports_op 永远返回 true,get_type 永远返回 GPU。这两个 TODO 会让调度器对远端能力做出过于乐观的假设,也会让日志和显存规划出现偏差。排查“为什么这个算子跑到远端就崩”时,先看这两个函数。
第四,服务端在数据命令前统一 sync_all_backends()。这保证了正确性,但也意味着“异步图计算”并不等于整条链路异步:每次 GET_TENSOR、SET_TENSOR、FREE_BUFFER 都会把之前所有在途计算排空。decode 阶段之所以还能跑,是因为调度器本来就要在边界取结果;如果未来想做更细的重叠,这个全局屏障会是第一个要改的地方。
第五,大载荷在传输层按最大 1 GiB 分块发送。socket_t::send_data 和 recv_data 各自循环,每轮只搬 MAX_CHUNK_SIZE(1024ull * 1024 * 1024)以内的字节。对 TCP 来说这只是一个 chunked 读写循环;对 RDMA 来说,它还要在每条消息边界调用 flush(),因为 RDMA 会把写合并成固定帧,最后那个不完整的帧要在这里补发。分块本身不改变协议语义,但会让你在 GGML_RPC_DEBUG=3 的日志里看到“一条 SET_TENSOR 对应多次 send/recv”的现象,排查带宽问题时不要把它误认为重复命令。
第六,RDMA 是“自动协商”,不是“必然启用”。Linux 上走 RoCEv2,GID 由本地 TCP 地址构造:IPv4 映射成 ::ffff:a.b.c.d 形式的 16 字节,然后在网卡端口上找字节相同的 GID,优先 RoCE v2、其次 v1。GGML_RDMA_DEV 和 GGML_RDMA_GID 可以强制指定设备和 GID 索引,GGML_RPC_NO_RDMA 可以强制回 TCP。传输层按 256 KiB 分块、预投 24 个接收缓冲(约 6 MiB),并在每条消息边界调用 flush(),因为 RDMA 会把写合并成固定帧,最后那个不完整的帧要在这里补发。Apple 平台走 Thunderbolt 5 上的 RDMA,需要 macOS 26.2 以上并在恢复模式里执行一次 rdma_ctl enable。这些条件任何一条不满足,连接就留在 TCP,命令行没有任何变化。客户端这一侧还会检查对端能力:update_caps 认为“24 字节 caps 全零”等于对端没有 RDMA,于是释放本地 QP、继续用 TCP,并打一条 warning;而 transport_name() 就是靠这个标志返回 TCP 或 RDMA。判断一条连接是不是真的走了 RDMA,不需要猜——看握手日志里 handshake ok: ... transport: RDMA 那一行即可。
第七,缓存和图的清理是“整体清空”而不是 LRU。GRAPH_CACHE_MAX 到 1024 条就 clear(),客户端和服务端必须同步清;缓冲区释放时服务端把所有图的指针置空。这样做实现简单,但在长跑、图结构频繁变化的负载里会出现“刚缓存就被清”的抖动。上游 #29287 这个补丁讨论的“multiple graphs cache”就是这一类问题。
第八,日志。GGML_RPC_DEBUG 分四档:0 只打警告和错误,1 打连接、握手、缓冲区分配、图计算、缓存淘汰,2 打每条命令和每次张量传输,3 打每条命令耗时、图节点和传输字节数。客户端的这些记录是 ggml 的 debug 记录,默认被过滤,需要同时加 -lv 5 才能看到。排查跨机问题时,这个组合比在代码里加 printf 有效得多。
第九,上游仍在持续加固这条协议。仓库里的相关改动包括:让不可达 endpoint 和失败的握手走可读的错误路径而不是直接崩、拒绝畸形的张量维度和非法算子、校验二维拷贝的步长与分配失败、以及避免把截断的缓存文件当成命中。这些改动说明 RPC 后端的功能已经够用,但“面对坏输入时的行为”还在补齐。用它做生产部署时,最好固定到某个 commit 或 release,并把服务端放在受控网络里;不要在滚动升级的集群里让两端版本自由漂移,因为协议只保证主版本相等、次版本向下兼容,字段语义的变化不一定有兼容层。
第十,客户端的 dispatcher 生命周期由 weak_ptr 管理。get_dispatcher 返回的是 weak_ptr 锁出来的 shared_ptr;当所有引用它的 backend 和 buffer 都销毁后,dispatcher 析构,线程退出、socket 关闭。这听起来很合理,但意味着“连接”并不是一个独立的、可复用的资源池:如果上层反复创建和销毁 backend,就会反复建连、握手、重新查询设备数,服务端的单线程 accept 也会被这些短连接占住。长时间服务时,应该让 backend 和 buffer 的生命周期覆盖整个进程,而不是按请求创建。
一个 decode step 的跨机字节账
把上面的机制压成数字,能更清楚地看出 RPC 层切分的成本结构。以下按 bf16、hidden = 4096、32 层、两台机器各放一半层来估算,忽略协议头和 TCP/IP 开销。
单个 token 的 decode,跨一个边界:
如果层切分产生 个跨机边界,每步的控制面还要加 次 GRAPH_RECOMPUTE(16 字节)和若干次同步;数据面是 KiB 去、 KiB 回。三台机器、两个边界时,每步约 32 KiB 往返。这个量在 10 GbE 上不到 0.1 ms 的传输时间,真正占时间的是往返延迟和同步屏障。
prefill 是另一回事。512 token 的一个 ubatch,跨一个边界:
如果边界有两处,就是 8 MiB 去、8 MiB 回;在 10 GbE 的线速下约 13 ms,在 1 GbE 下约 128 ms。这也解释了为什么层切分“prefill 友好、decode 一般”:decode 传的是行,prefill 传的是整批。
权重装载只发生一次。8B 参数的 bf16 模型约 16 GB,按 10 GbE 线速约 13 秒,按 1 GbE 约 2 分钟;开了 -c 且第二次加载同一份权重时,客户端只发哈希,时间主要花在服务端读本地缓存和写显存。这个账要和“模型根本放不下”对比:如果单机显存差 8 GB,RPC 的代价是每个 prefill 多十几毫秒、每个 decode 多几十微秒,换来的是不用换卡。
反过来,如果模型本来就放得下,RPC 层切分通常会让 decode 变慢:多了一次网络往返、一次主机中转、一次全局同步,而且没有流水线重叠。它不是一个“免费扩容”的开关。
按显存切分时,客户端会向每台设备查一次 GET_DEVICE_MEMORY,拿到 free 和 total;远端设备的 free 是服务端在握手后查询的实时值,所以远端机的其他进程如果占了显存,切分比例会跟着变。这个行为对“同一台机器同时跑别的服务”的场景不友好:切分比例可能在两次启动之间不同,导致层到设备的映射变化、图缓存全部失效。固定部署时,最好显式给 --tensor-split 或用 -ngl 把层数钉死。
还有一种常见的误用:把 RPC 设备当成“CPU offload 的替代品”。-ngl 99 加上远端设备,会让所有能放进设备的层都推到远端;但远端设备的 supports_op 恒真、type 恒为 GPU,所以调度器不会像对待 CPU 那样“能放就放、放不下再算”。如果远端显存其实不够,失败会发生在服务端分配或执行阶段,而不是在主控机的规划阶段。稳妥的做法是先用 --tensor-split 给出保守比例,观察 --list-devices 和远端日志里的 remote_size,再逐步上调。
与其他推理框架的横向对照
把 RPC 放回推理系统的谱系里,它的位置很清楚:它是“设备层”的分布式,而不是“请求层”或“KV 层”的分布式。
vLLM 的 KV Connector 做的是请求级 P/D 分离:prefill 实例算完 KV,通过 NIXL 之类的传输层把块交给 decode 实例,调度器要知道哪些块在途、何时可读。可参考 vLLM 源码完全拆解(十七):KV Connector。TensorRT-LLM 的 disaggregated serving 也是同一层的问题,控制面和数据面分开设计,见 TensorRT-LLM 源码完全拆解(十六):P/D 分离与 KV 传输。SGLang 的 disagg 与 DeepInfer 的 EngineType 同样是在请求和 KV 的边界上做文章。
llama.cpp 的 RPC 不碰这些。它不知道“请求”是什么,只看到 buffer 和 graph;它不传 KV 块,只传图边界上的激活;它没有路由、没有健康检查、没有重试。它的优点是侵入性小:任何能跑在 ggml 后端上的模型,不需要改一行模型代码,就能把一部分层放到远端。缺点是它把分布式系统的复杂度留给了使用者和网络。
如果要把它和站内的流水并行讨论对照,可以看 流水并行推理完全拆解:五个框架为什么选了五种流水形态。那篇里的流水并行是“层切分 + 多 microbatch 填泡”,而 RPC 的层切分是“层切分 + 单 ubatch 顺序穿过”,两者只在拓扑上相似,调度语义不同。
从“设备虚拟化”的角度看,RPC 更接近一个极简的 remote backend:它把 ggml_backend_buffer、ggml_backend、ggml_backend_device 三个接口搬到网络上,其他什么都不做。理解了这一点,就能理解为什么它的代码里到处是 TODO,也能理解为什么它在可信内网、模型略大于单机显存、偶尔用一下的场景里很好用。
小结
RPC 后端的全部机制可以压成四句话:
- 设备注册:
--rpc host:port让客户端连上服务端、查询设备数,把每台远端设备以RPCn的名字注册进 ggml 的后端表,之后调度器把它当普通 GPU 用。 - 地址模型:
ALLOC_BUFFER返回的是服务端的 buffer 句柄,BUFFER_GET_BASE返回服务端的基地址;客户端把“远端基地址 + 偏移”写进tensor->data,服务端校验后直接使用。跨进程传的是地址算术结果,不是数据位置。 - 图执行:客户端把图序列化成节点 id 和张量元数据,服务端重建
no_alloc图并异步执行;稳态下只发 16 字节的GRAPH_RECOMPUTE,按uid复用已建好的图。 - 跨机通信:只为双机张量切分提供点对点 allreduce,服务端之间直接交换部分和,大张量用 bf16 上网;三个以上 rank 会退回主机 fallback。
它的边界也同样清楚:单线程 accept、无认证、supports_op 恒真、每次数据命令前全局同步、没有跨段流水线重叠。把这些边界记住,比记住任何一个函数名都重要。
如果要把这套机制和自己的推理系统对照,可以抓住三个问题:第一,你的“设备”边界画在哪里——是像 RPC 这样画在 ggml_backend 接口上,还是像 vLLM/KV Connector 那样画在 KV 块上;第二,跨边界传的是图还是数据——RPC 传图、传边界激活,P/D 分离传的是已经算好的 KV;第三,同步点在哪里——RPC 在每次数据命令前把所有后端排空,P/D 分离则用“块就绪”事件把同步粒度压到单个块。这三个问题的答案决定了系统能扩展到几台机器、能容忍多大的网络抖动,以及故障时能不能只让一个请求失败而不是整个进程退出。
下一篇会把视角拉回单机,继续拆 llama.cpp 里尚未讲透的模块。
参考资料
- ggml-rpc.cpp(客户端后端、协议与服务端实现)
- transport.cpp(TCP 与 RDMA 传输抽象)
- tools/rpc/README.md(部署方式、缓存与 RDMA 说明)
- docs/multi-gpu.md(split mode 与多设备参数)
- ggml-backend-meta.cpp(meta device 与 allreduce 调用点)
- issue #28908:单线程 accept 导致第二个连接握手卡死
- GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



