


前端与引擎之间的那道进程边界:vLLM、SGLang、TensorRT-LLM、llama.cpp、DeepInfer 如何把一次请求交给 GPU
在线推理服务里,HTTP 请求进来之后并不会直接落到 GPU 上。中间总要跨过一条边界:一边是处理协议、分词、流式回传的「前端」,另一边是跑调度和前向的「引擎」。这条边界划在哪里、用什么方式跨越、谁负责把 token 从引擎往回泵,直接决定了服务的并发上限、首 token 延迟(TTFT)、以及一个进程崩掉时整个服务会怎么收场。
站内已经分别拆过各框架的入口层和引擎内部,但对「边界本身」只做过零散的描述。可参考 推理服务的入口层完全拆解 了解协议如何归一化,DeepInfer 源码拆解(十七):LLMEngine 的 step 与 Worker 握手 了解引擎单步如何组装,流水并行推理完全拆解 了解跨 rank 的通信形态。这一篇把五个框架的前端—引擎边界并排放在一起,逐层回答同一个问题:一次请求从哪里跨过进程围墙,又从哪里回到客户端。
先把边界画出来:前端、引擎、输出泵
三种角色,五种切法
不论框架怎么命名,跨边界的数据流都是三段:
- 前端:接收 HTTP 请求,做协议转换、分词、多模态预处理,产出引擎能消费的请求对象。
- 边界:一个或多个单向/双向通道,负责把请求对象送进去,把输出对象送出来。
- 输出泵:从边界上读取引擎输出,做反分词、stop 判定、组装流式响应,再交给前端事件循环。
三个角色可以由同一个进程承担,也可以拆到不同进程。五个框架的切法并不相同:
| 框架 | 前端进程 | 引擎进程 | 反分词位置 | 边界通道 |
|---|---|---|---|---|
| vLLM V1 | 与 HTTP 同进程(AsyncLLM) | EngineCore 独立子进程 | 前端进程(OutputProcessor) | ZMQ:ROUTER 入、PULL 出 |
| SGLang | 与 HTTP 同进程(TokenizerManager) | Scheduler 独立子进程 | 独立的 DetokenizerManager 子进程 | ZMQ:PUSH 入、PULL 出 |
| TensorRT-LLM | LLM API 进程(proxy) | MPI worker world | 前端进程(result queue 消费者) | IPC 队列 + MPI |
| llama.cpp | server.cpp 中的 HTTP 线程 | 同进程主循环,但另起一个 worker 线程 | 主循环内同步发送 | 进程内条件变量与队列 |
| DeepInfer | 离线 LLM(暂无在线包装) | driver worker 在主进程,CP 子 worker 另起进程 | 主进程 | 进程内直调 + CP 消息队列 |
这张表看起来只是「谁在哪」,但每一行的差异都会在后面变成具体的行为差异:反分词放在哪,决定了客户端断开时谁先知道;通道是进程内还是跨进程,决定了能不能用 asyncio 等待;通道方向是单向还是双向,决定了 aborts 需不需要另一条路。
表中「前端」的含义也不完全一致。vLLM 的前端只做传输与反分词,调度全部在引擎侧;TensorRT-LLM 的前端不做模型计算,但承担了拉起 worker world 的职责;llama.cpp 的前端还要提供 Web UI、健康检查与多模型路由;DeepInfer 的开源版本则没有在线前端,只有离线 LLM 这一个消费方。
为什么这条边界值得单独研究
边界一旦画错,会带来三类代价,而且都不是「慢一点」那么简单:
- 把 GPU 前向的等待挂在事件循环上,整台机器的并发就退回串行。
- 把大对象跨越进程拷贝,每步 decode 都会多出几毫秒的序列化开销。
- 通道语义不对称,客户端断开后引擎继续算、输出没人收,显存和算力白烧。
五个框架对这些代价的取舍各不相同,正好构成一组对照实验。
vLLM V1:ROUTER 入、PULL 出,输出泵是一个 asyncio 任务
进程拓扑
vLLM 官方文档给出的 V1 进程架构如图:前端进程里有 API server、Tokenizer、Processor、OutputProcessor;EngineCore 是独立的第二个进程,负责输入处理、调度与 KV Cache 管理;四个 GPU Worker 进程各占一张卡,负责模型前向。TP=4 时一共 6 个进程。

图片来源:vLLM 官方文档 Architecture Overview。左侧 API Server,中间 Engine Core(输入处理、调度、KV Cache 管理),右侧四个 GPU Worker(模型执行、前向);总计 6 个进程。
这张图里最容易被忽略的是「前端只与一个 Engine Core 进程对话」。TP 的宽度不改变边界形状:前端只负责把请求送进 Engine Core,Engine Core 再通过 executor 把同一批工作分发给四个 GPU Worker。边界只关心 Engine Core,rank 数被挡在第二层边界之后。
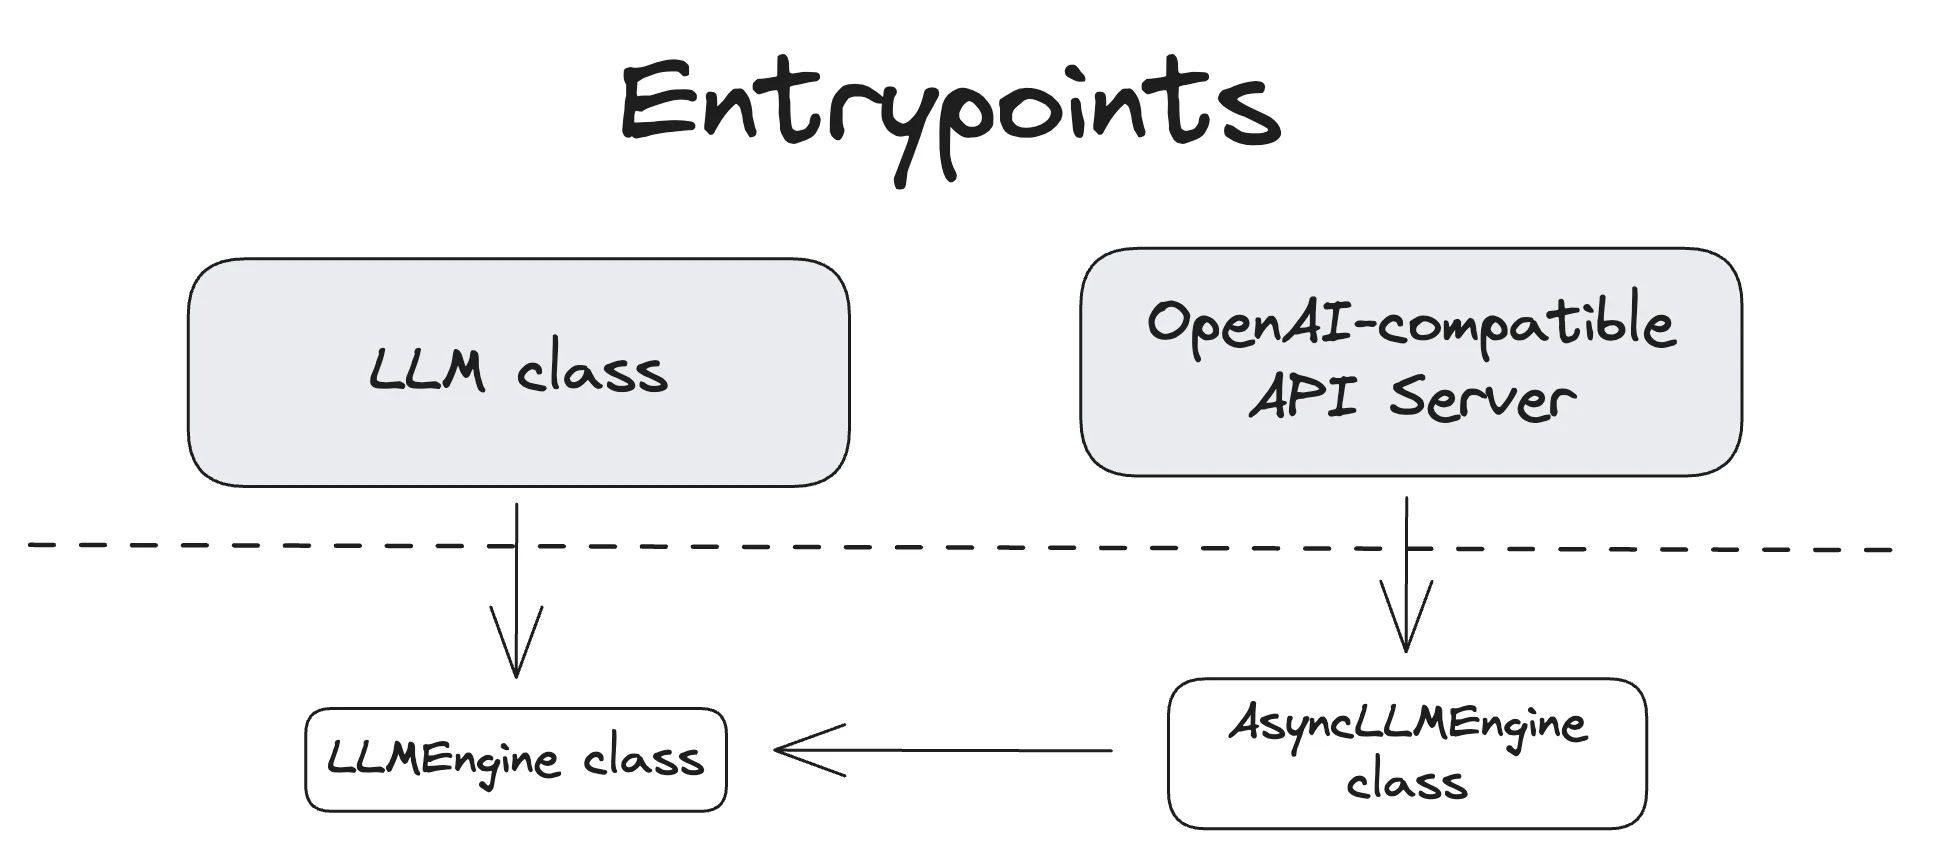
图片来源:vLLM 官方文档 Architecture Overview 的 Entrypoints 图。它把入口层与引擎层画成两个独立层次;V1 把引擎接口进一步拆成前端的 AsyncLLM 与后端的 EngineCore,本篇讨论的边界就落在两者之间。
建立边界:ROUTER/PULL 与握手
MPClient 的构造函数把两端套接字都建好:
# vllm/v1/engine/core_client.py(v0.9.2)self.input_socket = self.resources.input_socket = make_zmq_socket( self.ctx, input_address, zmq.ROUTER, bind=True)self.resources.output_socket = make_zmq_socket( self.ctx, output_address, zmq.PULL)输入端用 ROUTER 而不是 PUSH,原因在 DP:多个 EngineCore 进程各自以不同的 ZMQ identity 注册到同一个 ROUTER 上,前端才能按 engine 身份把请求定向发放。输出端用 PULL,意味着所有引擎的输出都汇成一条流,前端不需要关心输出来自哪个引擎——引擎身份信息被放进输出对象的 engine_index 字段。
握手阶段,前端会在同步套接字上等每个引擎发来第一帧:
identities = set(self.core_engines)sync_input_socket = zmq.Socket.shadow(self.input_socket)while identities: if not sync_input_socket.poll(timeout=600_000): raise TimeoutError("Timed out waiting for engines to send" "initial message on input socket.") identity, _ = sync_input_socket.recv_multipart() identities.remove(identity)超时是 10 分钟,这个数字反映的是大模型加载时间:权重装载、显存 profiling、CUDA Graph 捕获全部完成后,引擎才会发出这第一帧。边界在这里扮演的是「就绪信号线」,前端在握手完成前不会接新流量。
请求侧:一次 add_request 穿过两层
AsyncLLM.add_request 做了两件事,顺序不能颠倒:
queue = RequestOutputCollector(output_kind=params.output_kind)prompt_str, request = self.processor.process_inputs(...)await self._add_request(request, prompt_str, None, 0, queue)_add_request 里先在前端注册输出状态,再把请求送进引擎:
self.output_processor.add_request(request, prompt, parent_req, index, queue)await self.engine_core.add_request_async(request)先注册再发送,是为了消除一个竞态:如果引擎跑得极快,在 OutputProcessor 还没建立 request_states 之前就吐出了第一步输出,输出去泵就会查不到对应状态而丢弃。OutputProcessor.process_outputs 里对这种情况的处理很直接——查不到就跳过,因此顺序错了会直接丢 token。
n > 1 的情况在这里扇出成多个子请求,每个子请求有自己的 request_id 和采样参数,但共享同一个 RequestOutputCollector 队列,前端再按 request_index 区分。
输出泵:output_handler 与分块处理
输出泵是 AsyncLLM 启动时创建的一个后台任务:
async def output_handler(): while True: outputs = await engine_core.get_output_async() num_outputs = len(outputs.outputs) ... for i, outputs_slice in enumerate(slices): processed_outputs = output_processor.process_outputs( outputs_slice, outputs.timestamp, iteration_stats) assert not processed_outputs.request_outputs if i + 1 < len(slices): await asyncio.sleep(0) await engine_core.abort_requests_async( processed_outputs.reqs_to_abort)三个细节值得展开:
第一,输出被按块切分。 单步输出超过 VLLM_V1_OUTPUT_PROC_CHUNK_SIZE 个请求时,会被 np.array_split 切成几段,每段之间 await asyncio.sleep(0) 让出一次事件循环。这是为了防止一次大 batch 的反分词与 stop 判定把整个事件循环卡住几百毫秒。
第二,assert not processed_outputs.request_outputs。 这行断言揭示了 OutputProcessor 的双模式:同步 LLMEngine 用法下,输出被收集到列表返回;异步用法下,输出被直接推入每个请求的 RequestOutputCollector,不经过列表。同一个类同时服务两种前端,边界差异被压进一个开关。
第三,reqs_to_abort 的回流。 如果 stop string 在反分词阶段被检出,而引擎侧还没认为该请求结束,输出泵会立即通过同一条 ROUTER 通道发出 ABORT。这是 stop string 这类只在前端可见的停止条件与引擎对齐的唯一途径。
跨进程读取被单独拆成一个任务
AsyncMPClient 不只在前端跑一个 output_handler,它还额外起了一个读取任务:
async def process_outputs_socket(): while True: frames = await output_socket.recv_multipart(copy=False) resources.validate_alive(frames) outputs = decoder.decode(frames) if outputs.utility_output: _process_utility_output(outputs.utility_output, utility_results) continue ... if outputs.outputs or outputs.scheduler_stats: outputs_queue.put_nowait(outputs)validate_alive 是在每帧上检查是否收到 ENGINE_CORE_DEAD 哨兵;一旦收到,后续所有输出都被转成异常放进队列,让 output_handler 抛出、服务整体关停。这套「哨兵 + 异常传播」让「引擎进程死了」表现为一个可以捕获的异步异常,而不是静默挂起。
DP 模式下的路由与 abort 记账
数据并行时,DPLBAsyncMPClient 在发送前为每个请求选一个引擎,并把选择记在 reqs_in_flight 里:
def get_core_engine_for_request(self, request): if (eng_index := request.data_parallel_rank) is None: ... min_counts = [sys.maxsize, sys.maxsize] for i in range(num_engines): idx = (self.client_index + i) % num_engines counts = self.lb_engines[idx] if counts < min_counts: min_counts = counts eng_index = idx chosen_engine = self.core_engines[eng_index] self.reqs_in_flight[request.request_id] = chosen_engine return chosen_engineabort 必须知道请求当时被送到哪个引擎,所以这张表必须在发送之前写,在输出里的 finished_requests 出现之后删。client_index 参与轮转起点,是为了多前端进程同时接入时避免所有前端都从 0 号引擎开始发,造成前沿偏斜。
一次请求的边界时序
把上面的代码按时间顺序拼起来,一条请求在 vLLM 边界上的完整轨迹是:
AsyncLLM.generate创建RequestOutputCollector,确定这次请求的输出是增量还是累积。Processor.process_inputs在前端完成 tokenize 与多模态预处理,得到EngineCoreRequest。OutputProcessor.add_request在前端建立RequestState,其中包含增量反分词器、logprobs 处理器与输出队列。engine_core.add_request_async通过 ROUTER 把请求发给EngineCore的 rank 0。EngineCore调度、前向、采样,把结果包装成EngineCoreOutputs,经 PULL 通道送回前端。AsyncMPClient的读取任务把它放进outputs_queue,output_handler取出、分块、调用OutputProcessor;输出进入对应的RequestOutputCollector。generate的循环从 collector 里取RequestOutput,交给上层 SSE 序列化。- 请求完成后,
OutputProcessor删除状态,EngineCore回收 KV;如果客户端中途断开,generate的取消分支调用abort,同样走 ROUTER 送入 ABORT。
这条时序里有两个「反向」动作:abort 和 stop-string 触发的 abort。两者都复用请求通道,没有单独的控制通道。vLLM 的选择是「用一条 ROUTER 承载所有客户端到引擎的消息」,代价是需要在消息类型里区分 ADD / ABORT / UTILITY / EXECUTOR_FAILED,收益是通道数量最少、顺序天然一致。
输出的两种消费方式
OutputProcessor 的构造决定了输出往哪走:AsyncLLM 传入 RequestOutputCollector,同步 LLMEngine 不传,于是 process_outputs 走两条分支:
if req_state.queue is not None: req_state.queue.put(request_output)else: request_outputs.append(request_output)这段分支背后是两种完全不同的调用模型。异步模式下,generate 是一个生成器,消费者可以慢;同步模式下,step 返回一个列表,调用者必须自己循环。前者的队列可以合并输出,后者不能——因为同步调用者期待每次 step 都对应一次完整的前向输出。这解释了为什么合并逻辑只存在于 RequestOutputCollector,而不在 OutputProcessor 本身。
RequestOutputCollector 的合并语义
def put(self, output): if self.output is None or isinstance(output, Exception): self.output = output self.ready.set() elif isinstance(self.output, (RequestOutput, PoolingRequestOutput)): self.output.add(output, aggregate=self.aggregate)这里的 aggregate 由 RequestOutputKind.DELTA 决定:增量流式时合并 token 列表;非增量时用 add 把新输出并入旧输出。合并的边界很清楚——它只发生在「消费者还没来得及取走」的窗口里,一旦取走就清空。对于需要逐 token 时间线的场景(logprobs、投机验证的逐位置统计),合并会丢失中间状态,所以这类配置通常要求 DELTA 模式或关闭合并。
SGLang:三段式,反分词被拆成独立进程
为什么多切一刀
SGLang 的 launch_server 文档字符串把引擎说得很清楚:TokenizerManager 在主进程,Scheduler 在子进程,DetokenizerManager 在另一个子进程。三者通过 ZMQ 的 IPC 通道通信,请求路径是 TokenizerManager → Scheduler → DetokenizerManager → TokenizerManager。
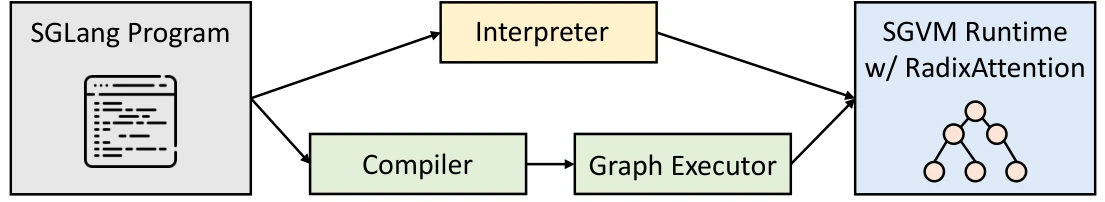
图片来源:SGLang 论文 SGLang: Efficient Execution of Structured Language Model Programs 图 1。图中右侧的 runtime 即本篇讨论的 server;论文没有画进程边界,边界细节以源码为准。
把反分词单独拆出去的原因和 GPUs 关系不大,而是 CPU 侧的账:增量反分词维护每个请求的 token→文本状态机,stop string 匹配要跨 chunk 扫字符串,长输出与高并发下是一笔实打实的 CPU 开销。放进 Scheduler 子进程会拖慢调度,放进主进程会和 HTTP/Tokenizer 抢 GIL,单独一个进程最干净。
通道与地址
PortArgs.init_new 为三个进程分配地址。单机多进程用 ipc:// 临时文件做 Unix 域套接字;跨节点部署时切成 TCP:
tokenizer_ipc_name=f"ipc://{tempfile.NamedTemporaryFile(delete=False).name}",scheduler_input_ipc_name=f"ipc://{tempfile.NamedTemporaryFile(delete=False).name}",detokenizer_ipc_name=f"ipc://{tempfile.NamedTemporaryFile(delete=False).name}",三根管道各管一段。TokenizerManager 侧只用两根:从 detokenizer 收(PULL),往 scheduler 发(PUSH)。
self.recv_from_detokenizer = get_zmq_socket( context, zmq.PULL, port_args.tokenizer_ipc_name, True)self.send_to_scheduler = get_zmq_socket( context, zmq.PUSH, port_args.scheduler_input_ipc_name, True)用 PUSH 而非 ROUTER,说明 SGLang 不打算在前端做 per-engine 路由:单机场景下只有一个 scheduler 接收端,DP 时由 scheduler 内部或上游负载均衡解决。这与 vLLM DP 模式下前端持有多个 engine identity 的做法正好相反。
反分词进程的内部
DetokenizerManager 的 event_loop 只有四步:
while True: with self.soft_watchdog.disable(): recv_obj = sock_recv(self.recv_from_scheduler) output = self._request_dispatcher(recv_obj) if output is not None: sock_send(self.send_to_tokenizer, output) self.soft_watchdog.feed()recv_from_scheduler 是 PULL,send_to_tokenizer 是 PUSH。它不持有调度器状态,也不参与 KV 管理,唯一的状态是 decode_status:一个容量有限的字典,按 rid 保存每个请求的增量解码进度。
self.decode_status = LimitedCapacityDict(capacity=DETOKENIZER_MAX_STATES)容量有限这一点很关键。它不是「无限增长的缓存」,而是一个有淘汰上限的 LRU 式结构;如果某条请求在反分词侧的状态被淘汰,后续 token 就只能从头解码。DETOKENIZER_MAX_STATES 的取值决定了反分词进程能同时跟踪多少活跃请求,也就决定了它能在多大并发下保持增量语义。这是一个在源码里很容易被忽略、但在线上高并发时会被打中的参数。
批量解码与逐请求偏移
_decode_batch_token_id_output 对一批 BatchTokenIDOutput 做三件事:批量 decode、按 sent_offset 截出本次新增的文本、更新偏移:
incremental_output = output_str[s.sent_offset :]s.sent_offset = len(output_str)output_strs.append(incremental_output)sent_offset 保存的是「已经发给前端的字符数」,不是 token 数。原因在于 token 与字符不是一一对应:一个 token 可能解码出多个字符,也可能在多字节 UTF-8 的中间;按字符偏移才能保证每次只发新增部分,不重复、不截断。这个细节在英文里不明显,在中文与 emoji 场景下是正确性的关键。
启动顺序与就绪判断
SGLang 的 _launch_subprocesses 先分配端口,再拉起 scheduler 进程,等待每个 scheduler 发回初始化信息,然后才构造 TokenizerManager 与 HTTP 服务。这个顺序与 vLLM 的握手方向相反:vLLM 是前端先建好、再等引擎发第一帧;SGLang 是把引擎先拉起来、再让前端接上。两者的共同点是「前端不会在引擎就绪前接流量」,区别在于超时与失败处理放在哪一侧。
请求状态与等待
SGLang 的每请求状态是一个 ReqState 数据类,里面塞了输出、事件、时间统计、LoRA 释放标记、上次输出偏移等:
class ReqState: out_list: List[Dict[Any, Any]] finished: bool event: asyncio.Event obj: Union[GenerateReqInput, EmbeddingReqInput] time_stats: APIServerReqTimeStats last_completion_tokens: int = 1 ttft_observed: bool = False dispatched: bool = False abort_sent: bool = False lora_released: bool = False last_output_offset: int = 0dispatched 和 abort_sent 这两个布尔量是边界两侧同步关系的记账:前者记录请求已经过 ZMQ 送出去,后者确保同一次客户端断开只发一次 AbortReq。
_stream_one_response 用一个循环「等事件、取输出、按流式模式产出」:
while True: try: if request is None: await state.event.wait() else: await asyncio.wait_for( state.event.wait(), timeout=_REQUEST_STATE_WAIT_TIMEOUT) except asyncio.TimeoutError: if request is not None and not obj.background \ and await request.is_disconnected(): self.abort_request(obj.rid) raise ValueError(f"Request is disconnected ... {obj.rid=}") continue ...超时不是为了限流,而是为了「定期醒来检查 HTTP 客户端是否还在」。对于非流式请求,客户端可能在整个等待期间都不发新数据,光靠 event 永远等不到一次可以用来察觉断开的时机。
输出侧的一处性能账:延迟拼文本
ReqState 里有两处注释很直白地说明了边界处的成本意识:
# Accumulate text lazily so incremental streaming can emit the incoming# delta directly without rebuilding the full output prefix.text: str = ""text_chunks: List[str] = dataclasses.field(default_factory=list)非增量流式时,每个 chunk 都需要「到目前为止的全部文本」,如果每步都 "".join 一次,总开销是 。SGLang 的做法是中间 chunk 的 text 置为 None,等到客户端真正消费时一次拼接:
if is_stream and not incremental_stream and "text" in out and out["text"] is None: out["text"] = state.get_text()同类优化在 vLLM 的 RequestOutputCollector 里换了一种写法:生产者跑得比消费者快时,多个增量输出被直接合并成一个对象,而不是排队。
一次批量输出如何扇出到各请求
scheduler 回来的不是「一个请求一个包」,而是 BatchStrOutput / BatchTokenIDOutput 这样的批对象。_handle_batch_output 按 rids 逐个查 ReqState,把批里的第 i 项拼成 meta_info,再追加到该请求的 out_list,最后 state.event.set():
for i, rid in enumerate(recv_obj.rids): state = self.rid_to_state.get(rid, None) if state is None: if rid.startswith(HEALTH_CHECK_RID_PREFIX): continue logger.warning(f"Received output for {rid=} but the state was deleted ...") continue ... state.out_list.append(out_dict) pending_notify[rid] = state if len(pending_notify) >= batch_notify_size: for s in pending_notify.values(): s.event.set() pending_notify = {} await asyncio.sleep(0)...for s in pending_notify.values(): s.event.set()这个循环是边界上的「分发点」,也是全系统唯一需要把批对象拆成单请求视图的地方。和 vLLM 一样,它必须在反分词之后执行,因为 BatchStrOutput 里的 output_strs 已经按请求切好;不同点在于 SGLang 把反分词放在独立进程,因此 TokenizerManager 收到的是「文本已就绪」的批对象,自己不再做 token→文本的工作。
pending_notify 这个中间集合值得单独讲。如果每处理一个请求就 event.set(),一批一千个输出会触发一千次事件循环唤醒;SGLang 改成「攒够 batch_notify_size 个再统一 set」,并在每次批量唤醒后 await asyncio.sleep(0) 让消费者先跑。这是边界上的合并唤醒(event coalescing),和 vLLM 的输出合并属于同一类优化,只是作用在「通知」而不是「数据」上。
state.out_list 是列表而不是单值:同一个请求在一次事件通知周期里可能积累多个 chunk。如果消费者还没醒,多个 out 会一起排队,醒来后由 _stream_one_response 统一取出。这也是为什么 out_list 的 append 与 event 的 set 必须在同一个同步段内完成——否则会出现「看到 event 但没有 out」或「有 out 但 event 已被清掉」的窗口。
取消、暂停与继续
abort_request 发的是 AbortReq,走的是 send_to_scheduler。它在发送前检查 state.abort_sent,避免同一个请求因为多次断连检测而重复发 abort:
if state is not None: if state.abort_sent: return state.abort_sent = Truepause_generation 与 continue_generation 是另外两类控制消息。暂停时,入口层把 is_pause 置真,并向 scheduler 发 PauseGenerationReqInput;继续时反向。注意这两个动作不经过 detokenizer:它们是纯调度语义,输出侧不需要知道。边界设计里把「影响调度但不影响输出语义」的控制消息单独归为一类,可以减少 detokenizer 的状态。
多 tokenizer 模式
init_ipc_channels 里还有一条分支容易被跳过:当 tokenizer_worker_num > 1 时,主进程里的 TokenizerManager 不再直连 scheduler,而是先连到多 tokenizer 池,每个 worker 带自己的 identity:
self.tokenizer_ipc_name = port_args.tokenizer_ipc_name...def _dispatch_to_scheduler(self, obj): if self.tokenizer_ipc_name is not None: stamp_http_worker_ipc(obj, self.tokenizer_ipc_name) sock_send(self.send_to_scheduler, obj)stamp_http_worker_ipc 把来源信息钉在请求对象上,detokenizer 回包时就能知道该把结果送回哪个 tokenizer worker。这说明边界不只是「一根管子」,它还可以是多路复用的一组管子,上游身份信息必须随请求携带。
TensorRT-LLM:IPC 队列 + MPI 的混合边界
进程布局
TensorRT-LLM 的 LLM API 进程(proxy)负责分词、预处理、结果分发,真正的推理活在 MPI 启动的 worker world 里。GenerationExecutorProxy 用 MpiPoolSession 或 MpiCommSession 拉起或绑定 worker,然后建立一套前端本地的 IPC 队列:
self.request_queue = IpcQueue(request_addr, is_server=False, bounded_buffer_size=..., name="proxy_request_queue")self.result_queue = FusedIpcQueue(frontend_result_addrs[0], ..., name="proxy_result_queue")请求走 request_queue,结果走 result_queue。但 rank 间的前向数据(张量并行、流水并行)走 MPI,不进这两根队列。混合边界是 TP/PP 这一层结构直接推出来的结果:worker 内部各 rank 必须用 MPI 集合通信,而前端不需要知道 MPI 的存在。
结果分发线程
_start_dispatch_threads 起一个 ManagedThread,名字是 proxy_dispatch_result_thread,循环跑 dispatch_result_task:
def dispatch_result_task(self): if (res := self.result_queue.get()) is None: return False # shutdown the thread ... for i in res: if i is None: return False process_res(i) if async_queues: _SyncQueue.notify_many(event_loop, async_queues)关键在最后两行。GenerationResult 在初始化时会根据「当前线程里有没有正在运行的事件循环」选择两种队列:
if has_event_loop(): self.aqueue = AsyncQueue() self.queue = self.aqueue.sync_qelse: self.queue = Queue() self.aqueue = None有事件循环时用 async_q,异步消费者 await aqueue.get();没有时用同步 Queue,result() 阻塞读取。分发线程不能直接 await,所以它把结果塞进 sync_q,再手动调用 _SyncQueue.notify_many(event_loop, async_queues) 把 asyncio 的等待者唤醒。这是一处典型的「线程做 I/O、事件循环做等待」的桥。
同步 API 与异步 API 共用一条边界
LLM.generate_async 返回的 RequestOutput 本身就是一个「结果句柄」。它在构造时决定队列类型,然后在 result() / __iter__ / __aiter__ 三种消费方式下走同一套 _result_step:
def result(self, timeout=None): ... while not self._done: self._result_step(remaining) return self
async def aresult(self): while not self._done: await self._aresult_step() return self同步 API generate 则是「逐个调用 generate_async,再逐个 future.result()」:
for i, request_input in enumerate(request_inputs_list): future = self.generate_async(request_input, ..., streaming=False) futures.append(future)for future in tqdm(futures, ...): future.result()注意这里的 future 不是 concurrent.futures.Future,而是 RequestOutput;它用 .result() 这个名字借用了 Future 的语义,但真正的等待发生在队列上。这种「看起来像 Future、实际上是流式结果句柄」的设计,让同步与异步两条路径共享同一套分发逻辑,不需要为同步模式再建一条输出通道。
启动握手的轮询与 ACK
TensorRT-LLM 的就绪判定走一条独立的 IPC 队列,而不是结果通道:
while True: if self.worker_init_status_queue.poll(1): status = self.worker_init_status_queue.get() self.worker_init_status_queue.put("ACK") signal = status[0] if signal == self.WORKER_PROCESS_IDENTITIES_SIGNAL: self._register_worker_processes(status) continue ...两条值得注意的细节。第一,worker 发来状态后必须收到 ACK 才继续,这是启动阶段的一问一答,避免 worker 在 proxy 还没登记进程身份时就进入服务。第二,worker 进程身份与 READY 分两条消息发送,WORKER_PROCESS_IDENTITIES_SIGNAL 先到、READY 后到,proxy 依此登记每个 worker 的 pid,后续才能监控它们是否还活着。启动阶段的状态通道与结果通道在物理上分开,意味着「初始化阶段」没有任何推理结果可以进入 result_queue,也就不会出现「结果先于状态到达」的顺序问题。
启动完成后,mpi_futures 才挂上死亡回调:
for fut in self.mpi_futures: fut.add_done_callback(mpi_done_callback)注释说明了为什么不能更早挂:如果某个 future 在挂回调时已经完成,add_done_callback 会同步执行回调,直接标记引擎死亡,把启动失败变成「引擎在初始化期间就死了」,从而盖住了启动错误本身。这是边界上「死亡信号」与「初始化错误」两类异常必须分开处理的典型例子。
请求与结果的配对
submit 先登记结果对象,再发送请求:
result = GenerationResult(request, ..., executor=self, ...)self._results[request.id] = resultif self._engine_dead or self._fatal_error is not None: self._results.pop(request.id, None) raise EngineDeadError(self._fatal_error)self.request_queue.put(request)中间的复检是为了关闭一个窗口:错误监控线程可能在 submit 刚登记完结果的瞬间标记引擎死亡,并把当时的 _results 快照全部标记为失败;晚一步登记的请求会漏过这次扫描,永远等不到结果。边界两端的并发安全是靠「登记 → 复检 → 发送」这个三段式兜住的。
大对象与序列化
TensorRT-LLM 的边界上还有一处不太显眼但很关键的设计:结果对象里的采样参数只在第一次随结果传一次,之后不再重复。代码注释写着 self._params_transmitted = False,用于避免把 SamplingParams 每步都序列化一遍。这是跨进程边界最常见的浪费——每个 step 都携带不该携带的元数据。
llama.cpp:进程内边界,但要跨越线程
同进程,两个线程
llama.cpp 的 server 是单进程程序:server_context 持有槽位、队列与结果队列,HTTP 线程由 httplib 管理。但推理不跑在 HTTP 线程上,而是跑在 server_queue::start_loop() 所在的主循环线程里。
server_queue 的成员说明了这条边界的形状:
std::deque<server_task> queue_tasks;std::deque<server_task> queue_tasks_deferred;std::deque<server_task> queue_tasks_unhandled;std::mutex mutex_tasks;std::condition_variable condition_tasks;std::function<bool(server_task &&, bool)> callback_new_task;std::function<void(void)> callback_update_slots;三根队列各有用途:queue_tasks 是常规入口,queue_tasks_deferred 是「暂时接不了的请求」(比如所有槽位都在算),queue_tasks_unhandled 是 yield 期间被拒绝、yield 结束后还要放回的任务。
HTTP 线程池的上界
llama.cpp 用 cpp-httplib,每个监听地址一个线程,所有监听共享一个线程池:
std::vector<std::thread> threads; // one thread per listenerstd::unique_ptr<httplib::ThreadPool> pool; // single pool shared among all listenersint n_threads_http = 0;默认线程数不是固定常数,而是随 n_parallel 走:
n_threads_http = std::max(params.n_parallel + 4, static_cast<int32_t>(std::thread::hardware_concurrency() - 1));+4 是留给监控、健康检查与 MCP 之类辅助请求的余量。这个公式说明了一个简单的工程事实:HTTP 线程数至少要能覆盖「所有槽位都在流式输出」的并发,否则会出现请求已经完成、但 SSE 响应还没写完的尴尬——槽位被占着,HTTP 线程却在排队。
主循环:先收任务,再跑前向
start_loop 的结构非常直白:
while (true) { if (process_new_tasks(false)) { break; // terminate } const int64_t t_update_slots = ggml_time_ms(); callback_update_slots(); ...}process_new_tasks 把新到达的任务交给 process_single_task,后者决定是给某个空闲槽位开工、推入 deferred、还是直接拒绝。所有任务处理完后,callback_update_slots 调用 update_slots() 跑一次 llama_decode。这是「批处理窗口」最原始的实现形态:一轮循环里到达的所有请求被一起送进同一次前向。
拒绝、延迟与放回
process_single_task 的返回值决定了任务去哪:能立刻开工就 launch_slot_with_task;暂时没有空闲槽位就 queue_tasks.defer;正在 yield 时不允许处理的任务会被拒绝,任务被移进 queue_tasks_unhandled,等 yield 结束后按原顺序放回队首:
while (!queue_tasks_unhandled.empty()) { queue_tasks.push_front(std::move(queue_tasks_unhandled.back())); queue_tasks_unhandled.pop_back();}这三条路径对应三种背压:
- 槽位不足:延迟,等当前 batch 结束;
- yield 期间不可处理:拒绝,等主循环恢复;
- 队列满/超时:更上层直接返回错误。
llama.cpp 没有显式的「最大排队长度」参数,背压主要靠调度延迟与 HTTP 层的超时来体现。这与 vLLM 的 max_num_seqs + max_num_batched_tokens 双约束不同:前者是「槽位」的硬上界,后者是「token 预算」的软上界。
结果等待与取消
server_response_reader 把「任务提交 → 结果读取」包成一个生成器式接口:
server_task_result_ptr next(const std::function<bool()> & should_stop);batch_response wait_for_all(const std::function<bool()> & should_stop);should_stop 每个轮询周期调用一次,HTTP 线程用它检查客户端是否断开。一旦返回真,reader 停止等待并返回 nullptr;上层据此停止发送 SSE,并调用 queue_tasks.terminate 或任务取消路径。和 SGLang 的 wait_for 超时一样,这是「用轮询把断连检测塞进阻塞等待」的另一种写法。
yield_to_queue:为什么主循环需要「让出」
这里有个其它框架不需要面对的问题:llama.cpp 的 HTTP 线程池可能同时处理路由、多模态解码等任务,有些任务需要在 update_slots 运行期间被处理,而 update_slots 本身是同步阻塞的。yield_to_queue 就是为此而生:
void server_queue::yield_to_queue(std::function<void()> && work) { { std::unique_lock<std::mutex> lock(mutex_tasks); worker.busy = true; worker.yielding = true; } worker.cv.notify_one(); work(); // run the work on the current thread, so that all ggml compute stays on the same thread ...}注释里那句 “so that all ggml compute stays on the same thread” 点出了硬约束:ggml 的计算图与后端状态在构建时不保证线程安全,计算必须固定在同一个线程上。yield 的机制是让一个 worker 线程去处理新任务,但任务处理里仍要保证 ggml 不跨线程。于是 process_new_tasks(is_yielding=true) 里那些会触碰计算的请求就会被拒绝并收进 queue_tasks_unhandled,等 yield 结束后再按原顺序放回队首。
结果回传与客户端断开
结果侧是 server_response,结构是「等待集合 + 结果列表 + 条件变量」:
std::unordered_set<int> waiting_task_ids;std::vector<server_task_result_ptr> queue_results;std::mutex mutex_results;std::condition_variable condition_results;HTTP 线程通过 server_response_reader::next(should_stop) 取结果。should_stop 是个回调,每次轮询间隔调用一次,用来检测客户端断开。wait_for_all 在多任务场景下继续消费直到全部结果到齐,遇到单个错误就提前停止。
这条边界的核心结论是:进程内不等于没有边界。线程间共享数据同样需要队列、互斥量与条件变量,而且比跨进程更难处理——跨进程有边界检查,跨线程则是「忘了加锁就静默出错」。
DeepInfer:把边界压在进程内,CP 才跨进程
驱动 worker 在主进程
DeepInfer 的 _init_workers 把 CP rank 0 的 worker 直接构造在主进程:
self.driver_worker = Worker( self.engine_type, self.model_config, self.parallel_config, self.scheduler_config, self.cache_config, 0, # local_rank 0, # cp_rank distributed_init_method, True, **driver_kwargs)其余 CP rank 用 SpawnProcessWithCrashHeader 拉起。因此对单机(CP=1)部署来说,调度、模型前向、采样全部在同一进程,边界退化为普通方法调用 _run_workers("execute_model_step", ...)。这是与 vLLM V1 最本质的差异:vLLM 强制有进程边界,DeepInfer 只在需要时才跨。
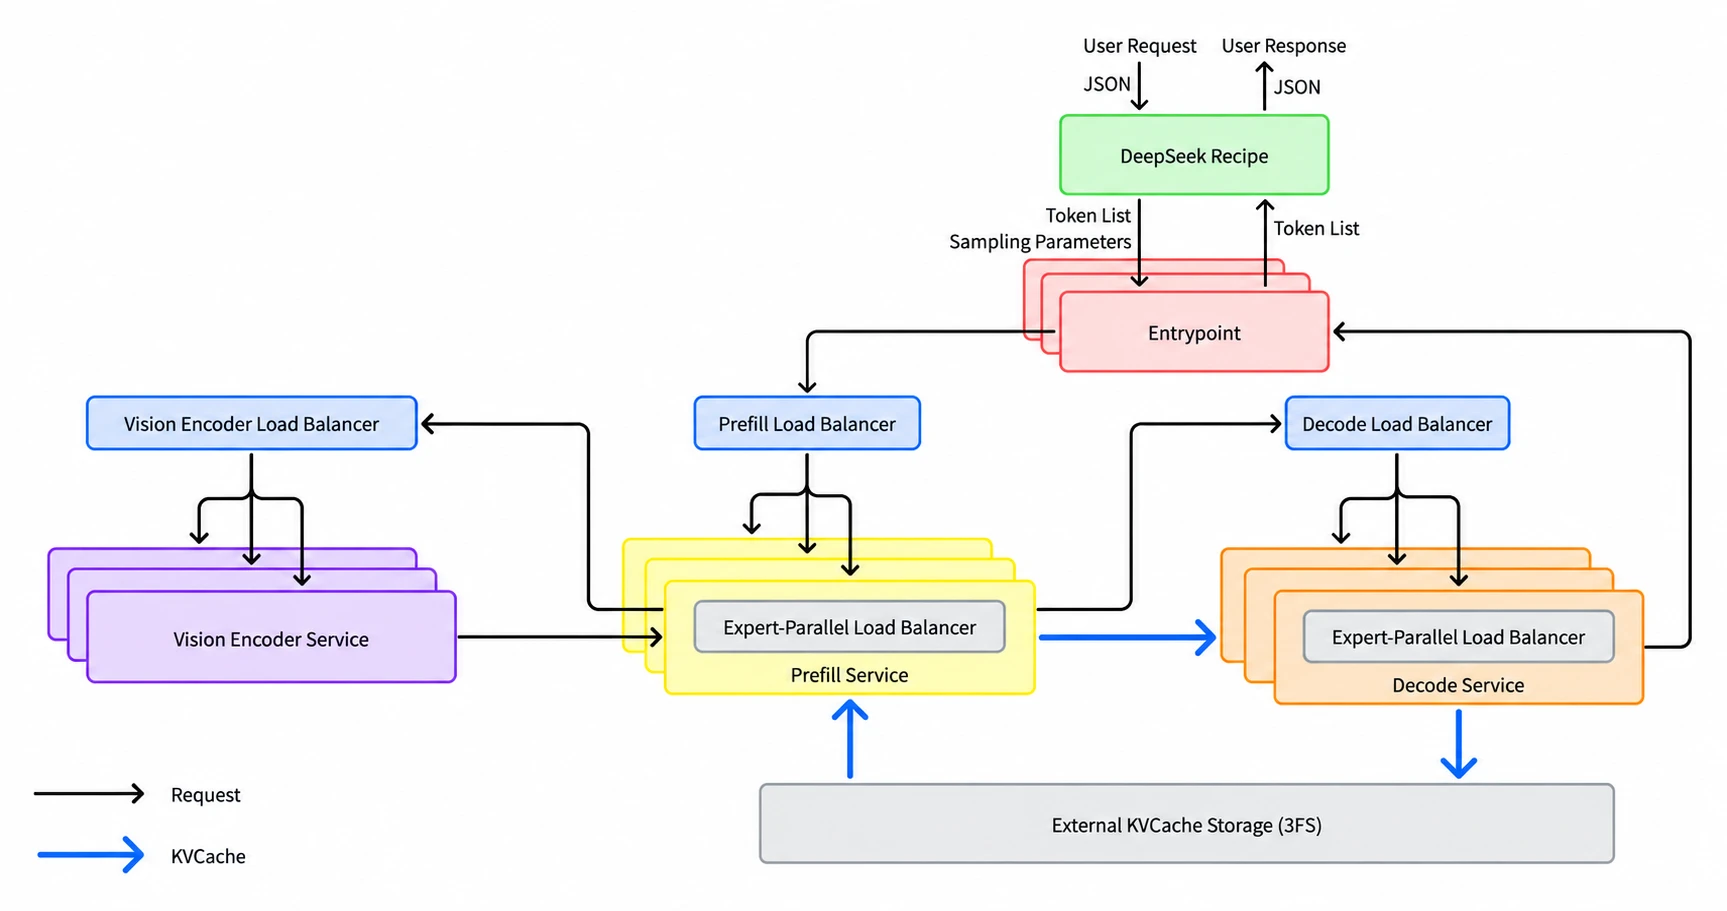
图片来源:DeepInfer 仓库 doc/images/architecture_overview.png。图展示的是 DeepSeek 生产推理服务的分层:DeepSeek Recipe 负责协议与会话,负载均衡器把请求分给 Prefill/Decode 服务,KV Cache 另存于 3FS;开源 DeepInfer 对应的是其中的引擎内核,不包含完整的在线接入层。
跨 CP 的控制面
CP > 1 时,一份调度结果要传给所有 CP rank 对应的 worker。WorkerBase.run_workers 里:
cp_group = PG.cpu_cp_groupif cp_group and cp_group.size() > 1: cp_broadcast_object((method, kwargs))return getattr(self, method)(**(driver_kwargs or {}), **kwargs)cp_broadcast_object 走的是 MessageQueue,而 MessageQueue 建立在共享内存之上:
if cp_size > 1: self.mq = MessageQueue.create_from_process_group(self.cpu_cp_group, 1 << 20, 10)注意这里刻意选了 cpu_cp_group——gloo 后端。控制面传的是方法名和 kwargs,不是张量,没有必要让它在 NCCL 上排队;GPU 侧真正的 KV 交换由注意力 kernel 里的 CP 通信解决。这是边界设计中一个值得记住的分离:控制面走 CPU 后端,数据面走 GPU 后端。
进程内边界不等于没有边界
即使 CP=1,DeepInfer 的引擎内部仍然存在「引擎线程」与「worker 回调」之间的分工。EngineCallbacks 把两个函数交给 worker:
driver_kwargs = { "engine_callbacks": EngineCallbacks( post_process_fn=self.post_process, pre_sampler_sync_fn=self.pre_sampler_sync),}execute_model_step 在采样之后调用 pre_sampler_sync_fn,在下一步开始时调用 post_process_fn 处理上一步的输出。这两个回调把「后处理」从 execute_model_step 的线性流程里摘出来,插到 GPU 采样的前后之间。没有跨进程,但仍然有明确的时序契约:回调必须在下一次采样之前完成,否则会把前一步的 CPU 工作挤进下一步的关键路径。DeepInfer 的 ZOS 正是在这个缝隙里做文章。
离线入口与在途输出
DeepInfer 的 LLM 是离线入口,_run_engine 的循环也很简单:
while True: unfinished = self.llm_engine.has_unfinished_requests() step_outputs = self.llm_engine.step() if unfinished else self.llm_engine.flush_inflight_reqs()flush_inflight_reqs 的存在与 ZOS(零开销调度)直接相关:decode 步的后处理被延后到下一步,为了让步间重叠,最后一步必须显式把在途结果冲出来,否则最后一个请求的输出会滞留在内部。这是「把工作延后」这种优化在生命周期末尾留下的尾巴,任何做延迟处理的边界都要处理它。
横向对比:五个设计决策点
决策一:反分词放在哪
| 位置 | 框架 | 代价 |
|---|---|---|
| 前端进程 | vLLM、TensorRT-LLM、llama.cpp、DeepInfer | 与 HTTP 共享 CPU;GIL 争用;但断开检测最直接 |
| 独立进程 | SGLang | 多一次跨进程拷贝与调度延迟;换来 CPU 互不干扰 |
选择独立进程的收益随并发线性增长:单请求几乎感知不到额外开销,但上千并发的时候,主进程反分词会成为事件循环的隐形阻塞源。
决策二:输出通道的方向
vLLM 与 SGLang 都用一组单向通道:请求侧 PUSH/ROUTER,输出侧 PULL。TensorRT-LLM 的 result_queue 只承载「worker → 前端」方向,取消另有 CancellingRequest 从 request_queue 送进去。llama.cpp 的结果队列则是进程内、双向共享的。
单向通道的好处是会自然产生「谁持有谁」的格局:读端永远只读,写端永远只写,任何一侧重启都不会让另一边误把别人写坏的数据读进来。代价是取消、健康检查、权重更新这类反向指令必须另开一条或挤进请求通道。
决策三:谁跑事件循环
这一点在不同框架差别最大:
- vLLM:
AsyncLLM本身就在 asyncio 里,output_handler是一个 asyncio 任务,RPC 客户端也支持await。 - SGLang:
TokenizerManager在主进程、运行于 uvicorn 的事件循环里,state.event是asyncio.Event,_stream_one_response是异步生成器。 - TensorRT-LLM:proxy 进程可以有事件循环,也可以没有;结果分发用「线程 + 手动唤醒」兼顾两种。
- llama.cpp:没有事件循环,HTTP 与推理都是线程。
- DeepInfer:离线模式,没有事件循环。
是否依赖事件循环,会影响整条链路上「阻塞是否可以表现为可 await 的等待」。TensorRT-LLM 的双模式代码告诉我们:如果边界需要同时服务同步和异步调用者,最干净的做法是让边界对象自己选择队列类型,而不是在上层写两套逻辑。
决策四:大对象怎么进引擎
跨进程边界上传输的最大对象通常是 prompt token 序列与多模态输入。几个框架的处理思路:
- vLLM 的
Processor在前端完成 tokenize,EngineCoreRequest里带着prompt_token_ids与mm_inputs;后者是哈希缓存的键,相同图片不会重复跨进程。 - SGLang 同样在
TokenizerManager内完成分词,但把「多模态处理」也放在这里,因此 scheduler 收到的已经是可直接调度的 token 序列。 - TensorRT-LLM 在 proxy 内完成预处理后,通过 IPC 队列把
prompt_token_ids送进 worker。 - DeepInfer 没有在线边界,但它的 CP 广播只传方法名与 kwargs,不传张量,把大对象传输排除在控制面之外。
共同点是:分词与多模态全部在前端完成,引擎只接收整数序列。这条规律在五个框架里没有例外,原因也一致——分词依赖 Python 侧大量状态与 GIL,放在引擎里会和调度、前向争抢 CPU。
决策五:异常与死亡如何跨边界传播
一个引擎进程挂掉时,前端必须有办法知道。三种做法:
- vLLM:哨兵帧
ENGINE_CORE_DEAD+ 异常入队; - SGLang:
subprocess_watchdog与 scheduler 进程退出检测; - TensorRT-LLM:错误监控线程把
EngineDeadError推给所有等待中的结果,并拒绝新请求。
三者本质是同一模式:用一条带外的「死亡信号」把带内通道上的等待者集体唤醒。区别只在于信号放在通道上(vLLM)、放在监控线程里(TensorRT-LLM)、还是放在进程管理侧(SGLang)。
三种故障场景,五种行为
场景一:客户端在第三个 token 时断开
这是线上最常见的异常。五个框架的处理路径差别很大:
| 框架 | 断连检测点 | 取消动作 | 最坏延迟 |
|---|---|---|---|
| vLLM | generate 生成器被取消 | AsyncLLM.abort → OutputProcessor + EngineCore ABORT | 立即(由 ASGI 层触发) |
| SGLang | _stream_one_response 的超时轮询 | abort_request → AbortReq | 一个 _REQUEST_STATE_WAIT_TIMEOUT |
| TensorRT-LLM | HTTP handler 调用 GenerationResult.abort | CancellingRequest 进 request_queue | 由上层 handler 决定 |
| llama.cpp | server_response_reader 的 should_stop | 停止等待 + 任务取消 | 一个轮询间隔 |
| DeepInfer | 离线调用,无客户端 | 调用者取消/关闭 | 不适用 |
vLLM 的路径最短,因为 generate 本身就是一个异步生成器,客户端断开会让 ASGI 层取消这个生成器,except (asyncio.CancelledError, GeneratorExit) 直接捕获并调用 abort。SGLang 与 llama.cpp 都需要「轮询」来发现断开,因为它们的等待不是由 HTTP 层的取消信号直接驱动的;这带来一个可调参数:轮询太慢会浪费算力,太快会增加事件循环/线程唤醒开销。
TensorRT-LLM 的取消是显式的:RequestOutput.abort() 只在调用者主动调用时发生。如果 HTTP handler 没有把客户端断开映射到 abort,引擎不会自己发现。这种「边界不负责断连检测」的设计把责任推给了上层框架,好处是引擎侧不需要处理半关闭连接,坏处是每个接入层都必须记得调用。
场景二:引擎进程崩溃
| 框架 | 死亡信号 | 前端表现 |
|---|---|---|
| vLLM | ENGINE_CORE_DEAD 帧 | EngineDeadError,输出泵抛出,服务关停 |
| SGLang | 子进程 watchdog + scheduler 退出 | server_status 变化,健康检查失败 |
| TensorRT-LLM | MPI future 完成回调 + 错误监控线程 | 所有在途 GenerationResult 收到 EngineDeadError |
| llama.cpp | 同进程,没有独立引擎进程 | 进程整体退出,连接被重置 |
| DeepInfer | worker 进程崩溃 → SpawnProcessWithCrashHeader | 驱动侧抛异常,离线调用失败 |
TensorRT-LLM 的 _mark_engine_dead 值得单独看:
for result in list(self._results.values()): try: result.queue.put(dead_error) except Exception: pass它把「引擎死亡」写成每个等待者都能理解的异常,而不是让它们永久阻塞在 queue.get() 上。vLLM 的做法是在输出帧里塞哨兵,SGLang 的做法是让 scheduler 进程退出、由进程管理层处理。三者都在解决同一个问题:不能让等待者无限期地等一个永远不会来的结果。
场景三:超长 prompt
超长 prompt 的处理位置,决定了边界上要不要传一个「注定失败」的请求:
- vLLM 在
Processor._validate_model_inputs里检查max_model_len,超长直接在前端抛ValueError,请求根本不跨边界。 - SGLang 在
_validate_one_request/ tokenizer 阶段检查,超长请求在进入 scheduler 前被拒。 - TensorRT-LLM 在
LLM._check_arguments里检查,proxy 侧就拒绝,不会送进 worker。 - llama.cpp 在
launch_slot_with_task里比较slot.task->n_tokens()与slot.n_ctx,超长请求返回ERROR_TYPE_EXCEED_CONTEXT_SIZE。注意此时请求已经跨过 HTTP→任务队列,是在槽位装载阶段被拒的。 - DeepInfer 的离线入口不做 HTTP 层校验,超长 prompt 由调度器按可用 KV 容量处理,失败表现为调度侧拒绝或内存不足。
前三个在线框架把长度校验放在前端,这是一个值得记住的原则:能在边界之前拒绝的请求,不要让它跨过去。跨过去再拒绝,不仅要占一次 IPC、一次调度,还可能因为引擎侧的错误处理路径而污染正在跑的 batch。llama.cpp 是反例:它的检查发生在槽位装载阶段,虽然还没解码,但请求已经占用了队列与槽位一次。
健康检查走哪条路
健康检查是对边界的额外扰动,五个框架的处理也不一样:
- vLLM 通过
EngineCoreClient的 utility 调用访问引擎,不占用正常的 ADD 通道语义; - SGLang 用带
HEALTH_CHECK_RID_PREFIX前缀的真实生成请求,输出侧识别并忽略; - TensorRT-LLM 有独立
check_health(),会检查错误队列与 MPI worker 状态; - llama.cpp 的
/health只查进程状态,不进推理队列; - DeepInfer 离线模式没有健康检查接口。
健康检查的设计目标不是「证明引擎能跑」,而是「证明边界仍然通」。只查进程存活是不够的:ZMQ 通道可能已经断了,引擎进程却还活着。vLLM 的 utility 调用与 SGLang 的真实生成请求都在验证「请求能进、输出能出」,代价是会产生真实计算或至少一次调度。llama.cpp 的 /health 最轻,但也最不敏感。
边界与时延:这条线值多少毫秒
一次 decode 步在边界上的账
一次 decode 步的端到端时延可以粗略拆成四段:
其中 是调度耗时, 是 GPU 前向, 是跨边界的序列化与传输, 是前端反分词、stop 判定与事件组装。前两项是引擎内部的事,后两项几乎完全由边界设计决定。
以 7B 级模型、batch=1 的 decode 为例, 通常在数毫秒量级,一个 step 的预算非常紧。这时 的绝对值虽然只有几十到上百微秒,但它在单个 step 中的占比可以达到几个百分点,乘上每秒几百个 step 就是可观的吞吐损失。这也解释了为什么五个框架都在这个量级上做文章:vLLM 用 copy=False 的 ZMQ 接收避免一次拷贝,SGLang 用延迟拼文本避免 的字符串重建,TensorRT-LLM 只在第一次传采样参数。
用一点串行算术估算边界成本
设一个 decode step 在边界上需要发送 个请求的输出,每个输出平均携带 个 token 与若干元数据,消息体大小为 字节。若边界是单向异步通道,这一段的平均开销近似为:
是通道有效带宽, 是每个请求的固定处理成本(反查状态、事件唤醒、队列操作)。第一项是传输,第二项是前端 CPU。前者与消息体大小成线性,后者与请求数成线性。
这条式子解释了 SGLang 为什么要把反分词搬走:反分词会把 放大几倍(字符串处理比整数拷贝贵得多),搬进独立进程后,主进程的 回到纯事件唤醒的量级,而反分词进程的 CPU 又能与 GPU 前向并行——只要它能跟上, 对主进程就不再有影响。与之相对,llama.cpp 的 c 基本为零:结果直接写到同进程队列里,唤醒成本只是条件变量的 notify。
边界宽度与并发上界
前端的输出处理是单线程的(无论是 asyncio 事件循环还是 llama.cpp 的主循环),所以边界还有一个隐式的「宽度」:
其中 是前端每秒能处理的 token 数(这里把每个请求的输出长度近似成相同的 )。当引擎的产出速率超过这个数,输出就会在前端积压。vLLM 的合并策略、SGLang 的延迟拼文本,本质上都是在压小 ,以提高 。这条式子也说明:如果只想让前端「更快一点点」,与其优化单次操作,不如减少每个 step 的 ——把多个 step 的输出合批送出,是最直接的降本。
实现细节:边界上的几个易错点
先注册还是先发送
vLLM 和 TensorRT-LLM 都是先在前端登记状态、再发送请求;SGLang 的顺序则是在发送之前就把 ReqState 建好。所有框架都遵循「登记在前、发送在后」。反过来会导致输出到达时找不到消费者,轻则丢 token,重则报 Received output for {rid} but the state was deleted。
为什么 vLLM 的线程模型是安全的
EngineCoreProc 里,GPU 前向跑在主线程上,ZMQ 收发放在两个后台线程:
threading.Thread(target=self.process_input_sockets, ..., daemon=True).start()self.output_thread = threading.Thread( target=self.process_output_sockets, ...)self.output_thread.start()线程与主循环之间只通过 queue.Queue 交换请求类型与输出批次。代码注释给出的理由有两条:一是 ZMQ 收发会释放 GIL,可以和 GPU 计算重叠;二是 msgspec 的序列化/反序列化本身是纯 CPU 工作,放在另一个线程里就能与 GPU 前向并行。主循环本身则很短:
def run_busy_loop(self): while True: self._process_input_queue() self._process_engine_step()_process_input_queue 在「没有请求可跑」时会阻塞在 input_queue.get() 上,这一步让空闲的引擎不空转;一旦有请求进来,它先把队列里剩余的消息全部抽干,再进一次前向。这就是为什么 vLLM 的引擎侧不需要事件循环,却依然能做到「等待时不烧 CPU」。
为什么 SGLang 的等待必须带超时
vLLM 的输出泵是后台任务,前端每个请求只是从自己的 RequestOutputCollector 里取数据,断连检测交给 HTTP 层。SGLang 的 _stream_one_response 是「请求自己驱动的生成器」,它必须同时承担两件事:等输出和察觉断开。所以 asyncio.wait_for 的 _REQUEST_STATE_WAIT_TIMEOUT 不是限流阈值,而是「轮询断连的间隔」。如果它被误设成很大的值,客户端断开后引擎会多算很久;设得太小,事件循环会被频繁唤醒,增加调度开销。这个参数属于边界调优参数,不该被当成普通超时来理解。
主循环空闲时怎么办
llama.cpp 的 start_loop 支持 idle sleep,避免空闲时占满一个核:
auto should_sleep = [&]() -> bool { if (idle_sleep_ms < 0) return false; int64_t now = ggml_time_ms(); return (now - time_last_task) >= idle_sleep_ms;};并且 update_slots 期间的时间会被「扣掉」:
time_last_task = std::min(now, time_last_task + (now - t_update_slots));否则一轮长前向之后,计时器会误判为「已经空闲了很久」。这类计时细节在边界上并不少见——vLLM 的 last_receive_tstamp、SGLang 的 last_receive_tstamp 都要在输出处理时刷新,否则健康检查会把仍在稳定输出的服务判成「失联」。
采样参数要不要跨边界
TensorRT-LLM 只在第一次随结果传 SamplingParams,之后不再传。vLLM 的选择相反:EngineCoreRequest 每次只传一次,但 OutputProcessor 在前端保留了一份副本,用于计算 max_tokens 边界与投机验证的统计。两种做法对应两种所有权:
- 引擎拥有采样参数(TensorRT-LLM):前端不需要知道采样细节,但后处理需要用 token 数做判定时就得多传一点信息;
- 前端拥有采样参数(vLLM):
OutputProcessor可以基于本地参数做 stop 判定,代价是两边都保留一份,需要在使用前对齐 clone。
一个容易踩的坑是:SamplingParams 带有 n、best_of、logprobs 这类会影响输出形状的字段。如果两边副本不一致,前端会把子请求的输出错误地合并到父请求上。vLLM 在 add_request 里把 params.clone() 后再下发,就是这个原因。
请求 ID 的生命周期
跨进程传的 request_id 必须在两边同步存活。SGLang 里有一段处理值得注意:
# A newer request may already be using the same rid.if self.rid_to_state.get(state.obj.rid) is state: del self.rid_to_state[state.obj.rid]客户端允许复用 rid 时,旧请求的收尾可能发生在同一个 rid 已被新请求占用之后。判断依据不是 rid 相等,而是 is state——对象身份。这是边界上「标识符可能被回收」的典型坑。
健康检查的请求
SGLang 与 vLLM 的健康检查都会向引擎发一个真实请求来探测存活。SGLang 用保留的 rid 前缀:
if rid.startswith(HEALTH_CHECK_RID_PREFIX): continue在输出处理时忽略这类请求,避免健康检查流量被当成业务流量的异常。健康检查穿越边界会扰动统计、抢占调度配额,所以边界内必须识别并隔离它。
输出合并的取舍
当生产者快于消费者时,边界上会积压输出。两种处理:
- 合并:vLLM 的
RequestOutputCollector.put在已有未取走的增量输出时直接add; - 丢弃中间态、保留最新:vLLM 的
put对非增量结果直接覆盖。
合并会牺牲「逐 token 时间线」,但保住了 token 计数与最终文本;覆盖会丢掉中间的 token id。两种策略在纯流式展示时都合理,但都在 use_cached_outputs、logprobs 这类需要完整历史的场景下必须禁用。
边界上的「最后一步」问题
任何把工作延后到下一步的优化,都会留下「最后一步没有下一步」的洞。前面看到 DeepInfer 用 flush_inflight_reqs 收尾;SGLang 的处理在 _handle_batch_output 末尾,把剩余的 pending_notify 一次性 set 出去;vLLM 的输出合并则要求 generate 在循环结束时确认 out.finished,否则合并后的对象可能还带着未提交的最后几个 token。这类问题在小流量下很难复现,但在压测最后一批请求时一定会出现,表现是「请求全部返回了,但流式响应的 [DONE] 晚了半秒」或者「最后一个 token 丢失」。
修法没有统一答案,但有一个共同的检查点:凡是依赖「下一步」的延迟,都必须存在一个明确的收尾路径。实现时最容易漏掉的是错误分支——引擎异常退出时,收尾函数不会被调用,在途请求就卡在那里。
优雅退出
SGLang 示例流式响应里有个经典写法:CancelScope(shield=True) 包住 aclose()。在跨进程边界上,客户端断开的处理顺序是:前端收到取消信号 → shield 保证关闭动作本身不被取消 → 关闭动作再通过通道发出 abort → 引擎侧回收 KV。顺序反了就会出现「前端已经走了,引擎还在算」。
设计原则小结
把五套实现放在一起,能提炼出五条在实现前端—引擎边界时反复出现的经验:
- 前端只接窄请求:引擎收到的永远是整数 token 序列 + 一组引擎自己能执行的参数,分词、多模态、协议转换全在前端。
- 登记先于发送:任何以请求 ID 为键的状态,都必须在前端先建立,再让请求跨过边界。
- 带外死亡信号:跨进程通道必须配一条独立的存活信号,且能唤醒所有在途等待者。
- 反向指令要么另开通道、要么挤进同一条:取消、权重更新、健康检查都属于这一类,必须明确选择。
- 控制面与数据面分家:控制信息走 CPU 后端或 IPC 队列,张量走 MPI/NCCL,两者不要混。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



